Probas - Programmation Probabiliste
À propos des décomptes : le marqueur
CATALOG-STATUSci-dessus est la source de vérité autoritative pour les volumes (total de la famille, notebooks par sous-série, maturité). Il est régénéré chaque nuit par le workflowcatalog-cron.ymlà 03:37 UTC surmain(commit pargithub-actions[bot], livré par la PR permanentechore/catalog-refresh-pending). Pour la répartition par kernel (C#/.NET vs Python vs Lean 4) au sein d’une sous-série — la décomposition technique par interpréteur, que le marqueur n’agrège pas —, la source est la lecture directe desmetadata.kernelspecdes notebooks : ces volumes dérivent à chaque ajout et aucun chiffre n’est maintenu ici en prose. Si vous observez un décalage entre ce marqueur et une phrase en prose de ce README, fiez-vous au marqueur ; la prose sera ré-alignée lors du prochain passage.
← Notebooks | Série Infer (C#) → | Série PyMC (Python) → | Percolation → | GameTheory →
Le monde réel est incertain. Un diagnostic médical n’est jamais sûr à 100%, un classement sportif dépend de performances intrinsèquement variables, et les données que nous collectons sont toujours bruitées ou incomplètes. La programmation probabiliste offre un cadre rigoureux pour modéliser cette incertitude : plutôt que de calculer une seule réponse, on obtient une distribution de probabilités qui quantifie notre confiance dans chaque résultat possible.
Cette série couvre trois stacks complémentaires : Infer.NET (Microsoft, C#/.NET Interactive) pour l’inférence par message passing déterministe (EP/VMP, plus un échantillonneur de Gibbs disponible), PyMC (Python) pour l’échantillonnage stochastique MCMC (NUTS), et des applications standalone (RSA, identification causale avec DoWhy, percolation de liens sur tore fini, géométrie catégorique quotients/fibres). Les volumes — total de la famille, décompte par sous-série, maturité — sont portés par le marqueur CATALOG-STATUS en tête de ce README ; la répartition par kernel se lit dans les metadata.kernelspec des notebooks.
Le corpus bayésien (Infer/) couvre le socle numéroté 1-19 (le numéro 6 n’existe pas — le debugging vit en accretion Infer-2b) et les accretions Infer-1b (premier modèle) et Infer-08b (formules fermées TrueSkill) : fondements (distributions, graphes de facteurs), modèles classiques (réseaux bayésiens, TrueSkill, LDA, HMM), frontières (causalité, processus gaussiens, modèles hiérarchiques, filtre de Kalman, détection de rupture, analyse de survie). La géométrie catégorique (quotients, fibres, recollement) vit en application autonome : Applications/Quotients-Fibres-Recollement-Python.ipynb (kernel Python).
L’arc décision (DecisionTheory/DecInfer/) en extrait des notebooks C# (utilité espérée, EVPI, MDPs, bandits, jusqu’au Thompson Sampling DecInfer-10). Il est en outre certifié par un lake compagnon Lean 4 (decision_theory_lean) et ses notebooks à kernel Lean (DecInfer-02 utilité espérée vNM, DecInfer-08b indice de Gittins) : les identités d’escompte y sont démontrées (0 sorry), le théorème d’optimalité restant énoncé — sa preuve complète attend une formalisation des MDP absente de Mathlib.
Le versant PyMC porte ces modèles en Python avec l’échantillonnage NUTS : le corpus bayésien PyMC (PyMC/, en miroir de l’arc Infer — paires numérotées, la paire de debugging étant PyMC-02b ↔︎ Infer-2b (toutes deux accrétions 2b, cf renommage #17808) ; fondations, modèles classiques, inférence causale, puis frontières : séquences, reco, processus gaussien épars, filtre de Kalman, change-point, survie) et les miroirs de l’arc décision (DecisionTheory/DecPyMC/, renumérotés, dont la jambe actuarielle 8-12).
La percolation (Applications/Percolation/) complète ce trio Lean avec Percolation-Lean (noyau fini prouvé sans sorry, compagnon du lake percolation_lean), jumeau de la simulation Python Percolation-Supercritique (trois régimes mesurés).
Enfin, un pont causal (DecisionTheory/Causal-Bridges/, kernels python3 et coursia-ml-training) fédère les quatre traitements de la causalité disséminés dans le dépôt — Tweety (logique), Infer.NET, PyMC et l’émergence causale (PyPhi) — autour de l’échelle de Pearl et du do-calculus. Sur l’outil de référence dowhy, le pont identifie l’estimande (backdoor, front-door, variable instrumentale), l’estime puis le réfute ; il monte au troisième échelon de Pearl (contrefactuel individuel), couvre les méthodes quasi-expérimentales (DiD, contrôle synthétique, RDD), et pousse chaque hypothèse d’identification dans ses retranchements : découverte de structure quand le graphe manque (causal-learn : PC, GES, LiNGAM — CausalBridges-04, ex-DoWhy-3), sensibilité au confondeur caché (robustness value, E-value, Rosenbaum — CausalBridges-05, ex-DoWhy-4) et instrument faible (F-stat, biais IV vs OLS — CausalBridges-06, ex-DoWhy-5).
Pourquoi cette série
La programmation probabiliste occupe une place singulière dans le paysage de l’IA. Alors que le machine learning classique fournit des prédictions ponctuelles (un score, une classe), il ne dit pas à quel point il a confiance en cette prédiction. La programmation probabiliste, elle, quantifie cette incertitude de façon native.
Cette série repose sur une double approche d’inférence, délibérément juxtaposée. L’axe de comparaison est déterministe vs stochastique (message passing vs échantillonnage), non « exact vs approché » : le moteur EP par défaut d’Infer.NET est lui-même approché dans le cas général (exact seulement sur les réseaux discrets sans boucle), et Infer.NET propose aussi un échantillonneur de Gibbs. Les deux stacks recouvrent donc des méthodes approchées ; ce qui les distingue, c’est le mécanisme, pas l’exactitude.
- Message passing déterministe (Infer.NET) : les probabilités se propagent le long des arêtes d’un graphe de facteurs comme des messages. Trois moteurs : EP (Expectation Propagation, défaut — rapide, approché en général, exact sur les modèles discrets sans boucle), VMP (variationnel — stable, sous-estime l’incertitude) et Gibbs (échantillonnage — exact asymptotiquement, lent, utile pour valider EP/VMP). Avantage : résultats reproductibles et rapides, visualisation du graphe de facteurs. Limite : chaque moteur ne couvre qu’une famille restreinte de modèles.
- Échantillonnage stochastique MCMC (PyMC) : pour les modèles génériques où le message passing déterministe ne s’applique pas. NUTS (No-U-Turn Sampler) explore l’espace posterior en simulant une dynamique hamiltonienne. Avantage : s’applique à presque tout modèle. Limite : résultats stochastiques, temps de convergence variable, diagnostic nécessaire (R-hat, ESS, trace plots).
Avoir les deux approches sur les mêmes modèles permet de comprendre leur champ d’application et leurs compromis, une connaissance cruciale pour tout praticien.
Au-delà de la méthodologie, cette série couvre des applications réelles qui utilisent la programmation probabiliste en production : TrueSkill (Xbox Live, 100M+ joueurs), Item Response Theory (GMAT/GRE, millions de candidats), LDA (Google News, classement de documents), et les réseaux bayésiens pour le diagnostic médical. Chaque modèle est une brique construite sur les précédentes, formant un édifice cohérent.
Qu’est-ce que la programmation probabiliste ?
| Aspect | ML classique (déterministe) | Programmation probabiliste |
|---|---|---|
| Sortie | Un seul résultat (ex: 0.73) | Une distribution complète (ex: N(0.73, 0.12)) |
| Incertitude | Non quantifiée | Intégrée nativement (intervalles de crédibilité) |
| Données manquantes | Problématique | Naturelles (variables latentes) |
| Combinaison de sources | Requiert ingénierie manuelle | Probabilités conditionnelles structurées |
| Décisions | Basées sur un point | Basées sur E[U] (utilité espérée) |
flowchart LR
    D["Données<br/>(observations)"] --> ML["ML classique<br/>(déterministe)"]
    D --> PP["Programmation<br/>probabiliste"]
    ML --> P1["Un seul résultat<br/>ex: 0.73"]
    PP --> P2["Une distribution<br/>ex: N(0.73, 0.12)"]
    P1 --> U1["Incertitude<br/>non quantifiée"]
    P2 --> U2["Incertitude<br/>native<br/>(intervalles de crédibilité)"]
    U2 --> DEC["Décision basée sur<br/>E[U] (utilité espérée)"]
    %% color: explicite -- sans lui, libelle clair sur fond clair en mode sombre GitHub (#15022) ; ton parfois plus fonce que le stroke (le stroke en couleur de texte rendrait infer illisible) : ne pas harmoniser
    classDef dist fill:#d1ecf1,stroke:#0c5460,stroke-width:2px,color:#0c5460;
    class P2,U2,DEC dist;
La différence fondatrice : le ML classique produit un point, la programmation probabiliste produit une distribution (en bleu). Cette incertitude native se propage jusqu’à la décision — on maximise l’utilité espérée E[U], pas un seul score.
De la distribution à l’utilité : pourquoi la courbe est concave
La maximisation de E[U] repose sur une hypothèse centrale de la théorie de la décision sous incertitude : l’utilité est une fonction concave de la richesse. Trois fonctions fondamentales l’illustrent ci-dessous — racine carrée √x, logarithme ln(x) (toutes deux concaves) et fonction linéaire x (neutre au risque, en référence) — chacune traduisant l’utilité marginale décroissante (chaque euro supplémentaire apporte moins d’utilité que le précédent pour les courbes concaves), fondement de l’aversion au risque :
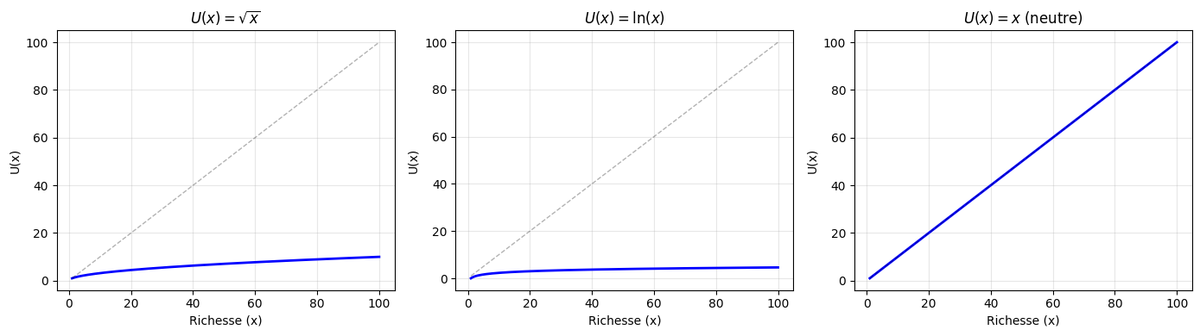
Source : DecPyMC-2-Utility-Money.ipynb (cellule 10 « Démonstration numérique : utilité marginale décroissante », index toutes-cellules), track DecisionTheory/DecPyMC.
Objectifs d’apprentissage
À l’issue de cette série, vous serez capable de :
- Construire un modèle probabiliste en Infer.NET ou PyMC (définition, inférence, validation)
- Interpréter les distributions postérieures (moyenne, variance, intervalles de crédibilité)
- Comparer message passing vs MCMC sur le même modèle
- Décaler d’un problème réel vers sa formulation probabiliste (variables, facteurs, observations)
- Intégrer inférence probabiliste et théorie de la décision (maximisation d’utilité espérée)
Parcours d’apprentissage
Phase 1 : Fondations (Notebooks 1-3, ~2h)
Le parcours commence par le notebook 1 (Setup) qui installe Infer.NET et construit le premier modèle bayésien — le classique “Two Coins” — en quelques lignes de C#. Le notebook 2 (Gaussian Mixtures) plonge dans les distributions continues avec les mélanges gaussiens, outil fondamental du clustering. Le notebook 3 (Factor Graphs) introduit la représentation graphique qui unifie tous les modèles : les graphs de facteurs, illustres par le problème de Monty Hall. À l’issue de cette phase, vous comprenez comment exprimer un problème incertain en termes de variables, de facteurs et de messages.
Phase 2 : Modèles classiques (Notebooks 4-13, ~8h)
Les notebooks 4 à 13 construisent des modèles de complexité croissante, chacun illustré par une application concrète : réseaux bayésiens (4, diagnostic médical), inférence causale (5), Item Response Theory (7, évaluation de compétences), TrueSkill (8, classement Xbox Live), classification bayésienne (9), sélection de modèles (10, Bayes Factors), LDA (11, topic modeling), modèles hiérarchiques (12), crowdsourcing (13, agrégation de labels). Les notebooks 14 et 15 prolongent sur les séquences temporelles (HMM) et les systèmes de recommandation. Chaque notebook est autonome mais présuppose la maîtrise des concepts des notebooks 1-3. Le notebook Infer-2b (Debugging) est une référence pratique à consulter tout au long du parcours.
Au-delà du consensus par défaut : EP vs VMP, un cas bimodal discriminant (Infer-2)
Le notebook 2 (Gaussian Mixtures) utilise VariationalMessagePassing pour identifier un mélange bimodal de durées de trajets vélo. La cellule d’analyse (cell. 62) justifie ce choix en une phrase : « VMP est recommandé pour les modèles de mélange car il gère mieux les variables latentes discrètes » — affirmation jusqu’ici non démontrée par l’exécution. Le notebook Infer-2b (Debugging) mentionne EP et VMP côte à côte, mais comme outils de diagnostic, pas comme alternatives testées sur un même modèle.
#7590 fix(probas,#3801): demonstrate EP-vs-VMP algorithm comparison (Prong-B) (MERGED 2026-07-20) comble ce gap en ré-exécutant le même modèle de mélange (donneesMixtes, priorsMMixtes, CyclisteBaseMixte) avec deux moteurs Infer.NET interchangeables via MoteurInference.Algorithm. Résultat discriminant first-hand (cell. 64) :
| Algorithme | Comp. 1 (Ordinaire) | Comp. 2 (Extra) | Poids | P(ordinaire) |
|---|---|---|---|---|
| VMP (VariationalMessagePassing) | Gaussian(15.07, 0.87) | Gaussian(26.69, 1.15) | Dirichlet(7.995, 4.005) | 0.67 ✓ |
| EP (ExpectationPropagation) | Gaussian(26.23, 2.48) ← labels inversés | Gaussian(14.96, 1.18) | Dirichlet(3.887, 7.224) | 0.35 ← poids inversés |
EP converge sans diverger mais inverse à la fois l’assignation des composantes ET l’estimation des poids — faiblesse connue d’Expectation Propagation sur les variables latentes discrètes (le Variable.Switch qui route chaque observation vers sa composante casse l’approximation EP, qui approxime chaque facteur marginalement au lieu de factoriser la conjointe comme VMP).
Pourquoi cette section manquait avant : EPIC #3801 Prong-B (« problème non-trivial qui met le moteur en valeur ») — la même famille de moteurs message-passing déterministes était présentée par défaut (VMP), mais sans jamais démontrer explicitement sur un même cas la différence entre EP et VMP. La table « Quel stack choisir ? » (ci-dessus) rangeait Infer.NET sous l’étiquette « EP/VMP » comme un bloc monolithique, sans granularité algorithmique. #7590 rétablit cette granularité par l’exécution.
À retenir : - Choix d’algorithme ≠ détail d’implémentation. InferenceEngine.Algorithm est un choix de modèle : sur un mélange avec Variable.Switch, VMP factorise l’approximation (stable), EP approxime marginalement (peut inverser labels/poids). Quatre assertions « VMP > EP pour variables discrètes » qui flottaient dans la prose sont maintenant démontrées par le notebook exécuté. - EP n’est pas mort : il reste précieux quand le modèle n’a pas de variables latentes discrètes (cf. Infer-16 Sparse GP, où EP sur géométrie latente continue est discriminant contre NUTS > 15 min). Mais sur Switch → préférer VMP par défaut, documenter le choix. - Validation cross-engine : la cellule 64 montre aussi le pattern d’ingénierie — comment substituer l’algorithme sur un même modèle Infer.NET (créer le modèle, remplacer MoteurInference, ré-entraîner). C’est un geste reproductible pour tout notebook ultérieur qui voudra qualifier la sensibilité d’un posterior au choix de l’algorithme.
Phase 3 : Décision bayésienne (arc autonome, ~7h)
La seconde moitié passe de l’inférence à la décision : comment choisir une action quand on ne connaît que des probabilités ? Chez Infer.NET, cet arc a été extrait dans DecisionTheory/DecInfer/ (renumérotés 1-10, accretion Lean 2b) : les notebooks 1-4 posent les fondations (axiomes de l’utilité, fonctions mono- et multi-attributs), les notebooks 5-8 appliquent aux réseaux de décision, valeur de l’information, systèmes experts robustes et processus décisionnels de Markov (MDPs) — qui relient cette série à RL. Le compagnon DecInfer-08b (kernel Lean 4 via WSL) formalise les identités d’escompte géométrique de l’indice de Gittins dans le lake decision_theory_lean — descendu dans DecisionTheory/ auprès de ses consommateurs (décision #4362 — il reste visible des deux pistes via le README de la sous-série) ; le théorème d’optimalité y est énoncé, sa preuve complète exigeant une formalisation des MDP qui manque encore à Mathlib. Le notebook DecInfer-10 (Thompson Sampling) clôt l’arc sur les bandits bayésiens en pratique. Côté PyMC, le cœur de cet arc est reproduit dans DecisionTheory/DecPyMC/ (renumérotés, dont la jambe actuarielle 8-12).
Parcours alternatifs
Parcours inférence comparée (Infer.NET vs PyMC, ~15h)
Suivez le même modèle dans les deux stacks pour comparer les approches :
| Concept | Infer.NET | PyMC | Différence principale |
|---|---|---|---|
| Fondations | Infer-1 → 2 → 3 | PyMC-1 → 2 → 3 | Message passing déterministe (EP/VMP) vs échantillonnage NUTS — Infer-2 démontre la différence EP vs VMP sur le même modèle [#7590] |
| Réseaux bayésiens | Infer-4 | PyMC-4 | Compilation statique vs échantillonnage dynamique |
| IRT (compétences) | Infer-7 | PyMC-7 | Variable.If vs pm.Bernoulli |
| TrueSkill | Infer-8 | PyMC-8 | Message passing déterministe (EP) vs échantillonnage MCMC |
| Classification | Infer-9 | PyMC-9 | Bayes Point Machine vs régression logistique |
| Model sélection | Infer-10 | PyMC-10 | Bayes Factors vs LOO/Pareto-SMI |
| Topic modeling | Infer-11 | PyMC-11 | VMP vs NUTS sur variables latentes |
| Crowdsourcing | Infer-13 | PyMC-13 | Worker models EP vs MCMC agrégation |
| Séquences (HMM) | Infer-14 | PyMC-14 | Forward-backward exact (chaîne sans boucle) vs échantillonné |
| Recommenders | Infer-15 | PyMC-15 | Factorisation bayésienne statique vs MCMC |
| Debugging | Infer-2b | PyMC-02b | ShowFactorGraph vs trace plot diagnostics |
| Causal Inference | Infer-5 | PyMC-5 | do-calculus message passing vs pm.do MCMC |
| Modèles hiérarchiques | Infer-12 | PyMC-12 | Pooling partiel, shrinkage EP vs paramétrisation non-centrée NUTS (funnel) |
Parcours applications (modèles concrets, ~6h)
Si vous préférez commencer par les cas d’usage, suivez cet ordre :
- TrueSkill (Infer-8 / PyMC-8) : classement bayésien, application Xbox Live
- IRT (Infer-7 / PyMC-7) : évaluation de compétences, application GMAT
- Crowdsourcing (Infer-13 / PyMC-13) : agrégation de labels, application Mechanical Turk
- Recommenders (Infer-15 / PyMC-15) : factorisation matricielle bayésienne
- LDA (Infer-11 / PyMC-11) : découverte de thèmes dans des corpus textuels
- HMM (Infer-14 / PyMC-14) : régimes cachés en finance et traitement du signal
Parcours décision (théorie de la décision, ~7h)
Pour les étudiants en recherche opérationnelle ou finance :
- Foundations (DecInfer-01) : axiomes VNM, loteries, théorème de représentation
- Utilité espérée en Lean (DecInfer-02) : le théorème de représentation vNM formalisé (kernel Lean 4)
- Money & risk (DecInfer-03) : CARA, CRRA, paradoxe Saint-Petersbourg
- Multi-attribute (DecInfer-04) : MAUT, SMART, décider avec plusieurs critères
- Networks (DecInfer-05) : diagrammes d’influence, politiques optimales
- Value of information (DecInfer-06) : EVPI, EVSI — quand un test est-il rentable ?
- Expert systems (DecInfer-07) : Minimax, Minimax Regret, robustesse
- Sequential (DecInfer-08) : MDPs, bandits, POMDPs — passerelle vers le RL
- Gittins en Lean (DecInfer-08b) : identités d’escompte démontrées (
0 sorry), théorème d’optimalité énoncé — pont vers SymbolicAI/Lean - Thompson Sampling (DecInfer-10) : bandits bayésiens en pratique, regret cumulé
Parcours rapide Python (standalone, ~2h)
Si vous préférez Python au C#, commencez par PyMC-01-Setup (introduction standalone en Python, premier modèle Two Coins) puis Pyro_RSA_Hyperbole.ipynb (application à la linguistique pragmatique avec le framework RSA). En C#/.NET, l’introduction est Infer-1b (Infer/Infer-1b-Premiers-Modeles.ipynb), le premier modèle avec les fondations de Infer/.
Parcours PyMC complet (~21h)
Les notebooks PyMC portent les modèles Infer.NET en Python avec PyMC et l’échantillonnage NUTS : le corpus bayésien dans PyMC/, numéroté 1:1 avec son jumeau Infer — à une asymétrie près : l’ex-Infer-20 (devenu Quotients-Fibres-Recollement) n’a pas de jumeau PyMC (le debugging vit en accrétion 2b des deux côtés) — (fondations 1-3 ; modèles classiques 4-13 dont l’inférence causale en 5 et les modèles hiérarchiques en 12 ; séquences 14, recommandation 15 et frontières 16-19 : processus gaussien épars, filtre de Kalman, change-point, analyse de survie), et le cœur de l’arc décision dans DecisionTheory/DecPyMC/ (socle 1-7 + capstone 08 ; l’arc actuariel T1-T5 vit dans DecisionTheory/Actuariat/). Ils constituent un excellent complément pour comparer les approches d’inférence (message passing vs MCMC) et rejoindre l’écosystème Python data science. La progression suit la même structure pédagogique en 3 phases que la série Infer.NET.
Quel stack choisir ?
flowchart TD
    START(["Votre profil ?"])
    START --> Q1{"Vous venez du<br/>C# / .NET ?"}
    START --> Q2{"Vous venez du<br/>Python / data science ?"}
    START --> Q3{"Indécis ?<br/>Découverte rapide"}
    Q1 -->|"oui"| INFER["<b>Infer.NET</b><br/>API C# native · Roslyn ·<br/>factor graphs · message passing<br/>déterministe (EP/VMP/Gibbs)"]
    Q2 -->|"oui"| PYMC["<b>PyMC</b><br/>with pm.Model() · NUTS ·<br/>écosystème pandas/arviz"]
    Q3 --> IN101["<b>Infer-1b</b><br/>(premier modèle, 1h)"]
    INFER --> PIVOT1{"Modèle trop complexe<br/>ou pipeline Python ?"}
    PYMC --> PIVOT2{"Besoin de message passing<br/>déterministe (VMP/EP) ou .NET ?"}
    PIVOT1 -->|"oui"| PYMC
    PIVOT2 -->|"oui"| INFER
    %% color: explicite -- sans lui, libelle clair sur fond clair en mode sombre GitHub (#15022) ; ton parfois plus fonce que le stroke (le stroke en couleur de texte rendrait infer illisible) : ne pas harmoniser
    classDef infer fill:#d4edda,stroke:#28a745,stroke-width:2px,color:#155724;
    classDef pymc fill:#cce5ff,stroke:#004085,stroke-width:2px,color:#004085;
    classDef entry fill:#fff3cd,stroke:#856404,stroke-width:2px,color:#856404;
    class INFER infer;
    class PYMC pymc;
    class IN101 entry;
Deux stacks, un même parcours de 20 modèles : Infer.NET (C#, message passing, déterministe) et PyMC (Python, MCMC, flexible). L’arbre ci-dessus donne le point d’entrée selon votre profil — et le pont de bascule vers l’autre stack quand le modèle ou l’environnement l’exige. Le détail comparatif notebook-par-notebook figure dans le Parcours inférence comparée ci-dessous.
Si vous venez du C# / .NET
Commencez par Infer.NET. L’API est native C# (Variable.GaussianFromMeanAndVariance), le compilateur Roslyn intègre au .NET Interactive gère la compilation dynamique, et la visualisation des graphes de facteurs via FactorGraphHelper offre une compréhension intuitive de la structure du modèle. C’est le choix idéal pour comprendre le message passing déterministe (EP/VMP) et la structure des graphes de facteurs.
Passez à PyMC quand : vous avez un modèle trop complexe pour Infer.NET (variables latentes discrètes à grande taille), ou vous voulez intégrer le modèle dans un pipeline Python (pandas, scikit-learn, visualisation).
Si vous venez du Python / data science
Commencez par PyMC. La syntaxe with pm.Model(): ... est plus familière aux data scientists, l’échantillonnage NUTS gère automatiquement les géométries complexes du posterior, et l’écosystème (arviz, pandas, matplotlib) est naturel.
Passez à Infer.NET quand : vous voulez comprendre le message passing déterministe (VMP/EP), qui donne des résultats reproductibles et rapides sans échantillonnage, ou vous êtes dans un environnement .NET. La visualisation du factor graph (FactorGraphHelper) est aussi un outil pédagogique unique pour comprendre les dépendances du modèle.
Si vous ne savez pas quoi choisir
| Critère | Recommandation |
|---|---|
| Juste découvrir la programmation probabiliste | Infer-1b (Infer/Infer-1b-Premiers-Modeles.ipynb) |
| Comprendre les graphes de facteurs | Infer-3 (Monty Hall, Murder Mystery) |
| Un premier modèle qui marche | Infer-1b ou PyMC-01-Setup |
| Application concrète rapide | Infer-8 TrueSkill ou Infer-11 LDA |
| Comparer les deux approches | Suivre la table “inférence comparée” ci-dessus |
| Production data science | PyMC (écosystème Python, NUTS, arviz) |
| Apprentissage embarqué / temps réel | Infer.NET (compilation statique = inférence rapide) |
Structure
Probas/
├── Applications/                # Applications standalone
│   ├── Quotients-Fibres-Recollement-Python.ipynb # Géométrie catégorique (kernel Python, ex-Infer-20)
│   ├── Percolation/             # Simulation supercritique (Python) + compagnon Lean 4 (lake percolation_lean)
│   └── Pyro_RSA_Hyperbole.ipynb # Pragmatique linguistique (Python)
├── PyMC/                # Port PyMC : bayésien + causal (1-13, dont PyMC-5 causal) + séquences/reco et frontières (14-19)
│   ├── PyMC-01-Setup.ipynb ... PyMC-19-Survival-Analysis.ipynb
│   └── README.md                # Documentation détaillée de la série PyMC
├── Infer/                       # Corpus bayésien : socle 1-19 sans le 6, accretions 1b/2b/8b
│   ├── Infer-1-Setup.ipynb ... Infer-19-Survival-Analysis.ipynb
│   ├── Infer-1b-Premiers-Modeles.ipynb  # Accretion du premier modèle (ex-Infer-101)
│   ├── Infer-08b-TrueSkill-Formules-Fermees-CSharp.ipynb # Accretion TrueSkill : mise à jour closed-form O(1) (V(t)/W(t))
│   ├── README.md                # Documentation détaillée de la série bayésienne
│   ├── Infer-Glossary.md        # Glossaire des termes Infer.NET
│   ├── FactorGraphHelper.cs     # Helper visualisation graphes de facteurs
│   ├── SvgChartHelper.cs        # Helper rendu SVG des modèles
│   └── scripts/                 # test_notebooks.py + setup_environment.ps1
└── DecisionTheory/              # Arc théorie de la décision : Infer.NET + PyMC (miroirs) + pont causal
    ├── DecInfer/                # DecInfer-01-Utility-Foundations ... DecInfer-10-Thompson-Sampling (+ companions Lean 02/02b/08b)
    ├── DecPyMC/                 # DecPyMC-1-Utility-Foundations ... DecPyMC-7-Sequential + DecPyMC-08-Actuariat-Capstone (escalier vers Actuariat/)
    ├── Actuariat/               # Sous-série actuarielle T1-T5 : Actuariat-01 ... Actuariat-05 (ex-DecPyMC-8..12, descente #14873)
    ├── decision_theory_lean/    # Projet Lake descendu auprès de ses consommateurs (#4362) : escompte géométrique + théorème de Gittins ; héberge les preuves VNM et Coherence/Dutch Book
    ├── Causal-Bridges/          # CausalBridges-01..08 : pont causal unifié (Pearl, dowhy), jusqu'à l'équité causale (08)
    └── voi/                     # Harnais VoI cross-engine Infer.NET x PyMC (contrat JSON commun, #13682) — hors compte notebooks
Ce que chaque notebook apporte
Chaque notebook introduit un concept ou modèle spécifique. Le tableau ci-dessous résume en une ligne l’apport pédagogique de chacun — au-delà du titre, c’est le concept clé qu’il enseigne.
Série Infer.NET
| # | Notebook | Apport pédagogique |
|---|---|---|
| 1 | Setup | Boucle fondamentale : définition du modèle → création du moteur → inférence |
| 2 | Gaussian Mixtures | Distributions continues, mélanges gaussiens, estimation de params — + comparaison EP vs VMP sur bimodal [#7590] |
| 2b | Debugging-Bonnes-Pratiques | EP vs VMP, diagnostic de divergence, ShowFactorGraph, ShowSchedule |
| 3 | Factor Graphs | Monty Hall + Murder Mystery : inférence discrète, Variable.If/Case |
| 4 | Bayesian Networks | Wet Grass, CPT, D-separation, explaining away, inférence causale |
| 5 | Causal Inference | do-calculus de Pearl, backdoor/front-door, paradoxe de Simpson |
| 7 | Skills (IRT) | Modélisation de compétences (DINA), évaluation adaptative |
| 8 | TrueSkill | Ranking bayésien, online learning, rating conservatif (mu - 3*sigma) |
| 8b | TrueSkill-Formules-Fermees | Mise à jour closed-form O(1) par match (V(t)/W(t), Herbrich-Minka-Graepel), cohérence exacte vérifiée contre le moteur EP |
| 9 | Classification | Bayes Point Machine, classification probit, tests A/B bayésiens |
| 10 | Model Sélection | Bayes Factors, evidence marginale, ARD (Automatic Relevance Détermination) |
| 11 | Topic Models | LDA, Dirichlet, prior asymétrique pour briser la symétrie VMP |
| 12 | Modèles Hiérarchiques | Partial pooling, shrinkage, paramétrisation non-centrée |
| 13 | Crowdsourcing | Worker models, communautés d’annotateurs, aggregation de labels |
| 14 | Séquences | HMM, detection de régimes, forward-backward, motifs temporels |
| 15 | Recommenders | Factorisation matricielle bayésienne, Click Model |
| 16 | Sparse Gaussian Process | EP sur géométrie latente GP, comparaison NUTS > 15min |
| 17 | Kalman Filter | Système dynamique linéaire gaussien, filtrage fermé |
| 18 | Change-Point | DiscreteUniform + switch, détection de rupture bayésienne |
| 19 | Survival Analysis | Exponentiel conjugué (Gamma), Weibull k inféré, sélection LOO |
Note : l’arc théorie de la décision vit désormais dans
DecisionTheory/DecInfer/(renumérotation 1-10), voir tableau dédié ci-dessous.
Série PyMC
| # | Notebook | Apport pédagogique |
|---|---|---|
| 1 | Setup | Boucle PyMC : pm.Model() → pm.sample(NUTS) → arviz |
| 2 | Gaussian Mixtures | Mélanges gaussiens MCMC, trace plots, convergence diagnostics |
| 3 | Factor Graphs | Inférence discrète avec PyMC, comparaison Infer.NET vs PyMC |
| 4 | Bayesian Networks | Réseaux bayésiens MCMC, CPT, explaining away |
| 5 | Causal Inference | pm.do, do-calculus de Pearl, contrefactuel bayésien |
| 6 | Debugging | Trace plots, R-hat, effective sample size, bonnes pratiques MCMC |
| 7 | Skills (IRT) | IRT en Python, estimation de compétences par MCMC |
| 8 | TrueSkill | TrueSkill avec NUTS, online learning bayésien |
| 9 | Classification | Classification bayésienne, régression logistique |
| 10 | Model Sélection | Model comparison MCMC, LOO, WAIC, Bayes Factors empiriques |
| 11 | Topic Models | LDA avec NUTS, gestion variables latentes, inférence approximation |
| 12 | Modèles Hiérarchiques | Shrinkage bayésien, divergences NUTS sur le funnel (cf. asymétrie structurelle Infer-12 EP) |
| 13 | Crowdsourcing | Agrégation de labels crowdsourcing, worker communities |
| 14 | Séquences | HMM MCMC, forward-backward avec échantillonnage |
| 15 | Recommenders | Factorisation matricielle bayésienne MCMC |
| 16 | Sparse Gaussian Process | NUTS sur géométrie latente (cf. asymétrie structurelle Infer-16 EP) |
| 17 | Kalman Filter | Value-add MCMC (estimation jointe Q/R/drift) |
| 18 | Change-Point | Switch bayésien, catastrophes minières (Poisson) |
| 19 | Survival Analysis | Weibull inféré directement, sélection LOO arviZ |
Note : l’arc théorie de la décision PyMC (socle 1-7 + capstone 08) vit dans
DecisionTheory/DecPyMC/(socleDecPyMC-1..7+ capstoneDecPyMC-08; l’ancienne jambe actuarielle 8-12 vit dansDecisionTheory/Actuariat/, T1-T5), voir tableau dédié ci-dessous.
Série Infer.NET (corpus bayésien + accretions 1b/2b · arc décision C# et companions Lean 4)
La série C#/.NET se scinde en deux arcs : le corpus bayésien (socle numéroté 1-19 plus les accretions 1b et 2b dans Infer/, et l’application autonome Quotients, fibres et recollement dans Applications/) et l’arc théorie de la décision (DecisionTheory/DecInfer/) qui mixe deux kernels — des notebooks C# (utilité espérée, EVPI, MDPs, bandits, Thompson Sampling DecInfer-10) et des notebooks Lean 4 (DecInfer-02 utilité espérée vNM, DecInfer-02b cohérence de de Finetti et DecInfer-08b indice de Gittins, formalisation des lemmes). L’ensemble DecisionTheory/ réunit les DecInfer (arc C# et companions Lean), leurs miroirs Python DecisionTheory/DecPyMC/, et les notebooks du pont causal DecisionTheory/Causal-Bridges/ — plus le lake compagnon Lean decision_theory_lean et le harnais VoI cross-engine DecisionTheory/voi/ (tous deux hors compte notebooks). La documentation détaillée de chaque notebook, les patterns Infer.NET avancés et les exercices corrigés vivent dans ces README.
Progression
| Partie | Notebooks | Focus | Durée |
|---|---|---|---|
| Fondations | 1-3 | Setup, distributions, factor graphs | 2h |
| Modèles classiques | 4-13 | Bayesian networks, IRT, TrueSkill, LDA, HMM | 8h |
| Frontières bayésiennes | 14-19 | Séquences (HMM), recommandation, GP sparse, filtre de Kalman, change-point, survie | 4,5h |
| Géométrie catégorique | Applications/ (ex-20) | Quotients, fibres, recollement — ce qui survit à la projection | — |
| Accretions | 1b, 2b, 8b | Premier modèle ; debugging, bonnes pratiques ; TrueSkill formules fermées | ~3h35 |
| Décision (arc autonome) | DecisionTheory/DecInfer/ 1-10 + accretion 2b | Théorie de la décision bayésienne + preuves Lean (vNM, de Finetti, Gittins) | 7h |
Les notebooks Infer.NET C# (corpus bayésien et accretions + arc décision) et les notebooks Lean 4 de l’arc décision sont détaillés individuellement dans Ce que chaque notebook apporte ci-dessous (apport pédagogique par notebook) ; le contenu exhaustif — patterns avancés, exercices corrigés — vit dans Infer/README.md, DecisionTheory/DecInfer/README.md et DecisionTheory/DecPyMC/README.md.
Série PyMC (19 corpus notebooks, Python + les notebooks décision DecisionTheory — socle DecPyMC et sa sous-série Actuariat)
Port Python des modèles Infer.NET, utilisant l’échantillonnage MCMC (NUTS) au lieu du message passing. Permet de comparer les deux approches d’inférence sur des modèles identiques. La série PyMC/ suit la même numérotation que la série Infer (le numéro 6 n’existe pas — le debugging vit en accrétion PyMC-02b jumelle de Infer-2b ; l’ex-Infer-20 (quotients et fibres), kernel Python autonome désormais dans Applications/, n’a pas de jumeau) — fondations 1-3, modèles classiques 4-13 (réseaux bayésiens, inférence causale, IRT, TrueSkill, classification, sélection de modèles, topic models, modèles hiérarchiques, crowdsourcing), puis frontières 14-19 (séquences/HMM, recommandation, processus gaussien épars, filtre de Kalman, change-point, analyse de survie) ; l’apport pédagogique de chacun est détaillé dans le tableau de la série PyMC ci-dessus. Le cœur de l’arc décision vit dans DecisionTheory/DecPyMC/ (socle 1-7 + capstone 08 ; l’arc actuariel T1-T5 vit dans DecisionTheory/Actuariat/).
Phase 1 — Fondations (notebooks 1-3, ~2h)
| # | Notebook | Sujet |
|---|---|---|
| 1 | PyMC-01-Setup | Configuration PyMC, modèle Beta-Bernoulli, diagnostic de convergence (r_hat, ESS, divergences) |
| 2 | PyMC-02-Gaussian-Mixtures | Distributions continues, mélanges gaussiens |
| 3 | PyMC-03-Factor-Graphs | Graphes de facteurs, inférence discrète |
Phase 2 — Modèles classiques (notebooks 4-13, ~9h)
| # | Notebook | Sujet |
|---|---|---|
| 4 | PyMC-04-Bayesian-Networks | Réseaux bayésiens, CPTs |
| 2b | PyMC-02b-Debugging-Python | Troubleshooting MCMC, diagnostics NUTS, bonnes pratiques |
| 7 | PyMC-07-Skills-IRT | Item Response Theory, modèles de compétences |
| 8 | PyMC-08-TrueSkill | Classement, TrueSkill |
| 9 | PyMC-09-Classification | Classification bayésienne, calibration mesurée |
| 10 | PyMC-10-Model-Selection | Sélection de modèles, Bayes Factors |
| 11 | PyMC-11-Topic-Models | LDA, Dirichlet priors |
| 12 | PyMC-12-Modeles-Hierarchiques | Partial pooling bayésien, shrinkage, paramétrisation non-centrée, divergences NUTS comme diagnostic du funnel |
| 13 | PyMC-13-Crowdsourcing | Agrégation de labels, workers, communautés |
Phase 3 — Théorie de la décision (sous-séries DecisionTheory/DecPyMC/ + Actuariat/, ~6h + ~4h)
Les notebooks décisionnels ont été extraits vers une sous-série autonome : DecisionTheory/DecPyMC/ (socle 1 à 7 + capstone 08), miroir Python de DecisionTheory/DecInfer/. L’ancienne jambe actuarielle (8-12) descend en sous-série dédiée DecisionTheory/Actuariat/ — le passage de la décision bayésienne au métier de l’assurance (prime pure, fréquence × sévérité, crédibilité, ruine, valeur de l’information en souscription), régraduée T1-T5.
| # | Notebook | Sujet |
|---|---|---|
| 1 | DecPyMC-1-Utility-Foundations | Loteries, axiomes Von Neumann-Morgenstern, utilité espérée |
| 2 | DecPyMC-2-Utility-Money | Aversion au risque, CARA, CRRA, paradoxe Saint-Petersbourg |
| 3 | DecPyMC-3-Multi-Attribute | MAUT, SMART, swing weights, décisions multi-critères |
| 4 | DecPyMC-4-Decision-Networks | Réseaux de décision, diagrammes d’influence, politique optimale |
| 5 | DecPyMC-5-Value-Information | EVPI, EVSI, valeur de l’information parfaite et d’échantillon |
| 6 | DecPyMC-6-Expert-Systems | Systèmes experts, Minimax, Minimax Regret, décisions robustes |
| 7 | DecPyMC-7-Sequential | MDPs, itération de valeur/politique, bandits, POMDPs |
| 8 | DecPyMC-08-Actuariat-Capstone | Capstone : l’escalier vers la sous-série Actuariat (T1-T5) |
| — | Sous-série Actuariat T1-T5 | Prime pure et chargement · fréquence × sévérité · crédibilité · ruine · valeur de l’information en souscription |
Phase 4 — Inférence causale (notebook 5, ~1h)
| # | Notebook | Sujet |
|---|---|---|
| 5 | PyMC-05-Causal-Inference | do-calculus de Pearl, pm.do, backdoor/front-door, paradoxe de Simpson, contrefactuel |
Phase 5 — Séquences et frontières bayésiennes (notebooks 14-19, ~3.5h)
Ports Python des séquences et frontières bayésiennes de la série Infer (séquences 14, recommandation 15, GP sparse 16, filtre de Kalman 17, change-point 18, analyse de survie 19 ; les modèles hiérarchiques 12 sont classés en Phase 2 avec les modèles classiques). Le notebook PyMC-16 (processus gaussiens) tourne en
> 15 minsur la géométrie latente — asymétrie structurelle assumée avec l’EP rapide d’Infer.NET (cf. PyMC/README.md).
| # | Notebook | Sujet |
|---|---|---|
| 14 | PyMC-14-Sequences | HMM MCMC, forward-backward avec échantillonnage |
| 15 | PyMC-15-Recommenders | Systèmes de recommandation bayésiens, factorisation matricielle MCMC |
| 16 | PyMC-16-Sparse-Gaussian-Process | Processus gaussien épars, NUTS sur inducing points, asymétrie structurelle avec Infer-16 EP |
| 17 | PyMC-17-Kalman-Filter | Système dynamique linéaire gaussien, récursion de filtrage fermée, value-add MCMC (estimation jointe Q/R/drift) |
| 18 | PyMC-18-Change-Point | Change-point bayésien, DiscreteUniform + switch, catastrophes minières (Poisson), entropie |
| 19 | PyMC-19-Survival-Analysis | Analyse de survie, exponentiel conjugué (Gamma), forme Weibull k inférée directement (NUTS), sélection LOO (arviZ), censure à droite exécutée (naïf vs S(c_i) vs Kaplan–Meier) |
Pont causal — les quatre séries causales réunies
La causalité est traitée à quatre endroits du dépôt, chacun avec son moteur et son angle propre. Le pont causal DecisionTheory/Causal-Bridges/ — notebooks Python — fournit l’armature formelle commune : l’échelle de Pearl (observation / intervention / contrefactuel), les trois règles du do-calculus et les méthodes quasi-expérimentales, exécutées sur l’outil de référence dowhy (installé et lancé réellement, pas de réimplémentation jouet) avant de renvoyer à chaque série pour l’instanciation par son moteur :
| Notebook | Durée | Ce qu’il couvre |
|---|---|---|
| CausalBridges-01 — Do-Calculus | ~55 min | Échelle de Pearl, trois règles du do-calculus, critères backdoor / front-door exécutés avec dowhy, Pearl (intervention) vs Hoel (émergence causale) |
| CausalBridges-02 — Exiger un estimand | ~45 min | Identification causale nommée via dowhy (backdoor, front-door, instrumentale) sur un cas complet ; sensibilité au graphe mesurée quand une hypothèse saute |
| CausalBridges-03 — Le contrefactuel individuel | ~40 min | Troisième échelon de Pearl : dowhy.gcm (abduction-action-prédiction) sur un individu ; l’effet moyen nul cache une CATE linéaire ; fragilité du chiffre individuel à la spécification du mécanisme |
| CausalBridges-04 — Le graphe qu’on n’a pas | ~45 min | Découverte de structure via causal-learn (PC, GES, LiNGAM) : classes d’équivalence de Markov, verdict CPDAG ambigu = résultat ; l’ambiguïté se propage à l’estimand (3 extensions du même CPDAG → 3 estimands dowhy) |
| CausalBridges-05 — Le confondeur non observé | ~50 min | Sensibilité, pas certitude : robustness value de Cinelli-Hazlett (linear-partial-R2), E-value natif dowhy, bornes de Rosenbaum exactes (Γ*), courbe de bascule du confondeur simulé |
| CausalBridges-06 — L’instrument faible | ~45 min | Variable instrumentale via dowhy (pipeline identify + estimate(iv) + refute) ; F-stat Staiger-Stock, biais IV vs OLS en Monte-Carlo, verdict NON_IDENTIFIABLE honnête sur exclusion violée |
| CausalBridges-07 — Quasi-Experimental | ~50 min | Méthodes quasi-expérimentales (DiD, contrôle synthétique, RDD, variables instrumentales) sur données réalistes ; estimands et hypothèses d’identification explicités |
| CausalBridges-08 — Décomposer la discrimination | ~50 min | Équité causale : critères structurels Str-DE/IE/SE, famille TV (TE, Exp-SE, NDE, NIE) — Lem 4.1 et Thm 4.2 vérifiés avec dowhy sur données de crédit |
| Série | Moteur | Angle causal |
|---|---|---|
| Tweety-11-Causal | Tweety (.NET, logique) | modèle causal structurel, opérateur do, contrefactuels |
| Infer-5-Causal-Inference | Infer.NET (message passing) | backdoor, front-door, paradoxe de Simpson, médiation |
| PyMC-05-Causal-Inference | PyMC (MCMC) | backdoor, front-door, contrefactuel bayésien |
| ICT-5 · ICT-6 | PyPhi (CE 2.0) | émergence causale, information effective de Hoel |
Ce que le pont ajoute par rapport aux quatre notebooks pris isolément :
- la théorie unifiée du do-calculus posée une bonne fois — l’échelle de Pearl et les trois règles, lues comme des chirurgies du graphe suivies d’un test de d-séparation, vérifiées sur
dowhyà effet connu ; - le pipeline complet d’une vraie étude causale :
dowhyidentifie l’estimande (backdoor / front-door / variable instrumentale), l’estime puis le réfute — là où Infer-5 et PyMC-5 instrumentent ledoà la main sur leur moteur,dowhyautomatise l’identification ; - la distinction explicite entre causalité interventionniste (Pearl : quel est l’effet d’une intervention sur
Xdans un graphe fixé ?) et émergence causale (Hoel : quelle échelle de description porte le plus de causalité ?) — deux réponses complémentaires à la question causale.
Applications standalone (dossier Applications/)
Les applications autonomes sont aujourd’hui toutes en kernel Python ; si un notebook .NET rejoint Applications/, la section se scinde par technologie (une sous-section par kernel), sur le modèle de la division théorie de la décision.
| Notebook | Kernel | Contenu | Durée |
|---|---|---|---|
| Pyro_RSA_Hyperbole | Python 3 | Rational Speech Acts, hyperboles | 30 min |
| Quotients-Fibres-Recollement-Python | Python 3 | Quotients, fibres et recollement : ce qui survit à la projection | 30 min |
Pyro_RSA_Hyperbole.ipynb
Application avancée à la linguistique pragmatique : - Framework RSA (Rational Speech Acts) - Implicatures scalaires (none/some/all) - Modélisation des hyperboles (prix, excitation) - Question Under Discussion (QUD)
L’entrée du corpus bayésien C#, Infer-1b (accrétion du premier modèle), vit dans Infer/ et y est documentée.
Quotients-Fibres-Recollement-Python.ipynb
Protocole de représentation — et non d’inférence : deux observations d’un même phénomène latent, comparées autrement que par « laquelle est la plus proche de la vérité ». Quatre temps (deux représentations, mesures d’information commune sur l’intersection, quotient Q, fibres), le temps 4 n’étant atteint que si le temps 3 a produit un quotient opérationnel :
- Information conditionnelle mesurée pour de vrai : KL discrète (
scipy.special.rel_entr) et entropies de Shannon, graine fixée, sans Infer.NET (le sujet sort de la famille inférentielle stricte) ; - Garde-fou Ruzsa et critère d’acceptation hérité de de Finetti : un quotient décoratif ne passe pas ;
- 2 exercices vérifiables — vos deux représentations et leur information commune ; raffiner le quotient et démasquer un quotient déguisé ;
- Ex-20 du corpus
Infer/, désormais application autonome : kernel Python propre, dossier d’accueilApplications/.
Percolation (sous-dossier Applications/Percolation/)
Duo simulation + formalisation autour de la percolation de liens sur tore fini (Diskin–Easo–Radhakrishnan–Sudakov–Tassion, arXiv:2603.03257) : Percolation-Supercritique (Python, trois régimes mesurés) et Percolation-Lean (Lean 4, compagnon exécutable du lake percolation_lean, noyau fini prouvé sans sorry) — voir Applications/Percolation/README.md et #14871.
Prerequisites
Niveau mathématique attendu
Cette série suppose une maîtrise de base en probabilités et statistiques :
| Concept | Utilité dans la série | Notes de révision |
|---|---|---|
| Variables aléatoires (discrètes/continues) | Partout, notebook 1+ | Loi de proba, espérance, variance |
| Distributions usuelles (Bernoulli, Gaussian, Beta, Gamma) | Notebook 1 (Beta-Bernoulli), 2 (Gaussian) | Paramètres, formes, conjugaison |
| Probabilités conditionnelles | Notebook 3+ (Variable.If, CPT) | P(A|B), théorème de Bayes |
| Indépendance conditionnelle | Notebook 3 (Monty Hall), 4 (D-separation) | Collider, explaining away |
| Espérance mathématique | Partout (calcul de EU) | E[X] = sum x*P(x) ou intégrale |
| Distributions conjuguées | Notebook 1 (Beta-Bernoulli), topic models 11 (Dirichlet) | Prior + likelihood = posterior (famille même) |
| Intégrales (niveau 1) | Notebook 2 ; arc décision (DecInfer-03, CARA/CRRA) | Calcul d’espérance avec fonctions non-linéaires |
Inutile de maîtriser : dérivation multivariée, algèbre linéaire avancée (sauf pour les modèles hiérarchiques en notebook 12). Les concepts sont introduits progressivement et réexpliqués dans le contexte.
Prerequisites techniques
Pour Infer.NET (C#)
# .NET SDK 9.0+
dotnet --version

# VS Code + extension Polyglot Notebooks
# Packages (auto-references dans notebooks):
# - Microsoft.ML.Probabilistic
# - CompilerChoice = Roslyn
Pour Python
# Environnement Python 3.10+
pip install pyro-ppl torch matplotlib numpy
Installation
Notebooks PyMC (Python)
Python 3.12 ou plus récent est requis : les notebooks suivent l’API de PyMC 6 et d’ArviZ 1.x, que pip n’installe pas sur une version antérieure.
pip install "pymc>=6" "arviz>=1" numpy scipy matplotlibNotebooks Infer.NET (C# .NET Interactive)
# 1. Installer .NET SDK 9.0+ depuis https://dotnet.microsoft.com/download
# 2. Installer le kernel dotnet-interactive
dotnet tool install -g Microsoft.dotnet-interactive
dotnet interactive jupyter install

# 3. Ou utiliser le script PowerShell (installe tout automatiquement) :
cd MyIA.AI.Notebooks/Probas/Infer/scripts
.\setup_environment.ps1
Notebooks Python (Pyro_RSA)
pip install pyro-ppl torch matplotlib numpyVérification
jupyter kernelspec list # doit afficher .net-csharp et python3Tester tous les notebooks
python MyIA.AI.Notebooks/Probas/Infer/scripts/test_notebooks.py --validate-onlyConcepts clés
| Concept | Description |
|---|---|
| Inférence bayésienne | Mise à jour de croyances avec des observations |
| Prior / Posterior | Distribution avant/après observations |
| Factor Graph | Représentation graphique de distributions jointes |
| Message Passing | Algorithmes EP (Expectation Propagation), VMP — voir comparaison EP vs VMP sur Infer-2 [#7590] |
| MCMC / NUTS | Échantillonnage pour modèles complexes (PyMC) |
| D-separation | Critère graphique d’indépendance conditionnelle |
| Explaining Away | Causes alternatives deviennent moins probables |
| Decision Theory | Maximisation d’utilité espérée |
| Valeur de l’information | EVPI, EVSI — coût d’un test complémentaire |
Domaines d’application
| Domaine | Notebooks |
|---|---|
| Jeux vidéo | Infer-8, PyMC-8 (TrueSkill) |
| Éducation | Infer-7, PyMC-7 (IRT) |
| NLP | Infer-11, PyMC-11 (LDA) |
| Médecine | Infer-4, Infer-5, Infer-17, Infer-18, Infer-19 (réseaux bayésiens, inférence causale, Kalman, change-point, survie) |
| Finance | Infer-14 (HMM régimes), DecInfer-03 (CARA/CRRA), DecInfer-08 (MDPs) |
| E-commerce | Infer-13, Infer-15, PyMC-13, PyMC-15 (crowdsourcing, recommenders) |
Exemples concrets
Derrière chaque modèle de la série se cache un système réel déjà en production :
- TrueSkill (notebook 8) est l’algorithme que Microsoft utilise pour apparier des millions de joueurs sur Xbox Live : il maintient pour chaque joueur une compétence gaussienne (moyenne + incertitude) mise à jour après chaque partie, généralisant l’Elo des échecs aux jeux en équipe.
- Item Response Theory (notebook 7) est le moteur des tests adaptatifs comme le GMAT ou le GRE : la difficulté de chaque question est calibrée probabilistiquement, et le test s’ajuste en temps réel au niveau estimé du candidat.
- Les réseaux bayésiens (notebook 4) fondent les systèmes d’aide au diagnostic médical (de QMR-DT aux outils modernes) et le filtrage anti-spam : ils propagent l’incertitude entre symptômes, causes et observations.
- LDA / topic models (notebook 11) structurent automatiquement de grands corpus — découverte de thématiques dans des archives de presse, cartographie de la littérature scientifique, analyse de tickets support.
- Les HMM (notebook 14) détectent les régimes cachés : phases de marche en finance, reconnaissance de la parole, segmentation de séquences biologiques.
- Les systèmes de recommandation bayésiens (notebook 15) sont la version « avec barre d’incertitude » du collaborative filtering de Netflix ou Amazon — utile pour décider quand explorer un nouvel item plutôt que d’exploiter une préférence connue.
- Le crowdsourcing (notebook 13) modélise la fiabilité de chaque annotateur (Mechanical Turk, labellisation de datasets) pour reconstruire la vérité terrain malgré des votes bruités.
- La théorie de la décision et les MDPs (arc
DecisionTheory/) relient la série au contrôle séquentiel : gestion de stocks, maintenance prédictive, et passerelle directe vers le reinforcement learning.
FAQ / Troubleshooting
Le kernel .NET Interactive n’apparait pas dans Jupyter
- Vérifiez que
dotnet interactive jupyter installa réussi (sortie :Kernel installed). - Redémarrez Jupyter. Si le kernel persiste à ne pas apparaître, vérifiez que .NET SDK 9.0+ est installé :
dotnet --version. - Sur Windows, les notebooks Infer.NET doivent être ouverts avec l’extension Polyglot Notebooks dans VS Code ou jupyterlab.
CompilerChoice.Roslyn obligatoire
Tous les notebooks Infer.NET utilisent moteur.Compiler.CompilerChoice = CompilerChoice.Roslyn. C’est obligatoire dans .NET Interactive car Infer.NET compile dynamiquement le modèle en code C#. Sans Roslyn, la compilation échoue. Ce pattern est présenté dans chaque notebook de la série (section 1 “Configuration”).
PyMC ne s’installe pas sur Windows (compilateur C manque)
PyMC nécessite un compilateur C pour certaines dépendances. Sur Windows : - Installez Microsoft Visual C++ Build Tools (la version “Build Tools” suffit, pas besoin de Visual Studio complet). - Ou utilisez un environnement conda : conda install -c conda-forge pymc. - Ou utilisez un conteneur Docker avec une image préconfigurée.
Erreur Graphviz / FactorGraphHelper
La visualisation des factor graphs nécessite Graphviz installé. Si dot n’est pas trouvé : - Les fichiers .gv sont sauvegardés dans le répertoire courant. - Vous pouvez les visualiser sur viz-js.com ou edotor.net. - Installation Graphviz Windows : télécharger depuis https://graphviz.org/download/, puis ajouter C:\Program Files\Graphviz\bin au PATH.
Kernels : un par sous-série, jamais mélangés
Chaque notebook de la série Probas utilise un unique kernel : .NET (C#) pour le corpus Infer/ et l’arc DecisionTheory/DecInfer/ (arc C#) ; Python 3 pour PyMC/, Pyro_RSA, DecisionTheory/DecPyMC/, DecisionTheory/Actuariat/, Applications/Percolation/Percolation-Supercritique et Applications/Quotients-Fibres-Recollement-Python ; coursia-ml-training pour les notebooks du pont causal qui l’exigent ; Lean 4 (WSL) pour DecInfer-02, DecInfer-02b, DecInfer-08b et Percolation-Lean. Aucun notebook ne mélange les kernels. (Historiquement, Infer-1b avait été rédigé en mode polyglot .NET Interactive avec des cellules #kernel par langage ; ce n’est plus le cas — il est aujourd’hui un notebook C#/.NET.)
PyMC : échantillonnage très lent ou divergence NUTS
- Augmentez
target_energyetadapt_delta(défaut 0.8 → essai 0.95). - Vérifiez le
R-hat(devrait être < 1.01 pour toutes les variables). - Consultez PyMC-02b-Debugging-Python pour des diagnostics détaillés (trace plots, effective sample size, tree depth).
Ressources
Activités associées
Les activités Chaîne de Markov de la météo et Axiomes de préférences rationnelles exercent en jeu d’équipe la distribution stationnaire et la théorie de l’utilité enseignées ici.
Infer.NET
PyMC
Théorie
- Bishop, C. (2006) - Pattern Recognition and Machine Learning
- Koller & Friedman (2009) - Probabilistic Graphical Models
- Von Neumann & Morgenstern (1944) - Theory of Games and Economic Behavior
- Russell & Norvig - Artificial Intelligence, Chapter 16 (Decision Theory)
Pont vers les Preuves Formelles (Lean 4) — différenciant CoursIA
Cette série ancre mathématiquement ses résultats phares dans un assistant de preuve, en partenariat avec les autres familles du dépôt. La programmation probabiliste ne se contente pas de calculer des densités, des utilités espérées et des bornes de généralisation — elle les prouve. Le tableau ci-dessous croise les notebooks Probas avec les lakes Lean 4 qui certifient leurs théorèmes, et signale les passerelles vers les autres hubs (QC ↔︎ kelly_lean, GameTheory ↔︎ game_theory_lean (Arrow), Search ↔︎ search_lean, SymbolicAI ↔︎ argumentation_lean).
| Famille | Lake phare | Théorème | Branchement notebook |
|---|---|---|---|
| Probas (DecisionTheory) | decision_theory_lean |
Axiomes de Von Neumann-Morgenstern ⇒ existence d’une utilité espérée (0 sorry) |
DecInfer-02-Lean-ExpectedUtility |
| Probas (DecisionTheory) | decision_theory_lean |
Coherence utility ⟹ preferences (loterie de référence) (0 sorry) |
DecisionTheory/DecInfer/ Coherence |
| ML ↔︎ Probas (PAC Learning) | learning_theory_lean |
pac_finite_class_bound + pac_agnostic_generalization (0 sorry bout-en-bout) |
2.8-Theorie-PAC + 2.8b-Theorie-PAC-Lean |
| Probas (DecisionTheory) | decision_theory_lean Peters |
Indice de Gittins, identités d’escompte (0 sorry, ref v4.27.0-rc1) |
DecInfer-08b-Lean-Gittins |
| QC ↔︎ Probas | kelly_lean |
Fraction risquée f* = μ−σ²/2 sous log-bienveillance (0 sorry) |
Kelly_companion.ipynb |
| GameTheory ↔︎ Probas | game_theory_lean (Arrow) |
Impossibilité d’Arrow (5 axiomes ⇒ dictature) | 01-Arrow-Impossibility-Theorem.ipynb |
| Search ↔︎ Probas | search_lean |
Consistance heuristique h ≤ h* ⇒ optimalité A* |
hub Search (cf search_lean/) |
| SymbolicAI ↔︎ Probas | argumentation_lean |
Extension Dung (grounded/preferred/stable) par cadre formel |
Argumentation-03-Dung-AF-Semantics-Python.ipynb |
flowchart LR
    subgraph SIM["Probas — simulation numérique"]
        NB_DT["DecInfer-02 — vNM (kernel Lean)"]
        NB_CO["Arc DecInfer — Coherence"]
        NB_GIT["DecInfer-08b Gittins companion"]
        NB_PAC["PAC Learning iter-2"]
        NB_MCMC["PyMC NUTS / HMC"]
        NB_EP["Infer.NET EP / VMP"]
    end
    subgraph LEAN["Lakes Lean 4 — preuves formelles"]
        LK_DT["decision_theory_lean VNM"]
        LK_CO["decision_theory_lean Coherence"]
        LK_PAC["PAC chain uniform_concentration"]
        LK_GIT["decision_theory_lean Peters Gittins"]
        LK_KELLY["kelly_lean"]
        LK_SC["game_theory_lean (Arrow)"]
    end
    NB_DT -. "axiomes vNM ⟹ utilité espérée" .-> LK_DT
    NB_CO -. "coherence ⟹ preferences" .-> LK_CO
    NB_PAC -. "uniform_concentration ⟹ erm_error_bound" .-> LK_PAC
    NB_GIT -. "identités d'escompte ⟹ indice Gittins" .-> LK_GIT
    NB_MCMC -. "log-bienveillance ⟹ f* = μ−σ²/2" .-> LK_KELLY
    %% NB_EP (Infer.NET EP / VMP) = inférence bayésienne approximative ;
    %% la passerelle Dung ↔ argumentation_lean est couverte par le tableau §E ci-dessus (ligne SymbolicAI ↔ Probas),
    %% pas par un lien direct depuis ce nœud de simulation.
    %% color: explicite -- sans lui, libelle clair sur fond clair en mode sombre GitHub (#15022) ; ton parfois plus fonce que le stroke (le stroke en couleur de texte rendrait infer illisible) : ne pas harmoniser
    style LK_DT fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style LK_CO fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style LK_PAC fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style LK_GIT fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style LK_KELLY fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style LK_SC fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
La double culture Probas tient en deux gestes complémentaires. D’un côté, simuler : PyMC fait tourner NUTS/HMC sur des modèles hiérarchiques, Infer.NET propage des messages EP/VMP sur des graphes factoriels, et les notebooks PAC entraînent des hypothèses parERM. De l’autre, prouver : decision_theory_lean (VNM et Coherence certifiés, 0 sorry) certifie que les axiomes de rationalité impliquent l’existence d’une utilité espérée, et la chaîne PAC iter-2 démontre pac_agnostic_generalization de bout en bout sans sorry. Les deux faces du même raisonnement bayésien et décisionnel — l’une touche l’intuition numérique, l’autre ancre la garantie formelle.
EPIC #4038 (Roadmap Lean) · cross-ref hubs QC ↔︎ kelly_lean, central P0, GameTheory ↔︎ game_theory_lean, SymbolicAI/Lean.
Conclusion / Prochaines étapes
Ce que vous avez appris
Cette série vous a fait changer de regard sur l’incertitude : plutôt que de la fuir ou de l’ignorer, vous avez appris à la modéliser, la quantifier et la traduire en décisions. L’arc pédagogique se déploie en trois temps, porté par trois stacks complémentaires :
- Le geste fondateur — remplacer une prédiction ponctuelle par une distribution. Un modèle probabiliste ne dit pas « la probabilité est 0.73 » mais « voici la distribution complète N(0.73, 0.12) », et cette densité porte l’information que la moyenne dissimule : la confiance, les queues, les modes multiples. C’est ce déplacement qui ouvre tout le reste.
- La double inférence — Infer.NET (message passing déterministe, EP/VMP/Gibbs) et PyMC (échantillonnage MCMC, NUTS) résolvent les mêmes modèles par des voies opposées : non pas « exact vs approché » (EP est lui-même approché en général), mais déterministe vs stochastique. Le traverser sur des modèles jumeaux (notebook à notebook, Infer-N ↔︎ PyMC-N) ancre une intuition qu’aucun cours théorique ne donne : quand le message passing déterministe s’applique, il est rapide et reproductible ; quand le modèle sort de son domaine, l’échantillonnage prend le relais mais exige des diagnostics (R-hat, effective sample size, trace plots).
- La décision — la seconde moitié franchit le pas : des croyances (distributions) aux actions. Utilité espérée E[U], valeur de l’information (EVPI/EVSI), réseaux de décision, et enfin les MDP qui relient cette série à l’apprentissage par renforcement. Chez Infer.NET cet arc forme un track autonome (
DecisionTheory/DecInfer/) ; son compagnon Lean 4 (DecInfer-08b) pousse l’exigence jusqu’à formaliser les identités d’escompte de l’indice de Gittins — l’assurance que les identités numériques ne sont pas des approximations accidentelles mais des théorèmes.
La thèse pratique est honnête : un modèle probabiliste est plus lourd à bâtir qu’un classifieur, mais il est le seul à pouvoir dire « je ne sais pas » — et dans le diagnostic médical, le classement sportif ou l’évaluation de compétences, cette honnêteté est précisément ce qu’on cherche.
Prochaines étapes
- Passer à la décision séquentielle : les MDP de l’arc décision (
DecisionTheory/DecInfer/ouDecisionTheory/DecPyMC/) préparent directement RL, où l’agent apprend la politique optimale par interaction plutôt que de la calculer hors ligne — la frontière naturelle entre inférence probabiliste et apprentissage par renforcement. - Croiser la théorie des jeux : GameTheory partage la notion de décision sous incertitude, mais l’incertitude y vient d’un adversaire rationnel plutôt que d’un processus stochastique. Les fonctions d’utilité multi-attributs trouvent leur miroir dans le choix social et l’utilité collective.
- Revenir au ML appliqué : le TP prévision de ventes de la série ML est une porte d’entrée — il traite la régression bayésienne comme cas d’application ; cette série en donne le langage complet (distributions, facteurs, inférence).
- Pour la pratique : reprenez un même modèle (par exemple TrueSkill, Infer-8 / PyMC-8) dans les deux stacks, comparez les intervalles de crédibilité, et observez comment EP (déterministe) et NUTS (stochastique) convergent vers des conclusions cohérentes — c’est l’exercice le plus formateur pour saisir le champ d’application de chaque approche.
Le fil rouge
La programmation probabiliste propose un changement de posture : ne plus demander « quelle est la bonne réponse ? » mais « à quel point suis-je sûr de cette réponse, et que dois-je faire compte tenu de cette incertitude ? ». Cette série vous a donné les trois couches — modéliser (facteurs, distributions), inférer (message passing ou échantillonnage), décider (utilité espérée, valeur de l’information) — pour transformer une question qualitative en un calcul, en gardant à l’esprit qu’une distribution honnête vaut mieux qu’une certitude illusoire.
Références canoniques (audit distillation #8081)
La série Probas/Infer+PyMC distille et adapte un corpus de modèles probabilistes canoniques. Le mapping source ↔︎ notebook est audité dans docs/reference/mbml-source-attribution.md (c.803, 2026-07-23). Références canoniques principales :
- Model-Based Machine Learning Book (Herbrich / Bishop / Winn / Diethe) — couvre la majorité des notebooks probas appliqués (Murder Mystery Ch.1, Skills IRT Ch.2, TrueSkill Ch.3, BPM Ch.4, WetGrass Ch.5, LDA Ch.10, Crowdsourcing Ch.7/9c, Recommenders, Sequences Ch.12, GP Ch.16, Survival Ch.17).
- TrueSkill: A Bayesian Skill Rating System (Herbrich, Minka & Graepel, NeurIPS 2007) — fondement algorithmique de Infer-8 et PyMC-8, dont les formules fermées V(t)/W(t)/τ² (section 7 bis PyMC-8).
- Pattern Recognition and Machine Learning (Bishop, Springer 2006) — référence générale pour les modèles gaussiens, mixtures, EM, et la théorie de l’inférence bayésienne.
- Rasch (1960) / Birnbaum (1968) / Lord (1980) — historique IRT cité dans PyMC-7 (cell 3) « Origine de la méthode » ; le pendant Infer-7 mérite un backfill analogue (#8702).
- Lauritzen & Spiegelhalter (1988), Jensen, Lauritzen & Olesen (1990) — fondement des réseaux bayésiens WetGrass/Sprinkler (Infer-4, PyMC-4).
- Blei, Ng & Jordan (2003) — Latent Dirichlet Allocation, cité dans Infer-11 et PyMC-11 comme « Source primaire ».
- Salakhutdinov & Mnih (2008) — Probabilistic Matrix Factorization, cité dans PyMC-15.
- Pearl (2000) — do-calculus, fondement causal d’Infer-5 / PyMC-5 / DecInfer Do-Calculus-Bridge.
- Rabiner (1989) — HMM tutorial, base conceptuelle d’Infer-14 / PyMC-14.
- Minka, T., Winn, J., et al. (2018) — Infer.NET 2.4, Microsoft Research Cambridge (cité PyMC-1).
Les notebooks qui distillent directement MBML (Infer-3 Murder Mystery, PyMC-3 Murder Mystery, PyMC-8 TrueSkill) citent la source canonique inline ; les autres notebooks s’appuient sur la bibliographie footer « Pour aller plus loin » (Infer-1, cellule 38 ; Infer-15, cellule 88) ou sur les sources primaires académiques. Le tableau de correspondance docs/reference/mbml-source-attribution.md inventorie chaque notebook avec sa source/attribution.
Licence
Voir la licence du repository principal.
Version 1.3.0 — Septembre 2026