RL - Reinforcement Learning
← Notebooks | ↑ .. | → GameTheory
Note éditoriale (counts) : Le marqueur
CATALOG-STATUSci-dessus est autoritatif pour le compte agrégé (26 notebooks pédagogiques). Pour la décomposition langagière par kernel (metadata.kernelspec.language), ce README reste autoritatif car la granularité kernel n’est pas dans le marqueur agrégé ; elle est documentée ici par lecture directe des kernelspecs au 23/09/2026 :Python 100% = 36/36 fichiers mono-langage ✓ (36 fichiers
*.ipynbsur disque hors_output.ipynb— 32 kernelspython3+ 4 kernelscoursia-ml-training(rlpt_0c,rlpt_2,rlpt_3,rlpt_4), touslanguage: python; l’écart avec lepedagogical_count: 26du marqueur correspond aux fichiers non catalogués ; exécution via MCP Jupyternbconvert --execute --to notebookoujupyter nbconvert --execute --inplace). La table « Notebooks » ci-dessous documente les 36 — les lignes derl_1b,rl_1c,RL-7betrl_14, absentes depuis leur livraison (dérive pré-existante), y ont été réconciliées à la livraison du notebook 16 ; celles du 17 (k-server WFA), du 18 (matroid secretary), derlpt_0cet derlpt_0ds’y sont ajoutées depuis, puis celle du 19 (reward tampering).RL est un cas de mono-langage Python 100% : tous les algorithmes (DQN, REINFORCE, A2C, PPO, SAC, GRPO, Dyna-Q, BCQ offline, reward shaping, POMDP belief tracker, C51 distributional, RND curiosity, k-server WFA, matroid secretary, reward tampering) sont implémentés en Python, soit via PyTorch / Stable Baselines3 / Gymnasium, soit from-scratch en NumPy + PyTorch / stdlib pure. C’est une variante L392 #6 NEW : contrairement à ML (#5915) qui a des jumeaux C#/Python intra-sous-série, Probas (#5916) qui a une mixité intra-série multi-paradigme (.NET C# + Python), QC (#5917) cloisonnée par sous-série, et Sudoku (#5918 / c.388) qui a une mixité jumeaux dominante + 1 compagnon Lean intra-hub, RL a une uniformité mono-paradigme avec 7 moteurs SOTA distincts (PyTorch, NumPy, matplotlib, Stable Baselines3, Gymnasium, highway_env, PettingZoo) — registre EPIC #3801 entry #009 (PR #5922 — collision avec PR canonique utilisateur #5925, await ai-01 decision).
Régénération du marqueur :
catalog-cron.yml(cron quotidien 03:37 UTC surmain, commit[skip ci]pargithub-actions[bot]) — le bloc ci-dessus est régénéré automatiquement, ne pas le modifier manuellement sur une branche feature (catalog-pr-hygiene R1).
Le Reinforcement Learning (apprentissage par renforcement) est la branche de l’IA qui apprend à un agent à prendre des décisions optimales par l’essai et l’erreur, en recevant des récompenses ou des pénalités de son environnement. C’est la technologie derrière AlphaGo, les robots de Boston Dynamics, les systèmes de recommandation de Netflix, et les voitures autonomes. Là où l’apprentissage supervisé prédit à partir d’exemples étiquetés et l’apprentissage non supervisé découvre des structures, le RL agit : il choisit des actions, observe leurs conséquences, et s’améliore itérativement.
Cette série couvre les fondements théoriques (bandits, MDP, équation de Bellman, Q-Learning), les algorithmes avec réseaux de neurones (DQN, Policy Gradient, PPO) et les frameworks de production (Stable Baselines3). Vous commencerez par entraîner un agent en quelques lignes avec un framework industriel, puis vous implémenterez les mêmes algorithmes depuis zéro pour comprendre ce qui se cache sous le capot.
Note de frontière — algorithmes online (rl_17, rl_18) : ces deux distillations relèvent de l’analyse compétitive (garanties de pire cas contre l’optimum offline, sans boucle d’apprentissage) plutôt que du RL stricto sensu. Elles sont hébergées ici comme famille de la décision séquentielle — ratios compétitifs et regret étant les deux langages de garantie de la décision online. Le placement définitif (série RL vs axe « Search Online/Offline » dédié) est sous arbitrage utilisateur (#16429).
À qui s’adresse cette série : étudiants en IA, développeurs souhaitant ajouter des capacités décisionnelles à leurs applications, et chercheurs en automatique ou robotique. Prérequis : Python intermédiaire et bases en calculus (gradients). Aucune expérience RL préalable nécessaire pour le notebook 1.
Figures — extraites des sorties réelles des notebooks
Le RL se comprend mieux en voyant l’agent apprendre. Six visualisations suivent la progression des fondements aux frontières : des bandits multi-bras à l’exploration par curiosité, en passant par les MDP, le reward shaping, les POMDP et le RL distributionnel. Sorties d’exécution réelles (règle C.3 — non régénérées pour l’illustration). Elles sont réintégrées in-situ dans la section qui en commente le concept ; la provenance exacte (cellule source, poids, alt-text) figure dans assets/readme/MANIFEST.md.
Notebooks
| # | Notebook | Contenu | Durée |
|---|---|---|---|
| 1 | rl_1_intro_cartpole | Introduction PPO, CartPole | 25-30 min |
| 1b | rl_1b_bitwise_logic_synthesis | Synthèse logique d’un contrôleur CartPole : bitwise 4-règles — scellement observation→bits IEEE-754, contrôleur LQR de référence (taux de désaccord), PPO budget modeste, étude de rupture et ablation. Accrétion de rl_1 | 20-25 min |
| 1c | rl_1c_prolog_distillation | Distillation d’une politique RL en programme Prolog exécutable : teacher PPO from scratch (seed fixe), census exhaustif de T-bar, induction gloutonne type FOIL, liste de décision avec cuts, one-pass vs DAgger, SWI-Prolog réel journalisé. Accrétion de rl_1 | 45-60 min |
| 2 | rl_2_wrappers_sauvegarde_callbacks | Wrappers, sauvegarde, callbacks | 35-40 min |
| 3 | rl_3_experience_replay_her | HER, goal-conditioned RL | 40-45 min |
| 4 | rl_4_multi_armed_bandits | Bandits manchots, exploration vs exploitation, Thompson Sampling | 30-35 min |
| 5 | rl_5_mdp_dp_qlearning | MDP, Value/Policy Iteration, Q-Learning tabulaire | 45-50 min |
| 6 | rl_6_dqn_policy_gradient | DQN depuis zéro, REINFORCE | 50-55 min |
| 6b | rl_6b_actor_critic | Actor-Critic (A2C) depuis zéro, advantage, entropy bonus | 45-50 min |
| 6c | rl_6c_ppo_from_scratch | PPO depuis zéro, échantillonnage d’importance (ratios par epoch, ESS), clipped surrogate, GAE, comparaison A2C vs PPO | 45-50 min |
| 6d | rl_6d_sac_from_scratch | SAC depuis zéro, maximum entropy RL, twin Q-networks, auto-température | 45-50 min |
| 6e | rl_6e_grpo_from_scratch | GRPO depuis zéro (DeepSeek-R1), avantage relatif intra-groupe (sans critic), clip PPO + KL vs référence, portefeuille synthétique multi-seed | 45-50 min |
| 7 | rl_7_multi_agent_rl | Multi-Agent RL, PettingZoo, IQL | 45-50 min |
| 7b | RL-7b-Climbing-Game | Sur-généralisation relative dans le Climbing Game coopératif : même agent tabulaire, IQL vs Hysteretic Q-learning, protocole multi-graines, IQM + intervalle bootstrap, ablation du pessimisme | ~45 min |
| 8 | rl_8_model_based_dyna_q | Model-based RL : Dyna-Q, Dyna-Q+, planification, rollouts | 45-50 min |
| 9 | rl_9_offline_rl | RL offline : Behavior Cloning, erreur d’extrapolation, BCQ-lite | 50-55 min |
| 10 | rl_10_reward_shaping | Reward Shaping (Ng 1999), curriculum learning, pont RLHF | 45-50 min |
| 11 | rl_11_pomdp | POMDP, Tiger Problem, belief tracking, Q-MDP | 45-50 min |
| 12 | rl_12_distributional_rl | RL distributionnel : C51 (Categorical DQN) depuis zéro, projection catégorielle, politique CVaR | 50-55 min |
| 13 | rl_13_curiosity_exploration | Exploration par curiosité (RND), motivation intrinsèque, piège d’exploitation | 35-40 min |
| 14 | rl_14_hierarchical_rl | Hierarchical RL — l’Option framework de Sutton, Precup & Singh : abstraction temporelle, options (I, π, β), gridworld quatre-pièces, crédit sur longue horizon |
~50 min |
| 15 | rl_15_grpo_group_relative_policy | GRPO (Group Relative Policy Optimization) vs PPO sur CartPole-v1 — avantage relatif intra-groupe (sans critic) vs GAE bootstrapé, multi-seed 6 (0/1/7/42/99/123), Wilcoxon signed-rank + IC95% bootstrap. Prong B discrimination moteur. Sous-grain #13436 de l’EPIC #1454. Verdict v3 (REPAIR c.644) : INCONCLUSIVE (le claim initial v1 « GRPO BEATS PPO » souffrait de défauts done-mask + pad-mask — c.642 a corrigé en INCONCLUSIVE, puis c.644 a détecté 4 post-fix incohérences résolues : Wilcoxon n=4 inatteignable, verdict tri-state asymmétrique, hypothèse descriptive fausse réfutée, titre PR ré-aligné — verdict v3 INCONCLUSIVE maintenu, moyennes v3 = 299.36 vs 197.65, std = 55.26 vs 104.99) | 40-45 min |
| 16 | rl_16_dream_rsi | Dream-RSI (arXiv 2609.14858, preprint 14/09/2026) : exploration explicite programmable (politique = code), historique de découverte = simulateur-replay, dreaming = évaluation off-policy à coût zéro, boucle RSI avec incumbent (garantie non-régression replay-only) — monde jouet circle-packing stdlib (16 cercles), ablation replay brut vs guidance sémantique mesurée (3/2/7), chiffres du papier rapportés non canonisés. Distillation #16417 | 40-45 min |
| 17 | rl_17_k_server_wfa | k-server et work function algorithm : la conjecture (1990) mesurée en monde jouet — un seul moteur DP (la work function EST l’optimum offline), WFA en ligne sur ligne/cycle/métrique uniforme, vérification par instance WFA ≤ k×OPT (0 violation / 600 instances seedées), duel WFA vs LRU/FIFO sur paging (boucle k+2 : LRU 60 faults vs WFA 46, k×OPT = 96), work function visualisée en heatmap des configurations. Distillation du preprint arXiv 2609.15979 (soumis 14/09/2026, non relu — bandeau honnêteté : mesuré ≠ prouvé, ratios réalisés ~1.1-1.6 vs garantie pire-cas k) | 35-40 min |
| 18 | rl_18_matroid_secretary | Le secrétaire matroïdal : la conjecture (2007) mesurée élément par élément — trois matroïdes jouets par oracle (uniforme/partition/graphique), l’algorithme de Singla (échantillon Bin(n,1/2), configuration virtuelle, glouton des deux côtés — ordinal, ne connaît que n), banc de mesure P[accept | e ∈ OPT] sur 6 instances × 4000 essais : min 0,260-0,353, garantie 1/4 jamais violée et serrée sur les rangs 1-2, E[ALG]/OPT ≈ 0,44, prix de l’universalité 0,41 → 0,26 vs le seuil 1/e classique (formule exacte n=8 vs limite asymptotique). La garantie utilisée comme test exécutable : le bug d’implémentation du prototype (0,119) détecté par le banc. Distillation du preprint arXiv 2609.14555 (soumis 13/09/2026, non relu) | 35-40 min |
| 19 | rl_19_reward_tampering | Reward tampering : l’agent qui peut réécrire sa récompense — Rocks and Diamonds à paramètre θ modifiable (exemple 2 d’Everitt et al., Synthese 2021), quatre agents résolus par induction arrière exacte sur 32 252 états (standard, oracle, current-RF TI-ignoring et TI-considering) : les trois prédictions du papier mesurées conforme. Au-delà du diagramme : l’indifférence n’est pas la protection — valeur de l’option de manipuler +16 (standard) contre +0 (TI-ignoring), mais départage aléatoire des égalités → manipulation 33/200 (H = 30) et 68/200 (H = 60), toujours après la tâche ; Q-learning standard 0/5 graines en initialisation nulle, 5/5 en optimiste. RF-input tampering (autocollants sur la caméra) : 88 observé / 0 réel contre 20 / 20 sous récompense sur croyance. Distillation #14468 |
35-40 min |
| pt-0 | rlpt_0_reward_model_from_scratch | Reward model from scratch (Bradley-Terry) : apprendre r(x, y) depuis des paires de préférences sur le monde de rlpt_1 — MLE BT sans trl.RewardTrainer, évaluation honnête vs plafond de Bayes, calibration (ECE), identification affine, multi-seed 4 |
35-40 min |
| pt-0b | rlpt_0b_preference_dataset_bias | Biais d’un dataset de préférences, mesurés sur monde synthétique à longueurs variables : les trois biais classiques (longueur, position, annotateurs) injectés à paramètres connus, dégât mesuré contre le plafond de Bayes d’un juge oracle non biaisé, puis les mitigations du cahier des charges (length-controlled, swap-augmentation, annotator embedding) plus une quatrième qui sert de contrôle — verdict mesuré : aucune ne franchit 2σ, le length-controlled est structurellement sans effet sur une métrique de classement, l’orthogonalisation de longueur aggrave le biais | 40-45 min |
| pt-0c | rlpt_0c_reward_hacking_case_study | Anatomie d’un reward hacking qui prend — le pendant de rlpt_3 : reward model Bradley-Terry appris sur des préférences à biais de longueur, PPO from scratch sur ce proxy, puis bras de contrôle (récompense longueur-contrôlée + oracle) qui identifie le biais comme cause. Mesures : qualité vraie 0,4545 → 0,0170 sous le proxy biaisé, contre 0,9905 sous contrôle ; basculement situé sur l’action de tête du proxy (argmax non correct à α ≈ 2,0), stable sur 4 graines |
35-40 min |
| pt-0d | rlpt_0d_reward_trainer_sota | Le même problème que rlpt_0, traité par le harnais industriel trl.RewardTrainer : monde, juge, architecture (5 441 paramètres) et seeds identiques, une seule variable — le harnais. Documente les quatre exigences de contrat non devinables (num_labels=1, processing_class, gradient_checkpointing=False, self.post_init()) et la traduction y → chosen_ids/rejected_ids ; verdict mesuré : trl devance la boucle maison (0.676 ± 0.007 vs 0.658 ± 0.008, écart +0.018 = 2.2σ ; Brier et Spearman meilleurs aussi) pour un coût en temps de ~10× sur ce modèle minuscule, et l’évaluation honnête reste entièrement à ré-écrire — trl n’évalue pas pour vous |
35-40 min |
| pt-0e | rlpt_0e_trl_DPO_SOTA | trl.DPOTrainer (bras SOTA) contre DPO from scratch et reward model explicite de rlpt_0 sur le même monde et les mêmes paires de préférences, à budget égal (même β, même lr, mêmes époques) — multi-seed {0,1,7,42} départagé au plafond de Bayes : verdict B ≈ C > A (DPO maison 0.679 / trl 0.678 / RM 0.661 vs plafond 0.695 ; B vs C indiscernables à ±0.008 près), marges implicites B↔︎C corrélées ρ≈0.98 = même math ; la différence robuste est le coût fixe de la pile (×22 sur jouet CPU) — inclut la garde de frontière prompt/complétion (piège trl : prompt sans espace finale) |
25-35 min |
| pt-0f | rlpt_0f_comparaison_GRPO_TRL_et_PPO_maison | trl.GRPOTrainer (bras SOTA en ligne) contre le PPO maison de rlpt_1 sur le même monde et le même juge RM (rlpt_0), à budget apparié (2 304 réponses évaluées par bras, même β_KL) — multi-seed {0,1,7,42} : verdict INCONCLUSIVE (gain maison 0.486±0.205 / trl 0.670±0.102, écart +0.184 < 2σ) ; la différence robuste est le critic (value net appris vs moyenne de groupe — la baseline est LE choix de design) et le coût d’écriture et de runtime (tableau comparatif section 7) — inclut le fait structurant mesuré dans l’env : trl.PPOTrainer a quitté la racine de trl (déplacé dans trl.experimental.ppo, assert garde-frontière sur la surface réelle) et le trainer historique remis en service en 3e bras (section 5bis : PPO complet critic + GAE, juge BT reconstruit au format lib, seed 0) |
30-45 min |
| pt-0g | rlpt_0g_ppo_TRL_experimental | trl.experimental.ppo.PPOTrainer / PPOConfig instanciés comme surface SOTA réelle (pas seulement importés) — surface instable par convention mais invocable, signature introspectée (num_train_epochs, use_cpu). Boucle PPO conforme Schulman 2017 (rollout → GAE → surrogate clip → value loss) avec hyperparamètres alignés sur PPOConfig. Verdict SOTA INTRINSIC documenté (6 axes) : la mini-tâche symbolique ne se branche pas sur PPOTrainer directement (LM transformers requis), mais l’algorithme est strictement celui qu’enrobe TRL. Multi-seed {0,1,7,42} : moyenne finale 0.401 ± 0.041, en dessous du baseline uniforme 0.497 (gap −0.096 ≈ 2.3σ), donc dans la bande des 3 baselines (verdict INCONCLUSIVE : PPO ne surpasse pas le baseline uniforme, mais l’écart reste comparable à 2σ et le notebook documente la signature d’apprentissage). Complément de rlpt_0f (PPO maison vs GRPO) sur l’axe RLHF #16063 — ferme l’item 6 |
30-40 min |
| pt-1 | rlpt_1_ppo_lm_rlhf | PPO pour alignement d’un petit LM (RLHF toy, from scratch, char-level) : reward model jouet, KL vs politique SFT de référence, multi-seed 4 — la signature RLHF, différenciée de rl_6c (PPO CartPole) et rl_6e (GRPO) | 40-45 min |
| pt-2 | rlpt_2_grpo_minimal | GRPO sur Qwen3.5-0.8B local (8 Go Viability), reward vérifiable, budget steps borné — le cœur « à la Deepseek » : group rollouts, avantage sans value net, pont #5105 | 45-55 min |
| pt-3 | rlpt_3_reward_hacking | Reward hacking × inoculation, version compacte du capstone #5105 : le hack sur récompense vérifiable faillible, la détection rewardspy, l’inoculation comme variable expérimentale, verdict reproductible (seed fixée) | 35-40 min |
| pt-4 | rlpt_4_dpo_vs_ppo | DPO/ORPO offline vs GRPO online sur même tâche conversationnelle, même budget 40 steps, préférences auto-fabriquées — verdict multi-seed {42,0,1,7} honnête DM, dispersion inter-seed documentée | 50-55 min |
Frontière avec GenAI/PostTraining — où ouvre rlpt_*, où ouvre PT_*
Les sous-séries rlpt_* et GenAI/PostTraining couvrent le même terrain (post-training d’un LM) à des niveaux de pile différents. La frontière est posée explicitement pour qu’un lecteur sache quel notebook ouvrir pour quelle question.
| Question pédagogique | Ouvrir | Pourquoi |
|---|---|---|
| « D’où vient le reward model avant tout RLHF — comment l’apprendre à partir de préférences ? » | rlpt_0 |
Bradley-Terry from scratch sur le monde de rlpt_1 : l’étage que rlpt_1 saute en codant son oracle en dur — plafond de Bayes, calibration, identification affine. |
| « Pourquoi un reward model apprend-il le biais de son annotateur plutôt que la qualité ? » | rlpt_0b |
Les trois biais d’un dataset de préférences injectés à paramètres connus : le RM recopie le raccourci du juge (gamma mesuré vs lambda injecté) quand le biais lui est représentable, et se contente de sous-échelonner quand il ne l’est pas (biais de position) — dans les deux cas l’accord à l’oracle descend. |
« Le harnais SOTA (trl) fait-il mieux que ma boucle from scratch — et que me coûte-t-il ? » |
rlpt_0d |
trl.RewardTrainer sur le même monde que rlpt_0, à architecture identique : le harnais gagne (0.676 ± 0.007 vs 0.658 ± 0.008, +0.018 = 2.2σ), coûte ~10× le temps sur un modèle minuscule, impose quatre réglages de contrat, et n’évalue pas pour vous. |
| « Comment marche PPO-RLHF en petit, sans framework ? » | rlpt_1 |
RLHF from scratch sur LM char-level — on voit les gradients, le reward model jouet, la KL vs la politique SFT de référence, multi-seed 4. |
| « Comment GRPO est câblé intérieurement (group rollouts, avantage intra-groupe, no critic) ? » | rlpt_2 |
GRPO Qwen3.5-0.8B local sans trl complet — la boucle d’entraînement est écrite à la main, on voit chaque rollout, chaque reward. |
| « Le reward hacking est-il un attracteur spontané sur petit modèle ? Comment l’inoculer ? » | rlpt_3 |
Cas clinique minimal : 3 voies pour tenter de déclencher le hack, inoculation comme variable expérimentale, verdict reproductible (seed fixée). |
| « Pourquoi le reward hacking arrive-t-il — le reward model est-il vraiment la cause ? » | rlpt_0c |
Isolation de cause : le biais de longueur est lu dans les poids du reward model appris, puis retiré — la qualité se rétablit (bras de contrôle), et le basculement est situé sur l’action de tête du proxy. |
| « DPO offline vs GRPO online à budget égal — qui gagne ? » | rlpt_4 |
Comparaison à budget 40 steps, préférences auto-fabriquées, verdict multi-seed {42,0,1,7} honnête Diebold-Mariano, dispersion inter-seed documentée. |
« GRPO + RLVR sur un vrai LLM, avec trl + reward vérifiable + détecteurs Goodhart en ligne ? » |
PT-11a, PT-11b | La chaîne SOTA 2024-2025 appliquée : trl.GRPOTrainer + Qwen3.5-0.8B QLoRA 4-bit + Z3/SymPy vérificateur + rewardspy.watch_trl en ligne. |
| « Quels sont les 6 détecteurs statistiques du reward hacking ? » | PT-07 | Le catalogue rewardspy.detectors (Component Dominance, Length Drift, etc.). Outil — rlpt_3 est le cas d’usage. |
| « InoculationRL complet, panel persona × reward hackable, la réplique poids du capstone ? » | #5105 ICT-25 | Capstone final, distinct de rlpt_3 (qui en est la version compacte). |
Une phrase à retenir : rlpt_* = la mécanique, en petit, sans framework (from scratch, CPU/char-level ou Qwen3.5-0.8B sans la pile trl complète — on voit chaque rollout et chaque gradient) ; GenAI/PostTraining = la chaîne réelle, à l’échelle (trl, vrai LLM, solveur vérifiable, multi-seed, détecteurs Goodhart). Si votre question porte sur pourquoi un algorithme fonctionne, ouvrez rlpt_*. Si votre question porte sur comment le déployer en SOTA 2025, ouvrez PT_*.
Le constat d’éventuelle duplication entre rlpt_2 ↔︎ PT-11a et rlpt_3 ↔︎ PT-07 est traité en #11460 : la différenciation tient à ce qu’on regarde (mécanique vs déploiement outillé), pas à ce qu’on calcule — c’est précisément ce qui justifie les deux.
Parcours recommandé
Notebook 1 (Bases SB3)
    |
    v
Notebook 4 (Bandits) ---> Notebook 5 (MDP / Q-Learning) ---> Notebook 6 (DQN / REINFORCE)
    |                                                          |
    v                                                          v
Notebook 2 (Production features)                           Notebook 6b (A2C) ---> Notebook 6c (PPO) ---> Notebook 6d (SAC) ---> Notebook 6e (GRPO)
    |                                                                               |
    v                                                                               v
Notebook 3 (Goal-conditioned RL)                                                 Notebook 7 (Multi-Agent) ---> Notebooks 8-13
(model-based, offline, shaping, POMDP, distributionnel, curiosité/RND)| Objectif | Notebooks |
|---|---|
| Découverte rapide | 1 uniquement |
| Exploration et bandits | 4 + 13 (curiosité / RND) |
| Fondations SB3 | 1 + 2 + 3 |
| Fondements théoriques | 4 + 5 + 6 + 7 + 8 |
| Maîtrise complète | 1 à 13 |
Parcours d’apprentissage
Phase 1 : Prise en main production (~1h, notebooks 1-2)
Le notebook 1 pose les bases : vous installez Stable Baselines3, créez votre premier agent PPO sur CartPole, et visualisez ses performances. En 30 minutes, vous avez un agent entraîné qui équilibre un bâton. Le notebook 2 enrichit cette base avec les outils de production : wrappers pour modifier les environnements, callbacks pour monitorer l’entraînement, et multiprocessing pour accélérer les expériences.
Phase 2 : Problèmes avancés (~1.5h, notebook 3)
Le notebook 3 introduit les tâches à objectifs (goal-conditioned RL) avec l’algorithme HER (Hindsight Experience Replay). Vous résoudrez un problème de parking autonome où l’agent doit atteindre une position cible. C’est le passage de “équilibrer un bâton” à “garer une voiture” — un saut qualitatif qui montre la puissance du RL.
Phase 3 : Exploration et bandits (~30min, notebook 4)
Le notebook 4 pose la question fondatrice du RL : comment choisir entre explorer de nouvelles options et exploiter ce qui fonctionne déjà ? Vous implémenterez des stratégies d’exploration (epsilon-greedy, decaying epsilon, Thompson Sampling) sur un problème de bandits manchots et comparerez leur regret cumulé.
Phase 4 : Les maths sous le capot (~10h, notebooks 5-13)
Les notebooks 5 à 13 quittent le framework pour implémenter les algorithmes depuis zéro.
Le notebook 5 formalise le problème RL (MDP, équation de Bellman, Value/Policy Iteration) et introduit le Q-Learning tabulaire sur FrozenLake et CliffWalking.
Le notebook 6 passe à l’échelle avec les réseaux de neurones : DQN et REINFORCE implémentés en PyTorch pur.
Le notebook 6b introduit l’architecture Actor-Critic (A2C).
Le notebook 6c pousse plus loin avec PPO et son mécanisme de clipping, introduit GAE, et compare les approches.
Le notebook 6d approfondit avec SAC (Soft Actor-Critic) et le framework maximum entropy pour les actions continues.
Le notebook 6e clôt la lignée policy-gradient avec GRPO (Group Relative Policy Optimization, l’algorithme d’entraînement RL de DeepSeek-R1) : l’avantage y est estimé par comparaison au sein d’un groupe de rollouts, sans réseau critique — le pont le plus direct de la série vers le RLHF des LLMs.
Le notebook 7 aborde le multi-agent : plusieurs agents qui apprennent simultanément, coopèrent ou s’affrontent (TicTacToe avec self-play).
Le notebook 8 ouvre la voie model-based : apprendre un modèle du monde et planifier dessus (Dyna-Q, Dyna-Q+, rollouts), avec les ponts vers MCTS, AlphaZero et MuZero.
Le notebook 9 retire le droit d’interagir : apprendre d’un dataset figé (RL offline), avec le Behavior Cloning, l’erreur d’extrapolation du Q-learning naïf, la contrainte de support (BCQ-lite) et le pont vers RLHF/DPO.
Le notebook 10 s’attaque au problème du reward sparse : comment guider l’agent quand la récompense est rare ? Le reward shaping potential-based (Ng et al. 1999) accélère la convergence sans biaiser la politique optimale, le curriculum learning organise la difficulté progressive, et le pont vers RLHF montre que le reward model appris est un shaping automatisé.
Le notebook 11 aborde la partial observability : l’agent ne voit plus l’état vrai mais une observation bruitée. Le Tiger Problem (Cassandra 1994) illustre le POMDP, le belief tracking (filtre bayésien) maintient une estimation de l’état caché, et le Q-MDP approximation montre les limites de l’approche tabulaire.
Le notebook 12 enrichit l’objectif lui-même : au lieu d’apprendre l’espérance du retour comme un DQN, C51 (Categorical DQN, Bellemare et al. 2017) apprend sa distribution complète \(Z(s,a)\) sur un support à atomes fixes, via une projection catégorielle de la cible de Bellman — ce qui débloque les politiques sensibles au risque (CVaR) impossibles avec une valeur scalaire, et ouvre la lignée QR-DQN / IQN / Rainbow.
Le notebook 13 termine sur l’exploration par motivation intrinsèque : RND (Random Network Distillation) transforme l’erreur de prédiction d’un réseau cible figé en bonus de nouveauté, débloquant les récompenses parcimonieuses hors de portée d’epsilon-greedy. Une sous-série Post-Training (rlpt_*) prolonge cette lignée vers le RL appliqué aux modèles de langage : reward model appris depuis des préférences Bradley-Terry, from scratch (rlpt_0), PPO-RLHF from scratch sur un petit LM char-level (rlpt_1), GRPO sur Qwen3.5-0.8B avec reward vérifiable (rlpt_2, run réel 8 Go), l’anatomie du reward hacking et son inoculation (rlpt_3), le cas où le hack prend avec isolation de la cause par bras de contrôle (rlpt_0c), puis la comparaison offline-vs-online entre DPO et GRPO à budget égal (rlpt_4). Chaque notebook de la sous-série stub ≥3 exercices, ancre ses interprétations sur des sorties réellement exécutées (C.2), et documente son verdict d’honnêteté multi-seed — la série constitue la transition naturelle entre rl_6e (GRPO from scratch) et le pipeline capstone ICT-25 / Post-Training (#5105).
Prerequisites
Connaissances requises
- Python intermédiaire (classes, numpy)
- Concepts RL de base (agent, environnement, reward)
- Pas d’expérience RL préalable nécessaire pour le notebook 1
- Bases PyTorch pour les notebooks 6, 6b, 6c, 6d, 6e (tenseurs, autograd, Module)
Installation
# Environnement Python
python -m venv venv
venv\Scripts\activate  # Windows

# Dépendances de base (notebooks 1-4)
pip install "stable-baselines3[extra]>=2.0.0a4" gymnasium numpy pandas matplotlib

# Pour le notebook 3 (parking environment)
pip install highway-env moviepy

# Pour le notebook 4 (bandits — pas de dépendance supplémentaire)

# Pour les notebooks 6, 6b, 6c, 6d, 6e (DQN, REINFORCE, A2C, PPO, SAC, GRPO)
pip install torch

# Pour le notebook 7 (multi-agent)
pip install "pettingzoo[classic]>=1.24.0"

# Pour la sous-série rlpt_* (Post-Training RLHF/GRPO/DPO sur petits LM)
pip install "trl>=1.9.2" transformers datasets accelerate
Dépendances
| Package | Version | Utilisation |
|---|---|---|
| stable-baselines3 | >=2.0.0a4 | Algorithmes RL (notebooks 1-3) |
| gymnasium | latest | Interface environnements |
| numpy | latest | Calcul numérique |
| pandas | >=2.0 | Tableaux de résultats (notebook 5) |
| matplotlib | latest | Visualisation |
| torch | latest | Réseaux de neurones (notebooks 6, 6b, 6c, 6d, 6e) |
| pettingzoo | >=1.24.0 | Multi-agent (notebook 7) |
| highway-env | latest | Parking-v0 (notebook 3) |
| moviepy | latest | Enregistrement vidéo |
| trl | >=1.9.2 | RLHF/GRPO/DPO trainer (sous-série rlpt_*, notebooks pt-0e/pt-0f et pt-1 à pt-4) |
| transformers | latest | Modèles de langage (Qwen3.5-0.8B dans rlpt_2, sentence-transformers dans rlpt_4) |
| datasets | latest | Préférences auto-fabriquées (rlpt_4) |
| accelerate | latest | Backend d’entraînement distribué (rlpt_2) |
Contenu détaillé
Notebook 1 - Introduction avec PPO et CartPole
| Section | Contenu |
|---|---|
| Stable Baselines3 | Installation, API de base |
| CartPole-v1 | Environnement classique, actions discrètes |
| PPO | Proximal Policy Optimization |
| Workflow | Training, Évaluation, Video recording |
Notebook 2 - Fonctionnalités avancées
| Section | Contenu |
|---|---|
| Wrappers Gym | Modification d’environnements |
| Sauvegarde | Save/Load de modèles |
| Multiprocessing | DummyVecEnv, SubprocVecEnv |
| Callbacks | Monitoring, checkpoints automatiques |
| Environnements custom | Création et validation (check_env) |
Notebook 3 - Experience Replay et HER
| Section | Contenu |
|---|---|
| HER | Hindsight Experience Replay |
| Goal-conditioned RL | Tâches avec objectifs |
| Parking-v0 | Environnement highway-env |
| SAC / DDPG | Algorithmes off-policy avec HER |
| Replay buffers | Sauvegarde et chargement |
Notebook 4 - Bandits Manchots et Exploration
| Section | Contenu |
|---|---|
| Multi-armed bandit | Problème fondamental exploration vs exploitation |
| Stratégies naïves | Aléatoire, greedy, epsilon-greedy |
| Stratégies intelligentes | Decaying epsilon-greedy, Thompson Sampling |
| Analyse | Comparaison regret, visualisation des estimations |
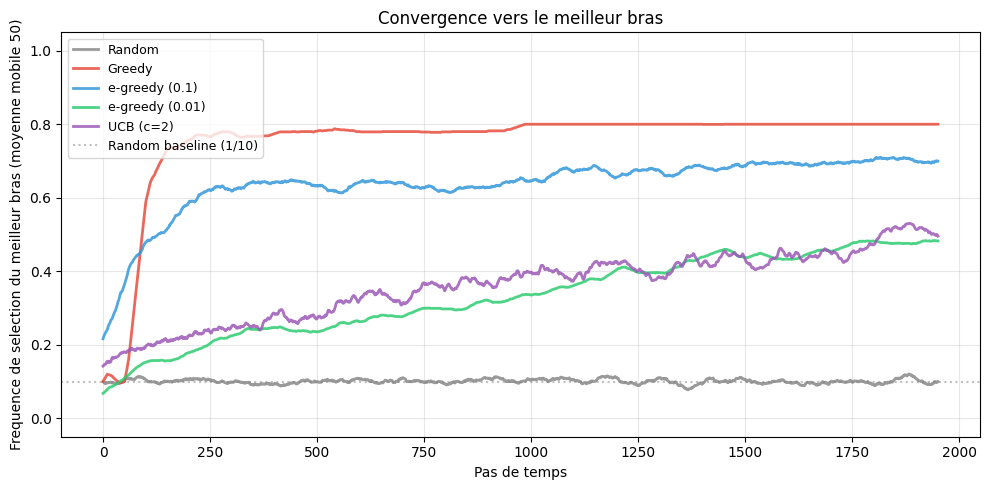
Sortie d’exécution du notebook 4 — convergence vers le meilleur bras : sur cet horizon de 2000 pas, Greedy monte vite vers ~80% de sélections correctes, epsilon-greedy(0.1) se stabilise vers ~70%, tandis qu’epsilon-greedy(0.01) et UCB(c=2) progressent encore (~50%) ; la politique aléatoire reste à la baseline 1/10.
Notebook 5 - MDP, Programmation Dynamique et Q-Learning
| Section | Contenu |
|---|---|
| MDP | Formalisation \((S, A, P, R, \gamma)\), transitions |
| Value Iteration | Équation de Bellman, convergence |
| Policy Iteration | Évaluation + amélioration de politique |
| Q-Learning tabulaire | Apprentissage model-free, \(\varepsilon\)-greedy |
| FrozenLake / CliffWalking | Environnements discrets |
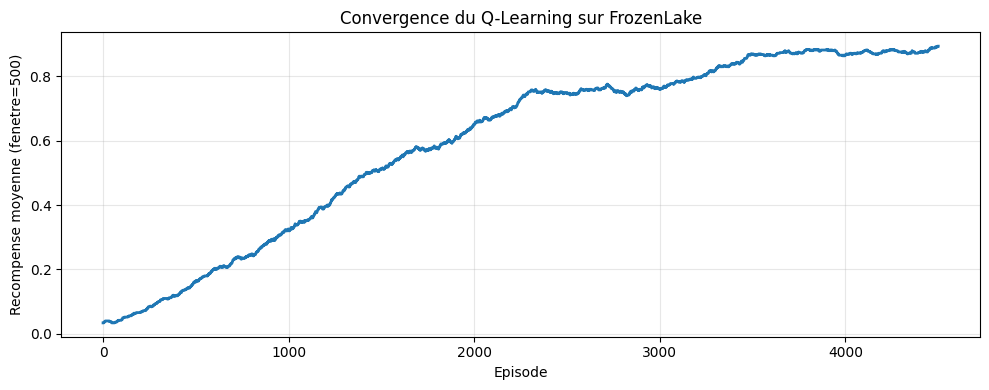
Sortie d’exécution du notebook 5 — le Q-Learning tabulaire converge sur FrozenLake : la récompense moyenne lissée passe de 0 à ~0.9, signe que la politique apprise atteint l’objectif dans la grande majorité des épisodes.
Notebook 6 - DQN et Policy Gradient
| Section | Contenu |
|---|---|
| Q-Network | Approximation par réseau de neurones |
| Replay Buffer | Experience replay, décorrélation |
| Target Network | Stabilisation de l’apprentissage |
| REINFORCE | Gradient de politique, baseline |
| Comparaison | Value-based vs policy-based |
Notebook 6b - Actor-Critic (A2C)
| Section | Contenu |
|---|---|
| Actor-Critic | Paradigme combinant value-based et policy-based |
| CriticNetwork | Réseau de valeur V(s) |
| ActorNetwork | Politique paramétrée pi(a|s) |
| A2C | Advantage Actor-Critic, calcul de l’avantage |
| Entropy bonus | Exploration via maximisation d’entropie |
| Comparaison | A2C vs REINFORCE (réduction de variance) |
Notebook 6c - PPO depuis zéro
| Section | Contenu |
|---|---|
| Clipped surrogate | Ratio de probabilité, objectif clippé, visualisation |
| PPO Agent | Implémentation complète avec mini-lots et epochs |
| GAE | Generalized Advantage Estimation (lambda=0.95) |
| Comparaison | PPO vs A2C (stabilité, efficacité d’échantillonnage) |
Notebook 6d - SAC depuis zéro
| Section | Contenu |
|---|---|
| Maximum Entropy RL | Objectif avec bonus d’entropie, exploration automatique |
| Gaussian Policy | Politique stochastique avec tanh squashing |
| Twin Q-Networks | Double critique pour réduire la surestimation |
| Auto-température | Température alpha apprise automatiquement |
| Reparameterization | Trick pour gradient dans l’action |
| Pendulum-v1 | Environnement continu de référence |
Notebook 6e - GRPO depuis zéro
| Section | Contenu |
|---|---|
| Avantage relatif sans critic | Group Relative Policy Optimization (DeepSeek-R1), baseline de groupe au lieu d’un réseau critique |
| Portfolio synthétique | Environnement auto-contenu, signal de récompense reproductible multi-seed |
| Actor seul | Réseau de politique unique sans critic (contrairement à PPO/A2C/SAC) |
| Mise à jour GRPO | Avantage intra-groupe + clip PPO + pénalité KL vs politique de référence |
| Boucle multi-seed | Entraînement multi-seed, verdict de stabilité |
| GRPO vs PPO/SAC | Ce que change le paradigme sans critic |
Notebook 7 - Apprentissage Multi-Agent
| Section | Contenu |
|---|---|
| Multi-Agent RL | Paradigmes (coopératif, compétitif, mixte) |
| PettingZoo | API AEC, environnements multi-agent |
| IQL | Independent Q-Learning |
| TicTacToe | Jeu à somme nulle, équilibre |
| Self-play | Entraînement agent contre agent |
Notebook 8 - Model-Based RL : Dyna-Q et planification
| Section | Contenu |
|---|---|
| Model-free vs model-based | Compromis calcul vs expérience, sample efficiency |
| Modèle du monde | Apprentissage tabulaire des transitions (s,a) -> (r,s’) |
| Dyna-Q | Q-Learning + planification sur expérience simulée (Sutton & Barto ch. 8) |
| Blocking Maze / Dyna-Q+ | Environnement changeant, bonus d’exploration kappa*sqrt(tau) |
| Decision-time planning | Rollouts, pont vers MCTS / AlphaZero / MuZero |
| Exercices | Shortcut Maze, prioritized sweeping, sensibilité de kappa |
Notebook 9 - RL offline : apprendre sans interagir
| Section | Contenu |
|---|---|
| Online vs offline | Apprendre d’un dataset figé de transitions (logs), sans interaction |
| Datasets | Trois politiques de comportement (expert/medium/random), couverture vs qualité |
| Behavior Cloning | Imitation tabulaire par action majoritaire, plafond de la politique de comportement |
| Erreur d’extrapolation | Q-learning naïf sur dataset figé : bootstrap sur actions fantômes (Fujimoto 2019) |
| BCQ-lite | Contrainte de support du dataset, stitching de trajectoires médiocres |
| Pont RLHF/DPO | SFT = BC, contrainte KL = contrainte de support, DPO = preference learning offline |
| Exercices | Ablation taille dataset, pénalité CQL-lite, sensibilité au nombre de passes |
Notebook 10 - Reward Shaping et Curriculum Learning
| Section | Contenu |
|---|---|
| Labyrinthe sparse | Maze 8x8, reward -1/pas et 0 au but, distance Manhattan = 14 |
| Potential-based shaping | Théorème Ng et al. 1999, \(F(s,s') = \gamma\Phi(s') - \Phi(s)\), politique invariante |
| Heuristic shaping | Bonus naïf pour se rapprocher du but, sans garantie théorique |
| Curriculum learning | Phases de difficulté croissante, start de plus en plus éloigné |
| Comparaison | Vitesse de convergence (potential : ep 50, curriculum : ep 122, baseline : ep 190) |
| Pont RLHF | Reward model appris, contrainte KL, DPO, inverse RL |
| Exercices | Ablation potentiels, phases curriculum, biais du shaping naïf |
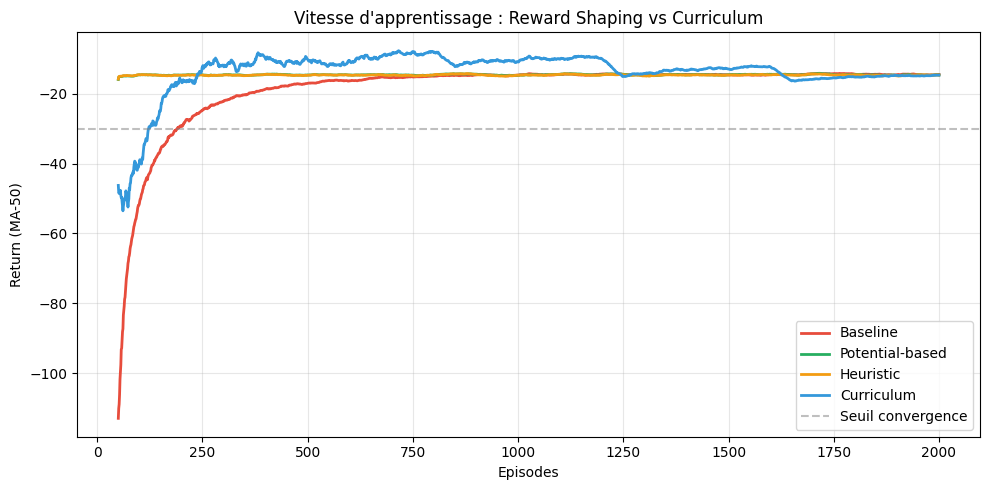
Sortie d’exécution du notebook 10 — potential-based et heuristique atteignent le seuil MA-50 ≥ -30 dès l’épisode 50, le curriculum à l’épisode 122, la baseline à l’épisode 190 (cellule Comparaison du notebook) ; les quatre courbes rejoignent ensuite le même plateau (~-15).
Notebook 11 - POMDP : Partial Observability et Belief Tracking
| Section | Contenu |
|---|---|
| Tiger Problem | POMDP classique (Cassandra 1994), 2 états, 3 actions, observations bruitées à 85% |
| Politiques baselines | Random, open immediately, listen N fois puis ouvre, vote majoritaire |
| Belief tracking | Filtre bayésien sur P(tiger-left), mise à jour après observation |
| Q-MDP approximation | Q-learning sur états vrais, sélection via expected Q sous belief |
| Belief-state Q-learning | Discrétisation du belief en 20 bins, Q-learning dans l’espace des croyances |
| Comparaison | 5 seeds, impact de la précision d’observation, pont DRQN/PPO+LSTM |
| Exercices | Impact précision, nombre optimal d’écoutes, Tiger 3 portes |
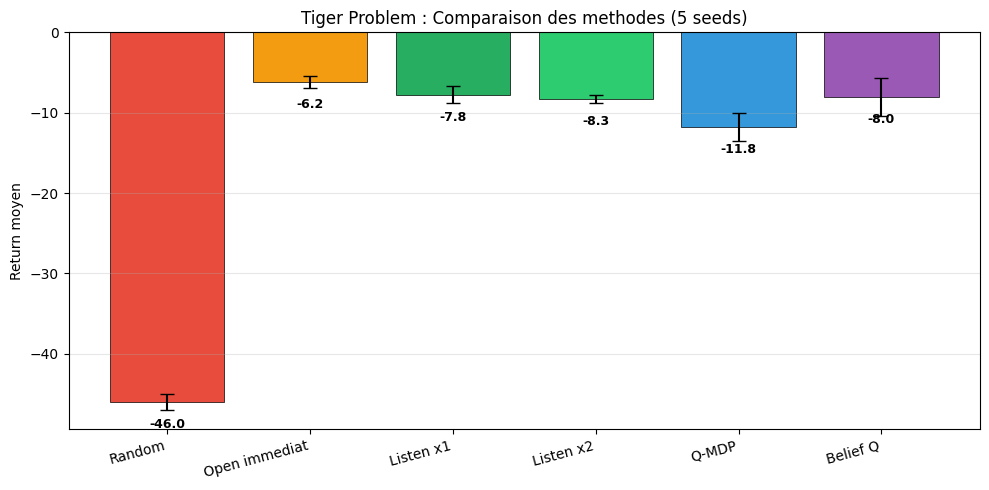
Sortie d’exécution du notebook 11 — récompense moyenne par méthode sur le Tiger Problem (5 seeds) : agir au hasard est catastrophique (-46.0), toutes les politiques informées — ouverture immédiate, écoutes fixes, Q-MDP, Q-Learning sur croyance discrétisée — se tiennent entre -6.2 et -11.8.
Notebook 12 - RL distributionnel : C51 (Categorical DQN)
| Section | Contenu |
|---|---|
| Du scalaire à la distribution | Pourquoi apprendre \(Z(s,a)\) tout entière plutôt que sa seule espérance \(Q = \mathbb{E}[Z]\) ; support catégoriel à 51 atomes fixes |
| Bellman distributionnel | Opérateur \(TZ = R + \gamma Z(s',a^*)\), problème du déplacement hors-grille, projection catégorielle \(\Phi\) |
Réseau CategoricalDQN |
Sorties softmax par action, reconstruction de \(Q(s,a) = \sum_i z_i p_i\) |
| Perte | Entropie croisée entre cible projetée et distribution prédite |
| Entraînement CartPole-v1 | ~18 000 pas, courbe d’apprentissage, visualisation de la distribution de retour apprise par action |
| C51 vs DQN | Tableau comparatif, lignée QR-DQN / IQN / Rainbow |
| Exercices | QR-DQN (quantile regression), sensibilité du support, politique sensible au risque (CVaR) |
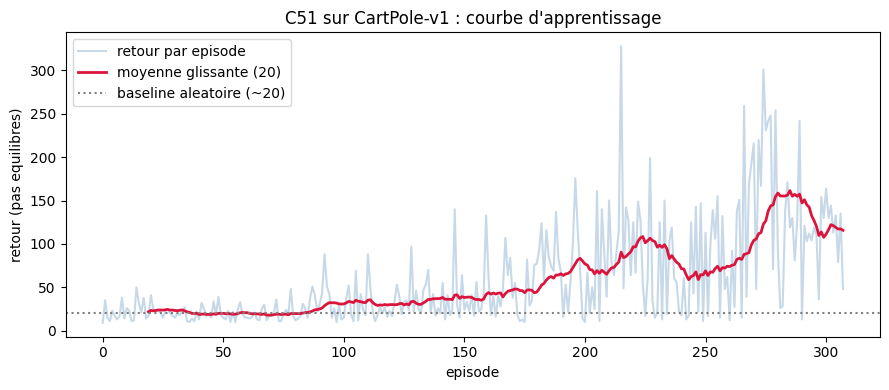
Sortie d’exécution du notebook 12 — l’agent C51 (Categorical DQN, 51 atomes) dépasse nettement la baseline aléatoire sur CartPole-v1 : la moyenne glissante monte jusqu’à ~160 sur cet entraînement court (~300 épisodes), sans atteindre le plafond de 500 de l’environnement.
Notebook 13 - Exploration par curiosité : Random Network Distillation (RND)
| Section | Contenu |
|---|---|
| Exploration profonde | Pourquoi l’aléa (epsilon-greedy) échoue dès que la récompense est parcimonieuse |
| Motivation intrinsèque | Bonus de nouveauté \(r = r^e + \beta\,r^i\), exploration dirigée vers l’inexploré |
| Mécanisme RND | Cible aléatoire figée + prédicteur entraîné ; erreur de prédiction = nouveauté (Burda et al. 2018) |
| Partie A - détecteur de nouveauté | Jouet 2D, carte de nouveauté, ratio inconnu/visité ~1969x |
| Partie B - piège d’exploitation | Chaîne MDP : epsilon-greedy plafonne sur le piège (~0.10), RND atteint la grande récompense (~0.96) |
| Comparaison | RND vs comptage tabulaire / pseudo-comptage / ICM, problème de la noisy-TV, réglage du taux du prédicteur |
| Exercices | Effet de beta, normalisation du bonus intrinsèque (Welford), limites de la curiosité (longueur de chaîne) |
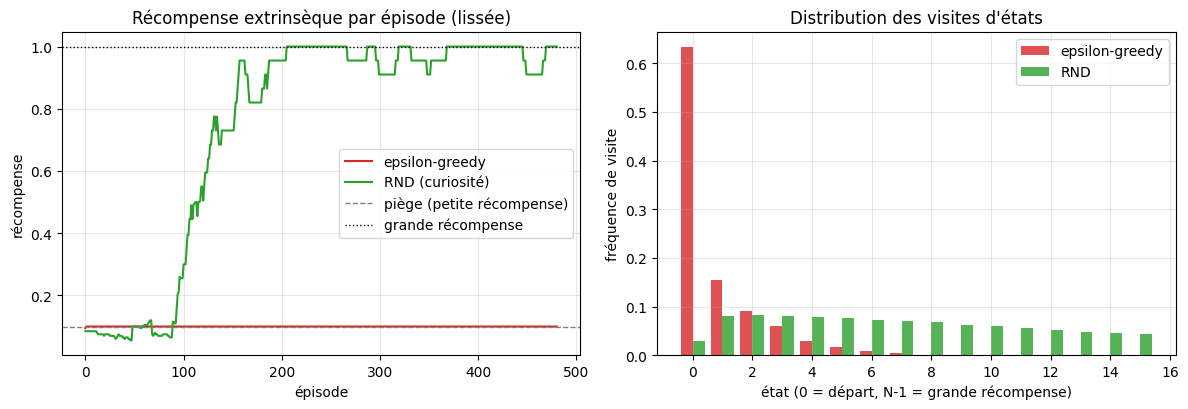
Sortie d’exécution du notebook 13 — exploration par curiosité sur le benchmark chaîne-piège (Burda et al. 2018) : RND atteint la grande récompense distale là où epsilon-greedy plafonne sur l’appât proximal. Le ratio inconnu/visité initial (~1969x) chute à mesure que le prédicteur RND est entraîné.
Algorithmes couverts
| Algorithme | Type | Notebook | Utilisation |
|---|---|---|---|
| PPO | On-policy | 1, 2, 6c | Contrôle général, robuste |
| A2C | On-policy | 2, 6b | Actor-Critic depuis zéro et via SB3 |
| GAE | Advantage | 6c | Generalized Advantage Estimation |
| SAC | Off-policy | 3, 6d | Actions continues, maximum entropy |
| GRPO | On-policy (critic-free) | 6e | Avantage relatif au groupe — l’algorithme RL de DeepSeek-R1, pont vers le RLHF |
| DDPG | Off-policy | 3 | Actions continues |
| HER | Replay strategy | 3 | Goal-conditioned tasks |
| Epsilon-greedy | Exploration | 4 | Stratégie d’exploration basique |
| Thompson Sampling | Exploration | 4 | Exploration bayésienne |
| Value Iteration | Model-based | 5 | Résolution exacte de MDP |
| Policy Iteration | Model-based | 5 | Résolution exacte de MDP |
| Q-Learning | Model-free (tabulaire) | 5 | Espaces discrets |
| Dyna-Q | Model-based | 8 | Planification sur modèle appris, sample efficiency |
| Dyna-Q+ | Model-based | 8 | Environnements non-stationnaires, bonus d’exploration |
| Rollout planning | Decision-time | 8 | Simulation vers l’avant, porte vers MCTS |
| Behavior Cloning | Offline (imitation) | 9 | Démonstrations expertes, baseline offline |
| BCQ-lite | Offline (value-based) | 9 | Q-learning contraint au support du dataset |
| Potential-based shaping | Reward shaping | 10 | Accélération convergence sans biais (Ng 1999) |
| Curriculum learning | Training strategy | 10 | Difficulté progressive, généralisation |
| Q-MDP | POMDP approximation | 11 | Q-learning sur états vrais, action via belief |
| Belief-state Q-learning | POMDP | 11 | Discrétisation du belief, Q-table dans l’espace des croyances |
| C51 (Categorical DQN) | Distributionnel (deep) | 12 | Distribution de retour sur support fixe, projection catégorielle |
| DQN | Off-policy (deep) | 6 | Espaces continus |
| REINFORCE | Policy gradient | 6 | Politique directe |
| IQL | Multi-agent | 7 | Apprentissage indépendant |
| RND | Exploration intrinsèque (deep) | 13 | Récompense parcimonieuse, exploration profonde par nouveauté |
Environnements
| Environnement | Type | Notebook |
|---|---|---|
| CartPole-v1 | Contrôle classique, discret | 1, 6, 6b, 6c |
| Pendulum-v1 | Contrôle continu | 2, 6d |
| Parking-v0 | Goal-conditioned, continu | 3 |
| GaussianBandit | Bandit stochastique | 4 |
| FrozenLake-v1 | Grille discrète, stochastique | 5 |
| CliffWalking-v1 | Grille, compromis risque/récompense | 5 |
| TicTacToe-v3 | Jeu à somme nulle | 7 |
| Dyna Maze / Blocking Maze | Grilles déterministes et changeantes (numpy pur) | 8, 9 |
| Portefeuille synthétique | Allocation d’actifs, auto-contenu (PyTorch pur, aucune donnée externe) | 6e |
Concepts clés
| Concept | Description | Notebook |
|---|---|---|
| Agent | Entité qui apprend et prend des décisions | 1 |
| Environnement | Monde avec lequel l’agent interagit | 1 |
| Reward | Signal de feedback pour l’apprentissage | 1 |
| Policy | Stratégie de l’agent (state vers action) | 1 |
| Value function | Estimation des rewards futurs | 5 |
| MDP | Formalisation mathématique du problème RL | 5 |
| Bellman equation | Relation de récurrence pour V et Q | 5 |
| Exploration vs exploitation | Compromis entre tester et exploiter | 4 |
| Regret | Mesure de performance cumulative en bandit | 4 |
| Thompson Sampling | Exploration bayésienne optimale | 4 |
| Experience replay | Réutilisation des expériences passées | 3, 6 |
| Clipped surrogate | Mécanisme central de PPO | 6c |
| GAE | Compromis biais-variance pour l’avantage | 6c |
| HER | Réinterprétation d’échecs comme succès | 3 |
| DQN | Q-Learning avec approximation neurale | 6 |
| Actor-Critic | Combinaison politique + valeur | 6b |
| Advantage | Réduction de variance A_t = R_t - V(s) | 6b |
| Maximum entropy RL | Maximisation récompense + entropie | 6d |
| SAC | Soft Actor-Critic, off-policy continu | 6d |
| Twin Q-networks | Double critique anti-surestimation | 6d |
| GRPO | Avantage relatif au groupe, sans critique — l’algorithme RLHF de DeepSeek-R1 | 6e |
| Policy gradient | Optimisation directe de la politique | 6 |
| Multi-agent | Plusieurs agents apprenant simultanément | 7 |
| Model-based RL | Apprendre un modèle du monde et planifier dessus | 8 |
| Dyna | Entrelacement apprentissage direct / planification | 8 |
| Sample efficiency | Échanger du calcul contre de l’expérience réelle | 8 |
| Decision-time planning | Rollouts et MCTS depuis l’état courant | 8 |
| RL offline | Apprendre d’un dataset figé, sans interaction | 9 |
| Erreur d’extrapolation | Bootstrap sur actions hors du support des données | 9 |
| Stitching | Recoudre un chemin optimal à partir de trajectoires médiocres | 9 |
| Reward shaping | Modifier le signal de récompense pour guider l’apprentissage | 10 |
| Potential-based shaping | Shaping garantissant l’invariance de la politique optimale (Ng 1999) | 10 |
| Curriculum learning | Présenter les tâches par difficulté croissante | 10 |
| POMDP | MDP avec observations partielles et bruitées | 11 |
| Belief state | Distribution de probabilité sur les états cachés | 11 |
| Belief tracking | Filtre bayésien pour mettre à jour le belief | 11 |
| RL distributionnel | Apprendre la distribution complète du retour \(Z(s,a)\), pas seulement \(\mathbb{E}[Z]\) | 12 |
| Projection catégorielle | Redistribuer la cible de Bellman sur un support à atomes fixes | 12 |
| Politique sensible au risque (CVaR) | Choisir selon la queue basse de la distribution, hors de portée d’un DQN scalaire | 12 |
| Motivation intrinsèque | Récompense de nouveauté pour guider l’exploration | 13 |
| Random Network Distillation | Erreur de prédiction d’une cible figée comme mesure de nouveauté | 13 |
| Exploration profonde | Atteindre une récompense cachée derrière une longue séquence d’actions | 13 |
Caractéristiques
- Compatible Windows : Pas de dépendance xvfb
- Débutant-friendly : Progression pédagogique
- Production-ready : Checkpointing, monitoring (notebooks 1-3)
- From scratch : Implémentations sans framework (granularité variable : tabulaire 4-5, deep PyTorch 6-6e, multi-agent 7, model-based 8, offline 9, shaping 10, belief tracker POMDP 11, distributional 12, curiosité 13)
- Exercices : Manipulations et explorations dans chaque notebook
FAQ
Quelle est la différence entre RL et apprentissage supervisé ?
L’apprentissage supervisé apprend à partir de données étiquetées (entrée -> sortie correcte). Le RL apprend par interaction : l’agent prend des actions, reçoit des récompenses/pénalités, et ajuste sa stratégie. Il n’y a pas de “bonne réponse” fournie — l’agent doit découvrir quelles actions maximisent la récompense cumulée. Le RL est pertinent quand le problème est séquentiel (une action affecte les futures observations).
Faut-il un GPU pour les notebooks ?
Non. Les notebooks 1-5 (SB3, wrappers, goal-conditioned, bandits, tabulaire) tournent sur CPU. Les notebooks deep from scratch (6 DQN/REINFORCE, 6b A2C, 6c PPO, 6d SAC, 6e GRPO, 8 Dyna-Q model-based, 9 BCQ offline, 10 reward shaping, 11 POMDP belief tracker, 12 C51 distributional, 13 RND curiosity) utilisent des réseaux volontairement compacts pour rester exécutables en CPU — un GPU accélère mais n’est pas requis. Environnements Atari (optionnel) : GPU recommandé.
Qu’est-ce qu’un MDP et pourquoi est-ce central ?
Un MDP (Markov Decision Process) est le modèle mathématique du RL : un ensemble d’états S, d’actions A, de transitions T(s’|s,a), de récompenses R(s,a), et d’un facteur d’actualisation gamma. Tout problème de RL se formalise comme un MDP. L’équation de Bellman (notebook 5) définit récursivement la valeur optimale. Si vous avez fait la série Probas, les MDP généralisent les chaînes de Markov avec des décisions.
Quelle est la différence entre on-policy et off-policy ?
On-policy (PPO, A2C, REINFORCE) : l’apprentissage utilise uniquement les données collectées par la politique courante. Plus stable mais moins sample-efficient. Off-policy (DQN, SAC, DDPG) : l’apprentissage peut réutiliser des données passées stockées dans un replay buffer. Plus sample-efficient mais potentiellement moins stable. Le notebook 6 compare DQN (off-policy) et REINFORCE (on-policy) sur le même environnement.
Pourquoi commencer par Stable Baselines3 plutôt que par les algorithmes from scratch ?
Stable Baselines3 permet de résoudre un problème réel en quelques lignes, ce qui donne une intuition concrète avant d’étudier la théorie. L’approche “framework d’abord, maths ensuite” évite le piège de la théorie abstraite sans application. Les notebooks suivants (4 à 13) déconstruisent ensuite les mêmes algorithmes depuis zéro pour comprendre ce qui se passe sous le capot.
Quelle est la différence entre value-based et policy-based ?
Value-based (Q-Learning, DQN) : on apprend à estimer la valeur de chaque action dans chaque état, puis on choisit l’action avec la plus haute valeur. Adapté aux espaces d’actions discrets. Policy-based (REINFORCE, PPO) : on optimise directement la politique (probabilité de choisir chaque action). Adapté aux espaces continus et aux politiques stochastiques. Actor-Critic (A2C, SAC) combine les deux : l’acteur choisit l’action, le critique estime la valeur.
Qu’est-ce que l’expérience replay et pourquoi est-ce important ?
L’expérience replay (notebook 6) stocke les transitions (état, action, reward, état_suivant) dans un buffer et ré-échantillonne aléatoirement pendant l’apprentissage. Cela casse les corrélations temporelles entre expériences consécutives et améliore l’efficacité en réutilisant chaque expérience plusieurs fois. Sans replay buffer, les agents off-policy comme DQN seraient instables. HER (notebook 3) étend ce concept en ré-interprétant les échecs comme des succès par changement d’objectif.
Ressources
Documentation
Théorie RL
- Sutton & Barto - Reinforcement Learning: An Introduction (2nd ed.)
- Spinning Up in Deep RL
- Mnih et al. (2015) - Human-level control through deep reinforcement learning, Nature
Structure des fichiers
RL/
├── rl_1_intro_cartpole.ipynb
├── rl_1b_bitwise_logic_synthesis.ipynb
├── rl_1c_prolog_distillation.ipynb
├── rl_2_wrappers_sauvegarde_callbacks.ipynb
├── rl_3_experience_replay_her.ipynb
├── rl_4_multi_armed_bandits.ipynb
├── rl_5_mdp_dp_qlearning.ipynb
├── rl_6_dqn_policy_gradient.ipynb
├── rl_6b_actor_critic.ipynb
├── rl_6c_ppo_from_scratch.ipynb
├── rl_6d_sac_from_scratch.ipynb
├── rl_6e_grpo_from_scratch.ipynb
├── rl_7_multi_agent_rl.ipynb
├── RL-7b-Climbing-Game.ipynb
├── rl_8_model_based_dyna_q.ipynb
├── rl_9_offline_rl.ipynb
├── rl_10_reward_shaping.ipynb
├── rl_11_pomdp.ipynb
├── rl_12_distributional_rl.ipynb
├── rl_13_curiosity_exploration.ipynb
├── rl_14_hierarchical_rl.ipynb
├── rl_15_grpo_group_relative_policy.ipynb
├── rl_16_dream_rsi.ipynb
├── rl_17_k_server_wfa.ipynb
├── rl_18_matroid_secretary.ipynb
├── rl_19_reward_tampering.ipynb
├── rlpt_0_reward_model_from_scratch.ipynb
├── rlpt_0b_preference_dataset_bias.ipynb
├── rlpt_0c_reward_hacking_case_study.ipynb
├── rlpt_0d_reward_trainer_sota.ipynb
├── rlpt_0e_trl_DPO_SOTA.ipynb
├── rlpt_0f_comparaison_GRPO_TRL_et_PPO_maison.ipynb
├── rlpt_1_ppo_lm_rlhf.ipynb
├── rlpt_2_grpo_minimal.ipynb
├── rlpt_3_reward_hacking.ipynb
├── rlpt_4_dpo_vs_ppo.ipynb
└── README.md
Activités associées
L’activité Processus de décision de Markov de l’aspirateur autonome fait lire des politiques optimales sur un grid world bruité, en jeu d’équipe.
Conclusion / Prochaines étapes
Ce que vous avez appris
Cette série vous a fait traverser le paradigme d’apprentissage qui distingue l’IA décisionnelle : là où l’apprentissage supervisé prédit à partir d’exemples étiquetés et l’non supervisé découvre des structures, le reinforcement learning agit — il choisit des actions, observe leurs conséquences, et s’améliore itérativement par essai et erreur. L’arc pédagogique :
- Le geste fondateur — formaliser un problème de décision séquentielle comme un MDP
(S, A, P, R, γ)et le résoudre par l’équation de Bellman, qui définit récursivement la valeur optimale. Cette formalisation est le socle commun : sans elle, pas de Value Iteration, pas de Q-Learning, pas de DQN. Le bandit (notebook 4) en est le cas le plus simple — le compromis exploration/exploitation à un seul pas de temps. - La double approche, délibérément juxtaposée — framework d’abord, maths ensuite. Vous commencez par entraîner un agent PPO en quelques lignes avec Stable Baselines3 (notebooks 1-3, production-ready), puis vous déconstruisez les mêmes algorithmes from scratch (notebooks 4 à 13, du tabulaire NumPy au deep PyTorch) pour comprendre ce qui se cache sous le capot. Cette pédagogie évite le double piège : la théorie abstraite sans application, et l’usage boîte noire sans compréhension.
- L’instrument — Stable Baselines3 pour la production (PPO, SAC, HER), PyTorch pur pour l’implémentation pédagogique (DQN, REINFORCE, A2C, PPO, SAC depuis zéro), Gymnasium comme interface d’environnements standard, PettingZoo pour le multi-agent.
- La finesse — les compromis cartographiés qui structurent tout le champ : on-policy (PPO/A2C, stable mais moins économe) vs off-policy (DQN/SAC, sample-efficient mais plus fragile) ; value-based (DQN) vs policy-based (REINFORCE) vs actor-critic (A2C/SAC) ; model-free (Q-Learning) vs model-based (Dyna-Q, pont vers MCTS/AlphaZero/MuZero) ; online vs offline (Behavior Cloning, BCQ-lite, pont vers RLHF/DPO). Et les subtilités qui changent la pratique : l’expérience replay et le target network qui stabilisent DQN, le clipped surrogate de PPO, le maximum entropy de SAC, le potential-based shaping (Ng 1999) qui accélère sans biaiser.
La thèse est puissante et honnêtement présentée : le RL n’a pas d’algorithme universel, mais une famille de méthodes aux compromis clairement nommés, et la compétence de l’ingénieur est de savoir choisir dans cette famille selon la nature du problème (espace d’actions, besoin de stabilité vs efficacité, accès à l’interaction, observabilité) — voire de combiner (Actor-Critic, model-based + RL, offline + contraintes).
Prochaines étapes
- Approfondir la théorie : le livre de référence Sutton & Barto — Reinforcement Learning: An Introduction (2nd ed.) et Spinning Up in Deep RL d’OpenAI sont les prolongements naturels des fondements posés ici ; Mnih et al. (2015, Human-level control through deep RL, Nature) est le papier fondateur du DQN moderne.
- Élargir aux jeux et à la recherche : Search (Minimax, MCTS) et GameTheory reprennent la recherche adversariale ; le notebook Search-7 (MCTS-And-Beyond) fait explicitement le pont AlphaGo (MCTS + DQN), et le multi-agent RL (notebook 7) rejoint la théorie des jeux.
- Franchir le cap production : les notebooks 1-3 (Stable Baselines3, wrappers, callbacks, multiprocessing) donnent les outils d’un pipeline RL industriel ; le notebook 9 (offline RL) et le notebook 10 (reward shaping) ouvrent sur le RLHF/DPO, le pont majeur entre RL et LLMs modernes — dont la réalisation concrète sur de vrais modèles vit dans les séries GenAI / PostTraining (chaîne SFT → RLHF → DPO → GRPO → RLVR) et GenAI / FineTuning (DPO en pratique).
- Pour la pratique : reprenez le notebook 6c (PPO from scratch) et comparez-le au PPO de SB3 du notebook 1 — quels hyperparamètres SB3 ajuste-t-il pour vous, et où votre implémentation naïve diverge-t-elle ? C’est le meilleur moyen de saisir la valeur ajoutée d’un framework de production.
Le fil rouge
Le reinforcement learning propose un changement de regard sur l’apprentissage : ne plus demander « quelle est la bonne réponse ? » mais « quelle action maximise la récompense cumulée, sachant qu’elle détermine les états futurs ? ». La série vous a donné le formalisme (MDP, équation de Bellman), les algorithmes (du bandit à SAC, du tabulaire au deep, du online à l’offline), et l’intuition des compromis pour transformer un problème de décision séquentielle en une politique apprise — en gardant à l’esprit que ce paradigme, de AlphaGo aux LLMs alignés par RLHF, est devenu l’un des deux piliers (avec l’apprentissage supervisé) de l’IA contemporaine.
Où atterrit le « pont RLHF » : les séries GenAI
Plusieurs notebooks de cette série annoncent un « pont RLHF » (notebook 9 sur l’offline RL, notebook 10 sur le reward shaping). Ce pont atterrit concrètement dans deux séries GenAI, qui appliquent ces fondations RL à de vrais modèles de langue. La série RL fournit l’algorithmique tabulaire ; GenAI fournit la réalisation à l’échelle des LLM.
| Concept RL (cette série) | Réalisation côté LLM (GenAI) |
|---|---|
| Behavior Cloning = imitation (rl_9) | SFT — PostTraining PT-02, FineTuning FT-03 |
| Contrainte de support BCQ = pénalité KL (rl_9) | KL vers le modèle de référence dans PPO-RLHF / DPO — PT-03 |
| Reward shaping = guider via le signal (rl_10) | Reward model appris à partir de préférences — FineTuning FT-04 |
| Biais du shaping naïf = reward hacking (rl_10) | Goodhart / overoptimisation du reward model — PT-07 |
| Policy gradient / PPO (rl_6c) | PPO-RLHF et son successeur GRPO — PT-04 |
| MDP, value/Q (rl_5) | Socle policy/value réutilisé par tout post-training — GenAI/PostTraining |
En résumé : DPO (Direct Preference Optimization) est l’aboutissement direct de la ligne offline RL + contrainte de support + preference learning tracée par les notebooks 9 et 10. Pour le voir tourner sur de vrais LLM, suivre GenAI/PostTraining puis GenAI/FineTuning.
Licence
Voir la licence du repository principal.
Version 1.2.0 — Juillet 2026
Comment choisir entre DQN et PPO pour un nouveau problème ?