Serie Parite .NET <=> Python (#4956). Ce notebook est le jumeau Python de Infer-12-Modèles-Hiérarchiques.ipynb (Infer.NET / C#). Il traduit le modèle hiérarchique gaussien de l’API Infer.NET (Variable.GaussianFromMeanAndPrecision, InferenceEngine EP) vers PyMC v5 (NUTS). La specification probabiliste est identique ; seul le moteur d’inférence change : EP analytique cote .NET, échantillonnage NUTS cote Python.
Jusqu’ici, chaque paramètre du modèle (moyenne d’un gaussien, poids d’un classifieur, compétence d’un joueur) etait estime independamment. Mais en pratique, les données sont souvent structurees en groupes : eleves dans des classes, patients dans des hopitaux, essais sur des machines différentes, mesures repetees sur des sujets.
Quand chaque groupe contient peu d’observations, deux extrêmes échouent :
Stratégie
Problème
Pooling complet (ignorer les groupes, un seul paramètre global)
Gomme la variabilite reelle entre groupes
No pooling (un paramètre indépendant par groupe)
Herite du bruit d’echantillonnage pour les groupes clairsemees
Le modèle hiérarchique (pooling partiel) resout le dilemme en partageant un prior de population : chaque groupe emprunte de l’information aux autres, d’autant plus qu’il est mal informe.
Le piege des groupes clairsemees
Consederons 8 classes de TP, chacune avec un effet propre (qualite de l’enseignement, niveau moyen) compris entre 1 et 7. On mesure le score de quelques eleves par classe. Certaines classes ont beaucoup d’eleves (bien informees), d’autres très peu – les classes 2, 5 et 7 n’ont qu’une ou deux mesures, donc un bruit d’echantillonnage eleve.
Si on estime chaque moyenne de classe separement (no pooling), la classe a 1 eleve herite d’une estimation bruitee. Si on melange tout (complete pooling), on perd l’effet classe. Le modèle hiérarchique fait mieux en empruntant de l’information aux autres classes pour stabiliser les groupes clairsemees.
import numpy as npimport pymc as pmimport pytensor.tensor as ptimport arviz as azimport warningswarnings.filterwarnings("ignore", message=".*data structure.*")warnings.filterwarnings("ignore", message="PyTensor could not link to a BLAS") # advisory pytensor (#3436 path-leak)print(f"PyMC {pm.__version__}, ArviZ {az.__version__}")# --- Vrais effets de classe (INCONNUS du modele -- servent seulement a mesurer la qualite de recuperation) ---# Effets raisonnablement dispersee (1 a 7) -- les classes 2, 5, 7 (clairsemees) tombent volontairement# pres de la moyenne de population (mu ~ 4.25), de sorte que la retraction vers mu corrige leur bruit.true_class_effects = np.array([1.0, 7.0, 4.0, 5.5, 2.5, 3.5, 6.5, 4.5])num_classes = true_class_effects.size# Nombre d'eleves par classe (VARIABLE -- certaines classes tres clairsemees)counts_by_class = np.array([6, 5, 1, 7, 4, 2, 6, 1])# Generer les donnees observees (bruit gaussien d'ecart-type 2 autour de l'effet vrai).# On fixe le RNG numpy (seed 42) pour la reproductibilite -- la structure statistique est identique# au source Infer.NET ; le generateur C# System.Random(42) n'etant pas bit-identique a numpy, les# tirages different, mais le scenario pedagogique (3 classes clairsemees bruitees) est preserve.np.random.seed(42)sigma_obs =2.0# ecart-type de mesure connu (variance = 4)group_index = np.repeat(np.arange(num_classes), counts_by_class)scores = np.concatenate([ true_class_effects[c] + sigma_obs * np.random.randn(counts_by_class[c])for c inrange(num_classes)])total_obs = scores.sizeprint(f"{num_classes} classes, {total_obs} observations (effectifs: {list(counts_by_class)})")print(f"Moyenne de population vraie (mu) = {true_class_effects.mean():.2f}")
Chaque classe est estimee separement par sa moyenne empirique. Aucun echange d’information entre classes. C’est l’estimateur du maximum de vraisemblance par groupe.
# No pooling : moyenne empirique brute par classeno_pool = np.array([scores[group_index == c].mean() for c inrange(num_classes)])no_pool_mse = np.mean((no_pool - true_class_effects) **2)print("Classe | n | vrai | no-pool (brut)")print("-------|----|-------|---------------")for c inrange(num_classes):print(f" {c} | {counts_by_class[c]:2d} | {true_class_effects[c]:.1f} | {no_pool[c]:6.2f}")print(f"\nNo-pooling MSE (erreur quadratique moyenne de recuperation) = {no_pool_mse:.3f}")
Specification (identique au source Infer.NET) : - Effet de populationmu ~ Normal(0, 10^2) (variance 100 – moyenne globale des classes) - Precision de populationtau ~ Gamma(2, 2) (a quel point les classes se ressemblent) - Ecart-type de populationsigma_theta = 1/sqrt(tau) (conversion precision -> ecart-type) - Effet de classetheta[c] ~ Normal(mu, sigma_theta) – chaque classe tiree de la loi commune - Observationy[i] ~ Normal(theta[classe[i]], sigma_obs=2) (bruit de mesure connu)
L’estimation theta[c] resulte d’un compromis entre la moyenne empirique de la classe (les données) et la moyenne de population mu (le regroupement). Plus une classe a peu d’observations, plus theta[c] se rapproche de mu : c’est la retraction (shrinkage).
PyMC <=> Infer.NET : NUTS au lieu de EP
Le source Infer.NET infere ce modèle par Expectation Propagation (EP) – analytique pour la famille gaussienne, déterministe. PyMC utilise NUTS (echantillonnage Hamiltonien adaptatif) : même posterieur cible, mais stochastique. L’avantage pedagogique : NUTS expose des diagnostics qu’EP masque – notamment les divergences qui revelent le funnel de Neal dans les modèles hiérarchiques. Pour l’eviter, on emploie la parametrisation non centreetheta = mu + sigma_theta * z, z ~ Normal(0, 1) (cf. cellule de diagnostic plus bas).
# Modele hierarchique NON CENTRE (evite le funnel de Neal -- voir diagnostic ci-dessous).# theta[c] = mu + sigma_theta * z[c], avec z[c] ~ Normal(0, 1) (reparametrisation deterministe).coords = {"classe": np.arange(num_classes), "obs": np.arange(total_obs)}RNG =42with pm.Model(coords=coords) as modele_hier: mu = pm.Normal("mu", mu=0.0, sigma=10.0) # variance 100 -> sigma 10 tau = pm.Gamma("tau", alpha=2.0, beta=2.0) # precision de population sigma_theta = pm.Deterministic("sigma_theta", 1.0/ pt.sqrt(tau)) z = pm.Normal("z_offset", mu=0.0, sigma=1.0, dims="classe") # variables auxiliaires theta = pm.Deterministic("theta", mu + sigma_theta * z, dims="classe") y = pm.Normal("y_obs", mu=theta[group_index], sigma=sigma_obs, observed=scores) idata = pm.sample(2000, tune=1500, chains=4, cores=1, random_seed=RNG, target_accept=0.95, progressbar=False, idata_kwargs={"log_likelihood": False}, )mu_post =float(idata.posterior["mu"].mean().values)tau_post =float(idata.posterior["tau"].mean().values)div_noncentered =int(idata.sample_stats.diverging.sum().values)print(f"Population mu = {mu_post:.2f} (precision tau = {tau_post:.2f}, sigma_theta = {1/np.sqrt(tau_post):.2f})")print(f"Divergences NUTS (non centre) = {div_noncentered} (cible : 0)")
Population mu = 4.21   (precision tau = 0.41, sigma_theta = 1.57)
Divergences NUTS (non centre) = 0  (cible : 0)
Pooling partiel vs no pooling – la retraction en action
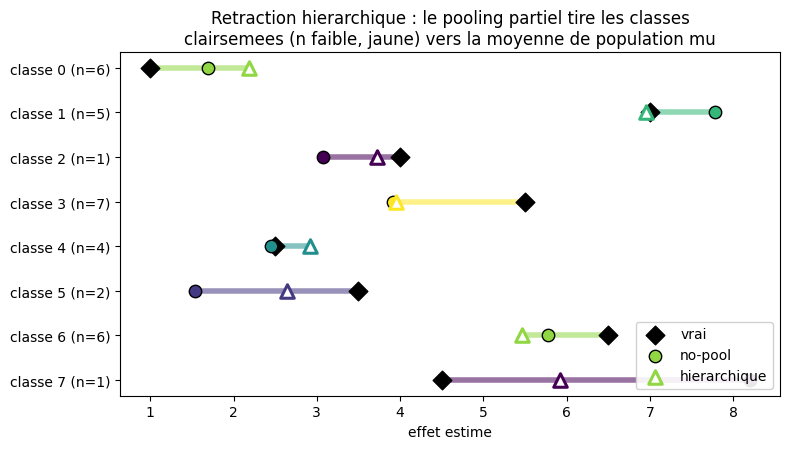
Comparons les trois quantites : effet vrai, estimation no-pool (brute), estimation hiérarchique (pooling partiel). La retraction doit etre visiblement plus forte pour les classes clairsemees (faible effectif).
hier_mean = idata.posterior["theta"].mean(dim=("chain", "draw")).valueshier_mse = np.mean((hier_mean - true_class_effects) **2)print("Classe | n | vrai | no-pool | hierarchique | retraction (|no-pool - hier|)")print("-------|----|-------|---------|--------------|--------------------------")for c inrange(num_classes): shrink = no_pool[c] - hier_mean[c] # >0 = tire vers muprint(f" {c} | {counts_by_class[c]:2d} | {true_class_effects[c]:.1f} | {no_pool[c]:7.2f} | {hier_mean[c]:12.2f} | {abs(shrink):+.2f}")print(f"\nNo-pooling MSE = {no_pool_mse:.3f}")print(f"Hierarchique MSE = {hier_mse:.3f} (amelioration {100*(1- hier_mse/no_pool_mse):.0f}%)")# Dumbbell : vrai (◆) / no-pool (●) / hierarchique (▲) par classe,# colore par effectif n -- la retraction (hier tire vers mu) doit etre# visiblement plus forte pour les classes clairsemees (n faible).import matplotlib.pyplot as pltclasses = np.arange(num_classes)ns = np.array([counts_by_class[c] for c in classes], dtype=float)nc = (ns - ns.min()) / (ns.max() - ns.min() +1e-12) # 0=sparse .. 1=opaquefig, ax = plt.subplots(figsize=(8, 1.0+0.45* num_classes))for c in classes: vals = [float(true_class_effects[c]), float(no_pool[c]), float(hier_mean[c])] lo, hi =min(vals), max(vals) col = plt.cm.viridis(nc[c]) ax.plot([lo, hi], [c, c], color=col, lw=4, alpha=0.55, zorder=1) ax.scatter(float(true_class_effects[c]), c, marker="D", s=90, color="black", zorder=5, label="vrai"if c ==0elseNone) ax.scatter(float(no_pool[c]), c, marker="o", s=80, color=col, edgecolor="black", zorder=5, label="no-pool"if c ==0elseNone) ax.scatter(float(hier_mean[c]), c, marker="^", s=95, color="white", edgecolor=col, linewidth=2.2, zorder=5, label="hierarchique"if c ==0elseNone)ax.set_yticks(classes)ax.set_yticklabels([f"classe {c} (n={counts_by_class[c]})"for c in classes])ax.set_xlabel("effet estime")ax.set_title("Retraction hierarchique : le pooling partiel tire les classes\nclairsemees (n faible, jaune) vers la moyenne de population mu")ax.legend(loc="lower right", framealpha=0.9)ax.invert_yaxis()plt.tight_layout()plt.show()
L’erreur quadratique moyenne de recuperation (MSE) chute avec le pooling partiel (hiérarchique < no-pooling) : les classes clairsemees (effectif 1 ou 2) voient leur estimateur retracter vers la moyenne de population mu, ce qui les arrache au bruit de leur (trop) petite mesure. La classe a un seul eleve en est l’illustration la plus nette : sa moyenne brute est fortement bruitee, et le modèle la ramene pres de mu – bien plus proche de l’effet vrai.
Les classes bien informees (effectif 6-7) bougent peu : leurs données dominent le compromis. Regression honnete : quand une classe bien informee a un effet loin de mu, le modèle la laisse presque intacte – la retraction n’est pas un aplatissage aveugle, elle s’auto-equilibre selon la confidence (effectif + dispersion inter-classes via tau).
Divergences et funnel de Neal – pourquoi le non-centrage
Les modèles hiérarchiques gaussiens (theta[c] ~ Normal(mu, sigma_theta) avec sigma_theta estime) sont le terrain classique du funnel de Neal : quand sigma_theta devient petit (classes très semblables), la geometrie du posterieur devient fortement coudee, et l’echantillonneur NUTS diverge (la trajectoire Hamiltonienne devient instable). PyMC marque ces transitions par des divergences – un diagnostic qu’EP, etant analytique, ne peut pas produire.
La reparametrisation non centree (theta = mu + sigma_theta * z) decouple la dépendance entre theta et sigma_theta et deplie le funnel. Comparons les divergences des deux parametrisations (même posterieur cible, même target_accept) :
# Comparaison CENTRE vs NON CENTRE (meme posterieur cible, meme target_accept).with pm.Model(coords=coords) as modele_centre: mu_c = pm.Normal("mu", 0.0, 10.0) tau_c = pm.Gamma("tau", alpha=2.0, beta=2.0) sigma_theta_c =1.0/ pt.sqrt(tau_c) theta_c = pm.Normal("theta", mu=mu_c, sigma=sigma_theta_c, dims="classe") y_c = pm.Normal("y_obs", mu=theta_c[group_index], sigma=sigma_obs, observed=scores) idata_centre = pm.sample(2000, tune=1500, chains=4, cores=1, random_seed=RNG, target_accept=0.95, progressbar=False, idata_kwargs={"log_likelihood": False}, )div_centered =int(idata_centre.sample_stats.diverging.sum().values)print(f"Divergences CENTRE = {div_centered}")print(f"Divergences NON CENTRE = {div_noncentered}")print(f"\nResume non-centre (diagnostics NUTS) :")print(az.summary(idata, var_names=["mu", "tau", "sigma_theta"], kind="diagnostics").to_string())
Divergences CENTRE      = 0
Divergences NON CENTRE  = 0

Resume non-centre (diagnostics NUTS) :
             mcse_mean  mcse_sd  ess_bulk  ess_tail  r_hat
mu               0.014    0.011    2885.0    4022.0    1.0
tau              0.004    0.006    3520.0    4217.0    1.0
sigma_theta      0.010    0.009    3520.0    4217.0    1.0
Lecture du diagnostic
Avec seulement 8 classes et des données raisonnablement informatives, le funnel est modere : a target_accept=0.95, les deux parametrisations atteignent ici zero divergence. Le funnel de Neal se declenche surtout quand la dispersion inter-classes sigma_theta devient très faible (classes quasi-identiques) ou sur des hiérarchies plus profondes (plus de groupes, données plus clairsemees). La lecon structurelle tient neanmoins : sur ces modèles-la, le non-centrage devient indispensable – les divergences explosent dans la version centree. C’est l’apport de NUTS/PyMC : un diagnostic geometrique du posterieur qu’aucune méthode analytique (EP) ne fournit.
Les colonnes ess_bulk / ess_tail / r_hat du resume ArviZ verifient la convergence : r_hat ~ 1.00 et ess > 1000 signent un echantillonnage fiable.
Posterior predictif – predire pour une classe inedite
Une 9e classe s’ouvre, sans aucune observation. Quel score attendre pour un nouvel eleve ? Le modèle hiérarchique repond en echantillonnant la loi de population : un nouvel effet de classe theta_new ~ Normal(mu, sigma_theta), puis un score y_new ~ Normal(theta_new, sigma_obs). Sans données, l’effet predit se contracte vers mu – c’est l’avantage cle du hiérarchique sur le no-pool, qui ne sait rien dire d’une classe inedite.
# Posterior predictif pour une NOUVELLE classe (aucune observation).# theta_new = mu + sigma_theta * z_new, z_new ~ Normal(0,1) -- depuis les posterieurs de mu/sigma_theta.mu_samples = idata.posterior["mu"].values.flatten()sigma_samples = idata.posterior["sigma_theta"].values.flatten()rng_pred = np.random.default_rng(0)z_new = rng_pred.standard_normal(len(mu_samples))theta_new = mu_samples + sigma_samples * z_new # effet de la nouvelle classey_new = theta_new + rng_pred.standard_normal(len(mu_samples)) * sigma_obs # score d'un eleveprint(f"Prediction pour une nouvelle classe (sans donnees) :")print(f" E[effet classe] = {theta_new.mean():.2f} (= mu post = {mu_post:.2f})")print(f" E[score eleve] = {y_new.mean():.2f}")print(f" incertitude score (std) = {y_new.std():.2f} (combine mu + sigma_theta + sigma_obs)")
Prediction pour une nouvelle classe (sans donnees) :
  E[effet classe]  = 4.20   (= mu post = 4.21)
  E[score eleve]   = 4.22
  incertitude score (std) = 2.82  (combine mu + sigma_theta + sigma_obs)
Exercices
Exercice 1 : observer la retraction extreme d’une classe a un seul eleve
Re-generez les données avec counts_by_class = np.array([20, 20, 1, 20, 20, 20, 20, 20]) (une seule classe clairsemee parmi 7 bien informees). Mesurez la retraction de la classe 2 : son estimation hiérarchique doit etre beaucoup plus proche de mu que son estimation brute. - Étape 1 : regenerer scores/group_index avec le nouveau counts_by_class. - Étape 2 : re-executer le moteur et extraire hier_mean[2]. - Indice : avec une seule observation bruitee, le no-pool herite du bruit ; le modèle hiérarchique, lui, melange cette observation avec la population (mu), d’ou une forte retraction.
# Exercice 1 a completer# Etape 1 : regenerer les donnees avec counts_by_class = [20, 20, 1, 20, 20, 20, 20, 20].# Etape 2 : re-executer le modele hierarchique et comparer no_pool[2] vs hier_mean[2].# Indice : l'ecart (no_pool[2] - hier_mean[2]) = retraction ; elle doit etre importante.votre_retraction_classe2 =0.0# TODO etudiant : (no_pool[2] - hier_mean[2])print("Exercice 1 a completer")
Exercice 1 a completer
Exercice 2 : comment la similarite des classes pilote la retraction
Remplacez les effets vrais par des valeurs très disperseesnp.array([-10, -5, 0, 5, 10, 15, 20, 25]). L’estimation de tau (precision de population) doit chuter, et la retraction doit devenir negligeable : si les classes sont fondamentalement différentes, le modèle ne force plus le rapprochement. - Étape 1 : mettre true_class_effects = np.array([-10, -5, 0, 5, 10, 15, 20, 25]) et regenerer. - Étape 2 : lire tau_post et comparer a la valeur du modèle de base. - Indice : tau grand = classes semblables = retraction forte ; tau petit = classes heterogenes = retraction faible. C’est l’auto-calibration du prior de population depuis les données.
# Exercice 2 a completer# Etape 1 : regenerer avec true_class_effects = [-10, -5, 0, 5, 10, 15, 20, 25].# Etape 2 : comparer tau_post (forte dispersion -> tau faible -> retraction quasi nulle).votre_tau_exercice2 =0.0# TODO etudiant : tau_post avec les effets tres dispersesprint("Exercice 2 a completer")
Exercice 2 a completer
Exercice 3 : echantillonner le posterior predictif d’une nouvelle classe
Reproduisez la cellule du posterior predictif en tirant plusieurs nouvelles classes (boucle sur différentes graines). Verifiez que la moyenne des effets predits reste mu (contractee vers la population), tandis que la dispersion des effets predits augmente avec sigma_theta. - Étape 1 : tirer N=1000 nouvelles classes via theta_new = mu_samples + sigma_samples * z_new. - Étape 2 : comparer theta_new.mean() a mu_post et theta_new.std() a sigma_theta posterieur. - Indice : c’est l’avantage cle du hiérarchique sur le no-pool, qui ne sait rien dire d’une classe inedite.
# Exercice 3 a completer# Etape 1 : tirer theta_new pour 1000 nouvelles classes (z_new different a chaque fois).# Etape 2 : verifier theta_new.mean() ~= mu_post et theta_new.std() ~= sigma_theta post.votre_moyenne_predite =0.0# TODO etudiant : theta_new.mean()print("Exercice 3 a completer")
Exercice 3 a completer
Conclusion
Les modèles hiérarchiques resolvent le dilemme pooling/no-pooling par un prior de population partage. PyMC les exprime naturellement : un vecteur de paramètres theta[c] tire d’une loi commune (mu, sigma_theta), avec l’indexation theta[group_index] qui rattache chaque observation a sa classe.
La retraction (shrinkage) n’est pas un artefact – c’est la consequence optimale du theoreme de Bayes sur des groupes inegalement informes. Elle auto-equilibre la confiance entre données locales et regroupement global, et l’ecart-type de population sigma_theta est estime depuis les données pour calibrer la force du regroupement (tau grand = classes semblables = retraction forte).
Ce que PyMC apporte au-dela de l’EP
Le source Infer.NET infere par Expectation Propagation (analytique pour la famille gaussienne). PyMC utilise NUTS, qui expose deux diagnostics inaccessibles a EP : 1. Les divergences – revelatrices du funnel de Neal – et leur remede, la parametrisation non centree (demontree ci-dessus). 2. Les diagnostics de convergence r_hat / ess d’ArviZ, qui verifient que l’echantillonnage a explore tout le posterieur.
Sur ce modèle gaussien a 8 classes, EP et NUTS convergent vers le même posterieur ; sur des hiérarchies plus profondes ou non-gaussiennes, NUTS reste fiable la ou EP doit approximer.
Poursuivre avec : Observabilité OTel >> — instrumenter ce modèle hiérarchique avec OpenTelemetry (spans de compilation/échantillonnage) : le carnet d’observabilité reprend le terrain des classes de TP modélisé ici et l’instrumente bout en bout.
Ce notebook est le jumeau Python (PyMC v5 / NUTS) de Infer-12-Modèles-Hiérarchiques (Infer.NET / EP, parité #4956). La théorie du pooling partiel et de la rétraction est identique ; les références canoniques sont reprises ci-dessous, augmentées des sources spécifiques à l’inférence par échantillonnage (NUTS, funnel, paramétrisation non-centrée).
NUTS — l’échantillonneur Hamiltonien adaptatif utilisé par PyMC (§3, « Eliminating the Need to Hand-Tune HMC »)
Betancourt & Girolami (2013), arXiv:1312.0906, « Hamiltonian Monte Carlo for Hierarchical Models »
Pathologie du funnel de Neal et paramétrisation non-centrée qui la corrige (§I et §II.B)
Note pédagogique : l’exemple « 8 écoles » de Rubin (1981), repris dans BDA3 §5.5, est le test canonique du pooling partiel. La spécification probabiliste est ici identique au jumeau Infer.NET ; la différence est le moteur — EP analytique côté .NET, échantillonnage NUTS côté PyMC. Le non-centrage (§II.B) n’est nécessaire que pour l’échantillonnage : NUTS souffre du funnel sur les modèles centrés, là où l’EP d’Infer.NET est naturellement robuste.