Duree estimee : 45 minutes Objectifs : - Implementer un modèle de classification binaire (probit) - Equivalence avec la Bayes Point Machine d’Infer.NET - Realiser des tests A/B avec PyMC - Comprendre l’impact de la taille d’echantillon - Appliquer au CTR (Click-Through Rate)
Prerequis : PyMC-1 a PyMC-4, statistiques (loi binomiale, test d’hypothese)
try:import numpy as np NUMPY_AVAILABLE =TrueexceptImportError: NUMPY_AVAILABLE =Falsetry:import pymc as pm PYMC_AVAILABLE =TrueexceptImportError: PYMC_AVAILABLE =Falsetry:import pytensor.tensor as pt PYTENSOR_AVAILABLE =TrueexceptImportError: PYTENSOR_AVAILABLE =Falsetry:import arviz as az ARVIZ_AVAILABLE =TrueexceptImportError: ARVIZ_AVAILABLE =Falsetry:from scipy import stats SCIPY_AVAILABLE =TrueexceptImportError: SCIPY_AVAILABLE =Falsetry:import matplotlib.pyplot as plt MATPLOTLIB_AVAILABLE =TrueexceptImportError: MATPLOTLIB_AVAILABLE =Falseif NUMPY_AVAILABLE and PYMC_AVAILABLE:print(f"PyMC version: {pm.__version__}")else:print("PyMC n'est pas installe. Executez: pip install pymc arviz matplotlib numpy scipy")
PyMC version: 6.0.1
1. Bayes Point Machine (Probit)
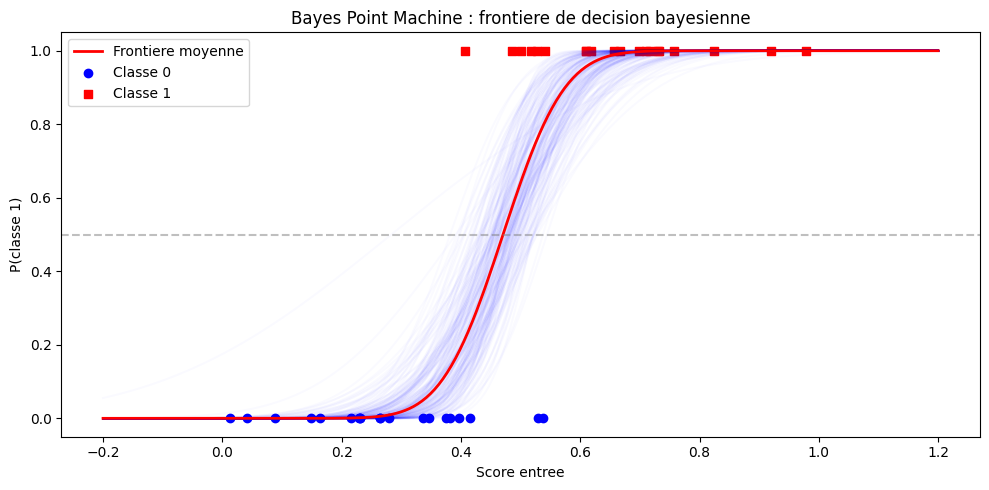
La Bayes Point Machine d’Infer.NET classifie en utilisant un score lineaire. En PyMC, on utilise un modèle probit : P(y=1|x) = Phi(w*x - b) ou Phi est la CDF normale.
Sources : La Bayes Point Machine est introduite par Herbrich, Graepel & Campbell (2001), Bayes Point Machines, Journal of Machine Learning Research 1:245-279 ; c’est l’exemple phare de la documentation Infer.NET, que ce notebook re-implemente en PyMC via un modèle probit. Le modèle probit classique remonte a Bliss (1935), The calculation of the dosage-mortality curve, Annals of Applied Biology 22(1) ; la regression des sequences binaires par modèle lineaire generalise est formalisee par Cox (1958), The regression analysis of binary sequences, JRSS-B 20(2).
Infer.NET vs PyMC
Concept
Infer.NET
PyMC
Score lineaire
Variable.InnerProduct(w, x)
poids * x_train - seuil
Fonction lien
Infer.NET interne
pm.math.invprobit
Classification
Variable.GaussianFromMeanAndVariance
pm.Bernoulli(p=invprobit(score))
# Donnees synthetiques : score d'entree vs admissionnp.random.seed(42)x_train = np.concatenate([np.random.normal(0.3, 0.15, 20), np.random.normal(0.7, 0.15, 20)])y_train = np.concatenate([np.zeros(20), np.ones(20)])# Modele Probit (equivalent Bayes Point Machine)# P(y=1|x) = Phi(poids * x - seuil)with pm.Model() as bpm:# Priors sur les parametres poids = pm.Normal('poids', mu=0, sigma=10) seuil = pm.Normal('seuil', mu=0, sigma=10)# Score lineaire score = poids * x_train - seuil# Fonction de lien probit p = pm.math.invprobit(score)# Vraisemblance y_obs = pm.Bernoulli('y_obs', p=p, observed=y_train) trace_bpm = pm.sample(3000, random_seed=42, return_inferencedata=True, chains=4)# Resultatspoids_post = trace_bpm.posterior['poids'].values.flatten()seuil_post = trace_bpm.posterior['seuil'].values.flatten()print(f"Poids posterior: {poids_post.mean():.2f} (std: {poids_post.std():.2f})")print(f"Seuil posterior: {seuil_post.mean():.2f} (std: {seuil_post.std():.2f})")
Implementez un modèle de regression logistique bayesienne pour la classification binaire. Contrairement au modèle probit qui utilise pm.math.invprobit, la regression logistique utilise pm.math.sigmoid.
Objectif : comparer les deux fonctions de lien (probit vs logit) sur des données synthetiques.
Indices : - Generer des données : 2 features gaussiennes, 2 classes separables - Score lineaire : pt.dot(X, w) + b ou w et b sont les paramètres - Fonction de lien : p = pm.math.sigmoid(score) au lieu de invprobit - Poids : pm.Normal('w', mu=0, sigma=5, shape=n_features) - Tracer la frontiere de decision avec les bandes d’incertitude posterieure
# TODO etudiant : implementer une regression logistique bayesienne# Etape 1 : generer des donnees synthetiques (2 features, classification binaire)# Etape 2 : definir le modele avec pm.Normal pour les poids et pm.math.sigmoid pour le lien# Etape 3 : echantillonner et extraire les poids posterieurs# Etape 4 : tracer la frontiere de decisionresult =None# TODO etudiant : remplacer par le modele logistiqueprint("Exercice a completer")
Exercice a completer
3. Test A/B Bayesien
Le test A/B bayesien compare deux proportions (taux de clic, conversions, etc.). Contrairement aux tests frequentistes, on obtient directement P(theta_B > theta_A).
Cadre : L’approche frequentiste (test d’hypothese, p-value) remonte a Fisher (1925) et Neyman & Pearson (1933). L’approche bayesienne pour comparer deux proportions repose sur l’analyse conjuguee Beta-Binomiale (Gelman et al., Bayesian Data Analysis 3e ed. 2013, ch. 2) : avec un prior Beta(a, b) et une vraisemblance Binomiale, le posterior est Beta(a + k, b + n - k).
Infer.NET vs PyMC
Concept
Infer.NET
PyMC
Taux A
Variable.Beta(aA, bA)
pm.Beta('theta_a', a, b)
Taux B
Variable.Beta(aB, bB)
pm.Beta('theta_b', a, b)
Différence
Inferer delta
pm.Deterministic('delta', theta_b - theta_a)
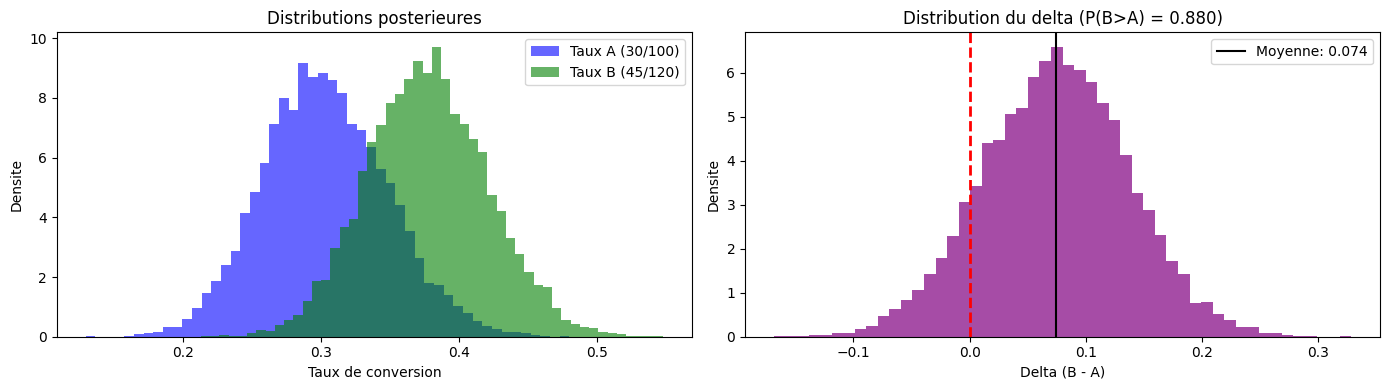
# Test A/B : comparaison de deux versions d'une page# Version A : 30 clics sur 100 visites# Version B : 45 clics sur 120 visitesclicks_a, visits_a =30, 100clicks_b, visits_b =45, 120with pm.Model() as ab_test:# Priors : Beta(1, 1) = Uniforme (non informatif) theta_a = pm.Beta('theta_a', alpha=1, beta=1) theta_b = pm.Beta('theta_b', alpha=1, beta=1)# Vraisemblance obs_a = pm.Binomial('obs_a', n=visits_a, p=theta_a, observed=clicks_a) obs_b = pm.Binomial('obs_b', n=visits_b, p=theta_b, observed=clicks_b)# Difference (quantite d'interet) delta = pm.Deterministic('delta', theta_b - theta_a) trace_ab = pm.sample(3000, random_seed=42, return_inferencedata=True, chains=4)# Resultatstheta_a_post = trace_ab.posterior['theta_a'].values.flatten()theta_b_post = trace_ab.posterior['theta_b'].values.flatten()delta_post = trace_ab.posterior['delta'].values.flatten()print(f"Taux A : {theta_a_post.mean():.3f} (95% CI: [{np.percentile(theta_a_post, 2.5):.3f}, {np.percentile(theta_a_post, 97.5):.3f}])")print(f"Taux B : {theta_b_post.mean():.3f} (95% CI: [{np.percentile(theta_b_post, 2.5):.3f}, {np.percentile(theta_b_post, 97.5):.3f}])")print(f"Delta (B - A) : {delta_post.mean():.3f}")print(f"P(theta_B > theta_A) = {(delta_post >0).mean():.3f}")
Taux A : 0.303 (95% CI: [0.218, 0.395])
Taux B : 0.377 (95% CI: [0.294, 0.464])
Delta (B - A) : 0.074
P(theta_B > theta_A) = 0.880
4. Impact de la Taille d’Echantillon
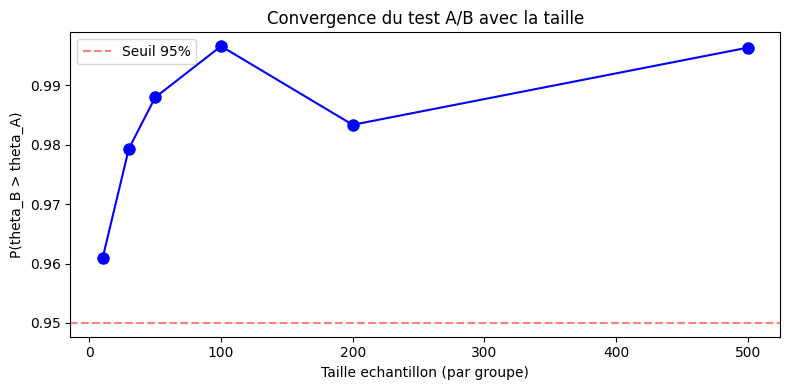
Plus l’echantillon est grand, plus l’incertitude diminue et la probabilite posterieure converge.
# Impact de la taille d'echantillon sur la certitudesizes = [10, 30, 50, 100, 200, 500]p_better = []true_rate_a =0.30true_rate_b =0.38for n in sizes: np.random.seed(42) c_a = np.random.binomial(n, true_rate_a) c_b = np.random.binomial(n, true_rate_b)with pm.Model() as m: ta = pm.Beta('ta', 1, 1) tb = pm.Beta('tb', 1, 1) pm.Binomial('oa', n=n, p=ta, observed=c_a) pm.Binomial('ob', n=n, p=tb, observed=c_b) d = pm.Deterministic('d', tb - ta) t = pm.sample(2000, random_seed=42, return_inferencedata=True, progressbar=False, chains=4) prob = (t.posterior['d'].values.flatten() >0).mean() p_better.append(prob)print(f"n={n:3d} : P(B>A) = {prob:.3f}")fig, ax = plt.subplots(1, 1, figsize=(8, 4))ax.plot(sizes, p_better, 'bo-', markersize=8)ax.axhline(0.95, color='red', linestyle='--', alpha=0.5, label='Seuil 95%')ax.set_xlabel('Taille echantillon (par groupe)')ax.set_ylabel('P(theta_B > theta_A)')ax.set_title('Convergence du test A/B avec la taille')ax.legend()plt.tight_layout()plt.show()
n= 10 : P(B>A) = 0.961
n= 30 : P(B>A) = 0.979
n= 50 : P(B>A) = 0.988
n=100 : P(B>A) = 0.997
n=200 : P(B>A) = 0.983
n=500 : P(B>A) = 0.996
5. Visualisation des Distributions A/B
# Visualisation des distributions posterieuresfig, axes = plt.subplots(1, 2, figsize=(14, 4))# Distributions theta_a et theta_bx = np.linspace(0.1, 0.7, 200)axes[0].hist(theta_a_post, bins=50, density=True, alpha=0.6, color='blue', label=f'Taux A ({clicks_a}/{visits_a})')axes[0].hist(theta_b_post, bins=50, density=True, alpha=0.6, color='green', label=f'Taux B ({clicks_b}/{visits_b})')axes[0].set_xlabel('Taux de conversion')axes[0].set_ylabel('Densite')axes[0].legend()axes[0].set_title('Distributions posterieures')# Distribution du deltaaxes[1].hist(delta_post, bins=50, density=True, alpha=0.7, color='purple')axes[1].axvline(0, color='red', linestyle='--', linewidth=2)axes[1].axvline(delta_post.mean(), color='black', linestyle='-', label=f'Moyenne: {delta_post.mean():.3f}')axes[1].set_xlabel('Delta (B - A)')axes[1].set_ylabel('Densite')axes[1].legend()axes[1].set_title(f'Distribution du delta (P(B>A) = {(delta_post >0).mean():.3f})')plt.tight_layout()plt.show()
6. Application : Click-Through Rate (CTR)
Un annonceur veut savoir si une nouvelle banniere a un meilleur CTR. - Ancienne banniere : 150 clics sur 1000 impressions - Nouvelle banniere : 180 clics sur 1000 impressions
La différence est-elle statistiquement significative ?
CTR ancien : 0.151
CTR nouveau : 0.181
Amelioration : 0.030
P(nouveau > ancien) = 0.964
Lift relatif : 19.7%
7. Calibration hors echantillon : du claim a la mesure (exemple execute)
Cette section etait l’Exercice 3 (stub) ; le contraste calibration/discrimination etant le message central d’un classifieur probabiliste, il est desormais demontre execute, et l’Exercice 3 (ci-dessous) l’etend a la recalibration. Le jumeau Infer-9 mesure la meme propriete cote EP.
Protocole (identique dans les deux twins, echantillons differents par moteur) :
un jeu 2 features, 2 classes chevauchantes (N = 400, 200 par classe), decoupe 75/25 stratifiee – les etiquettes de test ne servent jamais pendant l’inference ;
le modele probit bayesien (section 1) etend a 2 features, entraine sur le train seul ;
probabilites predictives sur le test : chaque tirage posterieur (w, b) donne Phi(w.x - b), on moyenne sur les tirages – l’incertitude des parametres est propagatee ;
Brier score (erreur quadratique moyenne, calibration + discrimination confondues) et AUC (discrimination seule : proba qu’un positif tire au hasard ait un score plus grand qu’un negatif tire au hasard) ;
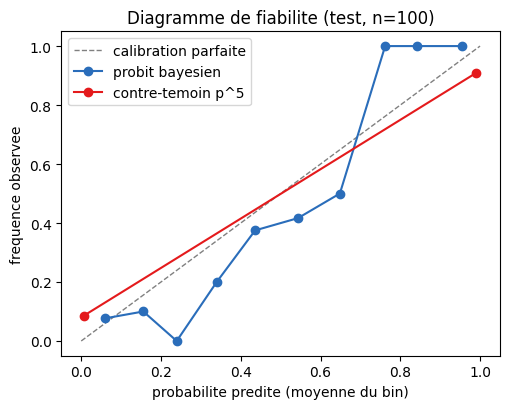
diagramme de fiabilite : 10 bins de meme largeur, probabilite predite moyenne vs frequence observee, avec les effectifs par bin ;
un contre-temoin volontairement mal calibre : la transformation monotone q = p^5 / (p^5 + (1-p)^5) (accentuation). Elle ne change pas l’ordre des scores donc laisse l’AUC identique – mais deplace toutes les probabilites vers 0 et 1 et detruit la calibration.
La discrimination et la calibration sont donc deux proprietes independantes : une bonne AUC ne garantit pas des probabilites utilisables telles quelles.
Lecture : la generation produit 400 points (200 par classe, moyennes [2.0, 2.0] et [3.5, 3.5], ecart-type 1.1) ; la decoupe apres permutation (graine 42) reserve 300 points au train et 100 au test — mesure imprimee : 149 positifs en train, 51 en test, un equilibre quasi parfait sans stratification explicite. Le classifieur apprend et est evalue sur des distributions homogenes, condition de lisibilite des metriques qui suivent. L’inference (2 chaines, 2 000 tirages) donne des poids posterieurs [0.52, 0.58] et un biais de 2.94 : les deux features contribuent a parts egales au score, et la frontiere separe les nuages malgre leur recouvrement. Deux notes de protocole : les etiquettes de test restent inertes pendant l’inference (aucune fuite de la cible), et PyMC avertit que 2 chaines sont peu pour des diagnostics de convergence robustes — suffisant pour un posterior aussi concentre, a ne pas generaliser.
# --- Probabilites predictives sur le test + metriques + contre-temoin ---from scipy.special import ndtr# Predictive : moyenne sur les tirages posterieurs de Phi(w.x - b) (incertitude propagatee)scores = X_test @ w_post.T - b_post # (n_test, n_draws)p_test = ndtr(scores).mean(axis=1)# Contre-temoin : accentuation monotone -- meme ordre, calibration detruiteq_test = p_test**5/ (p_test**5+ (1- p_test)**5)def brier(p, y): returnfloat(np.mean((p - y) **2))def auc(p, y):# AUC de Mann-Whitney par rangs (main, sans dependance) ranks = np.argsort(np.argsort(p)) +1.0 n1, n0 =int(y.sum()), int((1- y).sum())returnfloat((ranks[y ==1].sum() - n1 * (n1 +1) /2) / (n0 * n1))print("=== Test (100 points jamais vus) : calibration vs discrimination ===")print(f"{'modele':<28}{'Brier':>8}{'AUC':>8}{'acc@0.5':>9}")print(f"{'probit bayesien (calibre)':<28}{brier(p_test, y_test):>8.3f}{auc(p_test, y_test):>8.3f}"f"{float(((p_test >.5) == y_test).mean()):>9.3f}")print(f"{'contre-temoin p^5 (accentue)':<28}{brier(q_test, y_test):>8.3f}{auc(q_test, y_test):>8.3f}"f"{float(((q_test >.5) == y_test).mean()):>9.3f}")print("\nMeme AUC (transformation strictement croissante : l'ordre des scores est inchange),")print("Brier degrade : la discrimination est preservee, la calibration ne l'est pas.")
=== Test (100 points jamais vus) : calibration vs discrimination ===
modele                         Brier     AUC  acc@0.5
probit bayesien (calibre)      0.117   0.923    0.820
contre-temoin p^5 (accentue)   0.136   0.923    0.820

Meme AUC (transformation strictement croissante : l'ordre des scores est inchange),
Brier degrade : la discrimination est preservee, la calibration ne l'est pas.
Lecture : sur les 100 points de test jamais vus, le probit calibre obtient Brier 0.117 / AUC 0.923 / accuracy a 0.5 : 0.820, contre 0.136 / 0.923 / 0.820 pour le contre-temoin p^5. L’ecart est entierement porte par le Brier : le modele calibre gagne precisement la ou le contre-temoin echoue. C’est ce que la cellule imprime mot pour mot — « Meme AUC (transformation strictement croissante : l’ordre des scores est inchange), Brier degrade : la discrimination est preservee, la calibration ne l’est pas. » La demonstration executee montre donc que discrimination et calibration sont deux proprietes independantes : ne pas reordonner les scores ne dispense pas de bien les chiffrer.
# --- Diagramme de fiabilite (10 bins) avec effectifs + comparaison au contre-temoin ---def fiabilite(p, y, n_bins=10): edges = np.linspace(0, 1, n_bins +1) idx = np.clip(np.digitize(p, edges) -1, 0, n_bins -1) rows = []for k inrange(n_bins): m = idx == k rows.append((k, m.sum(), float(p[m].mean()) if m.any() else np.nan,float(y[m].mean()) if m.any() else np.nan))return rowsprint("Bin | effectif | p_pred moyen | freq observee (modele calibre)")for k, n, pp, fo in fiabilite(p_test, y_test):print(f"{k:>3} | {n:>8} | {pp:12.3f} | {fo:12.3f}")rows_c = fiabilite(q_test, y_test)ok_bins = [(pp, fo) for k, n, pp, fo in rows_c if n >=5]print(f"\nContre-temoin, bins peuples (n>=5) : p_pred vs freq observee")for pp, fo in ok_bins:print(f" {pp:.3f} -> {fo:.3f}")fig, ax = plt.subplots(figsize=(5.2, 4.2))ax.plot([0, 1], [0, 1], "--", color="gray", lw=1, label="calibration parfaite")mid = [(pp + fo) /2for k, n, pp, fo in fiabilite(p_test, y_test) if n >=5]for name, p_mod, color in [("probit bayesien", p_test, "#2a6dba"), ("contre-temoin p^5", q_test, "#e41a1c")]: pts = [(pp, fo) for k, n, pp, fo in fiabilite(p_mod, y_test) if n >=5] ax.plot([a for a, _ in pts], [b for _, b in pts], "o-", color=color, label=name)ax.set_xlabel("probabilite predite (moyenne du bin)"); ax.set_ylabel("frequence observee")ax.set_title("Diagramme de fiabilite (test, n=100)"); ax.legend(); fig.tight_layout()plt.show()
Le profil de fiabilité, bin par bin : le probit bayésien suit la diagonale aux extrémités (0.060 -> 0.077 ; 0.954 -> 1.000) mais surestime au milieu (0.340 -> 0.200, 0.436 -> 0.375, 0.544 -> 0.417, 0.648 -> 0.500) – l’affirmation « probabilités calibrées » est désormais mesurée hors échantillon, pas seulement affichée. Un bin isole porte la signature inverse : le bin 2 observe 0.000 pour 0.239 prédit (7 points). Avec 100 points de test, chaque bin attend ~10 événements : les bins peu peuplés (extrémités) ne portent pas de conclusion forte.
Le contre-témoin garde l’AUC et perd le Brier : la transformation monotone ne réordonne rien (discrimination intacte, accuracy à 0.5 identique) mais pousse chaque probabilité vers 0 ou 1 – un modèle surconfiant dont les probabilités, utilisées telles quelles (seuil de décision métier, espérance de coût), mentent. C’est la différence entre ranger les individus et quantifier un risque. Sur ses bins peuplés, il prédit 0.006 pour 0.086 observé et 0.990 pour 0.909 : l’excès de confiance est visible des deux bords de l’échelle.
Brier vs AUC, deux lectures d’un même score : le Brier mélange calibration et finesse de discrimination, l’AUC n’est sensible qu’à l’ordre – c’est pourquoi le contre-témoin, qui conserve l’AUC et dégrade le Brier, reste indiscernable à l’AUC seule. Les comparer sur deux transformations du même score est le diagnostic le plus simple de « où est l’erreur ».
Pont moteur : Infer-9 mène la même mesure côté EP – l’AUC y est identique par construction (même famille de modèle), et l’écart de Brier entre les moteurs mesure la différence EP/moyenne-posterior, pas une différence de protocole.
Exercice 3 : Recalibration du contre-temoin (temperature scaling)
Le contre-temoin accentue est mal calibre mais reste recuperable : la transformation inverse existe. Parametrez-la par une temperature T > 0 : q_T(p) = p^(1/T) / (p^(1/T) + (1-p)^(1/T)) ; T = 5 inverse exactement l’accentuation d’ordre 5.
Objectif : trouver le T qui minimise le Brier sur le train (jamais sur le test – sinon la mesure de test redevient un ajustement), puis rapporter le Brier test avant/apres.
Indice : une grille T dans [0.5, 6] suffit ; le minimum devrait tomber proche de 5.
Etape 1 : construire les probabilites train du modele probit (meme propagation des tirages que la section 7). Etape 2 : boucler sur la grille, retenir le T optimal. Etape 3 : appliquer q_T au contre-temoin test et rapporter Brier/AUC avant-apres.
# Exercice 3 a completer# TODO etudiant : temperature scaling du contre-temoin (grille T, minimisation du Brier TRAIN,# puis rapporter Brier/AUC test avant/apres recalibration).print("Exercice 3 a completer : recalibration par temperature scaling.")
Exercice 3 a completer : recalibration par temperature scaling.
8. Comparaison Infer.NET vs PyMC pour la classification
Aspect
Infer.NET
PyMC
Classification
Bayes Point Machine
Modèle Probit/Logit
Score lineaire
InnerProduct(w, x)
poids * x - seuil
Test A/B
Message passing
MCMC (NUTS)
Résultat
Distribution analytique
Echantillons posterieur
P(A > B)
Calcul exact
(delta > 0).mean()
Scalabilite
Rapide (EP)
Plus lent mais general
Méthodes : Infer.NET utilise l’Expectation Propagation (Minka 2001, UAI) pour propager les messages et obtenir une approximation analytique. PyMC utilise NUTS (Hoffman & Gelman 2014, JMLR 15) pour l’echantillonnage MCMC. PyMC : Salvatier, Wiecki & Fonnesbeck (2016), PeerJ Computer Science 2:e55. ArviZ : Kumar, Carroll, Hartikainen & Martin (2019), JOSS 4(33).
Implementer un classificateur de spam bayesien avec 3 features : - x1 : frequence du mot “gratuit” - x2 : presence de liens (0/1) - x3 : longueur de l’objet (normalise)
Le modèle : score = w1x1 + w2x2 + w3*x3 - seuil
Indices : - Priors : pm.Normal('w', mu=0, sigma=5, shape=3) pour les poids - Score : pt.dot(X, w) - seuil - Lien : pm.math.invprobit(score)
# TODO etudiant : implementer le classificateur de spam bayesien# Resultat attendu : poids posterieurs pour chaque feature + frontiere de decisionprint("Exercice a completer")
Exercice a completer
Conclusion
La classification bayesienne estime P(classe|features) en combinant prior et vraisemblance, fournissant non seulement une prediction mais aussi une incertitude quantifiee.
Points cles
La classification bayesienne (modèle probit/logit ici) produit une probabilite P(classe|x) plutot qu’un vote dur
Les predictions probabilistes permettent de detecter les cas incertains
La regression logistique bayesienne fournit des intervalles de confiance sur les coefficients
References
Herbrich, R., Graepel, T., & Campbell, C. (2001). Bayes Point Machines. Journal of Machine Learning Research, 1, 245-279.
Bliss, C. I. (1935). The calculation of the dosage-mortality curve. Annals of Applied Biology, 22(1), 134-167.
Fisher, R. A. (1925). Statistical Methods for Research Workers. Oliver and Boyd.
Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Phil. Trans. Royal Society A, 231, 289-337.
Cox, D. R. (1958). The regression analysis of binary sequences. JRSS-B, 20(2), 215-242.
Brier, G. W. (1950). Verification of forecasts expressed in terms of probability. Monthly Weather Review, 78(1), 1-3.
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian Data Analysis (3rd ed.). CRC Press.
Minka, T. (2001). Expectation Propagation for approximate Bayesian inference. UAI.
Hoffman, M. D., & Gelman, A. (2014). The No-U-Turn Sampler. JMLR, 15(1), 1593-1623.
Salvatier, J., Wiecki, T. V., & Fonnesbeck, C. (2016). Probabilistic programming in Python using PyMC3. PeerJ Computer Science, 2:e55.