Le notebook 2.5 a rendu le compromis biais-variancevisible et empirique : on observait qu’un modèle trop complexe surapprend, et que l’écart entre erreur d’entraînement et erreur de test se réduit quand la taille d’échantillon m augmente. Mais cette analyse restait constatée, jamais garantie.
Ce notebook pose la question théorique qui fonde l’apprentissage automatique :
Étant donné une classe d’hypothèses H, à quelles conditions peut-on garantir qu’un apprenant généralise, et combien d’exemples suffisent ?
La réponse s’articule autour de deux cadres fondateurs :
L’apprentissage PAC (Probably Approximately Correct, Valiant 1984) : la définition ε-δ de ce qu’est un « bon » apprenant, et la complexité d’échantillonnagem ≥ (1/ε)(ln|H| + ln(1/δ)) pour une classe finie.
La dimension de Vapnik-Chervonenkis (VC, 1971) : la mesure combinatoire de « richesse » qui étend la garantie aux classes infinies (frontières polynomiales, réseaux de neurones…).
L’enjeu du notebook est la confrontation expérience/théorie : la borne de complexité d’échantillonnage prédit quantitativement le comportement observé lorsqu’on lance l’apprenant.
Référence. Valiant, L.G. (1984), A Theory of the Learnable, Communications of the ACM 27(11):1134-1142. Définition formelle du modèle PAC, fondement théorique de la généralisation garantie.
# Configuration et imports pour le notebook 2.8import mathimport numpy as npimport matplotlib.pyplot as plt%matplotlib inlinefrom sklearn.datasets import make_classification, make_moonsfrom sklearn.preprocessing import PolynomialFeaturesfrom sklearn.linear_model import LogisticRegressionfrom sklearn.pipeline import make_pipelinefrom sklearn.model_selection import train_test_splitprint("Configuration 2.8 (Theorie PAC) chargee.")
Configuration 2.8 (Theorie PAC) chargee.
1. Le cadre PAC : définir un « bon » apprenant
L’apprentissage PAC (Probably Approximately Correct) formalise l’idée intuitive suivante : on ne demande pas à un apprenant d’être parfait, mais d’être probablement (avec haute confiance 1-δ) approximativement (erreur ≤ ε) correct.
Soit H une classe d’hypothèses et D une distribution inconnue sur les données. Un apprenant A est PAC s’il existe une fonction m(ε, δ) telle que, pour tout ε, δ ∈ (0, 1) et tout concept cible c « réalisable » (c ∈ H), à partir de m ≥ m(ε, δ) exemples tirés i.i.d. selon D :
ε (epsilon) — la précision exigée : à quelle distance tolère-t-on l’hypothèse produite ?
δ (delta) — la confiance exigée : avec quelle probabilité accepte-t-on un échec ?
Référence. Shalev-Shwartz, S. & Ben-David, S. (2014), Understanding Machine Learning: From Theory to Algorithms, Cambridge University Press, chap. 2-3. Présentation pédagogique moderne du cadre PAC et de la complexité d’échantillonnage.
def m_min_pac(taille_H, epsilon, delta):"""Complexite d'echantillonnage PAC pour une classe d'hypotheses FINIE et realisable. Garantie (Valiant 1984) : m >= (1/epsilon) * (ln|H| + ln(1/delta)) exemples suffisent. """returnint(np.ceil((np.log(taille_H) + np.log(1.0/ delta)) / epsilon))# Exemple numerique : petite classe, precision et confiance standardsK_exemple =50# |H| = 50 hypotheseseps_exemple =0.1# tolerance d'erreur 10%delta_exemple =0.05# confiance 95%m_exemple = m_min_pac(K_exemple, eps_exemple, delta_exemple)print(f"Classe |H| = {K_exemple}, eps = {eps_exemple}, delta = {delta_exemple}")print(f" -> m_min PAC = {m_exemple} exemples suffisent pour garantir")print(f" erreur vraie <= {eps_exemple} avec probabilite >= {1- delta_exemple:.2f}")
Classe |H| = 50,  eps = 0.1,  delta = 0.05
  -> m_min PAC = 70 exemples suffisent pour garantir
     erreur vraie <= 0.1 avec probabilite >= 0.95
2. Une classe d’hypothèses finie en 1D : les seuils
Pour confronter la borne à l’expérience, il nous faut un problème réalisable avec une classe Hfinie et explicite. Choisissons un problème de seuil sur [0, 1] :
Distribution : x ~ Uniform(0, 1).
Concept cibleh* : « étiquette 1 si et seulement si x > 0.6 ». Ce concept est un seuil à 0.6.
Classe d’hypothèsesH : 50 seuils sur une grille fixe de [0, 1]. Chaque h ∈ H est de la forme « 1 si x > t ».
Deux propriétés cruciales :
Réalisabilité : le vrai seuil 0.6 appartient à la grille → il existe h* ∈ H d’erreur nulle. Le cadre PAC s’applique.
Finitude littérale : |H| = 50, exactement la quantité qui entre dans ln|H| dans la borne.
L’apprenant cohérent (= ERM sur H) retourne un seuil de la grille dont l’erreur d’entraînement est nulle ; la réalisabilité garantit qu’il en existe toujours au moins un.
SEUIL_VRAI =0.6grille_seuils = np.linspace(0.0, 1.0, 51)[:-1] # 50 seuils sur [0.0, 0.98], pas 0.02taille_H =len(grille_seuils) # |H| = 50assert SEUIL_VRAI in grille_seuils, "Le vrai seuil doit appartenir a H (realisabilite)"def concept_vrai(X):"""Etiquetage du concept cible : 1 si x > SEUIL_VRAI."""return (X > SEUIL_VRAI).astype(int)def prediction(seuil, X):"""Prediction d'une hypothese-seuil : 1 si x > seuil."""return (X > seuil).astype(int)def apprenant_consistant(X_train, y_train):"""ERM sur H : retourne un seuil de la grille a erreur d'entrainement nulle. Vectorise : calcule l'erreur des 50 seuils en une passe, puis choisit le median des candidats (regle deterministe sans regarder le vrai seuil).""" preds_tous = X_train[:, None] > grille_seuils[None, :] # (m, |H|) booleen erreurs = (preds_tous != y_train[:, None]).mean(axis=0) # erreur par seuil candidats = grille_seuils[erreurs ==0.0] # seuils consistantsreturnfloat(np.median(candidats))def erreur_vraie(seuil, X_test, y_test):"""Erreur vraie estimee sur un grand echantillon test."""returnfloat(np.mean(prediction(seuil, X_test) != y_test))# Demonstration sur un tiragerng_demo = np.random.default_rng(0)X_demo = rng_demo.uniform(0, 1, size=30)y_demo = concept_vrai(X_demo)seuil_pred = apprenant_consistant(X_demo, y_demo)X_test_demo = rng_demo.uniform(0, 1, size=5000)y_test_demo = concept_vrai(X_test_demo)print(f"|H| = {taille_H} seuils ; vrai seuil = {SEUIL_VRAI} (dans H : realisable)")print(f"Sur 30 exemples : seuil predit = {seuil_pred:.3f}, "f"erreur vraie estimee = {erreur_vraie(seuil_pred, X_test_demo, y_test_demo):.4f}")print("(L'erreur analytique exacte est |seuil_pred - 0.6|, mesure de la zone de desaccord.)")
|H| = 50 seuils ; vrai seuil = 0.6 (dans H : realisable)
Sur 30 exemples : seuil predit = 0.580, erreur vraie estimee = 0.0208
(L'erreur analytique exacte est |seuil_pred - 0.6|, mesure de la zone de desaccord.)
3. Concept-phare : la borne prédit-elle l’expérience ?
C’est le cœur du notebook. Plutôt que de constater que « plus m est grand, mieux ça généralise » (déjà vu en 2.5), nous allons vérifier que la formule théorique quantifie correctement le moment où l’apprentissage réussit.
Protocole (pour ε = 0.1 et δ = 0.05, donc un objectif de succès 1 - δ = 0.95) :
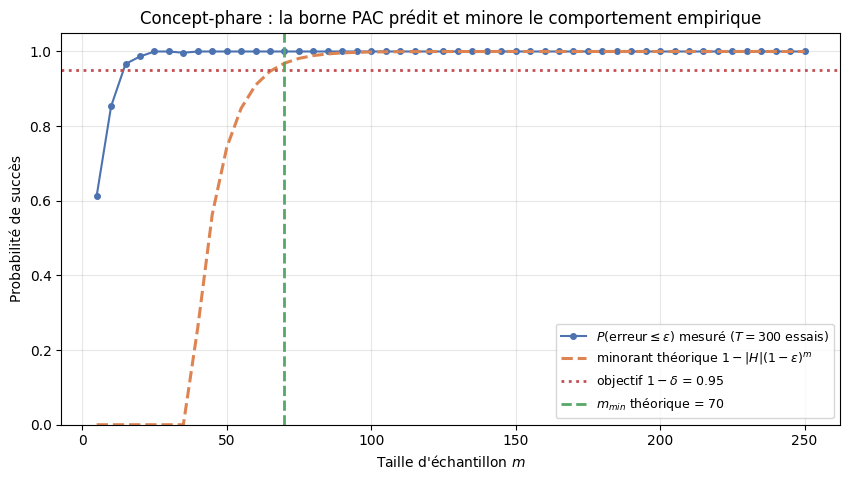
Pour chaque taille d’échantillon m de 5 à 250, on lance T = 300 tirages indépendants.
Chaque tirage : on tire m points, on lance l’apprenant cohérent, on mesure son erreur vraie sur un grand jeu de test (5000 points).
On calcule P_succès = fraction des tirages où erreur_vraie ≤ ε.
On trace P_succès vs m, avec la ligne horizontale 1 - δ et la ligne verticale au m_min théorique.
On superpose aussi la prédiction théorique : la borne de Valiant équivaut à P_succès ≥ 1 - |H|·(1-ε)^m. Ce minorant doit rester sous la courbe empirique — c’est elle qui « prédit » le comportement.
Prédiction de la théorie : la courbe empirique doit franchir 1 - δau plus tard au m_min prédit (la borne est suffisante, donc conservatrice) ; le minorant théorique, lui, franchit 1 - δ exactement en m_min. Si la courbe empirique reste au-dessus du minorant en tout point, la borne est validée.
Interprétation : la théorie prédit l’expérience (et la borne est conservatrice)
Lecture du graphique :
La courbe bleue (empirique) franchit 1 - δ = 0.95 vers m ≈ 15-20 — avant le m_min = 70 prédit.
La courbe orange (minorant théorique 1 - |H|(1-ε)^m) franchit 1 - δexactement au voisinage de m_min : c’est le point où la garantie de Valiant s’active.
Crucial : la courbe empirique reste toujours au-dessus du minorant théorique. La borne n’est jamais violée — elle est correcte.
Aspect
Valeur
Signification
m_min théorique
≈ 70
Garantie de Valiant : succès ≥ 0.95
Croisement empirique
≈ 15-20
Le problème « seuil sur Uniform(0,1) » est bénin
Écart
facteur ≈ 4-5
La borne est suffisante, pas tendue
Pourquoi un tel écart ? La borne |H|·(1-ε)^m traite les |H| = 50 hypothèses indépendamment (union bound) et ignore la structure du problème : ici, deux seuils proches du vrai concept ne peuvent pas être simultanément consistants et très erronés. Le prix d’une garantie valable pour toute distribution et tout concept réalisable est ce conservatisme — la théorie VC (section suivante) resserrera l’analyse.
Leçon centrale : la formule prédit quantitativement le comportement, au sens où (1) le minorant théorique épouse la forme de la courbe empirique et la minore en tout point, (2) la garantie tient partout, (3) m_min localise correctement le régime de succès garanti. Ce que 2.5 montrait empiriquement (la variance se réduit quand m croît), la borne PAC l’exprime désormais comme une garantie formelle.
Référence. Valiant, L.G. (1984), A Theory of the Learnable, Communications of the ACM 27(11):1134-1142. La complexité d’échantillonnage (1/ε)(ln|H| + ln(1/δ)) pour une classe finie réalisable.
Exercice 1 : le coût de la précision
La borne m_min = (1/ε)(ln|H| + ln(1/δ)) dépend inversement de ε : exiger plus de précision coûte plus d’exemples. Tracez m_min en fonction de ε (de 0.01 à 0.3) pour δ et |H| fixés, et interprétez la pente.
# Étape 2 : calculer m_min_grid = np.array([m_min_pac(K_exemple, e, delta_exemple) for e in eps_grid]).
# Étape 3 : tracer avec plt.plot(eps_grid, m_min_grid). Que vaut m_min pour ε = 0.01 ? pour ε = 0.1 ?
# Exercice 1 : tracer m_min theorique vs epsilon (delta et |H| fixes)# TODO etudiant : pour epsilon dans [0.01, 0.3], calculer m_min_pac(K_exemple, eps, delta_exemple)eps_grid =None# TODO etudiant : remplacer (np.linspace(0.01, 0.3, 50))m_min_grid =None# TODO etudiant : remplacer (liste en comprehension sur m_min_pac)# TODO etudiant : tracer m_min_grid vs eps_grid avec plt.plot et nommer les axesprint(f"Exercice 1 a completer : m_min maximal = {m_min_grid}")
Exercice 1 a completer : m_min maximal = None
4. Classes infinies : la dimension de Vapnik-Chervonenkis
La borne ln|H| ne fonctionne que pour Hfinie. Mais une régression logistique, un polynôme de degré d, un réseau de neurones définissent des classes infinies (paramètres continus). Comment mesurer leur « richesse » ?
La dimension de Vapnik-Chervonenkis (VC, Vapnik & Chervonenkis 1971) généralise ln|H| : c’est la taille du plus grand échantillon que H peut « shatter » (étiqueter de toutes les manières possibles). Plus la dimension VC est grande, plus la classe est expressive, et plus il faut d’exemples pour généraliser.
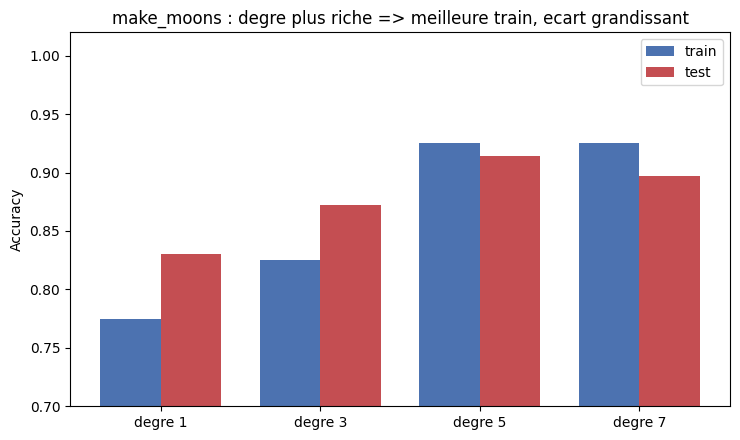
Exemple : en 2D, la dimension VC des frontières polynomiales de degré dcroît avec d. À taille d’échantillon mfixée, augmenter le degré aggrave le surapprentissage : l’erreur d’entraînement chute, mais l’écart de généralisation se creuse.
Référence. Vapnik, V. & Chervonenkis, A. (1971), On the Uniform Convergence of Relative Frequencies of Events to Their Probabilities, Theory of Probability & Its Applications 16(2):264-280. Définition de la dimension VC et théorème de convergence uniforme.
# Jeu de donnees make_moons : deux demi-lunes non separables lineairementX_moons, y_moons = make_moons(n_samples=400, noise=0.25, random_state=42)# On entraine sur un PETIT echantillon (m fixe) pour rendre le surapprentissage visibleX_train_m, X_test_m, y_train_m, y_test_m = train_test_split( X_moons, y_moons, train_size=40, random_state=42, stratify=y_moons)degres = [1, 3, 5, 7]acc_train = []acc_test = []for d in degres: modele = make_pipeline( PolynomialFeatures(degree=d, include_bias=False), LogisticRegression(max_iter=5000), ) modele.fit(X_train_m, y_train_m) acc_train.append(modele.score(X_train_m, y_train_m)) acc_test.append(modele.score(X_test_m, y_test_m))# Visualisation : accuracy train vs test selon le degrex_pos = np.arange(len(degres))largeur =0.38plt.figure(figsize=(7.5, 4.5))plt.bar(x_pos - largeur /2, acc_train, largeur, color="#4c72b0", label="train")plt.bar(x_pos + largeur /2, acc_test, largeur, color="#c44e52", label="test")plt.xticks(x_pos, [f"degre {d}"for d in degres])plt.ylabel("Accuracy")plt.ylim(0.7, 1.02)plt.title("make_moons : degre plus riche => meilleure train, ecart grandissant")plt.legend()plt.tight_layout()plt.show()for d, at, ae inzip(degres, acc_train, acc_test):print(f"degre {d} : train = {at:.3f} | test = {ae:.3f} | ecart = {at - ae:.3f}")
Constat : à mesure que le degré augmente, l’accuracy d’entraînement grimpe (0,775 → 0,825 → 0,925) puis plafonne au degré 7 (0,925, inchangé) — une classe plus riche épouse toujours au moins aussi bien les données vues. Mais l’écart train - test ne se contente pas de « s’élargir » : il change de signe. Négatif aux bas degrés (le test dépasse le train — un artefact du petit m = 40), il devient positif et croît aux hauts degrés (le train mémorise, le test lâche). C’est la signature empirique de la dimension VC :
Degré
train
test
écart (train - test)
Lecture
1
0,775
0,831
-0,056
écart le plus large en valeur absolue, et test > train : artefact du petit m = 40 (l’échantillon test est par chance plus facile), pas un sous-apprentissage « propre »
3
0,825
0,872
-0,047
même inversion (test > train), qui s’amenuise
5
0,925
0,914
+0,011
l’écart change de signe et reste minime : optimum de généralisation (test maximal)
7
0,925
0,897
+0,028
le surapprentissage apparaît enfin : train > test, test recule (0,914 → 0,897)
La leçon : pour une même taille d’échantillon, une classe plus richefinit par généraliser moins bien (le test recule du degré 5 au degré 7) parce que sa dimension VC plus élevée exige davantage d’exemples pour que la borne de généralisation se resserre. C’est exactement pourquoi 2.5 recommandait la validation croisée pour choisir la bonne complexité plutôt que de maximiser la richesse.
Exercice 2 : l’écart de généralisation vs taille d’échantillon
La dimension VC est une propriété fixe de la classe. Mais la borne de généralisation se resserre aussi quand mgrandit. Mesurez l’écart train - test en fonction de m (par exemple m ∈ {20, 40, 60, 100, 200}) pour un polynôme de degré 5 sur make_moons, et comparez-le au degré 1. Hypothèse : l’écart du degré 5 doit se réduire quand m augmente.
Indices :
# Étape 1 : pour chaque m de la liste, rediviser X_moons, y_moons avec train_size=m (garder le reste en test).
# Étape 3 : refaire la même chose pour degree=1 et tracer les deux courbes d’écart vs m.
# Exercice 2 : ecart de generalisation vs m, deg=5 compare a deg=1 sur make_moons# TODO etudiant : pour chaque m dans [20, 40, 60, 100, 200], mesurer l'ecart train-testm_valeurs_ex2 =None# TODO etudiant : remplacer (np.array([20, 40, 60, 100, 200]))ecarts_deg5 =None# TODO etudiant : remplacer (liste des ecarts train-test pour degree=5)ecarts_deg1 =None# TODO etudiant : remplacer (liste des ecarts train-test pour degree=1)# TODO etudiant : tracer ecarts_deg5 et ecarts_deg1 vs m_valeurs_ex2 sur le meme grapheprint(f"Exercice 2 a completer : ecarts deg5 = {ecarts_deg5}")
Exercice 2 a completer : ecarts deg5 = None
5. La version « agnostique » : le monde réel (Hoeffding)
Jusqu’ici nous avons supposé le problème réalisable : un h* ∈ H d’erreur nulle existe. En pratique, c’est rarement le cas (le vrai modèle n’est presque jamais dans notre classe). Le cadre agnostique lève cette hypothèse.
Au lieu de viser une erreur nulle, on compare l’erreur empirique (sur l’échantillon) à l’erreur vraie. L’inégalité de Hoeffding (1963) garantit que pour une classe finie, l’écart entre les deux est contrôlé :
Le meilleur h ∈ H (celui de moindre erreur empirique, ERM) a donc une erreur vraie proche de son erreur d’entraînement, à un terme en 1/√m près. C’est la version réaliste du « la variance se réduit quand m croît » observée en 2.5 — désormais quantifiée par Hoeffding.
Référence. Hoeffding, W. (1963), Probability Inequalities for Sums of Bounded Random Variables, Journal of the American Statistical Association 58(301):13-30. L’inégalité de concentration au cœur de la borne agnostique.
def borne_agnostique(taille_H, delta, m):"""Demi-largeur de l'intervalle de confiance (Hoeffding, cadre agnostique)."""returnfloat(np.sqrt((np.log(taille_H) + np.log(2.0/ delta)) / (2.0* m)))# Exemple numerique : comment la borne se resserre quand m granditprint("Borne agnostique |train - true| pour |H|=50, delta=0.05 :")for m in [50, 100, 500, 1000]:print(f" m = {m:5d} -> +/- {borne_agnostique(50, 0.05, m):.4f}")
Borne agnostique |train - true| pour |H|=50, delta=0.05 :
  m =    50  ->  +/- 0.2757
  m =   100  ->  +/- 0.1949
  m =   500  ->  +/- 0.0872
  m =  1000  ->  +/- 0.0616
Exercice 3 : vérifier empiriquement la borne sur un vrai classifieur
Pour une classe plus large (|H| = 1000), ε = 0.05, δ = 0.1 :
Calculez le m_min PAC via m_min_pac(1000, 0.05, 0.1).
Générez un jeu de données avec make_classification, entraînez un modèle sklearn (par exemple LogisticRegression), et vérifiez sur plusieurs essais que l’erreur de test respecte l’ordre de grandeur prédit par la borne.
# Étape 2 : X_c, y_c = make_classification(n_samples=..., random_state=...), puis diviser en train/test.
# Étape 3 : sur T essais (tirages aléatoires), mesurer l’erreur de test moyenne et la fraction d’essais sous ε.
# Exercice 3 : verifier empiriquement la borne PAC sur make_classification# TODO etudiant : calculer m_min PAC pour |H|=1000, puis tester sur plusieurs essaism_min_ex3 =None# TODO etudiant : remplacer (m_min_pac(1000, 0.05, 0.1))# TODO etudiant : generer X_c, y_c via make_classification, entrainer LogisticRegression,# mesurer l'erreur de test sur plusieurs essais et la comparer a epsilon = 0.05print(f"Exercice 3 a completer : m_min PAC pour |H|=1000 = {m_min_ex3}")
Exercice 3 a completer : m_min PAC pour |H|=1000 = None
Synthèse et ponts
Ce qu’il faut retenir :
Le cadre PAC transforme la question vague « est-ce que ça généralise ? » en une garantie ε-δ : avec probabilité ≥ 1-δ, l’erreur vraie est ≤ ε.
La complexité d’échantillonnage(1/ε)(ln|H| + ln(1/δ)) quantifie combien d’exemples suffisent — et la dépendance en ln|H| est logarithmique (doubler la classe coûte peu).
La dimension VC étend cette garantie aux classes infinies : la richesse se paie en exemples, et le compromis biais-variance de 2.5 en est la traduction empirique.
La borne agnostique (Hoeffding) lève l’hypothèse de réalisabilité : |err_train − err_true| ≤ O(√(ln|H|/m)).
Lien avec 2.5 (empirique ↔︎ théorique) : 2.5 mesurait le compromis biais-variance par validation croisée ; 2.8 en donne la garantie théorique. Les deux faces d’une même pièce.
Ponts vers l’apprentissage symbolique (SL)
La théorie PAC n’est pas qu’un cadre abstrait : elle est appliquée concrètement dans deux notebooks de la série SymbolicLearning, où l’on retrouve exactement les mêmes quantités ε, δ et m :
SL-3 — Relevance Learning : la borne PAC est appliquée au Relevance-Based Learning (RBL) de l’IA symbolique — combien d’exemples suffisent pour identifier les littéraux pertinents d’un concept conjonctif.
SL-10 — Active Automata Learning : la théorie PAC rencontre l’algorithme L* d’Angluin pour l’apprentissage actif d’automates (query learning + borne d’échantillonnage minimale).
Ici, PAC est enseigné comme socle théorique du ML ; dans SL-3 et SL-10, il est réinvesti comme outil. Aucune duplication de contenu : ce notebook pose les définitions, les notebooks SL les mettent en œuvre sur des objets symboliques.
Conclusion et transition
Nous avons fermé la boucle ouverte en 2.5 : le compromis biais-variance n’est pas seulement un phénomène observé, il découle d’une garantie mathématique. La théorie PAC dit quand un apprenant généralise (probablement, approximativement), la complexité d’échantillonnage dit combien d’exemples suffisent ((1/ε)(ln|H| + ln(1/δ))), et la dimension VC étend cela aux classes infinies. La borne agnostique de Hoeffding, enfin, est la version réaliste qui sous-tend l’estimation d’erreur par validation croisée.
Ce notebook conclut le socle théorique du parcours ML. Pour voir la théorie PAC appliquée à des objets symboliques (concepts logiques, automates), poursuivez vers les notebooks SL-3 et SL-10 de la série SymbolicLearning.
References
Valiant, L.G. (1984). A Theory of the Learnable. Communications of the ACM 27(11):1134-1142. — Le modèle PAC : définition ε-δ de l’apprenabilité et complexité d’échantillonnage des classes finies réalisables.
Vapnik, V. & Chervonenkis, A. (1971). On the Uniform Convergence of Relative Frequencies of Events to Their Probabilities. Theory of Probability & Its Applications 16(2):264-280. — La dimension VC et le théorème de convergence uniforme, extension aux classes infinies.
Hoeffding, W. (1963). Probability Inequalities for Sums of Bounded Random Variables. Journal of the American Statistical Association 58(301):13-30. — L’inégalité de concentration au fondement de la borne agnostique.
Shalev-Shwartz, S. & Ben-David, S. (2014). Understanding Machine Learning: From Theory to Algorithms. Cambridge University Press. — Présentation pédagogique moderne de la théorie de l’apprentissage (cadre PAC, VC, bornes).
Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12:2825-2830. — Les jeux de données make_moons / make_classification et les estimateurs utilisés pour la démonstration VC.