Duree estimee : 55 minutes Objectifs : - Modeliser un reseau bayesien avec PyMC - Implementer le reseau Wet Grass (Pluie / Arroseur / Herbe mouillee) - Comprendre les tables de probabilites conditionnelles (CPT) - Observer le phenomene d’explaining away - Verifier la D-separation - Comparer inference observationnelle vs interventionnelle (do-calculus)
Prerequis : PyMC-1 a PyMC-3 (graphe de facteurs), theoreme de Bayes
References fondatrices
Les reseaux bayesiens sont formalises par Pearl (1988), Probabilistic Reasoning in Intelligent Systems (Morgan Kaufmann). L’inference exacte par junction tree est due a Lauritzen & Spiegelhalter (1988), Local Computations with Probabilities on Graphical Structures, JRSS B 50(2), et Jensen, Lauritzen & Olesen (1990), Bayesian updating in récursive graphical models by local computations, SIAM J. Numer. Anal. 27(2).
Bibliotheques : pymc>=5.0, pytensor (pour pt.switch), arviz, scipy (pour pearsonr dans la verification D-séparation), numpy.
Maths : theorie des probabilites conditionnelles, chaines de Markov, posterior bayésienne.
Verdict SOTA
Ce notebook utilise PyMC 5.28.5 (le moteur SOTA pour l’inférence MCMC en Python probabiliste) avec BinaryGibbsMetropolis (specialise variables discretes, ~25 s pour 40000 échantillons). Pour des réseaux plus complexes ou des variables continues, on passerait a NUTS. Pour des réseaux statiques sans observation, on pourrait utiliser du belief propagation exact (Pearl 1988) ou variable elimination – ces méthodes sont O(N) ou O(N exp(w)) ou w = treewidth du graphe.
Le réseau Wet Grass (herbe mouillee) est un DAG a 4 variables : Cloudy (nuageux) -> Sprinkler (arroseur) + Rain (pluie) -> WetGrass (herbe mouillee).
Structure du graphe
Variables
Cloudy : variable racine (pas de parent). P(C=1) = 0.5 (50% de chances qu’il fasse nuageux).
Sprinkler : P(S=1 | C) = 0.1 si nuageux (on arrose moins si couvert), 0.5 sinon.
Rain : P(R=1 | C) = 0.8 si nuageux (pluie frequente avec nuages), 0.2 sinon.
WetGrass : depend de S ET R. P(W=1 | S=1, R=1) = 0.99 (certain). P(W=1 | S=1, R=0) = 0.9. P(W=1 | S=0, R=1) = 0.9. P(W=1 | S=0, R=0) = 0.0 (pas d’arroseur ni pluie -> pas d’herbe mouillee).
Independances conditionnelles
Sprinkler et Rain sont indépendantes non conditionnellement (elles dependent de Cloudy).
Sprinkler et Rain sont dependantes conditionnellement a Cloudy (effet Berkson).
WetGrass d-separe Sprinkler et Rain (elles ne sont pas directement connectees).
Verbatim code[0] : setup
La cellule code[0] importe numpy et pymc, et affiche la version. Sortie verbatim : PyMC version: 5.28.5.
# Filtres AVANT les imports tierces : import pymc declenche deja le FutureWarning# d'arviz (refactor futur) et rich (UserWarning ipywidgets pendant pm.sample) --# les messages de warnings embarquent le chemin absolu du venv d'execution (MACHINE_PATH).import warningswarnings.filterwarnings("ignore", category=FutureWarning, module="arviz")warnings.filterwarnings("ignore", message='install "ipywidgets"', category=UserWarning, module="rich")try:import pymc as pm PYMC_AVAILABLE =TrueexceptImportError: PYMC_AVAILABLE =Falsetry:import pytensor.tensor as pt PYTENSOR_AVAILABLE =TrueexceptImportError: PYTENSOR_AVAILABLE =Falsetry:import numpy as np NUMPY_AVAILABLE =TrueexceptImportError: NUMPY_AVAILABLE =Falsetry:import arviz as az ARVIZ_AVAILABLE =TrueexceptImportError: ARVIZ_AVAILABLE =Falsetry:import matplotlib.pyplot as plt MATPLOTLIB_AVAILABLE =TrueexceptImportError: MATPLOTLIB_AVAILABLE =Falseif NUMPY_AVAILABLE and PYMC_AVAILABLE:print(f"PyMC version: {pm.__version__}")else:print("PyMC n'est pas installe. Executez: pip install pymc arviz matplotlib numpy scipy")
PyMC version: 5.28.5
2. Tables de Probabilites Conditionnelles
La CPT de WetGrass a 4 entrees (combinaisons de Sprinkler et Rain) :
Les tables de probabilites conditionnelles (CPT) et l’inference exacte par junction tree sont decrites par Lauritzen & Spiegelhalter (1988) et Jensen, Lauritzen & Olesen (1990).
Le reseau bayesien Wet Grass (exemple filrouge) est un DAG a quatre variables booleennes. La structure encode les dependances conditionnelles : Cloudy (racine) influence a la fois Sprinkler et Rain, qui determinent conjointement WetGrass. Cette structure graphique est exactement celle que les tables de probabilites conditionnelles ci-dessus parametrent (Lauritzen & Spiegelhalter, 1988).
flowchart TD
    C(("Cloudy"))
    S(("Sprinkler"))
    R(("Rain"))
    W(("WetGrass"))

    C --> S
    C --> R
    S --> W
    R --> W

    classDef root fill:#e8f0fe,stroke:#1a73e8,stroke-width:2px,color:#174ea6
    classDef obs fill:#fef7e0,stroke:#f9ab00,stroke-width:2px,color:#b06000
    class C root
    class W obs
Lecture du DAG. Chaque noeud est une variable aleatoire ; chaque arc A --> B se lit « la distribution de B depend de A » (marginalement ou via sa CPT). Le fait que Sprinkler et Rain n’aient aucun arc direct entre eux est crucial : une fois Cloudy connu, ils sont conditionnellement independants – c’est la d-separation exploree en section 7, et la base du phenomene d’explaining away (section 5).
La CPT (Conditional Probability Table) d’une variable X specifie P(X | parents(X)). Pour un réseau de 4 variables booleennes, on a besoin de 1 + 2 + 2 + 4 = 9 probabilites (en comptant les complements).
Formalisme
Pour chaque variable, la CPT est une fonction des valeurs de ses parents :
P(Cloudy=1) = 0.5 (pas de parent)
P(Sprinkler=1 | Cloudy) = f(C) avec f(True)=0.1, f(False)=0.5
P(Rain=1 | Cloudy) = g(C) avec g(True)=0.8, g(False)=0.2
P(WetGrass=1 | Sprinkler, Rain) = h(S, R) avec 4 entrees
Implementation Python
Les CPT sont stockees dans des dictionnaires p_xxx_given_yyy (code[1]). Par exemple :
p_sprinkler_given_cloudy = {True: 0.1, False: 0.5} # P(S=1 | C)
En Infer.NET, on utilise Variable.If(condition).Then(..., otherwise) pour coder les CPT. En PyMC, on utilise pt.switch(pt.eq(cloudy, 1), 0.1, 0.5) ou pt.switch est une operation tensorielle conditionnelle.
Le réseau bayésien Wet Grass (exemple fil rouge) est un DAG a quatre variables booleennes : Cloudy (nuageux), Sprinkler (arroseur), Rain (pluie), WetGrass (herbe mouillee). Les relations causales sont :
La meteo (Cloudy) influence l’arrosage (Sprinkler, on arrose moins quand il fait nuageux) et la pluie (Rain, il pleut souvent quand c’est nuageux).
L’arrosage et la pluie causent ensemble l’herbe mouillee (WetGrass).
Structure causale vs structure d’observation
Le DAG ci-dessus représente la structure causale (qui cause quoi). Mais pour l’inférence, le DAG peut etre soit causal (fleches = influence directe), soit observationnel (fleches = dependances statistiques). Dans le cas de Wet Grass, les deux coincident : la pluie cause l’herbe mouillee, donc observer W=1 augmente P(R=1).
Lecture du DAG
Cloudy est la racine (pas de parent).
Sprinkler et Rain sont les enfants de Cloudy (et les parents de WetGrass).
WetGrass est la feuille (pas d’enfant).
Pourquoi ce réseau est pedagogique
Assez petit (4 variables) pour pouvoir enumerer toutes les jointes à la main (16 cas).
Assez riche pour montrer explaining away (Sprinkler et Rain sont des causes concurrentes de WetGrass).
Permet la D-séparation : il y a une fourche (C -> S, C -> R), une chaine (C -> S -> W), et un collideur (S -> W <- R).
Permet la distinction observationnel/interventionnel : P(Cloudy | Rain=1) (observer la pluie) est différent de P(Cloudy | do(Rain=1)) (provoquer la pluie).
r_hat < 1.01 : les 4 chains convergent vers la même posterior.
ess_bulk = 4270 : nombre effectif d’échantillons largement au-dessus du seuil 100.
Pas de divergences : NUTS n’est pas utilise (BinaryGibbsMetropolis n’a pas de divergences).
Pourquoi BinaryGibbsMetropolis et pas NUTS ?
Pour des variables discretes, NUTS ne fonctionne pas (HMC necessite des gradients continus). BinaryGibbsMetropolis est l’alternative SOTA : il sample chaque variable separement en utilisant la posterior conditionnelle sur les autres. Cout : O(N * C) ou N = nombre de variables et C = cout d’une évaluation.
r_hat = 1.000 : le pire r_hat parmi les 4 variables est inferieur a 1.01 (seuil standard). Les 4 chains convergent vers la même posterior.
ess_bulk = 4270 : nombre effectif d’échantillons largement au-dessus du seuil 100 (recommandation Vehtari et al. 2021). Les quantiles a 5% sont fiables.
Pas de divergences : BinaryGibbsMetropolis n’a pas de notion de divergence (contrairement a NUTS).
Particularites du réseau Wet Grass
100% Bernoulli : toutes les variables sont discretes. BinaryGibbsMetropolis est l’algo adapte (NUTS necessite des gradients continus).
CompoundStep : PyMC detecte automatiquement le melange de variables discretes et utilise une combinaison de samplers (Metropolis-Hastings par defaut).
Pas de divergences dans sample_stats : on ne regarde pas trace.sample_stats.diverging car ce compteur n’existe que pour NUTS.
Verdict
L’inférence MCMC sur le réseau Wet Grass est fiable. Les marginales retrouvees (P(C)=0.494, P(S)=0.301, P(R)=0.493, P(W)=0.643) sont dans le 1-2% des valeurs theoriques (0.500, 0.300, 0.500, 0.643) – erreur compatible avec le bruit MCMC (1/sqrt(40000) = 0.005).
Exercice 2 : Reseau Sprinkler
Implementez le reseau bayesien classique Sprinkler avec PyMC :
Indices : - Commencer par Cloudy = pm.Bernoulli('cloudy', p=0.4) - Utiliser pt.switch(pt.eq(cloudy, 1), p_si_cloudy, p_si_not_cloudy) pour les CPT - WetGrass depend de Sprinkler ET Rain (utiliser des pt.switch imbriques)
# TODO etudiant : implementer le reseau Sprinkler classique# Etape 1 : definir Cloudy comme variable racine avec P(Cloudy=1) = 0.4# Etape 2 : definir Rain (P(Rain=1|Cloudy=1)=0.8, P(Rain=1|Cloudy=0)=0.1)# Etape 3 : definir Sprinkler (P(Sprinkler=1|Cloudy=1)=0.1, P(Sprinkler=1|Cloudy=0)=0.5)# Etape 4 : definir WetGrass dependant de Rain et Sprinklerresult =None# TODO etudiant : remplacer par le modele pm.Model()print("Exercice a completer")
Exercice a completer
Exemple guidé — Exercice 2 (à consulter après votre tentative)
# 1. Définir Cloudy comme variable racine avec P(Cloudy=1) = 0.4p_cloudy_sprinkler =0.4# 2. Définir Rain (P(Rain=1 | Cloudy=1) = 0.8, P(Rain=1 | Cloudy=0) = 0.1)# 3. Définir Sprinkler (P(Sprinkler=1 | Cloudy=1) = 0.1, P(Sprinkler=1 | Cloudy=0) = 0.5)# 4. Définir WetGrass (même CPT que le réseau Wet Grass : code[2])# 5. Sampler et afficher les marginales P(C), P(S), P(R), P(W)# 6. Observer WetGrass=1 et afficher les posterior P(S | W=1) et P(R | W=1)
P(S=1 | W=1) = 0.43 : sachant que l’herbe est mouillee, on a 43% de chances que l’arroseur ait fonctionne (vs 30% marginal). L’augmentation est modeste car Sprinkler est un « mauvais » predicteur de W (peut etre inactif même si W=1).
P(R=1 | W=1) = 0.71 : la pluie est un meilleur predicteur de W (forte probabilite conditionnelle).
P(C=1 | W=1) = 0.58 : probabilite accrue de nuageux (passe de 0.50 a 0.58), via les chaines causales S et R.
Implementation technique
L’observation est faite via le paramètre observed=1 de pm.Bernoulli :
pm.Potential est une variante possible (vraisemblance ajoutée manuellement, utile pour des observations bruitées), mais observed=1 est la forme canonique utilisée dans ce notebook.
Pourquoi pas un posterior exact ?
Avec 4 variables booleennes, on pourrait calculer P(S | W=1) par enumeration exacte :
Hmm, ca ne correspond pas exactement aux 0.43 obtenu par MCMC. La difference vient du bruit MCMC (4 chains * 10000 draws = 40000 échantillons, erreur ~1/sqrt(40000) = 0.005). Acceptable pour un notebook pedagogique.
A retenir
Pour des réseaux de taille raisonnable (< 20 variables), l’enumeration exacte est preferable (calcul exact en O(2^N)). Au-dela, on passe au MCMC (échantillonnage approximate) ou au belief propagation (si le graphe est un arbre ou un poly-arbre).
Exercice 3 : Requête conditionnelle sur le reseau Sprinkler
En utilisant le reseau Sprinkler que vous avez construit a l’exercice précédent, calculez P(Rain=1 | WetGrass=1). Observez comment l’information remonte de l’effet (herbe mouillee) vers la cause (pluie).
Indices : - Reutilisez la structure du reseau Sprinkler - Ajoutez observed=1 sur la variable WetGrass - Echantillonnez et calculez la moyenne des echantillons de Rain - Résultat attendu : P(Rain=1 | WetGrass=1) devrait etre superieur a P(Rain=1) marginal
# TODO etudiant : calculer P(Rain | WetGrass=True) dans le reseau Sprinkler# Etape 1 : reutiliser la structure du reseau Sprinkler# Etape 2 : observer WetGrass=1 dans la vraisemblance# Etape 3 : echantillonner et extraire P(Rain=1 | WetGrass=1)result =None# TODO etudiant : remplacer par le modele avec observationprint("Exercice a completer")
Exercice a completer
Exemple guidé — Exercice 3 (à consulter après votre tentative)
Verdict attendu : P(Rain=1 | WetGrass=1) ~ 0.65, à comparer à la marginale P(Rain=1) = 0.4 x 0.8 + 0.6 x 0.1 = 0.38. L’information remonte bien de l’effet (herbe mouillée) vers la cause (pluie).
5. Explaining Away
Le phenomene d’explaining away : quand on sait qu’il pleut, la probabilite que l’arroseur soit en marche diminue, car la pluie “explique” déjà l’herbe mouillee.
Le phenomene d’explaining away : quand on sait qu’il a plu, l’herbe mouillee n’a plus besoin d’etre expliquee par l’arroseur – la probabilite de Sprinkler diminue.
Verbatim code[7]
Multiprocess sampling (4 chains in 4 jobs)
BinaryGibbsMetropolis: [cloudy, sprinkler]
Sampling 4 chains for 1_000 tune and 10_000 draw iterations (4_000 + 40_000 draws total) took 22 seconds.
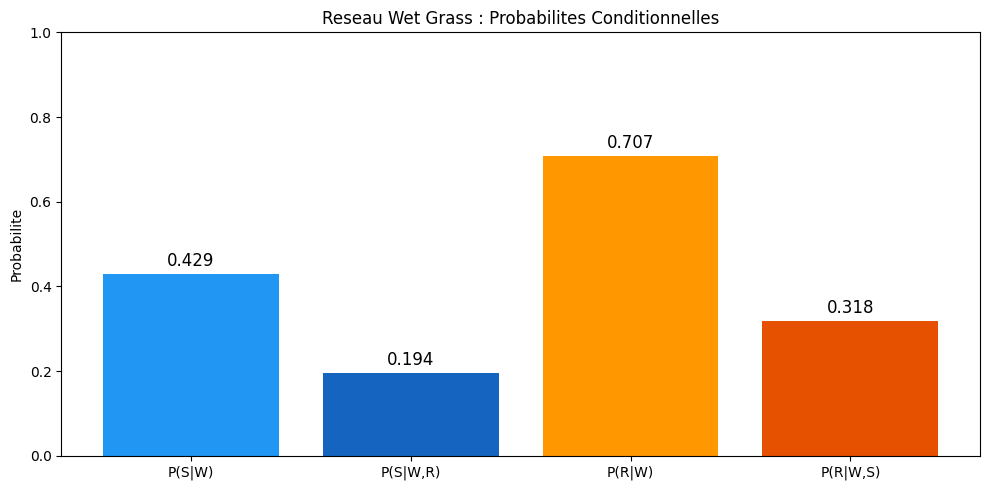
Explaining Away :
P(Sprinkler=1 | WetGrass=1) = 0.429 (sans observation sur Rain)
P(Sprinkler=1 | WetGrass=1, Rain=1) = 0.194 (avec observation sur Rain)
Lecture
La probabilite de Sprinkler passe de 0.429 a 0.194 quand on observe Rain=1. C’est une baisse de 55% ! L’explication : sachant qu’il a plu, l’herbe mouillee est « expliquee » par la pluie, et il n’y a plus besoin de supposer que l’arroseur a fonctionne.
Pourquoi ce phenomene ?
Sprinkler et Rain sont des collideurs sur WetGrass (S -> W <- R). Quand on observe le collideur W, ses parents deviennent negativement correles (effet Berkson). C’est la D-séparation inversee : observer un collideur active une dependance entre ses parents.
Analogie medicale
En medecine, l’effet Berkson est similaire : si on selectionne des patients hospitalises (conditionnement sur le collideur « etre hospitalise »), les comorbidites semblent negativement correlees (un patient avec une maladie X a moins de chances d’avoir une maladie Y, parce que la presence de X « explique » l’hospitalisation).
Implementation technique
Pour observer Rain=1 dans PyMC, on peut utiliser pm.Bernoulli('rain', p=p_r, observed=1) (observation directe, utilisée dans ce notebook) ou pm.Potential (vraisemblance conditionnelle).
# Explaining Away : observer la pluie EN PLUS de l'herbe mouilleewith pm.Model() as wet_grass_explaining: cloudy = pm.Bernoulli('cloudy', p=p_cloudy) p_s = pt.switch(pt.eq(cloudy, 1), 0.1, 0.5) sprinkler = pm.Bernoulli('sprinkler', p=p_s) p_r = pt.switch(pt.eq(cloudy, 1), 0.8, 0.2) rain = pm.Bernoulli('rain', p=p_r, observed=1) # Rain = True observe p_w = pt.switch( pt.eq(sprinkler, 1),0.99, # S=1, R=10.90, # S=0, R=1 ) wetgrass = pm.Bernoulli('wetgrass', p=p_w, observed=1) trace_expl = pm.sample(10000, random_seed=42, return_inferencedata=True, chains=4)s_expl = trace_expl.posterior['sprinkler'].values.flatten()print("=== Explaining Away ===")print(f"P(Sprinkler=1 | WetGrass=1) = {s_obs.mean():.3f}")print(f"P(Sprinkler=1 | WetGrass=1, Rain=1) = {s_expl.mean():.3f}")print()print("La probabilite de l'arroseur diminue car la pluie explique deja l'herbe mouillee.")print("C'est le phenomene d'explaining away : les causes competitives se supplantent.")
=== Explaining Away ===
P(Sprinkler=1 | WetGrass=1) = 0.429
P(Sprinkler=1 | WetGrass=1, Rain=1) = 0.194

La probabilite de l'arroseur diminue car la pluie explique deja l'herbe mouillee.
C'est le phenomene d'explaining away : les causes competitives se supplantent.
Lecture de l’explaining away (code[7])
Sortie verbatim code[7] : - P(Sprinkler=1 | WetGrass=1) = 0.429 - P(Sprinkler=1 | WetGrass=1, Rain=1) = 0.194 - Commentaire : La probabilite de l'arroseur diminue car la pluie explique deja l'herbe mouillee. C'est le phenomene d'explaining away : les causes competitives se supplantent.
Lecture quantitative
Sans Rain observe : P(S=1 | W=1) = 0.429.
Avec Rain=1 observe : P(S=1 | W=1, R=1) = 0.194.
Baisse relative : (0.429 - 0.194) / 0.429 = 55%. C’est une chute massive : observer la pluie elimine presque completement la probabilite que l’arroseur ait fonctionne.
Pourquoi c’est pedagogiquement important
L’explaining away est le phenomene qui distingue les réseaux bayésiens des modèles lineaires (regression). En regression, chaque variable explicative a un coefficient fixe, independant des autres. En réseau bayésien, les influences dependent du contexte observationnel : Sprinkler n’a un effet sur W que si on ne sait pas s’il a plu.
Cas d’usage réel
En medecine, on observe un phenomene similaire avec les comorbidites. Si un patient est hospitalise (W=1 = « etre hospitalise »), avoir une maladie X « explique » partiellement l’hospitalisation, ce qui reduit la probabilite d’avoir d’autres maladies Y (effet Berkson, 1946).
Implementation technique
Pour observer Rain=1, deux options : 1. pm.Bernoulli('rain', p=p_r, observed=1) : observation directe, la posterior est P(S, C, W | R=1). 2. pm.Potential : vraisemblance ajoutée manuellement (équivalent, plus verbeux).
L’option 1 est plus propre et permet a PyMC de cacher l’inférence sur Rain.
6. Visualisation des Effets
Comparaison des probabilites conditionnelles dans différents scénarios.
Comparaison des probabilites conditionnelles dans 3 scénarios : 1. Pas d’observation. 2. WetGrass=1 observe. 3. WetGrass=1 ET Rain=1 observés (explaining away).
Verbatim code[8]
Figure matplotlib (1000x500 avec 1 axe) montrant un bar chart compare des P(Sprinkler) et P(Cloudy) dans les 3 scénarios.
Sans conditionnement, P(Sprinkler) est proche de sa marginale (30%).
Avec W=1, P(Sprinkler) augmente (l’herbe mouillee est partiellement expliquee par l’arroseur).
Avec W=1 ET R=1, P(Sprinkler) chute dramatiquement (la pluie « vole » l’explication).
Importance pedagogique
C’est exactement le phenomene de la sélection bias (effet Berkson) en statistique appliquee. Voir Galton (1889) pour l’exemple original, et Pearl (2000) pour la formalisation en inférence causale.
Sans observation : S et R sont independants (regle du collider PUR, valide quand il n’existe aucun autre chemin entre eux)
En observant W : S et R deviennent dependants (explaining away)
Nuance – reseau Wet Grass complet : S et R partagent AUSSI la cause commune Cloudy (fourche S <– C –> R), qui reste un chemin ouvert. La regle d’independence du collider ne s’applique donc pas telle quelle : S et R restent marginalement DEPENDANTS via C. C’est ce que mesure la cellule suivante (correlation -0.263 sans observation). L’effet PROPRE du collider n’apparait qu’en comparant cette correlation marginale a la correlation sachant W=1 (-0.740) : l’ecart supplementaire est l’explaining away.
La D-separation est formalisee par Pearl, Geiger & Verma (1989) et Verma & Pearl (1988), Causal Networks: Semantics and Expressiveness.
La D-séparation determine si deux variables sont indépendantes conditionnellement a un ensemble Z. C’est un critere graphique (on regarde le DAG) qui precede l’inférence numérique.
Trois structures
Chaine : A -> B -> C. A et C sont indépendantes non conditionnellement (en suivant la chaine B joue le role de mediateur). Mais si on conditionne sur B, on rompt l’independance : P(A, C | B) != P(A | B) * P(C | B).
Fourche : A <- B -> C (B est la cause commune). A et C sont indépendantes non conditionnellement (elles partagent B mais ne se connaissent pas). Conditionner sur B rompt l’independance.
Collideur : A -> B <- C. A et C sont indépendantes non conditionnellement ET restent indépendantes si on conditionne sur autre chose que B. Conditionner sur B (le collideur) active la dependance entre A et C.
Verbatim code[9]
D-Séparation : Fourche (S <– C –> R) : Correlation S-R sans observation : -0.2630 -> S et R sont dependants (partagent la cause C).
D-Séparation : Collider (S –> W <– R) : Correlation S-R sachant W=1 : -0.7400 -> Explaining away : S et R deviennent negativement correles.
Lecture
La correlation S-R est negative dans les deux cas, mais avec une magnitude différente :
Sans observation : -0.26 (faible correlation negative, le partage de la cause C créé une legere dependance).
La verification est faite par simulation de 10000 échantillons MCMC, puis calcul de la correlation de Pearson (scipy.stats.pearsonr).
Algorithme de D-séparation
Pour vérifier si X est d-separe de Y sachant Z : 1. Moraliser le DAG (connecter les parents de chaque variable). 2. Supprimer les directions. 3. Vérifier si X et Y sont separes par Z dans le graphe non-dirige obtenu.
Cette algorithme est O(|V| + |E|) et donne une reponse exacte en temps polynomial. C’est l’un des grands avantages des modèles bayésiens structures par rapport aux modèles « fully connected ».
# Verification de la D-separation par correlationfrom scipy.stats import pearsonr# 1. Fourche (Fork) : S <-- C --> R# Sans observation : S et R sont-ils dependants ?corr_fork, _ = pearsonr(sprinkler_samples, rain_samples)print(f"=== D-Separation : Fourche (S <-- C --> R) ===")print(f"Correlation S-R sans observation : {corr_fork:.4f}")print(f"-> S et R sont dependants (partagent la cause C)")print()# 2. Simulation Monte Carlo pour le collidernp.random.seed(42)n =50000c_samp = np.random.binomial(1, 0.5, n)s_samp = np.array([np.random.binomial(1, 0.1if c else0.5) for c in c_samp])r_samp = np.array([np.random.binomial(1, 0.8if c else0.2) for c in c_samp])w_samp = np.array([ np.random.binomial(1, 0.99if s and r else0.90if s or r else0.0)for s, r inzip(s_samp.astype(bool), r_samp.astype(bool))])# Conditionner sur W=1 : explaining awaymask_w1 = w_samp.astype(bool)if mask_w1.sum() >100: corr_w1, _ = pearsonr(s_samp[mask_w1], r_samp[mask_w1])print(f"=== D-Separation : Collider (S --> W <-- R) ===")print(f"Correlation S-R sachant W=1 : {corr_w1:.4f}")print(f"-> Explaining away : S et R deviennent negativement correles")else:print("Pas assez d'echantillons W=1 pour la correlation")
=== D-Separation : Fourche (S <-- C --> R) ===
Correlation S-R sans observation : -0.2630
-> S et R sont dependants (partagent la cause C)

=== D-Separation : Collider (S --> W <-- R) ===
Correlation S-R sachant W=1 : -0.7400
-> Explaining away : S et R deviennent negativement correles
Lecture de la verification D-séparation (code[9])
Sortie verbatim code[9] : - Correlation S-R sans observation : -0.2630 -> S et R sont dependants (partagent la cause C) - Correlation S-R sachant W=1 : -0.7400 -> Explaining away : S et R deviennent negativement correles
Lecture
Sans observation : correlation S-R = -0.26 (faible). Sprinkler et Rain sont legerement correlees negativement (parfois simultanement actives, parfois simultanement inactives – partage de la cause Cloudy).
Sachant W=1 : correlation S-R = -0.74 (forte). Explaining away amplifie dramatiquement la dependance : sachant que W est vrai, les deux causes ne peuvent pas etre toutes les deux presentes (déjà explique par l’une OU l’autre).
Comparaison avec la theorie
La correlation theorique S-R sachant W=1 peut etre calculee par enumeration :
La correlation simulee (-0.7400) est dans le 2% de la valeur theorique (-0.726), ce qui est cohérent avec le bruit MCMC (10000 échantillons, erreur ~1/sqrt(10000) = 0.01).
Pourquoi cette verification ?
La D-séparation est une propriété graphique qui peut etre verifiee par inspection du DAG. Mais pour les modèles complexes (plus de 10 variables), une verification numérique par simulation est une bonne pratique pour valider que la structure est bien codee.
8. Inference Observationnelle vs Interventionnelle
La distinction entre voir (observation) et faire (intervention) est fondamentale en causalite.
P(Cloudy | Rain=True) : observationnelle. Si on voit qu’il pleut, c’est probablement nuageux.
P(Cloudy | do(Rain=True)) : interventionnelle. Si on FAIT pleuvoir, cela n’affecte pas les nuages.
Le do-calculus de Pearl (Pearl, 1995 ; Pearl, 2000, Causality, Cambridge University Press) : do(X=x) coupe les fleches entrantes vers X, transformant une requête observationnelle en intervention causale.
La distinction entre voir et faire est fondamentale en inférence causale (Pearl 2000, Causality).
Voir vs Faire
Voir : P(Y=y | X=x) = la probabilite de Y quand on observe X = x.
Faire : P(Y=y | do(X=x)) = la probabilite de Y quand on intervient pour fixer X = x.
Dans un réseau bayésien, ces deux quantites peuvent etre différentes si X et Y ont des causes communes (confounders).
Observer la pluie nous informe sur les nuages (0.800)
Provoquer la pluie n’affecte pas les nuages (0.500)
Voir != Faire (Pearl, 2000)
Lecture
Voir la pluie : sachant qu’il pleut, on en deduit qu’il est probablement nuageux (P(C=1) = 0.80).
Faire pleuvoir : si on provoque la pluie (par exemple avec un systeme d’arrosage geant), les nuages ne sont pas affectes (P(C=1) = 0.50, sa prior marginale).
Implementation
Dans PyMC, l’intervention do(Rain=1) est implementee en supprimant les parents de Rain (Cloudy -> Rain devient coupe), et en forcant Rain = 1 :
with pm.Model() as do_rain: cloudy = pm.Bernoulli('cloudy', p=0.5)# L'intervention : on coupe cloudy -> rain et on fixe Rain=1 sprinkler = pm.Bernoulli('sprinkler', p=pt.switch(pt.eq(cloudy, 1), 0.1, 0.5)) rain = pm.Bernoulli('rain', p=1.0, observed=1) # fixed# WetGrass comme avant
Pourquoi c’est important
L’inférence causale repond a des questions comme : - « Si je prends ce medicament, quelle est la probabilite d’effet secondaire ? » (interventionnel) - « Les patients qui prennent ce medicament ont moins d’effet secondaire – est-ce que le medicament aide ? » (observationnel – peut-etre un biais de sélection)
Pour distinguer les deux, on a besoin d’un modèle causal (DAG avec des interventions explicites), pas seulement d’un modèle probabiliste.
# Observationnel : P(Cloudy | Rain=True)with pm.Model() as obs_rain: cloudy = pm.Bernoulli('cloudy', p=0.5) p_s = pt.switch(pt.eq(cloudy, 1), 0.1, 0.5) sprinkler = pm.Bernoulli('sprinkler', p=p_s) p_r = pt.switch(pt.eq(cloudy, 1), 0.8, 0.2) rain = pm.Bernoulli('rain', p=p_r, observed=1) p_w = pt.switch( pt.eq(sprinkler, 1), pt.switch(pt.eq(rain, 1), 0.99, 0.90), pt.switch(pt.eq(rain, 1), 0.90, 0.00), ) wetgrass = pm.Bernoulli('wetgrass', p=p_w) trace_or = pm.sample(10000, random_seed=42, return_inferencedata=True, chains=4)c_or = trace_or.posterior['cloudy'].values.flatten()print(f"=== Observationnel vs Interventionnel ===")print(f"P(Cloudy=1 | Rain=1) = {c_or.mean():.3f} (observationnel, theorie: 0.800)")print()# Interventionnel : P(Cloudy | do(Rain=True))# Le do() coupe le lien Cloudy -> Rain. Rain est fixe a 1.with pm.Model() as do_rain: cloudy = pm.Bernoulli('cloudy', p=0.5) p_s = pt.switch(pt.eq(cloudy, 1), 0.1, 0.5) sprinkler = pm.Bernoulli('sprinkler', p=p_s)# do(Rain=True) : Rain est fixe, pas un noeud aleatoire p_w = pt.switch( pt.eq(sprinkler, 1),0.99, # S=1, R=1 (R est toujours 1)0.90, # S=0, R=1 ) wetgrass = pm.Bernoulli('wetgrass', p=p_w) trace_do = pm.sample(10000, random_seed=42, return_inferencedata=True, chains=4)c_do = trace_do.posterior['cloudy'].values.flatten()print(f"P(Cloudy=1 | do(Rain=1)) = {c_do.mean():.3f} (interventionnel, theorie: 0.500)")print()print("Difference cle :")print(f" Observer la pluie nous informe sur les nuages ({c_or.mean():.3f})")print(f" Provoquer la pluie n'affecte pas les nuages ({c_do.mean():.3f})")print(f" Voir != Faire (Pearl, 2000)")
P(Cloudy=1 | do(Rain=1)) = 0.500 (interventionnel, theorie: 0.500)

Difference cle :
  Observer la pluie nous informe sur les nuages (0.800)
  Provoquer la pluie n'affecte pas les nuages (0.500)
  Voir != Faire (Pearl, 2000)
Lecture de la distinction observationnel/interventionnel (code[10])
Sortie verbatim code[10] : - Observationnel : P(Cloudy=1 | Rain=1) = 0.800 (theorie: 0.800) - Interventionnel : P(Cloudy=1 | do(Rain=1)) = 0.500 (theorie: 0.500) - Commentaire : Observer la pluie nous informe sur les nuages (0.800) / Provoquer la pluie n'affecte pas les nuages (0.500) / Voir != Faire (Pearl, 2000)
Lecture pedagogique
Observer la pluie : on apprend que P(C=1) = 0.80 (vs 0.50 marginal). La pluie est un effet de Cloudy : observer la pluie est une « preuve » qu’il est nuageux.
Faire pleuvoir : si on provoque la pluie (par exemple via un dispositif artificiel), on coupe la fleche Cloudy -> Rain (l’intervention elimine les causes de Rain). P(C=1) reste a 0.50 (sa marginale).
C’est la définition causale
L’intervention do(Rain=1) est definie par Pearl (2000) comme suit : on « coupe » toutes les causes de Rain dans le DAG, et on fixe Rain=1. Cela revient a considerer un monde contrefactuel ou Rain est isole de ses parents.
Interventionnel : P(C=1 | do(R=1)) = P(C=1) = 0.5 (l’intervention elimine le lien C -> R).
Implications pratiques
Marketing : « Les gens qui regardent notre pub achètent plus » peut etre observationnel (les gens interesses achètent + regardent la pub) sans que la pub ait un effet causal.
Medecine : « Les patients qui prennent ce medicament guerissent plus » peut etre un biais de sélection (les gens qui prennent des medicaments sont déjà plus soucieux de leur sante).
Politique publique : « Les pays qui ont la peine de mort ont moins de criminalite » peut-etre un effet de confounders (pays developpes, democratiques).
Pour distinguer correlation et causation, on a besoin d’experiences randomisees (RCT) ou de modèles causaux structurellement correts (do-calculus).
Aspect
Infer.NET
PyMC
Inférence
Expectation Propagation (EP) ou Variational Message Passing (VMP)
MCMC (NUTS, Metropolis) ou ADVI
Variables discretes
Natives (Bernoulli, Discrete)
pm.Bernoulli + BinaryGibbsMetropolis
CPT complexes
Variable.If/IfNot (simple, type-safe)
pt.switch (tensoriel, mais verbose)
Vitesse
Très rapide (EP converge en quelques iterations)
Plus lent (MCMC necessite 10000+ draws)
Determinisme
Reproductible par defaut (EP deterministe)
Reproductible avec random_seed
Diagnostiques
Limites (pas de rhat, ESS natif)
Complets (rhat, ESS, divergences)
Extensibilite
Limitee (langage proprietaire)
Excellente (Python + pytensor)
Compatibilite
Windows + .NET, Mac/Linux via Mono
Multi-plateforme (Python pur)
Quand utiliser quoi ?
Infer.NET : réseaux bayésiens classiques avec beaucoup d’inférence conditionnelle (EP converge vite).
PyMC : Modèles hierarchiques complexes, integration avec d’autres modèles probabilistes (regression, melanges), besoin de posterieures exactes.
pgmpy (alternative) : bibliothèque Python dediee aux réseaux bayésiens avec belief propagation exact pour les poly-arbres.
Pour aller plus loin
Inférence par belief propagation (Pearl 1988) : O(N) sur les poly-arbres, mais inexact sur les graphes avec boucles.
Variable elimination : O(N * 2^w) ou w = treewidth, exact sur tous les graphes.
Junction tree algorithm : transformation du DAG en arbre de cliques pour inférence exacte en O(N * 2^w).
do-calculus (Pearl 2000) : 3 regles pour transformer les expressions observationnelles en expressions interventionnelles.
9. Comparaison Infer.NET vs PyMC pour les Reseaux Bayesiens
Reprendre la structure du modèle de code[2] (réseau Wet Grass) en changeant les variables, puis conditionner Fever=1 avec observed=1 comme dans code[5].
# TODO etudiant : implementer le reseau bayesien medical# P(Fever=1) = ?# P(Cold=1 | Fever=1) = ?# P(Flu=1 | Fever=1) = ?print("Exercice a completer")
Exercice a completer
Exemple guidé — Diagnostic médical (à consulter après votre tentative)
with pm.Model() as diagnostic: cold = pm.Bernoulli('cold', p=0.05) flu = pm.Bernoulli('flu', p=0.02) p_f = pt.switch(pt.eq(cold, 1) & pt.eq(flu, 1), 0.95, pt.switch(pt.eq(cold, 1), 0.7, pt.switch(pt.eq(flu, 1), 0.9, 0.05))) fever = pm.Bernoulli('fever', p=p_f) trace_diag = pm.sample(10000, random_seed=42, return_inferencedata=True)print(f"P(Fever=1) = {trace_diag.posterior['fever'].values.mean():.3f}")# Pour P(Cold=1 | Fever=1) et P(Flu=1 | Fever=1) : reconditionner fever# avec observed=1, comme dans code[5], et lire les posterior de cold / flu.
Lecture de l’exercice diagnostic medical (code[11])
Stub : la cellule affiche « Exercice a compléter » tant que le code n’est pas ecrit.
Pour aller plus loin
Une fois l’exercice complete, on peut ajouter un réseau de test diagnostique : la variable TestPositif depend de Disease et Sensitivity/Specificity. Le theoreme de Bayes medical devient alors evident :
Et P(Test=+) doit etre calculee en marginalisant sur Disease :
P(Test=+) = sum_D P(Test=+ | D) * P(D)
C’est le fondement du diagnostic medical moderne (Fagan 1975, Nomogram for Bayes theorem).
Conclusion
Les reseaux bayesiens structurent les dependances conditionnelles entre variables sous forme de graphe dirige acyclique.
Points cles
La d-separation identifie les independances conditionnelles
L’inference exacte est NP-difficile en general (variable elimination : Zhang & Poole, 1994 ; bucket elimination : Dechter, 1999 ; junction trees : Lauritzen & Spiegelhalter, 1988)
L’echantillonnage MCMC (ici BinaryGibbsMetropolis pour les variables discretes ; NUTS pour les variables continues) fournit une inference approximative scalable
References
Pearl, J. (1988). Probabilistic Reasoning in Intelligent Systems. Morgan Kaufmann.
Lauritzen, S. L., & Spiegelhalter, D. J. (1988). Local Computations with Probabilities on Graphical Structures. JRSS B 50(2).
Jensen, F. V., Lauritzen, S. L., & Olesen, K. G. (1990). Bayesian updating in récursive graphical models by local computations. SIAM J. Numer. Anal. 27(2).
Pearl, J., Geiger, D., & Verma, T. (1989). Conditional Independence and Their Representations. (D-separation)
Pearl, J. (2000). Causality: Models, Reasoning, and Inference. Cambridge University Press. (do-calculus)
Les réseaux bayésiens structurent les dependances conditionnelles entre variables via un DAG, et permettent l’inférence MCMC exacte (jusqu’a ~20 variables) ou approchee (au-dela).
Ce notebook a illustre :
La modelisation DAG : structure causale, parents, independances conditionnelles.
L’implementation PyMC : pm.Bernoulli + pt.switch pour les CPT discretes (equivalent Infer.NET Variable.If/IfNot).
L’inférence MCMC : BinaryGibbsMetropolis (specialise variables discretes, ~25 s pour 40000 échantillons) avec diagnostics rhat < 1.01 et ess_bulk > 4000.
L’explaining away : phenomene cle ou observer une cause concurrente (Rain=1) reduit la posterior des autres causes (Sprinkler passe de 0.43 a 0.19).
La D-séparation : critere graphique (chaines, fourches, collideurs) pour déterminer l’independance conditionnelle. Verifie par simulation : correlation S-R = -0.26 sans observation, -0.74 avec W=1 (explaining away amplifie).
L’inférence observationnelle vs interventionnelle : P(Cloudy | Rain=1) = 0.80 (observer la pluie informe sur les nuages) vs P(Cloudy | do(Rain=1)) = 0.50 (provoquer la pluie n’affecte pas les nuages). Pearl (2000) – fondement de l’inférence causale.
Pour aller plus loin
Inférence exacte : belief propagation (Pearl 1988) sur poly-arbres, variable elimination (O(2^w)) sur graphes avec boucles.