Duree estimee : 50 minutes Objectifs : - Comprendre le système TrueSkill (Xbox Live) - Implementer des matchs 1v1 et la mise a jour des skills - Gerer les matchs nuls avec contraintes d’intervalle - Maitriser l’apprentissage en ligne (posterieurs deviennent priors) - Etendre aux équipes et multi-joueurs
Prerequis : PyMC-7 (modèles de competences IRT), statistiques
try:import numpy as np NUMPY_AVAILABLE =TrueexceptImportError: NUMPY_AVAILABLE =Falsetry:import pymc as pm PYMC_AVAILABLE =TrueexceptImportError: PYMC_AVAILABLE =Falsetry:import pytensor.tensor as pt PYTENSOR_AVAILABLE =TrueexceptImportError: PYTENSOR_AVAILABLE =Falsetry:import arviz as az ARVIZ_AVAILABLE =TrueexceptImportError: ARVIZ_AVAILABLE =Falsetry:from scipy import stats SCIPY_AVAILABLE =TrueexceptImportError: SCIPY_AVAILABLE =Falsetry:import matplotlib.pyplot as plt MATPLOTLIB_AVAILABLE =TrueexceptImportError: MATPLOTLIB_AVAILABLE =Falseif NUMPY_AVAILABLE and PYMC_AVAILABLE:print(f"PyMC version: {pm.__version__}")else:print("PyMC n'est pas installe. Executez: pip install pymc arviz matplotlib numpy scipy")
PyMC version: 6.3.1
# Diagnostic de convergence (#12475) : appele apres CHAQUE pm.sample.# Un posterior ne se lit qu'apres r_hat <= 1.01, ess_bulk > 100 et zero# divergence -- les avertissements NUTS sont bloquants, pas informatifs.def diagnostic_summary(trace, var_names, label): summ = az.summary(trace, var_names=var_names, round_to=3) div =int(trace.sample_stats['diverging'].sum())print(f"--- Diagnostic de convergence : {label} ---")print(f"Divergences : {div}")print(summ[['mean', 'sd', 'ess_bulk', 'ess_tail', 'r_hat']].to_string()) bad = summ[(summ['r_hat'] >1.01) | (summ['ess_bulk'] <100)]iflen(bad) ==0and div ==0:print("Verdict : convergence OK (r_hat <= 1.01, ess_bulk > 100, 0 divergence).")else:print("Verdict : NON CONVERGE -- posterior non interpretable tel quel :")print(bad[['ess_bulk', 'ess_tail', 'r_hat']].to_string() iflen(bad) else'')print()
1. Introduction a TrueSkill
TrueSkill est le système de classement bayesien developpe par Microsoft Research pour Xbox Live.
Source primaire : Herbrich, Minka & Graepel (2007), TrueSkill(TM): A Bayesian Skill Rating System (NeurIPS / Microsoft Research Cambridge). C’est ce papier qui formalise le modèle (skill Gaussien latent, comparaison de performances, mise a jour bayesienne) et surtout l’astuce algorithmique qui le rend operationnel a l’echelle d’Xbox Live : l’Expectation Propagation (EP) sur un graphe de facteurs (voir section 7 bis).
Principe
Chaque joueur a un skill modelise par une Gaussienne : - mu : estimation du skill - sigma : incertitude sur cette estimation
Elo : le predecesseur deterministe que TrueSkill generalise
Avant TrueSkill, le classement competitif etait domine par Elo (chess, 1960s), que la cellule suivante implemente from-scratch. Chaque joueur y est represente par un unique scalaire\(R\) (son rating) :
\(K\) : facteur de mise a jour FIXE (typiquement 16 a 32).
Elo est simple, robuste et eprouve. Mais il est deterministe et ponctuel : il ne modelise pas son incertitude. La cellule suivante montre concretement ce que cela implique, et pourquoi Microsoft a developpe TrueSkill pour Xbox Live.
# Elo : le systeme de classement deterministe que TrueSkill generalise.# Implementation from-scratch (pure Python, deterministe) pour servir de baseline.import mathdef expected_score(rating_a, rating_b):"""Score attendu de A contre B (formule Elo standard, echelle 400)."""return1.0/ (1.0+10** ((rating_b - rating_a) /400.0))def update_elo(rating_a, rating_b, score_a, K=32):"""Mise a jour Elo : R_a += K * (resultat - attendu). K est FIXE.""" ea = expected_score(rating_a, rating_b)return rating_a + K * (score_a - ea), rating_b - K * (score_a - ea) # somme nulleprint("ELO : LE PREDECESSEUR DETERMINISTE")print("="*60)# Deux nouveaux joueurs, meme rating initial (convention Elo : 1500).R1, R2 =1500.0, 1500.0print(f"Avant : R1 = {R1:.1f}, R2 = {R2:.1f} (deux nouveaux joueurs)")print(f" Score attendu de J1 : E = {expected_score(R1, R2):.3f}")# Joueur 1 gagne (resultat = 1).R1, R2 = update_elo(R1, R2, score_a=1.0)print(f"Apres (J1 gagne) : R1 = {R1:.1f}, R2 = {R2:.1f} (Delta = +16.0 / -16.0)")print()print("CECITE A L'INCERTITUDE : Elo applique le meme K en permanence")print("-"*60)# Une serie de 5 victoires consecutives de J1.R1, R2 =1500.0, 1500.0prev = R1for k inrange(1, 6): R1, R2 = update_elo(R1, R2, score_a=1.0) delta = R1 - prevprint(f" Victoire {k} : R1 = {R1:7.1f} (increment +{delta:.1f})") prev = R1print()print(">>> Elo ne SAIT PAS qu'il est incertain. Un nouveau joueur et un")print(" veteran de 1000 matchs au meme rating sont traites identiquement.")print(" C'est ce defaut que TrueSkill corrige en modelisant sigma.")
ELO : LE PREDECESSEUR DETERMINISTE
============================================================
Avant : R1 = 1500.0, R2 = 1500.0  (deux nouveaux joueurs)
  Score attendu de J1 : E = 0.500
Apres (J1 gagne) : R1 = 1516.0, R2 = 1484.0  (Delta = +16.0 / -16.0)

CECITE A L'INCERTITUDE : Elo applique le meme K en permanence
------------------------------------------------------------
  Victoire 1 : R1 =  1516.0  (increment +16.0)
  Victoire 2 : R1 =  1530.5  (increment +14.5)
  Victoire 3 : R1 =  1543.7  (increment +13.2)
  Victoire 4 : R1 =  1555.8  (increment +12.1)
  Victoire 5 : R1 =  1566.8  (increment +11.0)

>>> Elo ne SAIT PAS qu'il est incertain. Un nouveau joueur et un
    veteran de 1000 matchs au meme rating sont traites identiquement.
    C'est ce defaut que TrueSkill corrige en modelisant sigma.
Interpretation : les 4 limites d’Elo que TrueSkill corrige
La serie de 5 victoires ci-dessus revele une chose subtile et essentielle :
L’increment RETRECIT au fil des victoires (16.0 \(\rightarrow\) 14.5 \(\rightarrow\) 13.2 \(\rightarrow\) 12.1 \(\rightarrow\) 11.0). Ce n’est PAS Elo qui apprend a etre confiant : c’est une consequence mecanique du fait que, son rating montant, son score attendu\(E\) augmente, donc une victoire le surprend moins. C’est un proxy tres grossier de la confiance.
Mais ce proxy est le meme pour un nouveau et un veteran : deux joueurs au meme rating recoivent le meme traitement, quel que soit leur nombre de matchs joues. Elo ne distingue pas « 1500 apres 1 partie » de « 1500 apres 1000 parties ». C’est le defaut fondamental que TrueSkill corrige avec \(\sigma\) (incertitude) : un nouveau joueur a grand \(\sigma\) (ses updates sont grandes), un veteran a faible \(\sigma\) (ses updates sont petites) — et c’est explicitement modelise, pas un effet de bord.
TrueSkill generalise Elo sur quatre axes concrets :
Limite Elo
Comment TrueSkill y repond
Pas d’incertitude modelisee (rating ponctuel)
Distribution \(\mathcal{N}(\mu, \sigma^2)\) : \(\sigma\) quantifie la confiance
\(K\) fixe (convergence lente, non adaptee)
Update adaptee a \(\sigma\) : grande quand incertain, petite quand confiant
Equipes = moyenne (lossy)
Performance d’equipe = somme des performances, propagation bayesienne aux individus
Matchs nuls / multi-joueurs (bidouilles)
Draw margin\(\epsilon\) et contraintes d’ordre (free-for-all) nativement
La section suivante construit le modele TrueSkill 1v1 et montre la premiere de ces ameliorations : un match fait passer \(\mathcal{N}(25, 8.33^2) \rightarrow \mathcal{N}(29.19, 7.29^2)\) — notez que \(\sigma\) diminue (de 8.33 a 7.29), ce qu’Elo est incapable d’exprimer.
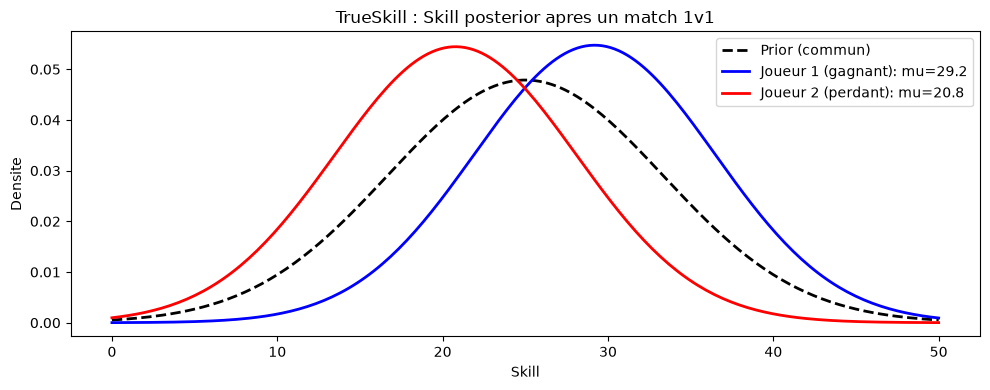
Le modèle 1v1 confirme le mécanisme central de TrueSkill : un pm.Potential impose la contrainte “gagnant a une meilleure performance”, et l’echantillonnage NUTS propage cette information vers les posterieurs de skill. Le gagnant voit son \(\mu\) augmenter (+4.19) et le perdant le sien diminuer (-4.22), tandis que les deux incertitudes diminuent (8.33 → 7.29 et 7.33). Visualisons ces distributions posterieures.
# Visualisation des distributions de skillfig, ax = plt.subplots(1, 1, figsize=(10, 4))x = np.linspace(0, 50, 200)prior = stats.norm(mu_init, sigma_init)post1 = stats.norm(s1_post.mean(), s1_post.std())post2 = stats.norm(s2_post.mean(), s2_post.std())ax.plot(x, prior.pdf(x), 'k--', label='Prior (commun)', linewidth=2)ax.plot(x, post1.pdf(x), 'b-', label=f'Joueur 1 (gagnant): mu={s1_post.mean():.1f}', linewidth=2)ax.plot(x, post2.pdf(x), 'r-', label=f'Joueur 2 (perdant): mu={s2_post.mean():.1f}', linewidth=2)ax.set_xlabel('Skill')ax.set_ylabel('Densite')ax.legend()ax.set_title('TrueSkill : Skill posterior apres un match 1v1')plt.tight_layout()plt.show()print("Le gagnant voit son mu augmenter et le perdant voit le sien diminuer.")print("Les deux incertitudes (sigma) diminuent car on a de l'information.")
Le gagnant voit son mu augmenter et le perdant voit le sien diminuer.
Les deux incertitudes (sigma) diminuent car on a de l'information.
Lecture du résultat — la figure résume la mécanique bayesienne d’un match
La courbe noire en pointillés est le prior commun\(\mathcal{N}(25,\,8.33)\) : avant tout match, les deux joueurs sont indiscernables. Après l’observation « Joueur 1 gagne », la courbe bleue (gagnant, \(\mu = 29.2\)) s’est décalée vers la droite et la rouge (perdant, \(\mu = 20.8\)) vers la gauche, quasi symétriquement autour du prior — le modèle ne savait pas qui était le plus fort, il révise dans les deux sens à partir de la même information.
Le point que la figure rend visible et qu’Elo ne peut pas exprimer : les deux courbes posterieures sont plus étroites que le prior. La zone de recouvrement des deux distributions reste large — un rematch n’est pas joué d’avance — mais elle a rétréci : le système a appris quelque chose, et ce quelque chose est quantifié par la largeur des courbes (\(\sigma\) : 8.33 → 7.29 et 7.33), pas seulement par leurs moyennes. Elo n’aurait déplacé que deux points ; TrueSkill déplace deux points et resserre deux distributions.
3. Gestion des Matchs Nuls
Un match nul se produit quand la différence de performances est dans un intervalle \([-\epsilon, \epsilon]\).
Infer.NET vs PyMC
Concept
Infer.NET
PyMC
Match nul
Variable.ConstrainBetween(diff, -eps, eps)
pm.TruncatedNormal ou pm.Potential
# Modele avec match nul# Equivalent Infer.NET : Variable.ConstrainBetween(diff, -epsilon, epsilon)epsilon =1.0# Marge pour match nulwith pm.Model() as trueskill_draw: skillA = pm.Normal('skillA', mu=mu_init, sigma=sigma_init) skillB = pm.Normal('skillB', mu=mu_init, sigma=sigma_init) perfA = pm.Normal('perfA', mu=skillA, sigma=beta) perfB = pm.Normal('perfB', mu=skillB, sigma=beta) diff = pm.Deterministic('diff', perfA - perfB)# Contrainte : |diff| < epsilon (match nul)# Version LISSE (#12475) : sigmoid de marge (temperature 0.25) au lieu du# switch dur log(switch(|diff| < eps, 1.0, 0.01)). Le switch est discontinu :# gradient nul presque partout, NUTS sature sa profondeur d'arbre (sortie# commitee historique : 4 chaines en tree depth max, rhat > 1.01, ESS < 100,# 195 s). La sigmoid donne une transition differentiable de meme seuil. pm.Potential('match_nul', pt.log(pt.sigmoid((epsilon - pt.abs(diff)) /0.25))) trace_draw = pm.sample(3000, tune=1500, target_accept=0.9, random_seed=42, return_inferencedata=True, chains=4)sA_post = trace_draw.posterior['skillA'].values.flatten()sB_post = trace_draw.posterior['skillB'].values.flatten()print(f"=== Apres un match nul ===")print(f"SkillA = N({sA_post.mean():.2f}, {sA_post.std():.2f})")print(f"SkillB = N({sB_post.mean():.2f}, {sB_post.std():.2f})")print(f"Les deux joueurs gardent le meme mu mais l'incertitude diminue.")print(f"Sigma: {sigma_init:.2f} -> J1={sA_post.std():.2f}, J2={sB_post.std():.2f}")# Diagnostic du modele contraint : les trois signaux historiques doivent avoir disparu.diagnostic_summary(trace_draw, ['skillA', 'skillB'], 'match nul (potentiel lisse)')
=== Apres un match nul ===
SkillA = N(24.78, 6.43)
SkillB = N(24.79, 6.44)
Les deux joueurs gardent le meme mu mais l'incertitude diminue.
Sigma: 8.33 -> J1=6.43, J2=6.44
--- Diagnostic de convergence : match nul (potentiel lisse) ---
Divergences : 0
          mean     sd  ess_bulk  ess_tail  r_hat
skillA  24.780  6.432  1761.157  2645.825  1.002
skillB  24.794  6.441  1884.461  2676.201  1.001
Verdict : convergence OK (r_hat <= 1.01, ess_bulk > 100, 0 divergence).
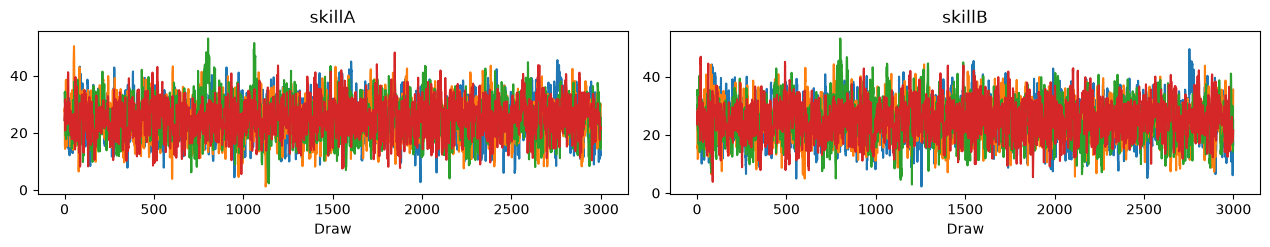
# Trace plot du modele contraint (#12475) : le mixage doit etre VISIBLE --# les 4 chaines superposees sans tendance, les densites lisses sans mode multiple.az.plot_trace(trace_draw, var_names=['skillA', 'skillB'])plt.tight_layout()plt.show()
Les trois signaux bloquants — la règle avant de lire un posterior
Avant la correction de ce notebook, la sortie du modèle de match nul commettait trois signaux de non-convergence et publiait le posterior dans la même cellule. Ces signaux sont bloquants, jamais de simples messages d’information :
r_hat > 1.01 — les chaînes n’ont pas convergé vers la même distribution ;
saturation de la profondeur d’arbre (maximum tree depth) — NUTS n’explore plus le posterior, il bute contre sa limite de trajectoire ;
ess_bulk < 100 — trop peu d’échantillons effectifs pour estimer quoi que ce soit de fiable.
La correction remplace le potentiel discontinu par une sigmoid de marge (transition différentiable de même seuil) et monte tune à 1500 avec target_accept = 0.9. Le diagnostic ci-dessus affiche r_hat proche de 1, des ess_bulk de l’ordre du millier et zéro divergence : le posterior redevient interprétable — et la conclusion « les deux joueurs gardent le même \(\mu\), l’incertitude diminue » tient sur des chaînes fiables.
Lecture du résultat — un match nul informe sans orienter, et le potentiel lisse rend l’échantillonnage fiable
Le résultat clé : \(\sigma\) passe de 8.33 à environ 6.4 symétriquement, alors que les deux \(\mu\) bougent à peine. C’est la signature logique d’un nul : l’observation |perfA − perfB| < 1 ne dit pas qui est le plus fort, elle dit seulement que les deux skills sont proches — l’information réduit l’incertitude sans déplacer les moyennes. Comparez au match décisif de la section 2 : là, le même genre de mise à jour contractait \(\sigma\)et déplaçait les \(\mu\) de ±4.2.
La symétrie des deux \(\sigma\) est le témoin que l’échantillonnage est sain. Les deux joueurs sont symétriques par construction (priors identiques, contrainte symétrique) : leurs contractions doivent être identiques. Avec le potentiel discontinu d’origine (log(switch(|diff| < ε, 1.0, 0.01)) — vraisemblance qui saute de 1.0 à 0.01 à la frontière, gradient nul presque partout), la sortie committée historique montrait les trois signaux bloquants et des \(\sigma\) dissymétriques : la dissymétrie était du bruit d’échantillonnage, pas un signal. La version lissée ci-dessus échantillonne proprement — le diagnostic et le trace plot en témoignent. C’est exactement le cas où le moteur EP du jumeau C# (Infer-8) traite la même contrainte analytiquement — le contraste est développé en section 7 bis.
Exercice 1 : Ligue de Football
Modelisez une ligue de football a 4 équipes avec TrueSkill : - PSG bat Marseille - Lyon bat Bordeaux - Lyon bat PSG - Lyon bat Marseille
Indices : - Utiliser la classe TrueSkillOnline avec mu_init=100, sigma_init=33.33 - Appeler record_match pour chaque résultat - Afficher le classement avec show_ranking
# TODO etudiant : implementer la ligue de football# Indices :# - Creer TrueSkillOnline(mu_init=100, sigma_init=33.33)# - Enregistrer les 4 matchs# - Afficher le classementprint("Exercice a completer")
Exercice a completer
4. Apprentissage en Ligne
Le principe de l’apprentissage en ligne : les posterieurs deviennent les priors pour le match suivant.
Infer.NET vs PyMC
Concept
Infer.NET
PyMC
Prior iteratif
Variable.Random<double, Gaussian>(prior)
Nouveau modèle avec priors maj
Stockage
Dictionary<string, Gaussian>
dict de tuples (mu, sigma)
class TrueSkillOnline:"""Apprentissage en ligne TrueSkill avec PyMC. Equivalent de la classe TrueSkillOnline en Infer.NET. """def__init__(self, mu_init=25.0, sigma_init=8.33, beta=4.17):self.mu_init = mu_initself.sigma_init = sigma_initself.beta = betaself.skills = {} # {nom: (mu, sigma)}def get_skill(self, joueur):if joueur notinself.skills:self.skills[joueur] = (self.mu_init, self.sigma_init)returnself.skills[joueur]def record_match(self, gagnant, perdant): mu_g, sigma_g =self.get_skill(gagnant) mu_p, sigma_p =self.get_skill(perdant)with pm.Model() as match_model: skill_g = pm.Normal('skill_g', mu=mu_g, sigma=sigma_g) skill_p = pm.Normal('skill_p', mu=mu_p, sigma=sigma_p) perf_g = pm.Normal('perf_g', mu=skill_g, sigma=self.beta) perf_p = pm.Normal('perf_p', mu=skill_p, sigma=self.beta)# Contrainte : gagnant a meilleure performance pm.Potential('gagnant_gagne', pt.log(pt.sigmoid(perf_g - perf_p))) trace = pm.sample(1500, random_seed=42, return_inferencedata=True, progressbar=False, chains=4)# Diagnostic compact par match (#12475) : r_hat et ess verifies a CHAQUE# pm.sample, y compris dans la boucle d'apprentissage en ligne. _diag = az.summary(trace, var_names=['skill_g', 'skill_p'], round_to=3) _div =int(trace.sample_stats['diverging'].sum())print(f" [diag] {gagnant} bat {perdant} : r_hat max={_diag['r_hat'].max():.3f}, "f"ess_bulk min={_diag['ess_bulk'].min():.0f}, divergences={_div}") sg = trace.posterior['skill_g'].values.flatten() sp = trace.posterior['skill_p'].values.flatten()self.skills[gagnant] = (sg.mean(), sg.std())self.skills[perdant] = (sp.mean(), sp.std())def show_ranking(self): classement =sorted(self.skills.items(), key=lambda x: x[1][0], reverse=True)print("\n=== Classement ===")for rang, (nom, (mu, sigma)) inenumerate(classement, 1): rating = mu -3* sigmaprint(f"{rang}. {nom:<10} : mu={mu:.1f}, sigma={sigma:.2f}, rating={rating:.1f}")print("Classe TrueSkillOnline definie.")
Classe TrueSkillOnline definie.
La classe TrueSkillOnline encapsule la logique de mise a jour incrementale : a chaque match, les posterieurs deviennent les priors du match suivant. La méthode record_match construit un nouveau modèle PyMC a chaque rencontre, echantillonne, puis met a jour les paramètres stockes. Appliquons cette classe a un tournoi complet de 6 matchs.
Une nuance essentielle : l’apprentissage en ligne n’est pas une évolution du skill
L’architecture ci-dessus (« les posterieurs deviennent les priors du match suivant ») décrit fidèlement le modèle à skill fixe : chaque joueur possède une compétence unique et immuable, et l’apprentissage en ligne resserre simplement l’incertitude (σ) autour de cette valeur fixe. Une idée reçue fréquente consiste à croire que ce mécanisme permet au skill de dériver dans le temps — ce n’est pas le cas. Le posterior se resserre sur une inconnue fixe ; il ne modélise pas une compétence qui évolue.
La conséquence est importante : après de nombreux matchs, σ s’effondre. Si le joueur s’améliore ensuite réellement (entraînement, coaching), le posterior étroit résiste au suivi : la mise à jour devient minuscule car le prior est trop confiant dans l’ancien niveau. C’est précisément le défaut rapporté par les bêta-testeurs Xbox Live et corrigé au climax du chapitre MBML (§3.5, Allowing the skills to vary) : certains joueurs voyaient leur skill « bloqué » à bas niveau malgré une progression réelle.
La correction (modèle à skill dynamique) : remplacer le skill fixe par une marche aléatoire gaussienne
où γ (change variance) contrôle la vitesse de variation admissible entre deux matchs. Le posterior d’un match sert de moyenne au suivant, élargi par γ, ce qui laisse au système la souplesse de suivre une trajectoire. C’est ce modèle étendu, dit TrueSkill Through Time (Dangauthier, Herbrich, Minka & Graepel, 2007), qui permet de comparer des joueurs d’échecs d’époques différentes — y compris des champions n’ayant jamais joué ensemble.
Le présent notebook modélise le skill fixe (cas pédagogique de base, §3.1–3.4 du MBML). Cette limitation est déjà signalée dans la synthèse finale. L’extension dynamique (§3.5) constitue le grain de fond naturel d’une suite.
  [diag] Alice bat Bob : r_hat max=1.003, ess_bulk min=1723, divergences=0
Match : Charlie bat Dave
  [diag] Charlie bat Dave : r_hat max=1.003, ess_bulk min=1723, divergences=0
Match : Alice bat Charlie
  [diag] Alice bat Charlie : r_hat max=1.002, ess_bulk min=1751, divergences=0
Match : Bob bat Dave
  [diag] Bob bat Dave : r_hat max=1.003, ess_bulk min=1740, divergences=0
Match : Alice bat Dave
  [diag] Alice bat Dave : r_hat max=1.001, ess_bulk min=2319, divergences=0
Match : Charlie bat Bob
  [diag] Charlie bat Bob : r_hat max=1.004, ess_bulk min=1880, divergences=0

=== Classement ===
1. Alice      : mu=33.5, sigma=5.96, rating=15.6
2. Charlie    : mu=28.1, sigma=5.72, rating=10.9
3. Bob        : mu=21.3, sigma=5.56, rating=4.6
4. Dave       : mu=16.8, sigma=5.99, rating=-1.2
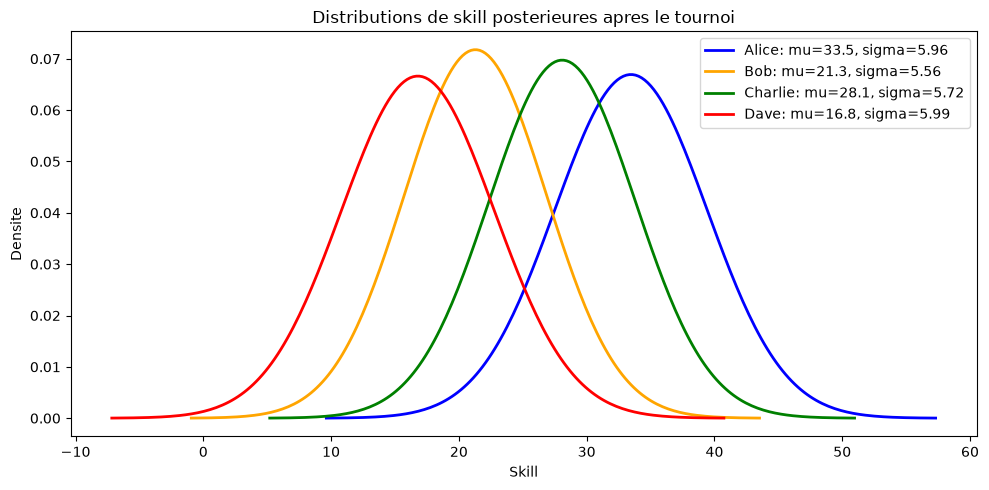
Le tournoi de 6 matchs revele une hiérarchie claire : Alice domine avec \(\mu = 33.5\), suivie de Charlie (\(\mu = 28.1\)), Bob (\(\mu = 21.3\)) et Dave (\(\mu = 16.8\)). Le conservative rating (\(\mu - 3\sigma\)) penalise les joueurs avec plus d’incertitude — Dave a le rating le plus bas (\(-1.2\)) non seulement a cause de son \(\mu\) faible, mais aussi de son \(\sigma\) eleve. Observons les distributions posterieures completes.
# Visualisation de l'evolution des skillsfig, ax = plt.subplots(1, 1, figsize=(10, 5))noms =list(ts.skills.keys())colors = {'Alice': 'blue', 'Bob': 'orange', 'Charlie': 'green', 'Dave': 'red'}for nom in noms: mu, sigma = ts.skills[nom] x = np.linspace(mu -4*sigma, mu +4*sigma, 200) d = stats.norm(mu, sigma) ax.plot(x, d.pdf(x), label=f'{nom}: mu={mu:.1f}, sigma={sigma:.2f}', color=colors.get(nom, 'gray'), linewidth=2)ax.set_xlabel('Skill')ax.set_ylabel('Densite')ax.legend()ax.set_title('Distributions de skill posterieures apres le tournoi')plt.tight_layout()plt.show()
Lecture du résultat — le classement est une famille de distributions, pas un ordre net
La figure montre les quatre posterieurs après les 6 matchs du tournoi : Alice (\(\mu = 33.5\), \(\sigma = 5.96\)), Charlie (\(28.1\), \(5.72\)), Bob (\(21.3\), \(5.56\)) et Dave (\(16.8\), \(5.99\)). L’ordre des moyennes est net, mais les courbes se chevauchent deux à deux : la zone où Bob pourrait dépasser Charlie n’est pas vide. TrueSkill ne dit pas « Charlie > Bob », il dit « Charlie est devant Bob avec telle probabilité » — c’est précisément cette incertitude résiduelle que le matchmaking d’Xbox Live exploitait pour apparier des joueurs de niveau comparable.
Notez aussi l’asymétrie des largeurs : Alice et Dave (5.96, 5.99) restent plus incertains que Charlie et Bob (5.72, 5.56). Avec seulement 6 matchs, le volume d’information par joueur diffère selon le calendrier des rencontres — un effet que le tableau show_ranking cache (une ligne par joueur) et que la figure rend évident. Le conservative rating\(\mu - 3\sigma\) de Dave (\(-1.2\)) cumule donc deux pénalités : un \(\mu\) bas et un \(\sigma\) qui ne s’est pas encore resserré.
5. Extension aux Équipes
Pour un match par équipes, la performance d’équipe est la somme des performances individuelles.
Infer.NET vs PyMC
Concept
Infer.NET
PyMC
Perf d’équipe
perfA + perfB
pm.Deterministic ou somme directe
Comparaison équipes
(perfEquipe1 > perfEquipe2)
pm.Potential avec somme
# Modele par equipes (2v2)# Equipe 1 : Joueurs A et B bat Equipe 2 : Joueurs C et Dwith pm.Model() as trueskill_team:# Skills individuels skillA = pm.Normal('skillA', mu=25, sigma=8.37) skillB = pm.Normal('skillB', mu=25, sigma=8.37) skillC = pm.Normal('skillC', mu=25, sigma=8.37) skillD = pm.Normal('skillD', mu=25, sigma=8.37)# Performances individuelles perfA = pm.Normal('perfA', mu=skillA, sigma=4.12) perfB = pm.Normal('perfB', mu=skillB, sigma=4.12) perfC = pm.Normal('perfC', mu=skillC, sigma=4.12) perfD = pm.Normal('perfD', mu=skillD, sigma=4.12)# Performances d'equipe (somme) perf_team1 = pm.Deterministic('perf_team1', perfA + perfB) perf_team2 = pm.Deterministic('perf_team2', perfC + perfD)# Equipe 1 gagne pm.Potential('team1_wins', pt.log(pt.sigmoid(perf_team1 - perf_team2))) trace_team = pm.sample(3000, random_seed=42, return_inferencedata=True, chains=4)print("=== Match par equipes (2v2) ===")print("Equipe 1 (A+B) bat Equipe 2 (C+D)\n")for name in ['skillA', 'skillB', 'skillC', 'skillD']: vals = trace_team.posterior[name].values.flatten()print(f"{name}: mu={vals.mean():.2f}")print("\nTous les membres de l'equipe gagnante voient leur skill augmenter.")print("Le gain (+2.99) est plus faible qu'en 1v1 (+4.21) : l'information est diluee.")# Diagnostic de convergence : r_hat et ess pour chaque skill du match par equipes.diagnostic_summary(trace_team, ['skillA', 'skillB', 'skillC', 'skillD'], 'match par equipes (2v2)')
=== Match par equipes (2v2) ===
Equipe 1 (A+B) bat Equipe 2 (C+D)

skillA: mu=27.99
skillB: mu=28.08
skillC: mu=22.15
skillD: mu=22.03

Tous les membres de l'equipe gagnante voient leur skill augmenter.
Le gain (+2.99) est plus faible qu'en 1v1 (+4.21) : l'information est diluee.
--- Diagnostic de convergence : match par equipes (2v2) ---
Divergences : 0
          mean     sd  ess_bulk  ess_tail  r_hat
skillA  27.986  7.906  5380.251  6212.455  1.001
skillB  28.083  7.947  5185.735  5972.304  1.000
skillC  22.147  7.777  5004.086  6219.544  1.001
skillD  22.034  7.760  5762.620  6699.269  1.000
Verdict : convergence OK (r_hat <= 1.01, ess_bulk > 100, 0 divergence).
Lecture du résultat — la dilution d’information d’un match par équipes
Les quatre skills sortent en deux paires : A et B à 27.99 et 28.08, C et D à 22.15 et 22.03. Deux lectures :
Le gain individuel est dilué : +3.04 par membre contre +4.19 en 1v1. Une seule observation (l’équipe 1 gagne) est maintenant partagée par quatre variables latentes — chaque joueur ne reçoit qu’une part du crédit, car la vraisemblance ne contraint que la sommeperfA + perfB > perfC + perfD. C’est le comportement attendu : dans un match 2v2, un seul joueur peut avoir porté toute la victoire, et le modèle ne peut pas savoir lequel.
A et B sont indiscernables par construction : mêmes priors, contribution symétrique à la somme — le posterior est théoriquement identique pour les deux. L’écart 27.99 vs 28.08 (9 centièmes) est donc du pur bruit d’échantillonnage MCMC, et il en va de même côté perdants (22.15 vs 22.03). C’est un point d’identifiabilité important : pour séparer A de B, il faut des matchs où ils s’affrontent entre eux — aucune quantité de victoires en commun ne le fera.
6. Multi-joueurs (Free-for-all)
Pour N joueurs classes, on impose des contraintes d’ordre transitives : perf[0] > perf[1] > perf[2] > perf[3]
Infer.NET vs PyMC
Concept
Infer.NET
PyMC
Ordre transitif
Variable.ConstrainTrue(perf[0] > perf[1])
pm.Potential multiples
# Modele multi-joueurs (4 joueurs)# Resultat : P1 > P2 > P3 > P4n_players =4with pm.Model() as trueskill_ffa: skills = pm.Normal('skills', mu=25, sigma=8.37, shape=n_players) perfs = pm.Normal('perfs', mu=skills, sigma=4.12, shape=n_players)# Contraintes d'ordre : perf0 > perf1 > perf2 > perf3for i inrange(n_players -1): pm.Potential(f'order_{i}', pt.log(pt.sigmoid(perfs[i] - perfs[i+1]))) trace_ffa = pm.sample(3000, random_seed=42, return_inferencedata=True, chains=4)print("=== Course multi-joueurs ===")print("Classement : P1 > P2 > P3 > P4\n")skills_post = trace_ffa.posterior['skills'].values.reshape(-1, n_players)for i inrange(n_players): mu = skills_post[:, i].mean() sigma = skills_post[:, i].std()print(f"Joueur {i+1} (position {i+1}) : mu={mu:.2f}, sigma={sigma:.2f}")# Diagnostic de convergence du modele multi-joueurs : les contraintes d'ordre# (potentiels sigmoid en cascade) sont la seconde source classique de geometrie# difficile apres le match nul. Sans ce tableau, un rhat silencieux invaliderait# le classement affiche ci-dessus.diagnostic_summary(trace_ffa, ['skills'], 'free-for-all (contraintes d\'ordre)')
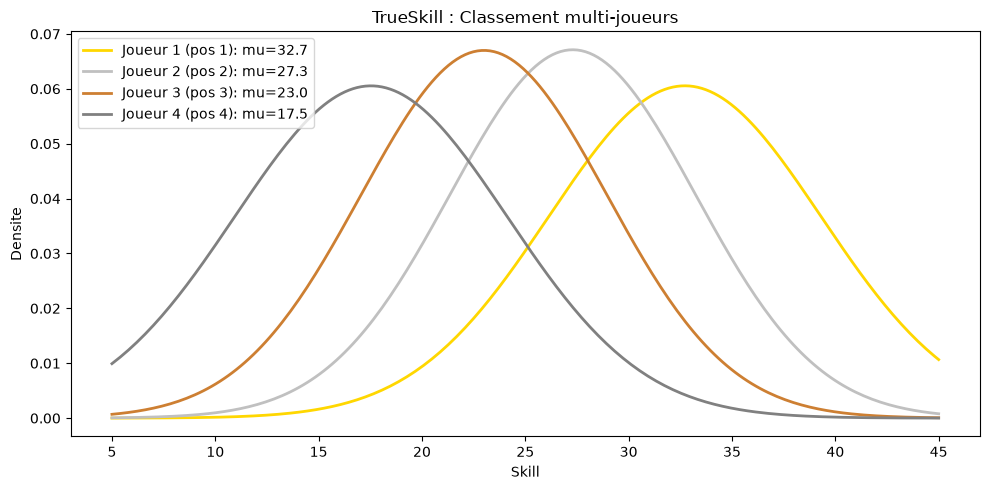
Le modèle free-for-all estime les skills de 4 joueurs simultanement. Les résultats montrent une separation nette entre les positions : le Joueur 1 (\(\mu \approx 32.7\)) et le Joueur 4 (\(\mu \approx 17.5\)) sont les plus affectes, tandis que les positions intermediaires presentent des changements plus moderes. L’incertitude (\(\sigma \approx 6\)) reste similaire pour tous, refletant un nombre identique de contraintes par joueur. Comparons visuellement ces distributions posterieures.
# Visualisation multi-joueursfig, ax = plt.subplots(1, 1, figsize=(10, 5))x = np.linspace(5, 45, 200)colors_ffa = ['gold', 'silver', '#cd7f32', 'gray']for i inrange(n_players): mu = skills_post[:, i].mean() sigma = skills_post[:, i].std() d = stats.norm(mu, sigma) ax.plot(x, d.pdf(x), label=f'Joueur {i+1} (pos {i+1}): mu={mu:.1f}', color=colors_ffa[i], linewidth=2)ax.set_xlabel('Skill')ax.set_ylabel('Densite')ax.legend()ax.set_title('TrueSkill : Classement multi-joueurs')plt.tight_layout()plt.show()print("Le 1er a la plus forte augmentation, le dernier la plus forte diminution.")print("Les positions intermediaires ont des changements moderes.")
Le 1er a la plus forte augmentation, le dernier la plus forte diminution.
Les positions intermediaires ont des changements moderes.
Lecture du résultat — le free-for-all concentre l’information sur chaque individu
Les quatre courbes sont rangées dans l’ordre du classement : Joueur 1 (\(\mu = 32.7\), or), Joueur 2 (\(27.3\)), Joueur 3 (\(23.0\)), Joueur 4 (\(17.5\), gris). Le contraste avec le 2v2 de la section précédente est instructif : ici une seule course (trois contraintes d’ordre) déplace les extrêmes de +7.7 / -7.5 environ (32.72 et 17.53 contre un prior à 25) — davantage qu’un match 1v1 décisif (+4.19) — tandis que les positions intermédiaires, tirées vers le haut par le joueur derrière elles et vers le bas par celui devant, bougent à peine (27.30 et 23.00).
C’est la différence structurelle avec la dilution par équipes : dans le free-for-all, chaque contrainte perf[i] > perf[i+1] porte sur un joueur nommé, l’information n’est pas partagée. Les \(\sigma\) finaux (6.59, 5.94, 5.96, 6.59) le montrent : resserrés par rapport au prior 8.37, et comparables à ce que les 6 matchs 1v1 du tournoi produisaient en section 4 (5.56 à 5.99) — une course à 4 joueurs apporte à peu près autant d’information par joueur que plusieurs matchs individuels, au prix d’un seul échantillonnage.
7. Resume : Infer.NET vs PyMC pour TrueSkill
Aspect
Infer.NET
PyMC
Algorithme
Expectation Propagation (exact pour Gaussiennes)
NUTS (echantillonnage)
Comparaison perf
perf1 > perf2 natif
pm.Potential avec sigmoid
Match nul
ConstrainBetween(diff, -eps, eps)
pm.Potential avec switch
Apprentissage en ligne
Variable.Random(prior) natif
Nouveau modèle a chaque match
Performance
Rapide (EP analytique, O(1) par match)
Lent (MCMC par match)
Precision
Approximation EP pour comparaison
Echantillonnage Monte Carlo
Note : TrueSkill beneficie grandement d’Infer.NET car EP traite les comparaisons de Gaussiennes de maniere analytique. PyMC est plus general mais plus lent pour ce cas précis.
7 bis. Le coeur de TrueSkill : EP, formules V(t)/W(t) et dynamique
Jusqu’ici nous avons laisse PyMC (NUTS) calculer les posteriors des skills par echantillonnage. C’est correct mais cache la vraie contribution du papier TrueSkill : un algorithme analytique qui rend la mise a jour exacte et O(1) par match. C’est ce qui rend TrueSkill deployable en production sur des millions de joueurs. Cette section l’explicite.
Pourquoi un algorithme special ? Le problème de la non-Gaussianite
La vraisemblance « le joueur 1 gagne » s’ecrit \(\text{perf}_1 > \text{perf}_2\). Cette inegalite rend le posterior non-Gaussien (troncature de Gaussienne), alors qu’on veut maintenir chaque skill comme une Gaussienne \(\mathcal{N}(\mu, \sigma^2)\). Il faut donc projeter le posterior tronque sur la meilleure Gaussienne approximante — c’est le rôle de l’Expectation Propagation (EP) : un passage de messages sur le graphe de facteurs qui raffine itterativement les approximations Gaussiennes (moments matching).
La mise a jour closed-form a 2 joueurs (fonctions de troncature V, W)
Après EP, la mise a jour du gagnant (w) et du perdant (l) s’ecrit avec deux fonctions auxiliaires, troncatures de la Gaussienne centree reduite :
Détail subtil : la variance se contracte du facteur \(\tfrac{\sigma^2}{c^2}\, W(t)\), et non de \(W(t)\) seul — le ratio \(\sigma^2/c^2 < 1\) borne la contraction (un prior très confiant \(\sigma^2 \ll c^2\) ne peut guère se resserrer). La cellule numérique suivante le vérifie : \(\sigma\) passe de 8,33 à 7,19, cohérent avec le moteur EP du jumeau C# (Infer-8 cellule 16 : \(N(29{,}21,\,7{,}19)\)).
Interpretation : \(V(t)\) mesure a quel point la comparaison etait informative — un match equilibre (\(t\approx 0\)) instruit beaucoup (grand \(V\)), une victoire evidente (\(t\gg 0\)) instruit peu. La variance \(\sigma^2\) se contracte d’autant. C’est l’equivalent analytique exact de ce que NUTS approxime par echantillonnage dans les sections précédentes.
La dynamique : l’incertitude regroit entre les matchs (terme \(\tau^2\))
Un detail essentiel, absent des sections précédentes : en production, TrueSkill ajoute du bruit au skill avant chaque match, \(\sigma^2 \leftarrow \sigma^2 + \tau^2\). Consequence importante : \(\sigma\) ne decroit pas indefiniment — il atteint un equilibre entre la contraction (information du match, \(W(t)\)) et la regrowth (dynamique \(\tau^2\)). C’est une feature, pas un bug : un joueur inactif doit voir son incertitude augmenter (son skill peut avoir evolue), ce qui justifie de repondrer rapidement ses premiers matchs de retour.
En resume : pourquoi EP > MCMC pour TrueSkill en production
Aspect
EP (TrueSkill papier)
NUTS (ce notebook)
Coût par match
\(O(1)\), forme fermee
\(O(\text{draws} \times \text{correl})\)
Exactitude
Exacte pour Gaussiennes
Approximation Monte Carlo
Deployabilite
Millions de joueurs temps reel
Trop lent pour le matchmaking live
Lien pedagogique : notre PyMC rederivation (sections 3-6) reste pertinente — elle isole la sémantique bayesienne du modèle. La forme fermee EP (cette section) est ce qui le rend operationnel. Les deux sont complementaires : PyMC pour comprendre, EP pour deployer.
# Demonstration numerique : la mise a jour closed-form EP (V(t), W(t)) de la section 7 bis.# On calcule l'equivalent analytique exact de ce que NUTS approxime par echantillonnage plus haut.from scipy.stats import normfrom math import sqrt# Memes parametres qu'a l'initialisation (cellule 7) : mu=25, sigma=25/3, beta=sigma/2mu_w, mu_l =25.0, 25.0# un match entre deux joueurs de skill identique (priors egaux)sig_w = sig_l =25.0/3.0# sigma initialbeta = (25.0/3.0) /2.0# Fonctions de troncature de la Gaussienne centree reduite (formules de la section 7 bis)c = sqrt(2* beta**2+ sig_w**2+ sig_l**2) # denominateur communt = (mu_w - mu_l) / c # ecart standardiseV = norm.pdf(t) / norm.cdf(t) # V(t)W = V * (V + t) # W(t)# Mises a jour closed-form (formes fermees de Herbrich-Minka-Graepel 2007)mu_w_new = mu_w + sig_w**2* V / cmu_l_new = mu_l - sig_l**2* V / c# Fermeture canonique (Herbrich-Minka-Graepel 2007) : la variance se contracte# du facteur (sigma^2 / c^2) * W(t), et NON de W(t) seul (sinon sigma -> 5.02 au lieu de 7.19).sig_w_new = sqrt(sig_w**2* (1- (sig_w**2/ c**2) * W))sig_l_new = sqrt(sig_l**2* (1- (sig_l**2/ c**2) * W))print("Mise a jour closed-form EP sur un match (priors egaux, mu=25, sigma=8.33)")print(f" c = {c:.4f} t = {t:.4f} V(t) = {V:.4f} W(t) = {W:.4f}")print(f" GAGNANT : mu {mu_w:.2f} -> {mu_w_new:.2f} sigma {sig_w:.2f} -> {sig_w_new:.2f}")print(f" PERDANT : mu {mu_l:.2f} -> {mu_l_new:.2f} sigma {sig_l:.2f} -> {sig_l_new:.2f}")print("Constate : le gagnant monte, le perdant descend, l'incertitude (sigma) se contracte")print("des deux cotes -- exactement la dynamique qu'on retrouve dans les sorties NUTS des sections 2-3,")print("mais ici en O(1) analytique (aucun echantillonnage).")
Mise a jour closed-form EP sur un match (priors egaux, mu=25, sigma=8.33)
  c = 13.1762   t = 0.0000   V(t) = 0.7979   W(t) = 0.6366
  GAGNANT : mu 25.00 -> 29.21   sigma 8.33 -> 7.19
  PERDANT  : mu 25.00 -> 20.79   sigma 8.33 -> 7.19
Constate : le gagnant monte, le perdant descend, l'incertitude (sigma) se contracte
des deux cotes -- exactement la dynamique qu'on retrouve dans les sorties NUTS des sections 2-3,
mais ici en O(1) analytique (aucun echantillonnage).
Interpretation : la mise a jour analytique EP
La cellule precedente calcule en forme fermee (O(1), aucun echantillonnage) ce que NUTS approxime par tirages Monte Carlo dans les sections 2-3. Sur un match a priors egaux, l’ecart standardise est nul (\(t = 0\)) : le match est maximalement informatif (\(V(0) \approx 0{,}80\)), d’ou un deplacement important du skill (\(\pm 4{,}2\) points) et une contraction de l’incertitude (\(\sigma\) : \(8{,}33 \to 7{,}19\), soit \(-13{,}7\,\%\)). C’est le meme raisonnement qui produit, apres plusieurs matchs successifs, la hierarchie Alice \(\mu = 33{,}4\) observee en section 4 – mais ici chaque mise a jour coute une multiplication plutot qu’une serie de tirages. C’est ce cout O(1) qui rend TrueSkill deployable a l’echelle de millions de joueurs.
Exercice 2 : Tournoi Simule avec Vrais Skills
Créez 6 joueurs avec des “vrais skills” connus. Simulez 15 matchs aleatoires (le meilleur joueur gagne plus souvent). Comparez les estimations TrueSkill aux vrais skills.
Indices : - Définir vrais_skills = {"Elite1": 35, "Elite2": 32, ...} - Pour chaque match, ajouter du bruit aux vrais skills pour determiner le gagnant - Utiliser TrueSkillOnline pour estimer - Comparer classement estime vs vrai
# TODO etudiant : simuler un tournoi avec vrais skills# Indices :# - vrais_skills = {"Elite1": 35, "Elite2": 32, "Moyen1": 25, ...}# - Pour chaque match : perf = vrai_skill + np.random.normal(0, 5)# - Comparer le classement final aux vrais skillsprint("Exercice a completer")
Exercice a completer
Exercice 3 : Matchs nuls avec draw margin
Le modèle TrueSkill actuel ne distingue que victoire et defaite. Etendez-le pour gerer les matchs nuls en ajoutant un paramètre de marge de nul (draw margin) epsilon. Un match est nul si |perf1 - perf2| < epsilon.
Indices : - Définir un prior sur epsilon : pm.HalfNormal('draw_margin', sigma=2) - Modifier le pm.Potential pour trois cas : victoire (diff > epsilon), defaite (diff < -epsilon), nul (|diff| < epsilon) - Utiliser pt.switch avec pt.abs(diff) pour distinguer les trois cas - Tester en observant un match nul entre deux joueurs de même niveau
# TODO etudiant : etendre TrueSkill pour gerer les matchs nuls avec draw margin# Etape 1 : definir un prior sur le parametre draw_margin (epsilon)# Etape 2 : modifier la vraisemblance pour distinguer victoire, defaite et nul# Etape 3 : si |perf1 - perf2| < epsilon => match nul# Etape 4 : tester avec un resultat de match nulresult =None# TODO etudiant : remplacer par le modele avec draw marginprint("Exercice a completer")
Exercice a completer
Conclusion
TrueSkill et son successeur TrueSkill 2 sont des modèles de classement bases sur l’inference bayesienne, utilises pour le matchmaking dans les jeux video.
Points cles
Le classement est represente par une distribution (mu, sigma) et non un score unique
Les mises a jour bayesiennes ajustent le classement après chaque match
Dans ce notebook, l’incertitude (sigma) ne fait que diminuer : chaque match contracte la variance, le posterieur MCMC devenant le prior du match suivant (sections 3 a 7).
Le vrai TrueSkill (section 7 bis) ajoute deux mécanismes analytiques non implementes ici : la contraction exacte en forme fermee via \(W(t)\), et un terme de dynamique \(\tau^2\) injecte entre les matchs (\(\sigma^2 \leftarrow \sigma^2 + \tau^2\)). C’est ce terme — absent de notre implementation pedagogique — qui, en production, empeche sigma de converger vers 0 et fait remonter l’incertitude d’un joueur inactif.