CausalBridges-05 — Le confondeur non observé : sensibilité, pas certitude
Renumerotation #17421 : ce carnet etait publie sous le nom DoWhy-4 ; les renvois internes de la serie citent desormais le numero courant.
CausalBridges-02 exigeait un estimand nommé ; CausalBridges-04 découvrait le graphe avec sa borne structurelle (le CPDAG ambigu). Il reste l’hypothèse qu’aucun graphe observé ne peut trancher : l’absence de confondeur NON OBSERVÉ. On ne peut ni la tester, ni la découvrir — on peut la chiffrer.
L’énoncé cible de ce notebook (issue #14049) :
« Quelle force devrait avoir un confondeur caché pour annuler cet effet ? »
— un chiffre, pas une réserve rhétorique. Trois formalisations SOTA de la même question, toutes réellement exécutées par dowhy (0.14) :
Formalisation
Moteur
Monde
Le chiffre
Robustness value (R² partiel)
refute_estimate → linear-partial-R2
continu
le R² partiel minimal qui annule
E-value (Ding & VanderWeele)
refute_estimate → e-value
binaire (RR)
le RR minimal qui annule
Bornes de Rosenbaum (Γ)
calcul exact binomial sur paires
binaire apparié
le Γ* qui rend non significatif
Et le pont concret : direct-simulation — un confondeur simulé de force croissante, et la courbe de bascule de l’estimé ajusté.
from pathlib import Pathimport sysimport numpy as npimport pandas as pd_fichier_organe =next(Path.cwd().rglob("dowhy_sensitivity_organs.py"))sys.path.insert(0, str(_fichier_organe.parent))import dowhy_sensitivity_organs as dsopd.set_option("display.precision", 3)print("organe :", _fichier_organe.parent.name)
organe : Causal-Bridges
1. Le monde A — l’analyste et son angle mort
Un traitement continu \(X\), une issue continue \(Y\), un confondeur observé\(C\) — et un confondeur caché\(U\) que l’analyste ne mesure pas :
L’effet vrai vaut \(\tau = 0.5\). L’analyste ajuste sur \(\{C\}\) — le mieux qu’il puisse faire avec ses données. Le générateur expose deux vues : la vue analyste (X, Y, C) et la vue oracle (avec U), qui servira de vérité terrain.
dowhy identifie l’ajustement backdoor \(\{C\}\) et estime par régression linéaire. C’est l’estimé que publierait l’étude : significatif, propre, bref — et biaisé par \(U\).
estime naive (ajustement C) = 1.159
IC 95 %                  = [1.116, 1.202]
effet vrai (simulateur)  = 0.5
Lecture de l’estimé naïf — précis ET faux. L’intervalle [1.116, 1.202] exclut l’effet vrai (0.5) avec confiance : l’IC à 95 % mesure la précision statistique (variabilité d’échantillonnage), pas la justesse causale (adéquation de l’ensemble d’ajustement). Un estimateur ajusté sur un backdoor incomduit reste biaisé quelle que soit la taille de l’échantillon — à n infini, l’IC se contracte autour de 1.16, jamais autour de 0.5. Toute la suite du notebook consiste à répondre à la question que cet intervalle ne pose pas : à quelle condition ce chiffre basculerait-il ? C’est un changement de paradigme : on abandonne « l’effet est-il significatif ? » (oui, mourument) pour « quelle force de confusion non observée suffirait à l’annuler ? ».
L’oracle — ce que l’analyste ne peut PAS faire
Par construction du monde, ajuster sur \(\{C, U\}\) restaure l’effet vrai. L’écart entre naïf et oracle mesure le travail que \(U\) fait en silence.
from dowhy import CausalModelmodele_oracle = CausalModel(data=df_oracle, treatment="X", outcome="Y", common_causes=["C", "U"])estimand_oracle = modele_oracle.identify_effect(proceed_when_unidentifiable=True)estime_oracle = modele_oracle.estimate_effect(estimand_oracle, method_name="backdoor.linear_regression")print(f"oracle (ajustement C+U) = {estime_oracle.value:.3f} (effet vrai {dso.TAU_VRAI})")print(f"biais du a U = {res_naif.value - estime_oracle.value:+.3f}")
oracle (ajustement C+U)  = 0.532   (effet vrai 0.5)
biais du a U             = +0.627
2. La robustness value — le R² partiel qui annule
Question : quelle force un confondeur caché devrait-il avoir pour annuler cet effet ? Cinelli & Hazlett (2020) y répondent par la robustness value : le \(R^2\) partiel minimal qu’un confondeur devrait avoir avec le traitement ET avec l’issue (après ajustement de \(\{C\}\), à force égale des deux côtés) pour ramener l’estimé à zéro. dowhy la calcule via le refuter add_unobserved_common_cause en mode linear-partial-R2.
robustness_value : annuler l’estimé (le ramener à 0) ;
robustness_value_alpha : le rendre statistiquement non significatif.
rob = dso.robustesse_partielle_r2(res_naif.model, res_naif.estimand, res_naif.estimate)print(f"robustness value (annuler) = {rob.robustness_value:.3f}")print(f"robustness value (non significatif) = {rob.robustness_value_alpha:.3f}")print(f"R2 partiel de X avec Y | C = {rob.r2yt_w:.3f}")
robustness value (annuler)             = 0.677
robustness value (non significatif)    = 0.665
R2 partiel de X avec Y | C             = 0.587
Lecture des trois nombres de la robustness value. Les deux RV (0.677 pour annuler, 0.665 pour rendre non significatif) sont proches — indice que l’association tient plus par sa magnitude que par la précision de l’IC. Le troisième nombre, R² partiel de X avec Y | C = 0.587, n’est pas un seuil mais une échelle : il dit combien de variance l’exposition elle-même explique. La règle de lecture tient en une phrase : un confondeur caché U n’est dangereux que s’il explique, conditionnellement aux covariables observées, plus de variance que le RV — au-delà, il peut annuler l’estimé ; en-deçà, non. Un RV de 0.68 est élevé (il faudrait un U très prédictif des deux côtés) ; un RV de 0.05 serait alarmant sur le même estimé. Le verdict ne se prononce pas ici : il attend la comparaison avec le R² réel de U (cellule suivante), que seule la vérité terrain du simulateur fournit.
La vérité terrain : le R² partiel réel de U
Le RV est un seuil ; il ne dit rien des confondeurs qui existent. Mais notre monde est simulé : sur la vue oracle, on mesure le \(R^2\) partiel réel de \(U\) — avec \(X\) (après \(C\)) et avec \(Y\) (après \(X, C\)) — et on le compare au seuil. C’est le geste que le praticien remplace par sa connaissance du domaine : « un cache aussi fort que tel facteur connu ».
r2_u_x = dso.r2_partiel(df_oracle, "X", "U", ["C"])r2_u_y = dso.r2_partiel(df_oracle, "Y", "U", ["X", "C"])print(f"R2 partiel reel de U avec X | C = {r2_u_x:.3f}")print(f"R2 partiel reel de U avec Y | X,C = {r2_u_y:.3f}")print(f"robustness value = {rob.robustness_value:.3f}")verdict_a = dso.verdict_sensibilite(r2_u_x, r2_u_y, rob)print(f"\nverdict : {verdict_a['verdict']}")print(verdict_a['message'])
R2 partiel reel de U avec X | C    = 0.493
R2 partiel reel de U avec Y | X,C  = 0.427
robustness value                   = 0.677

verdict : SURVIT_A_CE_CONFOUNDEUR
RESULTAT : l'association survit a ce confondeur -- meme a force egale des deux cotes au niveau de son cote le plus fort (0.49 < RV 0.68), le cache n'annule pas l'estime. ATTENTION : survivre a l'annulation n'est pas etre juste -- l'estime reste biaisé tant que le confondeur n'est pas mesure.
Lecture du verdict SURVIT — et de sa portée exacte. Le R² partiel réel de U (0.493 sur X, 0.427 sur Y, conditionnellement aux ajustements) reste sous le RV (0.677) : ce confondeur-là est trop faible pour annuler l’estimé — le verdict SURVIT ne dit rien de plus, et c’est déjà beaucoup. La comparaison oracle n’est possible que parce que le simulateur connaît U ; en observational, le verdict s’arrête au seuil et l’analyste doit convoquer des benchmarks (le meilleur confondeur mesuré, comme C en section 4) pour estimer ce qu’un U plausible « pèse ».
Deux lectures honnêtes cohabitent : (a) l’immunité — tout U expliquant moins de 68 % de la variance résiduelle des deux côtés laisse l’estimé en vie, c’est une barre élevée ; (b) la fragilité — à κ = 0.8 (section suivante), l’estimé tombe déjà de 0.755 à 0.39 : l’association survit en signe bien avant de survivre en magnitude. Annoncer « robuste » sans dire à quel cadre (annulation du signe ? de la significativité ? de la magnitude ?) est précisément l’ambiguïté que les trois sections qui suivent désambiguïsent, chacune avec sa propre définition.
Survivre n’est pas être juste
Le verdict dit que l’association survit à un confondeur de la force de \(U\) : même à force égale des deux côtés au niveau de son côté le plus fort (0.49 < 0.68), le cache n’annule pas l’estimé. Mais le tableau des trois nombres raconte l’histoire complète :
quantité
valeur
rôle
estimé naïf
1.159
ce que l’étude publie
oracle \(\{C, U\}\)
0.532
l’effet vrai du simulateur
robustness value
0.677
la force qui annulerait
\(R^2\) réel de \(U\)
0.49 / 0.43
la force du cache réel
\(U\) réduit l’estimé de moitié sans pouvoir l’annuler : la sensibilité chiffre l’attaque, elle ne certifie pas l’estimé.
synthese_a = pd.DataFrame({"quantite": ["estime naif (ajuste C)", "oracle (ajuste C+U)", "effet vrai","robustness value", "R2 reel U avec X", "R2 reel U avec Y"],"valeur": [res_naif.value, estime_oracle.value, dso.TAU_VRAI, rob.robustness_value, r2_u_x, r2_u_y],})synthese_a
quantite
valeur
0
estime naif (ajuste C)
1.159
1
oracle (ajuste C+U)
0.532
2
effet vrai
0.500
3
robustness value
0.677
4
R2 reel U avec X
0.493
5
R2 reel U avec Y
0.427
3. Le confondeur simulé — voir la bascule
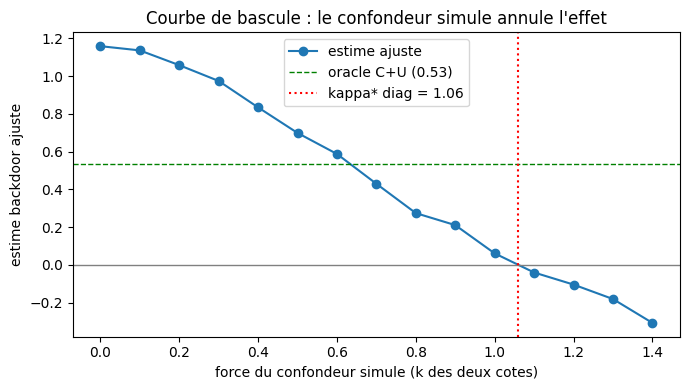
Le refuter direct-simulation rend le mécanisme concret : on injecte dans les données un confondeur gaussien \(U^*\) de coefficient \(\kappa_t\) sur \(X\) et \(\kappa_y\) sur \(Y\), puis on ré-estime l’effet backdoor avec \(U^*\) dans l’ensemble d’ajustement. Quand \(\kappa_y\) croît, l’estimé ajusté descend — la courbe de bascule. Le point de franchissement de zéro est le chiffre cherché, en unités du monde (coefficients de régression).
D’abord à \(\kappa_t = 0.7\) fixé (la force réelle de \(U\) sur \(X\)) :
Lecture de la bascule — le κ* est un point de retournement, pas une frontière de validité. La table parcourt κ (force du confondeur simulé) de 0.0 à 1.8 à κ_t fixé (0.7) : l’estimé chute de 0.755 à −0.043 de façon monotone, croise l’effet vrai (0.5) vers κ≈0.4, l’effet nul vers κ*=1.55. Sous κ*, l’estimé garde son signe — c’est tout ce que « survivre » veut dire : le signe de l’association résiste, pas sa magnitude. Entre κ=0.4 et κ*=1.55, l’estimé est déjà divisé par deux ou plus tout en restant positif. La zone honnête de reportage est donc un intervalle conditionnel : « l’association s’annule pour un confondeur de force κ > 1.55, mais dès κ = 0.8 elle n’est plus que 0.39 ». Résumer tout ça par « robuste » perd l’information la plus utile de la table.
%matplotlib inlineimport matplotlib.pyplot as pltbascule_diag = dso.confondeur_simule(res_naif.model, res_naif.estimand, res_naif.estimate, k_max=1.4, pas=0.1, diagonale=True)kappa_diag = dso.kappa_bascule(bascule_diag)fig, ax = plt.subplots(figsize=(7, 4))ax.plot(bascule_diag["k"], bascule_diag["estime_ajuste"], "o-", label="estime ajuste")ax.axhline(0.0, color="gray", lw=1)ax.axhline(estime_oracle.value, color="green", ls="--", lw=1, label=f"oracle C+U ({estime_oracle.value:.2f})")if kappa_diag isnotNone: ax.axvline(kappa_diag, color="red", ls=":", label=f"kappa* diag = {kappa_diag:.2f}")ax.set_xlabel("force du confondeur simule (k des deux cotes)")ax.set_ylabel("estime backdoor ajuste")ax.set_title("Courbe de bascule : le confondeur simule annule l'effet")ax.legend()plt.tight_layout()plt.show()
Lecture du diagramme de bascule. Les deux courbes (effet estimé en fonction de κ, à κ_t et κ_y symétriques ou non) matérialisent ce que la table numérique échantillonne : la pente de la chute est le rapport de forces entre le chemin causal (X→Y) et le chemin de confusion (X←U→Y). Un diagramme plat (estimé insensible à κ) signale une association dominée par l’effet causal ; un diagramme qui plonge tôt signale un estimé dont la survie dépend entièrement de la faiblesse supposée du confondeur. Le point d’intersection avec la ligne zéro est le κ* de la cellule précédente — le retrouver graphiquement est la vérification de cohérence la plus rapide avant de lire le chiffre dans la table.
Le rapport de forces. À force égale des deux côtés, il faut \(\kappa \approx 1.1\) pour annuler l’association — deux fois la force réelle de \(U\) sur \(X\) (0.7). Un résultat contre-intuitif mérite d’être mesuré : renforcer \(U\) ne rend PAS l’association plus fragile. Si \(U\) est plus fort, l’association observée grossit avec lui, et la robustness value monte (mesuré : \(U\) à 1.8/1.8 → RV 0.89 ; à 2.6/2.6 → RV 0.94). Le RV mesure un rapport de forces, pas une constante — c’est l’objet de l’exercice 1.
4. Le monde B — risques relatifs et E-value
Le monde continu parlait en \(R^2\) ; l’épidémiologie parle en risques relatifs. Nouveau monde : \(X\) binaire (exposé/non exposé), \(Y\) binaire et rare (~7 %), risques multiplicatifs (lien log) — le RR conditionnel vrai vaut \(e^{0.4} \approx 1.49\), et le GLM de Poisson à lien log de dowhy est bien spécifié.
Pourquoi changer de monde. Le monde A parlait en variances expliquées ; l’épidémiologie parle en risques relatifs — et les deux langages ne se traduisent pas terme à terme. La bascule vers un Y binaire force à reposer la question de la confusion sur des quantités interprétables en santé publique : « les traités ont combien de fois plus de risque ? ». Le prix : un monde B plus pauvre en information (un bit par individu sur l’issue) rend les estimés plus sensibles à la rareté de l’événement.
Le détail de la sortie mérite un arrêt : P(Y=1) de l’ordre de quelques pour cent = issue rare. En régime rare, le rapport de cotes (OR) et le risque relatif (RR) se confondent numériquement — c’est pourquoi la littérature épidémiologique tolère l’approximation OR ≈ RR, et pourquoi les E-values qui suivent sont formulées sur l’échelle RR. Mais l’approximation se dégrade à mesure que l’issue se banalise : le notebook d’exercices y reviendra. Retenir la chaîne : monde binaire → RR → E-value, chaque maillon choisissant l’échelle qui rend l’adversaire (le confondeur caché) commensurable avec les forces mesurées.
Le RR ajusté — et un piège de l’API
dowhy estime le RR par backdoor.generalized_linear_model (Poisson, lien log) en ajustant \(\{C\}\). Piège mesuré : estimate.value rend un contraste marginal sur l’échelle des probabilités prédites (~1.04), pas le RR — le log-RR se lit sur le coefficient du traitement (l’organe l’encapsule). Le \(U\) caché fait monter le RR ajusté au-dessus du vrai.
rr = dso.estimer_rr_binaire(df_binaire)print(f"RR ajuste C (coefficient) = {rr.rr:.3f} IC 95 % [{rr.rr_inf:.3f}, {rr.rr_sup:.3f}]")print(f"RR vrai (simulateur) = {np.exp(dso.B_X):.3f}")print(f"contraste marginal .value = {rr.estimate.value:.3f} <- PAS le RR (piege encapsule)")
RR ajuste C (coefficient) = 1.790   IC 95 % [1.352, 2.371]
RR vrai (simulateur)      = 1.492
contraste marginal .value = 0.041  <- PAS le RR (piege encapsule)
Le piège API, en entier. La même cellule produit deux « effets » : le coefficient exponentié (RR = 1.790) et le contraste marginal .value = 0.041. Les deux sont corrects — ils répondent à des questions différentes : le RR compare les ratiques de probabilité entre traités et non-traités à covariables fixées, le contraste marginal compare des différences de probabilité moyennées sur la population. Publier 0.041 comme « l’effet du traitement » sans son échelle (différence de risque, pas ratio) est l’erreur classique que l’étiquette PAS le RR (piège encapsulé) signale dans la sortie même. La leçon générale dépasse dowhy : une bibliothèque statistique rend plusieurs quantités par estimation ; l’attribut lu doit être nommé dans le rapport, pas choisi par défaut parce qu’il s’appelle value.
L’E-value — le RR minimal qui annule
L’E-value de Ding & VanderWeele (2017) : la force d’association minimale, sur l’échelle des risques relatifs, qu’un confondeur caché devrait avoir avec le traitement ET avec l’issue (conditionnellement aux covariables mesurées) pour expliquer entièrement l’association. dowhy l’implémente des packages R EValue/tipr, avec deux lectures :
pour l’estimé ponctuel : un cache de RR ≥ E-value des deux côtés annule ;
pour la borne d’IC la plus proche de 1 : un cache plus faible suffit déjà.
Et le benchmark de McGowan & Greevy : on retire chaque covariable mesurée, on ré-estime, on mesure le déplacement — l’« E-value observé » de \(C\) donne l’échelle des forces réelles de l’étude.
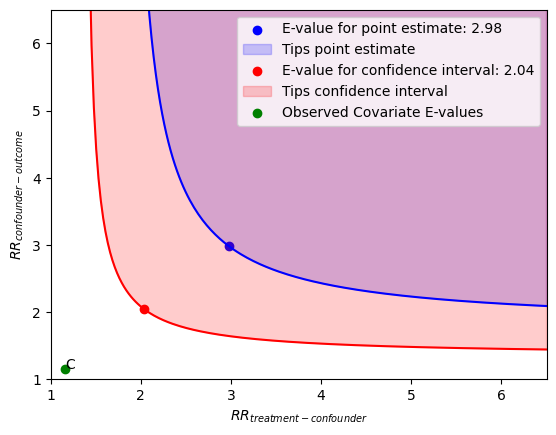
# les contours de bascule : (RR cache-traitement) x (RR cache-issue) qui annulentev.analyzer.plot(xy_limit=6.5)plt.show()
Lecture des contours de bascule. Chaque courbe de niveau relie les couples (RR caché→traitement) × (RR caché→issue) qui annulent exactement l’association observée. La courbe la plus proche de l’origine = le scénario de confusion le plus économe en force : c’est lui qui définit la « distance à l’annulation ». Un point observé réel (le meilleur confondeur mesuré, C, du benchmark) se projette dans ce plan : s’il tombe loin de toutes les courbes d’annulation, aucune force plausible au vu des données ne peut renverser le résultat. C’est la lecture en deux dimensions (force sur X ET force sur Y séparément) qui manquait au κ unique du monde A — le rapport de forces y était symétrique par hypothèse, ici les deux axes sont libres.
verdict_b = dso.verdict_e_value(ev)print(f"verdict : {verdict_b['verdict']} (rapport {verdict_b['rapport']:.2f}x)")print(verdict_b['message'])# controle independent : la formule fermee de VanderWeele-Dingrr_conv = ev.rr_convertievalue_formule = rr_conv + (rr_conv * (rr_conv -1)) **0.5print(f"\nformule RR + sqrt(RR(RR-1)) = {evalue_formule:.4f} vs dowhy {ev.evalue_estime:.4f}")
verdict : ROBUSTE_RELATIVEMENT_AUX_OBSERVES (rapport 2.57x)
RESULTAT : E-value 2.98 contre un maximum observe de 1.16 -- un confondeur cache devrait etre 2.6x plus fort (echelle E-value) que le meilleur confondeur mesure pour annuler l'association. La robustesse est relative aux forces observees dans CETTE etude, pas une certification d'absence de confondeur.

formule RR + sqrt(RR(RR-1)) = 2.9796 vs dowhy 2.9796
Lire un E-value nu est impossible — « 3.0, c’est grand ? » n’a pas de réponse universelle. Le benchmark répond : le meilleur confondeur mesuré de cette étude (\(C\), qui fait pourtant passer le RR de 1.49 à 1.79) a un E-value observé de 1.16. Un cache qui annulerait devrait être 2.6× plus fort que ce confondeur réel. La robustesse est relative aux forces observées dans l’étude — un résultat, pas une certification.
Le verdict ROBUSTE, déchiffré. Le rapport 2.57× se lit : l’association non observée qu’il faudrait pour annuler l’effet est 2.57 fois plus forte que l’association la plus forte jamais mesurée dans ces données (C, le benchmark). C’est une robustesse relative — exactement ce qu’il faut pour décider : nul besoin de savoir si 2.98 est « grand » dans l’absolu, il suffit de savoir qu’aucun confondeur observé n’approche ce régime. La borne d’IC (E-value 2.04, encore 1.76× le benchmark) dit que même l’estimation la plus pessimiste compatible avec les données resterait au-dessus du meilleur candidat mesuré.
La règle de décision à emporter : E-value estimé > E-value de la borne > benchmark ⇒ verdict ROBUSTE ; toute inversion de cette chaîne localise la fragilité. Si la borne passait sous le benchmark, le verdict correct deviendrait « robuste en estimé, fragile en borne » — un résultat publiable avec un caveat, pas un résultat solide. La section suivante (Rosenbaum) montrera qu’un autre adversaire — le biais de sélection des paires — renverse ce confort : le même estimé, mesuré contre un cadre différent, redevient fragile. D’où la morale de la synthèse finale : un chiffre de sensibilité n’a de sens qu’apparié à son cadre d’hypothèses.
5. Les bornes de Rosenbaum — Γ*, le déséquilibre qui masque
Troisième formalisation, sur paires appariées : on apparie exactement chaque exposé à un non-exposé de même strate de \(C\). Seules les paires discordantes (l’un malade, l’autre sain) renseignent : sous l’hypothèse nulle sans biais caché, chacune est un tirage à pile ou face. Un déséquilibre caché \(\Gamma\) borne la probabilité d’un tirage dans \([1/(1+\Gamma), \Gamma/(1+\Gamma)]\) — d’où des bornes exactes de la p-valeur du test du signe (Rosenbaum 2002, chap. 4 ; calcul binomial exact, il n’existe pas de package Python établi pour cette borne).
discordantes = dso.paires_appariees(df_binaire, seed=0)m, s =len(discordantes), int(discordantes.sum())p_obs = dso.bornes_rosenbaum(s, m, 1.0)[1]print(f"paires discordantes m = {m} ; succes (traite malade) s = {s}")print(f"p-valeur observee (Gamma=1) = {p_obs:.2e}")
paires discordantes m = 193 ; succes (traite malade) s = 122
p-valeur observee (Gamma=1) = 1.48e-04
Pourquoi passer par des paires appariées. Rosenbaum travaille sur des paires discordantes (une traitée malade, une non-traitée saine — les paires concordantes n’apportent aucune information sur le sens de l’effet) : ici m = 193 paires, dont s = 122 « succès » côté traité. Sous l’hypothèse nulle d’absence d’effet, chaque paire tire à pile ou face : E[s] = m/2 = 96.5. L’écart observé (122 vs 96.5) est ce que la p-valeur 1.48e-04 chiffre. L’appariement a un coût : en ne gardant que les discordantes, on jette de la puissance statistique ; il a un bénéfice : la question devient « *à quel point les paires sont-elles déséquilibrées en faveur du traité ? » — question que Γ paramètre exactement dans la cellule suivante.
lignes = []for g in (1.0, 1.33, 1.5, 2.0, 3.0): lo, hi = dso.bornes_rosenbaum(s, m, g) lignes.append({"Gamma": g, "p_basse": f"{lo:.1e}", "p_haute": f"{hi:.1e}"})bornes = pd.DataFrame(lignes)print(bornes.to_string(index=False))gamma_etoile = dso.gamma_critique(s, m)print(f"\nGamma* (borne haute croise 0.05) = {gamma_etoile:.2f}")
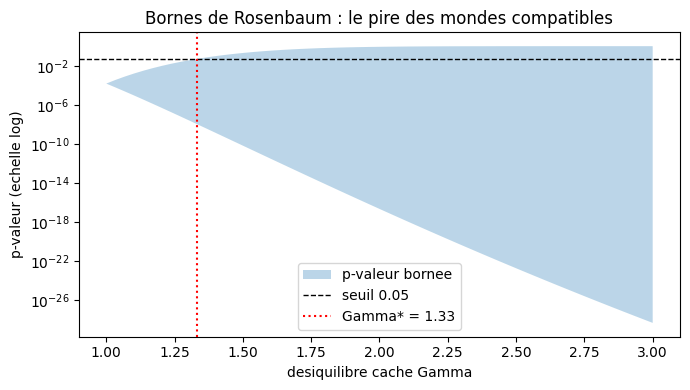
Γ* = 1.33 — la réponse la plus fragile des trois cadres. La borne haute (la plus favorable à H1) touche 0.05 dès Γ = 1.33 : un observateur non apparié qui aurait pu orienter 33 % de préférence vers le traitement suffit à dissoudre la significativité. À Γ = 2, la borne haute est 0.86 — plus rien ne subsiste. Contrepoint frappant avec le monde B binaire : l’E-value (2.98) disait l’association robuste ; Rosenbaum dit fragile. Aucun des deux ne se trompe — ils répondent à des hypothèses de biais différentes (un confondeur caché continu agissant sur X et Y contre un biais de sélection des paires à odds ratio Γ). La synthèse (cellule suivante) en tire la morale : la sensibilité d’un résultat n’est pas un nombre, c’est un nombre par cadre d’hypothèses.
gammas = np.linspace(1.0, 3.0, 60)p_hautes = [dso.bornes_rosenbaum(s, m, g)[1] for g in gammas]p_basses = [dso.bornes_rosenbaum(s, m, g)[0] for g in gammas]fig, ax = plt.subplots(figsize=(7, 4))ax.fill_between(gammas, p_basses, p_hautes, alpha=0.3, label="p-valeur bornee")ax.axhline(0.05, color="black", ls="--", lw=1, label="seuil 0.05")ax.axvline(gamma_etoile, color="red", ls=":", label=f"Gamma* = {gamma_etoile:.2f}")ax.set_yscale("log")ax.set_xlabel("desiquilibre cache Gamma")ax.set_ylabel("p-valeur (echelle log)")ax.set_title("Bornes de Rosenbaum : le pire des mondes compatibles")ax.legend()plt.tight_layout()plt.show()
Lecture de la courbe — un sandwich qui s’évase. La zone grisée entre borne basse et borne haute est l’intervalle d’ignorance : la vraie p-valeur (si l’assignation avait pu être biaisée d’un facteur Γ) vit quelque part dans cette bande, sans que rien dans les données ne permette d’y trancher. À Γ = 1 (bande nulle), on retrouve le test apparié classique ; à mesure que Γ croît, la bande s’évase et avale 0.05 — le verdict bascule non pas quand la borne basse dépasse le seuil, mais quand c’est la borne haute (la plus favorable à l’effet) qui le franchit : Γ* = 1.33.
La discipline de lecture est asymétrique et c’est le point pédagogique : un sceptique n’a pas besoin de connaître le vrai Γ — il lui suffit d’affirmer « un déséquilibre de sélection de l’ordre de 1.5 est plausible dans cette étude » pour que toute la bande soit au-dessus du seuil et que la significativité devienne indécidable. L’analyste, lui, doit argumenter que Γ plafonne plus bas (design, covariables d’appariement riches) — un argument de design, plus de données. La courbe matérialise ce déplacement : à gauche du croisement, la statistique décide ; à droite, seule la qualité du protocole peut décider. C’est la limite honnête de toute analyse d’observation, donnée à voir plutôt que maquillée.
6. Synthèse — trois chiffres pour une même question
« Quelle force devrait avoir un confondeur caché pour annuler cet effet ? »
Monde
Formalisation
Le chiffre
Contre quoi le lire
Continu (naïf 1.16)
robustness value
0.68 de R² partiel
\(R^2\) réel de \(U\) : 0.49
Continu (bascule)
\(\kappa\) simulé
1.5 (\(\kappa_t = 0.7\))
coefficients du monde
Binaire (RR 1.79)
E-value
2.98
E-value observé de \(C\) : 1.16
Paires (m=193)
Rosenbaum
Γ* = 1.33
Γ d’un biais plausible
Ce que les trois formalisations s’accordent à dire : la sensibilité ne dit pas que l’effet est vrai — elle dit à quel point il est attaquable. L’association du monde A survit à son \(U\) réel tout en étant réduite de moitié ; l’association du monde B exige un cache bien plus fort que \(C\), mais un déséquilibre d’appariement modeste (Γ 1.33) suffirait à la masquer. Un chiffre par monde, pas une réserve rhétorique.
Exercice 1 — Le rapport de forces : renforcer U vs affaiblir l’effet
Deux intuitions à confronter aux mesures, sur le monde A :
Renforcer le cache : régénérer avec coef_u_x=1.8, coef_u_y=1.8. Mesurer naive, RV et R² réels de U — le verdict bascule-t-il ?
Affaiblir le signal : régénérer avec tau=0.2, bruit_y=3.0 (l’effet vrai chute, le bruit monte). Mêmes mesures — et cette fois ?
Conclure : pourquoi le RV monte-t-il quand U se renforce, et pourquoi affaiblir l’effet (pas renforcer le cache) rend l’association annulable ?
attendu : cas 1 -> SURVIT (RV ~0.89 > R2U ~0.87) : l’association OBSERVEE grossit avec U
attendu : cas 2 -> ANNULABLE (RV ~0.25 < R2U ~0.49) : meme un cache aussi fort que U annule
resultats_ex1 =None# TODO etudiant# Etape 1 : df_fort = dso.generer_donnees_continues(seed=42, cacher_u=False, coef_u_x=1.8, coef_u_y=1.8)# Etape 2 : estimer + robustesse_partielle_r2 + r2_partiel + verdict_sensibilite (comme sections 1-2)# Etape 3 : idem avec tau=0.2, bruit_y=3.0# Indice : sur la vue cacher_u=False, estimer sur df[["X", "Y", "C"]] ; les R2 sur la vue complete
Exercice 2 — L’E-value de l’IC et la taille d’échantillon
L’E-value de l’estimé (2.98) dépasse celui de l’IC (2.04). Refaire l’analyse du monde B avec n=10000 :
Pourquoi l’IC se resserre-t-il, et que fait l’E-value de l’IC ?
Pourquoi l’E-value de l’estimé bouge-t-il à peine ?
attendu : IC plus etroit -> sa borne s’eloigne de 1 -> E-value(IC) MONTE vers l’E-value(estime)
attendu : l’estime ponctuel converge (biais de U constant) -> son E-value est presque inchange
resultats_ex2 =None# TODO etudiant# Etape 1 : df_b_grand = dso.generer_donnees_binaires(n=10000, seed=42)# Etape 2 : estimer_rr_binaire puis sensibilite_e_value, comparer a la section 4# Indice : comparer (rr.rr_inf, ev.evalue_ic_limite, ev.evalue_estime) a n=3000 vs n=10000
Exercice 3 — Γ* d’un effet plus faible
Reprendre le monde B avec b_x=0.2 (RR vrai \(e^{0.2} \approx 1.22\)) : ré-apparier, recompter \((m, s)\), recalculer Γ. Comparer au Γ* = 1.33 de la section 5 et conclure : Γ mesure-t-il la vérité de l’effet ou sa solidité statistique face au pire des mondes ?
attendu : effet plus faible -> Gamma* plus proche de 1 (un desequilibre cache plus faible suffit)
attendu : Gamma* peut rester > 1 tant que l’effet est detectable : solidite, pas verite
resultats_ex3 =None# TODO etudiant# Etape 1 : df_b_faible = dso.generer_donnees_binaires(n=3000, seed=42, b_x=0.2)# Etape 2 : paires_appariees -> (m, s) ; bornes_rosenbaum sur une grille ; gamma_critique# Indice : dso.gamma_critique(s, m) suffit pour le chiffre ; verifier que m reste ~150-200
Attendus et anti-pièges (exercices 1 à 3)
Exercice 1 (rapport de forces).Attendu : renforcer U fait chuter l’estimé ET abaisse le κ* (le point de bascule arrive plus tôt) ; affaiblir l’effet vrai b_x fait le contraire — à effet nul, tout κ > 0 annule. Les deux leviers ne sont pas symétriques dans la table : κ agit sur la pente, b_x sur l’ordonnée à l’origine. Anti-piège : comparer les mondes par le seul estimé final sans re-rapporter le RV — un estimé qui survit avec un RV divisé par deux n’a pas la même crédibilité.
Exercice 2 (E-value de la borne d’IC et taille d’échantillon).Attendu : à RR constant, l’IC se resserre avec n, donc la borne d’IC du RR monte vers le RR lui-même — et l’E-value de la borne grimpe vers l’E-value estimé (2.04 → 2.98). La robustesse apparente croît mécaniquement avec n : plus on a de données, plus l’IC exclut 1, plus il faut un confondeur fort pour annuler jusqu’à la borne. Anti-piège : conclure « plus de données = plus de validité causale » — n achète de la précision, jamais de l’identification ; l’E-value grandit avec n sur le même backdoor incomplet.
Exercice 3 (Γ* d’un effet plus faible).Attendu : avec b_x = 0.3, les paires discordantes s’équilibrent (s plus proche de m/2), la p-valeur monte, et Γ* chute sous 1.33 — possiblement sous 1.1, zone où même un déséquilibre de sélection modeste renverse le verdict. Anti-piège : rapporter « Γ* a baissé » sans la p-valeur à Γ=1 — un Γ* faible avec une p-valeur déjà limite à Γ=1 dit que l’étude ne tenait à rien dès le départ.
À retenir
L’hypothèse de non-confondance invérifiable se chiffre. Trois formalisations (R² partiel, E-value, Γ de Rosenbaum), trois unités, une même question : quelle force annulerait cet effet ?
Un seuil ne suffit pas : il faut l’échelle. Le RV se lit contre les \(R^2\) réels des variables connues ; l’E-value contre l’E-value observé des covariables mesurées ; Γ* contre le Γ d’un biais plausible.
Le rapport de forces est relatif. Renforcer le confondeur caché renforce l’association observée : c’est affaiblir l’effet vrai (signal faible sous bruit) qui rend l’association annulable.
Survivre n’est pas être juste. Le monde A survit à son \(U\) tout en étant réduit de moitié ; aucune analyse de sensibilité ne remplace la mesure du confondeur — elle dit combien elle coûte de l’ignorer.
Série Causal-Bridges (retour au README) : CausalBridges-02 l’estimand, CausalBridges-03 le contrefactuel, CausalBridges-04 le graphe, CausalBridges-05 le confondeur caché, CausalBridges-06 l’instrument faible.
Les trois cadres ne se contredisent pas, ils décrivent des adversaires différents — RV/κ (un confondeur continu caché), E-value (un confondeur binaire caché), Rosenbaum Γ* (un biais de sélection des paires). Reporter les trois chiffres côte à côte, avec leur cadre, est la pratique honnête ; n’en choisir qu’un revient à choisir l’adversaire qu’on accepte d’affronter.