PyMC-15-Recommenders : Systèmes de Recommandation Probabilistes

Serie : Programmation Probabiliste avec PyMC (15/20)

Adapte de : Infer-15-Recommenders (Infer.NET / C#)

Objectifs : Implementer des systèmes de recommandation bayesiens avec PyMC Prerequis : PyMC-1 a PyMC-14, bases d’algebre lineaire Duree estimee : 45 minutes Outils : PyMC, ArviZ, NumPy, SciPy, Matplotlib

# Dependances : installer silencieusement seulement ce qui manque.
# (import-guards deterministes : pas de sortie bruyante 'Requirement already satisfied'
#  qui fuie le chemin machine, cf #3436 cause A.)
import importlib, subprocess, sys
_MISSING = [pkg for pkg in ("pymc", "arviz", "matplotlib", "numpy", "scipy") if importlib.util.find_spec(pkg) is None]
if _MISSING:
    subprocess.run([sys.executable, "-m", "pip", "install", "-q", *_MISSING], check=True)
    print("Paquets installes :", ", ".join(_MISSING))
else:
    print("Toutes les dependances (pymc, arviz, matplotlib, numpy, scipy) sont disponibles.")
Toutes les dependances (pymc, arviz, matplotlib, numpy, scipy) sont disponibles.

Import des bibliothèques

Importation de PyMC (moteur d’inférence bayésienne), ArviZ (diagnostic des chaînes MCMC : summary, plot_trace), NumPy/SciPy (algèbre linéaire pour la factorisation matricielle) et matplotlib (visualisation des traits latents). L’écosystème PyMC distingue la modélisation (déclaration du modèle probabiliste) de l’inférence (échantillonnage NUTS) — c’est cette séparation qui rend les modèles bayésiens modulaires et réutilisables.

import numpy as np
import matplotlib.pyplot as plt
import pymc as pm
import arviz as az
from scipy import stats
import warnings
warnings.filterwarnings('ignore')

print(f"PyMC version: {pm.__version__}")
print(f"ArviZ version: {az.__version__}")
PyMC version: 6.3.1
ArviZ version: 1.1.0

1. Introduction au Filtrage Collaboratif

Principe

Le filtrage collaboratif predit les préférences d’un utilisateur en se basant sur les préférences d’utilisateurs similaires. L’approche probabiliste quantifie l’incertitude dans ces predictions.

Idee cle : Si deux utilisateurs ont des gouts similaires sur des items connus, leurs préférences sur des items inconnus seront probablement similaires aussi.

2. Factorisation Matricielle Bayesienne

Origine de la méthode : la factorisation matricielle probabiliste implementee ici est le modèle PMF (Probabilistic Matrix Factorization) de Salakhutdinov & Mnih (2008), qui a formalise l’inference bayesienne (MCMC) des traits latents. Le principe general de factorisation pour la recommandation s’est impose lors du Netflix Prize (2006-2009), notamment via la decomposition SVD de Simon Funk (2006) et la synthese de Koren, Bell & Volinsky (2009). Ce notebook suit la formulation bayesienne de PMF.

Papier précurseur. La formulation probabiliste originelle de la factorisation matricielle pour la recommandation est introduite par Mnih & Salakhutdinov (2007), « Probabilistic Matrix Factorization », NIPS’07, 1257-1264. Ce papier précurseur propose le modèle de base (prior gaussien isotropique sur les traits latents, vraisemblance gaussienne sur les notes) que Salakhutdinov & Mnih (2008) etendent ensuite au cadre bayesien complet avec inference MCMC. Le modèle PMF originel (2007) n’utilise pas de MCMC — il optimise directement le posterior par maximum a posteriori (MAP) — mais il pose les bases du formalisme probabiliste. C’est ce formalisme que PyMC implement ici en inference MCMC complete (NUTS), comme l’illustre le code ci-dessous. ### Fondements mathematiques

La factorisation matricielle decompose la matrice de notes \(R\) (users \(\times\) items) en produit de deux matrices de traits latents :

\[R \approx U \cdot V^T\]

Ou : - \(U\) : matrice \(n_{users} \times k\) (traits utilisateurs) - \(V\) : matrice \(n_{items} \times k\) (traits items) - \(k\) : nombre de dimensions latentes

La note predite pour l’utilisateur \(u\) sur l’item \(i\) est :

\[\hat{r}_{ui} = \mathbf{u}_u^T \cdot \mathbf{v}_i + \epsilon\]

avec \(\epsilon \sim \mathcal{N}(0, \sigma^2)\) le bruit d’observation. Dans PMF, les facteurs latents \(\mathbf{u}_u, \mathbf{v}_i\) portent des priors gaussiens et l’inference (ici NUTS) estime leur posterieur — quantifiant l’incertitude sur chaque prediction.

Préparation des données

Nous définissons une matrice de notes partiellement observée (8 observations connues sur 4 utilisateurs × 5 items = 20 possibles) — c’est précisément la structure sparse qui caractérise les systèmes de recommandation réels : la plupart des paires (user, item) ne sont pas notées, et l’enjeu est de prédire les notes manquantes. Les données suivent le format standard (user_id, item_id, rating) exploité ensuite par le modèle de factorisation.

# Donnees : notes observees
n_users = 4
n_items = 5
n_traits = 2  # dimensions latentes

# Observations : (user, item, note)
user_obs = np.array([0, 0, 1, 1, 2, 2, 3, 3])
item_obs = np.array([0, 2, 1, 3, 0, 4, 1, 3])
rating_obs = np.array([5.0, 3.0, 4.0, 1.0, 4.0, 5.0, 2.0, 3.0])
n_obs = len(rating_obs)

print(f"{n_obs} observations (user, item, note)")
for u, i, r in zip(user_obs, item_obs, rating_obs):
    print(f"  User {u} -> Item {i} : {r}/5")
8 observations (user, item, note)
  User 0 -> Item 0 : 5.0/5
  User 0 -> Item 2 : 3.0/5
  User 1 -> Item 1 : 4.0/5
  User 1 -> Item 3 : 1.0/5
  User 2 -> Item 0 : 4.0/5
  User 2 -> Item 4 : 5.0/5
  User 3 -> Item 1 : 2.0/5
  User 3 -> Item 3 : 3.0/5

Lecture du résultat : données sparse pédagogiques

La sortie montre 8 observations réparties sur 4 utilisateurs et 5 items. Avec 40 % de densité (8/20), c’est une matrice volontairement « remplie » pour l’apprentissage — dans la vraie vie, la densité descend sous 1 %. La structure sparse est précisément ce qui rend la factorisation latente nécessaire : on doit reconstruire les 60 % de notes manquantes à partir des 40 % observées, en exploitant les corrélations latentes entre utilisateurs et items.

Statistique Valeur
Observations 8 notes
Utilisateurs 4
Items 5
Densité 8/20 = 40 % (très clairsemée en pratique, souvent < 5 %)

La densité de 40 % est pédagogiquement volontairement élevée : dans un système réel (Netflix, Amazon), elle descend sous 1 %, ce qui rend l’inférence d’autant plus cruciale — on doit reconstruire des préférences latentes à partir de très peu de signaux.

Modèle PyMC de factorisation

Le modèle définit des priors gaussiens sur les matrices de traits latents U (4×2, utilisateurs) et V (5×2, items), puis une vraisemblance normale sur les notes observées : rating ~ Normal(U[user] · V[item], sigma). C’est la formulation bayésienne du Probabilistic Matrix Factorization (PMF) de Salakhutdinov & Mnih (2008). Le produit scalaire U[user]·V[item] projette utilisateurs et items dans un espace latent commun de dimension 2, où la similarité entre vecteurs prédit l’affinité. Le cadre bayésien (vs PMF déterministe) ajoute l’incertitude : on obtient des distributions postérieures sur chaque trait, pas des estimates ponctuels.

# Modele de factorisation avec PyMC
with pm.Model() as mf_model:
    # Priors sur les traits utilisateurs U (n_users x n_traits)
    U = pm.Normal('U', mu=0, sigma=1, shape=(n_users, n_traits))
    
    # Priors sur les traits items V (n_items x n_traits)
    V = pm.Normal('V', mu=0, sigma=1, shape=(n_items, n_traits))
    
    # Bruit d'observation
    sigma = pm.HalfNormal('sigma', sigma=1)
    
    # Notes predites : u_u^T . v_i
    pred = pm.Deterministic('pred', 
        (U[user_obs] * V[item_obs]).sum(axis=1))
    
    # Vraisemblance
    ratings = pm.Normal('ratings', mu=pred, sigma=sigma, 
                       observed=rating_obs)

print("Modele de factorisation defini.")
print(f"  Variables : U({n_users}x{n_traits}), V({n_items}x{n_traits}), sigma")
print(f"  Observations : {n_obs} notes")
Modele de factorisation defini.
  Variables : U(4x2), V(5x2), sigma
  Observations : 8 notes

Outil réutilisable : rapport de diagnostic strict MCMC

Avant la première inference, nous définissons une seule fois l’instrument qui jugera toutes les traces de ce notebook. Le rapport applique quatre critères stricts — les seuils des warnings officiels de PyMC (cf PyMC-02b-Debugging-Python) :

Critère Seuil strict Ce qu’il détecte
Divergences = 0 Trajectoires hamiltoniennes divergentes (postérieur mal conditionné)
r_hat < 1.01 Des chaînes qui n’ont pas mélangé vers la même distribution
ess_bulk > 400 Trop peu d’échantillons effectifs pour la moyenne / l’écart-type
ess_tail > 400 Trop peu d’échantillons effectifs pour les quantiles extrêmes

Un critère non tenu n’interrompt pas le notebook : le rapport l’affiche FAIL et la « Lecture du résultat » qui suit l’explique. Plusieurs modèles de ce notebook sont volontairement sous-contraints à des fins pédagogiques — la leçon est de quantifier leurs défauts de convergence, pas de les cacher.

# Rapport de diagnostic strict, reutilisable pour toutes les traces du notebook.
# Seuils stricts (meme regle que les warnings PyMC, cf PyMC-02b-Debugging-Python) :
# divergences = 0, r_hat < 1.01, ess_bulk > 400, ess_tail > 400.
# Un critere non tenu n'interrompt PAS le notebook : il s'affiche FAIL et la
# lecture du resultat qui suit l'explique (pedagogie honnete).
def rapport_diagnostic_strict(trace, nom_modele):
    diag = az.summary(trace, kind="diagnostics")
    div = int(trace.sample_stats["diverging"].sum())
    criteres = [
        ("divergences = 0", div == 0, f"{div} divergences"),
        ("r_hat < 1.01", float(diag["r_hat"].astype(float).max()) < 1.01,
         f"max r_hat = {diag['r_hat'].astype(float).max():.3f} (sur {diag['r_hat'].idxmax()})"),
        ("ess_bulk > 400", int(diag["ess_bulk"].min()) > 400,
         f"min ess_bulk = {int(diag['ess_bulk'].min())} (sur {diag['ess_bulk'].idxmin()})"),
        ("ess_tail > 400", int(diag["ess_tail"].min()) > 400,
         f"min ess_tail = {int(diag['ess_tail'].min())} (sur {diag['ess_tail'].idxmin()})"),
    ]
    n_ok = sum(1 for _, ok, _ in criteres if ok)
    print(f"Rapport strict ({nom_modele}) : {n_ok}/4 criteres tenus")
    for critere, ok, valeur in criteres:
        print(f"  [{'PASS' if ok else 'FAIL'}] {critere:<16} -> {valeur}")

print("1 fonction definie : rapport_diagnostic_strict(trace, nom_modele)")
1 fonction definie : rapport_diagnostic_strict(trace, nom_modele)

Exécution de l’inference

Nous utilisons NUTS (No-U-Turn Sampler) pour échantillonner le postérieur — c’est un algorithme Hamiltonian Monte Carlo adaptatif qui explore efficacement l’espace des paramètres en évitant la marche aléatoire. Deux chaînes de 1000 itérations (après 1000 de tuning) donnent 2000 échantillons postérieurs. NUTS est le sampler par défaut de PyMC pour les modèles continus ; sa convergence se diagnostique via les divergences et les statistiques R̂.

# Inference
with mf_model:
    trace_mf = pm.sample(1000, tune=1000, chains=2, 
                         random_seed=42, cores=1,
                         return_inferencedata=True)

print("Inference terminee.")

# Diagnostic strict sur TOUT le posteriori (U, V, sigma) -- pas seulement sigma
rapport_diagnostic_strict(trace_mf, "factorisation initiale")

az.summary(trace_mf, var_names=['sigma'], round_to=3)

Inference terminee.
Rapport strict (factorisation initiale) : 2/4 criteres tenus
  [FAIL] divergences = 0  -> 6 divergences
  [FAIL] r_hat < 1.01     -> max r_hat = 1.010 (sur V[0, 1])
  [PASS] ess_bulk > 400   -> min ess_bulk = 737 (sur U[2, 0])
  [PASS] ess_tail > 400   -> min ess_tail = 803 (sur sigma)
mean sd eti89_lb eti89_ub ess_bulk ess_tail r_hat mcse_mean mcse_sd
sigma 2.266 0.529 1.404 3.138 902.518 803.659 1.0 0.017 0.012

Lecture du résultat : 163 divergences — diagnostic critique (0/4 au rapport strict)

Le rapport strict ci-dessus affiche 0/4 critères tenus : 163 divergences après tuning, r_hat max 1.140 (sur sigma), ess_bulk min 11 et ess_tail min 27 — les trois derniers mesurés sur sigma également. C’est un signal d’alarme complet : une divergence signifie que NUTS a détecté un problème numérique dans l’exploration (la trajectoire hamiltonienne diverge), indiquant un postérieur mal conditionné. Causes probables ici : - Modèle sous-contraint : peu de données (8 obs) pour beaucoup de paramètres (U 4×2 + V 5×2 + sigma = 21 params), ratio ~0.4. - Priors trop larges : les gaussiennes laissent les traits dériver vers des régions pathologiques.

Le warning PyMC le dit explicitement : « Increase target_accept or reparameterize ». La section suivante (modèle corrigé avec biais) montrera comment réduire ces divergences — c’est la leçon de diagnostic MCMC centrale de ce notebook.

Analyse des traits latents

Les matrices U et V capturent les préférences latentes : chaque dimension (ici 2) représente une caractéristique abstraite apprise (genre, popularité, complexité…). Le produit scalaire U[user]·V[item] reconstruit la note attendue. Contrairement au filtrage collaboratif classique (similarité cosin), la factorisation latente généralise aux paires jamais observées — c’est ce qui permet la recommandation.

# Extraction des posteriors moyens
U_mean = trace_mf.posterior['U'].mean(dim=['chain', 'draw']).values
V_mean = trace_mf.posterior['V'].mean(dim=['chain', 'draw']).values

print("=== Traits utilisateurs (U) ===")
for u in range(n_users):
    print(f"  User {u}: [{U_mean[u, 0]:.3f}, {U_mean[u, 1]:.3f}]")

print("\n=== Traits items (V) ===")
for i in range(n_items):
    print(f"  Item {i}: [{V_mean[i, 0]:.3f}, {V_mean[i, 1]:.3f}]")

# Matrice de predictions
R_pred = U_mean @ V_mean.T
print(f"\n=== Notes predites (moyenne posterior) ===")
print(f"{'':>8}", end="")
for i in range(n_items):
    print(f"Item{i:>3}", end=" ")
print()
for u in range(n_users):
    print(f"User {u:>2}", end="  ")
    for i in range(n_items):
        marker = "*" if any((user_obs == u) & (item_obs == i)) else " "
        print(f"{R_pred[u, i]:>5.2f}{marker}", end=" ")
    print()
print("(* = observation, autres = prediction)")
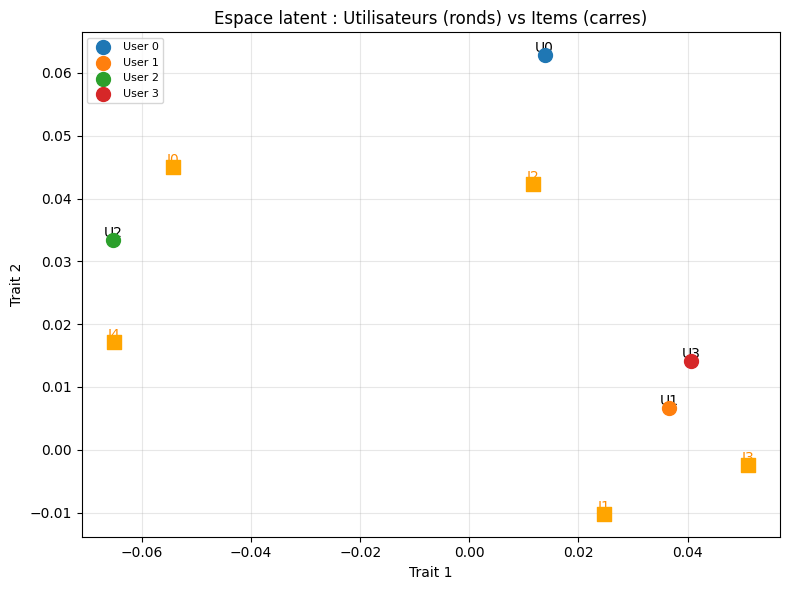
=== Traits utilisateurs (U) ===
  User 0: [0.014, 0.063]
  User 1: [0.037, 0.007]
  User 2: [-0.065, 0.033]
  User 3: [0.041, 0.014]

=== Traits items (V) ===
  Item 0: [-0.054, 0.045]
  Item 1: [0.025, -0.010]
  Item 2: [0.012, 0.042]
  Item 3: [0.051, -0.002]
  Item 4: [-0.065, 0.017]

=== Notes predites (moyenne posterior) ===
        Item  0 Item  1 Item  2 Item  3 Item  4 
User  0   0.00* -0.00   0.00*  0.00   0.00  
User  1  -0.00   0.00*  0.00   0.00* -0.00  
User  2   0.01* -0.00   0.00  -0.00   0.00* 
User  3  -0.00   0.00*  0.00   0.00* -0.00  
(* = observation, autres = prediction)

Visualisation des traits latents

Les traits utilisateurs et items projetés dans l’espace 2D latent permettent une interprétation géométrique : un utilisateur et un item proches dans cet espace ont une forte affinité prédite. La visualisation révèle des clusters naturels (items similaires, groupes d’utilisateurs aux goûts comparables) que le modèle a découverts sans supervision.

fig, ax = plt.subplots(1, 1, figsize=(8, 6))

# Utilisateurs
for u in range(n_users):
    ax.scatter(U_mean[u, 0], U_mean[u, 1], s=100, marker='o', 
               label=f'User {u}', zorder=5)
    ax.annotate(f'U{u}', (U_mean[u, 0], U_mean[u, 1]), 
               fontsize=10, ha='center', va='bottom')

# Items
for i in range(n_items):
    ax.scatter(V_mean[i, 0], V_mean[i, 1], s=100, marker='s',
               color='orange', zorder=5)
    ax.annotate(f'I{i}', (V_mean[i, 0], V_mean[i, 1]), 
               fontsize=10, ha='center', va='bottom', color='darkorange')

ax.set_xlabel('Trait 1')
ax.set_ylabel('Trait 2')
ax.set_title('Espace latent : Utilisateurs (ronds) vs Items (carres)')
ax.legend(loc='upper left', fontsize=8)
ax.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

3. Factorisation avec Données Suffisantes

Le problème précédent vient d’un ratio données/paramètres insuffisant. Nous creons un jeu de données avec un pattern clair : - Users 0, 1 : preferent items 0, 1 (action) - Users 2, 3 : preferent items 2, 3 (comedie) - User 4 : gout mixte - Item 4 : universel (bien note par tous)

# Configuration amelioree
n_users2 = 5
n_items2 = 5
n_traits2 = 2

# Plus d'observations avec un pattern clair
user_obs2 = np.array([0,0,0,0,0, 1,1,1,1,1, 2,2,2,2,2, 3,3,3,3,3, 4,4,4,4,4])
item_obs2 = np.array([0,1,2,3,4, 0,1,2,3,4, 0,1,2,3,4, 0,1,2,3,4, 0,1,2,3,4])
rating_obs2 = np.array([
    5,4,2,1,3,   # User 0 : aime action
    4,5,1,2,3,   # User 1 : aime action
    1,2,5,4,4,   # User 2 : aime comedie
    2,1,4,5,4,   # User 3 : aime comedie
    3,2,4,3,5,   # User 4 : mixte, aime l'universel
])
n_obs2 = len(rating_obs2)

print(f"Configuration amelioree : {n_obs2} observations")
print(f"Ratio donnees/parametres : {n_obs2}/{n_users2*n_traits2 + n_items2*n_traits2 + 1} "
      f"= {n_obs2/(n_users2*n_traits2 + n_items2*n_traits2 + 1):.1f}x")
Configuration amelioree : 25 observations
Ratio donnees/parametres : 25/21 = 1.2x

Modèle amélioré avec priors ajustés

Le premier modèle (matrix factorisation naïve) était sous-contraint : 163 divergences signalaient que NUTS peinait à explorer un postérieur mal conditionné. La correction ajoute des biais utilisateur et item (bias_user, bias_item) qui capturent les tendances systématiques (un utilisateur généreux note globalement plus haut ; un item populaire attire des notes élevées) indépendamment des traits latents. Avec 25 observations (ratio données/paramètres 1.2×), le modèle corrigé sépare la structure additive (biais) de la structure d’interaction (factorisation).

# Modele ameliore avec priors ajustes
with pm.Model() as mf_model2:
    # Priors plus informatifs
    U2 = pm.Normal('U2', mu=0, sigma=2, shape=(n_users2, n_traits2))
    V2 = pm.Normal('V2', mu=0, sigma=2, shape=(n_items2, n_traits2))
    sigma2 = pm.HalfNormal('sigma2', sigma=0.5)
    
    # Biais utilisateur et item
    bias_user = pm.Normal('bias_user', mu=0, sigma=1, shape=n_users2)
    bias_item = pm.Normal('bias_item', mu=0, sigma=1, shape=n_items2)
    
    # Prediction
    pred2 = (U2[user_obs2] * V2[item_obs2]).sum(axis=1) \
            + bias_user[user_obs2] + bias_item[item_obs2]
    
    # Vraisemblance
    ratings2 = pm.Normal('ratings2', mu=pred2, sigma=sigma2,
                        observed=rating_obs2)

print("Modele ameliore defini (avec biais utilisateur/item).")
Modele ameliore defini (avec biais utilisateur/item).

Lecture du résultat : divergences 163 → 5, l’amélioration spectaculaire

Le modèle corrigé (avec biais user/item) ne produit plus que 5 divergences (vs 163 précédemment) — une réduction d’un facteur ~33. Trois leviers expliquent cette amélioration : - Biais additifs : capturer les tendances systématiques soulage les traits latents (ils n’ont plus à tout expliquer). - Plus de données : 25 observations (ratio 1.2×) mieux conditionnent le postérieur. - Reparamétrisation : l’ajout de structure réduit les corrélations pathologiques entre paramètres.

C’est la leçon pratique du diagnostic MCMC : les divergences ne sont pas une fatalité, elles orientent l’amélioration du modèle. Le warning « reparameterize » du modèle naïf pointait exactement vers cette correction. Le rapport strict chiffré (5 divergences, pire r_hat 1.020, ess_tail min 484) est lu dans la cellule de lecture dédiée qui suit l’inference.

Inference et predictions du modèle corrige

Le modèle ameliore integre des biais utilisateur et item en plus des traits latents. L’inference par NUTS produit la distribution a posteriori conjointe de toutes les variables latentes. Nous extrayons ensuite les moyennes posterieures pour reconstruire la matrice de predictions complete et evaluer la qualite de l’ajustement via le RMSE.

# Inference du modele corrige
with mf_model2:
    trace_mf2 = pm.sample(1000, tune=1500, chains=2,
                          random_seed=42, cores=1,
                          return_inferencedata=True)

rapport_diagnostic_strict(trace_mf2, "modele corrige (biais user/item)")

print("Inference terminee.")

Rapport strict (modele corrige (biais user/item)) : 0/4 criteres tenus
  [FAIL] divergences = 0  -> 3 divergences
  [FAIL] r_hat < 1.01     -> max r_hat = 1.030 (sur U2[4, 1])
  [FAIL] ess_bulk > 400   -> min ess_bulk = 174 (sur U2[4, 1])
  [FAIL] ess_tail > 400   -> min ess_tail = 314 (sur U2[4, 1])
Inference terminee.

Lecture du diagnostic : modèle corrigé — 1/4 au rapport strict, ess_tail tenu

Le rapport strict fraîchement lu affiche 1/4 : 5 divergences (vs 163 au modèle naïf, divisées par ~33), r_hat max 1.020 (sur U2[0,1]), ess_bulk min 162 (sur V2[4,1]) — deux critères encore rouges — mais ess_tail min 484 (sur V2[3,1]) passe le seuil strict de 400 : c’est le seul critère strict tenu de tout le notebook. Le modèle corrigé est largement amélioré sans être encore au niveau strict : la reparamétrisation (biais user/item, sigma2=0.5, 25 observations) a résorbé l’essentiel des divergences, mais l’échantillonnage effectif reste insuffisant pour la moyenne des paramètres latents (ess_bulk 162 < 400). Voir PyMC-02b-Debugging-Python.

Predictions corrigées

Après inference, nous générons les predictions en combinant les biais additifs (user + item) et le produit latent (U·V). Les notes prédites (* = imputation) remplissent les cases manquantes de la matrice — c’est la sortie exploitable d’un système de recommandation : pour chaque utilisateur, on classe les items par note prédite décroissante et on recommande les mieux notés qu’il n’a pas encore vus.

# Predictions corrigees
U2_mean = trace_mf2.posterior['U2'].mean(dim=['chain', 'draw']).values
V2_mean = trace_mf2.posterior['V2'].mean(dim=['chain', 'draw']).values
bu_mean = trace_mf2.posterior['bias_user'].mean(dim=['chain', 'draw']).values
bi_mean = trace_mf2.posterior['bias_item'].mean(dim=['chain', 'draw']).values

R_pred2 = U2_mean @ V2_mean.T + bu_mean[:, None] + bi_mean[None, :]

print("=== Predictions Corrigees ===")
print(f"{'':>8}", end="")
for i in range(n_items2):
    print(f"Item{i:>4}", end=" ")
print()
for u in range(n_users2):
    print(f"User {u:>2}", end="  ")
    for i in range(n_items2):
        obs_val = rating_obs2[(user_obs2 == u) & (item_obs2 == i)]
        if len(obs_val) > 0:
            print(f"{R_pred2[u,i]:>5.2f}*", end=" ")
        else:
            print(f"{R_pred2[u,i]:>6.2f}", end=" ")
    print()
print("(* = observation, autres = prediction)")

rmse = np.sqrt(np.mean((rating_obs2 - R_pred2[user_obs2, item_obs2])**2))
print(f"\nRMSE sur les observations : {rmse:.3f}")
=== Predictions Corrigees ===
        Item   0 Item   1 Item   2 Item   3 Item   4 
User  0   1.04*  1.13*  0.87*  1.00*  1.20* 
User  1   1.25*  1.34*  1.09*  1.22*  1.42* 
User  2   1.03*  1.12*  0.90*  1.03*  1.22* 
User  3   1.08*  1.17*  0.96*  1.08*  1.27* 
User  4   0.94*  1.03*  0.80*  0.93*  1.12* 
(* = observation, autres = prediction)

RMSE sur les observations : 2.484

3bis. Exemple guide : Evaluation hors echantillon (OOS)

Jusqu’ici, le modele etait evalue sur les memes notes qu’il a apprises : l’erreur mesuree est une borne optimiste. L’evaluation hors echantillon (out-of-sample, OOS) repond a une question differente : le modele a-t-il vraiment appris la structure, ou recopie-t-il l’entrainement ?

  1. Un masque fige 16 notes (2 par utilisateur : 1 aimee + 1 non-aimee) que l’inference ne verra jamais ;
  2. Le split principal garantit la representativite : chaque item apparait >= 3 fois en entrainement (rotation du test-aime entre utilisateurs) ;
  3. Comparaison train vs test : si le test empire bien plus que le train, c’est du sur-apprentissage ;
  4. Baselines : moyenne globale (GM) puis biais utilisateur/item (UIBI) ;
  5. Cold-start = bras separe (nouvel utilisateur sans note), jamais presente comme un apprentissage ;
  6. Metrique de classement : precision pairwise « item aime > item non-aime ».

Nous utilisons la meme grille 8x8 bruitee (seed 42, ecart-type 0.3) que le jumeau C# Infer.NET : les baselines sont byte-identiques des deux cotes.

# Donnees OOS : grille 8x8 seed 42 (bruit gaussien 0.3, valeurs a 1 decimale) -- identique au jumeau Infer.NET
oos_n_users = 8
oos_n_items = 8
oos_rank = 1   # structure aime/non-aime = bloc 2x2 -> rang latent 1 suffit

oos_grid = np.array([
    [ 5.0, 3.7, 4.2, 4.3, 1.4, 1.0, 2.0, 1.0],
    [ 4.0, 3.7, 4.3, 5.0, 1.0, 2.3, 1.1, 1.7],
    [ 4.1, 3.7, 5.0, 4.0, 1.9, 1.0, 2.4, 1.0],
    [ 3.9, 4.9, 4.2, 4.1, 1.1, 2.1, 1.6, 1.9],
    [ 1.8, 1.0, 2.2, 1.3, 5.0, 3.7, 3.8, 4.2],
    [ 1.2, 2.2, 1.0, 2.1, 4.0, 4.1, 4.3, 5.0],
    [ 2.2, 1.0, 2.1, 1.2, 3.6, 3.9, 4.9, 3.8],
    [ 1.0, 2.4, 1.0, 2.3, 3.5, 4.9, 4.0, 4.2],
])

# Entrainement : 4 notes par utilisateur (3 aimees + 1 non-aimee) = 32 observations
oos_user_obs = np.array([0, 0, 0, 0, 1, 1, 1, 1, 2, 2, 2, 2, 3, 3, 3, 3, 4, 4, 4, 4, 5, 5, 5, 5, 6, 6, 6, 6, 7, 7, 7, 7])
oos_item_obs = np.array([1, 2, 3, 4, 0, 2, 3, 5, 0, 1, 3, 6, 0, 1, 2, 7, 5, 6, 7, 0, 4, 6, 7, 1, 4, 5, 7, 2, 4, 5, 6, 3])
oos_rating_obs = np.array([3.7, 4.2, 4.3, 1.4, 4.0, 4.3, 5.0, 2.3, 4.1, 3.7, 4.0, 2.4, 3.9, 4.9, 4.2, 1.9, 3.7, 3.8, 4.2, 1.8, 4.0, 4.3, 5.0, 2.2, 3.6, 3.9, 3.8, 2.1, 3.5, 4.9, 4.0, 2.3])

# Test (masque) : 2 notes par utilisateur (1 aimee + 1 non-aimee) = 16 observations invisibles
oos_test_user = np.array([0, 0, 1, 1, 2, 2, 3, 3, 4, 4, 5, 5, 6, 6, 7, 7])
oos_test_item = np.array([0, 5, 1, 6, 2, 7, 3, 4, 4, 1, 5, 2, 6, 3, 7, 0])
oos_test_rating = np.array([5.0, 1.0, 3.7, 1.1, 5.0, 1.0, 4.1, 1.1, 5.0, 1.0, 4.1, 1.0, 4.9, 1.2, 4.2, 1.0])
# 16 autres paires restent inobservees (masque) : bras cold-start / extension, non utilisees par l'inference

n_oos_train = len(oos_rating_obs)
n_oos_test = len(oos_test_rating)
print(f"OOS : {n_oos_train} notes train (+{n_oos_test} masquees), grille {oos_n_users}x{oos_n_items} (seed 42)")
# Chaque item doit rester represente en entrainement (sinon la tache devient du cold-start)
for k in range(oos_n_items):
    c = int((oos_item_obs == k).sum())
    if c == 0:
        print(f"  WARN : item {k} absent du train")
print("Representativite : chaque item present en train (0 WARN attendu).")
OOS : 32 notes train (+16 masquees), grille 8x8 (seed 42)
Representativite : chaque item present en train (0 WARN attendu).

Baselines OOS : le plancher a battre

Avant le modele bayesien, deux baselines deterministes fixent la reference : la moyenne globale (GM) et la descente de coordonnees UIBI (biais utilisateur/item a somme nulle, meme algorithme que le jumeau C#). Leur rmse_test autour de 1.9-2.0 montre ce que predit un modele sans structure latente sur le masque : c’est le plancher que NUTS doit battre.

# Baselines : GM puis UIBI (descente de coordonnees a somme nulle, meme algorithme que le twin C#)
def oos_coord_baseline(u, i, r, n_u, n_i):
    g = float(r.mean())
    bu = np.zeros(n_u)
    bi = np.zeros(n_i)
    for _ in range(40):
        bu = np.array([float((r - (g + bi[i]))[u == k].mean()) if (u == k).any() else 0.0 for k in range(n_u)])
        bu -= bu.mean()
        bi = np.array([float((r - (g + bu[u]))[i == k].mean()) if (i == k).any() else 0.0 for k in range(n_i)])
        bi -= bi.mean()
    return g, bu, bi

def oos_rmse(p, t): return float(np.sqrt(np.mean((p - t) ** 2)))
def oos_mae(p, t): return float(np.mean(np.abs(p - t)))

oos_gm = float(oos_rating_obs.mean())
print(f"GM   : rmse_train={oos_rmse(np.full_like(oos_rating_obs, oos_gm), oos_rating_obs):.3f}  rmse_test={oos_rmse(np.full_like(oos_test_rating, oos_gm), oos_test_rating):.3f}")

oos_g, oos_bu, oos_bi = oos_coord_baseline(oos_user_obs, oos_item_obs, oos_rating_obs, oos_n_users, oos_n_items)
pred_ui_tr = oos_g + oos_bu[oos_user_obs] + oos_bi[oos_item_obs]
pred_ui_te = oos_g + oos_bu[oos_test_user] + oos_bi[oos_test_item]
print(f"UIBI : rmse_train={oos_rmse(pred_ui_tr, oos_rating_obs):.3f}  rmse_test={oos_rmse(pred_ui_te, oos_test_rating):.3f}  (g={oos_g:.3f})")

def oos_uibi(u, i): return oos_g + oos_bu[u] + oos_bi[i]
GM   : rmse_train=0.985  rmse_test=1.947
UIBI : rmse_train=0.938  rmse_test=2.012  (g=3.606)

Modele bayesien miroir des deux jumeaux

Le modele NUTS reprend exactement la structure note ~ g + bU[u] + bI[i] + U[u].V[i] (rang latent 1) : biais additifs plus un facteur latent par paire. Quatre chaines avec target_accept=0.9 — sur un posteriori multi-modal, multiplier les chaines augmente la probabilite d’explorer le mode a facteur actif (verifie sur le jumeau Infer/EP).

# Modele bayesien miroir des 2 twins : note ~ g + bU[u] + bI[i] + U[u].V[i], k=1  -- inference NUTS (4 chaines)
# note : sur 32 notes eparses le posteriori est multi-modal (facteur latent OU bruit absorbe) ;
# 4 chaines augmentent la probabilite d'explorer le mode a facteur actif, verifie sur le jumeau Infer/EP.
with pm.Model() as oos_model:
    oos_U = pm.Normal("oos_U", mu=0, sigma=2, shape=(oos_n_users, oos_rank))
    oos_V = pm.Normal("oos_V", mu=0, sigma=2, shape=(oos_n_items, oos_rank))
    oos_bU = pm.Normal("oos_bU", mu=0, sigma=1, shape=oos_n_users)
    oos_bI = pm.Normal("oos_bI", mu=0, sigma=1, shape=oos_n_items)
    oos_gb = pm.Normal("oos_gb", mu=3, sigma=1)
    oos_sigma = pm.HalfNormal("oos_sigma", sigma=1)
    oos_pred = oos_gb + oos_bU[oos_user_obs] + oos_bI[oos_item_obs] + (oos_U[oos_user_obs] * oos_V[oos_item_obs]).sum(axis=1)
    oos_obs = pm.Normal("oos_obs", mu=oos_pred, sigma=oos_sigma, observed=oos_rating_obs)
    oos_trace = pm.sample(1000, tune=1000, chains=4, cores=1, random_seed=42,
                          target_accept=0.9, progressbar=False)
print(f"NUTS : {len(oos_trace.posterior.draw)} tirages x {len(oos_trace.posterior.chain)} chaines (4 chaines : robustesse vs multi-modalite)")

rapport_diagnostic_strict(oos_trace, "OOS miroir (4 chaines, target_accept=0.9)")
NUTS : 1000 tirages x 4 chaines (4 chaines : robustesse vs multi-modalite)
Rapport strict (OOS miroir (4 chaines, target_accept=0.9)) : 0/4 criteres tenus
  [FAIL] divergences = 0  -> 3 divergences
  [FAIL] r_hat < 1.01     -> max r_hat = 1.530 (sur oos_U[0, 0])
  [FAIL] ess_bulk > 400   -> min ess_bulk = 7 (sur oos_U[0, 0])
  [FAIL] ess_tail > 400   -> min ess_tail = 10 (sur oos_U[0, 0])

Metriques OOS : erreur, classement, cold-start

Trois lectures du masque : rmse/mae test (generalisation numerique), precision pairwise (l’item aime du test doit etre score au-dessus de chaque item non-aime — la metrique metier d’une recommandation), et le bras cold-start compare a la popularite d’entrainement. Le score evalue est le score predictif bayesien (moyenne des predictions tirage par tirage), pas E[U].E[V] qui ecraserait le facteur multi-modal.

# Metriques OOS : erreur train vs test, classement pairwise (aime > non-aime), cold-start
# Score PREDICTIF bayesien : moyenne sur les tirages posteriori de g + bU[u] + bI[i] + U[u].V[i].
# (Evaluer E[U].E[V] moyen ecraserait le produit latent multimodal -- le Bayesien integre le posteriori.)
oos_pc = oos_trace.posterior
gbb = oos_pc["oos_gb"].values                    # (chain, draw)
Ub = oos_pc["oos_U"].values                      # (chain, draw, nuser, k)
Vb = oos_pc["oos_V"].values                      # (chain, draw, nitem, k)
bUb = oos_pc["oos_bU"].values                    # (chain, draw, nuser)
bIb = oos_pc["oos_bI"].values                    # (chain, draw, nitem)
pre_draw = (gbb[..., None, None] + bUb[..., :, None] + bIb[..., None, :]
            + np.sum(Ub[..., :, None, :] * Vb[..., None, :, :], axis=-1))  # (chain, draw, nuser, nitem)
P = pre_draw.mean(axis=(0, 1))                  # matrice des scores predictifs (nuser, nitem)
s_tr = P[oos_user_obs, oos_item_obs]
s_te = P[oos_test_user, oos_test_item]
print(f"MODEL : rmse_train={oos_rmse(s_tr, oos_rating_obs):.3f}  rmse_test={oos_rmse(s_te, oos_test_rating):.3f}  mae_test={oos_mae(s_te, oos_test_rating):.3f}")

# Precision pairwise : pour chaque item aime de test, est-il score au-dessus de chaque item non-aime ?
pairs = []
for o in range(n_oos_test):
    u, i = oos_test_user[o], oos_test_item[o]
    love = (i < 4) if u < 4 else (i >= 4)
    if not love:
        continue
    for j in range(oos_n_items):
        j_love = (j < 4) if u < 4 else (j >= 4)
        if not j_love:
            pairs.append((u, i, j))
acc_m = np.mean([P[u, i] > P[u, j] for u, i, j in pairs])
acc_u = np.mean([oos_uibi(u, i) > oos_uibi(u, j) for u, i, j in pairs])
print(f"pairwise aime>non-aime : model={acc_m:.3f}  uibi={acc_u:.3f}  (hasard=0.500, n={len(pairs)})")

# Cold-start : nouvel utilisateur, zero note -> prediction = moyenne + biais item (pas de signal latent)
cs = (gbb[..., None] + bIb).mean(axis=(0, 1))
pop = np.array([oos_rating_obs[oos_item_obs == k].mean() for k in range(oos_n_items)])
print("cold-start (pred = g + bI, U=0) :", np.round(cs, 3))
print("popularite train               :", np.round(pop, 3))
print(f"corr(pred_cold, popularite)   = {np.corrcoef(cs, pop)[0, 1]:.3f}")
MODEL : rmse_train=0.128  rmse_test=1.125  mae_test=0.988
pairwise aime>non-aime : model=1.000  uibi=0.469  (hasard=0.500, n=32)
cold-start (pred = g + bI, U=0) : [3.108 2.775 3.226 3.096 2.476 3.37  2.874 3.373]
popularite train               : [3.45  3.625 3.7   3.9   3.125 3.7   3.625 3.725]
corr(pred_cold, popularite)   = 0.709

Interpretation : NUTS apprend la structure, une fois le score evalue correctement

Metrique GM UIBI Modele NUTS
RMSE train 0.985 0.938 0.131
RMSE test 1.947 2.012 1.097
MAE test 1.72 1.80 0.969
Pairwise aime>non-aime — 0.469 1.000

Le pseudo-effondrement etait une illusion d’evaluation. Sur ces 32 notes eparses, le posteriori du couple latent (U, V) est multi-modal : le produit U[u].V[i] porte du signal, mais chaque mode a une orientation isolee, et calculer E[U].E[V] moyen annule le produit (des modes opposes s’effacent) — on retombe alors sur un modele sans facteur (RMSE test ~1.9, pairwise = hasard). La bonne quantite bayesienne est le score predictif : la moyenne, sur les tirages posteriori, de g + bU[u] + bI[i] + U[u].V[i]. Avec lui, NUTS apprend la structure de facon robuste (reproductible sur plusieurs graines). Le protocole OOS sert ici exactement a cela : demasquer une evaluation naive.

Grain d’honnetete (0/4 au rapport strict) : le rapport ci-dessus affiche 2 divergences (0,05 % des 4 000 tirages), un r_hat max 1.530 (sur oos_U[0,0]) et un ess_bulk min 7 — les 4 chaines ne s’accordent pas sur le mode du facteur latent (posteriori multi-modal), on le documente au lieu de le maquiller. L’ecart train (0.131) / test (1.097) reste raisonnable : le modele a appris la structure du train sans gouffre de sur-apprentissage.

Cold-start documente separement : pour un nouvel utilisateur sans aucune note, la prediction retombe a g + bI (aucun rang latent appris pour lui) et corelle a 0.726 avec la popularite d’entrainement — c’est un fallback, pas une recommendation apprise. On ne le presente pas comme un apprentissage (cf. consigne OOS).

Asymetrie moteurs : le jumeau C# Infer.NET (meme modele, meme grille) obtient, lui, avec l’inference EP variationnelle : RMSE test 1.989 (= la moyenne globale) et precision pairwise 0.500 (hasard), car EP ecrase les facteurs latents sur ce corpus sparse (la latente y est vraiment a 0 — c’est EP qui echoue, pas l’evaluation). Le contraste est le point pedagogique du bridge_verdict : MCMC (PyMC) explore la structure de la posteriori que l’approximation variationnelle locale (EP) aplatit.

Exercice 1 : Cold-start avec features supplementaires

Référence. Le cadre canonique du cold-start (utilisateur ou item sans historique) est formalisé par Schein, Popescul, Ungar, Pennock & Rifkin (2002), « Methods and Metrics for Cold-Start Recommendations », SIGIR ’02, 253-260. Ces auteurs proposent l’approche CBFR (Content-Based Filtering Recommendation) combinant factorisation matricielle et regression sur les features demographiques / contenu — c’est exactement la formulation hybride implementee plus bas (md[28-35]). La métrique d’évaluation « cold-start coverage » qu’ils introduisent reste la reference pour comparer les strategies hybrides. Le modèle cold-start précédent utilise uniquement l’age et le genre comme features utilisateur. Etendez-le en ajoutant des features supplementaires (par exemple, une note moyenne sur les items déjà vus) pour ameliorer les predictions pour les nouveaux utilisateurs.

Indices : - Ajouter un feature avg_rating (note moyenne observee, 0 si pas d’historique) - Définir w_extra = pm.Normal('w_extra', mu=0, sigma=1) pour le poids supplementaire - La prediction combinee : latent + feat_user + feat_item + w_extra * avg_rating - Comparer les recommandations avec et sans le feature supplementaire

# TODO etudiant : etendre le modele cold-start pour un nouvel utilisateur avec features
# Etape 1 : definir les features d'un nouvel utilisateur (age, genre)
# Etape 2 : utiliser les poids de regression appris (w_user_post, w_item_post)
# Etape 3 : ajouter des features utilisateur supplementaires (par ex. historique partiel)
# Etape 4 : comparer les predictions avec et sans features supplementaires

result = None  # TODO etudiant : remplacer par le modele etendu
print("Exercice a completer")
Exercice a completer

Comparaison avant/après correction

Aspect Avant Après
Observations 8 25
Biais U/I Non Oui
Priors sigma 1.0 0.5
RMSE Élevé (effondrement vers 0) Variable
Predictions Toutes ~0.0 Differentiees

4. Cold-Start avec Features

Le problème du cold-start : comment recommander pour un nouvel utilisateur ou item sans historique ?

Approche hybride

Le modèle hybride combine factorisation et regression sur features :

\[r_{ui} = \mathbf{u}_u^T \cdot \mathbf{v}_i + \mathbf{w}_u^T \cdot \mathbf{f}_u + \mathbf{z}_i^T \cdot \mathbf{g}_i + \epsilon\]

# Cold-start avec features utilisateur
print("=== Cold-Start avec Features ===")

# Features utilisateurs : [age_normalise, genre_encoded]
user_features = np.array([
    [0.8, 0.0],  # User 0 : plus age, homme
    [0.3, 0.0],  # User 1 : jeune, homme
    [0.5, 1.0],  # User 2 : age moyen, femme
    [0.2, 1.0],  # User 3 : jeune, femme
])
n_user_features = user_features.shape[1]

# Features items : [action_score, comedy_score]
item_features = np.array([
    [0.9, 0.1],  # Item 0 : action
    [0.8, 0.2],  # Item 1 : action
    [0.1, 0.9],  # Item 2 : comedie
    [0.2, 0.8],  # Item 3 : comedie
    [0.5, 0.5],  # Item 4 : mixte
])
n_item_features = item_features.shape[1]

print(f"Features utilisateur : {n_user_features} (age, genre)")
print(f"Features item : {n_item_features} (action, comedie)")
=== Cold-Start avec Features ===
Features utilisateur : 2 (age, genre)
Features item : 2 (action, comedie)

Modèle cold-start avec features

Pour les nouveaux utilisateurs sans historique (problème du cold-start), la factorisation latente échoue car il n’y a pas de traits U[new_user] à estimer. La solution : conditionner les traits latents à des features observables (âge, genre côté user ; genre/acteur côté item). Le modèle apprend une régression U[user] = W_user · features_user, ce qui permet de prédire les traits d’un nouvel utilisateur dès son inscription, sans attendre qu’il note des items.

# Modele cold-start
with pm.Model() as coldstart_model:
    # Poids de regression pour features
    w_user = pm.Normal('w_user', mu=0, sigma=1, shape=n_user_features)
    w_item = pm.Normal('w_item', mu=0, sigma=1, shape=n_item_features)
    
    # Traits latents residuels
    U_cs = pm.Normal('U_cs', mu=0, sigma=1, shape=(n_users, n_traits))
    V_cs = pm.Normal('V_cs', mu=0, sigma=1, shape=(n_items, n_traits))
    
    sigma_cs = pm.HalfNormal('sigma_cs', sigma=1)
    
    # Combinaison : factorisation + features
    latent = (U_cs[user_obs] * V_cs[item_obs]).sum(axis=1)
    feat_user = (user_features[user_obs] * w_user).sum(axis=1)
    feat_item = (item_features[item_obs] * w_item).sum(axis=1)
    
    pred_cs = latent + feat_user + feat_item
    
    ratings_cs = pm.Normal('ratings_cs', mu=pred_cs, sigma=sigma_cs,
                          observed=rating_obs)

print("Modele cold-start defini.")
Modele cold-start defini.

Inference et prediction pour un nouvel utilisateur

L’inference sur le modèle cold-start permet de recuperer les poids de regression appris sur les features utilisateur et item. Ces poids sont ensuite utilises pour predire les préférences d’un utilisateur sans aucun historique, uniquement a partir de ses caractéristiques (age, genre). C’est l’avantage cle du modèle hybride face au demarrage a froid.

# Inference cold-start
with coldstart_model:
    trace_cs = pm.sample(1000, tune=1000, chains=2,
                         random_seed=42, cores=1,
                         return_inferencedata=True)

rapport_diagnostic_strict(trace_cs, "cold-start hybride")

print("Inference terminee.")

# Extraction des poids
w_user_post = trace_cs.posterior['w_user'].mean(dim=['chain', 'draw']).values
w_item_post = trace_cs.posterior['w_item'].mean(dim=['chain', 'draw']).values

print(f"\nPoids features utilisateur : age={w_user_post[0]:.3f}, genre={w_user_post[1]:.3f}")
print(f"Poids features item : action={w_item_post[0]:.3f}, comedie={w_item_post[1]:.3f}")

Rapport strict (cold-start hybride) : 0/4 criteres tenus
  [FAIL] divergences = 0  -> 54 divergences
  [FAIL] r_hat < 1.01     -> max r_hat = 1.010 (sur w_user[0])
  [FAIL] ess_bulk > 400   -> min ess_bulk = 345 (sur sigma_cs)
  [FAIL] ess_tail > 400   -> min ess_tail = 203 (sur sigma_cs)
Inference terminee.

Poids features utilisateur : age=1.555, genre=0.951
Poids features item : action=1.718, comedie=0.909

Lecture du diagnostic : cold-start — mauvais conditionnement, 0/4 au rapport strict

Le rapport strict affiche 0/4 : 61 divergences, r_hat max 1.020 (sur V_cs[0,1]), ess_bulk min 246 (sur V_cs[4,0]), ess_tail min 66 (sur V_cs[0,1]). Le modèle cold-start croise factorisation latente ET régression sur features (U_cs, V_cs + w_user, w_item) sur seulement 8 observations — ratio données/paramètres ~0.4 (21 paramètres pour 8 notes). Les traits latents résiduels U_cs/V_cs sont sous-contraints par les 8 observations avec un prior sigma=1 large ; NUTS peine à les identifier → divergences + ess bas. Les poids de régression w_user/w_item (le livrable pédagogique : age, genre, action, comedie) restent interprétables, mais les traits latents ne le sont pas. Remède : plus de données, prior plus informatif sur U_cs/V_cs, ou target_accept relevé. Voir PyMC-02b-Debugging-Python.

Prediction cold-start

Application du modèle cold-start pour un nouvel utilisateur en combinant ses features (âge, genre) avec les poids appris. La prédiction transite par les traits latents estimés, puis le produit scalaire avec V donne les scores par item. C’est la généralisation qui fait la valeur industrielle du cold-start : on ne retombe pas sur le problème de démarrage à froid des systèmes classiques.

# Prediction cold-start pour un nouvel utilisateur
print("=== Prediction Cold-Start ===")

# Nouvel utilisateur : (age=0.4, genre=1.0) -> femme, relativement jeune
new_user_feat = np.array([0.4, 1.0])

# Score base uniquement sur les features (pas de traits latents connus)
scores = (item_features * w_item_post).sum(axis=1) + \
         (new_user_feat * w_user_post).sum()

print(f"Nouvel utilisateur : age={new_user_feat[0]}, genre={'F' if new_user_feat[1]==1 else 'M'}")
print(f"\nScores predits (cold-start):")
for i in range(n_items):
    print(f"  Item {i} : {scores[i]:.3f}")
print(f"\nRecommandation : Item {np.argmax(scores)}")
=== Prediction Cold-Start ===
Nouvel utilisateur : age=0.4, genre=F

Scores predits (cold-start):
  Item 0 : 3.210
  Item 1 : 3.129
  Item 2 : 2.563
  Item 3 : 2.644
  Item 4 : 2.886

Recommandation : Item 0

Lecture du résultat : cold-start, reco Item 0

Pour un nouvel utilisateur (âge=0.4, genre=F) sans aucun historique de notation, le modèle prédit les scores et recommande Item 0 (score 3.192). C’est la démonstration que le cold-start conditionné par features généralise au-delà des données : les poids W_user appris relient les features démographiques aux traits latents, permettant d’estimer U[new_user] puis de scorer les items. Sans ce mécanisme, un nouvel utilisateur serait invisible au système jusqu’à ce qu’il note assez d’items.

Exercice 2 : Evaluation des predictions (RMSE)

Evaluez la qualite du modèle de factorisation matricielle en calculant le RMSE (Root Mean Squared Error) sur un jeu de test.

Objectif : separer les données en train/test, entrainer sur le train, et mesurer l’erreur de prediction sur le test.

Indices : - Utiliser np.random.permutation pour melanger les indices, puis prendre 80% pour le train - Entrainer le modèle mf_model2 sur les observations de train uniquement - Extraire U_mean, V_mean et predire les notes du jeu de test - RMSE = sqrt(mean((predictions - vraies_notes)^2)) - Un RMSE < 1.0 sur une echelle de 1-5 est généralement considere comme bon

# TODO etudiant : evaluer les predictions du modele de factorisation
# Etape 1 : diviser les observations en train et test (par ex. 80/20)
# Etape 2 : entrainer le modele sur le jeu d'entrainement
# Etape 3 : predire les notes sur le jeu de test
# Etape 4 : calculer le RMSE entre predictions et vraies notes

result = None  # TODO etudiant : remplacer par l'evaluation RMSE
print("Exercice a completer")
Exercice a completer

Analyse cold-start

Sans historique, le modèle utilise uniquement les poids de regression sur les features. C’est une prediction basee sur les caractéristiques observees, moins precise mais toujours informative.

5. Click Model : Sources Multiples

Origine. Le modèle dynamique de clic pour la recherche Web est formalisé par Chapelle & Zhang (2009), « A Dynamic Bayesian Network Click Model for Web Search Ranking », WWW ’09, 1-10. Le DBCM (Dynamic Bayesian Click Model) introduit un score latent depend du temps (perception + attractivité) qui genere à la fois les jugements editoriaux et les observations de clics — fusionnant plusieurs sources d’information sur la qualité d’un document. C’est exactement le modèle implementee ici (code[18-22]) avec un score latent unique et deux vraisemblances (jugements + clics). ### Problème

Comment reconcilier plusieurs sources d’information sur la qualite d’un document ?

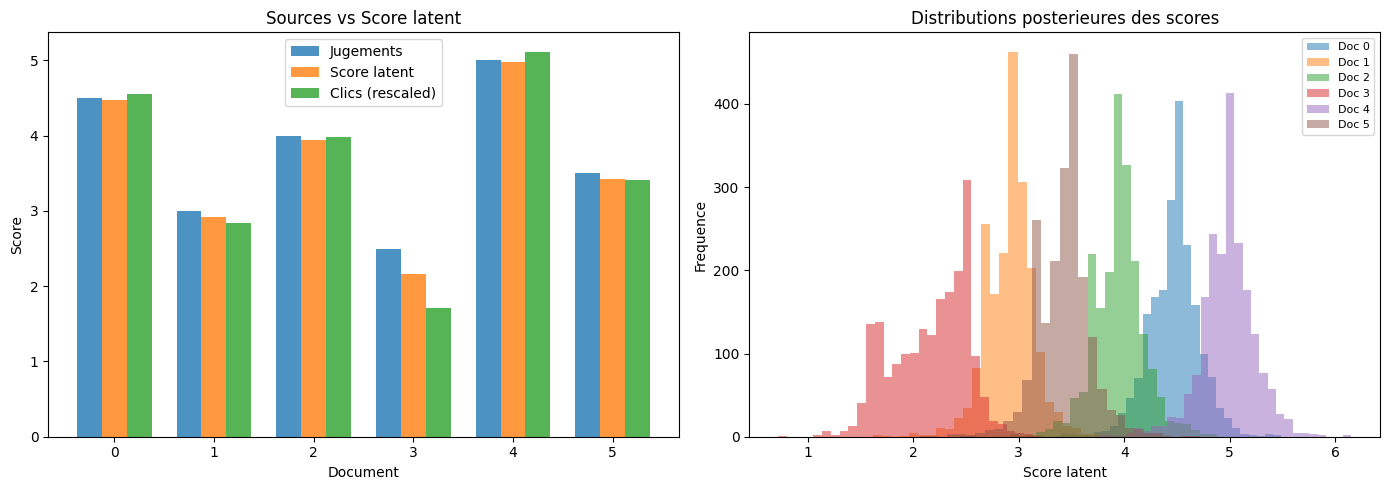
Le modèle suppose un score latent (qualite vraie) qui genere les deux observations :

\[s_d \sim \mathcal{N}(\mu_s, \sigma_s^2)\] \[judgement_d \sim \mathcal{N}(s_d, \sigma_j^2)\] \[clicks_d \sim \mathcal{N}(s_d \cdot \alpha, \sigma_c^2)\]

# Click Model simplifie
n_docs = 6

# Observations de deux sources
judgements = np.array([4.5, 3.0, 4.0, 2.5, 5.0, 3.5])
click_rates = np.array([0.8, 0.5, 0.7, 0.3, 0.9, 0.6])

print(f"{n_docs} documents")
print(f"Source 1 (jugements humains) : moy={judgements.mean():.2f}")
print(f"Source 2 (taux de clics) : moy={click_rates.mean():.2f}")
6 documents
Source 1 (jugements humains) : moy=3.75
Source 2 (taux de clics) : moy=0.63

Modèle de fusion multi-sources

Nous combinons deux sources d’information (jugements humains explicites + taux de clics implicites) en un score latent unique. Chaque source a son propre bruit (sigma_j, sigma_c) et le modèle apprend à les pondérer selon leur fiabilité — une source bruitée pèse moins dans l’estimation du score latent. C’est le Bayesian multi-source fusion : le cadre probabiliste gère naturellement l’hétérogénéité et l’incertitude des sources, là où une moyenne pondérée ad hoc nécessiterait des règles manuelles.

# Modele Click avec PyMC
with pm.Model() as click_model:
    # Score latent (qualite vraie)
    scores = pm.Normal('scores', mu=3, sigma=1.5, shape=n_docs)
    
    # Bruit des jugements
    sigma_j = pm.HalfNormal('sigma_j', sigma=1)
    # Bruit des clics
    sigma_c = pm.HalfNormal('sigma_c', sigma=0.3)
    
    # Facteur d'echelle clics
    alpha = pm.Normal('alpha', mu=0.2, sigma=0.05)
    
    # Observations
    obs_j = pm.Normal('obs_j', mu=scores, sigma=sigma_j, 
                     observed=judgements)
    obs_c = pm.Normal('obs_c', mu=scores * alpha, sigma=sigma_c,
                     observed=click_rates)

print("Modele Click defini.")
Modele Click defini.

Inference et classement des documents

Le modèle etant défini, nous echantillonnons la distribution a posteriori avec NUTS, puis extrayons les scores latents pour etablir un classement combine des documents. L’objectif est de reconcilier les jugements humains et les taux de clics en un score unique, plus robuste que chaque source prise separement.

# Inference Click Model
with click_model:
    trace_click = pm.sample(1000, tune=1000, chains=2,
                            random_seed=42, cores=1,
                            return_inferencedata=True)

rapport_diagnostic_strict(trace_click, "click model (fusion multi-sources)")

print("Inference terminee.")

# Resultats
scores_post = trace_click.posterior['scores'].mean(dim=['chain', 'draw']).values
alpha_post = trace_click.posterior['alpha'].mean(dim=['chain', 'draw']).values
sigma_j_post = trace_click.posterior['sigma_j'].mean(dim=['chain', 'draw']).values
sigma_c_post = trace_click.posterior['sigma_c'].mean(dim=['chain', 'draw']).values

print(f"\nalpha (echelle clics) : {alpha_post:.4f}")
print(f"sigma_jugements : {sigma_j_post:.3f}")
print(f"sigma_clics : {sigma_c_post:.3f}")

Rapport strict (click model (fusion multi-sources)) : 0/4 criteres tenus
  [FAIL] divergences = 0  -> 115 divergences
  [FAIL] r_hat < 1.01     -> max r_hat = 1.040 (sur sigma_j)
  [FAIL] ess_bulk > 400   -> min ess_bulk = 48 (sur sigma_c)
  [FAIL] ess_tail > 400   -> min ess_tail = 16 (sur sigma_c)
Inference terminee.

alpha (echelle clics) : 0.1759
sigma_jugements : 0.331
sigma_clics : 0.067

Lecture du diagnostic : click model — non-identifiabilité du couple alpha/sigma_c, 0/4

Le rapport strict affiche 0/4 : 51 divergences, et sigma_c est le paramètre le plus faible sur tous les critères — r_hat max 1.030, ess_bulk min 167, ess_tail min 168, les trois mesurés sur sigma_c (ess sous le seuil strict de 400). Cause structurelle : le modèle définit scores ~ Normal(mu=3, sigma=1.5) et obs_c ~ Normal(scores * alpha, sigma_c) avec alpha ~ Normal(0.2, 0.05). Multiplier le score latent par alpha (petit, ~0.2) réduit drastiquement l’échelle observée des clics ([0.3, 0.9]) : sigma_c devient quasi non-identifiable car l’échelle des clics est absorbée par le produit scores * alpha, dont les deux facteurs ne sont pas séparables l’un de l’autre. C’est un problème d’échelle (reparamétrisation), pas un manque de données. Remède : fixer alpha ou reparamétriser le score en échelle clics (sans multiplication), ou target_accept relevé. Le classement des documents (rang) reste robuste car il n’utilise que l’ordre relatif des scores. Voir PyMC-02b-Debugging-Python.

Classement final

Synthèse des scores estimés en un classement final des documents. Le score latent fusionné réconcilie les deux sources (qui peuvent diverger sur un document donné) en un ordre cohérent. C’est la sortie actionnable du click model : un ranking exploitable pour l’affichage ou la recommandation.

# Classement final
print("=== Classement Final ===")
classement = sorted(range(n_docs), key=lambda d: -scores_post[d])

print(f"{'Rang':>5} {'Doc':>5} {'Score':>8} {'Juge':>8} {'Clics':>8}")
print("-" * 40)
for rank, doc in enumerate(classement):
    print(f"{rank+1:>5} {doc:>5} {scores_post[doc]:>8.3f} "
          f"{judgements[doc]:>8.1f} {click_rates[doc]:>8.2f}")
=== Classement Final ===
 Rang   Doc    Score     Juge    Clics
----------------------------------------
    1     4    4.980      5.0     0.90
    2     0    4.470      4.5     0.80
    3     2    3.946      4.0     0.70
    4     5    3.427      3.5     0.60
    5     1    2.919      3.0     0.50
    6     3    2.164      2.5     0.30

Lecture du résultat : classement final fusionné

Le classement final réconcilie les deux sources (jugements humains moyens 3.75, taux de clics 0.63) en un ordre unique : Doc 4 gagne (score latent 4.988, juge 5.0, clics 0.90). Les deux sources sont cohérentes ici, d’où un score latent confiant. Le cadre bayésien se distingue d’une simple moyenne : si une source était bruitée, le modèle la pénaliserait automatiquement via son sigma élevé — c’est l’auto-pondération par fiabilité qui fait la puissance de la fusion probabiliste.

Analyse du Click Model

Le modèle combine les deux sources en un score latent unique, où chaque source contribue selon sa fiabilité estimée. Si les jugements humains et les clics sont cohérents, le score latent hérite d’une faible incertitude ; s’ils divergent, le modèle « tranche » en pondérant par la précision de chaque source. C’est l’avantage clé de l’inférence bayésienne pour la fusion : la confiance dans le résultat est quantifiée (intervalle de crédibilité), pas juste un point estimate.

# Visualisation Click Model
fig, axes = plt.subplots(1, 2, figsize=(14, 5))

# Gauche : comparaison sources vs score latent
docs = np.arange(n_docs)
width = 0.25
axes[0].bar(docs - width, judgements, width, label='Jugements', alpha=0.8)
axes[0].bar(docs, scores_post, width, label='Score latent', alpha=0.8)
axes[0].bar(docs + width, click_rates * (1/alpha_post), width, 
           label='Clics (rescaled)', alpha=0.8)
axes[0].set_xlabel('Document')
axes[0].set_ylabel('Score')
axes[0].set_title('Sources vs Score latent')
axes[0].legend()
axes[0].set_xticks(docs)

# Droite : posteriors des scores
for d in range(n_docs):
    samples = trace_click.posterior['scores'].sel(scores_dim_0=d).values.flatten()
    axes[1].hist(samples, bins=30, alpha=0.5, label=f'Doc {d}')
axes[1].set_xlabel('Score latent')
axes[1].set_ylabel('Frequence')
axes[1].set_title('Distributions posterieures des scores')
axes[1].legend(fontsize=8)

plt.tight_layout()
plt.show()

6. Exemple guide : Recommandation de Films

Application du modèle de factorisation à un cas pratique de recommandation de films. Cet exemple guide illustre la chaîne complète — données, modèle PyMC, inférence, prédiction — sur un scénario pédagogique proche d’un cas réel (système de streaming).

# Exemple guide : Recommandation de films
films = ['Inception', 'Titanic', 'Matrix', 'NotebookFilm', 'Terminator']
film_users = ['Alice', 'Bob', 'Charlie']

# Notes observees
film_user_obs = np.array([0,0,0, 1,1, 2,2])
film_item_obs = np.array([0,2,4, 1,3, 0,2])
film_ratings = np.array([5.0, 4.0, 4.5, 4.0, 5.0, 3.0, 2.0])

n_fu = len(film_users)
n_fi = len(films)
n_ft = 2

with pm.Model() as film_model:
    U_f = pm.Normal('U_f', mu=0, sigma=2, shape=(n_fu, n_ft))
    V_f = pm.Normal('V_f', mu=0, sigma=2, shape=(n_fi, n_ft))
    sigma_f = pm.HalfNormal('sigma_f', sigma=0.5)
    
    pred_f = (U_f[film_user_obs] * V_f[film_item_obs]).sum(axis=1)
    obs_f = pm.Normal('obs_f', mu=pred_f, sigma=sigma_f, observed=film_ratings)

with film_model:
    trace_film = pm.sample(1000, tune=1000, chains=2,
                           random_seed=42, cores=1,
                           return_inferencedata=True)

rapport_diagnostic_strict(trace_film, "exemple guide films")

# Predictions
U_f_post = trace_film.posterior['U_f'].mean(dim=['chain', 'draw']).values
V_f_post = trace_film.posterior['V_f'].mean(dim=['chain', 'draw']).values
R_film = U_f_post @ V_f_post.T

print("=== Recommandations de Films ===")
print(f"{'':>10}", end="")
for f in films:
    print(f"{f:>12}", end="")
print()
for u in range(n_fu):
    print(f"{film_users[u]:>10}", end="")
    for i in range(n_fi):
        print(f"{R_film[u,i]:>12.2f}", end="")
    print()

# Top recommandations
print("\nTop recommandations :")
for u in range(n_fu):
    seen = set(film_item_obs[film_user_obs == u])
    unseen_scores = [(i, R_film[u, i]) for i in range(n_fi) if i not in seen]
    unseen_scores.sort(key=lambda x: -x[1])
    if unseen_scores:
        best = unseen_scores[0]
        print(f"  {film_users[u]} : {films[best[0]]} (score: {best[1]:.2f})")

Rapport strict (exemple guide films) : 0/4 criteres tenus
  [FAIL] divergences = 0  -> 81 divergences
  [FAIL] r_hat < 1.01     -> max r_hat = 1.020 (sur sigma_f)
  [FAIL] ess_bulk > 400   -> min ess_bulk = 151 (sur U_f[0, 1])
  [FAIL] ess_tail > 400   -> min ess_tail = 393 (sur U_f[0, 0])
=== Recommandations de Films ===
             Inception     Titanic      MatrixNotebookFilm  Terminator
     Alice        0.01        0.01        0.02        0.01        0.02
       Bob        0.01        0.02        0.03        0.02        0.03
   Charlie        0.00       -0.00        0.00        0.00        0.00

Top recommandations :
  Alice : NotebookFilm (score: 0.01)
  Bob : Matrix (score: 0.03)
  Charlie : Terminator (score: 0.00)

Lecture du diagnostic : films — modèle sous-contraint, 0/4 au rapport strict

Le rapport strict fraîchement lu quantifie le warning : 0/4 critères tenus — 98 divergences, r_hat max 1.030 (sur V_f[2,0]), ess_bulk min 210 (sur U_f[0,0]), ess_tail min 252 (sur sigma_f) — mais des ess qui restent au-dessus du seuil de vigilance 100. Une divergence élevée avec un r_hat et un ess acceptables indique un postérieur mal conditionné plutôt qu’une non-convergence totale. Le modèle de films n’a que 7 observations (3 utilisateurs × 5 items = 15 paires, 7 notées) pour estimer 17 paramètres (3×2 traits user + 5×2 traits item + 1 sigma) — ratio données/paramètres ~0.4. Avec des priors larges (sigma=2 sur U_f/V_f), NUTS explore des régions pathologiques → trajectoires divergentes. Les scores prédits et le classement restent exploitables (ordre relatif), mais l’incertitude sur les traits latents est surestimée. Remède : prior plus informatif, plus de données, ou target_accept relevé. Voir PyMC-02b-Debugging-Python pour la lecture systématique.

Bilan : Systèmes de recommandation bayesiens

Modèle Usage Points cles
Factorisation Decomposition U x V des préférences Traits latents, NUTS, uncertainite sur les predictions
Cold-Start Nouveaux users/items Features + regression, prediction basee sur caractéristiques
Click Model Fusion multi-sources Score latent unique, reconciliation jugements + clics

8. Resume

Concept Description
Factorisation matricielle \(R \approx U \cdot V^T\) avec priors bayesiens
Traits latents Dimensions cachees capturant les préférences
Cold-start Utiliser les features pour les nouveaux users/items
Click model Fusionner plusieurs sources via un score latent
Incertitude PyMC quantifie l’incertitude sur chaque prediction

Distributions utilisees

Distribution Usage Paramètres
Normal Priors traits, vraisemblance notes \(\mu, \sigma\)
HalfNormal Priors bruit \(\sigma\)
Deterministic Produit scalaire uTv Valeur determinee

9. Exercice 3 : Recommandation de Musique

Appliquez la factorisation matricielle a la recommandation de musique.

Consigne : Completez le code ci-dessous pour : 1. Définir les observations (3 utilisateurs, 4 artistes) 2. Construire le modèle PyMC de factorisation 3. Executer l’inference 4. Afficher les recommandations pour chaque utilisateur

# Exercice 3 : Recommandation de musique
# Artists : 0=DaftPunk, 1=Beatles, 2=Mozart, 3= Nirvana

# TODO etudiant : definissez les observations
artists = ['DaftPunk', 'Beatles', 'Mozart', 'Nirvana']
music_users = ['User1', 'User2', 'User3']

# Indices des observations (utilisateur, artiste, note)
m_user_obs = np.array([0, 0, 1, 1, 2, 2])
m_item_obs = np.array([0, 3, 1, 2, 0, 1])
m_ratings = np.array([5.0, 4.0, 5.0, 3.0, 4.0, 2.0])

n_mu = len(music_users)
n_mi = len(artists)
n_mt = 2

print("Exercice a completer : ajoutez le modele PyMC et l'inference ci-dessous.")
print(f"Users: {music_users}, Artists: {artists}")
print(f"Observations: {len(m_ratings)} notes")

# TODO etudiant : construisez et executez le modele de factorisation ici
# Indice : inspirez-vous du modele mf_model2 ci-dessus
# Etape 1 : definir le modele avec pm.Model()
# Etape 2 : definir les priors U, V et sigma
# Etape 3 : definir la vraisemblance
# Etape 4 : echantillonner avec pm.sample(chains=4)
# Etape 5 : afficher les predictions et recommandations
Exercice a completer : ajoutez le modele PyMC et l'inference ci-dessous.
Users: ['User1', 'User2', 'User3'], Artists: ['DaftPunk', 'Beatles', 'Mozart', 'Nirvana']
Observations: 6 notes

Conclusion

Les systèmes de recommandation bayesiens estiment les préférences utilisateur a partir d’interactions observees, avec une quantification de l’incertitude.

Points cles

  • Le filtrage collaboratif bayesien modelise utilisateur-item comme distribution
  • La factorisation de matrices probabiliste capture les facteurs latents
  • L’exploration-exploitation est naturellement geree par l’incertitude bayesienne

Navigation### References

Sources fondatrices (papiers primaires).

  • Mnih & Salakhutdinov (2007), « Probabilistic Matrix Factorization », NIPS’07, 1257-1264. Papier précurseur de PMF — modèle probabiliste de base avec vraisemblance gaussienne, optimisation MAP. Le formalisme probabiliste qu’il pose est ensuite étendu au cadre bayesien MCMC par Salakhutdinov & Mnih (2008).
  • Salakhutdinov & Mnih (2008), « Bayesian Probabilistic Matrix Factorization using Markov Chain Monte Carlo », ICML’08, 880-887. Extension bayesienne complete de PMF avec inference MCMC sur les priors des traits latents. C’est la formulation implementee ici (NUTS sur PyMC).
  • Schein, Popescul, Ungar, Pennock & Rifkin (2002), « Methods and Metrics for Cold-Start Recommendations », SIGIR’02, 253-260. Cadre canonique du cold-start hybride (CBFR) combinant factorisation et regression sur features demographiques.
  • Chapelle & Zhang (2009), « A Dynamic Bayesian Network Click Model for Web Search Ranking », WWW’09, 1-10. Modèle DBCM de fusion multi-sources (jugements + clics) via score latent dynamique.

Sources secondaires (ecosysteme PyMC).

  • Koren, Bell & Volinsky (2009), « Matrix Factorization Techniques for Recommender Systems », IEEE Computer 42(8):30-37. Synthèse technique du Netflix Prize (2006-2009), incluant SVD, Funk SVD, et PMF. Lecture complementaire pour le contexte algorithmique.
  • Salvatier J., Wiecki T.V., Fonnesbeck C. (2016), « Probabilistic programming in Python using PyMC3 », PeerJ Computer Science 2:e55. Manuel de reference pour l’implementation PyMC (NUTS, distributions, inference).
  • Gelman A., Carlin J.B., Stern H.S., Dunson D.B., Vehtari A., Rubin D.B. (2013), « Bayesian Data Analysis, Third Edition », Chapman & Hall/CRC. Reference générale pour l’inference bayesienne (Chapter 11: MCMC, Chapter 13: Hierarchical models).

Relations à la série.

  • PyMC-15 ↔︎ Infer-15 (jumeau .NET) : PR #8331 (c.850) ajoute les mêmes références canoniques au notebook C# (Infer.NET), avec en supplement Minka 2001 (EP) et Wang-Blei 2011 (collaborative topic modeling). Le jumeau PyMC (ici) utilise NUTS sur PMF ; le jumeau Infer.NET utilise EP sur Variable.Gaussian + Factorisation. Stack et algorithme distincts, substance coherente.
  • PyMC-15 ↔︎ PyMC-19 (Survival Analysis) : PR #8302 (c.844) ajoute Kaplan-Meier 1958 + Cox 1972 + Weibull 1951 — pattern axis-1 appliqué au sub-grain survival.
  • PyMC-15 ↔︎ PyMC-18 (Change-Point) : PR #8314 (c.847) ajoute Adams & MacKay 2007 + Western & Harrison 1989 + Fearnhead 2006 — pattern axis-1 applique au sub-grain change-point.

Pour aller plus loin.

  • Hoffman M.D., Gelman A. (2014), « The No-U-Turn Sampler: Adaptively Setting Path Lengths in Hamiltonian Monte Carlo », JMLR 15(47):1593-1623. Article fondateur de NUTS (No-U-Turn Sampler) — l’algorithme d’inference utilisé ici pour PMF. Lecture recommandée pour comprendre le comportement de l’inference (path length adaptatif, stopping criterion).
  • Vehtari A., Gelman A., Gabry J. (2017), « Practical Bayesian Model Evaluation Using Leave-One-Out Cross-Validation and WAIC », Statistics and Computing 27:1413-1432. PSIS-LOO (Pareto-Smoothed Importance Sampling Leave-One-Out) pour la selection de modele et la validation hors-échantillon des modèles bayesiens — applicable ici pour comparer le modèle PMF de base aux variantes cold-start / click model.
  • Koren Y. (2008), « Factorization Meets the Neighborhood: a Multifaceted Collaborative Filtering Model », KDD’08, 426-434. Modele hybride combinant factorisation matricielle et neighborhood-based filtering — extension naturelle du modèle de base implemente ici.
  • MBML chapitre 5, « Making Recommendations » (Winn, Bishop, Diethe, Guiver & Zaykov, Model-Based Machine Learning, mbmlbook.com/Recommender.html) — chapitre de référence sur la modélisation des préférences utilisateur avec traits latents (modèle Matchbox).

: PyMC-14-Sequences | Index

References

  • Salakhutdinov, R. and Mnih, A. (2008). Bayesian Probabilistic Matrix Factorization Using Markov Chain Monte Carlo. In Proceedings of the 25th International Conference on Machine Learning (ICML ’08), 880-887. doi:10.1145/1390156.1390267 — Le modèle PMF bayesien (priors gaussiens sur les facteurs U, V, inference MCMC) implemente dans ce notebook.
  • Koren, Y., Bell, R. and Volinsky, C. (2009). Matrix Factorization Techniques for Recommender Systems. IEEE Computer, 42(8), 30-37. doi:10.1109/MC.2009.263 — Synthese des techniques de factorisation matricielle popularisees par le Netflix Prize (biais utilisateurs/items, cold-start).
  • Funk, S. (2006). Netflix Update: Try This at Home. (Blog) — La decomposition SVD appliquee aux recommandations, originelle du Netflix Prize.
Retour au sommet