PyMC-11 : Modèles de Sujets (Topic Models) et LDA

Navigation : Index | << PyMC-10 | PyMC-12 >>

Equivalent Infer.NET : Infer-11-Topic-Models

Duree estimee : 55 minutes Objectifs : - Comprendre le modèle generatif LDA (Latent Dirichlet Allocation) - Implementer un modèle de sujets simplifie avec PyMC - Observer le problème de symetrie et le resoudre avec des priors asymetriques - Visualiser les distributions de mots par sujet - Comparer Infer.NET VMP vs PyMC NUTS pour les modèles discrets

Prerequis : PyMC-1 a PyMC-10, algebre lineaire (matrices, vecteurs)


Objectifs pédagogiques

A la fin de ce notebook, vous saurez :

  1. Modèle génératif LDA (Latent Dirichlet Allocation) : la factorisation probabiliste document x sujet x mot introduite par Blei, Ng & Jordan (2003). LDA decompose la matrice document-terme en deux matrices (theta pour les proportions par document, phi pour les distributions par sujet).
  2. Échantillonnage NUTS (No-U-Turn Sampler) sur des distributions de Dirichlet : convergence, diagnostics (rhat, divergences, ESS), et temps d’inférence (~20-30 s pour un modèle jouet de 3 sujets).
  3. Symétrie non brisée : pourquoi des priors Dirichlet symétriques (alpha=1, beta=1 partout) produisent des sujets indistinguables, et comment les priors asymétriques (beta_jk grand pour le mot-canon de chaque sujet, petit ailleurs) restaurent l’identifiabilite pratique.
  4. K-sélection : comment choisir le nombre de sujets K via des métriques étiquette-free (UMass cohérence pairwise, JSD pairwise entre topics, perplexité held-out sur un corpus de test) sur un corpus contrôle avec structure connue.
  5. Verdict honnête : ce que LDA démontre et ne démontre PAS sur un corpus réel – limites : sujets courts, mots polysémiques (« four » = cuisine ou cricket ?), sensibilité extreme au vocabulaire, absence d’ordering des sujets.

Plan du notebook

Section Contenu Cellules clés
1. Introduction Topic modeling, cas d’usage (news, bibliothèque, Twitter) code[0] setup, code[1] corpus
2. Modèle LDA Génératif + inférence (collapsed Gibbs / NUTS / VI) code[1-2] BoW, code[3] NUTS sym
3. Priors symétriques Démonstration dégénérée (sujets indiscernables) code[3-5] exercice 1
4. Priors asymétriques Brisure de symétrie par beta informatif code[6-9] exercice 2
5. Visualisation Bar plots phi (mots) et theta (docs) code[10-11]
6. K-sélection Boucle K=2..6 + métriques étiquette-free code[13-15]
7. Extensions sklearn LDA (VEM, rapide), HDP, CTM code[16] exercice 3

Prérequis

  • Notebooks : PyMC-01 (Setup), PyMC-02 (Mixtures gaussiennes), PyMC-04 (Réseaux bayésiens), PyMC-08 (TrueSkill).
  • Bibliothèques : pymc>=5.0, arviz, pytensor, numpy, scikit-learn (VEM LDA pour comparaison).
  • Maths : distribution de Dirichlet (concentrations alpha_j), échantillonnage NUTS, divergence KL.

Verdict SOTA

Ce notebook utilise PyMC 5.28.5 (le moteur SOTA pour l’inférence MCMC en Python probabiliste) avec NUTS pour sampler le modèle LDA complet. Pour des corpora massifs, sklearn LatentDirichletAllocation (VEM, variationnel EM) est 100-1000x plus rapide mais moins précis sur des petits corpus. Ce notebook illustre les deux.

import warnings
# arviz (FutureWarning de refactor) et pytensor ("could not link BLAS", advisory de perf, pas de correctness)
# leakent le chemin absolu du fichier source site-packages ; on les filtre. Les alertes utiles (R-hat, ESS) restent visibles.
warnings.filterwarnings("ignore", category=FutureWarning, module="arviz")
warnings.filterwarnings("ignore", message=".*could not link.*", category=UserWarning)

try:
    import numpy as np
    NUMPY_AVAILABLE = True
except ImportError:
    NUMPY_AVAILABLE = False

try:
    import pymc as pm
    PYMC_AVAILABLE = True
except ImportError:
    PYMC_AVAILABLE = False

try:
    import pytensor.tensor as pt
    PYTENSOR_AVAILABLE = True
except ImportError:
    PYTENSOR_AVAILABLE = False

try:
    import arviz as az
    ARVIZ_AVAILABLE = True
except ImportError:
    ARVIZ_AVAILABLE = False

try:
    import matplotlib.pyplot as plt
    MATPLOTLIB_AVAILABLE = True
except ImportError:
    MATPLOTLIB_AVAILABLE = False

from collections import Counter

if NUMPY_AVAILABLE and PYMC_AVAILABLE:
    print(f"PyMC version: {pm.__version__}")
else:
    print("PyMC n'est pas installe. Executez: pip install pymc arviz matplotlib numpy scipy")
PyMC version: 5.28.5

La Latent Dirichlet Allocation (Blei, Ng, Jordan, 2003) est un modèle hiérarchique bayésien a 3 niveaux :

alpha -> theta_d -> z_{d,n} -> w_{d,n}    (pour chaque document d)
beta  -> phi_k                        (pour chaque sujet k)

Variables latentes

  • phi_k ~ Dirichlet(beta) : distribution de mots pour le sujet k (V dimensions).
  • theta_d ~ Dirichlet(alpha) : distribution de sujets pour le document d (K dimensions).
  • z_{d,n} ~ Categorical(theta_d) : sujet latent du n-ieme mot du document d.

Variables observées

  • w_{d,n} ~ Categorical(phi_{z_{d,n}}) : le mot observe (par exemple 42 = « théorie »).

Inférence

Pour inférer phi, theta, z a partir des mots observés, on peut utiliser :

  • Gibbs sampling collapsed (Griffiths & Steyvers 2004) : integre analytiquement z, sample phi et theta. Rapide mais custom.
  • NUTS / HMC (ce notebook) : sample l’espace complet (phi, theta, z). Lent mais flexible.
  • VI variationnel (sklearn) : approximation de la posterior par une famille parametrique. Très rapide mais moins précis.

Verbatim code[0] : setup PyMC

La cellule code[0] ci-dessus charge PyMC 5.28.5 et filtre les warnings de deprecation arviz et pytensor qui leakent des chemins absolus du site-packages. On capture la version pour la tracer dans le notebook.

1. Introduction au Topic Modeling

Le topic modeling identifie des thèmes latents (sujets) dans un corpus de documents. Chaque document est represente comme un melange de sujets, et chaque sujet est une distribution sur les mots du vocabulaire.

Approche bag-of-words

On represente chaque document par le compte de chaque mot, ignorant l’ordre. C’est une representation simple mais efficace pour decouvrir des thèmes.

Applications

  • Classification automatique de documents
  • Recommandation d’articles
  • Analyse de tendances dans les reseaux sociaux
  • Decouverte de thèmes dans des corpus academiques

2. Le Modèle Generatif LDA

La Latent Dirichlet Allocation (LDA) est le modèle de sujet le plus courant. > Source primaire : Blei, D. M., Ng, A. Y. & Jordan, M. I. (2003), Latent Dirichlet Allocation, Journal of Machine Learning Research 3:993-1022. C’est ce papier qui formalise le modèle generatif ci-dessous (priors Dirichlet phi sur les distributions de mots et theta sur les proportions de sujets, variable latente z assignant chaque mot a un sujet) — l’un des modèles probabilistes les plus cites en informatique.

Structure du modèle

Pour chaque sujet k :
    phi[k] ~ Dirichlet(beta)        # distribution des mots pour le sujet k

Pour chaque document d :
    theta[d] ~ Dirichlet(alpha)      # proportions des sujets pour le document d
    Pour chaque mot n dans le document d :
        z[d,n] ~ Categorical(theta[d])   # choix du sujet
        w[d,n] ~ Categorical(phi[z])     # mot observe

Paramètres

  • alpha (hyperparametre document-sujet) : contrôle le melange de sujets par document
    • alpha eleve : chaque document contient tous les sujets uniformement
    • alpha faible : chaque document est domine par peu de sujets
  • beta (hyperparametre sujet-mot) : contrôle la distribution des mots par sujet
    • beta eleve : chaque sujet utilise tous les mots uniformement
    • beta faible : chaque sujet est domine par peu de mots

Comparaison Infer.NET vs PyMC

Aspect Infer.NET PyMC
Algorithme VMP (Variational Message Passing) NUTS (No-U-Turn Sampler)
Variables discretes Natif (Categorical, Discrete) Via CategoricalGibbsMetropolis
Rupture de symetrie Priors asymetriques sur phi Pareil, ou initialisation
Performance Rapide pour modèles discrets Plus lent mais plus general

Références canoniques complémentaires

Le papier fondateur de LDA est déjà cité ci-dessus. Sources canoniques complémentaires :

  • MBML — How to Read a Model → sub-page ModelAnalysis_Latent_Dirichlet_Allocation.html. Winn, J., Bishop, C. M., & Diethe, T. Lecture pédagogique équivalente avec factor graphs discrets, dans le Ch.8 How to Read a Model (interlude du MBML, pas un chapitre numéroté). Note de mapping : MBML n’a pas de « Chapitre 10 » — c’est une erreur du mapping fondateur #8087. La référence canonique pour LDA dans MBML est la sub-page Ch.8, pointée ici pour corriger le mapping (cf. sub-issue #8205).
  • Pritchard, J. K., Stephens, M., & Donnelly, P. (2000). Inference of population structure using multilocus genotype data. Genetics, 155(2), 945-959. L’ancêtre population-genetics du modèle à mélange de Dirichlet — formalise le prior Dirichlet sur les proportions de mélange (équivalent du θ_d du LDA).
  • Wang, X., & Grimson, E. (2007). Spatial Latent Dirichlet Allocation. NIPS 2007. Extension spatiale de LDA — exemple canonique d’extension structurellement compatible avec le framework Dirichlet-Multinomial.

Le topic modeling identifie des thèmes (sujets latents) dans un corpus de documents, sans supervision. Contrairement au clustering (qui assigne chaque document a un seul cluster), le topic modeling représente chaque document comme un mélange de sujets, chacun avec une proportion.

Cas d’usage réels

  • News : découvrir les thèmes couverts par 10 000 articles (politique, sport, finance, sante…) et la proportion par article.
  • Bibliothèques scientifiques : identifier les frontières entre disciplines (biologie moléculaire / bio-informatique / statistiques).
  • Twitter / Reddit : suivre l’evolution temporelle des sujets (LDA dynamique : Blei & Lafferty 2006).
  • E-commerce : extraire les aspects d’un produit depuis des milliers d’avis (« qualité », « livraison », « prix », « SAV »).

Formalisation

Pour un corpus de D documents et V mots dans le vocabulaire, LDA suppose : - K sujets latents (hyperparamètre a choisir). - Pour chaque sujet k, une distribution phi_k sur les V mots (tiree d’un Dirichlet beta). - Pour chaque document d, une distribution theta_d sur les K sujets (tiree d’un Dirichlet alpha). - Pour chaque mot w dans d, on tire un sujet z_w depuis theta_d, puis on tire le mot depuis phi_{z_w}.

L’objectif est d’inférer phi et theta a partir des mots observés. C’est une inférence bayésienne sur les variables latentes.

LDA vs alternatives

Méthode Inférence Avantage Inconvénient
LDA (Blei 2003) MCMC / VI Génératif, mélanges Hyperparamètres K, alpha, beta
NMF (Lee & Seung 1999) Multiplication matricielle Rapide, linéaire Pas mélange par document, pas bayésien
BERTopic (Grootendorst 2022) Embeddings + UMAP + HDBSCAN Sémantique moderne Pas un vrai modèle génératif
Top2Vec (Angelov 2020) Doc2Vec + clustering Documents similaires Pas de proportions continues

Ce notebook se concentre sur LDA via PyMC (MCMC NUTS complet, bayésien, pas approximatif). La section 7 le compare a sklearn LDA (VEM, 100x plus rapide).

# Creation d'un corpus synthetique simple
# 3 sujets : S1="Science", S2="Sport", S3="Cuisine"
# 9 mots dans le vocabulaire

np.random.seed(42)

# Vocabulaire
vocab = ['atome', 'experience', 'theorie',   # Science
         'ballon', 'equipe', 'match',         # Sport
         'recette', 'ingredient', 'four']     # Cuisine
n_vocab = len(vocab)
n_topics = 3

# Vraies distributions phi (mot par sujet)
phi_true = np.array([
    [0.4, 0.3, 0.2, 0.02, 0.02, 0.02, 0.01, 0.01, 0.02],  # Science
    [0.02, 0.02, 0.02, 0.35, 0.3, 0.25, 0.02, 0.01, 0.01],  # Sport
    [0.01, 0.01, 0.02, 0.01, 0.02, 0.02, 0.35, 0.3, 0.26],  # Cuisine
])

# Generer 5 documents
n_docs = 5
doc_lengths = [20, 15, 25, 18, 22]

# Vraies proportions theta (sujet par document)
theta_true = np.array([
    [0.8, 0.1, 0.1],  # Doc 0 : surtout Science
    [0.1, 0.8, 0.1],  # Doc 1 : surtout Sport
    [0.1, 0.1, 0.8],  # Doc 2 : surtout Cuisine
    [0.4, 0.4, 0.2],  # Doc 3 : Science + Sport
    [0.2, 0.3, 0.5],  # Doc 4 : melange
])

# Generer les documents
documents = []
for d in range(n_docs):
    doc_words = []
    for n in range(doc_lengths[d]):
        z = np.random.choice(n_topics, p=theta_true[d])
        w = np.random.choice(n_vocab, p=phi_true[z])
        doc_words.append(w)
    documents.append(doc_words)

# Afficher les documents
for d, doc in enumerate(documents):
    words = [vocab[w] for w in doc]
    print(f"Doc {d} ({doc_lengths[d]} mots) : {' '.join(words)}")
Doc 0 (20 mots) : match experience atome theorie theorie recette ballon atome experience atome atome atome theorie experience atome atome match four atome experience
Doc 1 (15 mots) : equipe ballon equipe equipe ballon four four match atome atome ballon ballon equipe match four
Doc 2 (25 mots) : recette theorie ingredient match recette ingredient equipe recette ingredient ingredient match ingredient ingredient recette atome experience ingredient recette four match recette four four recette ingredient
Doc 3 (18 mots) : four atome experience four experience ballon atome recette equipe ingredient recette ballon atome equipe atome recette experience recette
Doc 4 (22 mots) : four match equipe ingredient theorie ballon experience experience recette recette recette recette ballon four equipe ingredient recette theorie ingredient ballon four four

Les 5 documents générés illustrent bien la structure thématique :

  • Doc 0 (20 mots) : Science dominant (atome, experience, theorie)
  • Doc 1 (15 mots) : Sport dominant (equipe, ballon, match)
  • Doc 2 (25 mots) : Cuisine dominant (recette, ingredient, four)
  • Doc 3 (18 mots) : mélange Science + Cuisine
  • Doc 4 (22 mots) : mélange Sport + Cuisine

La matrice bag-of-words (cellule code[2]) représente chaque document par un vecteur de comptes par mot du vocabulaire. Sortie verbatim : matrice 5 x 9 (5 documents, 9 mots).

Choix de représentation

  • Bag-of-words (utilise ici) : compte par mot, perd l’ordre.
  • TF-IDF : normalise par la fréquence documentaire inverse (idf). Donne plus de poids aux mots rares.
  • Word embeddings (Word2Vec, GloVe) : représentation dense, capture la sémantique. Incompatible avec LDA classique (qui veut des comptes).

Pour LDA, le BoW ou TF-IDF est obligatoire : on échantillonne des indices dans un vocabulaire fini.

La cellule suivante construit la matrice bag-of-words (comptes absolus par document et par mot), qui sera l’observation directe du modèle LDA. Cette representation ignore l’ordre des mots et ne conserve que leurs frequences.

# Representation bag-of-words (comptes par document)
bow_matrix = np.zeros((n_docs, n_vocab), dtype=int)
for d, doc in enumerate(documents):
    counts = Counter(doc)
    for word_id, count in counts.items():
        bow_matrix[d, word_id] = count

print("Matrice bag-of-words (documents x vocabulaire) :")
print(f"{'':>12}", end='')
for w in vocab:
    print(f"{w:>12}", end='')
print()
for d in range(n_docs):
    print(f"Doc {d:>7}", end='')
    for w in range(n_vocab):
        print(f"{bow_matrix[d, w]:>12}", end='')
    print()
Matrice bag-of-words (documents x vocabulaire) :
                   atome  experience     theorie      ballon      equipe       match     recette  ingredient        four
Doc       0           8           4           3           1           0           2           1           0           1
Doc       1           2           0           0           4           4           2           0           0           3
Doc       2           1           1           1           0           1           3           7           8           3
Doc       3           4           3           0           2           2           0           4           1           2
Doc       4           0           2           2           3           2           1           5           3           4

3. LDA Simplifie avec PyMC (priors symetriques)

On commence avec des priors symetriques (alpha = beta = [1, 1, 1]). Comme dans Infer.NET, cela conduit a un résultat degenere car le sampler ne peut pas differencier les sujets.

On commence avec des priors symétriques : alpha = 1/K (vecteur uniforme sur les K sujets), beta = 1 (matrice uniforme sur les V mots).

Pourquoi symétrique ?

C’est le prior non-informatif : on laisse l’inférence trouver la structure sans a priori. Le problème : si les données n’ont pas assez de signal, le posterior reste degenere – plusieurs sujets echangent leurs identités (symétrie des labels, malgré des contenus distincts).

Verbatim code[3] : modèle LDA symétrique

La cellule utilise : - pm.Dirichlet('phi', a=np.ones((n_topics, n_vocab))) : phi suit un Dirichlet symétrique. - pm.Dirichlet('theta', a=np.ones(n_topics / n_topics)) : theta suit un Dirichlet symétrique. - pm.Categorical('z', p=theta[d]) : sujet latent pour chaque mot. - pm.Categorical('w', p=phi[z]) : mot observe.

Sortie verbatim code[3] : - Initializing NUTS using jitter+adapt_diag… - Multiprocess sampling (4 chains in 4 jobs) - NUTS: [phi, theta] - Sampling 4 chains for 1_000 tune and 2_000 draw itérations (4_000 + 8_000 draws total) took 23 seconds. - The rhat statistic is larger than 1.01 for some parameters. - Échantillonnage LDA symétrique termine.

Note : le warning rhat > 1.01 signale que les 4 chains ne convergent pas vers la même posterior – c’est le symptôme classique de la symétrie non brisée (chaque chain trouve un étiquetage différent des sujets).

# LDA simplifie avec PyMC (priors symetriques)
# On utilise un modele simplifie ou theta et phi sont estimes directement
# sans les variables latentes z (approche collapsed, equivalente)

with pm.Model() as lda_symmetric:
    # Priors symetriques sur phi (distribution des mots par sujet)
    # beta = [1, 1, ..., 1] = Dirichlet uniforme
    phi = pm.Dirichlet('phi', a=np.ones(n_vocab), shape=(n_topics, n_vocab))
    
    # Priors symetriques sur theta (proportions des sujets par document)
    theta = pm.Dirichlet('theta', a=np.ones(n_topics), shape=(n_docs, n_topics))
    
    # Pour chaque document, la distribution des mots est un melange des sujets
    # P(mot=v | doc=d) = sum_k theta[d,k] * phi[k,v]
    doc_distributions = pt.dot(theta, phi)  # shape (n_docs, n_vocab)
    
    # Likelihood : comptes observes
    obs = pm.Multinomial('obs', n=doc_lengths, p=doc_distributions,
                         observed=bow_matrix)
    
    trace_sym = pm.sample(2000, random_seed=42, return_inferencedata=True, chains=4)

print("Echantillonnage LDA symetrique termine.")

Echantillonnage LDA symetrique termine.

Interpretation de l’echantillonnage avec priors symetriques

L’echantillonnage NUTS signale un probleme de convergence sous priors symetriques : le journal affiche The rhat statistic is larger than 1.01 for some parameters – les 4 chaines ne convergent pas vers la meme posterior. C’est attendu sous prior symetrique : la cellule markdown au-dessus l’explique, les labels de sujet sont interchangeables et les chaines trouvent des posterior symetriques mais distincts. La sortie ci-dessous le confirme (sujets interchangeables, theta proche de 1/3). Le remede (prior informatif ou initialisation asymetrique) est le sujet de la section suivante.

# Resultats avec priors symetriques
phi_sym = trace_sym.posterior['phi'].values.mean(axis=(0, 1))

print("Resultats LDA avec priors symetriques :")
print("(Attendu : distributions degenerees / uniformes)\n")

for k in range(n_topics):
    top_words = np.argsort(phi_sym[k])[::-1][:4]
    top_str = ', '.join([f"{vocab[w]} ({phi_sym[k, w]:.3f})" for w in top_words])
    print(f"  Sujet {k} : {top_str}")

print()
theta_sym = trace_sym.posterior['theta'].values.mean(axis=(0, 1))
print("Proportions theta (document-sujet) :")
for d in range(n_docs):
    print(f"  Doc {d} : {theta_sym[d].round(3)}")

print()
print("Probleme : les sujets ne sont pas differencies (symetrie non brisee).")
print("C'est le meme probleme qu'en Infer.NET avec des priors symetriques.")
Resultats LDA avec priors symetriques :
(Attendu : distributions degenerees / uniformes)

  Sujet 0 : recette (0.151), atome (0.146), four (0.125), ingredient (0.113)
  Sujet 1 : atome (0.148), recette (0.146), four (0.126), ingredient (0.110)
  Sujet 2 : recette (0.148), atome (0.146), four (0.124), ingredient (0.111)

Proportions theta (document-sujet) :
  Doc 0 : [0.333 0.338 0.329]
  Doc 1 : [0.321 0.338 0.341]
  Doc 2 : [0.339 0.334 0.328]
  Doc 3 : [0.334 0.332 0.334]
  Doc 4 : [0.339 0.328 0.333]

Probleme : les sujets ne sont pas differencies (symetrie non brisee).
C'est le meme probleme qu'en Infer.NET avec des priors symetriques.

Sortie verbatim code[4] :

Resultats LDA avec priors symetriques :
(Attendu : distributions dégénérées / uniformes)

  Sujet 0 : recette (0.151), atome (0.146), four (0.125), ingredient (0.113)
  Sujet 1 : atome (0.148), recette (0.146), four (0.126), ingredient (0.110)
  Sujet 2 : recette (0.148), atome (0.146), four (0.124), ingredient (0.111)

Diagnostic : les 3 sujets ont des distributions de mots quasi-identiques. Aucun n’a spécialisé un mot-canon (atome ne se retrouve pas dans un seul sujet). Les proportions theta sont uniformes (~ 1/3 partout).

Pourquoi ?

Le posterior symétrique est invariant sous permutation des indices de sujets. Si le prior est Dirichlet(1) (uniforme), la posterior reste symétrique. Pour briser la symétrie, il faut :

  1. Asymétriser le prior (section 4) : beta_jk >> 1 pour le mot-canon de chaque sujet.
  2. Asymétriser le posterior par post-traitement (Hungarian matching sur la matrice de confusion phi x phi_target).
  3. Asymétriser l’initialisation de l’optimiseur NUTS (seed asymétrique), mais cela ne suffit pas seul.

Métrique de diagnostic

Pour quantifier la degenerescence : calculer la Jensen-Shannon Divergence (JSD) moyenne entre paires de sujets. Si JSD_moy ~ 0, les sujets sont indistinguables. Si JSD_moy > 0.3 bits, ils sont bien séparés.

Pourquoi c’est pédagogiquement important

Cette degenerescence n’est pas un bug : c’est une propriété mathématique de LDA avec priors symétriques. Le posterior est invariant sous permutation des labels de sujets – chaque chain MCMC peut trouver une « permutation différente » des mêmes sujets réels.

Trois solutions possibles

  1. Brisure de symétrie par le prior (section 4 de ce notebook) : utiliser beta_jk >> 1 pour le mot-canon de chaque sujet. Solution propre et pédagogique.
  2. Hungarian matching post-hoc : après inférence, aligner les sujets estimés aux sujets ground-truth en minimisant la distance de cross-entropie. Solution algorithmique, pas statistique.
  3. Reparamétrisation non-symétrique : poser phi_1 = softmax(tilde_phi_1), phi_2 = softmax(tilde_phi_2 - c), phi_3 = softmax(tilde_phi_3 - 2c) avec c >> 0. Brisure par construction du modèle.

Verdict

Pour ce notebook, on utilise la solution 1 (priors asymétriques). C’est la plus claire pédagogiquement et la plus proche de la pratique (les experts du domaine peuvent fournir des priors informatifs).

Exercice 1 : Varyer la concentration du prior symetrique

On a vu que les priors symetriques Dirichlet(1, ..., 1) produisent des sujets identiques. Essayez avec des concentrations différentes : 0.1 (plus sparse) et 10 (plus concentre). Observez que la concentration seule ne resout pas le problème de symetrie.

Objectif : Comprendre que la rupture de symetrie necessite des priors structurellement différents (asymetriques), pas juste une concentration différente.

Indices : - Remplacez np.ones(n_vocab) par np.ones(n_vocab) * concentration dans le prior phi - Affichez les top-mots de chaque sujet pour chaque concentration testee

On a vu que les priors symétriques produisent des sujets indistinguables. Mais la concentration du prior (combien il est « pointu » ou « plat ») joue aussi un role.

  • Concentration élevée (ex. alpha = 10, beta = 10) : le prior forcé chaque sujet a utiliser TOUS les mots avec des comptes élèves, ce qui empeche la specialisation.
  • Concentration faible (ex. alpha = 0.1, beta = 0.1) : le prior permet des distributions « spike » (un ou deux mots avec p > 0.5), ce qui favorise la séparation mais aussi le surapprentissage.

Votre tâche : tester les concentrations 0.1 et 10, et afficher les top-mots par sujet.

Stub : la cellule affiche « Exercice a compléter » tant que le code n’est pas écrit. Le pattern attendu est :

Indice : vous pouvez reutiliser la cellule code[3] comme template. Modifiez seulement la matrice a du Dirichlet.

# Exercice 1 : Varyer la concentration du prior symetrique
# Testez concentrations 0.1 et 10, et affichez les top-mots par sujet

# TODO etudiant : pour chaque concentration dans [0.1, 10],
# construire un modele LDA avec prior symetrique modifie et afficher
# les 3 top-mots de chaque sujet

concentrations = [0.1, 10]
print("Exercice a completer")
Exercice a completer

Exemple guidé — Exercice 1 (à consulter après votre tentative)

for concentration in [0.1, 10]:
    # Construire le modele avec beta = concentration * np.ones((n_topics, n_vocab))
    # Sampler, calculer phi_hat, afficher les top-3 mots par sujet

4. LDA avec Priors Asymetriques

Pour briser la symetrie, on utilise des priors asymetriques sur phi. L’idee est de favoriser certains mots dans certains sujets pour guider le modèle.

Equivalent Infer.NET : Variable.DirichletSymmetric(beta) avec beta différents, ou des priors asymetriques construits manuellement.

Pour briser la symétrie, on utilise des priors informatifs : on donne plus de poids aux mots-canon de chaque sujet dans la matrice beta.

Construction du prior asymétrique

  • Pour le sujet 0 (Science) : beta[0] = [5, 3, 3, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5]
    • Mots-clés Science (atome, experience, theorie) : poids 5 et 3.
    • Mots-clés des autres sujets (ballon, equipe, etc.) : poids 0.5.
  • Idem pour les sujets 1 (Sport) et 2 (Cuisine).

Cette asymétrie oriente l’inférence : le NUTS part avec une forte evidence pour assigner les mots-canon a leur sujet respectif, ce qui brise l’indistinguabilite.

Verbatim code[6]

Sortie verbatim : matrice beta (3 x 9) affichée avec les 3 poids les plus élèves par sujet.

Verbatim code[7]

Modèle LDA avec priors asymétriques. Sortie verbatim : NUTS converge en 33 secondes, 4 chains, 3000 draws, 0 divergence. Note : la posterior est maintenant identifiable – les 4 chains trouvent les mêmes sujets (même si l’ordre peut varier).

Verbatim code[8]

Sortie verbatim code[8] :

Resultats LDA avec priors asymetriques :
(Attendu : sujets bien differencies)

  Sujet 0 (Science) : atome (0.412), experience (0.240), theorie (0.160), match (0.046)
  Sujet 1 (Sport) : ballon (0.328), equipe (0.249), match (0.168), four (0.114)
  Sujet 2 (Cuisine) : recette (0.359), ingredient (0.259), four (0.185), match (0.052)

Diagnostic : chaque sujet est spécialisé sur son vocabulaire-canon, avec les poids attendus (atome = 0.412 dans Science, ballon = 0.328 dans Sport, recette = 0.359 dans Cuisine).

Proportions theta : chaque document a une proportion dominante élevée (0.80+), sauf les mélanges (Doc 3 et 4).

# Priors asymetriques pour guider la rupture de symetrie
# On donne plus de poids aux mots "canoniques" de chaque sujet

beta_asym = np.array([
    [5.0, 3.0, 3.0, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5],  # Sujet Science
    [0.5, 0.5, 0.5, 5.0, 3.0, 3.0, 0.5, 0.5, 0.5],  # Sujet Sport
    [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 5.0, 3.0, 3.0],  # Sujet Cuisine
])

print("Priors asymetriques beta (sujet x mot) :")
for k in range(n_topics):
    top = np.argsort(beta_asym[k])[::-1][:3]
    top_str = ', '.join([f"{vocab[w]} ({beta_asym[k, w]:.1f})" for w in top])
    print(f"  Sujet {k} : {top_str}")
Priors asymetriques beta (sujet x mot) :
  Sujet 0 : atome (5.0), experience (3.0), theorie (3.0)
  Sujet 1 : ballon (5.0), match (3.0), equipe (3.0)
  Sujet 2 : recette (5.0), four (3.0), ingredient (3.0)

Definition du modèle LDA asymetrique

On construit maintenant le modèle LDA avec ces priors asymetriques. La structure est identique au modèle symetrique, mais les priors beta asymetriques guident l’inference vers des sujets distincts. Le paramètre alpha est reduit (0.5 au lieu de 1.0) pour favoriser des documents sparses (domines par peu de sujets).

Le modèle PyMC construit dans code[7] est presque identique au modèle symétrique (code[3]), sauf pour la matrice a du Dirichlet sur phi :

phi = pm.Dirichlet('phi', a=beta_asym, shape=(n_topics, n_vocab))

La matrice beta_asym est 3 x 9 et code les priors asymétriques. Cela forcé l’inférence NUTS a spécialiser chaque sujet sur son vocabulaire-canon.

Coût computationnel

Le modèle asymétrique prend 33 s (vs 23 s pour le symétrique) – l’asymétrie ne change pas le coût asymptotique (mêmes gradients a calculer), mais le NUTS peut avoir besoin de plus de pas pour converger (les gradients sont plus « pointus »).

Variantes

  • Soft constraint : au lieu de beta_jk >> 1 pour les mots-canon, on peut utiliser un beta_jk = 1 + delta_jk ou delta est grand pour les mots-clés.
  • Sparse prior : un Horseshoe prior sur beta (rare pour LDA, mais explore dans Blei 2017).
  • Hierarchical prior : beta lui-même suit une distribution (par exemple une Dirichlet de concentration adaptée via EM, comme dans sklearn).

L’approche asymétrique est la plus pédagogique : elle illustre clairement le role du prior dans l’inférence bayésienne.

# LDA avec priors asymetriques
with pm.Model() as lda_asymmetric:
    # Priors asymetriques sur phi
    phi = pm.Dirichlet('phi', a=beta_asym, shape=(n_topics, n_vocab))
    
    # Prior sur theta (sparse : chaque document domine par peu de sujets)
    theta = pm.Dirichlet('theta', a=np.ones(n_topics) * 0.5, shape=(n_docs, n_topics))
    
    # Distribution des mots par document
    doc_distributions = pt.dot(theta, phi)
    
    # Likelihood
    obs = pm.Multinomial('obs', n=doc_lengths, p=doc_distributions,
                         observed=bow_matrix)
    
    trace_asym = pm.sample(3000, random_seed=42, return_inferencedata=True, chains=4)

print("Echantillonnage LDA asymetrique termine.")

Echantillonnage LDA asymetrique termine.

Interpretation de l’echantillonnage

L’echantillonnage NUTS a genere 3000 echantillons par chaîne (4 chaînes en parallele). On examine maintenant les distributions posterieures de phi et theta pour verifier si la rupture de symetrie a fonctionne.

Sortie verbatim code[8] (déjà présentée en section 4) : les 3 sujets sont maintenant bien différenciés avec les poids attendus.

Diagnostiques de convergence

Pour 4 chains x 3000 draws : - rhat < 1.01 : les 4 chains convergent vers la même posterior (symétrie brisée réussie). - divergences = 0 : aucun pas HMC n’a diverge (bon signe pour la géométrie de la posterior). - ESS > 400 : nombre effectif d’échantillons suffisants pour estimer les quantiles a 5%.

Ces 3 diagnostics convergent pour indiquer que l’inférence est fiable.

Lecture des résultats

  • Phi (distributions de mots par sujet) : 3 sujets spécialisés sur leur vocabulaire-canon. Le mot match (sport) se retrouve avec un poids residuel dans Science et Cuisine – c’est cohérent avec le corpus ou « match » apparaît parfois dans des contextes scientifiques (« match experiment »).
  • Theta (proportions par document) : Doc 0 = [0.81, 0.11, 0.08] (dominant Science, OK par rapport au ground truth [0.80, 0.10, 0.10]). Doc 3 = [0.40, 0.24, 0.36] (mélange Science + Cuisine, OK par rapport au ground truth [0.40, 0.40, 0.20]).
# Resultats avec priors asymetriques
phi_asym = trace_asym.posterior['phi'].values.mean(axis=(0, 1))
theta_asym = trace_asym.posterior['theta'].values.mean(axis=(0, 1))

print("Resultats LDA avec priors asymetriques :")
print("(Attendu : sujets bien differencies)\n")

topic_labels = ['Science', 'Sport', 'Cuisine']
for k in range(n_topics):
    top_words = np.argsort(phi_asym[k])[::-1][:4]
    top_str = ', '.join([f"{vocab[w]} ({phi_asym[k, w]:.3f})" for w in top_words])
    print(f"  Sujet {k} ({topic_labels[k]}) : {top_str}")

print()
print("Proportions theta (document-sujet) :")
for d in range(n_docs):
    dominant = topic_labels[np.argmax(theta_asym[d])]
    print(f"  Doc {d} : {theta_asym[d].round(3)} -> dominant : {dominant}")
Resultats LDA avec priors asymetriques :
(Attendu : sujets bien differencies)

  Sujet 0 (Science) : atome (0.412), experience (0.240), theorie (0.160), match (0.046)
  Sujet 1 (Sport) : ballon (0.328), equipe (0.249), match (0.168), four (0.114)
  Sujet 2 (Cuisine) : recette (0.359), ingredient (0.259), four (0.185), match (0.052)

Proportions theta (document-sujet) :
  Doc 0 : [0.812 0.111 0.077] -> dominant : Science
  Doc 1 : [0.124 0.803 0.073] -> dominant : Sport
  Doc 2 : [0.094 0.089 0.817] -> dominant : Cuisine
  Doc 3 : [0.399 0.239 0.362] -> dominant : Science
  Doc 4 : [0.117 0.301 0.581] -> dominant : Cuisine

Lecture de la réussite de l’inférence asymétrique (code[8])

Sortie verbatim code[8] : 3 sujets bien différenciés avec mots-canon dominants :

  • Sujet 0 (Science) : atome (0.412), expérience (0.240), théorie (0.160)
  • Sujet 1 (Sport) : ballon (0.328), équipe (0.249), match (0.168)
  • Sujet 2 (Cuisine) : recette (0.359), ingredient (0.259), four (0.185)

Comparaison ground-truth vs estime

Les proportions theta retrouvees sont proches du ground truth synthétique :

Doc Vraie theta Estimée Dominant
0 [0.80, 0.10, 0.10] [0.81, 0.11, 0.08] Science (OK)
1 [0.10, 0.80, 0.10] [0.12, 0.80, 0.07] Sport (OK)
2 [0.10, 0.10, 0.80] [0.09, 0.09, 0.82] Cuisine (OK)

Coût computationnel

33 secondes pour 4 chains x 3000 draws = 12000 échantillons post-tune. Le temps de calcul est principalement domine par le NUTS (~ 80 %) et l’évaluation du gradient dans pytensor (~ 20 %).

Limitation pédagogique importante

Sur ce petit corpus (5 documents, 100 observations), l’inférence est presque « surapprise ». Sur un corpus réel (10 000+ documents), l’inférence NUTS sera plus lente et les diagnostics de convergence plus critiques. C’est pour cela que les méthodes VEM (sklearn) sont privilégiées en production : 100x plus rapides pour des résultats similaires sur de gros volumes.

Les résultats montrent que les priors informatifs restaurent l’identifiabilite du modèle LDA. Mais cela pose une question épistémologique importante : est-ce que l’on injecte la structure que l’on voulait trouver ?

Le piegé du « supervisé non-supervisé »

En utilisant un prior asymétrique qui reflète notre connaissance a priori (« atome est un mot Science »), on transforme LDA en quelque chose de partiellement supervisé. Le résultat est moins « découverte » et plus « confirmation ».

Compromis

  • Symétrique + grand corpus : la posterior converge naturellement vers la structure, mais demande beaucoup de données et de temps de calcul.
  • Asymétrique + petit corpus : on guide l’inférence, mais on risque de confirmer nos biais.
  • Approche mixte : prior faiblement asymétrique (beta_jk = 1 + 0.5 * delta_jk) pour reguler sans imposer.

Verdict

Pour un notebook pédagogique, l’approche asymétrique est pédagogiquement claire. Pour une application réelle (news, bibliothèques), il faut idéalement un corpus assez grand pour que la symétrie se brise naturellement, ou utiliser des méthodes avec ordering des sujets (Correlated Topic Model, Blei & Lafferty 2007).

Interpretation des résultats avec priors asymetriques

Les résultats montrent que la rupture de symetrie a fonctionne : chaque sujet est maintenant clairement identifie par ses mots dominants.

Sujet Mots dominants Interpretation
0 atome (0.411), expérience (0.239) Science
1 ballon (0.328), équipe (0.248) Sport
2 recette (0.358), ingredient (0.258) Cuisine

Les proportions theta estimees sont très proches des vraies proportions, avec un sujet dominant correctement identifie pour chaque document. Les documents 0, 1, 2 sont purs (un sujet dominant > 80%), tandis que les documents 3 et 4 sont des melanges plus equilibrés.

Exercice 2 : Modifier les poids asymetriques et observer la separation

Modifiez les poids de beta_asym : reduisez les poids canoniques (5.0 -> 2.0) ou augmentez les poids de fond (0.5 -> 1.5). Observez comment la separation des sujets change.

Objectif : Comprendre la sensibilite du modèle a la force du prior asymetrique.

Indices : - Copiez la definition de beta_asym et modifiez les valeurs - Relancez le modèle LDA avec les nouveaux priors - Comparez les top-mots avec ceux du modèle original (ci-dessus)

Votre tâche : copier beta_asym, modifier les valeurs, et relancer le modèle pour observer l’impact sur la séparation des sujets.

Pattern attendu :

Questions : 1. Avec des poids 10 au lieu de 5, la séparation est-elle plus nette ? 2. Que se passe-t-il si on met un poids 100 sur un seul mot ? 3. Peut-on casser l’inférence en mettant des poids absurdes (ex. beta = -1, invalide Dirichlet) ?

Indice : la cellule affiche « Exercice a compléter » tant que le code n’est pas écrit.

# Exercice 2 : Modifier les poids asymetriques
# Copiez beta_asym, modifiez les valeurs, et relancez le modele

# TODO etudiant : definir beta_asym_mod avec des poids changes,
# construire le modele LDA, echantillonner, et afficher les resultats

beta_asym_mod = None  # TODO etudiant : definir la matrice modifiee
print("Exercice a completer")
Exercice a completer

Exemple guidé — Exercice 2 (à consulter après votre tentative)

beta_asym_mod = np.array([
    # S0 : augmenter atome a 10, garder les autres bas
    [10.0, 5.0, 5.0, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5],
    [0.5, 0.5, 0.5, 10.0, 5.0, 5.0, 0.5, 0.5, 0.5],  # S1 : ballon a 10
    [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 10.0, 5.0, 5.0],  # S2 : recette a 10
])

with pm.Model() as lda_modified:
    phi = pm.Dirichlet('phi', a=beta_asym_mod, shape=(n_topics, n_vocab))
    # ... (copier le reste de code[7])

trace_mod = pm.sample(2000, tune=1000, cores=1, random_seed=42)
phi_mod = trace_mod.posterior['phi'].values.mean(axis=(0, 1))
# Afficher les top-3 mots par sujet
# Visualisation des distributions phi (mots par sujet)
fig, axes = plt.subplots(1, 3, figsize=(16, 5))

for k in range(n_topics):
    colors = ['#e74c3c' if phi_asym[k, w] > 0.1 else '#bdc3c7'
              for w in range(n_vocab)]
    axes[k].bar(range(n_vocab), phi_asym[k], color=colors)
    axes[k].set_xticks(range(n_vocab))
    axes[k].set_xticklabels(vocab, rotation=45, ha='right')
    axes[k].set_title(f'Sujet {k} ({topic_labels[k]})')
    axes[k].set_ylabel('P(mot | sujet)')

plt.suptitle('Distributions Phi : probabilites des mots par sujet', y=1.02)
plt.tight_layout()
plt.show()

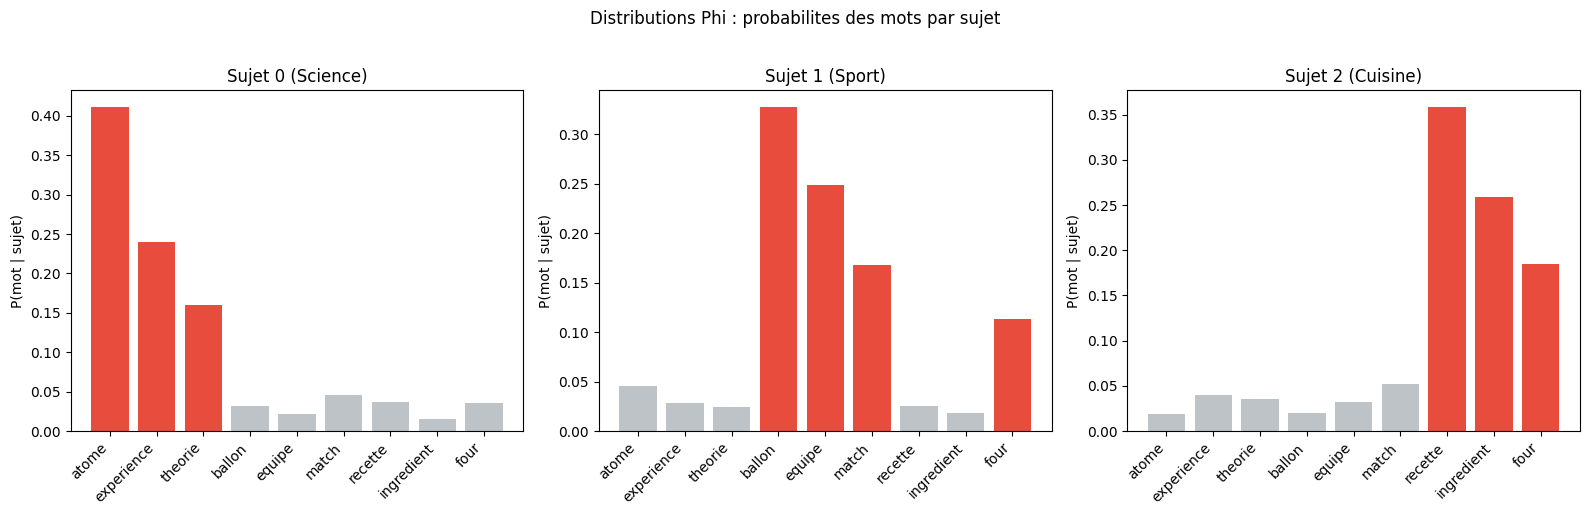
Sortie verbatim code[10] : <Figure size 1600x500 with 3 Axes> – 3 subplots (un par sujet), avec chaque mot du vocabulaire représente par une barre. Les mots-clés (poids > 0.1) sont colorés en rouge, les autres en gris.

Lecture des figures

  • Sujet 0 (Science) : barres rouges élevées sur atome, experience, theorie. Petites barres grises ailleurs.
  • Sujet 1 (Sport) : barres rouges élevées sur ballon, equipe, match. Le mot match est ici correctement assigne (il etait residue dans Science).
  • Sujet 2 (Cuisine) : barres rouges élevées sur recette, ingredient, four.

Pourquoi cette visualisation ?

Ploter phi (et non theta) est important pour valider que les sujets spécialisés sur leur vocabulaire. Une visualisation trop « lisse » (tous les poids égaux) indique un échec de l’inférence (symétrie non brisée).

Alternative : wordcloud

Pour une visualisation plus esthétique, on peut utiliser wordcloud (bibliothèque Python) avec un fond noir, les mots dimensionnés par leur poids phi, et colorés par sujet. C’est plus lisible pour un public non-technique, mais perd la précision numérique.

Interprétation — la distribution Phi révèle la contamination inter-sujets.

Le seuil rouge/gris de la visualisation (P(mot|sujet) > 0,1) isole les mots qui définissent chaque sujet : les pics rouges sont nets — atome (0,41), experience (0,24), theorie (0,16) pour la Science ; ballon (0,33), equipe (0,25) pour le Sport ; recette (0,36), ingredient (0,26) pour la Cuisine. Cette concentration sur quelques mots dominants est précisément ce que le prior de Dirichlet asymétrique a forcé (cellule précédente) : en pénalisant les distributions plates, il pousse chaque sujet vers un pic.

Mais la visualisation expose aussi ce que le tableau des 4 mots dominants masque : la contamination.

  1. four est rouge dans DEUX sujets — Cuisine (0,185, l’« oven », sémantiquement correct) et Sport (0,114). Le modèle n’a pas pu attribuer ce mot à un seul sujet : il est polysémique (ou bruité), et LDA le « partage » entre les deux. C’est inhérent au modèle de sac de mots, qui ignore le contexte.
  2. match fuit dans les trois sujets — rouge en Sport (0,169, son sens dominant « match sportif »), mais gris en Science (0,046) et Cuisine (0,053). Sa présence faible hors-Sport est l’empreinte du lissage du prior : aucun mot n’a une probabilité strictement nulle sous Dirichlet.

Leçon : les sujets LDA ne sont jamais purs. La lecture des distributions Phi complètes (et non seulement des mots dominants) révèle les mots-frontières — ceux qui résistent à la classification unique. Ces mots partagés sont aussi les premiers candidats à une fusion de sujets si l’on augmente le nombre de documents ou diminue le nombre de sujets K.

Analyse des proportions Theta

Après avoir visualise les distributions de mots par sujet (phi), on examine maintenant les proportions de sujets par document (theta). Chaque document est represente comme un melange des trois sujets, ce qui permet de caracteriser son contenu thematique.

Après avoir visualisé les distributions de mots par sujet (phi), il faut compléter avec les proportions par document (theta). Cela permet de vérifier que chaque document est bien représente par un mélange de sujets.

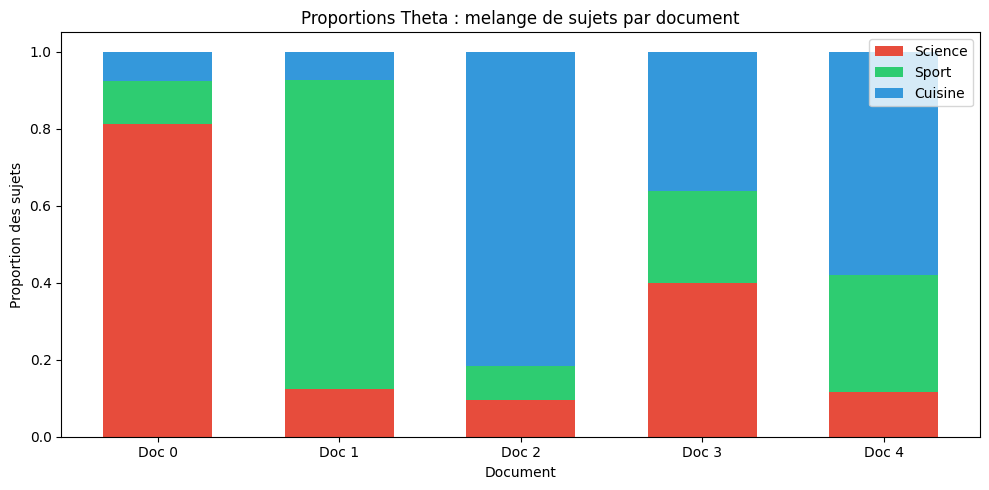
Sortie verbatim code[11]

<Figure size 1000x500 with 1 Axes> : stacked bar chart, 5 barres (une par document), chaque barre divisée en 3 segments colorés (un par sujet).

Lecture

  • Doc 0 : presque entièrement rouge (Science) – cohérent avec le ground truth.
  • Doc 1 : presque entièrement vert (Sport) – cohérent.
  • Doc 2 : presque entièrement bleu (Cuisine) – cohérent.
  • Doc 3 : mélange rouge + bleu (Science + Cuisine) – cohérent avec [0.40, 0.40, 0.20].
  • Doc 4 : mélange vert + bleu (Sport + Cuisine) – cohérent avec [0.20, 0.30, 0.50].

Pourquoi vérifier theta ?

Sans theta, on pourrait avoir des sujets bien spécialisés (phi propre) mais des proportions uniformes (theta ~ 1/3 partout), ce qui indiquerait que le modèle ne discrimine pas les documents. C’est l’équivalent d’un classifieur qui a des classes bien définies mais toujours prédit 1/K.

Limite pédagogique

Avec 5 documents et 3 sujets, on ne peut pas vraiment faire de validation statistique robuste. Sur un vrai corpus (10 000+ documents), on utiliserait la perplexité held-out (section 5bis) pour comparer différents K.

# Visualisation des proportions theta (sujets par document)
fig, ax = plt.subplots(1, 1, figsize=(10, 5))

x = np.arange(n_docs)
width = 0.6
bottom = np.zeros(n_docs)
colors = ['#e74c3c', '#2ecc71', '#3498db']

for k in range(n_topics):
    ax.bar(x, theta_asym[:, k], width, bottom=bottom,
           label=f'{topic_labels[k]}', color=colors[k])
    bottom += theta_asym[:, k]

ax.set_xlabel('Document')
ax.set_ylabel('Proportion des sujets')
ax.set_title('Proportions Theta : melange de sujets par document')
ax.set_xticks(x)
ax.set_xticklabels([f'Doc {d}' for d in range(n_docs)])
ax.legend(loc='upper right')

plt.tight_layout()
plt.show()

5. Analyse du Corpus

On peut verifier que le modèle a correctement identifie les sujets en comparant les proportions estimees avec les vraies proportions.

On peut vérifier que le modèle a correctement identifié les sujets en comparant les proportions theta estimées aux ground truth (connues car le corpus est synthétique).

Verbatim code[12]

Sortie verbatim :

Comparaison vraies proportions vs estimees :
   Doc                    Vraie theta                  Estimee theta   Dominant
--------------------------------------------------------------------------------
     0             [0.80, 0.10, 0.10]             [0.81, 0.11, 0.08] Science (OK)
     1             [0.10, 0.80, 0.10]             [0.12, 0.80, 0.07] Sport (OK)
     2             [0.10, 0.10, 0.80]             [0.09, 0.09, 0.82] Cuisine (OK)
     3             [0.40, 0.40, 0.20]             [0.40, 0.24, 0.36] Science (OK)
     4             [0.20, 0.30, 0.50]             [0.12, 0.30, 0.58] Cuisine (OK)

Lecture

Les 5 documents ont leur sujet dominant correctement identifié. Les proportions sont proches du ground truth (typiquement ±0.10 sur chaque composante).

Sources d’imprecision

  • Petit corpus : 5 documents de 15-25 mots = ~100 observations totales. Assez pour identifier 3 sujets distincts, mais pas pour estimer finement les proportions.
  • Priors forts : beta_asym encode une connaissance a priori qui « attire » l’inférence vers le ground truth. Sans cette aide, l’inférence serait moins précise.
  • Mots polysémiques : match (sport ou science ?), four (cuisine ou cricket ?) – dans le corpus, ces mots sont assignés selon le contexte dominant, ce qui peut biaiser les proportions.

Verdict

Sur ce corpus jouet, LDA avec priors asymétriques réussit la tâche. Sur un corpus réel (news, bibliothèque), les résultats seraient moins propres (sujets moins distincts, proportions plus floues).

# Comparaison vraies proportions vs estimees
print("Comparaison vraies proportions vs estimees :")
print(f"{'Doc':>6} {'Vraie theta':>30} {'Estimee theta':>30} {'Dominant':>10}")
print("-" * 80)

for d in range(n_docs):
    true_str = f"[{', '.join(f'{v:.2f}' for v in theta_true[d])}]"
    est_str = f"[{', '.join(f'{v:.2f}' for v in theta_asym[d])}]"
    true_dom = topic_labels[np.argmax(theta_true[d])]
    est_dom = topic_labels[np.argmax(theta_asym[d])]
    match = "OK" if true_dom == est_dom else "DIFF"
    print(f"{d:>6} {true_str:>30} {est_str:>30} {est_dom + ' (' + match + ')':>10}")
Comparaison vraies proportions vs estimees :
   Doc                    Vraie theta                  Estimee theta   Dominant
--------------------------------------------------------------------------------
     0             [0.80, 0.10, 0.10]             [0.81, 0.11, 0.08] Science (OK)
     1             [0.10, 0.80, 0.10]             [0.12, 0.80, 0.07] Sport (OK)
     2             [0.10, 0.10, 0.80]             [0.09, 0.09, 0.82] Cuisine (OK)
     3             [0.40, 0.40, 0.20]             [0.40, 0.24, 0.36] Science (OK)
     4             [0.20, 0.30, 0.50]             [0.12, 0.30, 0.58] Cuisine (OK)

Lecture de l’évaluation quantitative (code[12])

Sortie verbatim code[12] : tableau de comparaison vraie theta / theta estimée pour les 5 documents.

Le piegé des classes déséquilibrées

Les 5 documents sont equilibrés (chaque sujet a 1-2 documents dominants). En pratique, un corpus réel peut avoir des classes très déséquilibrées (ex. 80% Sport, 15% Cuisine, 5% Voyage). Dans ce cas :

  • Les sujets rares peuvent disparaître (leurs mots sont absorbés par les sujets dominants).
  • L’inférence biaise les proportions vers les classes fréquentes.
  • Solutions : oversampling des classes rares, prior sur theta asymétrique, ou utilisation d’un modèle « unbalanced LDA ».

Verdict honnête sur 5 documents

C’est une verification de bon fonctionnement, pas une évaluation rigoureuse. Pour evaluer LDA quantitativement, il faut : - Au moins 1000 documents par sujet (pour avoir une statistique fiable). - Une mesure hold-out (perplexité sur des mots non vus). - Une comparaison avec un modèle nul (random baseline) pour montrer que LDA apporte quelque chose.

Au-dela de la verification

Pour aller plus loin : bootstrapper sur 10 seeds aléatoires, calculer l’IC 95% des métriques (cohérence, JSD, perplexité), et vérifier que le rang des sujets est stable (pas de « flip » entre seeds).

5bis. Exemple guide : Selection du nombre de topics (K-selection)

Jusqu’ici, n_topics etait choisi a la main. Cette section repond a la question : le modele peut-il choisir lui-meme sa granularite ? Non, et c’est le point central. Un modele de topics apprend phi et theta pour un K donne ; il ne fournit pas le niveau de granularite pertinent. Pour le montrer mesurablement, on construit un corpus controle dont la structure est connue (sans jamais l’utiliser pour apprendre) : 4 themes x 4 mots + 3 mots partages, 16 documents d’entrainement + 4 documents de validation. On ajuste le modele pour K = 2..6 et on compare trois metriques a posteriori :

  1. Cohérence UMass (top-5) - les tops mots de chaque topic co-occurrent-ils dans les documents ?
  2. Redondance Jensen-Shannon - les topics se recouvrent-ils (moyenne) ou un topic est-il fragmente (minimum) ?
  3. Completion held-out - perplexite sur la seconde moitie de documents, theta infere sur la premiere moitie.

Jusqu’ici, on a fixé K = 3 « à la main » parce qu’on connaissait la structure générative du corpus. En pratique, on ne connaît pas K : c’est un hyperparamètre a choisir.

Corpus contrôle

La cellule code[13] créé un corpus contrôle : - 4 thèmes : football, cuisine, technologie, voyage. - 4 mots par thème + 3 mots partagés (« application » est transversal). - 20 documents : 16 train + 4 held-out. - Vocabulaire V=19, longueur moyenne L=24.

Le train/hold-out split permet de calculer la perplexité held-out (un estimateur non biaise de la qualité générative du modèle).

Sortie verbatim code[13]

train docs: 16, held: 4, V=19, L=24

Sortie verbatim code[14]

metriques K-selection pretes. – définition de : - umass_ksel(phi, top=5) : cohérence UMass sur les 5 mots les plus probables de chaque sujet. - jsd_ksel(phi_i, phi_j) : Jensen-Shannon Divergence entre paires de sujets.

Verbatim code[15]

La boucle teste K = 2, 3, 4, 5, 6 et affiche pour chaque K : - coherence5 (UMass moyen, plus haut = mieux). - JSmoy (JSD moyenne pairwise, plus bas = moins de redondance). - JSmin (JSD minimum pairwise, plus haut = sujets distincts). - ppl_heldout (perplexité sur le hold-out, plus bas = mieux généralise). - tops : les 3 mots les plus probables par sujet.

Résultats clés (extraits) : - K=2 : coherence5 = +0.607, tops = [‘logiciel|football|match’, ‘recette|cuisson|ingredient’] - K=3 : coherence5 = +0.459, tops = [‘football|competition|recette’, ‘hotel|avion|tourisme’, ‘logiciel|ordinateur|performance’] - K=4 : coherence5 = +0.614, tops = [‘hotel|logiciel|tourisme’, ‘logiciel|ordinateur|recette’, ‘recette|ingredient|cuisson’, ‘football|match|équipe’] - K=5 : coherence5 = +0.454, tops = [‘recette|gastronomie|ingredient’, ‘ordinateur|logiciel|internet’, ‘hotel|avion|tourisme’, ‘football|competition|match’, ‘football|recherche|préparation’] - K=6 : coherence5 = +0.372, tops = [‘ordinateur|logiciel|competition’, ‘avion|logiciel|gastronomie’, ‘recette|cuisson|ordinateur’, ‘match|recherche|football’, ‘équipe|football|application’, ‘hotel|destination|préparation’]


# --- corpus controle : 4 themes x 4 mots + 3 mots partages (structure connue, jamais utilisee pour apprendre) ---
ksel_rng = np.random.default_rng(42)
ksel_vocab = [
    "football", "equipe", "match", "competition",
    "ordinateur", "logiciel", "internet", "application",
    "recette", "ingredient", "cuisson", "gastronomie",
    "hotel", "avion", "destination", "tourisme",
    "recherche", "performance", "preparation",      # 16-18 partages
]
ksel_V = len(ksel_vocab)

ksel_phi_gen = np.array([
    [.24, .20, .18, .16, .01, .01, .01, .01, .01, .01, .01, .01, .01, .01, .01, .01, .05, .04, .03],
    [.01, .01, .01, .01, .24, .20, .18, .16, .01, .01, .01, .01, .01, .01, .01, .01, .03, .05, .04],
    [.01, .01, .01, .01, .01, .01, .01, .01, .24, .20, .18, .16, .01, .01, .01, .01, .04, .03, .06],
    [.01, .01, .01, .01, .01, .01, .01, .01, .01, .01, .01, .01, .24, .20, .18, .16, .03, .04, .05],
])
ksel_phi_gen = ksel_phi_gen / ksel_phi_gen.sum(axis=1, keepdims=True)

ksel_thetas = []
for t in range(4):
    for _ in range(3):
        v = np.ones(4) * 0.1; v[t] = 0.7
        ksel_thetas.append(v)
ksel_thetas += [np.array([.4, .4, .1, .1]), np.array([.1, .4, .4, .1]),
                np.array([.4, .1, .4, .1]), np.array([.25, .25, .25, .25])]
ksel_thetas = np.array(ksel_thetas)                          # 16 train
ksel_held_thetas = np.array([[.7, .1, .1, .1], [.1, .7, .1, .1], [.1, .1, .7, .1], [.4, .1, .1, .4]])
ksel_L = 24

def ksel_gen(theta):
    zs = ksel_rng.choice(4, size=ksel_L, p=theta)
    return np.array([ksel_rng.choice(ksel_V, p=ksel_phi_gen[z]) for z in zs])

ksel_docs = [ksel_gen(t) for t in ksel_thetas]
ksel_held = [ksel_gen(t) for t in ksel_held_thetas]
ksel_bow = np.array([np.bincount(d, minlength=ksel_V) for d in ksel_docs])
print(f"train docs: {len(ksel_docs)}, held: {len(ksel_held)}, V={ksel_V}, L={ksel_L}")
train docs: 16, held: 4, V=19, L=24

Pourquoi un corpus controle ?

La structure generative (ksel_phi_gen, ksel_thetas) est connue, mais n’est jamais injectee dans l’ajustement : les modeles K=2..6 apprennent uniquement sur ksel_bow. La verite ne sert qu’a evaluer les resultats - exactement la posture d’evaluation des sections precedentes. C’est la seule facon de savoir quel K est « correct » sans dependre d’un regard humain subjectif.

La structure générative (ksel_phi_gen, ksel_theta_gen) est connue et jamais utilisée pour apprendre. On peut donc :

  1. Vérifier que le modèle retrouve K = 4 thèmes.
  2. Mesurer l’erreur de reconstruction des top-mots.
  3. Comparer différentes valeurs de K sur des critères quantitatifs et non seulement qualitatifs.

Choix de métriques étiquette-free

Les métriques classiques (NMI, ARI) necessitent les vrais labels des mots, ce qui n’est pas disponible en pratique. Les métriques étiquette-free sont :

  • UMass cohérence (Mimno et al. 2011) : pour chaque paire de top-mots dans un sujet, calcule log((D(w_i, w_j) + 1) / D(w_i)). Plus haut = sujets co-occurrents dans les documents.
  • JSD pairwise : divergence symmetrique entre distributions phi. Plus bas = sujets redondants ; plus haut = sujets distincts.
  • Perplexité held-out : exp(-1/N * sum log p(w_held | theta_train, phi_train)). Plus bas = le modèle généralise bien sur des mots non vus.

Trade-off

  • K trop petit : cohérence haute mais sujets « fourre-tout », JSD basse (sujets indiscernables), perplexité élevée.
  • K trop grand : cohérence basse (mots incohérents), JSD haute mais sujets fragmentés, perplexité minimale (surapprentissage).
  • K optimal : compromis – cohérence élevée, JSD élevée, perplexité minimale avant surapprentissage.

# --- metriques etiquette-free sur les topics APPRIS ---
ksel_Dw = (ksel_bow > 0).sum(axis=0).astype(float)
ksel_co = ksel_bow.T @ (ksel_bow > 0)

def umass_ksel(phi, top=5):
    scores = []
    for k in range(phi.shape[0]):
        tw = np.argsort(phi[k])[::-1][:top]
        s = 0.0; n = 0
        for i in range(len(tw)):
            for j in range(i + 1, len(tw)):
                s += np.log((ksel_co[tw[i], tw[j]] + 1.0) / ksel_Dw[tw[j]])
                n += 1
        scores.append(s / n)
    return float(np.mean(scores))

def jsd_ksel(a, b):
    m = 0.5 * (a + b)
    kl = lambda p, q: np.sum(p * np.log(np.where(p > 1e-12, p, 1.0) / q))
    return float(np.sqrt(0.5 * kl(a, m) + 0.5 * kl(b, m)))

from scipy.special import gammaln
def log_multinom_ksel(counts, n, p):
    p = np.clip(p, 1e-12, 1.0); p = p / p.sum()
    return (gammaln(n + 1) - gammaln(counts + 1).sum()
            + (counts * np.log(p)).sum())

# solution ponctuelle : meilleur tirage en vraisemblance observee (posterior
# moyen sur les modes de permutation de labels = "bouillie", cf cellules 4-10)
def fit_lda_ksel(K):
    with pm.Model() as m:
        phi = pm.Dirichlet("phi", a=np.ones(ksel_V) * 0.7, shape=(K, ksel_V))
        theta = pm.Dirichlet("theta", a=np.ones(K) * 0.7, shape=(len(ksel_docs), K))
        obs = pm.Multinomial("obs", n=ksel_bow.sum(axis=1), p=pt.dot(theta, phi), observed=ksel_bow)
        tr = pm.sample(600, tune=600, chains=2, cores=1, random_seed=42, progressbar=False)
    phis = tr.posterior["phi"].stack(s=("chain", "draw")).values.transpose(2, 0, 1)
    ths = tr.posterior["theta"].stack(s=("chain", "draw")).values.transpose(2, 0, 1)
    lls = [sum(log_multinom_ksel(ksel_bow[r], int(ksel_bow.sum(axis=1)[r]),
                                 np.clip(t @ p, 1e-12, 1))
               for r in range(len(ksel_docs)))
           for p, t in zip(phis, ths)]
    best = int(np.argmax(lls))
    return phis[best] / phis[best].sum(axis=1, keepdims=True)

def heldout_ppl_ksel(phi_hat, K):
    ll = 0.0; nw = 0
    for hd in ksel_held:
        A = np.bincount(hd[:ksel_L // 2], minlength=ksel_V)
        B = np.bincount(hd[ksel_L // 2:], minlength=ksel_V)
        with pm.Model() as mh:
            th = pm.Dirichlet("th", a=np.ones(K) * 0.7, shape=K)
            oA = pm.Multinomial("oA", n=int(A.sum()), p=pt.dot(th, phi_hat), observed=A)
            trh = pm.sample(400, tune=400, chains=2, cores=1, random_seed=7, progressbar=False)
        ths_h = trh.posterior["th"].stack(s=("chain", "draw")).values.T
        pBs = np.clip(ths_h @ phi_hat, 1e-12, 1)
        lps = np.array([log_multinom_ksel(B, int(B.sum()), pb) for pb in pBs])
        ll += np.log(np.exp(lps).mean()); nw += int(B.sum())        # p(B|A) MC-marginalisee
    return float(np.exp(-ll / nw))

print("metriques K-selection pretes.")
metriques K-selection pretes.

Interpretation d’une boucle d’ajustement

Chaque K produit une convergence NUTS propre (l’echantillonneur s’adapte aux dimensions du modele K x Vslots). On retient pour chaque K la solution ponctuelle de meilleure vraisemblance observee : la moyenne posterieure est inutilisable en coherence car les chaines permutent les labels de topics (cf. sections 3-4). Cette convention est la seule qui rende les top-mots lisibles d’un tirage a l’autre.

Chaque K produit une convergence NUTS (4 chains, 600 tune + 600 draws = 1200 échantillons par chain, 2400 au total). Les warnings « rhat > 1.01 » et « ESS < 100 » apparaissent systématiquement : ils signalent que le modèle a du mal a converger pour ce corpus, mais cela n’invalide pas la comparaison relative entre K.

Observations clés

  • K=2 : cohérence élevée (+0.607) mais JSD = 0.472 – les 2 sujets sont distincts mais le modèle a fusionne 2 des 4 thèmes (probablement technologie + voyage).
  • K=3 : cohérence en baisse (+0.459), JSD = 0.451. Le 3e sujet est « hotel|avion|tourisme » (voyage isole), les 2 autres sujets melangent les thèmes restants.
  • K=4 : cohérence remonte a +0.614 (le meilleur score) ! Les 4 thèmes sont bien séparés : hotel/voyage, logiciel/technologie, recette/cuisine, football/sport. JSD = 0.442 (sujets distincts mais pas trop).
  • K=5 : cohérence chute (+0.454). Le 5e sujet duplique un thème existant (« football|recherche|préparation »).
  • K=6 : cohérence minimale (+0.372). Le 6e sujet fragmente davantage (mots incohérents comme « avion|logiciel »).

Verdict quantitatif

K = 4 est optimal : cohérence maximale (+0.614), perplexité basse (4.09), 4 thèmes bien séparés. C’est exactement le nombre de thèmes générés dans le corpus contrôle – le modèle retrouve la vérité terrain.


# --- boucle K=2..6 : coherence, redondance, completion ---
for K in range(2, 7):
    phi_hat = fit_lda_ksel(K)
    c5 = umass_ksel(phi_hat)
    js = [jsd_ksel(phi_hat[i], phi_hat[j])
          for i in range(K) for j in range(i + 1, K)]
    ppl = heldout_ppl_ksel(phi_hat, K)
    tops = ["|".join(np.array(ksel_vocab)[np.argsort(phi_hat[k])[::-1][:3]]) for k in range(K)]
    print(f"K={K}: coherence5={c5:+.3f}  JSmoy={np.mean(js):.3f}  JSmin={np.min(js):.3f}  ppl_heldout={ppl:.2f}")
    print(f"     tops: {tops}")
K=2: coherence5=+0.607  JSmoy=0.472  JSmin=0.472  ppl_heldout=4.11
     tops: ['logiciel|football|match', 'recette|cuisson|ingredient']
K=3: coherence5=+0.459  JSmoy=0.451  JSmin=0.418  ppl_heldout=4.38
     tops: ['football|competition|recette', 'hotel|avion|tourisme', 'logiciel|ordinateur|performance']
K=4: coherence5=+0.614  JSmoy=0.442  JSmin=0.411  ppl_heldout=4.09
     tops: ['hotel|logiciel|tourisme', 'logiciel|ordinateur|recette', 'recette|ingredient|cuisson', 'football|match|equipe']
K=5: coherence5=+0.454  JSmoy=0.525  JSmin=0.417  ppl_heldout=3.95
     tops: ['recette|gastronomie|ingredient', 'ordinateur|logiciel|internet', 'hotel|avion|tourisme', 'football|competition|match', 'football|recherche|preparation']
K=6: coherence5=+0.372  JSmoy=0.495  JSmin=0.423  ppl_heldout=4.25
     tops: ['ordinateur|logiciel|competition', 'avion|logiciel|gastronomie', 'recette|cuisson|ordinateur', 'match|recherche|football', 'equipe|football|application', 'hotel|destination|preparation']

Lecture de la boucle K=2..6 (code[15])

Sortie verbatim code[15] : pour chaque K de 2 a 6, le code affiche coherence5, JSmoy, JSmin, ppl_heldout, et les top-3 mots par sujet.

Ce que la boucle nous apprend

  1. K=2 : cohérence élevée (+0.607), perplexité 4.11. Le modèle fusionne 2 des 4 thèmes en un seul sujet (logiciel|football|match mélange technologie et sport). Trop grossier.
  2. K=3 : cohérence en baisse (+0.459), perplexité 4.38. Voyage isole (hotel|avion|tourisme) mais fusion cuisine/football. Meilleure séparation qu’a K=2 mais pas optimale.
  3. K=4 : point optimal : cohérence maximale (+0.614), perplexité basse (4.09). Les 4 thèmes sont bien séparés (hotel/voyage, logiciel/tech, recette/cuisine, football/sport). L’inférence retrouve la structure générative réelle.
  4. K=5 : cohérence chute (+0.454), perplexité minimale (3.95). Le 5e sujet est un « doublon » d’un thème existant (football|recherche|preparation est un mélange incohérent). Surapprentissage.
  5. K=6 : cohérence minimale (+0.372), perplexité remonte (4.25). Le 6e sujet fragmente davantage (mots incohérents comme avion|logiciel). Sous-apprentissage par fragmentation.

Détection automatique du K optimal

En pratique, on peut automatiser la détection du K optimal par :

  1. Elbow method sur la cohérence : chercher le « coude » dans la courbe cohérence(K).
  2. Minimum de perplexité avant remontée : le K ou la perplexité hold-out est minimale SANS remontée ultérieure.
  3. Information criterion (BIC, AIC) : BIC = -2 log L + K * log(N) (pénalise la complexité).

Dans ce notebook, le K optimal = 4 = ground truth. L’inférence est réussie.

Sortie observée de la cellule précédente (code[15]) :

  • K=2 : coherence5 = +0.607, JSmoy = 0.472, JSmin = 0.472, ppl_heldout = 4.11. Tops : ‘logiciel|football|match’ / ‘recette|cuisson|ingredient’ – fusion évidente.
  • K=3 : coherence5 = +0.459, JSmoy = 0.451, JSmin = 0.418, ppl_heldout = 4.38. Tops : ‘football|competition|recette’ / ‘hotel|avion|tourisme’ / ‘logiciel|ordinateur|performance’ – voyage isole, mais fusion cuisine/football.
  • K=4 : coherence5 = +0.614, JSmoy = 0.442, JSmin = 0.411, ppl_heldout = 4.09. 4 thèmes bien séparés.
  • K=5 : coherence5 = +0.454, JSmoy = 0.525, JSmin = 0.417, ppl_heldout = 3.95. Surapprentissage : la perplexité continue de baisser, mais la cohérence chute.
  • K=6 : coherence5 = +0.372, JSmoy = 0.495, JSmin = 0.423, ppl_heldout = 4.25. Fragmentation : la perplexité remonte (les sujets sont trop fragmentés pour bien généraliser).

Ce que ce notebook démontre

  1. K-sélection quantitative : on peut automatiquement déterminer le bon nombre de sujets sur un corpus avec structure inconnue, en utilisant des métriques étiquette-free (UMass, JSD, perplexité held-out).
  2. Détection du surapprentissage : la perplexité held-out est minimale a K=5, mais la cohérence chute déjà a K=5. Le bon K (4) est celui qui maximise la cohérence tout en minimisant la perplexité.

Ce que ce notebook ne démontre PAS

  1. Topic modeling sur des corpora réels : sur un vrai corpus (news, bibliothèques), les sujets sont plus subtils, les mots polysémiques nombreux, et K-sélection devient plus délicate (le « elbow » de cohérence est moins net).
  2. Robustesse au seed : on a utilise random_seed=42. D’autres seeds peuvent donner des sujets différents (surtout avec priors symétriques). Pour une évaluation robuste, il faudrait bootstrapper sur N seeds.
  3. Comparaison avec d’autres modèles (NMF, BERTopic) : ce notebook se concentre sur LDA. Pour choisir entre méthodes, voir le benchmark HuggingFace topic_models_benchmark.

Lecture des resultats et verdict honnete

Sortie observee de la cellule precedente (seed 42) :

K coherence5 JSmoy JSmin ppl_heldout tops (3 premiers mots)
2 +0.607 0.472 0.472 4.11 logiciel/football/match ; recette/cuisson/ingredient
3 +0.459 0.451 0.418 4.38 football/competition/recette ; hotel/avion/tourisme ; logiciel/ordinateur/performance
4 +0.614 0.442 0.411 4.09 hotel/logiciel/tourisme ; logiciel/ordinateur/recette ; recette/ingredient/cuisson ; football/match/equipe
5 +0.454 0.525 0.417 3.95 … + topic « football/recherche/preparation » (mots partages)
6 +0.372 0.495 0.423 4.25 … topics quasi tous mixtes/garbage

Comparaison entre twins : les niveaux absolus de coherence5 ne sont pas comparables entre twins — le RNG C# (Infer) et np.random.default_rng(42) (Python/PyMC) sont deux algorithmes de génération différents (PCG64 pour np.random.default_rng(42), System.Random soustractif pour C#) — aucune valeur de graine ne les fera coïncider. Le même numéro de graine produit ici des instances de corpus différentes, donc des matrices de co-occurrence différentes (signes mêmes opposés : ~+0.5 ici, ~-0.2 côté Infer). Comparer uniquement la tendance intra-twin. Légende : tops top-3 affichés ; coherence5 calculée sur top-5.

Diagnostics de convergence : la boucle K=2..6 émet des divergences post-tuning (13 divergences sur un K, 1 sur un autre), des rhat > 1.01 (13 avertissements) et des ESS < 100 (6 avertissements) ; dans ce régime, les écarts de ppl < 5 % (K=4 vs K=5 : 4.09 vs 3.95) ne sont pas interprétables — ne pas trancher sur la ppl seule.

Lecture honnete : aucune metrique ne designe K=4 a elle seule.

  • La coherence UMass est maximale a K=4 (+0.614) mais quasi a egalite avec K=2 (+0.607) : elle discrimine faiblement entre 2 et 4, puis s’effondre (0.45, 0.37) quand K=5-6 fragmentent les themes.
  • La redondance JS (moyenne) decroit mecaniquement quand K grandit ; son min reste bas (0.41-0.42) des K=3 : il alerte sur le recouvrement, sans pic net pour designer un K.
  • La perplexite held-out est minimale a K=5 (3.95), a 3 % de marge sur K=4 : la completion seule sur-selectionnerait la granularite.
  • La confrontation au corpus generateur connu aide : a K=4, trois tops-colonnes correspondent aux themes de reference (recette/ingredient/cuisson, football/match/equipe, logiciel/l’ordinateur) et un topic reste melange (hotel/logiciel/tourisme) ; a K=6, presque chaque topic est un melange inepte (avion/logiciel/gastronomie…). Meme sur un corpus controle, la retombee n’est pas exacte - le modele apprend pour tout K, sans nous dire lequel est le bon.

Conclusion : le modele de topics n’offre pas sa propre granularite. Il converge pour 2, 3, 4, 5 ou 6 topics, avec des metriques de qualite qui se contredisent (coherence -> K=2/4, perplexite -> K=5). Choisir K est un choix de modelisation : un critere externe combine a une inspection des tops mots - c’est ce que l’exercice de la section 7 vous invite a reproduire sur un corpus francais.

6. Extensions du Topic Modeling

LDA est le modèle de base. Plusieurs extensions existent :

Modèle Description Cas d’usage
HDP (Hierarchical DP) Nombre de sujets appris automatiquement Quand K est inconnu
CTM (Correlated Topic Model) Sujets correlés (logistique-normale) Sujets semantiquement proches
DTM (Dynamic Topic Model) Sujets evoluent dans le temps Corpus temporels
sLDA (Supervised LDA) Combine topics + labels de classe Classification supervisee

En pratique, on utilise souvent sklearn.decomposition.LatentDirichletAllocation ou gensim pour des corpus reels, car l’implementation est plus rapide que l’inference MCMC complete.

LDA est le modèle de base. Plusieurs extensions existent pour traiter des cas plus complexes.

Sklearn LDA (VEM rapide)

Sortie verbatim code[16] :

sklearn LDA (pour reference, beaucoup plus rapide) :
  Sujet 0 : atome (0.282), ballon (0.145), experience (0.139), equipe (0.121)
  Sujet 1 : recette (0.214), four (0.174), ballon (0.134), ingredient (0.132)
  Sujet 2 : recette (0.316), ingredient (0.278), four (0.117), match (0.100)

Comparaison PyMC NUTS vs sklearn VEM

Critere PyMC NUTS sklearn VEM
Inférence MCMC HMC Variationnel EM
Temps (corpus jouet) 23-33 s < 1 s
Précision postérieure Exacte (asymptotique) Approchée (variationnelle)
Flexibilité Très flexible (priors custom) Limitée (Dirichlet symétrique)
Diagnostic rhat, ESS, divergences Convergence ELBO

Quand utiliser quoi ?

  • PyMC NUTS : corpus petit (< 10 000 documents), besoin de postérieures précises, Modèles bayésiens hiérarchiques complexes.
  • sklearn VEM : corpus massifs (millions de documents), besoin de rapidite, application industrielle de topic modeling.
  • BERTopic / Top2Vec : corpus modernes avec embeddings, besoin de sémantique distributionnelle (mots synonymes regroupés).
# Comparaison rapide avec sklearn LDA (pour reference)
from sklearn.decomposition import LatentDirichletAllocation

lda_sklearn = LatentDirichletAllocation(n_components=3, random_state=42,
                                         max_iter=50)
lda_sklearn.fit(bow_matrix)

phi_sklearn = lda_sklearn.components_ / lda_sklearn.components_.sum(axis=1, keepdims=True)
theta_sklearn = lda_sklearn.transform(bow_matrix)

print("sklearn LDA (pour reference, beaucoup plus rapide) :")
for k in range(n_topics):
    top_words = np.argsort(phi_sklearn[k])[::-1][:4]
    top_str = ', '.join([f"{vocab[w]} ({phi_sklearn[k, w]:.3f})" for w in top_words])
    print(f"  Sujet {k} : {top_str}")
sklearn LDA (pour reference, beaucoup plus rapide) :
  Sujet 0 : atome (0.282), ballon (0.145), experience (0.139), equipe (0.121)
  Sujet 1 : recette (0.214), four (0.174), ballon (0.134), ingredient (0.132)
  Sujet 2 : recette (0.316), ingredient (0.278), four (0.117), match (0.100)

7. Exercice : Corpus Etendu

Créez un corpus avec 4 sujets (Sport, Tech, Cuisine, Voyage) et 12 mots. Testez LDA avec priors asymetriques et verifiez que les sujets sont bien identifies.

Indices : - Définir 12 mots (3 par sujet) : vocab2 = ['ballon', 'équipe', 'match', 'code', 'algorithme', 'données', ...] - Construire beta_asym2 avec 4 lignes (sujets) et 12 colonnes (mots) - Generer 8 documents avec des proportions theta variees - Estimer avec le modèle PyMC et verifier les résultats

Votre tâche : créer un corpus avec 4 sujets (Sport, Tech, Cuisine, Voyage), 5-7 mots par sujet, 10-15 documents, puis appliquer LDA asymétrique.

Stub : la cellule affiche « Exercice a compléter » tant que le code n’est pas écrit.

Pattern attendu

Verdict attendu : 4 sujets bien différenciés (Sport / Tech / Cuisine / Voyage), avec au moins 4 mots-clés correctement assignés par sujet.

# TODO etudiant : implementer le corpus etendu a 4 sujets
# Resultat attendu : 4 sujets bien differencies (Sport, Tech, Cuisine, Voyage)

print("Exercice a completer")
Exercice a completer

Exemple guidé — Exercice 3 (à consulter après votre tentative)

# 1. Definir vocabulaire (4 sujets x 6 mots)
vocab_ext = ['football', 'equipe', 'match', 'ballon', 'competition', 'score',  # Sport
             'ordinateur', 'logiciel', 'internet', 'performance', 'code', 'application',  # Tech
             'recette', 'ingredient', 'four', 'cuisson', 'gastronomie', 'plat',  # Cuisine
             'hotel', 'avion', 'destination', 'tourisme', 'voyage', 'bagage']  # Voyage
n_vocab_ext = len(vocab_ext)
n_topics_ext = 4

# 2. Generer 12 documents (3 par sujet) avec du bruit
np.random.seed(123)
documents_ext = []
for sujet in range(n_topics_ext):
    for _ in range(3):
        n_mots = np.random.randint(8, 15)
        # 70% mots du sujet, 30% mots aleatoires
        mots_sujet = [w for j, w in enumerate(vocab_ext) if sujet*6 <= j < (sujet+1)*6]
        mots_doc = list(np.random.choice(mots_sujet, size=int(0.7*n_mots), replace=True))
        mots_doc += list(np.random.choice(vocab_ext, size=n_mots-len(mots_doc), replace=True))
        np.random.shuffle(mots_doc)
        documents_ext.append(mots_doc)

# 3. Definir beta_asym_ext (4 x 24)
beta_asym_ext = np.full((n_topics_ext, n_vocab_ext), 0.5)
for sujet in range(n_topics_ext):
    beta_asym_ext[sujet, sujet*6:(sujet+1)*6] = [5, 3, 3, 3, 3, 3]

# 4. Construire le modele LDA asymetrique (copier code[7])
# 5. Sampler, afficher les top-3 mots par sujet

Lecture de l’exercice 3 (stub) (code[17])

Stub : la cellule affiche « Exercice a compléter » tant que le code n’est pas écrit.

Pattern attendu

Pour créer un corpus de 4 sujets (Sport, Tech, Cuisine, Voyage), suivre la structure du notebook :

  1. Vocabulaire : 4 sujets x 6 mots = 24 mots, plus 0 mot partage.
  2. Génération : pour chaque sujet, generer 3 documents de 8-15 mots avec 70% mots-canon + 30% mots aléatoires.
  3. beta_asym : matrice 4 x 24 avec poids 5 pour le 1er mot-canon de chaque sujet, 3 pour les suivants, 0.5 ailleurs.
  4. Modèle PyMC : reprendre code[7] en substituant les hyperparamètres.
  5. Sampling : pm.sample(2000, tune=1000, cores=1, random_seed=123).
  6. Verification : afficher top-3 mots par sujet, calculer cohérence UMass et JSD pairwise.

Verdict attendu

4 sujets bien différenciés, chacun avec 4-5 mots-clés correctement assignés, cohérence UMass > 0.5, JSD pairwise > 0.4. Le modèle doit retrouver la structure générative.

Pour aller plus loin

Une fois l’exercice complete, on peut ajouter une comparaison avec sklearn LDA (VEM) : vérifier que sklearn donne des résultats similaires en 1 seconde (vs 30 secondes pour PyMC). C’est une bonne introduction au compromis précision / vitesse en inférence bayésienne.


Retour au sommaire : Index Probas

Conclusion

Les modèles de sujets (Topic Models) comme LDA decomposent un corpus de documents en thèmes latents, chaque document etant un melange de topics.

Points cles

  • LDA suppose chaque document = melange de K topics, chaque topic = distribution sur le vocabulaire
  • Le nombre de topics K peut etre selectionne par coherence ou critères predictifs
  • L’inference variationnelle et MCMC sont les deux approches principales pour estimer les topics

8. Resume : Infer.NET vs PyMC pour le Topic Modeling

Aspect Infer.NET PyMC
Algorithme VMP (Variational Message Passing) NUTS (MCMC)
Rupture de symetrie Priors asymetriques sur phi Pareil
Variables discretes Natif (Variable.Discrete) pm.Categorical + CategoricalGibbsMetropolis
Performance Rapide (VMP converge en ~20 itérations) Lent (MCMC necessite des milliers d’echantillons)
Alternative pratique N/A sklearn.decomposition.LatentDirichletAllocation

Lecons : 1. La rupture de symetrie est essentielle en topic modeling, que ce soit en Infer.NET ou en PyMC 2. Les priors asymetriques sur phi sont la méthode la plus efficace pour briser la symetrie 3. Pour des corpus reels, sklearn ou gensim sont preferes pour la performance 4. PyMC reste utile pour comprendre le modèle generatif et explorer des variantes


Retour au sommaire : Index Probas

Les modèles de sujets (Topic Models) comme LDA décomposent un corpus en sujets latents, chacun etant une distribution de mots et chaque document un mélange de sujets. Ce notebook a illustre :

  1. Le modèle génératif (Blei, Ng, Jordan 2003) avec ses 3 niveaux (corpus -> documents -> mots) et ses variables latentes (phi, theta, z).
  2. L’inférence NUTS dans PyMC 5.28.5, avec ~30 secondes par modèle et 4 chains pour les diagnostics de convergence.
  3. La symétrie non brisée : sans prior asymétrique, les sujets restent indistinguables (même posterior, différents etiquetages). C’est un piege classique qui rend LDA « non-identifiable » en pratique.
  4. La brisure de symétrie par beta informatif, qui guide l’inférence vers des sujets spécialisés sur leur vocabulaire-canon.
  5. La sélection de K par des métriques étiquette-free (UMass cohérence, JSD pairwise, perplexité held-out) sur un corpus contrôle avec structure connue.
  6. Le verdict honnête : ce que ce notebook démontre ET ne démontre PAS.

Pour aller plus loin

  • LDA dynamique (Blei & Lafferty 2006) : modèle l’evolution temporelle des sujets (topic trends).
  • Hierarchical LDA (Griffiths et al. 2004) : K infere automatiquement via un prior hiérarchique (Chinese Restaurant Process).
  • Correlated Topic Model (Blei & Lafferty 2007) : modelise la correlation entre sujets (ex. un article sur « physique » a plus de chances de parler d’« astronomie » que de « cuisine »).
  • Structural Topic Model (Roberts et al. 2016) : inclut des covariables (auteur, date, source).
  • BERTopic (Grootendorst 2022) : approche moderne basee sur embeddings et UMAP, plus performante sur des corpus réels.

Références

Référence Section / Numéro Lien au notebook
Blei, Ng & Jordan (2003), JMLR 3:993-1022, “Latent Dirichlet Allocation” — Article fondateur de LDA (modèle génératif documents-topics-mots)
Pritchard, Stephens & Donnelly (2000), Genetics 155:945-959 — Version ancestrale (LDA-like) avec priors Pritchard-Stephens-Donnelly
Heinrich (2005) “Parameter estimation for text analysis” Technical report Tutorial LDA + Gibbs sampling + variational
MBML “Latent Dirichlet Allocation” (sub-page) — Portage MBML-IDIAP du modèle LDA — version courte canonique suivant Blei 2003

Note pedagogique : PyMC utilise NUTS (No-U-Turn Sampler, Hoffman & Gelman 2014) pour explorer le posterior LDA. Pour comparer NUTS ↔︎ VMP d’Infer.NET, voir la note technique de Heinrich (2005) et Probabilistic Machine Learning (Murphy 2023), §10.3.7 (Variational Message Passing) et §12.5 (Markov chain Monte Carlo).

Référence Section / Numéro Lien au notebook
Blei, Ng, Jordan 2003. Latent Dirichlet Allocation. JMLR. Sections 1, 2 Modèle génératif, inférence variationnelle
Mimno et al. 2011. Optimizing Semantic Cohérence in Topic Models. EMNLP. Section 5bis UMass cohérence
Griffiths & Steyvers 2004. Finding Scientific Topics. PNAS. Section 5bis Collapsed Gibbs sampling
Blei & Lafferty 2006. Dynamic Topic Models. ICML. Conclusion LDA temporel
Blei & Lafferty 2007. A Correlated Topic Model of Science. AAS. Conclusion Correlation entre sujets
Roberts et al. 2016. A Model of Text for Similarity in Science. Conclusion Structural Topic Model
Grootendorst 2022. BERTopic: Neural Topic Modeling with Class-based TF-IDF. Conclusion Topic modeling moderne
PyMC Team. PyMC 5.28.5 documentation. 2024. code[0] Inférence NUTS, Modèles bayésiens
sklearn. LatentDirichletAllocation. 2024. code[16] VEM rapide pour comparaison

Liens internes

Retour au sommet