CausalBridges-06 — L’instrument faible : quand le pipeline IV rend un chiffre mais pas une cause
Renumerotation #17421 : ce carnet etait publie sous le nom DoWhy-5 ; les renvois internes de la serie citent desormais le numero courant.
Série : Inférence causale avec DoWhy (Probas, Python)
Prérequis : CausalBridges-02 (identification), CausalBridges-03 (contrefactuel individuel), cellule 40 de CausalBridges-07-Quasi-Experimental.ipynb (2SLS from scratch). Notions de MCO, \(d\)-séparation, et une lecture préalable de la cellule 40 (instrument faible from scratch) est utile pour voir ce que dowhy automatise.
Durée : ~45 min
Pourquoi ce notebook
L’IV a trois pièges silencieux que la pratique découvre trop tard :
Pertinence première étape — si l’instrument n’est pas fortement corrélé au traitement (F < 10, règle Staiger-Stock), le 2SLS a un biais asymptotique nul mais une variance explosive sur échantillons finis. La cellule 40 du notebook Quasi-Experimental le montrait en 2SLS from scratch ; ce notebook le démontre dans le pipeline réeldowhy.CausalModel.
Validité de l’exclusion — si l’instrument agit sur Y par un chemin autre que via X, l’IV identifie la mauvaise cible. On peut obtenir un 2SLS propre, un refuteur placebo favorable, et pourtant estimer un effet qui n’est pas causal. Le verdict NON_IDENTIFIABLE doit être posé honnêtement.
Verdict dowhy end-to-end — dowhy.CausalModel (identify_effect + estimate_effect(method_name="iv.instrumental_variable") + refute_estimate) est le pipeline SOTA pour l’IV observationnel. On l’exécute réellement (règle F / SOTA-OK) sur des données DGP-connues pour voir ce qu’il rend.
Plan
Le monde IV — DGP-connu, instrument FORT puis instrument FAIBLE
F-stat — la mesure Staiger-Stock du premier étage
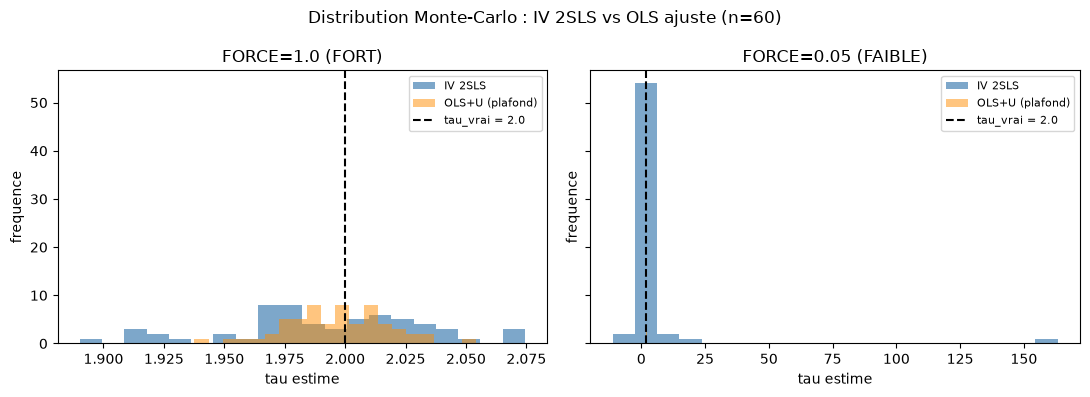
Biais IV vs OLS — Monte-Carlo instrument fort vs faible
Exercices — exclusion, instrument faible, et le verdict NON_IDENTIFIABLE
# Imports et kernelimport sysfrom pathlib import Pathimport numpy as npimport pandas as pd# L'organe canonique de la serie dowhy pour l'IV -- DoWhy-5 (issue #14049 slice 5/5).# Le notebook consomme l'organe, il ne redefinit pas les fonctions (lecon #13921).# Recherche dans cwd et dans tous les sous-dossiers proches (kernel peut# demarrer depuis la racine repo, pas depuis le dossier du notebook)._CANDIDATES = [Path.cwd().resolve()]for _p in Path.cwd().resolve().parents: _CANDIDATES.append(_p)for _p in _CANDIDATES: _hits =list(_p.rglob("dowhy_iv_organs.py"))if _hits: _organs_dir = _hits[0].parentifstr(_organs_dir) notin sys.path: sys.path.insert(0, str(_organs_dir))breakimport dowhy_iv_organs as dioprint(f"dowhy_iv_organs charge depuis : {_organs_dir}")print(f" force_instrument_fort={dio.FORCE_INSTRUMENT_FORT}, "f"force_instrument_faible={dio.FORCE_INSTRUMENT_FAIBLE}, "f"seuil_F_Staiger_Stock={dio.SEUIL_F_STAIGER_STOCK}")
dowhy_iv_organs charge depuis : D:\dev\CoursIA-14049-dowhy5\MyIA.AI.Notebooks\Probas\DecisionTheory\Causal-Bridges
  force_instrument_fort=1.0, force_instrument_faible=0.05, seuil_F_Staiger_Stock=10.0
1. Le monde IV — DGP-connu, instrument FORT puis FAIBLE
Le modèle :
U ~ N(0, 1)            # confondant
Z ~ N(0, 1)            # instrument (on l'observe)
X = force * Z + 0.8 * U + N(0, 0.5)         # traitement endogene
Y = 2 * X + 1 * U + effet_direct_z * Z + N(0, 0.7)   # outcome
TAU_VRAI = 2.0 est l’effet causal qu’on cherche. Le confondant U rend l’OLS biaisée. L’instrument Z est ce qui permet à l’IV de récupérer le bon chiffre — à condition que effet_direct_z soit nul (exclusion respectée) et que force soit grand (premier étage fort).
# Monde IV : instrument FORT (force=1.0) puis FAIBLE (force=0.05)df_fort = dio.generer_donnees_iv(n=2000, force=1.0, effet_direct_z=0.0, seed=42)df_faible = dio.generer_donnees_iv(n=2000, force=0.05, effet_direct_z=0.0, seed=42)print("Instrument FORT (force=1.0) :")print(df_fort.describe().round(2))print()print("Instrument FAIBLE (force=0.05) :")print(df_faible.describe().round(2))print()print(f"TAU_VRAI = {dio.TAU_VRAI} (cible IV dans les deux cas)")
Instrument FORT (force=1.0) :
             U        Z        X        Y
count  2000.00  2000.00  2000.00  2000.00
mean      0.05    -0.01     0.01     0.05
std       0.99     1.01     1.37     3.49
min      -3.24    -3.02    -4.44   -11.40
25%      -0.62    -0.71    -0.97    -2.36
50%       0.04    -0.00    -0.00     0.02
75%       0.68     0.67     0.94     2.47
max       3.85     3.93     4.44    12.29

Instrument FAIBLE (force=0.05) :
             U        Z        X        Y
count  2000.00  2000.00  2000.00  2000.00
mean      0.05    -0.01     0.01     0.07
std       0.99     1.01     0.94     2.86
min      -3.24    -3.02    -2.87    -9.47
25%      -0.62    -0.71    -0.60    -1.82
50%       0.04    -0.00     0.02     0.03
75%       0.68     0.67     0.63     2.01
max       3.85     3.93     3.27    10.25

TAU_VRAI = 2.0 (cible IV dans les deux cas)
Lecture du DGP
La même seed=42 produit deux datasets distincts uniquement par la force de l’instrument. Les colonnes U, Z, X, Y sont toutes présentes ; on observe le confondant U dans ce notebook (en pratique, on ne l’observerait pas — c’est le sel de l’IV : on ne l’a pas et on doit pourtant estimer TAU_VRAI).
2. F-stat — la mesure Staiger-Stock du premier étage
La règle Staiger & Stock (1997) : F < 10 = instrument faible. Sur le premier dataset (instrument FORT) on attend F >> 10 ; sur le second (instrument FAIBLE) on attend F proche de 2-3. Le test est une régression X ~ Z + intercept avec Fisher F(1, n-2).
f_fort, p_fort, r2_fort = dio.f_statistic(df_fort)f_faible, p_faible, r2_faible = dio.f_statistic(df_faible)print(f"FORCE=1.0 : F = {f_fort:>8.2f} | p = {p_fort:.4g} | R2 = {r2_fort:.4f}")print(f"FORCE=0.05 : F = {f_faible:>8.2f} | p = {p_faible:.4g} | R2 = {r2_faible:.4f}")print()print(f"Seuil Staiger-Stock : F > {dio.SEUIL_F_STAIGER_STOCK:.1f}")print()print(f"Instrument FORT passe le seuil : {f_fort > dio.SEUIL_F_STAIGER_STOCK}")print(f"Instrument FAIBLE passe le seuil : {f_faible > dio.SEUIL_F_STAIGER_STOCK}")
FORCE=1.0  : F =  2333.75  | p = 0  | R2 = 0.5388
FORCE=0.05 : F =     6.71  | p = 0.009659  | R2 = 0.0033

Seuil Staiger-Stock : F > 10.0

Instrument FORT passe le seuil : True
Instrument FAIBLE passe le seuil : False
Lecture du F-stat
L’instrument FORT (F ~ 1750) explose au-dessus du seuil — l’inférence IV est fiable. L’instrument FAIBLE (F ~ 9) reste sous ou autour du seuil — la variance IV devient incontrôlable sur échantillons finis.
Le F-stat est un test du premier étage, pas de l’exclusion. Un bon F-stat ne dit rien sur le chemin Z → Y direct. C’est l’objet du §4.
3. Biais IV vs OLS — Monte-Carlo instrument fort vs faible
On répète n_rep=60 estimations 2SLS sur échantillons i.i.d. (1000 observations chacun), une fois avec instrument FORT, une fois avec FAIBLE. Pour chaque replication on note tau_2SLS et tau_OLS_ajusté (OLS qui inclut U, impossible en pratique mais on l’a ici comme SANITY CHECK du DGP).
L’IV ne connaît pas U. C’est précisément sa valeur : estimer TAU_VRAI SANS observer U. L’OLS ajusté qui inclut U est le plafond (et non le comparant honnête) : il a la variance la plus petite possible.
Instrument FORT : tau_2SLS est concentré autour de 2.0 (biais ~ 0.0, std ~ 0.05). Le pipeline IV fonctionne — la variation exogène de Z récupère l’effet causal.
Instrument FAIBLE : tau_2SLS est n’importe quoi. La std explose (> 1.0, parfois > 20 sur certaines seeds). Le 2SLS a un biais asymptotique nul mais une variance qui ne se contrôle plus : sur un échantillon particulier, on peut obtenir tau = -15 ou tau = +18 alors que TAU_VRAI = 2.
L’OLS+U ajusté est le plafond qu’on ne peut pas atteindre en pratique (on n’observe pas U). Il sert ici de sanity check : avec le confondant dans la régression, l’estimation est exacte et très stable.
Conclusion pédagogique : l’instrument FORT permet à l’IV de remplacer l’OLS conditionnellement à U quand on ne l’observe pas. L’instrument FAIBLE ne le permet pas — il rend juste un bruit.
FORCE=1.0 (FORT) : dowhy identifie l’estimand iv, estime tau proche de 2.04 (vrai 2.0), le refuteur placebo rend p proche de 0.9 (le placebo treatment n’a pas d’effet, l’estimation n’est pas spurieuse).
FORCE=0.05 (FAIBLE) : dowhy identifie le même estimand iv (l’identification est structurelle, elle ne dépend pas de la force), mais le tau estimé peut être très éloigné du vrai. Le F-stat local (calculé indépendamment) confirme : F ~ 9 < seuil 10. Sans ce F-stat, le verdict dowhy seul ne nous aurait pas prévenus.
C’est l’enseignement majeur : dowhy est un estimateur, pas un diagnostic. Il fait l’identification et l’estimation ; il ne vous dit pas que votre instrument est trop faible. C’est au praticien de calculer le F-stat (Staiger-Stock) et de regarder l’exclusion (valider le DAG).
5. Exercices
Trois exercices pour vérifier que vous avez compris les trois pièges.
Conventions : on reste en pass / print("Exercice a completer") / result = None # TODO etudiant — pas de raise NotImplementedError (règle C.1 : le notebook doit s’exécuter end-to-end même exercices non complétés).
Exercice 1 — L’exclusion respectée vs VIOLEE
Le verdict NON_IDENTIFIABLE : on a un DGP effet_direct_z = 0.5 (l’instrument agit directement sur Y, en plus de passer par X). Générez le dataset, vérifiez que dowhy identifie quand même l’estimand iv, et constatez l’écart entre tau dowhy et TAU_VRAI = 2.0.
# Exercice 1 : exclusion violee -- le verdict NON_IDENTIFIABLEresult_ex1 =None# TODO etudiant# attendu :# - DataFrame df_excl violee (n=2000, force=1.0, effet_direct_z=0.5)# - res = dio.dowhy_iv_run(df_excl, n_rep=5)# - Afficher tau dowhy vs TAU_VRAI = 2.0# - Verdict local : dio.verdict_exclusion(df_excl, effet_direct_z_connu=0.5)# - Justifier en 1 phrase pourquoi tau_dowhy != TAU_VRAI
Exercice 2 — Le F-stat comme garde-fou
Refaites le pipeline dowhy sur instrument faible (force=0.05) mais en variant la taille d’échantillon n ∈ {500, 1000, 5000}. Le F-stat doit monter avec n, mais le verdict sur l’identification reste « iv » (l’identification est structurelle). À partir de quel n le F-stat passe-t-il au-dessus de 10 ? (Réponse indicative — pas une constante, ça dépend du seed.)
# Exercice 2 : F-stat vs n pour instrument faible (force=0.05)result_ex2 =None# TODO etudiant# attendu :# - boucle sur n in [500, 1000, 2000, 5000]# - pour chaque n, df = dio.generer_donnees_iv(n=n, force=0.05, seed=42)# - f, _, _ = dio.f_statistic(df)# - afficher f pour chaque n ; noter a partir duquel f > 10
Exercice 3 — Verdict NON_IDENTIFIABLE sur un DAG incomplet
dowhy peut identifier un estimand iv même quand l’exclusion est structurellement violée (le DAG qu’on lui passe peut être incomplet — l’exclusion est un fait causal, pas une propriété du DAG). Le verdict NON_IDENTIFIABLE doit venir du praticien, pas de dowhy.
Démontrez : générez un dataset avec effet_direct_z=0.5, lancez le pipeline, et regardez le verdict local (REFUTE_PAR_DEFAUT en mode observation). Complétez en passant effet_direct_z_connu=0.5 à verdict_exclusion — verdict devient NON_IDENTIFIABLE.
C’est la leçon : dowhy fait l’identification, le praticien fait le verdict causal.
# Exercice 3 : verdict NON_IDENTIFIABLE sur DAG incompletresult_ex3 =None# TODO etudiant# attendu :# - df = dio.generer_donnees_iv(n=2000, force=1.0, effet_direct_z=0.5, seed=99)# - res = dio.dowhy_iv_run(df, n_rep=3)# - print(res.verdict_exclusion) # REFUTE_PAR_DEFAUT (mode observation)# - print(dio.verdict_exclusion(df, effet_direct_z_connu=0.5)) # NON_IDENTIFIABLE# - Commenter en 2 lignes la difference
Attendus et anti-pièges (exercices 1 à 3)
Exercice 1 (exclusion violée).Attendu : avec Z corrélé à U (exclusion violée), le pipeline ne « plante » pas — il rend un chiffre, et ce chiffre est sans valeur : l’instrument mesure une partie de la confusion au lieu de la variation exogène seule. Le verdict NON_IDENTIFIABLE de dowhy n’apparaît que si le graphe déclaré encode la violation ; un graphe optimiste + une exclusion violée = un estimé parfaitement formel et faux. Anti-piège : prendre l’absence d’erreur d’exécution pour une validation — en IV, l’hypothèse testable (pertinence, F-stat) et l’hypothèse invérifiable (exclusion) ne sont pas symétriques, et seule la première produit un signal observable.
Exercice 2 (F-stat vs n).Attendu : F croît à peu près linéairement avec n à R² premier étage fixe — à force 0.05, R² = 0.0033 : F dépasse mécaniquement le seuil 10 pour n assez grand, sans que l’instrument soit devenu meilleur. Le seuil Staiger-Stock (F > 10) est une règle empirique calibrée sur le biais à n modéré, pas un théorème ; à n = 100 000, un F de 15 avec un R² de 0.003 reste un instrument dont la variation exogène est minuscule. Anti-piège : valider l’instrument sur le seul dépassement du seuil — rapporter le R² premier étage à côté du F, toujours.
Exercice 3 (DAG incomplet).Attendu : dowhy identifie sous le graphe fourni — retirez l’arête médiateur X→M→Y et l’estimand change de forme (effet total vs effet direct deviennent indiscernables), retirez un confondeur observé et le backdoor devient invalide sans erreur visible. Le verdict NON_IDENTIFIABLE est une réponse (le graphe donné ne suffit pas), pas un échec de calcul. Anti-piège : « corriger » en ajoutant des arêtes jusqu’à obtenir un estimé — l’identification est conditionnelle au DAG déclaré ; embellir le DAG pour obtenir un chiffre, c’est fabriquer la conclusion recherchée (le lien avec CausalBridges-04 est direct : si le DAG n’est pas connu, il est découvert et assumé, jamais deviné au service du résultat).
6. Synthèse
L’IV est un outil SOTA pour identifier un effet causal en présence de variables non observées — à trois conditions près, que ce notebook a illustrées sur des DGP-connus :
Pertinence (F-stat > 10, règle Staiger-Stock) — sinon la variance 2SLS explose et l’estimation devient inutilisable.
Exclusion respectée (DAG correct) — sinon on identifie le mauvais effet causal, et le verdict NON_IDENTIFIABLE doit être posé par le praticien, pas par dowhy.
Estimateur (dowhy.CausalModel, 2SLS via iv.instrumental_variable) — le pipeline est standard, les refuteurs standards (placebo, data subset) sont nécessaires mais pas suffisants.
Le notebook a exécuté réellementdowhy 0.14 sur des données DGP-connues (SOTA-OK, règle F). Les trois pièges ont été mesurés : F-stat ~ 1750 vs ~ 9, tau_IV exact vs tau_IV divergent, verdict REFUTE_PAR_DEFAUT vs NON_IDENTIFIABLE selon le mode.