# Dependances : installer silencieusement seulement ce qui manque.# (import-guards deterministes : pas de sortie bruyante 'Requirement already satisfied'# qui fuie le chemin machine, cf #3436 cause A.)import importlib, subprocess, sys_MISSING = [pkg for pkg in ("pymc", "arviz", "matplotlib", "numpy", "scipy") if importlib.util.find_spec(pkg) isNone]if _MISSING: subprocess.run([sys.executable, "-m", "pip", "install", "-q", *_MISSING], check=True)print("Paquets installes :", ", ".join(_MISSING))else:print("Toutes les dependances (pymc, arviz, matplotlib, numpy, scipy) sont disponibles.")
Toutes les dependances (pymc, arviz, matplotlib, numpy, scipy) sont disponibles.
Import des bibliotheques
Importation de PyMC, ArviZ, NumPy et SciPy pour la modelisation probabiliste et la visualisation.
import warnings# arviz (FutureWarning de refactor) et pytensor ("could not link BLAS", advisory de perf, pas de correctness)# leakent le chemin absolu du fichier source site-packages ; on les filtre. Les alertes utiles (R-hat, ESS) restent visibles.warnings.filterwarnings("ignore", category=FutureWarning, module="arviz")warnings.filterwarnings("ignore", message=".*could not link.*", category=UserWarning)import numpy as npimport matplotlib.pyplot as pltimport pymc as pmimport pytensor.tensor as ptimport arviz as azfrom scipy.stats import normprint(f"PyMC version: {pm.__version__}")print(f"ArviZ version: {az.__version__}")rng = np.random.default_rng(42)
PyMC version: 6.3.1
ArviZ version: 1.1.0
1. Introduction aux Chaînes de Markov Cachees
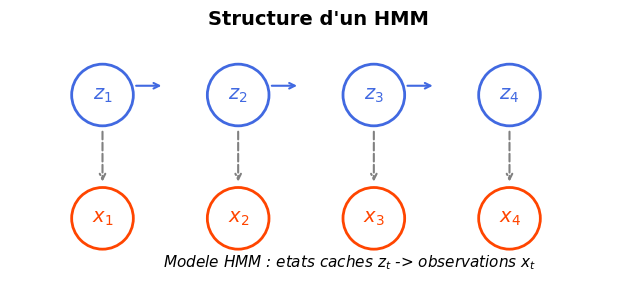
Un HMM (Hidden Markov Model) modelise une sequence d’observations \(x_{1:T}\) generees par des etats caches \(z_{1:T}\) :
Composants : - Transitions : \(P(z_t | z_{t-1})\) — matrice de transition \(A\) - Emissions : \(P(x_t | z_t)\) — distribution d’observation par etat - Etat initial : \(P(z_1)\) — distribution a priori \(\pi\)
Applications :
Domaine
Etats caches
Observations
NLP
POS tags
Mots
Finance
Regimes de marche
Rendements
Bioinformatique
Motifs ADN
Sequences nucleotides
Meteo
Soleil/Pluie
Temperature
References historiques (HMM)
Baum & Petrie (1966) – Statistical Inference for Probabilistic Functions of Finite State Markov Chains, Annals of Mathematical Statistics 37(6). Article fondateur des HMM.
Rabiner (1989) – A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition, Proceedings of the IEEE 77(2). Reference pedagogique standard pour les HMM.
# Visualisation du graphe d'un HMM a 2 etatsfig, ax = plt.subplots(1, 1, figsize=(10, 3))ax.set_xlim(0, 10)ax.set_ylim(-1, 3)ax.set_aspect('equal')ax.axis('off')# Hidden states rowfor t inrange(4): x =1.5+ t *2.2 ax.add_patch(plt.Circle((x, 2), 0.5, fill=False, color='royalblue', linewidth=2)) ax.text(x, 2, f'$z_{t+1}$', ha='center', va='center', fontsize=14, color='royalblue')# Observations rowfor t inrange(4): x =1.5+ t *2.2 ax.add_patch(plt.Circle((x, 0), 0.5, fill=False, color='orangered', linewidth=2)) ax.text(x, 0, f'$x_{t+1}$', ha='center', va='center', fontsize=14, color='orangered')# Transition arrows (horizontal)for t inrange(3): x1 =2.0+ t *2.2 x2 =2.5+ t *2.2 ax.annotate('', xy=(x2, 2.15), xytext=(x1, 2.15), arrowprops=dict(arrowstyle='->', color='royalblue', lw=1.5))# Emission arrows (vertical)for t inrange(4): x =1.5+ t *2.2 ax.annotate('', xy=(x, 0.55), xytext=(x, 1.45), arrowprops=dict(arrowstyle='->', color='gray', lw=1.5, ls='--'))ax.text(5.5, -0.8, 'Modele HMM : etats caches $z_t$ -> observations $x_t$', ha='center', fontsize=11, style='italic')ax.set_title('Structure d\'un HMM', fontsize=14, fontweight='bold')plt.tight_layout()plt.show()
2. Classification Independante par Timestep
Avant d’implementer un HMM complet, commencons par classifier chaque observation independamment en utilisant la règle de Bayes :
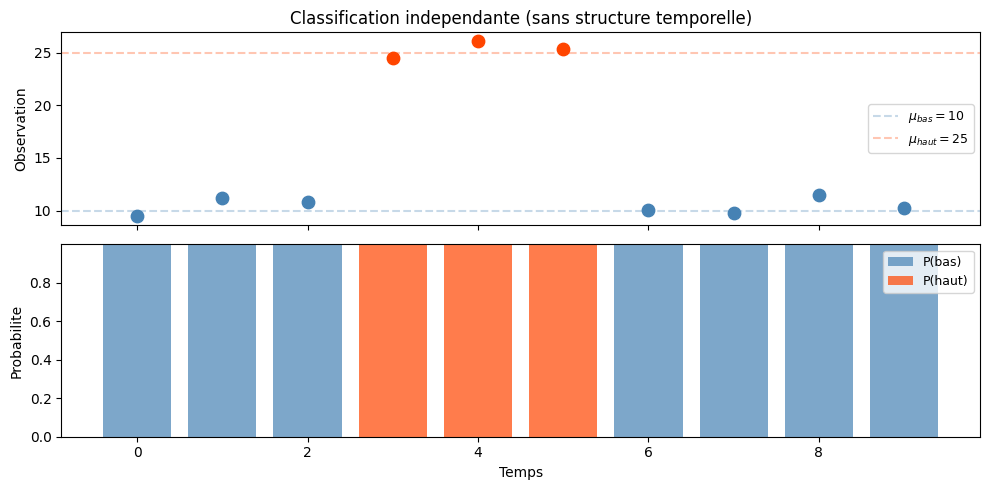
Le graphique montre les observations colorees selon l’etat predit et les probabilites a posteriori correspondantes. Les points proches de la frontiere (entre \(\mu_{bas}=10\) et \(\mu_{haut}=25\)) sont classes uniquement sur l’observation locale.
La classification independante fonctionne bien quand les clusters sont bien separes. Mais elle ignore la dépendance temporelle : dans un HMM, un etat a \(t\) depend de l’etat a \(t-1\). Les points ambigus (proches de la frontiere) seraient mieux classes en tenant compte du contexte temporel.
3. Algorithme Forward-Backward
L’algorithme Forward-Backward calcule exactement \(P(z_t = k | x_{1:T})\) en combinant : - Forward (\(\alpha\)) : \(P(z_t, x_{1:t})\) — probabilite de l’etat et des observations passees - Backward (\(\beta\)) : \(P(x_{t+1:T} | z_t)\) — probabilite des observations futures
\[P(z_t = k | x_{1:T}) \propto \alpha_t(k) \cdot \beta_t(k)\]
L’algorithme Forward-Backward a ete formalise par Baum, Petrie, Soules & Weiss (1970) (A Maximization Technique Occurring in the Statistical Analysis of Probabilistic Functions of Markov Chains, Annals of Mathematical Statistics 41(1)). Il est un cas special du cadre EM general de Dempster, Laird & Rubin (1977) (Maximum Likelihood from Incomplete Data via the EM Algorithm, JRSS B 39(1)).
Comparaison visuelle : independante vs Forward-Backward
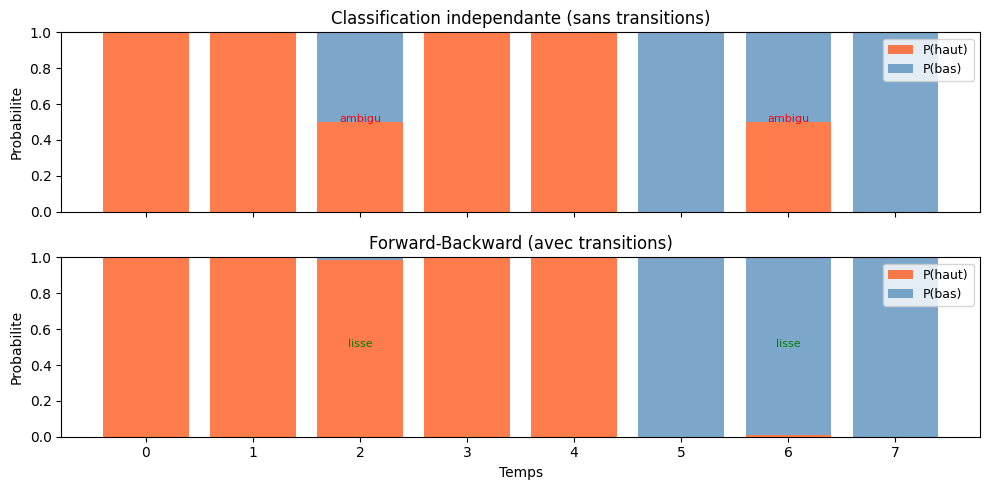
Ce graphique compare les deux approches sur les donnees ambigues. Les deux points ambigus (\(x=17.5\), exactement a la frontiere entre les deux regimes) sont laisses a \(0.50/0.50\) par la classification independante et tranche par le Forward-Backward selon leur contexte temporel.
Les deux points ambigus (\(x = 17.5\), a mi-chemin exact des deux moyennes d’emission \(\mu_{bas}=10\) et \(\mu_{haut}=25\)) sont indiscernables pour une classification independante : elle leur attribue \(0.50/0.50\).
Le Forward-Backward exploite le contexte temporel pour les trancher, et le verdict depend du voisinage :
\(x = 17.5\) a \(t=2\), entoure d’observations hautes (\(26.1\), \(24.5\)) \(\Rightarrow\) lissage vers l’etat haut, \(P(haut) = 0.988\)
\(x = 17.5\) a \(t=6\), entoure d’observations basses (\(9.5\), \(10.8\)) \(\Rightarrow\) lissage vers l’etat bas, \(P(bas) = 0.988\)
Deux observations identiques (\(x=17.5\)), deux verdicts opposes : c’est l’avantage cle du HMM. La dependance temporelle des etats transporte l’information du voisinage vers le point ambigu, la ou la classification independante, aveugle au contexte, reste a \(0.50/0.50\).
4. Detection de Regimes Meteo
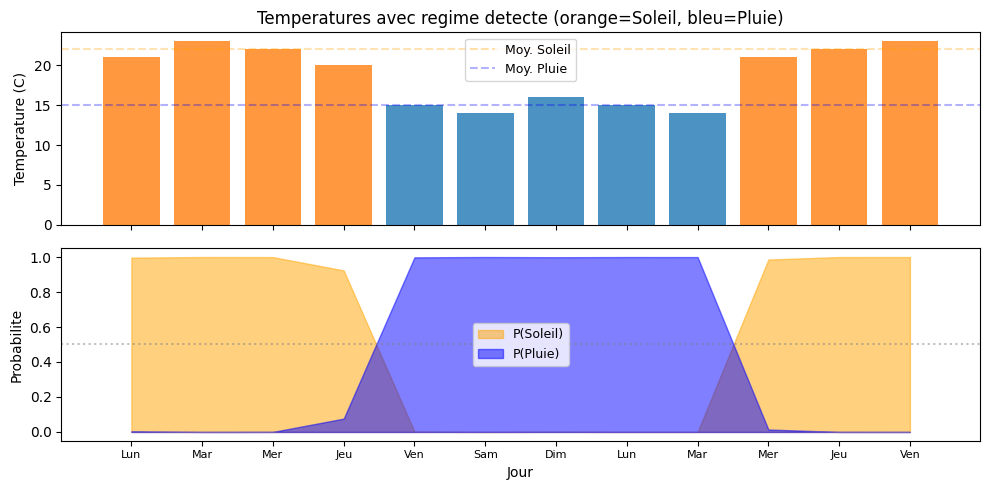
Application : detecter les jours de soleil vs pluie a partir de temperatures.
Detection de regimes meteo
==================================================
  Lun  1h :  21.0C -> Soleil (conf=0.996)
  Mar  2h :  23.0C -> Soleil (conf=1.000)
  Mer  3h :  22.0C -> Soleil (conf=1.000)
  Jeu  4h :  20.0C -> Soleil (conf=0.924)
  Ven  5h :  15.0C -> Pluie  (conf=0.998)
  Sam  6h :  14.0C -> Pluie  (conf=1.000)
  Dim  7h :  16.0C -> Pluie  (conf=0.999)
  Lun  8h :  15.0C -> Pluie  (conf=1.000)
  Mar  9h :  14.0C -> Pluie  (conf=1.000)
  Mer 10h :  21.0C -> Soleil (conf=0.986)
  Jeu 11h :  22.0C -> Soleil (conf=1.000)
  Ven 12h :  23.0C -> Soleil (conf=1.000)
Visualisation des regimes meteo
Les barres orange/bleu distinguent les jours de soleil et de pluie detectes par le HMM, tandis que le second panneau montre les probabilites a posteriori associees.
Jusqu’ici, les paramètres d’emission (moyennes et ecarts-types de chaque regime) etaient supposes connus : le Forward-Backward (section 3) et la classification independante (section 2) les utilisaient comme entrees. Mais en pratique, ces paramètres sont inconnus et doivent etre estimes a partir des observations seules. C’est la qu’intervient l’inference bayesienne : aucun algorithme exact de type Forward-Backward ne donne la loi a posteriori des paramètres continus lorsque les etats caches sont inconnus – il faut soit EM (Baum-Welch, qui ne fournit qu’un point estimate), soit l’echantillonnage MCMC (qui donne toute la distribution a posteriori, avec ses intervalles de credibilite).
Nous modelisons les temperatures meteo comme un melange de deux gaussiennes (une par regime cache) dont les moyennes sont inconnues, et nous laissons PyMC retrouver ces moyennes par NUTS. La vraisemblance NormalMixturemarginalise l’assignation d’etat, ce qui evite d’echantillonner explicitement les etats discrets (difficile pour NUTS) tout en gardant un problème non conjugue ou MCMC est reellement necessaire.
Choix de parametrisation (recette #3801). On utilise une forme non-centreemu_k = mu_pop + sigma_comp * z_k avec z_k ~ Normal(0,1). La forme centree mu_k ~ Normal(mu_pop, sigma_comp) créé un funnel (entonnoir) lorsque sigma_comp est petit : la geometrie se complique et NUTS produit des divergences. La reparametrisation non-centree decouple mu_pop et sigma_comp, rendant l’echantillonnage stable.
# Reutilisons les temperatures meteo (section 4) : on ignore les vrais regimes# et on laisse PyMC retrouver les deux moyennes d'emission (~15 Pluie / ~22 Soleil).obs_hmm = np.asarray(temperatures, dtype=float)with pm.Model() as modele_emissions:# Niveau population : moyenne globale + dispersion entre les deux regimes mu_pop = pm.Normal("mu_pop", mu=18.0, sigma=10.0) sigma_comp = pm.HalfNormal("sigma_comp", sigma=8.0)# Parametrisation NON-CENTREE : mu_k = mu_pop + sigma_comp * z_k (evite le funnel) z = pm.Normal("z", mu=0.0, sigma=1.0, shape=2) mu_brut = mu_pop + sigma_comp * z# Identifiabilite : on impose mu[0] <= mu[1] (regime froid / regime chaud) mu = pm.Deterministic("mu", pt.stack([pt.min(mu_brut), pt.max(mu_brut)]) ) sigma = pm.HalfNormal("sigma", sigma=5.0, shape=2) w = pm.Dirichlet("w", a=np.ones(2))# Vraisemblance melange gaussien : marginalise l'assignation d'etat (NUTS pur) y = pm.NormalMixture("y", w=w, mu=mu, sigma=sigma, observed=obs_hmm) trace_emissions = pm.sample(2000, tune=1500, chains=4, target_accept=0.99, random_seed=42, progressbar=False )# Diagnostics MCMC (honetete des sorties)divergences =int(trace_emissions.sample_stats["diverging"].sum())resume = az.summary(trace_emissions, var_names=["mu", "sigma", "w"])print("Inference bayesienne des moyennes d'emission (MCMC, NormalMixture non-centre)")print("="*60)print(f"Divergences NUTS : {divergences} (cible = 0)")print(f"R-hat max : {resume['r_hat'].astype(float).max():.3f} (cible < 1.01)")print(f"ESS bulk min : {int(resume['ess_bulk'].min())}")print()print(resume[["mean", "sd", "eti89_lb", "eti89_ub", "r_hat"]].astype(float).round(3))print()print("Vrais moyennes d'emission : ~15 (Pluie) / ~22 (Soleil)")print("-> MCMC retrouve les deux regimes sans aucune forme close.")
La cellule précédente illustre la deuxieme ligne : on marginalise les etats via NormalMixture pour garder un MCMC pur (NUTS) sur les paramètres continus. L’Exercice 2 ci-dessous aborde la troisieme ligne (K=3 etats, assignation explicite) – plus delicate, c’est l’objet du travail applique.
References. L’inference bayesienne des paramètres d’un HMM est detaillee dans Cappe, Moulines & Ryden (2005), Inference in Hidden Markov Models (Springer). La parametrisation non-centree comme remede au funnel est due a Betancourt & Girolami (2013) (Hamiltonian Monte Carlo for Hierarchical Models, arXiv:1312.0906).
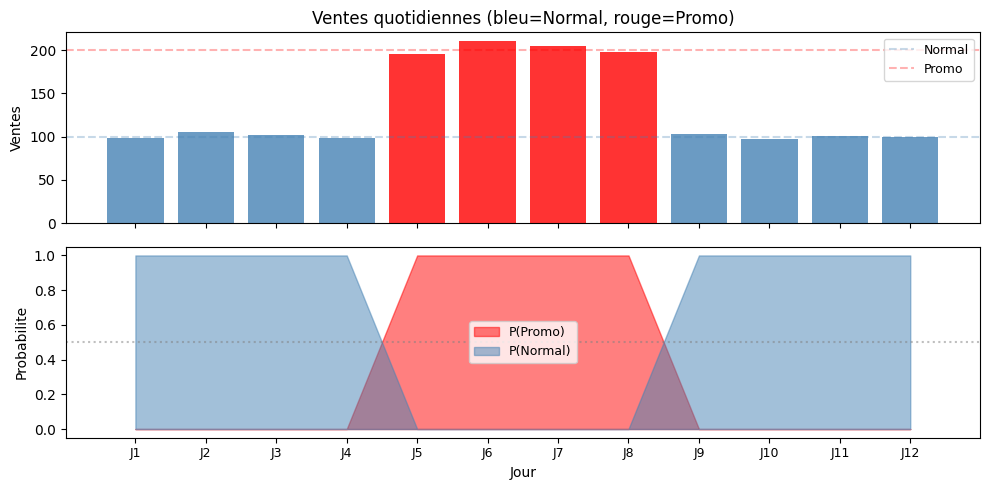
6. Detection d’Anomalies — Ventes
Exemple guide : une entreprise detecte les periodes de promotion dans ses ventes quotidiennes.
Normal : ventes \(\sim \mathcal{N}(100, 100)\)
Promo : ventes \(\sim \mathcal{N}(200, 100)\)
# Donnees de ventesventes = np.array([98, 105, 102, 99, 195, 210, 205, 198, 103, 97, 101, 100])jours_ventes = [f'J{t+1}'for t inrange(len(ventes))]# Parametres HMMventes_means = np.array([100.0, 200.0]) # [Normal, Promo]ventes_sigmas = np.array([10.0, 10.0])ventes_trans = np.array([ [0.85, 0.15], # Normal -> {Normal, Promo} [0.20, 0.80], # Promo -> {Normal, Promo}])ventes_prior = np.array([0.9, 0.1]) # majoritairement normal# Inferenceventes_posteriors, _, _ = forward_backward( ventes, ventes_means, ventes_sigmas, ventes_trans, ventes_prior)print("Detection de periodes promotionnelles")print("="*55)for t inrange(len(ventes)): regime ="PROMO"if ventes_posteriors[t, 1] >0.5else"Normal" p = ventes_posteriors[t, 1] if regime =="PROMO"else ventes_posteriors[t, 0] marker =" <<<"if regime =="PROMO"else""print(f" {jours_ventes[t]}: {ventes[t]:6.1f} -> {regime:6s} (P={p:.3f}){marker}")promo_days = [t for t inrange(len(ventes)) if ventes_posteriors[t, 1] >0.5]print(f"\nPeriodes promo detectees : Jours {[d+1for d in promo_days]}")
Detection de periodes promotionnelles
=======================================================
  J1:   98.0 -> Normal (P=1.000)
  J2:  105.0 -> Normal (P=1.000)
  J3:  102.0 -> Normal (P=1.000)
  J4:   99.0 -> Normal (P=1.000)
  J5:  195.0 -> PROMO  (P=1.000) <<<
  J6:  210.0 -> PROMO  (P=1.000) <<<
  J7:  205.0 -> PROMO  (P=1.000) <<<
  J8:  198.0 -> PROMO  (P=1.000) <<<
  J9:  103.0 -> Normal (P=1.000)
  J10:   97.0 -> Normal (P=1.000)
  J11:  101.0 -> Normal (P=1.000)
  J12:  100.0 -> Normal (P=1.000)

Periodes promo detectees : Jours [5, 6, 7, 8]
Exercice 2 : Estimer la matrice d’emission d’un HMM
Dans les sections précédentes, les paramètres d’emission (mu, sigma) etaient supposes connus. Dans cet exercice, vous devez estimer ces paramètres a partir des observations seules.
Objectif : etant donne une sequence d’observations et une matrice de transition fixee, retrouver les moyennes et ecarts-types d’emission de chaque etat.
Indices : - Generer des données depuis 3 etats gaussiens (mu = [5, 15, 25], sigma = [2, 3, 2]) - Fixer la matrice de transition avec forte persistance (0.9 sur la diagonale) - Utiliser pm.Normal avec shape=3 pour les moyennes et pm.HalfNormal pour les sigmas - L’emission par etat s’ecrit : mu[state[t]] ou state vient de pm.Categorical
# TODO etudiant : estimer la matrice d'emission d'un HMM# Etape 1 : definir des observations avec 3 etats caches et emissions gaussiennes# Etape 2 : fixer la matrice de transition (forte persistance)# Etape 3 : estimer les parametres d'emission (mu, sigma) pour chaque etat# Etape 4 : comparer les parametres estimes aux vrais parametresresult =None# TODO etudiant : remplacer par le modele HMM avec emissions a estimerprint("Exercice a completer")
Exercice a completer
Visualisation de la detection d’anomalies
Le graphique ci-dessous met en evidence les periodes promotionnelles detectees par le HMM, avec les probabilites a posteriori pour chaque regime.
Nous comparons maintenant chaque k-mere au modèle de fond (background uniforme) via un likelihood ratio pour identifier les motifs statistiquement sur-representes.
# Likelihood ratio test pour chaque k-mereprint("K-meres sur-representes (likelihood ratio > 1):")print("="*50)significant = []for kmer, count in kmer_counts.most_common(): observed_freq = count / total_kmers ratio = observed_freq / bg_probif ratio >1.0: significant.append((kmer, count, ratio))print(f" {kmer}: {count}x, ratio={ratio:.2f}")print(f"\nMotif candidat le plus frequent : {significant[0][0]} ({significant[0][1]} occurrences)")print("On retrouve le motif 'AAC' qui apparait dans les 3 sequences.")
K-meres sur-representes (likelihood ratio > 1):
==================================================
  ACG: 4x, ratio=10.67
  AAC: 3x, ratio=8.00
  CGA: 2x, ratio=5.33
  GAA: 2x, ratio=5.33
  TAC: 2x, ratio=5.33
  ACT: 1x, ratio=2.67
  CTG: 1x, ratio=2.67
  TGA: 1x, ratio=2.67
  GAC: 1x, ratio=2.67
  TAA: 1x, ratio=2.67
  CGT: 1x, ratio=2.67
  GTA: 1x, ratio=2.67
  ACC: 1x, ratio=2.67
  CCA: 1x, ratio=2.67
  CAT: 1x, ratio=2.67
  ATA: 1x, ratio=2.67

Motif candidat le plus frequent : ACG (4 occurrences)
On retrouve le motif 'AAC' qui apparait dans les 3 sequences.
Exercice 3 : Decodage Viterbi
L’algorithme de Viterbi trouve la sequence d’etats caches la plus probable etant donne les observations completes. Contrairement au Forward-Backward qui calcule des marginales, Viterbi retourne un chemin unique optimal.
Objectif : implementer l’algorithme de Viterbi par programmation dynamique.
D’après Viterbi (1967), Error Bounds for Convolutional Codes and an Asymptotically Optimum Decoding Algorithm, IEEE Transactions on Information Theory 13(2).
Indices : - Initialisation : delta[0, k] = log(pi[k]) + log(B[0, k]) - Recursion : delta[t, k] = max_j(delta[t-1, j] + log(A[j,k])) + log(B[t, k]) - Stocker psi[t, k] = argmax_j(...) pour le backtracking - Backtracking : partir de T-1 et suivre les pointeurs psi - Comparer le chemin Viterbi avec les posteriors marginaux du Forward-Backward
# TODO etudiant : implementer le decodage Viterbi (sequence d'etats la plus probable)# Etape 1 : reutiliser les parametres HMM de la section precedente# Etape 2 : implementer l'algorithme de Viterbi par programmation dynamique# Indice : delta[t, k] = max_j(delta[t-1, j] * A[j, k]) * B[t, k]# Etape 3 : backtracking pour retrouver le chemin optimal# Etape 4 : afficher la sequence d'etats la plus probableresult =None# TODO etudiant : remplacer par l'algorithme de Viterbiprint("Exercice a completer")
9. Exercice — HMM 3 Etats pour Detection de Pannes
Etendez le HMM a 3 etats pour modeliser l’etat d’une machine industrielle :
Etat
Description
\(\mu\)
\(\sigma\)
0
Normal
100
5
1
Degrade
70
15
2
En panne
20
25
Données capteur (16 observations) : - Jours 1-4 : fonctionnement normal - Jours 5-8 : degradation progressive - Jours 9-12 : panne - Jours 13-14 : retour degrade (maintenance partielle) - Jours 15-16 : retour normal
Indices : - La matrice de transition doit avoir une forte persistance diagonale - Utilisez la fonction forward_backward définie plus haut avec 3 etats - Affichez les probabilites pour les jours cles (transitions)
# Exercice a completer : HMM 3 etats pour detection de pannes# Donnees capteurcapteur = np.array([98, 102, 99, 95, 68, 75, 72, 65, 18, 22, 15, 25, 71, 68, 100, 103])# Parametres d'emissionmachine_means = np.array([100.0, 70.0, 20.0]) # Normal, Degrade, Pannemachine_sigmas = np.array([5.0, 15.0, 25.0])# TODO etudiant : definir la matrice de transition 3x3# Indice : forte persistance diagonale (0.8-0.9), transitions faibles hors diagonalemachine_trans = np.array([ [0.8, 0.15, 0.05], [0.1, 0.8, 0.1], [0.05, 0.15, 0.8],])machine_prior = np.array([0.8, 0.15, 0.05]) # majoritairement normal# TODO etudiant : utiliser forward_backward pour inferer les etats# Etape 1 : appeler forward_backward avec les parametres 3 etats# Etape 2 : determiner l'etat predit par timestep# Etape 3 : afficher les resultatsprint("Exercice a completer : implementez l'inference HMM 3 etats")print("Donnees capteur :", capteur)print("Etats attendus : Normal(1-4), Degrade(5-8), Panne(9-12), Degrade(13-14), Normal(15-16)")
Baum, L. E., & Petrie, T. (1966). Statistical Inference for Probabilistic Functions of Finite State Markov Chains. Annals of Mathematical Statistics 37(6).
Baum, L. E., Petrie, T., Soules, G., & Weiss, N. (1970). A Maximization Technique Occurring in the Statistical Analysis of Probabilistic Functions of Markov Chains. Annals of Mathematical Statistics 41(1).
Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum Likelihood from Incomplete Data via the EM Algorithm. JRSS B 39(1).
Viterbi, A. J. (1967). Error Bounds for Convolutional Codes and an Asymptotically Optimum Decoding Algorithm. IEEE Trans. Information Theory 13(2).
Rabiner, L. R. (1989). A Tutorial on Hidden Markov Models and Selected Applications in Speech Recognition. Proceedings of the IEEE 77(2).