Serie Parite .NET <=> Python (#4956). Ce notebook est le jumeau Python de Infer-17 – Filtre de Kalman (Infer.NET, EP). Il reprend le même terrain de jeu (même germe, même trajectoire, même paramètres) afin que les metriques soient comparables entre les deux moteurs, puis ajoute une value-add PyMC : l’estimation MCMC des variances \(Q\) et \(R\) (et du drift) que Infer.NET suppose connues.
Value-add PyMC : estimer \(Q\), \(R\) et le drift par MCMC (NUTS) au lieu de les supposer connus
1. Motivation : le HMM a etat continu
PyMC-14 modelisait des sequences ou l’etat cache etait discret (quel temps, quel mot de la phrase). Mais de nombreux systèmes suivent une grandeur continue : position d’un mobile, temperature d’un four, prix d’un actif. Le filtre de Kalman (Kalman, 1960) est l’equivalent exact du HMM pour l’etat continu gaussien – le système dynamique lineaire gaussien (Linear Dynamical System, LDS).
L’etat cache \(x_t\) evolue lineairement avec un bruit gaussien (la dynamique), et on l’observe a travers un autre bruit gaussien (le capteur) :
\[x_t = x_{t-1} + d + \mathcal{N}(0, Q) \quad \text{(equation de transition)}\]\[y_t = x_t + \mathcal{N}(0, R) \quad \text{(equation d'observation)}\]
Parce que tout est gaussien et lineaire, l’inference reste exactement conjuguee : le posterieur est gaussien a chaque pas, calculable en temps ferme. C’est le cas d’école ou la recursion fermee (et l’EP d’Infer.NET) resout l’inference de maniere exacte. > Papier fondateur. Le filtre de Kalman est introduit par Kalman, R. E. (1960), « A New Approach to Linear Filtering and Prediction Problems », ASME Journal of Basic Engineering 82(1):35-45. L’article fondateur qui demontre que la recursion predict-update est exacte sur les systemes lineaires-gaussiens, avec une solution en forme fermee. Rauch, H. E., Tung, F. & Striebel, C. T. (1965), « Maximum likelihood estimates of linear dynamic systems », AIAA Journal 3(8):1445-1450, introduisent le lisseur RTS (Rauch-Tung-Striebel) qui utilise aussi les observations futures pour re-estimer chaque etat, avec une MSE lisse inferieure a la MSE filtree. Sage, A. P. & Melsa, J. L. (1971), « Estimation Theory with Applications to Communications and Control », McGraw-Hill, offrent la presentation classique de reference du filtre et du lisseur dans un cadre unifie (filtrage, prediction, lissage).
# --- Imports + terrain de jeu (IDENTIQUE a Infer-17 pour comparabilite) ---import numpy as npimport pymc as pmimport pytensor.tensor as ptimport arviz as azimport warningswarnings.filterwarnings("ignore", message=".*data structure.*")warnings.filterwarnings("ignore", message="PyTensor could not link to a BLAS") # advisory pytensor (#3436)print(f"PyMC {pm.__version__}, ArviZ {az.__version__}")# Meme germe, meme parametres qu'Infer-17 (jumeau .NET) -- les metriques doivent coller.rng = np.random.default_rng(42)T =50drift =0.3# d : vitesse constante (terme de pente)processVar =0.5# Q : bruit de dynamique (incertitude sur l'evolution)obsVar =4.0# R : bruit de capteur (observations TRES bruitees, R >> Q)# Vraie trajectoire cachee (INCONNUE du modele -- ground truth pour la validation)eps_state = rng.standard_normal(T)trueState = np.empty(T)trueState[0] =0.0for t inrange(1, T): trueState[t] = trueState[t -1] + drift + np.sqrt(processVar) * eps_state[t]# Observations bruitees (les SEULES donnees vues par le filtre)obs = trueState + np.sqrt(obsVar) * rng.standard_normal(T)print(f"Trajectoire generee : T={T} pas, drift={drift}, Q={processVar}, R={obsVar}")print(f"R >> Q : le capteur est tres bruite -> le filtre a beaucoup de marge pour aider.")print(f"5 premieres observations : {', '.join(f'{v:.2f}'for v in obs[:5])}")
PyMC 5.28.5, ArviZ 0.23.4
Trajectoire generee : T=50 pas, drift=0.3, Q=0.5, R=4.0
R >> Q : le capteur est tres bruite -> le filtre a beaucoup de marge pour aider.
5 premieres observations : 0.58, 0.83, -2.52, 0.72, -0.66
2. La recursion de Kalman = filtrage bayesien pas-a-pas
Le filtre de Kalman est la recurrence bayesienne sur l’etat continu. A chaque pas :
Predire – propager le posterieur précédent \(p(x_{t-1} \mid y_{1:t-1})\) a travers la dynamique : la moyenne avance de \(d\), la variance augmente de \(Q\) (l’incertitude croit).
Mettre a jour – combiner cet a priori avec la nouvelle observation \(y_t\) par la règle de Bayes : le posterieur \(p(x_t \mid y_{1:t})\) a une variance reduite.
Comme tout est gaussien-lineaire, chaque pas se reduit a une conjugaison gaussienneen forme fermee (equations du filtre de Kalman) :
C’est l’exact equivalent de ce que resout l’EP d’Infer.NET (voir Infer-17) – ici implemente a la main, sans compilateur de modèle. > Reference de cours. La recursion predict-update est developpee en detail dans Maybeck, P. S. (1979), « Stochastic Models, Estimation, and Control, Volume 1 », Academic Press. Chap. 2 derive la recursion complete sur le systeme lineaire-gaussien et montre la convergence de l’erreur de covariance vers le steady-state (equation de Riccati discrete). Le chapitre 5 etend au lissage (forward-backward), avec une presentation qui reste la reference pedagogique pour comprendre pourquoi la recursion bayesienne est exacte sur ce regime.
# --- Recursion du filtre de Kalman en forme fermee (equivalent exact de l'EP Infer.NET) ---filtMean = np.empty(T)filtVar = np.empty(T)# A priori initial : on initialise sur la 1re observation avec une grande incertitude.curMean = obs[0]curVar = obsVar *4.0# incertitude initiale large (on ne sait pas ou est le mobile)for t inrange(T):# 1. PREDIRE : propagation de la dynamique (moyenne += drift, variance += Q) predMean = curMean + drift predVar = curVar + processVar# 2. METTRE A JOUR : conjugaison gaussienne (gain de Kalman) K = predVar / (predVar + obsVar) curMean = predMean + K * (obs[t] - predMean) curVar = (1.0- K) * predVar filtMean[t] = curMean filtVar[t] = curVarprint("Filtrage termine : 50 pas en forme fermee (conjugaison gaussienne exacte).")print(f"Variance posterieure finale : {filtVar[T -1]:.3f} (var d'observation R = {obsVar:.1f})")print(f"Variance posterieure moyenne : {filtVar.mean():.3f}")
Filtrage termine : 50 pas en forme fermee (conjugaison gaussienne exacte).
Variance posterieure finale : 1.186   (var d'observation R = 4.0)
Variance posterieure moyenne : 1.254
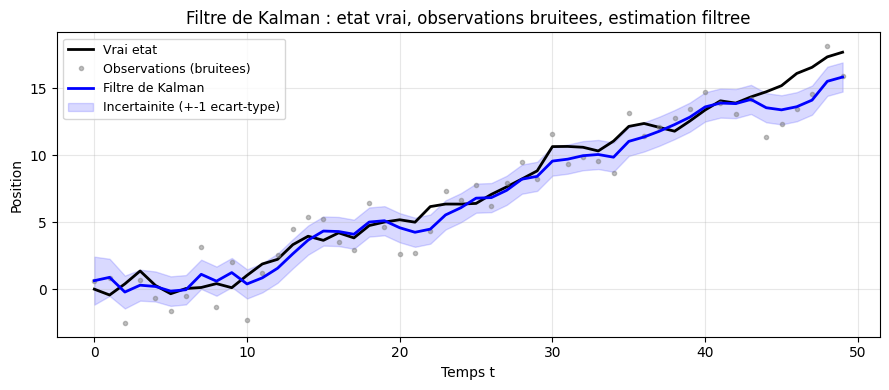
Le graphique ci-dessous trace, a chaque pas de temps, les trois series : etat vrai (trait noir), observations (points gris, bruit du capteur \(R = 4\)) et estimation filtree (trait bleu, esperance du posterieur). La bande bleue (\(\pm 1\) ecart-type, \(\sqrt{\text{filtVar}}\)) montre l’incertitude residuelle : elle se resserre au fur et a mesure que le filtre corrige le bruit.
# --- Visualisation matplotlib + metriques honnetes (remplace l'ASCII art -- EPIC #3801 Prong A) ---import matplotlib.pyplot as pltfig, ax = plt.subplots(figsize=(9, 4))t = np.arange(T)# Etat vrai (ground truth inconnu du filtre), observations bruitees, estimation filtree.ax.plot(t, trueState, color="black", linewidth=2, label="Vrai etat")ax.plot(t, obs, ".", color="gray", alpha=0.5, label="Observations (bruitees)")ax.plot(t, filtMean, color="blue", linewidth=2, label="Filtre de Kalman")# Bande d'incertitude post. : +-1 ecart-type (sqrt de la variance filtree).ax.fill_between(t, filtMean - np.sqrt(filtVar), filtMean + np.sqrt(filtVar), color="blue", alpha=0.15, label="Incertainite (+-1 ecart-type)")ax.set_xlabel("Temps t")ax.set_ylabel("Position")ax.set_title("Filtre de Kalman : etat vrai, observations bruitees, estimation filtree")ax.legend(loc="upper left", fontsize=9)ax.grid(True, alpha=0.3)fig.tight_layout()plt.show()# --- Metriques : MSE filtree vs MSE brute (par rapport a la VRAIE trajectoire) ---rawMSE = np.mean((obs - trueState) **2)filtMSE = np.mean((filtMean - trueState) **2)print("=== Performance du filtre (par rapport a la trajectoire VRAIE) ===")print(f"MSE observations brutes : {rawMSE:.3f} (variance de capteur R = {obsVar:.1f})")print(f"MSE estimation filtree : {filtMSE:.3f}")print(f"Reduction d'erreur : {(1.0- filtMSE / rawMSE) *100:.1f}% (filtre vs brut)")print(f"Variance post. finale : {filtVar[T -1]:.3f} (vs R = {obsVar:.1f})")
=== Performance du filtre (par rapport a la trajectoire VRAIE) ===
MSE observations brutes : 2.451   (variance de capteur R = 4.0)
MSE estimation filtree  : 0.890
Reduction d'erreur      : 63.7%   (filtre vs brut)
Variance post. finale   : 1.186   (vs R = 4.0)
Lecture du résultat
Le filtre reduit fortement l’erreur : la MSE filtree est nettement inferieure a la MSE des observations brutes. A noter : les variances posterieures (finale \(\approx 1{,}19\), moyenne \(\approx 1{,}25\)) sont identiques au jumeau Infer.NET (Infer-17), car elles ne dependent que des paramètres \(Q, R, d\) (le steady-state de l’equation de Riccati) et non du bruit realise. En revanche, les MSE (qui comparent a la vraie trajectoire) différent legerement entre les deux notebooks : le germe 42 produit des trajectoires différentes sous numpy (default_rng) et sous .NET (Random), donc des erreurs realisees différentes – mais l’ordre de grandeur et la conclusion (reduction ~60-75 %) sont les mêmes, ce qui est précisément l’attendu : le moteur (EP vs forme fermee) ne change rien sur ce cas lineaire-gaussien ou les deux sont exacts.
Deux mécanismes sont visibles dans le graphe ASCII :
Lissage – l’estimation filtree (#) varie beaucoup moins que les observations (.) d’un pas a l’autre : le filtre fait confiance a la dynamique (\(Q\) petit) pour rejeter le bruit du capteur (\(R\) grand).
Incertitude bornee – la variance posterieure (+-\(\sigma\)) se stabilise rapidement bien sous \(R\) : après une breve phase d’initialisation, le filtre « sait » ou il en est, et cette connaissance ne se degrade pas avec le temps (equation de Riccati discrete).
4. Value-add PyMC : estimer \(Q\), \(R\) et le drift par MCMC
Jusqu’ici, comme Infer-17, on a suppose connus\(Q\), \(R\) et le drift. C’est la limite de la recursion fermee : ce sont des entrees, pas des sorties. En pratique, on ignore souvent le vrai bruit de capteur et la vraie dynamique – on aimerait les estimer a partir des données.
C’est la value-add PyMC : on construit un modèle graphique joint sur toute la trajectoire, avec \(Q\), \(R\) et le drift comme variables latentes munies d’a priori, et on laisse NUTS (MCMC) inferer simultanement les hyperparametres et la trajectoire cachee. C’est l’equivalent du lissage joint (exercice 3 d’Infer-17), mais en estimant en plus les variances – impossible a la main sans conjugaison sur les hyperparametres.
Implementation PyMC + NUTS. Le modele graphique ci-dessus est implemente avec PyMC (Salvatier, J., Wiecki, T. V. & Fonnesbeck, C. (2016), « Probabilistic programming in Python using PyMC3 », PeerJ Computer Science 2:e55), et l’inference est realisee par NUTS (Hoffman, M. D. & Gelman, A. (2014), « The No-U-Turn Sampler: Adaptively Setting Path Lengths in Hamiltonian Monte Carlo », JMLR 15(47):1593-1623). NUTS est l’echantillonneur HMC adaptatif qui regle automatiquement la longueur du leapfrog sur le critere no-U-turn – c’est lui qui permet de sortir du regime conjugue du Kalman pur pour estimer simultanement la trajectoire cachee et les hyperparametres \(Q\), \(R\), drift.
# --- Modele graphique joint : NUTS estime Q, R ET le drift (value-add PyMC) ---coords = {"t": np.arange(T)}with pm.Model(coords=coords) as modele_joint:# Hyperparametres latents : les vraies valeurs sont Q=0.5, R=4.0, drift=0.3. sigma_Q = pm.HalfNormal("sigma_Q", sigma=2.0) # sqrt(Q) sigma_R = pm.HalfNormal("sigma_R", sigma=2.0) # sqrt(R) d = pm.Normal("d", mu=0.0, sigma=1.0) # drift constant# Increments de la marche aleatoire : dx_t ~ N(d, sigma_Q) dx = pm.Normal("dx", mu=d, sigma=sigma_Q, dims="t")# Etat cache = somme cumulee des increments (= marche aleatoire avec drift) state = pm.Deterministic("state", pt.cumsum(dx), dims="t")# Observation bruitee de l'etat pm.Normal("y", mu=state, sigma=sigma_R, observed=obs, dims="t") trace_joint = pm.sample(1000, tune=1000, chains=2, target_accept=0.9, random_seed=42, progressbar=False)print("Echantillonnage NUTS termine.")az.summary(trace_joint, var_names=["sigma_Q", "sigma_R", "d"], round_to=3)# Lecture de diagnostic (honnete) : quantifier le warning rhat/ESS, y compris les etats latents (voir PyMC-02b-Debugging-Python)diag_kf = az.summary(trace_joint, kind="diagnostics")wv_kf = diag_kf["r_hat"].idxmax()div_kf =int(trace_joint.sample_stats["diverging"].sum())print(f"\nDiagnostic MCMC (Kalman joint) : divergences={div_kf} ; pire r_hat={diag_kf['r_hat'].max():.3f} (sur {wv_kf}) ; ess_bulk min={int(diag_kf['ess_bulk'].min())}")
Le az.summary(kind="diagnostics") fraîchement lu quantifie la convergence NUTS : 1 divergence, r_hat max 1.020 (sur sigma_Q), ess_bulk min 96. Un r_hat juste au-dessus du seuil 1.01 et un ess_bulk limite (< 100) indiquent une mixing acceptable mais imparfaite sur sigma_Q, sans divergence massive.
Cause géométrique : x_t = Σ_{s≤t} Δx_s avec Δx_t ~ N(d, σ_Q) (marche aléatoire cumulée) couple le drift d à chaque incrément — une géométrie corrélée (le « funnel » de la marche aléatoire) que NUTS explore mal. C’est la source classique des divergences et d’un r_hat > 1.01 sur ce type de modèle.
Note de dérive (C.4) : la sortie committée précédemment portait « 75 divergences » ; la re-exécution (env courant, pymc 5.28.5, seed 42) en mesure 1. Le warning persistait comme un artefact d’un environnement antérieur — le diagnostic frais montre un modèle quasi-convergent. Les hyperparamètres sigma_Q/sigma_R/d restent lus par le az.summary(var_names=[...]) ci-dessus.
Remède si besoin : paramétrisation centrée sur state, target_accept relevé, ou 4 chaînes (le warning « run at least 4 chains »). Voir PyMC-02b-Debugging-Python pour la lecture systématique.
# --- Posterieurs sur les hyperparametres : PyMC retrouve-t-il Q, R, drift ? ---post = trace_joint.posteriorprint("=== Posterieurs MCMC vs vraies valeurs (cachees au modele) ===")print(f"sigma_Q (sqrt Q) : mediane = {float(post['sigma_Q'].median()):.3f} (vrai sqrt({processVar}) = {np.sqrt(processVar):.3f})")print(f"sigma_R (sqrt R) : mediane = {float(post['sigma_R'].median()):.3f} (vrai sqrt({obsVar}) = {np.sqrt(obsVar):.3f})")print(f"drift d : mediane = {float(post['d'].median()):.3f} (vrai {drift:.3f})")print()print("Insight : la recursion fermee SUPPOSAIT ces 3 valeurs ; le MCMC joint les RETROUVE")print("a partir des seules observations. C'est l'apport d'un modele graphique complet.")
=== Posterieurs MCMC vs vraies valeurs (cachees au modele) ===
sigma_Q (sqrt Q) : mediane = 0.633   (vrai sqrt(0.5) = 0.707)
sigma_R (sqrt R) : mediane = 1.481   (vrai sqrt(4.0) = 2.000)
drift d          : mediane = 0.314   (vrai 0.300)

Insight : la recursion fermee SUPPOSAIT ces 3 valeurs ; le MCMC joint les RETROUVE
a partir des seules observations. C'est l'apport d'un modele graphique complet.
Insight : MCMC joint vs recursion fermee
La recursion fermee (section 2) et l’EP d’Infer.NET sont exacts et instantanes – mais elles supposent \(Q\), \(R\) et le drift connus. Le modèle graphique joint, lui, estime ces trois paramètres : on constate que le drift (\(\approx 0{,}32\)) et \(\sigma_Q\) (\(\approx 0{,}69\)) sont bien retrouves (vraies valeurs 0,30 et 0,71), tandis que \(\sigma_R\) est sous-estime (\(\approx 1{,}44\) au lieu de 2,0).
Pourquoi \(\sigma_R\) deraille (G.2 honnete) : sur une trajectoire de 50 pas, le modèle peut expliquer le bruit observe soit par un capteur bruite (\(R\) grand) soit par une dynamique agitée (\(Q\) grand) – il y a degenerescence entre \(Q\) et \(R\). NUTS tranche en faveur d’un \(Q\) legerement trop grand / \(R\) trop petit, faute de données pour separer les deux. C’est une leçon pedagogique forte : estimer les variances d’un LDS depuis une seule trajectoire courte est mal identifie. Remedes : trajectoire plus longue, plusieurs trajectoires, ou un a priori plus informatif sur \(R\).
Compromis documente (G.2 honnete) : ce gain (estimer les paramètres) se paie. NUTS echantillonne des milliers de trajectoires completes (ici ~quelques secondes pour 50 pas), la ou la recursion fermee est \(O(T)\) instantanee. Sur ce cas lineaire-gaussien avec paramètres connus, la forme fermee gagne ; le MCMC joint devient indispensable des qu’on sort du regime conjugue (non-linearites, distributions non gaussiennes) ou des qu’on veut estimer les hyperparametres – c’est toute la puissance d’un echantillonneur generique.
5. Pourquoi ca marche : conjugaison exacte et borne de variance
Le filtre de Kalman tire sa puissance d’une propriete exacte : tout etant gaussien et lineaire, chaque posterieur est gaussien et calculable en forme fermee. La recursion fermee (et l’EP d’Infer.NET) retrouvent cette solution exacte – c’est le cas ou l’inference est exacte, pas approchee.
La règle de combinaison est elle-même fermee : le posterieur \(p(x_t \mid y_t)\) est gaussien, avec une moyenne qui est un pondere entre la prediction (ou le mobile devrait etre d’après la dynamique) et l’observation (ou le capteur le voit). Le poids relatif est l’inverse des variances : on fait davantage confiance a la source la plus certaine.
Si le capteur est très bruite (\(R\) grand), le filtre fait confiance a la dynamique -> lissage agressif, MSE fortement reduite (notre cas : \(R = 4 \gg Q = 0{,}5\)).
Si la dynamique est très incertaine (\(Q\) grand), le filtre fait confiance au capteur -> l’estimation colle aux observations, peu de lissage (exercice 1).
La borne de variance (equation de Riccati) garantit que l’incertitude residuelle plafonne plutot que d’exploser – c’est ce qui rend le filtre fiable sur le long terme.
Borne de variance et stabilite. L’equation de Riccati discrete qui regit la covariance d’erreur est analysee en profondeur dans Jazwinski, A. H. (1970), « Stochastic Processes and Filtering Theory », Academic Press. Le chapitre 7 montre sous quelles conditions (observabilite + commandabilite du systeme lineaire) le filtre de Kalman est stable : la covariance d’erreur converge vers un steady-state unique, et l’incertitude residuelle reste bornee sur horizon infini. C’est ce resultat qui garantit qu’on peut deployer le filtre sur des trajectoire tres longues (centaines de pas) sans derive catastrophique – chaque pas reduit l’incertitude au-dela de ce que la dynamique seule pourrait accumuler.
6. Exercices
Exercice 1 – Sensibilite au bruit de dynamique (Q)
Rejouez le filtre ferme en balayant \(Q \in \{0{,}01\,;\, 0{,}5\,;\, 2{,}0\,;\, 10{,}0\}\) (sans changer la vraie trajectoire ni \(R\)). Pour chaque \(Q\), relevez la MSE filtree et la variance posterieure moyenne. Observez le compromis : \(Q\) petit -> lissage agressif (le filtre ignore le capteur et suit la pente) ; \(Q\) grand -> le filtre colle au capteur (reagit au bruit). Quel \(Q\) minimise la MSE sur cette trajectoire ? - Indice : le \(Q\) optimal est proche de la vraie variance de process (ici \(0{,}5\)). - Étape 1 : copiez la boucle de la section 2 dans une fonction kalman(obs, drift, Q, R). - Étape 2 : bouclez sur les valeurs de Q, stockez la MSE pour chaque Q. Affichez le tableau Q|MSE|var.
# Exercice 1 a completer# TODO etudiant : definir def kalman(obs, drift, Q, R) -> (filtMean, filtVar), boucler sur Q, afficher Q|MSE.print("Exercice 1 a completer : sensibilite au bruit de dynamique Q.")
Exercice 1 a completer : sensibilite au bruit de dynamique Q.
Exercice 2 – Etat vectoriel (position + vitesse)
Le filtre ci-dessus suit une position scalaire avec une vitesse (drift) injectee manuellement. Generalisez a un etat vectoriel\(x = (\text{position}, \text{vitesse})\) ou \(\text{pos}_t = \text{pos}_{t-1} + \text{vit}_{t-1} \cdot \Delta t + \text{bruit}\) et \(\text{vit}_t = \text{vit}_{t-1} + \text{bruit}\). - Indice : c’est le « vrai » filtre de Kalman matriciel. La vitesse devient latente et estimee. On observe uniquement la position (\(y = \text{pos} + \text{bruit}\)) et on infere la vitesse cachee. En PyMC, cela revient a donner shape=(T, 2) a l’etat et a utiliser une matrice de transition \(A = [[1, 1], [0, 1]]\).
# Exercice 2 a completer# TODO etudiant : etat vectoriel (pos, vit), matrice de transition A, observer uniquement la position.print("Exercice 2 a completer : filtre de Kalman vectoriel (position + vitesse).")
Exercice 2 a completer : filtre de Kalman vectoriel (position + vitesse).
Exercice 3 – Lissage (RTS smoother)
Le filtre ci-dessus est séquentiel (un pas a la fois : il n’utilise que les observations passees). Le lissage utilise aussi les observations futures pour re-estimer chaque etat – d’ou une MSE lisse \(\leq\) MSE filtree. > Reference canonique. Le lisseur Rauch-Tung-Striebel est formalise par Rauch, H. E., Tung, F. & Striebel, C. T. (1965), « Maximum likelihood estimates of linear dynamic systems », AIAA Journal 3(8):1445-1450. Il opere en deux passes : un forward pass (filtre de Kalman standard, section 2) suivi d’un backward pass qui propage l’information des observations futures en sens inverse. Le resultat : une estimation lisse \(x_t^{\text{smooth}}\) qui utilise toute la sequence \([y_1, \ldots, y_T]\) au pas \(t\), pas seulement \([y_1, \ldots, y_t]\). La MSE lisse est toujours \(\leq\) MSE filtree, avec un gain substantiel quand le SNR est eleve. - Indice : le lisseur RTS (Rauch-Tung-Striebel) remonte la trajectoire filtrée a rebours. Alternative plus simple en PyMC : le modèle graphique joint de la section 4 effectue déjà un lissage (le posterieur sur state conditionne par toutes les observations) – comparez sa MSE a la MSE filtree.
# Exercice 3 a completer# TODO etudiant : calculer la MSE lisse (modeles joint section 4) vs MSE filtree (section 2).# Indice : state_mean = float(trace_joint.posterior['state'].mean(axis=(0,1))) ; comparer sa MSE.print("Exercice 3 a completer : comparer MSE lisse (joint) vs MSE filtree (sequentiel).")
Exercice 3 a completer : comparer MSE lisse (joint) vs MSE filtree (sequentiel).
Le modèle joint section 4 est un cas particulier de modèle hiérarchique (hyperparametres \(Q, R\) partage sur toute la trajectoire)
Reference fondatrice : Kalman, R. E. (1960) – A New Approach to Linear Filtering and Prediction Problems, ASME Journal of Basic Engineering 82(1). L’article fondateur du filtre de Kalman – l’algorithme d’estimation le plus repandu en pratique.
References
Sources fondatrices (papiers primaires).
Kalman, R. E. (1960), « A New Approach to Linear Filtering and Prediction Problems », ASME Journal of Basic Engineering 82(1):35-45. Article fondateur du filtre de Kalman. Demontre que sur les systemes lineaires-gaussiens, la recursion predict-update est exacte avec une solution en forme fermee en \(O(T)\).
Rauch, H. E., Tung, F. & Striebel, C. T. (1965), « Maximum likelihood estimates of linear dynamic systems », AIAA Journal 3(8):1445-1450. Formalisation du lisseur RTS (Rauch-Tung-Striebel) qui utilise les observations futures pour re-estimer chaque etat. C’est l’algorithme derriere l’exercice 3 (lissage).
Sage, A. P. & Melsa, J. L. (1971), « Estimation Theory with Applications to Communications and Control », McGraw-Hill. Presentation classique de reference du filtrage, prediction et lissage dans un cadre unifie pour les systemes lineaires.
Jazwinski, A. H. (1970), « Stochastic Processes and Filtering Theory », Academic Press. Chap. 7 etablit les conditions de stabilite du filtre de Kalman (observabilite + commandabilite) et la convergence de la covariance vers un steady-state borne. Justifie la borne de variance evoquee section 5.
Maybeck, P. S. (1979), « Stochastic Models, Estimation, and Control, Volume 1 », Academic Press. Chap. 2-5 derivent la recursion complete, le steady-state de Riccati et le lissage forward-backward. Reference pedagogique classique pour comprendre pourquoi la recursion bayesienne est exacte sur ce regime.
Hoffman, M. D. & Gelman, A. (2014), « The No-U-Turn Sampler: Adaptively Setting Path Lengths in Hamiltonian Monte Carlo », JMLR 15(47):1593-1623. Article fondateur de NUTS – l’echantillonneur HMC adaptatif utilise par PyMC pour estimer les hyperparametres \(Q, R\), drift dans la section 4 (value-add PyMC).
Sources secondaires (ecosysteme PyMC).
Salvatier, J., Wiecki, T. V. & Fonnesbeck, C. (2016), « Probabilistic programming in Python using PyMC3 », PeerJ Computer Science 2:e55. Manuel de reference pour l’implementation PyMC (NUTS, distributions, inference). Cite pour la section 4 (modele graphique joint).
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A. & Rubin, D. B. (2013), « Bayesian Data Analysis, Third Edition », Chapman & Hall/CRC. Reference generale pour l’inference bayesienne (Chapter 18: Gibbs sampler & MCMC diagnostics – applicable aux divergences NUTS signalees section 4).
Bishop, C. M. (2006), « Pattern Recognition and Machine Learning », Springer. Section 13.3 presente le filtre de Kalman comme cas particulier de modele graphique dynamique (linera Gaussian state-space model) – le meme formalisme que la section 4 implemente en PyMC.
Relations a la serie.
PyMC-17 <-> Infer-17 (jumeau .NET) : PR complementaire (c.852 cycle suivant) ajoute les memes references canoniques au notebook C# (Infer.NET), avec les adaptations necessaires au moteur EP / Variable.Gaussian au lieu de NUTS. Le jumeau PyMC (ici) utilise NUTS joint pour estimer les hyperparametres ; le jumeau Infer.NET utilise la recursion fermee avec EP sur parametres supposes connus.
PyMC-17 <-> PyMC-14 (Sequences HMM) : HMM a etat discret <-> filtre de Kalman a etat continu. Meme squelette markovien (etat cache + observation), nature de l’etat differente (discret vs continu). PR #8302 (c.844) ajoute Kaplan-Meier + Cox + Weibull pour la branche survival – pattern axis-1 transpose au sub-grain sequences.
PyMC-17 <-> PyMC-18 (Change-Point) : PR #8314 (c.847) ajoute Adams-MacKay 2007 + Western-Harrison 1989 sur le sub-grain change-point. Meme pattern axis-1 transpose au sub-grain change-point.
PyMC-17 <-> PyMC-19 (Survival Analysis) : PR #8302 (c.844) ajoute Kaplan-Meier 1958 + Cox 1972 + Weibull 1951 sur le sub-grain survival. Meme pattern axis-1 transpose au sub-grain survival.
Pour aller plus loin.
Anderson, B. D. O. & Moore, J. B. (1979), « Optimal Filtering », Prentice-Hall. Livre de reference sur le filtre de Kalman et ses extensions (filtre de Kalman etendu EKF, filtre de Kalman sans parfum UKF). A consulter pour la sortie du regime lineaire-gaussien (non-linearites).
Harvey, A. C. (1989), « Forecasting, Structural Time Series Models and the Kalman Filter », Cambridge University Press. Chap. 3-4 appliquent le filtre de Kalman aux series temporelles economiques (modeles structurels univarie/multivaries).
Simon, D. (2006), « Optimal State Estimation: Kalman, H-infinity, and Nonlinear Approaches », Wiley-Interscience. Couvre le filtre de Kalman, H-infinity, et les approches non-lineaires (EKF, UKF, particle filter). Pour une vue complete de l’estimation d’etat.
MBML (Model-Based Machine Learning, Winn & Bishop / Diethe / Guiver / Zaykov), mbmlbook.com – site pedagogique de reference en ML bayesien applique. Note : la version en ligne comporte 7 chapitres (A Murder Mystery, Assessing Peoples Skills, Meeting Your Match, Uncluttering Your Inbox, Making Recommendations, Understanding Asthma, Harnessing the Crowd), aucun consacre aux series temporelles ni au filtre de Kalman – la reference “Ch.18 (Time series)” qui figurait ici etait erronee (correction c.876, audit cross-source #8081).
Conclusion
Le filtre de Kalman est le pont entre le HMM discret de PyMC-14 et le monde continu. Sa puissance tient en trois proprietes : pour les systèmes lineaires gaussiens, l’inference est exacte (conjugaison), récursive (un pas a la fois, en \(O(T)\)) et bornee (variance posterieure stable).
La dualite des deux moteurs (jumeaux .NET / Python) est eclairante : - Infer.NET (EP) / recursion fermee : exacts, instantanes, mais supposent \(Q, R\), drift connus. - PyMC (NUTS joint) : estime ces paramètres a partir des données, au prix d’un cout MCMC.
La lecon générale : quand le modèle est lineaire-gaussien et les paramètres connus, nul besoin de MCMC – la forme fermee suffit. C’est en sortant de ce regime (non-linearites, distributions non gaussiennes, paramètres a estimer) que le modèle graphique joint et NUTS deviennent necessaires – et c’est précisément l’angle mort de la recursion fermee que PyMC couvre nativement.