ML - Machine Learning
À propos des décomptes : le marqueur
CATALOG-STATUSci-dessus est la source de vérité autoritative pour les volumes (notebooks par sous-série, maturité). Il est régénéré chaque nuit par le workflowcatalog-cron.ymlà 03:37 UTC surmain(commit[skip ci]pargithub-actions[bot]). Si vous observez un décalage entre ce marqueur et une phrase en prose de ce README — par exemple si une sous-série a reçu de nouveaux notebooks mergés après la dernière régénération —, fiez-vous au marqueur ; la prose sera ré-alignée manuellement lors du prochain passage. Pour les décomptes par kernel (Python vs C#/.NET) au sein d’une sous-série, ce README reste autoritatif car la décomposition langagière par sous-série n’est pas dans le marqueur agrégé.
← Notebooks | ML.NET (C#) → | Data Science with Agents (Python) → | RL →
Le monde regorge de données, mais les transformer en décisions éclairées demande plus qu’un tableur. Le Machine Learning offre un cadre systématique pour construire des modèles prédictifs à partir de données, en allant de la régression linéaire aux réseaux de neurones en passant par les systèmes de recommandation. Cette série vous forme au ML pratique avec trois fils complémentaires : ML.NET pour l’écosystème .NET/C#, Python Data Science with Agents pour les pipelines modernes enrichis de LLMs, et les jumeaux de parité qui confrontent un même concept aux deux écosystèmes.
Pourquoi cette série
Le Machine Learning est partout : recommandations Netflix, détection de spam, prévisions de vente, diagnostic médical. Mais passer de la théorie à la pratique reste un saut difficile. Cette série comble ce gap en proposant trois angles d’attaque :
- ML.NET (C#/.NET) : Pour les développeurs déjà familiers avec l’écosystème .NET, ML.NET offre un pipeline ML natif en C#. Pas besoin d’apprendre Python pour faire du ML en entreprise. Les notebooks couvrent le pipeline complet, de
IDataViewau déploiement ONNX, avec une évaluation rigoureuse par cross-validation. - Python + AI Agents : Pour les data scientists et praticiens IA, le track Python combine les fondamentaux (NumPy, Pandas, scikit-learn) avec les agents LLM (LangChain, Google ADK). C’est le futur du data science workflow : l’automatisation par des agents capables de nettoyer, analyser et modéliser des données.
- Jumeaux de parité (C# ⇄ Python/scikit-learn) : Pour saisir que les concepts ML sont universels, plusieurs notebooks avancés de la série ML.NET disposent d’un jumeau Python co-localisé (
*-Python.ipynb) qui traite le même problème avec les outils canoniques Python (détection d’anomaliesRandomizedPca↔︎PCA+résidu, recommandationMatrixFactorization↔︎NMF, séries temporellesForecastBySsa↔︎STL+SARIMA). Voir la feuille ML.NET.
Avoir ces trois angles permet de comprendre que le ML n’est pas lié à un langage : les concepts (features, entraînement, évaluation, généralisation) sont universels, seuls les outils diffèrent.
Applications réelles couvertes : prévisions de ventes (régression bayésienne), systèmes de recommandation (collaborative filtering), séries temporelles (forecasting), analyse de CV (NLP + agents), compétitions Kaggle (MLE-STAR pipeline).
Public cible
| Section | Audience | Prérequis |
|---|---|---|
| ML.NET | Développeurs C#/.NET, environnements enterprise | C# base, .NET SDK 9.0+ |
| Python Data Science (Days 1-3) | Analystes, data scientists, débutants-intermédiaires | Python base, Jupyter |
| AI Agents (Days 4-7) | Praticiens IA souhaitant intégrer LLMs | Days 1-3 ou expérience équivalente |
Positionnement pédagogique
Cette série sert les cours d’introduction au Machine Learning appliqué. Elle se situe après les fondamentaux de programmation (Python ou C#) et avant les séries spécialisées (QuantConnect pour le trading, RL pour l’apprentissage par renforcement). Aucun prérequis en statistiques avancées : les concepts sont introduits au fil des notebooks.
Slides de cours associés : 06-apprentissage/ | Livre de référence : Hands-On AI Trading (chapitres ML)
Objectifs d’apprentissage
À l’issue de cette série, vous serez capable de :
- Construire un pipeline ML complet (chargement, features, entraînement, évaluation) en C# ou Python
- Évaluer rigoureusement un modèle (cross-validation, métriques, Permutation Feature Importance, surapprentissage)
- Appliquer le feature engineering adapté au problème (encodage, normalisation, sélection de variables)
- Intégrer des agents LLM dans un workflow data science (analyse automatisée, parsing, recommandation)
- Déployer un modèle en production (export ONNX, interop Python/.NET, BigQuery ML)
Figures — extraites des sorties réelles des notebooks
Six figures illustrent les trois fils de la série : les fondations Python (Pandas, visualisation), le pipeline ML.NET (régression, séries temporelles, clustering) et l’angle émergent des agents data-science (Google ADK). Elles sont réintégrées in-situ dans les sections qui en commentent le concept — chacune en regard du notebook qu’elle illustre. La provenance exacte (cellule source, poids, alt-text) figure dans assets/readme/MANIFEST.md.
Parcours d’apprentissage
Track A : ML.NET (.NET/C#, parcours ML-1 à ML-9 + TP capstone, et leurs jumeaux Python scikit-learn, ~7h)
Le parcours ML.NET couvre le pipeline complet en C# : les notebooks 1-2 introduisent ML.NET et la préparation de données (IDataView, encodage). Le notebook 3 couvre l’entraînement (SDCA, LightGBM, AutoML) — son leaderboard AutoML (cell 12-13) rend visible la discrimination entre entraîneurs : sur données quadratiques, LightGbmRegression gagne avec un RMSE de 90 262 contre 30,5 millions pour FastTreeRegression, soit un écart de plus de 300× qu’aucun tableau Console.WriteLine ne fait ressortir. Le notebook 4 est crucial : évaluation rigoureuse par cross-validation et Permutation Feature Importance. Les notebooks 5-7 abordent les séries temporelles, l’export ONNX pour la production, et les systèmes de recommandation. Les notebooks 8-9 ouvrent sur l’apprentissage non-supervisé : clustering K-Means (segmentation RFM, méthode du coude) puis détection d’anomalies par Randomized PCA (maintenance prédictive, choix du seuil de décision). Le TP final (prévision de ventes) combine ML.NET et Infer.NET pour une régression bayésienne. Ce track présuppose .NET 9.0 + dotnet-interactive.
Track B : Data Science with Agents (Python, ~21h)
Le parcours Python s’articule en trois temps. Les fondations (NumPy/Pandas) installent la manipulation de données. Le socle ML canonique (02-ML-Cours, scikit-learn) pose ensuite les concepts fondamentaux — workflow et surapprentissage, descente de gradient, régressions et pont génératif, ensembles, biais-variance/calibration/équité, non supervisé, théorie PAC et ses compagnons formels, grokking, puis optimisation d’hyperparamètres, régularisation sparse et classes déséquilibrées — chacun rendant visible un concept-phare et ancrant un article fondateur. Viennent enfin les labs agentic, en deux sous-tracks : le sous-track LangChain (Labs 1-7) couvre le data wrangling, la visualisation, le ML classique et le NLP de base ; le sous-track Google ADK (Labs 8-18, extensions 12b-12d) monte en complexité avec le deep learning (PyTorch), le dashboarding et les pipelines multi-agents (agents LLM pour automatiser le workflow data science). Deux volets spécialisés complètent le parcours : 03-DeepLearning (PyTorch) et 04-Vision (dont le transfer learning ResNet). Ce track présuppose Python 3.10+ avec PyTorch, scikit-learn et pandas.
Progression recommandée
Parcours Data Scientist classique (~12h)
Parcours AI Agent Builder (~15h)
- Days 1-3 (Labs 1-7) : Data Science + LangChain
- Days 4-7 (Labs 8-18) : Google ADK + multi-agents
- Projets finaux : Kaggle + BigQuery
Parcours Enterprise .NET (~6h)
- ML-1 à ML-4 : fondamentaux ML.NET
- ML-5 : séries temporelles
- ML-6 : interop Python → .NET
- TP-prevision-ventes : projet intégré
Quel parcours choisir
| Profil | Parcours recommandé | Durée |
|---|---|---|
| Développeur C#/.NET en entreprise | Track A : ML.NET (ML-1 à ML-4 + TP) | ~6h |
| Data scientist débutant | Track B (Days 1-3) : Python + scikit-learn | ~8h |
| Praticien IA souhaitant automatiser | Track B complet : Python + Agents (Days 1-7) | ~17h |
| Curieux voulant comparer les approches | ML.NET (ML-1 à ML-4) + Python (Labs 1-5) | ~10h |
Structure
ML/
├── ML.Net/                           # Tutoriels ML.NET (C#)
│   ├── ML-1-Introduction.ipynb
│   ├── ML-1-Introduction-Python.ipynb   # jumeau scikit-learn (regression/logistique) ⇄ ML.NET pipeline
│   ├── ML-2-Data&Features.ipynb
│   ├── ML-2-Data&Features-Python.ipynb   # jumeau scikit-learn (ColumnTransformer) ⇄ IDataView/Transforms
│   ├── ML-3-Entrainement&AutoML.ipynb
│   ├── ML-3-Entrainement-Python.ipynb   # jumeau scikit-learn (SDCA/LightGBM ⇄ Linear/GradientBoosting)
│   ├── ML-4-Evaluation.ipynb
│   ├── ML-4-Evaluation-Python.ipynb   # jumeau scikit-learn (cross_val_score + permutation_importance) ⇄ cross-validation/PFI
│   ├── ML-5-TimeSeries.ipynb
│   ├── ML-5-TimeSeries-Python.ipynb   # jumeau scikit-learn (STL+SARIMA) ⇄ ForecastBySsa
│   ├── ML-6-ONNX.ipynb
│   ├── ML-6-ONNX-Python.ipynb   # jumeau skl2onnx+onnxruntime ⇄ OnnxTransformer
│   ├── ML-7-Recommendation.ipynb
│   ├── ML-7-Recommendation-Python.ipynb   # jumeau scikit-learn (NMF) ⇄ MatrixFactorization
│   ├── ML-8-Clustering.ipynb
│   ├── ML-8-Clustering-Python.ipynb   # jumeau scikit-learn (KMeans) ⇄ K-Means ML.NET
│   ├── ML-9-Anomaly-Detection.ipynb
│   ├── ML-9-Anomaly-Detection-Python.ipynb   # jumeau scikit-learn (PCA+résidu) ⇄ RandomizedPca
│   ├── TP-prevision-ventes.ipynb
│   └── taxi-fare.csv
│
├── DataScienceWithAgents/            # Data Science Python + AI Agents
│   ├── 01-PythonForDataScience/      # Fondations NumPy/Pandas
│   ├── 02-ML-Cours/                  # Socle ML canonique (scikit-learn)
│   │   ├── 2.8b-Theorie-PAC-Lean.ipynb   # compagnon Lean (lean4-wsl) du lake learning_theory_lean (moitie PAC)
│   │   └── 2.8d-Lean-Novikoff-Convergence.ipynb   # compagnon Lean (lean4-wsl) du lake learning_theory_lean (moitie Perceptron)
│   ├── 03-DeepLearning/              # Deep learning PyTorch
│   ├── 04-Vision/                    # Vision par ordinateur
│   ├── Track1-LangChain/   # Track LangChain (Labs 1-7)
│   └── Track2-GoogleADK/           # Track Google ADK (Labs 8-18, extensions 12b-12d)
│
└── learning_theory_lean/                  # Lake Lean 4 — convergence du perceptron (Novikoff)
Prérequis et installation
Installation ML.NET
# 1. Installer .NET SDK 9.0+ depuis https://dotnet.microsoft.com/download
dotnet tool install -g Microsoft.dotnet-interactive
dotnet interactive jupyter install

# Vérification
jupyter kernelspec list  # doit montrer .net-csharp
Documentation complète : ML.Net/README.md
Installation Python DataScience Labs (Days 1-3)
pip install pandas numpy matplotlib seaborn scikit-learn ipywidgets
# Labs 2-3 et 6-7 nécessitent aussi :
pip install langchain langchain-openai langchain-experimental
# + variable d'environnement OPENAI_API_KEY dans un fichier .env
Installation Track2-GoogleADK Labs (Days 4-7)
pip install -r MyIA.AI.Notebooks/ML/DataScienceWithAgents/Track2-GoogleADK/requirements.txt
cp .env.example .env  # puis configurer les clés API
Providers LLM supportés (Labs 8+) : Google Gemini (recommandé), OpenAI, OpenRouter, vLLM local, LM Studio.
Documentation complète : DataScienceWithAgents/README.md
ML.NET (C# / .NET Interactive)
Pipeline ML.NET complet en C#, de l’introduction à l’évaluation avancée : du chargement de données au déploiement ONNX, en passant par l’entraînement, l’AutoML et l’évaluation rigoureuse.
| # | Notebook | Contenu | Focus |
|---|---|---|---|
| 1 | ML-1-Introduction | Hello ML.NET World, pipeline de base | Fondamentaux |
| 1-Py | ML-1-Introduction-Python | Jumeau Python : pipeline ML.NET ⇄ scikit-learn (régression + classification) | Parité .NET⇄Python |
| 2 | ML-2-Data&Features | IDataView, TextLoader, encodage | Préparation données |
| 2-Py | ML-2-Data&Features-Python | Jumeau Python : IDataView/Transforms ⇄ ColumnTransformer+Pipeline (scikit-learn) |
Parité .NET⇄Python |
| 3 | ML-3-Entrainement&AutoML | SDCA, LightGBM, AutoML + leaderboard visuel (Plotly) | Entraînement |
| 3-Py | ML-3-Entrainement-Python | Jumeau Python : SDCA/LightGBM/AutoML ⇄ LinearRegression/GradientBoosting/GridSearchCV |
Parité .NET⇄Python |
| 4 | ML-4-Evaluation | Cross-validation, métriques, PFI | Évaluation |
| 4-Py | ML-4-Evaluation-Python | Jumeau Python : cross-validation + métriques + PFI ⇄ cross_val_score + permutation_importance (scikit-learn) |
Parité .NET⇄Python |
| 5 | ML-5-TimeSeries | Forecasts temporelles, windowing | Séries temporelles |
| 5-Py | ML-5-TimeSeries-Python | Jumeau Python : ForecastBySsa ⇄ STL+SARIMA (statsmodels) |
Parité .NET⇄Python |
| 6 | ML-6-ONNX | Export ONNX, inférence en production | Déploiement |
| 6-Py | ML-6-ONNX-Python | Jumeau Python : skl2onnx export + onnxruntime inférence ⇄ OnnxTransformer (ML.NET) |
Parité .NET⇄Python |
| 7 | ML-7-Recommendation | Système de recommandation | Recommandations |
| 7-Py | ML-7-Recommendation-Python | Jumeau Python : MatrixFactorization ⇄ NMF (scikit-learn) |
Parité .NET⇄Python |
| 8 | ML-8-Clustering | K-Means, segmentation RFM, méthode du coude | Non-supervisé |
| 8-Py | ML-8-Clustering-Python | Jumeau Python : ClusteringCatalog ⇄ KMeans scikit-learn + méthode du coude |
Parité .NET⇄Python |
| 9 | ML-9-Anomaly-Detection | Randomized PCA, AUC, seuil de décision | Détection d’anomalies |
| 9-Py | ML-9-Anomaly-Detection-Python | Jumeau Python : RandomizedPca ⇄ PCA+résidu (scikit-learn) |
Parité .NET⇄Python |
| TP | TP-prevision-ventes | Régression bayésienne (Infer.NET) | Application pratique |
AutoML : quand le leaderboard bat le Console.WriteLine (#7642, #7707, #7839)
Le notebook ML-3 AutoML produit, sur données non linéaires (y = 100·x² + bruit), 10 essais terminés en 30 secondes, couvrant 5 entraîneurs distincts. Sans visualisation, l’étudiant doit comparer 10 nombres à la main pour repérer le gagnant — exercice rébarbatif qui masque l’apport pédagogique de l’AutoML. La cellule 13 (NotebookMonitor.CompletedTrials + Plotly.NET.Interactive) trace un leaderboard qui rend la discrimination visible :
| Entraîneur | Essais | Meilleur RMSE |
|---|---|---|
LightGbmRegression |
3 | 90 262 ← gagnant |
FastForestRegression |
4 | 5 932 134 |
LbfgsPoissonRegressionRegression |
1 | 6 303 500 |
SdcaRegression |
1 | 11 323 122 |
FastTreeRegression |
1 | 30 523 762 ← perdant |
L’écart entre le pire et le meilleur essai est de 338× — un fait pédagogique majeur, invisible sans graphique. La lecture honnête du classement nuance aussi le stéréotype « non-linéaire bat linéaire » : FastTreeRegression (lui aussi non-linéaire, à base d’arbres) finit dernier (30 M), pire que SdcaRegression linéaire (11 M). L’AutoML a donné 3 essais à LightGbmRegression mais un seul à FastTreeRegression — moins d’occasions de bien le régler. La leçon : la famille d’algorithme ne garantit pas le succès, c’est l’association bon algorithme + bons hyper-paramètres que l’AutoML cherche conjointement. Cette nuance illustre l’anti-fabrication #3801 Prong-B : la cellule trace un graphique à partir des vrais résultats experiment.RunAsync(), pas une simulation ASCII ni un workaround dégradé.
Trois figures du track ML.NET (scikit-learn, statsmodels)
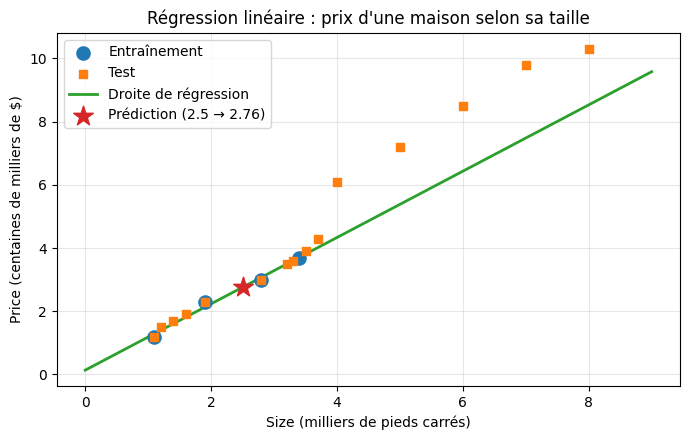 ML-1 — Régression linéaire prix/surface (scikit-learn). On observe que les points
Test (oranges) s’éloignent de la droite au-delà de ~4 milliers de pieds carrés : le modèle linéaire sous-extrapole les grandes maisons, ce que la métrique R² seule ne signalera pas.
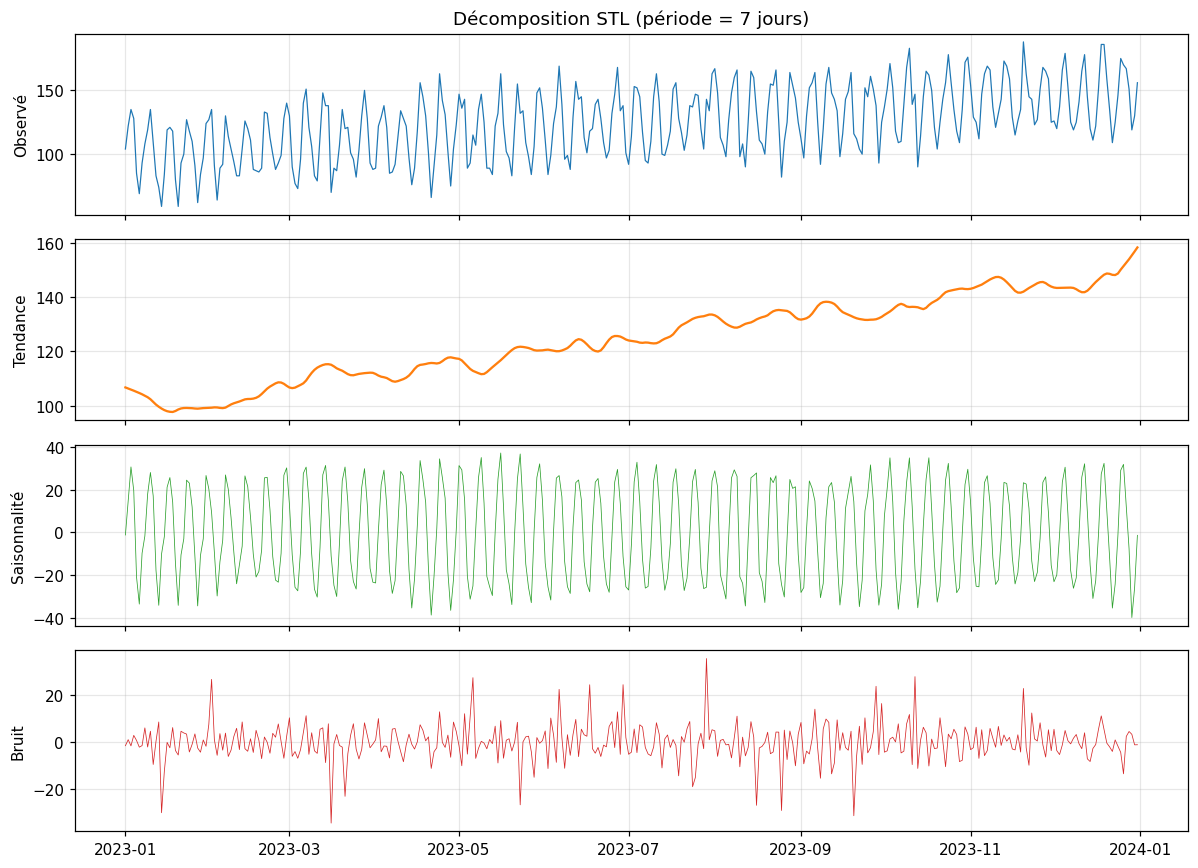 ML-5 — Décomposition STL (
statsmodels.tsa.seasonal_decompose, période 7). La saisonnalité hebdomadaire se lit immédiatement (amplitude ±40), et la tendance capture la croissance sous-jacente (~+50 sur 12 mois). Le TP-prevision-ventes s’appuie sur ce découpage pour combiner signal et saisonnalité.
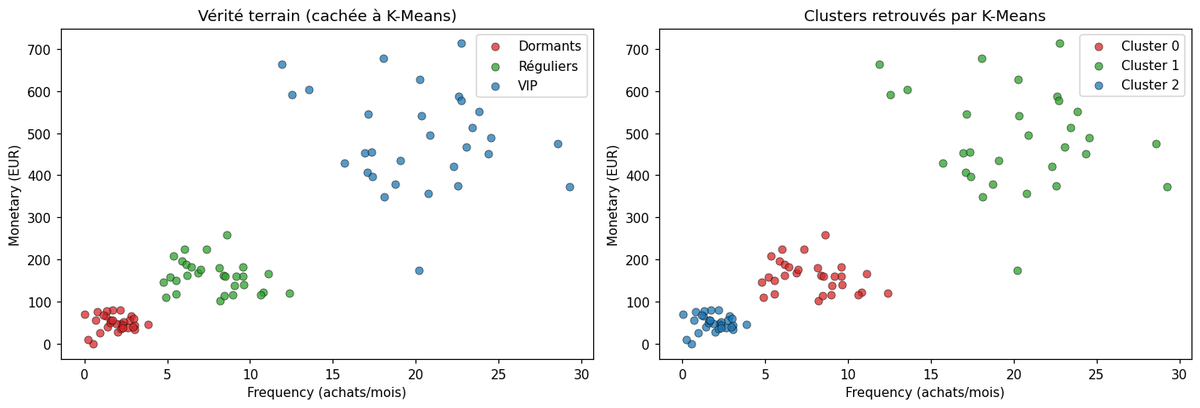 ML-8 — Clustering K-Means sur données RFM (scikit-learn). Le notebook démontre la limitation sémantique du K-Means non supervisé : les segments de clientèle (Dormants/Réguliers/VIP) sont des catégories métier, pas des clusters géométriques. La concordance parfaite n’est possible que par chance — d’où l’intérêt d’un mapping* a posteriori (et des méthodes supervisées dès qu’on connaît les segments).*
Python Data Science with Agents
Formation complète en Data Science Python enrichie d’agents IA. Vous commencerez par les fondamentaux (NumPy, Pandas), puis construirez des agents LLM capables d’analyser des données, de nettoyer des datasets, et de participer à des compétitions Kaggle. La seconde moitié plonge dans les frameworks Google ADK pour construire des systèmes multi-agents avancés.
Fondations (01-PythonForDataScience)
| Notebook | Contenu |
|---|---|
| 1.2-NumPy | Arrays, vectorisation, opérations |
| 1.3-Pandas | DataFrames, filtrage, manipulation |
Trois figures du track Data Science (Pandas, Seaborn, ADK)
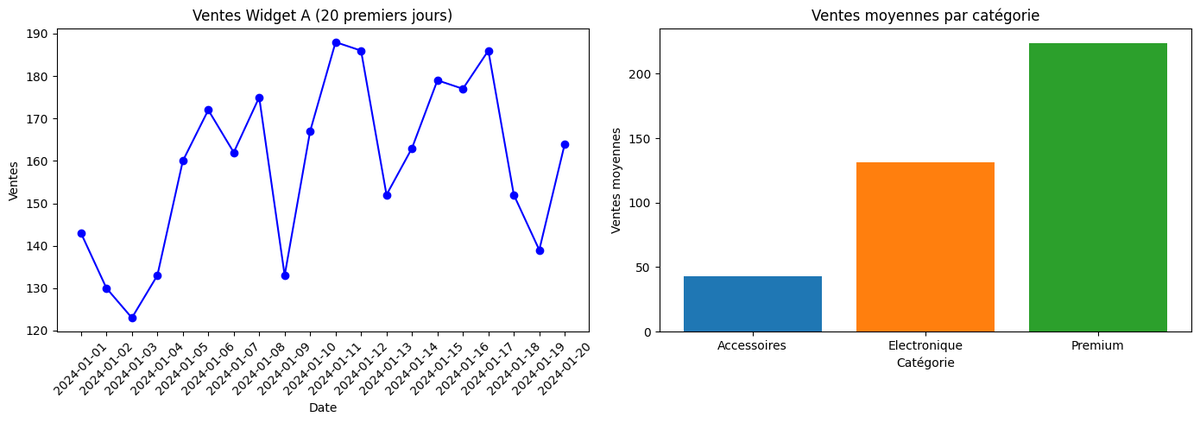 Lab1 — Pandas & Matplotlib : visualisation exploratoire des ventes (20 jours, série temporelle + barres par catégorie). Cette figure introduit le double-outil Pandas + Matplotlib qu’utilisent ensuite tous les notebooks ML du track.
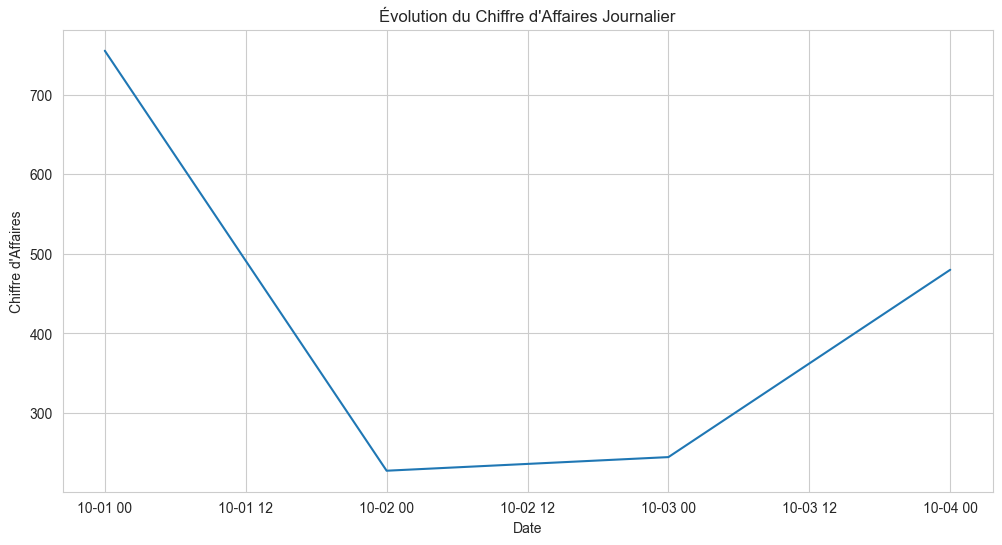 Lab5 — matplotlib pur : chiffre d’affaires journalier sur quatre jours — chute de ~760 à ~230 le premier jour, plateau, puis remontée à ~480. Sur une fenêtre aussi courte, aucune tendance ne peut en être déduite : la figure illustre le style
seaborn-v0_8-whitegrid (un style matplotlib, pas un import seaborn) appliqué à un DataFrame Pandas.
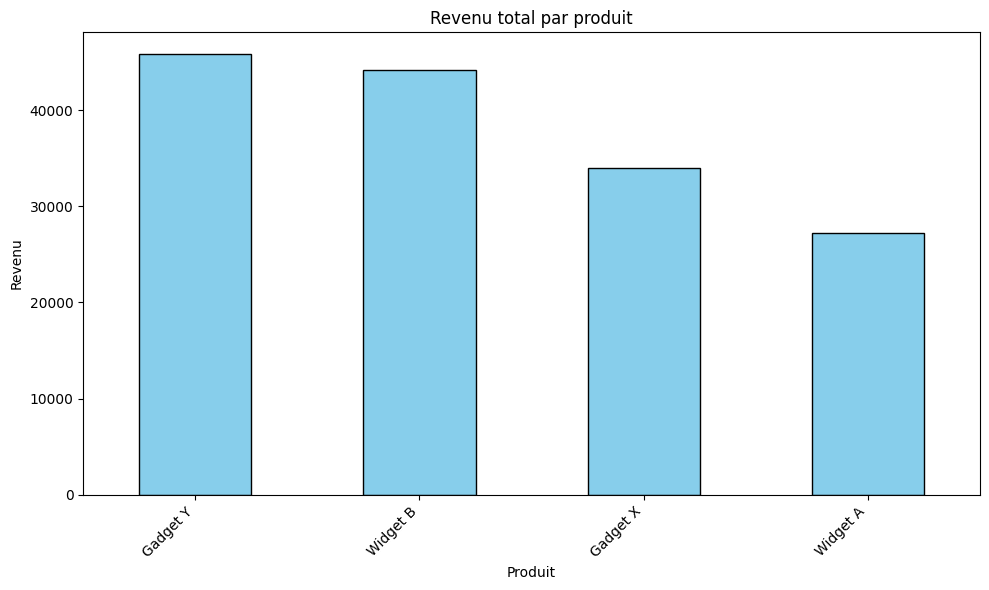 Lab9 — Premier agent ADK : l’agent a généré et exécuté le code Matplotlib qui produit cette figure, à partir de la requête « Crée un graphique à barres montrant le revenu par produit. Utilise matplotlib. » (cellule 17). Le tri décroissant (
sort_values(ascending=False)) n’était pas demandé : l’agent l’a ajouté spontanément, ce qui rend l’insight (Gadget Y bat Widget A de ~70%) immédiatement lisible — petit pas vers le « diagramme qui parle de lui-même ».
Socle ML canonique (02-ML-Cours)
Entre les fondations NumPy/Pandas et les labs agentic, le socle machine learning canonique avec scikit-learn : le workflow (train/test split, surapprentissage rendu visible), la descente de gradient (ouvrir la boîte noire de fit()), les régressions linéaire et logistique complétées par le pont génératif Naive Bayes et la grande dimension, les arbres et ensembles, l’évaluation rigoureuse (biais-variance, calibration, équité), le non supervisé, la théorie PAC et ses trois compagnons formel/concentration/Perceptron, puis trois chapitres de praticien (hyperparamètres, régularisation sparse, classes déséquilibrées) et l’analyse d’erreurs. Chaque notebook rend visible un concept-phare et ancre les articles fondateurs — le référent manuel qui rend jugeable ce qu’un agent produira ensuite.
| # | Notebook | Concept rendu visible | Focus |
|---|---|---|---|
| 2.1 | Workflow ML | Train/test split, surapprentissage rendu visible | Méthodologie |
| 2.2 | Descente de gradient | Ouvrir la boîte noire de fit() |
Optimisation |
| 2.3 | Régression linéaire & logistique | OLS vs maximum de vraisemblance | Modèles linéaires |
| 2.3b | Naive Bayes génératif | L’indépendance conditionnelle qui décide la frontière (Bernoulli, multinomial, Gaussien) | Modèles génératifs |
| 2.3c | Régression grande dimension | p >> n : Ridge, PCR, PLS — var ≠ valeur prédictive | Modèles linéaires |
| 2.3d | Modèle gaussien LDA/QDA | L’hypothèse de covariance décide la frontière : droite (LDA) vs conique (QDA) | Modèles génératifs |
| 2.4 | Arbres, forêts & ensembles | Réduction de variance (bagging, boosting) | Ensembles |
| 2.5 | Biais, variance, CV & ROC | Compromis biais-variance, validation croisée, ROC/AUC | Évaluation |
| 2.5b | Calibration des probabilités | Reliability diagram, ECE — pourquoi 0.87 n’est pas 87 % de chances | Évaluation |
| 2.5c | Équité par sous-groupes | Parité démographique, equalized odds, post-traitement par seuils | Évaluation |
| 2.6 | Clustering & PCA | KMeans, réduction de dimension | Non supervisé |
| 2.7 | Modèles non paramétriques | SVM, k plus proches voisins | Non paramétrique |
| 2.8 | Théorie PAC & VC | Cadre PAC, dimension de Vapnik-Chervonenkis | Théorie de l’apprentissage |
| 2.8b | Théorie PAC — compagnon Lean | La même borne PAC démontrée et interrogée depuis le lake (kernel lean4-wsl) |
Théorie formelle |
| 2.8c | Borne témoin concentration | Carte transversale + mesure numérique : Novikoff, témoin extrémal, Hoeffding | Théorie de l’apprentissage |
| 2.8d | Lean Novikoff convergence | Novikoff n·γ² ≤ R² interrogé en direct : #check + #print axioms |
Théorie formelle |
| 2.9 | Grokking — généralisation tardive | Généralisation qui émerge après que le surapprentissage soit maximal (PyTorch + ACP) | Épilogue avancé |
| 2.10 | Optimisation hyperparamètres | Grille, hasard, bayésien (TPE) — et quand s’arrêter | Praticien |
| 2.11 | Régularisation sparse LASSO | La géométrie décide : polyèdre L1 → sparsité, boule L2 → shrink | Praticien |
| 2.12 | Données déséquilibrées | La courbe PR dit la vérité quand la ROC flatte | Praticien |
| 2.13 | Analyse d’erreurs | Tranches, worst-k : la poche invisible sous un score global correct | Praticien |
Dossier : 02-ML-Cours/. Le notebook 2.8 (borne PAC/VC) est le pendant empirique du lake learning_theory_lean/ qui prouve la convergence du perceptron — voir la section Théorie formelle (Lean) ci-dessous. Le notebook 2.9 (grokking) est un épilogue avancé qui rend visible un phénomène empirique (la généralisation après surapprentissage complet) souvent cité dans la littérature récente (Power et al., 2022), positionné hors du parcours fundamentals par PR #7280.
Workshop 3 Jours (Track1-LangChain)
| Jour | Lab | Nom | Objectif |
|---|---|---|---|
| Day 1 | 1 | Python for Data Science | Révision Pandas, Matplotlib, Scikit-Learn |
| Day 2 | 2 | RFP Analysis | Parser des appels d’offres avec agents LLM |
| Day 2 | 3 | CV Screening | Scoring CV avec agents IA |
| Day 3 | 4 | Data Wrangling | Nettoyage et transformation de données |
| Day 3 | 5 | Viz & ML | Visualisation et intro Scikit-Learn |
| Day 3 | 6 | First Agent | Construire un agent simple (LLM + Tools) |
| Day 3 | 7 | Data Analysis Agent | Agent pour interroger des DataFrames |
Track Track2-GoogleADK (Days 4-7)
Track avancé intégrant les frameworks Google ADK (DS-STAR, MLE-STAR) avec support multi-provider (Gemini 3.1, vLLM, OpenAI).
| Jour | Lab | Nom | Objectif |
|---|---|---|---|
| Day 4 | 8 | ADK Introduction | Architecture ADK, configuration providers |
| Day 4 | 9 | First ADK Agent | Premier agent pour Data Science |
| Day 5 | 10 | File Analyzer | Analyse de fichiers hétérogènes |
| Day 5 | 11 | Planner-Coder Loop | Boucle itérative multi-agents |
| Day 5 | 12 | DS-Star Workshop | Application complète DS-STAR |
| Day 5 | 12b | Sequential-Orchestration | Orchestration séquentielle (contrat C4 : désignation séquentielle) |
| Day 5 | 12c | Agent-Handoff | Handoff natif câblé (contrat C5) |
| Day 5 | 12d | Token-Usage | Traçabilité de la consommation LLM (contrat C6) |
| Day 5 | 18 | Session-Persistence | Persistance d’état de session |
| Day 6 | 13 | Web Search SOTA | Recherche de modèles SOTA |
| Day 6 | 14 | Ablation Refinement | Optimisation ciblée par ablation |
| Day 6 | 15 | Kaggle Challenge | Compétition Kaggle avec MLE-STAR |
| Day 7 | 16 | Data Science Agent | Agent BigQuery/BQML |
| Day 7 | 17 | Final Project | Projet intégré |
Documentation complète : DataScienceWithAgents/Track2-GoogleADK/README.md
Théorie formelle (Lean)
Au-delà des notebooks empiriques (ML.NET, Python), la série ML accueille un lake Lean 4 qui formalise deux résultats théoriques canoniques de l’apprentissage : learning_theory_lean/. Convention des lakes frères — le lake est le livrable formel, lake build SUCCESS en est la preuve d’exécution, et les notebooks pédagogiques viennent en pendant : ici 02-ML-Cours/2.8b-Theorie-PAC-Lean.ipynb pour la moitié PAC et 02-ML-Cours/2.8d-Lean-Novikoff-Convergence.ipynb pour la moitié Perceptron, compagnons kernel Lean (lean4-wsl) placés contre leur jumeau empirique 2.8-Theorie-PAC.ipynb (EPIC #11703).
learning_theory_lean/— théorème de convergence du perceptron (Novikoff, 1962) : pour des données linéairement séparables de marge γ et de rayon R, l’algorithme du perceptron effectue au plus(R/γ)²mises à jour avant de trouver un classifieur correct. Preuve géométrique élémentaire et entièrement 0-sorry (croissance de l’alignement⟨wₖ,u⟩ ≥ kγ+ croissance de la norme‖wₖ‖² ≤ kR²+ Cauchy–Schwarz), sur un espace préhilbertien réel abstrait via Mathlib.- Module
PacLearning— théorie PAC (Valiant, 1984) : la chaîne complète de la borne de complexité d’échantillon en classe finiem ≥ (1/ε)(ln|H| + ln(1/δ))(concentration de Hoeffding pour Bernoulli + borne de l’union) et la borne de généralisation agnostic — toutes deux 0-sorry. C’est ce module que le notebook 2.8b rend exécutable déclaration par déclaration, en pendant formel du 2.8 qui en mesure la prédiction empirique. Un second compagnon, côté série SymbolicAI, couvre la chaîne complète des bornes et toute la branche perceptron (Novikoff + serrage) avec exercices :SymbolicAI/SymbolicLearning/SL-1b-LogicalLearning-Lean-Native.ipynb(See #11703).
C’est le pendant prouvé des notebooks de classification linéaire (ML.Net/ML-3 entraîne des classifieurs, 02-ML-Cours/2.3 pose régression linéaire/logistique) : là où les notebooks montrent que le perceptron converge en pratique, le lake prouve la borne. Voir le README du lake pour les modules et le détail de la preuve.
Pont vers les Preuves Formelles (Lean 4) — différenciant CoursIA
La section ci-dessus focusse sur le lake phare learning_theory_lean (Novikoff perceptron). Le différenciant CoursIA tient à la cartographie inter-familles : chaque notebook ML (simulation/expérimentation) peut être doublé par un lake (preuve formelle) chez au moins une autre famille — décision, choix social, partage équitable, recherche de chemin. Cette double culture (empirique ML.NET / scikit-learn ↔︎ formelle Lean 4 / Mathlib) ancre mathématiquement les notebooks qui montrent par les résultats des preuves qu’ils invoquent.
| Famille | Lake phare | Théorème | Branchement notebook ML |
|---|---|---|---|
| ML | learning_theory_lean |
Convergence perceptron Novikoff 0 sorry #4140 | Ce hub (Novikoff marge γ rayon R) |
| ML | learning_theory_lean |
Tightness (borne optimale) #4301 MERGED | Ce hub (borne prouvée serrée : égalité atteinte) |
| ML | learning_theory_lean |
i18n-B tranche 5 (FR .lean + companion .en.md) MERGED #5009 |
Convention i18n à étendre aux autres lakes |
| Probas | decision_theory_lean |
VNM résolu 0 sorry #4049, Coherence MERGED #4150, Peters Gittins ref v4.27.0-rc1, PAC iter-2 chaîne 0-sorry bout-en-bout | Notebooks PAC (02-ML-Cours 2.5 biais-variance / ERM sous incertitude) |
| QuantConnect | kelly_lean |
Kelly criterion Growth MERGED #5003, Calmar/IR/MDD #4223 / #4164 | 02-ML-Cours lien finance/ML : allocation optimale sous i.i.d. |
| GameTheory | game_theory_lean/SocialChoice (lake social_choice_lean absorbé post-#4365) |
Arrow impossibilité, Sen, Voting | 02-ML-Cours 2.7 ensembles (vote d’ensemble ≅ agrégation préférences) |
| GameTheory | game_theory_lean/CooperativeGames/Shapley.lean (lake cooperative_games_lean supprimé post-#4365, contenu absorbé) |
Bondareva-Shapley 0 sorry #3954 (noyau, attributions) | 02-ML-Cours Shapley values (feature importance ≅ valeur de Shapley) |
| Search | search_lean |
Phase 1-3 SHIPPED #4090 / #4142 OPEN / #4144 OPEN | 02-ML-Cours 2.4 descente de gradient / arêtes de coût ≅ heuristique admissible |
| SymbolicAI | argumentation_lean |
Extension Dung (complète, préférée, stable, fondée) | 02-ML-Cours 2.5 / 02-ML-Cours 2.7 débat ≅ framework d’argumentation |
flowchart LR
    subgraph SIM["Simulation (notebooks ML)"]
        NB1["ML-3 — SDCA classification"]
        NB2["2.3 — régression linéaire/logistique"]
        NB3["2.4 — descente de gradient"]
        NB4["2.5 — biais-variance / ERM"]
        NB5["2.7 — ensembles (vote, bagging)"]
        NB6["2.6 — PAC / échantillons"]
    end
    subgraph LEAN["Preuves formelles (Lean 4)"]
        L1["learning_theory_lean — Novikoff 0 sorry #4140"]
        L2["learning_theory_lean — Tightness #4301 MERGED"]
        L3["decision_theory_lean — VNM 0 sorry #4049 + Coherence #4150"]
        L4["kelly_lean — Growth #5003 / #4223 / #4164"]
        L5["game_theory_lean/SocialChoice + CooperativeGames — Arrow + Bondareva-Shapley<br/>(lakes #4365 absorbés)"]
        L6["search_lean + argumentation_lean — heuristique + Dung"]
    end
    NB1 -. "marge γ ⊥ rayon R ⟹ convergence" .-> L1
    NB2 -. "ERM minimise erreur empirique" .-> L3
    NB3 -. "pas adaptatif + Lipschitz" .-> L1
    NB4 -. "PAC ⇓ uniform_concentration" .-> L3
    NB5 -. "vote ≅ préférences agrégées" .-> L5
    NB6 -. "échantillon i.i.d. + Hoeffding" .-> L3
    %% color: explicite -- sans lui, libelle clair sur fond clair en mode sombre GitHub (#15022) ; ton parfois plus fonce que le stroke (le stroke en couleur de texte rendrait infer illisible) : ne pas harmoniser
    style L1 fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style L2 fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style L3 fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style L4 fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style L5 fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
    style L6 fill:#e8f5e9,stroke:#2e7d32,color:#1b5e20
Lecture : chaque nœud SIM représente un notebook ML dont le résultat empirique (marge, ERM, ensemble, PAC) est prouvé par au moins un nœud LEAN via une flèche pointillée. Le vert pâle sur les nœuds Lean rappelle que la preuve est l’engagement de véracité du notebook — pas une décoration. Voir l’EPIC #4038 (Roadmap Lean) et le hub central P0 pour la cartographie complète (PR #5049). Cross-réf hubs voisins déjà livrés : QuantConnect (PR #5047), GameTheory (PR #5050), Probas (PR #5053), SymbolicAI Lean (#5043 MERGED).
FAQ / Troubleshooting
Quelle est la différence entre ML.NET et les notebooks Python ?
ML.NET (C#/.NET 9.0) couvre le machine learning classique (classification, régression, clustering, anomaly detection) via le framework Microsoft.ML. Les notebooks Python couvrent les agents IA (LangChain, Google ADK, data wrangling avec Pandas). Les deux sous-séries sont indépendantes. ML.NET est pertinent si vous travaillez dans l’écosystème .NET ; les notebooks Python sont plus généraux.
Faut-il connaître le C# pour les notebooks ML.NET ?
Oui, les notebooks ML.NET utilisent .NET Interactive (C#). Les concepts ML sont introduits depuis zéro, mais la syntaxe C# de base (variables, LINQ, classes) est supposée. Si vous ne connaissez pas C#, les notebooks Python (DataScienceWithAgents) couvrent des concepts similaires sans prérequis C#.
Quelle est la progression recommandée ?
- ML.NET (notebooks 1-5) : comprendre les bases du ML supervisé/non supervisé
- DataScienceWithAgents (Day 1-7) : découvrir les agents IA et le RAG
- Track2-GoogleADK (Day 4-7) : agents avancés avec Google ADK
Les deux sous-séries sont indépendantes et peuvent être suivies dans n’importe quel ordre.
| Problème | Solution |
|---|---|
dotnet-interactive non trouvé |
dotnet tool install -g Microsoft.dotnet-interactive puis dotnet interactive jupyter install |
Kernel .net-csharp absent |
Vérifier avec jupyter kernelspec list. Réinstaller si nécessaire (cf. docs/reference/kernels-runtime.md) |
ML.NET : erreur IDataView au chargement |
Vérifier le chemin du CSV (utilisez Path.Combine plutôt qu’un chemin absolu) |
OPENAI_API_KEY manquant (Labs 2-3) |
Créer un fichier .env à la racine avec OPENAI_API_KEY=sk-... |
| PyTorch lent sur CPU | Normal pour les Labs 8+. Le GPU est recommandé mais pas obligatoire |
langchain import error |
pip install langchain langchain-openai langchain-experimental (versions compatibles) |
erreur No module named 'google.adk' |
Installer le track Track2-GoogleADK : pip install -r requirements.txt dans le bon répertoire |
| Plots ne s’affichent pas | Vérifier ipywidgets installé + extension Jupyter activée |
Concepts clés
| Concept | Description |
|---|---|
| Pipeline ML | Enchaînement data loading → features → training → évaluation |
| Feature Engineering | One-hot encoding, normalisation, concatenation |
| AutoML | Recherche automatique d’hyperparamètres |
| Evaluation | R², MAE, RMSE, cross-validation |
| Agents IA | LLM + Tools + Prompt + Executor |
Ressources
ML.NET
- Documentation ML.NET
- ML.NET Samples
- Hands-On AI Trading — chapitres ML.NET et pipeline de trading
Python Data Science
Conclusion / Prochaines étapes
Ce que vous avez appris
Cette série vous a fait parcourir le pipeline complet du Machine Learning appliqué, en gardant toujours les deux pieds dans le code — depuis le chargement d’un IDataView ou d’un DataFrame jusqu’au déploiement et à l’automatisation par agents. L’arc pédagogique se déploie sur deux registres complémentaires :
- Le geste fondamental — construire un modèle, ce n’est pas invoquer une boîte noire, c’est enchaîner des étapes explicites : préparer les données (encodage, normalisation), choisir un algorithme adapté au problème, entraîner, puis évaluer rigoureusement par cross-validation et Permutation Feature Importance plutôt que sur une seule exécution.
- La double stack — ML.NET (C#/.NET) et Python (scikit-learn, PyTorch) résolvent les mêmes problèmes avec des outils différents. Les concepts — features, surapprentissage, généralisation, compromis biais/variance — sont universels ; traverser les deux écosystèmes ancre cette universalité mieux qu’un seul le pourrait.
- Le passage à l’agent — la seconde moitié franchit un seuil : l’agent LLM devient un collaborateur du workflow data science, capable d’interroger un DataFrame, de parser des fichiers hétérogènes, d’orchestrer une boucle planner-coder ou de se confronter à une compétition Kaggle. Le data scientist ne fait plus seulement du modèle, il construit des systèmes qui font du modèle.
La thèse pratique est honnête : un bon modèle vit ou meurt par la qualité de son évaluation et de ses features, et l’automatisation par agents ne dispense ni de l’un ni de l’autre — elle les rend reproductibles à l’échelle.
Prochaines étapes
- Approfondir le calcul bayésien : le TP prévision de ventes dresse un pont vers Probas (Infer.NET, PyMC), où la régression bayésienne traitée ici comme cas d’application devient un langage à part entière — distributions, inférence, incertitude quantifiée.
- Passer à l’apprentissage par renforcement : RL prend le relais quand l’apprentissage ne se fait plus sur des données statiques mais par interaction avec un environnement — le cadre naturel pour le trading (QuantConnect) et les systèmes décisionnels séquentiels.
- Mesurer l’incertitude, pas seulement la prédiction : les notebooks d’évaluation (ML-4) introduisent métriques et PFI ; la série Probas pousse plus loin en quantifiant l’incertitude d’une prédiction plutôt que son seul point estimé.
- Pour la pratique : reprenez le TP prévision de ventes en remplaçant la régression ML.NET par une Infer.NET, puis comparez les intervalles de confiance — c’est le passage le plus formateur entre ML classique et modélisation probabiliste.
Le fil rouge
Le Machine Learning appliqué, c’est l’art de transformer des données en décisions reproductibles — et cette série insiste sur le « reproductibles » : cross-validation, PFI, pipelines explicités plutôt que notebooks jetables. Que vous soyez développeur .NET en entreprise ou data scientist Python branchant ses premiers agents, le fil conducteur reste le même : un modèle qu’on ne sait pas évaluer honnêtement ne sert à rien, et un workflow qu’on ne sait pas automatiser ne passe pas à l’échelle.
Licence
Voir la licence du repository principal.