Les notebooks précédents (2.1 et 2.4) ont rendu le surapprentissage visible : un arbre profond affiche une accuracy d’entraînement proche de 1.0 tandis que son score de test s’effondre, et les méthodes d’ensemble (2.4) réduisent cet écart. Ce phénomène n’est pas un bug : c’est la manifestation concrète d’un compromis fondamental, le compromis biais-variance. Nous le formalisons ici, puis nous outillons pour le maîtriser : la validation croisée donne une estimation fiable de la performance (au lieu d’un seul découpage aléatoire source de bruit), et la courbe ROC avec l’AUC évaluent un classifieur au-delà de la seule accuracy, en exposant la structure des erreurs (faux positifs vs faux négatifs).
Objectifs d’apprentissage
À la fin de ce notebook, vous saurez : 1. Décomposer l’erreur de généralisation en biais et variance et reconnaître chaque régime (sous- et sur-apprentissage). 2. Utiliser la validation croisée k-fold pour obtenir une estimation fiable des performances, plutôt qu’un seul découpage entraînement/test. 3. Lire une courbe ROC et interpréter l’AUC comme métrique indépendante du seuil de décision. 4. Choisir un seuil de décision adapté au coût relatif des faux positifs et des faux négatifs.
Notebook 2.4 (arbres, forêts aléatoires, réduction de variance par ensembles).
Référence. Geman, S., Bienenstock, É. & Doursat, R. (1992), Neural Networks and the Bias/Variance Dilemma, Neural Computation 4(1):1-58. La décomposition biais-variance formalise l’arbitrage fondamental : un modèle trop simple a un biais élevé (sous-apprentissage), un modèle trop complexe a une variance élevée (surapprentissage).
import warningsdef _warn_no_path(message, category, filename, lineno, file=None, line=None):returnf"{category.__name__}: {message}\n"warnings.formatwarning = _warn_no_path# Configuration et imports pour le notebook 2.5import numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.datasets import load_breast_cancerfrom sklearn.model_selection import train_test_split, cross_val_score, cross_validatefrom sklearn.linear_model import LogisticRegressionfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.metrics import accuracy_score, roc_curve, roc_auc_score, confusion_matrixnp.random.seed(42)print("Configuration OK : 2.5 - Biais, variance, validation croisee et ROC")
Configuration OK : 2.5 - Biais, variance, validation croisee et ROC
Auto-évaluation
Ce carnet porte un dispositif d’auto-évaluation formatif : quatre questions, placées avant le parcours (diagnostic de prérequis), au milieu (vérification de la notion) et à la fin (transfert). Aucune note n’est stockée, aucune réponse n’est enregistrée.
Chaque cellule de question s’exécute sans erreur tant que vous n’avez pas répondu ; la correction s’affiche uniquement lorsque vous remplacez reponse=None par la lettre de votre choix, puis ré-exécutez la cellule.
# Dispositif d'auto-evaluation de la serie (module partage, issue #18207)import pathlibimport sysfor _racine in (pathlib.Path.cwd(), *pathlib.Path.cwd().parents):if (_racine /"MyIA.AI.Notebooks").is_dir(): sys.path.insert(0, str(_racine /"MyIA.AI.Notebooks"/"ML"/"DataScienceWithAgents"))breakfrom auto_evaluation import question # noqa: E402
Avant de commencer — question de diagnostic
question("Un modèle affiche 0,99 d'accuracy sur un jeu où 99 % des exemples sont d'une seule classe. Que vaut cette mesure ?", choix=["Elle est excellente : 0,99 est proche du maximum","Elle est ininterprétable seule : un modèle qui prédit toujours cette classe fait aussi bien","Elle prouve que le modèle a appris la classe rare", ], bonne="B", explication="Sur des classes déséquilibrées, l'accuracy d'une prédiction constante est déjà très haute. Ce carnet montre pourquoi la matrice de confusion et le rappel sont nécessaires pour lire ce genre de score.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="avant",)
Diagnostic de prérequis — Un modèle affiche 0,99 d'accuracy sur un jeu où 99 % des exemples sont d'une seule classe. Que vaut cette mesure ?

  A. Elle est excellente : 0,99 est proche du maximum
  B. Elle est ininterprétable seule : un modèle qui prédit toujours cette classe fait aussi bien
  C. Elle prouve que le modèle a appris la classe rare

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
1. Le compromis biais-variance
L’erreur de généralisation d’un modèle se décompose en trois termes :
Le biais mesure l’erreur systématique d’un modèle trop rigide : une régression linéaire appliquée à des données non-linéaires sous-apprend (underfitting). Ses prédictions sont cohérentes d’un échantillon à l’autre, mais systématiquement à côté.
La variance mesure la sensibilité du modèle à l’échantillon d’entraînement : un arbre très profond mémorise les données (overfitting). Changez quelques lignes du jeu d’entraînement et sa frontière de décision change du tout au tout.
On ne peut pas minimiser les deux simultanément avec une seule complexité de modèle : c’est le dilemme de Geman et al. (1992). Image mentale : une règle rigide (biais élevé, variance faible) face à une nouille flexible (biais faible, variance élevée). La bonne complexité se trouve entre les deux — et la validation croisée (section 3) sert justement à la repérer.
# Chargement du jeu de donnees breast_cancer (classification binaire)cancer = load_breast_cancer()X = cancer.datay = cancer.target# Decoupage entraînement/test stratifie (meme proportion de classes dans chaque sous-ensemble)X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42, stratify=y)print(f"Dimensions X : {X.shape} | nombre de variables : {X.shape[1]}")print(f"Entraînement : {X_train.shape[0]} lignes | Test : {X_test.shape[0]} lignes")print(f"Classes (0 = malin, 1 = benin) dans y : {np.bincount(y)}")
Dimensions X : (569, 30) | nombre de variables : 30
Entraînement : 398 lignes | Test : 171 lignes
Classes (0 = malin, 1 = benin) dans y : [212 357]
Lecture du jeu de données
Le tableau de contrôle fixe la géométrie du problème : 569 observations × 30 variables, réparties en 398 lignes d’entraînement et 171 de test (≈ 70/30), pour deux classes déséquilibrées — 212 tumeurs malignes (37,3 %) contre 357 bénignes (62,7 %). Ce dernier chiffre pose la ligne de base de référence : un modèle trivial qui répondrait « bénin » à toutes les questions atteindrait 62,7 % d’accuracy sans rien apprendre. Toute performance doit donc se lire au-dessus de ce plancher — et c’est précisément ce déséquilibre qui rendra l’accuracy insuffisante à la section 5, où faux négatifs et faux positifs ne coûtent pas la même chose.
2. Comparer plusieurs modèles (biais vs variance en pratique)
Comparons trois modèles de complexité croissante sur le même découpage entraînement/test :
Forêt aléatoire : moyenne de nombreux arbres → variance réduite (cf. notebook 2.4).
Arbre de décision profond : un seul arbre non limité → variance élevée, mémorisation de l’entraînement.
Attention : la comparaison ci-dessous repose sur un unique découpage. Or la performance mesurée sur un seul ensemble de test est bruitée — elle dépend de quelles lignes sont tombées dans le test. La section 3 (validation croisée) corrigera ce défaut.
# Ajustement de 3 modeles et comparaison train vs test# L'ecart (train - test) revele la variance : un modele qui memorise a train proche de 1.0# mais un test nettement plus bas.modeles = [ ("Regression logistique", LogisticRegression(max_iter=1000)), ("Foret aleatoire", RandomForestClassifier(n_estimators=100, random_state=42)), ("Arbre profond", DecisionTreeClassifier(random_state=42)),]print(f"{'Modele':22s} | {'train':>7s} | {'test':>7s} | {'ecart':>7s}")print("-"*55)for nom, modele in modeles: modele.fit(X_train, y_train) acc_train = accuracy_score(y_train, modele.predict(X_train)) acc_test = accuracy_score(y_test, modele.predict(X_test))print(f"{nom:22s} | {acc_train:7.3f} | {acc_test:7.3f} | {acc_train - acc_test:7.3f}")
Le tableau inverse l’intuition naïve : la régression logistique, au score d’entraînement le plus faible (0,967), est la seule à dépasser 0,94 en test (0,942), tandis que les deux modèles au train parfait (1,000) régressent à 0,936 (forêt) et 0,918 (arbre profond). La colonne ecart chiffre le phénomène : 0,026 contre 0,064 et 0,082, un rapport de 3,1 entre les extrêmes. Un train à 1,000 n’est pas une preuve de qualité mais la signature d’une mémorisation : le modèle récite les 398 exemples vus au lieu d’en extraire la règle. Détail à ne pas rater : le ConvergenceWarning signale que la régression logistique a plafonné à 1 000 itérations de lbfgs — son 0,967/0,942 est donc un plancher, pas sa valeur convergée.
Exercice 1 : identifier le modèle à plus forte variance
À partir du tableau affiché ci-dessus (ou en recalculant), repérez quel modèle présente le plus grand écart entre accuracy d’entraînement et accuracy de test. Ce gap train - test est l’indice le plus direct d’une variance élevée : le modèle ajuste trop finement l’échantillon d’entraînement pour bien généraliser.
Indices : - # Étape 1 : pour chaque (nom, modèle) dans modèles, recalculer acc_train et acc_test (comme dans la cellule précédente). - # Étape 2 : former la liste ecarts des différences acc_train - acc_test. - # Étape 3 : récupérer l’indice du maximum avec np.argmax(ecarts), puis modèles[indice_max][0] pour le nom.
# Exercice 1 : trouver le modele avec le plus grand ecart train-test (variance la plus elevee)# TODO etudiant : pour chaque modele dans modeles, calculer l'ecart (train_acc - test_acc)ecarts =None# TODO etudiant : remplacer (liste des ecarts train-test pour chaque modele)# TODO etudiant : indice du modele avec le plus grand ecartindice_max =None# TODO etudiant : remplacer (np.argmax(ecarts))nom_max_variance =None# TODO etudiant : remplacer (modeles[indice_max][0])print(f"Exercice 1 a completer : modele a plus forte variance = {nom_max_variance}")
Exercice 1 a completer : modele a plus forte variance = None
3. Validation croisée k-fold
Un seul découpage entraînement/test donne une estimation bruitée de la performance : deux random_state différents produisent des scores différents. La validation croisée k-fold réduit cette incertitude en découpant les données en k plis de taille égale, puis en entraînant sur k-1 plis et en testant sur le pli restant, en faisant tourner les rôles. On obtient ainsi k scores, dont la moyenne ± l’écart-type est une estimation bien plus fiable.
Notez bien la nuance : la validation croisée traite la variance de l’évaluation (l’incertitude sur le score mesuré), qui est distincte de la variance du modèle (section 1). Les deux se combinent, mais on les combat différemment.
Référence. Stone, M. (1974), Cross-Validatory Choice and Assessment of Statistical Predictions, Journal of the Royal Statistical Society. Series B (Methodological) 36(2):111-147. La validation croisée y est posée comme la méthode de référence pour estimer l’erreur de généralisation sans sacrifier de données à un unique ensemble de test.
# Validation croisee 5-fold de la regression logistique sur l'ensemble des donneesscores_cv = cross_val_score(LogisticRegression(max_iter=1000), X, y, cv=5)print("Scores par fold :", np.round(scores_cv, 3))print(f"Moyenne : {scores_cv.mean():.3f}")print(f"Ecart-type : {scores_cv.std():.3f}")
3.1 Le k-fold naïf ne suffit pas sur des données déséquilibrées
Le StratifiedKFold n’était jusqu’ici qu’une mention en prose (section 1, stratify=y). Il devient critique dès que les classes sont déséquilibrées : si les positifs sont rares, un découpage aléatoire peut produire un pli qui n’en contient aucun. Sur ce pli, le modèle n’apprend jamais un positif et le score mesuré est dégénéré (prédire la classe majoritaire). Construisons un jeu de données synthétique à ~3 % de positifs et comparons les deux découpages.
# Dataset binaire tres desequilibre : ~3% de positifs (6 sur 200)from sklearn.datasets import make_classificationfrom sklearn.model_selection import KFold, StratifiedKFoldX_imb, y_imb = make_classification( n_samples=200, n_features=10, n_informative=5, weights=[0.97, 0.03], random_state=42, flip_y=0, class_sep=1.5,)print(f"Positifs : {y_imb.sum()} / {len(y_imb)} ({100*y_imb.mean():.1f}%)")# k-fold NAIF : la repartition des classes dans chaque pli est laissee au hasardnaive_fold_pos = [int(y_imb[te].sum())for _, te in KFold(n_splits=5, shuffle=True, random_state=0).split(X_imb)]# StratifiedKFold : chaque pli conserve la proportion de chaque classestrat_fold_pos = [int(y_imb[te].sum())for _, te in StratifiedKFold(n_splits=5, shuffle=True, random_state=0).split(X_imb, y_imb)]print()print(f"{'pli':>3} | {'naif pos.':>9} | {'stratifie pos.':>15}")for k inrange(5):print(f"{k+1:>3} | {naive_fold_pos[k]:>9} | {strat_fold_pos[k]:>15}")print()print(f"Plis a 0 positif : naif {sum(p ==0for p in naive_fold_pos)}"f" | stratifie {sum(p ==0for p in strat_fold_pos)}")# Effet mesure sur le score CV : meme modele, deux decoupagescv_naif = cross_val_score(LogisticRegression(max_iter=3000), X_imb, y_imb, cv=KFold(n_splits=5, shuffle=True, random_state=0))cv_strat = cross_val_score(LogisticRegression(max_iter=3000), X_imb, y_imb, cv=StratifiedKFold(n_splits=5, shuffle=True, random_state=0))print()print(f"Naif : moyenne {cv_naif.mean():.3f} +/- {cv_naif.std():.3f}")print(f"Stratifie : moyenne {cv_strat.mean():.3f} +/- {cv_strat.std():.3f}")
Lecture : pourquoi le k-fold naïf échoue sur les classes rares
La colonne « naif » montre 2 plis sur 5 sans aucun positif (plis 2 et 4 : zéro exemple de la classe rare en validation) — 40 % des mesures portent sur un jeu où la classe intéressante est absente, donc évaluent la bonne réponse à une question jamais posée. Le k-fold stratifié répartit 1, 1, 1, 1, 2 positifs : chaque pli voit la classe rare. Le gain se lit sur la dispersion : écart-type 0,029 → 0,010, divisé par trois à moyenne identique (0,970). Et c’est là le piège le plus instructif : avec 3,0 % de positifs, prédire systématiquement « négatif » rapporte 0,970 d’accuracy — les deux moyennes collent au score trivial ; seule la variance trahit laquelle des deux évaluations est digne de confiance.
3.2 La fuite temporelle : un k-fold aléatoire est faux sur une série temporelle
Le k-fold mélange les lignes : un pli de test peut contenir des points intercalés dans le temps, et leurs voisins passés et futurs se retrouvent dans le pli d’entraînement. Sur des données i.i.d. c’est parfait ; sur une série temporelle, c’est une fuite d’informations : le modèle apprend à interpeler le futur plutôt qu’à le prévoir.
TimeSeriesSplit impose l’ordre chronologique : on entraîne uniquement sur le passé et on teste sur le futur (fenêtre expansive). Comparons les deux sur une série à forte dépendance temporelle, avec un modèle strictement identique.
# Serie temporelle synthetique : tendance + sinus lent + bruit (forte dependance temporelle)from sklearn.model_selection import TimeSeriesSplitfrom sklearn.neighbors import KNeighborsRegressorrng = np.random.default_rng(42)n =300t = np.arange(n).astype(float).reshape(-1, 1)y_ts =0.02* np.arange(n) +6.0* np.sin(np.arange(n) /12.0) + rng.normal(0, 0.3, n)# Le meme modele (KNN sur l'indice temporel) sous deux hypotheses sur les donneesknn = KNeighborsRegressor(n_neighbors=3)# Split ALEATOIRE : le futur est inleve dans le train (fuite)s_naif = cross_val_score(knn, t, y_ts, cv=KFold(n_splits=5, shuffle=True, random_state=0), scoring="r2")# Split TEMPOREL : uniquement le passe pour predire le futurs_tss = cross_val_score(knn, t, y_ts, cv=TimeSeriesSplit(n_splits=5), scoring="r2")print("Split ALEATOIRE :", np.round(s_naif, 3))print("TimeSeriesSplit :", np.round(s_tss, 3))print()print(f"Moyenne aleatoire : {s_naif.mean():.3f} | TimeSeriesSplit : {s_tss.mean():.3f}")print(f"Ecart R2 (fuite quantifiee) : {s_naif.mean() - s_tss.mean():.3f}")
L’écart entre les deux lignes mesure le mensonge du découpage : R² ≈ 0,990 en moyenne pour le split aléatoire, −2,566 pour TimeSeriesSplit, soit une fuite de 3,556 points de R² fabriquée par le seul choix du découpage. Le split aléatoire mélange passé et futur : pour chaque pli de validation, le modèle dispose d’observations postérieures à celles qu’il doit prédire — il interpole, il ne prévoit pas. TimeSeriesSplit l’oblige à extrapoler, et le R² négatif dit crûment que la prédiction est pire que la moyenne constante de la cible. Règle pratique : dès qu’existe un axe temporel (prix, capteurs, cohortes), le k-fold aléatoire n’est pas « approximatif » — il est faux, et l’écart ci-dessus en est la mesure.
3.3 Quel split pour quel type de données ?
Les sections 1-3 nous ont donné les outils ; ce tableau est le guide de choix qui décide quand les utiliser.
Nature des données
Split adapté
Pourquoi
i.i.d., classes équilibrées
k-fold
Un seul découpage est bruité ; le k-fold moyenne les scores des plis.
i.i.d., classes déséquilibrées
StratifiedKFold
Le k-fold naïf peut produire un pli à 0 positif (mesuré en 3.1), score dégénéré et variance gonflée.
Données temporelles (séries, finance, …)
TimeSeriesSplit (fenêtre expansive)
Le k-fold aléatoire met du futur dans le train (mesuré en 3.2) : un R² de 0,99 qui masque un vrai score de -2,57.
Groupes (un même sujet observé plusieurs fois)
GroupKFold
Évite qu’un même groupe soit simultanément dans le train et le test (fuite d’identité).
Transition vers la suite. C’est TimeSeriesSplit qui devient le réflexe des notebooks de séries temporelles (ML-5-TimeSeries) et surtout des notebooks QuantConnect : la validation walk-forward exigée par notre règle d’évaluation (règle C du review) n’est rien d’autre qu’une validation croisée temporelle. Vous venez de voir d’où elle vient — et le prix de l’oublier.
Exercice 2 : quantifier la fuite temporelle sur une série de prix
Vous disposez d’une série de prix journaliers. Reproduisez le raisonnement de 3.2 : pourquoi un k-fold aléatoire surestime-t-il la performance d’un modèle de prévision, et quel split utiliseriez-vous à la place ? Quantifiez l’écart de R² comme en 3.2.
# Exercice 2 : comparer KFold(aleatoire) vs TimeSeriesSplit sur une serie de prix# TODO etudiant : charger (ou simuler) une serie de prix, choisir un modele de regression,# puis calculer le score R2 sous les deux splits et afficher l'ecart (fuite quantifiee).resultat =None# TODO etudiant : remplacer par l'ecart de R2 (naif - temporal)print(f"Exercice 2 a completer : ecart R2 (fuite temporelle) = {resultat}")
Pour chacun des scénarios suivants, choisissez le split adapté parmi KFold, StratifiedKFold, TimeSeriesSplit et GroupKFold, puis justifiez votre choix en une phrase :
une détection de fraude bancaire avec 0,5 % de transactions positives ;
un capteur de température produisant une mesure horodatée toutes les minutes ;
un jeu médical où chaque patient contribue plusieurs prélèvements.
Le troisième cas n’est pas i.i.d. : deux prélèvements du même patient ne doivent jamais être séparés entre entraînement et test.
# Exercice 3 : choisir le bon split (a completer)# TODO etudiant : renseigner un split par scenario et justifier chaque choix.reponse_split =None# TODO etudiantprint("Exercice 3 a completer : choisir le split adapte a chaque scenario.")
Exercice 3 a completer : choisir le split adapte a chaque scenario.
Vérification 1 — découper une série temporelle
question("Sur une série de prix, pourquoi un k-fold aléatoire est-il trompeur ?", choix=["Parce que les plis mélangent passé et futur : le modèle s'entraîne sur des points postérieurs à ceux qu'il évalue","Parce que les séries temporelles sont trop courtes pour k plis","Parce que la validation croisée ne s'applique qu'à la classification", ], bonne="A", explication="Mélanger les dates fait fuiter le futur dans l'entraînement : le score obtenu est meilleur que celui qu'on obtiendra en production. C'est la fuite temporelle quantifiée dans cette section.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — Sur une série de prix, pourquoi un k-fold aléatoire est-il trompeur ?

  A. Parce que les plis mélangent passé et futur : le modèle s'entraîne sur des points postérieurs à ceux qu'il évalue
  B. Parce que les séries temporelles sont trop courtes pour k plis
  C. Parce que la validation croisée ne s'applique qu'à la classification

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
4. Comparer les modèles par validation croisée
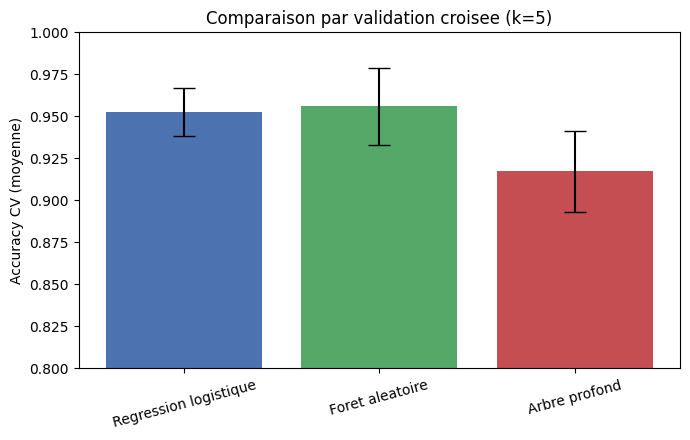
Évaluons maintenant les trois modèles par validation croisée 5-fold sur l’ensemble des données, et comparons les scores moyens (avec l’écart-type comme barre d’incertitude). C’est la démarche principielle pour choisir un modèle : non pas un seul découpage arbitraire, mais une estimation accompagnée de son incertitude.
# Comparaison des 3 modeles par validation croiseeprint(f"{'Modele':22s} | {'moyenne':>9s} | {'ecart-type':>10s}")print("-"*50)for nom, modele in modeles: sc = cross_val_score(modele, X, y, cv=5)print(f"{nom:22s} | {sc.mean():9.3f} | {sc.std():10.3f}")
Le choix de k n’est pas anodin. Recalculez le score de validation croisée de la régression logistique avec cv=10 au lieu de 5 et comparez la moyenne à celle de scores_cv (cv=5, cellule précédente). Un k plus grand utilise davantage de données pour l’entraînement (plis de test plus petits) : la moyenne a tendance à être légèrement optimiste, mais le coût de calcul augmente.
Indices : - # Étape 1 : appeler cross_val_score(LogisticRegression(max_iter=1000), X, y, cv=10). - # Étape 2 : stocker le résultat dans scores_cv10 puis moyenne_cv10 = np.mean(scores_cv10). - # Étape 3 : comparer à scores_cv.mean() (cv=5).
# Exercice 4 : recalculer le score CV de la regression logistique avec cv=10# TODO etudiant : cross_val_score avec cv=10 sur la regression logistique (X, y)scores_cv10 =None# TODO etudiant : remplacer# TODO etudiant : comparer la moyenne a celle de scores_cv (cv=5)moyenne_cv10 =None# TODO etudiant : remplacer (np.mean(scores_cv10))print(f"Exercice 4 a completer : moyenne cv=10 = {moyenne_cv10}")
Exercice 4 a completer : moyenne cv=10 = None
5. Au-delà de l’accuracy : faux positifs et faux négatifs
L’accuracy globale masque le type d’erreurs commises. Or dans un diagnostic de cancer du sein, un faux négatif (manquer une tumeur maligne) est bien plus coûteux qu’un faux positif (faire passer un examen complémentaire à un patient sain). Nous avons besoin de la matrice de confusion et de la courbe ROC pour voir la structure des erreurs, pas seulement leur nombre agrégé.
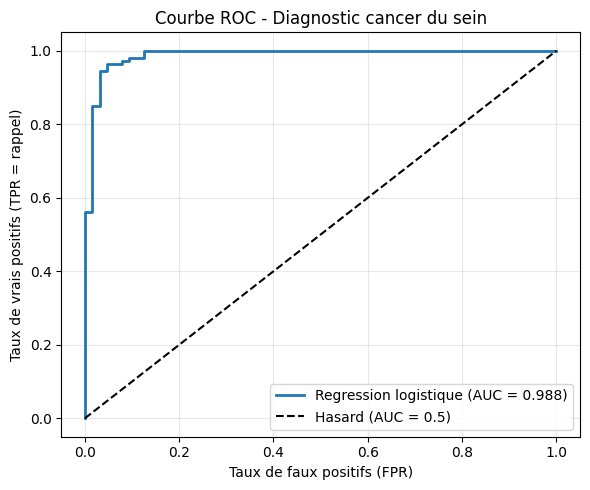
# Courbe ROC et AUC de la regression logistique sur l'ensemble de testmeilleur_modele = LogisticRegression(max_iter=1000)meilleur_modele.fit(X_train, y_train)# Probabilites predites pour la classe 1 (benin)proba_test = meilleur_modele.predict_proba(X_test)[:, 1]# Courbe ROC et AUCfpr, tpr, seuils = roc_curve(y_test, proba_test)auc_score = roc_auc_score(y_test, proba_test)plt.figure(figsize=(6, 5))plt.plot(fpr, tpr, label=f"Regression logistique (AUC = {auc_score:.3f})", linewidth=2)plt.plot([0, 1], [0, 1], "k--", label="Hasard (AUC = 0.5)")plt.xlabel("Taux de faux positifs (FPR)")plt.ylabel("Taux de vrais positifs (TPR = rappel)")plt.title("Courbe ROC - Diagnostic cancer du sein")plt.legend(loc="lower right")plt.grid(alpha=0.3)plt.tight_layout()plt.show()
Lecture de la courbe ROC
La figure se lit point par point : chaque point est un seuil de décision ; l’abscisse porte le taux de faux positifs (FPR), l’ordonnée le taux de vrais positifs (TPR). La diagonale est la ligne du hasard — un classifieur qui répond au pile-ou-face ; plus la courbe colle au coin supérieur gauche (FPR = 0, TPR = 1), plus le modèle ordonne correctement les exemples à ce seuil. Ce qui frappe ici : la courbe reste au-dessus de la diagonale sur toute la plage, signe que le signal est exploitable à n’importe quel seuil, pas seulement à 0,5. L’AUC — l’aire sous cette courbe, que l’exercice 5 mesure — résume le tout en un nombre : la probabilité qu’un exemple positif reçoive un score plus élevé qu’un négatif tiré au hasard.
6. La courbe ROC et l’AUC
La courbe ROC (Receiver Operating Characteristic) trace le TPR (taux de vrais positifs, c’est-à-dire le rappel) en fonction du FPR (taux de faux positifs) pour tous les seuils de décision possibles. Plus la courbe se rapproche du coin supérieur gauche, meilleur est le classifieur. La diagonale correspond à un classifieur aléatoire (AUC = 0.5).
L’AUC (aire sous la courbe) se lit comme la probabilité que le modèle classe un exemple positif au-dessus d’un exemple négatif tirés au hasard. Elle est indépendante du seuil de décision, contrairement à l’accuracy : c’est ce qui en fait une métrique équitable pour comparer deux classifieurs dont les seuils par défaut pourraient différer.
Référence. Bradley, A.P. (1997), The Use of the Area Under the ROC Curve in the Evaluation of Machine Learning Algorithms, Pattern Recognition 30(6):1145-1159. L’AUC (aire sous la courbe ROC) y est établie comme métrique robuste, indépendante du seuil de décision, pour comparer des classifieurs.
Exercice 5 : interpréter l’AUC
L’AUC mesure la probabilité que le modèle classe un exemple positif au-dessus d’un exemple négatif tirés au hasard. Reprenez auc_score calculé dans la cellule précédente, comparez-le à 0,5 (hasard), puis qualifiez la discrimination du modèle.
# Exercice 5 : interpreter l'AUC# TODO etudiant : l'AUC mesure la probabilite que le modele classe un positif au-dessus d'un negatif# TODO etudiant : reprendre auc_score (cellule precedente) et le comparer a 0.5 (hasard)verdict_auc =None# TODO etudiant : remplacer par une chaine, ex "excellent (>0.9)" ou "correct (0.7-0.9)" ou "faible (<0.7)"print(f"Exercice 5 a completer : AUC = {auc_score:.3f} => {verdict_auc}")
Exercice 5 a completer : AUC = 0.988 => None
Vérification 2 — ce que mesure l’AUC
question("Que mesure l'aire sous la courbe ROC ?", choix=["L'accuracy obtenue au seuil 0,5","La qualité du classement par le score, tous seuils confondus","Le nombre de faux positifs au seuil optimal", ], bonne="B", explication="La courbe ROC décrit le couple (rappel, faux positifs) que l'on obtient en balayant tous les seuils possibles ; l'AUC résume ce balayage. Elle ne dit rien du seuil à utiliser : ce choix vient des coûts relatifs des deux erreurs.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — Que mesure l'aire sous la courbe ROC ?

  A. L'accuracy obtenue au seuil 0,5
  B. La qualité du classement par le score, tous seuils confondus
  C. Le nombre de faux positifs au seuil optimal

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
7. Choisir un seuil de décision
Par défaut, un classifieur comme la régression logistique prédit la classe 1 dès que la probabilité estimée dépasse 0.5. Ce seuil n’a rien de magique. En médecine, on peut vouloir le baisser (ex. 0.3) pour rattraper davantage de cas positifs, quitte à déclencher plus de fausses alarmes ; ou au contraire le monter si le coût d’un faux positif est élevé. Se déplacer le long de la courbe ROC, c’est exactement échanger du TPR contre du FPR. Le bon point de fonctionnement dépend du coût relatif des erreurs.
# Matrices de confusion a deux seuils differents pour le meme modeleproba = meilleur_modele.predict_proba(X_test)[:, 1]pred_05 = (proba >=0.5).astype(int)pred_03 = (proba >=0.3).astype(int)print("Seuil = 0.5 (par defaut)")print(confusion_matrix(y_test, pred_05))print("\nSeuil = 0.3 (plus sensible aux positifs)")print(confusion_matrix(y_test, pred_03))print("\nInterpretation : la matrice de confusion s'organise en")print("[[vrais negatifs, faux positifs], [faux negatifs, vrais positifs]].")print("Ici, abaisser le seuil de 0.5 a 0.3 ramene les faux negatifs de 2 a 0")print("sans augmenter les faux positifs (8 aux deux seuils) : sur ce modele bien")print("calibre, le gain est gratuit. Le cout en faux positifs n'apparait qu'a")print("des seuils plus bas (cf. courbe ROC).")
Seuil = 0.5 (par defaut)
[[ 56   8]
 [  2 105]]

Seuil = 0.3 (plus sensible aux positifs)
[[ 56   8]
 [  0 107]]

Interpretation : la matrice de confusion s'organise en
[[vrais negatifs, faux positifs], [faux negatifs, vrais positifs]].
Ici, abaisser le seuil de 0.5 a 0.3 ramene les faux negatifs de 2 a 0
sans augmenter les faux positifs (8 aux deux seuils) : sur ce modele bien
calibre, le gain est gratuit. Le cout en faux positifs n'apparait qu'a
des seuils plus bas (cf. courbe ROC).
Lecture : le seuil comme décision d’application
Passer le seuil de 0,5 à 0,3 ramène les faux négatifs de 2 à 0 — les deux exemples positifs manqués sont rattrapés — sans coût en faux positifs (8 aux deux seuils) : le terme diagonal inférieur passe de 105 à 107 sur 107. Cette dissymétrie du gain est la leçon centrale : dans une application où un faux négatif et un faux positif n’ont pas le même coût (une maladie manquée contre un examen complémentaire), aucun score global ne capture la différence — elle ne se lit que dans la matrice de confusion, seuil par seuil. Le seuil « optimal » n’est donc pas une réponse statistique mais une décision d’application : le rapport de coûts FN/FP appartient au domaine, pas au modèle. Que ce gain soit ici gratuit (0 faux positif supplémentaire) tient à la qualité du classifieur — sur un modèle plus faible, abaisser le seuil se serait payé.
Synthèse : quel modèle, quelle métrique ?
Trois leçons à retenir :
Biais vs variance : un modèle trop simple sous-apprend (biais élevé), un modèle trop complexe surapprend (variance élevée). La bonne complexité minimise l’erreur de généralisation, pas l’erreur d’entraînement.
Estimation fiable : la validation croisée k-fold remplace le découpage unique par une moyenne ± écart-type, quantifiant l’incertitude de l’évaluation.
Choix de métrique : l’accuracy suffit sur des données équilibrées et des coûts symétriques. Dès qu’une classe est rare ou qu’un type d’erreur coûte plus cher, on passe à l’AUC (seuil-indépendant) et on choisit son seuil selon le coût des faux positifs / faux négatifs.
La validation croisée resserre le verdict du simple split : régression logistique 0,953 ± 0,014, forêt aléatoire 0,956 ± 0,023, arbre profond 0,917 ± 0,024. Deux lectures s’imposent. D’abord, l’écart de 0,003 entre forêt et régression logistique est non concluant : leurs intervalles à ±1 écart-type se recouvrent largement — à ce niveau, préférer la forêt revient à élire un bruit d’échantillon. Ensuite, l’arbre profond perd 3,6 points de moyenne : c’est le modèle le plus expressif du trio et le plus pauvre en généralisation — la variance de mémorisation s’y paie en toutes lettres, confirmant la lecture du comparatif train/test. La régression logistique, à la dispersion la plus faible, s’impose comme candidat robuste par défaut ; la forêt ne se justifierait que si son avance survivait à une comparaison multi-graine.
Exercice 6 (capstone) : diagnostiquer biais et variance avec une courbe d’apprentissage
Les exercices précédents comparent des modèles par validation croisée et lisent une courbe ROC. Il reste un outil de diagnostic central pour le compromis biais / variance : la courbe d’apprentissage (learning curve). Elle trace le score — en entraînement et en validation — en fonction de la taille du jeu d’entraînement, et permet de distinguer deux régimes :
biais élevé (sous-apprentissage) : les deux courbes convergent vers un score faible ; ajouter des données n’aide pas, il faut un modèle plus expressif ou de meilleures variables ;
variance élevée (sur-apprentissage) : le score d’entraînement est élevé mais le score de validation reste en dessous ; l’écart se réduit avec plus de données, il faut en ajouter ou régulariser.
Objectif. Pour la régression logistique et l’arbre de décision, tracer la courbe d’apprentissage sur X_train / y_train et identifier lequel souffre plutôt de biais, lequel plutôt de variance.
Indice 1 : from sklearn.model_selection import learning_curve.
Indice 2 : learning_curve(est, X, y, train_sizes=np.linspace(0.1, 1.0, 10), cv=5) renvoie (train_sizes, train_scores, test_scores) où chaque ligne de scores correspond à un train_sizes et chaque colonne à un pli de la CV.
Indice 3 : tracer train_scores.mean(axis=1) et test_scores.mean(axis=1) ; ajouter une bande fill_between(..., mean +/- std) pour visualiser la variabilité. Un écart persistant entre les deux courbes = variance ; une convergence à un plateau bas = biais.
# Exercice 6 (capstone) : courbe d'apprentissage de la regression logistique# et de l'arbre de decision sur breast_cancer.# Etape 1 : importer learning_curve depuis sklearn.model_selection.# Etape 2 : pour chacun des 2 modeles, calculer train_sizes + train_scores + test_scores# avec cv=5 et train_sizes=np.linspace(0.1, 1.0, 10).# Etape 3 : tracer (2 sous-figures) le score moyen train vs validation +/- ecart-type,# et commenter : quel modele a un probleme de biais ? De variance ?# Indice : la convergence des deux courbes vers un plateau bas signe un biais ;# un ecart persistant (train haut, validation basse) signe une variance.resultat =None# TODO etudiantprint("Exercice 6 a completer : tracer les courbes d'apprentissage.")
Exercice 6 a completer : tracer les courbes d'apprentissage.
Après le parcours — question de transfert
question("Vous devez fixer un seuil de décision en production. Que vous donnent la courbe ROC et son AUC ?", choix=["Le seuil qu'il faut utiliser","Les couples (rappel, faux positifs) atteignables : le choix du seuil dépend du coût relatif des deux erreurs","La garantie que le seuil 0,5 est le meilleur", ], bonne="B", explication="Un modèle postal et un modèle de dépistage ne choisissent pas le même point de la courbe, à AUC égale. La courbe décrit les possibles ; la décision, elle, appartient au métier.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="apres",)
Transfert — Vous devez fixer un seuil de décision en production. Que vous donnent la courbe ROC et son AUC ?

  A. Le seuil qu'il faut utiliser
  B. Les couples (rappel, faux positifs) atteignables : le choix du seuil dépend du coût relatif des deux erreurs
  C. La garantie que le seuil 0,5 est le meilleur

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
Conclusion et transition
Nous avons formalisé le compromis biais-variance entrevu empiriquement en 2.1 et 2.4, puis outillé son évaluation : la validation croisée k-fold pour une estimation fiable (moyenne ± écart-type plutôt qu’un seul découpage bruité), et la courbe ROC avec l’AUC pour juger un classifieur au-delà de l’accuracy et choisir un seuil de décision adapté au coût des erreurs.
L’accrétion 2.5d-Derive-Distribution-Deploiement.ipynb prolonge ce socle par l’étude des dérives entre la validation croisée et le déploiement, et les garde-fous à mettre en place (monitoring de distribution, signal d’alerte) lorsqu’un modèle quitte l’expérimentation pour la production.
Le notebook suivant (2.6-Clustering-KMeans-PCA) quitte l’apprentissage supervisé pour l’apprentissage non supervisé : clustering (KMeans) et réduction de dimension (PCA), sans étiquettes.
References
Geman, S., Bienenstock, É. & Doursat, R. (1992). Neural Networks and the Bias/Variance Dilemma. Neural Computation 4(1):1-58. — Décomposition biais-variance, l’arbitrage fondamental.
Stone, M. (1974). Cross-Validatory Choice and Assessment of Statistical Predictions. Journal of the Royal Statistical Society. Series B 36(2):111-147. — La validation croisée comme estimation fiable de l’erreur de généralisation.
Bradley, A.P. (1997). The Use of the Area Under the ROC Curve in the Evaluation of Machine Learning Algorithms. Pattern Recognition 30(6):1145-1159. — L’AUC, métrique seuil-indépendante pour comparer des classifieurs.
Hastie, T., Tibshirani, R. & Friedman, J. (2009). The Elements of Statistical Learning. Springer (2e éd.), §7.10-7.11. — Validation croisée et compromis biais-variance.
Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12:2825-2830. — cross_val_score, roc_curve, roc_auc_score, confusion_matrix.