A la fin de ce laboratoire, vous saurez : 1. Charger et manipuler des données avec Pandas 2. Explorer un DataFrame (info, describe, head) 3. Filtrer et sélectionner des données avec des conditions 4. Visualiser des données avec Matplotlib 5. Entraîner un modèle de régression linéaire simple
Prérequis
Python 3.10+
Bibliothèques : pandas, matplotlib, scikit-learn
Aucune expérience préalable en Data Science requise
Durée estimée : 30-40 minutes
Introduction à Pandas
Pandas est la bibliothèque de référence pour la manipulation de données en Python. Elle introduit deux structures : la Series (un vecteur indexé, une colonne) et le DataFrame (un tableau à deux axes — lignes indexées, colonnes nommées) qui couvre l’essentiel des besoins de la data science tabulaire. Pourquoi un DataFrame plutôt qu’une liste de listes ? Parce que chaque colonne porte un dtype contrôlé (entier, chaîne, date), que les opérations sont vectorisées (filtrer, moyenner, grouper s’écrivent en une expression, sans boucle) et que l’alignement par index empêche les erreurs d’appariement silencieuses. La cellule ci-dessous montre d’abord un DataFrame minimal construit à la main, puis construit le dataset qui servira à tout le laboratoire : des ventes quotidiennes de cinq produits sur soixante jours. Notez le np.random.seed(42) : le dataset est synthétique mais déterministe — ré-exécuter le notebook produira exactement les mêmes chiffres que ceux commentés dans la suite.
import pandas as pdimport numpy as npfrom datetime import datetime, timedelta# Créer un DataFrame avec un dataset réaliste de ventesnp.random.seed(42) # Pour reproductibilité# Générer 60 jours de données de ventesn_days =60start_date = datetime(2024, 1, 1)dates = [start_date + timedelta(days=i) for i inrange(n_days)]# Produits avec prix et catégoriesproduits = {'Widget A': {'prix_base': 150, 'categorie': 'Electronique'},'Widget B': {'prix_base': 80, 'categorie': 'Electronique'},'Gadget X': {'prix_base': 45, 'categorie': 'Accessoires'},'Gadget Y': {'prix_base': 30, 'categorie': 'Accessoires'},'Module Z': {'prix_base': 200, 'categorie': 'Premium'}}# Générer les transactionsdata = []for date in dates:for produit, info in produits.items():# Variation saisonnière + bruit aléatoire saison =1+0.3* np.sin(2* np.pi * date.timetuple().tm_yday /365) ventes =int(info['prix_base'] * saison * (0.8+0.4* np.random.random())) data.append({'Date': date.strftime('%Y-%m-%d'),'Produit': produit,'Categorie': info['categorie'],'Prix_Unitaire': info['prix_base'],'Ventes': ventes })df = pd.DataFrame(data)# Créer aussi un DataFrame simple pour la démonstrationdf_simple = pd.DataFrame({'col1': [1, 2], 'col2': [3, 4]})print("DataFrame simple :")print(df_simple)print(f"\nDataset de ventes : {len(df)} enregistrements sur {n_days} jours")print(f"Produits : {df['Produit'].nunique()} | Catégories : {df['Categorie'].nunique()}")print("\nAperçu des données :")df.head(10)
DataFrame simple :
   col1  col2
0     1     3
1     2     4

Dataset de ventes : 300 enregistrements sur 60 jours
Produits : 5 | Catégories : 3

Aperçu des données :
Date
Produit
Categorie
Prix_Unitaire
Ventes
0
2024-01-01
Widget A
Electronique
150
143
1
2024-01-01
Widget B
Electronique
80
94
2
2024-01-01
Gadget X
Accessoires
45
49
3
2024-01-01
Gadget Y
Accessoires
30
31
4
2024-01-01
Module Z
Premium
200
173
5
2024-01-02
Widget A
Electronique
150
130
6
2024-01-02
Widget B
Electronique
80
66
7
2024-01-02
Gadget X
Accessoires
45
52
8
2024-01-02
Gadget Y
Accessoires
30
31
9
2024-01-02
Module Z
Premium
200
218
Lecture du dataset — la sortie résume la construction : 300 enregistrements sur 60 jours, 5 produits, 3 catégories. D’où viennent ces chiffres ? Cinq produits vendus chaque jour pendant 60 jours : 5 x 60 = 300 lignes, exactement. L’aperçu montre la structure : une ligne par couple (produit, jour), avec son prix unitaire (fixe par produit : Widget A a 150 partout) et ses ventes (tirées aléatoirement — la seule colonne qui varie pour un produit donné). La colonne Date est ici une chaîne, pas un type temporel : on le verra dans info() plus bas, et c’est une limite réaliste d’un dataset fabriqué à la main. Enfin, le np.random.seed(42) du code garantit que ces chiffres — 143 ventes de Widget A le 2024-01-01, 173 de Module Z — sont les mêmes à chaque exécution : les lectures qui suivent citent des valeurs que vous retrouverez à l’identique.
Exploration de Données
Avant toute analyse, trois questions et trois outils pour y répondre : à quoi ressemblent les données ? (head() — les premières lignes, brutes), quelle est leur structure ? (info() — nombre de lignes, colonnes, dtypes, valeurs manquantes, empreinte mémoire) et quelle est leur distribution ? (describe() — moyenne, écart-type, quartiles, extrêmes des colonnes numériques). Cette triade suffit à détecter la plupart des problèmes de données avant qu’ils ne contaminent l’analyse : colonne au mauvais dtype, valeurs manquantes, échelle aberrante. La cellule ajoute un quatrième geste, le groupby — agréger les ventes par catégorie — qui est l’opération centrale de l’analyse de données tabulaires : segmenter, agréger, comparer.
# Afficher les premières lignesprint("Premières lignes (head) :")print(df.head())# Obtenir des informations générales sur le DataFrameprint("\nInformations (info) :")df.info()# Obtenir des statistiques descriptivesprint("\nStatistiques descriptives (describe) :")print(df.describe())# Statistiques par catégorieprint("\nVentes moyennes par catégorie :")print(df.groupby('Categorie')['Ventes'].mean().round(2))
Premières lignes (head) :
         Date   Produit     Categorie  Prix_Unitaire  Ventes
0  2024-01-01  Widget A  Electronique            150     143
1  2024-01-01  Widget B  Electronique             80      94
2  2024-01-01  Gadget X   Accessoires             45      49
3  2024-01-01  Gadget Y   Accessoires             30      31
4  2024-01-01  Module Z       Premium            200     173

Informations (info) :
<class 'pandas.DataFrame'>
RangeIndex: 300 entries, 0 to 299
Data columns (total 5 columns):
 #   Column         Non-Null Count  Dtype
---  ------         --------------  -----
 0   Date           300 non-null    str
 1   Produit        300 non-null    str
 2   Categorie      300 non-null    str
 3   Prix_Unitaire  300 non-null    int64
 4   Ventes         300 non-null    int64
dtypes: int64(2), str(3)
memory usage: 20.2 KB

Statistiques descriptives (describe) :
       Prix_Unitaire      Ventes
count     300.000000  300.000000
mean      101.000000  114.370000
std        64.636881   74.929977
min        30.000000   26.000000
25%        45.000000   46.000000
50%        80.000000   93.000000
75%       150.000000  186.000000
max       200.000000  284.000000

Ventes moyennes par catégorie :
Categorie
Accessoires      42.64
Electronique    131.33
Premium         223.90
Name: Ventes, dtype: float64
Lecture du trio d’inspection — chaque outil répond à sa question. head() : cinq lignes, une par produit du premier jour, l’ordre du dictionnaire de construction. info() : 300 entrées, 5 colonnes, aucune valeur manquante (300 non-null partout), dtypes str pour les trois colonnes textuelles et int64 pour les deux numériques, 20.2 KB en mémoire — un dataset propre, où le seul point de vigilance est le Date en chaîne. describe() : les ventes vont de 26 à 284 autour d’une moyenne de 114.37 (écart-type 74.93) ; les quartiles montrent une distribution étalée, pas concentrée. Détail révélateur : les colonnes de Prix_Unitaire ont des quartiles qui tombent exactement sur 30 / 45 / 80 / 150 / 200 — les cinq prix de base, chacun présent 60 fois (une fois par jour). Un describe qui affiche les valeurs discrètes d’une variable « continue » est toujours la trace d’une construction synthétique. Et le groupby final établit la hiérarchie commerciale : Accessoires 42.64, Electronique 131.33, Premium 223.90 — un facteur 5 entre les extrêmes, structurant pour tout ce qui suit.
Sélection et Filtrage
Deux gestes distincts qu’il ne faut pas confondre : la sélection (df['Produit']) extrait des colonnes — le résultat est une Series, le vecteur des valeurs d’une variable ; le filtrage (df[df['Ventes'] > 100]) extrait des lignes — le résultat est un DataFrame complet, réduit aux lignes qui satisfont la condition. Le filtrage exploite le masque booléen : df['Ventes'] > 100 produit d’abord un vecteur de True/False (une par ligne), puis les crochets ne gardent que les lignes vraies. C’est ce mécanisme qui rend les conditions composées naturelles — df[(df['Categorie'] == 'Electronique') & (df['Ventes'] > 100)] combine les masques avec & et | (et non and/or, qui ne savent pas se vectoriser). La cellule montre les deux, plus la sélection simultanée de colonnes via une liste df[['Date', 'Produit', 'Ventes']].
# Sélectionner une seule colonneproduits = df['Produit']print("Colonne 'Produit' (5 premiers) :")print(produits.head())# Filtrer les lignes où les ventes sont supérieures à 100ventes_elevees = df[df['Ventes'] >100]print(f"\nVentes supérieures à 100 : {len(ventes_elevees)} enregistrements")print(ventes_elevees.head())# Filtrer par catégorieelectronique = df[df['Categorie'] =='Electronique']print(f"\nProduits Electronique : {len(electronique)} enregistrements")print(electronique[['Date', 'Produit', 'Ventes']].head())
Colonne 'Produit' (5 premiers) :
0    Widget A
1    Widget B
2    Gadget X
3    Gadget Y
4    Module Z
Name: Produit, dtype: str

Ventes supérieures à 100 : 135 enregistrements
          Date   Produit     Categorie  Prix_Unitaire  Ventes
0   2024-01-01  Widget A  Electronique            150     143
4   2024-01-01  Module Z       Premium            200     173
5   2024-01-02  Widget A  Electronique            150     130
9   2024-01-02  Module Z       Premium            200     218
10  2024-01-03  Widget A  Electronique            150     123

Produits Electronique : 120 enregistrements
          Date   Produit  Ventes
0   2024-01-01  Widget A     143
1   2024-01-01  Widget B      94
5   2024-01-02  Widget A     130
6   2024-01-02  Widget B      66
10  2024-01-03  Widget A     123
Lecture du filtrage — la sélection retourne bien une Series (une colonne, son dtype str, son index) ; le filtrage retourne bien un DataFrame réduit. Ventes > 100 garde 135 enregistrements sur 300 — 45 % des lignes, cohérent avec une moyenne à 114.37 : un seuil posé presque à la moyenne coupe mécaniquement la population à peine sous la moitié. Le filtre par catégorie donne 120 lignes : deux produits Electronique x 60 jours, exactement le compte attendu — quand un filtre retourne pile le produit cartésien attendu, c’est le signe que le dataset n’a pas de trou. Dernier détail instructif : les index des lignes filtrées (0, 4, 5, 9, 10…) sont non contigus et préservés — le masque ne renumérote pas, il sélectionne ; pour réindexer, il faudrait .reset_index(drop=True) explicitement.
Visualisation de Données
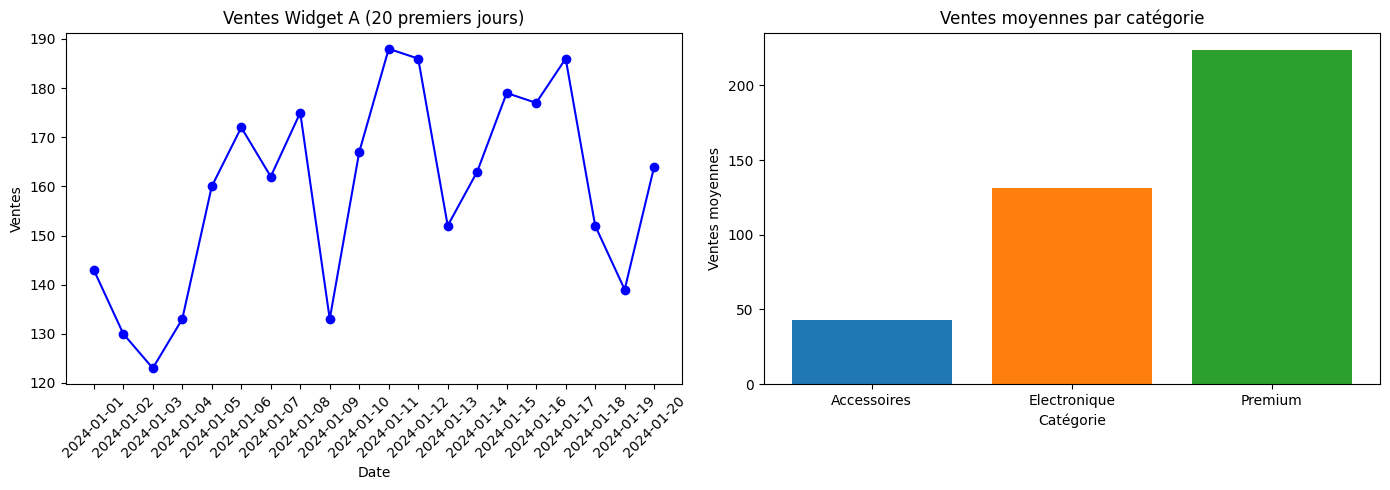
La visualisation n’est pas une décoration : c’est un outil de diagnostic. La cellule construit une figure à deux panneaux (plt.subplots(1, 2)) parce qu’elle pose deux questions différentes : une série temporelle (courbe) — comment les ventes d’un produit évoluent-elles dans le temps ? — et une comparaison de groupes (barres) — quelles catégories vendent le plus ? Chaque type de question a son geométrie : la courbe préserve l’ordre temporel, la barre compare des grandeurs indépendantes. Interchanger les deux (barres pour une série, courbe pour des catégories) rend le graphique illisible — c’est la première décision de design à prendre, avant toute question d’esthétique (figsize, couleurs, rotation des étiquettes).
import matplotlib.pyplot as plt# Graphique 1 : Ventes par date (échantillon)fig, axes = plt.subplots(1, 2, figsize=(14, 5))# Ventes par date pour Widget Awidget_a = df[df['Produit'] =='Widget A']axes[0].plot(widget_a['Date'].values[:20], widget_a['Ventes'].values[:20], 'b-o')axes[0].set_title('Ventes Widget A (20 premiers jours)')axes[0].set_xlabel('Date')axes[0].set_ylabel('Ventes')axes[0].tick_params(axis='x', rotation=45)# Ventes moyennes par catégorieventes_cat = df.groupby('Categorie')['Ventes'].mean()axes[1].bar(ventes_cat.index, ventes_cat.values, color=['#1f77b4', '#ff7f0e', '#2ca02c'])axes[1].set_title('Ventes moyennes par catégorie')axes[1].set_xlabel('Catégorie')axes[1].set_ylabel('Ventes moyennes')plt.tight_layout()plt.show()
Lecture de la figure — les deux panneaux racontent la même histoire sous deux angles. À gauche, la courbe de Widget A sur 20 jours : 143, 130, 123… elle saute de jour en jour sans tendance nette — c’est du bruit autour d’un niveau, pas une croissance. Retenez cette impression visuelle : la section suivante ajustera précisément une tendance sur ces ventes, et son score faible confirmera ce que l’œil voit déjà — il n’y a presque rien à expliquer par le temps seul. À droite, les barres reprennent le groupby de l’exploration (42.64 / 131.33 / 223.90) : la hiérarchie des catégories y est lisible d’un coup d’œil, c’est exactement le travail d’une barre — comparer trois grandeurs indépendantes. Les deux graphiques ensemble posent la question qui structure la fin du labo : ce qui explique les ventes est-il le temps (courbe) ou le produit (barres) ?
Introduction au Machine Learning
Pour cette première approche du Machine Learning, nous utilisons scikit-learn (sklearn), la bibliotheque de reference en Python pour les algorithmes de ML classique (regression, classification, clustering). Elle offre une API uniforme (fit / predict) et des outils d’evaluation (train_test_split, r2_score). Ici, un modèle de regression lineaire est entraite pour predire les ventes futures.
Reference : Pedregosa, F., Varoquaux, G., Gramfort, A., et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12, pp. 2825-2830. arXiv:1201.0490. https://arxiv.org/abs/1201.0490
Le Machine Learning consiste à entraîner un ‘modèle’ sur des données pour qu’il puisse faire des ‘prédictions’ sur de nouvelles données. C’est un concept clé de l’IA. Ici, nous allons simuler une prédiction très simple.
from sklearn.linear_model import LinearRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import r2_score, mean_squared_errorimport numpy as np# Préparer les données pour le ML# Convertir la date en jour de l'année (feature numérique)df['Jour'] = pd.to_datetime(df['Date']).dt.dayofyear# Filtrer un seul produit pour la démonstrationwidget_a = df[df['Produit'] =='Widget A'].copy()X = widget_a[['Jour']].values # Feature : jour de l'annéey = widget_a['Ventes'].values # Target : ventes# Diviser en train/testX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# Créer et entraîner le modèlemodel = LinearRegression()model.fit(X_train, y_train)# Prédictions sur le test sety_pred = model.predict(X_test)# Évaluer le modèler2 = r2_score(y_test, y_pred)rmse = np.sqrt(mean_squared_error(y_test, y_pred))print(f"Performance du modèle :")print(f" R² Score : {r2:.3f}")print(f" RMSE : {rmse:.2f}")print(f" Coefficient : {model.coef_[0]:.4f}")print(f" Intercept : {model.intercept_:.2f}")# Prédire les ventes pour un jour futurjour_futur =90# 31 marsprediction = model.predict([[jour_futur]])print(f"\nPrédiction des ventes pour le jour {jour_futur} : {prediction[0]:.2f}")
Performance du modèle :
  R² Score : 0.229
  RMSE : 20.66
  Coefficient : 0.7251
  Intercept : 148.96

Prédiction des ventes pour le jour 90 : 214.22
Lecture du modèle — un R² honnête : la sortie donne R² = 0.229, et c’est le chiffre le plus instructif du laboratoire. Le modèle régresse les ventes sur le numéro de jour seul : R² = 0.229 signifie qu’il explique 23 % de la variance — et donc que 77 % dépendent d’autre chose. L’autre chose, la figure précédente vient de la nommer : le produit (facteur 5 entre catégories). Les autres métriques se lisent ensemble : RMSE = 20.66 ventes d’erreur typique, à rapporter à la moyenne 114.37 (~18 % d’erreur relative) ; coefficient 0.7251 — le modèle n’apprend qu’une hausse de +0.73 vente par jour, un effet minuscule ; intercept 148.96 — le niveau de départ. Enfin la prédiction du jour 90 : 214.22 : 148.96 + 90 x 0.7251, la droite extrapolée… sur un dataset qui s’arrête au jour 60. Prédire au-delà du domaine observé est l’erreur classique de la régression temporelle — la sortie est arithmétiquement exacte et statistiquement téméraire. La leçon : un score faible n’est pas un échec de code mais une information — la variable explicative choisie (le temps) ne porte qu’un quart du phénomène.
Exercices Pratiques
Les trois exercices réutilisent le DataFrame df et les gestes vus plus haut (groupby, filtrage booléen, régression). Les cellules sont des stubs : complétez-les, le notebook reste exécutable de bout en bout même non rempli.
Critères de réussite (vérifiables sur vos sorties) :
Exercice 1 : trois sorties distinctes (total, moyenne, jour max par produit) sur Widget A et Widget B ; les moyennes doivent être de l’ordre de grandeur des ventes de la catégorie Electronique (~131 en moyenne) — une moyenne à 20 ou à 400 signale une agrégation sur la mauvaise colonne.
Exercice 2 : un compte d’enregistrements strictement inférieur aux 120 lignes Electronique (vous filtrez au-dessus de la moyenne globale 114.37) et cohérent avec la distribution de la catégorie.
Exercice 3 : deux modèles séparés, deux coefficients différents — chaque produit a sa propre dynamique ; une prédiction du jour 7 identique pour les deux produits signale que vous avez régressé sur le DataFrame complet au lieu de filtrer par produit.
# Votre code pour l'Exercice 1# TODO: Calculez le total des ventes par produittotal_ventes_produit =None# Utilisez groupby('Produit')['Ventes'].sum()# TODO: Calculez la moyenne des ventes par produitmoyenne_ventes_produit =None# Utilisez groupby('Produit')['Ventes'].mean()# TODO: Trouvez le jour avec les ventes les plus élevées pour chaque produit# Indice: Utilisez sort_values() puis drop_duplicates()jour_max_ventes =None# Affichage des résultatsprint("Total des ventes par produit :")print(total_ventes_produit)print("\nMoyenne des ventes par produit :")print(moyenne_ventes_produit)print("\nJour avec ventes maximales par produit :")print(jour_max_ventes)
Total des ventes par produit :
None

Moyenne des ventes par produit :
None

Jour avec ventes maximales par produit :
None
Exercice 2 : Filtrage conditionnel et statistiques
À partir du DataFrame df, identifiez les transactions « exceptionnelles » de la catégorie Electronique :
Calculez la moyenne globale des ventes sur tout le dataset
Créez un DataFrame filtré contenant uniquement les transactions de catégorie Electronique dont les ventes sont strictement supérieures à cette moyenne globale
Affichez le nombre d’enregistrements filtrés et un aperçu du résultat
Indices : Utilisez df["Ventes"].mean() pour la moyenne, et combinez les deux conditions avec l’opérateur & (pensez aux parenthèses autour de chaque condition).
# Votre code pour l'Exercice 2# TODO: Calculez la moyenne globale des ventesmoyenne_globale =None# Utilisez df["Ventes"].mean()# TODO: Créez le DataFrame filtré avec les deux conditions# Conditions: Ventes > moyenne_globale ET Categorie == "Electronique"df_filtre =None# Utilisez des parenthèses pour chaque condition# Affichage du résultatif moyenne_globale isnotNoneand df_filtre isnotNone:print(f"Moyenne globale des ventes : {moyenne_globale:.2f}")print(f"Nombre d enregistrements filtrés : {len(df_filtre)}")print("DataFrame filtré (Electronique avec ventes > moyenne) :")print(df_filtre.head())else:print("Exercice à compléter : calculez la moyenne et filtrez le DataFrame")
Exercice à compléter : calculez la moyenne et filtrez le DataFrame
Exercice 3 : Prédictions pour chaque produit
Entraînez un modèle de régression linéaire séparé pour chaque produit (Widget A et Widget B), puis prédisez les ventes pour le jour 7 de chacun.
Indices : filtrez le DataFrame par produit avant d’entraîner (df[df['Produit'] == 'Widget A']), exactement comme la cellule de visualisation a isolé Widget A pour sa courbe. Comparez enfin les deux prédictions : l’écart entre elles mesure combien la dynamique temporelle diffère selon le produit — un avant-goût de la question « le modèle devrait-il voir le produit ? » que la lecture du modèle global posera.
# Votre code pour l'Exercice 3from sklearn.linear_model import LinearRegressionfrom sklearn.model_selection import train_test_splitimport numpy as np# TODO: Créez deux DataFrames, un pour chaque produit (Widget A et Gadget X)df_widget_a =None# Filtrez df où Produit == "Widget A"df_gadget_x =None# Filtrez df où Produit == "Gadget X"# TODO: Préparez les features (X = Jour) et target (y = Ventes) pour Widget AX_a =None# df_widget_a[["Jour"]].valuesy_a =None# df_widget_a["Ventes"].values# TODO: Préparez les features et target pour Gadget XX_x =Noney_x =None# TODO: Entraînez un modèle pour chaque produitmodel_a = LinearRegression()model_x = LinearRegression()# Appelez model.fit(X, y) pour chaque modèle# TODO: Prédisez les ventes pour le jour 90 (31 mars)prediction_a =None# model_a.predict([[90]])[0]prediction_x =None# Affichage des résultatsif prediction_a isnotNoneand prediction_x isnotNone:print(f"Prédiction jour 90 - Widget A : {prediction_a:.2f}")print(f"Prédiction jour 90 - Gadget X : {prediction_x:.2f}")print(f"Différence de prédictions : {abs(prediction_a - prediction_x):.2f}")else:print("Exercice à compléter : filtrez les DataFrames et entraînez les modèles")
Exercice à compléter : filtrez les DataFrames et entraînez les modèles
Conclusion : De la Data aux Agents IA
Félicitations ! Vous avez exploré les briques fondamentales de la Data Science en Python : charger et manipuler des données avec Pandas, les visualiser, et même faire une prédiction simple avec un modèle de Machine Learning.
Ces briques (le DataFrame comme source de connaissance, le Modèle comme outil de raisonnement) sont exactement ce que nous allons apprendre à fournir à des Agents d’IA.
Dans la suite de ce cursus, nous verrons comment un agent peut : 1. Recevoir un Prompt en langage naturel (ex: “Donne-moi le total des ventes pour le Widget A”). 2. Utiliser le DataFrame comme un outil via une API pour trouver la réponse. 3. Utiliser un Modèle de ML pour répondre à des questions plus complexes (ex: “Quelle serait la prévision des ventes pour demain ?”).
Ce laboratoire constitue la base technique essentielle pour construire des systèmes d’IA plus autonomes et intelligents.
Pedregosa, F., Varoquaux, G., Gramfort, A., et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12, pp. 2825-2830. arXiv:1201.0490. https://arxiv.org/abs/1201.0490
McKinney, W. (2010). Data Structures for Statistical Computing in Python. SciPy 2010 proceedings, pp. 51-56.
Harris, C.R., Millman, K.J., et al. (2020). Array programming with NumPy. Nature 585, pp. 357-362.