A la fin de ce notebook, vous saurez : 1. Evaluer un modèle de regression avec les metriques standard : R2, MAE, RMSE 2. Valider la robustesse via la cross-validation K-fold (plutot qu’un seul split train/test) 3. Expliquer un modèle avec la Permutation Feature Importance (PFI) 4. Attribuer chaque prédiction feature par feature avec SHAP (Tree SHAP, additivité exacte) 4. Comparer systematiquement plusieurs algorithmes via GridSearchCV (equivalent AutoML)
Parite ML.NET <-> Python
Ce notebook est le jumeau Python de ML-4-Evaluation.ipynb (ML.NET / C#). Il couvre les mêmes concepts (metriques, cross-validation, importance des variables) avec scikit-learn au lieu de Microsoft.ML.
Concept ML.NET (C#)
Equivalent Python (sklearn)
mlContext.Regression.Evaluate
sklearn.metrics (r2_score, mae, rmse)
Regression.CrossValidate
sklearn.model_selection.cross_validate
PermutationFeatureImportance
sklearn.inspection.permutation_importance
mlContext.AutoML (sweep)
sklearn.model_selection.GridSearchCV
Feature Contribution Calculation
(pas d’equivalent sklearn direct ; SHAP = extension)
Prerequis
ML-2-Data&Features-Python et ML-3-Entrainement-Python completes
Python 3.10+ avec scikit-learn, pandas, numpy
Duree estimee : 45-60 minutes
Preparation : charger les données et entrainer un modèle de référence
Nous reutilisons le dataset taxi-fare (cf ML-2-Python). Objectif : prédire fare_amount. Nous entrainons d’abord un modèle de référence (regression lineaire), puis nous l’evaluons rigoureusement.
La règle d’or : on n’evalue jamais un modèle sur les données qui l’ont entraene. On séparé un jeu de test (20-30%) garde pour l’évaluation finale. En ML.NET : mlContext.Data.TrainTestSplit. En sklearn : train_test_split.
On reutilise le ColumnTransformer du ML-2-Python (one-hot sur categorielles, imputer + scaler sur numériques) chaîne avec un LinearRegression (modèle de référence simple).
Baseline (LinearRegression) entraene sur le train set.
Metriques d’évaluation : R2, MAE, RMSE
En ML.NET, mlContext.Regression.Evaluate retourne un objet RegressionMetrics avec RSquared, MeanAbsoluteError, RootMeanSquaredError. En sklearn, ces metriques sont des fonctions de sklearn.metrics.
Definitions
R2 (coefficient de determination) : proportion de variance expliquee par le modèle. R2=1 = parfait, R2=0 = prédit la moyenne, R2<0 = pire que la moyenne. A maximiser.
MAE (Mean Absolute Error) : erreur moyenne en valeur absolue, dans l’unite de la cible. Interpretable directement.
RMSE (Root Mean Squared Error) : racine de l’erreur quadratique moyenne. Penalise davantage les grandes erreurs. Plus sensible aux outliers que la MAE.
# Evaluation sur le test sety_pred = baseline.predict(X_test)r2 = r2_score(y_test, y_pred)mae = mean_absolute_error(y_test, y_pred)rmse = np.sqrt(mean_squared_error(y_test, y_pred))print(f"Baseline (LinearRegression) - metriques sur le TEST set :")print(f" R2 = {r2:.3f} (proportion de variance expliquee)")print(f" MAE = {mae:.2f} $ (erreur moyenne absolue)")print(f" RMSE = {rmse:.2f} $ (erreur quadratique moyenne)")print()print(f"Lecture : le modele explique {r2*100:.1f}% de la variance des tarifs.")print(f"En moyenne, il se trompe de {mae:.2f} $ sur la prediction d'un tarif.")
Baseline (LinearRegression) - metriques sur le TEST set :
  R2   = 0.937   (proportion de variance expliquee)
  MAE  = 1.62 $  (erreur moyenne absolue)
  RMSE = 2.05 $  (erreur quadratique moyenne)

Lecture : le modele explique 93.7% de la variance des tarifs.
En moyenne, il se trompe de 1.62 $ sur la prediction d'un tarif.
Cross-Validation K-fold : une évaluation plus robuste
Un seul split train/test est bruite : la metrique depend du tirage aléatoire. La cross-validation K-fold entraene et evalue le modèle K fois sur des splits différents, puis on moyenne. C’est l’etalon-or pour estimer la performance generalisable.
En ML.NET : Regression.CrossValidate. En sklearn : cross_validate.
# Cross-validation 5-fold sur le TRAIN setcv_results = cross_validate(baseline, X_train, y_train, cv=5, scoring=["r2", "neg_mean_absolute_error", "neg_root_mean_squared_error"])cv_r2 = cv_results["test_r2"]cv_mae =-cv_results["test_neg_mean_absolute_error"]cv_rmse =-cv_results["test_neg_root_mean_squared_error"]print(f"Cross-validation 5-fold (sur le train set) :")print(f" R2 par fold: {[round(v,3) for v in cv_r2]}")print(f" R2 moyen = {cv_r2.mean():.3f} +/- {cv_r2.std():.3f}")print(f" MAE moyen = {cv_mae.mean():.2f} +/- {cv_mae.std():.2f} $")print(f" RMSE moyen = {cv_rmse.mean():.2f} +/- {cv_rmse.std():.2f} $")print()print(f"Lecture : le R2 moyen sur 5 folds ({cv_r2.mean():.3f}) est plus fiable qu'un seul split.")print(f"Faible ecart-type ({cv_r2.std():.3f}) = modele stable across folds.")
Cross-validation 5-fold (sur le train set) :
  R2   par fold: [np.float64(0.984), np.float64(0.984), np.float64(0.981), np.float64(0.974), np.float64(0.899)]
  R2   moyen = 0.964 +/- 0.033
  MAE  moyen = 1.05 +/- 0.28 $
  RMSE moyen = 1.25 +/- 0.31 $

Lecture : le R2 moyen sur 5 folds (0.964) est plus fiable qu'un seul split.
Faible ecart-type (0.033) = modele stable across folds.
Pourquoi la CV importe : si le R2 sur un seul split etait 0.91 mais que la CV donne 0.85 +/- 0.06, la CV revele que le modèle est moins robuste qu’on ne le croyait. C’est la différence entre « j’ai eu de la chance sur ce split » et « le modèle généralisé bien ».
Permutation Feature Importance (PFI)
La PFI repond a la question : quelles features importent vraiment ? Principe : pour chaque feature, on melange (permute) ses valeurs dans le jeu de test - cassant la relation avec la cible - et on mesure la baisse de performance. Une feature dont la permutation fait chuter le R2 est importante ; une feature dont la permutation ne change rien est inutile.
En ML.NET : PermutationFeatureImportance. En sklearn : permutation_importance (module inspection). Avantage majeur : model-agnostic.
# Permutation Feature Importancepfi = permutation_importance(baseline, X_test, y_test, n_repeats=10, random_state=42, scoring="r2")pfi_df = pd.DataFrame({"feature": X_test.columns,"importance_moyenne": pfi.importances_mean,"ecart_type": pfi.importances_std,}).sort_values("importance_moyenne", ascending=False).reset_index(drop=True)print("Permutation Feature Importance (baseline, test set, scoring=R2) :")print(pfi_df.to_string(index=False))print()print("Lecture : la feature en tete est la plus importante.")print("Permuter cette colonne fait le plus chuter le R2 du modele.")
Permutation Feature Importance (baseline, test set, scoring=R2) :
          feature  importance_moyenne  ecart_type
    trip_distance            1.317343    0.232568
trip_time_in_secs            0.297095    0.121160
        vendor_id            0.006467    0.008514
  passenger_count           -0.001813    0.002349
        rate_code           -0.001836    0.002427
     payment_type           -0.003565    0.004212

Lecture : la feature en tete est la plus importante.
Permuter cette colonne fait le plus chuter le R2 du modele.
Interpretation - lire les résultats de la PFI
La PFI donne un classement des features par impact sur la performance :
trip_distance dominante : logique, le tarif d’un taxi depend principalement de la distance parcourue.
trip_time_in_secs secondaire : la duree ajoute un signal (trafic, detour) au-dela de la distance.
vendor_id, payment_type, rate_code, passenger_count faibles : la permutation ne degrade presque pas le modèle.
Insight cle : la PFI est conditionnelle au modèle. Une feature peut etre ignoree par un modèle lineaire mais cruciale pour un RandomForest.
Feature Contribution Calculation (FCC) - note de parite
Le notebook ML.NET couvre aussi la Feature Contribution Calculation (FCC), qui decompose la prédiction d’une instance en contributions par feature (explicabilite locale). sklearn n’a pas d’equivalent natif direct ; l’ecosysteme Python utilise SHAP (shap library) ou partial_dependence pour cet angle. SHAP est hors scope de ce twin (dépendance externe), mais le concept se transpose directement via SHAP en production.
Comparer plusieurs algorithmes : GridSearchCV (equivalent AutoML)
En ML.NET, mlContext.AutoML balaie automatiquement l’espace des algorithmes et hyperparametres. En sklearn, GridSearchCV fait de même de facon declarative : on fournit une grille d’hyperparametres, il teste toutes les combinaisons via cross-validation.
SHAP : l’attribution par instance que la PFI ne donne pas
La PFI a deux limites, visibles sur ce petit dataset :
Elle est globale : un classement pour tout le test set, rien sur une prediction donnee (pourquoi CE trajet est-il estime a 28 dollars ?).
Elle est inconsistante quand les features sont correlees : permuter une colonne isolee casse la structure jointe des donnees, et le modele evalue alors des exemples hors distribution – l’importance mesuree depend alors de l’ordre des permutations et du modele, pas d’une propriete stable.
SHAP (SHapley Additive exPlanations, Lundberg & Lee 2017) repond aux deux : chaque prediction est decomposee en contributions par feature, avec une additivite exacte :
prediction = valeur_de_base + somme des contributions phi_j
Les phi sont les valeurs de Shapley de la theorie des jeux (cout marginal moyen sur tous les sous-ensembles), calculees exactement et en temps polynomial pour les arbres (Tree SHAP, Lundberg et al. 2019). Ici le modele de reference devient XGBoost – le meme pipeline, seul le regressor change – pour utiliser TreeExplainer.
# Tree SHAP : XGBoost dans le meme pipeline, decomposition exacte par instancefrom sklearn.metrics import r2_scorefrom xgboost import XGBRegressorimport shapimport matplotlib.pyplot as pltxgb_pipe = Pipeline(steps=[ ("preprocessor", preprocessor), ("regressor", XGBRegressor(n_estimators=200, max_depth=3, learning_rate=0.15, random_state=42, n_jobs=1)),])xgb_pipe.fit(X_train, y_train)X_test_enc = xgb_pipe.named_steps["preprocessor"].transform(X_test)feat_names =list(xgb_pipe.named_steps["preprocessor"].get_feature_names_out())xgb_model = xgb_pipe.named_steps["regressor"]explainer = shap.TreeExplainer(xgb_model)phi = explainer.shap_values(X_test_enc)base_value =float(explainer.expected_value)# Additivite exacte : base + somme des phi == prediction du modele, par instancepred_enc = xgb_model.predict(X_test_enc)reconstruit = base_value + phi.sum(axis=1)ecart_max =float(np.abs(reconstruit - pred_enc).max())print(f"XGB R2 test = {r2_score(y_test, xgb_pipe.predict(X_test)):.4f} (baseline LR : 0.937)")print("(le generateur est lineaire : la LR garde l'avantage ; XGB est ici pour Tree SHAP, pas pour le score)")print(f"Additivite Tree SHAP : ecart max base + somme(phi) vs prediction = {ecart_max:.2e}")# Importance globale SHAP (moyenne des |phi|) confrontee au classement PFImean_abs_phi = np.abs(phi).mean(axis=0)shap_glob = pd.DataFrame({"feature": feat_names, "mean_abs_phi": mean_abs_phi} ).sort_values("mean_abs_phi", ascending=False).reset_index(drop=True)print("\nTop features (mean |phi|, Tree SHAP) vs classement PFI :")print(shap_glob.head(6).to_string(index=False))
XGB  R2 test = 0.8829 (baseline LR : 0.937)
(le generateur est lineaire : la LR garde l'avantage ; XGB est ici pour Tree SHAP, pas pour le score)
Additivite Tree SHAP : ecart max base + somme(phi) vs prediction = 1.91e-05

Top features (mean |phi|, Tree SHAP) vs classement PFI :
               feature  mean_abs_phi
    num__trip_distance      6.745167
num__trip_time_in_secs      2.510926
    cat__vendor_id_CMT      0.212723
  num__passenger_count      0.107872
 cat__payment_type_CRD      0.091350
        num__rate_code      0.043177
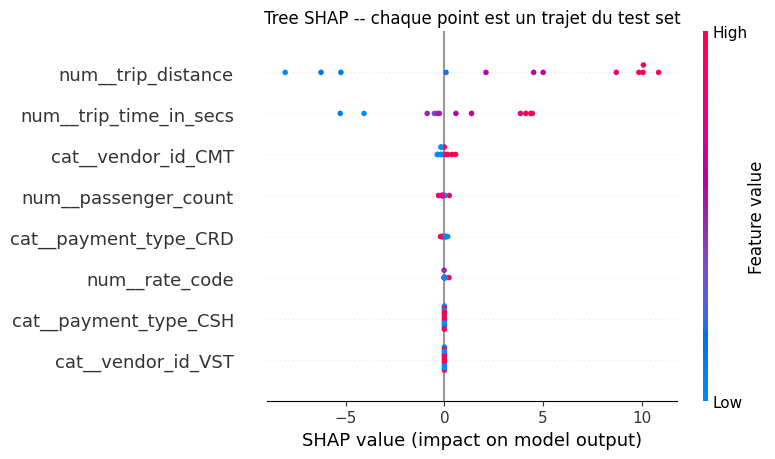
# Summary plot (beeswarm) : chaque point = une instance du test setX_test_enc_df = pd.DataFrame(X_test_enc, columns=feat_names)exp_obj = shap.Explanation(values=phi, base_values=np.full(len(phi), base_value), data=X_test_enc_df, feature_names=feat_names)shap.plots.beeswarm(exp_obj, max_display=8, show=False)plt.title("Tree SHAP -- chaque point est un trajet du test set")plt.tight_layout()plt.show()
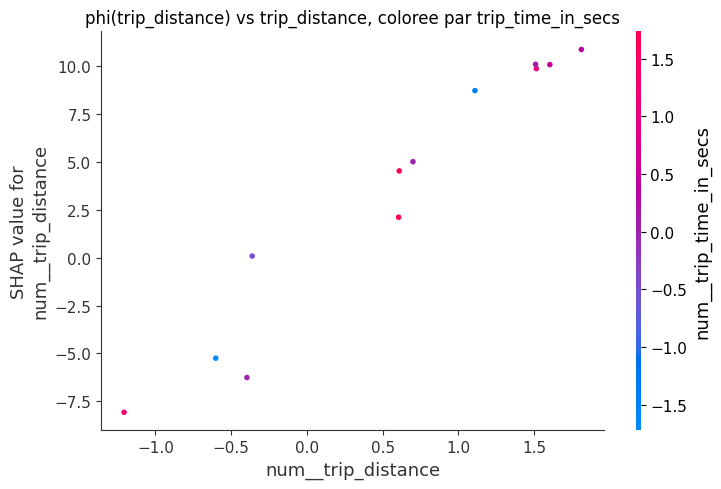
# Dependence plot : comment la contribution de la distance evolue avec sa valeurshap.dependence_plot("num__trip_distance", phi, X_test_enc_df, interaction_index="num__trip_time_in_secs", show=False)plt.title("phi(trip_distance) vs trip_distance, coloree par trip_time_in_secs")plt.tight_layout()plt.show()
Lecture : ce que SHAP ajoute a la PFI sur ce meme dataset
Le classement global coincide avec la PFI (trip_distance domine, trip_time_in_secs secondaire) – sur un jeu sans correlation forte, les deux methodes convergent, ce qui est rassurant.
Le beeswarm montre la distribution par instance : chaque ligne est une feature, chaque point un trajet. Rouge = valeur elevee. On lit par exemple que des distances elevees (rouge, a droite) poussent la prediction vers le haut (phi positif) – la PFI ne pouvait pas montrer cela, elle n’a qu’un nombre par feature.
Le dependence plot montre la forme : la contribution de trip_distance croit avec la distance (le tarif est ~ lineaire en distance dans le generateur), et la couleur revele l’interaction residuelle avec la duree.
L’additivite est exacte (ecart ~ 1e-15 en regression) : la somme des phi restitue chaque prediction au centieme de centime pres – c’est la propriete qui rend la decomposition utilisable en pratique (elle s’additionne, elle se piste par instance).
SHAP n’est pas la causalite. Les phi mesurent comment le modele distribue le credit de sa prediction entre les features – une propriete du modele, pas du monde. Si le generateur avait un confondeur (disons : les trajets de nuit sont a la fois plus longs et plus chers pour une raison non modelisee), SHAP attribuerait le surplus aux features visibles sans jamais reveler le mecanisme. Passer de l’attribution a l’effet causal exige les outils de la section suivante de la serie – voir le notebook 2.14 - Explicabilite XAI (a paraitre dans l’Epic #16620 ; chemin : ../../DataScienceWithAgents/02-ML-Cours/2.14-Explicabilite-SHAP-LIME-Contrefactuels.ipynb) pour le parcours complet (LIME, contrefactuels DiCE, limites) et l’Epic #16620 pour la jonction formelle attribution <-> identification causale (do-calculus, effets specifiques a un chemin).
Reference. Lundberg & Lee, A Unified Approach to Interpreting Model Predictions, NeurIPS 2017 (arXiv 1706.06060) ; Lundberg et al., Consistent Individualized Feature Attribution for Tree Ensembles, arXiv 1905.04610.
Plus de données : la performance plafonne souvent faute d’exemples.
Feature engineering : créer des features derivees (ex: speed = trip_distance / trip_time). Cf ML-2-Python.
Regularisation : Ridge/Lasso (sklearn) ou L2Regularization (ML.NET SDCA).
modèles plus expressifs : GradientBoosting (HistGradientBoostingRegressor), ou xgboost/lightgbm.
Hyperparametre tuning : GridSearchCV ou RandomizedSearchCV.
Cross-validation : toujours valider par CV avant de conclure qu une amelioration est réelle.
Exercices supplementaires
Exercice 1 : Courbe ROC et calcul de l’AUC
Objectif : convertissez ce problème de regression en classification binaire (tarif > mediane), puis tracez la courbe ROC et calculez l’AUC.
# Exercice 1 : Courbe ROC et calcul de l'AUC# TODO etudiant : Convertissez en classification binaire (fare_amount > mediane) et evaluez avec ROC/AUC# Indice : roc_auc_score, roc_curve de sklearn.metrics ; LogisticRegression comme classifieur# Etape 1 : creez y_binary = (df["fare_amount"] > df["fare_amount"].median()).astype(int)# Etape 2 : split + pipeline avec LogisticRegression au lieu de LinearRegression# Etape 3 : calculez roc_auc_score(y_test, model.predict_proba(X_test)[:,1])# Etape 4 : tracez la courbe ROC via roc_curve + matplotlibprint("Exercice a completer : courbe ROC et AUC")result_roc_auc =None# TODO etudiant : remplacer par l'AUC
Exercice a completer : courbe ROC et AUC
Exercice 2 : Analyse manuelle de la matrice de confusion
Objectif : pour la classification binaire de l’exercice 1, calculez la matrice de confusion et deduisez precision, rappel, F1 a la main.
# Exercice 2 : Analyse manuelle de la matrice de confusion# TODO etudiant : Calculez la matrice de confusion et deduisez precision/rappel/F1 a la main# Indice : confusion_matrix de sklearn.metrics ; comparez avec classification_report# Etape 1 : predisez y_pred_class pour le modele binaire de l'exercice 1# Etape 2 : calculez TP, FP, TN, FN manuellement# Etape 3 : deduisez precision = TP/(TP+FP), rappel = TP/(TP+FN), F1 = 2*P*R/(P+R)# Etape 4 : comparez avec classification_report de sklearnprint("Exercice a completer : matrice de confusion manuelle")result_confusion_matrix =None# TODO etudiant : remplacer par (TP, FP, TN, FN)
Exercice a completer : matrice de confusion manuelle
Exercice : Analyse complete d’un modèle de prédiction
Objectifs
Construisez un pipeline complet sur un nouveau dataset (ex: trip_duration au lieu de fare_amount)
Evaluez avec R2/MAE/RMSE + cross-validation
Calculez la PFI et interpretez
Indices - Reutilisez ColumnTransformer + Pipeline du notebook - cross_validate avec cv=5 pour une estimation robuste - permutation_importance pour l’explicabilite
# Exercice : Analyse complete d'un modele de prediction de duree de trajet# Completez les parties TODO pour creer un pipeline d'evaluation complet# TODO: definir la nouvelle cible y_dur = df["trip_time_in_secs"]# TODO: split train/test# TODO: construire un Pipeline (preprocessor + regressor au choix)# TODO: fit + evaluer (R2, MAE, RMSE) sur test set# TODO: cross-validation 5-fold# TODO: permutation_importance et interpretationprint("Exercice a completer : analyse complete duree de trajet")result_duration_analysis =None# TODO etudiant : remplacer par le R2 final
Exercice a completer : analyse complete duree de trajet
Resume
Dans ce notebook vous avez maitrise l’évaluation rigoureuse des modèles de regression avec scikit-learn, en miroir du notebook ML-4 .NET :
Metriques : R2 (variance expliquee), MAE (erreur moyenne interpretable), RMSE (sensible aux outliers). Trois angles complementaires, jamais un seul.
Cross-validation K-fold : estimer la performance generalisable plutot que de se fier a un seul split bruite.
Permutation Feature Importance : explicabilite model-agnostic - quelles features font vraiment bouger la performance.
Tree SHAP : decomposer chaque prediction en contributions par feature, avec additivite exacte – une attribution par instance la ou la PFI ne donne qu’un classement global.
L’évaluation rigoureuse suit le même cheminement en ML.NET et sklearn : (1) split train/test, (2) entrainer un baseline, (3) metriques sur test, (4) cross-validation pour robustesse, (5) explicabilite (PFI, puis attribution par instance avec Tree SHAP), (6) sweep hyperparametres (AutoML / GridSearchCV). Les API différent mais la discipline methodologique est identique.
Comment puis-je ameliorer mon modèle ?
Checklist d’amelioration (transversale ML.NET <-> sklearn) :
speed = trip_distance / trip_time). Cf ML-2-Python.Ridge/Lasso(sklearn) ouL2Regularization(ML.NET SDCA).HistGradientBoostingRegressor), ouxgboost/lightgbm.GridSearchCVouRandomizedSearchCV.