À la fin de ce laboratoire, vous saurez : 1. Réaliser une analyse exploratoire avec des visualisations (EDA) 2. Utiliser seaborn et matplotlib pour explorer des données 3. Construire un premier modèle de classification supervisée 4. Évaluer la performance d’un modèle avec l’accuracy
Prérequis
Avoir complété le Lab 4 (nettoyage de données avec Pandas)
Fichier transactions.csv généré dans le Lab 4
Notions de base en statistiques
Durée estimée : 40-50 minutes
Contexte : Le Lab 4 nous a fourni un jeu de données propre sur les transactions. Notre objectif est maintenant de le “faire parler” en utilisant la visualisation de données, puis de construire un premier modèle de Machine Learning capable de faire des prédictions.
Étape 1 : Préparation des Données
import pandas as pdfrom pathlib import Path# Resolution robuste (cf. Lab 4) : fonctionne depuis n'importe quel CWD_data = Path('../Lab4-DataWrangling/transactions.csv')ifnot _data.exists():for _p in [Path.cwd(), *Path.cwd().parents]: _candidate = _p /'MyIA.AI.Notebooks/ML/DataScienceWithAgents/Track1-LangChain/Day3-Data-Agents/Labs/Lab4-DataWrangling'/'transactions.csv'if _candidate.exists(): _data = _candidatebreak# Charger les données depuis le lab précédentdf = pd.read_csv(_data)# Ré-appliquer les étapes de nettoyage du Lab 4 (révision)# 1. Gestion des valeurs manquantes - supprimer les lignes sans quantitédf.dropna(subset=['quantite'], inplace=True)df['prix_unitaire'] = df['prix_unitaire'].fillna(df['prix_unitaire'].median())# 2. Correction des types de donnéesdf['date'] = pd.to_datetime(df['date'], format='mixed')df['quantite'] = df['quantite'].astype(int)# 3. Création de la colonne 'chiffre_affaires'df['chiffre_affaires'] = df['quantite'] * df['prix_unitaire']df.head()
date
id_produit
categorie
quantite
prix_unitaire
chiffre_affaires
0
2023-10-01
A101
Electronique
5
120.0
600.0
1
2023-10-01
B202
Livre
10
15.5
155.0
2
2023-10-02
A101
Electronique
3
75.9
227.7
3
2023-10-03
C303
Maison
2
75.9
151.8
4
2023-10-03
B202
Livre
6
15.5
93.0
Étape 2 : Analyse Exploratoire par la Visualisation (EDA)
import matplotlib.pyplot as pltimport seaborn as sns# Style des graphiquessns.set_style("whitegrid")print("Bibliotheques de visualisation chargees (matplotlib, seaborn) - style 'whitegrid' applique")
Bibliotheques de visualisation chargees (matplotlib, seaborn) - style 'whitegrid' applique
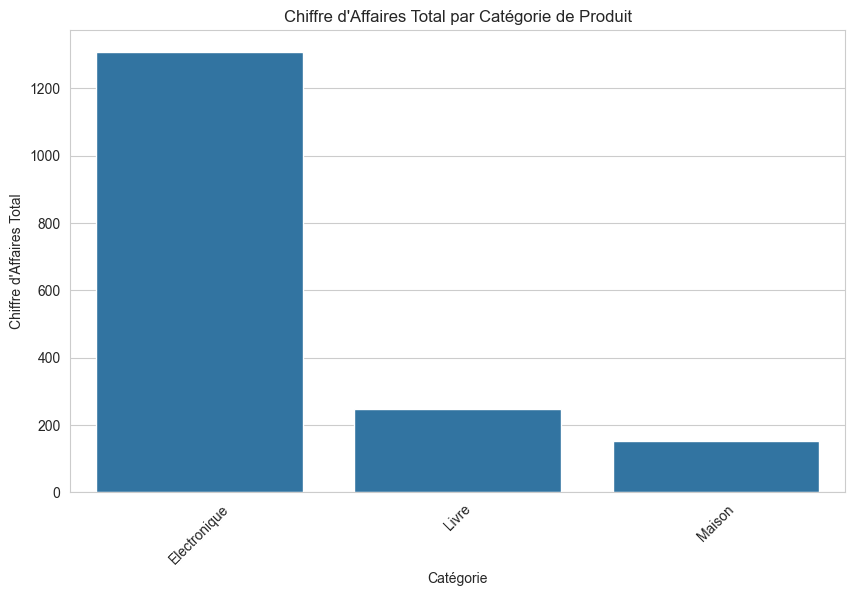
Visualisation 1 : Chiffre d’affaires total par catégorie
plt.figure(figsize=(10, 6))sns.barplot(x='categorie', y='chiffre_affaires', data=df, estimator=sum, errorbar=None)plt.title("Chiffre d'Affaires Total par Catégorie de Produit")plt.xlabel("Catégorie")plt.ylabel("Chiffre d'Affaires Total")plt.xticks(rotation=45)plt.show()
Interprétation : Ce graphique nous montre quelles catégories de produits génèrent le plus de revenus. Exécutez les cellules ci-dessus pour visualiser les résultats et identifier les catégories les plus performantes.
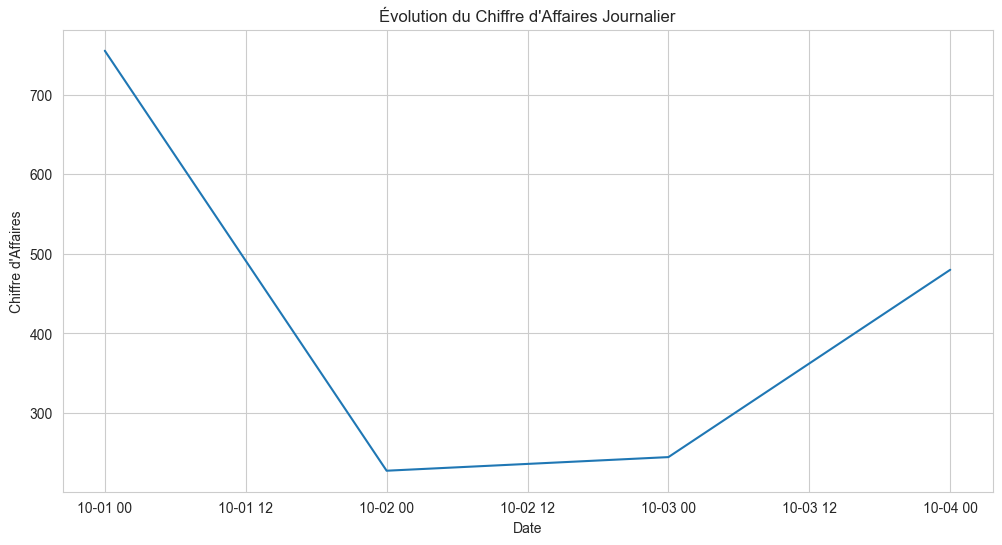
Visualisation 2 : Évolution du chiffre d’affaires journalier
Interprétation : Ce graphique linéaire permet de visualiser les tendances des ventes au fil du temps. Exécutez les cellules pour repérer d’éventuelles saisonnalités, pics de vente, ou périodes de creux.
Étape 3 : Introduction au Machine Learning - Classification
Régression logistique
Pour cette première tâche de classification supervisée, nous utilisons la régression logistique : un modèle linéaire qui estime la probabilité d’appartenance à chaque classe via la fonction logistique (sigmoïde). C’est l’un des classifieurs les plus utilisés et les plus interprétables ; introduit formellement par Cox (1958) pour la régression de variables binaires, il reste une référence pédagogique incontournable. Scikit-learn l’expose via la classe LogisticRegression.
Problématique : Pouvons-nous prédire la catégorie d’un produit en nous basant uniquement sur son prix_unitaire et la quantite vendue ?
from sklearn.model_selection import train_test_splitfrom sklearn.linear_model import LogisticRegressionfrom sklearn.metrics import accuracy_score# Définir les features (X) et la target (y)features = ['prix_unitaire', 'quantite']target ='categorie'# S'assurer qu'il n'y a pas de valeurs manquantes dans les featuresdf_clean = df.dropna(subset=features + [target])X = df_clean[features]y = df_clean[target]# Diviser les données en ensembles d'entraînement et de testX_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)print(f"Donnees preparees : {len(X_train)} echantillons d'entrainement, {len(X_test)} de test")print(f"Features utilisees : {features} | Target : {target}")
Donnees preparees : 4 echantillons d'entrainement, 2 de test
Features utilisees : ['prix_unitaire', 'quantite'] | Target : categorie
Entraînement et Évaluation du modèle
# Instancier et entraîner le modèlemodel = LogisticRegression()model.fit(X_train, y_train)# Faire des prédictionsy_pred = model.predict(X_test)# Calculer la précisionaccuracy = accuracy_score(y_test, y_pred)print(f"Précision du modèle : {accuracy:.2f}")
Précision du modèle : 1.00
Interprétation du score : Le score de précision (accuracy) nous indique le pourcentage de prédictions correctes que notre modèle a faites sur l’ensemble de test. Exécutez les cellules ci-dessus pour obtenir le score, puis interprétez-le : - > 0.7 : le modèle distingue bien les catégories à partir du prix et de la quantité. - 0.4-0.7 : les features choisies donnent des résultats mitigés. - < 0.4 : le prix et la quantité seuls ne suffisent pas à différencier les catégories de produits.
Conclusion
Félicitations ! Vous avez acquis deux compétences fondamentales en Data Science : 1. L’analyse exploratoire par la visualisation, pour comprendre vos données. 2. La modélisation prédictive, pour utiliser vos données afin de faire des prédictions.
Lien avec les agents d’IA : Ce processus que nous avons mené manuellement peut être entièrement automatisé par un agent d’IA. Imaginez pouvoir demander simplement : “Analyse les ventes du trimestre dernier, identifie les 3 meilleures catégories de produit, et construis un modèle pour prédire la catégorie des nouveaux produits.”
Pour ce faire, l’agent utiliserait des outils (tools) qui encapsuleraient la logique que nous venons d’écrire avec pandas, seaborn et sklearn. Le rôle de l’agent est d’orchestrer ces outils pour répondre à la demande de l’utilisateur.
Exemple guidé
À vous de pratiquer la visualisation et la classification binaire !
# Exercice : Creez une nouvelle visualisation et entrainez un autre modele# 1. Creez un graphique montrant le prix moyen par categorie# 2. Entrainez un modele pour predire si le chiffre d'affaires est > 50# --- Exercice 1 : Prix moyen par categorie ---# Exercice: Calculez le prix moyen par categorie avec groupby# Indice: df.groupby('categorie')['prix_unitaire'].mean().reset_index()prix_moyen =None# Remplacez None# Exercice: Creez un barplot avec seaborn# Indice: sns.barplot(x=..., y=..., data=prix_moyen)# plt.figure(figsize=(10, 6))# ...# plt.title("Prix Moyen par Categorie")# plt.show()# --- Exercice 2 : Classification binaire ---# Exercice: Creez une colonne binaire 'ca_eleve' (1 si chiffre_affaires > 50, 0 sinon)# Indice: (df_clean['chiffre_affaires'] > 50).astype(int)# df_clean['ca_eleve'] = None # Remplacez None# Exercice: Definissez X (features) et y (target), puis split train/test# Indice: memes features que l'exemple guide (prix_unitaire, quantite)# X_bin = None# y_bin = None# Exercice: Entrainez un LogisticRegression et evaluez l'accuracy# Indice: meme pattern que l'etape 3 (fit, predict, accuracy_score)# model_bin = LogisticRegression()# ...# print(f"Precision du modele binaire (CA > 50) : {accuracy_bin:.2f}")
Exercice 2 : Analyse de la distribution des prix
La comprehension de la distribution des variables est essentielle avant de construire un modèle. Vous allez créer un histogramme et un boxplot pour analyser la repartition des prix unitaires par catégorie.
Objectif : Visualiser la distribution de prix_unitaire avec un histogramme global et un boxplot par catégorie.
Indices : - Utilisez sns.histplot() avec le paramètre bins pour l’histogramme - Utilisez sns.boxplot() avec x='catégorie' et y='prix_unitaire' pour le boxplot - Utilisez plt.subplots(1, 2, figsize=(14, 5)) pour afficher les deux graphiques cote a cote
# Exercice 2 : Distribution des prix unitaires# Creez un histogramme et un boxplot pour analyser les prix# Etape 1: Creez une figure avec deux sous-graphiques (1 ligne, 2 colonnes)# Indice: fig, axes = plt.subplots(1, 2, figsize=(14, 5))# Etape 2: Histogramme de la distribution globale des prix# Indice: sns.histplot(data=df, x='prix_unitaire', bins=10, ax=axes[0])# axes[0].set_title("Distribution des prix unitaires")# Etape 3: Boxplot des prix par categorie# Indice: sns.boxplot(data=df, x='categorie', y='prix_unitaire', ax=axes[1])# axes[1].set_title("Prix unitaires par categorie")# plt.tight_layout()# plt.show()print("Exercice 2 a completer : distribution des prix avec histogramme et boxplot")
Exercice 2 a completer : distribution des prix avec histogramme et boxplot
Exercice 3 : Evaluation avec la matrice de confusion
L’accuracy seule ne suffit pas toujours a evaluer un modèle de classification. Vous allez utiliser la matrice de confusion et le rapport de classification pour obtenir une vue detaillee des performances de votre modèle par catégorie.
Objectif : Afficher la matrice de confusion et le rapport de classification du modèle LogisticRegression entraine precedemment.
Indices : - Importez confusion_matrix et classification_report depuis sklearn.metrics - Utilisez confusion_matrix(y_test, y_pred) pour obtenir la matrice - Utilisez sns.heatmap() pour visualiser la matrice de confusion - Appelez classification_report(y_test, y_pred) pour le rapport detaille
# Exercice 3 : Matrice de confusion et rapport de classification# Evaluez plus finement les performances du modele de classification# Etape 1: Importez les metriques# Indice: from sklearn.metrics import confusion_matrix, classification_report# Etape 2: Calculez la matrice de confusion# Indice: cm = confusion_matrix(y_test, y_pred, labels=model.classes_)cm =None# Remplacez None# Etape 3: Affichez la matrice avec un heatmap seaborn# Indice: sns.heatmap(cm, annot=True, fmt='d', xticklabels=model.classes_, yticklabels=model.classes_)# plt.xlabel("Predit")# plt.ylabel("Reel")# plt.title("Matrice de confusion")# plt.show()# Etape 4: Affichez le rapport de classification# Indice: print(classification_report(y_test, y_pred))print("Exercice 3 a completer : matrice de confusion et rapport de classification")
Exercice 3 a completer : matrice de confusion et rapport de classification
Exercice 4 : Courbe ROC et evaluation visuelle du modèle
L’accuracy et la matrice de confusion donnent une vision globale, mais la courbe ROC (Receiver Operating Characteristic) permet de visualiser le compromis entre le taux de vrais positifs et le taux de faux positifs a différents seuils de decision. Vous allez tracer la courbe ROC pour la classification binaire (chiffre d’affaires eleve vs. bas).
Objectif : Construire une cible binaire (ca_eleve = 1 si chiffre_affaires > 50), entrainer un LogisticRegression, puis tracer la courbe ROC avec sklearn.metrics.roc_curve.
Indices : - Créez la cible binaire : df_clean['ca_eleve'] = (df_clean['chiffre_affaires'] > 50).astype(int) - Utilisez roc_curve(y_test_bin, y_proba) ou y_proba = model.predict_proba(X_test_bin)[:, 1] - Tracez avec plt.plot(fpr, tpr) et ajoutez la diagonale de reference plt.plot([0,1], [0,1], '--', color='gray') - Calculez l’AUC avec roc_auc_score(y_test_bin, y_proba)
Référence. La courbe ROC et l’AUC sont issues de la théorie du signal (radars, années 1950) et popularisées en apprentissage automatique par Fawcett (2006), An Introduction to ROC Analysis, Pattern Recognition Letters 27(8):861-874. L’AUC (aire sous la courbe) résume la performance du classifieur sur tous les seuils.
# Exercice 4 : Courbe ROC pour la classification binaire# Construisez un modele binaire et tracez la courbe ROC# Etape 1: Creez la cible binaire# Indice: df_clean['ca_eleve'] = (df_clean['chiffre_affaires'] > 50).astype(int)df_clean['ca_eleve'] =None# TODO etudiant# Etape 2: Preparez les donnees (features, target, split)# Indice: X_bin = df_clean[['prix_unitaire', 'quantite']]# Indice: y_bin = df_clean['ca_eleve']# Indice: X_train_bin, X_test_bin, y_train_bin, y_test_bin = train_test_split(X_bin, y_bin, test_size=0.3, random_state=42)# Etape 3: Entrainez le modele et obtenez les probabilites# Indice: model_bin = LogisticRegression()# Indice: model_bin.fit(X_train_bin, y_train_bin)# Indice: y_proba = model_bin.predict_proba(X_test_bin)[:, 1]y_proba =None# TODO etudiant# Etape 4: Tracez la courbe ROC# Indice: from sklearn.metrics import roc_curve, roc_auc_score# Indice: fpr, tpr, thresholds = roc_curve(y_test_bin, y_proba)# Indice: auc = roc_auc_score(y_test_bin, y_proba)# plt.figure(figsize=(8, 6))# plt.plot(fpr, tpr, linewidth=2, label=f'ROC (AUC = {auc:.2f})')# plt.plot([0, 1], [0, 1], '--', color='gray', label='Hasard')# plt.xlabel('Taux de faux positifs')# plt.ylabel('Taux de vrais positifs')# plt.title('Courbe ROC - Classification binaire (CA > 50)')# plt.legend()# plt.grid(True, alpha=0.3)# plt.show()print("Exercice 4 a completer : courbe ROC et AUC")
Exercice 4 a completer : courbe ROC et AUC
References
D. R. Cox, The Regression Analysis of Binary Sequences, Journal of the Royal Statistical Society: Series B (Methodological) 20(2), 1958, pp. 215-232. Origine formelle de la régression logistique pour les variables binaires — classifieur central de l’Étape 3 de ce laboratoire.
T. Fawcett, An Introduction to ROC Analysis, Pattern Recognition Letters 27(8), 2006, pp. 861-874. Référence canonique de la courbe ROC et de l’AUC (Exercice 4).
F. Pedregosa et al., Scikit-learn: Machine Learning in Python, JMLR 12, 2011, pp. 2825-2830. Implémentation LogisticRegression / roc_curve / train_test_split — référence détaillée au Lab 1.
J. W. Tukey, Exploratory Data Analysis, Addison-Wesley, 1977. Cadre de l’EDA (Étape 2) — référence détaillée au Lab 4.