ML-1 (Python) : Introduction au Machine Learning avec scikit-learn
Ce notebook est le jumeau Python de ML-1-Introduction.ipynb (.NET / ML.NET). Il reprend exactement les trois exemples guidés et les trois exercices du notebook C#, en utilisant la bibliothèque canonique scikit-learn.
Pourquoi un jumeau Python ? ML.NET et scikit-learn sont les deux bibliothèques de référence pour le Machine Learning « classique » (non profond), l’une côté .NET, l’autre côté Python. Comparer les deux sur les mêmes exemples pédagogiques permet de : 1. comprendre que les concepts (pipeline, entraînement, évaluation, prédiction) sont universels — seules les API diffèrent ; 2. voir les écarts de comportement entre solveurs (par ex. SDCA en ML.NET vs OLS en scikit-learn pour la régression linéaire) ; 3. disposer d’une version exécutable sans installation .NET.
Un workflow de Machine Learning comporte toujours les mêmes étapes, quel que soit le framework :
Référencer la bibliothèque (import en Python, #r nuget en .NET).
Préparer le contexte (graine aléatoire, affichage).
Définir les structures de données (ici, de simples tableaux NumPy).
Charger les données d’entraînement.
Construire le pipeline (transformation + algorithme).
Entraîner le modèle (fit).
Évaluer sur des données de test (R², accuracy, AUC…).
Prédire de nouvelles valeurs.
Étape 1 : Référencer les bibliothèques
En Python, on importe les modules. NumPy pour les tableaux numériques, scikit-learn (sklearn) pour les algorithmes et métriques, Matplotlib pour les visualisations.
On fixe la graine (42) pour rendre l’expérience déterministe : les tirages aléatoires (s’ils surviennent) reproduiront les mêmes résultats à chaque exécution.
rng = np.random.default_rng(42)
Pourquoi fixer la graine ?
Au-delà du déterminisme : sans graine, chaque exécution donnerait des chiffres légèrement différents — impossible de comparer une correction à un résultat attendu, ou de déboguer un échec intermittent. C’est l’équivalent du MLContext(seed: 0) de ML.NET : la reproductibilité est un prérequis de l’expérimentation, pas un luxe.
Étape 2 : Définir les structures de données
En ML.NET on définit des classes POCO (HouseData, Prediction). En Python on travaille directement avec des tableaux NumPy : un tableau 2D X pour les features (ici la taille) et un vecteur 1D y pour les étiquettes (ici le prix). C’est la convention universelle de scikit-learn : X de forme (n_samples, n_features), y de forme (n_samples,).
Exemple guide 1 : Prédiction du prix d’une maison (régression)
On veut prédire le prix d’une maison à partir de sa taille (en milliers de pieds carrés). C’est un problème de régression : la cible (Price) est continue.
# Données d'entraînement : 4 exemples (Size, Price)# Size en milliers de pieds carrés, Price en centaines de milliers de $ (comme le .NET)house_train = np.array([ [1.1, 1.2], [1.9, 2.3], [2.8, 3.0], [3.4, 3.7],])X_house_train = house_train[:, 0].reshape(-1, 1) # feature : Sizey_house_train = house_train[:, 1] # cible : Priceprint(f"Données d'entraînement : {len(y_house_train)} exemples")
Données d'entraînement : 4 exemples
Lecture des données d’entraînement
Quatre exemples suffisent pour une régression linéaire à une feature : le modèle n’a que deux paramètres (pente et ordonnée à l’origine) à estimer. Lisez le tableau : le prix suit presque proportionnellement la taille (1,1 → 1,2 ; 1,9 → 2,3 ; 2,8 → 3,0 ; 3,4 → 3,7) — le rapport prix/taille est proche de 1,05 partout. La relation paraît linéaire dans cette plage (1,1 à 3,4) ; nous verrons si elle tient au-delà.
Construire et entraîner le pipeline
Le pipeline le plus simple pour une régression linéaire : un modèle LinearRegression qui apprend la relation Price = a * Size + b par moindres carrés (OLS — Ordinary Least Squares). C’est l’équivalent naturel du Sdca de ML.NET sur ce petit jeu.
Le modèle apprend Price = 1,049 x Size + 0,137. La pente de 1,049 reflète le rapport prix/taille observé à l’œil dans les données (~1,05) ; l’ordonnée à l’origine de 0,137 est petite mais non nulle — un léger « tarif de base ». C’est la solution des moindres carrés ordinaires : pour deux paramètres, il existe une formule fermée (géométriquement, la projection orthogonale des points sur l’espace des droites). Aucune itération, aucun hyperparamètre — le modèle est exact.
Évaluer le modèle sur des données de test
On dispose de 15 exemples de test (dont certains sortent de la plage d’entraînement, jusqu’à 8 milliers de pieds carrés). On mesure le coefficient de détermination R² : 1.0 = prédiction parfaite, 0.0 = pas mieux que la moyenne.
# 15 exemples de testhouse_test = np.array([ [1.1, 1.2], [1.2, 1.5], [1.4, 1.7], [1.6, 1.9], [1.9, 2.3], [2.8, 3.0], [3.2, 3.5], [3.3, 3.6], [3.5, 3.9], [3.7, 4.3], [4.0, 6.1], [5.0, 7.2], [6.0, 8.5], [7.0, 9.8], [8.0, 10.3],])X_house_test = house_test[:, 0].reshape(-1, 1)y_house_test = house_test[:, 1]y_house_pred = model_house.predict(X_house_test)r2_house = r2_score(y_house_test, y_house_pred)mae_house = mean_absolute_error(y_house_test, y_house_pred)print(f"R² sur le test : {r2_house:.3f}")print(f"MAE sur le test : {mae_house:.3f} (centaines de milliers de $)")
R² sur le test  : 0.852
MAE sur le test : 0.716 (centaines de milliers de $)
Lecture du jeu de test : l’extrapolation est volontaire
Regardez la construction du jeu de test : 15 exemples étalés de 1,1 à 8,0 — bien au-delà de la plage d’entraînement (1,1 à 3,4). Ce choix est délibéré : il va exposer le comportement du modèle en extrapolation, là où aucune donnée ne le contraint. Les points entre 4,0 et 8,0 testent la capacité de la droite apprise sur le segment initial à prédire le monde extérieur — et les valeurs réelles y montrent un prix au pied carré croissant.
Prédire le prix d’une nouvelle maison
Une fois le modèle entraîné, on peut prédire le prix pour une taille non vue.
Félicitations ! Vous avez entraîné un modèle de régression avec scikit-learn en quelques lignes. Visualisons la droite apprise et les données.
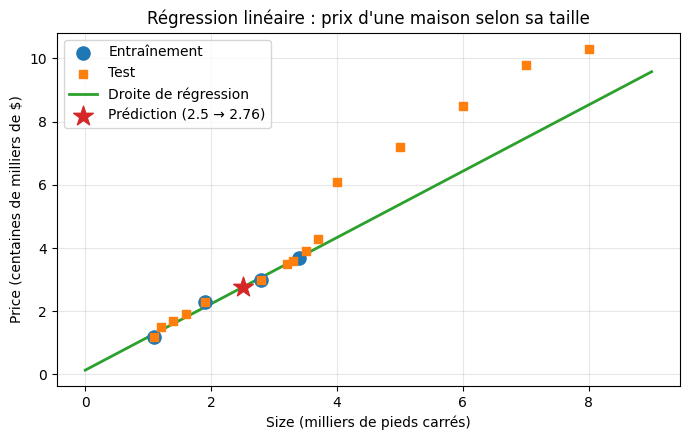
fig, ax = plt.subplots(figsize=(7, 4.5))ax.scatter(X_house_train, y_house_train, color="tab:blue", s=90, label="Entraînement", zorder=3)ax.scatter(X_house_test, y_house_test, color="tab:orange", marker="s", label="Test", zorder=3)xs = np.linspace(0, 9, 100).reshape(-1, 1)ax.plot(xs, model_house.predict(xs), color="tab:green", linewidth=2, label="Droite de régression")ax.scatter(size_new, price_new, color="tab:red", marker="*", s=220, label=f"Prédiction (2.5 → {price_new[0]:.2f})", zorder=4)ax.set_xlabel("Size (milliers de pieds carrés)")ax.set_ylabel("Price (centaines de milliers de $)")ax.set_title("Régression linéaire : prix d'une maison selon sa taille")ax.legend(loc="upper left")ax.grid(alpha=0.3)plt.tight_layout()plt.show()
Lecture du graphique
Le nuage de points et la droite de régression rendent visible ce que le R² = 0,852 quantifiait : la droite passe au milieu des points d’entraînement (bleu) mais sous-estime systématiquement les grandes tailles (orange, points test). Regardez l’écart croissant à droite du graphe : à 8 000 pieds carrés, le prix réel (10,3) dépasse largement la prédiction linéaire (~8,5). C’est la signature d’une relation non linéaire (effet « premium » des grandes surfaces) qu’un modèle de degré 1 ne peut pas capturer.
La prédiction pour 2,5 (l’étoile rouge) est raisonnable car elle tombe dans la plage des données d’entraînement — l’erreur locale y est faible. En extrapolation (au-delà de 3,4), l’erreur croît de façon non mesurée : c’est la limite d’un modèle linéaire appris sur 4 points.
Exemple guide 2 : Prédiction du temps de trajet (régression)
Deuxième exemple de régression : on prédit le temps de trajet (en minutes) à partir de la distance (en km). Cette fois la relation est presque exactement linéaire (≈ 3 min/km), ce qui donnera un R² proche de 1.
Temps prévu pour 25 km : 75.1 minutes
Pente apprise : 3.021 min/km
Interpolation vs extrapolation : le contraste des deux exemples
Comparez les deux prédictions : ici, 25 km est dans la plage observée (5 à 40 km) — le modèle interpole, et l’erreur attendue est de l’ordre du bruit résiduel. Dans l’exemple 1, la prédiction pour 2,5 interpolait aussi (plage 1,1-3,4), mais l’évaluation test poussait jusqu’à 8,0 — en extrapolation, où l’erreur explose. La distinction est fondamentale en pratique : un modèle n’est fiable que dans la plage de ses données d’entraînement. Tout rapport de déploiement devrait répondre à la question : mes données de production sont-elles dans la plage d’entraînement ?
Exemple guide 3 : Classification binaire de transactions
On passe à la classification : prédire si une transaction bancaire est suspecte (oui/non) à partir de son montant et de l’heure. La cible est binaire — on utilise une régression logistique (LogisticRegression), l’équivalent du SdcaLogisticRegression de ML.NET.
Interprétation : perfection apparente et sur-apprentissage
L’accuracy de 100 % et l’AUC de 1,000 sont parfaits — et c’est précisément le problème. Avec 12 exemples et 2 features (montant, heure), les classes sont linéairement séparables par construction : les transactions suspectes ont toutes un montant > 2000 $ et une heure < 6 h, les normales < 500 $ et > 8 h. La régression logistique n’a aucune difficulté à trouver une frontière qui les sépare sans erreur.
Ce score parfait sur le jeu d’entraînement ne dit rien sur la généralisation : en production, une transaction à 1 800 $ à 7 h du matin (proche de la frontière) serait classée avec une probabilité bien inférieure à 100 %, et potentiellement mal. La leçon : un score parfait sur des données synthétiques séparables est un signal d’alerte, pas de succès. Il faut des données plus bruitées, ou une évaluation sur un jeu de test indépendant, pour mesurer la performance réelle.
La grammaire commune des trois exemples
Relisez les trois exemples : derrière la variété des sujets (prix immobilier, temps de trajet, détection de fraude), la même séquence de gestes revient à chaque fois :
Structurer les données : un tableau X de features (taille, distance, montant + heure) et un vecteur y de cibles (prix, durée, étiquette 0/1).
Choisir l’estimateur selon la nature de la cible : LinearRegression pour une cible continue (régression), LogisticRegression pour une cible binaire (classification). Ce choix n’est pas cosmétique — il fixe la fonction de perte minimisée (erreur quadratique vs log-vraisemblance).
Entraîner : fit(X, y) — deux lignes, quel que soit le modèle.
Évaluer : r2_score / mean_absolute_error côté régression, accuracy_score / roc_auc_score côté classification. La métrique dépend elle aussi de la nature du problème : un R² sur un problème de classification n’a pas de sens.
Prédire : predict sur de nouvelles entrées — le seul geste qui sorte du notebook, celui qui sera exposé en production.
C’est cette grammaire que scikit-learn rend uniforme, exactement comme ML.NET avec son context.Regression.Trainers.Sdca() et ses Evaluate(). Les exercices qui suivent l’étendent dans trois directions : mesurer quelles features portent le signal (importance par permutation), connaître les données avant de modéliser (exploration statistique), et sortir du cas une-feature-une-cible (régression multi-features).
Exercices supplémentaires
Les trois exercices suivent ceux du notebook .NET. Ils sont laissés à compléter : lisez les indices, écrivez votre code, puis exécutez la cellule.
Exercice 1 : Importance des features (permutation)
Objectif : mesurer quelle feature (Size, ou d’autres) pèse le plus sur la prédiction du prix.
Étape 3 : affichez result.importances_mean (plus c’est grand, plus la feature compte).
# Exercice 1 : Importance des features# TODO étudiant : calculez l'importance par permutation sur le modèle de régression maison# from sklearn.inspection import permutation_importance# result = permutation_importance(...) # TODO étudiant# print(result.importances_mean) # TODO étudiantprint("Exercice à compléter : analyse de l'importance des features")
Exercice à compléter : analyse de l'importance des features
Exercice 2 : Exploration statistique des données
Objectif : calculer des statistiques descriptives sur un jeu de données d’employés.
Indice : utilisez pandas (pd.DataFrame) puis .describe().
Étape 1 : créez un DataFrame avec des colonnes expérience, education, taille_societe, salaire.
Étape 3 : comptez les valeurs uniques d’une colonne catégorielle avec df["col"].value_counts().
# Exercice 2 : Exploration statistique des données# TODO étudiant : utilisez pandas pour résumer un jeu de données d'employés# import pandas as pd# df = pd.DataFrame(...) # TODO étudiant# print(df.describe()) # TODO étudiantprint("Exercice à compléter : exploration statistique des données")
Exercice à compléter : exploration statistique des données
Exercice 3 : Régression multi-features — prédiction de salaire
Objectif : entraîner une régression linéaire sur plusieurs features (années d’expérience, niveau d’éducation, taille de société) pour prédire le salaire.
Étape 1 : construisez X de forme (n, 3) et y (salaire) pour 10+ employés.
Étape 2 : entraînez LinearRegression().fit(X, y).
Étape 3 : évaluez avec r2_score et mean_absolute_error.
Étape 4 : prédisez le salaire pour un employé (5 ans, Master=2, Grande société=2).
# Exercice 3 : Régression multi-features - prédiction de salaire# TODO étudiant : définir les données d'employés et entraîner le modèle# X = np.array([[2, 1, 1], [10, 3, 3], ...]) # TODO étudiant (10+ lignes)# y = np.array([32000, 110000, ...]) # TODO étudiant# model = LinearRegression().fit(X, y) # TODO étudiant# pred = model.predict([[5, 2, 2]]) # TODO étudiantprint("Exercice à compléter : régression multi-features (salaire)")
Exercice à compléter : régression multi-features (salaire)
Résumé
Vous avez parcouru le workflow complet d’un projet de Machine Learning avec scikit-learn :
Étape
scikit-learn (Python)
ML.NET (.NET)
Imports
import numpy, sklearn
#r nuget Microsoft.ML
Contexte
graine np.random.default_rng
new MLContext(seed)
Données
tableaux NumPy X, y
classes POCO + IDataView
Pipeline
LinearRegression()
Concatenate + Trainers.Sdca
Entraînement
model.fit(X, y)
pipeline.Fit(data)
Évaluation
r2_score, accuracy_score
mlContext.Regression.Evaluate
Prédiction
model.predict(X_new)
predictionEngine.Predict(x)
Deux familles abordées à travers trois exemples guidés : régression linéaire (maison, trajet), classification binaire (transactions). Les concepts sont identiques entre .NET et Python — seules les API et les solveurs par défaut diffèrent.