Ce notebook enseigne le workflow fondamental de l’apprentissage automatique supervisé : séparer les données (train/test), ajuster un modèle (fit), prédire (predict), puis évaluer. Il répond à une question centrale : pourquoi évalue-t-on sur des données que le modèle n’a pas vues ? Il montre aussi comment rendre le surapprentissage (overfitting) directement visible. C’est le prérequis de 2.2-Descente-de-gradient et de toute la série 02-ML-Cours.
Objectifs d’apprentissage
Comprendre POURQUOI on sépare un jeu de données en entraînement et test.
Exécuter le workflow fit / predict / evaluate avec scikit-learn.
Rendre le surapprentissage visible grâce à un balayage de complexité.
Distinguer les métriques de classification (accuracy) et de régression (MAE).
Prérequis
NumPy et Pandas (voir 01-PythonForDataScience).
Bases de Python (boucles, fonctions, indexation).
Référence. Mitchell, T. (1997), Machine Learning, McGraw-Hill. La distinction entraînement/généralisation et le surapprentissage (overfitting) y sont définis comme le concept central de l’apprentissage supervisé.
# Configuration : imports et graine aléatoireimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.model_selection import train_test_splitfrom sklearn.tree import DecisionTreeClassifierfrom sklearn.linear_model import LinearRegressionfrom sklearn.datasets import make_classification, make_regressionfrom sklearn.metrics import accuracy_score, mean_absolute_errorfrom sklearn.pipeline import Pipelinefrom sklearn.preprocessing import StandardScalernp.random.seed(42)print("Configuration OK : 2.1 - Workflow ML")
Configuration OK : 2.1 - Workflow ML
Auto-évaluation
Ce carnet porte un dispositif d’auto-évaluation formatif : quatre questions, placées avant le parcours (diagnostic de prérequis), au milieu (vérification de la notion) et à la fin (transfert). Aucune note n’est stockée, aucune réponse n’est enregistrée.
Chaque cellule de question s’exécute sans erreur tant que vous n’avez pas répondu ; la correction s’affiche uniquement lorsque vous remplacez reponse=None par la lettre de votre choix, puis ré-exécutez la cellule.
# Dispositif d'auto-evaluation de la serie (module partage, issue #18207)import pathlibimport sysfor _racine in (pathlib.Path.cwd(), *pathlib.Path.cwd().parents):if (_racine /"MyIA.AI.Notebooks").is_dir(): sys.path.insert(0, str(_racine /"MyIA.AI.Notebooks"/"ML"/"DataScienceWithAgents"))breakfrom auto_evaluation import question # noqa: E402
Avant de commencer — question de diagnostic
question("Que mesure la performance d'un modèle calculée sur ses propres données d'entraînement ?", choix=["Sa capacité à généraliser à des données nouvelles","Sa capacité à restituer des données qu'il a déjà vues","La qualité du jeu de données, indépendamment du modèle", ], bonne="B", explication="Un modèle évalué sur ce qu'il a vu mesure sa restitution, pas sa généralisation. C'est pourquoi on met des données de côté avant de conclure quoi que ce soit.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="avant",)
Diagnostic de prérequis — Que mesure la performance d'un modèle calculée sur ses propres données d'entraînement ?

  A. Sa capacité à généraliser à des données nouvelles
  B. Sa capacité à restituer des données qu'il a déjà vues
  C. La qualité du jeu de données, indépendamment du modèle

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
1. Le jeu de données
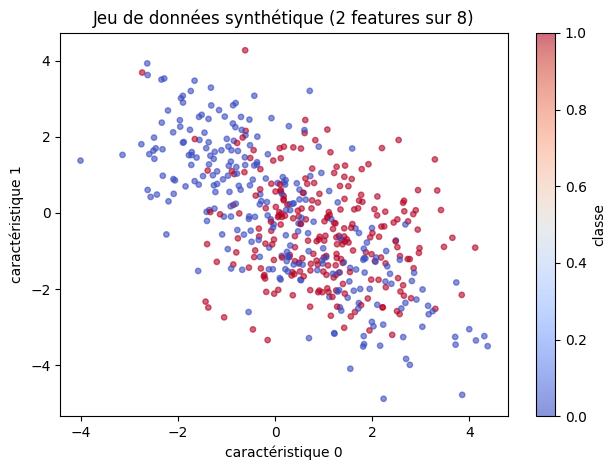
Nous utilisons un jeu de données synthétique généré par make_classification. Le choix d’un jeu synthétique (plutôt qu’un CSV réel) est délibéré :
il est déterministe (même random_state → mêmes données), donc reproductible ;
on contrôle le niveau de bruit et le nombre de caractéristiques informatives, ce qui permet d’observer proprement le surapprentissage ;
n_redundant=2 — 2 caractéristiques redondantes (combinaisons linéaires des informatives).
flip_y=0.10 — 10 % des étiquettes sont inversées (bruit de label).
random_state=42 — pour la reproductibilité.
# Génération du jeu de données synthétique (exemple résolu)X, y = make_classification( n_samples=500, n_features=8, n_informative=5, n_redundant=2, flip_y=0.10, random_state=42,)print("Forme de X :", X.shape)print("Forme de y :", y.shape)print("\nRépartition des classes :")print(pd.Series(y).value_counts())# Aperçu visuel : deux premières caractéristiquesplt.scatter(X[:, 0], X[:, 1], c=y, cmap='coolwarm', alpha=0.6, s=15)plt.colorbar(label='classe')plt.xlabel('caractéristique 0')plt.ylabel('caractéristique 1')plt.title('Jeu de données synthétique (2 features sur 8)')plt.tight_layout()plt.show()
Forme de X : (500, 8)
Forme de y : (500,)

Répartition des classes :
0    259
1    241
Name: count, dtype: int64
2. Pourquoi séparer train et test ?
Le concept-clé est le principe du holdout : on évalue un modèle sur des données qu’il n’a pas vues pendant l’entraînement. Pourquoi ? Parce qu’un modèle suffisamment flexible peut mémoriser les données d’entraînement (y compris leur bruit) sans pour autant généraliser à de nouvelles données. Mesurer la performance sur les données d’entraînement surestime donc la vraie capacité du modèle.
L’évaluation sur un ensemble de test distinct fournit une estimation honnête de la capacité de généralisation.
Référence. Stone, M. (1974), Cross-Validatory Choice and Assessment of Statistical Predictions, Journal of the Royal Statistical Society. Series B (Methodological) 36(2):111-147. La validation croisée et le principe d’évaluation sur des données non vues fondent la mesure honnête de la capacité de généralisation.
# Exemple résolu : découpage stratifié train/test (70% / 30%)X_train, X_test, y_train, y_test = train_test_split( X, y, test_size=0.3, random_state=42, stratify=y)print("Taille entraînement :", X_train.shape, y_train.shape)print("Taille test :", X_test.shape, y_test.shape)print()# stratify=y conserve les proportions de classes entre train et testprint("Proportion classe 1 - train : {:.3f}".format((y_train ==1).mean()))print("Proportion classe 1 - test : {:.3f}".format((y_test ==1).mean()))
Taille entraînement : (350, 8) (350,)
Taille test         : (150, 8) (150,)

Proportion classe 1 - train : 0.483
Proportion classe 1 - test  : 0.480
Lecture du résultat : pourquoi ces deux nombres méritent votre attention
Les proportions de la classe 1 — 0,483 sur le train et 0,480 sur le test — sont presque identiques : c’est exactement l’effet recherché de stratify=y. Sans stratification, un tirage au hasard peut s’écarter de quelques points ; sur un jeu de test de 150 observations, deux points de pourcentage représentent trois exemples — peu ici. Mais sur une classe rare (1 % de fraudes, par exemple), un découpage non stratifié peut produire un jeu de test où la classe d’intérêt est quasi absente, et toute métrique calculée dessus devient un non-sens. La stratification est une assurance quasi gratuite contre ce risque d’échantillonnage : elle conserve dans chaque découpage la structure que le modèle doit apprendre ET celle sur laquelle il sera jugé.
Exercice 1 : comparer un découpage naïf au découpage stratifié
Contexte. Le paramètre stratify=y garantit que les proportions de classes sont conservées entre train et test. Que se passe-t-il si l’on ignore cette précaution ?
Objectif. Implémentez un découpage naïf : prenez les 70 % premières lignes du jeu de données comme entraînement (sans mélanger, sans stratifier), puis comparez la proportion de classe 1 dans ce train naïf à celle du train stratifié ci-dessus.
Indice : comparez (y_train_naif == 1).mean() à (y_train == 1).mean().
La cellule de stub ci-dessous est à compléter.
# Exercice 1 : découpage naïf (70% premières lignes) vs stratifién_train_naif =int(0.7*len(X))# TODO etudiant : extraire X_train_naif, y_train_naif, X_test_naif, y_test_naifX_train_naif =None# TODO etudiant : remplacery_train_naif =None# TODO etudiant : remplacer# TODO etudiant : calculer la proportion de classe 1 dans le train naïf vs le train stratifiéprop_naif =None# TODO etudiant : remplacer (proportion de classe 1 dans y_train_naif)prop_stratifie =None# TODO etudiant : remplacer (proportion de classe 1 dans y_train)print(f"Exercice 1 a completer : prop classe 1 (naif) = {prop_naif}, (stratifie) = {prop_stratifie}")
Exercice 1 a completer : prop classe 1 (naif) = None, (stratifie) = None
3. Premier modèle : un arbre de décision
Un arbre de décision (DecisionTreeClassifier) classe une observation en posant une suite de questions binaires sur les caractéristiques (« la feature 3 est-elle > 0.5 ? »), ce qui partitionne l’espace en régions. Le paramètre clé est max_depth : il contrôle la profondeur maximale de l’arbre, donc sa complexité. Un arbre peu profond sous-apprend (trop rigide) ; un arbre très profond surapprend (il mémorise).
Référence. Breiman, L., Friedman, J., Olshen, R. & Stone, C. (1984), Classification and Regression Trees, Wadsworth. Les arbres CART et la notion de profondeur (complexité du modèle) y sont introduits ; un arbre trop profond mémorise les données d’entraînement.
# Exemple résolu : arbre de décision de profondeur 3arbre = DecisionTreeClassifier(max_depth=3, random_state=42)arbre.fit(X_train, y_train)# Prédictions sur train ET test pour comparery_pred_train = arbre.predict(X_train)y_pred_test = arbre.predict(X_test)acc_train = accuracy_score(y_train, y_pred_train)acc_test = accuracy_score(y_test, y_pred_test)# L'accuracy de train est en général >= à celle de test : c'est attenduprint("Accuracy - train : {:.3f}".format(acc_train))print("Accuracy - test : {:.3f}".format(acc_test))
Accuracy - train : 0.874
Accuracy - test  : 0.773
Vérification 1 — découper avant de transformer
question("On normalise toutes les variables en calculant moyenne et écart-type sur le jeu complet, puis on sépare train et test. Qu'est-ce que cela change ?", choix=["Rien : la normalisation est une transformation neutre","Les statistiques ont vu le test : la performance mesurée est trop optimiste","Le modèle devient moins précis, car il perd l'échelle d'origine", ], bonne="B", explication="C'est une fuite d'information : les statistiques de normalisation utilisées par l'entraînement ont été calculées sur des données de test. Les statistiques s'apprennent sur le train seul — le Pipeline (section 6) le fait pour vous.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — On normalise toutes les variables en calculant moyenne et écart-type sur le jeu complet, puis on sépare train et test. Qu'est-ce que cela change ?

  A. Rien : la normalisation est une transformation neutre
  B. Les statistiques ont vu le test : la performance mesurée est trop optimiste
  C. Le modèle devient moins précis, car il perd l'échelle d'origine

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
4. Rendre le surapprentissage VISIBLE
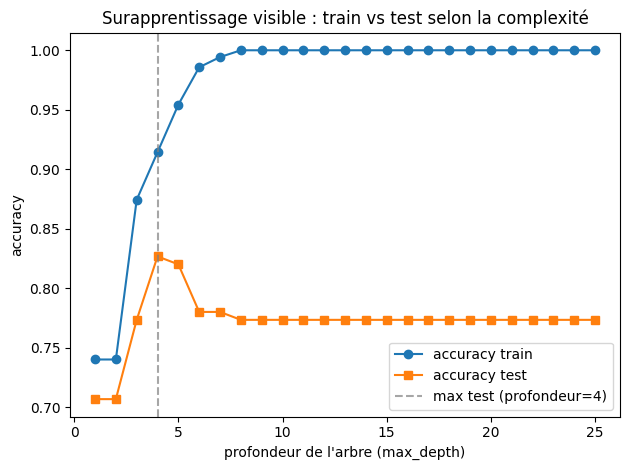
C’est le concept-phare de ce notebook. Plutôt qu’un seul point de mesure, nous balayons la complexité : pour chaque profondeur max_depth de 1 à 25, nous entraînons un arbre puis mesurons son accuracy sur train et sur test. On trace alors les deux courbes.
Que doit-on observer ?
L’accuracy d’entraînement monte vers 1.0 (l’arbre mémorise de plus en plus finement).
L’accuracy de test plafonne puis redescend : au-delà d’une certaine complexité, le modèle apprend du bruit.
L’écart de généralisation (train − test) s’élargit avec la profondeur : c’est la signature visible du surapprentissage.
Référence. Hastie, T., Tibshirani, R. & Friedman, J. (2009), The Elements of Statistical Learning, Springer (2e éd.), sections 2.9 et 7. Le compromis biais-variance et le surapprentissage y sont analysés : la complexité du modèle augmente la variance et réduit la capacité de généralisation.
# Exemple résolu : balayage de complexité (max_depth de 1 à 25)depths =list(range(1, 26))trains = []tests = []for d in depths: clf = DecisionTreeClassifier(max_depth=d, random_state=42) clf.fit(X_train, y_train) trains.append(accuracy_score(y_train, clf.predict(X_train))) tests.append(accuracy_score(y_test, clf.predict(X_test)))sweep = pd.DataFrame({'profondeur': depths,'accuracy_train': trains,'accuracy_test': tests,})plt.figure()plt.plot(sweep['profondeur'], sweep['accuracy_train'], marker='o', label='accuracy train')plt.plot(sweep['profondeur'], sweep['accuracy_test'], marker='s', label='accuracy test')# Marquer la profondeur d'accuracy test maximalemeilleur = sweep.loc[sweep['accuracy_test'].idxmax(), 'profondeur']plt.axvline(meilleur, color='gray', linestyle='--', alpha=0.7, label=f'max test (profondeur={meilleur})')plt.xlabel("profondeur de l'arbre (max_depth)")plt.ylabel('accuracy')plt.title("Surapprentissage visible : train vs test selon la complexité")plt.legend()plt.tight_layout()plt.show()# Ligne d'accuracy test maximaleprint(sweep.loc[sweep['accuracy_test'].idxmax()])
Lecture du graphique : les ciseaux du surapprentissage
La courbe d’accuracy train monte continûment et finit par atteindre 1,0 : un arbre assez profond mémorise chaque observation, bruit compris. La courbe test suit la même trajectoire au début, culmine autour de la profondeur 4 (accuracy 0,827), puis plafonne voire régresse. L’écart qui s’ouvre entre les deux courbes — 0,914 contre 0,827 au sommet du test — est le surapprentissage rendu visible : le modèle gagne sur des exemples déjà vus sans gagner sur des exemples nouveaux.
Deux précautions pour la suite. D’abord, l’argmax du test (exercice 2) est une estimation fragile : sur 150 observations de test, un point d’accuracy représente 1,5 exemple, et le voisinage de l’optimum est plat — la validation croisée (notebook 2.5) remplacera ce jugement à décision unique par une moyenne sur plusieurs découpages. Ensuite, ce balayage a utilisé le jeu de test pour choisir l’hyperparamètre : en pratique, ce choix se fait sur un jeu de validation dédié, et le test ne sert qu’une seule fois, à la toute fin — sinon on optimise contre le juge.
Exercice 2 : trouver la profondeur optimale
Objectif. À partir du DataFrame sweep construit ci-dessus, extrayez la profondeur optimale : celle qui maximise l’accuracy de test. Reportez ensuite l’accuracy d’entraînement et de test à cette profondeur.
Indices.
Indice : sweep['accuracy_test'].idxmax() donne l’indice de la ligne où l’accuracy de test est maximale.
# Exercice 2 : profondeur optimale = argmax de l'accuracy test# TODO etudiant : trouver l'indice de profondeur optimale puis la valeurindice_optimal =None# TODO etudiant : remplacer (idx de l'accuracy test maximale)profondeur_optimale =None# TODO etudiant : remplacer (sweep.loc[indice_optimal, 'profondeur'])acc_train_opt =None# TODO etudiant : remplaceracc_test_opt =None# TODO etudiant : remplacerprint(f"Exercice 2 a completer : profondeur optimale = {profondeur_optimale}, "f"train = {acc_train_opt}, test = {acc_test_opt}")
Exercice 2 a completer : profondeur optimale = None, train = None, test = None
5. Côté régression : une autre famille de métriques
Jusqu’ici nous faisions de la classification (étiquettes discrètes 0/1), mesurée par l’accuracy (proportion de prédictions correctes). En régression, la cible est un nombre continu : prédire « 2.51 » quand la vérité est « 2.49 » n’est ni totalement faux ni totalement juste. Il faut donc une métrique de distance entre prédiction et réalité.
La MAE (mean absolute error) est la moyenne des valeurs absolues des écarts :
Plus la MAE est faible, meilleure est la régression (elle s’exprime dans la même unité que la cible).
Référence. La MAE (mean absolute error) est l’un des estimateurs d’erreur les plus robustes pour la régression ; voir Hastie, Tibshirani & Friedman (2009), The Elements of Statistical Learning, Springer (2e éd.), section 10.6 pour la comparaison des critères de perte (L1 vs L2).
# Exemple résolu : régression linéaire et MAEXr, yr = make_regression(n_samples=300, n_features=5, noise=15.0, random_state=42)# En régression, pas de stratify (la cible est continue)Xr_train, Xr_test, yr_train, yr_test = train_test_split(Xr, yr, test_size=0.3, random_state=42)modele_reg = LinearRegression()modele_reg.fit(Xr_train, yr_train)yr_pred = modele_reg.predict(Xr_test)mae = mean_absolute_error(yr_test, yr_pred)print("MAE (mean absolute error) : {:.3f}".format(mae))
MAE (mean absolute error) : 11.105
Exercice 3 : recalculer la MAE à la main
Objectif. Recalculez la MAE manuellement avec NumPy (moyenne des valeurs absolues des résidus) et comparez-la à la valeur renvoyée par mean_absolute_error de scikit-learn. Elles doivent être égales.
Indices.
Indice : np.mean(np.abs(yr_pred - yr_test)).
Étape 1 : calculer les résidus yr_pred - yr_test.
Étape 2 : prendre la valeur absolue puis la moyenne avec NumPy.
# Exercice 3 : MAE manuelle (moyenne des valeurs absolues des résidus)# TODO etudiant : calculer la MAE à la main avec numpymae_manuelle =None# TODO etudiant : remplacerprint(f"Exercice 3 a completer : MAE manuelle = {mae_manuelle}")
Exercice 3 a completer : MAE manuelle = None
Vérification 2 — l’écart qui mesure le surapprentissage
question("Un arbre de décision devient de plus en plus profond. Que se passe-t-il ?", choix=["L'accuracy d'entraînement monte et l'écart avec l'accuracy de test se creuse","Les deux accuracies montent ensemble","L'accuracy de test rejoint exactement l'accuracy d'entraînement", ], bonne="A", explication="Une profondeur plus grande réduit le biais et augmente la variance : l'arbre finit par mémoriser le train, et c'est l'écart train/test qui rend ce surapprentissage visible.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — Un arbre de décision devient de plus en plus profond. Que se passe-t-il ?

  A. L'accuracy d'entraînement monte et l'écart avec l'accuracy de test se creuse
  B. Les deux accuracies montent ensemble
  C. L'accuracy de test rejoint exactement l'accuracy d'entraînement

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
6. Bonne pratique : le Pipeline
Le prétraitement (mise à l’échelle, imputation des valeurs manquantes…) doit toujours vivre à l’intérieur d’un Pipeline scikit-learn. Pourquoi ? Pour éviter les fuites de données (data leakage) : si l’on calcule les paramètres d’un StandardScaler (moyenne, écart-type) sur tout le jeu de données — test compris — puis qu’on évalue sur le test, le modèle a indirectement « vu » des informations issues du test. Le Pipeline garantit que le scaler est ajusté uniquement sur le fragment d’entraînement, puis appliqué au test sans réutiliser ses propres statistiques.
# Exemple résolu : un Pipeline (scaler + arbre) sans fuite de donnéespipeline = Pipeline([ ('scaler', StandardScaler()), ('tree', DecisionTreeClassifier(max_depth=4, random_state=42)),])# Même workflow que sans pipeline, mais le scaler ne voit que le trainpipeline.fit(X_train, y_train)y_pred_pipe = pipeline.predict(X_test)acc_pipe = accuracy_score(y_test, y_pred_pipe)print("Accuracy (Pipeline scaler + arbre) : {:.3f}".format(acc_pipe))print("-> Le Pipeline applique le StandardScaler ajusté sur le train seulement :")print(" aucune statistique du test ne fuite dans l'entraînement.")
Accuracy (Pipeline scaler + arbre) : 0.827
-> Le Pipeline applique le StandardScaler ajusté sur le train seulement :
   aucune statistique du test ne fuite dans l'entraînement.
Lecture : 0,827 — exactement l’accuracy de l’arbre nu à profondeur 4
Ce n’est pas une coïncidence, et c’est l’occasion d’une observation honnête : un arbre de décision est insensible aux changements d’échelle. Ses seuils de coupure se déplacent avec la mise à l’échelle, mais les partitions de l’espace des caractéristiques restent les mêmes — le StandardScaler ne change donc rien pour ce modèle précis. La valeur du Pipeline n’est pas ici un gain d’accuracy : c’est la discipline. Dès que le modèle deviendra sensible aux échelles (k-NN, régression régularisée, SVM dans les notebooks suivants), ce même pipeline garantira que le scaler est ajusté sur le train seul ; écrit à la main, le réflexe « scaler puis découper » laisserait la moyenne et l’écart-type du test contaminer l’entraînement — une fuite silencieuse qui gonfle l’accuracy mesurée.
7. Reculer d’un pas : la grille « Data Science in Context »
Le workflow split -> fit -> predict -> evaluate est le geste technique central — mais un projet de science des données n’est pas que ce geste. Spector, Norvig, Wiggins et Wing (Data Science in Context, 2022 ; « More Than Just Algorithms », Communications of the ACM 66(8), 2023) proposent une grille en sept points pour interroger n’importe quel projet : données traitables, approche technique, fiabilité, intelligibilité, objectifs clairs, tolérance aux échecs, implications éthiques/juridiques/sociétales.
Appliquons-la au cas que ce notebook vient d’exécuter — non pas à la main, mais par une fonction : chaque ligne dira ce que le notebook couvre, ce qu’il tait, et quel notebook de la série y répond.
# Exemple résolu : grille Data Science in Context appliquée au cas de ce notebookdef grille_contexte(cas):"""Rend la grille à sept points (Spector, Norvig, Wiggins & Wing) pour un cas donné. cas : dict {1..7: {"titre": str, "couvert": str, "tais": str, "ref": str}} """ lignes = [ {"point": f"{num}. {p['titre']}", "couvert ici": p["couvert"],"tenu silencieux": p["tais"], "où le voir": p["ref"]}for num, p insorted(cas.items()) ]return pd.DataFrame(lignes).set_index("point")# Faits mesurés sur le cas RÉEL de ce notebook (aucune valeur écrite à la main)prop_majoritaire =float(pd.Series(y).value_counts(normalize=True).max())ecart_arbre =float(acc_train - acc_test) # arbre de profondeur 3 (section 3)chute_test =float(sweep["accuracy_test"].max() - sweep["accuracy_test"].iloc[-1])cas_21 = {1: {"titre": "Données traitables","couvert": f"Jeu synthétique déterministe (500 obs., 8 caractéristiques, classes quasi équilibrées : {prop_majoritaire:.2f} pour la majoritaire) — reproductible, sans dépendance de fichier.","tais": "Le nettoyage de données réelles : valeurs manquantes, encodage, et surtout le déséquilibre de classes.","ref": "2.12-Donnees-Desequilibrees.ipynb"},2: {"titre": "Approche technique","couvert": "Arbre de décision et régression linéaire, workflow fit/predict/evaluate explicite, Pipeline anti-fuite (section 6).","tais": "Le CHOIX de l'approche : pourquoi un arbre plutôt qu'une forêt ou un k-NN ? Aucune comparaison d'alternatives n'est exécutée.","ref": "2.4-Arbres-Forets-Ensembles.ipynb"},3: {"titre": "Fiabilité","couvert": f"Holdout stratifié + mise en garde explicite contre l'argmax fragile (section 4) ; l'écart de généralisation de l'arbre de profondeur 3 est mesuré : {ecart_arbre:.3f}.","tais": "Une seule découpe train/test : ni validation croisée, ni intervalle de confiance sur la métrique.","ref": "2.5-Biais-Variance-CV-ROC.ipynb ; 2.5b-Calibration-Probabilites.ipynb"},4: {"titre": "Intelligibilité","couvert": "Métriques définies (accuracy, MAE) et courbes train/test lisibles ; mais fit() reste une boîte noire appelée, pas comprise.","tais": "Pourquoi un arbre prédit ce qu'il prédit : importance des variables, SHAP, LIME, contrefactuels.","ref": "2.14-Explicabilite-SHAP-LIME-Contrefactuels.ipynb"},5: {"titre": "Objectifs clairs","couvert": "La tâche et la métrique sont fixées AVANT l'évaluation (classification -> accuracy, régression -> MAE) : pas de métrique choisie après coup.","tais": "La dérivation du besoin métier vers la tâche ML : qui consomme la prédiction, pour quelle décision, à quel coût d'erreur ? Ce point vit au cadrage du projet, pas dans cette série technique.","ref": "(hors série 02 : cadrage projet)"},6: {"titre": "Tolérance aux échecs","couvert": f"Le balayage de complexité rend l'échec VISIBLE : l'accuracy test culmine puis perd {chute_test:.3f} entre son sommet et la profondeur 25.","tais": "L'analyse systématique des erreurs : quels exemples sont mal classés, forment-ils des segments cohérents ?","ref": "2.13-Analyse-Erreurs.ipynb"},7: {"titre": "Implications éthiques, juridiques, sociétales","couvert": "Rien — et c'est un fait : données synthétiques, pas de personnes, pas de biais de collecte possible.","tais": "Sur des données réelles, ce point serait le plus exigeant : équité entre sous-groupes, impact d'un faux négatif selon le profil.","ref": "2.5c-Equite-Sous-Groupes.ipynb"},}with pd.option_context("display.max_colwidth", None): display(grille_contexte(cas_21))
couvert ici
tenu silencieux
où le voir
point
1. Données traitables
Jeu synthétique déterministe (500 obs., 8 caractéristiques, classes quasi équilibrées : 0.52 pour la majoritaire) — reproductible, sans dépendance de fichier.
Le nettoyage de données réelles : valeurs manquantes, encodage, et surtout le déséquilibre de classes.
2.12-Donnees-Desequilibrees.ipynb
2. Approche technique
Arbre de décision et régression linéaire, workflow fit/predict/evaluate explicite, Pipeline anti-fuite (section 6).
Le CHOIX de l'approche : pourquoi un arbre plutôt qu'une forêt ou un k-NN ? Aucune comparaison d'alternatives n'est exécutée.
2.4-Arbres-Forets-Ensembles.ipynb
3. Fiabilité
Holdout stratifié + mise en garde explicite contre l'argmax fragile (section 4) ; l'écart de généralisation de l'arbre de profondeur 3 est mesuré : 0.101.
Une seule découpe train/test : ni validation croisée, ni intervalle de confiance sur la métrique.
Métriques définies (accuracy, MAE) et courbes train/test lisibles ; mais fit() reste une boîte noire appelée, pas comprise.
Pourquoi un arbre prédit ce qu'il prédit : importance des variables, SHAP, LIME, contrefactuels.
2.14-Explicabilite-SHAP-LIME-Contrefactuels.ipynb
5. Objectifs clairs
La tâche et la métrique sont fixées AVANT l'évaluation (classification -> accuracy, régression -> MAE) : pas de métrique choisie après coup.
La dérivation du besoin métier vers la tâche ML : qui consomme la prédiction, pour quelle décision, à quel coût d'erreur ? Ce point vit au cadrage du projet, pas dans cette série technique.
(hors série 02 : cadrage projet)
6. Tolérance aux échecs
Le balayage de complexité rend l'échec VISIBLE : l'accuracy test culmine puis perd 0.053 entre son sommet et la profondeur 25.
L'analyse systématique des erreurs : quels exemples sont mal classés, forment-ils des segments cohérents ?
2.13-Analyse-Erreurs.ipynb
7. Implications éthiques, juridiques, sociétales
Rien — et c'est un fait : données synthétiques, pas de personnes, pas de biais de collecte possible.
Sur des données réelles, ce point serait le plus exigeant : équité entre sous-groupes, impact d'un faux négatif selon le profil.
2.5c-Equite-Sous-Groupes.ipynb
Lecture de la grille : les trous sont le résultat
Deux lignes parlent plus que les autres. Le point 7 est vide — et c’est honnête : sur des données synthétiques, il n’y a personne à léser ; mais le réflexe doit être pris AVANT les données réelles, où ce point devient le plus exigeant (2.5c-Equite-Sous-Groupes). Le point 5 n’est couvert qu’à moitié : fixer la métrique avant l’évaluation est une discipline que ce notebook tient ; la dérivation du besoin métier vers la tâche ML ne vit dans aucun notebook de la série — c’est un cadrage de projet, pas un geste technique.
La grille ne dit pas que ce notebook est incomplet : elle dit où continuer — 2.12 pour les données réelles déséquilibrées, 2.5 pour la fiabilité multi-découpes, 2.13 pour l’analyse d’erreurs, 2.14 pour l’intelligibilité.
Exercice 4 : la grille sur le second cas de ce notebook
Contexte. La section 5 a exécuté un second cas : la régression (make_regression, LinearRegression, MAE). La grille s’applique à tout projet — y compris à ce cas-là.
Objectif. Construisez cas_regression : le dictionnaire des sept points appliqués au cas régression. Deux lignes au minimum doivent changer réellement par rapport à cas_21 (la métrique n’est plus l’accuracy ; il n’y a pas de stratify sur une cible continue). Rendez ensuite la grille avec grille_contexte(cas_regression).
Indices.
Étape 1 : partir de la structure de cas_21 (mêmes clés 1..7, mêmes champs titre/couvert/tais/ref).
Indice : pour le point 1, mesurez par exemple l’étendue de la cible : float(yr.max() - yr.min()).
Indice : pour le point 3, le holdout de la régression n’est PAS stratifié — pourquoi ?
# Exercice 4 : grille appliquée au cas régression de la section 5# TODO etudiant : construire le dict des 7 points pour le cas (Xr, yr, modele_reg, mae)cas_regression =None# TODO etudiant : remplacer (dict {1..7: {"titre", "couvert", "tais", "ref"}})if cas_regression isNone:print("Exercice 4 a completer : appliquer la grille au cas regression (metrique, donnees, fiabilite...)")else:print(grille_contexte(cas_regression))
Exercice 4 a completer : appliquer la grille au cas regression (metrique, donnees, fiabilite...)
Après le parcours — question de transfert
question("Vous estimez une performance par validation croisée, avec une standardisation des variables. Où placer le `StandardScaler` ?", choix=["Sur le jeu complet, avant la boucle de validation","Dans le `Pipeline`, pour que chaque pli apprenne ses propres statistiques","Peu importe : le score obtenu est le même", ], bonne="B", explication="Hors du Pipeline, les statistiques voient les plis de validation et le score remonte artificiellement. Dans le Pipeline, la transformation est réapprise à chaque pli, et le score mesure ce qu'il prétend mesurer.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="apres",)
Transfert — Vous estimez une performance par validation croisée, avec une standardisation des variables. Où placer le `StandardScaler` ?

  A. Sur le jeu complet, avant la boucle de validation
  B. Dans le `Pipeline`, pour que chaque pli apprenne ses propres statistiques
  C. Peu importe : le score obtenu est le même

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
Conclusion et transition
Récapitulatif.
Le workflow canonique : train_test_split → fit → predict → evaluate.
On sépare train et test pour estimer honnêtement la généralisation.
Le surapprentissage devient visible quand on balaye la complexité : l’écart train/test s’élargit.
Le choix de la métrique dépend de la tâche : accuracy pour la classification, MAE pour la régression.
Le Pipeline protège contre les fuites de données.
Transition. Le prochain notebook (2.2-Descente-de-gradient) ouvre la boîte noire : au lieu d’appeler fit(), nous implémenterons nous-mêmes l’optimisation qui fait apprendre un modèle.
References
Mitchell, T. (1997). Machine Learning. McGraw-Hill. — Le surapprentissage et la distinction entraînement/généralisation comme concept central de l’apprentissage supervisé.
Stone, M. (1974). Cross-Validatory Choice and Assessment of Statistical Predictions. Journal of the Royal Statistical Society. Series B (Methodological) 36(2):111-147. — Le principe d’évaluation sur des données non vues.
Breiman, L., Friedman, J., Olshen, R. & Stone, C. (1984). Classification and Regression Trees. Wadsworth. — Les arbres CART et la profondeur comme contrôle de complexité.
Hastie, T., Tibshirani, R. & Friedman, J. (2009). The Elements of Statistical Learning. Springer (2e éd.). — Compromis biais-variance, surapprentissage, critères de perte pour la régression.
Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12:2825-2830. — La bibliothèque scikit-learn utilisée dans tout ce notebook (train_test_split, DecisionTreeClassifier, LinearRegression, métriques, Pipeline).