Tous les notebooks précédents (2.1 à 2.5) relevaient de l’apprentissage supervisé : on disposait d’étiquettes y à prédire. Ce notebook aborde l’apprentissage non supervisé : aucune étiquette n’est fournie à l’algorithme. Nous étudions deux techniques canoniques : le clustering (regrouper les observations similaires, ici avec KMeans) et la réduction de dimension (projeter des données à forte dimension dans un espace plus petit tout en préservant l’information, ici l’Analyse en Composantes Principales — ACP / PCA).
Nous travaillons sur les chiffres manuscrits de load_digits : 64 pixels par image (une image 8×8 aplanie en un vecteur de dimension 64) et 10 classes de chiffres (0 à 9). Les algorithmes ne verront jamais les étiquettes — nous les utiliserons uniquement pour vérifier que la structure non supervisée retrouve les classes connues.
Objectifs d’apprentissage
À la fin de ce notebook, vous saurez : 1. Appliquer KMeans et choisir le nombre de clusters (méthode du coude) ; 2. Comprendre l’inertie (somme des carrés des écarts intra-cluster) ; 3. Réduire 64 dimensions à 2 avec la PCA et visualiser la projection ; 4. Interpréter la variance expliquée cumulée pour choisir le nombre de composantes ; 5. Visualiser les mêmes données avec t-SNE et UMAP (réduction non linéaire), mesurer l’effet de la perplexité, et choisir la méthode de réduction selon votre objectif (compression, visualisation, pipeline aval).
Prérequis
Notebooks 2.1 (workflow ML), notions de distance euclidienne et de variance.
Référence. MacQueen, J. (1967), Some Methods for Classification and Analysis of Multivariate Observations, Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability. La méthode des k-means (k-moyennes) y est introduite : on partitionne les observations en k groupes qui minimisent l’inertie intra-cluster (somme des carrés des écarts au centre).
# Configuration et imports pour le notebook 2.6import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets import load_digitsfrom sklearn.cluster import KMeansfrom sklearn.decomposition import PCAfrom sklearn.metrics import confusion_matrix, accuracy_score # pour la verification uniquementnp.random.seed(42)print("Configuration OK : 2.6 - Clustering (KMeans) et ACP")
Configuration OK : 2.6 - Clustering (KMeans) et ACP
Auto-évaluation
Ce carnet porte un dispositif d’auto-évaluation formatif : quatre questions, placées avant le parcours (diagnostic de prérequis), au milieu (vérification de la notion) et à la fin (transfert). Aucune note n’est stockée, aucune réponse n’est enregistrée.
Chaque cellule de question s’exécute sans erreur tant que vous n’avez pas répondu ; la correction s’affiche uniquement lorsque vous remplacez reponse=None par la lettre de votre choix, puis ré-exécutez la cellule.
# Dispositif d'auto-evaluation de la serie (module partage, issue #18207)import pathlibimport sysfor _racine in (pathlib.Path.cwd(), *pathlib.Path.cwd().parents):if (_racine /"MyIA.AI.Notebooks").is_dir(): sys.path.insert(0, str(_racine /"MyIA.AI.Notebooks"/"ML"/"DataScienceWithAgents"))breakfrom auto_evaluation import question # noqa: E402
Avant de commencer — question de diagnostic
question("Qu'est-ce qui distingue le clustering de l'apprentissage supervisé ?", choix=["Il n'y a pas de variable cible : les groupes se définissent par la structure des données, et le numéro d'un cluster n'a pas de sens en lui-même","Le clustering est supervisé, mais sans étiquettes fournies","Le clustering prédit une classe apprise à l'avance", ], bonne="A", explication="Sans cible, il n'y a rien à prédire juste ou faux : on décrit une structure. C'est pourquoi le numéro des clusters est arbitraire, et pourquoi ce carnet les compare aux vraies étiquettes seulement après coup.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="avant",)
Diagnostic de prérequis — Qu'est-ce qui distingue le clustering de l'apprentissage supervisé ?

  A. Il n'y a pas de variable cible : les groupes se définissent par la structure des données, et le numéro d'un cluster n'a pas de sens en lui-même
  B. Le clustering est supervisé, mais sans étiquettes fournies
  C. Le clustering prédit une classe apprise à l'avance

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
1. Le jeu de données : chiffres manuscrits
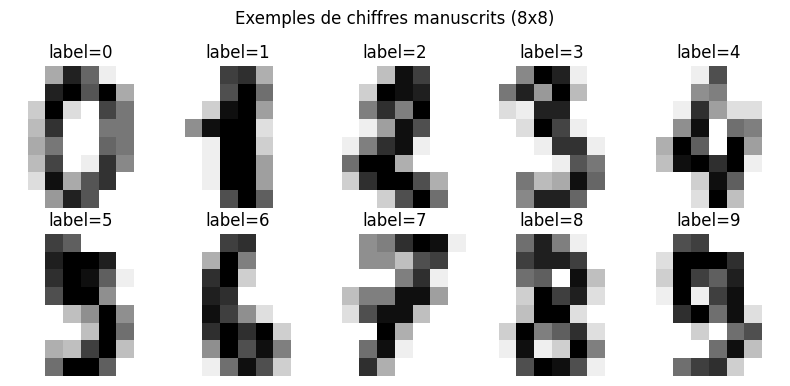
Le jeu de données load_digits contient 1797 images de chiffres manuscrits (0 à 9), chacune codée sur une grille de 8×8 = 64 pixels niveaux de gris. Chaque image, une fois aplanie, devient un vecteur de dimension 64 : c’est ce vecteur que les algorithmes manipulent. Les 10 classes (les chiffres 0 à 9) sont connues via les étiquettes y, mais le clustering et la PCA les ignoreront — nous n’utiliserons y qu’après coup pour vérifier que la structure non supervisée retrouve ces classes.
# Chargement des chiffres manuscritsdigits = load_digits()X = digits.data # 1797 images x 64 pixels (vecteurs aplanis)y = digits.target # etiquettes 0-9 (utilisees UNIQUEMENT pour verification)print(f"X shape : {X.shape}") # attendu (1797, 64)print(f"Nombre de classes : {len(np.unique(y))}") # attendu 10# Apercu de quelques imagesfig, axes = plt.subplots(2, 5, figsize=(8, 4))for i, ax inenumerate(axes.flat): ax.imshow(digits.images[i], cmap='gray_r') ax.set_title(f"label={y[i]}") ax.axis('off')plt.suptitle("Exemples de chiffres manuscrits (8x8)")plt.tight_layout()plt.show()
X shape : (1797, 64)
Nombre de classes : 10
Lecture du jeu de données
1797 images de 64 pixels : chaque chiffre manuscrit est une grille 8×8 aplatie en un vecteur de 64 intensités de gris — c’est ce que dit le (1797, 64) affiché, et pourquoi chaque ligne de X vit dans un espace à 64 dimensions. Les 10 classes (chiffres 0 à 9) sont à peu près équilibrées, environ 180 images chacune. Le point clé pour la suite : ces étiquettes existent dans le jeu de données, mais le clustering ne les utilisera jamais — elles ne serviront qu’à vérifier, a posteriori, si les groupes trouvés sans supervision coïncident avec les vrais chiffres. C’est ce protocole (apprendre sans les labels, évaluer avec) qui rend ce jeu de données un banc d’essai honnête du non-supervisé.
2. Clustering avec KMeans
KMeans partitionne les données en k clusters. Il procède itérativement : (1) il affecte chaque point au centroïde le plus proche, puis (2) déplace chaque centroïde sur la moyenne de ses points. L’algorithme minimise l’inertie (somme des carrés des distances de chaque point à son centroïde). Il faut fournir k en entrée — nous utilisons 10 ici (nous savons qu’il y a 10 chiffres), puis nous verrons comment choisir k objectivement avec la méthode du coude.
# Clustering KMeans avec 10 clusterskmeans = KMeans(n_clusters=10, random_state=42, n_init=10)kmeans.fit(X)print(f"Inertie (within-cluster sum of squares) : {kmeans.inertia_:.2f}")print(f"Labels de cluster (10 premiers points) : {kmeans.labels_[:10]}")print("Attention : les identifiants de cluster sont ARBITRAIRES ""(le cluster 3 ne correspond pas forcement au chiffre 3).")
Inertie (within-cluster sum of squares) : 1165256.30
Labels de cluster (10 premiers points) : [1 3 3 6 9 8 5 4 3 8]
Attention : les identifiants de cluster sont ARBITRAIRES (le cluster 3 ne correspond pas forcement au chiffre 3).
Lecture de la première expérience KMeans
L’inertie 1 165 256 est la somme des carrés des distances de chaque point au centre de son cluster : c’est la quantité que KMeans minimise, une mesure de compacité interne — plus elle est basse, plus les boules sont serrées. Le détail affiché juste après est le piège classique du non-supervisé : les labels de cluster sont arbitraires. Le cluster « 3 » de la sortie n’a aucun lien avec le chiffre 3 — l’algorithme numérote ses groupes selon l’ordre d’initialisation, pas selon notre sémantique. Toute correspondance cluster → chiffre demandera une étape d’alignement explicite (ce que fera la matrice de confusion de la section 5). Enfin, demander k=10 est déjà une hypothèse forte : nous savons qu’il y a 10 chiffres, mais en vraie donnée sans étiquette, choisir k serait tout le problème — c’est l’objet de la méthode du coude qui suit.
3. Choisir k : la méthode du coude
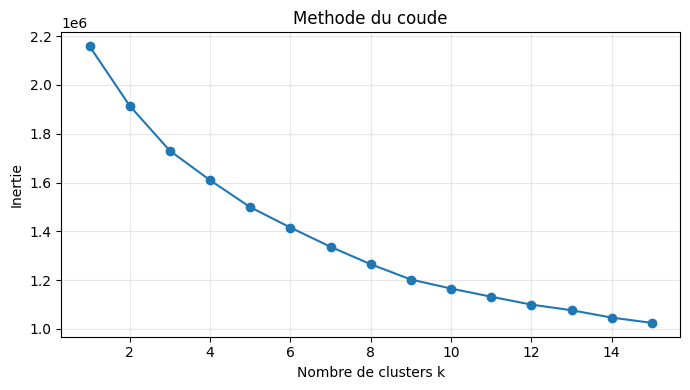
L’inertie décroît toujours quand k augmente (plus de clusters = des groupes plus serrés). Il n’existe pas de « vrai » k déductible de la seule inertie, mais la courbe présente souvent un coude (en anglais elbow) : un point d’inflexion où ajouter des clusters n’apporte plus guère de gain. Ce coude est un choix raisonnable pour k.
# Methode du coude : inertie en fonction du nombre de clusters kinerties = []for k inrange(1, 16): km = KMeans(n_clusters=k, random_state=42, n_init=10) km.fit(X) inerties.append(km.inertia_)plt.figure(figsize=(7, 4))plt.plot(range(1, 16), inerties, 'o-')plt.xlabel("Nombre de clusters k")plt.ylabel("Inertie")plt.title("Methode du coude")plt.grid(True, alpha=0.3)plt.tight_layout()plt.show()print(f"Inertie pour k=10 : {inerties[9]:.2f}")print("Un coude est visible autour de k=10, coherent avec les 10 chiffres.")
Inertie pour k=10 : 1165256.30
Un coude est visible autour de k=10, coherent avec les 10 chiffres.
Lecture de la courbe du coude
La courbe décroît vite puis s’aplatit : chaque cluster ajouté retire de l’inertie, mais avec un rendement décroissant. Le coude est le point où le gain marginal devient négligeable — payer un cluster de plus ne « serre » presque plus rien. Que ce coude émerge autour de k=10 est une information remarquable : l’algorithme, qui n’a jamais vu les étiquettes, retrouve de lui-même la structure des dix chiffres dans la donnée. C’est le message central du non-supervisé : la classe n’est pas une annotation magique, c’est une régularité de la donnée que la compacité seule suffit à révéler — au prix, ici, d’un œil sur la courbe pour trancher où s’arrêter.
Exercice 1 : la décroissance de l’inertie
Objectif : mesurer la chute d’inertie lorsqu’on passe de k=5 à k=10 clusters, à partir de la liste inerties.
Indice : inerties est une liste 0-indexée (indice 0 = k=1, indice 4 = k=5, indice 9 = k=10). La baisse vaut inerties[4] - inerties[9].
# Exercice 1 : chute d'inertie entre k=5 et k=10# inerties est une liste 0-indexee : indice 4 = k=5, indice 9 = k=10baisse_inertie =None# TODO etudiant : remplacer (inerties[4] - inerties[9])print(f"Exercice 1 a completer : l'inertie baisse de {baisse_inertie} entre k=5 et k=10")
Exercice 1 a completer : l'inertie baisse de None entre k=5 et k=10
Vérification 1 — lire la courbe du coude
question("L'inertie diminue quand k augmente. Qu'est-ce que cela implique pour la méthode du coude ?", choix=["Elle fournit un critère absolu : on retient le k qui minimise l'inertie","Elle ne peut être qu'un repère visuel : on cherche un changement de pente, pas un minimum","Elle prouve que le découpage en k clusters est le bon", ], bonne="B", explication="Comme l'inertie décroît toujours avec k, elle ne peut pas désigner un optimum par elle-même — à la limite, k égal au nombre de points l'annule. Le coude est un changement de régime, lu sur la courbe.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — L'inertie diminue quand k augmente. Qu'est-ce que cela implique pour la méthode du coude ?

  A. Elle fournit un critère absolu : on retient le k qui minimise l'inertie
  B. Elle ne peut être qu'un repère visuel : on cherche un changement de pente, pas un minimum
  C. Elle prouve que le découpage en k clusters est le bon

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
4. Réduction de dimension : l’ACP (PCA)
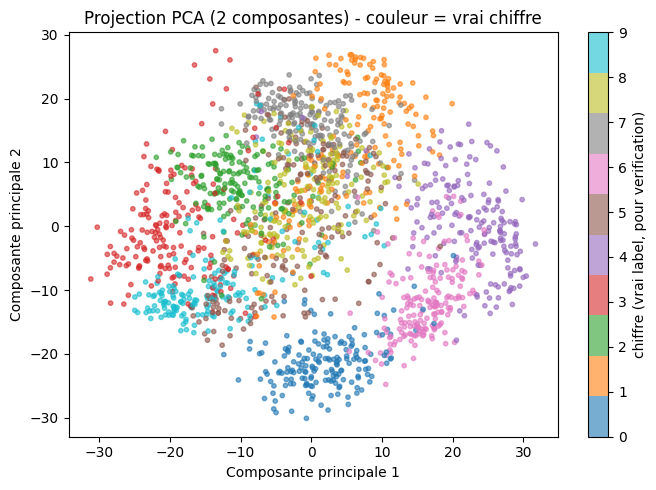
Chaque chiffre est un point dans un espace à 64 dimensions — impossible à tracer directement. La PCA (Principal Component Analysis, ou ACP en français) identifie les directions de variance maximale et projette les données sur les premières. La première composante principale capture le plus de variance, la deuxième le résidu orthogonal, etc. Projeter sur les 2 premières composantes donne un nuage de points 2D que l’on PEUT visualiser — et souvent les classes s’y séparent.
Référence. Pearson, K. (1901), On Lines and Planes of Closest Fit to Systems of Points in Space, Philosophical Magazine 2(11):559-572. Article fondateur de l’Analyse en Composantes Principales : la recherche des axes de variance maximale comme projection optimale (au sens des moindres carrés).
# Reduction de dimension : PCA a 2 composantespca = PCA(n_components=2)X_pca = pca.fit_transform(X)variance_2d = pca.explained_variance_ratio_.sum()print(f"Variance expliquee par les 2 premieres composantes : {variance_2d:.3f} "f"({variance_2d*100:.1f}%)")plt.figure(figsize=(7, 5))plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, cmap='tab10', s=10, alpha=0.6)plt.colorbar(label="chiffre (vrai label, pour verification)")plt.xlabel("Composante principale 1")plt.ylabel("Composante principale 2")plt.title("Projection PCA (2 composantes) - couleur = vrai chiffre")plt.tight_layout()plt.show()print("Meme en 2D, les classes de chiffres forment des groupes visibles : ""la PCA non supervisée retrouve la structure connue.")
Variance expliquee par les 2 premieres composantes : 0.285 (28.5%)
Meme en 2D, les classes de chiffres forment des groupes visibles : la PCA non supervisée retrouve la structure connue.
Lecture de la projection ACP
Les deux premières composantes ne capturent que 28,5 % de la variance : projeter 64 dimensions sur 2 en jette les sept dixièmes. Et pourtant le nuage montre déjà des regroupements — les classes les plus séparées dans l’espace original restent séparées après projection. C’est le compromis de l’ACP : c’est la meilleure projection linéaire possible (au sens de la variance conservée), mais elle reste linéaire — deux chiffres séparés par une frontière courbe dans l’espace original peuvent se chevaucher une fois aplatis. L’exigence des 95 % de l’exercice 2 mesurera exactement ce que coûte la compression : combien de directions faut-il garder pour ne presque rien perdre.
Exercice 2 : combien de composantes garder ?
Les 2 premières composantes ne captent qu’une partie de la variance. Pour compresser sans trop perdre d’information, on cherche le nombre de composantes suffisant à atteindre 95 % de variance cumulée.
Étapes 1. La cellule suivante ajuste une PCA() (toutes les composantes) sur X et définit variance_expliquee (le ratio de variance de chacune des 64 composantes). 2. Calculez la variance cumulée avec np.cumsum(variance_expliquee). 3. Trouvez le premier indice où la cumulée dépasse 0.95 (rappelez-vous d’ajouter 1 pour passer de l’indice au nombre de composantes).
# Exercice 2 : nombre de composantes pour 95% de variance expliquee# variance_expliquee est le ratio de variance par composante (64 valeurs)cumul =None# TODO etudiant : remplacer (np.cumsum(variance_expliquee))# TODO etudiant : nombre de composantes pour atteindre 95% (premier indice ou cumul >= 0.95)n_composantes_95 =None# TODO etudiant : remplacerprint(f"Exercice 2 a completer : {n_composantes_95} composantes suffisent pour 95% de la variance")
Exercice 2 a completer : None composantes suffisent pour 95% de la variance
5. Vérifier le clustering contre les vraies étiquettes
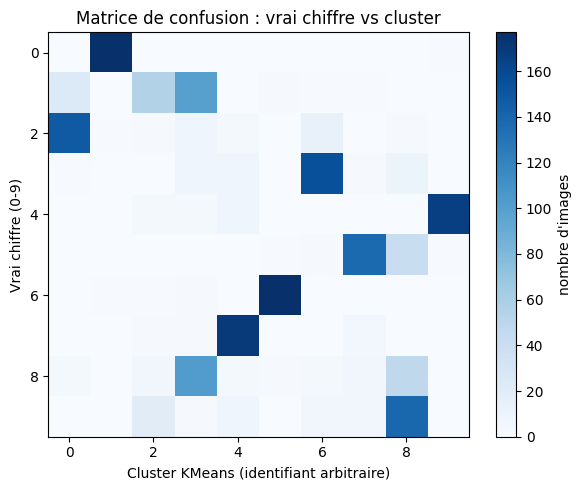
KMeans a trouvé 10 clusters sans voir les étiquettes. Ces clusters correspondent-ils aux 10 classes de chiffres ? On peut le vérifier avec une matrice de confusion entre kmeans.labels_ et y. Attention : les identifiants de cluster étant arbitraires, la matrice est une permutation des colonnes — mais si une structure diagonale se dessine, la méthode non supervisée a bien retrouvé les classes. C’est la démonstration honnête que l’apprentissage non supervisé redécouvre une structure connue.
# Verification : matrice de confusion entre vrais chiffres et clusters KMeansmatrice = confusion_matrix(y, kmeans.labels_)plt.figure(figsize=(6, 5))plt.imshow(matrice, cmap='Blues', aspect='auto')plt.colorbar(label="nombre d'images")plt.xlabel("Cluster KMeans (identifiant arbitraire)")plt.ylabel("Vrai chiffre (0-9)")plt.title("Matrice de confusion : vrai chiffre vs cluster")plt.tight_layout()plt.show()print("Chaque ligne = un vrai chiffre, chaque colonne = un cluster.")print("Une structure diagonale (a permutation des colonnes pres) signifie")print("que les clusters correspondent aux classes de chiffres.")
Chaque ligne = un vrai chiffre, chaque colonne = un cluster.
Une structure diagonale (a permutation des colonnes pres) signifie
que les clusters correspondent aux classes de chiffres.
Lecture du résultat — la diagonale à permutation près
La matrice montre une structure quasi diagonale, à une permutation des colonnes près : chaque ligne (vrai chiffre) concentre l’essentiel de sa masse sur une colonne (un cluster) — mais cette colonne change d’une ligne à l’autre, conséquence directe des identifiants de cluster arbitraires. Deux lectures concrètes de ce que la géométrie de l’espace pixel révèle : (1) les cases hors diagonale portant une masse non négligeable indiquent les chiffres que KMeans confond dans cet espace — des écritures dont les vecteurs de 64 pixels se recouvrent ; (2) un chiffre dont la masse se partage entre deux colonnes signale une classe coupée en deux modes d’écriture (deux « styles » du même chiffre que deux clusters distincts absorbent). C’est une information qu’un simple taux de réussite supervisé ne donne pas : la matrice montre où la structure non supervisée échoue, pas seulement combien. La section 7 y répondra par anticipation : ce sont précisément ces recouvrements que la réduction non linéaire vient séparer visuellement.
Exercice 3 : les clusters correspondent-ils aux chiffres ?
Objectif : pour le vrai chiffre « 0 » (les points où y == 0), trouver quel cluster (0 à 9) est le plus fréquent parmi ceux attribués par KMeans.
Étapes 1. Construisez le masque masque_zero = (y == 0). 2. Sélectionnez les clusters de ces points : clusters_zero = kmeans.labels_[masque_zero]. 3. Trouvez le cluster dominant avec np.bincount(clusters_zero).argmax().
# Exercice 3 : pour le vrai chiffre 0, quel cluster (0-9) est le plus frequent ?masque_zero = (y ==0) # les points dont le vrai chiffre est 0clusters_zero = kmeans.labels_[masque_zero] # leurs clusters assignes par KMeans# TODO etudiant : trouver le cluster le plus frequent parmi clusters_zerocluster_dominant_zero =None# TODO etudiant : remplacer (np.bincount(clusters_zero).argmax())print(f"Exercice 3 a completer : le chiffre 0 tombe surtout dans le cluster {cluster_dominant_zero}")
Exercice 3 a completer : le chiffre 0 tombe surtout dans le cluster None
Vérification 2 — ce que sont les composantes
question("Que sont les composantes principales ?", choix=["Un sous-ensemble des variables d'origine, les plus importantes","Des combinaisons linéaires de toutes les variables, orthogonales entre elles : une rotation, pas une sélection","Les variables les plus corrélées à la cible", ], bonne="B", explication="L'ACP ne choisit pas des variables : elle change de base. Chaque composante mélange toutes les colonnes d'origine, et le signe d'une composante est arbitraire — c'est ce que montre la reconstruction de cette section.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — Que sont les composantes principales ?

  A. Un sous-ensemble des variables d'origine, les plus importantes
  B. Des combinaisons linéaires de toutes les variables, orthogonales entre elles : une rotation, pas une sélection
  C. Les variables les plus corrélées à la cible

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
6. Reconstruire une image à partir de la PCA
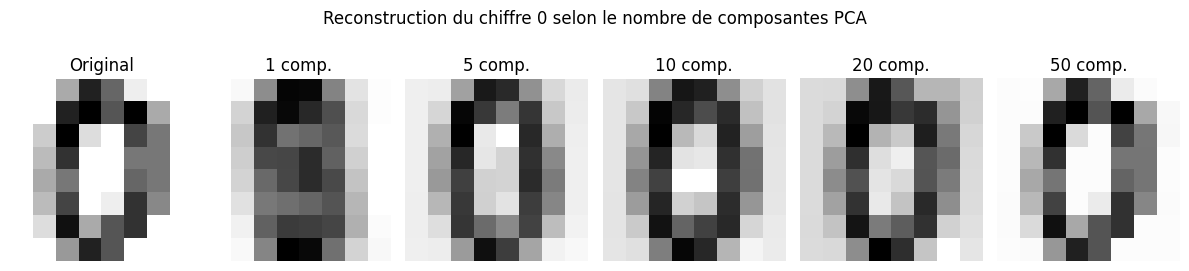
La PCA est aussi une compression : projeter sur k composantes puis inverse-transformer reconstruit une approximation de l’original. Moins de composantes = plus de compression et plus de flou. Cette section illustre visuellement le compromis entre réduction de dimension et perte d’information.
# Reconstruction d'un chiffre a partir d'un nombre croissant de composantes PCAimage_originale = digits.images[0]fig, axes = plt.subplots(1, 6, figsize=(12, 3))axes[0].imshow(image_originale, cmap='gray_r')axes[0].set_title("Original")axes[0].axis('off')for i, n inenumerate([1, 5, 10, 20, 50]): p = PCA(n_components=n) proj = p.fit_transform(X) recon = p.inverse_transform(proj) axes[i +1].imshow(recon[0].reshape(8, 8), cmap='gray_r') axes[i +1].set_title(f"{n} comp.") axes[i +1].axis('off')plt.suptitle("Reconstruction du chiffre 0 selon le nombre de composantes PCA")plt.tight_layout()plt.show()print("Plus on garde de composantes, plus l'image reconstruite devient nette.")
Plus on garde de composantes, plus l'image reconstruite devient nette.
7. Au-delà de l’ACP : t-SNE et UMAP (réduction non linéaire)
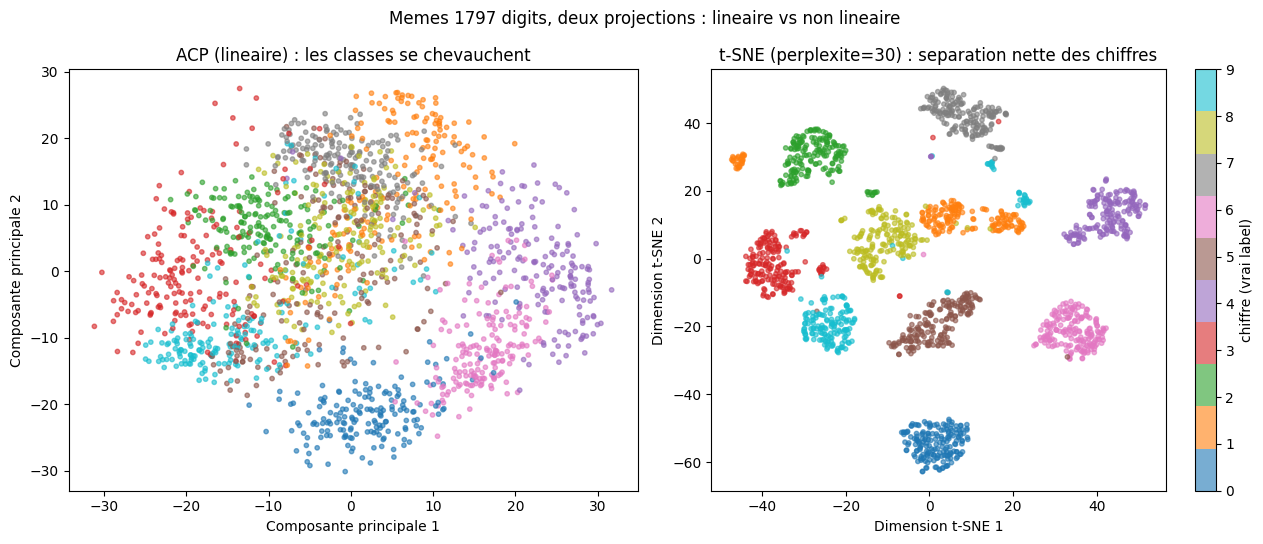
La projection ACP de la section 4 est linéaire : chaque composante est une combinaison linéaire des 64 pixels. C’est une limite structurelle — deux chiffres peuvent être proches dans l’espace pixel tout en étant séparés par une variation non linéaire (la boucle d’un 8, la barre d’un 7), et aucun plan de projection linéaire ne peut les découper proprement. Le résultat s’est vu sur la figure : les classes de chiffres se chevauchent.
t-SNE (t-distributed Stochastic Neighbor Embedding, van der Maaten & Hinton 2008) attaque le problème différemment : au lieu de chercher des axes, il construit une projection 2D qui préserve les voisinages — deux points proches en dimension 64 doivent rester proches en 2D (et réciproquement), en mesurant la « proximité » par des probabilités gaussiennes côté haute dimension et une loi de Student côté basse dimension, puis en minimisant la divergence de Kullback-Leibler entre les deux distributions. La projection obtenue est non linéaire par construction.
Référence. van der Maaten, L. & Hinton, G. (2008), Visualizing Data using t-SNE, Journal of Machine Learning Research 9:2579-2605.
# t-SNE sur les memes digits, cote a cote avec la projection ACPimport timefrom sklearn.manifold import TSNEX_pca_2d = PCA(n_components=2).fit_transform(X)t0 = time.perf_counter()tsne = TSNE(n_components=2, perplexity=30, random_state=42, init='pca')X_tsne = tsne.fit_transform(X)duree_tsne = time.perf_counter() - t0fig, axes = plt.subplots(1, 2, figsize=(13, 5.5))scatter0 = axes[0].scatter(X_pca_2d[:, 0], X_pca_2d[:, 1], c=y, cmap='tab10', s=10, alpha=0.6)axes[0].set_title("ACP (lineaire) : les classes se chevauchent")axes[0].set_xlabel("Composante principale 1")axes[0].set_ylabel("Composante principale 2")scatter1 = axes[1].scatter(X_tsne[:, 0], X_tsne[:, 1], c=y, cmap='tab10', s=10, alpha=0.6)axes[1].set_title(f"t-SNE (perplexite=30) : separation nette des chiffres")axes[1].set_xlabel("Dimension t-SNE 1")axes[1].set_ylabel("Dimension t-SNE 2")fig.colorbar(scatter1, ax=axes[1], label="chiffre (vrai label)")plt.suptitle("Memes 1797 digits, deux projections : lineaire vs non lineaire")plt.tight_layout()plt.show()print(f"t-SNE sur {X.shape[0]} digits x {X.shape[1]} dimensions : {duree_tsne:.1f} s")print("La ou l'ACP melange les classes, le t-SNE les separe visuellement presque") print("parfaitement - c'est ce que 'non lineaire' achete en visualisation.")
t-SNE sur 1797 digits x 64 dimensions : 3.1 s
La ou l'ACP melange les classes, le t-SNE les separe visuellement presque
parfaitement - c'est ce que 'non lineaire' achete en visualisation.
Lecture du résultat — ce que la séparation veut dire, et ce qu’elle ne veut PAS dire
La figure de droite montre ~10 îlots quasi purs, un par chiffre — le contraste avec l’ACP à gauche est la démonstration visuelle de ce que « non linéaire » apporte. Mais deux garde-fous essentiels avant d’interpréter une carte t-SNE :
Les distances ENTRE clusters et les tailles relatives des clusters ne sont PAS interprétables. t-SNE préserve les voisinages locaux, pas les distances globales : deux îlots éloignés sur la carte ne sont pas forcément plus dissemblables que deux îlots proches, et un gros îlot n’est pas forcément une classe plus dispersée dans l’espace original. Seule la cohérence interne d’un groupe (les points d’une même couleur regroupés) est un vrai signal.
Le temps est super-linéaire et l’objet n’a pas de transform : chaque nouveau jeu de données impose de refaire l’embedding entier. C’est un outil d’exploration, pas une étape de pipeline — le guide de choix en fin de section formalise cette frontière.
L’effet de la perplexité : le paramètre qui change la carte
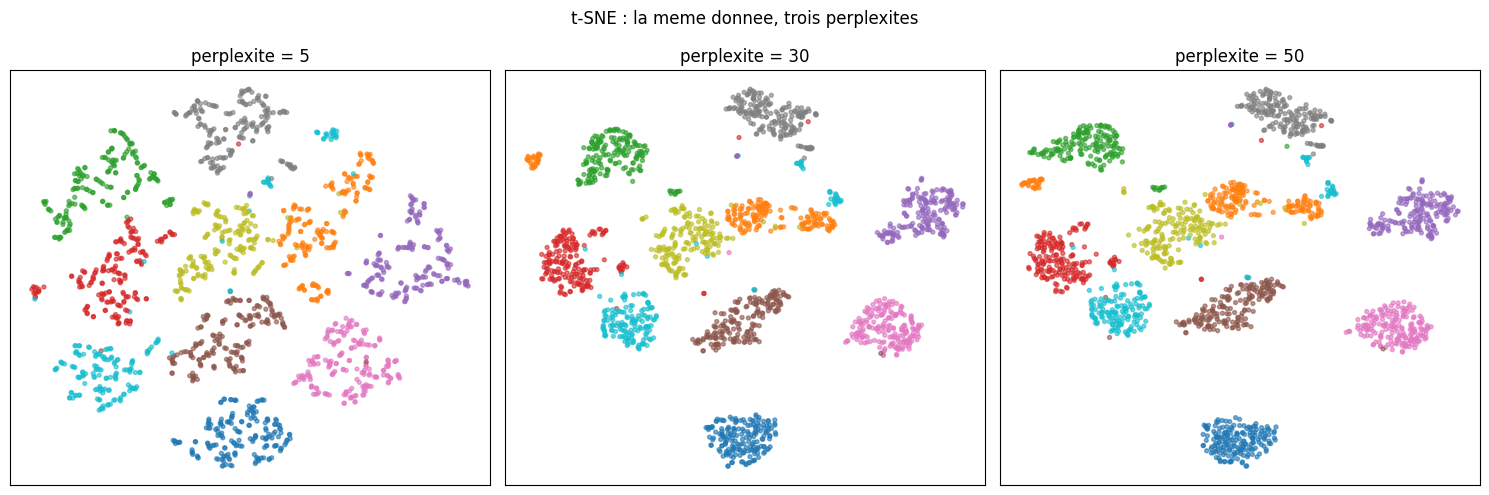
La perplexité est le nombre de voisins « effectifs » que t-SNE considère pour chaque point (l’écart-type des Gaussiennes locales s’ajuste pour que chaque point ait ce nombre de voisins perceptibles). Elle n’a pas de valeur universelle — van der Maaten & Hinton la recommandent entre 5 et 50 — et changer la perplexité change la carte. La cellule suivante le montre au lieu de l’affirmer : trois valeurs sur les mêmes données.
# Effet de la perplexite : trois valeurs sur les memes digitsfig, axes = plt.subplots(1, 3, figsize=(15, 5))for ax, perp inzip(axes, [5, 30, 50]): emb = TSNE(n_components=2, perplexity=perp, random_state=42, init='pca').fit_transform(X) ax.scatter(emb[:, 0], emb[:, 1], c=y, cmap='tab10', s=8, alpha=0.6) ax.set_title(f"perplexite = {perp}") ax.set_xticks([]); ax.set_yticks([])plt.suptitle("t-SNE : la meme donnee, trois perplexites")plt.tight_layout()plt.show()print("Perplexite 5 : tres locale - les groupes se fragmentent en petits ilots.")print("Perplexite 30 : equilibre - dix groupes coherents (valeur par defaut de sklearn).")print("Perplexite 50 : plus globale - les groupes s'elargissent et se rapprochent.")
Perplexite 5  : tres locale - les groupes se fragmentent en petits ilots.
Perplexite 30 : equilibre - dix groupes coherents (valeur par defaut de sklearn).
Perplexite 50 : plus globale - les groupes s'elargissent et se rapprochent.
Lecture du résultat — une sensibilité à connaître avant de publier une carte
Les trois cartes montrent la même donnée, mais pas la même histoire : à perplexité 5 la structure se fragmente (chaque îlot ne « voit » que ses 5 voisins les plus proches — des micro-groupes apparaissent qui ne sont pas des classes), à 30 les dix chiffres forment des groupes compacts, à 50 les groupes s’étalent et se rapprochent. Aucune de ces trois cartes n’est « fausse » : la perplexité est un choix d’échelle d’analyse, comme le choix d’une bande passante en estimation de densité. En pratique : essayer plusieurs valeurs, et se méfier d’une conclusion qui n’est stable que pour une seule perplexité.
UMAP : la structure globale mieux conservée
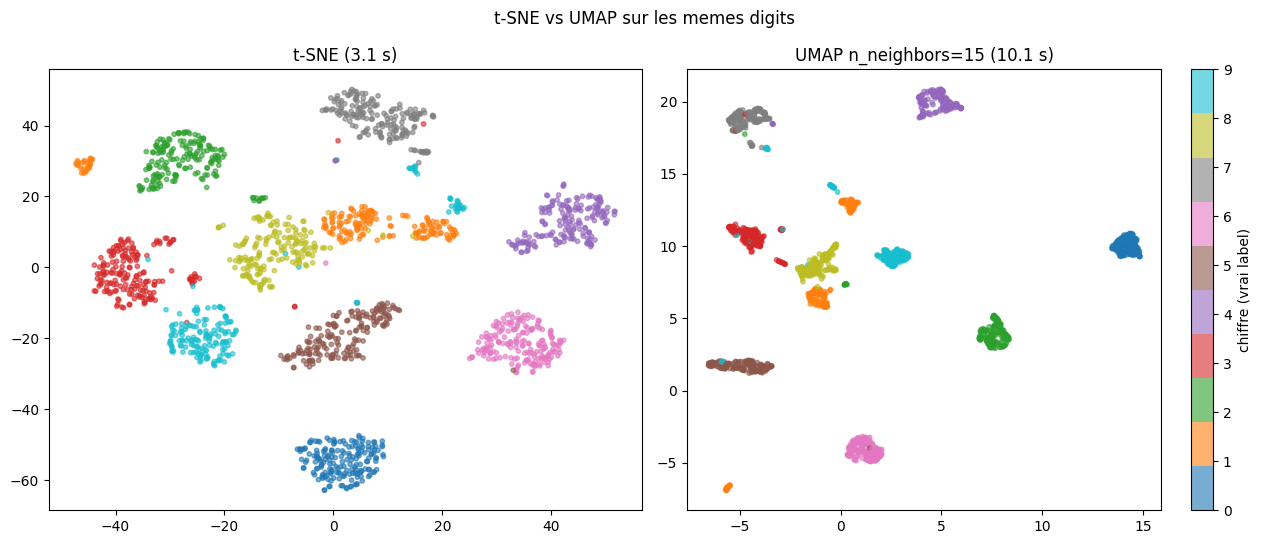
UMAP (Uniform Manifold Approximation and Projection, McInnes, Healy & Melville 2018) poursuit le même objectif que t-SNE (préserver les voisinages en 2D) avec deux différences pratiques : son coût passe mieux à l’échelle (graphe de voisinage + optimisation SGD — sur les grands jeux de données il devient nettement plus rapide que t-SNE, dont le coût est super-linéaire ; en revanche, sur un petit jeu comme celui-ci, la première exécution paie la compilation JIT de numba et peut sortir plus lente que t-SNE, comme la cellule ci-dessous le mesure), et il conserve mieux la structure globale — les groupes restent disposés de façon cohérente avec leur similarité d’ensemble, là où t-SNE disperse les îlots arbitrairement. Ses paramètres : n_neighbors (l’équivalent de la perplexité — la taille du voisinage) et min_dist (la distance minimale tolérée entre points projetés).
Dépendance.umap-learn est optionnel (pip install umap-learn) ; la cellule contient une garde d’import — sans la librairie, le notebook poursuit avec un message explicite.
# UMAP sur les memes digits, compare au t-SNEtry:import umap UMAP_DISPONIBLE =TrueexceptImportError: UMAP_DISPONIBLE =Falseif UMAP_DISPONIBLE: t0 = time.perf_counter() reducer = umap.UMAP(n_neighbors=15, min_dist=0.1, n_components=2, random_state=42) X_umap = reducer.fit_transform(X) duree_umap = time.perf_counter() - t0 fig, axes = plt.subplots(1, 2, figsize=(13, 5.5)) axes[0].scatter(X_tsne[:, 0], X_tsne[:, 1], c=y, cmap='tab10', s=10, alpha=0.6) axes[0].set_title(f"t-SNE ({duree_tsne:.1f} s)") scatter = axes[1].scatter(X_umap[:, 0], X_umap[:, 1], c=y, cmap='tab10', s=10, alpha=0.6) axes[1].set_title(f"UMAP n_neighbors=15 ({duree_umap:.1f} s)") fig.colorbar(scatter, ax=axes[1], label="chiffre (vrai label)") plt.suptitle("t-SNE vs UMAP sur les memes digits") plt.tight_layout() plt.show()print(f"Durees sur {X.shape[0]} digits : t-SNE {duree_tsne:.1f} s vs UMAP {duree_umap:.1f} s")print("Les dix groupes sont nets dans les deux cas ; UMAP conserve en outre")print("une disposition globale coherente (groupes semblables plus proches).")else:print("umap-learn n'est pas installe : pip install umap-learn")print("La suite du notebook ne depend pas de cette cellule.")
Durees sur 1797 digits : t-SNE 3.1 s vs UMAP 10.1 s
Les dix groupes sont nets dans les deux cas ; UMAP conserve en outre
une disposition globale coherente (groupes semblables plus proches).
Lecture : UMAP face à t-SNE
Sur la comparaison à trois panneaux, UMAP sépare les dix groupes et préserve leur arrangement relatif — les clusters voisins en UMAP sont grosso modo voisins dans la donnée, là où t-SNE optimise les voisinages locaux sans garantie sur les distances entre groupes. Ce « respect de la structure globale » est la principale différence pratique entre les deux moteurs. Le warning affiché n’est pas une erreur : en fixant random_state, on demande une carte reproductible au prix du parallélisme (n_jobs ramené à 1) — un arbitrage assumé en pédagogie, à lever si la vitesse devient le critère. Enfin UMAP est typiquement plus rapide à taille égale, ce qui le rend plausible sur des jeux plus grands que ces 1797 points.
Guide de choix : quelle réduction pour quel objectif ?
Objectif
Méthode
Pourquoi
Limitations à connaître
Compresser / débruiter (section 6)
ACP
Projection optimale en variance ; inverse_transform reconstruit une approximation
Linéaire — perd les variations non linéaires
Visualiser / explorer (cette section)
t-SNE / UMAP
Séparent des classes que l’ACP chevauche
Distances inter-clusters non interprétables (t-SNE) ; perplexité/n_neighbors change la carte ; coût super-linéaire (t-SNE)
Réduire AVANT un modèle (pipeline aval)
ACP
transform s’applique à de nouvelles données — indispensable en production
t-SNE n’a pas de transform propre : il faut refaire l’embedding entier à chaque nouveau point
La règle pratique tient en une ligne : l’ACP est une transformation, t-SNE/UMAP sont des visualisations. On met la première dans un pipeline, les secondes dans un notebook d’exploration. Pour la lecture des espaces latents (autoencodeurs, VAE, embeddings RAG), ce contraste sera le réflexe à réutiliser.
Exercice 4 : le t-SNE vu par KMeans
Les deux moitiés de ce notebook ne se sont encore jamais croisées : X_tsne (la projection t-SNE) a toujours été colorée par le vrai chiffre y. Refaites la visualisation en colorant par le cluster KMeans (kmeans.labels_, section 2) — si le clustering a bien retrouvé la structure des chiffres, les îlots doivent rester homogènes, à une permutation de couleurs près.
Étapes 1. Tracez le scatter de X_tsne coloré par kmeans.labels_ (même modèle d’appel que les figures ci-dessus : plt.scatter(X_tsne[:, 0], X_tsne[:, 1], c=kmeans.labels_, cmap='tab10', s=10, alpha=0.6)). 2. Comparez avec la figure colorée par y : combien d’îlots mélangés voyez-vous ?
# Exercice 4 : colorier la projection t-SNE par cluster KMeans# X_tsne : projection 2D de chaque image (calculee plus haut)# kmeans.labels_ : cluster (0-9) assigne a chaque image par KMeans (section 2)# Etape 1 : plt.scatter(X_tsne[:, 0], X_tsne[:, 1], c=kmeans.labels_, cmap='tab10', s=10, alpha=0.6)# Etape 2 : comparer avec la figure coloree par le vrai chiffre yilots_melanges =None# TODO etudiant : combien d'ilots melangez-vous avec la couleur KMeans ?print(f"Exercice 4 a completer : {ilots_melanges} ilot(s) melange(s) avec la couleur KMeans")
Exercice 4 a completer : None ilot(s) melange(s) avec la couleur KMeans
Vérification 3 — lire une carte t-SNE
question("Deux amas nettement séparés apparaissent sur une carte t-SNE. Que peut-on en dire ?", choix=["Que la distance entre les amas est une distance dans l'espace d'origine","Que seule la structure de voisinage est exploitable : la distance entre amas n'est pas interprétable, et la carte change avec la perplexité","Que les amas sont les vraies classes du jeu de données", ], bonne="B", explication="t-SNE et UMAP préservent le voisinage local, pas les distances globales : deux amas écartés sur la carte peuvent être proches dans les données. La carte sert à voir, pas à mesurer — et la perplexité en déplace les frontières.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — Deux amas nettement séparés apparaissent sur une carte t-SNE. Que peut-on en dire ?

  A. Que la distance entre les amas est une distance dans l'espace d'origine
  B. Que seule la structure de voisinage est exploitable : la distance entre amas n'est pas interprétable, et la carte change avec la perplexité
  C. Que les amas sont les vraies classes du jeu de données

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
8. Au-delà de KMeans : quand un cluster n’est pas une « boule »
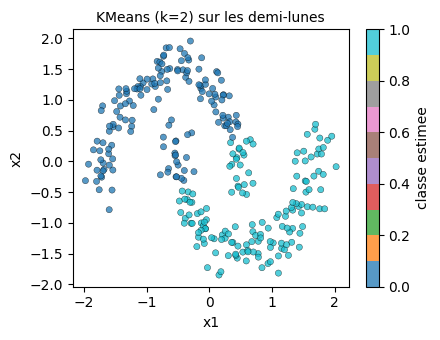
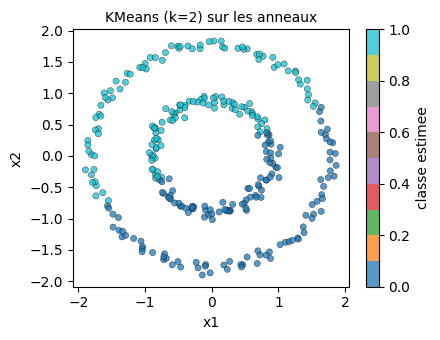
Les sections 2-3 ont clusterisé des chiffres avec KMeans : il y a fonctionné, car chaque chiffre forme une masse à peu près compacte. KMeans découpe l’espace avec des frontières de Voronoï (chaque point rejoint le centroïde le plus proche) : il produit donc toujours des clusters convexes, en « boules ». Dès qu’un groupe authentique ne ressemble pas à une boule — deux croissants imbriqués, deux anneaux concentriques — KMeans le coupe en deux morceaux pourtant arbitraires.
Cette section construit deux jeux de données synthétiques où la forme compte, regarde ce que KMeans en fait, puis introduit deux familles qui suivent la forme : DBSCAN (densité) et le clustering hiérarchique (dendrogramme).
# Deux formes non convexes : des demi-lunes imbriquees et deux anneaux concentriquesfrom sklearn.datasets import make_moons, make_circlesfrom sklearn.metrics import adjusted_rand_score # 1 = accord parfait avec les vraies classes, 0 = hasardfrom sklearn.preprocessing import StandardScalerdef scatter_2d(X, labels, title, cmap='tab10'): plt.figure(figsize=(4.5, 3.5)) plt.scatter(X[:, 0], X[:, 1], c=labels, cmap=cmap, s=20, alpha=0.75, edgecolors='k', linewidths=0.3) plt.title(title, fontsize=10) plt.xlabel("x1"); plt.ylabel("x2") plt.colorbar(label="classe estimee") plt.tight_layout() plt.show()# StandardScaler : DBSCAN et le hierarchique mesurent des DISTANCES -> l'echelle change toutX_moons, y_moons = make_moons(n_samples=300, noise=0.10, random_state=42)X_rings, y_rings = make_circles(n_samples=300, factor=0.5, noise=0.03, random_state=42)X_moons = StandardScaler().fit_transform(X_moons)X_rings = StandardScaler().fit_transform(X_rings)# KMeans force k=2 : il ne peut que decouper en deux "boules" a frontiere droitekm_moons = KMeans(n_clusters=2, n_init=10, random_state=42).fit(X_moons)km_rings = KMeans(n_clusters=2, n_init=10, random_state=42).fit(X_rings)scatter_2d(X_moons, km_moons.labels_, "KMeans (k=2) sur les demi-lunes")scatter_2d(X_rings, km_rings.labels_, "KMeans (k=2) sur les anneaux")print(f"ARI KMeans — demi-lunes : {adjusted_rand_score(y_moons, km_moons.labels_):.2f}")print(f"ARI KMeans — anneaux : {adjusted_rand_score(y_rings, km_rings.labels_):.2f}")
ARI KMeans — demi-lunes : 0.48
ARI KMeans — anneaux   : -0.00
Lecture du résultat — pourquoi KMeans échoue ici
Un ARI de 0.48 sur les demi-lunes et ~0 sur les anneaux veut dire que KMeans ne reproduit pas les deux groupes réels. Sur les demi-lunes, il apparie la moitié de chaque croissant : le haut-gauche de l’un finit dans le même cluster que le haut-gauche de l’autre (0.48, très loin du 1.0 qu’un clustering correct donnerait). Sur les anneaux, il assigne un « coin » du cercle extérieur à un cluster et le reste à l’autre. C’est un échec structurel : la frontière de Voronoï est toujours droite, donc le cluster est toujours convexe, et ces deux jeux ne le sont pas.
Ce n’est pas une mauvaise exécution, c’est l’hypothèse du modèle. Pour suivre une forme, il faut un algorithme qui raisonne en distance locale (qui est près de qui) plutôt qu’en distance au centroïde (qui est près du centre).
9. DBSCAN : le clustering par densité
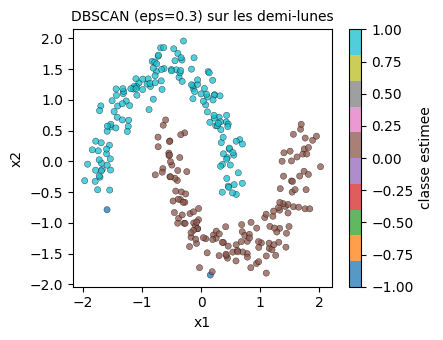
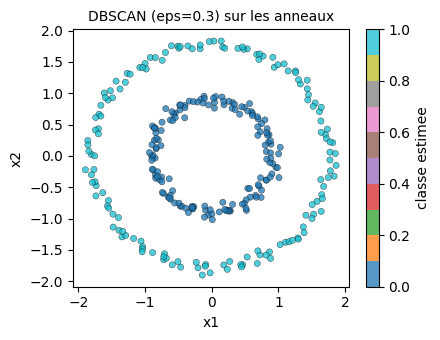
DBSCAN (Density-Based Spatial Clustering of Applications with Noise) ne fixe pas de nombre de clusters : il part d’un point « noyau » (au moins min_samples voisins dans un rayon eps) et étend le cluster aux points atteignables. Deux conséquences :
il détecte des formes arbitraires, pas seulement des boules ;
il ne force aucunk — mais il introduit un hyperparamètre eps (le rayon) à régler, et il peut laisser des points non assignés (label = -1), traités comme du bruit/outlier.
# DBSCAN est sensible a eps : trop petit -> fragmenté, trop grand -> tout fusionnefrom sklearn.cluster import DBSCANfor eps in [0.2, 0.3, 0.4]: db = DBSCAN(eps=eps, min_samples=5).fit(X_moons) ncl =len(set(db.labels_)) - (1if-1in db.labels_ else0)print(f" Demi-lunes eps={eps:.1f} : ARI={adjusted_rand_score(y_moons, db.labels_):.2f} clusters={ncl} outliers={int((db.labels_==-1).sum())}")db_moons = DBSCAN(eps=0.3, min_samples=5).fit(X_moons)db_rings = DBSCAN(eps=0.3, min_samples=5).fit(X_rings)scatter_2d(X_moons, db_moons.labels_, "DBSCAN (eps=0.3) sur les demi-lunes")scatter_2d(X_rings, db_rings.labels_, "DBSCAN (eps=0.3) sur les anneaux")print(f"ARI DBSCAN — demi-lunes : {adjusted_rand_score(y_moons, db_moons.labels_):.2f} (outliers={int((db_moons.labels_==-1).sum())})")print(f"ARI DBSCAN — anneaux : {adjusted_rand_score(y_rings, db_rings.labels_):.2f} (outliers={int((db_rings.labels_==-1).sum())})")
ARI DBSCAN — demi-lunes : 0.99  (outliers=2)
ARI DBSCAN — anneaux   : 1.00  (outliers=0)
Lecture du résultat — densité, eps et outliers
À eps=0.3, DBSCAN retrouve les deux formes (ARI ≈ 1) : chaque croissant, chaque anneau devient un cluster qui épouse la forme. Le balayage eps montre le mécanisme : trop petit, le cluster se fragmente et une partie des points devient -1 (outliers) ; trop grand, tout se fond en un seul cluster (ARI 0). On n’a pas à choisir k, mais on a remplacé k par eps — le réglage reste, c’est juste un paramètre différent, plus attaché à l’échelle des données (d’où le StandardScaler du début).
Le label = -1 est un avantage d’honnêteté : là où KMeans assigne tout le monde, DBSCAN avoue qu’un point est du bruit s’il n’est dense près de rien.
Exercice 5 : trouver le rayon eps qui fait la balance
La réussite de DBSCAN dépend du rayon eps. Fais-le varier sur les demi-lunes et observe l’ARI, le nombre de clusters et le nombre d’outliers. Trouve le eps qui sépare les deux croissants sans les fragmenter.
# Exercice 5 : trouver le rayon eps qui separe les deux demi-lunes sans les fragmenter# Etape 1 : faire varier eps et observer ARI / nombre de clusters / outliers# Etape 2 : retenir le eps qui maximise l'ARI sans outliers qui noient la structurebon_eps =None# TODO etudiant : le rayon qui fait la balanceprint(f"Exercice 5 a completer : bon eps = {bon_eps}")
Exercice 5 a completer : bon eps = None
10. Le clustering hiérarchique et le dendrogramme
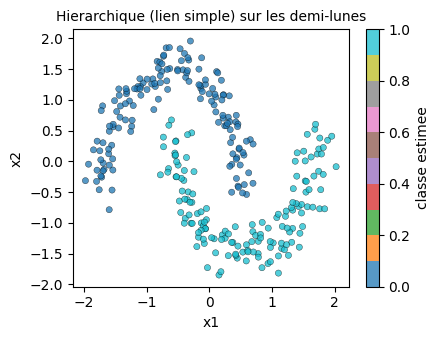
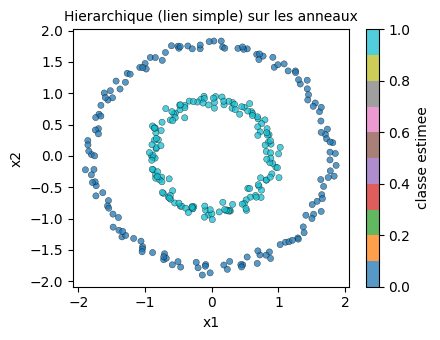
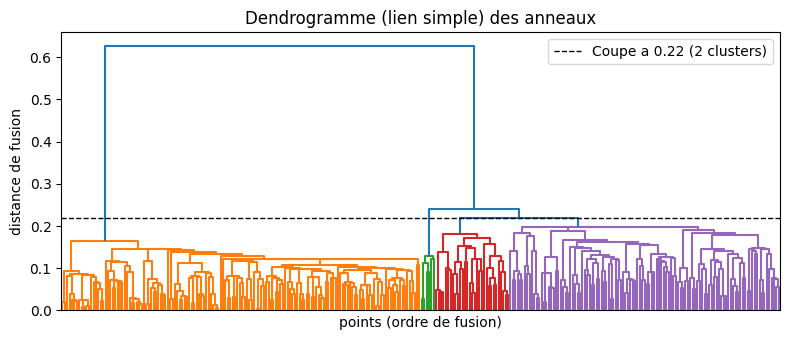
Le clustering hiérarchique agglomératif construit une hiérarchie : on part de chaque point isolé et on fusionne les deux groupes les plus proches, jusqu’à un seul. Le résultat est un dendrogramme (arbre de fusion), que l’on découpe à la hauteur donnant le bon nombre de clusters. Le choix du lien (distance entre deux groupes) change tout :
lien simple (single) : la distance la plus courte entre les deux groupes — suit les formes allongées, mais « enchaîne » des points via un pont ;
lien complet (complete) : la distance la plus longue — produit des groupes compacts, mais rate les formes allongées.
# Lien simple vs lien complet : le lien choisi change le resultatfrom sklearn.cluster import AgglomerativeClusteringfrom scipy.cluster.hierarchy import dendrogram, linkagefor link in ["single", "complete"]: a = AgglomerativeClustering(n_clusters=2, linkage=link).fit(X_rings)print(f" Anneaux lien={link:10s} : ARI={adjusted_rand_score(y_rings, a.labels_):.2f}")ag_moons = AgglomerativeClustering(n_clusters=2, linkage="single").fit(X_moons)ag_rings = AgglomerativeClustering(n_clusters=2, linkage="single").fit(X_rings)scatter_2d(X_moons, ag_moons.labels_, "Hierarchique (lien simple) sur les demi-lunes")scatter_2d(X_rings, ag_rings.labels_, "Hierarchique (lien simple) sur les anneaux")# Le dendrogramme des anneaux : la hauteur de fusion dit ou couper pour 2 clustersZ = linkage(X_rings, method="single")thr = Z[-3, 2] # distance de fusion du 3e plus grand saut = coupe pour obtenir 2 clustersplt.figure(figsize=(8, 3.5))dendrogram(Z, no_labels=True, color_threshold=thr)plt.axhline(thr, color="k", ls="--", lw=1, label=f"Coupe a {thr:.2f} (2 clusters)")plt.title("Dendrogramme (lien simple) des anneaux")plt.xlabel("points (ordre de fusion)"); plt.ylabel("distance de fusion")plt.legend(); plt.tight_layout(); plt.show()print(f"ARI hierarchique lien simple — demi-lunes : {adjusted_rand_score(y_moons, ag_moons.labels_):.2f}")print(f"ARI hierarchique lien simple — anneaux : {adjusted_rand_score(y_rings, ag_rings.labels_):.2f}")
ARI hierarchique lien simple — demi-lunes : 1.00
ARI hierarchique lien simple — anneaux   : 1.00
Lecture du résultat — chaining, coupe et choix du lien
Le dendrogramme se lit de bas en haut : les deux anneaux forment chacun une grande branche, puis tout fusionne en un seul groupe au sommet. Couper à la hauteur du 3ᵉ plus grand saut donne exactement 2 clusters, et le lien simple retrouve les deux anneaux (ARI = 1). Le lien complet les rate : il exige que les deux groupes soient proches en tous points (distance la plus longue), or chaque anneau est un cercle creux dont les points les plus éloignés sont à l’opposé l’un de l’autre.
C’est le compromis du lien : le lien simple enchaîne (chaining) et suit les formes courbes, mais se laisse piéger par un pont de points ; le lien complet ou moyen produit des groupes plus compacts, mais ne suit pas les formes concaves. Il n’y a pas de choix gratuit — c’est le sens du guide qui suit.
Exercice 6 : lien simple ou lien complet sur les demi-lunes ?
Compare l’ARI des deux liens sur X_moons. Lequel suit les deux croissants ? Explique pourquoi l’autre échoue.
# Exercice 6 : meilleur lien pour les demi-lunes# Etape 1 : comparer l'ARI de "single" et "complete" sur X_moons# Etape 2 : expliquer pourquoi l'un suit les croissants et pas l'autremeilleur_lien =None# TODO etudiant : "single" ou "complete" ?print(f"Exercice 6 a completer : meilleur lien = {meilleur_lien}")
Exercice 6 a completer : meilleur lien = None
11. Guide de choix : quel algorithme pour quelle forme ?
Algorithme
Hypothèse implicite
Formes qu’il suit
À connaître
Résultat ici (demi-lunes / anneaux)
KMeans
clusters convexes, isotropes, tailles comparables
« boules »
il faut fixer k ; frontières droites ; assigne tout le monde
0.48 / 0.00
DBSCAN
densité locale : zones denses séparées par du vide
formes arbitraires
il faut régler eps (+min_samples) ; -1 = outlier ; fragilité à eps
0.99 / 1.00
Hiérarchique
aucune forme imposée a priori
ce que le lien autorise
choix du lien ; dendrogramme = inspection à une hauteur
lien simple : 1.00 / 1.00
Le réflexe. Avant tout clustering à base de distance (DBSCAN, hiérarchique, et même KMeans), standardiser les variables — sinon le réglage d’eps ou la distance dépendent de l’unité de chaque axe. Et quand un groupe ne ressemble visiblement pas à une boule, ne pas « tordre » KMeans : changer de modèle.
Exercice 7 : quel algorithme dans quel cas ?
Associe chaque description à la famille la plus adaptée (KMeans, DBSCAN ou hiérarchique) et justifie en une ligne.
# Exercice 7 : quel algorithme pour quelle forme ?# (a) une base clients : 3 masses homogenes et bien separees -> ?# (b) une carte de taches spatiales : des ilots denses et du bruit -> ?choix_a =None# TODO etudiant : "KMeans", "DBSCAN" ou "hierarchique" ?choix_b =None# TODO etudiant : idemprint(f"Exercice 7 a completer : (a) {choix_a}, (b) {choix_b}")
Exercice 7 a completer : (a) None, (b) None
Synthèse : supervisé vs non supervisé
Le supervisé (notebooks 2.1 à 2.5) dispose d’étiquettes et apprend à prédire. Le non supervisé (ce notebook) n’a pas d’étiquettes et trouve de la structure (clusters) ou compresse (PCA). En pratique, ces approches se combinent souvent : on peut appliquer une PCA avant un clustering, ou avant un modèle supervisé pour accélérer l’apprentissage et réduire le surajustement.
Référence. Hastie, T., Tibshirani, R. & Friedman, J. (2009), The Elements of Statistical Learning, Springer (2e éd.), §14.3, 14.5. — Synthèse du clustering et de la réduction de dimension dans le cadre de l’apprentissage statistique.
Après le parcours — question de transfert
question("Vous cherchez des groupes en forme de croissants, non sphériques. Quel outil choisir ?", choix=["KMeans, avec un k plus grand","DBSCAN ou le lien simple du clustering hiérarchique","L'ACP, qui sépare les croissants par ses composantes", ], bonne="B", explication="KMeans découpe l'espace en régions autour de centres : il coupe les croissants. Les méthodes de densité et le lien simple suivent la forme des groupes — c'est ce que montre la comparaison de cette section.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="apres",)
Transfert — Vous cherchez des groupes en forme de croissants, non sphériques. Quel outil choisir ?

  A. KMeans, avec un k plus grand
  B. DBSCAN ou le lien simple du clustering hiérarchique
  C. L'ACP, qui sépare les croissants par ses composantes

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
Conclusion : fin du socle ML
Vous avez parcouru les six premiers notebooks de la série 02-ML-Cours : (2.1) le workflow ML, (2.2) la descente de gradient, (2.3) la régression linéaire et logistique, (2.4) les arbres / forêts / ensembles, (2.5) le compromis biais-variance / validation croisée / courbes ROC, et (2.6) le clustering, l’ACP et la réduction non linéaire de visualisation (t-SNE, UMAP). Un étudiant ayant travaillé ces six notebooks dispose du socle ML canonique qui manquait entre NumPy/Pandas et les ateliers agents. La série se poursuit avec 2.7 (modèles non paramétriques), 2.8 (théorie PAC) et 2.9 (grokking).
References
MacQueen, J. (1967). Some Methods for Classification and Analysis of Multivariate Observations. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability 1:281-297. — La méthode des k-moyennes, partitionnement par minimisation de l’inertie intra-cluster.
Pearson, K. (1901). On Lines and Planes of Closest Fit to Systems of Points in Space. Philosophical Magazine 2(11):559-572. — Article fondateur de l’Analyse en Composantes Principales (axes de variance maximale).
Jolliffe, I.T. (2002). Principal Component Analysis. Springer (2e éd.). — Référence sur l’ACP : variance expliquée, choix du nombre de composantes.
van der Maaten, L. & Hinton, G. (2008). Visualizing Data using t-SNE. Journal of Machine Learning Research 9:2579-2605. — t-SNE : embedding non linéaire préservant les voisinages, rôle de la perplexité.
McInnes, L., Healy, J. & Melville, J. (2018). UMAP: Uniform Manifold Approximation and Projection for Dimension Reduction. arXiv:1802.03426. — UMAP : graphe de voisinage, rapidité et conservation de la structure globale.
Hastie, T., Tibshirani, R. & Friedman, J. (2009). The Elements of Statistical Learning. Springer (2e éd.), §14.3, 14.5. — Clustering et réduction de dimension.
Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12:2825-2830. — KMeans, PCA, TSNE, load_digits.
Deisenroth, M.P., Faisal, A.A. & Ong, C.S. (2020). Mathematics for Machine Learning. Cambridge UP. — ch. 10 (Dimensionality Reduction) pose l’analyse en composantes principales (décomposition en valeurs singulières, variance expliquée cumulée) que ce carnet implémente en PCA.fit_transform. Le lien avec K-means est aussi abordé comme cas particulier de décomposition spectrale (ch. 10.3).