Le notebook 2.8 a posé la question théorique de la généralisation : combien d’exemples faut-il pour garantir qu’un apprenant qui minimise l’erreur d’entraînement minimise aussi l’erreur de test ? La réponse classique (PAC, dimension VC) suppose un tableau rassurant : l’erreur d’entraînement descend, l’erreur de test la suit à un écart borné, et cet écart se referme quand on ajoute des données. Le surapprentissage est le seul danger — un modèle qui mémorise sans généraliser.
Ce notebook présente un phénomène qui dérange ce tableau : le grokking (Power et al. 2022). Un petit réseau de neurones apprend une opération arithmétique. Il atteint très vite 100 % sur l’entraînement (mémorisation parfaite) tandis que le test reste au niveau du hasard — le manuel dirait « surapprentissage, cause perdue ». Puis, après une longue phase où plus rien ne semble bouger, la précision de test bascule soudain vers 100 %. Le réseau a fini par comprendre la règle, très longtemps après l’avoir mémorisée.
C’est aussi le premier réseau de neurones de cette série — et son épilogue : là où les huit chapitres précédents posaient le socle scikit-learn, celui-ci franchit le pas vers le deep learning. Il prolonge directement la descente de gradient du 2.2 et la notion de capacité du 2.8, en réutilisant l’ACP du 2.6 pour la révélation finale.
Rôle dans la série. Ce notebook est l’amorce : la démonstration boîte noire sous PyTorch. Le traitement canonique et détaillé des phénomènes de généralisation — le même montage réécrit en NumPy pur (gradient à la main), un contre-témoin qui isole le weight-decay, puis la double descente — est le 3.5 — Phénomènes de généralisation de la série Deep Learning.
Référence. Power, A., Burda, Y., Edwards, H., Babuschkin, I. & Misra, V. (2022). Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets. arXiv:2201.02177. — L’article qui nomme et caractérise le phénomène.
# Configuration et imports pour le notebook 2.9import timeimport numpy as npimport torchimport torch.nn as nnimport torch.nn.functional as Fimport matplotlib.pyplot as pltfrom sklearn.decomposition import PCA%matplotlib inline# Reproductibilitetorch.manual_seed(0)np.random.seed(0)RNG = np.random.default_rng(0)# Hyperparametres canoniques du grokking (Power et al. 2022)P =97# modulo (nombre premier) : la tache est (a + b) mod PD_EMBED =64# dimension des embeddings apprisHIDDEN =256# largeur des couches cacheesTRAIN_FRAC =0.4# fraction des couples (a, b) montres a l'entrainementLR =1e-3# taux d'apprentissage (AdamW)WEIGHT_DECAY =1.0# LE LEVIER : regularisation forte qui declenche le grokSTEPS =12000# pas d'optimisation (full-batch)print(f"Imports OK : torch {torch.__version__}, sklearn PCA, matplotlib")print(f"Tache : (a + b) mod {P} | embeddings {D_EMBED}D | weight_decay = {WEIGHT_DECAY}")
Imports OK : torch 2.11.0+cpu, sklearn PCA, matplotlib
Tache : (a + b) mod 97 | embeddings 64D | weight_decay = 1.0
1. Le montage — addition modulaire et un premier réseau à embeddings
On choisit une tâche algorithmique minuscule mais qui possède une vraie règle à découvrir : l’addition modulaire(a + b) mod P pour un nombre premier P. Il n’y a que P² couples possibles ; on n’en montre au réseau qu’une fraction (ici 40 %), le reste servant de test. Mémoriser les couples vus ne dit rien des couples non vus — sauf si le réseau découvre la règle sous-jacente.
Le modèle est un perceptron multicouche (MLP) précédé d’une couche d’embedding : chaque nombre 0..P-1 est représenté par un vecteur appris (comme un mot dans un modèle de langage). Les embeddings de a et b sont concaténés puis passés dans deux couches cachées. C’est le montage de la référence pédagogique francophone de David Louapre (Science Étonnante).
Le levier décisif — le weight-decay. L’ingrédient qui déclenche le grokking est la régularisation weight_decay de l’optimiseur AdamW. Fixée à 1.0 (une valeur élevée, canonique — Power et al. §3.3), elle pousse continûment le réseau vers une solution plus simple : c’est cette compression lente qui finit par faire émerger la règle générale. Avec un weight-decay trop faible, le réseau mémorise et ne grokke jamais (l’exercice 1 le vérifie).
# Jeu de donnees : tous les couples (a, b) et leur somme modulairepairs = torch.cartesian_prod(torch.arange(P), torch.arange(P))labels = (pairs[:, 0] + pairs[:, 1]) % Pn_total = pairs.shape[0]perm = RNG.permutation(n_total)n_train =int(TRAIN_FRAC * n_total)idx_tr = torch.as_tensor(perm[:n_train])idx_te = torch.as_tensor(perm[n_train:])a_tr, b_tr, y_tr = pairs[idx_tr, 0], pairs[idx_tr, 1], labels[idx_tr]a_te, b_te, y_te = pairs[idx_te, 0], pairs[idx_te, 1], labels[idx_te]class GrokMLP(nn.Module):"""MLP a embeddings : chaque nombre 0..P-1 recoit un vecteur appris, concatene pour (a, b), puis passe dans deux couches cachees."""def__init__(self, p, d, h):super().__init__()self.emb = nn.Embedding(p, d)self.net = nn.Sequential( nn.Linear(2* d, h), nn.ReLU(), nn.Linear(h, h), nn.ReLU(), nn.Linear(h, p), )def forward(self, a, b): x = torch.cat([self.emb(a), self.emb(b)], dim=1)returnself.net(x)model = GrokMLP(P, D_EMBED, HIDDEN)optimizer = torch.optim.AdamW(model.parameters(), lr=LR, weight_decay=WEIGHT_DECAY)n_params =sum(param.numel() for param in model.parameters())print(f"Modele : {n_params} parametres")print(f"Donnees : {n_train} couples d'entrainement / {n_total - n_train} couples de test")
Modele : 129953 parametres
Donnees : 3763 couples d'entrainement / 5646 couples de test
2. La démonstration — mémorisation, longue attente, puis grok
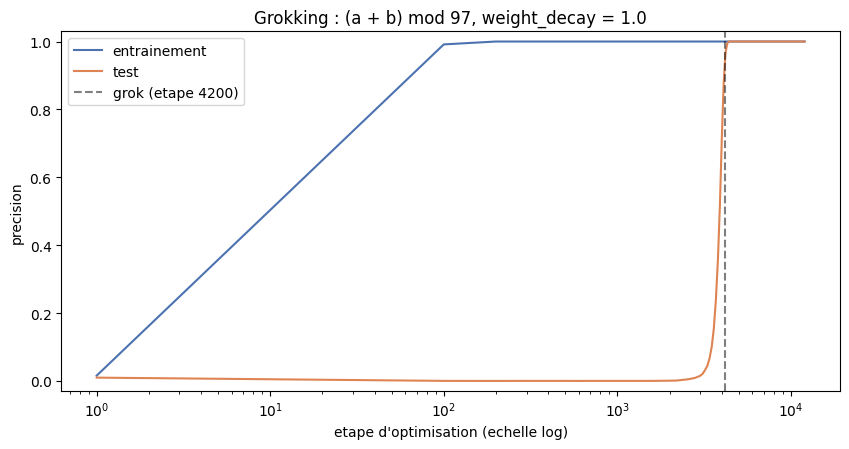
On entraîne le réseau en journalisant, tous les 100 pas, la précision d’entraînement et de test. Le scénario attendu : (1) l’entraînement grimpe vite à ~100 % ; (2) le test stagne longtemps au niveau du hasard (~1/P) ; (3) après une phase plate, le test bascule vers ~100 %. On repère le grok point comme le premier instant où le test dépasse 90 % alors que l’entraînement est déjà saturé.
@torch.no_grad()def accuracy(a, b, y): model.eval() acc = (model(a, b).argmax(-1) == y).float().mean().item() model.train()return acchistorique = [] # liste de (step, acc_train, acc_test)t0 = time.time()for step inrange(1, STEPS +1): logits = model(a_tr, b_tr) loss = F.cross_entropy(logits, y_tr) optimizer.zero_grad() loss.backward() optimizer.step()if step %100==0or step ==1: historique.append((step, accuracy(a_tr, b_tr, y_tr), accuracy(a_te, b_te, y_te)))# Detection du grok : premier pas ou le test depasse 90 % alors que le train est saturegrok_step =next((s for s, at, av in historique if at >=0.95and av >=0.9), None)acc_test_final = historique[-1][2]print(f"Entrainement termine en {time.time() - t0:.0f}s | precision de test finale {acc_test_final:.3f}")print(f"Grok point (test > 0.90 apres saturation du train) : etape {grok_step}")
Entrainement termine en 188s | precision de test finale 1.000
Grok point (test > 0.90 apres saturation du train) : etape 4200
Interprétation : deux régimes séparés dans le temps
Les deux régimes se lisent dans les nombres ci-dessus. L’entraînement sature à 1.0 en quelques centaines de pas — le réseau a mémorisé les couples vus. Le test, lui, reste d’abord près du hasard, puis grimpe bien plus tard vers 1.0. L’écart entraînement/test — le surapprentissage du manuel — est ici transitoire : il finit par se refermer, non pas en ajoutant des données, mais en continuant d’optimiser un modèle déjà parfait sur l’entraînement.
steps = [h[0] for h in historique]acc_tr = [h[1] for h in historique]acc_te = [h[2] for h in historique]plt.figure(figsize=(8.6, 4.6))plt.plot(steps, acc_tr, "-", color="#4c72b0", label="entrainement")plt.plot(steps, acc_te, "-", color="#dd8452", label="test")if grok_step: plt.axvline(grok_step, color="k", ls="--", alpha=0.5, label=f"grok (etape {grok_step})")plt.xscale("log")plt.xlabel("etape d'optimisation (echelle log)")plt.ylabel("precision")plt.ylim(-0.03, 1.03)plt.title(f"Grokking : (a + b) mod {P}, weight_decay = {WEIGHT_DECAY}")plt.legend()plt.tight_layout()plt.show()
Interprétation du graphique
La courbe rend le grokking spectaculaire : sur l’axe des pas en échelle logarithmique, la précision de test forme une marche nette, décalée de plusieurs ordres de grandeur après la saturation de l’entraînement. Rien dans la perte d’entraînement (déjà quasi nulle) n’annonce ce basculement — le signal est ailleurs, dans la structure interne que le réseau réorganise silencieusement. C’est cette structure qu’on va maintenant regarder.
3. Le payoff — l’horloge cachée dans les embeddings
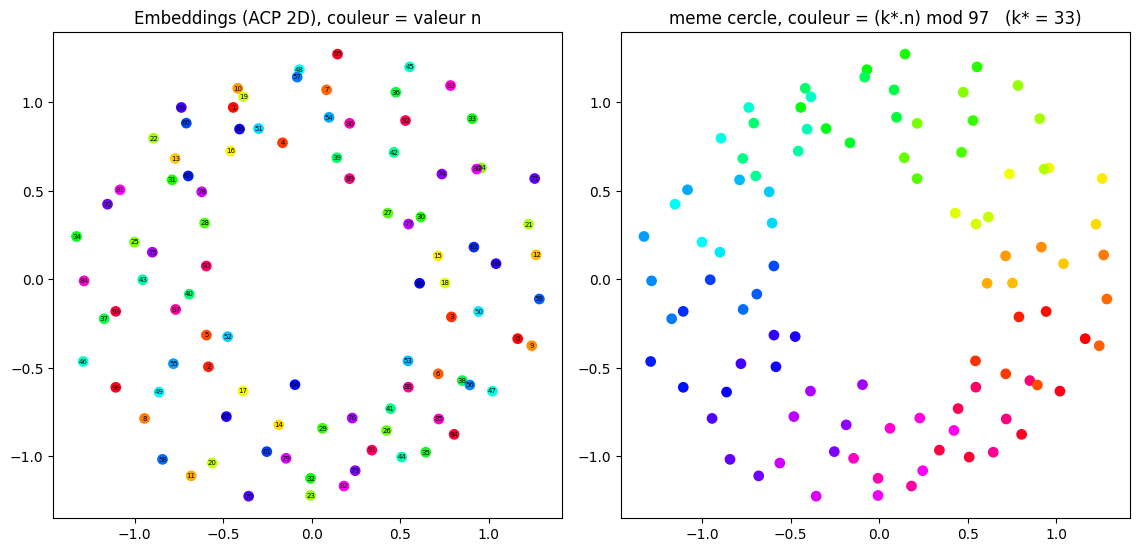
Qu’a appris le réseau au moment du grok ? La réponse est visuelle. On prend la matrice d’embedding (un vecteur appris par nombre 0..P-1) et on la projette en 2D par ACP — le même outil qu’au notebook 2.6. Après le grok, les nombres ne sont plus dispersés au hasard : ils s’effondrent sur un cercle. Le réseau a découvert que, pour additionner modulo P, le plus économique est de placer les nombres sur une horloge et d’additionner des angles (comme 11 h + 3 h = 2 h).
Une subtilité, énoncée honnêtement : l’ordre autour du cercle ne suit pas la valeur brute 0, 1, 2, …. Le réseau organise les nombres selon un petit nombre de fréquences de Fourier qu’il a lui-même choisies (Nanda et al. 2023 en observent typiquement une poignée) ; la plus forte, k*, suffit déjà à révéler le cercle — il avance d’un pas constant k* à chaque cran. Le panneau de droite colore les points par cette position d’horloge (k*·n) mod P : le dégradé redevient régulier, révélant l’ordre caché. L’exercice 3 débusque ces fréquences par transformée de Fourier.
Référence. Nanda, N., Chan, L., Lieberum, T., Smith, J. & Steinhardt, J. (2023). Progress Measures for Grokking via Mechanistic Interpretability. arXiv:2301.05217. — Identifie le circuit de Fourier que le réseau construit au grok.
# Embeddings appris (un vecteur par nombre 0..P-1), centresE = model.emb.weight.detach().numpy()E = E - E.mean(axis=0, keepdims=True)# Frequence de Fourier dominante : le reseau range les nombres sur un cercle a une# "vitesse angulaire" k* (transformee de Fourier sur l'axe des chiffres).spectre = (np.abs(np.fft.fft(E, axis=0)) **2).sum(axis=1)spectre[0] =0.0# ignorer la composante continue (moyenne deja retiree)k_star =int(np.argmax(spectre[1:P //2+1])) +1part_variance = spectre[k_star] *2/ spectre.sum()position_horloge = (k_star * np.arange(P)) % P# Projection ACP 2D (le meme outil qu'au notebook 2.6)coords = PCA(n_components=2).fit_transform(E)fig, axes = plt.subplots(1, 2, figsize=(11.5, 5.6))axes[0].scatter(coords[:, 0], coords[:, 1], c=np.arange(P), cmap="hsv", s=45)for i inrange(P): axes[0].annotate(str(i), coords[i], fontsize=5, ha="center", va="center")axes[0].set_title("Embeddings (ACP 2D), couleur = valeur n")axes[0].set_aspect("equal")axes[1].scatter(coords[:, 0], coords[:, 1], c=position_horloge, cmap="hsv", s=45)axes[1].set_title(f"meme cercle, couleur = (k*.n) mod {P} (k* = {k_star})")axes[1].set_aspect("equal")fig.tight_layout()plt.show()demi_spectre = spectre[1:P //2+1]principales = np.argsort(demi_spectre)[::-1][:4] +1print(f"Frequence dominante k* = {k_star} (part de variance {part_variance:.0%})")print("Frequences principales (k : part de variance) :", [(int(k), f"{spectre[k] *2/ spectre.sum():.0%}") for k in principales])
Frequence dominante k* = 33 (part de variance 25%)
Frequences principales (k : part de variance) : [(33, '25%'), (41, '24%'), (30, '20%'), (6, '19%')]
Interprétation : un cercle, ordonné par une fréquence
Les embeddings de dimension 64, projetés en 2D par ACP, dessinent ici un anneau ; le spectre imprimé au-dessus révèle plusieurs fréquences de Fourier de poids comparables. À gauche, coloré par valeur brute, l’ordre paraît brouillé ; à droite, coloré par (k*·n) mod P, le dégradé devient plus régulier. La géométrie est compatible avec une représentation périodique de l’addition modulaire, au-delà du seul score train/test.
Lecture critique. La couleur du panneau de droite est calculée à partir de k*, lui-même choisi sur ces embeddings : elle aide à lire le motif, mais ne valide pas indépendamment le circuit. L’ACP peut aussi masquer la structure hors du plan affiché. Le notebook ne mesure ni l’effet d’une intervention sur les composantes de Fourier dans le calcul de model(a, b), ni la fidélité d’un circuit de remplacement ; il ne démontre donc pas que le réseau additionne effectivement par cette horloge. Pour le tester, comparer la précision sur les couples de test après ablation ciblée d’une composante de Fourier et après une ablation témoin de même énergie, puis vérifier si un circuit de remplacement prédit les sorties du modèle. La prédiction test déjà mesurée ici est une première voie de validation, pas une preuve causale du mécanisme.
4. Retour sur la théorie (2.8) — pourquoi ce n’est pas une contradiction
Le grokking semble défier la théorie PAC du 2.8 : le réseau généralise longtemps après avoir minimisé l’erreur d’entraînement, et sans donnée supplémentaire. La conciliation tient en un mot : capacité effective. La borne VC majore l’écart entraînement/test à partir de la richesse de la classe d’hypothèses H — mais sous weight_decay, le réseau ne parcourt pas tout H : il migre continûment vers les fonctions de faible norme, donc plus simples. La solution mémorisée (une grosse table de correspondance) et la solution générale (l’horloge, de norme bien plus faible) ont la même erreur d’entraînement — nulle — mais des complexités très différentes ; l’optimisation régularisée passe de l’une à l’autre.
Le grokking n’est donc pas une violation de la théorie, mais une illustration de la régularisation implicite : ce n’est pas le nombre d’exemples qui change, c’est la capacité effectivement utilisée qui décroît — une lecture dynamique du compromis biais-variance du 2.5.
Référence. Liu, Z., Kitouni, O., Nolte, N., Michaud, E., Tegmark, M. & Williams, M. (2022). Towards Understanding Grokking: An Effective Theory of Representation Learning. arXiv:2205.10343. — Relie le grokking à la géométrie des représentations et au rôle du weight-decay.
5. Exercices
Les exercices ci-dessous sont des stubs à compléter. Ils conservent les conventions de la série : aucune erreur volontaire (le notebook s’exécute de bout en bout même non complété), avec indices et # Etape N.
Ils sont propres à cette amorce : le montage PyTorch et l’horloge des embeddings. Les deux leviers classiques du grokking — le weight-decay (déplacer le moment du grok) et le seuil de données (la transition de phase) — s’exercent dans le traitement canonique 3.5 (ses Exercices 1 et 2), où le montage est réouvert à la main : pas de double emploi.
Exercice 1 — Quantifier l’horloge
L’horloge se lit à l’œil ; mesurez-la. Après le grok, calculez pour chaque nombre n son angleθ_n sur le cercle ACP (atan2(y_n, x_n)), puis vérifiez que θ_n est (à une rotation près) une fonction affine de (k*·n) mod P — et non de la valeur brute n. Indice : np.fft.fft sur les embeddings (variable spectre déjà calculée) révèle la ou les fréquences dominantes ; ici, un petit nombre de pics de poids comparable (cf. la liste imprimée plus haut) organise une horloge quasi propre.
# Exercice 1 : quantifier l'horloge# TODO etudiant : verifier que l'ordre angulaire des embeddings suit bien une# frequence unique k*, et non la valeur brute n.# Etape 1 : calculer l'angle theta_n = atan2(y_n, x_n) sur l'anneau ACP (coords)# Etape 2 : tracer theta_n contre n (disperse) puis contre (k*.n mod P) (aligne)# Indice : np.fft.fft sur les embeddings (deja calcule : variable 'spectre')# revele la ou les frequences dominantes. Ici un petit nombre de pics de poids comparable.angles =None# TODO etudiant : remplacer par np.arctan2(coords[:, 1], coords[:, 0])print("Exercice 1 a completer")
Exercice 1 a completer
Exercice 2 — Le modulus P : plus petit, plus vite ?
La tâche est (a + b) mod P avec P = 97. La taille du modulus fixe celle du problème (P² couples) et le nombre de classes. Relancez le montage (les cellules de la section 1 et 2) pour P dans {31, 59, 97} — mêmes TRAIN_FRAC, WEIGHT_DECAY, STEPS — et notez pour chaque valeur le pas où le test bascule. Indice : moins de classes, mémorisation plus courte à saturer — mais le grok a-t-il besoin d’autant de pas ? Et P = 91 = 7 × 13 (non premier) vous dira si la primalité est une exigence du montage ou une convention de l’article.
# Exercice 2 : le modulus P — plus petit, plus vite ?# TODO etudiant : relancer le montage pour P dans {31, 59, 97} (meme TRAIN_FRAC,# WEIGHT_DECAY, STEPS) et noter le pas de bascule du test pour chaque valeur.# Etape 1 : re-creer couples/labels/modele pour chaque valeur de P# Etape 2 : entrainer et relever grok_step (le pas ou acc_test depasse 50 %)# Indice : tester aussi P = 91 = 7 x 13 pour trancher la primalite.grok_par_P =None# TODO etudiant : remplacer par {p: grok_step}print("Exercice 2 a completer")
Exercice 2 a completer
Exercice 3 — La dimension d’embedding : quelle largeur pour l’horloge ?
L’horloge vit dans des embeddings de dimension D_EMBED = 64 — pourtant une fréquence unique k* n’a besoin que de deux nombres (cosinus, sinus). Balayez D_EMBED dans {4, 8, 16, 64} et observez (i) le grok arrive-t-il quand même, (ii) l’anneau ACP de la section 3 reste-t-il lisible. Indice : une dimension trop étroite bride la capacité à mémoriser ; une large n’est pas nécessaire pour coder une fréquence. Reliez ce constat au compromis capacité/généralisation du 2.8.
# Exercice 3 : la dimension d'embedding — quelle largeur pour l'horloge ?# TODO etudiant : relancer le montage pour D_EMBED dans {4, 8, 16, 64} et observer# (i) si le grok arrive, (ii) si l'anneau ACP des embeddings reste lisible.# Etape 1 : re-creer le modele avec un d_embed variable (reutiliser GrokMLP)# Etape 2 : apres le grok, refaire l'ACP des embeddings (section 3) et verifier l'anneau# Indice : une frequence unique n'a besoin que de 2 dimensions (cos, sin).horloge_par_demb =None# TODO etudiant : remplacer par {d: (grok_step, anneau_lisible)}print("Exercice 3 a completer")
Exercice 3 a completer
Conclusion et transition
Le grokking donne à voir, sur un jouet exécutable en quelques minutes, trois idées que le reste de la série n’abordait qu’en partie. La généralisation n’est pas un événement instantané : elle peut arriver très en retard sur la mémorisation. La capacité effective d’un réseau peut évoluer pendant l’optimisation, ce que les seules courbes train/test ne suffisent pas à expliquer. Et ce qu’un réseau apprend a une forme : ici, une périodicité visible dans les embeddings projetés, dans l’esprit de l’ACP du 2.6. Le rôle causal du weight-decay et celui du circuit de Fourier ne sont pas isolés par ces figures : le contre-témoin du 3.5 traite le premier ; une intervention ciblée resterait nécessaire pour le second.
Un organisme modèle, pas une preuve universelle. L’addition modulaire sert de terrain contrôlé pour confronter une hypothèse mécaniste à un résultat connu. La lecture de Nanda et al. (2023) situe ce petit transformer de référence parmi les model organisms de l’interprétabilité mécaniste ; le MLP PyTorch de ce notebook est un montage pédagogique distinct, qui n’en reproduit ni l’architecture ni les interventions. Pour passer d’un motif visuel à une explication éprouvée, quatre voies se complètent : prédire des sorties sur des couples tenus à l’écart (mesuré ici, sans discriminer deux circuits de même précision) ; construire des pièces de remplacement et comparer leurs sorties à celles du modèle (non fait ici) ; confronter l’analyse à un modèle à circuit connu, tel que Tracr (non fait ici) ; répliquer les interventions sur d’autres organismes modèles contrôlés, dont le transformer modulaire (non fait ici). Ce sont des tests à mener, et non des validations déjà acquises par l’ACP.
La série ferme ici son socle scikit-learn en montrant le premier pas au-delà. Le traitement canonique de la généralisation — le montage réouvert en NumPy pur, un contre-témoin qui isole le weight-decay, puis la double descente — attend dans la série Deep Learning : 3.5 — Phénomènes de généralisation. La critique des métriques de parcimonie d’un autre outil, les autoencodeurs parcimonieux, est traitée séparément dans ICT-21 — SAE : l’anneau d’embeddings de ce MLP n’est pas une mesure de sparsity, de MDL ou de feature splitting.
References
Power, A., Burda, Y., Edwards, H., Babuschkin, I. & Misra, V. (2022). Grokking: Generalization Beyond Overfitting on Small Algorithmic Datasets. arXiv:2201.02177. — Article fondateur : nomme le phénomène et établit le rôle du weight-decay (wd = 1) dans le déclenchement du grok.
Nanda, N., Chan, L., Lieberum, T., Smith, J. & Steinhardt, J. (2023). Progress Measures for Grokking via Mechanistic Interpretability. arXiv:2301.05217. — Le circuit trigonométrique (features de Fourier) étudié dans un transformer modulaire, distinct du MLP exécuté ici.
Liu, Z., Kitouni, O., Nolte, N., Michaud, E., Tegmark, M. & Williams, M. (2022). Towards Understanding Grokking: An Effective Theory of Representation Learning. arXiv:2205.10343. — Théorie effective reliant grokking, géométrie des représentations et weight-decay.
Louapre, D. (2023). « Grokking » : quand les réseaux de neurones pigent d’un coup. Science Étonnante. — Référence pédagogique francophone : le montage MLP à embeddings et l’horloge ACP repris ici.
Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12:2825-2830. — L’ACP (sklearn.decomposition.PCA) utilisée pour révéler l’horloge.
Sharkey, L. et al. (2025). Open Problems in Mechanistic Interpretability. arXiv:2501.16496, §1–2.2. — Limites épistémiques de la lecture d’une représentation et voies de validation des hypothèses mécanistes.