Ce notebook couvre les deux familles de régression canoniques en machine learning. La régression linéaire prédit un nombre continu (un prix, une température) et est ajustée par la méthode des moindres carrés (OLS). La régression logistique prédit une probabilité pour une classe binaire (spam / non-spam) et est ajustée par le maximum de vraisemblance (MLE). Les deux sont des modèles linéaires, mais ils répondent à des tâches différentes et utilisent des métriques différentes.
Objectifs d’apprentissage
À la fin de ce notebook, vous saurez : 1. Ajuster une régression linéaire et lire le coefficient de détermination R² ainsi que les résidus. 2. Ajuster une régression logistique, comprendre la fonction sigmoid et le seuil de décision. 3. Contraster les deux principes d’estimation : OLS (moindres carrés) vs MLE (maximum de vraisemblance). 4. Interpréter les coefficients de chaque modèle (pente vs odds ratio).
Prérequis
Notebook 2.1 (métriques d’évaluation).
Notebook 2.2 (descente de gradient).
Notion de base en probabilités.
Référence. Nelder, J.A. & Wedderburn, R.W.M. (1972), Generalized Linear Models, Journal of the Royal Statistical Society. Series A 135(3):370-384. Ce cadre unifie régression linéaire (gaussienne) et logistique (binomiale) comme modèles linéaires généralisés, chacun avec sa fonction de lien et son estimation.
# Configuration : imports et graine aleatoireimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom sklearn.datasets import make_regression, make_classificationfrom sklearn.linear_model import LinearRegression, LogisticRegressionfrom sklearn.model_selection import train_test_splitfrom sklearn.metrics import r2_score, mean_squared_error# Graine pour la reproductibilitenp.random.seed(42)print("Configuration OK : 2.3 - Regression lineaire et logistique")
Configuration OK : 2.3 - Regression lineaire et logistique
Auto-évaluation
Ce carnet porte un dispositif d’auto-évaluation formatif : quatre questions, placées avant le parcours (diagnostic de prérequis), au milieu (vérification de la notion) et à la fin (transfert). Aucune note n’est stockée, aucune réponse n’est enregistrée.
Chaque cellule de question s’exécute sans erreur tant que vous n’avez pas répondu ; la correction s’affiche uniquement lorsque vous remplacez reponse=None par la lettre de votre choix, puis ré-exécutez la cellule.
# Dispositif d'auto-evaluation de la serie (module partage, issue #18207)import pathlibimport sysfor _racine in (pathlib.Path.cwd(), *pathlib.Path.cwd().parents):if (_racine /"MyIA.AI.Notebooks").is_dir(): sys.path.insert(0, str(_racine /"MyIA.AI.Notebooks"/"ML"/"DataScienceWithAgents"))breakfrom auto_evaluation import question # noqa: E402
Avant de commencer — question de diagnostic
question("Une régression linéaire affiche un R² de 0,92 sur les données qui ont servi à l'ajuster. Qu'est-ce que cela prouve ?", choix=["Que le modèle prédira aussi bien sur de nouvelles données","Que les valeurs ajustées restituent 92 % de la variance observée sur ces données-là","Que les coefficients mesurent des effets causaux", ], bonne="B", explication="Le R² est une mesure interne au jeu ajusté. Il ne dit rien de la performance hors échantillon, ni du caractère causal des coefficients : ce sont deux questions différentes, que ce carnet traite séparément.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="avant",)
Diagnostic de prérequis — Une régression linéaire affiche un R² de 0,92 sur les données qui ont servi à l'ajuster. Qu'est-ce que cela prouve ?

  A. Que le modèle prédira aussi bien sur de nouvelles données
  B. Que les valeurs ajustées restituent 92 % de la variance observée sur ces données-là
  C. Que les coefficients mesurent des effets causaux

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
1. Régression linéaire : prédire une valeur continue
La régression linéaire modélise la cible continue \(y\) comme une combinaison linéaire des variables explicatives :
La qualité de l’ajustement se mesure par le coefficient de détermination R² : la proportion de la variance de \(y\) expliquée par le modèle (entre 0 et 1, 1 étant parfait).
# Generation de donnees de regression (3 variables explicatives, bruit modere)X, y = make_regression(n_samples=200, n_features=3, noise=25.0, bias=5.0, random_state=42)# Separation en jeu d'entrainement et de test (80/20)X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)# Ajustement du modele de regression lineaire par moindres carres (OLS)modele_lineaire = LinearRegression().fit(X_train, y_train)# Prediction sur le jeu de testy_pred = modele_lineaire.predict(X_test)# Affichage des coefficients et de la qualite (R^2)print("Coefficients (pentes) :", modele_lineaire.coef_)print("Ordonnee a l'origine (biais) :", modele_lineaire.intercept_)print("R^2 sur le jeu de test :", r2_score(y_test, y_pred))
Coefficients (pentes) : [71.71064149 21.96838218 72.87345924]
Ordonnee a l'origine (biais) : 3.408876242728427
R^2 sur le jeu de test : 0.9117475179470665
Lecture du premier ajustement
Les trois pentes estimées — 71,7 (x0), 22,0 (x1), 72,9 (x2) — contre une ordonnée à l’origine de 3,41 : le modèle a récupéré des effets très inégaux, x0 et x2 portant chacun plus de trois fois le poids de x1. Le R² = 0,912 sur le jeu de test dit que 91,2 % de la variance de la cible est expliquée par ces trois variables — le reste (8,8 %) est le bruit injecté à la génération, qu’aucun modèle ne peut rattraper : viser un R² de 1,0 sur ces données reviendrait à apprendre le bruit. À retenir dès maintenant : ce R² élevé ne dit rien de la validité des coefficients — la section 3bis montrera que multicollinéarité, résidus et points influents doivent passer avant toute interprétation.
2. R² et résidus
Le R² se lit ainsi : - R² = 1 : ajustement parfait. - R² = 0 : le modèle ne fait pas mieux que prédire systématiquement la moyenne de \(y\). - R² < 0 : le modèle est pire que la moyenne (modèle mal spécifié).
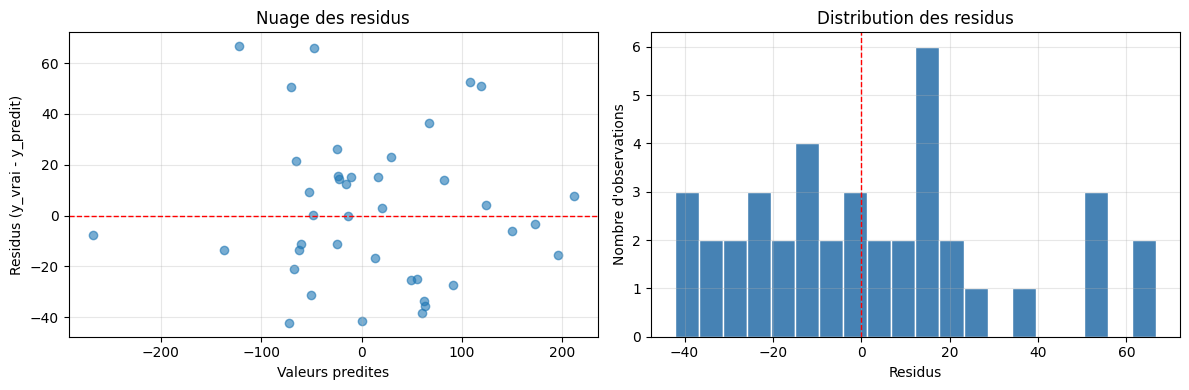
Les résidus sont les erreurs \(e_i = y_i^{vrai} - y_i^{predit}\). Pour un bon modèle linéaire, les résidus sont centrés sur zéro et ne présentent aucune structure visible (ni courbe, ni entonnoir). Un motif dans les résidus (par exemple une forme en U) indique que le modèle passe à côté d’une relation non linéaire.
# Calcul des residus sur le jeu de testresidus = y_test - y_pred# Figure : nuage des residus + histogrammefig, axes = plt.subplots(1, 2, figsize=(12, 4))# Nuage : valeurs predites vs residus (doit etre centre sur 0, sans structure)axes[0].scatter(y_pred, residus, alpha=0.6)axes[0].axhline(0, color="red", linestyle="--", linewidth=1)axes[0].set_xlabel("Valeurs predites")axes[0].set_ylabel("Residus (y_vrai - y_predit)")axes[0].set_title("Nuage des residus")axes[0].grid(alpha=0.3)# Histogramme : doit etre centre sur 0, approximativement symetriqueaxes[1].hist(residus, bins=20, color="steelblue", edgecolor="white")axes[1].axvline(0, color="red", linestyle="--", linewidth=1)axes[1].set_xlabel("Residus")axes[1].set_ylabel("Nombre d'observations")axes[1].set_title("Distribution des residus")axes[1].grid(alpha=0.3)plt.tight_layout()plt.show()# A lire : residus centres sur 0, pas de courbe ni d'entonnoir visible.
Lecture du graphe des résidus
Le diagramme se lit comme un test de structure : les résidus (écarts verticaux entre points et droite) doivent flotter sans motif autour de zéro. Un nuage en entonnoir (variance croissante), une courbure systématique ou un point isolé à forte amplitude sont autant de signaux que le modèle linéaire rate quelque chose — hétéroscédasticité, relation non linéaire, valeur atypique. Le panneau de droite (distribution des résidus) complète : à peu près symétrique et centrée, elle est compatible avec l’hypothèse d’erreurs gaussiennes qui fonde les intervalles de confiance d’OLS. Ces graphes coûtent trois lignes de code et répondent à des questions qu’aucun R² ne pose.
Exercice 1 : calculer et interpréter R² à la main
Objectif : calculer le coefficient de détermination R² directement à partir de sa définition, puis le comparer à la valeur renvoyée par r2_score de scikit-learn.
où \(\bar{y}\) est la moyenne des valeurs observées sur le jeu de test.
Indice : - SS_res se calcule avec np.sum((y_test - y_pred)**2). - Pour SS_tot, remplacez y_pred par la moyenne np.mean(y_test).
# Exercice 1 : calculer R^2 a la main (1 - SS_res / SS_tot)# TODO etudiant : calculer SS_res et SS_tot sur le jeu de testSS_res =None# TODO etudiant : remplacer (somme des carres des residus)SS_tot =None# TODO etudiant : remplacer (somme des ecarts a la moyenne)r2_manuel =None# TODO etudiant : remplacer (1 - SS_res / SS_tot)print(f"Exercice 1 a completer : R^2 manuel = {r2_manuel}")
Exercice 1 a completer : R^2 manuel = None
3. Interpréter les coefficients
Chaque coefficient \(w_j\) mesure de combien varie \(y\) lorsque la variable \(x_j\)augmente d’une unité, toutes les autres variables étant maintenues constantes : - le signe indique le sens (positif ou négatif) ; - la magnitude indique l’ampleur de l’effet.
Attention : la magnitude dépend de l’échelle de la variable. Pour comparer l’importance relative de plusieurs variables, il faut les standardiser (même échelle) au préalable, sinon une variable exprimée en milliers paraîtra artificiellement plus influente qu’une variable exprimée en unités.
# Tableau des coefficients tries par valeur absolue decroissantecoefs_df = pd.DataFrame({"variable": [f"x{j}"for j inrange(X.shape[1])],"coefficient": modele_lineaire.coef_,})coefs_df["valeur_absolue"] = coefs_df["coefficient"].abs()coefs_df = coefs_df.sort_values("valeur_absolue", ascending=False).reset_index(drop=True)print(coefs_df[["variable", "coefficient"]])# Interpretation : la variable en tete a le plus grand impact (en valeur absolue)# sur la cible y, une unite supplementaire de cette variable modifie y d'environ# la valeur de son coefficient.
Le tri par valeur absolue donne la hiérarchie des effets : x2 (72,87) > x0 (71,71) > x1 (21,97) — un rapport de 3,3 entre extrêmes. Chaque coefficient se lit comme l’effet moyen sur la cible d’une augmentation d’une unité de la variable, les autres étant tenues constantes : « toutes choses égales par ailleurs ». C’est ce pluriel qui est fragile : la section 3bis.1 montrera que si deux variables bougent ensemble (corrélation de 0,99), cette clause devient vide et les coefficients deviennent instables — le tableau ci-dessus n’est interprétable que si les diagnostics qui suivent sont au vert.
Vérification 1 — deux variables qui se ressemblent
question("Deux variables explicatives sont fortement corrélées entre elles. Que devient l'interprétation de leurs coefficients ?", choix=["Elle reste valide : chaque coefficient donne l'effet propre de sa variable","Elle devient instable : le modèle peut répartir le même effet d'un coefficient à l'autre, et le signe peut changer d'un échantillon à l'autre","Les deux coefficients deviennent exactement nuls", ], bonne="B", explication="C'est la multicollinéarité : quand deux variables portent la même information, le modèle n'a pas de raison de choisir laquelle porte l'effet. Le VIF de cette section mesure cette instabilité.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — Deux variables explicatives sont fortement corrélées entre elles. Que devient l'interprétation de leurs coefficients ?

  A. Elle reste valide : chaque coefficient donne l'effet propre de sa variable
  B. Elle devient instable : le modèle peut répartir le même effet d'un coefficient à l'autre, et le signe peut changer d'un échantillon à l'autre
  C. Les deux coefficients deviennent exactement nuls

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
3bis. Vérifier les hypothèses avant d’interpréter les coefficients
Le §3 a lu les coefficients comme si chacun mesurait un effet propre. C’est vrai si et seulement si les hypothèses de la régression linéaire tiennent. Or un modèle peut avoir un R² élevé et des coefficients ininterprétables : la régression (moindres carrés) ne vérifie aucune hypothèse, elle calcule la droite qui minimise l’erreur — la qualité de l’ajustement ne garantit pas la validité de la lecture.
Quatre hypothèses conditionnent l’interprétation :
Hypothèse
Ce qu’elle garantit
Si violée
Pas de multicollinéarité
chaque coefficient mesure un effet propre
coefficients instables, signes aléatoires
Homoscédasticité
variance des résidus constante
p-values et intervalles de confiance faux
Linéarité
la forme du modèle est la bonne
une relation courbe est lue comme linéaire
Indépendance
les observations ne se prédisent pas
les écarts-types sont sous-estimés
Ci-dessous, trois violations construites exprès (pas un diagnostic au hasard sur un dataset propre) : on mesure, on regarde, on conclut. La leçon transversale : vérifier avant d’interpréter, car un coefficient lisible sur un modèle bien posé est une lecture, le même coefficient sur un modèle violé est une illusion.
3bis.1 Multicollinéarité — quand deux variables se ressemblent trop
La multicollinéarité apparaît quand une variable explicative est presque une combinaison linéaire des autres (ici x2 ≈ x1). Le modèle ne peut plus distinguer leur effet propre : il peut tout attribuer à x1, tout à x2, ou n’importe quel partage — tous également bons pour la prédiction, tous différents pour la lecture.
Le VIF (variance inflation factor) mesure l’inflation de la variance d’un coefficient due à cette dépendance. Règle pratique : VIF > 10 = drapeau rouge. On compare ici un jeu collinéaire (x1/x2 corréles à ~0.99) à un jeu orthogonal (mêmes variables, mais x2 indépendant), et on regarde la stabilité bootstrap des coefficients (on ré-ajuste sur 300 échantillons et on mesure la dispersion des coefficients obtenus).
Sur le jeu collinéaire, le VIF de x1 et x2 est de 52 (le seuil est 10) : la variance de chacun est gonflée d’un facteur 52 par sa dépendance à l’autre. À l’opposé, le jeu orthogonal donne un VIF de 1.0 partout : les variables sont parfaitement distinguables.
Le bootstrap rend la conséquence visible : le coefficient de x1 a un écart-type de ~0.25 sur le jeu collinéaire contre ~0.044 sur le jeu orthogonal — soit une instabilité ≈5.7× plus grande dès qu’on tire un autre échantillon. x2 se comporte pareil (~0.25 contre ~0.041, ≈6.2×). x3, resté orthogonal à la paire, ne bouge pas (~0.03) : c’est bien la collinéarité de la paire qui est en cause, pas un hasard global.
Ce que cela signifie pour la lecture : sur le jeu collinéaire, le coefficient de x1 peut valoir 3, 1, ou même changer de signe selon l’échantillon — et le R² reste excellent. La régression « explique » toujours, mais ne distingue plus qui explique quoi. Remède : retirer une des variables corrélées, les standardiser, ou recourir à une régression régularisée (ridge).
3bis.2 Hétéroscédasticité — la variance des résidus n’est pas constante
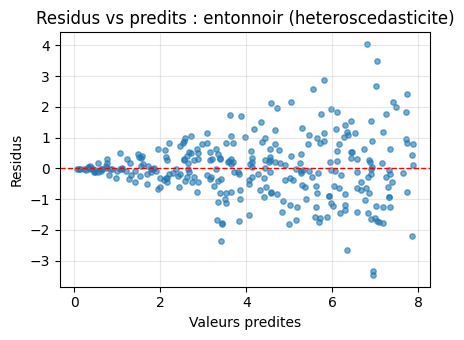
Le §2 a vérifié l’homoscédasticité sur un jeu propre (résidus centrés sans structure). Ici on construit le cas inverse : la variance des résidus croît avec la valeur prédite — le nuage devient un entonnoir. Les coefficients (moindres carrés) restent sans biais, mais les écarts-types, les intervalles de confiance et les p-values deviennent faux : la régression croit en savoir plus qu’elle n’en sait.
On le mesure par la corrélation entre |résidu| et la prédiction (positive ⇒ entonnoir) et par le test de White (rejette l’homoscédasticité si p < 0.05).
corr(|resid|, pred) = 0.520  (nettement > 0 : entonnoir)
test de White p = 8.01e-10  (p < 0.05 : variance non constante)
R2 = 0.826  (eleve, pourtant les hypotheses sont violees)
Lecture — un R² élevé qui ne dit pas tout
Le nuage s’ouvre en entonnoir : les résidus sont serrés à gauche (faibles prédictions) et s’étalent à droite. La corrélation |résidu| / prédiction est de 0.52 et le test de White rend p ≈ 8e-10 : on rejette sans ambiguïté l’homoscédasticité.
Le point clé : le R² est de 0.83 — l’ajustement est bon, et pourtant l’hypothèse d’homoscédasticité est violée. C’est exactement la leçon : R² ne valide pas les hypothèses, il mesure juste la qualité de la droite. Sur ce modèle, un intervalle de confiance ou une p-value calculée naïvement sous-estime l’incertitude réelle : on croit le coefficient « précis » alors que l’erreur est bien plus grande aux fortes valeurs.
Remède : regarder le nuage des résidus avant de lire des p-values ; corriger par des écarts-types robustes à l’hétéroscédasticité (HC), transformer y (log), ou modéliser la variance elle-même (ce que ferait une approche bayésienne).
3bis.3 Points leviers et points influents — la distance de Cook
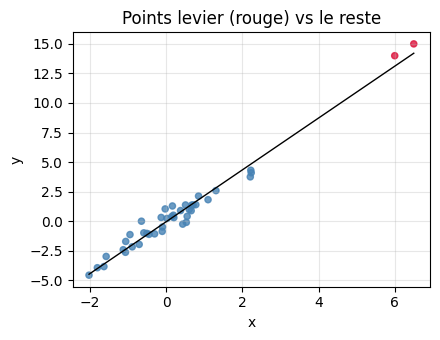
Un point levier est éloigné du centre de gravité des x : il « tire » la droite vers lui. Sa levierh_ii mesure à quel point une observation peut influencer sa propre prédiction (seuil usuel 2p/n). La distance de Cook combine levier et résidu : elle dit combien la prédiction d’ensemble changerait si l’on retirait ce point (seuil usuel 4/n). Un point à la fois levier et résiduel élevé est influent — il peut à lui seul dessiner une relation. On injecte ici 2 observations loin du nuage : elles doivent sauter aux yeux des métriques.
levier max h_ii = 0.354  (seuil 2p/n = 0.095)
Cook's D max    = 0.695  (seuil 4/n = 0.095)
Lecture — deux points qui font basculer la droite
Les deux observations injectées (à x = 6.0 et 6.5) ressortent au levier (h_ii jusqu’à 0.35, contre un seuil de 0.095) et à la distance de Cook (jusqu’à 0.70, contre un seuil de 0.095). En rouge sur la figure, elles sont seules en haut à droite : elles, ou la droite calculée, ne sont pas représentatives du nuage — les deux statements se tiennent.
La conséquence pratique : sur ce dataset, deux observations suffisent à faire pencher la pente. Interpréter le coefficient de x comme un « effet moyen » serait ignorer que cet effet est porté par deux points. À lire avant d’interpréter : repérer les leviers, examiner leur Cook, et vérifier qu’ils ne sont pas des erreurs de saisie ou des cas à part (premier jugement : les exclure et regarder l’effet).
La règle — quatre diagnostics avant d’interpréter un coefficient
Hypothèse
Métrique
Seuil usuel
Si dépassé
Pas de multicollinéarité
VIF
> 10
corrélation entre variables ; retirer une variable ou régulariser
Homoscédasticité
corr(\|résidu\|, prédiction), test de White
corr proche de 0 ; p > 0.05
écarts-types robustes (HC) ou transformation
Leviers / points influents
levier h_ii, Cook’s D
2p/n ; 4/n
examiner ces points avant de les laisser peser
Linéarité
nuage résidus vs prédits
sans structure courbe
ajouter un terme non linéaire
Le réflexe. R² n’est pas une validation : il mesure l’ajustement, pas la légitimité de l’interprétation. Avant de lire un coefficient comme un « effet », vérifier la multicollinéarité, jeter un œil au nuage des résidus, et repérer les points influents. Ces quatre vérifications prennent dix lignes et transforment une lecture en interprétation.
4. Régression logistique : prédire une probabilité binaire
Changement de tâche : nous passons à la classification. La régression logistique modélise la probabilité d’appartenir à la classe 1 :
La fonction sigmoid\(\sigma\) écrase n’importe quel score réel dans l’intervalle \((0, 1)\). Contrairement à la régression linéaire, l’ajustement se fait par maximum de vraisemblance (MLE) et non par moindres carrés : on cherche les paramètres qui rendent les labels observés les plus probables.
Référence. Cox, D.R. (1958), The Regression Analysis of Binary Sequences, Journal of the Royal Statistical Society. Series B (Methodological) 20(2):215-232. La régression logistique (modèle logit) y est introduite pour les réponses binaires — l’estimation se fait par maximum de vraisemblance, non par moindres carrés.
# Generation de donnees de classification binaire (4 variables, 3 informatives)Xc, yc = make_classification(n_samples=300, n_features=4, n_informative=3, n_redundant=0, flip_y=0.08, random_state=42)# Separation en jeu d'entrainement et de test (80/20)Xc_train, Xc_test, yc_train, yc_test = train_test_split(Xc, yc, test_size=0.2, random_state=42)# Ajustement du modele de regression logistique (max_iter augmente pour la convergence)modele_logistique = LogisticRegression(max_iter=1000).fit(Xc_train, yc_train)# Probabilites predites sur quelques points du jeu de test (colonnes : P(classe 0), P(classe 1))proba_exemple = modele_logistique.predict_proba(Xc_test[:5])print("Probabilites predites (5 premiers points de test) :")print("Colonne 0 = P(classe 0), Colonne 1 = P(classe 1)")print(proba_exemple)
La régression logistique ne rend pas des classes mais des probabilités : chaque ligne de la matrice donne P(classe 0) et P(classe 1), dont la somme vaut 1. Les cinq points de test couvrent toute la gamme : du quasi-certain (0,988 pour la classe 1 au quatrième point) à l’indécis (0,32 / 0,68 au premier, presque un pile-ou-face). Cette granularité est la richesse du modèle : c’est elle qui permettra, à l’exercice 2, de choisir un seuil de décision adapté au coût des erreurs, plutôt que d’accepter le seuil implicite 0,5 d’un predict qui masque tout l’audit.
5. La fonction sigmoid
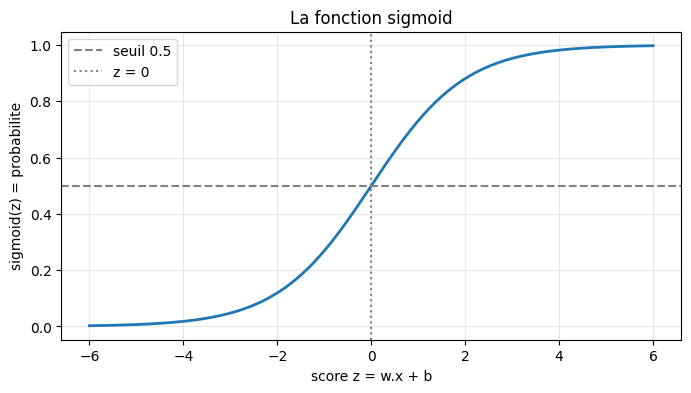
La sigmoid transforme le score linéaire\(z = \mathbf{w} \cdot \mathbf{x} + b\) en une probabilité comprise dans \((0, 1)\) :
\[\sigma(z) = \frac{1}{1 + e^{-z}}\]
Le seuil de décision par défaut est 0,5 : si \(p \geq 0,5\), on prédit la classe 1, sinon la classe 0. La courbe a la forme en S caractéristique : autour de \(z = 0\), la probabilité vaut 0,5 et la décision est la plus incertaine.
# Visualisation de la fonction sigmoidz = np.linspace(-6, 6, 200)p =1/ (1+ np.exp(-z))plt.figure(figsize=(8, 4))plt.plot(z, p, linewidth=2)plt.axhline(0.5, linestyle="--", color="gray", label="seuil 0.5")plt.axvline(0, linestyle=":", color="gray", label="z = 0")plt.xlabel("score z = w.x + b")plt.ylabel("sigmoid(z) = probabilite")plt.title("La fonction sigmoid")plt.legend()plt.grid(alpha=0.3)plt.show()# A lire : la courbe en S ecrase les scores extremes vers 0 et 1,# et coupe 0.5 exactement en z = 0.
6. OLS vs MLE : deux principes d’estimation
C’est le contraste conceptuel clé de ce notebook :
Aspect
Régression linéaire (OLS)
Régression logistique (MLE)
Cible
continue
binaire (0/1)
Principe
minimiser l’erreur quadratique
maximiser la vraisemblance
Solution
forme fermée (analytique)
pas de forme fermée (descente de gradient / IRLS)
Sortie
valeur réelle
probabilité dans (0, 1)
Les deux modèles partagent le même cœur linéaire (\(\mathbf{w} \cdot \mathbf{x} + b\)), mais le principe d’estimation diffère radicalement. Tous deux sont des cas particuliers de modèles linéaires généralisés (GLM).
Référence. Hastie, T., Tibshirani, R. & Friedman, J. (2009), The Elements of Statistical Learning, Springer (2e éd.), sections 4.2-4.4. La distinction entre estimation par moindres carrés (OLS) et par maximum de vraisemblance (MLE) y est posée comme le principe fondateur du choix de modèle.
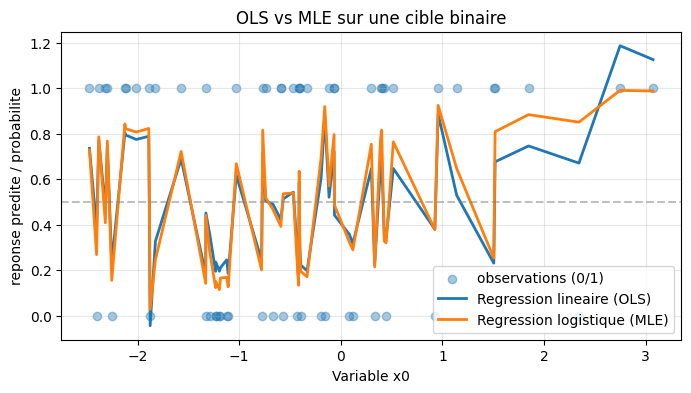
# Comparaison : regression lineaire vs logistique sur les MEMES donnees binaires# On utilise la premiere variable explicative pour la visualisationfeature_idx =0x_visu = Xc_test[:, feature_idx]ordre = np.argsort(x_visu)x_visu_trie = x_visu[ordre]# Ajustement d'une regression lineaire sur les labels 0/1 (illustratif, "mal adapte")modele_lin_binaire = LinearRegression().fit(Xc_train, yc_train)pred_lineaire = modele_lin_binaire.predict(Xc_test)[ordre]# Probabilites de la regression logistiquepred_logistique = modele_logistique.predict_proba(Xc_test)[:, 1][ordre]plt.figure(figsize=(8, 4))plt.scatter(x_visu, yc_test, alpha=0.4, label="observations (0/1)")plt.plot(x_visu_trie, pred_lineaire, label="Regression lineaire (OLS)", linewidth=2)plt.plot(x_visu_trie, pred_logistique, label="Regression logistique (MLE)", linewidth=2)plt.axhline(0.5, linestyle="--", color="gray", alpha=0.5)plt.xlabel(f"Variable x{feature_idx}")plt.ylabel("reponse predite / probabilite")plt.title("OLS vs MLE sur une cible binaire")plt.legend()plt.grid(alpha=0.3)plt.show()# A lire : la courbe logistique est bornee entre 0 et 1 (forme en S),# tandis que la droite lineaire depasse 1 et descend sous 0.# C'est precisement pour cela que la regression logistique existe.
Lecture : OLS et MLE ne répondent pas à la même question
La figure superpose deux ajustements des mêmes données binaires : la droite OLS traverse le nuage en tirant chaque prédiction vers la moyenne locale des 0 et des 1 — elle peut produire des valeurs hors de [0, 1] et traite chaque point avec le même poids, quelle que soit sa position. La courbe logistique, ajustée par maximum de vraisemblance (MLE), est contrainte dans [0, 1] et s’aplatit exactement là où les probabilités doivent saturer. Sur des données binaires, OLS reste un estimateur correct en espérance, mais MLE fournit des intervalles et des tests cohérents avec la nature 0/1 de la cible — c’est le prix de la bonne fonction de lien.
Exercice 2 : le seuil de décision change les prédictions
Objectif : prédire les classes à l’aide d’un seuil personnalisé (par exemple 0,3 au lieu du seuil par défaut 0,5) à partir des probabilités prédites, puis compter combien de prédictions changent par rapport au seuil standard.
Baisser le seuil (ex. 0,3) rend le modèle plus sensible : il classe plus d’observations en classe 1. L’augmenter (ex. 0,7) le rend plus spécifique.
Indice : la conversion probabilité → classe s’écrit (proba >= seuil).astype(int). Comparez ensuite au résultat du seuil 0,5 pour compter les changements.
# Exercice 2 : predire les classes avec un seuil personnalise (ex 0.3)proba_test = modele_logistique.predict_proba(Xc_test)[:, 1] # proba de classe 1seuil =None# TODO etudiant : choisir un seuil (ex 0.3 ou 0.7)# TODO etudiant : predire les classes avec ce seuilclasses_seuil =None# TODO etudiant : remplacer ((proba_test >= seuil).astype(int))# TODO etudiant : nombre de predictions differentes du seuil par defaut 0.5nb_changements =None# TODO etudiant : remplacerprint(f"Exercice 2 a completer : seuil={seuil}, nb predictions changees = {nb_changements}")
Exercice 2 a completer : seuil=None, nb predictions changees = None
Vérification 2 — pourquoi pas une droite sur une cible binaire
question("On veut prédire une issue binaire (0 ou 1). Pourquoi ne pas lire directement la sortie d'une régression linéaire ajustée sur cette cible ?", choix=["Parce qu'une droite peut prédire 1,4 ou -0,3 : ce ne sont pas des probabilités","Parce que la régression linéaire refuse de s'ajuster sur une cible binaire","Parce que la sigmoïde n'est qu'un embellissement d'affichage", ], bonne="A", explication="Une droite n'est pas bornée : elle sort de [0, 1], donc ses valeurs ne peuvent pas être lues comme des probabilités. La régression logistique change de principe d'estimation (MLE) et de fonction de lien (sigmoïde).", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="pendant",)
Vérification — On veut prédire une issue binaire (0 ou 1). Pourquoi ne pas lire directement la sortie d'une régression linéaire ajustée sur cette cible ?

  A. Parce qu'une droite peut prédire 1,4 ou -0,3 : ce ne sont pas des probabilités
  B. Parce que la régression linéaire refuse de s'ajuster sur une cible binaire
  C. Parce que la sigmoïde n'est qu'un embellissement d'affichage

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
7. Interprétation des coefficients logistiques
En régression logistique, un coefficient \(w_j\) modifie les log-odds d’une quantité \(w_j\) par unité de \(x_j\). La quantité directement interprétable est l’odds ratio :
\[\text{odds ratio}_j = e^{w_j}\]
Il représente l’effet multiplicatif sur la cote (odds) d’appartenir à la classe 1 : - \(\text{odds ratio} > 1\) : la variable augmente la probabilité de la classe 1. - \(\text{odds ratio} < 1\) : la variable diminue cette probabilité. - \(\text{odds ratio} = 1\) : aucun effet.
Par exemple, un odds ratio de 2 signifie que chaque unité supplémentaire de la variable double la cote d’être en classe 1.
# Calcul des odds ratios = exp(coefficient) pour la regression logistiqueodds_ratios = np.exp(modele_logistique.coef_[0])or_df = pd.DataFrame({"variable": [f"x{j}"for j inrange(Xc.shape[1])],"coefficient_logistique": modele_logistique.coef_[0],"odds_ratio": odds_ratios,})print(or_df)# Interpretation : une variable dont l'odds ratio vaut 2 double la cote de# la classe 1 pour chaque unite supplementaire ; un odds ratio de 0.5 la divise par 2.
Objectif : identifier la variable qui a le plus grand effet (en valeur relative) sur la probabilité d’appartenir à la classe 1, puis interpréter concrètement sa valeur.
Étape 1 : calculez les odds ratios np.exp(modele_logistique.coef_[0]). Étape 2 : repérez l’indice de la variable dont l’odds ratio est le plus grand (le plus éloigné au-dessus de 1). Étape 3 : interprétez : « chaque unité supplémentaire de cette variable multiplie la cote de la classe 1 par … ».
# Exercice 3 : identifier la feature avec le plus grand odds ratioodds_ratios =None# TODO etudiant : remplacer (np.exp des coefficients logistiques)# TODO etudiant : trouver l'indice de la feature avec le plus grand odds ratioindice_max =None# TODO etudiant : remplacervaleur_max =None# TODO etudiant : remplacerprint(f"Exercice 3 a completer : feature {indice_max} a le plus grand odds ratio = {valeur_max}")
Exercice 3 a completer : feature None a le plus grand odds ratio = None
Exercice 4 : détecter la multicollinéarité
On te donne un jeu où x1 et x2 sont fortement corrélées. Calcule le VIF de chaque variable et conclus : laquelle faut-il retirer ? Quel VIF devient acceptable ?
# Exercice 4 : VIF et multicollinearite# Etape 1 : calculer le VIF de chaque variable# Etape 2 : identifier la variable la plus correlee et conclure sur sa retentionvif_acceptable =None# TODO etudiant : valeur de VIF a partir de laquelle on retire la variable ?print(f"Exercice 4 a completer : VIF acceptable = {vif_acceptable}")
Exercice 4 a completer : VIF acceptable = None
Exercice 5 : l’entonnoir ou le point qui bascule
Deux situations à diagnostic : (a) un nuage de résidus qui s’ouvre en entonnoir ; (b) un point loin du nuage avec un Cook élevé. Pour chacune, dis quelle hypothèse est menacée et quelle métrique te l’a révélé.
# Exercice 5 : heteroscedasticite ou point levier ?# (a) nuage de residus en entonnoir -> quelle hypothese ? quelle metrique ?# (b) point loin du nuage avec Cook eleve -> quelle hypothese ? quelle metrique ?diagnostic_a =None# TODO etudiant : "heteroscedasticite", "multicollinearite", "levier" ?diagnostic_b =None# TODO etudiant : idemprint(f"Exercice 5 a completer : (a) {diagnostic_a}, (b) {diagnostic_b}")
Exercice 5 a completer : (a) None, (b) None
Après le parcours — question de transfert
question("Un coefficient logistique vaut 0,7 (en log-odds). Comment le lire ?", choix=["La probabilité augmente de 70 %","La cote (odds) est multipliée par environ 2","La probabilité est multipliée par 0,7", ], bonne="B", explication="Un coefficient logistique s'interprète après exponentiation : exp(0,7) ≈ 2, soit une cote doublée. Une probabilité ne se multiplie pas ainsi : elle dépend aussi du niveau de départ.", reponse=None, # remplacez None par la lettre de votre choix, puis re-executez moment="apres",)
Transfert — Un coefficient logistique vaut 0,7 (en log-odds). Comment le lire ?

  A. La probabilité augmente de 70 %
  B. La cote (odds) est multipliée par environ 2
  C. La probabilité est multipliée par 0,7

Réponse non donnée. Remplacez `reponse=None` par la lettre de votre choix dans cette cellule, puis ré-exécutez-la pour afficher la correction.
Conclusion et transition
Ce notebook a couvert les deux familles de régression canoniques :
Modèle
Cible
Estimation
Métriques / lecture
Régression linéaire
continue
OLS (moindres carrés)
R², résidus centrés
Régression logistique
binaire
MLE (maximum de vraisemblance)
sigmoid, odds ratios
Les deux partagent le même cœur linéaire (\(\mathbf{w} \cdot \mathbf{x} + b\)), mais la tâche (continu vs binaire) et le principe d’estimation (OLS vs MLE) diffèrent. Savoir choisir entre les deux selon la nature de la cible est une compétence fondatrice.
Le prochain notebook (2.4-Arbres-Forets-Ensembles) quitte les modèles linéaires pour les arbres de décision et les méthodes d’ensemble, qui capturent des relations non linéaires.
References
Nelder, J.A. & Wedderburn, R.W.M. (1972). Generalized Linear Models. Journal of the Royal Statistical Society. Series A 135(3):370-384. — Le cadre unifiant régression linéaire (gaussienne) et logistique (binomiale).
Cox, D.R. (1958). The Regression Analysis of Binary Sequences. Journal of the Royal Statistical Society. Series B (Methodological) 20(2):215-232. — La régression logistique, estimation par maximum de vraisemblance.
Hastie, T., Tibshirani, R. & Friedman, J. (2009). The Elements of Statistical Learning. Springer (2e éd.), §4.2-4.4. — OLS vs MLE comme principes d’estimation.
Hosmer, D.W., Lemeshow, S. & Sturdivant, R.X. (2013). Applied Logistic Regression. Wiley (3e éd.). — Interprétation des coefficients et des odds ratios.
Pedregosa, F. et al. (2011). Scikit-learn: Machine Learning in Python. Journal of Machine Learning Research 12:2825-2830. — LinearRegression, LogisticRegression, métriques.
Deisenroth, M.P., Faisal, A.A. & Ong, C.S. (2020). Mathematics for Machine Learning. Cambridge UP. — ch. 9 (Linear Regression) pose la formulation probabiliste de la régression linéaire (vraisemblance gaussienne, estimateur du maximum de vraisemblance = moindres carrés), la régularisation ridge (L2) et Lasso (L1) en Bayesian prior, et la régression logistique comme modèle linéaire généralisé (GLM, lien logit). La régression logistique de ce carnet est précisément le GLM binomial du ch. 9.4.