Image - Génération d’Images par IA
← Documentation GenAI | ↑ .. | → Docker Management
La génération d’images par IA est la deuxième modalité générative la plus accessible après le texte. Elle couvre un spectre large : génération from scratch (DALL-E, FLUX), édition d’images existantes (Qwen Image Edit), upscaling (Real-ESRGAN), et orchestration de workflows multi-modèles via ComfyUI. La progression va du prompt cloud one-shot au workflow ComfyUI multi-modèles orienté production.
Fil rouge : construire un générateur de contenu visuel éducatif
L’objectif fil rouge de cette série est de construire un système capable de produire des visuels pédagogiques de qualité : diagrammes, illustrations conceptuelles, et images d’identité pour des supports de cours. Chaque niveau apporte une brique supplémentaire : génération simple via API cloud (niveau 1), modèles avancés et édition fine (niveau 2), comparaison et orchestration multi-modèles (niveau 3), workflows de production (niveau 4), et cas d’usage concrets par domaine (examples).
Acquis d’apprentissage
À l’issue de la série, l’apprenant sait :
- Choisir la bonne modalité : API cloud (gpt-image-1, GPT-5 Image) vs ComfyUI auto-hébergé (SD XL, FLUX, Qwen) selon le besoin (contrôle, coût, débit, données sensibles).
- Manipuler une image en code : PIL/OpenCV pour redimensionnement, masques, compositing, conversion VAE latents <-> pixels.
- Concevoir un workflow ComfyUI : graphe de nœuds (Sampler, VAE, ConditioningCombine, ModelSampling), import/export JSON, batching et seeds reproductibles.
- Éditer plutôt que régénérer : Qwen Image Edit, ControlNet, inpainting (zones à régénérer dans un visuel existant) — moins coûteux et plus contrôlable que repartir de zéro.
- Composer plusieurs modèles : pipeline base + LoRA style + upscaler + post-processing pour atteindre une qualité “supports de cours”.
- Opérationnaliser : gestion VRAM (quantizations Nunchaku INT4 / FP8), file d’attente ComfyUI, monitoring GPU, déploiement derrière une API.
La structure détaillée (notebooks par niveau, contenu, services utilisés) est listée plus bas. Le décompte canonique réside dans CATALOG-STATUS.json du dépôt.
Structure
Image/
├── 01-Foundation/     # Modèles de base
├── 02-Advanced/       # Modèles avancés
├── 03-Orchestration/  # Multi-modèles
├── 04-Applications/   # Production
├── 05-History/        # Racines pré-Stable-Diffusion
├── assets/            # Médias partagés (couvertures, panneaux)
└── examples/          # Cas d'usage par domaine
Les guides de référence transversaux (DALL-E 3, GPT-5 image, OpenRouter, workflows éducatifs) vivent dans le répertoire partagé ../tutorials/ — pas de doublon local ici.
Progression par niveau
01-Foundation - Modèles de base
Avant de produire des visuels pédagogiques, il faut maîtriser les outils de génération. Ce niveau couvre les deux approches : API cloud (gpt-image-1, GPT-5) pour la simplicité, et modèles locaux via ComfyUI (SD XL Turbo, Qwen) pour le contrôle fin. 01-3 donne les bases de manipulation d’image (PIL, OpenCV) nécessaires pour comprendre ce que font les modèles.
La première étape est un simple appel d’API : on décrit l’image en langage naturel et le modèle cloud renvoie un visuel. C’est le point d’entrée le plus accessible — pas de GPU, pas de configuration, juste une clé.
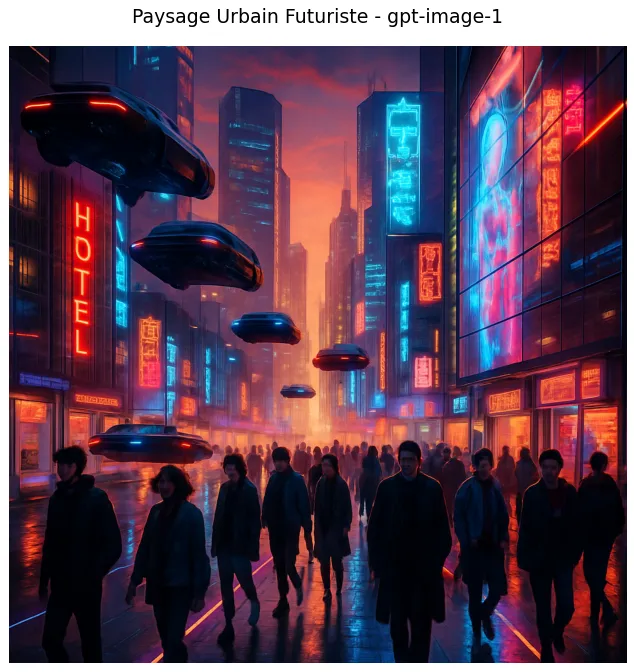
Sortie du notebook 01-1 : paysage urbain futuriste cyberpunk au coucher de soleil, généré par gpt-image-1 (DALL-E 3 retiré). Le notebook source appelle désormais gpt-image-1 depuis la migration PR #4230.
| Notebook | Contenu | Service |
|---|---|---|
| 01-1-OpenAI-DALL-E-3 | Génération avec gpt-image-1 (DALL-E 3 retiré) | OpenAI API |
| 01-2-GPT-5-Image-Generation | Génération avec GPT-5 | OpenAI API |
| 01-3-Basic-Image-Operations | Opérations de base | PIL/OpenCV |
| 01-4-Forge-SD-XL-Turbo | Stable Diffusion XL Turbo | ComfyUI |
| 01-5-Qwen-Image-Edit | Introduction Qwen | ComfyUI |
Une fois le cloud maîtrisé, la génération locale via ComfyUI ouvre le contrôle fin : choix du sampler, de la seed, du checkpoint. SD XL Turbo (01-4) distille la diffusion pour une génération rapide sur GPU auto-hébergé :
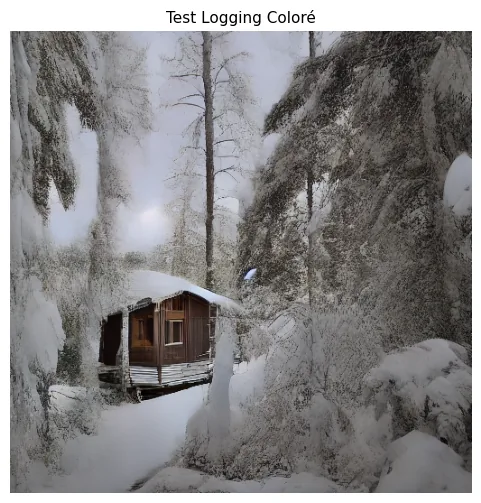
Sortie du notebook 01-4 : chalet hivernal produit localement par SD XL Turbo, sans appel d’API.
L’autre apport du niveau foundation est l’édition : plutôt que de régénérer une image entière, Qwen Image Edit (01-5) ne recalcule que la zone masquée — moins coûteux et plus contrôlable. Le panneau ci-dessous montre un rendu réel d’inpainting Qwen : à gauche, le portrait original d’un pêcheur au coucher de soleil sur le port ; à droite, la même scène avec un prompt d’édition (denoise=0.5) qui augmente le contraste et révèle des reflets chauds en arrière-plan — le sujet reste préservé tout en intégrant la modification :
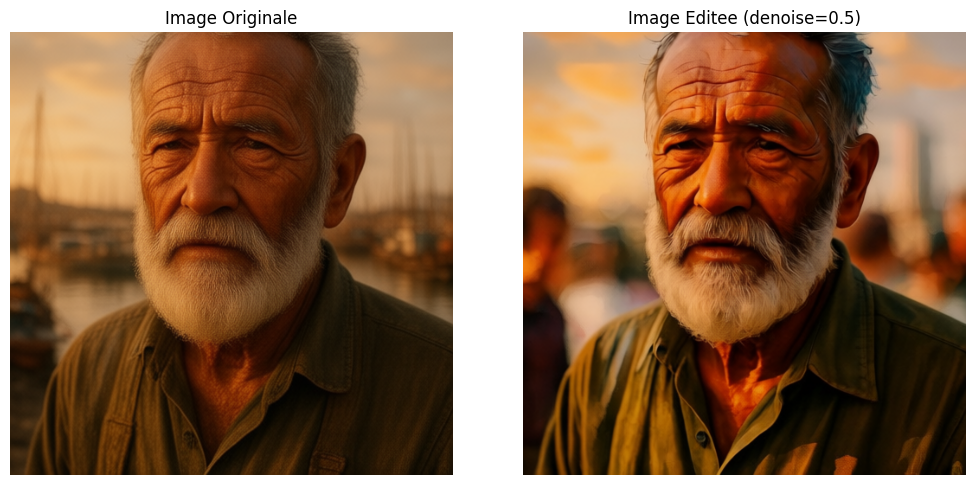
Sortie du notebook 01-5 : panneau Originale/Editée — vrai inpainting Qwen, sujet préservé, modification contrôlée par denoise=0.5 (figure régénérée post-#7003 sur stack ComfyUI-Qwen Phase 29).
02-Advanced - Modèles avancés
Un visuel éducatif de qualité demande des outils plus précis : édition d’images existantes (Qwen), génération haute qualité (FLUX), ou modèles légers et rapides (Z-Image/Lumina). Ce niveau explore les modèles de pointe et leurs compromis entre qualité, vitesse et ressources GPU. Le notebook 02-5 pousse l’optimisation à l’extrême avec Bonsai-Image (FLUX.2 Klein 4B en quantization ternaire 1.58-bit), qui ne consomme que ~6.8 GiB de VRAM à 1024x1024.
Le porte-drapeau de ce niveau pour la qualité est FLUX.1 (02-2) : un rendu photo-réaliste fidèle au prompt détaillé, là où gpt-image-1 tend à lisser les textures complexes.
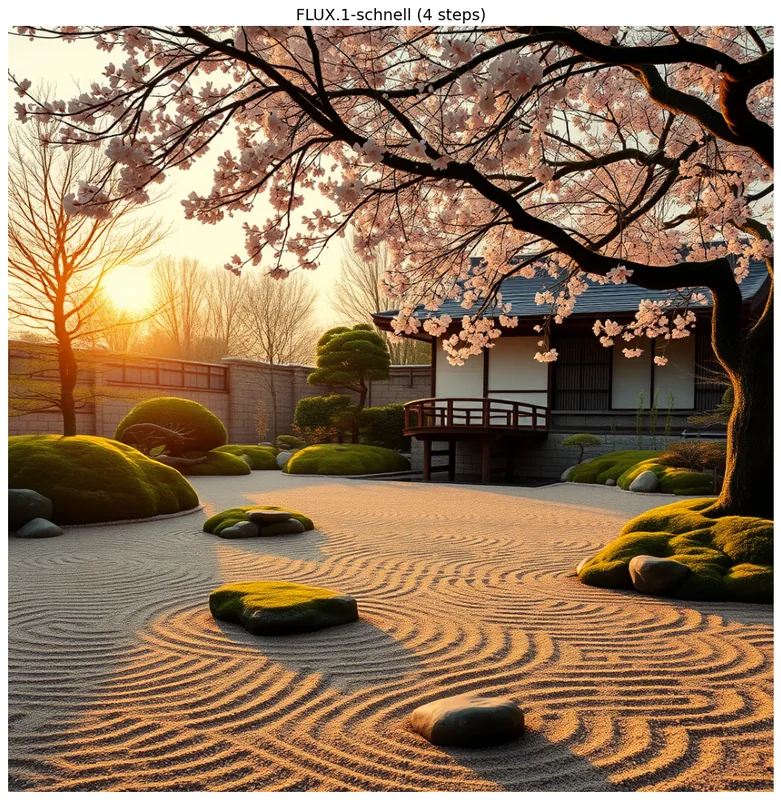
Sortie du notebook 02-2 : jardin zen rendu par FLUX.1-schnell — fidélité de texture et suivi de prompt avancé.
| Notebook | Contenu | Service |
|---|---|---|
| 01-5b-Qwen-Image-Edit-2509 | Édition avancée Qwen | ComfyUI |
| 02-2-FLUX-1-Advanced-Generation | Génération FLUX | ComfyUI |
| 02-3-Stable-Diffusion-3-5 | SD 3.5 | ComfyUI |
| 02-4-Z-Image-Lumina2 | Z-Image/Lumina | ComfyUI |
| 02-5-Bonsai-Image-Ternary | Bonsai-Image 4B, quantization ternaire 1.58-bit | ComfyUI |
À l’opposé de FLUX.1 côté légèreté, Z-Image/Lumina2 (02-4) vise une génération rapide pour le prototypage — un compromis qualité/débit utile pour itérer sur un prompt avant de lancer un rendu lourd :
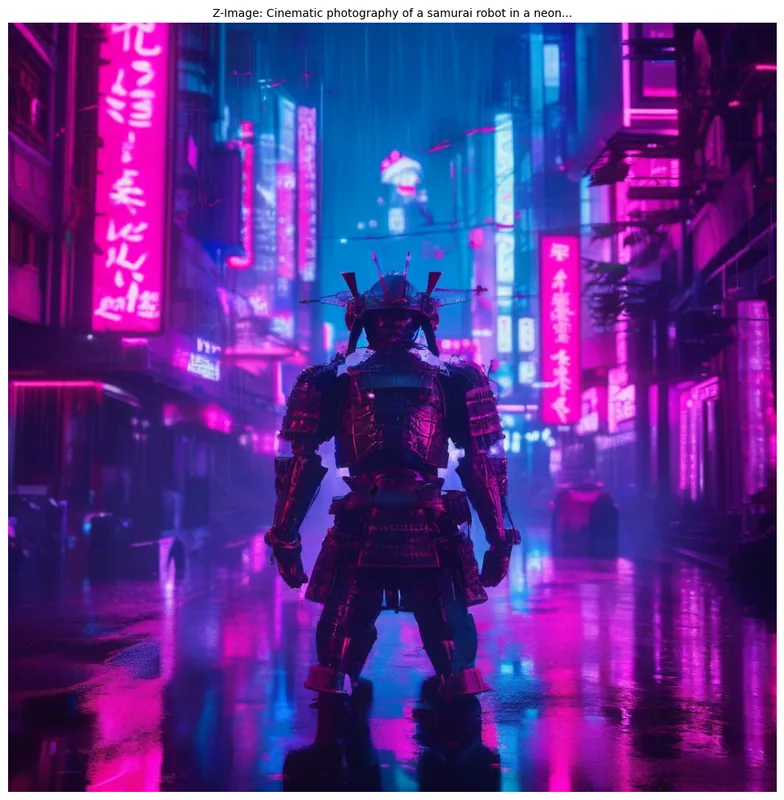
Sortie du notebook 02-4 : samouraï robot cyberpunk généré par Z-Image Lumina2 (Lumina Diffusers) — rendu authentique illustrant le prototypage rapide.
03-Orchestration - Multi-modèles
En production, un seul modèle ne suffit pas toujours. Ce niveau compare les modèles entre eux pour choisir le bon selon le contexte, orchestre des pipelines de traitement (génération puis édition puis upscaling), et optimise les performances pour le déploiement. L’orchestration se matérialise par un workflow ComfyUI : un graphe de nœuds (Sampler, VAE, upscaler) que l’on enchaîne et exporte en JSON pour le rendre reproductible — reproductible jusqu’à voyager dans l’image elle-même : chaque PNG sauvegardé par ComfyUI embarque son propre workflow dans les métadonnées, et 03-4 montre qu’on peut extraire ce graphe par simple parsing binaire puis le rejouer, y compris sa boucle la plus intéressante : un VLM dans le graphe qui examine une image de référence et rédige lui-même le prompt de character design avant la diffusion Krea 2. Le panneau ci-dessous illustre le concept de multi-variations appliqué à SD35 : trois exécutions du même prompt « chalet en bois dans une forêt de conifères sous la neige » avec des prompts de style distincts (photorealistic / watercolor / anime) produisent trois rendus différenciés tout en préservant le sujet — c’est exactement le scénario qu’un workflow ComfyUI orchestre de façon reproductible :
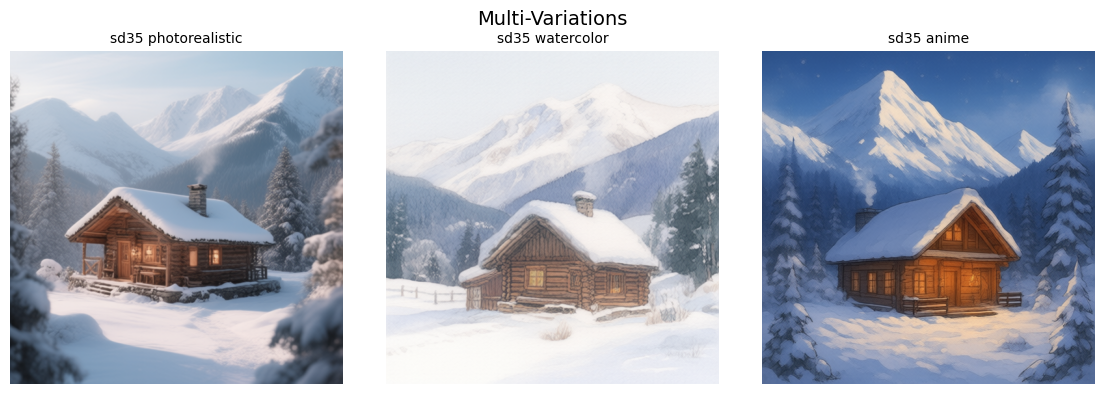
Sortie du notebook 03-2 : trois variations de style SD35 sur le même sujet (chalet enneigé), obtenues par orchestration ComfyUI du même prompt avec prompts de style distincts — la différenciation visuelle valide l’apport de l’orchestration multi-modèles (figure régénérée post-#7003 sur stack ComfyUI-Qwen Phase 29).
| Notebook | Contenu |
|---|---|
| 03-1-Multi-Model-Comparison | Comparaison multi-modèles |
| 03-2-Workflow-Orchestration | Orchestration de workflows |
| 03-3-Performance-Optimization | Optimisation performance |
| 03-4-VLM-Character-Design-Workflow | Boucle VLM in-graph (workflow embarqué dans un PNG) |
04-Applications - Production
Ce niveau met en œuvre les workflows complets : génération automatisée de contenu éducatif, pipelines créatifs, intégration en production, et un exemple concret de conversion d’images en patrons de point de croix.
| Notebook | Contenu |
|---|---|
| 04-1-Educational-Content-Generation | Contenu éducatif |
| 04-2-Creative-Workflows | Workflows créatifs |
| 04-3-Production-Integration | Intégration production |
| 04-4-Cross-Stitch-Pattern-Maker-Legacy | Point de croix (legacy) |
05-History - Racines pré-Stable-Diffusion
Notebooks rétrospectifs : les outils d’avant Stable Diffusion (2021-2022) qui ont établi les paradigmes encore à l’œuvre aujourd’hui — CLIP comme fonction de perte sémantique, guidance par classifieur. 05-2 exécute le code officiel de CLIPasso (SIGGRAPH 2022) : une image devient une esquisse de 4 à 32 traits, reconnaissable même à 4 — parce que l’optimisation est guidée par CLIP, pas par un signal bas-niveau.
| Notebook | Contenu | Publication |
|---|---|---|
| 05-2-CLIPasso-Semantic-Sketching | Sketching sémantique, abstraction par nombre de traits | Vinker et al., SIGGRAPH 2022 |
| 05-1-DiscoDiffusion (en préparation, #16477) | CLIP-guided diffusion pré-SD | — |
examples/ - Cas d’usage
Applications directes par domaine : histoire-géographie (cartes, reconstitutions), littérature (illustrations de textes), et sciences (diagrammes, schémas techniques). Ces notebooks montrent comment adapter les techniques des niveaux précédents à des besoins concrets.
| Notebook | Domaine |
|---|---|
| history-geography | Histoire-Géographie |
| literature-visual | Littérature |
| science-diagrams | Diagrammes scientifiques |
Tutorials — guides de référence
Section transversale de guides markdown (pas de notebooks) — quatre références longues pour approfondir un aspect précis du pipeline image, à consulter après avoir pratiqué les notebooks ci-dessus. Les guides vivent dans le répertoire partagé GenAI/tutorials/ (source autoritaire unique) :
| Guide | Sujet |
|---|---|
| dalle3-complete-guide | DALL-E 3 de bout en bout via l’API OpenAI — prompt engineering, templates pédagogiques, batch et intégration workflows CoursIA |
| educational-workflows | Supports de cours, évaluations et présentations via API OpenAI (DALL-E 3 + GPT-5) et OpenRouter — contrôle qualité, accessibilité |
| gpt5-image-analysis-guide | Analyse d’images multimodale GPT-5 via OpenRouter — configuration, templates cas pédagogiques, alt-text, optimisation des coûts |
| openrouter-ecosystem-guide | Routage DALL-E 3 / GPT-5 via OpenRouter — endpoints multiples, fallback, rate limiting et optimisation des coûts |
Technologies
| Technologie | Notebooks | Prérequis |
|---|---|---|
| OpenAI gpt-image-1 | 01-1, 01-2 | OPENAI_API_KEY |
| ComfyUI + Qwen | 01-4, 01-5, 02-1 | Docker, ~29GB VRAM |
| ComfyUI + FLUX | 02-2 | Docker GPU |
| ComfyUI + SD 3.5 | 02-3 | Docker GPU |
| Z-Image/Lumina | 02-4 | Docker, ~10GB VRAM |
| Bonsai-Image (ternaire) | 02-5 | ComfyUI, ~7 GB VRAM |
Prérequis
API Keys
# Dans GenAI/.env (jamais de littéral en clair dans le repo — voir .gitignore)
# OPENAI_API_KEY et COMFYUI_API_TOKEN sont configurés via .secrets/master.env
# et propagés par `python scripts/secrets/render_envs.py` (cf secrets-hygiene.md).
# COMFYUI_AUTH_TOKEN est un alias synchronisé : même valeur que COMFYUI_API_TOKEN.
Docker Services
cd docker-configurations/services/comfyui-qwen
docker-compose up -d
Accès : http://localhost:8188
Parcours recommandé
01-Foundation (bases)
    |
02-Advanced (modèles spécifiques)
    |
03-Orchestration (comparaison, workflows)
    |
04-Applications (production)| Objectif | Notebooks |
|---|---|
| Découverte rapide | 01-1, 01-3 |
| Génération avancée | 01-1 à 02-5 |
| Production | Tous + 03 + 04 |
Recette : construire un générateur de contenu visuel éducatif
Le fil rouge de cette série est la création d’un système de visuels pédagogiques. Voici comment les niveaux s’articulent :
01-Foundation (génération de base) : 01-1 et 01-2 couvrent la génération via API cloud. 01-4 et 01-5 introduisent les modèles locaux. À la fin, vous savez générer une image à partir d’un texte.
02-Advanced (édition et qualité) : 01-5b permet d’éditer une image existante pour corriger ou enrichir un visuel. 02-4 offre une génération rapide pour le prototypage. 02-2 pousse la qualité plus loin. 02-5 montre la quantization extrême (ternaire 1.58-bit) pour faire tenir un modèle 4B dans ~7 GB de VRAM.
03-Orchestration (comparaison et pipelines) : 03-1 compare les modèles pour choisir le meilleur rapport qualité/coût. 03-2 assemble un pipeline de génération complet.
04-Applications (production) : 04-1 applique le pipeline au contenu éducatif. Les notebooks examples/ montrent des cas d’usage par domaine (histoire, sciences, littérature).
Le schéma ci-dessous résume comment les niveaux s’articulent pour construire un générateur de visuels pédagogiques : du prompt cloud one-shot (niveau 1) au workflow ComfyUI multi-modèles orienté production (niveau 4), en passant par l’édition fine (niveau 2) et l’orchestration (niveau 3).
flowchart TD
    subgraph N1["1 · Générer de base — 01-Foundation"]
        A1["01-1 gpt-image-1 : API cloud"]
        A2["01-2 GPT-5 Image : API cloud"]
        A3["01-3 : bases PIL / OpenCV"]
        A4["01-4 SD XL Turbo : ComfyUI"]
        A5["01-5 Qwen Image Edit : local"]
    end
    subgraph N2["2 · Éditer & pousser la qualité — 02-Advanced"]
        B1["02-1 Qwen Edit : édition fine"]
        B2["02-2 FLUX : génération haute qualité"]
        B3["02-4 Z-Image/Lumina : rapide"]
        B4["02-5 Bonsai : quantization ternaire ~7 GB"]
    end
    subgraph N3["3 · Orchestrer — 03-Orchestration"]
        C1["03-1 : comparer qualité / coût"]
        C2["03-2 : pipeline gén→édit→upscale"]
        C3["03-3 : perf & quantization"]
    end
    subgraph N4["4 · Produire — 04-Applications"]
        D1["04-1 : contenu éducatif"]
        D2["examples/ : cas par domaine"]
    end
    N1 --> N2 --> N3 --> N4
FAQ
gpt-image-1 : qualité et suivi du prompt
gpt-image-1 (notebook 01-1) offre une bonne qualité par défaut mais peut simplifier les détails complexes. Mitigation :
- Structurer le prompt :
style [photographiste/illustration/3D render], sujet [précis], contexte [arrière-plan], éclairage [type]. - Utiliser
size="1536x1024"pour les compositions larges (gpt-image-1 accepte1024x1024/1024x1536/1536x1024/auto),1024x1024pour les portraits. - GPT-5 Image (notebook 01-2) offre un meilleur suivi des instructions détaillées que gpt-image-1.
- Pour un contrôle total, passer en ComfyUI local (niveau 02+).
ComfyUI retourne une erreur 401 ou 502
Les services ComfyUI (ports 8188, 8001, 1111, 17861) tournent dans des conteneurs Docker avec authentification bearer token. Si erreur 401 ou 502 :
# Vérifier les conteneurs actifs
docker ps | grep comfyui

# Redémarrer le service
cd docker-configurations/services/comfyui-qwen && docker-compose restart

# Vérifier le bearer token (drift bcrypt entre container et .env)
# COMFYUI_API_TOKEN (principal) et COMFYUI_AUTH_TOKEN (alias) portent la même valeur
grep -E '^(COMFYUI_API_TOKEN|COMFYUI_AUTH_TOKEN)=' MyIA.AI.Notebooks/GenAI/.env
Les notebooks ont une graceful degradation : sans token, ils basculent vers les API cloud quand c’est possible.
Qwen Image Edit ne modifie pas l’image correctement
Le modèle Qwen Image Edit (notebooks 01-5 et 01-5b) est sensible au format du prompt d’édition. Points critiques :
- L’image source doit être en PNG ou JPEG, résolution <= 1024x1024 pour des résultats optimaux.
- Le prompt d’édition doit être spécifique : “remplacer le texte ‘X’ par ‘Y’” plutôt que “changer le texte”.
- L’architecture Qwen utilise un VAE 16 canaux (non standard SDXL), un scheduler
beta, et CFG 1.0 — ces paramètres sont pré-configurés dans les notebooks, ne pas les modifier sans test.
GPU Out of Memory pendant un notebook ComfyUI
Les modèles image sont gourmands en VRAM. Allocation typique :
| Modèle | VRAM requise | Notebooks |
|---|---|---|
| Qwen Image Edit | ~29 GB | 01-5, 02-1 |
| FLUX.1 | ~24 GB | 02-2 |
| SD XL Turbo | ~10 GB | 01-4 |
| SD 3.5 | ~12 GB | 02-3 |
| Z-Image/Lumina | ~10 GB | 02-4 |
Stratégies si OOM :
- Utiliser les quantizations Nunchaku INT4 ou FP8 pour réduire la VRAM (notebook 03-3).
- Fermer les autres notebooks GPU avant une génération lourde.
- Vérifier avec
nvidia-smiet libérer avectorch.cuda.empty_cache().
Quelle différence entre gpt-image-1, GPT-5 Image et ComfyUI ?
| Critère | gpt-image-1 | GPT-5 Image | ComfyUI (SD/FLUX/Qwen) |
|---|---|---|---|
| Coût | Usage-based (API) | Variable (API) | Gratuit (local) |
| Contrôle | Prompt seul | Prompt + instructions | Nœuds, masques, seeds |
| Édition | Oui (native) | Oui (native) | Oui (inpainting, ControlNet) |
| Qualité | Excellente | Excellente | Excellente (avec réglages) |
| VRAM | 0 (API) | 0 (API) | 10-29 GB |
Pour du prototypage rapide, gpt-image-1 ou GPT-5 Image suffisent. Pour un contrôle fin, une production répétitive, ou des données sensibles, ComfyUI est indispensable.
Licence
Voir la licence du repository principal.
Comment créer un workflow ComfyUI reproductible ?
Un workflow ComfyUI est un graphe JSON de nœuds connectés. Pour le rendre reproductible :
noise_seeddans le nœud KSampler) pour reproduire exactement la même image.