Z-Image utilise l’architecture Lumina-Next-SFT via le wrapper Diffusers pour la generation d’images haute qualite. Ce notebook utilise le node LuminaDiffusersNode qui integre le pipeline HuggingFace Diffusers directement dans ComfyUI.
Architecture
Composant
Details
Pipeline
LuminaPipeline (diffusers 0.34+)
Modèle
Alpha-VLLM/Lumina-Next-SFT-diffusers (~10GB)
VAE
SDXL VAE (sdxl_vae.safetensors)
Resolution
1024x1024 (natif)
Note savante — architecture sous-jacente. Z-Image repose sur la famille Lumina d’Alpha-VLLM, des Flow-based Large Diffusion Transformers :
Lumina-T2X (Gao et al. 2024, arXiv:2405.05945) — rapport technique fondateur du framework unifié text-to-any-modality, architecture Flag-DiT (Flow-matching DiT) avec attention à initialisation nulle.
Lumina-Next (Zhuo et al. 2024, arXiv:2406.18583) — architecture Next-DiT améliorant Flag-DiT, base directe du checkpoint Lumina-Next-SFT-diffusers utilisé ici.
Diffusers (von Platen et al. 2022) — bibliothèque HuggingFace qui fournit le pipeline LuminaPipeline wrappé par le node ComfyUI.
Le VAE SDXL (Kingma & Welling 2013, arXiv:1312.6114) décode l’espace latent 4-channel vers l’espace pixel.
Note sur l’approche GGUF
L’approche GGUF (z_image_turbo + gemma CLIP) a ete abandonnee en raison d’incompatibilites dimensionnelles (2560 vs 2304 entre RecurrentGemma et Gemma-2).
# Verification des dependances externesimport importlib_DEPS_STATUS = {}try: importlib.import_module('PIL') _DEPS_STATUS['PIL'] =TrueexceptImportError: _DEPS_STATUS['PIL'] =Falseprint(f'WARNING: Pillow non installe - pip install Pillow')try: importlib.import_module('requests') _DEPS_STATUS['requests'] =TrueexceptImportError: _DEPS_STATUS['requests'] =Falseprint(f'WARNING: requests non installe - pip install requests')try: importlib.import_module('matplotlib') _DEPS_STATUS['matplotlib'] =TrueexceptImportError: _DEPS_STATUS['matplotlib'] =Falseprint(f'WARNING: matplotlib non installe - pip install matplotlib')try: importlib.import_module('dotenv') _DEPS_STATUS['dotenv'] =TrueexceptImportError: _DEPS_STATUS['dotenv'] =Falseprint(f'WARNING: python-dotenv non installe - pip install python-dotenv')_all_deps_ok =all(_DEPS_STATUS.values())ifnot _all_deps_ok: missing = [k for k, v in _DEPS_STATUS.items() ifnot v]print(f'Dependances manquantes: {missing}')else:print('Toutes les dependances sont disponibles')# 1. Configuration de l'environnementfrom pathlib import Pathimport osimport requestsimport jsonimport timefrom PIL import Imagefrom io import BytesIOfrom dotenv import load_dotenvimport matplotlib.pyplot as plt# Chargement robuste de la configuration .env (Pattern A - Papermill-safe)current_path = Path.cwd()genai_path =None# Remonter jusqu'au dossier GenAIwhilelen(current_path.parts) >1:if current_path.name =="GenAI": genai_path = current_pathbreak current_path = current_path.parentif genai_path: env_path = genai_path /".env"if env_path.exists(): load_dotenv(env_path)print(f".env charge depuis: {env_path.name}")else:print("WARNING: .env non trouve dans GenAI")else:print("WARNING: Dossier GenAI non trouve")# URL du serveur ComfyUI (par defaut: service myia.io pour etudiants)COMFYUI_URL = os.getenv("COMFYUI_API_URL", "https://qwen-image-edit.myia.io")COMFYUI_TOKEN = os.getenv("COMFYUI_AUTH_TOKEN") or os.getenv("COMFYUI_API_TOKEN")ifnot COMFYUI_TOKEN:print("WARNING: COMFYUI_AUTH_TOKEN non defini")HEADERS = {"Authorization": f"Bearer {COMFYUI_TOKEN}"}print("Configuration chargee")print(f"Target URL: {COMFYUI_URL}")
Toutes les dependances sont disponibles
.env charge depuis: .env
Configuration chargee
Target URL: http://127.0.0.1:8188
L’environnement est configure et la connexion a l’API ComfyUI Z-Image verifiee. La cellule suivante construit le workflow JSON avec le node LuminaDiffusersNode et ses paramètres de generation (steps, guidance_scale, resolution).
# 2. Definition du Workflow Z-Image (Diffusers)# Ce workflow utilise LuminaDiffusersNode qui telecharge automatiquement# le modele depuis HuggingFace (Alpha-VLLM/Lumina-Next-SFT-diffusers)def create_zimage_workflow(prompt: str, negative_prompt: str="blurry, low quality, text, watermark", width: int=1024, height: int=1024, steps: int=30, guidance: float=4.0, seed: int=None) ->dict:""" Cree un workflow Z-Image avec le wrapper Diffusers. Args: prompt: Description de l'image a generer negative_prompt: Elements a eviter width/height: Dimensions (1024x1024 recommande) steps: Etapes de diffusion (20-40 optimal) guidance: Guidance scale (3-5 optimal pour Lumina) seed: Graine pour reproductibilite (-1 = aleatoire) Returns: Workflow JSON pret pour ComfyUI """if seed isNone: seed =-1# -1 = random dans LuminaDiffusersNodereturn {# LuminaDiffusersNode - Le coeur de la generation# Note: Le node gere en interne la resolution via le scheduler"1": {"class_type": "LuminaDiffusersNode","inputs": {"model_path": "Alpha-VLLM/Lumina-Next-SFT-diffusers","prompt": prompt,"negative_prompt": negative_prompt,"num_inference_steps": steps,"guidance_scale": guidance,"seed": seed,"batch_size": 1,"scaling_watershed": 0.3,"proportional_attn": True,"clean_caption": True,"max_sequence_length": 256,"use_time_shift": False,"t_shift": 4,"strength": 1.0 } },# VAELoader - SDXL VAE pour le decodage"2": {"class_type": "VAELoader","inputs": {"vae_name": "sdxl_vae.safetensors" } },# VAEDecode - Conversion latent vers image"3": {"class_type": "VAEDecode","inputs": {"samples": ["1", 0],"vae": ["2", 0] } },# SaveImage - Sauvegarde du resultat"4": {"class_type": "SaveImage","inputs": {"filename_prefix": "Z-Image-Lumina","images": ["3", 0] } } }# Workflow de test basiquez_image_workflow = create_zimage_workflow( prompt="A vibrant sunset over a mountain lake, reflection in water, photorealistic", steps=20, guidance=4.0, seed=42)print("Workflow Z-Image (Diffusers) defini")print(" - Node principal: LuminaDiffusersNode")print(" - Modele: Alpha-VLLM/Lumina-Next-SFT-diffusers")print(" - VAE: SDXL")print(" - Output node: '4'")
Exercice 1 : Workflow personnalise avec paramètres avances
La fonction create_zimage_workflow() accepte des paramètres avances comme scaling_watershed et proportional_attn. Ces paramètres influencent la saturation et la coherence spatiale de l’image generee.
Objectif : Créer un workflow personnalise en modifiant les paramètres avances de create_zimage_workflow() et observer l’impact sur le rendu final.
Indices : - # Étape 1 : Generer une image de reference avec les paramètres par defaut (scaling_watershed=0.3, proportional_attn=True) - # Étape 2 : Generer une seconde image avec scaling_watershed=0.0 (desaturation desactivee) - # Étape 3 : Generer une troisieme image avec proportional_attn=False - # Étape 4 : Comparer les 3 résultats pour identifier l’impact de chaque paramètre - # Indice : Modifiez directement les valeurs dans le dictionnaire retourne par create_zimage_workflow() ou créez votre propre fonction
# Exercice 3 : Workflow personnalise avec parametres avances# TODO etudiant : comparer l'impact de scaling_watershed et proportional_attntest_prompt =None# TODO etudiant : definir un prompt avec des couleurs variees# TODO etude 1 : generer avec parametres par defaut (scaling_watershed=0.3)# wf_default = create_zimage_workflow(prompt=test_prompt, seed=42)# img_default = generate_z_image(test_prompt, seed=42)# TODO etude 2 : modifier scaling_watershed dans le workflow# wf_custom = create_zimage_workflow(prompt=test_prompt, seed=42)# wf_custom["1"]["inputs"]["scaling_watershed"] = 0.0# TODO etudiant : comparer et afficher les resultatsprint("Exercice a completer")
Exercice a completer
Le workflow ComfyUI pour Z-Image est construit avec le node LuminaDiffusersNode. La cellule suivante encapsule la logique de soumission et de recuperation des résultats dans une fonction utilitaire.
# 3. Fonction de Generation Helperdef generate_z_image(prompt, seed=None, steps=20, guidance=4.0, width=1024, height=1024):""" Genere une image avec Z-Image (Lumina Diffusers). Args: prompt: Description de l'image seed: Graine pour reproductibilite (None/-1 = aleatoire) steps: Nombre d'etapes (20-40 recommande) guidance: Guidance scale (3-5 recommande) width/height: Dimensions Returns: PIL.Image ou None en cas d'erreur """if seed isNone: seed =-1# Creer le workflow workflow = create_zimage_workflow( prompt=prompt, seed=seed, steps=steps, guidance=guidance, width=width, height=height ) payload = {"prompt": workflow}print(f"Envoi de la requete... (Seed: {seed})")try: resp = requests.post(f"{COMFYUI_URL}/prompt", json=payload, headers=HEADERS, timeout=30)except requests.exceptions.ConnectionError:print(f"SERVICE INDISPONIBLE: Serveur ComfyUI inaccessible a {COMFYUI_URL}")print("Le service doit etre demarre pour generer des images.")returnNoneexcept requests.exceptions.Timeout:print(f"TIMEOUT: Le serveur ComfyUI ne repond pas ({COMFYUI_URL})")returnNoneif resp.status_code !=200:print(f"Erreur API ({resp.status_code}): {resp.text[:200]}")returnNone prompt_id = resp.json()["prompt_id"]print(f"Tache ID: {prompt_id}")print("Generation en cours (premiere execution peut prendre plusieurs minutes pour telecharger le modele)...")# Polling avec timeout etendu (premier run telecharge ~10GB) max_wait =600# 10 minutes pour le premier run start_time = time.time()while time.time() - start_time < max_wait:try: history_resp = requests.get(f"{COMFYUI_URL}/history/{prompt_id}", headers=HEADERS, timeout=10)except requests.exceptions.RequestException: time.sleep(2)continueif history_resp.status_code ==200: history_data = history_resp.json()if prompt_id in history_data: prompt_data = history_data[prompt_id] status = prompt_data.get('status', {})if status.get('completed'): elapsed = time.time() - start_timeprint(f"Generation terminee en {elapsed:.1f}s")# Recuperation image (node 4 = SaveImage) outputs = prompt_data.get('outputs', {})if'4'in outputs and'images'in outputs['4']: output_data = outputs['4']['images'][0] filename = output_data['filename'] subfolder = output_data.get('subfolder', '') img_type = output_data.get('type', 'output') img_url =f"{COMFYUI_URL}/view?filename={filename}&subfolder={subfolder}&type={img_type}" img_resp = requests.get(img_url, headers=HEADERS)if img_resp.status_code ==200:return Image.open(BytesIO(img_resp.content))print("Pas d'image dans les outputs")returnNoneif status.get('status_str') =='error':print(f"Erreur: {status.get('messages', 'Unknown')}")returnNone time.sleep(2)print(f"Timeout apres {max_wait}s")returnNone
Exercice 2 : Comparaison de styles par prompt engineering
Le même sujet peut etre interprete dans des styles visuels très différents selon le prompt. Z-Image (Lumina) repond bien aux mots-cles de style (photorealistic, watercolor, anime, etc.).
Objectif : Generer 4 images du même sujet dans des styles différents et afficher une grille comparative.
Indices : - # Étape 1 : Choisir un sujet neutre (ex: “a ancient tree in a mystical forest”) - # Étape 2 : Créer 4 prompts en ajoutant des suffixes de style différents - # Étape 3 : Appeler generate_z_image() pour chaque prompt avec le même seed - # Étape 4 : Afficher les 4 résultats dans une grille 2x2 avec plt.subplots(2, 2) - # Indice : Utilisez guidance=4.0 et steps=20 pour un bon compromis qualite/vitesse
# Exercice 2 : Comparaison de styles par prompt engineering# TODO etudiant : generer 4 images du meme sujet dans des styles differentsbase_subject =None# TODO etudiant : definir un sujet (ex: "a lighthouse on a cliff")style_suffixes =None# TODO etudiant : definir 4 suffixes de style# TODO etudiant : boucler sur les styles et generer chaque image# for i, suffix in enumerate(style_suffixes):# prompt = f"{base_subject}, {suffix}"# img = generate_z_image(prompt, seed=42, guidance=4.0, steps=20)# TODO etudiant : afficher les 4 images dans une grille 2x2print("Exercice a completer")
Exercice a completer
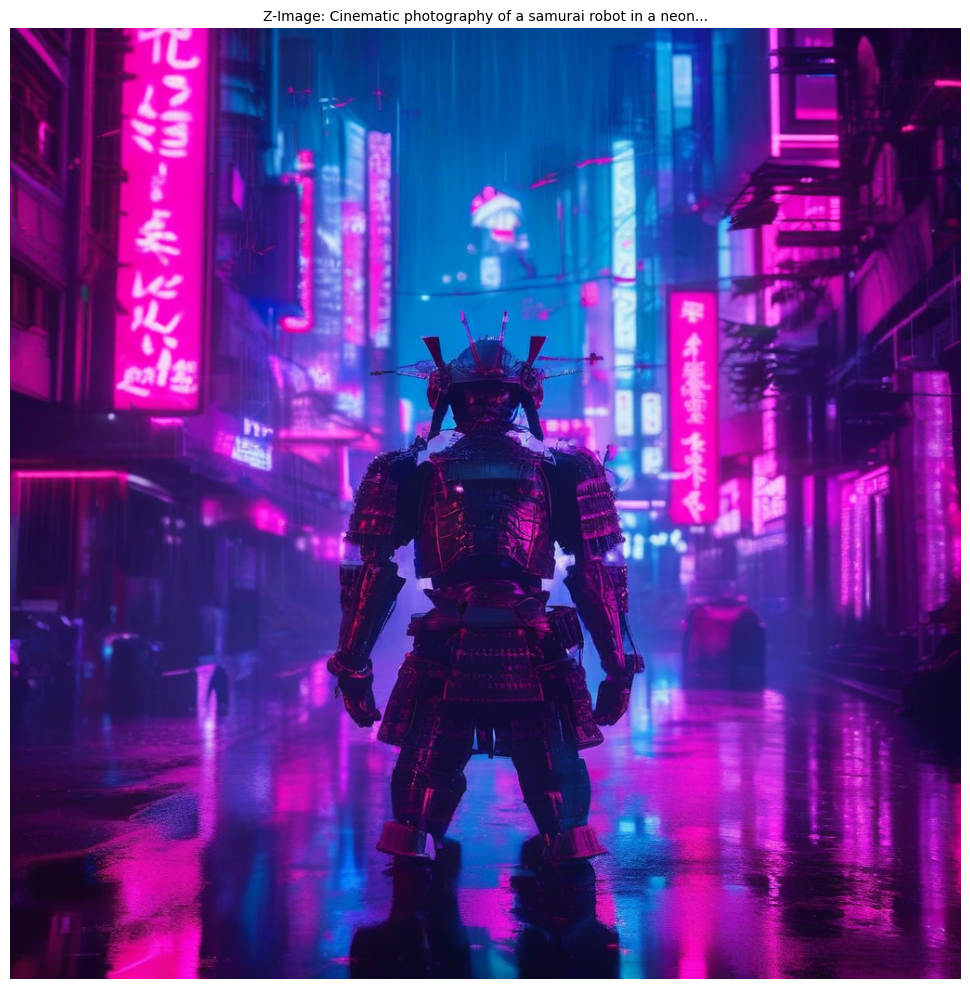
La fonction de generation est définie. La cellule suivante lance le test effectif en soumettant un prompt a Z-Image via l’API ComfyUI et en affichant l’image produite.
# 4. Test de Generation# Note: La premiere execution telecharge le modele (~10GB), prevoir 5-10 minutesprompt ="Cinematic photography of a samurai robot in a neon cyberpunk city, raining, reflections, 8k, highly detailed"print("Lancement de la generation Z-Image (Lumina Diffusers)...")print(f"Prompt: {prompt}")print("\nNote: Le premier lancement telecharge le modele (~10GB)")image = generate_z_image(prompt, seed=42, steps=20, guidance=4.0)if image: plt.figure(figsize=(10, 10)) plt.imshow(image) plt.title(f"Z-Image: {prompt[:50]}...", fontsize=10) plt.axis("off") plt.tight_layout() plt.show()print(f"\nImage generee: {image.size[0]}x{image.size[1]}")else:print("\nEchec de la generation. Verifiez:")print(" 1. Le service ComfyUI est actif")print(" 2. Le node LuminaDiffusersNode est installe")print(" 3. Le VAE SDXL est present dans models/vae/")
Lancement de la generation Z-Image (Lumina Diffusers)...
Prompt: Cinematic photography of a samurai robot in a neon cyberpunk city, raining, reflections, 8k, highly detailed

Note: Le premier lancement telecharge le modele (~10GB)
Envoi de la requete... (Seed: 42)
Tache ID: ab1c3d8c-a159-483e-b7d3-55e4dfbc923c
Generation en cours (premiere execution peut prendre plusieurs minutes pour telecharger le modele)...
Generation terminee en 108.8s
Image generee: 1024x1024
Exercice 3 : Exploration du paramètre guidance
Le paramètre guidance contrôle l’adherence du modèle au prompt textuel. Une valeur basse (2.0) permet plus de liberte creative, tandis qu’une valeur haute (6.0) suit le prompt plus fidelement mais peut sur-saturer les couleurs.
Objectif : Generer une image avec 3 valeurs de guidance différentes (2.0, 4.0, 6.0) et observer l’impact sur la fidelite au prompt et la qualite visuelle.
Indices : - # Étape 1 : Choisir un prompt descriptif riche (ex: scene naturelle avec details) - # Étape 2 : Appeler generate_z_image() avec le même seed mais différentes valeurs de guidance - # Étape 3 : Afficher les 3 résultats cote a cote avec plt.subplots pour comparer - # Indice : Utilisez seed=42 fixe pour isoler l’effet du guidance
# Exercice 1 : Exploration du parametre guidance# TODO etudiant : generer 3 images avec guidance=2.0, 4.0 et 6.0guidance_prompt =None# TODO etudiant : definir un prompt descriptifguidance_values = [2.0, 4.0, 6.0]guidance_results = []for g in guidance_values:pass# TODO etudiant : appeler generate_z_image avec guidance=g, seed=42# TODO etudiant : afficher les 3 resultats avec plt.subplotsprint("Exercice a completer")
Exercice a completer
Recapitulatif des Exercices
Les exercices pratiques sont repartis dans le notebook aux endroits stratégiques :
Exercice
Section
Concept
Placement
Exercice 1
Après le test de generation
Exploration du paramètre guidance
Après demo samurai robot
Exercice 2
Après la fonction helper
Comparaison de styles par prompt engineering
Après definition workflow
Exercice 3
Après la definition du workflow
Workflow personnalise avec paramètres avances
Après create_zimage_workflow
Chaque exercice est precede d’un bloc markdown avec les objectifs et indices, suivi d’une cellule de code a completer.
Notes Techniques
Paramètres recommandes
Paramètre
Plage
Recommande
Impact
steps
15-50
20-30
Qualite vs vitesse
guidance
2-7
3-5
Fidelite au prompt
scaling_watershed
0.0-1.0
0.3
Reduction saturation
Différences avec Qwen
Lumina/Z-Image: Generation text-to-image de haute qualite, meilleur pour scenes complexes
Qwen: Specialise dans l’edition d’images existantes, image-to-image
Lumina utilise un VAE 4-channel SDXL, Qwen utilise un VAE 16-channel
Premier lancement
Le premier lancement telecharge automatiquement le modèle (~10GB) depuis HuggingFace. Cela peut prendre 5-10 minutes selon votre connexion.
Fix technique (Janvier 2025)
Le node LuminaDiffusersNode a ete mis a jour pour utiliser LuminaPipeline au lieu de LuminaText2ImgPipeline (renomme dans diffusers 0.34+).
Références savantes
Gao, S., Zhou, P., Cheng, M.-M., et al. (2024). Lumina-T2X: Transforming Text into Any Modality, Resolution, and Duration via Flow-based Large Diffusion Transformers. arXiv:2405.05945. — Framework fondateur Flag-DiT dont dérive la famille Lumina.
Zhuo, L., Du, R., Han, X., Li, Y., et al. (2024). Lumina-Next: Making Lumina-T2X Stronger and Faster with Next-DiT. arXiv:2406.18583. — Architecture Next-DiT, base du checkpoint Lumina-Next-SFT-diffusers.
von Platen, P., Patil, S., Lozhkov, A., et al. (2022). Diffusers: State-of-the-art diffusion models. HuggingFace (logiciel). — Bibliothèque fournissant le pipeline LuminaPipeline.
Z-Image exploite la famille Lumina d’Alpha-VLLM, des Flow-based Large Diffusion Transformers (Lumina-T2X, Lumina-Next) entraînés avec l’objectif Flow Matching. Le pipeline est encapsulé par le node ComfyUI LuminaDiffusersNode qui télécharge automatiquement le checkpoint Alpha-VLLM/Lumina-Next-SFT-diffusers (~10 GB) depuis HuggingFace au premier lancement.
Architecture à comprendre : VAE SDXL (4 canaux, pas 16 comme Qwen), scheduler interne au pipeline Diffusers, paramètres spécifiques (scaling_watershed=0.3 pour la désaturation contrôlée, proportional_attn=True pour la cohérence spatiale, clean_caption=True pour le prétraitement du prompt). Ces réglages sont les Successeurs directs des travaux Flag-DiT → Next-DiT de Gao et Zhuo et al. (2024).
Leçon technique : la voie GGUF (quantization z_image_turbo + Gemma CLIP) a été abandonnée en raison d’une incompatibilité dimensionnelle (2560 vs 2304) entre RecurrentGemma et Gemma-2. C’est un cas concret de la règle F : on ne contourne pas un défaut d’architecture, on revient au chemin supporté. Le wrapper Diffusers est plus lent au premier chargement (téléchargement du modèle) mais évite les écueils de quantization.
Différenciation par rapport aux autres notebooks 02-Advanced : Lumina est un excellent généraliste (text-to-image de scènes complexes), tandis que Qwen-Image-Edit est spécialisé dans l’édition d’image existante et FLUX dans la fidélité prompt + génération de texte. Cette complémentarité se reflète dans les pipelines de 03-Orchestration.
Pour aller plus loin : 03-1-Multi-Model-Comparison met en regard Lumina, Qwen, FLUX et SD 3.5 sur des critères objectifs (fidélité prompt, cohérence spatiale, vitesse, gestion du texte). Le notebook illustre la complémentarité des modèles et justifie une approche multi-modèles pour les applications de production.