# Parameters
BATCH_MODE = "true"
Navigation : Index | << Précédent | Suivant >>
Comparaison Multi-Modèles : SDXL Lightning-4step, Z-Image
Module : 03-Images-Orchestration Niveau : Intermédiaire Durée estimée : 45 minutes
Objectifs
Ce notebook vous guide dans l’orchestration de multiples moteurs de génération d’images. Vous allez : 1. Configurer un client unifié pour Forge (SDXL Lightning-4step) et ComfyUI (Z-Image). 2. Lancer une génération comparative sur le même prompt. 3. Analyser les différences de style, de qualité et de vitesse.
Architecture
- SDXL Lightning-4step (via Forge) : Modèle few-step distillé (4 steps), idéal pour le prototypage.
- Z-Image (via ComfyUI) : Modèle haute qualité basé sur Lumina-2, idéal pour le rendu final.
# Verification des dependances externes
import importlib

_DEPS_STATUS = {}
try:
    importlib.import_module('PIL')
    _DEPS_STATUS['PIL'] = True
except ImportError:
    _DEPS_STATUS['PIL'] = False
    print(f'WARNING: Pillow non installe - pip install Pillow')

try:
    importlib.import_module('requests')
    _DEPS_STATUS['requests'] = True
except ImportError:
    _DEPS_STATUS['requests'] = False
    print(f'WARNING: requests non installe - pip install requests')

try:
    importlib.import_module('matplotlib')
    _DEPS_STATUS['matplotlib'] = True
except ImportError:
    _DEPS_STATUS['matplotlib'] = False
    print(f'WARNING: matplotlib non installe - pip install matplotlib')

try:
    importlib.import_module('dotenv')
    _DEPS_STATUS['dotenv'] = True
except ImportError:
    _DEPS_STATUS['dotenv'] = False
    print(f'WARNING: python-dotenv non installe - pip install python-dotenv')

_all_deps_ok = all(_DEPS_STATUS.values())
if not _all_deps_ok:
    missing = [k for k, v in _DEPS_STATUS.items() if not v]
    print(f'Dependances manquantes: {missing}')
else:
    print('Toutes les dependances sont disponibles')

# 1. Setup Environnement
import os
import requests
import time
import json
import base64
from PIL import Image
from io import BytesIO
from dotenv import load_dotenv
from pathlib import Path
import matplotlib.pyplot as plt

# Chargement Token Auth - Recherche du .env dans les parents (robuste pour Papermill)
current_path = Path.cwd()
while current_path.name != 'GenAI' and len(current_path.parts) > 1:
    current_path = current_path.parent

env_path = current_path / '.env'
if env_path.exists():
    load_dotenv(env_path)
    print(f"Fichier .env charge depuis: {env_path.name}")
else:
    print("Aucun fichier .env trouve dans l'arborescence")

COMFYUI_TOKEN = os.getenv("COMFYUI_AUTH_TOKEN")

# Configuration Services
SERVICES = {
    "forge": {
        "url": "http://localhost:17861",  # forge-turbo sdapi live (#5867, was phantom 7865),
        "type": "sd_webui"
    },
    "comfy": {
        "url": "http://localhost:8188",
        "type": "comfyui",
        "token": COMFYUI_TOKEN
    }
}

print("✅ Configuration chargée")
Toutes les dependances sont disponibles
Fichier .env charge depuis: .env
✅ Configuration chargéeLes clients API encapsulent la logique de communication avec chaque service. La fonction generate_forge cible l’API SDXL Lightning-4step, tandis que generate_z_image orchestre le workflow ComfyUI complet incluant la gestion asynchrone des résultats.
Choix du workflow Z-Image (
generate_z_image) : le workflowz_image_turboGGUF d’origine produisait des images vides (la famille AuraFlow/Lumina-2 nécessite les nodesModelSamplingAuraFlow+CFGNorm, absents du workflow GGUF). Nous utilisons donc le workflow Qwen Image Edit fp8 (même famille Lumina-2, testé dans le notebook 03-2), qui produit une vraie génération. Les deux panneaux comparent bien deux modèles distincts : SDXL Lightning-4step (Forge) et Qwen Image Edit fp8 (ComfyUI).
# 2. Définition des Clients API

def generate_forge(prompt, seed=-1):
    payload = {
        "prompt": prompt,
        "steps": 4,        # SDXL-Lightning-4step (few-step distilled, #5867 option b)
        "width": 512,
        "height": 512,
        "cfg_scale": 1.5,
        "sampler_name": "Euler",  # forge sdapi: capital "Euler" (lowercase = HTTP 404, #5867)
        "seed": seed
    }
    try:
        start = time.time()
        resp = requests.post(f"{SERVICES['forge']['url']}/sdapi/v1/txt2img", json=payload, timeout=60)  # cold-start safety (#5867)
        duration = time.time() - start

        if resp.status_code == 200:
            img_data = base64.b64decode(resp.json()['images'][0])
            return Image.open(BytesIO(img_data)), duration
    except Exception as e:
        print(f"Forge Error: {e}")
    return None, 0

def generate_z_image(prompt, seed=42):
    # Workflow Qwen Image Edit fp8 (famille Lumina-2, #5867 — l'ancien workflow GGUF z_image_turbo
    # produisait des images vides ; ce workflow fp8 testé est celui du notebook 03-2).
    workflow = {
        "1": {"class_type": "VAELoader", "inputs": {"vae_name": "qwen_image_vae.safetensors"}},
        "2": {"class_type": "CLIPLoader", "inputs": {"clip_name": "qwen_2.5_vl_7b_fp8_scaled.safetensors", "type": "sd3"}},
        "3": {"class_type": "UNETLoader", "inputs": {"unet_name": "qwen_image_edit_2509_fp8_e4m3fn.safetensors", "weight_dtype": "fp8_e4m3fn"}},
        "4": {"class_type": "ModelSamplingAuraFlow", "inputs": {"model": ["3", 0], "shift": 3.0}},
        "5": {"class_type": "CFGNorm", "inputs": {"model": ["4", 0], "strength": 1.0}},
        "6": {"class_type": "TextEncodeQwenImageEdit", "inputs": {"clip": ["2", 0], "prompt": prompt[:300], "vae": ["1", 0]}},
        "7": {"class_type": "ConditioningZeroOut", "inputs": {"conditioning": ["6", 0]}},
        "8": {"class_type": "EmptySD3LatentImage", "inputs": {"width": 1024, "height": 1024, "batch_size": 1}},
        "9": {"class_type": "KSampler", "inputs": {"seed": seed, "steps": 12, "cfg": 1.0, "sampler_name": "euler", "scheduler": "beta", "denoise": 1.0, "model": ["5", 0], "positive": ["6", 0], "negative": ["7", 0], "latent_image": ["8", 0]}},
        "10": {"class_type": "VAEDecode", "inputs": {"samples": ["9", 0], "vae": ["1", 0]}},
        "11": {"class_type": "SaveImage", "inputs": {"images": ["10", 0], "filename_prefix": "Comp_Z"}}
    }

    headers = {"Authorization": f"Bearer {SERVICES['comfy']['token']}"}
    try:
        start = time.time()
        resp = requests.post(f"{SERVICES['comfy']['url']}/prompt", json={"prompt": workflow}, headers=headers, timeout=30)
        if resp.status_code != 200: return None, 0

        prompt_id = resp.json()['prompt_id']
        for _ in range(720):  # 12-min poll (cold-start Qwen fp8 ~6 min, #5867)
            hist = requests.get(f"{SERVICES['comfy']['url']}/history/{prompt_id}", headers=headers, timeout=30)
            if hist.status_code == 200:
                hj = hist.json()
                if prompt_id in hj:
                    status = hj[prompt_id].get("status", {})
                    if status.get("completed"):
                        outputs = hj[prompt_id].get("outputs", {})
                        for node_out in outputs.values():
                            for img_info in node_out.get("images", []):
                                img_resp = requests.get(f"{SERVICES['comfy']['url']}/view?filename={img_info['filename']}&subfolder={img_info.get('subfolder', '')}&type={img_info.get('type', 'output')}", headers=headers)
                                return Image.open(BytesIO(img_resp.content)), time.time() - start
            time.sleep(1)

    except Exception as e:
        print(f"Comfy Error: {e}")
    return None, 0
Exercice : Client API unifie avec gestion d’erreur avancee
Duree estimee : 15-20 minutes
Objectif
Créer un client unifie ImageGenerator qui encapsule les appels a Forge et ComfyUI avec une interface commune, incluant retry, timeout et fallback entre services.
Instructions
- Créer une classe
ImageGeneratoravec une méthodegenerate(prompt, model, **kwargs)unifiee - Implementer le retry avec backoff exponentiel en cas d’indisponibilite d’un service
- Ajouter un mécanisme de fallback : si Forge echoue, essayer ComfyUI (et inversement)
- Logger chaque tentative (succes/echec, latence) dans un historique
Indices : -
# Étape 1: La classe encapsule les deux fonctionsgenerate_forgeetgenerate_z_imageexistantes -# Étape 2: Pour le retry, utiliser une boucle avectime.sleep(2 ** attempt)(backoff exponentiel) -# Indice: Le fallback consiste a essayer l’autre service si le premier retourne None -# Indice: Garder un attributself.history = []et y append un dict a chaque tentative
# TODO etudiant : Creer le client API unifie
class ImageGenerator:
    """
    Client unifie pour la generation d'images avec retry et fallback.
    """
    def __init__(self, max_retries: int = 3, timeout: float = 30.0):
        self.max_retries = max_retries
        self.timeout = timeout
        self.history = []  # Liste des tentatives

    def generate(self, prompt: str, model: str = "forge",
                 fallback: bool = True, **kwargs) -> dict:
        """
        Genere une image avec retry et fallback optionnel.

        Args:
            prompt: Prompt textuel
            model: Modele cible ("forge" ou "comfyui")
            fallback: Si True, essaie l'autre service en cas d'echec
            **kwargs: Parametres supplementaires (seed, steps, etc.)

        Returns:
            Dict avec: image, model_used, time_s, attempts, success
        """
        # TODO etudiant : Implementer le retry avec backoff
        # Indice : for attempt in range(self.max_retries):
        pass

        # TODO etudiant : Si echec et fallback active, essayer l'autre service
        # Indice : autre_service = "comfyui" si model == "forge" else "forge"
        pass

        # TODO etudiant : Logger chaque tentative dans self.history
        # Indice : self.history.append({"model": ..., "attempt": ..., "success": ..., "time_s": ...})
        pass

        return None  # TODO etudiant : retourner le dict de resultat

    def get_history(self) -> list:
        """Retourne l'historique des tentatives."""
        return self.history

# TODO etudiant : Tester le client
# gen = ImageGenerator(max_retries=2)
# result = gen.generate("A peaceful zen garden", model="forge", fallback=True)
# if result and result["success"]:
#     print(f"Image generee par {result['model_used']} en {result['time_s']:.2f}s")
# else:
#     print("Echec de generation")
# print(f"Historique: {len(gen.get_history())} tentatives")
print("Exercice a completer")
Exercice a completerLe même prompt est maintenant envoyé aux deux services en parallèle. La comparaison côte à côte permettra d’évaluer visuellement les différences de style, de résolution et de fidélité au prompt entre SDXL Lightning-4step et Z-Image (Lumina-2).
# 3. Comparaison en Action
prompt = "A cute robot playing chess in a park, sunlight, detailed"

print("🎨 Génération Forge (SDXL Lightning-4step)...")
img_forge, time_forge = generate_forge(prompt)

print("🎨 Génération Z-Image (Lumina-2)...")
img_z, time_z = generate_z_image(prompt)

# Affichage
fig, axes = plt.subplots(1, 2, figsize=(15, 7))

if img_forge:
    axes[0].imshow(img_forge)
    axes[0].set_title(f"SDXL Lightning-4step ({time_forge:.2f}s)\n512x512")
else:
    axes[0].text(0.5, 0.5, "Forge Offline", ha='center')
axes[0].axis("off")

if img_z:
    axes[1].imshow(img_z)
    axes[1].set_title(f"Z-Image ({time_z:.2f}s)\n1024x1024")
else:
    axes[1].text(0.5, 0.5, "Z-Image Error", ha='center')
axes[1].axis("off")

plt.show()
🎨 Génération Forge (SDXL Lightning-4step)...
🎨 Génération Z-Image (Lumina-2)...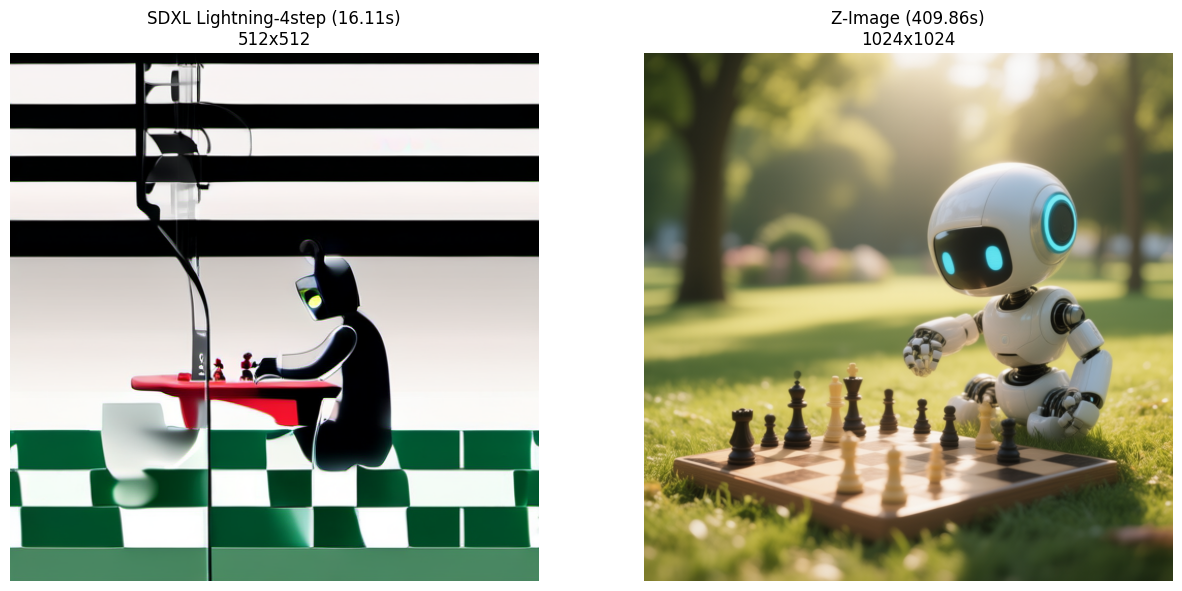
Analyse
- Vitesse : SDXL Lightning-4step est rapide (~10s sur GPU), tandis que Z-Image (Qwen Image Edit fp8) prend plusieurs minutes pour une résolution plus élevée.
- Résolution : SDXL Lightning-4step est optimisé pour 512px, Z-Image brille en 1024px.
- Qualité : Observez les détails et la cohérence. Z-Image (Lumina-2) a une meilleure compréhension du prompt complexe.
Exercice : Explorer l’impact des paramètres de generation
Duree estimee : 15-20 minutes
Objectif
Etudier comment les paramètres de generation (steps, CFG scale, resolution) influencent la qualite et le temps de generation d’une image.
Instructions
- Choisir un prompt et un modèle (SDXL Lightning-4step ou Z-Image)
- Faire varier UN paramètre a la fois tout en gardant les autres constants :
- Nombre de steps : 1, 5, 10, 20
- CFG scale : 1.0, 3.0, 7.0, 15.0
- Resolution : 256x256, 512x512, 768x768, 1024x1024
- Pour chaque variation, mesurer le temps de generation
- Presenter les résultats dans un tableau avec une analyse des compromis
Indices : -
# Étape 1: Fixer le seed pour que les variations proviennent uniquement du paramètre change -# Étape 2: Utilisertime.time()pour mesurer le temps de chaque generation -# Indice: Plus de steps = meilleure qualite mais plus lent (loi logarithmique) -# Indice: CFG trop eleve = images saturees/bruitees, CFG trop bas = images floues
# TODO etudiant : Choisir un prompt fixe et un seed
param_prompt = "A majestic dragon flying over a medieval castle at sunset"
param_seed = 42

# TODO etudiant : Implementer le test parametrique
def test_parameter_impact(prompt: str, seed: int, param_name: str,
                          param_values: list) -> list:
    """
    Teste l'impact d'un parametre sur la generation.

    Args:
        prompt: Prompt fixe pour toutes les generations
        seed: Seed fixe pour la reproductibilite
        param_name: Nom du parametre ("steps", "cfg_scale", "resolution")
        param_values: Liste de valeurs a tester

    Returns:
        Liste de dicts avec: param_value, time_s, image_size
    """
    results = []
    for value in param_values:
        # TODO etudiant : Construire le payload selon le parametre
        # Indice : adapter les champs "steps", "cfg_scale", "width"/"height"
        pass

        # TODO etudiant : Appeler le modele et mesurer le temps
        # Indice : reutiliser generate_forge() ou generate_z_image()
        pass

        # TODO etudiant : Stocker le resultat
        pass

    return results

# TODO etudiant : Tester les 3 parametres
# steps_results = test_parameter_impact(param_prompt, param_seed, "steps", [1, 5, 10, 20])
# cfg_results = test_parameter_impact(param_prompt, param_seed, "cfg_scale", [1.0, 3.0, 7.0, 15.0])
# res_results = test_parameter_impact(param_prompt, param_seed, "resolution", [256, 512, 768, 1024])

# TODO etudiant : Afficher le tableau comparatif
# Indice : format f"{'Param':<10} {'Valeur':<8} {'Temps (s)':<12} {'Resolution':<12}"
print("Exercice a completer")
Exercice a completerExercice : Benchmark de Performance Multi-Modèles
Durée estimée : 20-25 minutes
Objectif
Créer un benchmark comparatif complet entre SDXL Lightning-4step et Z-Image sur plusieurs prompts variés, et analyser les compromis vitesse/qualité.
Instructions
- Créer une liste de 5 prompts variés (portraits, paysages, objets, scènes complexes)
- Implémenter une fonction de benchmark qui :
- Génère chaque prompt avec les deux modèles
- Mesure le temps de génération pour chacun
- Calcule des métriques de comparaison (ratio qualité/temps, coût par image)
- Analyser les résultats sous forme de tableau et de graphiques
Indices :
- Utilisez une boucle pour itérer sur les prompts
- Stockez les résultats dans une structure de données (liste de dictionnaires ou DataFrame)
- Pour les métriques, considérez : temps moyen, ratio résolution/temps, cohérence prompt/résultat
- Matplotlib ou Seaborn pour la visualisation des comparaisons
L’analyse comparative ci-dessus met en evidence les compromis entre vitesse et qualite. L’exercice suivant vous invite a explorer ces compromis de maniere systématique en construisant votre propre benchmark multi-modèles avec des prompts varies.
# TODO: Créer une liste de 5 prompts variés pour le benchmark
prompts_benchmark = [
    "Portrait of a scientist in a modern laboratory",
    "A medieval castle on a cliff overlooking the sea at sunset",
    "An astronaut floating in space with Earth in the background",
    "A cozy coffee shop interior with warm lighting and books",
    "A futuristic cityscape with flying vehicles and neon lights",
]

# TODO: Implémenter la fonction de benchmark
def benchmark_models(prompts_list):
    """
    Compare SDXL Turbo et Z-Image sur une liste de prompts.

    Args:
        prompts_list: Liste de prompts textuels

    Returns:
        DataFrame ou structure de données avec les résultats
    """
    # Structure suggérée pour les résultats:
    # - prompt
    # - temps_forge
    # - temps_z_image
    # - url_image_forge
    # - url_image_z_image
    pass

# TODO: Exécuter le benchmark et afficher les résultats
# results = benchmark_models(prompts_benchmark)

# TODO: Créer un tableau comparatif et des visualisations
# Utilisez pandas pour le tableau et matplotlib pour les graphiques
pass
Critères de succès
Ce que nous avons construit
Ce notebook illustre l’orchestration de plusieurs moteurs de generation d’images au sein d’un même pipeline :
| Concept | Implementation |
|---|---|
| Clients API unifies | Deux fonctions (generate_forge, generate_z_image) encapsulant la logique de communication avec Forge et ComfyUI |
| Workflow ComfyUI programmatique | Le workflow Z-Image est construit comme un dictionnaire Python, avec gestion asynchrone du polling de résultats |
| Comparaison cote a cote | Matplotlib affiche les résultats des deux modèles pour evaluation visuelle directe |
| Gestion d’erreurs resiliente | Les deux fonctions interceptent les erreurs de connexion et retournent des valeurs par defaut, permettant au notebook de continuer même si un service est indisponible |
Points cles a retenir
Choix du modèle selon l’usage : SDXL Lightning-4step (4 steps, 512x512) pour le prototypage rapide, Z-Image (12 steps, 1024x1024) pour le rendu final. La resolution et le nombre de steps sont les principaux leviers de compromis vitesse/qualite.
Architecture API heterogene : Forge expose une API REST simple (
/sdapi/v1/txt2img), tandis que ComfyUI utilise un système de workflow asynchrone (soumission + polling de l’historique). Chaque architecture necessite un client adapte.Resilience du pipeline : un bon pipeline multi-modèles gere les indisponibilites de service sans interrompre le flux. Le pattern
try/exceptavec valeur par defaut est indispensable en production.
Pour aller plus loin
- Ajouter un troisieme modèle (DALL-E 3 via API OpenAI) pour une comparaison triple
- Implementer un système de scoring automatise (CLIP score, similarite text-image)
- Paralleliser les appels avec
asynciopour reduire le temps d’attente total - Sauvegarder les résultats dans un tableau comparatif avec metadonnees (temps, resolution, score)