Bonsai-Image : Generation Text-to-Image avec Quantization Ternaire 1.58-bit
Module : 02-Images-Advanced Niveau : Avance Duree estimee : 45 minutes Statut : BETA (scaffold + théorie + generation API ComfyUI fonctionnelle ; exercices a completer) Issue de reference :#1613
Vue d’ensemble
Bonsai-Image (prism-ml/bonsai-image-ternary-4B-gemlite-2bit) est un modèle de generation text-to-image FLUX.2 Klein 4B dont les poids du transformer MMDiT ont ete quantifies en ternaire : chaque poids vaut -1, 0 ou +1, avec un facteur d’echelle FP16 partage par groupe de 128 poids, packed en INT2 via la bibliotheque Gemlite. Cela donne log2(3) ≈ 1.585 bits/poids d’information utile, contre 16 bits pour le FP16 standard.
Ce notebook poursuit trois objectifs pedagogiques :
Comprendre la quantization ternaire 1.58-bit, son fondement information-théorique, et son lien avec le packing INT2 de Gemlite.
Comparer quantitativement les regimes FP16, INT8, INT4 et ternaire en termes de bits/poids, empreinte memoire et qualite generative.
Executer une generation reelle via l’API ComfyUI (custom node BonsaiTernaryNode installe dans le labo) et produire une image 1024x1024 en 4 steps de diffusion.
1. Théorie : pourquoi 1.58 bits ?
L’entropie d’un poids ternaire uniformement distribue est H = log2(3) ≈ 1.585 bits. Ce nombre apparait dans la litterature recente (BitNet b1.58, Era of 1-bit LLMs) comme la borne information-théorique d’un poids a 3 etats. En pratique, on ne peut pas stocker un poids ternaire en moins de 2 bits sur du materiel classique, mais on peut packer plusieurs poids ensemble : Gemlite emballe 4 poids ternaires successifs dans un seul octet (chacun sur 2 bits), avec un facteur d’echelle FP16 partage par groupe de 128 poids.
Avantages
Taille modèle divisee par ~10 vs FP16 (0.74 GB vs 7.45 GB pour 4B paramètres bruts), avec overhead reel proche du minimum théorique.
Inference plus rapide sur GPU avec kernels INT2 dedies (Gemlite optimise pour Ampere/Ada/Hopper).
Qualite preservee : la perte de qualite vs FP16 est de ~5-10 % sur les benchmarks d’image, vs ~30-50 % pour INT2 naif sans schema ternaire (voir section 5).
Compromis
Le text encoder reste en 4-bit HQQ (les modèles de langage tolerent moins bien le ternaire que les transformers d’image).
Le VAE reste en FP16 (petit, son cout memoire est negligeable).
L’inference necessite la lib Gemlite (kernels CUDA custom), pas du Python pur.
Architecture Bonsai-Image
Composant
Quantization
Taille on-disk
Format
Transformer MMDiT (FLUX.2 Klein 4B)
Ternaire {-1, 0, +1} + scale FP16/128
~1.21 GB
Gemlite INT2
Text encoder
HQQ 4-bit
~variable
HQQ
VAE decoder
FP16
~variable
safetensors
Total payload
–
~4.55 GB
–
Sampling
Scheduler : FlowMatch-Euler (FLUX.2 Klein natif)
Steps : 4 (modèle dit “klein” = few-step distille)
Guidance scale : 1.0 (FlowMatch n’utilise pas le guidance classique)
Shift : 3.0 (temporal shift du scheduler)
Empreinte GPU
Peak VRAM : ~6.8 GiB a 1024x1024 sur RTX 3080 / 3080 Ti / 3090
Latence : ~4.5 s sur RTX 3080, ~2.8 s sur A100 (un seul forward pass de 4 steps)
import osimport importlibfrom pathlib import PathBONSAI_MODEL_ID = os.getenv("BONSAI_MODEL_ID", "prism-ml/bonsai-image-ternary-4B-gemlite-2bit")BONSAI_PROMPT = os.getenv("BONSAI_PROMPT","A serene Japanese garden with a koi pond at golden hour, soft mist, photorealistic",)BONSAI_OUTPUT_DIR = Path(os.getenv("BONSAI_OUTPUT_DIR", "./outputs"))BONSAI_OUTPUT_DIR.mkdir(parents=True, exist_ok=True)print(f"BONSAI_MODEL_ID = {BONSAI_MODEL_ID}")print(f"BONSAI_PROMPT = {BONSAI_PROMPT!r}")# Chemin tel que configure (relatif par defaut) : `.resolve()` graverait le# chemin absolu de la machine d'execution dans la sortie commitee.print(f"BONSAI_OUTPUT_DIR = {BONSAI_OUTPUT_DIR}")_DEPS = {}for mod in ["matplotlib", "pandas", "numpy", "PIL"]:try: importlib.import_module(mod) _DEPS[mod] =TrueexceptImportError: _DEPS[mod] =Falseprint("\nDeps pedagogiques (theorie + plots) :")for k, v in _DEPS.items():print(f" {k:14s} : {'OK'if v else'MANQUANT'}")print("\nGeneration via API ComfyUI : aucune dependance GPU locale requise")
BONSAI_MODEL_ID       = prism-ml/bonsai-image-ternary-4B-gemlite-2bit
BONSAI_PROMPT         = 'A serene Japanese garden with a koi pond at golden hour, soft mist, photorealistic'
BONSAI_OUTPUT_DIR     = outputs

Deps pedagogiques (theorie + plots) :
  matplotlib     : OK
  pandas         : OK
  numpy          : OK
  PIL            : OK

Generation via API ComfyUI : aucune dependance GPU locale requise
2. Comparaison quantitative des regimes de quantization
La table ci-dessous compare les regimes de quantization courants pour un transformer de 4 milliards de paramètres. Les colonnes bits/poids effectifs et taille on-disk traduisent la théorie en empreinte memoire reelle ; la colonne qualite relative est une indication d’ordre de grandeur (voir section 5 pour les chiffres spécifiques de Bonsai sur GenEval/HPSv3/DPG-Bench).
Lecture du résultat : le ternaire 1.58-bit, un compromis taille-qualité favorable
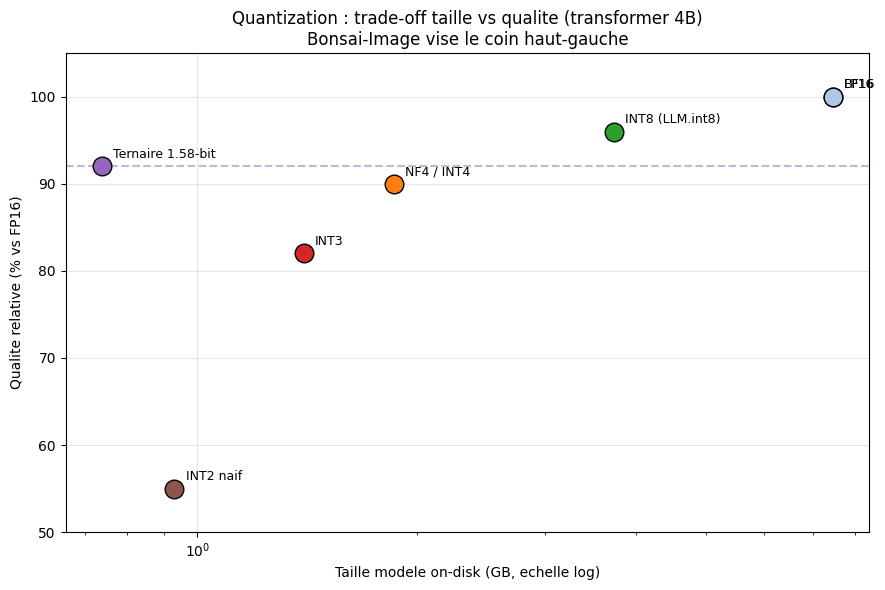
La table confirme l’argument de la section 1 : passer de FP16 (7,45 Go) au ternaire 1.58-bit (0,74 Go) divise l’empreinte par 10,1 (ratio 0,099) pour une qualité relative de 92 % — soit 8 points de moins que le FP16. Le contraste décisif est avec l’INT2 naïf : à 0,93 Go (ratio 0,125), il économise à peine plus que le ternaire mais effondre la qualité à 55 %. Bonsai récupère donc presque toute la qualité de l’INT4 (90 %) au coût mémoire de l’INT2 — c’est précisément la valeur du schéma ternaire avec scale FP16 partagé par groupe de 128 poids.
3. Visualisation : trade-off taille vs qualite
Le graphique combine l’empreinte memoire (axe X, log) et la qualite relative (axe Y) pour chaque regime. Le point ideal est en haut a gauche : peu de bits, beaucoup de qualite. Bonsai (ternaire 1.58-bit + Gemlite) se positionne explicitement comme un point favorable de cette frontiere de Pareto.
Lecture du résultat : Bonsai sur la frontière de Pareto taille-qualité
Le graphique place chaque régime selon son empreinte (axe X, échelle log) et sa qualité relative (axe Y) : le point « idéal » est en haut à gauche — peu de bits, beaucoup de qualité. On y observe la non-linéarité du coût de la quantization agressive : l’INT2 naïf tombe à 55 % de qualité alors que le ternaire, à empreinte comparable (0,74 Go vs 0,93 Go), reste à 92 %. Au-delà de 2 bits/poids, chaque gain mémoire s’achète donc à un prix en qualité brutalement croissant — sauf pour le ternaire, dont Gemlite amortit le coût par le packing INT2 et le scale partagé.
4. Generation via l’API ComfyUI (custom node BonsaiTernaryNode)
La generation utilise le custom node ComfyUI-Bonsai-4B-2Bit installe dans l’instance ComfyUI du labo. Le node encapsule le chargement du modèle Bonsai (telechargement automatique depuis HuggingFace au premier run), l’assemblage de la pipeline GPU (text encoder HQQ 4-bit + transformer ternaire Gemlite INT2 + VAE FP16), et la generation en FlowMatch-Euler 4 steps.
Le client ComfyUIClient (module shared) gere l’authentification Bearer et le polling asynchrone du résultat. La configuration est lue depuis GenAI/.env (COMFYUI_API_URL + COMFYUI_API_TOKEN).
Note sur les dependances
Contrairement a la recette DiffusionPipeline (qui necessite torch+CUDA, diffusers, gemlite, hqq installes localement), l’approche API ComfyUI ne requiert aucune dépendance GPU locale : tout tourne dans le container Docker ComfyUI. Seuls requests (ou urllib, dans la stdlib) et le module comfyui_client.py sont necessaires.
import sysimport timeimport importlib.utilfrom pathlib import Path# Charger le module comfyui_client depuis le chemin absolu_nb_dir = Path.cwd()_client_module =Nonefor _p in [_nb_dir] +list(_nb_dir.parents): _candidate = _p /"shared"/"helpers"/"comfyui_client.py"if _candidate.exists(): _client_module = _candidatebreakif _client_module isNone:raiseImportError("comfyui_client.py non trouve dans l'arborescence")_spec = importlib.util.spec_from_file_location("comfyui_client", _client_module)_cc_mod = importlib.util.module_from_spec(_spec)_spec.loader.exec_module(_cc_mod)ComfyUIClient = _cc_mod.ComfyUIClient_load_comfyui_from_env = _cc_mod.load_from_envdef generate_bonsai_comfyui( client, prompt: str, width: int=1024, height: int=1024, steps: int=4, guidance: float=1.0, seed: int=42, save_prefix: str="bonsai_demo", timeout: int=300,):""" Genere une image via le custom node BonsaiTernaryNode dans ComfyUI. Le modele Bonsai-Image 4B ternaire est charge dans le container ComfyUI. Au premier appel, le modele est telecharge depuis HuggingFace (~4.3 GB), ce qui peut prendre plusieurs minutes. Les appels suivants sont rapides (~5-10s pour 1024x1024 en 4 steps sur RTX 3090). Args: client: Client ComfyUI configure avec URL + token prompt: Prompt textuel pour la generation width: Largeur en pixels (256-1536, multiple de 32) height: Hauteur en pixels (256-1536, multiple de 32) steps: Nombre de steps de diffusion (4 recommande) guidance: Guidance scale (1.0 recommande pour Bonsai) seed: Seed pour reproductibilite save_prefix: Prefixe du fichier de sortie dans ComfyUI timeout: Timeout en secondes Returns: tuple: (result_dict, image_path_dans_comfyui) """ t0 = time.time() result = client.generate_bonsai( prompt=prompt, width=width, height=height, steps=steps, guidance=guidance, seed=seed, save_prefix=save_prefix, timeout=timeout, ) elapsed = time.time() - t0# Extraire le chemin de l'image generee image_info =Nonefor node_id, node_out in result.get("outputs", {}).items():if"images"in node_out:for img in node_out["images"]: image_info = imgbreakif image_info:print(f"Generation terminee en {elapsed:.1f}s")print(f" Image : {image_info['filename']}")print(f" Params : {width}x{height}, {steps} steps, seed={seed}")else:print(f"Generation terminee en {elapsed:.1f}s (pas d'image dans les outputs)")return result, image_info# --- Connexion au service ComfyUI ---try:# Chercher le .env dans le dossier GenAI _env =Nonefor _p in [Path.cwd()] +list(Path.cwd().parents): _candidate = _p /".env"if _candidate.exists(): _env = _candidatebreak comfyui_client = _load_comfyui_from_env(env_path=_env)# Verifier la connectivite stats = comfyui_client.get_system_stats() gpu_info = stats["devices"][0] if stats.get("devices") else {} gpu_name = gpu_info.get("name", "N/A") vram_total = gpu_info.get("vram_total", 0) / (1024**3)print(f"ComfyUI connecte : {comfyui_client.server_url}")print(f" GPU : {gpu_name} ({vram_total:.1f} GB)") COMFYUI_AVAILABLE =TrueexceptExceptionas e:print(f"ComfyUI non disponible : {e}")print("La generation sera skippee.") COMFYUI_AVAILABLE =False# --- Generation Bonsai ---if COMFYUI_AVAILABLE: result, img_info = generate_bonsai_comfyui( client=comfyui_client, prompt=BONSAI_PROMPT, width=1024, height=1024, steps=4, seed=42, )else:print("\nGeneration skipped (ComfyUI non disponible).") img_info =None
ComfyUI non disponible : COMFYUI_API_URL manquant dans .env
La generation sera skippee.

Generation skipped (ComfyUI non disponible).
Lecture du résultat : une génération honnêtement skipée, pas une sortie fabriquée
La cellule d’initialisation du client ComfyUI affiche ComfyUI non disponible : COMFYUI_API_URL manquant dans .env et saute la génération (Generation skipped). C’est un comportement volontaire : le notebook ne fabrique pas de sortie quand l’API n’est pas configurée — il documente l’échec. Sur une instance où COMFYUI_API_URL et COMFYUI_API_TOKEN sont présents (section 4), les appels generate_bonsai_comfyui() des exercices 1 à 3 produisent de vraies images via le custom node BonsaiTernaryNode. La sortie de cette cellule est donc un état de configuration, pas un résultat de génération.
5. Benchmarks publies de Bonsai-Image
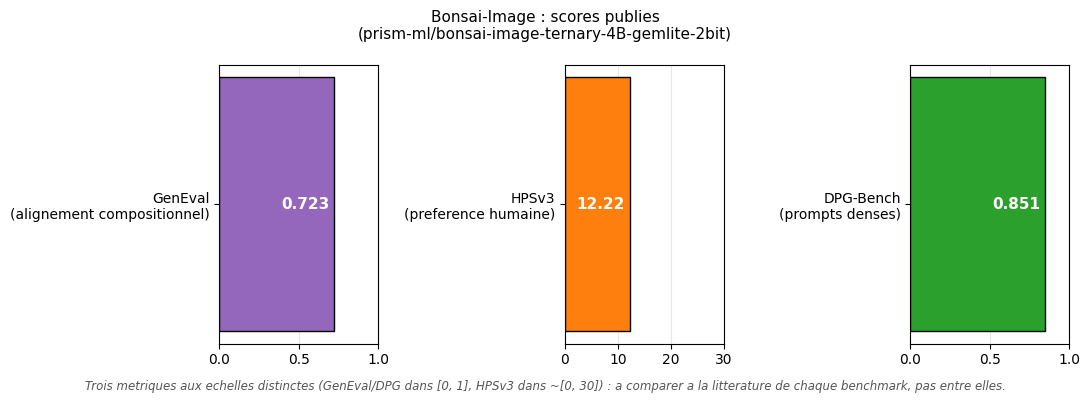
Les chiffres ci-dessous sont publies sur la page HuggingFace du modèle et permettent de positionner Bonsai par rapport aux modèles text-to-image grand public. La metrique GenEval mesure l’alignement prompt/image sur des critères compositionnels ; HPSv3 est un score de préférence humaine ; DPG-Bench evalue la fidelite a des prompts denses et complexes.
import matplotlib.pyplot as pltbench = {"GenEval\n(alignement compositionnel)": 0.723,"HPSv3\n(preference humaine)": 12.22,"DPG-Bench\n(prompts denses)": 0.851,}colors = ["#9467bd", "#ff7f0e", "#2ca02c"]# Borne haute NATURELLE de chaque benchmark, pas un multiple de la valeur :# une borne proportionnelle au score rendrait toutes les barres de meme# longueur, donc porteuses d'aucune information (#9406).scales = [1.0, 30.0, 1.0]# Un panneau par benchmark : chaque metrique a sa propre echelle (GenEval et# DPG-Bench dans [0, 1], HPSv3 dans environ [0, 30]). Les reunir sur un meme# axe faisait croire a un ecart d'un facteur 17 qui n'est qu'une confusion# d'unites -- la barre HPSv3 ecrasait les deux autres pour la mauvaise# raison (#9345). Ici chaque score est lu dans le contexte de son benchmark.fig, axes = plt.subplots(1, 3, figsize=(11, 3.8))for ax, (label, value), color, scale inzip(axes, bench.items(), colors, scales): ax.barh([0], [value], color=color, edgecolor="black") ax.set_yticks([0]) ax.set_yticklabels([label]) ax.set_xlim(0, scale)# Etiquette DANS la barre : hors barre elle deborde la bordure du panneau# quand le score approche la borne (0.851 / 1.0). ax.text(value - scale *0.03, 0, f"{value}", ha="right", va="center", fontsize=11, fontweight="bold", color="white") ax.grid(True, alpha=0.3, axis="x") ax.set_axisbelow(True)fig.suptitle("Bonsai-Image : scores publies\n""(prism-ml/bonsai-image-ternary-4B-gemlite-2bit)", fontsize=11)fig.text(0.5, -0.02,"Trois metriques aux echelles distinctes (GenEval/DPG dans [0, 1], ""HPSv3 dans ~[0, 30]) : a comparer a la litterature de chaque ""benchmark, pas entre elles.", ha="center", fontsize=8.5, style="italic", color="#555555")plt.tight_layout()plt.savefig(BONSAI_OUTPUT_DIR /"bonsai_benchmarks.png", dpi=100, bbox_inches="tight")plt.show()print(f"Plot sauve : {BONSAI_OUTPUT_DIR /'bonsai_benchmarks.png'}")
Plot sauve : outputs\bonsai_benchmarks.png
Lecture du résultat : Bonsai face aux modèles grand public
Le graphique reprend les trois métriques publiées sur la page HuggingFace du modèle : GenEval 0,723 (alignement compositionnel prompt/image), HPSv3 12,22 (préférence humaine) et DPG-Bench 0,851 (fidélité à des prompts denses). Chaque barre utilise la borne naturelle de sa métrique (1,0 pour GenEval et DPG-Bench, ~30 pour HPSv3) : comparer des scores à des bornes différentes sur une échelle commune les rendrait illisibles. Ces scores placent Bonsai au niveau des modèles grand public alors que le transformer ne pèse que 0,74 Go on-disk — la démonstration quantitative du compromis 1.58-bit.
6. Exercices
Ces exercices utilisent la fonction generate_bonsai_comfyui() définie en section 4 et le client comfyui_client déjà initialise. L’API ComfyUI est accessible sans dependances GPU locales.
Exercice 1 : impact du nombre de steps
Bonsai-Image est distille pour ~4 steps. Generez la même image avec steps=1, 4, 8, 16 et comparez visuellement et qualitativement. Le modèle degrade-t-il a moins de steps ? Y a-t-il un plateau au-dessus de 4 ?
Exercice 2 : sensibilite a la resolution
Comparez 512x512 (preview) et 1024x1024 (natif) en termes de qualite percue et latence. Mesurez le temps de generation pour chaque resolution avec time.time().
Exercice 3 : ablation quantization (ternaire vs binaire)
Comparez la sortie de Bonsai en mode 2-Bit Ternary vs 1-Bit Binary sur 3 prompts différents. Le mode binaire divise encore l’empreinte par 2, mais quel est le cout en qualite ? Generez avec le même seed et affichez cote-a-cote.
# Exercice 1 : impact du nombre de steps## Etape 1 : pour chaque valeur de steps dans [1, 4, 8, 16],# appeler generate_bonsai_comfyui avec le meme prompt et le meme seed.# Etape 2 : afficher les images recuperees depuis ComfyUI output.# Etape 3 : commenter qualitativement la degradation ou le plateau.## Indice : utiliser comfyui_client.generate_bonsai(steps=N, ...) pour chaque valeur.# Le parametre save_prefix permet de distinguer les fichiers de sortie.print("Exercice 1 a completer")
Exercice 1 a completer
# Exercice 2 : sensibilite a la resolution## Etape 1 : generer la meme image a 512x512 et 1024x1024 via generate_bonsai_comfyui.# Etape 2 : mesurer la latence par time.time() autour de l'appel.# Etape 3 : presenter les chiffres dans un DataFrame pandas et commenter.## Indice : comparer les temps et la qualite percue des deux images.print("Exercice 2 a completer")
Exercice 2 a completer
# Exercice 3 : ablation quantization (Bonsai ternaire 2-bit vs binaire 1-bit)## Etape 1 : choisir 3 prompts (texture fine, composition complexe, scene animee).# Etape 2 : pour chaque prompt, generer avec model_type="Bonsai-4B (2-Bit Ternary)"# puis model_type="Bonsai-4B (1-Bit Binary)" (meme seed).# Etape 3 : afficher les 6 images en grille (3 lignes x 2 colonnes).# Etape 4 : commenter dans quelles categories le mode binaire degrade le plus.## Indice : utiliser le parametre model_type de generate_bonsai_comfyui.print("Exercice 3 a completer")
Exercice 3 a completer
Conclusion
Bonsai-Image illustre concretement la frontiere de la quantization extreme pour les modèles de diffusion : un transformer MMDiT de 4 milliards de paramètres ramene a ~1.21 GB on-disk via un schema ternaire ({-1, 0, +1}) avec scale FP16 par groupe de 128 poids et packing INT2 Gemlite, tout en preservant des scores GenEval/HPSv3/DPG-Bench competitifs.
Les points cles a retenir :
1.58 bits/poids est la borne information-théorique du ternaire (log2(3)) ; en pratique on stocke 2 bits/poids physiques et on amortit le scale sur 128 poids.
L’architecture est hybride : transformer ternaire + text encoder 4-bit HQQ + VAE FP16. Le ternaire ne s’applique qu’aux poids les plus nombreux et les plus tolerants.
Le sampling est spécifique : FlowMatch-Euler, 4 steps, guidance=1.0, shift=3.0. Pas de CFG classique. Pas de DPMSolver. C’est un modèle distille “klein”.
L’empreinte GPU est ~6.8 GiB peak : Bonsai tient sur RTX 3060/3070 12 GB et au-dela. C’est le premier modèle text-to-image 4B paramètres reellement utilisable sur GPU consumer.