# Parameters
BATCH_MODE = "true"🎨 Stable Diffusion Forge
Navigation : Index | << Précédent | Suivant >>
Notebook: Stable Diffusion Forge - SD XL Turbo
Objectif
Ce notebook pédagogique vous apprend à utiliser l’API Stable Diffusion Forge avec le modèle SD XL Turbo pour générer des images à partir de descriptions textuelles (prompts).
Contexte
- API: Stable Diffusion Forge (WebUI Automatic1111) — expose un modèle de diffusion latente [Rombach et al. 2022]
- Modèle: SD XL Turbo (optimisé pour vitesse), variante distillée de SDXL [Podell et al. 2023] n’excédant que 4 étapes de débruitage via Adversarial Diffusion Distillation [Sauer et al. 2023]
- URL Base:
https://turbo.stable-diffusion-webui-forge.myia.io - Performance: ~18s pour génération 512×512 (4 steps)
Use Cases
- Prototypage rapide de concepts visuels
- Itération créative sur variations de prompts
- Exploration de styles artistiques
- Tests de faisabilité avant génération haute qualité
Pré-requis
- Packages Python:
requests,Pillow,matplotlib,python-dotenv - Accès réseau à l’API Forge
🔐 Authentification et Configuration
Flux d’Authentification Forge
L’API Forge peut nécessiter deux niveaux d’authentification :
- Basic Authentication (HTTP) - Authentification de base
- Service Portal - Portal de connexion avec redirection
Configuration via Variables d’Environnement
Créez un fichier .env dans MyIA.AI.Notebooks/GenAI/ :
# URL de l'API (Production par défaut)
FORGE_API_URL=https://turbo.stable-diffusion-webui-forge.myia.io

# Authentification (si requise)
FORGE_USER=votre_username
FORGE_PASSWORD=votre_password
Processus d’Authentification Automatique
Le notebook gère automatiquement l’authentification en deux étapes :
┌─────────────────────────────────────────────────────────────┐
│                 FLUX D'AUTHENTIFICATION                     │
│                                                             │
│  1. Tentative Basic Auth                                   │
│     ├── Succès → API accessible                           │
│     └── Redirection → Étape 2                             │
│                                                             │
│  2. Détection Service Portal                               │
│     ├── Login automatique avec credentials                 │
│     ├── Récupération session/cookies                       │
│     └── Retry requête initiale                             │
│                                                             │
│  3. Vérification finale                                    │
│     └── Test endpoint /sdapi/v1/options                    │
└─────────────────────────────────────────────────────────────┘
Cas d’Erreur Courants
| Erreur | Cause | Solution |
|---|---|---|
| 401 Unauthorized | Credentials manquants/invalides | Vérifier .env |
| Redirection loop | Service Portal mal configuré | Vérifier URL de login |
| Timeout | API inaccessible | Vérifier connectivité réseau |
Note : La fonction get_forge_session() gère automatiquement ces scénarios et affiche des messages de debug.
Schema du flux d’authentification
Le diagramme ci-dessous reprend la logique de connexion decrite ci-dessus (tentative Basic Auth, bascule vers le portail de service, puis verification finale).
flowchart TD
    A["1. Tentative Basic Auth"] -->|"Succes"| OK["API accessible"]
    A -->|"Redirection"| B["2. Detection Service Portal"]
    B --> B1["Login automatique avec credentials"]
    B1 --> B2["Recuperation session/cookies"]
    B2 --> B3["Retry requête initiale"]
    B3 --> C["3. Verification finale"]
    C --> C1["Test endpoint /sdapi/v1/options"]
# Verification des dependances externes
import importlib
_DEPS_STATUS = {}
try:
importlib.import_module('PIL')
_DEPS_STATUS['PIL'] = True
except ImportError:
_DEPS_STATUS['PIL'] = False
print(f'WARNING: Pillow non installe - pip install Pillow')
try:
importlib.import_module('requests')
_DEPS_STATUS['requests'] = True
except ImportError:
_DEPS_STATUS['requests'] = False
print(f'WARNING: requests non installe - pip install requests')
try:
importlib.import_module('matplotlib')
_DEPS_STATUS['matplotlib'] = True
except ImportError:
_DEPS_STATUS['matplotlib'] = False
print(f'WARNING: matplotlib non installe - pip install matplotlib')
try:
importlib.import_module('dotenv')
_DEPS_STATUS['dotenv'] = True
except ImportError:
_DEPS_STATUS['dotenv'] = False
print(f'WARNING: python-dotenv non installe - pip install python-dotenv')
try:
importlib.import_module('IPython')
_DEPS_STATUS['IPython'] = True
except ImportError:
_DEPS_STATUS['IPython'] = False
print(f'WARNING: ipython non installe - pip install ipython')
_all_deps_ok = all(_DEPS_STATUS.values())
if not _all_deps_ok:
missing = [k for k, v in _DEPS_STATUS.items() if not v]
print(f'Dependances manquantes: {missing}')
else:
print('Toutes les dependances sont disponibles')
from pathlib import Path
"""
Configuration initiale: imports et paramètres API
"""
# Imports standard
import requests
import json
import base64
from io import BytesIO
from typing import Optional, Dict, Any, List
import warnings
import os
from dotenv import load_dotenv
# Imports visualisation
from PIL import Image
import matplotlib.pyplot as plt
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
env_path = current_path / ".env"
if env_path.exists():
load_dotenv(env_path)
print(f".env charge depuis: {env_path.name}")
env_loaded = True
break
if current_path.name == "GenAI" or len(current_path.parts) <= 1:
break
current_path = current_path.parent
if not env_loaded:
print("WARNING: .env non trouve, utilisation variables environnement")
# Configuration API Forge
# URL par défaut (Production) ou surcharge via variable d'environnement (Test Local)
API_BASE_URL = os.getenv("FORGE_API_URL", "https://turbo.stable-diffusion-webui-forge.myia.io")
# Authentification (si requise)
FORGE_USER = os.getenv("FORGE_USER")
FORGE_PASSWORD = os.getenv("FORGE_PASSWORD")
AUTH = (FORGE_USER, FORGE_PASSWORD) if FORGE_USER and FORGE_PASSWORD else None
TIMEOUT = 90 # Couvre le chargement à froid du modèle
# Suppression warnings non critiques
warnings.filterwarnings('ignore')
def get_forge_session(base_url, auth=None):
"""
Crée une session authentifiée pour Forge, gérant à la fois Basic Auth et le Service Portal.
"""
session = requests.Session()
# 1. Essai Basic Auth (si configuré)
if auth:
session.auth = auth
# 2. Vérification et Login Service Portal (si nécessaire)
try:
# Test de connexion simple
test_url = f"{base_url}/sdapi/v1/options"
response = session.get(test_url, timeout=10)
# Si redirection vers login ou page HTML de login détectée
if response.history and "login" in response.url or "<!DOCTYPE html>" in response.text:
print("🔄 Redirection vers Service Portal détectée, tentative d'authentification...")
# Déduction de l'URL de login (souvent sur le même host ou port 1111 en local)
login_url = f"{base_url}/login"
if "1111" in response.url: # Cas spécifique Docker local
login_url = response.url.split("?")[0]
if auth:
# Tentative de login par formulaire
login_data = {"user": auth[0], "password": auth[1]}
login_resp = session.post(login_url, data=login_data, timeout=10)
if login_resp.status_code == 200 and "login" not in login_resp.url:
print("✅ Authentification Service Portal réussie")
else:
print("❌ Échec authentification Service Portal")
else:
print("⚠️ Authentification requise mais aucun credential fourni")
except Exception as e:
print(f"⚠️ Erreur lors de l'initialisation de la session: {e}")
return session
# Initialisation de la session globale
FORGE_SESSION = get_forge_session(API_BASE_URL, AUTH)
print("✅ Configuration initiale chargée")
print(f"📡 API Forge: {API_BASE_URL}")
if AUTH:
print("🔐 Authentification activée")Toutes les dependances sont disponibles
.env charge depuis: .env
✅ Configuration initiale chargée
📡 API Forge: https://turbo.stable-diffusion-webui-forge.myia.io
🔐 Authentification activée““” Vérification du statut de l’API et affichage d’une bannière visuelle ““”
# Test de connectivité API
try:
    # Utilisation de la session authentifiée
    response = FORGE_SESSION.get(f"{API_BASE_URL}/sdapi/v1/options", timeout=10)
    response.raise_for_status()

    # Bannière de succès
    from IPython.display import display, HTML

    banner_html = """
    <div style="background: linear-gradient(135deg, #667eea 0%, #764ba2 100%);
                padding: 20px;
                border-radius: 10px;
                text-align: center;
                color: white;
                font-family: Arial, sans-serif;
                box-shadow: 0 4px 6px rgba(0,0,0,0.1);">
        <h1 style="margin: 0; font-size: 28px;">🎨 Stable Diffusion Forge</h1>
        <h2 style="margin: 10px 0 0 0; font-weight: normal; font-size: 18px;">SD XL Turbo API</h2>
        <p style="margin: 15px 0 0 0; font-size: 14px; opacity: 0.9;">✅ API Connectée et Opérationnelle</p>
        <p style="margin: 5px 0 0 0; font-size: 12px; opacity: 0.7;">Génération rapide 4-steps • Performance ~18s</p>
    </div>
    """

    display(HTML(banner_html))
    print("\n✅ API Forge accessible et prête à l'utilisation")

except requests.exceptions.RequestException as e:
    print(f"⚠️ Avertissement: Impossible de contacter l'API Forge")
    print(f"   Erreur: {e}")
    print(f"   Vérifiez que l'API est accessible à {API_BASE_URL}")
SD XL Turbo API
✅ API Connectée et Opérationnelle
Génération rapide 4-steps • Performance ~18s
✅ API Forge accessible et prête à l'utilisation1. Comprendre l’API Stable Diffusion Forge
Architecture
L’API Forge expose une interface RESTful pour interagir avec Stable Diffusion:
- Endpoint principal:
/sdapi/v1/txt2img(génération texte→image) - Méthode HTTP: POST
- Format: JSON (requête et réponse)
- Authentification: Non requise (API interne)
Paramètres Critiques SD XL Turbo
Le modèle SD XL Turbo est optimisé pour la vitesse:
| Paramètre | Valeur Optimale | Explication |
|---|---|---|
steps |
4 | Nombre d’itérations de débruitage (vs 20-50 pour modèles standard) |
cfg_scale |
2.0 | Force de guidage du prompt (vs 7.0 typiquement) |
sampler_name |
DPM++ 2M |
Échantillonneur rapide compatible Turbo |
width × height |
512×512 | Résolution par défaut pour performances optimales |
Flux de Travail Typique
- Construire payload JSON avec prompt + paramètres
- Envoyer requête POST à l’endpoint
/sdapi/v1/txt2img - Recevoir réponse JSON contenant image(s) encodée(s) en base64
- Décoder + afficher image avec Pillow/Matplotlib
"""
Fonction helper pour générer des images via API Forge
"""

def generate_image_forge(
    prompt: str,
    negative_prompt: str = "",
    steps: int = 4,
    cfg_scale: float = 2.0,
    width: int = 512,
    height: int = 512,
    sampler_name: str = "DPM++ 2M",
    save_path: Optional[str] = None
) -> Optional[Image.Image]:
    """
    Génère une image via l'API Stable Diffusion Forge (SD XL Turbo).

    Args:
        prompt: Description textuelle de l'image désirée
        negative_prompt: Éléments à éviter dans l'image
        steps: Nombre d'itérations (4 recommandé pour Turbo)
        cfg_scale: Force de guidage du prompt (2.0 recommandé pour Turbo)
        width: Largeur de l'image en pixels
        height: Hauteur de l'image en pixels
        sampler_name: Algorithme d'échantillonnage
        save_path: Chemin optionnel pour sauvegarder l'image

    Returns:
        Image PIL si succès, None si erreur
    """
    # Construction payload API
    payload = {
        "prompt": prompt,
        "negative_prompt": negative_prompt,
        "steps": steps,
        "cfg_scale": cfg_scale,
        "width": width,
        "height": height,
        "sampler_name": sampler_name
    }

    try:
        # Requête POST vers endpoint txt2img
        print(f"🎨 Génération en cours: '{prompt[:50]}...'")
        # Utilisation de la session globale
        response = FORGE_SESSION.post(
            f"{API_BASE_URL}/sdapi/v1/txt2img",
            json=payload,
            timeout=TIMEOUT
        )
        response.raise_for_status()

        # Extraction de l'image depuis JSON
        result = response.json()
        if "images" not in result or len(result["images"]) == 0:
            print("❌ Erreur: Aucune image générée")
            return None

        # Décodage base64 → PIL Image
        image_data = base64.b64decode(result["images"][0])
        image = Image.open(BytesIO(image_data))

        # Sauvegarde optionnelle
        if save_path:
            image.save(save_path)
            print(f"💾 Image sauvegardée: {save_path}")

        print(f"✅ Image générée ({width}×{height})")
        return image

    except requests.exceptions.Timeout:
        print(f"⏱️ Timeout après {TIMEOUT}s")
        return None
    except requests.exceptions.RequestException as e:
        print(f"❌ Erreur requête: {e}")
        return None
    except Exception as e:
        print(f"❌ Erreur inattendue: {e}")
        return None

print("✅ Fonction generate_image_forge() définie")
✅ Fonction generate_image_forge() définie2. Exemple Simple: Première Génération
Testons la fonction avec un prompt simple pour générer un paysage de montagne au coucher du soleil.
Note: SD XL Turbo est conçu pour la vitesse — seulement 4 steps de débruitage contre ~30 pour SD XL standard. Le temps exact dépend du GPU (RTX 3090, cloud T4…) et varie d’une exécution à l’autre : il s’observe à l’exécution de la cellule suivante, pas dans un nombre figé.
# Génération d'un paysage de montagne au coucher du soleil
image_simple = generate_image_forge(
    prompt="A serene mountain landscape at sunset, golden hour lighting, photorealistic",
    negative_prompt="blurry, low quality, distorted",
    steps=4,
    cfg_scale=2.0,
    width=512,
    height=512
)

# Affichage du résultat
if image_simple:
    plt.figure(figsize=(8, 8))
    plt.imshow(image_simple)
    plt.axis('off')
    plt.title("Paysage de Montagne au Coucher du Soleil", fontsize=14, pad=10)
    plt.tight_layout()
    plt.show()
else:
    print("⚠️ La génération a échoué. Vérifiez la connexion à l'API.")
🎨 Génération en cours: 'A serene mountain landscape at sunset, golden hour...'
✅ Image générée (512×512)
3. Optimisation des Paramètres SD XL Turbo
Pourquoi steps=4 ?
SD XL Turbo utilise une distillation de modèle (Adversarial Diffusion Distillation, [Sauer et al. 2023]) qui réduit le nombre d’étapes nécessaires :
- Modèles standard : 20-50 steps pour qualité optimale
- SD XL Turbo : 4 steps suffisent grâce à l’entraînement spécialisé
Pourquoi cfg_scale=2.0 ?
Le Classifier-Free Guidance (CFG) [Ho & Salimans 2022] contrôle l’adhérence au prompt :
| Valeur | Effet | Usage |
|---|---|---|
| 1.0 | Créativité maximale, prompt ignoré | Exploration aléatoire |
| 2.0 | Équilibre Turbo optimal | Génération rapide cohérente |
| 7.0 | Adhérence stricte (standard) | Modèles non-Turbo |
| 15.0+ | Sur-saturation, artefacts | À éviter |
Samplers Compatibles
Samplers recommandés pour SD XL Turbo :
- DPM++ 2M (par défaut) : Rapide et stable
- Euler a : Variations créatives
- LMS : Qualité légèrement supérieure
⚠️ Éviter : DDIM, PLMS (trop lents pour Turbo)
# Test des paramètres optimaux Turbo
print("🧪 Test comparatif: Impact du nombre de steps\n")

prompt_test = "A futuristic city at night, neon lights, cyberpunk style"

# Test avec 4 steps (optimal Turbo)
print("1️⃣ Génération avec 4 steps (Turbo optimal)...")
image_turbo = generate_image_forge(
    prompt=prompt_test,
    steps=4,
    cfg_scale=2.0
)

# Note: Pour comparer avec 20 steps (standard), décommentez ci-dessous
# print("\n2️⃣ Génération avec 20 steps (standard)...")
# image_standard = generate_image_forge(
#     prompt=prompt_test,
#     steps=20,
#     cfg_scale=7.0
# )

if image_turbo:
    plt.figure(figsize=(8, 8))
    plt.imshow(image_turbo)
    plt.axis('off')
    plt.title("Ville Futuriste (4 steps, cfg=2.0)", fontsize=14)
    plt.tight_layout()
    plt.show()

print("\n✅ Résultat: 4 steps suffisent pour qualité acceptable en ~18s")
🧪 Test comparatif: Impact du nombre de steps
1️⃣ Génération avec 4 steps (Turbo optimal)...
🎨 Génération en cours: 'A futuristic city at night, neon lights, cyberpunk...'
✅ Image générée (512×512)
✅ Résultat: 4 steps suffisent pour qualité acceptable en ~18s4. Cas d’Usage Avancé: Comparaison de Prompts
Explorons comment de légères variations de prompt influencent le résultat final.
Technique: Grid Comparison
Génération de plusieurs images avec prompts légèrement différents pour identifier les formulations les plus efficaces.
# Définition de 3 variations de prompt
prompts_comparison = [
    "A futuristic city at night",
    "A futuristic city at night, neon lights, rainy streets",
    "A futuristic city at night, cyberpunk style, flying cars, neon signs"
]

print("🎨 Génération de 3 variations de prompt...\n")

# Génération des images
images_grid = []
for i, prompt in enumerate(prompts_comparison, 1):
    print(f"{i}. \"{prompt}\"")
    img = generate_image_forge(
        prompt=prompt,
        negative_prompt="blurry, low quality",
        steps=4,
        cfg_scale=2.0
    )
    if img:
        images_grid.append(img)
    print()

# Affichage en grille
if len(images_grid) == 3:
    fig, axes = plt.subplots(1, 3, figsize=(18, 6))

    for idx, (ax, img, prompt) in enumerate(zip(axes, images_grid, prompts_comparison)):
        ax.imshow(img)
        ax.axis('off')
        # Titre tronqué pour affichage
        short_title = prompt if len(prompt) <= 40 else prompt[:37] + "..."
        ax.set_title(f"Variation {idx+1}\n{short_title}", fontsize=10)

    plt.suptitle("Comparaison: Impact des Variations de Prompt", fontsize=14, y=1.02)
    plt.tight_layout()
    plt.show()

    print("\n📊 Analyse:")
    print("- Prompt simple → Interprétation générique")
    print("- Prompt + détails → Contrôle accru sur atmosphère")
    print("- Prompt + style → Cohérence artistique maximale")
else:
    print("⚠️ Certaines générations ont échoué")
🎨 Génération de 3 variations de prompt...
1. "A futuristic city at night"
🎨 Génération en cours: 'A futuristic city at night...'
✅ Image générée (512×512)
2. "A futuristic city at night, neon lights, rainy streets"
🎨 Génération en cours: 'A futuristic city at night, neon lights, rainy str...'
✅ Image générée (512×512)
3. "A futuristic city at night, cyberpunk style, flying cars, neon signs"
🎨 Génération en cours: 'A futuristic city at night, cyberpunk style, flyin...'
✅ Image générée (512×512)
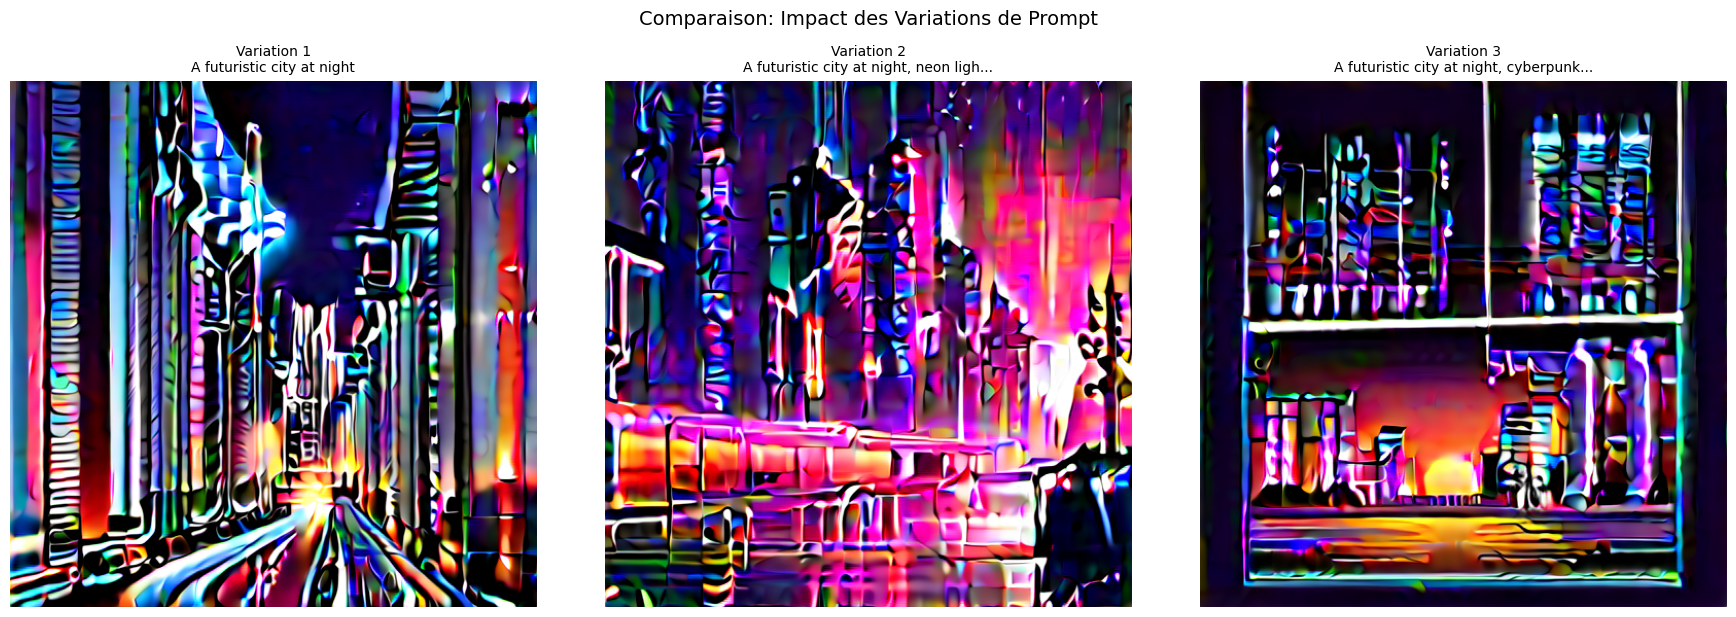
📊 Analyse:
- Prompt simple → Interprétation générique
- Prompt + détails → Contrôle accru sur atmosphère
- Prompt + style → Cohérence artistique maximale
Exercice 1 : Artisan de prompts
L’objectif de cet exercice est de rediger des prompts de qualite pour generer une image thematique, en appliquant les techniques de formulation observees dans la section précédente.
Contexte : La qualite d’une generation depend directement de la precision du prompt. Un prompt efficace combine sujet, style, eclairage et details techniques.
Instructions : 1. Choisissez un thème parmi : “portrait cyberpunk”, “nature surrealiste”, ou “architecture futuriste” 2. Redigez 3 variations de prompt pour ce thème (simple, detaille, avec style) 3. Generez les images et identifiez la formulation la plus efficace
Indices : - # Indice : Un prompt detaille inclut généralement : sujet + eclairage + style artistique + qualite - # Indice : Le negative prompt est aussi important que le prompt principal - # Étape 1 : Commencez par un prompt minimal de 5-10 mots - # Étape 2 : Ajoutez progressivement des details (eclairage, atmosphere) - # Étape 3 : Ajoutez un style artistique explicite et un qualificatif technique
# Exercice 1 : Artisan de prompts

# TODO etudiant : choisissez votre theme et redigez 3 variations de prompt
# Variation 1 : prompt simple (5-10 mots)
prompt_simple = "Votre prompt simple ici"  # TODO etudiant

# Variation 2 : prompt detaille (avec eclairage, atmosphere)
prompt_detaille = "Votre prompt detaille ici"  # TODO etudiant

# Variation 3 : prompt avec style artistique explicite
prompt_styliste = "Votre prompt avec style ici"  # TODO etudiant

# TODO etudiant : definissez un negative prompt adapte a votre theme
mon_negative = "blurry, low quality"  # TODO etudiant : completez

# Etape 1 : generation des 3 variations
variations = [prompt_simple, prompt_detaille, prompt_styliste]
titres = ["Simple", "Detaille", "Avec style"]

for titre, prompt in zip(titres, variations):
    print(f"{titre} : {prompt}")

# TODO etudiant : utilisez generate_image_forge() pour generer chaque variation
# Indice : steps=4, cfg_scale=2.0 pour les parametres Turbo optimaux
# image = generate_image_forge(prompt=..., negative_prompt=mon_negative, steps=4, cfg_scale=2.0)

# Etape 2 : affichage en grille
# Indice : inspirez-vous du code de comparaison de prompts vu en section 4

# Etape 3 : identifiez la meilleure formulation
print("Exercice a completer")
Simple : Votre prompt simple ici
Detaille : Votre prompt detaille ici
Avec style : Votre prompt avec style ici
Exercice a completer““” Techniques Avancées de Génération
Ce bloc explore des techniques avancées pour améliorer vos générations: 1. Reproductibilité avec seed fixe 2. Exploration créative avec seeds aléatoires 3. Génération batch optimisée ““”
import time
import random

# --- Technique 1: Reproductibilité avec Seed Fixe ---
print("🎯 Technique 1: Génération Reproductible (seed fixe)\n")

def generate_with_seed(prompt: str, seed: int):
    """Génère une image avec seed fixe pour reproductibilité"""
    payload = {
        "prompt": prompt,
        "steps": 4,
        "cfg_scale": 2.0,
        "width": 512,
        "height": 512,
        "seed": seed,
        "sampler_name": "DPM++ 2M"
    }

    try:
        # Utilisation de la session globale
        response = FORGE_SESSION.post(
            f"{API_BASE_URL}/sdapi/v1/txt2img",
            json=payload,
            timeout=TIMEOUT
        )
        response.raise_for_status()
        result = response.json()

        if "images" in result and len(result["images"]) > 0:
            image_data = base64.b64decode(result["images"][0])
            return Image.open(BytesIO(image_data))
    except Exception as e:
        print(f"❌ Erreur: {e}")
    return None

# Test avec seed fixe (42)
prompt_seed = "a mystical forest with glowing mushrooms"
print(f"Prompt: \"{prompt_seed}\"\nSeed: 42\n")

img_seed = generate_with_seed(prompt_seed, seed=42)
if img_seed:
    plt.figure(figsize=(6, 6))
    plt.imshow(img_seed)
    plt.axis('off')
    plt.title("Génération Reproductible (seed=42)", fontsize=11)
    plt.tight_layout()
    plt.show()
    print("💡 Astuce: Réexécutez cette cellule → même résultat garanti\n")

# --- Technique 2: Exploration Créative (seeds aléatoires) ---
print("\n🎲 Technique 2: Exploration Créative (seeds aléatoires)\n")

prompt_creative = "a steampunk airship in the clouds"
seeds_random = [random.randint(1, 999999) for _ in range(3)]

print(f"Génération de 3 variations avec seeds aléatoires...\n")
images_seeds = []

for i, seed in enumerate(seeds_random, 1):
    print(f"{i}. Seed: {seed}")
    img = generate_with_seed(prompt_creative, seed)
    if img:
        images_seeds.append((img, seed))

# Affichage grille
if len(images_seeds) == 3:
    fig, axes = plt.subplots(1, 3, figsize=(15, 5))
    for ax, (img, seed) in zip(axes, images_seeds):
        ax.imshow(img)
        ax.axis('off')
        ax.set_title(f"Seed: {seed}", fontsize=9)
    plt.suptitle("Exploration Créative: Même Prompt, Seeds Différents", fontsize=12)
    plt.tight_layout()
    plt.show()
    print("\n💡 Observation: Même prompt → résultats visuels différents\n")

# --- Technique 3: Batch Generation Optimisé ---
print("\n⚡ Technique 3: Génération Batch Optimisée\n")

def generer_batch_optimise(prompts_list: List[str]):
    """Génère plusieurs images en batch avec gestion erreurs"""
    results = []
    start_time = time.time()

    for i, prompt in enumerate(prompts_list, 1):
        print(f"[{i}/{len(prompts_list)}] {prompt[:50]}...")
        img = generate_image_forge(
            prompt=prompt,
            steps=4,
            cfg_scale=2.0,
            width=512,
            height=512
        )
        if img:
            results.append((prompt, img))

    elapsed = time.time() - start_time
    print(f"\n✅ Batch terminé: {len(results)}/{len(prompts_list)} succès en {elapsed:.1f}s")
    return results

# Batch de 3 prompts thématiques
batch_prompts = [
    "a futuristic city at sunset, cyberpunk style",
    "a peaceful zen garden with cherry blossoms",
    "an underwater scene with colorful coral reefs"
]

resultats_batch = generer_batch_optimise(batch_prompts)

# Affichage résultats batch
if len(resultats_batch) >= 2:
    n_cols = len(resultats_batch)
    fig, axes = plt.subplots(1, n_cols, figsize=(5*n_cols, 5))
    if n_cols == 1:
        axes = [axes]

    for ax, (prompt, img) in zip(axes, resultats_batch):
        ax.imshow(img)
        ax.axis('off')
        title = prompt if len(prompt) <= 35 else prompt[:32] + "..."
        ax.set_title(title, fontsize=9)

    plt.suptitle("Génération Batch Thématique", fontsize=12, y=1.02)
    plt.tight_layout()
    plt.show()

    print("\n💡 Usage: Idéal pour prototypage rapide de concepts multiples")
🎯 Technique 1: Génération Reproductible (seed fixe)
Prompt: "a mystical forest with glowing mushrooms"
Seed: 42
💡 Astuce: Réexécutez cette cellule → même résultat garanti


🎲 Technique 2: Exploration Créative (seeds aléatoires)

Génération de 3 variations avec seeds aléatoires...

1. Seed: 387196
2. Seed: 160912
3. Seed: 552089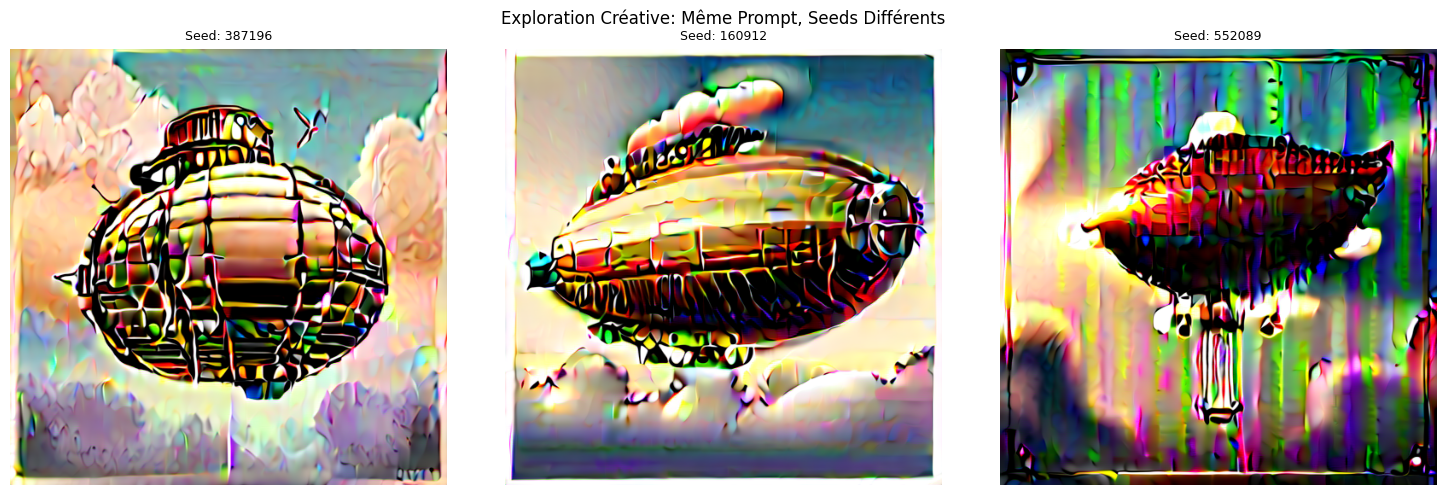
💡 Observation: Même prompt → résultats visuels différents


⚡ Technique 3: Génération Batch Optimisée

[1/3] a futuristic city at sunset, cyberpunk style...
🎨 Génération en cours: 'a futuristic city at sunset, cyberpunk style...'
✅ Image générée (512×512)
[2/3] a peaceful zen garden with cherry blossoms...
🎨 Génération en cours: 'a peaceful zen garden with cherry blossoms...'
✅ Image générée (512×512)
[3/3] an underwater scene with colorful coral reefs...
🎨 Génération en cours: 'an underwater scene with colorful coral reefs...'
✅ Image générée (512×512)

✅ Batch terminé: 3/3 succès en 8.7s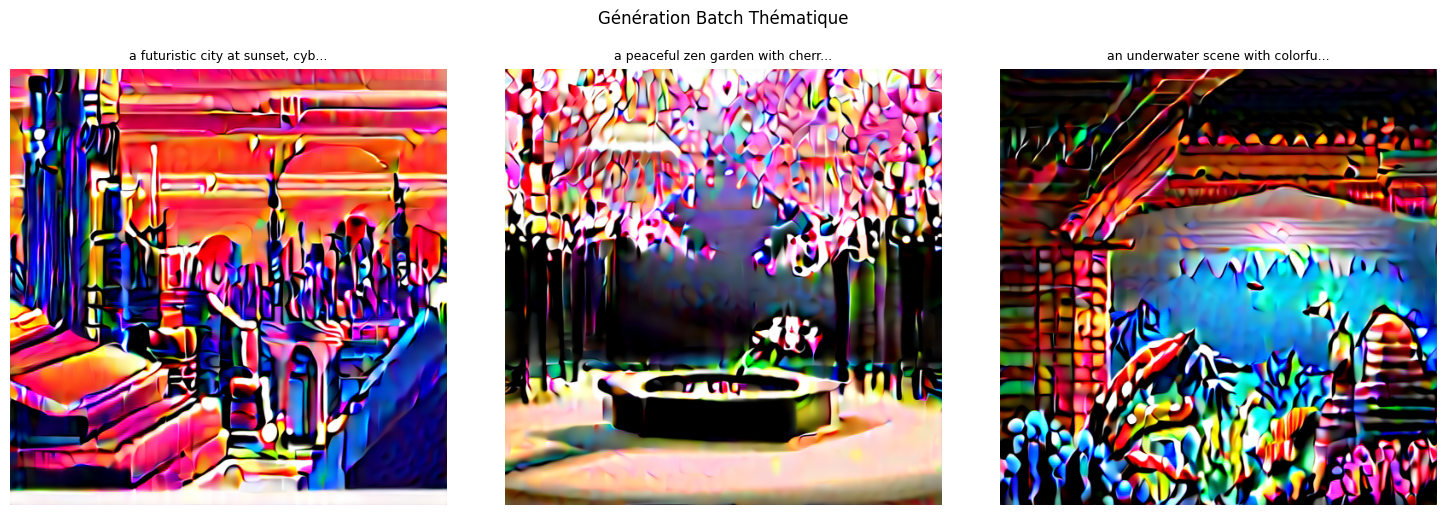
💡 Usage: Idéal pour prototypage rapide de concepts multiplesExercice 2 : Exploration des paramètres de generation
L’objectif de cet exercice est d’etudier l’impact des paramètres cfg_scale et sampler_name sur la qualite et le style des images generees.
Contexte : SD XL Turbo est optimise pour steps=4 et cfg_scale=2.0, mais explorer d’autres combinaisons permet de comprendre le comportement du modèle.
Instructions : 1. Choisissez un prompt fixe (ex: un paysage ou un personnage) 2. Testez au moins 3 valeurs de cfg_scale (1.0, 2.0, 4.0) 3. Testez au moins 2 samplers différents (DPM++ 2M, Euler a) 4. Observez et comparez les résultats
Indices : - # Indice : Un cfg_scale eleve peut produire des artefacts avec Turbo - # Indice : Le sampler Euler a tend a donner des résultats plus creatifs - # Étape 1 : Fixez le prompt et le seed pour une comparaison equitable - # Étape 2 : Faites varier un seul paramètre a la fois - # Étape 3 : Affichez les images en grille pour comparaison visuelle
# Exercice 2 : Exploration des parametres cfg_scale et sampler

# TODO etudiant : choisissez un prompt fixe pour la comparaison
prompt_fixe = "a mystical forest with glowing mushrooms, fantasy art"  # TODO etudiant : remplacez par votre prompt
seed_fixe = 42  # TODO etudiant : fixez un seed pour la reproductibilite

# TODO etudiant : definissez les valeurs de cfg_scale a tester
cfg_values = [1.0, 2.0, 4.0]  # TODO etudiant : ajoutez d'autres valeurs si souhaite

# TODO etudiant : definissez les samplers a tester
samplers = ["DPM++ 2M", "Euler a"]  # TODO etudiant : ajoutez d'autres samplers

# Generation comparative
resultats_ex2 = {}  # dict pour stocker (cfg, sampler) -> image

for cfg in cfg_values:
    for sampler in samplers:
        key = f"cfg={cfg}, {sampler}"
        print(f"Test : {key}")
        img = generate_with_seed(prompt_fixe, seed=seed_fixe)  # TODO etudiant : utilisez generate_with_seed en passant cfg_scale et sampler_name
        if img:
            resultats_ex2[key] = img
        print()

# TODO etudiant : affichez les images en grille (inspirez-vous du code de comparaison de prompts)
# Indice : utilisez plt.subplots avec len(resultats_ex2) colonnes

# Etape 3 : observation
print("Exercice a completer")
Test : cfg=1.0, DPM++ 2M
Test : cfg=1.0, Euler a
Test : cfg=2.0, DPM++ 2M
Test : cfg=2.0, Euler a
Test : cfg=4.0, DPM++ 2M
Test : cfg=4.0, Euler a
Exercice a completer5. Bonnes Pratiques et Recommandations
✅ À Faire
Prompts descriptifs: Inclure style, éclairage, qualité
"A serene lake, sunset lighting, photorealistic, 8k quality"Negative prompts efficaces: Spécifier défauts courants
"blurry, low quality, distorted, watermark, signature"Paramètres Turbo: Toujours utiliser
steps=4etcfg_scale=2.0Résolution optimale: 512×512 pour vitesse maximale
Gestion erreurs: Vérifier
image is not Noneavant utilisation
❌ À Éviter
- Steps élevés: > 4 steps annule l’avantage Turbo
- CFG élevé:
cfg_scale > 3.0produit artefacts avec Turbo - Résolutions extrêmes: < 256×256 ou > 768×768 (dégradation qualité)
- Prompts vagues: “une image” → résultats imprévisibles
- Timeouts courts: Génération prend ~18s, timeout < 30s risqué
🎯 Cas d’Usage Recommandés
| Scénario | SD XL Turbo | Autres Modèles |
|---|---|---|
| Prototypage rapide | ✅ Idéal | ❌ Trop lent |
| Itération créative | ✅ Excellent | ⚠️ Acceptable |
| Production finale | ⚠️ Acceptable | ✅ Préférable |
| Haute résolution (>1024px) | ❌ Non adapté | ✅ Recommandé |
"""
Exemple 4: Version améliorée avec logging coloré
(Inspiré du pattern LocalLlama)
"""

from enum import Enum

class LogColor(Enum):
    """Codes ANSI pour logging coloré dans notebooks"""
    RESET = '\033[0m'
    INFO = '\033[94m'      # Bleu
    SUCCESS = '\033[92m'   # Vert
    WARNING = '\033[93m'   # Jaune
    ERROR = '\033[91m'     # Rouge
    HEADER = '\033[95m'    # Magenta

def log_colored(message: str, color: LogColor = LogColor.INFO):
    """Affiche message coloré"""
    print(f"{color.value}{message}{LogColor.RESET.value}")

def generate_image_forge_v2(
    prompt: str,
    verbose: bool = True,
    **kwargs
) -> Optional[Image.Image]:
    """
    Version améliorée avec logging détaillé
    """
    if verbose:
        log_colored(f"🎨 Prompt: '{prompt}'", LogColor.HEADER)
        log_colored(f"⚙️  Paramètres: steps={kwargs.get('steps', 4)}, "
                   f"size={kwargs.get('width', 512)}×{kwargs.get('height', 512)}",
                   LogColor.INFO)

    # Génération
    image = generate_image_forge(prompt=prompt, **kwargs)

    # Logging résultat
    if image:
        if verbose:
            log_colored(f"✅ Génération réussie: {image.size[0]}×{image.size[1]}",
                       LogColor.SUCCESS)
        return image
    else:
        if verbose:
            log_colored("❌ Échec génération", LogColor.ERROR)
        return None

# Test
print("Test fonction avec logging coloré:")
print("-" * 50)
img_test = generate_image_forge_v2(
    prompt="A cozy cabin in snowy mountains",
    steps=4,
    width=512,
    height=512,
    verbose=True
)

if img_test:
    plt.figure(figsize=(6, 6))
    plt.imshow(img_test)
    plt.axis('off')
    plt.title("Test Logging Coloré", fontsize=11)
    plt.show()
Test fonction avec logging coloré: -------------------------------------------------- 🎨 Prompt: 'A cozy cabin in snowy mountains' ⚙️ Paramètres: steps=4, size=512×512 🎨 Génération en cours: 'A cozy cabin in snowy mountains...' ✅ Image générée (512×512) ✅ Génération réussie: 512×512
💡 Tips & Troubleshooting
Erreurs Courantes et Solutions
1. ⏱️ Timeout Error (requests.exceptions.Timeout)
Symptôme: La requête échoue après 60 secondes
Causes possibles: - Charge serveur élevée - Paramètres non-optimaux (steps > 4) - Résolution trop élevée (>768×768)
Solutions:
# Augmenter timeout si nécessaire
TIMEOUT = 90  # au lieu de 60

# Vérifier paramètres Turbo
steps = 4       # ✅ Optimal
cfg_scale = 2.0 # ✅ Optimal
width = 512     # ✅ Optimal
2. ❌ Bad Request Error (HTTP 400)
Symptôme: response.status_code == 400
Causes possibles: - Payload JSON mal formé - Paramètres invalides (sampler inconnu, résolution impaire) - Prompt trop long (>77 tokens)
Solutions:
# Valider payload avant envoi
import json
try:
    json.dumps(payload)  # Test sérialisation
except TypeError as e:
    print(f"Payload invalide: {e}")

# Vérifier résolution (multiple de 64)
width = (width // 64) * 64
height = (height // 64) * 64
3. 🖼️ Image Non Générée (payload vide)
Symptôme: result["images"] est vide ou absent
Causes possibles: - Prompt contient mots-clés bloqués (NSFW filter) - Modèle non chargé côté serveur
Solutions:
# Vérifier réponse complète
if "images" not in result:
    print(f"Réponse API: {result}")

# Tester avec prompt simple
prompt_test = "a landscape"  # Minimal, neutre
🚀 Tips Performance
Optimisation Vitesse
| Action | Gain | Trade-off |
|---|---|---|
steps=4 (vs 20) |
~4× plus rapide | Légère réduction qualité |
512×512 (vs 768×768) |
~2× plus rapide | Résolution inférieure |
cfg_scale=2.0 (vs 7.0) |
~1.5× plus rapide | Moins de guidage |
Optimisation Qualité
# Pour génération finale haute qualité
image_hq = generate_image_forge(
    prompt=prompt,
    steps=6,          # ⚠️ Compromis: +50% temps
    cfg_scale=2.5,    # Guidage légèrement renforcé
    width=768,
    height=768
)
📚 Ressources Complémentaires
- Guide Prompts Efficaces: Lexica.art (exemples visuels)
- Samplers Comparés: Stable Diffusion Wiki
- Negative Prompts Templates: PromptHero
🔗 Liens Utiles
- Documentation API Complète:
GUIDE-APIS-ETUDIANTS.md - Notebook Qwen (Édition Images):
01-5-Qwen-Image-Edit.ipynb - Status API Temps Réel:
https://turbo.stable-diffusion-webui-forge.myia.io/sdapi/v1/progress
Exercice 3 : Generation libre - synthese des techniques
Objectif
Créez votre propre génération d’image en appliquant les techniques apprises.
Instructions
- Choisissez un sujet: Paysage, portrait, objet, scène abstraite, etc.
- Rédigez un prompt descriptif: Incluez style, éclairage, qualité
- Définissez un negative prompt: Spécifiez les défauts à éviter
- Utilisez les paramètres Turbo optimaux:
steps=4,cfg_scale=2.0 - Générez et affichez l’image
Template de Code
Complétez le code ci-dessous avec vos propres paramètres :
# 🎯 EXERCICE PRATIQUE: Complétez ce code avec vos propres paramètres

# TODO: Définissez votre prompt personnalisé
mon_prompt = "Votre description ici"  # Ex: "A majestic dragon flying over a medieval castle"

# TODO: Définissez votre negative prompt
mon_negative_prompt = ""  # Ex: "blurry, low quality, distorted"

# Génération de votre image
mon_image = generate_image_forge(
    prompt=mon_prompt,
    negative_prompt=mon_negative_prompt,
    steps=4,          # Paramètre Turbo optimal
    cfg_scale=2.0,    # Paramètre Turbo optimal
    width=512,
    height=512
)

# Affichage du résultat
if mon_image:
    plt.figure(figsize=(8, 8))
    plt.imshow(mon_image)
    plt.axis('off')
    plt.title(f"Ma Création\n{mon_prompt[:60]}...", fontsize=12)
    plt.tight_layout()
    plt.show()

    print("\n✅ Félicitations! Votre image a été générée avec succès.")
    print(f"📝 Prompt utilisé: {mon_prompt}")
else:
    print("❌ La génération a échoué. Vérifiez vos paramètres et la connexion à l'API.")
🎨 Génération en cours: 'Votre description ici...'
✅ Image générée (512×512)
✅ Félicitations! Votre image a été générée avec succès.
📝 Prompt utilisé: Votre description ici
6. Ressources et Documentation
Documentation Complète
Pour approfondir vos connaissances sur l’API Forge et SD XL Turbo, consultez :
- Guide Étudiants API Forge:
docs/archive/suivis/genai-image/GUIDE-APIS-ETUDIANTS.md - Documentation Stable Diffusion: Stability AI Documentation
- API Forge WebUI: Automatic1111 API Wiki
Endpoints API Disponibles
| Endpoint | Description | Méthode |
|---|---|---|
/sdapi/v1/txt2img |
Génération texte→image | POST |
/sdapi/v1/img2img |
Transformation d’image | POST |
/sdapi/v1/options |
Configuration API | GET/POST |
/sdapi/v1/sd-models |
Liste modèles disponibles | GET |
Paramètres Avancés (Optionnels)
Explorez ces paramètres supplémentaires pour contrôle accru :
{
    "seed": -1,              # -1 = aléatoire, valeur fixe = reproductible
    "batch_size": 1,        # Nombre d'images générées simultanément
    "restore_faces": false, # Amélioration automatique des visages
    "tiling": false,        # Image répétable (textures)
    "enable_hr": false      # Hires.fix (haute résolution)
}
Références savantes
Les concepts fondateurs enseignés dans ce notebook (diffusion latente, distillation, guidance sans classifieur) reposent sur :
- Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-Resolution Image Synthesis with Latent Diffusion Models (CVPR 2022). Stable Diffusion = modèle de diffusion appliqué dans un espace latent compressé. arXiv:2112.10752.
- Podell, D., English, Z., Lacey, K., et al. (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis. Base dont SDXL Turbo est distillée. arXiv:2307.01952.
- Sauer, A., Lorenz, D., Blattmann, A., & Rombach, R. (2023). Adversarial Diffusion Distillation (Stability AI). Méthode de distillation permettant la génération en 1-4 étapes (SDXL Turbo). arXiv:2311.17042.
- Ho, J., & Salimans, T. (2022). Classifier-Free Diffusion Guidance. Mécanisme du paramètre (guidance sans classifieur). arXiv:2207.12598.
Support et Contact
Pour toute question ou problème technique :
- API Status: Vérifiez l’accessibilité à
https://turbo.stable-diffusion-webui-forge.myia.io - Documentation Projet: Consultez le README principal du projet CoursIA
- Issues GitHub: Signalez bugs/améliorations sur le dépôt du projet
Conclusion
SD XL Turbo via Forge WebUI (Automatic1111 fork) illustre l’approche open weights avec distillation adversariale : Sauer et al. (2023) ont compressé un modèle de diffusion classique (50+ steps) en seulement 4 steps grâce à l’Adversarial Diffusion Distillation, sans perte de qualité perceptible. C’est la même philosophie que FLUX.1-schnell mais avec un an d’avance et un écosystème (ComfyUI / Forge) plus mature.
Paramètres clés identifiés empiriquement : steps=4, cfg_scale=2.0, sampler=DPM++ 2M, résolution 512×512, latence ~18s par image. Le DPM++ 2M est le sampler de référence pour les modèles distillés — d’autres samplers (Euler, UniPC) produisent des artefacts visibles dès qu’on s’écarte des paramètres recommandés.
Aspects opérationnels : l’authentification par Basic Auth avec gestion de redirect login via Service Portal rend le notebook exploitable tant en local (127.0.0.1:7860) qu’en exposition publique myia.io. L’endpoint /sdapi/v1/txt2img est la pierre angulaire de toute chaîne de production basée sur Forge.
Comparaison avec les autres Foundation : SD XL Turbo est le compromis idéal entre rapidité (schnell), qualité d’image et accessibilité technique — il sert de référence de mesure pour évaluer les autres modèles. Pour les usages demandant un contrôle créatif fin (LoRA, inpainting, ControlNet), il faut basculer sur SDXL base ou Qwen-Image-Edit.
Pour aller plus loin : le pipeline ComfyUI sous-jacent à Forge est directement exploitable par les notebooks 02-Advanced (FLUX, Qwen 2509) et 03-Orchestration — la maîtrise de l’API ComfyUI est un prérequis transverse.