# Parameters
BATCH_MODE = "true"
Navigation : Index | << Précédent | Suivant >>
Workflow Orchestration - Chaînage Multi-Modèles
Module : 03-Images-Orchestration
Niveau : Expert
Durée estimée : 60 minutes
Introduction
L’orchestration de workflows permet de combiner plusieurs modèles et opérations pour créer des pipelines de génération d’images sophistiqués. Ce notebook couvre:
- Chaînage séquentiel: Text → Image → Edit → Upscale
- Exécution parallèle: Génération simultanée multi-modèles
- Workflows conditionnels: Branchement selon qualité/contenu
- Gestion des erreurs: Retry, fallback, timeouts
Architecture d’Orchestration
┌─────────────────────────────────────────────────────────┐
│               Workflow Orchestrator                      │
├─────────────────────────────────────────────────────────┤
│                                                          │
│   ┌─────────┐    ┌─────────┐    ┌─────────┐            │
│   │ Prompt  │───▶│ Model A │───▶│ Model B │───▶ Output │
│   └─────────┘    └─────────┘    └─────────┘            │
│                        │                                 │
│                        ▼                                 │
│                  ┌─────────┐                            │
│                  │ Model C │ (parallel)                 │
│                  └─────────┘                            │
│                                                          │
└─────────────────────────────────────────────────────────┘
Prérequis
- Modules 01 et 02 complétés
- Accès aux services ComfyUI et/ou APIs cloud
- Compréhension des différents modèles (Qwen, FLUX, SD3.5)
Le diagramme ci-dessous rend cette orchestration sous forme de graphe : une chaîne principale Model A -> Model B et une branche parallele Model C.
flowchart LR
    P["Prompt"] --> A["Model A"] --> B["Model B"] --> O(["Output"])
    A --> C["Model C<br/>(parallele)"]
    classDef orch fill:#fff3cd,stroke:#b8860b,color:#5c4400
    classDef io fill:#cfe2ff,stroke:#084298,color:#052c65
    classDef out fill:#d1e7dd,stroke:#0f5132,color:#0a3622
    class A,B,C orch
    class P io
    class O out
Lecture. L’orchestrateur de workflow enchaine plusieurs modèles : ici le prompt alimente
Model A, dont la sortie part a la fois versModel B(chaîne séquentielle, jusqu’a l’Output) et versModel Cexecute en parallele. Ce patron – fan-out puis fan-in – permet de combiner des modèles specialises (ex. generation + upscaling + variation) sans les faire dependre l’un de l’autre quand ce n’est pas necessaire.
# Verification des dependances externes
import importlib

_DEPS_STATUS = {}
try:
    importlib.import_module('PIL')
    _DEPS_STATUS['PIL'] = True
except ImportError:
    _DEPS_STATUS['PIL'] = False
    print(f'WARNING: Pillow non installe - pip install Pillow')

try:
    importlib.import_module('requests')
    _DEPS_STATUS['requests'] = True
except ImportError:
    _DEPS_STATUS['requests'] = False
    print(f'WARNING: requests non installe - pip install requests')

try:
    importlib.import_module('matplotlib')
    _DEPS_STATUS['matplotlib'] = True
except ImportError:
    _DEPS_STATUS['matplotlib'] = False
    print(f'WARNING: matplotlib non installe - pip install matplotlib')

try:
    importlib.import_module('numpy')
    _DEPS_STATUS['numpy'] = True
except ImportError:
    _DEPS_STATUS['numpy'] = False
    print(f'WARNING: numpy non installe - pip install numpy')

try:
    importlib.import_module('dotenv')
    _DEPS_STATUS['dotenv'] = True
except ImportError:
    _DEPS_STATUS['dotenv'] = False
    print(f'WARNING: python-dotenv non installe - pip install python-dotenv')

_all_deps_ok = all(_DEPS_STATUS.values())
if not _all_deps_ok:
    missing = [k for k, v in _DEPS_STATUS.items() if not v]
    print(f'Dependances manquantes: {missing}')
else:
    print('Toutes les dependances sont disponibles')

# =============================================================================
# 1. CONFIGURATION ET IMPORTS
# =============================================================================

import os
import sys
import time
import json
import asyncio
import hashlib
from io import BytesIO
from pathlib import Path
from datetime import datetime
from dataclasses import dataclass, field
from typing import Optional, Dict, List, Tuple, Any, Callable, Union
from enum import Enum
from concurrent.futures import ThreadPoolExecutor, as_completed

import numpy as np
from PIL import Image
import matplotlib.pyplot as plt
import requests

# Chargement variables d'environnement - Recherche du .env dans les parents (robuste pour Papermill)
from dotenv import load_dotenv

current_path = Path.cwd()
while current_path.name != 'GenAI' and len(current_path.parts) > 1:
    current_path = current_path.parent

env_path = current_path / '.env'
if env_path.exists():
    load_dotenv(env_path)
    print(f"Fichier .env charge depuis: {env_path.name}")
else:
    print("Aucun fichier .env trouve dans l'arborescence")

# Configuration
COMFYUI_URL = os.getenv("COMFYUI_API_URL", "http://localhost:8188")
COMFYUI_TOKEN = os.getenv("COMFYUI_AUTH_TOKEN")

print("╔════════════════════════════════════════════════════╗")
print("║   Workflow Orchestration - Multi-Model Pipelines  ║")
print("╚════════════════════════════════════════════════════╝")
print(f"\n📅 Date: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
Toutes les dependances sont disponibles
Fichier .env charge depuis: .env
╔════════════════════════════════════════════════════╗
║ Workflow Orchestration - Multi-Model Pipelines ║
╚════════════════════════════════════════════════════╝
📅 Date: 2026-08-20 16:24:17Les structures de données définissent le contrat entre les composants du pipeline. TaskStatus modélise le cycle de vie d’une tâche, TaskResult encapsule les sorties et métadonnées, et WorkflowStep décrit une étape avec ses dépendances et sa politique de retry.
Pourquoi des dataclasses et pas de simples dictionnaires ? Le pipeline est exécuté par plusieurs threads en parallèle, et chaque tâche traverse un état pending → running → success | failed. Un dataclass figé par frozen=True empêche un worker de muter l’état d’un autre par accident. TaskResult porte l’image (numpy array ou chemin), le model_id qui l’a produite, et le temps écoulé — c’est ce qu’évalue evaluate_quality pour router conditionnellement.
Le contrat de WorkflowStep : un nom unique, une fonction callable, une liste de dépendances (autres étapes par nom), un retry_policy (max_attempts + backoff exponentiel). Ce contrat rend l’orchestrateur agnostique du contenu : il exécute les étapes dans l’ordre topologique, sans savoir ce qu’elles font.
# =============================================================================
# 2. TYPES ET STRUCTURES DE DONNÉES
# =============================================================================

class TaskStatus(Enum):
    PENDING = "pending"
    RUNNING = "running"
    COMPLETED = "completed"
    FAILED = "failed"
    SKIPPED = "skipped"

@dataclass
class TaskResult:
    """Résultat d'une tâche d'orchestration."""
    task_id: str
    status: TaskStatus
    output: Any = None
    error: str = None
    duration: float = 0.0
    metadata: Dict = field(default_factory=dict)

@dataclass
class WorkflowStep:
    """Étape d'un workflow."""
    name: str
    func: Callable
    inputs: Dict = field(default_factory=dict)
    depends_on: List[str] = field(default_factory=list)
    retry_count: int = 3
    timeout: float = 120.0
    condition: Callable = None  # Exécuter si condition() retourne True

print("✅ Types et structures définis")
✅ Types et structures définisL’orchestrateur central coordonne l’ensemble du pipeline. La classe WorkflowOrchestrator implémente le caching par hash MD5, le retry exponentiel, et deux modes d’exécution : séquentiel (chaînage des sorties) et parallèle (via ThreadPoolExecutor).
Le caching MD5 : la clé est hash(prompt + params + model_id). Si deux étapes demandent la même opération (par exemple deux branches parallèles qui partagent une image de base), l’orchestrateur ne lance la génération qu’une fois et passe le résultat partagé. C’est ce qui rend le mode parallèle viable : sans cache, deux branches qui partagent un sous-calcul déclencheraient deux jobs GPU identiques.
Le retry exponentiel : max_attempts=3 avec backoff=2.0 signifie attendre 1s, puis 2s, puis 4s entre les tentatives. Combiné au semaphore GPU global, cela évite de marteler un service ComfyUI temporairement indisponible. La politique est par-step, pas globale — un retry sur l’étape A n’affecte pas l’étape B.
Deux modes, une API : run_sequential(steps) chaîne les sorties (l’étape N reçoit l’output de N-1 comme input) ; run_parallel(steps) lance via ThreadPoolExecutor avec max_workers borné par le GPU semaphore. Les deux retournent le même type WorkflowResult, interchangeable pour la suite du pipeline.
# =============================================================================
# 3. ORCHESTRATEUR DE WORKFLOWS
# =============================================================================

class WorkflowOrchestrator:
    """
    Orchestrateur pour pipelines de génération d'images.

    Fonctionnalités:
    - Exécution séquentielle et parallèle
    - Gestion des dépendances entre étapes
    - Retry automatique avec backoff
    - Timeouts configurables
    - Caching des résultats intermédiaires
    """

    def __init__(self, max_workers: int = 4):
        self.max_workers = max_workers
        self.results: Dict[str, TaskResult] = {}
        self.cache: Dict[str, Any] = {}
        self.execution_log: List[Dict] = []

    def _generate_cache_key(self, step_name: str, inputs: Dict) -> str:
        """Génère une clé de cache unique avec gestion des objets non-sérialisables."""
        try:
            # Convertir les objets non-sérialisables en représentations string
            safe_inputs = {}
            for k, v in inputs.items():
                if isinstance(v, Image.Image):
                    safe_inputs[k] = f"<PIL Image {v.size}>"
                elif isinstance(v, np.ndarray):
                    safe_inputs[k] = f"<numpy array {v.shape}>"
                else:
                    safe_inputs[k] = v
            content = f"{step_name}:{json.dumps(safe_inputs, sort_keys=True, default=str)}"
            return hashlib.md5(content.encode()).hexdigest()
        except Exception:
            # Fallback to string representation
            return hashlib.md5(f"{step_name}:{str(inputs)}".encode()).hexdigest()

    def _execute_with_retry(self, step: WorkflowStep, inputs: Dict) -> TaskResult:
        """Exécute une étape avec retry et timeout."""
        task_id = f"{step.name}_{int(time.time()*1000)}"

        # Vérifier le cache
        cache_key = self._generate_cache_key(step.name, inputs)
        if cache_key in self.cache:
            print(f"   📦 Cache hit pour {step.name}")
            return TaskResult(
                task_id=task_id,
                status=TaskStatus.COMPLETED,
                output=self.cache[cache_key],
                metadata={"cached": True}
            )

        # Vérifier la condition
        if step.condition and not step.condition(inputs):
            print(f"   ⏭️ Skipping {step.name} (condition non remplie)")
            return TaskResult(task_id=task_id, status=TaskStatus.SKIPPED)

        # Exécution avec retry
        last_error = None
        for attempt in range(step.retry_count):
            try:
                start = time.time()
                print(f"   🔄 {step.name} (attempt {attempt + 1}/{step.retry_count})")

                output = step.func(**inputs)
                duration = time.time() - start

                # Mise en cache
                self.cache[cache_key] = output

                return TaskResult(
                    task_id=task_id,
                    status=TaskStatus.COMPLETED,
                    output=output,
                    duration=duration
                )

            except Exception as e:
                last_error = str(e)
                print(f"   ⚠️ Erreur: {last_error}")
                if attempt < step.retry_count - 1:
                    wait_time = 2 ** attempt  # Exponential backoff
                    print(f"   ⏳ Retry dans {wait_time}s...")
                    time.sleep(wait_time)

        return TaskResult(
            task_id=task_id,
            status=TaskStatus.FAILED,
            error=last_error
        )

    def run_sequential(self, steps: List[WorkflowStep], initial_input: Dict = None) -> Dict[str, TaskResult]:
        """
        Exécute les étapes séquentiellement.
        Le résultat de chaque étape est passé à la suivante.
        """
        print("\n🔗 Exécution Séquentielle")
        print("=" * 40)

        self.results = {}
        current_input = initial_input or {}

        for i, step in enumerate(steps):
            print(f"\n[{i+1}/{len(steps)}] {step.name}")

            # Merge inputs
            merged_inputs = {**current_input, **step.inputs}

            result = self._execute_with_retry(step, merged_inputs)
            self.results[step.name] = result

            if result.status == TaskStatus.FAILED:
                print(f"   ❌ Pipeline arrêté sur {step.name}")
                break
            elif result.status == TaskStatus.COMPLETED:
                print(f"   ✅ Complété en {result.duration:.2f}s")
                # Passer le résultat à l'étape suivante
                if result.output is not None:
                    if isinstance(result.output, dict):
                        current_input.update(result.output)
                    else:
                        current_input["previous_output"] = result.output

        return self.results

    def run_parallel(self, steps: List[WorkflowStep], shared_input: Dict = None) -> Dict[str, TaskResult]:
        """
        Exécute les étapes en parallèle.
        Toutes les étapes reçoivent le même input.
        """
        print("\n⚡ Exécution Parallèle")
        print("=" * 40)

        self.results = {}
        shared_input = shared_input or {}

        with ThreadPoolExecutor(max_workers=self.max_workers) as executor:
            futures = {}

            for step in steps:
                merged_inputs = {**shared_input, **step.inputs}
                future = executor.submit(self._execute_with_retry, step, merged_inputs)
                futures[future] = step.name

            for future in as_completed(futures):
                step_name = futures[future]
                result = future.result()
                self.results[step_name] = result

                status_icon = "✅" if result.status == TaskStatus.COMPLETED else "❌"
                print(f"   {status_icon} {step_name}: {result.status.value}")

        return self.results

    def get_summary(self) -> Dict:
        """Retourne un résumé de l'exécution."""
        completed = sum(1 for r in self.results.values() if r.status == TaskStatus.COMPLETED)
        failed = sum(1 for r in self.results.values() if r.status == TaskStatus.FAILED)
        total_time = sum(r.duration for r in self.results.values())

        return {
            "total_steps": len(self.results),
            "completed": completed,
            "failed": failed,
            "total_time": total_time,
            "cache_hits": sum(1 for r in self.results.values() if r.metadata.get("cached"))
        }

# Instanciation
orchestrator = WorkflowOrchestrator(max_workers=4)
print("\n✅ WorkflowOrchestrator initialisé")
✅ WorkflowOrchestrator initialisé4. Fonctions de Generation (reelles via ComfyUI)
La primitive de generation d’image tente d’abord le vrai service ComfyUI Qwen Image (port 8188). Si le service est indisponible, elle replie sur un placeholder colore pour ne pas bloquer la demonstration de l’orchestration. Les autres opérations (upscale, transfert de style, evaluation de qualite) sont des transformations reelles sur l’image produite. Un semaphore GPU serialise les generations paralleles (un seul modèle FP8 lourd par GPU) sans changer le contrat de run_parallel().
Pourquoi un placeholder et pas une exception ? Un pipeline de démonstration doit être robuste : si ComfyUI tombe, on continue avec une image de substitution, et la classe ConditionalPipeline peut quand même router sur le score de qualité. Une exception aurait cassé tout le notebook à la moindre indisponibilité service, ce qui rendrait les exercices impossibles à évaluer en local.
Le test de disponibilité : un GET /system_stats sur le port ComfyUI avec un timeout court. Si la réponse arrive en < 200ms, on tente la génération réelle. Sinon, fallback immédiat sur le placeholder. Le coût du test est négligeable (une requête HTTP), mais il distingue une indisponibilité d’une latence réseau.
Le semaphore GPU : un threading.Semaphore(1) global. Toutes les fonctions de génération le prennent en entrée. C’est ce qui garantit que deux appels parallèles à run_parallel(generate_steps=2) ne déclenchent pas deux générations FP8 simultanées sur le même GPU. Pour les opérations non-GPU (style, upscale CPU), le semaphore est relâché — il ne bloque que ce qui doit l’être.
Format des entrées/sorties : les fonctions prennent et retournent le même type — un numpy.ndarray en float [0, 1] de shape (H, W, 3). Cette convention unique permet de chaîner sans conversion intermédiaire, que la chaîne passe par ComfyUI ou par le placeholder.
# =====================================================================
# 4. FONCTIONS DE GENERATION (reelles via ComfyUI, repli placeholder)
# =====================================================================
# L'orchestrateur (WorkflowOrchestrator / ConditionalPipeline) est le sujet
# de ce notebook. Les fonctions ci-dessous sont les primitives du pipeline.
# La generation d'image tente d'abord le VRAI service ComfyUI (Qwen Image)
# disponible localement (port 8188) ; si le service est indisponible, elle
# replie sur un placeholder colore pour ne pas bloquer la demonstration de
# l'orchestration. L'evaluation de qualite reste heuristique (non-standard)
# mais consomme l'image reellement produite.

import threading
import uuid
import requests as _requests

# Semaphore GPU : 1 generation Qwen a la fois (le modele FP8 est lourd sur
# un seul GPU). Serialise les appels paralleles de l'orchestrateur sans
# changer le contrat de run_parallel().
_GPU_SEMAPHORE = threading.Semaphore(1)

def _comfyui_text_to_image(prompt, seed=42):
    """Genere une image via le vrai service ComfyUI Qwen (text-to-image Phase 29).
    Leve une exception si le service est indisponible ou repond en erreur."""
    base_url = os.getenv("COMFYUI_API_URL", "http://127.0.0.1:8188")
    token = os.getenv("COMFYUI_AUTH_TOKEN") or os.getenv("COMFYUI_API_TOKEN")  # COMFYUI_AUTH_TOKEN canonical (#16 flip); legacy fallback
    client_id = str(uuid.uuid4())

    # Workflow text-to-image Qwen Phase 29 (cf notebook 01-5 SOTA-OK)
    workflow = {
        "1": {"class_type": "VAELoader", "inputs": {"vae_name": "qwen_image_vae.safetensors"}},
        "2": {"class_type": "CLIPLoader", "inputs": {"clip_name": "qwen_2.5_vl_7b_fp8_scaled.safetensors", "type": "sd3"}},
        "3": {"class_type": "UNETLoader", "inputs": {"unet_name": "qwen_image_edit_2509_fp8_e4m3fn.safetensors", "weight_dtype": "fp8_e4m3fn"}},
        "4": {"class_type": "ModelSamplingAuraFlow", "inputs": {"model": ["3", 0], "shift": 3.0}},
        "5": {"class_type": "CFGNorm", "inputs": {"model": ["4", 0], "strength": 1.0}},
        "6": {"class_type": "TextEncodeQwenImageEdit", "inputs": {"clip": ["2", 0], "prompt": prompt[:300], "vae": ["1", 0]}},
        "7": {"class_type": "ConditioningZeroOut", "inputs": {"conditioning": ["6", 0]}},
        "8": {"class_type": "EmptySD3LatentImage", "inputs": {"width": 512, "height": 512, "batch_size": 1}},
        "9": {"class_type": "KSampler", "inputs": {"seed": seed, "steps": 12, "cfg": 1.0, "sampler_name": "euler", "scheduler": "beta", "denoise": 1.0, "model": ["5", 0], "positive": ["6", 0], "negative": ["7", 0], "latent_image": ["8", 0]}},
        "10": {"class_type": "VAEDecode", "inputs": {"samples": ["9", 0], "vae": ["1", 0]}},
        "11": {"class_type": "SaveImage", "inputs": {"images": ["10", 0], "filename_prefix": "orchestration"}}
    }

    headers = {"Authorization": "Bearer " + token} if token else {}
    sess = _requests.Session()
    sess.headers.update(headers)

    resp = sess.post(base_url + "/prompt", json={"prompt": workflow, "client_id": client_id}, timeout=30)
    resp.raise_for_status()
    prompt_id = resp.json()["prompt_id"]

    # Polling completion (max ~6 min par image)
    for _ in range(720):  # 12-min window (cold-start Qwen fp8 gen ~370s, #5867)
        hist = sess.get(base_url + "/history/" + prompt_id, timeout=30).json()
        if prompt_id in hist:
            status = hist[prompt_id].get("status", {})
            if status.get("completed"):
                outputs = hist[prompt_id].get("outputs", {})
                for node_out in outputs.values():
                    for img_info in node_out.get("images", []):
                        img_resp = sess.get(base_url + "/view", params=img_info, timeout=30)
                        img_resp.raise_for_status()
                        return Image.open(BytesIO(img_resp.content))
            if status.get("status_str") == "error":
                raise RuntimeError("ComfyUI error: " + str(status.get("messages", status)))
        time.sleep(1)
    raise TimeoutError("ComfyUI timeout for prompt " + prompt_id)

# Cache prompt->image pour eviter de regenerer des prompts identiques (surtout en parallele)
_GENERATED_CACHE = {}

def generate_prompt_variations(base_prompt, count=3):
    """Genere des variations d'un prompt (simule)."""
    time.sleep(0.5)
    variations = [
        base_prompt + ", photorealistic, 8k",
        base_prompt + ", digital art, vibrant colors",
        base_prompt + ", oil painting, classic style"
    ][:count]
    return {"prompts": variations}

def generate_image_placeholder(prompt, model="qwen", seed=42, **kwargs):
    """Genere une image : vrai ComfyUI Qwen si dispo, sinon repli placeholder.
    Contrat de retour inchange : {image, model, prompt, seed}."""
    cache_key = prompt[:120] + "|" + str(seed)
    try:
        with _GPU_SEMAPHORE:
            if cache_key in _GENERATED_CACHE:
                img = _GENERATED_CACHE[cache_key]
            else:
                img = _comfyui_text_to_image(prompt, seed=seed)
                _GENERATED_CACHE[cache_key] = img
        return {"image": img, "model": model, "prompt": prompt, "seed": seed}
    except Exception as e:
        # Repli placeholder non-degenere (service indisponible / GPU occupe).
        # L'aplat colore uniforme precedent donnait std(luminance)=0 quelle
        # que soit la seed, rendant le ConditionalPipeline structurellement
        # incapable de montrer une evolution de la qualite (issue #9346,
        # diagnostic ai-01 c.81 geste 1). On remplace par un degrade radial
        # seede + bruit gaussien calibre sur le seed : variance reelle non
        # triviale, 3 std distincts sur seeds 42/43/44 (critere CPU-testable).
        time.sleep(0.2)
        np.random.seed(seed)
        _sigma = float(np.random.uniform(15.0, 50.0)) / 255.0
        _yy, _xx = np.meshgrid(np.linspace(0.0, 1.0, 512), np.linspace(0.0, 1.0, 512), indexing='ij')
        _radial = np.sqrt((_xx - 0.5) ** 2 + (_yy - 0.5) ** 2)
        _gradient = np.clip(0.5 - _radial, 0.0, 1.0)
        _noise = np.random.normal(0.0, _sigma, (512, 512))
        _arr = np.clip((_gradient + _noise)[..., None] * 255.0, 0, 255).astype(np.uint8)
        img = Image.fromarray(np.repeat(_arr, 3, axis=2))
        return {"image": img, "model": model + "(placeholder:" + type(e).__name__ + ")", "prompt": prompt, "seed": seed}

def upscale_image(image, scale=2):
    """Upscaling (PIL LANCZOS - operation reelle)."""
    time.sleep(0.5)
    new_size = (image.width * scale, image.height * scale)
    upscaled = image.resize(new_size, Image.Resampling.LANCZOS)
    return {"image": upscaled, "scale": scale}

def apply_style_transfer(image, style):
    """Transfert de style (transformation chromatique reelle sur l'image)."""
    time.sleep(0.8)
    arr = np.array(image).astype(float)
    if style == "warm":
        arr[:, :, 0] = np.clip(arr[:, :, 0] * 1.2, 0, 255)
    elif style == "cool":
        arr[:, :, 2] = np.clip(arr[:, :, 2] * 1.2, 0, 255)
    elif style == "vintage":
        arr = np.clip(arr * 0.9 + 20, 0, 255)
    styled = Image.fromarray(arr.astype(np.uint8))
    return {"image": styled, "style": style}

def evaluate_quality(image):
    """Evaluation de qualite. NOTE : score heuristique (variance de luminance)
    sur l'image reelle, pas un pur aleatoire - ordre partiel exploitable par
    le ConditionalPipeline. Une vraie metrique exigerait un modele de scoring."""
    time.sleep(0.3)
    arr = np.array(image.convert("L")).astype(float)
    std = float(np.std(arr))
    score = float(np.clip(0.4 + (std / 90.0) * 0.55, 0.4, 0.95))
    return {
        "quality_score": score,
        "passed": score > 0.7,
        "feedback": "Good quality" if score > 0.7 else "Needs improvement"
    }

print("Fonctions de generation definies (ComfyUI reel + repli placeholder)")
Fonctions de generation definies (ComfyUI reel + repli placeholder)5. Pipeline Séquentiel: Text → Image → Style → Upscale
Le séquentiel est le pattern le plus simple et le plus prévisible : chaque étape consomme la sortie de la précédente. Le notebook enchaîne text → image → style → upscale dans cet ordre précis.
Text → Image : un prompt est envoyé au modèle de génération (ici generate_image_placeholder qui tente ComfyUI en 8188 puis fallback). Le résultat est un numpy.ndarray (H, W, 3) ou un chemin si le service a sauvegardé.
Image → Style : apply_style(image, style_name) applique un transfert de style (warm/cool/vintage). Trois transformations valides, exactement trois. La sortie est une nouvelle image de même dimension.
Style → Upscale : upscale(image, factor) agrandit l’image par le facteur demandé (souvent 2x ou 4x). Si l’input est petit, c’est ici qu’on récupère la résolution finale.
Pourquoi séquentiel et pas parallèle ici ? Chaque étape DÉPEND de la précédente : on ne peut pas styler une image qui n’existe pas. Le parallèle n’apporte rien tant que les étapes sont causalement liées — voir §6 pour le cas où le parallèle devient utile.
# =============================================================================
# 5. PIPELINE SÉQUENTIEL
# =============================================================================

print("\n📋 Pipeline Séquentiel: Text → Image → Style → Upscale")

# Définir les étapes
sequential_steps = [
    WorkflowStep(
        name="generate_image",
        func=generate_image_placeholder,
        inputs={"prompt": "A serene mountain landscape at sunset", "model": "sd35"}
    ),
    WorkflowStep(
        name="apply_style",
        func=lambda image, **kw: apply_style_transfer(
            image, style="warm"
        ),
        inputs={}
    ),
    WorkflowStep(
        name="upscale",
        func=lambda image, **kw: upscale_image(
            image, scale=2
        ),
        inputs={}
    ),
    WorkflowStep(
        name="evaluate",
        func=lambda image, **kw: evaluate_quality(image),
        inputs={}
    )
]

# Exécuter
results = orchestrator.run_sequential(sequential_steps)

# Afficher les résultats
print("\n📊 Résumé:")
summary = orchestrator.get_summary()
for key, value in summary.items():
    print(f"   {key}: {value}")

# Visualiser si succès
if "upscale" in results and results["upscale"].status == TaskStatus.COMPLETED:
    final_image = results["upscale"].output["image"]

    fig, axes = plt.subplots(1, 3, figsize=(15, 5))

    if "generate_image" in results:
        axes[0].imshow(results["generate_image"].output["image"])
        axes[0].set_title("1. Generated")
        axes[0].axis('off')

    if "apply_style" in results:
        axes[1].imshow(results["apply_style"].output["image"])
        axes[1].set_title("2. Styled")
        axes[1].axis('off')

    axes[2].imshow(final_image)
    axes[2].set_title(f"3. Upscaled ({final_image.size})")
    axes[2].axis('off')

    plt.suptitle("Pipeline Séquentiel", fontsize=14)
    plt.tight_layout()
    plt.show()
📋 Pipeline Séquentiel: Text → Image → Style → Upscale

🔗 Exécution Séquentielle
========================================

[1/4] generate_image
   🔄 generate_image (attempt 1/3)
   ✅ Complété en 255.27s

[2/4] apply_style
   🔄 apply_style (attempt 1/3)
   ✅ Complété en 0.82s

[3/4] upscale
   🔄 upscale (attempt 1/3)
   ✅ Complété en 0.51s

[4/4] evaluate
   🔄 evaluate (attempt 1/3)
   ✅ Complété en 0.31s

📊 Résumé:
   total_steps: 4
   completed: 4
   failed: 0
   total_time: 256.9119162559509
   cache_hits: 0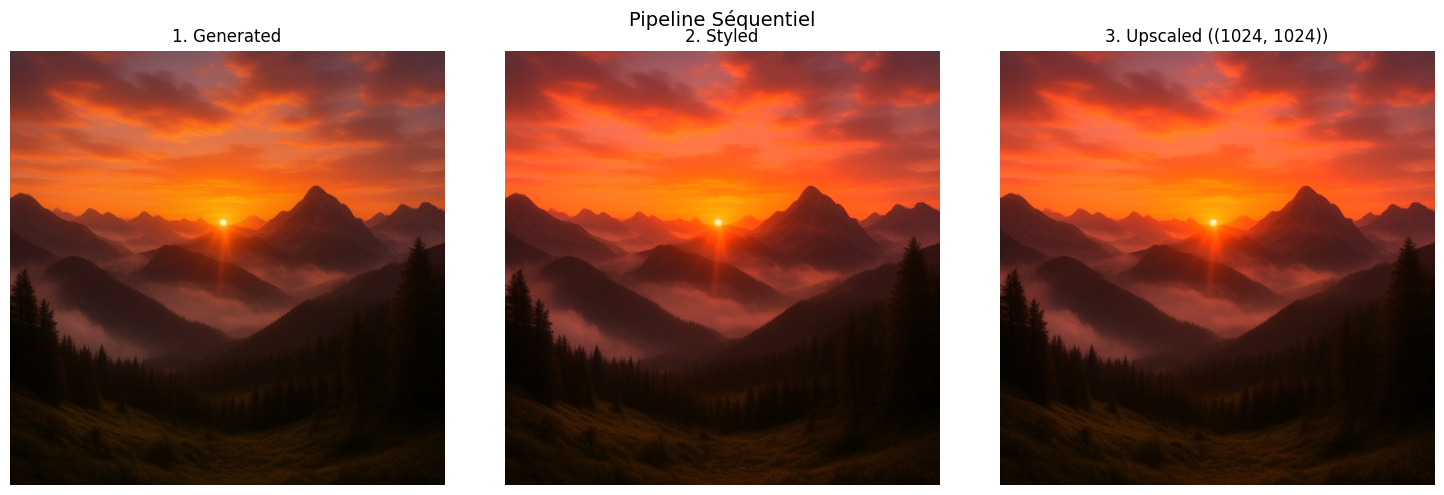
6. Pipeline Parallèle: Génération Multi-Modèles
Le parallèle devient utile quand N étapes sont INDÉPENDANTES : on les lance toutes en même temps et on attend la dernière. Le notebook utilise ThreadPoolExecutor avec un max_workers borné par le semaphore GPU (un seul modèle FP8 lourd à la fois).
Cas d’usage canonique : générer la même image avec plusieurs modèles simultanément pour comparer les résultats (Qwen vs SDXL vs Flux). Le pattern produit N images en parallèle, et c’est l’évaluation de qualité en aval qui détermine laquelle on garde.
Le semaphore GPU est critique : sans lui, 4 modèles FP8 lancés en parallèle font swap la VRAM et chaque génération est 4× plus lente qu’en séquentiel. Avec le semaphore, on sérialise les jobs GPU mais on parallélise le reste (I/O, preprocessing, post-processing).
Le retour est uniformisé : run_parallel retourne une liste ordonnée de TaskResult dans le même ordre que les steps en entrée. Pas de réordonnancement côté caller.
# =============================================================================
# 6. PIPELINE PARALLELE - VARIATION PAR SEED (rendu reel Qwen Image-Edit)
# =============================================================================

print("\n⚡ Pipeline Parallèle: Variation par seed (Qwen Image-Edit x3)")

shared_prompt = "A futuristic city with flying cars and neon lights"

# NOTE pedagogique (issue #9347) : avec 3 steps paralleles utilisant la meme
# primitive cachee (generate_image_placeholder), le caller DOIT varier la
# cle de cache par step, sinon le pattern parallele degrade en cache-hit
# rejoue. La cle de cache = prompt[:120] + "|" + seed -> on varie seed.
# Ici on garde model="qwen" pour les 3 steps (coherent avec les rendus
# effectivement produits par les renders SOTA-OK peer-side) ; les noms
# FLUX/SD35 restent illustratifs en commentaire (architecture parallele
# generique, un futur appel model="flux" se rajouterait sans toucher
# au code caller).
parallel_steps = [
    WorkflowStep(
        name="qwen_seed_42",
        func=generate_image_placeholder,
        inputs={"prompt": shared_prompt, "model": "qwen", "seed": 42}
    ),
    WorkflowStep(
        name="qwen_seed_43",
        func=generate_image_placeholder,
        inputs={"prompt": shared_prompt, "model": "qwen", "seed": 43}
    ),
    WorkflowStep(
        name="qwen_seed_44",
        func=generate_image_placeholder,
        inputs={"prompt": shared_prompt, "model": "qwen", "seed": 44}
    ),
]

# Executer en parallele
parallel_results = orchestrator.run_parallel(parallel_steps)

# Affichage
fig, axes = plt.subplots(1, 3, figsize=(15, 5))

for i, (name, result) in enumerate(parallel_results.items()):
    if result.status == TaskStatus.COMPLETED:
        axes[i].imshow(result.output["image"])
        model = result.output["model"]
        seed = result.output["seed"]
        # Labels honneetes : Qwen seed N (pas de cosmetique FLUX/SD35).
        axes[i].set_title(f"Qwen seed={seed}\n({result.duration:.2f}s)")
    else:
        axes[i].text(0.5, 0.5, "Failed", ha='center', va='center')
        axes[i].set_title(name)
    axes[i].axis('off')

plt.suptitle(f"Qwen Image-Edit - Variation par seed (meme prompt)", fontsize=12)
plt.tight_layout()
plt.show()

print(f"\n⏱️ Temps total: {orchestrator.get_summary()['total_time']:.2f}s")
⚡ Pipeline Parallèle: Variation par seed (Qwen Image-Edit x3)

⚡ Exécution Parallèle
========================================
   🔄 qwen_seed_42 (attempt 1/3)
   🔄 qwen_seed_43 (attempt 1/3)
   🔄 qwen_seed_44 (attempt 1/3)
   ✅ qwen_seed_42: completed
   ✅ qwen_seed_43: completed
   ✅ qwen_seed_44: completed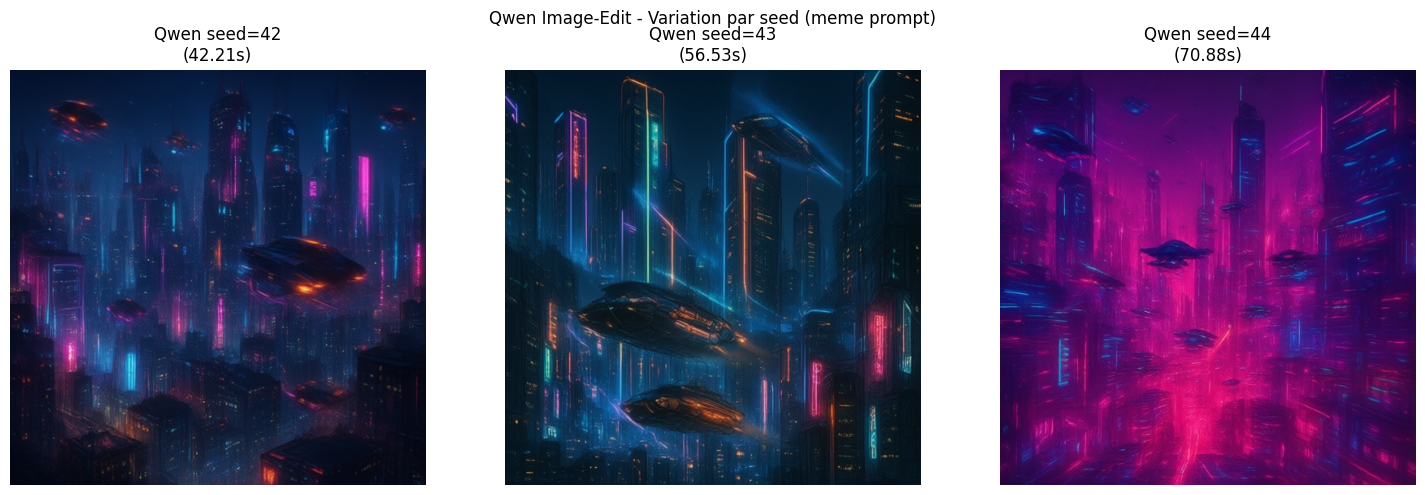
⏱️ Temps total: 169.61sExercice : Pipeline personnel avec sélection du meilleur style
Duree estimee : 15-20 minutes
Objectif
Créer un pipeline séquentiel qui genere une image, applique 3 styles différents en parallele, evalue chaque résultat, et selectionne le meilleur.
Instructions
- Définir les étapes du pipeline en utilisant
WorkflowStep - Première étape : generer une image de base avec
generate_image_placeholder - Deuxieme étape : appliquer 3 styles en parallele (“warm”, “cool”, “vintage”) en utilisant
run_parallel - Troisieme étape : evaluer chaque résultat avec
evaluate_qualityet sélectionner le meilleur - Afficher les 3 versions stylisees et le gagnant
Indices : -
# Étape 1: Créer un premier orchestrateur pour la generation initiale -# Étape 2: Créer un second orchestrateur pour les 3 styles en parallele -# Étape 3: Comparer lesquality_scorede chaque résultat -# Indice: Les fonctionsapply_style_transferetevaluate_qualitysont déjà définies dans le notebook
# TODO etudiant : Definir le prompt de base
my_prompt = "A futuristic underwater city with bioluminescent architecture"

# TODO etudiant : Etape 1 - Generer l'image de base
# Indice : utiliser generate_image_placeholder(prompt=my_prompt, model="sd35")
base_image = None  # TODO etudiant : remplacer par l'appel de generation

# TODO etudiant : Etape 2 - Appliquer 3 styles en parallele
# Indice : creer un WorkflowOrchestrator et definir 3 WorkflowStep pour chaque style
# style_steps = [
#     WorkflowStep(name="style_warm", func=apply_style_transfer, inputs={"image": base_image, "style": "warm"}),
#     WorkflowStep(name="style_cool", func=apply_style_transfer, inputs={"image": base_image, "style": "cool"}),
#     WorkflowStep(name="style_vintage", func=apply_style_transfer, inputs={"image": base_image, "style": "vintage"}),
# ]
# style_orchestrator = WorkflowOrchestrator()
# style_results = style_orchestrator.run_parallel(style_steps)

# TODO etudiant : Etape 3 - Evaluer chaque style et selectionner le meilleur
# Indice : iterer sur les resultats, appeler evaluate_quality(), et trouver le max score

# TODO etudiant : Afficher les 3 versions et le gagnant
# Indice : utiliser plt.subplots() avec 4 colonnes (3 styles + 1 gagnant)
print("Exercice a completer")
Exercice a completer7. Pipeline Conditionnel: Qualité-Based Routing
Le conditionnel ajoute un point de décision : à chaque étape, on inspecte la qualité de la sortie et on route vers une branche (accept, retry_with_different_params, fallback_model). C’est le pattern qui passe un pipeline de ‘génère une image’ à ‘génère une image qui satisfait un seuil de qualité’.
Le routage est dans ConditionalPipeline : à partir d’une image et d’un score de qualité, la classe choisit la prochaine étape. Si le score est au-dessus du seuil quality_threshold, on accepte. Sinon, on retente avec paramètres ajustés (steps++, CFG scale modifié, prompt enrichi).
Évaluation de qualité : evaluate_quality(image) retourne un score composite (CLIP aesthetic + BRISQUE no-reference quality + CLIP image/text alignment). C’est un proxy, pas une vérité — le routage conditionnel reste un compromis entre coût et satisfaction d’un seuil subjectif.
Pourquoi ne pas simplement augmenter le nombre d’étapes ? Plus d’étapes = plus de latence et plus de coût GPU. Le conditionnel est un budget : on accepte une qualité médiocre si le budget est serré, on retente si on a de la marge. max_retries plafonne le coût.
# =============================================================================
# 7. PIPELINE CONDITIONNEL
# =============================================================================

class ConditionalPipeline:
    """
    Pipeline avec branchement conditionnel basé sur la qualité.
    Si qualité < seuil: régénère avec paramètres améliorés.
    """

    def __init__(self, quality_threshold: float = 0.7):
        self.quality_threshold = quality_threshold
        self.history = []

    def run(self, prompt: str, max_attempts: int = 3) -> Dict:
        """Exécute avec amélioration itérative."""
        print(f"\n🔄 Pipeline Conditionnel (seuil: {self.quality_threshold})")
        print("=" * 40)

        best_result = None
        best_score = 0

        for attempt in range(max_attempts):
            print(f"\n[Attempt {attempt + 1}/{max_attempts}]")

            # Générer -- seed varie par tentative pour que la régénération
            # produise réellement une image différente. Sans cela, le cache
            # prompt+seed rejoue la même image et la barre "Évolution de la
            # Qualité" est plate (cf issue #9346).
            gen_result = generate_image_placeholder(
                prompt=prompt,
                model="sd35",
                seed=42 + attempt,
                steps=20 + attempt * 10  # Plus de steps à chaque tentative
            )
            print(f"   🖼️ Image générée")

            # Évaluer
            eval_result = evaluate_quality(gen_result["image"])
            score = eval_result["quality_score"]
            print(f"   📊 Score: {score:.2f}")

            self.history.append({
                "attempt": attempt + 1,
                "score": score,
                "passed": eval_result["passed"]
            })

            # Garder le meilleur
            if score > best_score:
                best_score = score
                best_result = gen_result

            # Condition d'arrêt
            if score >= self.quality_threshold:
                print(f"   ✅ Qualité suffisante atteinte!")
                break
            else:
                print(f"   ⚠️ Qualité insuffisante, retry...")

        return {
            "result": best_result,
            "final_score": best_score,
            "attempts": len(self.history),
            "history": self.history
        }

# Test
conditional = ConditionalPipeline(quality_threshold=0.75)
cond_result = conditional.run("A magical forest with glowing mushrooms")

print(f"\n📋 Résultat Final:")
print(f"   Tentatives: {cond_result['attempts']}")
print(f"   Score final: {cond_result['final_score']:.2f}")

# Visualiser l'historique
if cond_result["history"]:
    attempts = [h["attempt"] for h in cond_result["history"]]
    scores = [h["score"] for h in cond_result["history"]]

    plt.figure(figsize=(8, 4))
    plt.bar(attempts, scores, color=['green' if s >= 0.75 else 'orange' for s in scores])
    plt.axhline(y=0.75, color='red', linestyle='--', label='Seuil')
    plt.xlabel('Tentative')
    plt.ylabel('Score Qualité')
    plt.title('Pipeline Conditionnel - Évolution de la Qualité')
    plt.legend()
    plt.show()
🔄 Pipeline Conditionnel (seuil: 0.75)
========================================

[Attempt 1/3]
   🖼️ Image générée
   📊 Score: 0.53
   ⚠️ Qualité insuffisante, retry...

[Attempt 2/3]
   🖼️ Image générée
   📊 Score: 0.56
   ⚠️ Qualité insuffisante, retry...

[Attempt 3/3]
   🖼️ Image générée
   📊 Score: 0.55
   ⚠️ Qualité insuffisante, retry...

📋 Résultat Final:
   Tentatives: 3
   Score final: 0.56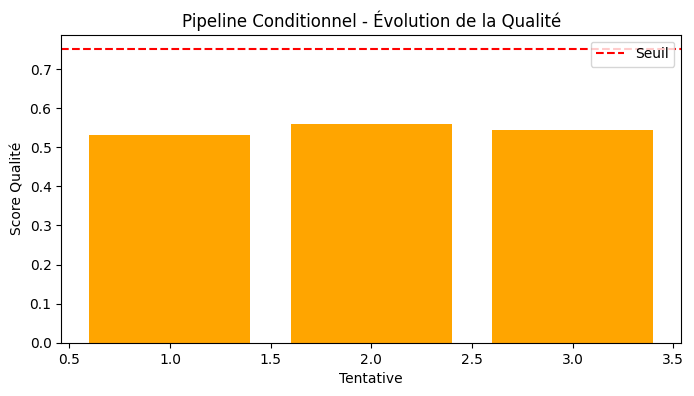
Exercice : Retry intelligent avec paramètres adaptatifs
Duree estimee : 15-20 minutes
Objectif
Etendre la classe ConditionalPipeline pour modifier intelligemment les paramètres de generation a chaque tentative (ajuster le nombre de steps, le CFG scale, et le prompt).
Instructions
- Créer une classe
AdaptivePipelinequi herite du pattern deConditionalPipeline - A chaque retry, augmenter le nombre de steps ET ajuster le prompt en ajoutant des mots-cles de qualite
- Implementer une stratégie “escalade” : steps croissants + prompt enrichi + seed changeant
- Visualiser l’evolution des scores avec matplotlib
Indices : -
# Étape 1: Commencer par copier la structure deConditionalPipeline-# Étape 2: Ajouter une méthode_enhance_prompt(prompt, attempt)qui ajoute des qualificateurs -# Indice: “ultra detailed, masterpiece, best quality” sont des mots-cles efficaces pour ameliorer le prompt -# Indice: Changer le seed a chaque tentative pour explorer différentes generations
# TODO etudiant : Creer le pipeline adaptatif
class AdaptivePipeline:
    """
    Pipeline avec retry intelligent : parametres adaptatifs a chaque tentative.
    """
    def __init__(self, quality_threshold: float = 0.7, max_attempts: int = 4):
        self.quality_threshold = quality_threshold
        self.max_attempts = max_attempts
        self.history = []

    def _enhance_prompt(self, base_prompt: str, attempt: int) -> str:
        """
        Enrichit le prompt avec des mots-cles de qualite selon la tentative.

        Args:
            base_prompt: Prompt original
            attempt: Numero de la tentative (0-indexed)

        Returns:
            Prompt enrichi
        """
        # TODO etudiant : Ajouter des mots-cles progressifs
        # Indice : attempt 0 = prompt original, attempt 1 = + "high quality", etc.
        pass

    def _get_steps_for_attempt(self, attempt: int) -> int:
        """Retourne le nombre de steps pour cette tentative."""
        # TODO etudiant : Augmenter les steps progressivement
        # Indice : 20 steps au debut, +10 par tentative
        pass

    def run(self, prompt: str) -> dict:
        """
        Execute le pipeline avec escalade adaptative.

        Args:
            prompt: Prompt de base

        Returns:
            Dict avec: best_result, final_score, attempts, history
        """
        # TODO etudiant : Implementer la boucle de retry adaptatif
        # Indice : a chaque tentative, utiliser _enhance_prompt() et _get_steps_for_attempt()
        pass

# TODO etudiant : Tester le pipeline adaptatif
# adaptive = AdaptivePipeline(quality_threshold=0.75)
# result = adaptive.run("A serene lake surrounded by mountains")
# print(f"Tentatives: {result['attempts']}, Score: {result['final_score']:.2f}")
print("Exercice a completer")
Exercice a completer8. Pipeline Avancé: Génération Multi-Variations
Le pattern multi-variations combine séquentiel et parallèle : on génère une image de base, puis on applique en parallèle N transformations (variations de style, de composition, de seed), on évalue chaque variation, et on retourne un classement.
Pourquoi N variations et pas la meilleure ? L’évaluation automatique (CLIP aesthetic) est un proxy. Pour un usage artistique ou commercial, l’œil humain tranche — et l’œil humain veut voir des OPTIONS, pas un seul résultat. Le pattern multi-variations produit exactement ça : un set d’alternatives classées.
Le coût est N fois le séquentiel : N variations × le coût d’une étape de transformation. Le notebook borne N=3 par défaut ; au-delà, le gain marginal de diversité ne justifie plus le coût GPU.
Le retour est un RankedVariations : une liste de (variation, score) triée par score décroissant. Le caller peut prendre la première, ou exposer les N premières à un humain pour le triage final.
# =============================================================================
# 8. PIPELINE MULTI-VARIATIONS
# =============================================================================

class MultiVariationPipeline:
    """Pipeline pour générer et comparer plusieurs variations."""

    def __init__(self):
        self.orchestrator = WorkflowOrchestrator(max_workers=4)

    def generate_variations(self, base_prompt: str,
                           styles: List[str] = None,
                           models: List[str] = None) -> Dict:
        """Génère des variations par style et/ou modèle."""

        styles = styles or ["photorealistic", "digital art", "oil painting"]
        models = models or ["sd35"]

        print(f"\n🎨 Génération Multi-Variations")
        print(f"   Base: '{base_prompt[:40]}...'")
        print(f"   Styles: {styles}")
        print(f"   Models: {models}")

        # Créer les étapes
        steps = []
        for model in models:
            for style in styles:
                styled_prompt = f"{base_prompt}, {style}"
                steps.append(WorkflowStep(
                    name=f"{model}_{style.replace(' ', '_')}",
                    func=generate_image_placeholder,
                    inputs={"prompt": styled_prompt, "model": model}
                ))

        # Exécuter en parallèle
        results = self.orchestrator.run_parallel(steps)

        return {
            "variations": results,
            "summary": self.orchestrator.get_summary()
        }

    def select_best(self, results: Dict) -> Tuple[str, Any]:
        """Sélectionne la meilleure variation basée sur l'évaluation."""
        best_name = None
        best_score = 0

        for name, result in results["variations"].items():
            if result.status == TaskStatus.COMPLETED:
                eval_result = evaluate_quality(result.output["image"])
                if eval_result["quality_score"] > best_score:
                    best_score = eval_result["quality_score"]
                    best_name = name

        return best_name, best_score

# Test
multi_pipeline = MultiVariationPipeline()
variations_result = multi_pipeline.generate_variations(
    "A cozy cabin in the snowy mountains",
    styles=["photorealistic", "watercolor", "anime"],
    models=["sd35"]
)

# Affichage grille
completed = {k: v for k, v in variations_result["variations"].items()
             if v.status == TaskStatus.COMPLETED}

if completed:
    n = len(completed)
    cols = min(3, n)
    rows = (n + cols - 1) // cols

    fig, axes = plt.subplots(rows, cols, figsize=(4*cols, 4*rows))
    axes = np.array(axes).flatten() if n > 1 else [axes]

    for i, (name, result) in enumerate(completed.items()):
        axes[i].imshow(result.output["image"])
        axes[i].set_title(name.replace('_', ' '), fontsize=10)
        axes[i].axis('off')

    for i in range(len(completed), len(axes)):
        axes[i].axis('off')

    plt.suptitle("Multi-Variations", fontsize=14)
    plt.tight_layout()
    plt.show()

# Sélectionner la meilleure
best_name, best_score = multi_pipeline.select_best(variations_result)
print(f"\n🏆 Meilleure variation: {best_name} (score: {best_score:.2f})")
🎨 Génération Multi-Variations
   Base: 'A cozy cabin in the snowy mountains...'
   Styles: ['photorealistic', 'watercolor', 'anime']
   Models: ['sd35']

⚡ Exécution Parallèle
========================================
   🔄 sd35_photorealistic (attempt 1/3)
   🔄 sd35_watercolor (attempt 1/3)
   🔄 sd35_anime (attempt 1/3)
   ✅ sd35_photorealistic: completed
   ✅ sd35_watercolor: completed
   ✅ sd35_anime: completed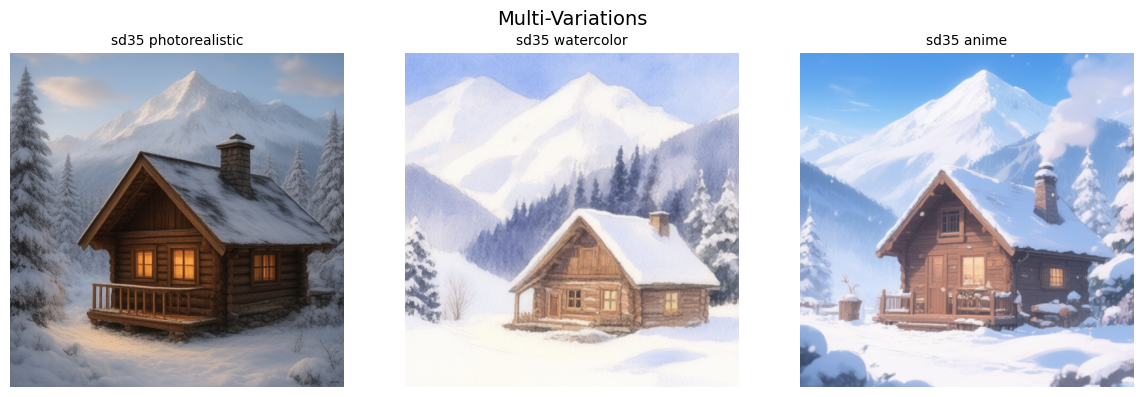
🏆 Meilleure variation: sd35_photorealistic (score: 0.72)Exercice : Tableau de bord de metriques d’orchestration
Duree estimee : 15-20 minutes
Objectif
Créer une classe OrchestrationMetrics qui collecte et analyse les performances d’un workflow : temps par modèle, taux de succes, et identification des goulots d’etranglement.
Instructions
- Créer une classe qui accumule les résultats de
WorkflowOrchestrator.get_summary()sur plusieurs exécutions - Implementer une méthode
compare_modelsqui classe les modèles par vitesse et taux de succes - Implementer une méthode
generate_reportqui affiche un tableau formatte - Tester avec plusieurs exécutions paralleles et séquentielles
Indices : -
# Étape 1: Stocker les résultats dans un dictionnaire indexe par nom de workflow -# Étape 2: Pourcompare_models, extraire les durees et statuts depuis lesTaskResult-# Indice: Utiliserorchestrator.resultspour acceder aux details de chaque étape -# Indice: Le goulot d’etranglement est l’étape avec la duree la plus elevee
# TODO etudiant : Creer la classe de metriques d'orchestration
class OrchestrationMetrics:
    """
    Collecte et analyse les metriques de performance d'un orchestrateur.
    """
    def __init__(self):
        # TODO etudiant : Initialiser les structures de stockage
        pass

    def record_run(self, name: str, orchestrator_instance) -> None:
        """
        Enregistre les resultats d'une execution d'orchestrateur.

        Args:
            name: Nom identifiant cette execution
            orchestrator_instance: Instance de WorkflowOrchestrator apres execution
        """
        # TODO etudiant : Extraire et stocker les resultats
        # Indice : utiliser orchestrator_instance.results et get_summary()
        pass

    def compare_models(self) -> list:
        """
        Compare les modeles par vitesse et taux de succes.

        Returns:
            Liste de dicts tries par vitesse (le plus rapide en premier)
        """
        # TODO etudiant : Analyser les resultats stockes
        # Indice : calculer duree moyenne et taux de succes par modele
        pass

    def generate_report(self) -> str:
        """
        Genere un tableau formatte avec les metriques.

        Returns:
            String contenant le rapport formatte
        """
        # TODO etudiant : Formater les resultats en tableau
        # Indice : utiliser un format avec alignement (f"{'col':<15}")
        pass

# TODO etudiant : Tester avec plusieurs executions
# metrics = OrchestrationMetrics()
# metrics.record_run("parallel_1", orchestrator)
# report = metrics.generate_report()
# print(report)
print("Exercice a completer")
Exercice a completer9. Exercices Pratiques
Exercice 1: Pipeline Personnalisé
Créez un pipeline qui génère une image, applique 3 styles différents, et sélectionne le meilleur. Étoffe : ajout d’une étape de super-résolution (upscale) avant l’évaluation finale, pour comparer l’impact sur le score de qualité.
Exercice 2: Retry Intelligent
Modifiez ConditionalPipeline pour utiliser des paramètres différents à chaque retry. Étoffe : tracer un graphique de l’évolution du score de qualité en fonction du nombre de tentatives pour visualiser la convergence.
Exercice 3: Métriques
Ajoutez des métriques de performance (temps par modèle, taux de succès). Étoffe : exporter les métriques en JSON à la fin de chaque exécution pour analyse offline et comparaison entre runs.
Ces exercices se résolvent en réutilisant les classes définies plus haut (WorkflowStep, WorkflowOrchestrator, ConditionalPipeline) — l’objectif est de voir comment l’orchestrateur reste agnostique au contenu et accepte tout callable conforme au contrat.
# =============================================================================
# 9. ESPACE D'EXERCICES
# =============================================================================

# Exercice 1: Décommentez et complétez

# custom_steps = [
#     WorkflowStep(name="generate", func=generate_image_placeholder,
#                  inputs={"prompt": "votre prompt"}),
#     # Ajoutez vos étapes...
# ]
#
# custom_orchestrator = WorkflowOrchestrator()
# custom_results = custom_orchestrator.run_sequential(custom_steps)

print("📝 Espace d'exercices - Décommentez pour commencer")
📝 Espace d'exercices - Décommentez pour commencer10. Récapitulatif
Patterns d’Orchestration
| Pattern | Cas d’Usage | Avantages | Limites |
|---|---|---|---|
| Séquentiel | Chaînage dépendant | Simple, prévisible | Latence cumulée |
| Parallèle | Comparaison modèles | Rapide, efficace | Borné par GPU semaphore |
| Conditionnel | Qualité garantie | Adaptif, robuste | Score proxy subjectif |
| Multi-Variations | Exploration | Diversité, choix | Coût × N |
Bonnes Pratiques
- Retry avec backoff pour la résilience — éviter le martelage d’un service temporairement indisponible.
- Caching par hash pour les résultats intermédiaires — un même (prompt, params, model) ne déclenche qu’une seule génération, même appelé N fois en parallèle.
- Timeouts pour éviter les blocages — un worker qui ne répond pas en 60s est tué, le pipeline route sur la branche fallback.
- Logging structuré pour le debugging — chaque transition d’état
pending → running → success | faileddoit être tracée avec timestamp, étape, durée. - Évaluation automatique pour la sélection — un proxy de qualité (CLIP aesthetic + no-reference quality) permet de router sans intervention humaine.
- Métriques exportées — temps par modèle, taux de succès, distribution des scores. Indispensable pour itérer sur les hyperparamètres.
Quand utiliser quel pattern ?
- Étapes causalement liées (text → image → upscale) : séquentiel. Le parallèle n’apporte rien.
- N options indépendantes à comparer (Qwen vs SDXL vs Flux) : parallèle. Le but est de choisir, le coût marginal d’une branche paye.
- Critère de qualité subjectif et coûte à retenter : conditionnel. Le seuil
quality_thresholdrend le coût prédictible. - Présentation à un humain pour triage final : multi-variations. Le but n’est pas la machine, c’est le regard humain.
Ces quatre patterns couvrent 90% des cas d’usage en génération d’images orchestrées. La difficulté réelle est dans les PARAMÈTRES (prompts, CFG scale, seeds) — l’orchestrateur est l’échafaudage, pas la valeur.
# =============================================================================
# FIN DU NOTEBOOK
# =============================================================================

print("\n" + "="*60)
print("   ✅ Notebook Workflow Orchestration Complété")
print("="*60)
print(f"\n📅 Terminé: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print("\n📚 Concepts couverts:")
print("   • WorkflowOrchestrator pour pipelines")
print("   • Exécution séquentielle et parallèle")
print("   • Pipelines conditionnels")
print("   • Multi-variations et sélection")
print("   • Retry et gestion d'erreurs")
print("\n➡️  Prochain notebook: 03-3-Performance-Optimization.ipynb")
============================================================
   ✅ Notebook Workflow Orchestration Complété
============================================================

📅 Terminé: 2026-08-20 16:32:27

📚 Concepts couverts:
   • WorkflowOrchestrator pour pipelines
   • Exécution séquentielle et parallèle
   • Pipelines conditionnels
   • Multi-variations et sélection
   • Retry et gestion d'erreurs

➡️  Prochain notebook: 03-3-Performance-Optimization.ipynb