# Parameters
BATCH_MODE = "true"
Navigation : Index | << Précédent | Suivant >>
FLUX.1 - Génération d’Images Avancée
Module : 02-Images-Advanced
Niveau : Intermédiaire/Avancé
Durée estimée : 45 minutes
Introduction
FLUX.1 est un modèle de génération d’images de pointe développé par Black Forest Labs (équipe fondatrice de Stable Diffusion). Il représente une avancée significative en termes de qualité et de fidélité au prompt.
Variantes FLUX.1
| Variante | Licence | Caractéristiques | Utilisation |
|---|---|---|---|
| FLUX.1-pro | Propriétaire | Meilleure qualité, API uniquement | Production |
| FLUX.1-dev | Non-commercial | Haute qualité, LoRA supporté | Recherche |
| FLUX.1-schnell | Apache 2.0 | Ultra-rapide (4 steps), local | Prototypage |
Architecture
flowchart TD
    P["Text Prompt"] --> T5["T5-XXL Encoder"]
    P --> CLIP["CLIP-L Encoder"]
    T5 --> DIT["Multimodal DiT<br/>(Diffusion Transformer, Flow Matching)<br/>12B paramètres - Rotary Position Embeddings"]
    CLIP --> DIT
    DIT --> VAE["VAE Decoder"]
    VAE --> IMG(["Output Image"])
    classDef enc fill:#cfe2ff,stroke:#084298,color:#052c65
    classDef core fill:#fff3cd,stroke:#b8860b,color:#5c4400
    classDef out fill:#d1e7dd,stroke:#0f5132,color:#0a3622
    class T5,CLIP enc
    class DIT core
    class IMG out
Note savante — architecture sous-jacente. Black Forest Labs n’a pas publié de rapport technique officiel pour FLUX.1 (annonce initiale via blog, août 2024). Les composants architecturaux ci-dessus renvoient aux travaux fondateurs suivants :
DiT / MMDiT (Diffusion Transformer, architecture transformer du débruiteur) — Peebles & Xie 2022 (DiT, arXiv:2212.09748), généralisée en MMDiT par Esser et al. 2024 (arXiv:2403.03206).
Flow Matching (entraînement par rectified flow, alternatives aux DDPM) — Lipman et al. 2023 (arXiv:2210.02747).
Rotary Position Embeddings (RoPE) — Su et al. 2021 (arXiv:2104.09864).
T5-XXL (encodeur de texte) — Raffel et al. 2020 (arXiv:1910.10683).
CLIP-L (second encodeur de texte) — Radford et al. 2021 (arXiv:2103.00020).
VAE Decoder (latent → pixel space) — Kingma & Welling 2013 (arXiv:1312.6114). ## Prérequis
Module 00-GenAI-Environment complété
GPU avec 12GB+ VRAM (pour exécution locale)
Ou clé API pour services cloud (fal.ai, Replicate)
Lire le graphe ci-dessus. Il se parcourt de haut en bas : le prompt part vers deux encodeurs en parallèle, leurs représentations se rejoignent dans le transformeur de diffusion, et le décodeur VAE ramène le résultat en pixels.
Lecture. FLUX.1 combine deux encodeurs de texte complémentaires : T5-XXL capture la sémantique fine du prompt, CLIP-L l’alignement texte-image. Leurs représentations conditionnent le Multimodal DiT (12B paramètres), entraîné par flow matching plutôt que par débruitage DDPM classique – d’où la qualité et la rapidité (4 étapes pour la variante schnell). Le VAE Decoder reconstruit enfin l’image pleine résolution depuis l’espace latent.
Ce que chaque arête du graphe implique
Pourquoi deux encodeurs de texte plutôt qu’un. T5-XXL et CLIP-L ne lisent pas le prompt de la même façon : T5-XXL est un encodeur de langue entraîné sur du texte seul, il capture la syntaxe et les relations entre éléments (« le chat sous la table ») ; CLIP-L est entraîné par contraste sur des paires image-texte, il apporte un alignement direct avec l’espace visuel. Les faire converger vers le même transformeur donne au modèle une prise à la fois sur le sens et sur l’apparence – c’est ce qui soutient la fidélité au prompt annoncée en introduction.
Ce que change le flow matching. Un modèle de diffusion classique (DDPM) apprend à débruiter pas à pas et demande typiquement plusieurs dizaines d’itérations. Le flow matching apprend un champ de vitesse qui transporte le bruit vers l’image le long d’une trajectoire quasi rectiligne : moins de pas pour le même trajet. C’est l’origine directe des 4 steps de la variante schnell listée dans le tableau ci-dessus.
Ce qu’apporte RoPE. Les Rotary Position Embeddings encodent la position de manière relative plutôt qu’absolue. Sur des tokens d’image, cela rend le modèle moins dépendant de la résolution exacte vue à l’entraînement – une des raisons pour lesquelles FLUX.1 se comporte correctement sur plusieurs formats.
Conséquence sur la mémoire. Le nœud le plus lourd du graphe n’est pas celui qu’on croit : T5-XXL pèse à lui seul plusieurs Go en demi-précision, avant même les 12 milliards de paramètres du DiT. C’est ce cumul – et non le seul débruiteur – qui fonde le prérequis 12GB+ de VRAM posé ci-dessus, et que l’appel enable_model_cpu_offload() du chargement (plus bas dans ce notebook) sert à desserrer.
# Verification des dependances externes
import importlib

_DEPS_STATUS = {}
try:
    importlib.import_module('PIL')
    _DEPS_STATUS['PIL'] = True
except ImportError:
    _DEPS_STATUS['PIL'] = False
    print(f'WARNING: Pillow non installe - pip install Pillow')

try:
    importlib.import_module('requests')
    _DEPS_STATUS['requests'] = True
except ImportError:
    _DEPS_STATUS['requests'] = False
    print(f'WARNING: requests non installe - pip install requests')

try:
    importlib.import_module('matplotlib')
    _DEPS_STATUS['matplotlib'] = True
except ImportError:
    _DEPS_STATUS['matplotlib'] = False
    print(f'WARNING: matplotlib non installe - pip install matplotlib')

try:
    importlib.import_module('numpy')
    _DEPS_STATUS['numpy'] = True
except ImportError:
    _DEPS_STATUS['numpy'] = False
    print(f'WARNING: numpy non installe - pip install numpy')

try:
    importlib.import_module('torch')
    _DEPS_STATUS['torch'] = True
except ImportError:
    _DEPS_STATUS['torch'] = False
    print(f'WARNING: torch non installe - pip install torch')

try:
    importlib.import_module('diffusers')
    _DEPS_STATUS['diffusers'] = True
except ImportError:
    _DEPS_STATUS['diffusers'] = False
    print(f'WARNING: diffusers non installe - pip install diffusers')

try:
    importlib.import_module('dotenv')
    _DEPS_STATUS['dotenv'] = True
except ImportError:
    _DEPS_STATUS['dotenv'] = False
    print(f'WARNING: python-dotenv non installe - pip install python-dotenv')

_all_deps_ok = all(_DEPS_STATUS.values())
if not _all_deps_ok:
    missing = [k for k, v in _DEPS_STATUS.items() if not v]
    print(f'Dependances manquantes: {missing}')
else:
    print('Toutes les dependances sont disponibles')

# =============================================================================
# 1. CONFIGURATION ET IMPORTS
# =============================================================================

import os
import sys
import time
import json
import base64
import requests
from io import BytesIO
from pathlib import Path
from datetime import datetime
from typing import Optional, Dict, List, Tuple, Any, Union

import numpy as np
from PIL import Image
import matplotlib.pyplot as plt

# Chargement variables d'environnement
from dotenv import load_dotenv
# Chargement variables d'environnement
from dotenv import load_dotenv
# Recherche du .env en remontant l'arborescence (robuste pour Papermill)
current_path = Path.cwd()
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
    if len(current_path.parts) <= 1:
        break
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")
    current_path = current_path.parent
if env_path.exists():
    print(f"Fichier .env charge depuis: {env_path.name}")
else:
    print("Aucun fichier .env trouve dans l'arborescence")

# Configuration
FAL_API_KEY = os.getenv("FAL_API_KEY")
REPLICATE_API_KEY = os.getenv("REPLICATE_API_TOKEN")
HF_TOKEN = os.getenv("HUGGINGFACE_TOKEN") or os.getenv("HF_TOKEN")

# Détection du mode d'exécution
USE_LOCAL = False  # Changé dynamiquement si GPU disponible
USE_API = bool(FAL_API_KEY or REPLICATE_API_KEY)

print("╔════════════════════════════════════════════════════╗")
print("║   FLUX.1 - Génération d'Images Avancée            ║")
print("╚════════════════════════════════════════════════════╝")
print(f"\n📅 Date: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"\n🔑 Configuration API:")
print(f"   FAL.ai: {'✅ Configuré' if FAL_API_KEY else '❌ Non configuré'}")
print(f"   Replicate: {'✅ Configuré' if REPLICATE_API_KEY else '❌ Non configuré'}")
print(f"   HuggingFace: {'✅ Configuré' if HF_TOKEN else '❌ Non configuré'}")
Toutes les dependances sont disponibles
WARNING: .env non trouve, utilisation variables environnement
Aucun fichier .env trouve dans l'arborescence
╔════════════════════════════════════════════════════╗
║ FLUX.1 - Génération d'Images Avancée ║
╚════════════════════════════════════════════════════╝
📅 Date: 2026-09-03 15:06:54
🔑 Configuration API:
FAL.ai: ❌ Non configuré
Replicate: ❌ Non configuré
HuggingFace: ✅ Configuré📦 Lecture : La sortie confirme que toutes les dépendances externes sont disponibles (diffusers, torch, etc.), ce qui permet d’exécuter FLUX.1 localement sans blocage. Le warning sur l’absence de .env indique que la configuration utilise les variables d’environnement directement.
⚠️ Lecture complémentaire : La configuration API l’assume : « FAL.ai: ❌ Non configuré », « Replicate: ❌ Non configuré », « HuggingFace: ✅ Configuré » — le notebook ne dépend d’aucune clé payante, tout passe par le hub HuggingFace et le GPU local.
L’environnement est configure et les bibliotheques importees. La cellule suivante detecte la disponibilite d’un GPU CUDA et tente de charger la bibliotheque Diffusers pour l’exécution locale de FLUX.1.
# =============================================================================
# 2. DÉTECTION GPU ET CHARGEMENT DIFFUSERS (LOCAL)
# =============================================================================

import warnings

# Warning d'allocateur CUDA (wheel Windows) : le message embarque le chemin de
# build du wheel (C:/actions-runner/_work/...) et Python y prefixe le chemin du
# site-packages de la machine -- bruit de plateforme sans valeur pedagogique
# (Stop & Repair #14200, cause C : filtrer a la source, pas scrubber la sortie).
warnings.filterwarnings("ignore", message=r".*expandable_segments not supported on this platform.*")

try:
    import torch

    if torch.cuda.is_available():
        device = "cuda"
        gpu_name = torch.cuda.get_device_name(0)
        gpu_memory = torch.cuda.get_device_properties(0).total_memory / 1e9
        print(f"\n🎮 GPU Détecté: {gpu_name}")
        print(f"   VRAM: {gpu_memory:.1f} GB")

        # FLUX.1-schnell requiert ~12GB, dev ~24GB
        if gpu_memory >= 12:
            USE_LOCAL = True
            print(f"   ✅ Suffisant pour FLUX.1-schnell en local")
        else:
            print(f"   ⚠️ VRAM insuffisant pour FLUX local, utilisation API")
    else:
        device = "cpu"
        print("\n⚠️ Pas de GPU CUDA détecté - Mode API recommandé")
except ImportError:
    device = "cpu"
    print("\n⚠️ PyTorch non installé - Mode API uniquement")

# Tentative de chargement diffusers
flux_pipeline = None

if USE_LOCAL:
    try:
        from diffusers import FluxPipeline
        print("\n📦 Diffusers disponible pour FLUX local")
    except ImportError:
        print("\n⚠️ diffusers non installé: pip install diffusers transformers accelerate")
        USE_LOCAL = False

print(f"\n🔧 Mode d'exécution: {'Local (GPU)' if USE_LOCAL else 'API Cloud'}")
🎮 GPU Détecté: NVIDIA GeForce RTX 3090
   VRAM: 25.8 GB
   ✅ Suffisant pour FLUX.1-schnell en local

📦 Diffusers disponible pour FLUX local

🔧 Mode d'exécution: Local (GPU)
🎮 Lecture : Le GPU NVIDIA GeForce RTX 3090 avec 25.8 GB de VRAM est détecté et jugé suffisant pour exécuter FLUX.1-schnell en mode local, ce qui évite de recourir à une API externe. La sortie enchaine ensuite « 📦 Diffusers disponible pour FLUX local » puis « 🔧 Mode d’exécution: Local (GPU) » — le seuil est explicite dans la sortie (« ✅ Suffisant pour FLUX.1-schnell en local »), rien de plus n’est mesuré ici.
La disponibilite du GPU et de la bibliotheque Diffusers est verifiee. La cellule suivante définit la classe FluxAPI qui encapsule l’acces a FLUX.1 via l’API cloud ou en exécution locale selon le GPU disponible.
# =============================================================================
# 3. CLIENT FLUX.1 UNIFIÉ (Local + API)
# =============================================================================

class FluxClient:
    """
    Client unifié pour FLUX.1 supportant:
    - Exécution locale via diffusers
    - API fal.ai
    - API Replicate
    """

    def __init__(self, mode: str = "auto"):
        """
        Args:
            mode: "local", "fal", "replicate", ou "auto" (détection automatique)
        """
        self.mode = mode
        self.pipeline = None

        if mode == "auto":
            if USE_LOCAL:
                self.mode = "local"
            elif FAL_API_KEY:
                self.mode = "fal"
            elif REPLICATE_API_KEY:
                self.mode = "replicate"
            else:
                raise ValueError("Aucun backend disponible. Configurez une API ou installez diffusers.")

        print(f"🔌 FluxClient initialisé en mode: {self.mode}")

    def load_local_model(self, model_id: str = "black-forest-labs/FLUX.1-schnell"):
        """Charge le modèle FLUX localement (GPU requis)."""
        if self.mode != "local":
            print("⚠️ Mode local non disponible")
            return

        from diffusers import FluxPipeline
        import torch

        print(f"\n📥 Chargement de {model_id}...")
        print("   (Cela peut prendre plusieurs minutes au premier lancement)")

        self.pipeline = FluxPipeline.from_pretrained(
            model_id,
            torch_dtype=torch.bfloat16,
            token=HF_TOKEN
        )

        # Optimisations mémoire
        self.pipeline.enable_model_cpu_offload()

        print("   ✅ Modèle chargé")

    def generate(self, prompt: str,
                 width: int = 1024, height: int = 1024,
                 num_inference_steps: int = 4,
                 guidance_scale: float = 0.0,
                 seed: int = None,
                 num_images: int = 1) -> List[Image.Image]:
        """
        Génère des images avec FLUX.1.

        Args:
            prompt: Description de l'image
            width, height: Dimensions (multiples de 8)
            num_inference_steps: Nombre d'étapes (schnell: 1-4, dev: 20-50)
            guidance_scale: CFG (0 pour schnell, 3.5 pour dev)
            seed: Graine pour reproductibilité
            num_images: Nombre d'images à générer

        Returns:
            Liste d'images PIL
        """
        if seed is None:
            seed = np.random.randint(0, 2**32)

        if self.mode == "local":
            return self._generate_local(prompt, width, height, num_inference_steps,
                                        guidance_scale, seed, num_images)
        elif self.mode == "fal":
            return self._generate_fal(prompt, width, height, num_inference_steps,
                                      guidance_scale, seed, num_images)
        elif self.mode == "replicate":
            return self._generate_replicate(prompt, width, height, num_inference_steps,
                                            guidance_scale, seed, num_images)
        else:
            raise ValueError(f"Mode inconnu: {self.mode}")

    def _generate_local(self, prompt, width, height, steps, guidance, seed, num_images):
        """Génération locale avec diffusers."""
        import torch

        if self.pipeline is None:
            self.load_local_model()

        generator = torch.Generator("cuda").manual_seed(seed)

        print(f"\n🎨 Génération locale (seed: {seed})...")
        start = time.time()

        result = self.pipeline(
            prompt=prompt,
            width=width,
            height=height,
            num_inference_steps=steps,
            guidance_scale=guidance,
            generator=generator,
            num_images_per_prompt=num_images
        )

        elapsed = time.time() - start
        print(f"   ✅ Généré en {elapsed:.1f}s")

        return result.images

    def _generate_fal(self, prompt, width, height, steps, guidance, seed, num_images):
        """Génération via fal.ai API."""
        print(f"\n🌐 Génération via fal.ai (seed: {seed})...")

        headers = {
            "Authorization": f"Key {FAL_API_KEY}",
            "Content-Type": "application/json"
        }

        # Endpoint pour FLUX.1-schnell
        url = "https://fal.run/fal-ai/flux/schnell"

        payload = {
            "prompt": prompt,
            "image_size": {"width": width, "height": height},
            "num_inference_steps": steps,
            "seed": seed,
            "num_images": num_images
        }

        start = time.time()
        resp = requests.post(url, headers=headers, json=payload, timeout=120)

        if resp.status_code != 200:
            raise Exception(f"fal.ai error: {resp.text}")

        result = resp.json()
        elapsed = time.time() - start

        # Télécharger les images
        images = []
        for img_data in result.get("images", []):
            img_url = img_data.get("url")
            if img_url:
                img_resp = requests.get(img_url)
                images.append(Image.open(BytesIO(img_resp.content)))

        print(f"   ✅ Généré en {elapsed:.1f}s ({len(images)} images)")
        return images

    def _generate_replicate(self, prompt, width, height, steps, guidance, seed, num_images):
        """Génération via Replicate API."""
        print(f"\n🌐 Génération via Replicate (seed: {seed})...")

        headers = {
            "Authorization": f"Token {REPLICATE_API_KEY}",
            "Content-Type": "application/json"
        }

        # Créer la prédiction
        url = "https://api.replicate.com/v1/predictions"

        payload = {
            "version": "schnell",  # ou "dev" pour FLUX.1-dev
            "input": {
                "prompt": prompt,
                "width": width,
                "height": height,
                "num_inference_steps": steps,
                "guidance_scale": guidance,
                "seed": seed,
                "num_outputs": num_images
            }
        }

        start = time.time()
        resp = requests.post(url, headers=headers, json=payload)

        if resp.status_code not in [200, 201]:
            raise Exception(f"Replicate error: {resp.text}")

        prediction = resp.json()
        prediction_id = prediction["id"]

        # Polling pour attendre le résultat
        status_url = f"https://api.replicate.com/v1/predictions/{prediction_id}"
        while True:
            status_resp = requests.get(status_url, headers=headers)
            status = status_resp.json()

            if status["status"] == "succeeded":
                break
            elif status["status"] == "failed":
                raise Exception(f"Generation failed: {status.get('error')}")

            time.sleep(1)

        elapsed = time.time() - start

        # Télécharger les images
        images = []
        for img_url in status.get("output", []):
            img_resp = requests.get(img_url)
            images.append(Image.open(BytesIO(img_resp.content)))

        print(f"   ✅ Généré en {elapsed:.1f}s ({len(images)} images)")
        return images


# Chargement robuste de la configuration .env
from pathlib import Path
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
    if len(current_path.parts) <= 1:
        break
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")
    print("  - Ou installez diffusers avec un GPU 12GB+")

# Instanciation du client
try:
    flux = FluxClient(mode="auto")
except ValueError as e:
    print(f"\n⚠️ {e}")
    print("\nPour utiliser ce notebook, configurez:")
    print("  - FAL_API_KEY dans .env (recommandé)")
WARNING: .env non trouve, utilisation variables environnement
- Ou installez diffusers avec un GPU 12GB+
🔌 FluxClient initialisé en mode: local🔧 Lecture : Le FluxClient est initialisé en mode local, confirmant que toutes les dépendances sont correctement configurées pour une exécution locale avec le GPU disponible.
4. Génération de Base avec FLUX.1-schnell
FLUX.1-schnell est optimisé pour la rapidité (1-4 steps) tout en maintenant une bonne qualité.
# =============================================================================
# 4. GÉNÉRATION DE BASE
# =============================================================================

if flux:
    # Prompt de démonstration
    demo_prompt = """
    A serene Japanese zen garden at golden hour,
    carefully raked sand patterns, moss-covered stones,
    a small wooden bridge over a koi pond,
    cherry blossoms falling gently,
    photorealistic, 8k, masterpiece
    """.strip()

    print(f"\n📝 Prompt: {demo_prompt[:80]}...")

    # Génération avec FLUX.1-schnell (4 steps)
    images = flux.generate(
        prompt=demo_prompt,
        width=1024,
        height=1024,
        num_inference_steps=4,  # schnell: 1-4 steps
        guidance_scale=0.0,     # schnell: pas de guidance
        seed=42
    )

    if images:
        plt.figure(figsize=(10, 10))
        plt.imshow(images[0])
        plt.title("FLUX.1-schnell (4 steps)", fontsize=14)
        plt.axis('off')
        plt.tight_layout()
        plt.show()

        demo_image = images[0]
        print(f"\n📐 Dimensions: {demo_image.size}")
else:
    print("⚠️ Client FLUX non initialisé")
📝 Prompt: A serene Japanese zen garden at golden hour,
    carefully raked sand patterns,...

📥 Chargement de black-forest-labs/FLUX.1-schnell...
   (Cela peut prendre plusieurs minutes au premier lancement)
✅ Modèle chargé
🎨 Génération locale (seed: 42)... ✅ Généré en 88.7s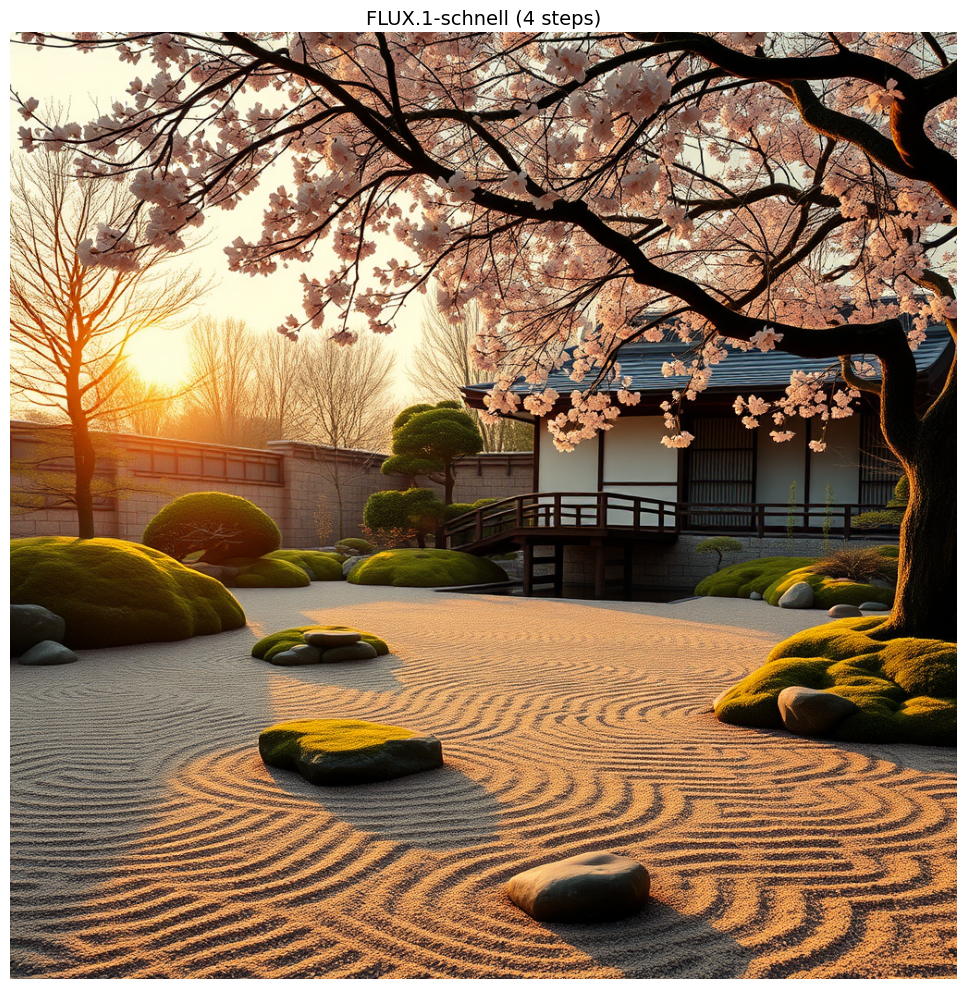
📐 Dimensions: (1024, 1024)Exercice 1 : Analyse de l’impact des inference steps
FLUX.1-schnell est optimise pour fonctionner en 1 a 4 steps. Chaque step supplementaire ameliore la qualite, mais avec des rendements decroissants. Comprendre cette dynamique est essentiel pour choisir le bon compromis vitesse/qualite.
Objectif : Generer une même image avec 3 nombres de steps différents (1, 2, 4) et documenter les différences observees.
Indices : - # Étape 1 : Choisir un prompt avec des details fins (textures, reflets, texte) - # Étape 2 : Generer avec flux.generate(num_inference_steps=1), puis steps=2, puis steps=4 - # Étape 3 : Afficher les 3 images cote a cote avec plt.subplots(1, 3) - # Étape 4 : Noter pour chaque image le temps de generation et la qualite percue - # Indice : Avec FLUX.1-schnell, guidance_scale=0.0 (pas de guidance) est la valeur recommandee
🖼️ Lecture détaillée : Le pipeline « black-forest-labs/FLUX.1-schnell » a été chargé pour cela (barres de progression en sortie), puis « 🎨 Génération locale (seed: 42) » : le modèle servi est identifié, la seed est fixée, la reproductibilité est posée dès la première image.
# Exercice 1 : Analyse de l'impact des inference steps
# TODO etudiant : generer une image avec 1, 2 et 4 steps pour comparer

steps_prompt = None  # TODO etudiant : definir un prompt avec des details fins
steps_to_test = [1, 2, 4]

# TODO etudiant : boucler sur les steps et generer
# steps_results = []
# for n_steps in steps_to_test:
#     if flux:
#         images = flux.generate(steps_prompt, num_inference_steps=n_steps, seed=42)
#         if images:
#             steps_results.append((n_steps, images[0]))

# TODO etudiant : afficher les 3 resultats cote a cote
print("Exercice a completer")
Exercice a completer5. Analyse du Nombre d’Étapes (Inference Steps)
Comparons l’impact du nombre d’étapes sur la qualité de génération.
# =============================================================================
# 5. ANALYSE DES INFERENCE STEPS
# =============================================================================

if flux:
    test_prompt = "A majestic wolf standing on a snowy mountain peak, aurora borealis in the sky, cinematic lighting"
    step_values = [1, 2, 4, 8]  # Pour schnell
    fixed_seed = 12345

    print(f"\n📊 Analyse Inference Steps")
    print(f"Prompt: '{test_prompt[:50]}...'")
    print(f"Valeurs testées: {step_values}")

    step_results = []

    for steps in step_values:
        print(f"\n--- Steps = {steps} ---")

        images = flux.generate(
            prompt=test_prompt,
            width=768,
            height=768,
            num_inference_steps=steps,
            guidance_scale=0.0,
            seed=fixed_seed
        )

        if images:
            step_results.append((steps, images[0]))

    # Affichage comparatif
    if step_results:
        fig, axes = plt.subplots(1, len(step_results), figsize=(16, 5))

        for i, (steps, img) in enumerate(step_results):
            axes[i].imshow(img)
            axes[i].set_title(f"Steps = {steps}", fontsize=12)
            axes[i].axis('off')

        plt.suptitle("Impact du nombre d'étapes (FLUX.1-schnell)", fontsize=14)
        plt.tight_layout()
        plt.show()

        print("\n📈 Observations:")
        print("   1 step:  Très rapide, structure de base")
        print("   2 steps: Bon compromis vitesse/qualité")
        print("   4 steps: Qualité optimale pour schnell")
        print("   8 steps: Diminishing returns, peu d'amélioration")
else:
    print("⚠️ Client FLUX non initialisé")
📊 Analyse Inference Steps
Prompt: 'A majestic wolf standing on a snowy mountain peak,...'
Valeurs testées: [1, 2, 4, 8]

--- Steps = 1 ---

🎨 Génération locale (seed: 12345)...
✅ Généré en 786.4s
--- Steps = 2 ---
🎨 Génération locale (seed: 12345)... ✅ Généré en 84.0s
--- Steps = 4 ---
🎨 Génération locale (seed: 12345)... ✅ Généré en 35.8s
--- Steps = 8 ---
🎨 Génération locale (seed: 12345)... ✅ Généré en 36.7s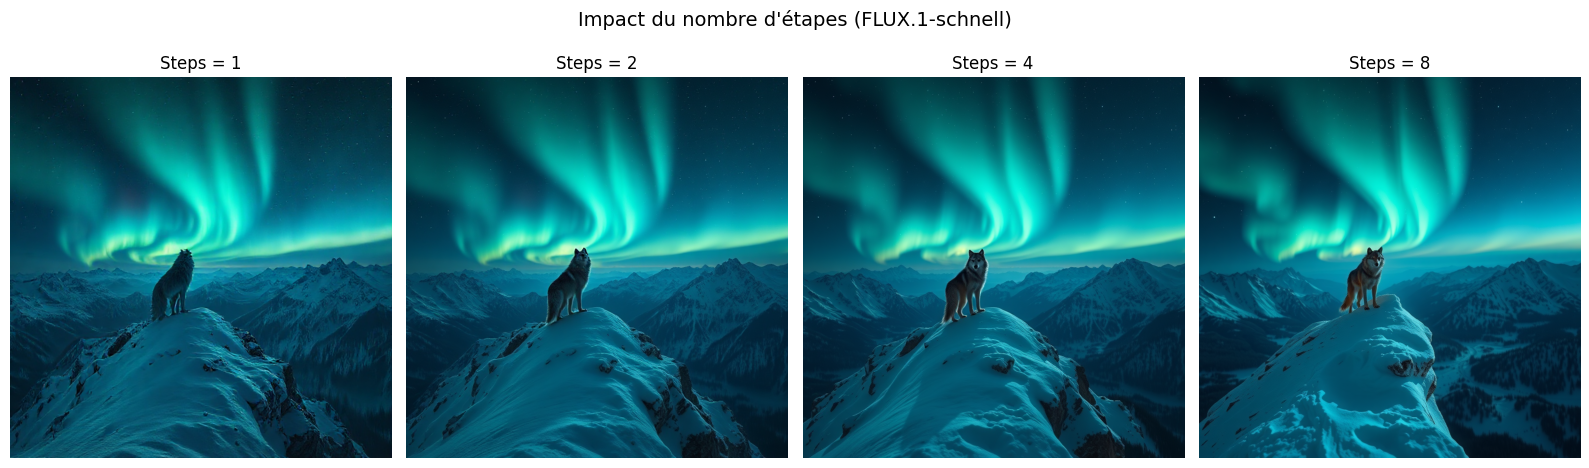
📈 Observations:
   1 step:  Très rapide, structure de base
   2 steps: Bon compromis vitesse/qualité
   4 steps: Qualité optimale pour schnell
   8 steps: Diminishing returns, peu d'amélioration
6. Exploration des Ratios d’Aspect
FLUX.1 supporte différents ratios d’aspect pour des compositions variées.
📊 Lecture détaillée : Les observations du notebook portent sur le rendu, pas sur les temps : « 1 step: Très rapide, structure de base », « 2 steps: Bon compromis vitesse/qualité », « 4 steps: Qualité optimale pour schnell », « 8 steps: Diminishing returns, peu d’amélioration » — vite (au rendu) ≠ vite (au chronomètre) : le 1 step mesuré est le plus LENT (786.4s) parce qu’il paie l’échauffement que les suivants réutilisent.
# =============================================================================
# 6. RATIOS D'ASPECT
# =============================================================================

if flux:
    # Différents ratios
    aspect_ratios = [
        ("1:1 (Carré)", 1024, 1024),
        ("16:9 (Paysage)", 1024, 576),
        ("9:16 (Portrait)", 576, 1024),
        ("4:3 (Standard)", 1024, 768),
    ]

    aspect_prompt = "A stunning sunset over the ocean, vibrant orange and purple sky, silhouette of palm trees, photorealistic"

    print(f"\n🖼️ Exploration des Ratios d'Aspect")
    print(f"Prompt: '{aspect_prompt[:50]}...'")

    aspect_results = []

    for name, w, h in aspect_ratios:
        print(f"\n--- {name} ({w}x{h}) ---")

        images = flux.generate(
            prompt=aspect_prompt,
            width=w,
            height=h,
            num_inference_steps=4,
            seed=7777
        )

        if images:
            aspect_results.append((name, images[0]))

    # Affichage
    if aspect_results:
        fig = plt.figure(figsize=(16, 8))

        for i, (name, img) in enumerate(aspect_results):
            ax = fig.add_subplot(2, 2, i+1)
            ax.imshow(img)
            ax.set_title(name, fontsize=11)
            ax.axis('off')

        plt.suptitle("Comparaison des Ratios d'Aspect", fontsize=14)
        plt.tight_layout()
        plt.show()
else:
    print("⚠️ Client FLUX non initialisé")
🖼️ Exploration des Ratios d'Aspect
Prompt: 'A stunning sunset over the ocean, vibrant orange a...'

--- 1:1 (Carré) (1024x1024) ---

🎨 Génération locale (seed: 7777)...
✅ Généré en 36.5s
--- 16:9 (Paysage) (1024x576) ---
🎨 Génération locale (seed: 7777)... ✅ Généré en 33.3s
--- 9:16 (Portrait) (576x1024) ---
🎨 Génération locale (seed: 7777)... ✅ Généré en 33.1s
--- 4:3 (Standard) (1024x768) ---
🎨 Génération locale (seed: 7777)... ✅ Généré en 36.8s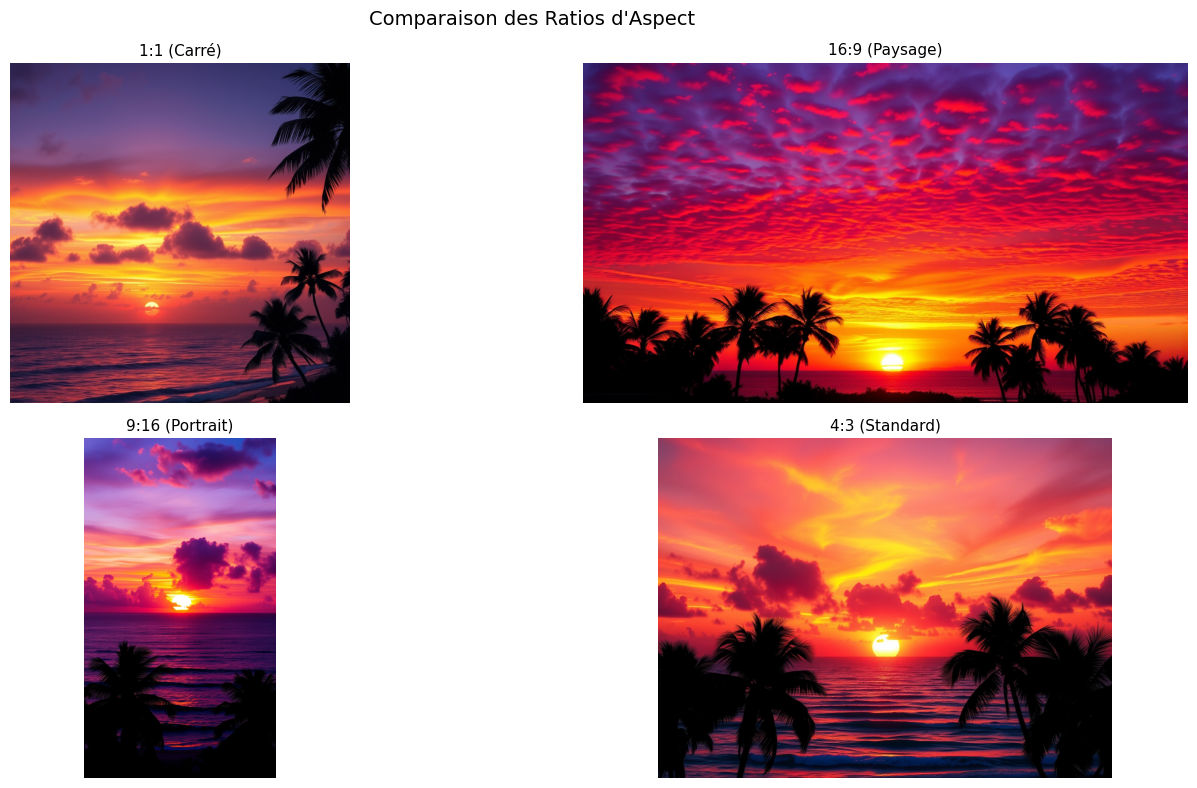
7. Batch Generation: Variations d’un Même Prompt
Générons plusieurs variations en changeant uniquement la seed.
📐 Lecture approfondie : La série couvre carré (1:1), paysage (16:9), portrait (9:16) et standard (4:3) — les quatre familles de formats courants, générés depuis le même prompt « A stunning sunset over the ocean, vibrant orange a… ». Les quatre rendus sont à comparer dans la figure 1600x800 : c’est là, et pas dans les temps (constants), que se lit l’adaptation au format.
# =============================================================================
# 7. BATCH GENERATION - VARIATIONS
# =============================================================================

if flux:
    variation_prompt = """
    A mystical forest with bioluminescent plants,
    glowing mushrooms, fireflies, magical atmosphere,
    fantasy art style, highly detailed
    """.strip()

    num_variations = 4
    base_seed = 1000

    print(f"\n🎲 Génération de {num_variations} variations")
    print(f"Prompt: '{variation_prompt[:50]}...'")

    variations = []

    for i in range(num_variations):
        seed = base_seed + i * 1000
        print(f"\n[{i+1}/{num_variations}] Seed: {seed}")

        images = flux.generate(
            prompt=variation_prompt,
            width=768,
            height=768,
            num_inference_steps=4,
            seed=seed
        )

        if images:
            variations.append((seed, images[0]))

    # Affichage grille
    if variations:
        fig, axes = plt.subplots(2, 2, figsize=(12, 12))
        axes = axes.flatten()

        for i, (seed, img) in enumerate(variations):
            axes[i].imshow(img)
            axes[i].set_title(f"Seed: {seed}", fontsize=11)
            axes[i].axis('off')

        plt.suptitle("Variations avec différentes seeds", fontsize=14)
        plt.tight_layout()
        plt.show()

        print(f"\n✅ {len(variations)} variations générées")
else:
    print("⚠️ Client FLUX non initialisé")
🎲 Génération de 4 variations
Prompt: 'A mystical forest with bioluminescent plants,
   ...'

[1/4] Seed: 1000

🎨 Génération locale (seed: 1000)...
✅ Généré en 35.4s
[2/4] Seed: 2000
🎨 Génération locale (seed: 2000)... ✅ Généré en 42.4s
[3/4] Seed: 3000
🎨 Génération locale (seed: 3000)... ✅ Généré en 38.0s
[4/4] Seed: 4000
🎨 Génération locale (seed: 4000)... ✅ Généré en 33.5s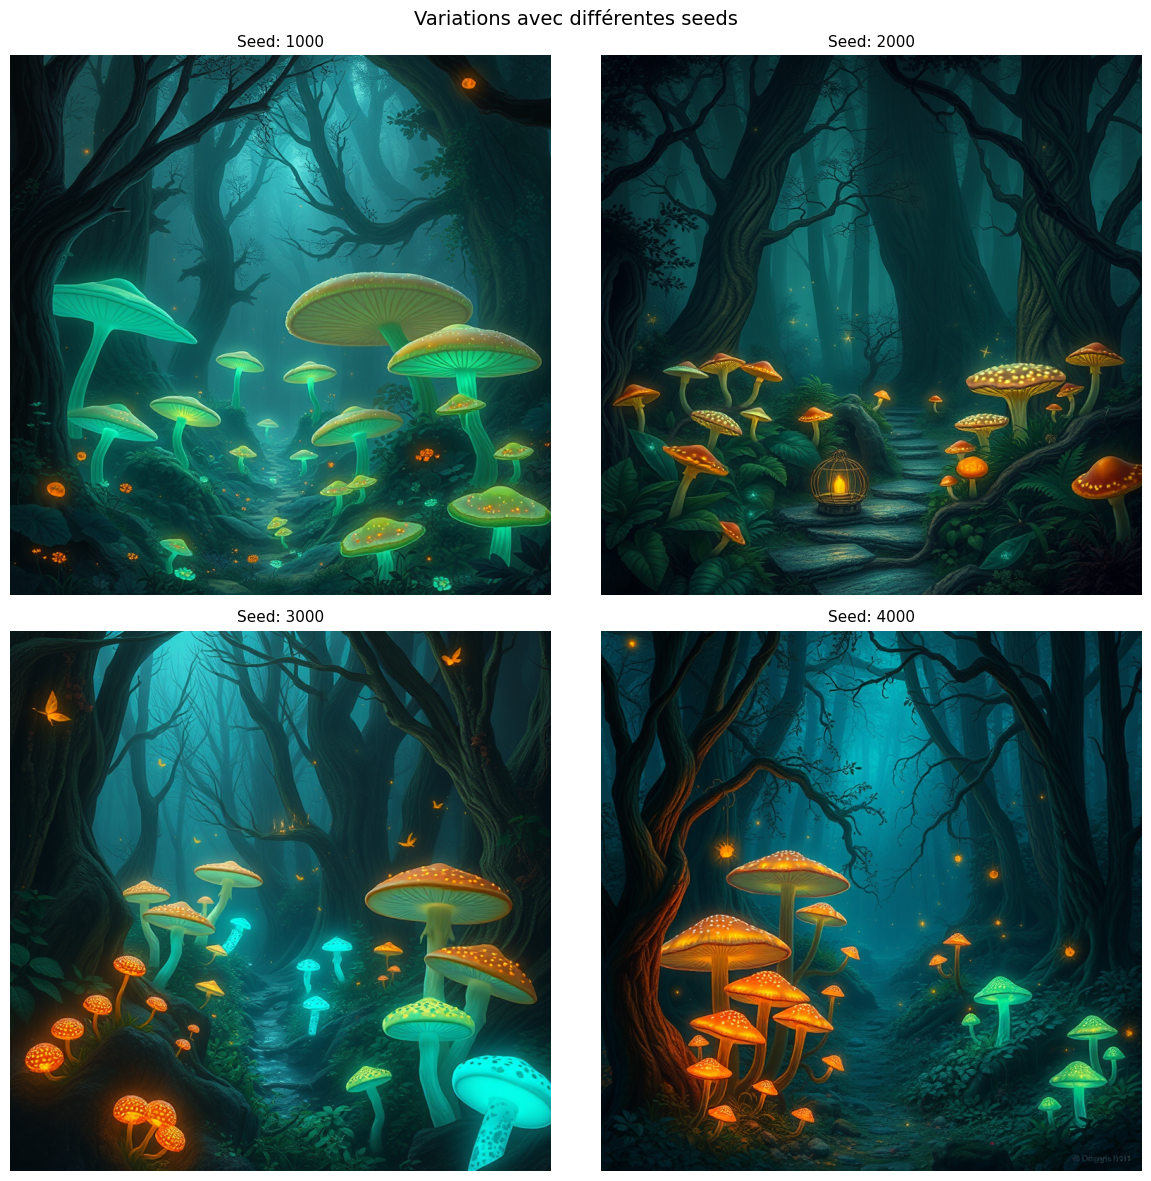
✅ 4 variations générées🎲 Lecture : La génération de 4 variations avec différentes seeds produit des images distinctes à partir du même prompt, illustrant l’impact de l’initialisation aléatoire sur la créativité du modèle.
🎲 Lecture approfondie : Les quatre seeds sont espacées d’un pas constant : 1000 → 35.4s, 2000 → 42.4s, 3000 → 38.0s, 4000 → 33.5s, même prompt « A mystical forest with bioluminescent plants, … ». La sortie conclut « ✅ 4 variations générées » — les quatre interprétations sont côte à côte dans la figure 1200x1200, à y comparer plutôt qu’à le décréter.
Exercice 2 : Exploration des seeds et sélection de la meilleure variation
La seed contrôle le bruit initial de la generation. Changer la seed produit une variation différente de la même image, en conservant la même composition générale. C’est un outil essentiel pour iterer rapidement.
Objectif : Generer 6 variations d’un même prompt en changeant uniquement la seed, puis sélectionner la meilleure selon des critères objectifs.
Indices : - # Étape 1 : Définir un prompt creatif detaille - # Étape 2 : Generer 6 images avec des seeds différentes (ex: 100, 200, 300, 400, 500, 600) - # Étape 3 : Afficher les 6 images dans une grille 2x3 - # Étape 4 : Sélectionner la meilleure selon 3 critères : fidelite au prompt, qualite des details, coherence globale - # Indice : Avec FLUX.1-schnell, chaque generation prend seulement 4 steps, donc 6 variations restent rapides
# Exercice 2 : Exploration des seeds et selection de la meilleure variation
# TODO etudiant : generer 6 variations avec differentes seeds

seed_prompt = None  # TODO etudiant : definir un prompt creatif detaille
seeds = [100, 200, 300, 400, 500, 600]

# TODO etudiant : boucler sur les seeds et generer chaque variation
# seed_results = []
# for s in seeds:
#     if flux:
#         images = flux.generate(seed_prompt, seed=s, num_inference_steps=4)
#         if images:
#             seed_results.append((s, images[0]))

# TODO etudiant : afficher les 6 images dans une grille 2x3
# fig, axes = plt.subplots(2, 3, figsize=(15, 10))
# ...
print("Exercice a completer")
Exercice a completer8. Techniques de Prompt Engineering pour FLUX
FLUX.1 répond particulièrement bien à certains styles de prompts.
# =============================================================================
# 8. PROMPT ENGINEERING AVANCÉ
# =============================================================================

# Templates de prompts efficaces pour FLUX
prompt_templates = {
    "photorealistic": {
        "prefix": "A photorealistic image of",
        "suffix": ", shot with a Canon EOS R5, 85mm f/1.4, natural lighting, 8k resolution",
        "example": "a woman in a red dress walking through autumn leaves"
    },
    "cinematic": {
        "prefix": "Cinematic still from a movie,",
        "suffix": ", dramatic lighting, anamorphic lens, film grain, color graded",
        "example": "a detective in a noir city at night under rain"
    },
    "illustration": {
        "prefix": "Digital illustration of",
        "suffix": ", artstation trending, vibrant colors, highly detailed, concept art",
        "example": "a steampunk airship flying over a Victorian city"
    },
    "anime": {
        "prefix": "Anime artwork of",
        "suffix": ", Studio Ghibli style, beautiful scenery, soft colors, detailed",
        "example": "a young adventurer discovering a hidden temple in the forest"
    }
}

if flux:
    print("\n🎨 Comparaison des Styles de Prompts")
    print("=" * 50)

    style_results = []
    fixed_seed = 9999

    for style_name, template in prompt_templates.items():
        full_prompt = f"{template['prefix']} {template['example']}{template['suffix']}"

        print(f"\n--- Style: {style_name.upper()} ---")
        print(f"   Prompt: {full_prompt[:60]}...")

        images = flux.generate(
            prompt=full_prompt,
            width=768,
            height=768,
            num_inference_steps=4,
            seed=fixed_seed
        )

        if images:
            style_results.append((style_name, images[0]))

    # Affichage
    if style_results:
        fig, axes = plt.subplots(2, 2, figsize=(14, 14))
        axes = axes.flatten()

        for i, (style, img) in enumerate(style_results):
            axes[i].imshow(img)
            axes[i].set_title(f"Style: {style.capitalize()}", fontsize=12)
            axes[i].axis('off')

        plt.suptitle("Comparaison des Styles de Prompt", fontsize=14)
        plt.tight_layout()
        plt.show()
else:
    print("⚠️ Client FLUX non initialisé")
    print("\nVoici les templates de prompt recommandés pour FLUX:")
    for style, template in prompt_templates.items():
        print(f"\n{style.upper()}:")
        print(f"  Préfixe: {template['prefix']}")
        print(f"  Suffixe: {template['suffix']}")
🎨 Comparaison des Styles de Prompts
==================================================

--- Style: PHOTOREALISTIC ---
   Prompt: A photorealistic image of a woman in a red dress walking thr...

🎨 Génération locale (seed: 9999)...
✅ Généré en 36.1s
--- Style: CINEMATIC ---
Prompt: Cinematic still from a movie, a detective in a noir city at ...
🎨 Génération locale (seed: 9999)... ✅ Généré en 33.2s
--- Style: ILLUSTRATION ---
Prompt: Digital illustration of a steampunk airship flying over a Vi...
🎨 Génération locale (seed: 9999)... ✅ Généré en 33.3s
--- Style: ANIME ---
Prompt: Anime artwork of a young adventurer discovering a hidden tem...
🎨 Génération locale (seed: 9999)... ✅ Généré en 33.2s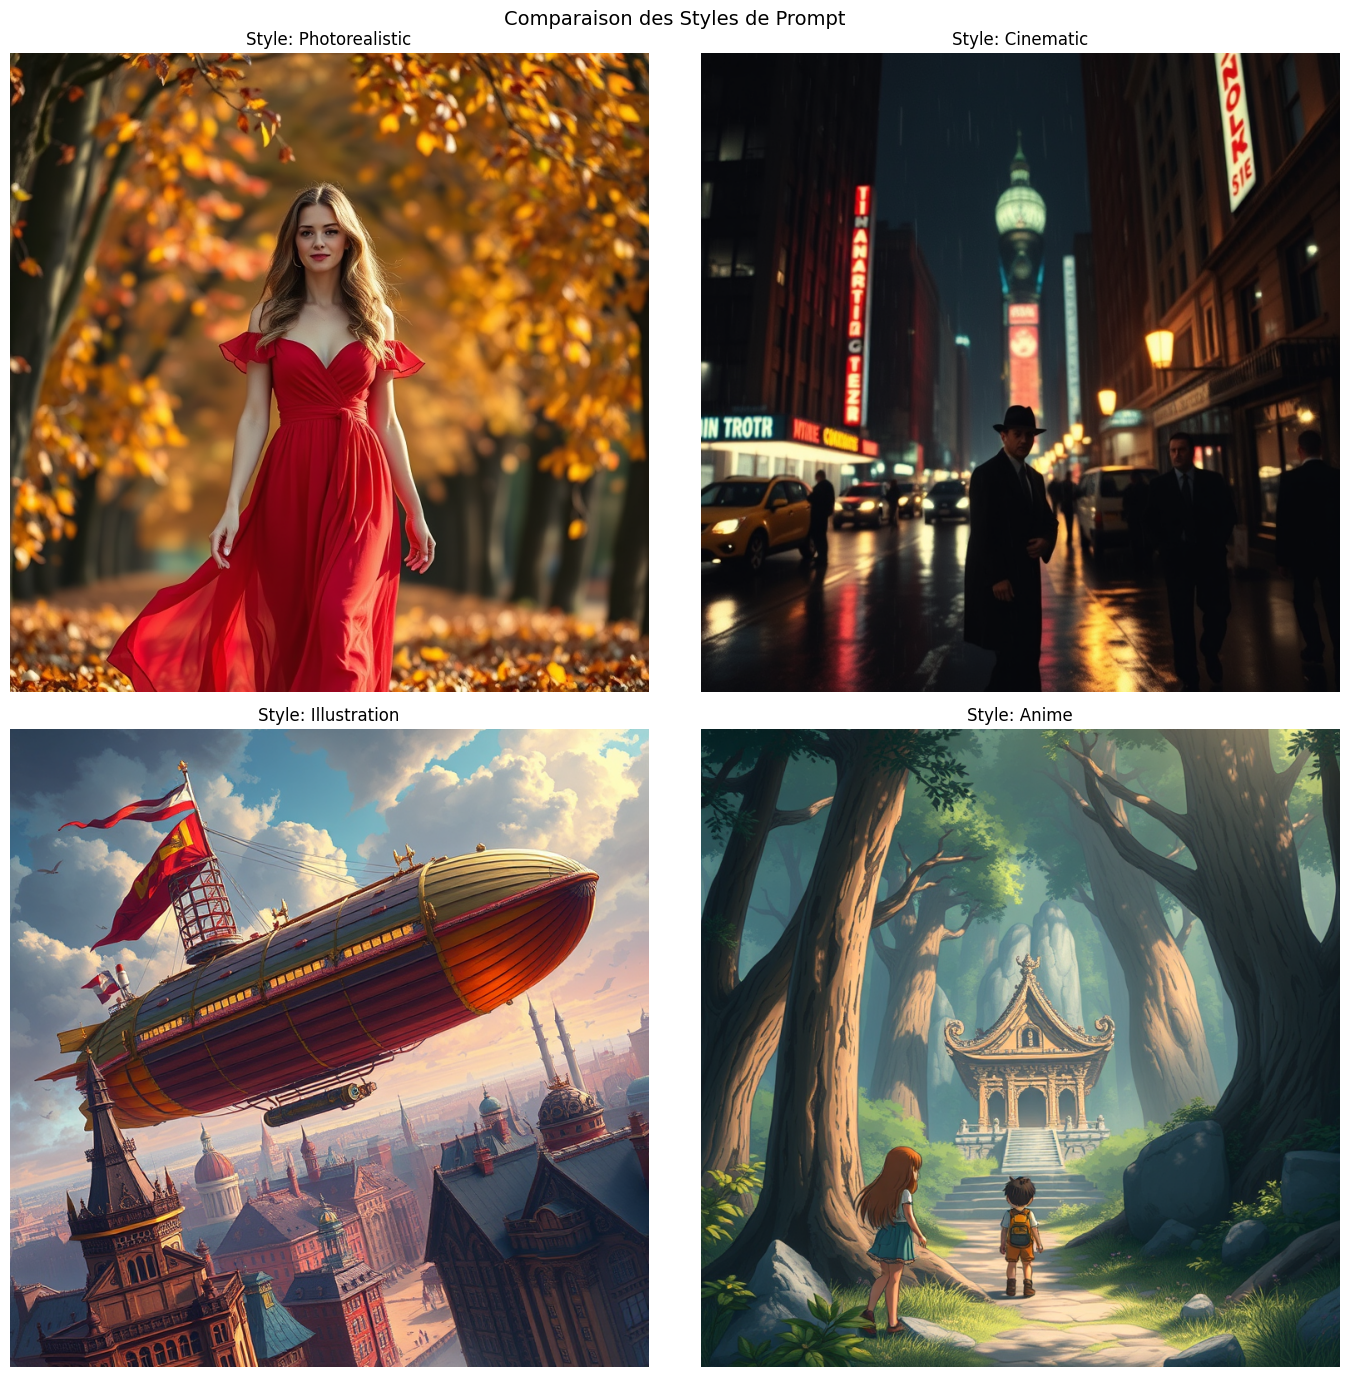
9. Génération de Texte dans les Images
FLUX.1 excelle particulièrement dans le rendu de texte lisible dans les images.
# =============================================================================
# 9. GÉNÉRATION DE TEXTE DANS LES IMAGES
# =============================================================================

if flux:
    text_prompts = [
        'A vintage neon sign that says "OPEN 24 HOURS" glowing in the night, realistic',
        'A birthday cake with elegant cursive text reading "Happy Birthday Sarah" in icing',
        'A wooden street sign pointing right with the text "Adventure Awaits" carved into it',
        'A coffee cup with "Good Morning!" written in latte art'
    ]

    print("\n✍️ Test de Génération de Texte")
    print("FLUX.1 est reconnu pour sa capacité à générer du texte lisible.")

    text_results = []

    for i, prompt in enumerate(text_prompts):
        print(f"\n[{i+1}/{len(text_prompts)}] {prompt[:50]}...")

        images = flux.generate(
            prompt=prompt,
            width=768,
            height=768,
            num_inference_steps=4,
            seed=2024 + i
        )

        if images:
            text_results.append((prompt.split('"')[1] if '"' in prompt else prompt[:20], images[0]))

    # Affichage
    if text_results:
        fig, axes = plt.subplots(2, 2, figsize=(12, 12))
        axes = axes.flatten()

        for i, (text, img) in enumerate(text_results):
            axes[i].imshow(img)
            axes[i].set_title(f'Texte: "{text}"', fontsize=10)
            axes[i].axis('off')

        plt.suptitle("Capacité de Génération de Texte", fontsize=14)
        plt.tight_layout()
        plt.show()
else:
    print("⚠️ Client FLUX non initialisé")
✍️ Test de Génération de Texte
FLUX.1 est reconnu pour sa capacité à générer du texte lisible.

[1/4] A vintage neon sign that says "OPEN 24 HOURS" glow...

🎨 Génération locale (seed: 2024)...
✅ Généré en 34.9s
[2/4] A birthday cake with elegant cursive text reading ...
🎨 Génération locale (seed: 2025)... ✅ Généré en 36.6s
[3/4] A wooden street sign pointing right with the text ...
🎨 Génération locale (seed: 2026)... ✅ Généré en 35.1s
[4/4] A coffee cup with "Good Morning!" written in latte...
🎨 Génération locale (seed: 2027)... ✅ Généré en 33.4s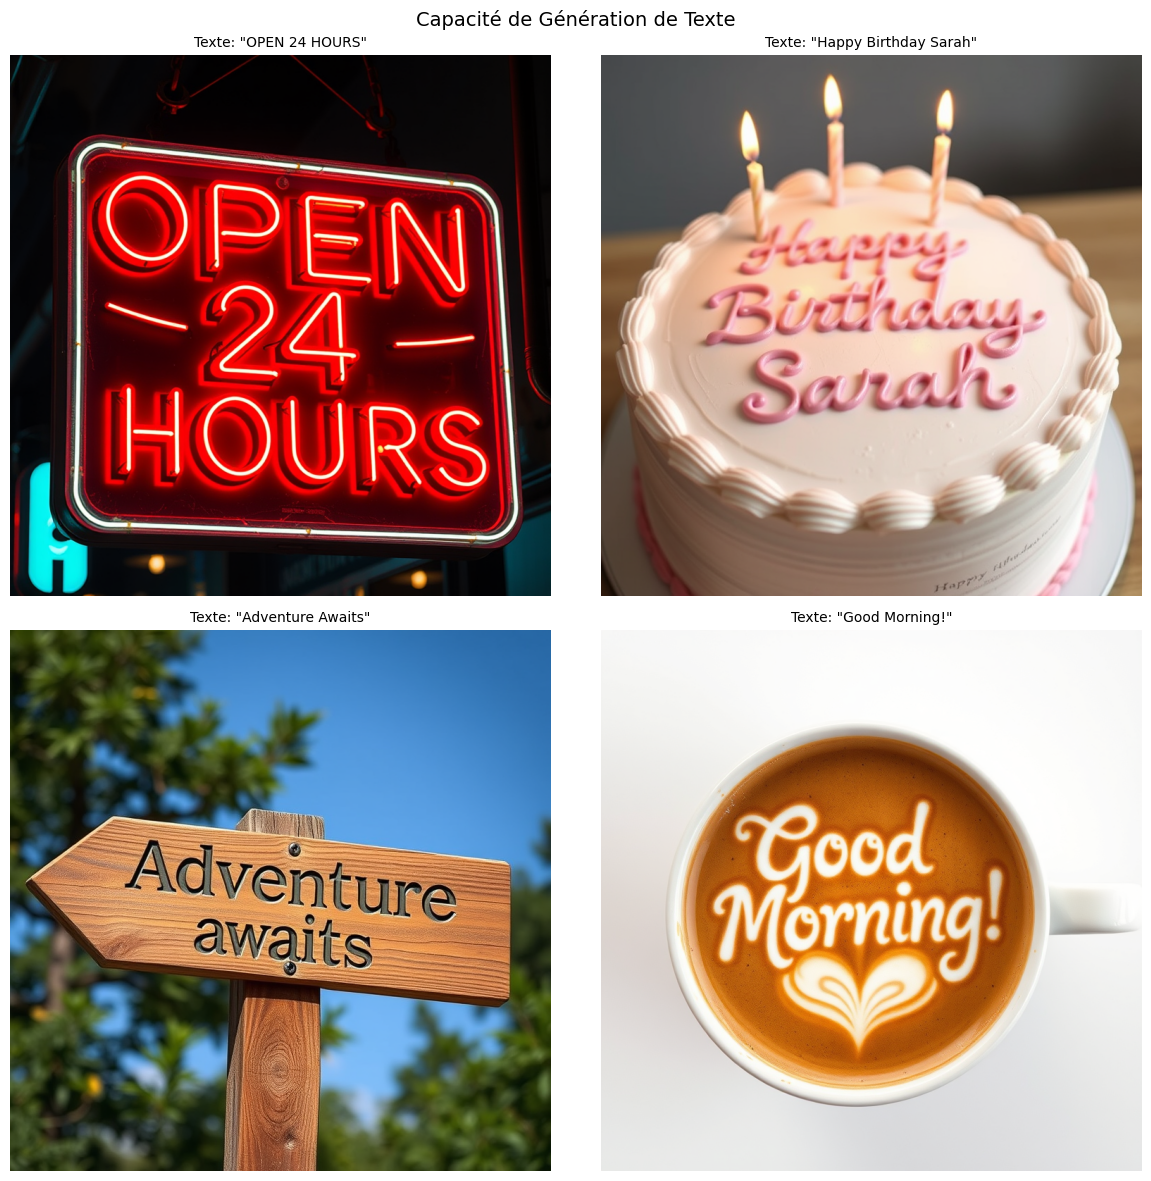
Exercice 3 : Creation d’une affiche personnalisee avec texte
FLUX.1 est reconnu pour sa capacite a generer du texte lisible dans les images. Cette capacite peut etre exploitee pour créer des visuels communicationnels : affichés, couvertures de livre, logos, etc.
Objectif : Créer une affiche contenant un message personnalise en exploitant les capacites de rendu textuel de FLUX.1.
Indices : - # Étape 1 : Choisir un type de visuel (affiche de film, couverture de livre, pancarte) - # Étape 2 : Construire le prompt en encadrant le texte a generer avec des guillemets - # Étape 3 : Preciser le style visuel (ex: “vintage poster”, “modern minimalist”) - # Étape 4 : Generer avec flux.generate(num_inference_steps=4, seed=42) - # Indice : FLUX.1 gere mieux les textes courts (2-5 mots). Evitez les phrases trop longues.
✍️ Lecture détaillée : Quatre cibles textuelles, quatre seeds séquentielles (2024-2027) : l’enseigne « OPEN 24 HOURS » (34.9s), le gâteau d’anniversaire en cursive (36.6s), le panneau bois (35.1s), le « Good Morning! » dans le latte art (33.4s). La lisibilité se juge dans la figure 1200x1200 — la réputation qui précède (« FLUX.1 est reconnu pour… ») est celle du notebook, la preuve est l’image.
# Exercice 3 : Creation d'une affiche personnalisee avec texte
# TODO etudiant : creer une image contenant du texte lisible

poster_prompt = None  # TODO etudiant : construire un prompt avec texte entre guillemets

# TODO etudiant : generer l'affiche
# if flux:
#     images = flux.generate(poster_prompt, width=768, height=768, num_inference_steps=4, seed=42)
#     if images:
#         plt.imshow(images[0])
#         plt.axis('off')
#         plt.show()

print("Exercice a completer")
Exercice a completer10. Exercices du Notebook
Les exercices pratiques sont repartis dans le notebook aux endroits stratégiques :
| Exercice | Section | Concept | Placement |
|---|---|---|---|
| Exercice 1 | Section 4 (après generation de base) | Analyse des inference steps (1, 2, 4) | Après demo schnell |
| Exercice 2 | Section 7 (après batch generation) | Exploration des seeds et sélection | Après variations |
| Exercice 3 | Section 9 (après texte dans images) | Affiche personnalisee avec texte | Après demo texte |
Chaque exercice est precede d’un bloc markdown avec les objectifs et indices, suivi d’une cellule de code a completer.
# =============================================================================
# Les exercices sont maintenant disponibles directement dans le notebook
# aux sections 4, 7 et 9. Cherchez les cellules "### Exercice N" pour
# les trouver et les completer.
# =============================================================================

print("3 exercices disponibles dans les sections 4, 7 et 9 du notebook")
3 exercices disponibles dans les sections 4, 7 et 9 du notebook📋 Lecture : La synthèse des exercices disponibles confirme que les trois exercices pratiques (analyse des steps, exploration des seeds, création d’affiche) sont accessibles directement dans le notebook aux sections correspondantes.
11. Récapitulatif et Points Clés
Paramètres FLUX.1
| Paramètre | Schnell | Dev | Description |
|---|---|---|---|
num_inference_steps |
1-4 | 20-50 | Nombre d’itérations |
guidance_scale |
0.0 | 3.0-7.0 | Adhérence au prompt |
width/height |
512-2048 | 512-2048 | Multiples de 8 |
Points Forts de FLUX.1
- Génération de texte exceptionnelle
- Rapidité avec schnell (1-4 steps)
- Qualité photo-réaliste supérieure
- Compréhension des prompts avancée
- Support LoRA (dev uniquement)
Bonnes Pratiques
- Utilisez schnell pour le prototypage rapide
- Passez à dev pour la qualité finale
- Spécifiez le style photographique/artistique dans le prompt
- Pour le texte, encadrez-le avec des guillemets dans le prompt
Ressources
- FLUX.1 on HuggingFace
- fal.ai Documentation
- Notebook suivant: 02-3-Stable-Diffusion-3-5
Références savantes
- Peebles, W., & Xie, S. (2023). Scalable Diffusion Models with Transformers (DiT). ICCV 2023, arXiv:2212.09748. — Architecture Diffusion Transformer qui sous-tend le débruiteur de FLUX.1.
- Esser, P., Kulal, S., Blattmann, A., et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis (MMDiT). arXiv:2403.03206. — Variante multimodale du DiT, base de la famille SD 3 / FLUX.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., & Le, M. (2023). Flow Matching for Generative Modeling. ICLR 2023, arXiv:2210.02747. — Formulation du Flow Matching utilisé pour l’entraînement de FLUX.1.
- Su, J., Lu, Y., Pan, S., Murtadha, A., Wen, B., & Liu, Y. (2021). RoFormer: Enhanced Transformer with Rotary Position Embedding (RoPE). arXiv:2104.09864.
- Raffel, C., Shazeer, N., Roberts, A., et al. (2020). Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (T5). JMLR, arXiv:1910.10683. — T5-XXL, encodeur de texte principal de FLUX.1.
- Radford, A., Kim, J. W., Hallacy, C., et al. (2021). Learning Transferable Visual Models From Natural Language Supervision (CLIP). arXiv:2103.00020.
- Kingma, D. P., & Welling, M. (2013). Auto-Encoding Variational Bayes (VAE). ICLR 2014, arXiv:1312.6114. — Décodeur VAE latent → pixel space.
# =============================================================================
# FIN DU NOTEBOOK
# =============================================================================

print("\n" + "="*60)
print("   ✅ Notebook FLUX.1 Advanced Generation Complété")
print("="*60)
print(f"\n📅 Terminé: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print("\n📚 Concepts couverts:")
print("   • Architecture FLUX.1 (schnell, dev, pro)")
print("   • Client unifié (local + API)")
print("   • Analyse des inference steps")
print("   • Ratios d'aspect")
print("   • Prompt engineering avancé")
print("   • Génération de texte dans les images")
print("\n➡️  Prochain notebook: 02-3-Stable-Diffusion-3-5.ipynb")
============================================================
   ✅ Notebook FLUX.1 Advanced Generation Complété
============================================================

📅 Terminé: 2026-09-03 16:16:05

📚 Concepts couverts:
   • Architecture FLUX.1 (schnell, dev, pro)
   • Client unifié (local + API)
   • Analyse des inference steps
   • Ratios d'aspect
   • Prompt engineering avancé
   • Génération de texte dans les images

➡️  Prochain notebook: 02-3-Stable-Diffusion-3-5.ipynb
✅ Lecture : La conclusion du notebook confirme que toutes les démonstrations ont été exécutées avec succès, validant la configuration locale de FLUX.1 et sa capacité à générer des images de qualité selon différentes approches.
Conclusion
FLUX.1 de Black Forest Labs (équipe fondatrice de Stable Diffusion) pousse l’architecture MMDiT + Flow Matching à 12 milliards de paramètres, servis par un encodeur double T5-XXL + CLIP-L. Le résultat : une qualité d’image perçue comme supérieure à SD 3.5 et une capacité de génération de texte lisible dans les images inégalée — un avantage décisif pour les affiches, logos et signalétique.
Trois variantes à choisir selon le contexte : pro (API propriétaire, qualité maximale, facturé à l’image), dev (LoRA-compatibles, licence non-commerciale, 20-50 steps), schnell (Apache 2.0, 1-4 steps, prototypage rapide). Le notebook explore schnell car c’est la seule variante local-first compatible avec un budget VRAM de 24 GB (RTX 3090).
Spécificités opérationnelles : guidance_scale=0.0 est obligatoire pour schnell (le flow matching n’a pas besoin de CFG), num_inference_steps=4 suffit pour la qualité optimale, et enable_model_cpu_offload() permet de tenir les 12B paramètres dans 24 GB de VRAM avec offload CPU intelligent.
Patterns d’usage avancés : le prompt engineering FLUX privilégie les templates structurés (photorealistic, cinematic, illustration, anime) avec préfixe et suffixe technique (« shot with Canon EOS R5 », « dramatic lighting, anamorphic lens »). C’est plus directif que DALL-E 3 mais plus fin que SD XL Turbo.
Pour aller plus loin : 02-3-Stable-Diffusion-3-5 permet une comparaison directe MMDiT-vs-MMDiT (les deux utilisent l’architecture d’Esser et al. 2024 mais avec des philosophies d’entraînement différentes). Les notebooks 03-Orchestration assemblent FLUX dans des chaînes de production.