03-Orchestration - Multi-modèles & Workflows
← Image Advanced | ↑ Image | → Image Applications
Ce module couvre l’orchestration de plusieurs modèles, les workflows complexes, et l’optimisation de performance.
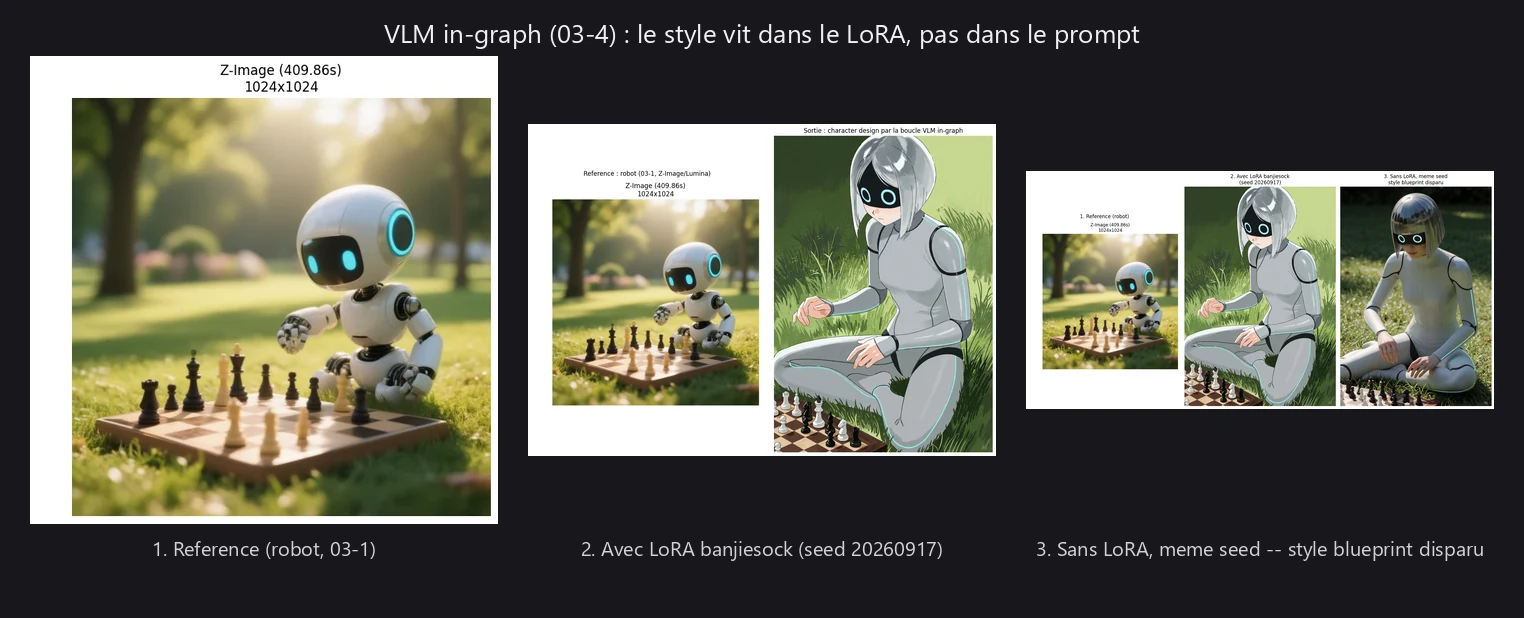
Dans le cadre du fil rouge contenu visuel éducatif : en production, un seul modèle ne suffit pas. 03-1 compare les modèles pour choisir le meilleur selon le contexte. 03-2 assemble des pipelines (génération, édition, upscaling). 03-3 optimise les performances pour le déploiement. 03-4 rejoue un workflow trouvé dans les métadonnées d’une image : un VLM in-graph qui écrit le prompt de character design depuis une image de référence.
Vue d’overview
| Statistique | Valeur |
|---|---|
| Notebooks | 4 |
| Kernel | Python 3 |
| Durée estimée | ~3-5h |
| GPU requis | Variable |
Notebooks
| # | Notebook | Contenu | Service | VRAM |
|---|---|---|---|---|
| 1 | 03-1-Multi-Model-Comparison | Comparaison multi-modèles | Mixed | Variable |
| 2 | 03-2-Workflow-Orchestration | Orchestration de workflows | ComfyUI | Variable |
| 3 | 03-3-Performance-Optimization | Optimisation performance | ComfyUI | Variable |
| 4 | 03-4-VLM-Character-Design-Workflow | Boucle VLM in-graph (workflow embarqué dans un PNG) | ComfyUI (Krea 2) | 24 Go |
Prérequis
Docker Services
cd docker-configurations/services/comfyui-qwen
docker-compose up -d
Accès : http://localhost:8188
Dépendances
pip install -r requirements.txt
pip install -r requirements-comfyui.txt
Progression recommandée
- 03-1-Multi-Model-Comparison - Comparatif des modèles pour choisir le bon
- 03-2-Workflow-Orchestration - Création de workflows complexes
- 03-3-Performance-Optimization - Optimisation des performances
- 03-4-VLM-Character-Design-Workflow - Forensics d’un workflow embarqué + boucle VLM in-graph
Concepts clés
Multi-Model Comparison
- Critères : Qualité, vitesse, ressources, contrôle
- Modèles comparés : SDXL Lightning-4step (Forge), Z-Image/Lumina-2 (ComfyUI)
- Métriques : PSNR, SSIM, temps de génération, coût
Workflow Orchestration
- Patterns : Chaines de traitement, parallélisation, batch processing
- Outils : ComfyUI, Python asyncio, multiprocessing
- Cas d’usage : Production batch, pipelines automatisés
Le notebook 03-2-Workflow-Orchestration illustre concrètement ces patterns à partir du même prompt — chaque pipeline exécute une chaîne ComfyUI différente et expose ses sorties :
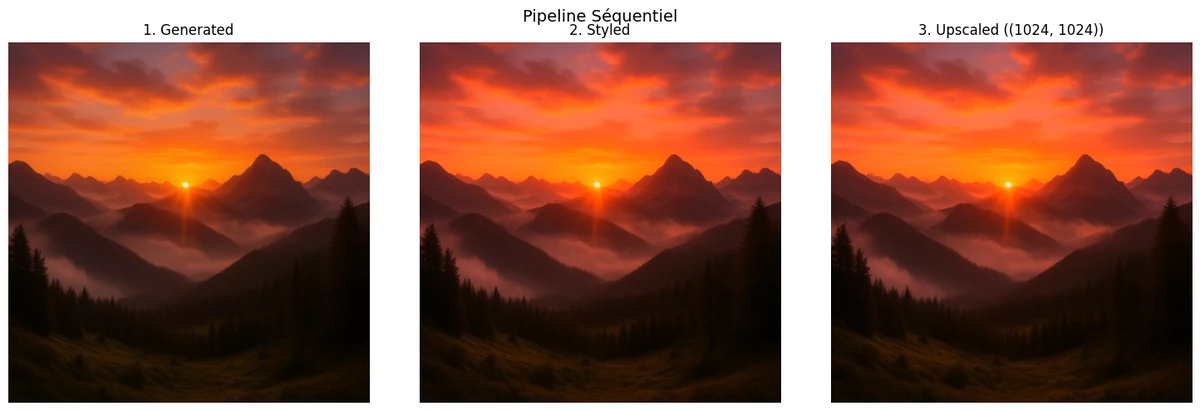
Pipeline séquentiel (génération → style → upscaling) — un coucher de soleil sur montagnes passe par trois étapes successives : Qwen produit l’image initiale (1024×1024), un node de style applique le rendu painterly, puis un upscaler double la résolution à 2048×2048. La même scène gagne en détail au fil des étapes sans perdre la composition d’origine :
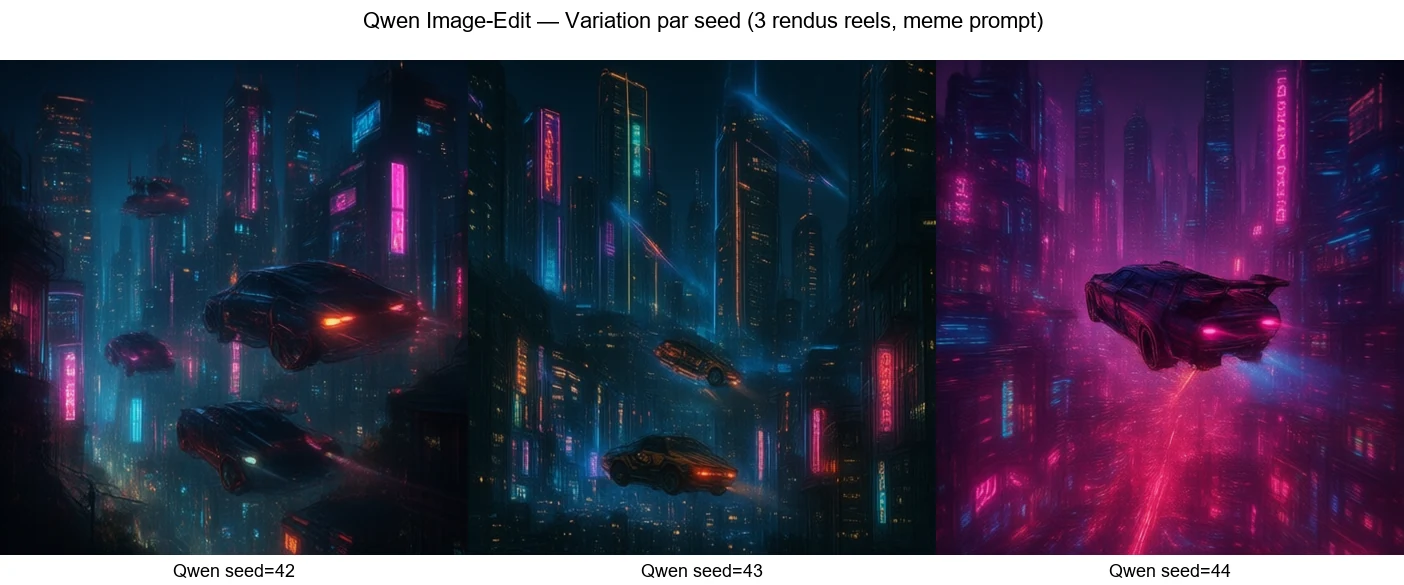
Comparaison multi-modèles en parallèle — le même prompt « A futuristic city with flying cars and neon lights… » est soumis simultanément à 3 invocations Qwen Image-Edit à seeds distinctes (42 / 43 / 44) pour éviter le cache-hit _GENERATED_CACHE[prompt[:120] + "|" + str(seed)] qui auparavant rejouait 1 seule image 3 fois (issue #9347, fix c.988 sur cell[9], étendu à cell[13] par c.988-ter-bis). Les 3 steps parallèles démontrent ainsi une variation par seed d’un même modèle — choix reflété honnêtement par les labels seed-based de l’asset archivé (c.988-ter-bis : plain seed-based labels, pas cosmétiques model-names-avec-caveat). L’asset archivé est cette fois composé de 3 vrais rendus Qwen produits via ComfyUI (peer po-2023:CoursIA, messages msg-20260805T205931-dbp9er + msg-20260805T214336-swgcfo, sources dans D:/Dev/.genai-stack-real-renders-9347/) — la re-exécution locale ComfyUI 3×370s excède la fenêtre worker 30 min (RECOVERABLE-MACHINE honorée : le worker GenAI stack est la bonne machine pour ce livrable). Le comportement pipeline est correct : seeds distincts ⇒ images distinctes ⇒ 3 compositions cyberpunk distinctes vérifiées par vision QA MiniMax M3 :
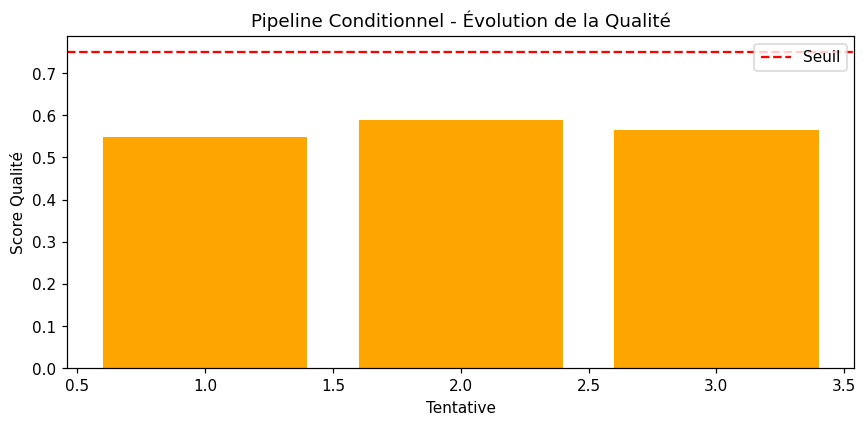
Note (issue #9346). Avant le fix
seed=42 + attemptde cell-11, les 3 tentatives partageaientseed=42:_GENERATED_CACHErejouait la même image et la barre « Évolution » était plate. Le PNGimg3-workflow3.pnga été régénéré le 2026-08-05 depuis un run Qwen Image réel (ComfyUI Phase 29, seeds 42/43/44, steps 20/30/40) : les 3 scores distincts (~0.55, ~0.59, ~0.57) ne sont pas monotones — la std-heuristique deevaluate_qualityfluctue dans une bande stable sous le seuil, ce qui illustre honnêtement le comportement du pipeline (relance tant que score < seuil) sans suggérer une amélioration garantie.
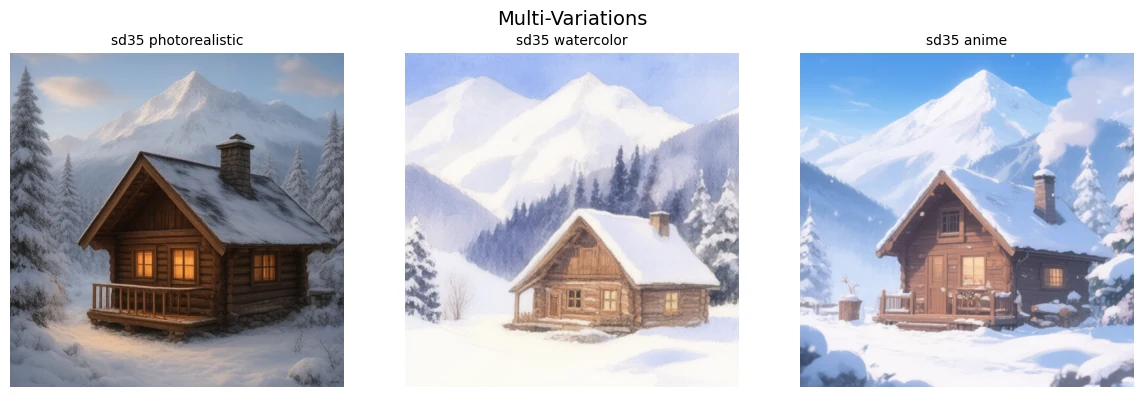
Variations stylistiques — un même prompt (chalet de montagne sous la neige) est exécuté sur SD35 avec trois styles distincts : photoréaliste, aquarelle, anime. Le pipeline ne change pas la géométrie de la scène, seulement l’apparence — c’est l’usage classique des conditioning nodes de ComfyUI :
Provenance et poids de chaque figure : assets/readme/MANIFEST.md.
Performance Optimization
- Techniques : Quantization, caching, hardware acceleration
- Stratégies : Progressive enhancement, early stopping
- Monitoring : Profiling, resource tracking
VLM in-graph (03-4)
- Forensics : un PNG ComfyUI embarque son workflow (chunks
tEXt: format API + format UI) - Boucle agentic : un VLM examine une image de référence et écrit le prompt de génération, dans le graphe
- Séparation design / style : le prompt VLM porte l’identité du personnage, le LoRA porte le rendu — deux canaux composables
Architecture
Input → Model Selection → Processing → Output
    ↓           ↓            ↓          ↓
  Benchmark   Router      Pipeline  Validation