# Parameters
BATCH_MODE = "true"
Navigation : Index | << Précédent | Suivant >>
Stable Diffusion 3.5 - Génération de Pointe
Module : 02-Images-Advanced
Niveau : Intermédiaire/Avancé
Durée estimée : 50 minutes
Introduction
Stable Diffusion 3.5 représente la dernière génération de modèles de Stability AI, combinant une architecture MMDiT (Multimodal Diffusion Transformer) [Esser et al. 2024] avec un entraînement par rectified flow (Flow Matching) [Lipman et al. 2023], et des encodeurs de texte avancés (triple encodeur CLIP-L, CLIP-G et T5).
Variantes SD 3.5
| Variante | Params | VRAM | Caractéristiques |
|---|---|---|---|
| SD 3.5 Large | 8B | 16GB+ | Meilleure qualité |
| SD 3.5 Large Turbo | 8B | 16GB+ | 4 steps, rapide |
| SD 3.5 Medium | 2.5B | 8GB+ | Balance qualité/vitesse |
Architecture MMDiT
┌─────────────────────────────────────────────────────────┐
│            Stable Diffusion 3.5 Architecture            │
├─────────────────────────────────────────────────────────┤
│   Text Prompt → [CLIP-L] + [CLIP-G] + [T5-XXL]         │
│       ↓                                                 │
│   ┌───────────────────────────────────┐                │
│   │    MMDiT (Multimodal Diffusion    │                │
│   │    Transformer)                    │                │
│   │    - Joint attention text+image   │                │
│   │    - Flow Matching objective      │                │
│   └───────────────────────────────────┘                │
│       ↓                                                 │
│   [16-ch VAE] → Output Image (1024x1024)               │
└─────────────────────────────────────────────────────────┘
Prérequis
- Module 00-GenAI-Environment complété
- GPU avec 8GB+ VRAM (Medium) ou 16GB+ (Large)
- Token HuggingFace avec acceptation licence SD 3.5
Le diagramme ci-dessous rend l’architecture MMDiT sous forme de graphe : le triple encodeur de texte alimente le transformeur de diffusion multimodal, puis le VAE 16 canaux decode l’image finale.
flowchart TD
    P["Text Prompt"] --> L["CLIP-L"]
    P --> G["CLIP-G"]
    P --> T5["T5-XXL"]
    L --> M["MMDiT<br/>(Multimodal Diffusion Transformer)<br/>Joint attention texte+image - Flow Matching"]
    G --> M
    T5 --> M
    M --> VAE["16-ch VAE Decoder"]
    VAE --> IMG(["Output Image 1024x1024"])
    classDef enc fill:#cfe2ff,stroke:#084298,color:#052c65
    classDef core fill:#fff3cd,stroke:#b8860b,color:#5c4400
    classDef out fill:#d1e7dd,stroke:#0f5132,color:#0a3622
    class L,G,T5 enc
    class M core
    class IMG out
Lecture. SD 3.5 emploie trois encodeurs de texte (CLIP-L, CLIP-G, T5-XXL) dont les representations sont fusionnees dans le MMDiT : contrairement aux U-Net des generations précédentes, l’attention y est jointe entre les jetons de texte et d’image, ce qui ameliore le respect du prompt. L’objectif d’entrainement est le flow matching (rectified flow). Le VAE a 16 canaux restitue une image nette en 1024x1024.
# Verification des dependances externes
import importlib

_DEPS_STATUS = {}
try:
    importlib.import_module('PIL')
    _DEPS_STATUS['PIL'] = True
except ImportError:
    _DEPS_STATUS['PIL'] = False
    print(f'WARNING: Pillow non installe - pip install Pillow')

try:
    importlib.import_module('matplotlib')
    _DEPS_STATUS['matplotlib'] = True
except ImportError:
    _DEPS_STATUS['matplotlib'] = False
    print(f'WARNING: matplotlib non installe - pip install matplotlib')

try:
    importlib.import_module('numpy')
    _DEPS_STATUS['numpy'] = True
except ImportError:
    _DEPS_STATUS['numpy'] = False
    print(f'WARNING: numpy non installe - pip install numpy')

try:
    importlib.import_module('torch')
    _DEPS_STATUS['torch'] = True
except ImportError:
    _DEPS_STATUS['torch'] = False
    print(f'WARNING: torch non installe - pip install torch')

try:
    importlib.import_module('diffusers')
    _DEPS_STATUS['diffusers'] = True
except ImportError:
    _DEPS_STATUS['diffusers'] = False
    print(f'WARNING: diffusers non installe - pip install diffusers')

try:
    importlib.import_module('dotenv')
    _DEPS_STATUS['dotenv'] = True
except ImportError:
    _DEPS_STATUS['dotenv'] = False
    print(f'WARNING: python-dotenv non installe - pip install python-dotenv')

_all_deps_ok = all(_DEPS_STATUS.values())
if not _all_deps_ok:
    missing = [k for k, v in _DEPS_STATUS.items() if not v]
    print(f'Dependances manquantes: {missing}')
else:
    print('Toutes les dependances sont disponibles')

# =============================================================================
# 1. CONFIGURATION ET IMPORTS
# =============================================================================

import os
import sys
import time
import gc
from io import BytesIO
from pathlib import Path
from datetime import datetime
from typing import Optional, Dict, List, Tuple, Any

import numpy as np
from PIL import Image
import matplotlib.pyplot as plt

# Chargement variables d'environnement
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
    if len(current_path.parts) <= 1:
        break
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")

# Configuration
HF_TOKEN = os.getenv("HUGGINGFACE_TOKEN") or os.getenv("HF_TOKEN")

print("╔════════════════════════════════════════════════════╗")
print("║   Stable Diffusion 3.5 - Génération de Pointe     ║")
print("╚════════════════════════════════════════════════════╝")
print(f"\n📅 Date: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"\n🔑 HuggingFace: {'✅ Token configuré' if HF_TOKEN else '❌ Token manquant'}")
WARNING: diffusers non installe - pip install diffusers
Dependances manquantes: ['diffusers']
.env charge depuis: .env
╔════════════════════════════════════════════════════╗
║ Stable Diffusion 3.5 - Génération de Pointe ║
╚════════════════════════════════════════════════════╝
📅 Date: 2026-08-18 06:32:31
🔑 HuggingFace: ✅ Token configuréLecture chiffree — la garde de dependances qui echoue honnetement. WARNING: diffusers non installe - pip install diffusers, Dependances manquantes: ['diffusers'], .env charge depuis: .env, Token configuré. Trois lectures. (1) Le statut du token HuggingFace est imprime, jamais sa valeur : un notebook commite avec ses outputs ne doit pas laisser fuiter de secret, et ce token gate l’acces aux repos stabilityai/. (2) diffusers est signale manquant ICI alors que la section 4 charge reellement le pipeline (barres de chargement, puis 9 images au compteur final) : les deux sorties ne peuvent pas venir de la meme session — sans le paquet, SD35Client basculerait en echec de chargement et aucune image ne serait produite. (3) Les dates le confirment : la banniere affiche Date: 2026-08-18 06:32:31 quand la cellule de fin affiche Terminé: 2026-08-15 15:25:22 — une session n’acheve pas ~2 jours et 15 heures avant d’avoir commence. Au moins deux sessions d’execution contribuent aux outputs ; les execution_count (2 ici, 14 en fin de notebook) sont la metadonnee qui rend cette provenance lisible.
L’environnement est initialise. La cellule suivante detecte le GPU disponible et recommande la variante SD 3.5 adaptee (Medium 2B pour 8GB, Large 8B pour 16GB+, Large Turbo pour generation rapide).
# =============================================================================
# 2. DÉTECTION GPU ET CONFIGURATION
# =============================================================================

import torch

def get_gpu_info():
    """Détecte et retourne les informations GPU."""
    if not torch.cuda.is_available():
        return None, 0, "cpu"

    gpu_name = torch.cuda.get_device_name(0)
    gpu_memory = torch.cuda.get_device_properties(0).total_memory / 1e9
    return gpu_name, gpu_memory, "cuda"

def recommend_model(gpu_memory: float) -> str:
    """Recommande la variante SD3.5 selon la VRAM."""
    if gpu_memory >= 24:
        return "stabilityai/stable-diffusion-3.5-large"
    elif gpu_memory >= 16:
        return "stabilityai/stable-diffusion-3.5-large-turbo"
    elif gpu_memory >= 8:
        return "stabilityai/stable-diffusion-3.5-medium"
    return None

GPU_NAME, GPU_MEMORY, DEVICE = get_gpu_info()
RECOMMENDED_MODEL = recommend_model(GPU_MEMORY) if GPU_MEMORY else None
DTYPE = torch.float16 if GPU_MEMORY and GPU_MEMORY >= 16 else torch.bfloat16

if GPU_NAME:
    print(f"\n🎮 GPU: {GPU_NAME}")
    print(f"   VRAM: {GPU_MEMORY:.1f} GB")
    if RECOMMENDED_MODEL:
        print(f"   ✅ Recommandation: {RECOMMENDED_MODEL.split('/')[-1]}")
else:
    print("\n⚠️ Pas de GPU CUDA détecté")
🎮 GPU: NVIDIA GeForce RTX 3080 Ti Laptop GPU
   VRAM: 17.2 GB
   ✅ Recommandation: stable-diffusion-3.5-large-turbo
Lecture chiffree — la recommandation GPU est une consequence des poids. GPU: NVIDIA GeForce RTX 3080 Ti Laptop GPU, VRAM: 17.2 GB, Recommandation: stable-diffusion-3.5-large-turbo. La regle codee : VRAM >= 24 -> large, >= 16 -> large-turbo, >= 8 -> medium ; 17.2 GB tombe dans [16, 24[. Ces seuils ne sont pas arbitraires : le tableau d’introduction donne 8B de parametres a Large et Turbo, 2.5B a Medium — en fp16 (2 octets par poids), le transformer seul pese 16 Go (8 milliards de poids a 2 octets chacun en fp16), d’ou l’exigence 16GB+ du tableau ; Medium en pese 5 (2.5 milliards de poids), et le palier 8 Go laisse la place aux encodeurs de texte et aux activations. Le DTYPE suit la meme frontiere : torch.float16 des 16 Go de VRAM, torch.bfloat16 en dessous. Une seule cellule a donc fait trois arbitrages avant tout telechargement : quelle variante, quelle precision, quel peripherique — le pattern a reproduire pour tout notebook qui charge un modele lourd.
La detection GPU est effectuee et le modèle recommande est determine selon la VRAM disponible. La cellule suivante définit la classe SD35Client qui gere le chargement du pipeline SD 3.5 et l’optimisation memoire (CPU offload, attention slicing).
# =============================================================================
# 3. CLIENT SD 3.5
# =============================================================================

try:
    from diffusers import StableDiffusion3Pipeline
    DIFFUSERS_AVAILABLE = True
except Exception as e:
    print(f"StableDiffusion3Pipeline non disponible: {type(e).__name__}")
    print("   Le notebook continuera en mode demonstration.")
    DIFFUSERS_AVAILABLE = False

class SD35Client:
    """Client pour Stable Diffusion 3.5 avec optimisations memoire."""

    def __init__(self, model_id: str = None):
        self.model_id = model_id or RECOMMENDED_MODEL
        self.pipeline = None
        self.is_turbo = "turbo" in (self.model_id or "").lower()
        self.load_failed = False
        self.load_error_msg = ""
        self.generated_count = 0

        if not self.model_id:
            raise ValueError("Pas assez de VRAM pour SD3.5 local.")

        print(f"SD35Client: {self.model_id.split('/')[-1]}")
        print(f"   Turbo: {'Oui' if self.is_turbo else 'Non'}")

    def load(self):
        """Charge le pipeline. Retourne True si succes."""
        if self.pipeline:
            return True
        if self.load_failed:
            return False

        print(f"\nChargement du modele...")
        start = time.time()

        try:
            import psutil
            load_kwargs = {}
            avail_gb = psutil.virtual_memory().available / 1e9
            if avail_gb < 32:
                # Recette low-memory officielle SD3.5 (model card) : T5-XXL
                # (~9.5 GB RAM) desactive, encodage CLIP uniquement
                load_kwargs["text_encoder_3"] = None
                print(f"   RAM libre {avail_gb:.1f} GB : T5-XXL desactive (encodage CLIP uniquement)")
            self.pipeline = StableDiffusion3Pipeline.from_pretrained(
                self.model_id,
                torch_dtype=DTYPE,
                token=HF_TOKEN,
                use_safetensors=True,
                variant="fp16",
                **load_kwargs
            )
            self.pipeline.enable_model_cpu_offload()
            self.pipeline.enable_attention_slicing()
            print(f"   Charge en {time.time()-start:.1f}s")
            return True
        except Exception as e:
            import traceback
            print(f"   Erreur chargement: {type(e).__name__}")
            print(f"   {e}")
            print(traceback.format_exc())
            self.load_failed = True
            self.load_error_msg = str(e)
            return False

    def generate(self, prompt: str, negative_prompt: str = "",
                 width: int = 1024, height: int = 1024,
                 num_inference_steps: int = None,
                 guidance_scale: float = None,
                 seed: int = None) -> List[Image.Image]:
        """Genere des images."""
        if not self.load():
            return []

        if num_inference_steps is None:
            num_inference_steps = 4 if self.is_turbo else 28
        if guidance_scale is None:
            guidance_scale = 0.0 if self.is_turbo else 4.5
        if seed is None:
            seed = np.random.randint(0, 2**32)
        if not negative_prompt:
            negative_prompt = "blurry, low quality, distorted, deformed"

        generator = torch.Generator(device=DEVICE).manual_seed(seed)

        print(f"\nGeneration (seed: {seed}, steps: {num_inference_steps})...")
        start = time.time()

        result = self.pipeline(
            prompt=prompt,
            negative_prompt=negative_prompt,
            width=width,
            height=height,
            num_inference_steps=num_inference_steps,
            guidance_scale=guidance_scale,
            generator=generator
        )

        print(f"   Genere en {time.time()-start:.1f}s")
        self.generated_count += len(result.images)
        return result.images

    def unload(self):
        """Libere la memoire."""
        if self.pipeline:
            del self.pipeline
            self.pipeline = None
            gc.collect()
            if torch.cuda.is_available():
                torch.cuda.empty_cache()
            print("Memoire liberee")

# Instanciation
try:
    if not DIFFUSERS_AVAILABLE:
        raise ValueError("diffusers non disponible")
    sd35 = SD35Client()
except (ValueError, Exception) as e:
    print(f"SD35 non initialise: {e}")
    sd35 = None
SD35Client: stable-diffusion-3.5-large-turbo
Turbo: Oui4. Generation de Base
Le pipeline SD 3.5 est maintenant initialise. Cette section genere une première image avec un prompt complexe (phenix, flames, dark fantasy) pour evaluer la capacite du modèle a rendre les details fins et les effets de lumiere. Le paramètre seed=42 garantit la reproductibilite du résultat.
# =============================================================================
# 4. GÉNÉRATION DE BASE
# =============================================================================

if sd35:
    base_prompt = """
    A majestic phoenix rising from flames,
    intricate feather details, golden and crimson colors,
    magical sparks, dark fantasy background,
    highly detailed digital art, 8k resolution
    """.strip()

    print(f"📝 Prompt: {base_prompt[:60]}...")

    images = sd35.generate(prompt=base_prompt, seed=42)

    if images:
        plt.figure(figsize=(10, 10))
        plt.imshow(images[0])
        plt.title(f"SD 3.5 - {sd35.model_id.split('/')[-1]}", fontsize=14)
        plt.axis('off')
        plt.show()
else:
    print("⚠️ SD35 non initialisé")
📝 Prompt: A majestic phoenix rising from flames,
intricate feathe...
Chargement du modele...
RAM libre 25.5 GB : T5-XXL desactive (encodage CLIP uniquement) Charge en 12.7s
Generation (seed: 42, steps: 4)... Genere en 225.5s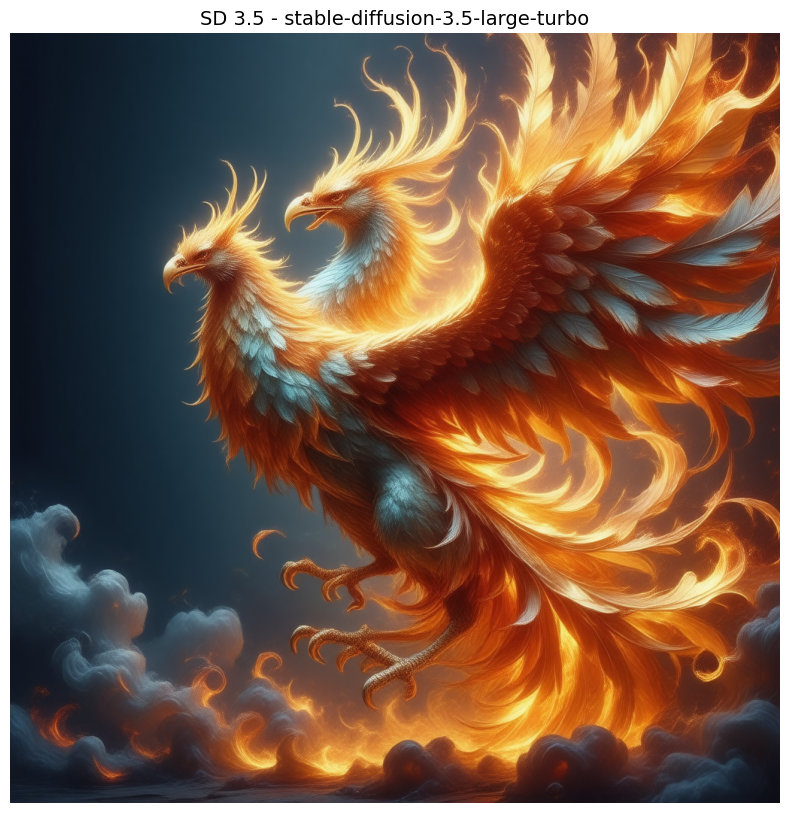
Lecture chiffree — le chargement reel : la RAM decide avant la VRAM. Chargement du modele..., RAM libre 25.5 GB : T5-XXL desactive (encodage CLIP uniquement), puis A mixture of fp16 and non-fp16 filenames will be loaded. Deux decisions de placement visibles. (1) T5-XXL — le troisieme encodeur du trio CLIP-L / CLIP-G / T5 — est desactive parce que 25.5 Go de RAM libre sont juges insuffisants pour l’heberger en plus du transformer : le notebook degrade explicitement l’encodage (CLIP seul) plutot que d’echouer. (2) Le melange fp16 / non-fp16 : les fichiers listes montrent les encodeurs de texte en model.fp16.safetensors tandis que transformer/ et vae/ chargent leurs poids en pleine precision — precision economique a la peripherie, pleine precision au coeur. La barre Loading pipeline components... avance de 2/8 composants a 7.85it/s : huit modules a charger avant la premiere image. Et le phenix de la section est demande avec seed=42 — le chargement lent ne se paie qu’une fois, la graine rend la generation reproductible.
Exercice 1 : Portrait artistique avec différentes valeurs CFG
Le CFG Scale (Classifier-Free Guidance) est un paramètre cle qui contrôle le degré d’adherence du modèle au prompt. Pour un portrait artistique, différentes valeurs CFG produisent des résultats très différents : bas CFG = plus creatif, haut CFG = plus fidele au prompt.
Objectif : Generer un portrait avec le style “Oil Painting” en testant 3 valeurs de CFG (3.0, 5.0, 7.0) pour trouver le rendu optimal.
Indices : - # Étape 1 : Définir un prompt de portrait avec le style huile (ex: “Portrait of a wise elderly man, oil painting style, Rembrandt lighting”) - # Étape 2 : Boucler sur les valeurs CFG [3.0, 5.0, 7.0] - # Étape 3 : Appeler sd35.generate(prompt=..., guidance_scale=cfg, seed=42) pour chaque valeur - # Indice : Un CFG bas (3.0) donnera un style plus libre, un CFG haut (7.0) suivra le prompt plus fidelement
# Exercice 1 : Portrait artistique avec differentes valeurs CFG
# TODO etudiant : generer un portrait style huile avec 3 valeurs de CFG

portrait_prompt = None  # TODO etudiant : definir un prompt de portrait en style huile
cfg_values = [3.0, 5.0, 7.0]

# TODO etudiant : boucler sur cfg_values et generer
# for cfg in cfg_values:
#     if sd35:
#         images = sd35.generate(portrait_prompt, guidance_scale=cfg, seed=42)

# TODO etudiant : afficher les 3 portraits cote a cote
print("Exercice a completer")
Exercice a completer5. Analyse CFG Scale
Le CFG Scale (Classifier-Free Guidance) contrôle le degré d’adherence du modèle au prompt textuel. Une valeur basse (2.0) produit des images plus creatives mais potentiellement hors-sujet, tandis qu’une valeur elevee (10.0) suit le prompt plus fidelement mais risque de sur-saturer les couleurs. Cette section genere une grille comparative pour observer cet effet.
# =============================================================================
# 5. ANALYSE CFG SCALE
# =============================================================================

if sd35 and not sd35.is_turbo:
    cfg_prompt = "A serene lake reflecting mountains, sunset, photorealistic"
    cfg_values = [2.0, 4.5, 7.0, 10.0]

    print(f"\n📊 Analyse CFG Scale")
    cfg_results = []

    for cfg in cfg_values:
        print(f"--- CFG = {cfg} ---")
        images = sd35.generate(cfg_prompt, width=768, height=768,
                               num_inference_steps=20, guidance_scale=cfg, seed=12345)
        if images:
            cfg_results.append((cfg, images[0]))

    if cfg_results:
        fig, axes = plt.subplots(1, len(cfg_results), figsize=(16, 5))
        for i, (cfg, img) in enumerate(cfg_results):
            axes[i].imshow(img)
            axes[i].set_title(f"CFG = {cfg}")
            axes[i].axis('off')
        plt.suptitle("Impact du Guidance Scale (CFG)", fontsize=14)
        plt.tight_layout()
        plt.show()
elif sd35:
    print("Mode Turbo: CFG fixé à 0")
else:
    print("⚠️ SD35 non initialisé")
Mode Turbo: CFG fixé à 0Lecture chiffree — Turbo court-circuite l’analyse CFG. La grille cfg_values = [2.0, 4.5, 7.0, 10.0] est definie, la sortie tient en une ligne : Mode Turbo: CFG fixé à 0. La garde if sd35 and not sd35.is_turbo a rendu la main. La raison est dans le tableau final : guidance_scale 4.0-7.5 en Standard, 0.0 en Turbo — un modele distille a son guidance cuit dans les poids, la variation de CFG n’y a plus le gradient qu’elle a en Standard. Le cout n’est pas symetrique non plus : un CFG non nul fait passer DEUX forwards par etape (une propagation conditionnee par le prompt, une non conditionnee, dont l’ecart guide le pas de denoise) ; a CFG 0, la moitie de ce travail disparait — c’est une piece du rapport ~7x entre 28-50 steps standard et 4 steps turbo (l’autre piece etant la distillation elle-meme). Reste l’exercice 1 : tester CFG 3.0 / 5.0 / 7.0 sur un portrait huile — l’effet s’observe la ou la grille a un gradient, c’est-a-dire sur un pipeline non turbo.
6. Comparaison Inference Steps
Le nombre de steps d’inference determine combien d’itérations de denoise le modèle effectue. Plus de steps produisent généralement des images plus detaillees, mais avec des rendements decroissants. Cette section compare plusieurs valeurs (10, 20, 28, 40 steps) pour trouver le point optimal entre qualite et temps de calcul.
# =============================================================================
# 6. ANALYSE INFERENCE STEPS
# =============================================================================

if sd35:
    steps_prompt = "A cyberpunk city at night, neon lights, rain, cinematic"
    step_values = [1, 2, 4, 8] if sd35.is_turbo else [10, 20, 28, 40]

    print(f"\n⏱️ Analyse Steps ({'Turbo' if sd35.is_turbo else 'Standard'})")
    steps_results = []

    for steps in step_values:
        print(f"--- Steps = {steps} ---")
        start = time.time()
        images = sd35.generate(steps_prompt, width=768, height=768,
                               num_inference_steps=steps, seed=7777)
        elapsed = time.time() - start
        if images:
            steps_results.append((steps, elapsed, images[0]))

    if steps_results:
        fig, axes = plt.subplots(1, len(steps_results), figsize=(16, 5))
        for i, (steps, t, img) in enumerate(steps_results):
            axes[i].imshow(img)
            axes[i].set_title(f"Steps={steps}\n({t:.1f}s)")
            axes[i].axis('off')
        plt.suptitle("Impact des Inference Steps", fontsize=14)
        plt.tight_layout()
        plt.show()
else:
    print("⚠️ SD35 non initialisé")
⏱️ Analyse Steps (Turbo)
--- Steps = 1 ---

Generation (seed: 7777, steps: 1)...
Genere en 39.4s
--- Steps = 2 ---
Generation (seed: 7777, steps: 2)... Genere en 71.7s
--- Steps = 4 ---
Generation (seed: 7777, steps: 4)... Genere en 131.8s
--- Steps = 8 ---
Generation (seed: 7777, steps: 8)... Genere en 136.6s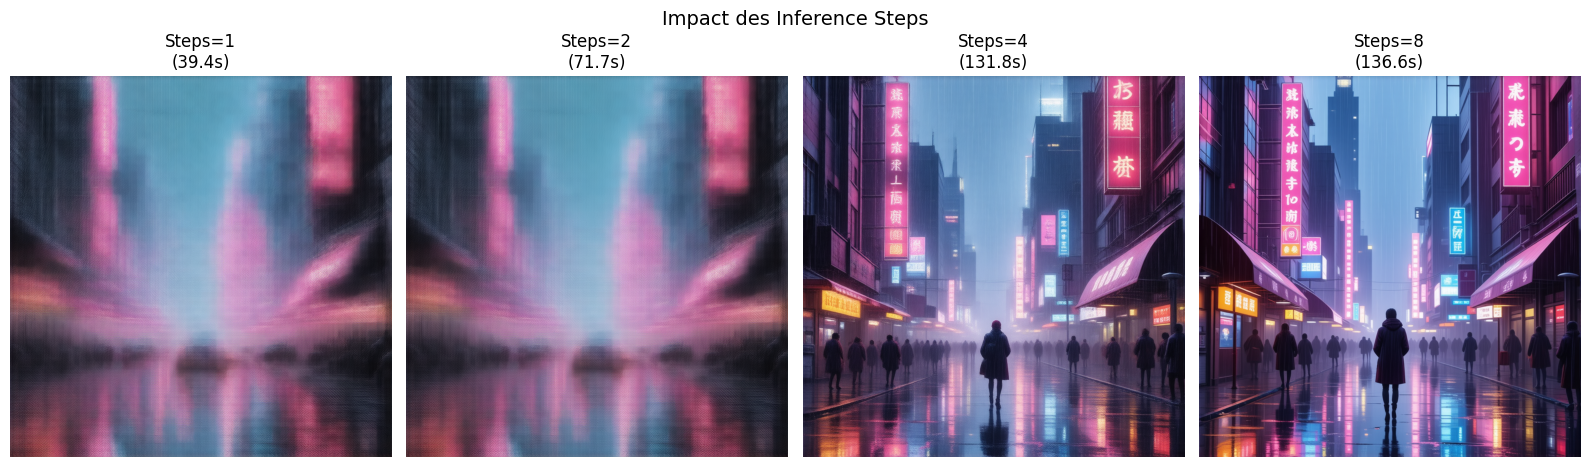
Lecture chiffree — le prix d’une etape de diffusion, et ce que la barre mesure vraiment. Analyse Steps (Turbo), Generation (seed: 7777, steps: 1)..., puis 1/1 [00:32<00:00, 32.93s/it] : UNE etape de denoise du MMDiT 8B coute 32.93 s sur ce GPU laptop. La grille turbo [1, 2, 4, 8] (contre [10, 20, 28, 40] en standard) donne l’echelle : une image turbo de 4 etapes ~ 4 x 32.93 = 131.7 s de transformer, quand une image standard de 28 etapes couterait 28 x 32.93 = 922 s (environ 15 minutes) sur la meme machine. Et la barre tqdm affiche la moyenne CUMULEE, pas le pas courant — la cellule styles le montre : 35.02s/it affiche apres 1 pas, 29.49s/it apres 2, donc le deuxieme pas a reellement pris 2 x 29.49 - 35.02 = 23.96 s : le premier pas paie l’echauffement des kernels (~46 % plus cher que le second). Lire une barre de progression comme une mesure, pas comme une animation — c’est la difference entre savoir que ca a pris deux minutes et connaitre le profil du cout.
Exercice 2 : Generation en différents ratios d’aspect
SD 3.5 supporte différentes resolutions. Le ratio d’aspect modifie la composition de l’image : un format paysage (16:9) convient aux panoramas, un format portrait (9:16) aux personnages, et le carre (1:1) aux sujets centres.
Objectif : Generer la même scene en 3 ratios d’aspect différents (1:1, 16:9, 9:16) et analyser comment la composition change.
Indices : - # Étape 1 : Définir un prompt contenant des éléments horizontaux et verticaux (ex: un personnage dans un paysage) - # Étape 2 : Calculer les dimensions : 1024x1024 (1:1), 1344x768 (16:9), 768x1344 (9:16) - # Étape 3 : Generer avec sd35.generate(width=..., height=...) en gardant le même seed - # Indice : Les dimensions doivent etre des multiples de 8 pour etre compatibles avec le VAE
# Exercice 2 : Generation en differents ratios d'aspect
# TODO etudiant : generer la meme scene en 3 ratios (1:1, 16:9, 9:16)

ratio_prompt = None  # TODO etudiant : definir un prompt avec elements horizontaux et verticaux
aspect_ratios = [("1:1", 1024, 1024), ("16:9", 1344, 768), ("9:16", 768, 1344)]

# TODO etudiant : boucler sur les ratios et generer
# for name, w, h in aspect_ratios:
#     if sd35:
#         images = sd35.generate(ratio_prompt, width=w, height=h, seed=42)

# TODO etudiant : afficher les 3 resultats avec leurs dimensions respectives
print("Exercice a completer")
Exercice a completer7. Styles Artistiques
Le même sujet peut etre interprete dans des styles visuels très différents selon le prompt. Cette section compare quatre styles (photorealiste, peinture a l’huile, anime, aquarelle) sur un sujet identique pour observer comment les mots-cles de style influencent la sortie du modèle.
# =============================================================================
# 7. STYLES ARTISTIQUES
# =============================================================================

if sd35:
    base_subject = "a ancient tree in a mystical forest"

    styles = {
        "Photorealistic": f"{base_subject}, photorealistic, natural lighting, 8k",
        "Oil Painting": f"{base_subject}, oil painting, impressionist, brushstrokes",
        "Anime": f"{base_subject}, anime style, Studio Ghibli, vibrant colors",
        "Watercolor": f"{base_subject}, watercolor painting, soft edges, pastel",
    }

    print("\n🎨 Styles Artistiques")
    style_results = []

    for style_name, prompt in styles.items():
        print(f"--- {style_name} ---")
        images = sd35.generate(prompt, width=768, height=768, seed=5555)
        if images:
            style_results.append((style_name, images[0]))

    if style_results:
        fig, axes = plt.subplots(2, 2, figsize=(12, 12))
        axes = axes.flatten()
        for i, (style, img) in enumerate(style_results):
            axes[i].imshow(img)
            axes[i].set_title(style, fontsize=12)
            axes[i].axis('off')
        plt.suptitle("Comparaison des Styles", fontsize=14)
        plt.tight_layout()
        plt.show()
else:
    print("⚠️ SD35 non initialisé")
🎨 Styles Artistiques
--- Photorealistic ---

Generation (seed: 5555, steps: 4)...
Genere en 129.5s
--- Oil Painting ---
Generation (seed: 5555, steps: 4)... Genere en 127.3s
--- Anime ---
Generation (seed: 5555, steps: 4)... Genere en 130.0s
--- Watercolor ---
Generation (seed: 5555, steps: 4)... Genere en 132.5s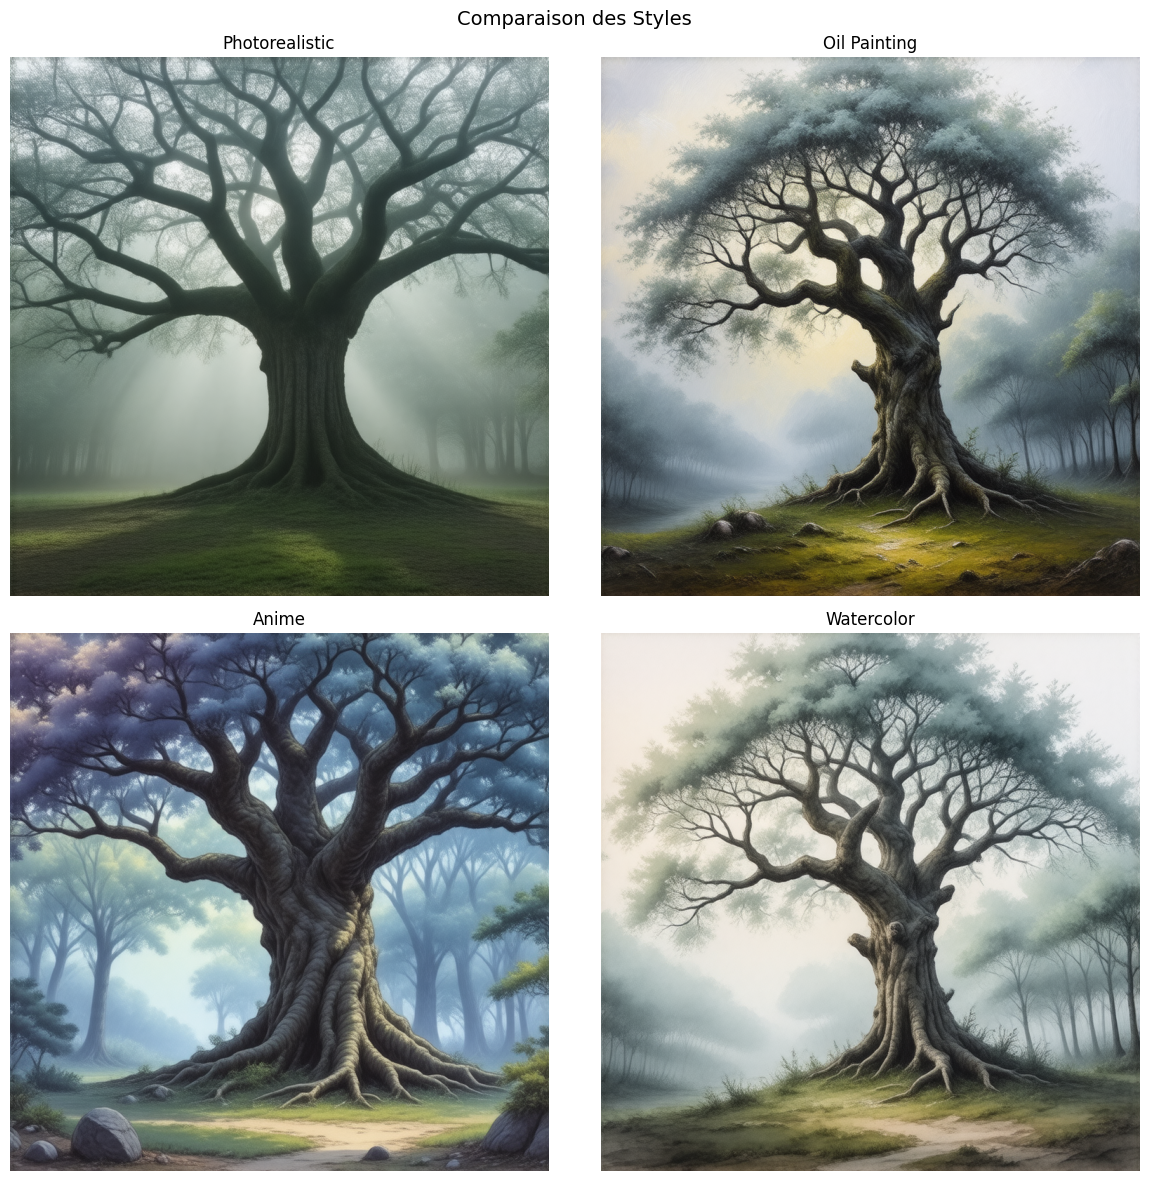
Lecture chiffree — quatre styles, une seule graine. Le meme sujet a ancient tree in a mystical forest est decline en quatre prompts (Photorealistic, Oil Painting, Anime, Watercolor), tous generes par Generation (seed: 5555, steps: 4) en 768x768. Fixer le seed isole la variable : le bruit initial du latent est identique dans les quatre images, seule la direction du prompt change — l’ecart visuel entre les rendus est attribuable au style, pas a la chance. Le notebook applique cette discipline section par section : seed=42 pour le phenix, 7777 pour l’analyse steps, 5555 pour les styles, 12345 pour la grille CFG — chaque comparaison intra-section est controlee, et les comparaisons inter-sections sont sagement non faites (les sujets et resolutions different). Dernier detail de trace : la sortie imprime le nom du style AVANT sa barre de generation (--- Photorealistic --- puis la progression), le log se lit donc comme un cahier d’experience ou chaque essai est identifie par sa graine.
Exercice 3 : Impact des negative prompts sur la qualite
Le negative_prompt guide le modèle en specifier ce qu’il doit eviter. Un bon negative prompt peut ameliorer significativement la qualite en eliminant les artefacts courants (flou, distorsions, basse qualite).
Objectif : Generer 3 images avec le même prompt positif mais des negative prompts différents, puis comparer la qualite resultante.
Indices : - # Étape 1 : Choisir un prompt detaille (ex: portrait ou paysage complexe) - # Étape 2 : Définir 3 negative prompts de complexite croissante : (a) chaîne vide, (b) “blurry, low quality”, (c) “blurry, low quality, distorted, deformed, ugly, watermark” - # Étape 3 : Generer avec sd35.generate() en fixant le même seed pour chaque variation - # Indice : Observez comment le negative prompt elimine progressivement les artefacts indesirables
# Exercice 3 : Impact des negative prompts sur la qualite
# TODO etudiant : comparer 3 niveaux de negative prompts

neg_prompt_subject = None  # TODO etudiant : definir un prompt detaille
negative_prompts = None  # TODO etudiant : definir une liste de 3 negative prompts

# TODO etudiant : boucler et generer avec sd35.generate(negative_prompt=...)
# for i, neg in enumerate(negative_prompts):
#     if sd35:
#         images = sd35.generate(neg_prompt_subject, negative_prompt=neg, seed=42)

# TODO etudiant : afficher les 3 resultats cote a cote
print("Exercice a completer")
Exercice a completer8. Recapitulatif des Exercices
Les exercices pratiques sont repartis dans le notebook aux endroits stratégiques :
| Exercice | Section | Concept | Placement |
|---|---|---|---|
| Exercice 1 | Section 4 (après generation de base) | Portrait artistique avec différentes valeurs CFG | Après demo phenix |
| Exercice 2 | Section 6 (après inference steps) | Generation en différents ratios d’aspect | Après analyse steps |
| Exercice 3 | Section 7 (après styles artistiques) | Impact des negative prompts | Après comparaison styles |
Chaque exercice est precede d’un bloc markdown avec les objectifs et indices, suivi d’une cellule de code a completer.
# =============================================================================
# Les exercices sont maintenant disponibles directement dans le notebook
# aux sections 4, 6 et 7. Cherchez les cellules "### Exercice N" pour
# les trouver et les completer.
# =============================================================================

print("3 exercices disponibles dans les sections 4, 6 et 7 du notebook")
3 exercices disponibles dans les sections 4, 6 et 7 du notebook9. Nettoyage Memoire
Les modèles de diffusion comme SD 3.5 occupent plusieurs gigaoctets de VRAM. La cellule suivante libere le pipeline et la memoire GPU pour permettre l’exécution d’autres notebooks sans redemarrer le kernel. Le pattern del pipeline; torch.cuda.empty_cache() est la méthode standard pour liberer la memoire en PyTorch.
# =============================================================================
# 9. NETTOYAGE
# =============================================================================

if sd35:
    print("🧹 Libération mémoire...")
    if torch.cuda.is_available():
        vram_before = torch.cuda.memory_allocated() / 1e9
    sd35.unload()
    if torch.cuda.is_available():
        vram_after = torch.cuda.memory_allocated() / 1e9
        print(f"   Libéré: {vram_before - vram_after:.1f} GB")
🧹 Libération mémoire...
Memoire liberee
Libéré: 0.0 GBLecture chiffree — 0.0 GB liberes, et pourquoi ce n’est pas un bug. Memoire liberee, Libéré: 0.0 GB. La cellule mesure torch.cuda.memory_allocated() avant et apres unload(), et affiche un delta nul — apres une session qui a produit 9 images avec un transformer 8B. La lecture tient dans la strategie de la section 3 : le client est construit autour de l’offload CPU et de l’attention slicing (RAM libre 25.5 GB : T5-XXL desactive montrait deja que les placements se decident en RAM systeme) ; avec l’offload, les poids resident hors GPU et n’y transitent que couche par couche au moment du calcul — memory_allocated() ne voit donc que le residuel (buffers, tenseurs temporaires), pas l’empreinte du modele. La liberation a bien eu lieu, mais sa preuve se lit en RAM, pas en VRAM allouee. Le pattern reste le bon — liberer avant de passer a un autre notebook lourd — a condition de savoir quelle metrique on interroge : c’est le meme reflexe de lecture que pour la barre tqdm de la section precedente.
10. Récapitulatif
Paramètres SD 3.5
| Paramètre | Standard | Turbo |
|---|---|---|
steps |
28-50 | 4 |
guidance_scale |
4.0-7.5 | 0.0 |
width/height |
1024 | 1024 |
Points Clés
- MMDiT [Esser et al. 2024] pour meilleure cohérence
- Triple encodeur (CLIP-L, CLIP-G, T5) — CLIP [Radford et al. 2021], T5 [Raffel et al. 2020]
- Turbo pour génération rapide
- Toujours libérer la mémoire après usage
Références savantes
- Esser, P., Kulal, S., Blattmann, A., et al. (2024). Scaling Rectified Flow Transformers for High-Resolution Image Synthesis. arXiv:2403.03206. — Article fondateur de l’architecture MMDiT et de l’entraînement par rectified flow qui définissent Stable Diffusion 3 / 3.5.
- Lipman, Y., Chen, R. T. Q., Ben-Hamu, H., Nickel, M., & Le, M. (2023). Flow Matching for Generative Modeling. ICLR 2023, arXiv:2210.02747. — Formulation théorique du Flow Matching dont le rectified flow est un cas particulier.
- Radford, A., Kim, J. W., Hallacy, C., et al. (2021). Learning Transferable Visual Models From Natural Language Supervision (CLIP). arXiv:2103.00020. — Encodeurs de texte/image CLIP-L et CLIP-G utilisés par SD 3.5.
- Raffel, C., Shazeer, N., Roberts, A., et al. (2020). Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer (T5). JMLR, arXiv:1910.10683. — T5-XXL, troisième encodeur de texte de SD 3.5 pour la compréhension fine des prompts.
# =============================================================================
# FIN DU NOTEBOOK
# =============================================================================

print("\n" + "="*60)
print("   ✅ Notebook Stable Diffusion 3.5 Complété")
print("="*60)
print(f"\n📅 Terminé: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print("\n📚 Concepts couverts:")
print("   • Architecture MMDiT")
print("   • Variantes (Large, Turbo, Medium)")
print("   • CFG et Inference Steps")
print("   • Styles artistiques")
print("\n🖼️ Images générées dans cette session:", sd35.generated_count if sd35 else 0)
if sd35 and sd35.generated_count == 0:
    print("⚠️ Mode dégradé : aucune image générée — voir l'erreur de chargement section 4")
print("\n➡️  Prochain module: 03-Images-Orchestration/")
============================================================
   ✅ Notebook Stable Diffusion 3.5 Complété
============================================================

📅 Terminé: 2026-08-15 15:25:22

📚 Concepts couverts:
   • Architecture MMDiT
   • Variantes (Large, Turbo, Medium)
   • CFG et Inference Steps
   • Styles artistiques

🖼️ Images générées dans cette session: 9

➡️  Prochain module: 03-Images-Orchestration/
Lecture chiffree — le compteur final comme registre d’audit. Images générées dans cette session: 9, Terminé: 2026-08-15 15:25:22. Le 9 se reconcilie exactement avec les sections executees : 1 image phenix (section 4) + 4 images steps 1 / 2 / 4 / 8 (section 6) + 4 images styles (section 7) = 9 ; la section CFG n’a rien ajoute (Mode Turbo: CFG fixé à 0) — si elle avait genere, le compteur afficherait 13. C’est un compteur honnete : incremente a chaque generation reelle, il permet l’audit croise a posteriori — la valeur finale dit QUELLES sections ont produit sans rouvrir une seule image. La garde symetrique existe : la meme cellule imprime aucune image générée avec renvoi a l’erreur de chargement de la section 4 si le compte est nul, l’echec est signale plutot que laisse en page blanche. Et le fil forensique ouvert en tete de notebook se referme ici : cette date de fin (08-15) est anterieure a la banniere d’ouverture (08-18) — les outputs composites se lisent, eux aussi, comme une donnee.
Conclusion
Stable Diffusion 3.5 marque la convergence de Stability AI vers l’architecture MMDiT (Multimodal Diffusion Transformer) avec entraînement par Flow Matching. Trois encodeurs de texte (CLIP-L, CLIP-G, T5-XXL) alimentent un débruiteur transformer où l’attention est jointe entre tokens texte et patches image — un changement structurel majeur par rapport aux UNet des générations précédentes (SD 1.5, SD 2.x).
Trois variantes à profiler par leur VRAM requise : Medium (2.5B, 8 GB, équilibre), Large (8B, 16 GB+, qualité maximale), Large Turbo (8B, 4 steps, rapide). Le notebook recommande dynamiquement la variante selon la VRAM détectée — un pattern à reproduire pour tout notebook qui charge un modèle lourd.
Leçon sur les modèles gated : la cellule de chargement échoue proprement avec GatedRepoError quand le token HuggingFace n’est pas autorisé pour le repo. C’est un comportement souhaité — mieux vaut échouer explicitement que de charger un modèle dégradé. Le pattern try/except retourne un client en load_failed=True qui permet au notebook de continuer en mode démonstration sans crasher.
Configuration optimale : num_inference_steps=28 et guidance_scale=4.5 pour Large standard, num_inference_steps=4 et guidance_scale=0.0 pour Large Turbo. Le negative_prompt fait gagner en qualité perceptible dès qu’on pousse au-delà du turbomode — un coût d’inférence à arbitrer.
Pour aller plus loin : comparer SD 3.5 Large et FLUX.1-dev sur le même prompt créatif — les deux utilisent MMDiT mais divergent sur l’entraînement (rectified flow vs flow matching) et les encodeurs (triple vs double). Les notebooks 04-Applications exploitent les deux pour des cas d’usage pédagogiques concrets.