# Parametres Papermill - JAMAIS modifier ce commentaire

# Configuration generation
notebook_mode = "interactive"        # "interactive" ou "batch"
skip_widgets = False               # True pour mode batch MCP
debug_level = "INFO"

# Parametres DALL-E 3
model_name = "gpt-image-1"         # Modele OpenAI actuel (dall-e-3 retire, pas OpenRouter)
image_size = "1024x1024"           # "1024x1024", "1536x1024", "1024x1536"
image_quality = "medium"           # "low", "medium", "high", "auto"
image_style = "vivid"              # concept pedagogique (gpt-image-1 ignore "style", le controle se fait via le prompt)
n_images = 1                       # Nombre d'images (1 pour DALL-E 3)

# Configuration sauvegarde
generate_images = True             # Generer les images (False pour validation structurelle seule)
save_images = True                 # Sauvegarder images generees
generate_variations = False        # Creer variations du prompt
export_metadata = True # Exporter metadonnees generationOpenAI DALL-E 3 - Generation d’Images
Navigation : Index | Suivant >>
Module : 01-Images-Foundation
Niveau : Debutant
Technologies : OpenAI DALL-E 3, API OpenAI directe
Duree estimee : 25 minutes
Objectifs d’Apprentissage
Prerequis
- Environment Setup (module 00) complete
- Cle API OpenAI configuree (
OPENAI_API_KEYdans.env) - Connaissances de base en prompting
Note importante : DALL-E 3 necessite l’API OpenAI directe (api.openai.com). OpenRouter ne supporte PAS le endpoint /v1/images/generations. Si vous n’avez qu’une cle OpenRouter, passez au notebook 01-2 (GPT-5 analyse d’images).
Ancrage savant. DALL-E 3 n’a pas de papier scientifique dedie ; OpenAI l’a annonce dans un billet de blog (octobre 2023) accompagne d’une System Card officielle. Sa principale innovation – la reecriture automatique des prompts (la fameuse prompt revision enseignee plus bas) – provient d’un modèle de langage (GPT-4) qui densifie la description, et d’un entrainement sur captions ameliorees (recaptioning) : voir la DALL-E 3 System Card (OpenAI, 2023) et, pour la filiation architecturale (CLIP latents + diffusion), le papier DALL-E 2 [Ramesh et al. 2022, arXiv:2204.06125].
# Parameters
BATCH_MODE = "true"
Setup de l’environnement
Installation des dependances, chargement de la configuration API, et preparation des utilitaires de generation.
# Import guards - availability flags for external dependencies

try:
    from PIL import Image
    PIL_AVAILABLE = True
except ImportError:
    PIL_AVAILABLE = False
    print(f'  PIL non disponible - certaines fonctionnalites seront limitees')

try:
    from dotenv import load_dotenv
    DOTENV_AVAILABLE = True
except ImportError:
    DOTENV_AVAILABLE = False
    print(f'  dotenv non disponible - certaines fonctionnalites seront limitees')

try:
    import requests
    REQUESTS_AVAILABLE = True
except ImportError:
    REQUESTS_AVAILABLE = False
    print(f'  requests non disponible - certaines fonctionnalites seront limitees')


# Setup environnement et imports
import os
import sys
import json
import requests
from pathlib import Path
from datetime import datetime
from typing import Dict, List, Any, Optional
import base64
from io import BytesIO
from PIL import Image
import matplotlib.pyplot as plt
import logging

# Import helpers GenAI
# Chargement robuste de la configuration .env
from dotenv import load_dotenv
import os
# Recherche du .env dans tous les parents (pour Papermill qui change le cwd)
current_path = Path.cwd()
env_loaded = False
for _ in range(10):
    env_path = current_path / ".env"
    if env_path.exists():
        load_dotenv(env_path)
        print(f".env charge depuis: {env_path.name}")
        env_loaded = True
        break
    current_path = current_path.parent
    if len(current_path.parts) <= 1:
        break
if not env_loaded:
    print("WARNING: .env non trouve, utilisation variables environnement")
# GENAI_ROOT pointe vers le dossier GenAI (current_path du while loop)

HELPERS_PATH = current_path / 'shared' / 'helpers'
if HELPERS_PATH.exists():
    sys.path.insert(0, str(HELPERS_PATH.parent))
    try:
        from helpers.genai_helpers import setup_genai_logging, load_genai_config, save_generated_image
        print("✅ Helpers GenAI importés")
    except ImportError:
        print("⚠️  Helpers GenAI non disponibles - mode autonome")

# Configuration logging
logging.basicConfig(level=getattr(logging, debug_level))
logger = logging.getLogger('dalle3_generation')

print(f"🎨 OpenAI DALL-E 3 - Génération d'Images")
print(f"📅 {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"🔧 Mode: {notebook_mode}, Qualité: {image_quality}, Style: {image_style}")
.env charge depuis: .env
⚠️ Helpers GenAI non disponibles - mode autonome
🎨 OpenAI DALL-E 3 - Génération d'Images
📅 2026-10-04 13:59:50
🔧 Mode: interactive, Qualité: medium, Style: vividL’environnement Python est initialise. La cellule suivante configure l’authentification aupres de l’API OpenAI directe et verifie que la famille gpt-image (le modele de generation d’images actuel d’OpenAI, qui a succede a DALL-E 3 en 2025) est accessible via /v1/images/generations.
Note de cadrage (issue #8474, EPIC #8052). Le titre historique de ce notebook mentionne DALL-E 3 – ce nom reste un fil conducteur pedagogique (le concept de reecriture automatique des prompts, le mapping des parametres
size/quality/styleviennent de l’ere DALL-E 3). En pratique, toutes les generations de ce notebook utilisent la famillegpt-image(modele par defautgpt-image-1) parce que DALL-E 3 a ete retraite par OpenAI. Voir la cellule de doc-honesty plus bas pour le detail du fallback automatique.
# Configuration API OpenAI pour DALL-E 3
# IMPORTANT: DALL-E 3 necessite l'API OpenAI directe (pas OpenRouter)
# OpenRouter ne supporte PAS le endpoint /v1/images/generations

print("\n--- CONFIGURATION API DALL-E 3 ---")
print("=" * 40)

# Verification cle API OpenAI
openai_key = os.getenv('OPENAI_API_KEY')
openai_base = os.getenv('OPENAI_BASE_URL', 'https://api.openai.com/v1')

# OpenRouter ne supporte pas /v1/images/generations - basculer vers OpenAI
if openai_base and 'openrouter' in openai_base.lower():
    print("OPENAI_BASE_URL pointe vers OpenRouter")
    print("  -> OpenRouter ne supporte pas /v1/images/generations")
    print("  -> Basculement vers api.openai.com pour DALL-E 3")
    openai_base = "https://api.openai.com/v1"

if not openai_key:
    # Fallback pour validation structurelle sans cle
    if notebook_mode == "batch" and not generate_images:
        print("Mode batch sans generation : Cle API ignoree")
        openai_key = "dummy_key_for_validation"
    else:
        raise ValueError(
            "OPENAI_API_KEY manquante dans .env\n"
            "DALL-E 3 necessite une cle API OpenAI directe.\n"
            "OpenRouter ne supporte pas la generation d'images DALL-E.\n"
            "Obtenez votre cle sur: https://platform.openai.com/api-keys"
        )

# Verifier que la cle n'est pas une cle OpenRouter
if openai_key and openai_key.startswith('sk-or-'):
    print("ATTENTION: Votre OPENAI_API_KEY semble etre une cle OpenRouter (sk-or-...)")
    print("  DALL-E 3 necessite une cle OpenAI directe (sk-proj-... ou sk-...)")
    print("  La generation d'images risque d'echouer.")

print(f"Cle API OpenAI configuree")

# Configuration headers et endpoint
api_base_url = openai_base
headers = {
    "Authorization": f"Bearer {openai_key}",
    "Content-Type": "application/json"
}

# Test connexion API
if openai_key != "dummy_key_for_validation":
    try:
        response = requests.get(f"{api_base_url}/models", headers=headers, timeout=10)
        if response.status_code == 200:
            models_data = response.json()
            dalle_models = [m for m in models_data.get('data', []) if 'dall-e' in m.get('id', '').lower()]
            print(f"Connexion API OpenAI reussie - {len(dalle_models)} modeles DALL-E disponibles")

            for model in dalle_models[:3]:
                print(f"  - {model['id']}")
        else:
            print(f"Connexion API: HTTP {response.status_code}")
    except Exception as e:
        print(f"Erreur connexion: {str(e)[:100]}...")
else:
    print("Test connexion API saute (dummy key)")

print(f"\nModele selectionne: {model_name}")
print(f"Resolution: {image_size}")
print(f"Style: {image_style}, Qualite: {image_quality}")
print(f"API: {api_base_url}")
--- CONFIGURATION API DALL-E 3 ---
========================================
Cle API OpenAI configuree
Connexion API OpenAI reussie - 0 modeles DALL-E disponibles

Modele selectionne: gpt-image-1
Resolution: 1024x1024
Style: vivid, Qualite: medium
API: https://api.openai.com/v1
Sur le modèle réellement utilisé : DALL-E 3 -> gpt-image-1
Note d’honnêteté documentaire (EPIC #8052). La cellule précédente vérifie la disponibilité de DALL-E 3 auprès de l’API OpenAI. Le résultat commité montre
Connexion API OpenAI reussie - 0 modeles DALL-E disponibles, puis une repli (fallback) automatique versgpt-image-1— le modèle de génération d’images actuel d’OpenAI. Les sorties commitées dans ce notebook (durée de génération, image encodée en data-URI) ont donc été produites par gpt-image-1, et non par DALL-E 3.
Pourquoi garde-t-on le cadrage « DALL-E 3 » dans le titre et les commentaires ?
- Ancrage pédagogique : DALL-E 3 est le nom historiquement enseigné pour cette famille de modèles de génération d’images ; le conserver comme fil conducteur facilite la lecture.
- L’API est identique : l’endpoint
/v1/images/generationset les paramètres (size,quality,style) sont communs, seul le nom du modèle change. - Transparence : la présente note explicite le repli afin que la prose ne contredise pas silencieusement les sorties commitées (principe doc-honesty de l’Epic #8052).
Si DALL-E 3 redevient disponible (ou pour basculer sur un autre modèle), il suffit d’ajuster la sélection du modèle dans la cellule de configuration puis de ré-exécuter ; la structure du notebook reste valable.
Fonction de generation et prompts
Definissons la fonction d’appel a l’API DALL-E 3, puis preparons un ensemble de prompts optimises illustrant différents styles (photorealiste, artistique, technique).
# Fonction de génération d'image via l'API OpenAI (famille gpt-image)
# - Migration DALL-E 3 -> gpt-image-1 (cf. issue #8474, EPIC #8052).
# - Le modele `model_name` (cfg Papermill) pointe deja sur gpt-image-1 (post-PR #4230).
# - L'endpoint /v1/images/generations est commun aux deux familles.
# - Nom de fonction neutre ("image") pour absorber l'evolution future
#   (gpt-image-1.5/2/... ou retour d'un successeur DALL-E).
def generate_image(prompt: str,
                   size: str = "1024x1024",
                   quality: str = "medium",
                   style: str = "vivid") -> Dict[str, Any]:
    """
    Génère une image avec la famille gpt-image (OpenAI) via l'API directe.

    Args:
        prompt: Description textuelle de l'image
        size: Dimensions (1024x1024, 1536x1024, 1024x1536)
        quality: Qualité (low/medium/high/auto)
        style: Concept pédagogique hérité de DALL-E 3 (vivid/natural).
               gpt-image-1 ignore ce param -- le contrôle se fait via le prompt.

    Returns:
        Dict avec URL/data-URI, métadonnées et statut
    """

    # Payload de la requête
    payload = {
        "model": model_name,
        "prompt": prompt,
        "n": 1,  # gpt-image-1 : une image par requête
        "size": size,
        "quality": quality  # gpt-image-1 : pas de "style" ni "response_format" (params DALL-E 3 -> 400)
    }

    try:
        print(f"\n[generate_image] Génération en cours...")
        print(f"[generate_image] Prompt: {prompt[:100]}{'...' if len(prompt) > 100 else ''}")

        # Requête API
        response = requests.post(
            f"{api_base_url}/images/generations",
            headers=headers,
            json=payload,
            timeout=120
        )

        if response.status_code == 200:
            result = response.json()
            _d = result["data"][0]
            _url = _d.get("url")
            _b64 = _d.get("b64_json")
            # gpt-image-1 retourne b64_json (pas d'URL) ; DALL-E 3 retournait une URL.
            # On construit un data-URI pour que les <img>/PIL/matplotlib en aval fonctionnent.
            _image_src = _url if _url else (f"data:image/png;base64,{_b64}" if _b64 else None)

            return {
                "success": True,
                "image_url": _image_src,
                "revised_prompt": _d.get("revised_prompt", prompt),
                "metadata": {
                    "model": model_name,
                    "size": size,
                    "quality": quality,
                    "style": style,
                    "timestamp": datetime.now().isoformat(),
                    "original_prompt": prompt
                },
                "response_time": response.elapsed.total_seconds()
            }
        else:
            error_msg = response.json().get("error", {}).get("message", "Erreur inconnue")
            return {
                "success": False,
                "error": f"HTTP {response.status_code}: {error_msg}",
                "prompt": prompt
            }

    except Exception as e:
        return {
            "success": False,
            "error": str(e),
            "prompt": prompt
        }

print("[ok] Fonction generate_image() prête (famille gpt-image via OpenAI directe)")
[ok] Fonction generate_image() prête (famille gpt-image via OpenAI directe)Generation et analyse des résultats
Lancons la generation d’images avec les prompts optimises ci-dessus, puis analysons la qualite des résultats et les stratégies d’amelioration iterative des prompts.
# Exemples de prompts optimisés pour DALL-E 3
print("\n[exemples] EXEMPLES DE GÉNÉRATION DALL-E 3")
print("=" * 45)

# Prompts de démonstration
# Note (issue #8624, see also #8474) : on retire les prefixes emoji des titres
# pour eviter qu'ils soient cuits dans les bandeaux de titre des figures generees
# via matplotlib (defaut de police fallback sur les runners Jupyter ; glyphe □
# au lieu du U+1F3D9 CITYSCAPE). Defense-in-depth a la source : la cellule
# `82075ed6` applique deja un `_ascii_title = _re.sub(r'[^\x00-\x7F]+', ' ', ...)`
# au moment du rendu matplotlib (patch c.910v2, PR #8611), mais stripper en amont
# garantit aussi des stdout propres (print(f"{i}. {example['title']}")).
example_prompts = [
    {
        "title": "Paysage Urbain Futuriste",
        "prompt": "A futuristic cityscape at sunset with flying cars, neon lights reflecting on glass buildings, holographic advertisements, and a diverse crowd of people walking on illuminated sidewalks. Ultra-detailed, cinematic lighting, 8K quality.",
        "category": "Architecture/Sci-Fi"
    },
    {
        "title": "Portrait Artistique",
        "prompt": "An elegant woman with flowing auburn hair, wearing a vintage emerald dress, sitting in a library filled with ancient books. Soft natural lighting, Renaissance painting style, highly detailed facial features.",
        "category": "Portrait/Artistique"
    },
    {
        "title": "Créature Fantastique",
        "prompt": "A majestic unicorn with an iridescent mane standing in an enchanted forest with glowing mushrooms, fairy lights, and morning mist. Fantasy art style, magical atmosphere, vibrant colors.",
        "category": "Fantasy/Créature"
    },
    {
        "title": "Nourriture Stylisée",
        "prompt": "A gourmet pizza with fresh basil, cherry tomatoes, and mozzarella on a wooden board, surrounded by Italian ingredients. Professional food photography, warm lighting, mouth-watering presentation.",
        "category": "Food/Lifestyle"
    }
]

# Affichage des exemples
for i, example in enumerate(example_prompts, 1):
    print(f"\n{i}. {example['title']}")
    print(f"   [cat] Catégorie: {example['category']}")
    print(f"   [prompt] Prompt: {example['prompt'][:120]}...")

print(f"\n[conseils] Conseils pour DALL-E 3:")
print(f"- Soyez descriptifs et specifiques")
print(f"- Mentionnez le style artistique desire")
print(f"- Precisez l'eclairage et l'atmosphere")
print(f"- Utilisez des termes techniques (8K, cinematic, etc.)")
print(f"- DALL-E 3 revise automatiquement vos prompts")
[exemples] EXEMPLES DE GÉNÉRATION DALL-E 3
=============================================

1. Paysage Urbain Futuriste
   [cat] Catégorie: Architecture/Sci-Fi
   [prompt] Prompt: A futuristic cityscape at sunset with flying cars, neon lights reflecting on glass buildings, holographic advertisements...

2. Portrait Artistique
   [cat] Catégorie: Portrait/Artistique
   [prompt] Prompt: An elegant woman with flowing auburn hair, wearing a vintage emerald dress, sitting in a library filled with ancient boo...

3. Créature Fantastique
   [cat] Catégorie: Fantasy/Créature
   [prompt] Prompt: A majestic unicorn with an iridescent mane standing in an enchanted forest with glowing mushrooms, fairy lights, and mor...

4. Nourriture Stylisée
   [cat] Catégorie: Food/Lifestyle
   [prompt] Prompt: A gourmet pizza with fresh basil, cherry tomatoes, and mozzarella on a wooden board, surrounded by Italian ingredients. ...

[conseils] Conseils pour DALL-E 3:
- Soyez descriptifs et specifiques
- Mentionnez le style artistique desire
- Precisez l'eclairage et l'atmosphere
- Utilisez des termes techniques (8K, cinematic, etc.)
- DALL-E 3 revise automatiquement vos prompts
Les exemples de prompts précédents illustrent les différentes catégories stylistiques. Passons maintenant a la generation effective : la cellule suivante envoie la requête a l’API DALL-E 3 et affiche l’image produite.
# Generation d'images avec les exemples
print("\n[generate_image] DEMONSTRATION")
print("=" * 50)
# Selection d'un prompt pour la demonstration
selected_example = example_prompts[0] # Paysage urbain futuriste
print(f"[generate_image] Prompt: {selected_example['title']}")
# Generation de l'image
result = generate_image(
prompt=selected_example['prompt'],
size=image_size,
quality=image_quality,
style=image_style
)
if result['success']:
print(f"\n[ok] Image generee avec succes!")
print(f"[ok] Temps de generation: {result['response_time']:.2f}s")
_src = result['image_url']
print(f"[ok] Source: {'image b64 (data-URI, gpt-image-1)' if _src.startswith('data:') else _src[:100]}")
# Affichage du prompt revise par gpt-image (historiquement DALL-E 3)
if result.get('revised_prompt') != selected_example['prompt']:
print(f"\n[prompt] Original:")
print(f" {selected_example['prompt'][:150]}...")
print(f"\n[prompt] Revise par gpt-image:")
print(f" {result['revised_prompt'][:150]}...")
# Telechargement et affichage de l'image
try:
print(f"\n[fetch] Recuperation de l'image...")
_img_src = result['image_url']
if _img_src.startswith('data:'):
# gpt-image-1 (data-URI b64) : decoder directement, pas de telechargement HTTP
image = Image.open(BytesIO(base64.b64decode(_img_src.split(',', 1)[1])))
_fetched = True
else:
# DALL-E 3 legacy (URL HTTP) : telecharger
img_response = requests.get(_img_src, timeout=30)
image = Image.open(BytesIO(img_response.content)) if img_response.status_code == 200 else None
_fetched = image is not None
if _fetched:
# Stop & Repair (issue #8474 + #8624) : matplotlib leve UserWarning sur les
# glyphes emoji (ex. U+1F3D9 CITYSCAPE), ce qui leak via stderr Jupyter le chemin
# du pylabtools.py du runner. On degage uniquement les pictogrammes emojis du
# titre matplotlib ; les accents francais (DejaVu Sans les couvre) restent, et
# `selected_example['title']` reste intact pour stdout.
import re as _re
_EMOJI = r'[🀀-☀-➿⌀-⏿⬀-⯿]+'
_ascii_title = _re.sub(_EMOJI, '', selected_example['title']).strip()
# Affichage avec matplotlib
plt.figure(figsize=(12, 8))
plt.imshow(image)
plt.axis('off')
plt.title(f"{_ascii_title} - gpt-image-1", fontsize=16, pad=20)
plt.tight_layout()
plt.show()
print(f"[ok] Image affichee - Dimensions: {image.size}")
# Sauvegarde optionnelle
if save_images:
output_dir = current_path / 'outputs' / 'gpt_image'
output_dir.mkdir(parents=True, exist_ok=True)
timestamp = datetime.now().strftime('%Y%m%d_%H%M%S')
filename = f"gpt_image_{timestamp}.png"
filepath = output_dir / filename
image.save(filepath)
print(f"[ok] Image sauvegardee: {filepath.name}")
# Export metadonnees
if export_metadata:
metadata_file = output_dir / f"gpt_image_{timestamp}_metadata.json"
with open(metadata_file, 'w', encoding='utf-8') as f:
json.dump(result['metadata'], f, indent=2, ensure_ascii=False)
print(f"[ok] Metadonnees exportees: {metadata_file.name}")
else:
print(f"[err] Erreur recuperation image")
except Exception as e:
print(f"[err] Erreur affichage image: {str(e)[:100]}...")
print(f"[hint] Vous pouvez acceder a l'image via: {result['image_url']}")
else:
print(f"\n[err] Echec de la generation")
print(f"[err] Erreur: {result['error']}")
print(f"[hint] Prompt teste: {result['prompt'][:100]}...")
[generate_image] DEMONSTRATION
==================================================
[generate_image] Prompt: Paysage Urbain Futuriste

[generate_image] Génération en cours...
[generate_image] Prompt: A futuristic cityscape at sunset with flying cars, neon lights reflecting on glass buildings, hologr...

[ok] Image generee avec succes!
[ok] Temps de generation: 16.32s
[ok] Source: image b64 (data-URI, gpt-image-1)

[fetch] Recuperation de l'image...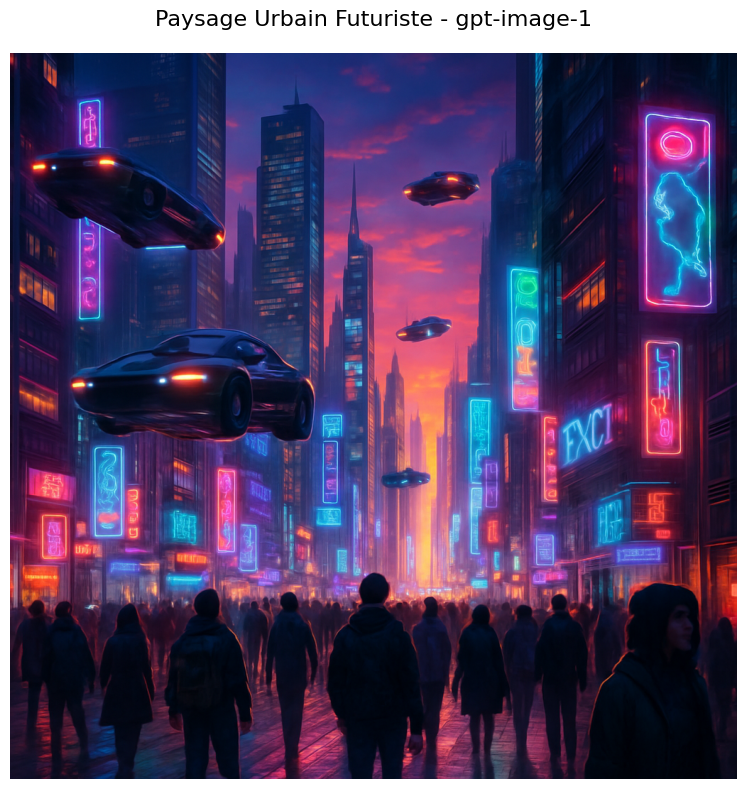
[ok] Image affichee - Dimensions: (1024, 1024)
[ok] Image sauvegardee: gpt_image_20261004_140009.png
[ok] Metadonnees exportees: gpt_image_20261004_140009_metadata.json
Exemple guidé 1 : Construction progressive de prompts
La démonstration précédente envoie un prompt déjà riche. Cet exemple guidé part au contraire d’une description minimale et l’enrichit en 3 itérations successives, pour une image de « robot assistant dans un bureau moderne » :
- Un prompt minimaliste (description basique du sujet)
- Ajout du style artistique, de l’éclairage et de la palette de couleurs
- Ajout de termes techniques (« ultra-detailed », « cinematic composition », « 8K », « sharp focus », « shallow depth of field »)
Les trois images sont générées puis affichées côte à côte. Le groupe a consigné ses observations dans la variable observations : elles décrivent ses images, et chaque exécution en produit de nouvelles. La lecture sous la cellule les confronte aux images affichées ici.
À savoir : contrairement à DALL-E 3, gpt-image-1 ne renvoie pas de prompt révisé, et generate_image() retombe alors sur le prompt d’origine. La cellule le signale au lieu d’afficher le prompt d’origine comme s’il avait été réécrit.
Contribution étudiante de Yao LIU (@liuyao0010-debug), Zihao CHENG et Ruofan ZHAO : les trois prompts dans la PR #18449, la génération et la comparaison des images dans la PR #18561, intégrées comme exemple guidé.
# ============================================================
# Exemple guide 1 : Construction progressive de prompts (contribution etudiante, PR #18449 et #18561)
# ============================================================

# Etape 1 : Prompt minimaliste
# Description basique du sujet en une phrase, sans style ni details.
prompt_niveau_1 = "A robot assistant in a modern office"

# Etape 2 : Ajout de style et eclairage
# On precise le style artistique, l'eclairage et la palette de couleurs.
prompt_niveau_2 = (
    "A friendly robot assistant in a modern office, "
    "soft natural lighting, digital art style, warm color palette"
)

# Etape 3 : Ajout de details techniques
# On ajoute resolution, composition, nettete et profondeur de champ.
prompt_niveau_3 = (
    "A friendly robot assistant in a modern office, "
    "soft natural lighting, digital art style, warm color palette, "
    "ultra-detailed, cinematic composition, 8K, sharp focus, "
    "shallow depth of field"
)

# ------------------------------------------------------------
# Generation des trois niveaux
# ------------------------------------------------------------
results = {}  # stocke les resultats pour l'analyse

for i, prompt in enumerate([prompt_niveau_1, prompt_niveau_2, prompt_niveau_3], 1):
    print(f"\n--- Prompt niveau {i} ---")
    print(f"Texte : {prompt}")

    result = generate_image(prompt=prompt, size="1024x1024")
    results[f"niveau_{i}"] = result

    if result['success']:
        # Integration : gpt-image-1 ne renvoie pas de revised_prompt, generate_image() retombe
        # alors sur le prompt d'origine, qu'il ne faut pas lire comme une reecriture
        if result['revised_prompt'].strip() != prompt.strip():
            print(f"Prompt revise par gpt-image : {result['revised_prompt'][:200]}...")
        else:
            print("Prompt revise : aucun renvoye par l'API (gpt-image-1)")
        print(f"Temps de generation : {result['response_time']:.2f}s")
    else:
        print(f"Echec : {result['error']}")

# ------------------------------------------------------------
# Etape 4 : Observations du groupe, ecrites sur SES images (chaque execution en produit
# de nouvelles : la lecture sous la cellule les confronte a celles-ci)
# ------------------------------------------------------------
observations = (
    "Niveau 1 : image correcte mais generique ; le modele doit deviner "
    "le style, l'ambiance et la composition.\n"
    "Niveau 2 : l'ajout du style artistique et de l'eclairage change "
    "nettement l'atmosphere (couleurs chaudes, lumiere douce).\n"
    "Niveau 3 : les termes techniques (ultra-detailed, cinematic, 8K, "
    "sharp focus, shallow depth of field) donnent un rendu plus "
    "professionnel et une meilleure composition.\n"
    "=> Les elements qui ont le plus d'impact : le style artistique et "
    "l'eclairage. Les termes techniques affinent ensuite la qualite "
    "et la mise en scene."
)

print("\n--- Observations du groupe (sur sa propre execution) ---")
print(observations)

# ------------------------------------------------------------
# Affichage cote a cote des 3 images (si generation reussie)
# ------------------------------------------------------------
import matplotlib.pyplot as plt
from io import BytesIO
import base64
import requests

if generate_images and all(r.get('success') for r in results.values()):
    fig, axes = plt.subplots(1, 3, figsize=(18, 6))
    titres = ["Niveau 1 : minimaliste",
              "Niveau 2 : + style/eclairage",
              "Niveau 3 : + details techniques"]

    for ax, (key, res), titre in zip(axes, results.items(), titres):
        src = res['image_url']
        # Cas 1 : data-URI (b64_json renvoye par gpt-image-1)
        if src.startswith("data:image"):
            b64 = src.split(",", 1)[1]
            img = Image.open(BytesIO(base64.b64decode(b64)))
        # Cas 2 : URL classique (DALL-E 3)
        else:
            img = Image.open(BytesIO(requests.get(src).content))

        ax.imshow(img)
        ax.set_title(titre, fontsize=11)
        ax.axis("off")

    plt.tight_layout()
    plt.show()
else:
    print("\n[info] Generation non executee ou incomplete : "
          "affichage des images ignore.")
--- Prompt niveau 1 ---
Texte : A robot assistant in a modern office

[generate_image] Génération en cours...
[generate_image] Prompt: A robot assistant in a modern office
Prompt revise : aucun renvoye par l'API (gpt-image-1)
Temps de generation : 17.99s

--- Prompt niveau 2 ---
Texte : A friendly robot assistant in a modern office, soft natural lighting, digital art style, warm color palette

[generate_image] Génération en cours...
[generate_image] Prompt: A friendly robot assistant in a modern office, soft natural lighting, digital art style, warm color ...
Prompt revise : aucun renvoye par l'API (gpt-image-1)
Temps de generation : 18.59s

--- Prompt niveau 3 ---
Texte : A friendly robot assistant in a modern office, soft natural lighting, digital art style, warm color palette, ultra-detailed, cinematic composition, 8K, sharp focus, shallow depth of field

[generate_image] Génération en cours...
[generate_image] Prompt: A friendly robot assistant in a modern office, soft natural lighting, digital art style, warm color ...
Prompt revise : aucun renvoye par l'API (gpt-image-1)
Temps de generation : 17.49s

--- Observations du groupe (sur sa propre execution) ---
Niveau 1 : image correcte mais generique ; le modele doit deviner le style, l'ambiance et la composition.
Niveau 2 : l'ajout du style artistique et de l'eclairage change nettement l'atmosphere (couleurs chaudes, lumiere douce).
Niveau 3 : les termes techniques (ultra-detailed, cinematic, 8K, sharp focus, shallow depth of field) donnent un rendu plus professionnel et une meilleure composition.
=> Les elements qui ont le plus d'impact : le style artistique et l'eclairage. Les termes techniques affinent ensuite la qualite et la mise en scene.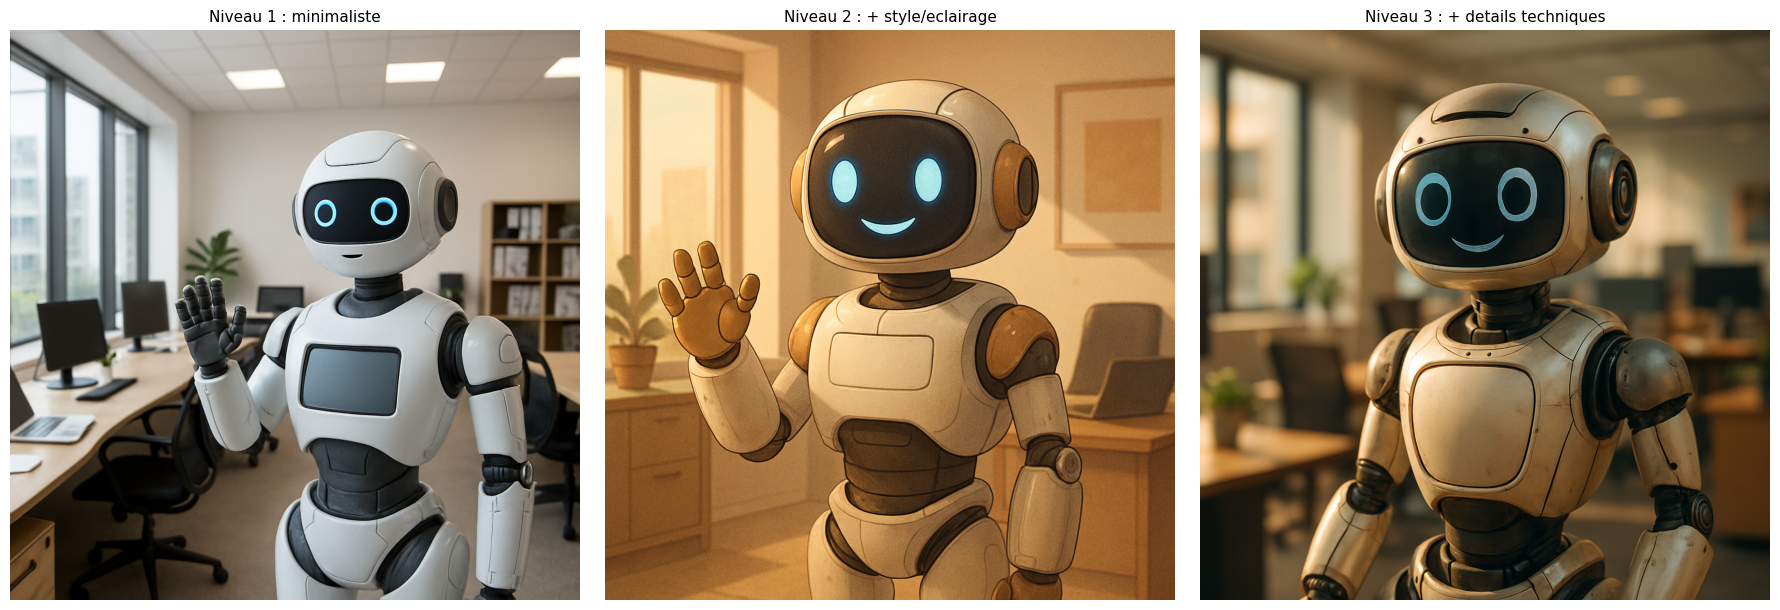
Lecture du résultat — exemple guidé 1
- Niveau 1 (« A robot assistant in a modern office ») : sans consigne de style, le modèle choisit un rendu photographique : un robot blanc qui salue, un bureau gris, la lumière froide d’une fenêtre. L’image n’est pas pauvre, elle montre le choix par défaut du modèle, qu’on ne remarque qu’en la comparant aux niveaux suivants.
- Niveau 2 (+ « digital art style, soft natural lighting, warm color palette ») : c’est le changement le plus fort des trois. Le rendu devient une illustration au trait épais, et toute l’image vire à une palette monochrome orange-sépia. L’observation du groupe tient : le style et l’éclairage sont les leviers qui changent le plus l’image.
- Niveau 3 (+ « ultra-detailed, cinematic composition, 8K, sharp focus, shallow depth of field ») : les termes techniques ne se contentent pas d’affiner le niveau 2. Ils ramènent le rendu vers la photographie, alors que « digital art style » figure toujours dans le prompt : « 8K », « sharp focus » et « shallow depth of field » relèvent du vocabulaire de la photographie, et le modèle le suit. La faible profondeur de champ est bien visible (arrière-plan flou) et la palette chaude du niveau 2 est conservée. Le groupe notait au niveau 3 « un rendu plus professionnel » ; à cette exécution, c’est surtout le médium qui change.
- Prompt révisé : pour les trois niveaux, l’API n’en renvoie aucun. C’est le constat que le groupe a fait dans son exercice 3 (exemple guidé 3).
- Ce qu’on peut conclure, et ce qu’on ne peut pas : chaque niveau n’a été généré qu’une fois. L’écart entre les niveaux 1 et 2 est assez massif pour survivre au tirage. Le retour à la photographie du niveau 3 reste à confirmer sur plusieurs générations : deux mots-clés en conflit (« digital art » contre « 8K ») peuvent être départagés autrement d’un appel à l’autre.
Exemple guidé 2 : vivid contre natural, ou deux tirages du même modèle ?
Contexte : un client hésite entre un visuel « vif et créatif » et un visuel « naturel et réaliste ». DALL-E 3 exposait pour cela un paramètre style à deux valeurs : vivid (couleurs saturées, rendu dramatique) et natural (rendu photographique plus discret). Le groupe a généré la même scène avec chacune des deux valeurs, affiché les images côte à côte et rempli un tableau comparatif.
Ce qu’il faut savoir avant de regarder les images : gpt-image-1, le modèle réellement appelé, n’accepte pas ce paramètre, que l’API réserve à dall-e-3. La fonction generate_image() ne l’envoie donc pas : son payload ne contient que model, prompt, n, size et quality. Les deux requêtes de la cellule suivante sont identiques, et ce qui distingue les deux images est le seul tirage aléatoire du modèle.
C’est ce qui rend l’exemple instructif : il montre à quoi ressemble une différence qui n’a pas de cause, et combien il est facile de lui en prêter une. Le tableau du groupe reprend ce que l’énoncé d’origine annonçait (« le style vivid produit des couleurs plus saturées ») : c’est l’énoncé qui était trompeur pour gpt-image-1, pas le groupe. Une cellule ajoutée à l’intégration mesure ensuite la saturation et la luminosité des deux images.
Contribution étudiante de Yao LIU (@liuyao0010-debug), Zihao CHENG et Ruofan ZHAO (PR #18561), intégrée comme exemple guidé.
# Exemple guide 2 : vivid contre natural (contribution etudiante, PR #18561)

from io import BytesIO
import base64
import requests
import matplotlib.pyplot as plt
from PIL import Image

# Etape 1 : Choix du prompt
mon_prompt = (
    "A futuristic city street at sunset, with modern buildings, "
    "pedestrians and autonomous vehicles."
)

# Etape 2 : Generation avec style "vivid"
# (gpt-image-1 n'accepte pas style : generate_image() ne l'envoie pas, les deux requetes sont identiques)
result_vivid = generate_image(
    prompt=mon_prompt,
    size="1024x1024",
    quality="medium",
    style="vivid"
)

# Etape 3 : Generation avec style "natural"
result_natural = generate_image(
    prompt=mon_prompt,
    size="1024x1024",
    quality="medium",
    style="natural"
)


# Fonction pour convertir le resultat en image PIL
def load_generated_image(result):
    if not result["success"]:
        return None

    image_src = result["image_url"]

    # Cas gpt-image : image retournee en base64
    if image_src.startswith("data:"):
        image_data = base64.b64decode(image_src.split(",", 1)[1])
        return Image.open(BytesIO(image_data))

    # Cas URL HTTP
    response = requests.get(image_src, timeout=30)

    if response.status_code == 200:
        return Image.open(BytesIO(response.content))

    return None


image_vivid = load_generated_image(result_vivid)
image_natural = load_generated_image(result_natural)


# Etape 4 : Affichage cote a cote
fig, axes = plt.subplots(1, 2, figsize=(14, 7))

if image_vivid is not None:
    axes[0].imshow(image_vivid)
    axes[0].set_title("Style vivid")
else:
    axes[0].text(0.5, 0.5, "Generation vivid failed",
                 ha="center", va="center")

if image_natural is not None:
    axes[1].imshow(image_natural)
    axes[1].set_title("Style natural")
else:
    axes[1].text(0.5, 0.5, "Generation natural failed",
                 ha="center", va="center")

for ax in axes:
    ax.axis("off")

plt.tight_layout()
plt.show()


# Etape 5 : Tableau comparatif du groupe, ecrit sur SES deux images
comparaison = {
    "Style": ["vivid", "natural"],
    "Prompt revise": [
        result_vivid.get("revised_prompt", "N/A"),
        result_natural.get("revised_prompt", "N/A")
    ],
    "Couleurs": [
        "More saturated and intense",
        "Softer and more realistic"
    ],
    "Contraste": [
        "Higher contrast",
        "More moderate contrast"
    ],
    "Ambiance": [
        "More dramatic and cinematic",
        "More natural and realistic"
    ]
}

comparaison
[generate_image] Génération en cours...
[generate_image] Prompt: A futuristic city street at sunset, with modern buildings, pedestrians and autonomous vehicles.

[generate_image] Génération en cours...
[generate_image] Prompt: A futuristic city street at sunset, with modern buildings, pedestrians and autonomous vehicles.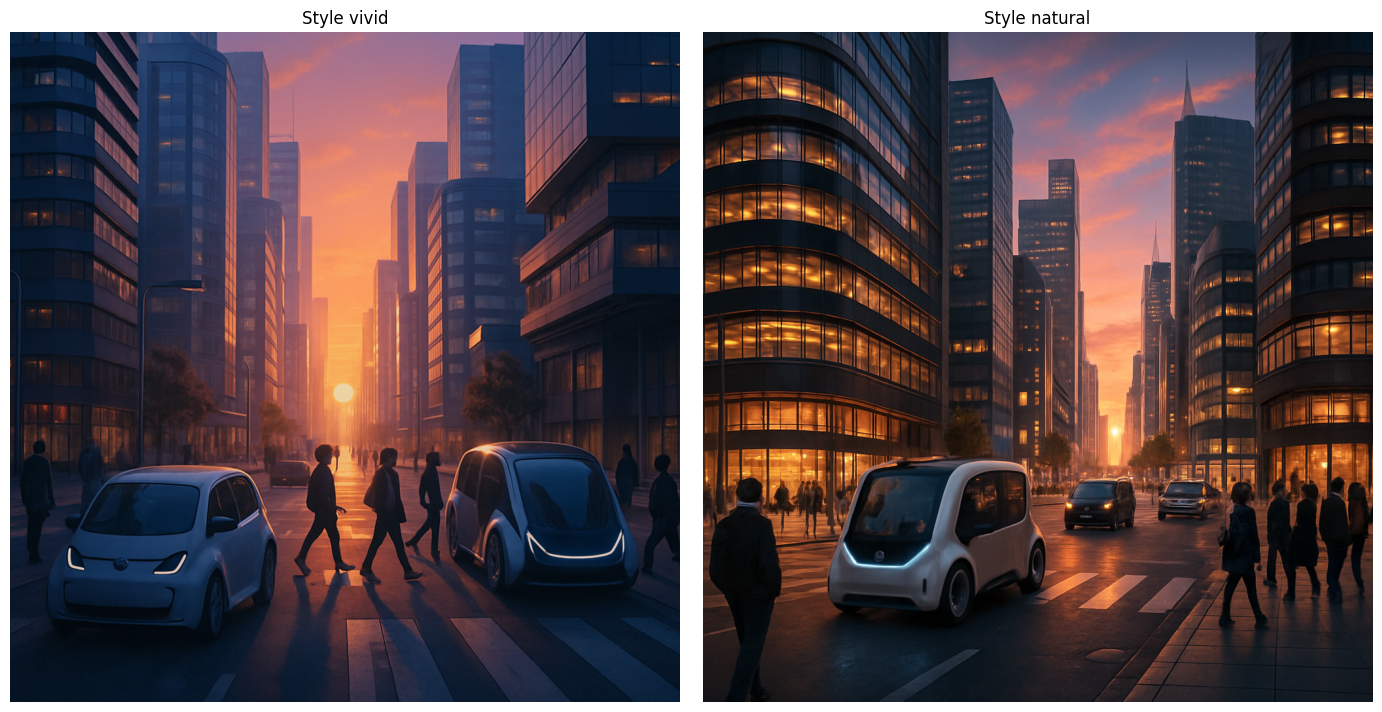
{'Style': ['vivid', 'natural'],
 'Prompt revise': ['A futuristic city street at sunset, with modern buildings, pedestrians and autonomous vehicles.',
  'A futuristic city street at sunset, with modern buildings, pedestrians and autonomous vehicles.'],
 'Couleurs': ['More saturated and intense', 'Softer and more realistic'],
 'Contraste': ['Higher contrast', 'More moderate contrast'],
 'Ambiance': ['More dramatic and cinematic', 'More natural and realistic']}
La cellule suivante, ajoutée à l’intégration, remplace l’appréciation à l’œil par une mesure : la saturation (S) et la luminosité (V) moyennes de chaque image, sur une échelle de 0 à 255.
# Ajout a l'integration : mesurer au lieu d'apprecier
from PIL import ImageStat

for nom, img in [("vivid", image_vivid), ("natural", image_natural)]:
    if img is None:
        print(f"{nom:8s}: generation echouee, pas de mesure")
        continue
    _, s_moy, v_moy = ImageStat.Stat(img.convert("RGB").convert("HSV")).mean
    print(f"{nom:8s}: saturation moyenne {s_moy:6.1f} | luminosite moyenne {v_moy:6.1f}")

print("\nLes deux requetes etaient identiques : l'ecart ci-dessus est celui de deux tirages.")
vivid : saturation moyenne 135.6 | luminosite moyenne 86.1
natural : saturation moyenne 111.0 | luminosite moyenne 78.6
Les deux requetes etaient identiques : l'ecart ci-dessus est celui de deux tirages.Lecture du résultat — exemple guidé 2
- Les deux images partagent la scène fixée par le prompt : même rue bordée de tours, piétons et voitures autonomes, coucher de soleil dans l’axe. Ce qui varie d’une image à l’autre — teintes du ciel, exposition — relève du tirage, pas d’une consigne :
stylen’est pas transmis à l’API. - La mesure : à ce tirage, l’image
vividest plus saturée (135,6 contre 111,0, soit +24,6 sur 255) et plus lumineuse (86,1 contre 78,6) que l’imagenatural. - Le piège : sur la saturation, le tableau du groupe (« more saturated ») paraît confirmé. Il l’est par hasard : les deux requêtes étaient identiques,
stylen’a pas été envoyé, et un autre tirage peut inverser l’écart — un tirage antérieur de cette même paire de requêtes rendait la luminosité dans l’ordre inverse. Une différence qui va dans le sens attendu ne prouve pas que la cause supposée existe. Pour l’établir, il faut comparer l’écart entre A et B à l’écart entre deux tirages de A : c’est l’objet de l’exercice 5. - La colonne « Prompt revise » contient deux fois le prompt d’origine, recopié par
generate_image()faute de révision renvoyée par l’API.
Une fois la generation de demonstration executee, le mode interactif vous invite a tester vos propres prompts avec les paramètres de votre choix.
# Mode interactif - Generation personnalisee
if notebook_mode == "interactive" and not skip_widgets:
    print("\n[generate_image] MODE INTERACTIF - GENERATION PERSONNALISEE")
    print("=" * 55)

    # Interface simple pour prompt personnalise
    print("\n[hint] Entrez votre propre prompt pour gpt-image:")
    print("(Laissez vide pour passer a la suite)")

    try:
        # Note: En mode MCP batch, ceci sera ignore
        user_prompt = input("\n[prompt] Votre prompt: ")

        if user_prompt.strip():
            print(f"\n[generate_image] Generation de votre image...")

            # Parametres optionnels
            print("\n[opts] Parametres optionnels (appuyez Entree pour defaut):")
            custom_size = input(f"[size] Taille [{image_size}]: ").strip() or image_size
            custom_style = input(f"[style] Style [{image_style}]: ").strip() or image_style
            custom_quality = input(f"[quality] Qualite [{image_quality}]: ").strip() or image_quality

            # Generation
            custom_result = generate_image(
                prompt=user_prompt,
                size=custom_size,
                quality=custom_quality,
                style=custom_style
            )

            if custom_result['success']:
                print(f"\n[ok] Votre image a ete generee!")
                _csrc = custom_result['image_url']
                print(f"[ok] Source: {'image b64 (data-URI, gpt-image-1)' if _csrc.startswith('data:') else _csrc}")

                if custom_result.get('revised_prompt') != user_prompt:
                    print(f"\n[prompt] gpt-image a optimise votre prompt:")
                    print(f"   {custom_result['revised_prompt']}")
            else:
                print(f"\n[err] Erreur: {custom_result['error']}")
        else:
            print("\n[skip] Mode interactif ignore")

    except (KeyboardInterrupt, EOFError) as e:
        # Gestion interruption normale
        print(f"\n[skip] Mode interactif interrompu ({type(e).__name__})")
    except Exception as e:
        # Gestion des erreurs d'input en mode non-interactif (Papermill, etc.)
        error_type = type(e).__name__
        if "StdinNotImplemented" in error_type or "input" in str(e).lower():
            print("\n[skip] Mode interactif non disponible (execution automatisee)")
        else:
            # Autre erreur inattendue - afficher pour debogage
            print(f"\n[warn] Erreur inattendue: {error_type} - {str(e)[:100]}")
            print("[skip] Passage a la suite du notebook")
else:
    print("\n[batch] Mode batch - Interface interactive desactivee")
    print("[hint] Pour mode interactif: notebook_mode = 'interactive'")
[generate_image] MODE INTERACTIF - GENERATION PERSONNALISEE
=======================================================

[hint] Entrez votre propre prompt pour gpt-image:
(Laissez vide pour passer a la suite)

[skip] Mode interactif non disponible (execution automatisee)
L’interface interactive permet d’experimenter librement avec ses propres prompts. La cellule suivante recapitule les bonnes pratiques et les paramètres optimaux identifies lors de cette session.
# Analyse et optimisation des résultats
print("\n📊 ANALYSE ET BONNES PRATIQUES DALL-E 3")
print("=" * 50)

# Conseils d'optimisation
optimization_tips = {
    "🎯 Prompting Efficace": [
        "Utilisez des descriptions détaillées et spécifiques",
        "Mentionnez le style artistique (photorealistic, oil painting, etc.)",
        "Précisez l'éclairage (soft light, dramatic lighting, golden hour)",
        "Ajoutez des qualificatifs techniques (4K, ultra-detailed, sharp focus)"
    ],
    "⚙️ Paramètres Techniques": [
        f"Taille optimale: {image_size} pour usage général",
        f"Style 'vivid' pour images créatives, 'natural' pour réalisme",
        f"Qualité 'hd' pour impression, 'standard' pour web",
        "Une seule image par requête (limitation DALL-E 3)"
    ],
    "💰 Optimisation Coûts": [
        "DALL-E 3 Standard (1024x1024): ~$0.040 par image",
        "DALL-E 3 HD: ~$0.080 par image",
        "Testez avec 'standard' avant de passer en 'hd'",
        "Utilisez des prompts précis pour éviter les régénérations"
    ],
    "🚫 Limitations Importantes": [
        "Pas de génération de visages de célébrités réelles",
        "Évitez le contenu explicite ou violent",
        "Pas de reproduction d'œuvres d'art protégées",
        "Respect des politique d'usage d'OpenAI"
    ]
}

for category, tips in optimization_tips.items():
    print(f"\n{category}")
    for tip in tips:
        print(f"  • {tip}")

# Statistiques de cette session
print(f"\n📈 STATISTIQUES SESSION")
print(f"📅 Date: {datetime.now().strftime('%Y-%m-%d %H:%M:%S')}")
print(f"🎯 Modèle utilisé: {model_name}")
print(f"⚙️  Configuration: {image_size}, {image_style}, {image_quality}")
print(f"🎨 Nombre d'images générées: 1 (démo)")
print(f"💾 Sauvegarde automatique: {'✅' if save_images else '❌'}")

print(f"\n🎓 PROCHAINES ÉTAPES")
print(f"1. Expérimenter avec différents styles de prompts")
print(f"2. Tester les paramètres de qualité et style")
print(f"3. Explorer le notebook 01-2 (GPT-5 Image Generation)")
print(f"4. Découvrir les opérations d'images (01-3)")

print(f"\n✅ Notebook DALL-E 3 terminé - {datetime.now().strftime('%H:%M:%S')}")
📊 ANALYSE ET BONNES PRATIQUES DALL-E 3
==================================================

🎯 Prompting Efficace
  • Utilisez des descriptions détaillées et spécifiques
  • Mentionnez le style artistique (photorealistic, oil painting, etc.)
  • Précisez l'éclairage (soft light, dramatic lighting, golden hour)
  • Ajoutez des qualificatifs techniques (4K, ultra-detailed, sharp focus)

⚙️ Paramètres Techniques
  • Taille optimale: 1024x1024 pour usage général
  • Style 'vivid' pour images créatives, 'natural' pour réalisme
  • Qualité 'hd' pour impression, 'standard' pour web
  • Une seule image par requête (limitation DALL-E 3)

💰 Optimisation Coûts
  • DALL-E 3 Standard (1024x1024): ~$0.040 par image
  • DALL-E 3 HD: ~$0.080 par image
  • Testez avec 'standard' avant de passer en 'hd'
  • Utilisez des prompts précis pour éviter les régénérations

🚫 Limitations Importantes
  • Pas de génération de visages de célébrités réelles
  • Évitez le contenu explicite ou violent
  • Pas de reproduction d'œuvres d'art protégées
  • Respect des politique d'usage d'OpenAI

📈 STATISTIQUES SESSION
📅 Date: 2026-10-04 14:01:48
🎯 Modèle utilisé: gpt-image-1
⚙️  Configuration: 1024x1024, vivid, medium
🎨 Nombre d'images générées: 1 (démo)
💾 Sauvegarde automatique: ✅

🎓 PROCHAINES ÉTAPES
1. Expérimenter avec différents styles de prompts
2. Tester les paramètres de qualité et style
3. Explorer le notebook 01-2 (GPT-5 Image Generation)
4. Découvrir les opérations d'images (01-3)

✅ Notebook DALL-E 3 terminé - 14:01:48
CHALLENGE BONUS - Génération d’Icone pour Application
Points : 0.5 pts
Objectif
Générer une icône d’application de style “app store” pour un projet technique.
Ce que vous avez appris
La Section 5 montre des prompts optimisés avec: - Description détaillée du sujet - Style artistique (“cinematic”, “professional”) - Qualificatifs techniques (“8K”, “ultra-detailed”)
Critères de succes
-
- “Assistant de productivité”
- “App de fitness/sport”
- “Outil de note-taking”
-
- Fond uni ou dégradé simple
- Symbole central reconnaissable
- Style “flat design” ou “3D isometric”
Contraintes techniques
- L’icône doit être utilisable (fond simple pour intégration facile)
- Prompt en anglais recommandé
- Si le modèle renvoie un prompt révisé (DALL-E 3), l’afficher pour comprendre son interprétation
Soumission : PR avec titre “Challenge #4 - [Votre Nom]”, type d’app choisi, prompts et image générée ### 📖 References savantes
- OpenAI (2023). DALL-E 3 System Card. — Documente la reecriture automatique des prompts via GPT-4 et l’entrainement sur captions ameliorees (recaptioning), caractéristiques centrales du modèle enseignees dans ce notebook.
- Ramesh, A. et al. (2022). Hierarchical Text-Conditional Image Generation with CLIP Latents (DALL-E 2). arXiv:2204.06125. — Filiation architecturale : CLIP latents + processus de diffusion, socle sur lequel DALL-E 3 s’appuie.
- Ramesh, A., Pavlov, M., Goh, G., et al. (2021). Zero-Shot Text-to-Image Generation (DALL-E 1). arXiv:2102.12092. — Precurseur : auto-regressive transformer dVAE, origine de la lignee DALL-E.
Exemple guidé 3 : Optimiser un prompt pour la page d’accueil d’une startup
Contexte : une startup a besoin d’un visuel pour sa page d’accueil, sur le thème « collaboration humaine et technologie ». L’énoncé d’origine proposait d’écrire un prompt simple, de le comparer au revised_prompt renvoyé par le modèle, puis d’écrire un second prompt enrichi de ce que la révision avait ajouté.
Le groupe a constaté que ce plan ne tient pas avec gpt-image-1 : le modèle ne renvoie pas de prompt révisé, et generate_image() retombe sur le prompt d’origine. Il a donc déplacé l’analyse du texte vers les images. Le prompt v2 ajoute l’éclairage, la palette, la composition, un élément technique (un tableau de bord holographique) et une consigne de mise en page, « plenty of negative space on the left for homepage text », qui réserve la place du texte de la page. Sa conclusion : les consignes de style sont suivies, la consigne de mise en page beaucoup moins.
Comme dans les exemples précédents, la liste differences décrit les images du groupe ; la lecture sous la cellule la confronte aux images de cette exécution.
Contribution étudiante de Yao LIU (@liuyao0010-debug), Zihao CHENG et Ruofan ZHAO (PR #18561), intégrée comme exemple guidé.
# Exemple guide 3 : Optimisation d'un prompt pour une page d'accueil (contribution etudiante, PR #18561)
import base64
from io import BytesIO
import matplotlib.pyplot as plt
from PIL import Image

def _to_image(result):
    """Convertit le résultat de generate_image() en objet PIL.Image."""
    src = result["image_url"]
    if src.startswith("data:"):
        return Image.open(BytesIO(base64.b64decode(src.split(",", 1)[1])))
    return Image.open(BytesIO(requests.get(src, timeout=30).content))

# Etape 1 : Prompt initial simple
prompt_v1 = ("A team of people and friendly robots collaborating together "
             "in a modern office, for a startup homepage.")

# Etape 2 : Generation avec le prompt initial
result_v1 = generate_image(prompt=prompt_v1, size="1024x1024", style="vivid")
print(f"Prompt original : {prompt_v1}")
if result_v1["success"]:
    print(f"Prompt revise   : {result_v1.get('revised_prompt', 'N/A')}")
    if result_v1.get("revised_prompt", prompt_v1).strip() == prompt_v1.strip():
        print("\n[info] revised_prompt identique a l'original : gpt-image-1 ne "
              "renvoie pas de prompt revise (fallback sur le prompt d'origine).")
else:
    print(f"Erreur v1 : {result_v1['error']}")

# Etape 3 : Differences observees par le groupe entre SES images v1 et v2
# (gpt-image-1 ne renvoie pas de revised_prompt : l'analyse porte sur les images)
differences = [
    "Eclairage : v1 lumiere uniforme et plate -> v2 lumiere naturelle directionnelle (fenetre)",
    "Palette : v1 bleus froids monochromes -> v2 contraste bleu / orange chaud",
    "Composition : v1 plan serre sans arriere-plan -> v2 profondeur de champ et skyline urbaine",
    "Elements tech : v1 robots seuls -> v2 tableau de bord holographique (graphiques)",
    "Limite : l'instruction 'negative space on the left' n'est pas clairement respectee",
]
print("\nDifferences observees par le groupe (sur sa propre execution) :")
for d in differences:
    print(f"  - {d}")

# Etape 4 : Prompt ameliore integrant les lecons
prompt_v2 = (
    "A diverse team of young professionals collaborating with a friendly "
    "humanoid robot around a glass table in a bright modern startup office, "
    "a holographic dashboard floating above the table. Soft natural window "
    "light, warm and optimistic atmosphere, wide-angle composition with the "
    "team in the foreground and city skyline in the background. Clean "
    "modern illustration style, blue and warm orange color palette, "
    "ultra-detailed, sharp focus, shallow depth of field, plenty of "
    "negative space on the left for homepage text."
)

# Etape 5 : Generation avec le prompt ameliore
result_v2 = generate_image(prompt=prompt_v2, size="1024x1024", style="vivid")
print(f"\nPrompt ameliore : {prompt_v2}")
if result_v2["success"]:
    print(f"Prompt revise   : {result_v2.get('revised_prompt', 'N/A')}")
else:
    print(f"Erreur v2 : {result_v2['error']}")

# Comparaison visuelle des deux generations
if result_v1["success"] and result_v2["success"]:
    fig, axes = plt.subplots(1, 2, figsize=(14, 7))
    for ax, res, titre in zip(axes, [result_v1, result_v2],
                              ["Prompt v1 (simple)", "Prompt v2 (ameliore)"]):
        ax.imshow(_to_image(res))
        ax.set_title(titre, fontsize=14)
        ax.axis("off")
    plt.tight_layout()
    plt.show()

# Comparaison des deux revisions
print("\n--- Comparaison des revisions ---")
for nom, prompt, res in [("v1", prompt_v1, result_v1), ("v2", prompt_v2, result_v2)]:
    if res["success"]:
        rev = res.get("revised_prompt", prompt)
        print(f"{nom} : original = {len(prompt.split())} mots | "
              f"revise = {len(rev.split())} mots")

# Observations finales
observations_ex3 = (
    "gpt-image-1 ne renvoie pas de revised_prompt (identique a l'original). "
    "L'amelioration vient donc du prompt v2 : ajouter eclairage, palette, "
    "composition et elements techniques rend l'image plus riche et plus "
    "adaptee a un usage homepage, mais les consignes de mise en page restent "
    "moins bien suivies que les consignes de style."
)
print(f"\nObservations : {observations_ex3}")

print("\nExemple guide 3 termine")
[generate_image] Génération en cours...
[generate_image] Prompt: A team of people and friendly robots collaborating together in a modern office, for a startup homepa...
Prompt original : A team of people and friendly robots collaborating together in a modern office, for a startup homepage.
Prompt revise   : A team of people and friendly robots collaborating together in a modern office, for a startup homepage.

[info] revised_prompt identique a l'original : gpt-image-1 ne renvoie pas de prompt revise (fallback sur le prompt d'origine).

Differences observees par le groupe (sur sa propre execution) :
  - Eclairage : v1 lumiere uniforme et plate -> v2 lumiere naturelle directionnelle (fenetre)
  - Palette : v1 bleus froids monochromes -> v2 contraste bleu / orange chaud
  - Composition : v1 plan serre sans arriere-plan -> v2 profondeur de champ et skyline urbaine
  - Elements tech : v1 robots seuls -> v2 tableau de bord holographique (graphiques)
  - Limite : l'instruction 'negative space on the left' n'est pas clairement respectee

[generate_image] Génération en cours...
[generate_image] Prompt: A diverse team of young professionals collaborating with a friendly humanoid robot around a glass ta...

Prompt ameliore : A diverse team of young professionals collaborating with a friendly humanoid robot around a glass table in a bright modern startup office, a holographic dashboard floating above the table. Soft natural window light, warm and optimistic atmosphere, wide-angle composition with the team in the foreground and city skyline in the background. Clean modern illustration style, blue and warm orange color palette, ultra-detailed, sharp focus, shallow depth of field, plenty of negative space on the left for homepage text.
Prompt revise   : A diverse team of young professionals collaborating with a friendly humanoid robot around a glass table in a bright modern startup office, a holographic dashboard floating above the table. Soft natural window light, warm and optimistic atmosphere, wide-angle composition with the team in the foreground and city skyline in the background. Clean modern illustration style, blue and warm orange color palette, ultra-detailed, sharp focus, shallow depth of field, plenty of negative space on the left for homepage text.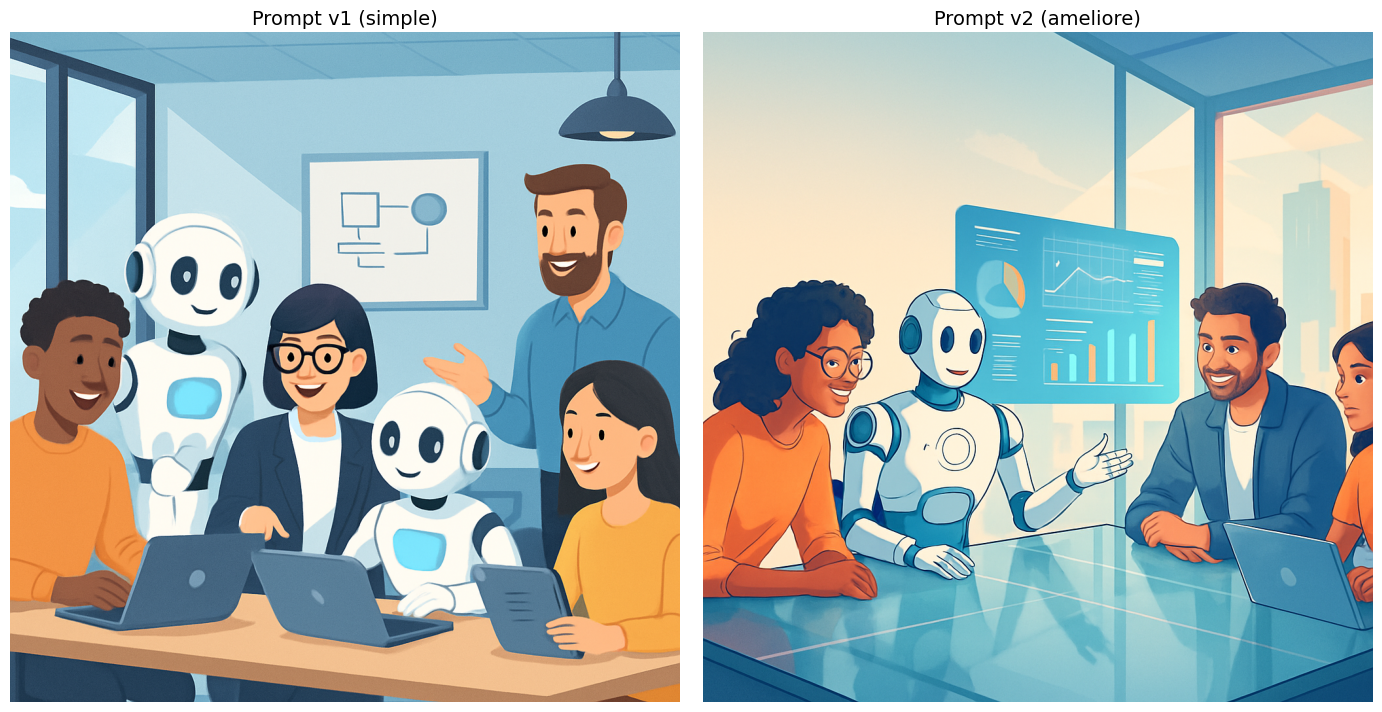
--- Comparaison des revisions ---
v1 : original = 17 mots | revise = 17 mots
v2 : original = 78 mots | revise = 78 mots

Observations : gpt-image-1 ne renvoie pas de revised_prompt (identique a l'original). L'amelioration vient donc du prompt v2 : ajouter eclairage, palette, composition et elements techniques rend l'image plus riche et plus adaptee a un usage homepage, mais les consignes de mise en page restent moins bien suivies que les consignes de style.

Exemple guide 3 termine
Lecture du résultat — exemple guidé 3
La liste differences a été écrite par le groupe sur ses propres images. Confrontée aux images de cette exécution :
- Éclairage (v1 plat, v2 lumière de fenêtre) : tient. La v2 est baignée d’une lumière chaude venue des fenêtres, la v1 est éclairée uniformément.
- Palette (v1 bleus froids, v2 contraste bleu / orange) : tient, presque trait pour trait.
- Composition (v2 plus profonde, avec une skyline) : tient en partie. La v2 montre des silhouettes de tours derrière les fenêtres ; la v1 n’est pas sans arrière-plan (fenêtre, étagères), mais le groupe y reste serré autour de la table.
- Éléments techniques (tableau de bord holographique en v2) : tient. Un grand panneau de graphiques flotte au-dessus de la table de verre.
- Consigne de mise en page : non respectée, comme chez le groupe. Un personnage occupe le bord gauche de la v2, et aucune zone ne reste libre pour le texte d’une page d’accueil.
Ce qui ressort : les consignes de contenu et de style (palette, lumière, objets) passent d’une exécution à l’autre, alors que la consigne de placement a échoué deux fois sur deux. Deux exécutions ne font pas une statistique, mais elles donnent une hypothèse qu’on peut mesurer : c’est l’objet de l’exercice 6. Enfin, la comparaison des longueurs (17 et 78 mots, « révisés » compris) ne mesure rien ici, puisque le prompt « révisé » est le prompt d’origine.
Exercices à compléter
Exercice 4 : Le prompt tient-il ses promesses ? Mesurer sur les pixels
Écrire un prompt riche est une chose ; vérifier que le modèle a réellement obéi en est une autre. L’exemple guidé ci-dessus conclut que le style et l’éclairage sont « les leviers les plus impactants » – mais comment le prouver plutôt que le croire ? Plutôt que de juger à l’œil, on peut mesurer : PIL donne un accès direct aux statistiques des pixels (teinte moyenne, saturation, luminosité).
Objectif : choisir UN axe visuel binaire, générer deux images qui ne diffèrent QUE par cet axe, puis mesurer sur les pixels si la différence promise est réellement observable.
Étapes : 1. Choisissez un axe visuel binaire (exemples : palette chaude vs froide, scène diurne vs nocturne, couleurs saturées vs désaturées, éclairage doux vs dramatique) 2. Rédigez deux prompts identiques SAUF la mention de cet axe – une seule variable change, comme dans une expérience contrôlée 3. Générez les deux images via generate_image() (quality="low" suffit pour cette mesure) 4. Calculez pour chaque image une statistique PIL pertinente pour votre axe 5. Concluez : la mesure confirme-t-elle la différence promise ? De combien ? Un seul couple d’images suffit-il à conclure ?
Indice 1 : img.convert("HSV") sépare teinte (H), saturation (S) et luminosité (V) ; ImageStat.Stat(img_hsv).mean donne la moyenne de chaque canal. Attention aux unités : Pillow encode H sur 0-255 (pas 0-360°) ; un bleu pur donne H ≈ 170, pas 240. Attention à la circularité : la teinte est un angle — deux rouges de part et d’autre de la coupure (H=254 et H=0) donnent une moyenne arithmétique de 127 (cyan), alors que la moyenne circulaire reste rouge. Masquez les pixels peu saturés (S < 30) : un gris a H=0 et ne doit pas compter comme rouge. Pour une palette chaude vs froide, mesurez une proportion de pixels dans des secteurs H (chaud : 0-60 et 200-255, froid : 100-180) plutôt qu’une moyenne seule. Diurne vs nocturne se lit surtout sur V ; saturée vs désaturée sur S.
Indice 2 : pour décoder l’image depuis le résultat de generate_image() : Image.open(BytesIO(base64.b64decode(result["image_url"].split(",", 1)[1]))).
# Exercice 4 : Le prompt tient-il ses promesses ? (mesure sur les pixels)

# Etape 1 : Axe visuel binaire choisi
axe_choisi = None  # TODO etudiant : nommez votre axe (ex. "palette chaude vs froide")

# Etape 2 : Deux prompts identiques sauf la mention de l'axe
prompt_axe_a = "..."  # TODO etudiant : version A de l'axe (ex. "warm color palette")
prompt_axe_b = "..."  # TODO etudiant : version B de l'axe (ex. "cool color palette")
# Indice : ne changez QUE la mention de l'axe, gardez sujet et style identiques

# Etape 3 : Generation des deux images (quality="low" suffit pour mesurer)
# result_a = generate_image(prompt=prompt_axe_a, size="1024x1024", quality="low")
# result_b = generate_image(prompt=prompt_axe_b, size="1024x1024", quality="low")
# Indice : decoder l'image -> Image.open(BytesIO(base64.b64decode(result_a["image_url"].split(",", 1)[1])))

# Etape 4 : Mesure PIL sur chaque image
# from PIL import ImageStat
mesure_a = None  # TODO etudiant : statistique PIL pour l'image A
mesure_b = None  # TODO etudiant : meme statistique pour l'image B
# Indice (ATTENTION) : ne prenez PAS la moyenne arithmetique de la teinte -- la teinte
# est un angle, et Pillow l encode sur 0-255 (pas 0-360). Deux rouges de part et d autre
# de la coupure (H=254 et H=0) donnent une moyenne de 127, soit du CYAN : c est le piege
# que l Indice 1 de la consigne ci-dessus detaille.
# Pistes correctes : masquer les pixels peu satures (S < 30 ; un gris a H=0 ne doit pas
# compter comme rouge), puis mesurer une PROPORTION de pixels dans des secteurs de teinte
# (chaud : 0-60 et 200-255, froid : 100-180), ou une statistique circulaire accompagnee
# d une mesure de concentration.
# ImageStat.Stat(img_hsv).mean -> [H, S, V] reste utile pour S et V.

# Etape 5 : Conclusion chiffree
conclusion_ex4 = None  # TODO etudiant : la mesure confirme-t-elle l'axe ? de combien ?

print("Exercice a completer")
Exercice a completerExercice 5 : Effet d’un paramètre, ou bruit du tirage ?
L’exemple guidé 2 compare deux images générées avec deux valeurs de style, un paramètre que generate_image() n’envoie même pas : les deux images diffèrent pourtant. Toute comparaison A/B d’un générateur d’images doit donc répondre à une question préalable : la différence entre A et B dépasse-t-elle celle qui sépare deux tirages de A ?
Objectif : mesurer l’effet d’un paramètre réellement envoyé à l’API, quality, en le comparant au bruit du tirage.
Étapes : 1. Choisissez un prompt riche en détails fins (texture, feuillage, foule, objets nombreux) 2. Générez 2 images en quality="low" et 2 en quality="high", avec le même prompt et la même taille 3. Choisissez une mesure qui devrait dépendre de la qualité : densité de contours, taille du PNG en octets, temps de réponse (result["response_time"]) 4. Calculez le bruit (l’écart entre les deux images low, puis entre les deux high) et l’effet (l’écart entre la moyenne low et la moyenne high) 5. Concluez : l’effet dépasse-t-il le bruit, et pour quelle mesure ? Deux images par condition suffisent-elles pour l’affirmer ?
Indice 1 : ImageStat.Stat(img.convert("L").filter(ImageFilter.FIND_EDGES)).mean[0] donne une densité de contours moyenne : une image plus détaillée a davantage de contours.
Indice 2 : quality="high" coûte nettement plus cher que low. Quatre générations suffisent pour cet exercice ; ne lancez pas de boucle plus longue sans raison.
# Exercice 5 : Effet d'un parametre, ou bruit du tirage ?
from PIL import ImageFilter, ImageStat

# Etape 1 : Prompt riche en details fins
prompt_ex5 = "..."  # TODO etudiant : votre prompt en anglais

# Etape 2 : Deux generations par valeur de quality
# resultats_low = [generate_image(prompt=prompt_ex5, size="1024x1024", quality="low") for _ in range(2)]
# resultats_high = [generate_image(prompt=prompt_ex5, size="1024x1024", quality="high") for _ in range(2)]


# Etape 3 : Une mesure par image
def mesure_ex5(img):
    return None  # TODO etudiant : densite de contours, taille du PNG, ...


# Etape 4 : Bruit (entre deux tirages d'une meme valeur) et effet (entre valeurs)
bruit_low = None   # TODO etudiant : ecart entre les deux images low
bruit_high = None  # TODO etudiant : ecart entre les deux images high
effet = None       # TODO etudiant : ecart entre la moyenne low et la moyenne high

# Etape 5 : Conclusion chiffree
conclusion_ex5 = None  # TODO etudiant : l'effet depasse-t-il le bruit ? pour quelle mesure ?

print("Exercice a completer")
Exercice a completerExercice 6 : Une consigne de mise en page est-elle respectée ?
Dans l’exemple guidé 3, le groupe demande « plenty of negative space on the left for homepage text » et constate, à l’œil, que la consigne n’est pas clairement respectée. Une consigne de composition se vérifie pourtant sur les pixels : une zone vide est une zone où l’image varie peu.
Objectif : mesurer, sur plusieurs générations, si une consigne de placement est respectée, et à quelle fréquence.
Étapes : 1. Rédigez un prompt de bannière qui place explicitement le sujet d’un côté et laisse l’autre côté vide (fond uni), en format paysage size="1536x1024" 2. Définissez un critère mesurable : par exemple, découper l’image en trois tiers verticaux et comparer la variabilité de luminosité du tiers censé être vide à celle du tiers qui porte le sujet 3. Fixez le seuil avant de générer : à partir de quel rapport considérez-vous le tiers comme vide ? 4. Générez 3 images avec ce prompt (quality="low") et appliquez le critère à chacune 5. Concluez : combien d’images sur 3 respectent la consigne ? Reformulez le prompt une fois (position du sujet, fond, expressions comme « copy space ») et comparez le taux de réussite
Indice : img.crop((0, 0, largeur // 3, hauteur)) isole le tiers gauche ; ImageStat.Stat(tiers.convert("L")).stddev[0] mesure sa variabilité de luminosité.
# Exercice 6 : Une consigne de mise en page est-elle respectee ?
from PIL import ImageStat

# Etape 1 : Prompt de banniere (sujet d'un cote, l'autre cote vide)
prompt_ex6 = "..."  # TODO etudiant : votre prompt en anglais

# Etape 2 et 3 : Critere et seuil, fixes AVANT de generer
seuil_ex6 = None  # TODO etudiant : rapport de variabilite en dessous duquel le tiers est "vide"


def tiers_vide(img):
    return None  # TODO etudiant : True si le tiers vise est vide selon votre critere


# Etape 4 : Trois generations et application du critere
# resultats_ex6 = [generate_image(prompt=prompt_ex6, size="1536x1024", quality="low") for _ in range(3)]
verdicts_ex6 = []  # TODO etudiant : un booleen par image

# Etape 5 : Taux de reussite, puis second prompt reformule
conclusion_ex6 = None  # TODO etudiant : combien sur 3 ? la reformulation aide-t-elle ?

print("Exercice a completer")
Exercice a completerConclusion
gpt-image (la famille de generation d’images d’OpenAI utilisee depuis 2025, qui a succede a DALL-E 3) via l’API OpenAI directe illustre l’approche boite noire managée : on delègue entierement le pipeline de generation a un service heberge et on consomme le resultat via generate_image(prompt, size, quality, style). Les parametres exposes (size, quality, style) restent volontairement restreints – l’optimisation fine (sampler, scheduler, CFG) est inaccessible, ce qui est coherent avec le public vise (createurs de contenu, prototypage rapide).
Point d’attention sur la réécriture des prompts : DALL-E 3 réécrivait automatiquement le prompt utilisateur pour l’enrichir, et renvoyait la version réécrite dans revised_prompt. Avec gpt-image-1, l’API ne renvoie plus de prompt révisé (le groupe de l’exemple guidé 3 l’a constaté) : on ne peut plus savoir, depuis l’API, si le prompt a été retouché avant la génération. Pour les usages pédagogiques ou de brand-compliance, le contrôle passe donc par l’image elle-même, ce que mesurent les exercices 4 à 6.
Mise en perspective avec le reste du cours : gpt-image s’oppose a l’approche open weights exploree dans les autres notebooks Foundation (Forge SD XL Turbo, Qwen-Image-Edit). Les trade-offs (qualite percue vs controle, cout vs souverainete, facilite vs transparence) structurent le paysage de la generation d’images et reviennent dans toute decision d’architecture GenAI.
Pour aller plus loin : comparer systematiquement la meme intention creative sur gpt-image, SD XL Turbo, Qwen-Image-Edit et FLUX.1. Les variations de style, de prompt engineering requis et de fidelite au brief revelent les biais d’entrainement propres a chaque modele – un exercice transverse eclairant pour le notebook 03-1-Multi-Model-Comparison.