02-ML-Cours — Le socle Machine Learning canonique avec scikit-learn
← DataScienceWithAgents (série parente) | 01-PythonForDataScience (prérequis) →
Kernel : Python 3 · Bibliothèque : scikit-learn · Niveau : intermédiaire (post NumPy/Pandas)
Environnement : CPython 3.13 — pip install -r [requirements.txt](requirements.txt) installe toutes les dépendances de la série (relevées par imports : scikit-learn, optuna, shap, lime, dice-ml, diffprivlib, cvxpy, imbalanced-learn, umap-learn, statsmodels, torch). Sans lui, 2.10 / 2.12 / 2.14 / 2.14b / 2.15 lèvent une ImportError dès la première cellule.
Pourquoi cette série
La formation DataScienceWithAgents saute aujourd’hui un maillon. Après les fondations NumPy/Pandas (01-PythonForDataScience), les labs agentic (LangChain, Google ADK) demandent à des agents LLM de produire et d’exécuter du code de data science — y compris du machine learning. Mais entre les deux, aucun notebook n’enseigne le workflow ML, un modèle ou une métrique comme un sujet en soi : scikit-learn n’apparaît que comme une séquence magique non expliquée (un fit() isolé dans un lab de visualisation, ou cité en litteral dans une chaîne LLM).
Cette série comble ce socle manquant. Elle pose, à la main et de façon canonique, les huit chapitres fondamentaux du machine learning supervisé et non supervisé — le référent qui rend jugeable ce qu’un agent produira ensuite. L’arc pédagogique suit la progression classique : le workflow d’ensemble, puis on ouvre les boîtes noires (descente de gradient, fonction de lien), on élargit la famille de modèles (régression linéaire/logistique, arbres et ensembles, SVM à noyau et k plus proches voisins), on formalise l’évaluation (biais-variance, validation croisée, ROC, calibration des probabilités), puis l’on bascule en non supervisé (clustering, ACP), avant de clore par le cadre théorique (théorie PAC, dimension VC). Chaque notebook rend visible un concept-phare — le surapprentissage, la divergence d’un learning rate, la frontière de décision, la réduction de variance, le coût d’un seuil, le kernel trick, la structure retrouvée sans étiquettes, et le nombre d’exemples suffisant pour généraliser.
La thèse est volontairement classique : on ne peut évaluer ce qu’un agent génère comme pipeline scikit-learn que si l’on sait soi-même ce que fit() minimise, pourquoi un arbre surapprend, et ce que mesure une AUC. Cette série fournit ce référent, en gardant les outils à leur juste place (vraies API scikit-learn, exécutées, sorties réelles committées).
Vue d’ensemble
| Notebook | Sujet | Concept-phare | Dataset |
|---|---|---|---|
| 2.1-Workflow-ML | Le workflow ML (split → fit → predict → évaluer) | Surapprentissage rendu visible (sweep max_depth 1→25) |
synthétique make_* |
| 2.2-Descente-de-gradient | Ouvrir la boîte noire de fit() |
3 learning rates (lent / bon / divergeant) | synthétique make_regression |
| 2.3-Regression-lineaire-logistique | Régression linéaire (OLS) vs logistique (MLE) | OLS vs MLE : droite vs sigmoïde sur mêmes labels binaires | synthétique make_* |
| 2.3b-Naive-Bayes-Generatif | Bayésien naïf génératif vs régression logistique discriminative | Génératif vs discriminatif : modéliser P(x|y) puis Bayes, ou P(y|x) directement — l’hypothèse d’indépendance coûte du biais | synthétique (corrélations homogènes et en bloc) |
| 2.3c-Regression-Grande-Dimension | p >> n : ridge, PCR (composantes principales), PLS (composantes supervisées) | Var ≠ valeur prédictive : la PLS trouve en 5 composantes ce que la PCR paie à 44 | synthétique (blocs corrélés, SEED=42) |
| 2.3d-Modele-Gaussien-LDA-QDA | Modèle gaussien : analyse discriminante linéaire (LDA) vs quadratique (QDA) | L’hypothèse de covariance décide la frontière : partagée → droite (LDA), propre → conique (QDA) | synthétique make_* (régimes contrôlés) |
| 2.4-Arbres-Forets-Ensembles | Arbres, forêt aléatoire, gradient boosting | Réduction de variance : frontière en escalier vs lisse | réel load_breast_cancer |
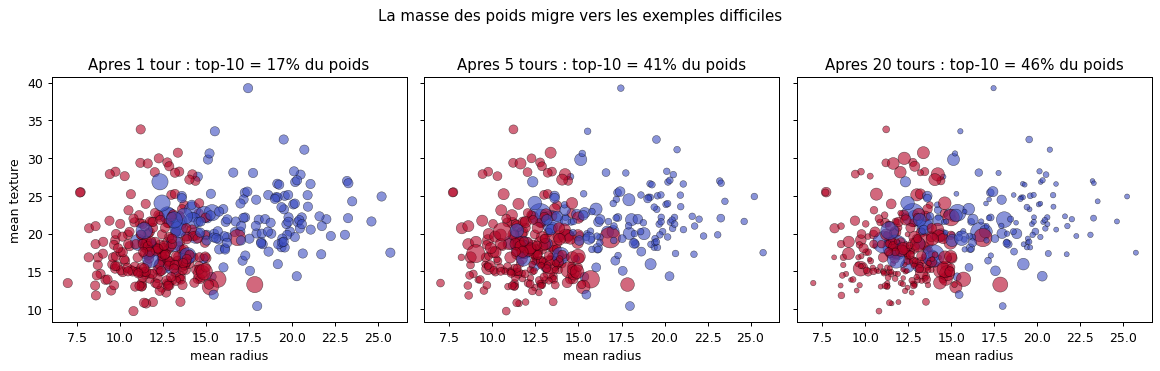
| 2.4b-AdaBoost-From-Scratch | Accrétion de 2.4 — AdaBoost (SAMME) écrit à la main : stump à erreur pondérée, vote α = ½ln((1−ε)/ε), repondération des exemples, borne d’erreur ∏2√(ε(1−ε)) vérifiée | Les poids rendus visibles : la masse migre vers les exemples difficiles, l’escalier du comité émerge des demi-plans pondérés | réel load_breast_cancer |
| 2.5-Biais-Variance-CV-ROC | Compromis biais-variance, validation croisée, ROC/AUC | ROC + coût du seuil : faux négatifs vs faux positifs | réel load_breast_cancer |
| 2.5b-Calibration-Probabilites | Calibration des probabilités : reliability diagrams, ECE, Brier | Pourquoi 0.87 n’est pas 87 % de chances : discrimination vs calibration, la diagonale du reliability diagram | réel load_breast_cancer |
| 2.5c-Equite-Sous-Groupes | Équité par sous-groupe : parité démographique, equalized odds, l’incompatibilité des trois métriques sous prévalences différentes (Chouldechova) et le post-traitement par seuils par groupe (Hardt) | L’accuracy globale ne suffit pas : 96,4 % global coexiste avec deux groupes à [0,977–0,995] et [0,922–0,957] | synthétique contrôlé (2 groupes, prévalences réglables) |
| 2.5d-Derive-Distribution-Deploiement | Dérive de distribution au déploiement : trois dérives construites volontairement (covariable, étiquette, concept), chacune mesurée par l’écart entre ce que la validation croisée annonce et ce que le déploiement produit ; trois détecteurs (test à deux échantillons, classifieur discriminant, MMD) réimplémentés puis confrontés à alibi-detect |
Deux dérives sur trois se corrigent : la covariable par pondération d’importance, l’étiquette par BBSE — la dérive de concept ne se corrige pas sans nouvelles étiquettes, et le carnet le montre | synthétique contrôlé (régimes entraînement/déploiement réglables) |
| 2.6-Clustering-KMeans-PCA | Apprentissage non supervisé : KMeans + ACP | Structure retrouvée sans étiquettes (PCA 2D + reconstruction) | réel load_digits |
| 2.7-Modeles-Non-Parametriques | SVM à noyau et k plus proches voisins | Le kernel trick rendu visible (linéaire vs RBF sur demi-lunes) | synthétique make_moons + réel load_breast_cancer |
| 2.7b-SMO-From-Scratch | Accrétion de 2.7 — SMO (Platt) écrit à la main : sous-problème 2D (dont la branche dégénérée η ≤ 0), cascade de working set, KKT et gap de dualité |
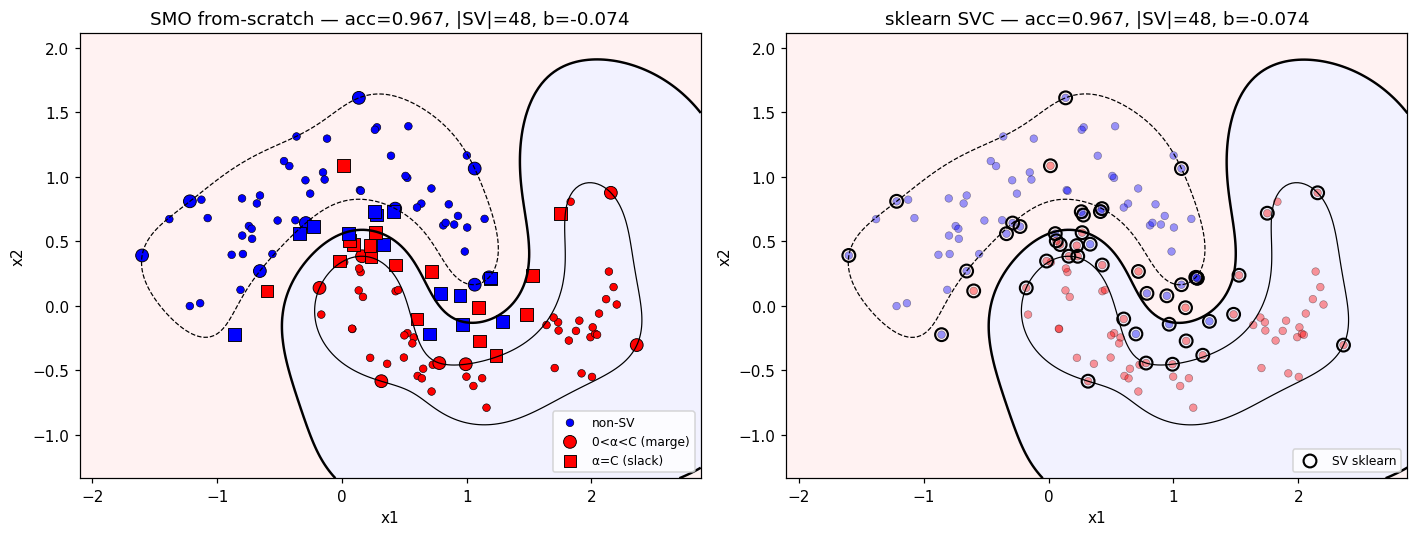
Le solveur écrit à la main retrouve sklearn : même biais à 4·10⁻⁴ près, gap de dualité ≈ 3·10⁻³, pire violation KKT ponctuelle ≈ 10⁻³ | synthétique make_moons |
| 2.7c-SVM-SOTA-Comparison | Accrétion de 2.7b — le SOTA (LIBSVM sous sklearn.svm.SVC) lu sous le capot : dual reconstruit depuis dual_coef_, gap de dualité et violations KKT mesurés sur LIBSVM, working set au second ordre et shrinking, tolérance d’arrêt comme contrat |
Le SOTA n’achète pas la solution, il achète le temps : même optimum et mêmes 48 supports que la SMO maison, trois ordres de grandeur plus vite (fit sub-milliseconde contre 1,19 s) — les deux solveurs s’arrêtent à tol près |
synthétique make_moons (graine de 2.7b) |
| 2.8-Theorie-PAC | Théorie PAC : sample complexity et dimension VC | La borne PAC prédit l’empirique (m_min théorique vs courbe d’erreur) | synthétique make_* |
| 2.8b-Theorie-PAC-Lean | Compagnon Lean (kernel lean4-wsl) — la même borne, démontrée plutôt que mesurée |
Ce que 2.8 constate, le lake le prouve : Hoeffding, borne de l’union, ERM, complexité d’échantillon | aucun (arithmétique exacte) |
| 2.8c-Borne-Temoin-Concentration | Carte transversale + compagnon numérique Python — Novikoff, témoin extrémal et Hoeffding bilatérale sur des instances seedées | Mesurer avant de certifier : 2.8c rejoue les trois phénomènes en NumPy ; 2.8b et 2.8d portent les preuves Lean | synthétique seedé |
| 2.8d-Lean-Novikoff-Convergence | Compagnon Lean (kernel lean4-wsl) — la moitié Perceptron du lake, exécutée : Novikoff n·γ² ≤ R², ses deux lemmes, son témoin de saturation |
Le théorème interrogé en direct : #check + #print axioms depuis le lake, dynamique rejouée sur entiers, balayage de marge |
aucun (arithmétique exacte) |
| 2.9-Grokking-Generalisation | Épilogue, amorce du 3.5 — grokking : la généralisation qui arrive en retard (premier réseau de neurones, PyTorch boîte noire) | L’horloge cachée : embeddings rangés en cercle après le grok (ACP + Fourier) | synthétique (a+b) mod 97 |
| 2.9b-GenEFT-Theorie-Effective | Accrétion de 2.9 — GenEFT (Baek, Liu & Tegmark 2024), théorie effective de la généralisation : bits de description, fraction critique, gap inductif, puis dynamique des « repons » | Le ratio des learning rates décide : frontière arctan (Théorème 3), diagramme de phase en pente −1, règle η_dec/η_enc ≲ 10 | synthétique (graphe de connaissances n=30 : mod 3, mod 5, greater-than, biparti) |
| 2.9c-Grokking-Diagrammes-Phases | Accrétion de 2.9 — la cartographie de R02 (Liu, Michaud & Tegmark 2022) : les 4 phases (compréhension, grokking, mémorisation, confusion), la course encoder/decoder, RQI et généralisation par parallélogrammes, grokking MNIST, ticket de loterie aux axes | Le grokking est une zone frontière : carte des phases multi-seed (Table 1 exacte) où le grokking apparaît coincé entre compréhension et mémorisation, et l’accuracy de validation continue qui révèle où vivent les frontières | synthétique (a+b) non modulaire + réel MNIST (1 000 ex., App J) |
| 2.9d-Features-Circulaires-Helice-Nombres | Accrétion de 2.9 — features circulaires des jours/mois (R10, Engels et al.) et hélice des nombres (R07, Kantamneni & Tegmark) sur modèles-jouets white-box : ACP des activations, intervention causale par rotation, FFT des états cachés | La géométrie latente prédit les échecs : une droite à R²=0.974 condamne l’addition linéaire à 6.8 % (le modèle : ~100 %) ; les erreurs se concentrent à ±5 = un tour de l’horloge dominante | synthétique days/months later, (a+b) mod 97, a+b (0..149) |
| 2.9e-MIPS-Extraction-Programme | Chaînon aval du 2.9 — MIPS : extraire le programme qu’un réseau entraîné implémente déjà (Michaud et al. 2024, arXiv:2402.05110) | Du réseau au programme vérifié : états cachés → machine à états → autoencodeur booléen (les \(4!\) assignations essayées) → régression symbolique → ripple-carry adder, vérifié exhaustivement | synthétique s + t sur 6 bits |
| 2.10-Optimisation-Hyperparametres | La méthodologie du réglage : grille, hasard, bayésien (TPE) — et quand s’arrêter | Le budget qui s’aplatit : le bayésien s’installe dès le premier tiers du budget ; le critère d’arrêt économise la moitié des essais | synthétique make_classification (MLP) |
| 2.11-Regularisation-Sparse-LASSO | Régularisation sparse — LASSO (L1, polyèdre) vs Ridge (L2, boule), coord descent, sélection de λ, cas pathologique colinéarité (ElasticNet) | La géométrie décide : polyèdre L1 → sparsity (sélection de variables), boule L2 → shrink continu ; sur features corrélées, LASSO est arbitraire et ElasticNet stabilise | synthétique design_sparse(n, p, k, snr) |
| 2.11b-Proximal-Operators-From-Scratch | Pend direct de 2.11 (LASSO) — opérateurs proximaux : ISTA (forward-backward splitting) et FISTA (inertie de Nesterov, O(1/k²)) pour le Lasso ; sparse recovery synthétique n=200, p=500, k=30 |
Quatre solveurs convergent vers la même solution : ISTA, FISTA, sklearn.Lasso (coord descent) et cvxpy CLARABEL (SOCP) donnent tous ‖x−x*‖₂ ≈ 0.13 ; FISTA gagne ~k fois en itérations vs ISTA |
synthétique (signal sparse gaussien, mesures bruitées) |
| 2.11c-Lasso-SOTA-Comparison | SOTA du bloc LASSO — coordinate descent from scratch (le moteur réel de sklearn.Lasso), LassoCV pour le λ, mise à l’échelle p croissant (500 → 4000) |
Le λ se mesure, il ne se déclare pas : LassoCV retient ~100× le seuil Donoho-Johnstone théorique (λ ≈ 0,25 contre 0,0125) et restitue la parcimonie juste (30 non-nuls, 26/30 du support) là où l’a priori surestime (92) | synthétique (même problème sparse que 2.11b, seed partagé) |
| 2.11d-Optimisation-ADMM-From-Scratch | ADMM from scratch — split β = z, opérateur proximal en brique élémentaire, pré-factorisation Cholesky, balayage du paramètre ρ |
Un seul optimum, plusieurs chemins : sur design corrélé ρ_corr = 0,95 (κ ≈ 80), coord-descente, sklearn et cvxpy coïncident à ~10⁻⁷ et ADMM à 2,1·10⁻³ — exactement sa tolérance d’arrêt ; ρ change la trajectoire, pas la solution |
synthétique (design AR(1) corrélé, formulation β = z scindée) |
| 2.11e-CVXPY-Optimisation | Troisième voie (bloc B.7) — le déclaratif — le problème écrit, pas la méthode : le Lasso en une ligne cvxpy, la reformulation canonique lue sur ce que le solveur reçoit (500 inconnues déclarées → 1200 variables, épigraphe), un problème trois solveurs (CLARABEL, SCS, OSQP), le certificat KKT lu dans les variables duales, λmax = ‖Aᵀb‖∞ calculé par le solveur seul |
Quatre moteurs, un optimum à 10⁻⁶ près : cvxpy, coord descent scratch, ISTA et sklearn coïncident sur P1 ; le déclaratif paie sa généralité à l’échelle mais gagne la course du changement — group Lasso ou forme contrainte sans écrire un nouvel algorithme, convexité certifiée par le ruleset DCP | synthétique (même problème sparse que 2.11b, seed partagé) |
| 2.11f-Comparaison-Optimisation-Convexe | Clôture de la chaîne (bloc B.8) — le tableau croisé bloc A / bloc B : six solveurs Lasso (ISTA, FISTA, ADMM, coord descent, sklearn, cvxpy) re-mesurés dans un même processus sur P1 et deux solveurs SVM (SMO maison vs LIBSVM) sur le terrain de 2.7b/2.7c ; objectif, itérations à unités nommées, LOC à deux portées étiquetées, sondes d’échelle (n et p croissants) |
Le SOTA achète le temps, le from scratch achète la visibilité : mêmes optima et mêmes vecteurs supports partout (certificats croisés, dont l’égalité calculée avec la baseline committée de 2.7b) ; des itérations non comparables d’une ligne à l’autre sans nommer l’unité ; LOC bibliothèque = surface d’appel, jamais l’implémentation | synthétiques des parents (make_moons seed 42 ; P1 sparse seed 42) |
| 2.12-Donnees-Desequilibrees | Classes déséquilibrées — la métrique qui ment (accuracy vs PR), stratégies de rééchantillonnage, seuillage par coût | La courbe PR dit la vérité : sur une classe à ~3 %, la ROC flatte, seule l’average precision rend l’arbitrage visible | synthétique make_classification (~3 % positifs) |
| 2.13-Analyse-Erreurs | Le geste du praticien : diagnostiquer un modèle entraîné (tranches, worst-k, plan d’action) | La poche invisible : 67.6% d’erreur sur ~5% de la population, cachée dans un score global correct (82.2%) | synthétique télécom (churn, incident d’étiquetage) |
| 2.14-Explicabilite-SHAP-LIME-Contrefactuels | Expliquer une décision individuelle : SHAP (arbre + kernel), LIME, contrefactuels DiCE — et leurs limites communes | Additivité exacte vs récits instables : Tree SHAP se vérifie à 1e-16, LIME varie de seed en seed (σ jusqu’à 0.035), le contrefactuel est un autre récit | réel German Credit (credit-g, 1000×21, CSV vendé) |
| 2.14b-XAI-Shap-Attribution-Causal-Bridge | Pont attribution ↔︎ causalité — Kernel SHAP marginal contre Tree SHAP conditionnel sur un DAG explicite (age -> credit_amount -> default), sur l’individu idx=773 ; puis LIME, DiCE et un contrefactuel age=42 |
L’attribution reste une fonction du background dataset : écarts marginal/conditionnel en valeur absolue mais même signe des contributions ; l’additivité se vérifie (base + somme φ = 0.9400 vs P(default | x) = 0.940) ; un contrefactuel (age=42, f(x’) = 0.7200) n’est pas une intervention do(.) — l’exercice 3 (les distinguer) reste à compléter |
| 2.15-Donnee-Comme-Responsabilite-Python | La donnée comme responsabilité — inférence d’appartenance (MIA) menée pour de vrai, confidentialité différentielle : mécanisme de Laplace, DP-SGD écrit à la main puis confronté au SOTA diffprivlib (IBM), datasheet et model card | La protection se mesure, elle ne se déclare pas : la forêt qui mémorise laisse fuir ses données (avantage d’attaque +0.439, AUC 0.719) quand la régression régularisée, qui généralise, retombe à +0.057 ; face à diffprivlib, le DP-SGD maison est « cohérent en tendance, divergent en ampleur » | réel load_breast_cancer |
Épilogue — au-delà du socle scikit-learn. Les huit chapitres ci-dessus posent le socle canonique. Le notebook 2.9 fait un pas de côté vers le deep learning : il entraîne le premier réseau de neurones de la série (PyTorch, quelques minutes sur CPU) pour montrer le grokking — la généralisation qui surgit longtemps après la mémorisation parfaite, un phénomène que la borne PAC (2.8) ne laissait pas prévoir — et réutilise l’ACP du 2.6 pour révéler la structure apprise. Il joue le rôle d’amorce : le traitement canonique — montage réécrit en NumPy pur (gradient à la main), contre-témoin isolant le weight-decay, double descente — est le 3.5 — Phénomènes de généralisation de la série Deep Learning, dont les exercices portent les leviers classiques (weight-decay, seuil de données) ; ceux du 2.9 lui sont propres (horloge, modulus, dimension d’embedding). Son accrétion 2.9b apporte la contrepartie théorique — GenEFT, la théorie effective de la généralisation : la longueur en bits de la relation fixe la fraction critique de données, et la dynamique encodeur/décodeur (les « repons », leur quantité conservée) prédit une frontière arctan entre mémorisation et généralisation qui ne dépend que du ratio des learning rates — le grokking devient un régime calculable. Son accrétion 2.9c fait la cartographie : les quatre phases de l’apprentissage définies par la théorie effective de R02 (Liu, Michaud & Tegmark 2022) — compréhension, grokking, mémorisation, confusion — mesurées sur un toy à decoder appris multi-seed (le grokking y apparaît comme une zone frontière entre compréhension et mémorisation, pas un régime à rechercher), confirmées sur MNIST (App J), puis relues par le ticket de loterie aux axes (App K) — où le ticket se révèle forgé par l’entraînement plutôt qu’hérité de l’initialisation.
La carte des phases du grokking. L’accrétion 2.9c transforme la courbe isolée du 2.9 en cartographie, avec les critères exacts de la Table 1 de R02 (seuils 90 %, retard 10³ steps). Le toy à decoder hard-codé ne peut pas mémoriser : RQI = 1.000 et validation parfaite à toute fraction de données, et la généralisation par parallélogrammes dAcc borne inférieurement l’accuracy réelle (0.609 ≤ 0.890 à 25 % des paires, convergence à 75 %) sans toucher au jeu de validation. Sur le toy à decoder appris (100 runs multi-seed vectorisés en ~36 s), la carte learning-rate-decoder × fraction révèle le grokking comme une seule cellule frontière entre compréhension et mémorisation, sur un paysage d’accuracy continue (0.03 → 0.90) — pas un régime à rechercher, un symptôme de réglage. Sur MNIST (App J : 1 000 exemples, MSE one-hot, tête lente), un seul levier sépare les phases : init ×10 → mémorisation figée (train 1.000, val 0.130 sur 25 000 steps), init standard → compréhension (val 0.905, seuil 60 % franchi au step 500). Et le ticket de loterie aux axes (App K) referme le questionnement du 2.9 : la structure circulaire n’est pas en germe à l’initialisation (corrélation circulaire r = 0.075 ≈ bruit) — le ticket est forgé — mais la solution vit sur peu d’axes : 10 directions sur 32 suffisent à 0.930 d’accuracy (protocole Fig 22 exact : projection sur les n PCs du final, reconstruction, decoder gelé).
Les cercles et l’hélice — la géométrie du latent. Le notebook 2.9d poursuit l’épilogue en remontant d’un cran : si l’horloge du 2.9 est un cercle, ces cercles sont-ils des objets de calcul à part entière — et que deviennent les nombres hors du monde modulaire ? Deux papiers de la même école servent de fil. R10 (Engels et al., ICLR 2025) : les jours et les mois vivent sur des features circulaires irréductibles, causalement actives chez Mistral 7B — tourner la représentation décale la réponse. R07 (Kantamneni & Tegmark) : les entiers vivent sur une hélice — une massue linéaire enroulée d’horloges périodiques — et cette géométrie prédit les performances avant toute prédiction. Sur des modèles-jouets entraînés from scratch (white-box total, kernel GPU
coursia-ml-trainingcomme le 2.8c), le notebook mesure chaque pièce : le cercle des jours, déformé en ACP brute mais causal (rotation 6/7 de tour → +2 jours cohérents 7/7) ; le cercle des mois au même montage ; l’horloge mod-97 rangée à la fréquence dominante k*=35 (R²=0.998 là où l’ACP naïve à la fréquence 1 donne ~0) mais sans plan causal unique (rotation : 0 % — négatif honnête, contrasté avec les LLM du papier) ; le contrepoint P=7 ; l’hélice de l’addition 0..149 avec les horloges mesurées du jouet (T ≈ 2.4/3.4/5.4, pas les {2,5,10,100} héritées de Qwen) ; la punchline de l’annexe E (une droite explique R²=0.974 de la représentation, donc l’addition linéaire échoue : 6.8 % contre ~100 % pour le modèle — le modèle comme code correcteur d’erreurs) ; et l’anatomie des erreurs de l’annexe F (88 % des erreurs à ±5, exactement un tour de l’horloge dominante T=5.36 — le quantum d’erreur d’un modèle qui calcule en trigonométrie). Les exercices portent les indices d’irréductibilité S(f) et Mϵ(f) de R10 et le test du χ² sur quanta arbitraires.
Les compagnons formels et numériques. Le notebook 2.8b tourne sous kernel Lean 4 (
lean4-wsl) et suit module par module la moitié statistique du lakelearning_theory_lean/. Là où 2.8 observe que la borne PAC prédit la courbe d’erreur empirique, 2.8b en rend les étapes exécutables —expect/Markov, MGF de Bernoulli, Hoeffding, borne de l’union, ERM, complexité d’échantillon — avec les noms de déclarations du lake. Le compagnon 2.8d fait de même pour la moitié Perceptron : borne de Novikoffn·γ² ≤ R², lemmes de croissance et témoin de saturation, interrogés en direct souslean4-wsl, avec une dynamique rejouée sur entiers. Entre eux, 2.8c reste la carte transversale et le compagnon numérique Python : il rejoue en NumPy la borne, le témoin et Hoeffding sous kernelcoursia-ml-training. Ainsi, 2.8c mesure sur des instances explicites tandis que 2.8b et 2.8d certifient les énoncés généraux. C’est la même paire empirique/formel que la série ML annonce dans sa section Théorie formelle (Lean) (EPIC #11703).
Au-delà du socle — classes déséquilibrées. Le notebook 2.12 sort du cadre des huit chapitres pour traiter le cas où la classe d’intérêt est rare (fraude, défaut, anomalie, régime de marché). La ROC y apparaît comme une métrique qui ment — sur une classe à ~3 %, le taux de faux positifs reste bas par construction — et la courbe Precision-Recall comme la métrique honnête. Cinq stratégies y sont comparées sur le même protocole multi-seed (
class_weight, sous-échantillonnage, sur-échantillonnage naïf, SMOTE, et « ne rien faire »), avec la matrice de confusion et la courbe PR pour chacune ; le tableau final montre qu’aucune stratégie ne domine partout — le choix dépend du coût d’un faux négatif face à un faux positif. Le seuil optimal n’y est pas0.5mais celui qui minimise le coût attendu (pont vers la théorie de la décision), et le piège de la fuite SMOTE-avant-split y est démontré puis corrigé. Le geste du praticien. Le notebook 2.13 ferme la boucle : mesurer (2.4, 2.5) ne suffit pas, il faut diagnostiquer. Sur un modèle au score global correct (accuracy 82.2%, aucune alerte), l’analyse par tranches révèle une poche à 67.6% d’erreur — 115 étiquettes d’entraînement corrompues par un incident d’intégration, invisibles de toute métrique globale. Le workflow : tranches → worst-k (les deux côtés de la matrice) → confiance → cause → correction mesurée (−42.3 points sur la poche) — ce qui distingue un praticien d’un tourneur d’hyperparamètres (le tuning, lui, ne répare rien : 67.6% → 67.6%). Ouvrir la boîte noire, honnêtement. Le notebook 2.14 prend le relais du diagnostic : expliquer une décision individuelle — pourquoi ce dossier-là, à 70.7% de risque ? Trois moteurs réels consommés (pas de réimplémentation jouet) : Tree SHAP (exact, additivité vérifiée à 1.1e-16), Kernel SHAP (espace brut, le pipeline comme boîte noire — même top-5, reconstruction exacte), LIME (surrogate local linéaire, R² 0.496) et DiCE pour les contrefactuels (3 plans d’action, probabilité ramenée de 0.707 à ~0.35-0.40). Le fil rouge honnête : ces outils produisent des récits, pas des causes — LIME instable de seed en seed (σ jusqu’à 0.0352), la base de référence SHAP déplace la valeur de base (0.3135 vs 0.2132) sans changer le classement, et Rudin 2019 rappelle qu’un modèle intrinsèquement interprétable évite le problème. Ponts posés vers Causal-Bridges/ (SHAP n’est pas de la causalité), PyMC-05 et Infer-5 (inférence causale), Tweety-11 (argumentation). La donnée comme responsabilité. Le notebook 2.15 referme le triptyque du praticien : diagnostiquer (2.13), expliquer (2.14), puis protéger les personnes derrière les données. L’attaque par inférence d’appartenance y est menée pour de vrai : la confiance du modèle en ses exemples d’entraînement sert de signal, et la forêt qui mémorise offre un avantage d’attaque de +0.439 (AUC 0.719) là où la régression régularisée, qui généralise, retombe à +0.057 — la première protection contre la fuite est la généralisation elle-même. Vient ensuite la confidentialité différentielle : le mécanisme de Laplace (bruit calibré par le budget epsilon), le DP-SGD écrit à la main (clipper chaque gradient, bruiter chaque lot, composer le budget), la courbe utilité/confidentialité mesurée, puis la confrontation au SOTA diffprivlib consommé tel quel — verdict honnête du notebook : cohérent en tendance, divergent en ampleur. La datasheet (Gebru et al. 2018) et la model card (Mitchell et al. 2019) ferment le parcours : sur un jeu de données médical, documenter provenance, limites et usages est une responsabilité, pas une formalité.
La méthodologie du réglage. Le notebook 2.10 assume le rôle que le 2.13 laisse en creux — celui du « tourneur d’hyperparamètres » — et le fait honnêtement : un espace de recherche mixte (continu, discret, conditionnel) sur un MLP, un budget commun de 45 essais, et les trois stratégies superposées sur la courbe meilleur score vs nombre d’essais (médiane sur 3 graines, bande min–max). La grille exhaustive y explose en dimension (6300 configurations, 0.7 % couvertes), le hasard tient l’argument de couverture de Bergstra & Bengio, et le search bayésien (TPE/Optuna, consommé, pas réécrit) s’installe dès le premier tiers du budget. Le vrai concept-phare est le critère d’arrêt : un gain marginal explicite (arrêter si le meilleur n’a pas gagné δ sur les K derniers essais) qui économise 21 à 31 essais sur 45 pour un coût de 2 à 8 millièmes d’AUC. C’est la méthodologie transverse que réutilisent les sweeps du ML-Training-Pipeline et l’ablation du Lab14.
La régularisation sparse. Le notebook 2.11 comble le trou que la série laissait en suspens entre 2.3c (Ridge L2 en grande dimension) et 2.10 (méthodologie du réglage, où LassoCV apparaissait en passant) : la géométrie de la contrainte — boule L2 pour Ridge (shrink continu) vs polyèdre L1 pour LASSO (sparsity, sélection de variables). Sur 50 features dont 5 vraiment actives (SNR ≈ 4), LASSO retrouve ~80-100 % du support actif en 5-7 coefficients non-nuls, Ridge distribue les poids sur les 50. La coord descent from-scratch (10-50 itérations, soft-thresholding
S(z,λ) = sign(z)·max(|z|-λ, 0)) est validée à 1e-3 près contresklearn.linear_model.Lasso. LassoCV sélectionne λ automatiquement (grille logspace + CV 5 folds, sub-seconde). Le cas pathologique : sur 3 paires de features corrélées à ρ = 0.7, LASSO devient arbitraire (alterneb₀ = 0oub₁ = 0selon le tirage) ; ElasticNet (l1_ratio = 0.7) distribue le poids sur les deux features de chaque paire — la règle pratique : ElasticNet dès que des features corrélées sont attendues. Le chemin de régularisationβ(λ)trace l’arrivée progressive des features : λ grand → 0 non-nuls, λ intermédiaire → les 5 vraies features, λ petit → bruit. Le tout avec 3 exercices (C.1 stubs) sur le λ qui tue la sélection, le SNR faible où Ridge bat LASSO en MSE, et la stabilité d’ElasticNet sur paires corrélées.
Les opérateurs proximaux. Le notebook 2.11b prend le relais algorithmique que le 2.11 (LASSO coord descent) laissait en suspens : comment minimiser un objectif composite
f(x) + λ·‖x‖₁oùfest lisse et‖x‖₁ne l’est pas ? ISTA alterne un pas de gradient surfet un soft-thresholdingS_λ(x) = sign(x)·max(|x|−λ, 0); FISTA ajoute l’inertie de Nesterov et passe d’une convergenceO(1/k)àO(1/k²). Le notebook pose un problème de sparse recovery canonique (signalx* ∈ ℝ^500àk=30coefficients actifs,n=200mesures bruitées, ration/p = 0.40) et confronte quatre solveurs sur le même problème : ISTA from-scratch (numpy), FISTA from-scratch (numpy),sklearn.Lasso(coordinate descent) etcvxpyCLARABEL (SOCP, vérité terrain). Mesure : les quatre convergent vers la même solution à‖x−x*‖₂ ≈ 0.13près (rappel du support ≈ 93 %), FISTA gagne un facteur~ken itérations vs ISTA, etsklearn.Lassoreste le plus rapide (coord descent par colonne). Trois exercices (C.1 stubs) ferment le notebook : soft-thresholding vectorisé sur matrice, ISTA avec backtracking de Lipschitz (Beck & Teboulle 2009 Algo 3.1), et FISTA sur Elastic Net proximal (L1 + ridge). Pont direct vers 2.11 (Lasso coord descent) et 2.7b (SMO, autre solveur d’un problème dual).
Le λ mesuré, le SOTA libéré. Le notebook 2.11c referme le geste SOTA côté Lasso, symétrique du 2.7c côté SVM : la coordinate descent from scratch y est écrite comme le moteur réel de
sklearn.Lasso(pas une réimplémentation jouet — le même algorithme,α = λ/nprès), puisLassoCVprend le relais pour le choix de λ. La mesure phare est un désaveu de l’a priori : le seuil universel de Donoho-Johnstone (λ = 0.0125) surestime le support (92 non-nuls, vérité : 30), quand la CV retientλ ≈ 0.25— cent fois le théorique — et restitue la parcimonie juste (30 non-nuls, 26/30 du support). Les trois moteurs (ISTA, CD scratch, sklearn) coïncident à l’objectif près (10⁻⁶) et à4·10⁻³en solution, et l’échellep(500 → 4000) montre le quand SOTA : àp=4000, ISTA vectorisé et sklearn convergent au même ordre (~0,2 s) quand la boucle Python paie ~1 s — le from scratch est la compréhension, le SOTA est l’échelle.
ADMM : découper pour régner. Le notebook 2.11d complète la famille en réécrivant le Lasso sous forme scindée
min ½‖Xβ−y‖² + λ‖z‖₁ sous β = z: chaque rôle a son update (β prend le data-fit via une Cholesky pré-factorisée, z prend la parcimonie via le soft-thresholding — la même brique proximale que 2.11b, ici enargminpar coordonnée), et le paramètreρarbitre la vitesse. Le résultat central est un certificat croisé : sur un design corrélé AR(1) (ρ_corr = 0,95, conditionnement κ ≈ 80), coord-descente,sklearnetcvxpy(l’arbitre) coïncident à ~10⁻⁷, et ADMM à2,1·10⁻³— précisément sa tolérance d’arrêt. Le balayage deρmontre le concept honnête :ρchange la trajectoire (budget d’itérations, palier dezà zéro tant queλ/ρdomine), jamais la solution — l’optimum d’un problème convexe est unique. Trois exercices (trajectoiresβ(ρ),ρempirique sur cas pathologique, extension ridge) ferment le notebook. Pont direct vers 2.11b (proximal) et 2.7b (autre split d’un problème dual).
Le déclaratif, puis la synthèse — la chaîne optimisation convexe se referme. Le notebook 2.11e prend le troisième chemin : on n’écrit plus l’algorithme du tout — on écrit le problème (
cvxpy), on choisit le solveur par son nom (CLARABEL, SCS, OSQP), et le ruleset DCP refuse une formulation non convexe avant même de la résoudre. Son certificat : quatre moteurs (cvxpy, coord descent from scratch, ISTA,sklearn) atteignent le même objectif à10⁻⁶près sur P1, la dualité sort des variables duales sans être recodée, etλmax = ‖Aᵀb‖∞se calcule par le solveur seul — la contrepartie est le prix de la généralité (500 inconnues déclarées deviennent 1200 variables canoniques), la valeur est la course du changement : un group Lasso ou une forme contrainte sans écrire un nouvel algorithme. La clôture 2.11f assemble enfin le tableau croisé demandé par l’EPIC (#16061, bloc B.8) : six solveurs Lasso et deux solveurs SVM re-mesurés dans un même processus, mêmes graines, mêmes normalisations, sous un contrat de comparaison explicite — itérations à unités nommées (appels d’examen vs sélections de working set vs epochs : elles ne s’additionnent pas), LOC à deux portées étiquetées (corps de solveur défini dans le notebook vs surface d’appel publique), sondes d’échelle ennet enp. Le verdict mesuré : partout les mêmes optima et les mêmes vecteurs supports (certificats croisés, dont l’égalité calculée avec la baseline committée de 2.7b) — le SOTA achète le temps et l’échelle, le from scratch achète la visibilité (α, caches d’erreurs, résidus, compteurs dans leur propre unité).
Le SOTA côté SVM, la boîte noire ouverte. Le notebook 2.7c applique au SVM la règle pratique de l’EPIC optimisation convexe (#16061, bloc B.5) : from scratch pour comprendre, SOTA pour produire — et il montre que les deux se certifient mutuellement. Sur le même terrain que 2.7b (graine près), LIBSVM (
sklearn.svm.SVC) rend exactement le même classifieur : même accuracy (0,967), mêmes 48 supports, écart de score de décision déjà mesuré à 0,005 en 2.7b — mais trois ordres de grandeur plus vite (fit sub-milliseconde contre 1,19 s de la boucle Python). Le geste distinctif : le dual queSVCne rend pas se reconstruit depuisdual_coef_(contrainteΣ α_i y_iexacte à10⁻¹⁶), et le gap de dualité comme les violations KKT se mesurent sur LIBSVM exactement comme sur la SMO maison — les deux solveurs s’arrêtent àtol = 10⁻³près, chacun avec son critère. Le notebook détaille aussi ce que LIBSVM fait que la cascade de Platt ne fait pas (working set au second ordre, shrinking, cache de noyau) et l’exercice 3 pose le geste de production :GridSearchCVsurC × gamma.
La grande dimension. Le notebook 2.3c ouvre le régime que le 2.3 ne faisait qu’annoncer (VIF 52) : p = 205 variables pour n = 120 observations. Une direction de X ne vaut pour la prédiction que par Cov(Y, Xu) — pas par Var(Xu) : l’ACP (donc la PCR) trie par Var et paie 38 composantes de leurre avant d’atteindre le signal ; la PLS trie par Cov et le capture en 5 composantes (RMSE test 0.244 contre 0.942 à budget égal), loadings à l’appui. Ridge (λ par CV) rend le problème déterminé et referme la promesse du 2.3. Le verdict est vérifié sur dix graines (section 9bis, hyperparamètres re-choisis à chaque tirage) : PLS et PCR devant quand le signal vit hors des grandes variances, ridge devant dans le régime aligné, OLS min-norme dépassée 8 fois sur 10 puis 6 fois sur 10.
La frontière, signature de l’hypothèse. Le notebook 2.3d tisse le pont génératif que la série laissait en creux entre 2.3 (OLS vs logistique) et 2.3b (hypothèse d’indépendance) : il dérive la frontière depuis la log-densité gaussienne et montre que c’est l’hypothèse de covariance — partagée vs propre — qui décide linéaire ou quadratique. Mesure phare : sur des régimes contrôlés, QDA devance LDA de +5.7 pts dès que les covariances diffèrent ; en grande dimension, QDA s’effondre (
nan) dès quedrivalise avecn_c(2 classes,n_c=30:nanàd=30), là où LDA 0.975 et Naive Bayes 0.994 survivent. Le concept-phare n’est pas une course d’accuracy mais la signature d’une hypothèse — et le prix de la flexibilité (O(d²)pour QDA) devient une singularité. Cross-référé à 2.3b et 2.6.
Aperçu — les concepts-phare en images
La série ne se contente pas d’ajuster des modèles : chaque chapitre rend visible un concept distinct, dans une figure extraite des sorties réelles des notebooks. Les voici replacées dans leur progression pédagogique — chacune illustre la capacité distinctive d’une technique et l’exerce sur un cas non trivial.
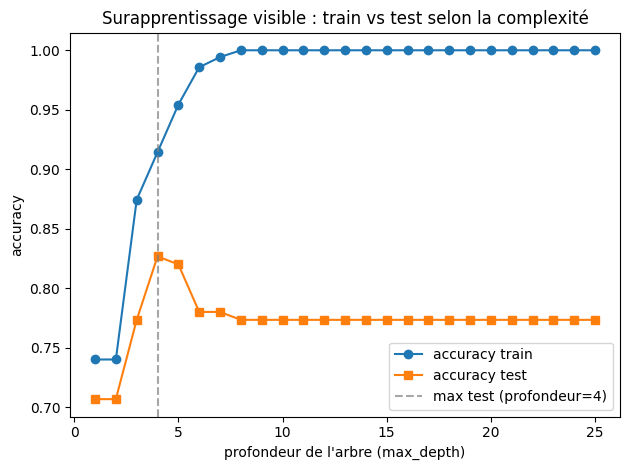
2.1 — Le surapprentissage, rendu observable. On balaie la profondeur d’un arbre de décision de 1 à 25 et l’on trace, côte à côte, le score d’entraînement et le score de test. Tant que la profondeur reste modeste, les deux courbes suivent la même trajectoire ; passé un seuil, elles se séparent, et l’écart ne cesse de grandir à mesure que le modèle mémorise le bruit de l’entraînement. Ce geste diagnostique — voir le surapprentissage plutôt que le subir — est le fil rouge du workflow ML.
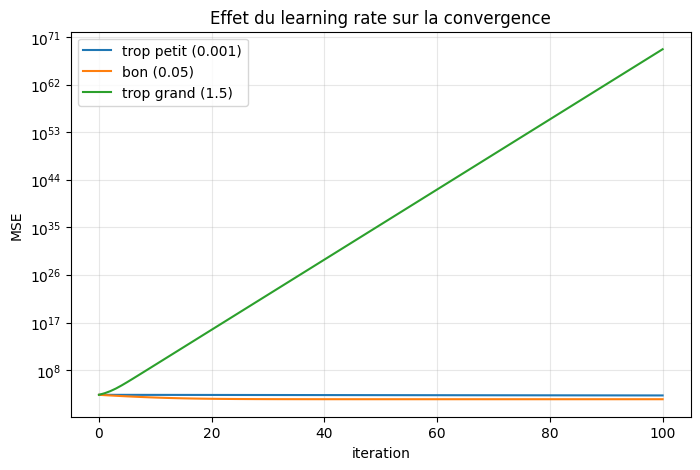
2.2 — Trois régimes de learning rate. On ouvre la boîte noire de fit() en lançant la descente de gradient sur la même fonction de coût avec trois pas d’apprentissage. L’un converge trop lentement, le second trouve le minimum sans errer, le troisième oscille puis s’envole : la frontière entre une bonne convergence et la divergence tient à un seul scalaire, le learning rate.
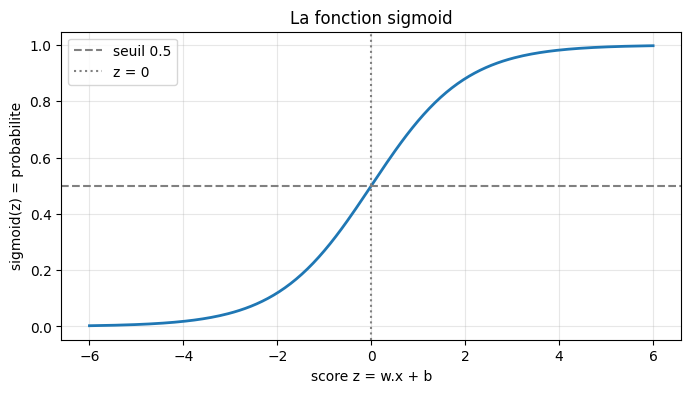
2.3 — Une sigmoïde plutôt qu’une droite. À partir des mêmes étiquettes binaires, on ajuste d’abord une droite (moindres carrés, OLS), puis une sigmoïde (maximum de vraisemblance, MLE). La droite sort du cadre dès qu’elle doit prédire une probabilité ; la sigmoïde écrase le score linéaire dans [0, 1] et donne à chaque point sa probabilité d’appartenir à la classe — c’est tout l’écart entre régression linéaire et logistique.
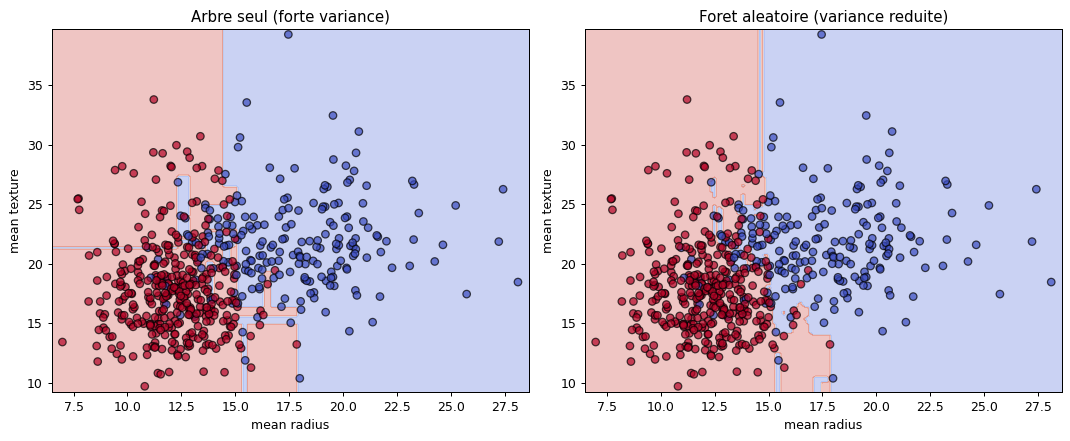
2.4 — La frontière, de l’escalier au lissage. Sur le jeu de cancer du sein, on trace la frontière de décision d’un arbre unique, puis celle d’une forêt aléatoire. L’arbre seul découpe l’espace en escaliers rigides, sensible au bruit ; l’ensemble moyenne ces coupes et lisse la frontière. C’est la réduction de variance rendue géométrique — la raison pour laquelle les forêts battent l’arbre isolé.
2.4b — Le comité qui concentre ses poids. AdaBoost (SAMME) reconstruit à la main sur le même jeu que 2.4 : chaque tour retient le stump d’erreur pondérée minimale, lui donne un vote α = ½ln((1−ε)/ε), puis fait monter le poids des exemples mal classés — et descendre les autres. La figure montre la conséquence : la masse des poids migre vers les exemples difficiles (les dix plus lourds portent 17 % de la masse au tour 1, 46 % au tour 20), pendant que la frontière du comité émerge en escalier de la superposition des demi-plans pondérés. Le comité écrit à la main classe le jeu de test à l’identique de sklearn.ensemble.AdaBoostClassifier (0,959, accord des prédictions 1,000) — la réimplémentation est validée par recoupement avec la référence.
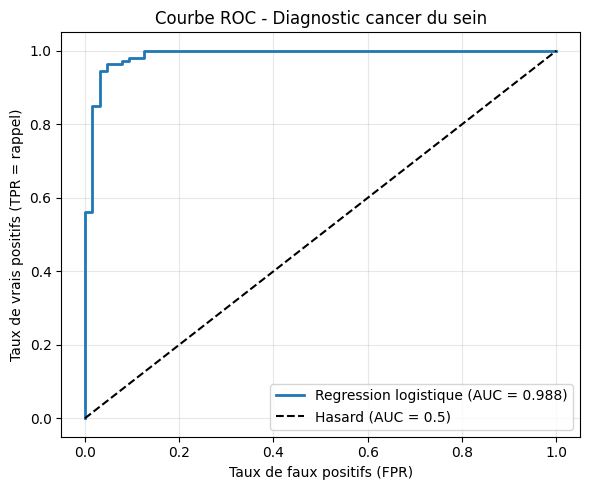
2.5 — Le coût d’un seuil. La courbe ROC balaye tous les seuils de décision possibles et échange les faux positifs contre les faux négatifs ; l’aire sous la courbe (AUC) résume ce compromis en un nombre. Mais le bon seuil n’est pas celui qui maximise l’AUC : il dépend du coût métier d’un faux négatif (rater un cancer) face à un faux positif. La figure impose cette lecture économique de la décision.
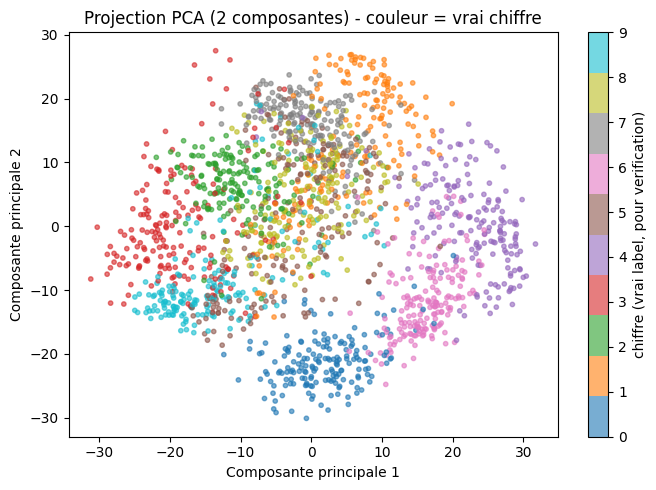
2.6 — La structure retrouvée sans étiquettes. Sur les chiffres manuscrits, sans jamais fournir les étiquettes, l’analyse en composantes principales projette les images en deux dimensions — et les amas qui émergent suivent déjà les classes de chiffres. C’est la promesse de l’apprentissage non supervisé : retrouver la structure latente que les étiquettes confirmeraient a posteriori.
2.7b — Le solveur écrit à la main retrouve la bibliothèque. Sur les deux demi-lunes, on écrit SMO (l’algorithme de Platt) à la main, puis on superpose sa frontière de décision à celle de sklearn.svm.SVC. Les deux panneaux montrent la même frontière, les mêmes marges à −1 / 0 / +1 et les mêmes régimes de vecteurs supports (non-support, 0 < α < C sur la marge, α = C en slack actif — point dans la marge ou mal classé). Le concept-phare est le contrôle : le biais appris à la main et celui de sklearn coïncident à 4·10⁻⁴, l’écart maximal de score de décision reste à 5·10⁻³ au plus sur les deux ensembles (0,0049 en test, 0,0050 en entraînement), et le gap de dualité chiffre l’écart à l’optimum à environ 3·10⁻³ — un recoupement empirique entre deux solveurs aux heuristiques distinctes, dans un cas où l’optimum dual est unique (Gram RBF définie positive sur des points deux à deux distincts).
Chaque figure renvoie au notebook dont elle est extraite ; la provenance détaillée (cellule, output, poids, alt-text) figure dans assets/readme/MANIFEST.md.
L’arc pédagogique
Le fil rouge de la série : on pose le workflow, on ouvre les boîtes noires (descente de gradient, fonction de lien), on élargit la famille de modèles (linéaire/logistique, arbres, ensembles, SVM à noyau et k-NN), on formalise l’évaluation (biais-variance, validation croisée, ROC, calibration des probabilités), puis l’on bascule en non supervisé (clustering, ACP), avant de clore par le cadre théorique (théorie PAC, dimension VC). Chaque notebook rend visible un concept-phare distinct.
flowchart TD
    subgraph SUP["Apprentissage supervisé (2.1 à 2.5, 2.7)"]
      direction TB
      A["2.1 - Workflow ML<br/>split, fit, predict, évaluer<br/>surapprentissage visible (sweep max_depth)"]
      B["2.2 - Descente de gradient<br/>ouvrir la boîte noire de fit()<br/>3 learning rates : lent / bon / divergeant"]
      C["2.3 - Régression linéaire et logistique<br/>OLS vs MLE<br/>droite vs sigmoïde sur mêmes labels"]
      D["2.4 - Arbres, forêts, ensembles<br/>au-delà du linéaire<br/>réduction de variance (frontière lisse)"]
      E["2.5 - Biais-variance, CV, ROC<br/>évaluer rigoureusement<br/>ROC + coût du seuil (FN vs FP)"]
      E2["2.5b - Calibration des probabilités<br/>discrimination vs calibration<br/>reliability diagram, ECE, Brier"]
      G["2.7 - SVM à noyau et k-NN<br/>modèles non paramétriques<br/>kernel trick (linéaire vs RBF)"]
      M["2.7b - SMO from scratch (accrétion de 2.7)<br/>écrire le solveur à la main<br/>sous-problème 2D, KKT, gap de dualité"]
      P["2.7c - SVM SOTA : LIBSVM sous le capot<br/>dual reconstruit, working set au second ordre<br/>même optimum que 2.7b, trois ordres de grandeur plus vite"]
      S["2.11 - Régularisation sparse<br/>LASSO L1 vs Ridge L2, coord descent<br/>la géométrie décide"]
      N["2.11b - Proximal operators (relais de 2.11)<br/>ISTA / FISTA, soft-thresholding<br/>sparse recovery, comparaison sklearn + cvxpy"]
      Q["2.11c - Lasso SOTA : LassoCV et l'échelle<br/>le λ mesuré par CV, coordinate descent libérée<br/>trois moteurs, un seul optimum"]
      R["2.11d - ADMM from scratch<br/>split β = z, proximal en brique élémentaire<br/>ρ change le chemin, pas la solution"]
      A --> B --> C --> D --> E --> E2 --> G
      G -. "sous le capot : le solveur écrit à la main" .-> M
      M -. "le SOTA certifie le from scratch" .-> P
      S --> N --> Q
      N -. "même brique prox, autre découpage" .-> R
    end
    subgraph UNSUP["Apprentissage non supervisé (2.6)"]
      F["2.6 - Clustering et ACP<br/>travailler sans étiquettes<br/>structure retrouvée (PCA 2D + reconstruction)"]
    end
    H["2.8 - Théorie PAC<br/>sample complexity, dimension VC<br/>la borne prédit l'empirique"]
    I["2.9 - Grokking (épilogue)<br/>la généralisation en retard<br/>premier réseau de neurones, l'horloge cachée"]
    I2["2.9c - Diagrammes de phases (accrétion de 2.9)<br/>compréhension / grokking / mémorisation / confusion<br/>course encoder-decoder, loterie aux axes"]
    I3["2.9d - Features circulaires et hélice des nombres<br/>jours/mois : cercles causaux (R10)<br/>hélice : la géométrie prédit l'échec (R07)"]
    E -. "plus d'étiquettes" .-> F
    E -. "cadre théorique" .-> H
    H -. "au-delà du socle : deep learning" .-> I
    I -. "cartographier les régimes" .-> I2
    I2 -. "au-delà de l'ACP : cercles causaux, hélice, anatomie des erreurs" .-> I3
    J["2.13 - Analyse d'erreurs (praticien)<br/>diagnostiquer un modèle entraîné<br/>tranches, worst-k, plan d'action"]
    E -. "après les métriques : diagnostiquer" .-> J
    O["2.14 - Explicabilité XAI (SHAP, LIME, contrefactuels)<br/>expliquer une décision individuelle<br/>additivité exacte vs récits instables"]
    J -. "après le diagnostic : expliquer la décision" .-> O
    K["2.10 - Optimisation d'hyperparamètres (méthodologie)<br/>grille, hasard, bayésien (TPE)<br/>budget, gain marginal, critère d'arrêt"]
    E -. "après l'évaluation : régler" .-> K
    L["2.3c - Régression en grande dimension (p >> n)<br/>ridge, PCR, PLS<br/>Var ≠ prédictivité, verdict sur 10 graines"]
    C -. "quand p >> n : régulariser / réduire" .-> L
    F -. "ses composantes, orientées ou non vers la cible" .-> L
Pédagogie
Chaque notebook suit les mêmes conventions :
- Concept-phare rendu visible. Plutôt qu’un seul ajustement dégénéré, chaque notebook pose une démonstration non-triviale qui exerce la capacité distinctive de la technique (le compromis biais-variance, le choix du learning rate, l’effet du seuil de décision) et la rend lisible dans une figure réelle.
- Exemples résolus et exercices cohabitent. Les cellules d’exemple (solutions complètes) ne sont jamais stubbées ; les cellules d’exercice sont laissées à compléter (
# TODO etudiant), avec indices et# Etape N. Le notebook s’exécute de bout en bout même exercices non complétés (jamais d’erreur volontaire). - ≥ 3 exercices par notebook, répartis dans le flux, chacun précédé d’un énoncé avec objectif et indices.
- Citations ancrées. Chaque concept fondateur renvoie à son article canonique (blocknote inline
> **Référence.**+ cellule## Referencesfinale avec glose en français). - Sorties réelles committées. Les notebooks sont exécutés via papermill (kernel
python3, environnementcoursia-ml-training), outputs etexecution_countinclus — la preuve d’exécution fait partie du livrable.
Objectifs d’apprentissage (série)
À l’issue de la série, l’étudiant sait :
Mettre en place un workflow ML complet (séparation train/test, ajustement, prédiction, métrique) et diagnostiquer le surapprentissage.
Ouvrir la boîte noire de l’optimisation : ce que minimise la descente de gradient, et pourquoi le learning rate contrôle la convergence.
Choisir un modèle linéaire ou logistique selon la nature de la cible (continue vs binaire), et interpréter les coefficients (OLS, MLE, odds ratios).
Aller au-delà du linéaire avec les arbres et les ensembles, et comprendre la réduction de variance qu’apportent les forêts.
Évaluer rigoureusement : compromis biais-variance, validation croisée k-fold, courbe ROC / AUC, choix de seuil selon le coût des erreurs, et calibrer les probabilités (reliability diagram, ECE, Brier — pourquoi 0.87 n’est pas 87 % de chances, 2.5b).
Travailler sans étiquettes : regrouper (KMeans, méthode du coude) et réduire la dimension (ACP, variance expliquée).
Aller au-delà des modèles paramétriques : SVM (maximisation de la marge, kernel trick, vecteurs supports) et k plus proches voisins, et comprendre pourquoi la standardisation devient indispensable.
Formaliser le cadre théorique : théorie PAC (Valiant 1984), complexité d’échantillon
m ≥ (1/ε)(ln|H| + ln(1/δ)), dimension VC (Vapnik-Chervonenkis 1971), borne de Novikoffn ≤ (R/γ)²sur le perceptron (2.8d) — combien d’exemples suffisent pour généraliser et combien d’erreurs coûte l’apprentissage, et le pont entre borne théorique et erreur empirique.Diagnostiquer un modèle entraîné : analyse par tranches (heatmap tranches × métrique, effectifs lus), inspection worst-k des deux côtés de la matrice, erreurs affirmées vs hésitantes (pont vers la calibration, 2.5b), et plan d’action cause → remède dont le gain est mesuré par tranche (2.13).
Régler les hyperparamètres honnêtement : poser un espace de recherche mixte (continu, discret, conditionnel), mesurer pourquoi la grille exhaustive explose en dimension, lire l’argument de couverture du hasard, consommer un search bayésien (TPE/Optuna), et s’arrêter sur un critère de gain marginal explicite — budget, multi-seed, médiane (2.10).
Régulariser et réduire en grande dimension : comprendre pourquoi OLS devient indéterminée quand \(p \gg n\) (rang \(< p\), deux solutions exactes), ce que la pénalité ridge (\(\lambda\) par CV) change, la différence entre composantes ignorantes de la cible (PCR) et supervisées (PLS), et re-vérifier tout verdict sur plusieurs graines — la min-norme perd 8/10 et 6/10 selon le régime (2.3c).
Prérequis
- NumPy et Pandas : manipulation de tableaux et DataFrames (
01-PythonForDataScience). - Notions de base : fonction, dérivée, variance, probabilité.
Suite logique
Cette série est le référent manuel des labs agentic qui suivent. Une fois le socle ML posé, le track Track1-LangChain (LangChain) et Track2-GoogleADK (Google ADK) demandent à des agents LLM de produire ce même type de pipeline — la valeur de ce qu’ils génèrent ne se juge qu’au regard de ce socle.
Références transverses
Les citations canoniques ancrées dans la série (cellule ## References de chaque notebook) incluent : Mitchell 1997 (généralisation), Cauchy 1847 (descente de gradient), Nelder & Wedderburn 1972 (modèles linéaires généralisés), Cox 1958 (régression logistique), Breiman et al. 1984 (CART), Breiman 2001 (forêts aléatoires), Friedman 2001 (gradient boosting), Stone 1974 (validation croisée), Bradley 1997 (AUC), Brier 1950 (score de Brier), Niculescu-Mizil & Caruana 2005 (calibration par famille de modèles), Platt 1999 (Platt scaling), Zadrozny & Elkan 2002 (régression isotonique), Guo et al. 2017 (ECE, temperature scaling), MacQueen 1967 (k-means), Pearson 1901 (ACP), Cortes & Vapnik 1995 (réseaux de vecteurs supports), Platt 1998 (Sequential Minimal Optimization — a fast algorithm for training support vector machines), Fan, Chen & Lin 2005 (sélection du working set au second ordre), Chang & Lin 2011 (LIBSVM), Cover & Hart 1967 (k plus proches voisins), Valiant 1984 (théorie PAC), Vapnik & Chervonenkis 1971 (dimension VC), Novikoff 1962 (convergence du perceptron), Bergstra et al. 2011 (TPE), Bergstra & Bengio 2012 (random search), Akiba et al. 2019 (Optuna), Hoerl & Kennard 1970 (ridge), Tibshirani 1996 (LASSO), Zou & Hastie 2005 (elastic net), Donoho & Johnstone 1994 (seuil universel), Beck & Teboulle 2009 (ISTA/FISTA), Friedman, Hastie & Tibshirani 2010 (glmnet, coordinate descent), Boyd et al. 2011 (ADMM), Wold 1975 (NIPALS/PLS), de Jong 1993 (SIMPLS), Frank & Friedman 1993 (continuum ridge/PCR/PLS), Jolliffe 2002 (ACP), Hastie/Tibshirani/Friedman 2009 (The Elements of Statistical Learning) et Pedregosa et al. 2011 (scikit-learn).
Conclusion — ce que vous emportez
Au terme des huit chapitres, le machine learning supervisé et non supervisé n’est plus une suite d’appels fit() opaques mais un paysage cartographié. Vous savez désormais ce que minimise un modèle (moindres carrés ou vraisemblance), comment il le minimise (la descente de gradient et la sensibilité au learning rate), pourquoi il sur- ou sous-apprend (le compromis biais-variance), et combien d’exemples il faut pour généraliser (la borne PAC, la dimension VC) et combien d’erreurs peut coûter l’apprentissage (la borne de Novikoff, prouvée et saturée en 2.8d). Vous savez aussi élargir la famille au-delà du linéaire (arbres, ensembles, SVM à noyau, k plus proches voisins), travailler sans étiquettes (clustering, ACP), et juger une décision au regard du coût réel de ses erreurs (courbe ROC, choix de seuil) et de la fiabilité de ses probabilités (calibration, ECE).
Le fil rouge
La série s’ouvrait sur une thèse : on ne peut juger ce qu’un agent LLM produit comme pipeline scikit-learn que si l’on sait soi-même ce que ce pipeline fait. Ce socle vient de fournir ce référent. Là où un lab agentic vous montrera un agent appeler RandomForestClassifier().fit(X, y) puis afficher une AUC flatteuse, vous lisez désormais cet enchaînement d’un œil critique : la séparation train/test est-elle honnête (pas de fuite de données) ? La métrique est-elle adaptée au déséquilibre des classes ? Le seuil de décision correspond-il au coût métier des faux négatifs ? L’évaluation repose-t-elle sur une validation croisée ou sur un seul découpage chanceux ? Le socle rend l’agent jugeable — et c’est exactement la compétence que les tracks agentic suivants présupposent acquise.
Pour prolonger
- Approfondir la théorie : Hastie, Tibshirani & Friedman, The Elements of Statistical Learning (2009) reprend et formalise l’ensemble de ces chapitres ; le guide utilisateur scikit-learn (Pedregosa et al. 2011) en est le prolongement pratique direct.
- Exercer le jugement : reprenez un notebook des tracks Track1-LangChain ou Track2-GoogleADK et confrontez le pipeline produit par l’agent aux quatre questions ci-dessus — c’est le meilleur exercice de consolidation, car il met le socle au travail.
- Vers le deep learning et le RL : la descente de gradient (2.2) et la notion de capacité d’un modèle (2.8) sont les deux fondations directement réinvesties par les réseaux de neurones ; l’épilogue 2.9 fait ce premier pas (un réseau de neurones qui grokke, entraîné en quelques minutes sur CPU), et la série RL montre cette même descente de gradient à l’œuvre dans l’apprentissage par renforcement profond (DQN, PPO).
Licence
Voir la licence du repository principal.