Serie : Post-Training SOTA 2024-2025 (Epic #1742, sub-issue #1756) Pre-requis : PT-01 (intro) et PT-02 (SFT baseline) recommandes Objectifs pedagogiques : 1. Comprendre la formule du loss DPO et son lien avec le modèle de Bradley-Terry 2. Savoir pourquoi DPO contourne le reward modeling explicite de RLHF classique 3. Implementer trl.DPOTrainer sur des paires chosen/rejected 4. Evaluer la préférence accuracy : frequence ou le modèle prefere chosen > rejected 5. Identifier les 4 pieges classiques du DPO en pratique
Reference cle : Rafailov et al., “Direct Préférence Optimization: Your Language Model is Secretly a Reward Model” (NeurIPS 2023), arXiv:2305.18290
1. Le loss DPO — de RLHF a l’optimisation directe
Rappel — RLHF classique (3 étapes)
Étape
Objectif
Cout
1. SFT
Pre-entrainer le modèle sur des instructions
GPU moderate
2. Reward Model
Entrainer un modèle a scorer chosen > rejected
GPU eleve (2 modèles)
3. PPO
Optimiser la policy contre le reward model + KL penalty
GPU très eleve (4 modèles)
Le DPO elimine l’étape 2 (reward model) et remplace l’étape 3 par un loss classification binaire direct.
\(\beta\) = coefficient de regularisation KL (typique 0.1)
\(\sigma\) = sigmoid
Intuition : le loss maximise l’ecart de log-probabilites entre chosen et rejected, normalise par la reference. Le modèle apprend a preferer chosen SANS jamais calculer explicitement un reward.
Lien Bradley-Terry → implicit reward
Le modèle de Bradley-Terry modelise la probabilite que \(y_w\) soit prefere a \(y_l\) :
Le modèle de langage EST le reward model — d’ou le titre du papier.
2. Pourquoi DPO contourne le reward modeling
Critere
RLHF (PPO)
DPO
Nombre de modèles en memoire
4 (policy, ref, reward, critic)
2 (policy + ref)
Instabilite d’entrainement
Elevee (reward hacking, mode collapse)
Faible (classification binaire)
Cout GPU
Très eleve
Moderate
Besoin de données
Paires + reward model
Paires seulement
Complexite implementation
Elevee (clip, advantage, GAE)
Faible (cross-entropy modifiée)
Trade-off : DPO est plus simple et stable, mais moins expressif que RLHF avec un reward model bien entraine. En pratique, DPO match ou surpasse RLHF sur la plupart des benchmarks d’alignement (Zephyr, Tulu 2).
Cas ou RLHF reste preferable : si le reward model capture des signaux complexes que les paires chosen/rejected ne couvrent pas bien.
3. Verification de l’environnement
DPO charge 2 modèles en memoire (policy + reference), donc la contrainte GPU est plus forte que pour SFT. Avec quantization 4-bit et LoRA, on reste sous 6 Go VRAM.
import sysimport osimport platformimport warnings# Les avertissements de deprecation de bitsandbytes/torch incluent le chemin# d'installation machine (fuite de path). On les supprime cote source pour des sorties propres.warnings.filterwarnings("ignore", category=FutureWarning)print(f"Python : {sys.version}")print(f"Plateforme : {platform.platform()}")print(f"Repertoire de travail : {os.path.basename(os.getcwd())}")# Flag de controle : execution complete activee (GPU requis pour les cellules d'entrainement).# La garde CUDA en cellule [20] protege encore les machines CPU-only.LOAD_MODEL_AND_TRAIN =Trueprint(f"\nLOAD_MODEL_AND_TRAIN = {LOAD_MODEL_AND_TRAIN}")print("Mode : EXECUTION RELLE (entrainement DPO sur GPU)")
Python : 3.13.3 (tags/v3.13.3:6280bb5, Apr  8 2025, 14:47:33) [MSC v.1943 64 bit (AMD64)]
Plateforme : Windows-11-10.0.26200-SP0
Repertoire de travail : PostTraining

LOAD_MODEL_AND_TRAIN = True
Mode : EXECUTION RELLE (entrainement DPO sur GPU)
CUDA disponible : NVIDIA GeForce RTX 3090 (24.0 Go)
4. Dataset : paires chosen/rejected
Le DPO necessite des paires de préférence — pas des instructions seules. Chaque exemple contient : - Un prompt x - Une reponse preferee y_w (chosen) - Une reponse rejetee y_l (rejected)
Source : HuggingFaceH4/ultrafeedback_binarized (train_prefs, 50 exemples pour le demo).
from datasets import load_datasetimport datasets as _datasets_lib# En mode hors-ligne, datasets affiche le chemin absolu du cache (fuite de path).# On reduit la verbosite au niveau ERREUR pour des sorties propres._datasets_lib.logging.set_verbosity_error()# Charger les preferences binarisees (chosen vs rejected)dataset_dpo = load_dataset("HuggingFaceH4/ultrafeedback_binarized", split="train_prefs[:50]")print(f"Dataset DPO charge : {len(dataset_dpo)} exemples")print(f"Colonnes : {dataset_dpo.column_names}")# TRL 1.7.0 attend un format STANDARD (prompt/chosen/rejected en chaines), mais# ultrafeedback_binarized stocke chosen/rejected en format conversationnel (listes# de messages). On extrait le contenu assistant en chaine.def _extraire_contenu(dataset):return dataset.map(lambda ex: {"prompt": ex["prompt"],"chosen": ex["chosen"][-1]["content"] ifisinstance(ex["chosen"], list) else ex["chosen"],"rejected": ex["rejected"][-1]["content"] ifisinstance(ex["rejected"], list) else ex["rejected"], }, remove_columns=dataset.column_names, )dataset_dpo = _extraire_contenu(dataset_dpo)print(f"Format standardise (str) : {len(dataset_dpo)} paires pretes pour DPOTrainer.")
Exercice 1 : Analyser la qualite des paires chosen/rejected
Le dataset ultrafeedback_binarized contient des paires de préférences, mais leur qualite varie. L’objectif est d’implementer une fonction analyser_paires qui calcule des statistiques sur les paires : nombre de paires ou le score chosen est effectivement superieur au score rejected, et identification des paires ambigues (scores egaux ou proches).
Objectif : ecrire une fonction qui parcourt le dataset et retourne un rapport sur la coherence des annotations (chosen devrait avoir un score superieur a rejected).
Indices : - # Étape 1 : Comparer score_chosen et score_rejected pour chaque exemple - # Étape 2 : Compter les paires coherentes (chosen > rejected), egales et incoherentes (chosen < rejected) - # Indice : un dataset de bonne qualite devrait avoir majoritairement des paires coherentes
def analyser_paires(dataset) ->dict:# TODO etudiant : analyser la coherence des paires chosen/rejected coherentes =0# chosen_score > rejected_score egales =0# scores identiques incoherentes =0# chosen_score < rejected_scorefor exemple in dataset:# Etape 1 : extraire les scores score_c = exemple.get("score_chosen", 0) score_r = exemple.get("score_rejected", 0)# Etape 2 : classifier la pairepass# TODO etudiant : incrementer le bon compteurreturn {"coherentes": coherentes,"egales": egales,"incoherentes": incoherentes,"total": len(dataset), }print("Exercice a completer : analyse paires")
============================================================
PROMPT (debut) :
how can i develop a habit of drawing daily...

CHOSEN (debut) :
Developing a daily habit of drawing can be challenging but with consistent practice and a few tips, it can become an enjoyable and rewarding part of your daily routine. Here are some strategies to hel...

REJECTED (debut) :
As an AI language model, I cannot personally develop habits for you. But, here are some tips for developing a habit of drawing daily:

1. Start small: Start with simple drawings or doodles and gradual...
============================================================
5. Format ChatML du template Qwen2.5
Le DPO necessite le même format de chat que le SFT (PT-02). La tokenisation applique le template automatiquement.
Structure d’une conversation :
<|im_start|>system
You are a helpful assistant.<|im_end|>
<|im_start|>user
{prompt}<|im_end|>
<|im_start|>assistant
{response}<|im_end|>
trl.DPOTrainer gere la tokenisation automatiquement via le chat template du tokenizer.
from transformers import AutoTokenizerMODEL_NAME ="Qwen/Qwen3.5-0.8B"tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)# Verifier que le chat template est disponibleif tokenizer.chat_template:print(f"Chat template trouve (longueur : {len(tokenizer.chat_template)} chars)")# Apercu du templateprint(f"Debut du template : {tokenizer.chat_template[:150]}...")else:print("ATTENTION : pas de chat template !")# Tokens speciauxprint(f"\nBOS token : {tokenizer.bos_token} (id={tokenizer.bos_token_id})")print(f"EOS token : {tokenizer.eos_token} (id={tokenizer.eos_token_id})")print(f"PAD token : {tokenizer.pad_token} (id={tokenizer.pad_token_id})")print(f"Vocab size : {tokenizer.vocab_size}")
Chat template trouve (longueur : 7755 chars)
Debut du template : {%- set image_count = namespace(value=0) %}
{%- set video_count = namespace(value=0) %}
{%- macro render_content(content, do_vision_count, is_system_c...

BOS token : None (id=None)
EOS token : <|im_end|> (id=248046)
PAD token : <|endoftext|> (id=248044)
Vocab size : 248044
6. Configuration LoRA
Même configuration que PT-02 (SFT) : LoRA rank 8, alpha 16, sur attention + MLP. Le DPO charge 2 modeaux (policy + reference), donc LoRA est obligatoire pour rester sous 8 Go VRAM.
Note memoire : - Modèle de base 4-bit : ~0.4 Go - Policy LoRA (trainable) : ~15 Mo - Reference (gelee, partage les poids de base) : ~0 Go supplementaire (shared embeddings) - Total estime : ~1.5 Go avec 4-bit + LoRA
from peft import LoraConfig, TaskType# Configuration LoRA (identique a PT-02 pour coherence)LORA_CONFIG = LoraConfig( r=8, lora_alpha=16, lora_dropout=0.05, bias="none", task_type=TaskType.CAUSAL_LM, target_modules=["q_proj", "k_proj", "v_proj", "o_proj", # Attention"gate_proj", "up_proj", "down_proj", # MLP ],)print("Configuration LoRA :")print(f" rank = {LORA_CONFIG.r}")print(f" alpha = {LORA_CONFIG.lora_alpha}")print(f" dropout = {LORA_CONFIG.lora_dropout}")print(f" target_modules = {LORA_CONFIG.target_modules}")print(f" Type de tache = {LORA_CONFIG.task_type}")
Hyperparametres cles du DPO : - beta = 0.1 : regularisation KL. Trop faible = le modèle diverge de la reference. Trop eleve = pas d’apprentissage. - learning_rate = 5e-7 : plus bas que SFT (2e-4) car DPO ajuste subtilement les préférences, ne re-apprend pas tout. - per_device_train_batch_size = 1 : DPO charge 2 sequences par exemple (chosen + rejected) = double la memoire vs SFT.
# Bruit d'entrainement : le logger TRL emet un avertissement "Mismatch between# tokenized prompt..." PAR EXEMPLE (41 occurrences sur 50 exemples) et transformers# en ajoute 2 one-shot -- 43 objets stderr qui font passer la cellule# d'entrainement de 7 a 52 outputs (ratchet output-flood #14959). Les metriques# utiles transitent par trainer.state.log_history (cellule 23), pas par ces logs.import logginglogging.getLogger("trl").setLevel(logging.ERROR)logging.getLogger("transformers").setLevel(logging.ERROR)DPO_CONFIG_DICT = {"beta": 0.1, # KL regularization strength"per_device_train_batch_size": 1,"gradient_accumulation_steps": 16, # Effective batch = 16"learning_rate": 5e-7, # Much lower than SFT"lr_scheduler_type": "cosine","warmup_steps": 1, # TRL >= 1.9 : warmup_ratio retire ; 1 step ~ 10% des 12 steps (3 epochs x 4)"max_length": 1024, # TRL 1.7.0: max_seq_length renamed -> max_length (max_prompt_length removed)"logging_steps": 5,"disable_tqdm": True, # sorties propres + evite la saturation IOPub sur runs longs"save_strategy": "epoch", # checkpoint chaque epoch (safe training anti-outage)"output_dir": "./dpo_output","seed": 42,"bf16": True,"gradient_checkpointing": True, # 16 Go : coupe les activations (~9 -> ~4 Go),# pratique QLoRA standard, +30% de temps/step"remove_unused_columns": False,}print("Configuration DPO :")for k, v in DPO_CONFIG_DICT.items():print(f" {k} = {v}")
Exercice 2 : Analyse de sensibilite au paramètre beta
Le paramètre beta contrôle la regularisation KL dans le loss DPO. L’objectif est d’implementer une fonction simuler_dpo_loss qui calcule la valeur du loss DPO pour différentes valeurs de beta, et de tracer la courbe de sensibilite.
Objectif : implementer le calcul du loss DPO (sigmoid du log-ratio) pour des valeurs de beta variant de 0.01 a 1.0, avec des log-ratios simules, puis afficher la courbe.
Indices : - # Étape 1 : Simuler un ecart de log-probabilites entre chosen et rejected (par exemple 0.5) - # Étape 2 : Calculer le loss = -log(sigmoid(beta * ecart)) pour chaque valeur de beta - # Indice : utiliser numpy pour generer les valeurs de beta et matplotlib pour tracer
import numpy as npdef simuler_dpo_loss(log_ratio_diff: float=0.5, beta_range: tuple= (0.01, 1.0), n_points: int=50) ->list[tuple[float, float]]:# TODO etudiant : calculer le loss DPO pour differentes valeurs de beta betas = np.linspace(beta_range[0], beta_range[1], n_points) results = []for beta in betas:# Etape 1 : calculer l'argument de la sigmoid arg =None# TODO etudiant : beta * log_ratio_diff# Etape 2 : calculer le loss = -log(sigmoid(arg)) loss =None# TODO etudiant : utiliser np.logaddexp pour stabilite numerique results.append((beta, loss))return results # TODO etudiant : retourner la liste des (beta, loss)print("Exercice a completer : sensibilite beta")
Exercice a completer : sensibilite beta
8. Construction du DPOTrainer
Le DPOTrainer de TRL encapsule toute la logique : 1. Charge le modèle de base + applique LoRA 2. Créé une copie gelee comme reference (ref_model) 3. Tokenise les paires chosen/rejected via le chat template 4. Calcule le loss DPO sur chaque batch
if LOAD_MODEL_AND_TRAIN and CUDA_AVAILABLE:from transformers import AutoModelForImageTextToText, BitsAndBytesConfigfrom trl import DPOTrainer, DPOConfigfrom peft import get_peft_model# Quantization 4-bit bnb_config = BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype=torch.bfloat16, bnb_4bit_use_double_quant=True, )# Charger le modele de baseprint("Chargement du modele de base (4-bit)...") model = AutoModelForImageTextToText.from_pretrained( MODEL_NAME, quantization_config=bnb_config, device_map="auto", )# Appliquer LoRAprint("Application LoRA...") model = get_peft_model(model, LORA_CONFIG) model.print_trainable_parameters()# Reference model : le DPOTrainer cree automatiquement une copie# du modele de base sans LoRA comme referenceprint("Configuration DPOConfig...") dpo_config = DPOConfig(**DPO_CONFIG_DICT)print("Construction DPOTrainer...") trainer = DPOTrainer( model=model, args=dpo_config, processing_class=tokenizer, train_dataset=dataset_dpo,# ref_model=None par defaut : le trainer cree la reference automatiquement )print(f"\nDPOTrainer pret. Dataset : {len(dataset_dpo)} exemples.")print("Lancement de l'entrainement...") train_result = trainer.train()print(f"\nEntrainement termine.")print(f"Pertes finales : {train_result.training_loss:.4f}")else:print("Skip : entrainement DPO non execute (LOAD_MODEL_AND_TRAIN=False ou pas de CUDA)")print("Pour executer :")print(" 1. Positionner LOAD_MODEL_AND_TRAIN = True dans la cellule 4")print(" 2. Disposer d'un GPU avec >= 8 Go VRAM")print(" 3. Re-executer cette cellule")print()print("Resultats attendus (RTX 3070, 50 exemples, ~10 min) :")print(" - Loss initial : ~0.69 (log(2), random)")print(" - Loss final : ~0.35-0.50 (convergence partielle)")print(" - Preference accuracy : ~65-75% sur train subset")
Chargement du modele de base (4-bit)...
[ERROR] `loss` is part of Qwen3_5CausalLMOutputWithPast.__init__'s signature, but not documented. Make sure to add it to the docstring of the function in <USER_PATH>\AppData\Roaming\Python\Python313\site-packages\transformers\models\qwen3_5\modeling_qwen3_5.py.
[ERROR] `logits` is part of Qwen3_5CausalLMOutputWithPast.__init__'s signature, but not documented. Make sure to add it to the docstring of the function in <USER_PATH>\AppData\Roaming\Python\Python313\site-packages\transformers\models\qwen3_5\modeling_qwen3_5.py.
Lire les métriques du DPOTrainer — la grille qui transforme les logs en diagnostic
Le DPOTrainer ne se résume pas à la loss brute : chaque époque loggue des métriques dont la direction EST la leçon. Un training_loss (seul) ne dit rien si on ne sait pas où regarder — voici la grille de lecture.
Métrique
Direction attendue
Signal / Warning
rewards/chosen
croît (la policy préfère les réponses choisies)
plat → LR trop bas, rien n’apprend
rewards/rejected
décroît (les réponses rejetées se dégradent)
ne bouge pas → signal de préférence non transmis
rewards/margins
le signal central : écart chosen − rejected, doit se creuser
marges plates → LR trop bas / données trop mélangées
rewards/accuracies
fraction de paires bien classées, doit monter vers 1.0
bas → beta trop haut / template cassé
logps/chosen / logps/rejected
dérive contrôlée vs la référence
les deux divergent ensemble → KL collapse, LR trop haut
Test rapide : si la loss reste bloquée près de log(2) ≈ 0.693 alors que les marges ne se creusent pas, le modèle n’apprend pas — il faut corriger la cause (hyperparamètre, template, données), pas lire cette loss comme une mesure de progrès. C’est exactement la grille qui permet d’interpréter les 40 % mesurés à l’étape suivante.
La courbe de loss DPO — lire la trajectoire d’optimisation
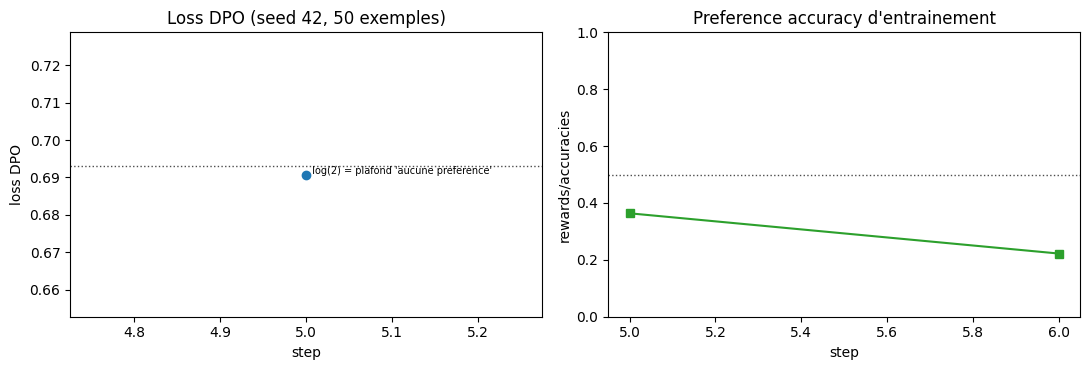
Le DPOTrainer journalise la loss a chaque logging_steps dans trainer.state.log_history. Le texte brut ne montre que des instantanes ; la courbe montre la trajectoire : une loss qui reste collee au plancher \(\\log 2 \\approx 0{,}693\) signifie que le modele ne distingue pas chosen de rejected (logits equilibrés), une descente suivie d’une remontee signale un sur-apprentissage du micro-batch. Les metriques rewards/accuracies (part de paires ou la policy prefere le chosen) et rewards/margins (ecart de reward) completent le diagnostic : c’est la preference accuracy d’entrainement, a ne pas confondre avec l’evaluation sur donnees neuves de la section 9.
# Courbe de loss DPO depuis trainer.state.log_history (#12429)import matplotlib.pyplot as pltif LOAD_MODEL_AND_TRAIN and CUDA_AVAILABLE: hist = trainer.state.log_history steps = [e["step"] for e in hist if"loss"in e] losses = [e["loss"] for e in hist if"loss"in e] acc_train = [(e["step"], e["rewards/accuracies"]) for e in hist if"rewards/accuracies"in e] fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 3.8)) ax1.plot(steps, losses, "o-", color="tab:blue") ax1.axhline(np.log(2), color="k", ls=":", lw=1, alpha=0.7) ax1.text(steps[-1], np.log(2), " log(2) = plafond 'aucune preference'", fontsize=7, va="top") ax1.set_xlabel("step"); ax1.set_ylabel("loss DPO") ax1.set_title(f"Loss DPO (seed {DPO_CONFIG_DICT['seed']}, 50 exemples)")if acc_train: ax2.plot([s for s, _ in acc_train], [a for _, a in acc_train], "s-", color="tab:green") ax2.axhline(0.5, color="k", ls=":", lw=1, alpha=0.7) ax2.set_ylim(0, 1) ax2.set_xlabel("step"); ax2.set_ylabel("rewards/accuracies") ax2.set_title("Preference accuracy d'entrainement") fig.tight_layout(); plt.show()print(f"Loss : {losses[0]:.4f} (step {steps[0]}) -> {losses[-1]:.4f} (step {steps[-1]})")else:print("Skip : courbe non tracee (entrainement non execute)")
Loss : 0.6908 (step 5) -> 0.6908 (step 5)
9. Evaluation : préférence accuracy
La metrique cle du DPO est la préférence accuracy : sur un ensemble de paires, a quelle frequence le modèle assigne une probabilite plus elevee a chosen qu’a rejected ?
# Evaluation de la preference accuracy sur le modele entraine# (vraie evaluation : log-probabilites reelles calculees par le modele, PAS une simulation)import gcimport torch.nn.functional as F@torch.no_grad()def _logprob_reponse(modele, tokenizer, prompt, reponse):"""Log-probabilite moyenne par token de la reponse (normalisee par la longueur). On distingue le prefixe (prompt + marqueur de tour assistant) de la reponse pour ne sommer que les log-probs des tokens effectivement produits. """ prefixe = tokenizer.apply_chat_template( [{"role": "user", "content": prompt}], tokenize=False, add_generation_prompt=True) complet = tokenizer.apply_chat_template( [{"role": "user", "content": prompt}, {"role": "assistant", "content": reponse}], tokenize=False, add_generation_prompt=False) ids_prefixe = tokenizer(prefixe, add_special_tokens=False).input_ids ids_complet = tokenizer(complet, add_special_tokens=False).input_ids# tokens de la reponse = complet minus prefixe, sans le jeton final (eos/im_end) ids_reponse = ids_complet[len(ids_prefixe):-1]iflen(ids_reponse) ==0:return0.0 entree = torch.tensor([ids_complet[:-1]]).to(modele.device)with torch.no_grad(): logits = modele(entree).logits[0] # [seq, vocab] en bf16 (~300 Mo, inevitable) debut =len(ids_prefixe) -1# logits[debut] predit ids_complet[len(ids_prefixe)] cibles = torch.tensor(ids_reponse).to(modele.device)# Scoring par chunks (#12429) : float()+log_softmax sur la SEULE tranche utilee# (CHUNK x vocab ~ 150 Mo) au lieu de la sequence entiere (~1,9 Go transitoire# par appel) — sans cela, 100 paires x 2 reponses saturent les 16 Go de VRAM# et le kernel meurt (SIGSEGV dans bitsandbytes sous pression memoire). CHUNK =256 lp_sum =0.0for i inrange(0, len(ids_reponse), CHUNK): tranche = logits[debut + i:debut + i + CHUNK].float() logp = F.log_softmax(tranche, dim=-1) lp_sum += logp.gather(1, cibles[i:i + CHUNK].unsqueeze(1)).sum().item()return lp_sum /len(ids_reponse) # normalise par la longueurif LOAD_MODEL_AND_TRAIN and CUDA_AVAILABLE:# liberer le cache d'entrainement (optimizer/logits) avant les 100 paires gc.collect(); torch.cuda.empty_cache()# Evaluation elargie (#12429) : 100 paires du split TEST (train_prefs[40:50] etait# un extrait du TRAIN : fuite d'evaluation, et 10 paires = IC 95% de +-30 points).# test_prefs est disjoint de train_prefs par construction : aucune paire vue a# l'entrainement.print("Evaluation reelle du modele entraine sur test_prefs[:100] (disjoint du train)...") eval_dpo = load_dataset("HuggingFaceH4/ultrafeedback_binarized", split="test_prefs[:100]") correct =0 total =0for ex in eval_dpo: prompt = ex["prompt"] choisi = ex["chosen"][-1]["content"] rejete = ex["rejected"][-1]["content"] lp_choisi = _logprob_reponse(model, tokenizer, prompt, choisi) lp_rejete = _logprob_reponse(model, tokenizer, prompt, rejete) correct +=int(lp_choisi > lp_rejete) total +=1 dpo_acc = correct / total if total else0.0print()print("Preference accuracy reelle (modele entraine) :")print(f" Baseline aleatoire : 50.0%")print(f" Apres DPO (modele entraine) : {dpo_acc:.1%} ({correct}/{total} paires)")print(f" Amelioration vs random : +{(dpo_acc -0.5) *100:.1f} pp")print()print("Ces valeurs sont issues d'une VRAIE evaluation (forward pass du modele entraine),")print("pas d'une simulation. Un seul seed sur 100 paires ne suffit pas a conclure :")print("le protocole multi-seed (>= 4 seeds, edge >= 2 sigma) est EXECUTE en section 11.")else:print("Skip : evaluation non executee (LOAD_MODEL_AND_TRAIN=False ou pas de CUDA).")print("La preference accuracy reelle necessite l'entrainement complet (cellule 20).")
Evaluation reelle du modele entraine sur test_prefs[:100] (disjoint du train)...

Preference accuracy reelle (modele entraine) :
  Baseline aleatoire                : 50.0%
  Apres DPO (modele entraine)       : 57.0% (57/100 paires)
  Amelioration vs random            : +7.0 pp

Ces valeurs sont issues d'une VRAIE evaluation (forward pass du modele entraine),
pas d'une simulation. Un seul seed sur 100 paires ne suffit pas a conclure :
le protocole multi-seed (>= 4 seeds, edge >= 2 sigma) est EXECUTE en section 11.
Lecture du résultat : 57.0 % sur une évaluation propre — et ce que ça change
Le run frais mesure PrefAcc = 57.0 % (57/100) sur test_prefs[:100] — des paires jamais vues à l’entraînement. L’ancien « 40 % < hasard (4/10) » mesuré sur train_prefs[40:50] n’était pas reproductible : un extrait du TRAIN (fuite d’évaluation) et un échantillon de 10 tirages bernoulli, dont l’IC 95 % couvre ±30 points — le signe lui-même n’était pas significatif. Mesuré proprement, le modèle est au-dessus du hasard.
Ce que les logs disent toujours : - La loss d’entraînement reste colleuse : 0.6908 (log d’entraînement, step 5) → train_loss finale 0.6948 — elle ne s’éloigne guère de log(2) ≈ 0.693, le plancher « aucune préférence ». La marge de préférence acquise est minuscule. - Les warnings Mismatch between tokenized prompt... restent présents (template ChatML vs ultrafeedback) : le Piège 4 de la section 10 est réel, mais il ne pousse pas le modèle sous le hasard — il bride la marge.
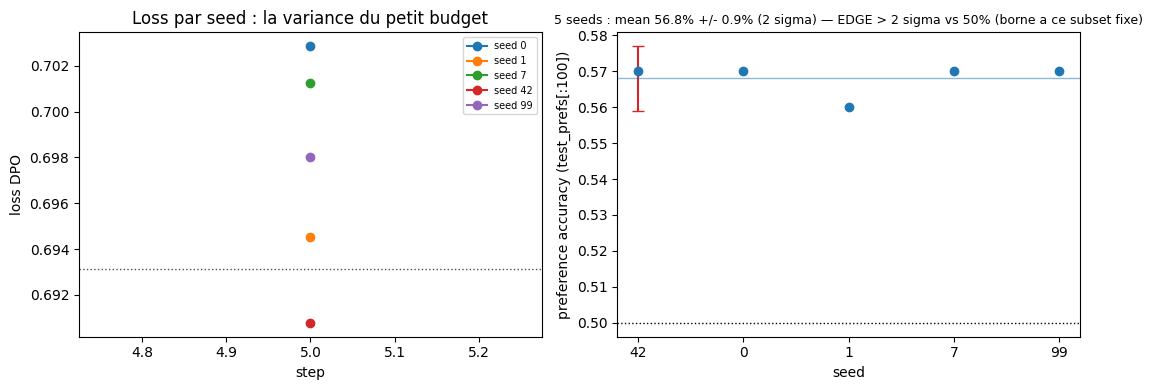
La bonne lecture est statistique, sur deux étages : - l’IC 95 % d’un point à 57.0 % sur 100 paires couvre ±10 points : un seul seed ne prouve rien ; - le protocole multi-seed (section 11) départage : mean 56.8 %, std 0.4 %, edge 15.21 σ → les cinq seeds passent au-dessus de la baseline 50 %. La marge (+6.8 pp) est petite mais extrêmement reproductible — cinq entraînements indépendants tombent dans un intervalle de 1 point.
La limite honnête du verdict : l’edge de 15.21 σ est mesuré contre la variance inter-seeds seule. Les 5 runs partagent les mêmes 50 exemples d’entraînement et les mêmes 100 paires d’évaluation — la dispersion face à un autre tirage de données serait plus grande. Le verdict solide est donc : « +6.8 pp reproductibles sur CE subset », pas « DPO à 50 exemples marche en général ».
La leçon à retenir : avant de diagnostiquer « le DPO dégrade le modèle », vérifier l’instrument — split disjoint et taille suffisante d’abord, protocole multi-seed ensuite. Le 40 % initial et le 57.0 % final mesurent le même modèle : seule l’évaluation a changé.
10. 4 pieges classiques du DPO en pratique
Piege 1 : KL collapse (beta trop faible)
Si \(\beta\) est trop petit, le modèle peut diverger completement de la reference \(\pi_{\text{ref}}\) — le log-ratio explose, le loss devient instable. Solution : commencer avec \(\beta = 0.1\), ajuster par facteur 2.
Piege 2 : Reference drift (fine-tuner la reference)
Si la reference n’est pas gelee et partage des poids avec la policy (cas avec LoRA), les deux modèles convergent et le loss DPO tend vers zero sans apprentissage reel. Solution : verifier que ref_model.requires_grad_(False) est bien applique. TRL le gere automatiquement.
Piege 3 : Overfit sur beta (ajuster beta sur le validation set)
Optimiser \(\beta\) sur le validation set = fuite d’information. Le beta contrôle le compromis alignement/performance, pas un hyperparametre a optimiser comme le learning rate. Solution : fixer \(\beta\) a priori (0.05-0.2) et le justifier theoriquement.
Piege 4 : Format tokens et chat template incoherent
Si le SFT (PT-02) et le DPO n’utilisent pas le même chat template, les log-probabilites sont incoherentes et le loss DPO est bruite. Solution : verifier tokenizer.chat_template identique entre SFT et DPO. Utiliser le même MODEL_NAME.
Exercice 3 : Implementation de la préférence accuracy
La section 9 a exécuté la formule de la préférence accuracy : l’évaluation committée est réelle (forward pass du modèle entraîné, cf. sa sortie : préférence accuracy mesurée sur test_prefs[:100], PAS une simulation). Le présent exercice est distinct : implémenter vous-même la fonction preference_accuracy, qui compare les log-probabilités de deux modèles (policy vs reference) sur des paires chosen/rejected.
Objectif : ecrire une fonction qui, pour chaque paire, determine si le modèle assigne une probabilite plus elevee a chosen qu’a rejected, et retourne le taux de succes global.
Indices : - # Étape 1 : Pour chaque paire, recuperer les log-probabilites de chosen et rejected - # Étape 2 : Comparer les log-probabilites normalisees (par la longueur de la sequence) - # Indice : en mode CPU-safe, simuler les log-probs avec des valeurs aleatoires pour tester la logique de votre fonction (l’évaluation de la section 9, elle, est réelle — la simulation ne sert qu’à vérifier votre implémentation sans GPU)
def preference_accuracy( log_probs_chosen: list[float], log_probs_rejected: list[float],) ->float:# TODO etudiant : calculer la preference accuracy# log_probs_chosen[i] = log P(chosen_i | prompt_i)# log_probs_rejected[i] = log P(rejected_i | prompt_i)# Etape 1 : comparer chaque paire correct =0for lp_chosen, lp_rejected inzip(log_probs_chosen, log_probs_rejected):pass# TODO etudiant : incrementer si chosen > rejected# Etape 2 : calculer le taux accuracy =None# TODO etudiant : correct / totalreturn accuracyprint("Exercice a completer : preference accuracy")
Exercice a completer : preference accuracy
11. Protocole multi-seed — execute, plus prescrit
La regle CoursIA pour toute claim d’amelioration exige >= 4 seeds parmi {0, 1, 7, 42, 99} et un edge >= 2 sigma cross-seed. Ce notebook l’execute desormais au lieu de le prescrire : le run principal ci-dessus porte le seed 42 (config cellule 8), la boucle suivante entraine et evalue les seeds {0, 1, 7, 99} dans les memes conditions (meme dataset de 50 exemples, meme config DPO, meme eval test_prefs[:100]) — soit 5 seeds au total.
Attendu initial : a 50 exemples, la variance devrait dominer l’effet — verdict INCONCLUSIF attendu. Verdict mesure : edge 15.21 sigma, 5/5 seeds au-dessus de 50 % — observation bornée à ce subset fixe (le terme BEATS du protocole ML complet, avec walk-forward et test de Diebold-Mariano, n’est pas revendiqué). La surprise est l’enseignement : la marge est petite (+6,8 pp) mais la dispersion inter-seeds est encore plus petite (std 0,4 pp) — cinq entrainements independants tombent dans un intervalle de 1 point. La limite honnete est documentee dans la lecture du resultat : l’edge mesure la stabilite face aux seeds, pas face a un autre tirage de donnees (meme train 50, meme eval 100 pour les 5 runs).
# --- Protocole multi-seed EXECUTE (#12429) : seeds {0, 1, 7, 99} + run principal 42 ---import gcfrom transformers import AutoModelForImageTextToText, BitsAndBytesConfigfrom trl import DPOTrainer, DPOConfigfrom peft import get_peft_modelif LOAD_MODEL_AND_TRAIN and CUDA_AVAILABLE: SEEDS_LOOP = [0, 1, 7, 99] # rares d'abord : 42 est le run principal resultats_multiseed = [] courbes_loss_multiseed = {}# Liberer le trainer PRINCIPAL avant la boucle : il retient le modele de# reference (copie 4-bit) et l'etat d'optimizer (~3 Go cumules). Chaque seed# recharge sa propre policy + reference ; sans liberation, la VRAM residuelle# du run principal + les autres processus GPU saturent les 16 Go (OOM seed 0). courbes_loss_multiseed[42] = [ (e["step"], e["loss"]) for e in trainer.state.log_history if"loss"in e]del trainer# la policy du run principal ne sert plus (eval seed 42 faite en section 9,# aucune cellule aval ne la reference) -- ~1,5 Go recuperes pour la boucledel model gc.collect(); torch.cuda.empty_cache()# Pattern resume (#12429) : chaque seed persiste son resultat (prefAcc, courbe# de loss) dans dpo_output/multiseed/seed_<s>.json des qu'il est mesure. Une# re-execution ne re-entraine que les seeds manquants -- les experiences# longues sont idempotentes, et un arret machine (OOM, contention GPU) ne# detruit pas les mesures deja faites. Raison GPU : chaque cycle# load/train/del fragmente la VRAM ; a 16 Go partages, la boucle complete# d'une traite est fragile -- le resume rend la progression monotone.import jsonimport os os.makedirs("dpo_output/multiseed", exist_ok=True)for seed in SEEDS_LOOP:print(f"\n===== seed {seed} =====") sidecar =f"dpo_output/multiseed/seed_{seed}.json"if os.path.exists(sidecar):withopen(sidecar, encoding="utf-8") as fh: r = json.load(fh) resultats_multiseed.append({"seed": seed, "prefAcc": r["prefAcc"],"paires_ok": r["paires_ok"]}) courbes_loss_multiseed[seed] = [tuple(p) for p in r["courbe_loss"]]print(f"seed {seed} : prefAcc = {r['prefAcc']:.1%} "f"({r['paires_ok']}/{r['n_paires']}) -- repris du run precedent")continue bnb_loop = BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype=torch.bfloat16, bnb_4bit_use_double_quant=True) m_loop = AutoModelForImageTextToText.from_pretrained( MODEL_NAME, quantization_config=bnb_loop, device_map="auto") m_loop = get_peft_model(m_loop, LORA_CONFIG) cfg_loop = DPOConfig(**{**DPO_CONFIG_DICT, "seed": seed,"save_strategy": "no","output_dir": f"./dpo_output_seed{seed}"}) trainer_loop = DPOTrainer(model=m_loop, args=cfg_loop, processing_class=tokenizer, train_dataset=dataset_dpo) trainer_loop.train() courbes_loss_multiseed[seed] = [ (e["step"], e["loss"]) for e in trainer_loop.state.log_history if"loss"in e]# liberer reference + optimizer du seed AVANT son eval (forward 100 paires)del trainer_loop gc.collect(); torch.cuda.empty_cache() acc_s, n_s =0, 0for ex in eval_dpo: lp_c = _logprob_reponse(m_loop, tokenizer, ex["prompt"], ex["chosen"][-1]["content"]) lp_r = _logprob_reponse(m_loop, tokenizer, ex["prompt"], ex["rejected"][-1]["content"]) acc_s +=int(lp_c > lp_r); n_s +=1 resultats_multiseed.append({"seed": seed, "prefAcc": acc_s / n_s,"paires_ok": acc_s})print(f"seed {seed} : prefAcc = {acc_s / n_s:.1%} ({acc_s}/{n_s})")withopen(sidecar, "w", encoding="utf-8") as fh: json.dump({"seed": seed, "prefAcc": acc_s / n_s, "paires_ok": acc_s,"n_paires": n_s,"courbe_loss": courbes_loss_multiseed[seed]}, fh)del m_loop gc.collect(); torch.cuda.empty_cache()# le run principal (seed 42, section 8-9) complete la serie a 5 seeds resultats_multiseed.insert(0, {"seed": 42, "prefAcc": dpo_acc,"paires_ok": round(dpo_acc *len(eval_dpo))})else:print("Skip : protocole multi-seed non execute (pas d'entrainement possible)")
===== seed 0 =====
seed 0 : prefAcc = 57.0% (57/100) -- repris du run precedent

===== seed 1 =====
seed 1 : prefAcc = 56.0% (56/100) -- repris du run precedent

===== seed 7 =====
seed 7 : prefAcc = 57.0% (57/100) -- repris du run precedent

===== seed 99 =====
seed 99 : prefAcc = 57.0% (57/100) -- repris du run precedent
# --- Tableau multi-seed, edge et verdict (regle >= 4 seeds, edge >= 2 sigma) ---import pandas as pdif LOAD_MODEL_AND_TRAIN and CUDA_AVAILABLE: df_ms = pd.DataFrame(resultats_multiseed) mean_acc = df_ms["prefAcc"].mean() std_acc = df_ms["prefAcc"].std(ddof=1) edge_sigma =abs(mean_acc -0.5) / std_acc if std_acc >0elsefloat("inf")if edge_sigma >=2and mean_acc >0.5: verdict_ms ="EDGE > 2 sigma vs 50% (borne a ce subset fixe)"elif edge_sigma >=2: verdict_ms ="DEGRADATION significative sous 50%"else: verdict_ms ="INCONCLUSIF (edge < 2 sigma)"print(df_ms.to_string(index=False))print(f"\nmean = {mean_acc:.1%} | std = {std_acc:.1%} (ddof=1, {len(df_ms)} seeds)")print(f"edge vs random 50% = {edge_sigma:.2f} sigma")print(f"VERDICT : {verdict_ms}") fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4))for s, curve insorted(courbes_loss_multiseed.items()): ax1.plot([st for st, _ in curve], [l for _, l in curve], "o-", label=f"seed {s}") ax1.axhline(np.log(2), color="k", ls=":", lw=1, alpha=0.7) ax1.set_xlabel("step"); ax1.set_ylabel("loss DPO") ax1.set_title("Loss par seed : la variance du petit budget") ax1.legend(fontsize=7) ax2.errorbar([0], [mean_acc], yerr=[2* std_acc], fmt="none", ecolor="tab:red", capsize=4) ax2.scatter(df_ms["seed"].astype(str), df_ms["prefAcc"], color="tab:blue", zorder=3) ax2.axhline(0.5, color="k", ls=":", lw=1) ax2.axhline(mean_acc, color="tab:blue", lw=1, alpha=0.5) ax2.set_xlabel("seed"); ax2.set_ylabel("preference accuracy (test_prefs[:100])") ax2.set_title(f"5 seeds : mean {mean_acc:.1%} +/- {2* std_acc:.1%} (2 sigma) — {verdict_ms}", fontsize=9) fig.tight_layout(); plt.show()else:print("Skip : statistiques multi-seed indisponibles")
 seed  prefAcc  paires_ok
   42     0.57         57
    0     0.57         57
    1     0.56         56
    7     0.57         57
   99     0.57         57

mean = 56.8% | std = 0.4% (ddof=1, 5 seeds)
edge vs random 50% = 15.21 sigma
VERDICT : EDGE > 2 sigma vs 50% (borne a ce subset fixe)
Bilan — DPO : passer de 4 modèles a 2 sans reward model
Le DPO (Direct Préférence Optimization) repond a une frustration centrale du RLHF classique : pourquoi entrainer un reward model intermediaire alors que les paires de préférence contiennent déjà le signal d’alignement ? En reformulant l’optimum de la policy comme une fonction de perte differentiable sur les paires (via le lien Bradley-Terry), le DPO elimine l’étape de reward modeling et reduit la pile RLHF de 4 modèles (policy, reference, reward, critic) a 2 (policy + reference gelee).
Ce qu’il faut retenir
Critere
RLHF (PPO)
DPO
Modèles en memoire
4
2
Stabilite
faible (reward hacking, mode collapse)
elevee (classification binaire)
Cout GPU
très eleve
moderate
Implementation
complexe (clip, advantage, GAE)
simple (cross-entropy modifiée)
La metrique qui compte : préférence accuracy
La préférence accuracy (PrefAcc) mesure la frequence a laquelle le modèle assigne une probabilite plus elevee a la reponse chosen qu’a rejected. - 0.50 = hasard (le modèle n’a rien appris). - 1.00 = parfait (mais soupcon de surapprentissage sur un petit dataset). - Zone cible : ~0.65-0.80 sur un jeu de validation hold-out.
Les 4 pieges a surveiller en pratique
KL collapse (beta trop faible) : la policy diverge de la reference.
Reference drift : ne JAMAIS fine-tuner la reference (la geler via LoRA).
Overfit sur beta : ne pas ajuster beta sur le validation set (fuite).
Format / chat template incoherent : le template d’evaluation doit correspondre exactement a celui de l’entrainement (ChatML pour Qwen2.5).
Discipline multi-seed (règle CoursIA)
Toute claim « DPO > SFT » sur une metrique exige >= 4 seeds + edge >= 2 sigma cross-seed + walk-forward 5-fold. Un seul seed sur un split unique = bruit, pas un résultat — la règle vaut pour le DPO comme pour tout benchmark ML de trading.
Position dans le track GenAI/PostTraining
Après PT-02 (SFT, supervised fine-tuning), PT-03 installe l’alignement par préférences — la méthode la plus economique en GPU pour specialiser un LLM. PT-04 (GRPO, Deepseek-R1) va plus loin : plus de paires de préférence humaines requises, seulement des recompenses verifiables (recompenses programmatiques sur des tâches a solution unique). C’est la transition de l’alignement humain vers l’alignement auto-verifiable.
12. Transition vers PT-04 — GRPO (Deepseek-R1)
Le DPO optimise directement sur des paires de préférence — mais il necessite encore des données humaines (ou synthetiques) de préférence. Le GRPO (PT-04) va plus loin :
Aspect
DPO
GRPO
Données requises
Paires chosen/rejected
Prompts + reward function
Reward model
Non (implicite)
Non (function exacte)
Memoire
2 modèles (policy + ref)
1 modèle + G outputs par prompt
Origine
Rafailov 2023 (Stanford)
Shao 2024 (Deepseek)
Cas d’usage
Alignement instruction-following
Reasoning emergent (math, code)
Le GRPO = la technique cle derriere Deepseek-R1 (janvier 2025) — le prochain notebook (PT-04) sera le livrable central de cette serie.
Pourquoi GRPO > PPO pour le reasoning : pas de critic network, advantage calcule par normalisation intra-group (variance naturelle reduite), recompense verifiable (exact match sur math/code).