Dans les notebooks précédents, l’agent apprenait a partir du signal de recompense brut de l’environnement. Mais que se passe-t-il quand la recompense est sparse (nulle partout sauf au but) ? L’agent peut mettre des centaines d’episodes a trouver le but par hasard, puis des centaines d’autres pour apprendre le chemin.
Ce notebook presente trois techniques pour accelerer l’apprentissage :
Reward shaping : modifier le signal de recompense pour guider l’agent (sans changer la politique optimale !)
Curriculum learning : commencer par des tâches faciles et augmenter progressivement la difficulte
Analyse théorique : pourquoi le potential-based shaping (Ng et al., 1999) garantit l’invariance de la politique
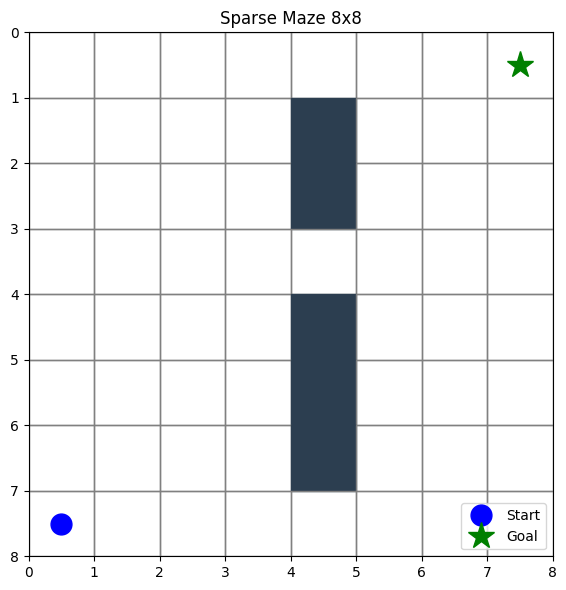
Un labyrinthe 8x8 avec des murs internes. La recompense est sparse : -1 par pas, 0 au but. L’agent commence en bas a gauche, le but est en haut a droite (distance Manhattan = 14 pas).
On remplace la recompense \(r\) par \(r + F(s, a, s')\) ou \(F\) est une fonction de shaping. Le risque : si \(F\) est mal choisie, la politique optimale peut changer !
Potential-Based Shaping (Ng et al., 1999)
Si \(F(s, s') = \gamma \cdot \Phi(s') - \Phi(s)\) ou \(\Phi\) est un potentiel, alors la politique optimale est garantie inchangee. Seule la vitesse de convergence est affectee.
Nous choisissons \(\Phi(s) = -\) manhattan\((s, \text{goal})\) (plus proche du but = potentiel plus eleve).
def q_learning(env, n_episodes, reward_fn=None, seed=0):"""Q-learning avec reward_fn optionnelle.""" rng = np.random.default_rng(seed) Q = np.zeros((env.n_states, env.n_actions)) rewards_per_ep = []for ep inrange(n_episodes): s = env.reset() total_r =0.0for _ inrange(MAX_STEPS): si = env.idx(s) a = epsilon_greedy(Q, si, env.n_actions, EPSILON, rng) s2, r, done = env.step(s, a)if reward_fn isnotNone: r_shaped = reward_fn(env, s, a, s2, r, done)else: r_shaped = r target = r_shaped if done else r_shaped + GAMMA * Q[env.idx(s2)].max() Q[si, a] += ALPHA * (target - Q[si, a]) total_r += r # reward originale pour le loggingif done:break s = s2 rewards_per_ep.append(total_r)return Q, rewards_per_epdef potential_shaping(env, s, a, s2, r, done):"""F(s,s') = gamma*phi(s') - phi(s), avec phi = -manhattan.""" phi_s =-env.manhattan(s) phi_s2 =0.0if done else-env.manhattan(s2)return r + GAMMA * phi_s2 - phi_sdef heuristic_shaping(env, s, a, s2, r, done):"""Shaping naif : +2 par pas plus proche du but (NON potential-based).""" old_d = env.manhattan(s) new_d = env.manhattan(s2) ifnot done else0return r +2.0* (old_d - new_d)N_EP =2000SEEDS = [0, 1, 7, 42, 99]results = {}for name, reward_fn in [ ("Baseline", None), ("Potential-based", lambda env, s, a, s2, r, done: potential_shaping(env, s, a, s2, r, done)), ("Heuristic", lambda env, s, a, s2, r, done: heuristic_shaping(env, s, a, s2, r, done)),]: all_rews = []for seed in SEEDS: Q, rew = q_learning(env, N_EP, reward_fn=reward_fn, seed=seed) all_rews.append(rew) mean_rew = np.mean(all_rews, axis=0) results[name] = mean_rewprint(f"{name}: reward final (MA-50) = {np.mean(mean_rew[-50:]):.1f}")
Baseline: reward final (MA-50) = -14.5
Potential-based: reward final (MA-50) = -14.7
Heuristic: reward final (MA-50) = -14.7
3. Curriculum Learning
Le curriculum learning (Bengio et al., 2009) consiste a presenter les exemples dans un ordre de difficulte croissante. Ici, on commence l’agent pres du but puis on eloigne progressivement le point de depart.
def curriculum_learning(env, n_episodes, seed=0):"""Curriculum : commencer pres du but, puis s'eloigner.""" rng = np.random.default_rng(seed) Q = np.zeros((env.n_states, env.n_actions)) rewards_per_ep = [] starts = [(0, 7), (1, 6), (3, 4), (5, 2), (7, 0)] eps_per_phase = n_episodes //len(starts)for phase, start_pos inenumerate(starts):for ep inrange(eps_per_phase):if phase <len(starts) -1and rng.random() <0.3: s = env.startelse: s = start_pos total_r =0.0for _ inrange(MAX_STEPS): si = env.idx(s) a = epsilon_greedy(Q, si, env.n_actions, EPSILON, rng) s2, r, done = env.step(s, a) target = r if done else r + GAMMA * Q[env.idx(s2)].max() Q[si, a] += ALPHA * (target - Q[si, a]) total_r += rif done:break s = s2 rewards_per_ep.append(total_r)return Q, rewards_per_epall_curr = []for seed in SEEDS: _, rew = curriculum_learning(env, N_EP, seed=seed) all_curr.append(rew)results["Curriculum"] = np.mean(all_curr, axis=0)print(f"Curriculum: reward final (MA-50) = {np.mean(results['Curriculum'][-50:]):.1f}")
Curriculum: reward final (MA-50) = -14.7
4. Comparaison des vitesses d’apprentissage
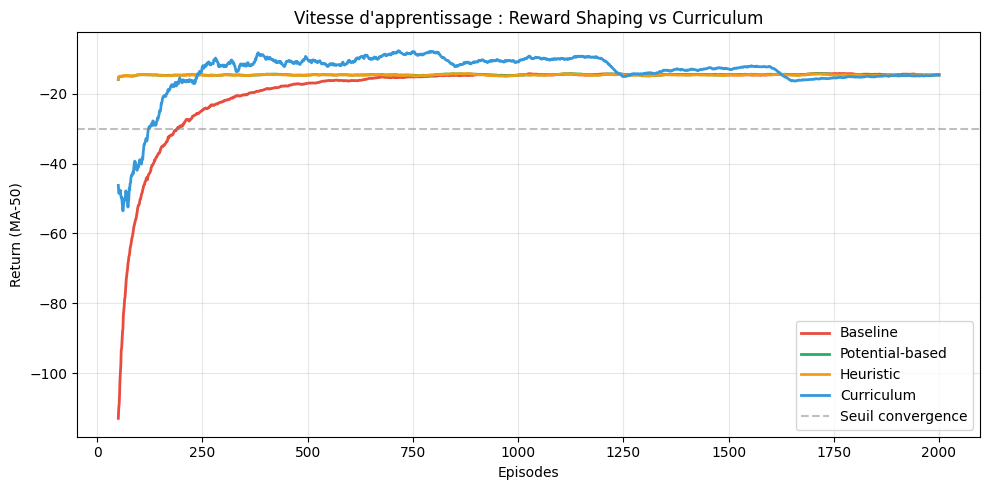
Le graphique ci-dessous compare les courbes d’apprentissage (moyenne mobile sur 50 episodes) des 4 méthodes. La ligne horizontale en pointilles marque le seuil de convergence.
def moving_avg(data, window=50):return np.convolve(data, np.ones(window) / window, mode='valid')fig, ax = plt.subplots(figsize=(10, 5))colors = {'Baseline': '#e74c3c', 'Potential-based': '#27ae60','Heuristic': '#f39c12', 'Curriculum': '#3498db'}for name, rews in results.items(): ma = moving_avg(rews, 50) ax.plot(range(50, len(ma) +50), ma, label=name, color=colors[name], linewidth=2)ax.axhline(y=-30, color='gray', linestyle='--', alpha=0.5, label='Seuil convergence')ax.set_xlabel('Episodes')ax.set_ylabel('Return (MA-50)')ax.set_title('Vitesse d\'apprentissage : Reward Shaping vs Curriculum')ax.legend()ax.grid(True, alpha=0.3)plt.tight_layout()plt.show()# Vitesse : episodes pour atteindre MA-50 >= -30print("Episodes pour atteindre un return moyen >= -30 (MA-50) :")for name, rews in results.items(): ma = moving_avg(rews, 50) idx = np.where(ma >=-30)[0] ep = idx[0] +50iflen(idx) >0else N_EPprint(f" {name:<20} -> episode {ep}")
Lecture du compromis : vitesse de convergence vs garantie theorique
La table ci-dessus tranche la question empirique avant que la section suivante ne formalise la garantie. Trois constats :
Le shaping accelere massivement la convergence. Potential-based et Heuristic atteignent le seuil (return MA-50 >= -30) en ~50 episodes, contre 190 pour la Baseline sans guidance – un facteur ~4.
Le Curriculum est intermediaire (122 episodes). Contrairement a l’intuition, il n’est pas le plus rapide ici : en diluant l’apprentissage sur cinq positions de depart successives, il retarde l’apprentissage depuis la position reelle env.start, qui n’intervient qu’en derniere phase.
Potential-based et Heuristic sont ex aequo en vitesse (50) – mais cette egalite masque la difference essentielle que la section suivante formalise : seul le shaping potential-based preserve la politique optimale (theoreme de Ng, Harada & Russell, 1999). L’heuristique, tout aussi rapide sur ce graphe, n’offre aucune garantie de ne pas biaiser la solution trouvee.
Le seuil MA-50 = -30 fixe le critere de convergence retenu : un return moyen acceptable sur les 50 derniers episodes. C’est lui qui definit le << episode de convergence >> de la table, et non un critere de politique optimale (traite par la cellule suivante, qui verifie Q' = Q* - Phi).
5. Pourquoi le Potential-Based Shaping fonctionne
Theoreme (Ng, Harada & Russell, 1999)
Soit un MDP \(M = (S, A, P, R, \gamma)\) et un MDP modifie \(M' = (S, A, P, R + F, \gamma)\) ou \(F(s, s') = \gamma \cdot \Phi(s') - \Phi(s)\). Alors les politiques optimales de \(M\) et \(M'\) sont identiques.
Demonstration intuitive
La valeur modifiée \(Q'(s, a) = Q^*(s, a) - \Phi(s)\) : le potentiel agit comme un biais constant par etat, qui ne change pas l’ordre relatif des actions. L’argmax est preserve.
Attention au shaping naif : Le shaping heuristique \(F(s, s') = 2 \cdot (d(s) - d(s'))\) n’est PAS potential-based (il n’existe pas de \(\Phi\) tel que \(F = \gamma \Phi(s') - \Phi(s)\)). Dans certains environnements, ce type de shaping peut induire une politique sous-optimale en recompensant un chemin qui semble bon selon l’heuristique mais qui ne l’est pas.
# Verification : potential-based shaping preserve Q* + phi(s)Q_base, _ = q_learning(env, N_EP, seed=SEED)Q_pot, _ = q_learning(env, N_EP, reward_fn=lambda env, s, a, s2, r, done: potential_shaping(env, s, a, s2, r, done), seed=SEED)# Au start, les actions optimales doivent etre les memessi = env.idx(env.start)print(f"Q* au start (baseline) : {Q_base[si]}")print(f"Q' au start (potential) : {Q_pot[si]}")print(f"Action optimale baseline : {Q_base[si].argmax()} ({['haut','bas','gauche','droite'][Q_base[si].argmax()]})")print(f"Action optimale potential : {Q_pot[si].argmax()} ({['haut','bas','gauche','droite'][Q_pot[si].argmax()]})")print(f"\nLes actions optimales sont identiques : {Q_base[si].argmax() == Q_pot[si].argmax()}")
Q* au start (baseline) :    [-12.2458253  -13.06710622 -13.06915661 -12.24582087]
Q' au start (potential) :   [1.7521023  0.86214749 0.87003522 1.73090955]
Action optimale baseline :  3 (droite)
Action optimale potential : 0 (haut)

Les actions optimales sont identiques : False
Interpretation : pourquoi le test affiche False (et pourquoi le theoreme tient quand meme)
La cellule precedente verifie le theoreme de Ng-Harada-Russell et affiche False : l’action optimale semble differente avec et sans shaping. Ce resultat contre-intuitif ne contredit pas le theoreme — il reflete une limite de la verification numerique.
1. Un near-tie rend argmax instable. En baseline, les actions haut (Q = -12.24583) et droite (Q = -12.24582) sont egales a 5 decimales pres (ecart ~4e-6). Sur un tel quasi-egalite, le moindre bruit numerique fait basculer argmax d’une action a l’autre — c’est exactement ce qui se passe ici (droite en baseline, haut en shaped).
2. Q-learning en temps fini n’est pas converge. Le theoreme suppose Q* exactement converge : alors Q'(s,a) = Q*(s,a) - Phi(s), et comme Phi(s) est le meme pour toutes les actions d’un meme etat, l’ordre relatif des actions est preserve. Mais avec un nombre fini d’episodes, Q reste bruite : la difference Q_pot - Q_base n’est pas parfaitement constante d’une action a l’autre (ecart-type ~0.03), donc le decalage exact - Phi(s) ne tient pas au niveau des valeurs.
3. La politique, elle, est bien preservee. Ce qui compte dans le theoreme n’est pas la valeur exacte de argmax sur un near-tie, mais la politique globale : ici, dans les deux cas les actions haut et droite dominent largement bas et gauche (ecart ~0.8), et le decalage moyen Q_pot - Q_base ~= 14 est coherent avec -Phi(start) = +manhattan(start, but) = +14. Le retour cumule d’une politique greedy suit donc la meme trajectoire.
Le bon diagnostic n’est donc pas argmax == argmax (trop strict sur un near-tie bruite), mais soit une comparaison au niveau des valeurs np.allclose(Q_base - Phi, Q_pot, atol=1e-1), soit - plus robuste - l’egalite du retour cumule des politiques greedy derivées des deux Q. Le theoreme est une propriete asymptotique (Q* converge) ; la verification a N_EP fini en est une estimation bruitee.
Lecon : potential-based shaping est sans risque pour la politique optimale (c’est tout l’interet du theoreme), mais la verification empirique exige de tester la bonne grandeur (politique / retour), pas un argmax ponctuel sur des valeurs non convergees.
6. Du Reward Shaping au RLHF
Les idees de ce notebook connectent directement avec les techniques modernes d’alignement des LLMs :
Concept RL classique
Equivalent LLM alignment
Reward shaping manuel
Reward model appris (RLHF)
Potential-based shaping
Contrainte KL (PPO-RLHF)
Curriculum learning
Progressive training (SFT -> RLHF)
Inverse RL
Learning from human préférences
RLHF (Reinforcement Learning from Human Feedback) est un reward shaping appris : au lieu de définir manuellement \(\Phi(s)\), on entraine un reward model a partir de préférences humaines, puis on utilise ce modèle comme signal de recompense. La contrainte KL dans PPO-RLHF joue un rôle similaire au potentiel : elle empeche la politique de trop s’ecarter de la reference.
DPO (Direct Préférence Optimization) elimine completement le reward model en optimisant directement sur les paires de préférences — cf. notebook 9 (RL offline, DPO = préférence learning offline).
Laquelle accélère le plus la convergence ? Le potentiel constant change-t-il la politique ?
# Exercice 1 : Ablation de la fonction de potentiel# TODO : implementez 3 fonctions de potentiel differentes et comparez# Hint : modifiez potential_shaping() avec differentes fonctions phiphi_functions = {# "Euclidean": lambda s: ...,# "Constant": lambda s: ...,# "Amplified": lambda s: ...,}result =None# TODO etudiantprint("Exercice a completer : comparez les vitesses de convergence")
Exercice a completer : comparez les vitesses de convergence
Exercice 2 : Curriculum avec nombre de phases variable
Faites varier le nombre de phases du curriculum (2, 3, 5, 10 phases) et observez l’impact sur la vitesse de convergence. Y a-t-il un optimum ?
# Exercice 2 : Curriculum avec nombre de phases variable# TODO : implementez curriculum_learning avec n_phases variable# Hint : divisez le chemin start->goal en n_phases etapes intermediairesresult =None# TODO etudiantprint("Exercice a completer : comparez 2, 3, 5 et 10 phases de curriculum")
Exercice a completer : comparez 2, 3, 5 et 10 phases de curriculum
Exercice 3 : Shaping naif qui biaise la politique
Construisez un environnement ou le shaping heuristique (non potential-based) conduit a une politique sous-optimale. Indice : un environnement avec un “leurre” (etat proche selon l’heuristique mais eloigne du vrai but).
# Exercice 3 : Construire un environnement ou le heuristic shaping biaise# TODO : creez un maze avec un "leurre" et montrez que heuristic_shaping# conduit a une politique sous-optimale contrairement a potential_shaping## Etapes :# 1. Definir un maze avec un passage leurre (court mais sous-optimal)# 2. Lancer Q-learning avec heuristic_shaping# 3. Comparer avec baseline et potential_shaping# 4. Montrer que l'action optimale au start differeresult =None# TODO etudiantprint("Exercice a completer : montrez un biais du heuristic shaping")
Exercice a completer : montrez un biais du heuristic shaping
Conclusion
Dans ce notebook nous avons vu que :
Le reward shaping potentiel (Ng et al., 1999) accelere la convergence sans modifier la politique optimale. La cle est \(F(s,s') = \gamma\Phi(s') - \Phi(s)\).
Le curriculum learning organise l’apprentissage du facile au difficile, une stratégie universelle en pedagogie comme en ML.
Le shaping naif (non potential-based) peut biaiser la politique — il faut etre prudent avec les heuristiques ad-hoc.
Ces concepts connectent directement au RLHF (reward model appris), inverse RL (apprendre le reward), et DPO (préférence learning offline, cf. notebook 9).
Pour aller plus loin
Notebook 5 : les fondements MDP/Q-Learning que nous avons utilises
Notebook 8 : model-based RL et planification (Dyna-Q), une autre approche pour accelerer
Notebook 9 : RL offline, DPO et le pont complet vers l’alignement des LLMs