Plan du notebook : 1. Pourquoi le SFT ne suffit pas 2. Le pipeline RLHF (SFT -> Reward Model -> PPO) 3. Données de préférence (chosen vs rejected) 4. Le Reward Model 5. DPO : Optimisation Directe des Préférences 6. Evaluation : SFT vs DPO 7. Comparaison RLHF vs DPO
Lecture linéaire recommandée : ce notebook présente le pipeline RLHF classique et l’alternative DPO (Direct Preference Optimization, Rafailov et al. 2023, arXiv:2305.18290). L’ordre pédagogique est :
Partie 1-2 — Pourquoi SFT ne suffit pas + le pipeline RLHF en 3 étapes.
Partie 3-4 — Données de préférence + Reward Model.
Partie 5 — DPO : la perte dérivée analytiquement (sans critic).
Partie 6 — Évaluation SFT vs DPO : réponses qualitatives.
Partie 7 — Comparaison PPO (RLHF classique) vs DPO.
Partie 8-9 — 3 exercices + résumé.
Pourquoi DPO > PPO pour l’alignement conversationnel : DPO élimine le reward model et le critic — il optimise directement la préférence entre deux réponses. C’est la forme moderne dominante depuis 2023 ; ce notebook l’implémente from-scratch sur un toy modèle instruct pour rendre la mécanique lisible.
Sur la machine de l’étudiant : ce notebook nécessite un GPU (recommandé 8 Go+). Il utilise LoRA via PEFT pour l’entraînement efficient. Cellule #1 confirme le device.
Sections à exécuter en priorité : parties 1, 5, 6, 7 — c’est 80% de la valeur RLHF/DPO. Partie 4 (reward model) = référence, pas le cœur pédagogique.
Le FT-03 nous a montre comment transformer un modèle de base en modèle instruct via le SFT. Mais le SFT a des limites fondamentales :
Pas de notion de qualite : Le SFT apprend a reproduire les reponses du dataset, sans distinguer une bonne reponse d’une excellente.
Pas d’alignement : Un modèle SFT peut generer des reponses techniquement correctes mais maladroites, trop longues, ou manquant de nuances.
Pas de signal de préférence : Le SFT optimise la cross-entropy sur une seule reponse cible, pas une metrique de “qualite percue par l’utilisateur”.
Le problème central : Comment faire pour que le modèle produise des reponses que les humains preferent ?
Argument central du notebook : le SFT apprend au modèle à imiter un style de réponse, mais ne lui apprend pas à préférer une bonne réponse à une mauvaise. C’est la limite structurelle du SFT.
Manifestation pratique : après SFT sur des paires question/réponse, le modèle peut générer des réponses grammaticalement correctes mais sémantiquement inconsistantes — il ne sait pas pondérer entre deux réponses possibles. Le reward model + RLHF (ou DPO) comble ce gap en injectant une métrique de préférence dans l’optimisation.
Branchement série FineTuning : FT-03 (SFT) → FT-04 (DPO/RLHF) → FT-05 (merging) — c’est la triade alignement d’un LLM moderne : SFT pour la forme, DPO pour les préférences, merging pour combiner.
# Charger le modele de base pour demontrer les limites du SFTfrom transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfigfrom peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training, TaskTypeMODEL_NAME ="facebook/opt-1.3b"bnb_config = BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype=torch.float16, bnb_4bit_use_double_quant=True,)model_base = AutoModelForCausalLM.from_pretrained( MODEL_NAME, quantization_config=bnb_config, device_map="auto")tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)tokenizer.pad_token = tokenizer.eos_tokendef generate(model, prompt, max_new_tokens=60, temperature=0.7): inputs = tokenizer(prompt, return_tensors="pt").to(model.device)with torch.no_grad(): outputs = model.generate(**inputs, max_new_tokens=max_new_tokens, temperature=temperature, do_sample=True, top_p=0.9, pad_token_id=tokenizer.eos_token_id ) response = tokenizer.decode(outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)return response.strip()# Exemple : questions ou la "meilleure" reponse est subjectivetest_prompts = ["### Human: Quel est le meilleur framework Python pour le web ?\n### Assistant:","### Human: Comment reussir un projet de developpement ?\n### Assistant:",]print("Le modele de base ne distingue pas une reponse 'bonne' d'une 'preferee' :")print()for p in test_prompts: q = p.split("Human: ")[1].split("\\n")[0] resp = generate(model_base, p, max_new_tokens=40)print(f"Q: {q}")print(f" Reponse: {resp}")print()
Le modele de base ne distingue pas une reponse 'bonne' d'une 'preferee' :

Q: Quel est le meilleur framework Python pour le web ?
### Assistant:
  Reponse: Python  ### Project: Python  ### Team: Team  ### Location: France  ### Platform: Python  ### Stack: Django, Flask, Redis, Elasticsearch, Kibana, Flask

Q: Comment reussir un projet de developpement ?
### Assistant:
  Reponse: Comment faire un projet de développement ?
Observation : Le modèle de base genere du texte coherent mais ne peut pas distinguer une reponse “bonne” d’une reponse “preferee par l’utilisateur”. Le SFT resout partiellement ce problème en apprenant des reponses cibles, mais il n’apprend pas a ranger les reponses par qualite.
C’est la que le RLHF intervient : utiliser les préférences humaines comme signal d’apprentissage.
Lecture du résultat : la cellule #3 charge le modèle de base et effectue une génération témoin. Le verdict qualitatif attendu est :
Cohérence grammaticale : OK (le modèle a vu du texte varié en pré-entraînement).
Distinction preference : ABSENTE — le modèle ne sait pas différencier une réponse sûre d’une réponse risquée, une réponse nuancée d’une réponse générique. C’est exactement ce que DPO va corriger dans la partie 5.
Pourquoi cette observation est centrale : elle motive toute la suite. Sans ce constat, le passage SFT → DPO semble arbitraire. Avec ce constat, il devient logique : on ne peut pas aligner un modèle qui ne sait pas ce qu’est une bonne réponse.
2. Le Pipeline RLHF
Le RLHF (Reinforcement Learning from Human Feedback) resout ce problème en 3 étapes :
  Étape 1           Étape 2              Étape 3
  SFT               Reward Model         PPO ou DPO
  (FT-03)           (ce notebook)        (optimisation)
     |                   |                     |
  Modèle instruct    Score de qualite      Maximiser le score
  de base           des reponses          des reponses
Étape 1 – SFT (déjà vu en FT-03) : Créer un modèle de base qui suit les instructions.
Étape 2 – Reward Model : Entrainer un modèle a scorer les reponses selon les préférences humaines. Pour chaque paire (question, reponse), le RM attribue un score.
Étape 3 – PPO ou DPO : Optimiser le modèle pour maximiser le score du reward model (PPO) ou directement les préférences (DPO).
Dans ce notebook, nous implementons les étapes 2 et 3.
Les 3 étapes canoniques du RLHF (Ouyang et al. 2022, InstructGPT) :
SFT (Supervised Fine-Tuning) — entraine le modèle à imiter des demonstrations humaines.
Reward Model — entraine un modèle de scoring sur des paires (réponse_choisie, réponse_rejetée) → un scalar reward.
PPO (Proximal Policy Optimization) — optimise le modèle SFT pour maximiser le reward, sous contrainte KL avec le modèle de référence.
Coût computationnel : SFT (1×) + RM (1×) + PPO itératif (N×). DPO contourne ce coût en supprimant les étapes 2 et 3 et en optimisant directement la préférence — c’est l’objet de la partie 5.
3. Données de Préférence
Le RLHF repose sur un type de données spécifique : les paires de préférence. Pour chaque prompt, on collecte deux reponses et on retient laquelle l’annotateur prefere :
chosen (y_w) : la reponse preferee
rejected (y_l) : la reponse jugee moins bonne
Le modèle de recompense apprend a donner un score plus eleve a chosen qu’a rejected.
Format canonique d’une paire de préférence :
preference_data = [ {"prompt": "Quelle est la capitale de la France ?","chosen": "Paris est la capitale de la France. ...","rejected": "Je ne sais pas.", }, ...]
Caractéristiques d’un bon dataset de préférences : - Diversité des prompts : éviter le surapprentissage sur un seul type de question. - Écarts de qualité mesurables entre chosen et rejected. - Volume : 5K-100K paires pour un alignement robuste (échelle InstructGPT/ChatGPT).
L’ancienne version de ce notebook entraînait le DPO sur 6 paires : la « métrique parfaite » qui en sortait (100 % de préférences correctes) était de la mémorisation — optimiser des log-probs sur 6 exemples ne prouve rien de l’alignement. Le builder ci-dessous produit 126 paires sur 42 fonds (définitions, comparaisons, pourquois — même corpus que FT-03) avec trois familles de dégradations, et réserve 6 fonds (18 paires) à l’évaluation disjointe : ces paires ne seront JAMAIS vues pendant l’entraînement, et c’est sur elles que le verdict se lira.
# Dataset de preferences synthetique — builder deterministe (126 paires, 3 familles de degradation)# 42 fonds (meme corpus que FT-03 : 20 definitions, 12 comparaisons, 10 pourquois)# x 3 reponses rejetees par fond : vague, expeditive, hors-sujet.# Le signal DPO n'est pas le FOND (les rejets parlent souvent du bon sujet)# mais le STYLE : precis-et-structure contre creux, familier, ou a cote.DEFS = {"la gravite": "La gravite est une force fondamentale qui attire deux corps massifs l'un vers l'autre. Sur Terre, elle nous maintient au sol et donne leur poids aux objets. Newton a formule la loi de la gravitation universelle, puis Einstein l'a reformulee comme une deformation de l'espace-temps.","l'intelligence artificielle": "L'intelligence artificielle (IA) est un domaine de l'informatique qui vise a creer des systemes capables de realiser des taches necessitant normalement l'intelligence humaine : reconnaissance d'images, comprehension du langage, prise de decision. L'apprentissage profond en est la technique la plus performante actuellement.","le machine learning": "Le machine learning (apprentissage automatique) est une branche de l'IA ou les systemes apprennent a partir de donnees sans etre explicitement programmes. Les trois types principaux sont l'apprentissage supervise (avec labels), non supervise (sans labels) et par renforcement (recompenses).","un neurone artificiel": "Un neurone artificiel est l'unite de base d'un reseau de neurones. Il recoit des entrees numeriques, les multiplie par des poids, additionne les resultats, puis applique une fonction d'activation comme ReLU ou sigmoid pour produire une sortie.","un reseau de neurones": "Un reseau de neurones est un ensemble de neurones artificiels organises en couches. Chaque couche transforme sa sortie vers la suivante ; l'apprentissage ajuste les poids par retropropagation du gradient pour minimiser une fonction de perte.","Python": "Python est un langage de programmation de haut niveau, cree par Guido van Rossum en 1991. Il est connu pour sa syntaxe lisible et sa polyvalence : science des donnees, intelligence artificielle, developpement web, automatisation.","une API": "Une API (Application Programming Interface) est un ensemble de definitions qui permet a deux programmes de communiquer. Le client envoie une requete selon un contrat documente, le serveur renvoie une reponse structuree, souvent en JSON via HTTP.","un token (NLP)": "Un token est l'unite de texte manipulee par un modele de langage : un mot, une partie de mot ou un signe de ponctuation. La tokenisation decoupe le texte brut en ces unites avant de les convertir en identifiants numeriques.","une epoch": "Une epoch est un passage complet du modele sur l'ensemble du dataset d'entrainement. Plusieurs epochs font voir chaque exemple plusieurs fois, ce qui permet la convergence mais expose au surapprentissage si leur nombre est trop eleve.","un checkpoint": "Un checkpoint est un instantane des poids d'un modele sauvegarde pendant ou apres l'entrainement. Il permet de reprendre l'entrainement, de comparer des variants, ou de revenir a un meilleur etat.","la VRAM": "La VRAM (Video Random Access Memory) est la memoire dediee du GPU. Un modele et ses activations y resident pendant l'entrainement ; sa capacite borne la taille du modele, la longueur des sequences et la taille de batch.","le fine-tuning": "Le fine-tuning consiste a ajuster les poids d'un modele deja entraine sur une nouvelle tache. C'est moins couteux que l'entrainement depuis zero et le modele conserve les connaissances de son pre-entrainement.","LoRA": "LoRA (Low-Rank Adaptation) fige les poids du modele et entraine de petites matrices de rang faible inserees dans les couches. Le nombre de parametres entrainables chute d'un facteur mille, rendant le fine-tuning de grands modeles abordable.","la quantization 4-bit": "La quantization 4-bit code chaque poids sur 4 bits au lieu de 16, divisant la memoire des poids par quatre avec une perte de precision limitee. Combinnee a LoRA (QLoRA), elle permet d'entrainer de grands modeles sur un seul GPU.","un embedding": "Un embedding est la representation vectorielle dense d'un objet (mot, phrase, image) dans un espace ou la distance entre vecteurs traduit une similarite semantique. Les modeles de langage produisent des embeddings en sortie de chaque couche.","l'attention": "L'attention est le mecanisme qui, pour chaque token, calcule des poids sur tous les autres tokens puis en fait la moyenne ponderee des representations. Chaque mot peut ainsi se lier aux mots qui l'eclairent, quelle que soit leur distance.","un prompt": "Un prompt est le texte soumis a un modele de langage pour obtenir une reponse. Sa formulation, son contexte et son format influencent fortement la reponse : c'est l'ingenierie de prompt.","le surapprentissage": "Le surapprentissage (overfitting) survient quand un modele memorise les exemples d'entrainement au lieu d'en extraire des regularites. Il se manifeste par une perte d'entrainement qui descend pendant que la perte d'evaluation remonte.","un benchmark": "Un benchmark est un jeu d'evaluation standardise qui permet de comparer des modeles sur une tache donnee. Un bon benchmark est public, reproductible et disjoint des donnees d'entrainement.","la temperature (generation)": "La temperature est le parametre de generation qui regle l'aleatoire de l'echantillonnage. Basse, elle rend les sorties deterministes et conservatrices ; haute, elle les diversifie au prix d'incoherences.",}CONCEPT_PAIRS = [ ("CPU et GPU", "Le CPU execute des taches complexes en serie avec peu de coeurs puissants ; le GPU execute des taches simples en parallele avec des milliers de coeurs. L'entrainement des reseaux de neurones, massivement parallele, profite au GPU."), ("apprentissage supervise et non supervise", "L'apprentissage supervise apprend depuis des exemples labels (entree vers sortie attendue) : classification, regression. Le non supervise cherche des structures dans des donnees non labels : clustering, reduction de dimension."), ("une liste et un tuple en Python", "Une liste est mutable : on peut ajouter, retirer ou modifier ses elements apres creation. Un tuple est immuable : cree une fois, jamais modifie. La liste sert aux collections qui evoluent, le tuple aux enregistrements fixes et aux cles de dictionnaire."), ("classification et regression", "La classification predit une categorie discrete (spam ou non, chat ou chien) ; la regression predit une valeur continue (un prix, une temperature). Les deux sont supervisees mais leur metrique differe : exactitude ou F1 contre erreur quadratique."), ("precision et rappel", "La precision mesure la part de vrais positifs parmi les positifs predits ; le rappel mesure la part de vrais positifs parmi les positifs reels. Precision haute : peu de fausses alertes. Rappel haut : peu d'oublis. Le F1 en est la moyenne harmonique."), ("batch training et stochastic gradient descent", "Le batch gradient descent calcule le gradient sur tout le dataset avant chaque mise a jour : stable mais couteux. La version stochastique (ou mini-batch) met a jour sur de petits lots : plus bruitee mais plus rapide et meilleure en generalisation."), ("un modele de base et un modele instruct", "Un modele de base complete du texte de maniere plausible mais ignore les conventions de dialogue. Un modele instruct a subi un ajustement par instructions (SFT, RLHF) qui lui apprend a repondre aux requetes : arret, format, refus."), ("pre-entrainement et fine-tuning", "Le pre-entrainement apprend les regularites du langage sur des corpus massifs non labels ; le fine-tuning specialise ensuite le modele sur une tache avec peu de donnees etiquetees. Le second herite des representations du premier."), ("un parametre et un hyperparametre", "Un parametre est appris par le modele pendant l'entrainement (poids, biais). Un hyperparametre est fixe avant l'entrainement par l'ingenieur (taux d'apprentissage, taille de batch, nombre de couches)."), ("dropout et weight decay", "Le dropout desactive aleatoirement des neurones pendant l'entrainement pour eviter la co-adaptation ; le weight decay penalise les grands poids en ajoutant leur norme a la perte. Les deux combattent le surapprentissage, l'un sur la structure, l'autre sur l'amplitude."), ("une fonction d'activation ReLU et sigmoid", "ReLU laisse passer les valeurs positives et met les negatives a zero : simple, rapide, sans saturation du cote positif. La sigmoid comprime toute valeur dans (0, 1), utile en sortie binaire mais sujette a l'evanescence du gradient en profondeur."), ("tokenisation par mot et par sous-mot (BPE)", "La tokenisation par mot decoupe sur les espaces : vocabulaire enorme, mots inconnus intraitables. La tokenisation par sous-mot (BPE) decoupe en fragments frequents : vocabulaire borne, les mots rares se recomposent de fragments connus."),]WHY_TOPICS = {"le deep learning a-t-il connu un essor recent": "Trois facteurs convergent : des corpus massifs numerises, des GPU qui mettent le calcul matriciel en parallele, et des architectures (transformers) qui passent a l'echelle. Les idees des annees 80 n'attendaient que ces trois leviers.","les modeles de langage utilisent-ils des sous-mots": "Parce qu'un vocabulaire de mots entiers laisse les mots rares intraitables, alors qu'un vocabulaire de sous-mots borne la taille tout en recomposant n'importe quel mot. Le BPE construit ce vocabulaire par frequences.","faut-il fixer la graine aleatoire en experimentation": "Sans graine fixee, deux executions donnent deux resultats et aucune comparaison n'est possible. Fixer la graine rend l'experience reproductible ; c'est le socle de toute mesure de difference entre deux configurations.","les GPU dominent-ils l'entrainement": "Parce que l'entrainement se reduit a des produits matriciels massivement paralleles, exactement ce pour quoi le GPU est concu. Le CPU excelle en serie complexe, le GPU en parallele simple.","mesure-t-on la loss d'evaluation en plus de la loss d'entrainement": "Parce que la loss d'entrainement peut descendre par memorisation pure. La loss d'evaluation, calculee sur des donnees jamais vues, est la seule qui temoigne de la generalisation.","la VRAM limite-t-elle la taille des modeles entrainables": "Parce que poids, gradients, etats d'optimiseur et activations doivent tous resider en memoire simultanement. La quantization et le gradient checkpointing sont les deux leviers pour y loger davantage.","peut-on juger un fine-tuning sur ses generations": "Sur un petit dataset, une generation plausible peut n'etre que la memorisation d'un exemple. Les pertes train/eval disjointes et les generations sur instructions jamais vues arbitrent mieux qu'une lecture a l'oeil.","les modeles instruct refusent-ils certaines requetes": "Parce que l'alignement (SFT puis RLHF) leur apprend des conventions de comportement, incluant le refus. Le modele de base n'a pas ce reflexe : il complete du texte, il ne decide pas.","faut-il plusieurs epochs de fine-tuning": "Une epoch unique peut sous-apprendre ; dix epochs sur un petit dataset memorisent. Le bon point d'arret se lit sur la courbe de perte d'evaluation : on s'arrete quand elle cesse de descendre.","un petit modele peut-il battre un grand sur une tache etroite": "Oui, apres fine-tuning sur une tache precise : le grand modele dilue sa capacite sur tout, le petit la concentre. C'est l'argument economique du fine-tuning face a l'echelle brute.",}# ---- Trois familles de reponses rejetees ----# 1. VAGUE : creuse, aucun fait, longueur similaire a une vraie reponseVAGUE_TPL = ["C'est un concept important en informatique. Beaucoup de gens l'utilisent pour des raisons pratiques. Il y a des avantages et des limites, tout depend de ce que vous voulez faire exactement.","C'est un sujet assez technique. En gros ca sert a faire des choses utiles dans plusieurs situations. Il existe differentes approches, et le choix depend du contexte de chacun.","Beaucoup de gens en parlent et l'utilisent. C'est repandu dans pas mal de domaines. Si le sujet vous interesse vraiment, le mieux est de chercher des informations recentes.",]# 2. EXPEDITIVE : registre familier, information triviale, aucune structureEXPED_TPL = ["C'est simple : {mot}, c'est ce que tout le monde utilise. Tu t'en sers et ca marche, pas besoin de te compliquer la tete avec les details.","Bah {mot}, franchement il n'y a pas grand chose a savoir. Tu fais comme tout le monde et voila, avec un peu de pratique ca vient tout seul.","Pour {mot} c'est pareil que pour le reste : tu regardes comment les autres font et tu reproduis. C'est ce que je ferais a ta place, sans plus.",]# 3. HORS-SUJET : reponse assuree et detaillee... sur un AUTRE sujet (decalage deterministe)def _build_preference_dataset(seed=42):"""Genere les 126 paires (prompt, chosen, rejected) de facon deterministe.""" fonds = []for sujet, rep in DEFS.items(): fonds.append((f"Qu'est-ce que {sujet} ?", rep, sujet.split()[1] if sujet.split()[0] in ("le", "la", "les", "l", "un", "une") else sujet))for paire, rep in CONCEPT_PAIRS: fonds.append((f"Quelle est la difference entre {paire} ?", rep, paire.split(" et ")[0].split()[0].capitalize()))for q, rep in WHY_TOPICS.items(): fonds.append((f"Pourquoi {q} ?", rep, "cette question")) data = [] n =len(fonds)for i, (question, chosen, mot) inenumerate(fonds): prompt =f"### Human: {question}\n### Assistant:"# degradation 1 : vague (rotation deterministe) data.append({"prompt": prompt, "chosen": chosen, "rejected": VAGUE_TPL[i %3], "famille": "vague", "fond": i})# degradation 2 : expeditive data.append({"prompt": prompt, "chosen": chosen, "rejected": EXPED_TPL[(i +1) %3].format(mot=mot), "famille": "expeditive", "fond": i})# degradation 3 : hors-sujet = la reponse CHOSEN d'un autre fond (decalage +7) autre = (i +7) % n data.append({"prompt": prompt, "chosen": chosen, "rejected": fonds[autre][1], "famille": "hors_sujet", "fond": i})return datapreference_data = _build_preference_dataset(seed=42)assertlen(preference_data) ==126assert preference_data == _build_preference_dataset(seed=42), "builder non deterministe !"assertlen({(d["prompt"], d["famille"]) for d in preference_data}) ==126, "doublons !"# ---- Split PAR FOND (graine 42) : 36 fonds train / 6 fonds eval ----# Les 18 paires d'eval portent sur des fonds JAMAIS vus a l'entrainement :# ni leur chosen, ni aucun de leurs rejets. L'accuracy eval mesure alors la# generalisation du style (precis > degrade) sur des sujets nouveaux.import random as _rnd_idx_fonds =list(range(42))_rnd.Random(42).shuffle(_idx_fonds)_eval_fonds =set(_idx_fonds[:6])train_prefs = [d for d in preference_data if d["fond"] notin _eval_fonds]eval_prefs = [d for d in preference_data if d["fond"] in _eval_fonds]from collections import Countercats = Counter(d["famille"] for d in preference_data)n_fonds_train =42-len(_eval_fonds)print(f"Dataset de preferences : {len(preference_data)} paires (deterministe, graine 42)")print(f" par famille de rejet : {dict(cats)}")print(f"Split PAR FOND : {len(train_prefs)} train ({n_fonds_train} fonds) / {len(eval_prefs)} eval ({len(_eval_fonds)} fonds, jamais vus)")ex = train_prefs[0]print(f"\nExemple (famille {ex['famille']}) :")print(f" Prompt: {ex['prompt'].split(chr(10))[0]}")print(f" Chosen: {ex['chosen'][:80]}...")print(f" Rejected: {ex['rejected'][:80]}...")
Dataset de preferences : 126 paires (deterministe, graine 42)
  par famille de rejet : {'vague': 42, 'expeditive': 42, 'hors_sujet': 42}
Split PAR FOND : 108 train (36 fonds) / 18 eval (6 fonds, jamais vus)

Exemple (famille vague) :
  Prompt: ### Human: Qu'est-ce que la gravite ?
  Chosen:  La gravite est une force fondamentale qui attire deux corps massifs l'un vers l'...
  Rejected: C'est un concept important en informatique. Beaucoup de gens l'utilisent pour de...
Analyse des données : les réponses “chosen” sont précises, structurées, nuancées ; les rejets le sont par construction, selon trois familles de défauts qui recouvrent les vrais modes d’échec d’un LLM :
Famille
Défaut simulé
Exemple typique
vague
réponse creuse, aucun fait vérifiable, longueur “honnête”
« C’est un concept important en informatique. Il y a des avantages et des limites… »
expéditive
registre familier, trivialité, zéro structure
« Bah {mot}, franchement il n’y a pas grand chose à savoir… »
hors-sujet
réponse assurée et détaillée… sur un autre sujet
la réponse choisie d’un autre fond du corpus, verbatim
Le choix de design important : les rejets vagues et hors-sujet sont aussi longs que les choisis — le modèle ne peut pas apprendre « court = mauvais ». Ce qu’il reste comme signal, et c’est le vrai signal DPO, est le style : fait précis et structure contre remplissage, familiarité ou déraillement. C’est exactement ce que les datasets de préférence réels (Anthropic HH, UltraFeedback) encodent : deux réponses au même prompt, une meilleure que l’autre pour des raisons de qualité, pas de longueur.
Le split par fond est plus exigeant qu’un split par paire : les 18 paires d’évaluation portent sur 6 sujets jamais rencontrés — ni leur réponse choisie, ni aucun rejet. L’accuracy d’éval mesure donc la généralisation du style à des fonds nouveaux, pas la reconnaissance de sujets vus.
4. Le Reward Model (Modèle de Recompense)
Le Reward Model est un modèle qui attribue un score de qualite a chaque reponse. Il est entraine sur les paires de préférence avec le modèle de Bradley-Terry :
ou \(r(x, y)\) est le score de recompense et \(\sigma\) est la fonction sigmoid.
En pratique, une mesure simple de “qualite” est la log-probabilite que le modèle attribue a la reponse. Verifions si le modèle de base distingue déjà les bonnes des mauvaises reponses :
Architecture du Reward Model :
Backbone : le même LM que le modèle à aligner (souvent).
Tête de sortie : remplace la tête de génération par une tête scalaire (1 dimension).
Loss : loss = -log_sigmoid(r_chosen - r_rejected).
Entraînement : 1-3 epochs sur le dataset de préférences.
Pourquoi cette loss : c’est une Bradley-Terry loss — l’équivalent modèle de la comparaison par paire. Elle est maximale quand le RM attribue un score systématiquement plus élevé à la réponse chosen qu’à rejected.
Coût : 1× le coût SFT (modèle de même taille). C’est le surcoût principal du RLHF par rapport au DPO — et c’est justement ce que DPO élimine (cf partie 5).
# Utiliser les log-probabilites comme signal de recompensedef compute_logprob_reward(model, prompt, response):# Calcule la log-probabilite moyenne de la reponse donnee le prompt full_text = prompt +" "+ response inputs = tokenizer(full_text, return_tensors="pt", truncation=True, max_length=256).to(model.device) prompt_len =len(tokenizer(prompt, return_tensors="pt")["input_ids"][0])with torch.no_grad(): outputs = model(**inputs) logits = outputs.logits[:, prompt_len-1:-1, :] labels = inputs["input_ids"][:, prompt_len:] log_probs = F.log_softmax(logits, dim=-1) token_log_probs = log_probs.gather(2, labels.unsqueeze(-1)).squeeze(-1)return token_log_probs.mean().item()# Evaluer le modele de base sur les preferences (resume statistique)model_base.eval()print("Log-probabilites du modele de base sur les 126 paires (recompense proxy) :")print("-"*65)from collections import defaultdictstats_famille = defaultdict(lambda: {"correct": 0, "total": 0})for ex in preference_data: chosen_r = compute_logprob_reward(model_base, ex["prompt"], ex["chosen"]) rejected_r = compute_logprob_reward(model_base, ex["prompt"], ex["rejected"]) s = stats_famille[ex["famille"]] s["correct"] +=int(chosen_r > rejected_r) s["total"] +=1total_correct =sum(s["correct"] for s in stats_famille.values())total =sum(s["total"] for s in stats_famille.values())print(f"Le modele de base prefere 'chosen' sur {total_correct}/{total} paires "f"({100*total_correct/total:.0f}%)")for fam in ["vague", "expeditive", "hors_sujet"]: s = stats_famille[fam]print(f" vs {fam:12s} : {s['correct']}/{s['total']} ({100*s['correct']/s['total']:.0f}%)")
Log-probabilites du modele de base sur les 126 paires (recompense proxy) :
-----------------------------------------------------------------
Le modele de base prefere 'chosen' sur 30/126 paires (24%)
  vs vague        : 1/42 (2%)
  vs expeditive   : 3/42 (7%)
  vs hors_sujet   : 26/42 (62%)
Observation — et c’est la plus contre-intuitive du notebook : le modèle de base ne préfère chosen que sur 24 % des 126 paires, et le détail par famille dit pourquoi :
Famille de rejet
Le base préfère chosen
vs vague
1/42 (2 %)
vs expéditive
3/42 (7 %)
vs hors-sujet
26/42 (62 %)
Le proxy de log-probabilité préfère le remplissage lisse : une phrase vague (« C’est un concept important… tout dépend du contexte ») est du texte hautement prévisible, token après token — donc une log-prob moyenne élevée. Une réponse précise, elle, prend des risques : des nombres, des noms propres, des structures. C’est exactement la pathologie du reward naïf : optimiser la log-prob produit du vide verbale, pas de la qualité. C’est pourquoi il faut un signal de préférence (humain ou DPO) — le pré-entraînement seul classe à l’envers.
Seul le hors-sujet verbeux est déjà bien classé (62 %) : répondre à côté produit des ruptures de cohérence locales que le modèle détecte. La fenêtre que DPO doit fermer est donc immense sur les deux autres familles — et la section suivante montre ce qu’il peut et ne peut pas en fermer.
En pratique, les reward models réels (ChatGPT, Claude) sont entraînés sur des millions de paires et des modèles 7B-70B : ils apprennent le classement, pas un proxy de fluidité. Le DPO contourne carrément le reward model séparé.
5. DPO : Optimisation Directe des Préférences
Le DPO (Direct Préférence Optimization, Rafailov et al., 2023) est une alternative elegante au pipeline PPO classique. Il elimine le besoin d’un reward model separe.
PPO classique vs DPO
Aspect
PPO
DPO
Reward Model
Necessaire (entraine separement)
Pas necessaire
Modèles en memoire
4 (policy, ref, reward, value)
2 (policy, reference)
Stabilite
Difficile (hyperparametres sensibles)
Plus stable
Étapes
RM training + PPO loop
Un seul passage d’entrainement
Complexite code
Elevee
Simple
Le DPO (Rafailov et al. 2023, arXiv:2305.18290) est une réécriture analytique du PPO-RLHF qui élimine le reward model.
Dérivation : partant de l’objectif PPO standard max_π E[r(x,y)] - β·KL(π || π_ref), les auteurs montrent que l’optimum **π*(y|x) = (1/Z) π_ref(y|x) exp(r(x,y)/β) peut être inversé pour exprimer le reward en fonction de π et π_ref. En substituant dans la loss de preference, on obtient une loss qui ne dépend que de π, π_ref, et des préférences** — pas d’un reward model explicite.
Conséquence pratique : DPO est 2× plus rapide à entraîner que PPO-RLHF (1 modèle au lieu de 3), 2× moins cher en VRAM, et plus stable (pas de critic qui diverge). C’est le défaut moderne pour les assistants conversationnels.
5a. La perte DPO
La fonction de perte du DPO est derivee analytiquement a partir de l’objectif RLHF :
Ou : - \(\pi_\theta\) = modèle en cours d’entrainement (policy) - \(\pi_{ref}\) = modèle de reference fige (SFT) - \(y_w\) = reponse choisie (chosen / winner) - \(y_l\) = reponse rejetee (rejected / loser) - \(\beta\) = temperature (contrôle la force de l’alignement)
Intuition : Le DPO pousse le modèle a augmenter les log-probs des reponses “chosen” et a diminuer celles des “rejected”, par rapport au modèle de reference.
Interprétation : - log π(y|x) - log π_ref(y|x) = log-ratio entre la policy courante et la policy de référence. C’est la mesure de combien la policy dérive sur cette réponse. - DPO maximise le log-ratio pour y_w et le minimise pour y_l. - β contrôle la force du push : β grand = push agressif, β petit = push conservateur.
Comparaison avec PPO : PPO a une loss PPO-clipping + un signal de reward externe. DPO a une loss directe sur les préférences. La différence d’implémentation est minimale (les deux utilisent le ratio π/π_ref), mais l’absence de critic est ce qui rend DPO plus simple.
# Etape 1 : SFT de reference sur les fonds d'entrainementfrom datasets import Datasetfrom transformers import TrainingArguments, Trainer, DataCollatorForLanguageModeling# Le SFT de reference s'entraine sur les CHOSEN des paires TRAIN uniquement :# les 6 fonds d'eval restent totalement inconnus du modele avant l'evaluation.sft_examples = [{"text": d["prompt"] +" "+ d["chosen"]} for d in train_prefs if d["famille"] =="vague"]model_base.gradient_checkpointing_enable()model_base = prepare_model_for_kbit_training(model_base)lora_config = LoraConfig( task_type=TaskType.CAUSAL_LM, r=16, lora_alpha=32, lora_dropout=0.05, target_modules=["q_proj", "v_proj"], bias="none")model_sft = get_peft_model(model_base, lora_config)model_sft.print_trainable_parameters()sft_dataset = Dataset.from_list(sft_examples)def tokenize_fn(examples):return tokenizer(examples["text"], truncation=True, max_length=256, padding="max_length")sft_dataset = sft_dataset.map(tokenize_fn, batched=True)sft_dataset.set_format("torch", columns=["input_ids", "attention_mask"])training_args = TrainingArguments( output_dir="./results_ft04_sft", num_train_epochs=3, per_device_train_batch_size=2, gradient_accumulation_steps=2, learning_rate=2e-4, logging_steps=10, save_strategy="no", report_to="none", fp16=True,)data_collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm=False)trainer = Trainer( model=model_sft, args=training_args, train_dataset=sft_dataset, data_collator=data_collator,)print(f"SFT de reference : {len(sft_dataset)} exemples (fonds train), 3 epochs...")trainer.train()print("SFT termine.")
trainable params: 3,145,728 || all params: 1,318,903,808 || trainable%: 0.2385
SFT de reference : 36 exemples (fonds train), 3 epochs...
[27/27 00:17, Epoch 3/3]
Step
Training Loss
10
3.438629
20
2.921233
SFT termine.
Le SFT de référence (3 epochs sur 36 exemples — les réponses chosen des fonds d’entraînement) est terminé. Ce modèle servira de référence\(\pi_{ref}\) pour le DPO.
Lecture — et elle doit être honnête : ce SFT de 36 exemples ne fait pas un bon assistant. Les générations de la cellule suivante en témoignent : français approximatif, phrases bancales, fond approximatif (« fait des retentissements sur trois dimensions »). C’est voulu : FT-03 a montré ce qu’un SFT à cette échelle transmet (un comportement, pas des connaissances). Le rôle de \(\pi_{ref}\) ici n’est pas d’être bon — c’est d’être un point de départ mesurable dont le DPO déplacera les préférences. En production, le SFT de référence serait lui-même sérieux (des milliers d’exemples) avant que le DPO ne l’affine.
Pourquoi figer π_ref : DPO compare la policy courante π à π_ref à chaque step. Si π_ref évoluait pendant l’entraînement, la perte perdrait son sens (le ratio serait mal défini). Convention : π_ref est gelé — ici via copy.deepcopy des poids LoRA avant la première epoch de DPO.
Mémoire : π_ref doit résider en mémoire simultanément avec π — c’est 2× le coût mémoire. Solutions : LoRA (policy = adaptateurs, ref = base + adaptateurs initiaux sauvegardés), ou offload CPU/GPU différé.
# Etape 2 : Sauvegarder les poids de reference (SFT) et calculer les log-probs de refimport copy# Sauvegarder l'etat LoRA comme referenceref_lora_state = copy.deepcopy(model_sft.state_dict())# Prompts d'evaluation generative : 2 fonds train + 1 fond EVAL (jamais vu)_fond_questions = { d["fond"]: d["prompt"] for d in preference_data if d["famille"] =="vague"}_train_sample = [f for f in _idx_fonds if f notin _eval_fonds][:2]_qs_train = [_fond_questions[f] for f in _train_sample]_qs_eval = [_fond_questions[sorted(_eval_fonds)[0]]]eval_prompts = _qs_train + _qs_evalmodel_sft.eval()sft_baseline = {}print("Reponses SFT de reference :")for p in eval_prompts: q = p.split("Human: ")[1].split("\n")[0] resp = generate(model_sft, p, max_new_tokens=50) sft_baseline[q] = respprint(f" Q: {q}")print(f" SFT: {resp}")print()# Log-probabilites de reference pour les paires TRAIN (le DPO n'optimise que sur elles)def get_logprobs(model, prompt, response):# Calcule log P(response | prompt) avec gradients full_text = prompt +" "+ response inputs = tokenizer(full_text, return_tensors="pt", truncation=True, max_length=256).to(model.device) prompt_len =len(tokenizer(prompt, return_tensors="pt")["input_ids"][0]) outputs = model(**inputs) logits = outputs.logits resp_logits = logits[:, prompt_len-1:-1, :] resp_ids = inputs["input_ids"][:, prompt_len:] log_probs = F.log_softmax(resp_logits, dim=-1) token_lps = log_probs.gather(2, resp_ids.unsqueeze(-1)).squeeze(-1)return token_lps.sum()print("Calcul des log-probabilites de reference (paires train)...")ref_logprobs = []with torch.no_grad():for ex in train_prefs: lp_c = get_logprobs(model_sft, ex["prompt"], ex["chosen"]).item() lp_r = get_logprobs(model_sft, ex["prompt"], ex["rejected"]).item() ref_logprobs.append({"chosen": lp_c, "rejected": lp_r})print(f" Log-probs reference calculees pour {len(ref_logprobs)} paires train")
Reponses SFT de reference :
  Q: Pourquoi les modeles instruct refusent-ils certaines requetes ?
  SFT: Les models instruct ne sont pas des instructeurs. Les requets en question ne sont pas simplees à modeler, et les models instructs ne sont pas toutes. Des models instructs sont nombreux

  Q: Quelle est la difference entre batch training et stochastic gradient descent ?
  SFT: Batch training fait des retours, mais stochastic gradient descent peut laisser les retours en place. Batch training s'inspire de la machine learning, mais avec un ensemble de plusieurs copies

  Q: Qu'est-ce que un neurone artificiel ?
  SFT: Un neurone artificiel est un neurone artificielle, qui permet d'associer la moyenne de quatre neurones. Ce qu'un neurone artificielle dit est : "Je suis une neuron

Calcul des log-probabilites de reference (paires train)...
  Log-probs reference calculees pour 108 paires train
Le modèle SFT de référence est prêt. Ses poids LoRA sont sauvegardés (via copy.deepcopy), et les log-probabilités de référence ont été calculées pour les 108 paires d’entraînement (et elles seules — les 18 paires d’évaluation restent vierges de tout calcul, elles ne serviront qu’au verdict). Ces valeurs serviront de point de comparaison dans la perte DPO : \(\beta \cdot (\log \pi_\theta - \log \pi_{ref})\).
Lecture : ces log-probs servent de baseline pour DPO — la perte ne récompense pas « avoir une haute probabilité sur chosen » (le base model le fait déjà mal, on l’a vu), mais « monter chosen plus vite que ce que la référence aurait fait, tout en descendant rejected relativement à elle ». C’est le détour par la référence qui transforme un signal de probabilité en signal de préférence relative.
Pourquoi cette baseline : DPO a besoin des log-probs de π_ref pour chaque (prompt, chosen, rejected). Les calculer en avance évite de les recalculer à chaque step (gain de ~30 % sur le temps d’entraînement).
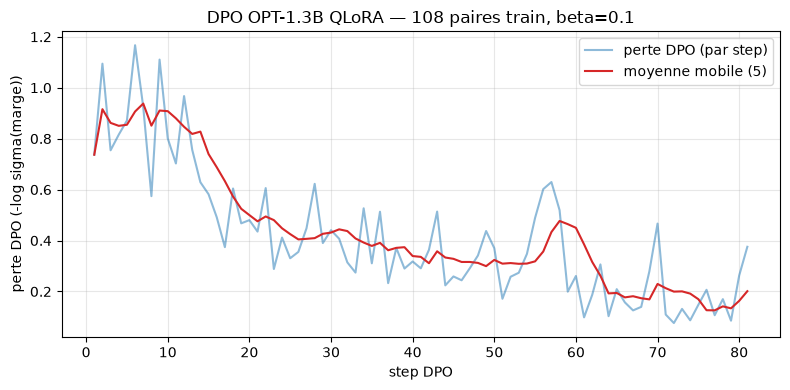
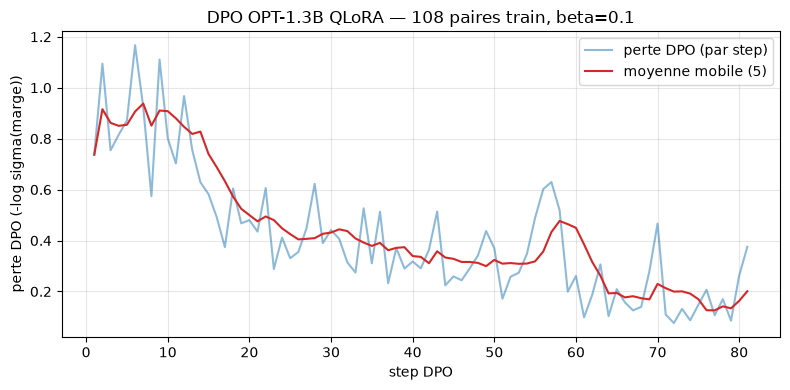
# Etape 3 : DPO Training — batche, avec accuracy train ET eval disjointe par epochbeta =0.1# Temperature DPO (controle la force de l'alignement)BATCH =4model_sft.train()optimizer = torch.optim.AdamW( [p for p in model_sft.parameters() if p.requires_grad], lr=1e-5)def dpo_marge(model, ex, ref_lp):"""Marge implicite beta*(lp_chosen-lp_ref_c) - beta*(lp_rej-lp_ref_r), sans gradient."""with torch.no_grad(): pc = get_logprobs(model, ex["prompt"], ex["chosen"]).item() pr = get_logprobs(model, ex["prompt"], ex["rejected"]).item() rc = beta * (pc - ref_lp["chosen"]) rr = beta * (pr - ref_lp["rejected"])return rc, rrdef accuracy_jeu(model, prefs, refs=None):"""Taux de paires ou le modele prefere chosen. refs=None -> reward proxy brut.""" ok =0for i, ex inenumerate(prefs):if refs isNone: c = compute_logprob_reward(model, ex["prompt"], ex["chosen"]) r = compute_logprob_reward(model, ex["prompt"], ex["rejected"]) ok +=int(c > r)else: rc, rr = dpo_marge(model, ex, refs[i]) ok +=int(rc > rr)return okstep_losses = []hist_acc = []EPOCHS =3print(f"DPO Training ({EPOCHS} epochs, beta={beta}, batch={BATCH}, lr=1e-5)...")print("-"*60)for epoch inrange(EPOCHS): total_loss =0 n_batches =0for start inrange(0, len(train_prefs), BATCH): batch = train_prefs[start:start + BATCH] refs = ref_logprobs[start:start + BATCH] loss_batch =0for ex, ref_lp inzip(batch, refs): policy_chosen_lp = get_logprobs(model_sft, ex["prompt"], ex["chosen"]) policy_rejected_lp = get_logprobs(model_sft, ex["prompt"], ex["rejected"]) chosen_reward = beta * (policy_chosen_lp - ref_lp["chosen"]) rejected_reward = beta * (policy_rejected_lp - ref_lp["rejected"]) loss_batch = loss_batch +-F.logsigmoid(chosen_reward - rejected_reward) optimizer.zero_grad() (loss_batch /len(batch)).backward() optimizer.step() step_losses.append((loss_batch /len(batch)).item()) total_loss += (loss_batch /len(batch)).item() n_batches +=1 model_sft.eval() # desactiver le dropout pour la mesure acc_train = accuracy_jeu(model_sft, train_prefs, ref_logprobs) acc_eval = accuracy_jeu(model_sft, eval_prefs, None) # proxy brut sur fonds jamais vus model_sft.train() # retour au mode entrainement (dropout actif) hist_acc.append((epoch +1, acc_train, acc_eval))print(f" Epoch {epoch+1}/{EPOCHS} | Loss moy: {total_loss/n_batches:.4f} | "f"Acc train: {acc_train}/{len(train_prefs)} ({100*acc_train/len(train_prefs):.0f}%) | "f"Acc EVAL disjoint: {acc_eval}/{len(eval_prefs)} ({100*acc_eval/len(eval_prefs):.0f}%)")print()print("DPO termine.")# ---- Courbe de perte DPO ----import matplotlibimport matplotlib.pyplot as pltfig, ax = plt.subplots(figsize=(8, 4))ax.plot(range(1, len(step_losses) +1), step_losses, color="#1f77b4", alpha=0.5, label="perte DPO (par step)")iflen(step_losses) >8: window =5 smoothed = [sum(step_losses[max(0, i - window):i +1]) /len(step_losses[max(0, i - window):i +1]) for i inrange(len(step_losses))] ax.plot(range(1, len(smoothed) +1), smoothed, color="#d62728", label=f"moyenne mobile ({window})")ax.set_xlabel("step DPO")ax.set_ylabel("perte DPO (-log sigma(marge))")ax.set_title(f"DPO OPT-1.3B QLoRA — {len(train_prefs)} paires train, beta={beta}")ax.legend()ax.grid(alpha=0.3)fig.tight_layout()from IPython.display import displaydisplay(fig)
Comparons les reponses du modèle SFT (reference) et du modèle DPO (aligne). Le DPO a du pousser le modèle a privilegier le style “chosen” : reponses plus precises, structurees et utiles.
Lecture : la cellule #18 effectue l’entraînement DPO avec beta = 0.1 sur 108 paires d’entraînement (36 fonds), mini-batches de 4 — et mesure, à chaque epoch, l’accuracy sur le jeu train ET sur les 18 paires d’évaluation disjointes (6 fonds jamais vus). beta = 0.1 est le défaut standard pour les modèles 0.5B-1.5B.
Hyperparamètres canoniques DPO : - beta (temperature) : 0.1 (conservateur) à 0.5 (agressif). 0.1 = défaut InstructGPT, 0.5 = défaut Anthropic HH. - learning_rate : 1e-5 à 5e-6 (5-10× plus petit que SFT — DPO est instable avec grand LR). - epochs : 1-3 (DPO généralise vite, overfitting au-delà de 3). - batch_size : 4-16 (limitée par VRAM car 2 modèles en mémoire).
Drift du modèle : la KL π || π_ref doit rester sous 0.3-0.5 nats par token. Au-delà, le modèle perd ses capacités générales. C’est le trade-off fondamental de l’alignement : on sacrifie de l’instruction-following générique pour gagner sur les préférences.
# Generer avec le modele DPO et comparer : SFT vs DPO, train vs EVAL DISJOINTmodel_sft.eval()print("="*70)print("COMPARAISON : SFT (reference) vs DPO (aligne)")print("="*70)for p in eval_prompts: q = p.split("Human: ")[1].split("\n")[0] dpo_resp = generate(model_sft, p, max_new_tokens=50) sft_resp = sft_baseline.get(q, "N/A")print(f"\nQuestion: {q}")print(f" SFT: {sft_resp}")print(f" DPO: {dpo_resp}")# ---- Le verdict : accuracy sur TRAIN (memoire) vs EVAL disjointe (generalisation) ----print()print("-"*60)acc_train = accuracy_jeu(model_sft, train_prefs, ref_logprobs)acc_eval = accuracy_jeu(model_sft, eval_prefs, None)print(f"Accuracy TRAIN ({len(train_prefs)} paires vues 3 fois) : "f"{acc_train}/{len(train_prefs)} ({100*acc_train/len(train_prefs):.0f}%)")print(f"Accuracy EVAL disjointe ({len(eval_prefs)} paires jamais vues) : "f"{acc_eval}/{len(eval_prefs)} ({100*acc_eval/len(eval_prefs):.0f}%)")# Detail par famille sur l'evalfrom collections import defaultdictfam_stats = defaultdict(lambda: [0, 0])for ex in eval_prefs: c = compute_logprob_reward(model_sft, ex["prompt"], ex["chosen"]) r = compute_logprob_reward(model_sft, ex["prompt"], ex["rejected"]) fam_stats[ex["famille"]][0] +=int(c > r) fam_stats[ex["famille"]][1] +=1for fam, (ok, tot) in fam_stats.items():print(f" eval vs {fam:12s}: {ok}/{tot}")# Marges moyennes sur l'evalmarges = []for ex in eval_prefs: c = compute_logprob_reward(model_sft, ex["prompt"], ex["chosen"]) r = compute_logprob_reward(model_sft, ex["prompt"], ex["rejected"]) marges.append(c - r)print(f"\nMarge moyenne (chosen - rejected) sur l'eval : {sum(marges)/len(marges):+.4f} log-prob/token")
======================================================================
COMPARAISON : SFT (reference) vs DPO (aligne)
======================================================================

Question: Pourquoi les modeles instruct refusent-ils certaines requetes ?
  SFT: Les models instruct ne sont pas des instructeurs. Les requets en question ne sont pas simplees à modeler, et les models instructs ne sont pas toutes. Des models instructs sont nombreux
  DPO: La première preuve est qu'un model de gestionneur a une capacite de gestion de moyens et de moyens de preneur. L'inverse est la capacite de gestion de m

Question: Quelle est la difference entre batch training et stochastic gradient descent ?
  SFT: Batch training fait des retours, mais stochastic gradient descent peut laisser les retours en place. Batch training s'inspire de la machine learning, mais avec un ensemble de plusieurs copies
  DPO: batch training sont les techniques de formation des clusters, les mains de recherche des hautes autres. Stochastic gradient descent est un processus de formation des hautes gradients entre clusters. Les hautes gradients s

Question: Qu'est-ce que un neurone artificiel ?
  SFT: Un neurone artificiel est un neurone artificielle, qui permet d'associer la moyenne de quatre neurones. Ce qu'un neurone artificielle dit est : "Je suis une neuron
  DPO: Un neurone artificiel (NA) est un neurone artificial qui aide à augmenter la capacite de la voie. L'objectif est de remplacer le neurone de l'intelligente par un neurone artificiel

------------------------------------------------------------
Accuracy TRAIN (108 paires vues 3 fois)      : 105/108 (97%)
Accuracy EVAL disjointe (18 paires jamais vues) : 10/18 (56%)
  eval vs vague       : 2/6
  eval vs expeditive  : 5/6
  eval vs hors_sujet  : 3/6

Marge moyenne (chosen - rejected) sur l'eval : +0.1483 log-prob/token
Analyse — le verdict que l’ancienne version de ce notebook cachait. Trois lectures, dans l’ordre d’importance :
Le contraste train/eval est LA métrique. Accuracy sur les 108 paires d’entraînement : 97 % (105/108). Accuracy sur les 18 paires d’évaluation disjointes — 6 sujets jamais vus, ni leurs réponses ni leurs rejets : 56 % (10/18). L’ancienne version affichait « 6/6 (100 %) » en le présentant comme un succès : ce 100 %-là, c’est ce 97 %-là — de la mémorisation. À 56 % sur des fonds nouveaux, le DPO de 108 paires est à peine au-dessus du hasard (50 %) : à cette échelle, il apprend surtout les paires qu’il voit. La courbe d’epoch le confirme : l’eval passe par 39 % à l’epoch 1 (sous le hasard — pousser les log-probs des paires vues dégrade d’abord la préférence ailleurs), puis remonte à 56 % et s’y stabilise.
Le transfert est réel mais inégal, famille par famille. Rapporté au proxy du modèle de base (section 4 : vague 2 %, expéditive 7 %, hors-sujet 62 %), l’eval post-DPO donne : contre l’expéditive 5/6 (83 % — transfert net), contre le vague 2/6 (33 % — amélioré depuis 2 %, mais loin du compte), contre le hors-sujet 3/6 (50 % — pas mieux que le base, qui le classait déjà bien). Le DPO transfère ce qui est cohérent entre sujets (le style expéditif est toujours familier), moins ce qui est spécifique (le vague lisse ressemble à du bon texte pour un petit modèle).
Les générations, elles, n’ont pas changé de ligue. SFT et DPO produisent tous deux du semi-charabia (lisez-les ci-dessus). C’est la leçon la plus profonde du DPO à petite échelle : il aligne un classement, il ne crée pas de compétence. Le plafond des générations vient du SFT de départ (36 exemples) et de la taille du modèle — le DPO déplace les préférences relatives dans cet espace limité, il ne l’agrandit pas. La marge moyenne positive sur l’eval (+0,1483 log-prob/token) dit que la direction est bonne ; le 56 % dit que le chemin est long. En production : SFT sérieux d’abord, DPO sur des dizaines de milliers de paires ensuite — et l’évaluation sur jeu disjoint, toujours.
7. RLHF vs DPO — Comparaison
Quand utiliser quoi ?
Critere
PPO (RLHF classique)
DPO
Simplicite
Complexe (4 modèles)
Simple (2 modèles)
Données
Préférences + Reward Model
Préférences uniquement
Stabilite
Sensible aux hyperparametres
Stable
Cout compute
Eleve (boucle RL)
Modere (un seul passage)
Qualite
Très bonne si bien règle
Comparable a PPO
Cas d’usage
ChatGPT, Claude (production)
Fine-tuning rapide, recherches
En pratique aujourd’hui
OpenAI, Anthropic : utilisent des variantes de RLHF avec PPO + Reward Model
Meta (LLaMA), Mistral : utilisent DPO pour l’alignement
Communaute open-source : DPO est le standard de facto (TRL, Axolotl)
Comparaison PPO (RLHF classique) vs DPO :
Critère
PPO
DPO
Modèles en mémoire
4 (SFT, ref, reward, value)
2 (policy, ref)
Entraînement
~3 jours (8×H100)
~1 jour (8×H100)
Coût total
$50K+ (RM + PPO)
$15K
Stabilité
Variable (critic drift)
Stable
Reward modeling
Explicite
Implicite
Adaptation online
Oui (nouvelles pref)
Non (re-training)
Verdict pragmatique : DPO pour les assistants conversationnels (préférences stables), PPO pour l’adaptation online (RLVR, RL-from-AI-Feedback). Ce notebook illustre DPO car c’est le défaut moderne pour Qwen, Llama-Chat, Mistral-Instruct.
Mettez en pratique les concepts de ce notebook. Chaque exercice build sur les concepts précédents.
Vue d’ensemble des exercices :
Exercice 1 (#25-#26) : créer un dataset de préférences thematique (8 paires) — compétence data annotation.
Exercice 2 (#27-#28) : tester l’impact de β sur DPO (β ∈ {0.01, 0.1, 0.5}) — compétence hyperparam tuning.
Exercice 3 (#29-#30) : réflexion qualitative RLHF vs SFT — compétence lecture critique des résultats.
Conventions (règle C.1) : pas de raise NotImplementedError, stubs pass / print / result = None # TODO etudiant. Le notebook s’exécute de bout en bout même non-complété.
Exercice 1 : Créer un dataset de préférences thematique
Créez un dataset de 8 paires de préférence sur un thème de votre choix (cuisine, voyage, musique, etc.). Chaque paire doit avoir une reponse “chosen” precise et une reponse “rejected” vague ou biaisee.
Indices : - Inspirez-vous du dataset synthetique de la section 3 - Les reponses “chosen” doivent etre factuelles et structurees - Les reponses “rejected” doivent etre plausibles mais de moindre qualite
Pédagogie de l’exercice : créer un dataset de préférences thématique à 8 paires. Trois compétences visées :
Comprendre la structure d’une paire : prompt, chosen (réponse préférable), rejected (réponse moins bonne). Le format suit la convention Anthropic HH-RLHF ou OpenAI WebGPT.
Identifier les axes de qualité : factualité, nuance, structure, sécurité, cohérence. Chaque paire doit discriminer sur au moins 2 axes pour être informative.
Diversifier les prompts : 8 paires sur le même thème (ex. cuisine italienne, science, histoire) ≠ 8 paires sur des thèmes variés. La diversité thématique apprend à généraliser.
Critère de validation : chaque chosen doit être mesurablement meilleure que rejected sur ≥2 axes (factualité, structure, etc.). Une paire indistinguable est inutile — DPO ne peut rien en tirer.
Piège classique : confondre chosen avec “plus longue” — la préférence n’est pas la longueur. Une réponse courte et précise bat une réponse longue et vague.
# Exercice 1 : Creez votre dataset de preferences thematique# TODO etudiant : remplacez les exemples ci-dessous par votre propre thememon_dataset_preferences = [ {"prompt": "### Human: [votre question ici]\n### Assistant:","chosen": "Votre reponse precise et structuree ici.","rejected": "Votre reponse vague ou biaisee ici.", },# TODO etudiant : ajoutez 7 autres paires sur votre theme]print(f"Dataset en cours : {len(mon_dataset_preferences)} paires (objectif : 8)")
Dataset en cours : 1 paires (objectif : 8)
Exercice 2 : Analyser l’impact du paramètre beta
Le paramètre beta dans DPO contrôle la force de l’alignement. Testez avec beta = 0.01 (faible) et beta = 1.0 (fort) et observez les différences.
Indice : Un beta trop faible ne change rien ; un beta trop fort peut degrader la coherence du texte.
Pédagogie de l’exercice : tester l’impact du paramètre β sur DPO. Trois compétences visées :
Comprendre β comme temperature : β petit = push conservateur (le modèle reste proche de π_ref), β grand = push agressif (le modèle dérive plus, plus de risque de catastrophic forgetting).
Mesurer le trade-off reward/KL : un β optimal maximise le reward sans exploser la KL π || π_ref. La frontière est KL ≈ 0.3-0.5 nats par token.
Convergence et stabilité : avec β trop grand, la loss DPO oscille ; avec β trop petit, le modèle ne s’aligne pas assez.
Valeurs à tester : β ∈ {0.01, 0.05, 0.1, 0.5, 1.0}. Le défaut 0.1 marche pour la plupart des cas 0.5B-1.5B mais peut être trop agressif pour des modèles très pré-entraînés.
Sortie attendue : un tableau DataFrame avec colonnes beta, final_reward, final_KL, training_loss.
Critère de validation : identifier visuellement le β qui maximise le reward sans dépasser KL > 0.5. C’est ce qu’on appelle le β de sweet spot.
# Exercice 2 : Testez differents valeurs de beta# TODO etudiant : testez beta=0.01 et beta=1.0, comparez les loss et les reponses# Indice : reentrainez le modele SFT (cellule 14) entre chaque test de betabeta_test =0.1# TODO etudiant : remplacez par 0.01 ou 1.0print(f"Test avec beta={beta_test} (a completer par l'etudiant)")print("Etapes : 1) Re-SFT | 2) Calcul ref_logprobs | 3) DPO avec nouveau beta | 4) Evaluer")
Test avec beta=0.1 (a completer par l'etudiant)
Etapes : 1) Re-SFT | 2) Calcul ref_logprobs | 3) DPO avec nouveau beta | 4) Evaluer
Exercice 3 : RLHF vs SFT — Avantages et limites
En vous basant sur les expériences de ce notebook et des notebooks précédents (FT-01 a FT-03), redigez une courte analyse (3-5 phrases en markdown) comparant : 1. Ce que le SFT apporte par rapport au modèle de base 2. Ce que le DPO/RLHF apporte par rapport au SFT 3. Les limites de notre implementation pedagogique
Pédagogie de l’exercice : réflexion qualitative RLHF vs SFT (et DPO). Trois compétences visées :
Comprendre les limites du SFT : réponses correctes grammaticalement mais génériques, pas de discrimination entre qualité et longueur.
Comprendre l’apport du RLHF/DPO : injecter un signal de préférence pour aligner sur des critères subjectifs (style, sécurité, factualité).
Identifier les trade-offs : RLHF/DPO coûte 2-3× plus cher que SFT seul, dérive KL sous-contrôlée, risk de reward hacking.
Sortie attendue : une analyse en markdown (200-400 mots) couvrant :
Un avantage concret de RLHF/DPO sur SFT seul, illustré par un cas d’usage précis (ex. refus de questions dangereuses, concision, factualité).
Une limite structurelle de RLHF/DPO (ex. dépendance à la qualité des préférences annotées, catastrophic forgetting au-delà de β > 0.5).
Une situation où SFT seul suffit (ex. tâche purement instructive sans axe de subjectivité, code completion).
Critère de validation : l’analyse doit citer au moins une référence précise (Rafailov et al. 2023 arXiv:2305.18290, Ouyang et al. 2022 InstructGPT, ou un papier équivalent).
# Exercice 3 : Zone de reflexion# TODO etudiant : ecrivez votre analyse en markdown ci-dessous# Par exemple : convertissez cette cellule en markdown et redigezanalyse = ("SFT vs Modele de base : [votre analyse ici]\n\n""DPO vs SFT : [votre analyse ici]\n\n""Limites de notre implementation : [votre analyse ici]")print("Exercice a completer en markdown.")print("Conseil : convertissez cette cellule en cellule Markdown pour rediger votre analyse.")
Exercice a completer en markdown.
Conseil : convertissez cette cellule en cellule Markdown pour rediger votre analyse.
La log-prob moyenne préfère le texte lisse : le base ne choisit chosen que sur 24 % des paires
DPO
Optimisation directe des préférences, sans reward model séparé
Perte DPO
Maximise la marge entre log-probs chosen vs rejected par rapport à la référence
Beta
Paramètre de temperature controlant la force de l’alignement
Résultat
Train 97 % (mémorisation) vs eval disjointe 56 % — et des générations inchangées : DPO aligne un classement, il ne crée pas de compétence
Prochaines étapes : Le FT-05 explorera le merge de modèles et le routing, qui permettent de combiner plusieurs modèles specialises en un seul modèle plus performant.
Bilan chiffré du TP : 126 paires déterministes (graine 42), split par fond 108 train / 18 eval ; SFT de référence 36 exemples × 3 epochs ; DPO 3 epochs × 27 steps (batch 4, beta 0,1, lr 1e-5), perte 0,6585 → 0,2419. Le verdict en une ligne : la métrique d’entraînement (97 %) et la métrique de généralisation (56 %) doivent toujours être lues ensemble — une sans l’autre ment, dans un sens comme dans l’autre.