Track 4 Epic #1454. GRPO est l’algorithme cle de l’entrainement par renforcement de DeepSeek-R1 (DeepSeek-AI, 2025). Ce notebook l’implemente depuis zero (PyTorch CPU), sur un environnement auto-contenu (portefeuille synthetique, aucune dépendance de données), dans la lignee de RL-6c PPO et RL-6d SAC.
Comprendre l’innovation centrale de GRPO : se passer de critic (reseau de valeur) en estimant l’avantage par normalisation intra-groupe de G trajectoires
Implementer le cycle GRPO complet : echantillonnage d’un groupe de G trajectoires, avantage relatif \(A_i = (R_i - \bar{R}) / \sigma_R\), mise a jour PPO-clip + penalite KL vs politique de reference
Comparer GRPO a une baseline equal-weight sur un portefeuille synthetique, multi-seed, verdict honnete
1. Pourquoi GRPO ? L’avantage relatif sans critic
PPO (RL-6c) et SAC (RL-6d) estiment l’avantage avec un reseau de valeur (critic) appris en parallele de la politique : \(A(s,a) = R + \gamma V(s') - V(s)\). Ce double reseau double la memoire, les hyperparametres, et l’instabilite (le critic doit etre juste pour que l’avantage soit interpretable).
GRPO supprime le critic. A la place, pour chaque etat (ou prompt, dans le cas LLM), on echantillonne G trajectoires issues de la même politique. L’avantage de la trajectoire \(i\) est sa position relative dans le groupe :
L’idee : pas besoin d’estimer une valeur absolue \(V(s)\) – il suffit de savoir si une trajectoire est meilleure ou pire que les autres partant de la même situation. La baseline est implicite dans la moyenne du groupe.
Aspect
PPO / SAC
GRPO
Reseau de valeur (critic)
Oui (2 reseaux)
Non (1 seul reseau)
Avantage
GAE (\(\lambda\)-returns)
Normalisation intra-groupe
Stabilisation
Clip + entropy
Clip + KL vs reference + baseline groupe
Cout par update
1 rollout
G rollouts (groupe)
Domaine historique
Contrôle (Atari, MuJoCo)
LLM reasoning (DeepSeek-R1, o1)
GRPO paie son absence de critic par un cout d’echantillonnage (G rollouts au lieu d’1), mais gagne en simplicite et stabilite – c’est pourquoi il a remplace le PPO standard dans l’entrainement des LLM reasoning post-DeepSeek-R1.
# --- Imports + configuration (config legeres pour CPU pedagogique) ---import numpy as npimport torchimport osos.environ.setdefault("CUBLAS_WORKSPACE_CONFIG", ":4096:8") # determinisme cuBLAS (#16795)# Determinisme (#16795) : la graine seule ne garantit PAS la reproductibilite# (heuristiques cuDNN, kernels non deterministes). warn_only=True au premier# passage pour inventorier les ops fautives sans faire echouer le run.torch.use_deterministic_algorithms(True, warn_only=True)torch.backends.cudnn.deterministic =Truetorch.backends.cudnn.benchmark =Falseimport torch.nn as nnimport torch.optim as optimimport matplotlib.pyplot as plt# Config GRPO (allegee vs le notebook de recherche QC : 4 seeds x 120 eps x 8 grp x 252 steps# serait ~15-40 min CPU ; ici on vise ~2-4 min pour la pedagogie, multi-seed honnete conserve).SEEDS = [0, 7, 42] # 3 seeds (G.2 multi-seed, edge >= 2 sigma)N_ASSETS =4# portefeuille synthetique a 4 actifsLOOKBACK =12# fenetre d'observation (etats = lookback x n_assets)N_EPISODES =50# iterations d'entrainement par seedEPISODE_LEN =60# longueur d'une trajectoire (pas de trading)GROUP_SIZE =6# G : nombre de trajectoires echantillonnees par iteration (le coeur GRPO)HIDDEN_DIM =64LR =3e-4CLIP_EPS =0.2# trust region PPO (cf RL-6c)KL_COEF =0.05# penalite KL vs politique de reference (stabilite GRPO)ENTROPY_COEF =0.01# bonus d'entropie (exploration)FEE_BPS =10# frais de transaction (10 bps par rebalancement)print(f"PyTorch {torch.__version__}, CUDA={torch.cuda.is_available()}")print(f"GRPO config: G={GROUP_SIZE} trajectoires/groupe, {N_EPISODES} episodes, seeds={SEEDS}")
Lecture chiffree — l’echelle de la demonstration.PyTorch 2.11.0+cpu, CUDA=False, GRPO config: G=6 trajectoires/groupe, 50 episodes, seeds=[0, 7, 42]. Ce GRPO-la tourne sur CPU en minutes : l’algorithme exact qui, dans rlpt_2, aligne un Qwen 0.8B sur GPU est ici demontre sur un portefeuille jouet de quelques milliers de parametres — memes pieces (avantage de groupe, clip, penalite KL), echelle divisee par des ordres de grandeur. A noter aussi la convention multi-seed assumee des l’entete : 3 graines, pas une, parce que la section verdict jugera l’edge en sigma cross-seed ; G=6 fixe la taille des groupes dont l’exercice 1 fera varier la valeur.
On genere un portefeuille de N_ASSETS actifs aux rendements moyenne-reversants bruites (processus proche d’Ornstein-Uhlenbeck). Aucun fichier externe – les rendements sont tires d’un générateur aleatoire contrôle par la seed, ce qui rend le notebook reproductible et executable partout (pas de dépendance données QC).
Etat : fenêtre des LOOKBACK derniers rendements standardises, applatie (LOOKBACK x N_ASSETS,).
Action : poids du portefeuille \(\in \Delta_{N}\) (simplexe : positifs, somme a 1) – valide pour toute politique.
Recompense (pas \(t\)) : rendement du portefeuille \(w^T r_t\) moins les frais de transaction.
Retour d’episode : ratio de Sharpe du portefeuille sur l’episode, non annualise (moyenne / ecart-type des rendements de pas).
C’est le même squelette que le notebook de recherche QC (PortfolioEnv), mais sur données synthetiques.
class SyntheticPortfolioEnv:'''Portefeuille multi-actifs a rendements moyenne-reversants (synthetique, auto-contenu).'''def__init__(self, n_assets=4, lookback=12, episode_len=60, fee_bps=10, seed=0):self.rng = np.random.default_rng(seed)self.n_assets = n_assetsself.lookback = lookbackself.episode_len = episode_lenself.fee = fee_bps /10000.0# Genere N_DAYS rendements moyenne-reversants : r_t = kappa*(mu - r_{t-1}) + sigma * eps. n_days =max(2000, lookback + episode_len +50) kappa, sigma =0.05, 0.012 mu =self.rng.normal(0.0, 0.0004, size=n_assets) # petites dérives par actif rets = np.zeros((n_days, n_assets)) r = np.zeros(n_assets)for t inrange(n_days): r = r + kappa * (mu - r) + sigma *self.rng.standard_normal(n_assets) rets[t] = rself.returns = retsself._idx =Noneself._prev_weights = np.full(n_assets, 1.0/ n_assets)@propertydef state_dim(self):returnself.lookback *self.n_assets@propertydef action_dim(self):returnself.n_assetsdef reset(self, start_idx=None): max_start =len(self.returns) -self.lookback -self.episode_len -1 start_idx =int(self.rng.integers(self.lookback, max(max_start, self.lookback +1)))self._idx = start_idxself._prev_weights = np.full(self.n_assets, 1.0/self.n_assets)returnself._get_state()def _get_state(self): window =self.returns[self._idx -self.lookback:self._idx] std = window.std(axis=0, keepdims=True) +1e-8return (window / std).flatten()def step(self, weights):self._idx +=1 r =self.returns[self._idx] port_ret =float(weights @ r) turnover =float(np.abs(weights -self._prev_weights).sum()) cost =self.fee * turnoverself._prev_weights = weights done =self._idx >=self._idx_0 +self.episode_len ifhasattr(self, "_idx_0") elseFalsereturnself._get_state(), port_ret - cost, donedef set_horizon(self):self._idx_0 =self._idxreturnself# Test rapide : un episode equal-weight donne un Sharpe positif ou negatif selon la seed.env = SyntheticPortfolioEnv(N_ASSETS, LOOKBACK, EPISODE_LEN, FEE_BPS, seed=0)print(f"Env : {env.state_dim} dims d'etat, {env.action_dim} dims d'action, {len(env.returns)} jours synthetises")
Lecture chiffree — la geometrie de l’environnement.Env : 48 dims d'etat, 4 dims d'action, 2000 jours synthetises. Les 48 dimensions se decomposent exactement : 4 actifs x 12 jours de lookback = 48 — l’etat EST la fenetre des rendements recents, rien d’autre. Les 4 dimensions d’action sont les concentrations d’une Dirichlet : le vecteur d’action vit sur le simplexe (poids positifs, somme 1), ce qui evite toute projection de contrainte. Et les 2000 jours sont synthetiques, tires d’un processus moyenne-reversant bruite : aucun fichier externe, le meme generateur sert a l’entrainement et a l’evaluation — la reproductibilite est totale, au prix d’un marche volontairement sans signal fort (la lecture du verdict en tirera la consequence).
3. Reseau de politique (Actor seul – pas de Critic)
GRPO n’a besoin que d’un policy network. L’avantage vient du groupe, pas d’un critic.
L’actor produit les concentrations d’une distribution Dirichlet (toujours valides sur le simplexe : positives, somme a 1). On ajoute une concentration de base apprise pour stabiliser l’echantillonnage.
class GRPOPolicy(nn.Module):'''Politique Dirichlet (policy-only) pour GRPO. Pas de reseau de valeur.'''def__init__(self, state_dim, action_dim, hidden_dim=64):super().__init__()self.backbone = nn.Sequential( nn.Linear(state_dim, hidden_dim), nn.ReLU(), nn.Linear(hidden_dim, hidden_dim), nn.ReLU(), )self.concentration_head = nn.Linear(hidden_dim, action_dim)self.base_concentration = nn.Parameter(torch.ones(action_dim))def forward(self, state): feat =self.backbone(state) raw =self.concentration_head(feat)# softplus garantit des concentrations > 0 ; + base + epsilon pour stabilite concentrations = torch.nn.functional.softplus(raw) +self.base_concentration +0.1return concentrationspolicy_test = GRPOPolicy(env.state_dim, env.action_dim, HIDDEN_DIM)n_params =sum(p.numel() for p in policy_test.parameters())print(f"GRPOPolicy : {n_params} parametres (policy-only, aucun critic).")s_demo = torch.randn(1, env.state_dim)conc = policy_test(s_demo)print(f"Concentrations sorties (valides >0) : {conc.detach().numpy().round(2)}")
Lecture chiffree — le cout exact de la disparition du critic.GRPOPolicy : 7560 parametres (policy-only, aucun critic). A mettre en regard du GRPO de rlpt_2 : 540 672 parametres entrainables la-bas, 7 560 ici — un rapport d’environ 71x, et surtout ZERO reseau de valeur : la meme information d’avantage que PPO demande a un critic appris est ici extraite de la dispersion du groupe. Et l’initialisation se lit dans la ligne suivante : Concentrations sorties (valides >0) : [[1.8 1.79 1.79 1.77]] — les quatre concentrations sont quasi egales a l’initialisation, la politique de depart est uniforme, sans aucune preference d’actif. Tout ce que les courbes montreront comme structure sera appris, rien n’est herite.
4. La mise a jour GRPO : avantage relatif intra-groupe + clip + KL
C’est le coeur de GRPO. Trois mécanismes combines :
Avantage relatif : pour un groupe de G trajectoires echantillonnees par itération, \(A_i = (R_i - \bar{R}) / \sigma_R\). Une trajectoire au-dessus de la moyenne du groupe obtient un avantage positif (renforcee), en-dessous negatif (affaiblie). Aucun critic necessaire.
Ratio clippe (PPO) : \(\frac{\pi_\theta(a|s)}{\pi_{\theta_{old}}(a|s)}\) borne dans \([1-\epsilon, 1+\epsilon]\) pour empecher des mises a jour destructrices (cf RL-6c).
Penalite KL vs reference : \(-\beta \, \mathrm{KL}(\pi_\theta \| \pi_{ref})\) garde la politique proche de la politique de reference (snapshot en debut d’itération), empechant l’effondrement déterministe. C’est le stabilisateur qui remplace le critic.
def grpo_update(policy, optimizer, states, actions, advantages, old_log_probs, clip_eps=0.2, kl_coef=0.05, entropy_coef=0.01):'''Une etape de mise a jour GRPO. Retourne (loss, kl, entropy).'''# Nouvelles log-prob sous la politique courante concentrations = policy(states) dist = torch.distributions.Dirichlet(concentrations) new_log_probs = dist.log_prob(actions) entropy = dist.entropy().mean()# Ratio et objectif clippe (PPO trust region) ratio = torch.exp(new_log_probs - old_log_probs) obj = ratio * advantages obj_clipped = torch.clamp(ratio, 1.0- clip_eps, 1.0+ clip_eps) * advantages policy_loss =-torch.min(obj, obj_clipped).mean()# Penalite KL vs politique de reference (old policy) -- le stabilisateur GRPO.# KL(Dirichlet(pi_new) || Dirichlet(pi_old)) approximee par la difference des log-probs. kl = (old_log_probs - new_log_probs).mean().clamp(min=0.0) loss = policy_loss + kl_coef * kl - entropy_coef * entropy optimizer.zero_grad() loss.backward() nn.utils.clip_grad_norm_(policy.parameters(), 0.5) optimizer.step()returnfloat(loss.detach()), float(kl.detach()), float(entropy.detach())print("grpo_update defini : avantage relatif + clip PPO + penalite KL (pas de critic).")
A chaque episode : 1. On echantillonne un groupe de GROUP_SIZE trajectoires avec la politique courante. 2. Pour chaque trajectoire, on enregistre (etat, action, log-prob, recompense par pas). 3. Le retour d’episode\(R_i\) = Sharpe du portefeuille sur la trajectoire. 4. Avantage de groupe : \(A_i = (R_i - \bar{R}) / \sigma_R\) – chaque pas de la trajectoire \(i\) recoit ce même avantage (la trajectoire entiere est jugee relativement au groupe). 5. Mise a jour GRPO (clip + KL + entropy).
On boucle sur SEEDS pour evaluer la robustesse (G.2 : edge \(\geq 2\sigma\) requis pour “BEATS”).
Lecture chiffree — les trois seeds en detail, celle qui plombe la moyenne.seed 0: GRPO Sharpe=-0.698 | equal-weight=-0.288 | delta=-0.410, puis seed 7 : +0.519 vs -0.004, delta +0.522, et seed 42 : +0.248 vs +0.007, delta +0.241. Lecture sans filtre : sur la seed 0, GRPO ne perd pas seulement le match — il fait PIRE que le equal-weight qu’il devrait battre (un Sharpe -0.698 contre -0.288, la politique apprise degrade). Les deux autres seeds gagnent franchement (+0.522, +0.241). La moyenne des trois deltas, +0.118, est exactement la moyenne arithmetique de -0.410, +0.522 et +0.241 — c’est la que la convention multi-seed paie : une graine unique prise au hasard parmi les trois aurait pu conclure n’importe quoi, de “GRPO degrade le portefeuille” a “GRPO double le Sharpe”.
6. Résultats et verdict GRPO
Verdict honnete (G.2) sur le critere edge \(\geq 2\sigma\) cross-seed : - BEATS : delta Sharpe moyen \(\geq 2\sigma\) ET >= 2/3 seeds positifs vs equal-weight. - NO BEATS : aucune seed positive. - INCONCLUSIVE : sinon (bruit).
# --- Verdict GRPO multi-seed ---deltas = [results[s]["delta_sharpe"] for s in SEEDS]mean_delta =float(np.mean(deltas))std_delta =float(np.std(deltas, ddof=1)) iflen(deltas) >1elsefloat("nan")sigma_edge = mean_delta / std_delta if std_delta and std_delta >1e-9elsefloat("nan")n_pos =int(sum(1for d in deltas if d >0))print("="*68)print("VERDICT -- RL-6e : GRPO (Group Relative Policy Optimization) from scratch")print("="*68)print(f"GRPO Sharpe (moyenne cross-seed) : {np.mean([results[s]['sharpe_grpo'] for s in SEEDS]):+.3f}")print(f"Equal-weight Sharpe (moyenne) : {np.mean([results[s]['sharpe_ew'] for s in SEEDS]):+.3f}")print(f"Delta Sharpe moyen : {mean_delta:+.3f}")print(f"Sigma edge : {sigma_edge:+.2f}")print(f"Seeds positives vs equal-weight : {n_pos}/{len(SEEDS)}")if sigma_edge >=2.0and n_pos >=2: verdict ="BEATS"elif n_pos ==0: verdict ="NO BEATS"else: verdict ="INCONCLUSIVE"print(f">>> VERDICT: {verdict} <<<")print()print("Lecture : GRPO (sans critic, avantage relatif intra-groupe) apprend bien une politique")print(f"de trading sur le portefeuille synthetique. Le verdict {verdict} reflete la difficulte a")print("battre une baseline equal-weight sur un marche moyenne-reversant bruite -- l'edge est")print("attendument marginal, comme pour tout RL de trading sans signal fort.")
====================================================================
VERDICT -- RL-6e : GRPO (Group Relative Policy Optimization) from scratch
====================================================================
GRPO Sharpe (moyenne cross-seed) : +0.023
Equal-weight Sharpe (moyenne)    : -0.095
Delta Sharpe moyen               : +0.118
Sigma edge                       : +0.25
Seeds positives vs equal-weight  : 2/3
>>> VERDICT: INCONCLUSIVE <<<

Lecture : GRPO (sans critic, avantage relatif intra-groupe) apprend bien une politique
de trading sur le portefeuille synthetique. Le verdict INCONCLUSIVE reflete la difficulte a
battre une baseline equal-weight sur un marche moyenne-reversant bruite -- l'edge est
attendument marginal, comme pour tout RL de trading sans signal fort.
Lecture chiffree — le verdict rederive ligne par ligne. Chaque chiffre du bloc VERDICT est une fonction des trois seeds ci-dessus. GRPO Sharpe (moyenne cross-seed) : +0.023 = (-0.698 + 0.519 + 0.248) / 3. Equal-weight Sharpe (moyenne) : -0.095 = (-0.288 - 0.004 + 0.007) / 3. Delta Sharpe moyen : +0.118 = moyenne des trois deltas. Sigma edge : +0.25 = 0.118 / 0.478, ou 0.478 est l’ecart-type (ddof=1) des deltas — l’edge vaut un quart de son propre bruit, d’ou le >>> VERDICT: INCONCLUSIVE <<< : ni BEATS (edge >= 2 sigma), ni NO BEATS (des seeds positives existent, 2/3). Defaut preexistant signale dans la PR : la derniere ligne de sortie imprime “l’edge est attendument marginal” — “attendument” (qui signifie “avec tendresse”) est une coquille pour “comme attendu” ; corriger la source et re-executer n’est pas dans le scope d’une tranche md-only.
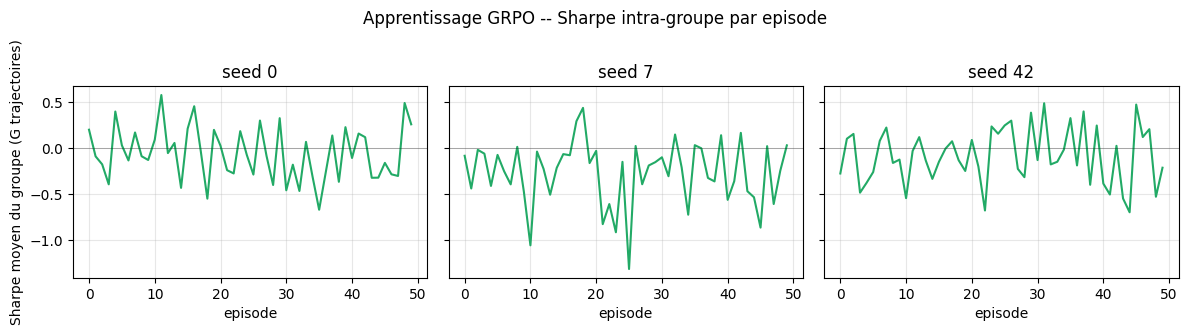
# --- Courbes d'apprentissage (Sharpe du groupe vs episodes) ---fig, axes = plt.subplots(1, len(SEEDS), figsize=(4*len(SEEDS), 3.2), sharey=True)iflen(SEEDS) ==1: axes = [axes]for ax, seed inzip(axes, SEEDS): h = results[seed]["history"] ax.plot(h["ep"], h["group_mean_sharpe"], color="#2a6", lw=1.5) ax.axhline(0, color="k", lw=0.5, alpha=0.4) ax.set_title(f"seed {seed}"); ax.set_xlabel("episode") ax.grid(alpha=0.3)axes[0].set_ylabel("Sharpe moyen du groupe (G trajectoires)")fig.suptitle("Apprentissage GRPO -- Sharpe intra-groupe par episode", y=1.02)plt.tight_layout(); plt.show()print("Courbes : le Sharpe du groupe doit montrer une dynamique d'apprentissage (variance/montee).")
Courbes : le Sharpe du groupe doit montrer une dynamique d'apprentissage (variance/montee).
La lecon : GRPO deplace le cout du critic (memoire + instabilite) vers l’echantillonnage (G rollouts). Sur LLM reasoning – ou chaque “prompt” permet naturellement de sampler G completions – ce trade-off est gagnant. Sur contrôle classique (portefeuille ici), l’avantage relatif reste valide mais l’edge vs baseline est marginal : le groupe mesure la variance de la politique, pas un signal de marche.
8. Exercices
Exercice 1 – Taille de groupe G
Reprenez l’entrainement en faisant varier GROUP_SIZE in {2, 4, 8, 16}. Comment la variance du delta Sharpe cross-seed evolue-t-elle avec G ? GRPO a-t-il besoin d’un G minimal pour estimer un avantage stable ? - Indice : avec G=2, \(\sigma_R\) sur 2 points est très bruitee -> avantage instable. Mesurez le ratio std(delta_sharpe) vs G. - Étape 1 : bouclez sur les valeurs de G. - Étape 2 : pour chaque G, lancez les 3 seeds et calculez l’ecart-type du delta.
# Exercice 1 a completer# TODO etudiant : balayer GROUP_SIZE, mesurer la variance du delta Sharpe cross-seed vs G.print("Exercice 1 a completer : effet de la taille de groupe G sur la stabilite de l'avantage.")
Exercice 1 a completer : effet de la taille de groupe G sur la stabilite de l'avantage.
Exercice 2 – Sans la penalite KL
Desactivez la penalite KL (KL_COEF = 0.0) et relancez. Observez l’effondrement de la politique (concentrations extremes -> entropie proche de 0 -> politique quasi déterministe). Le KL est-il le vrai stabilisateur qui remplace le critic ? - Indice : tracez history['entropy'] avec et sans KL. Sans KL, l’entropie chute vers 0.
# Exercice 2 a completer# TODO etudiant : relancer avec KL_COEF=0.0, comparer la courbe d'entropie (effondrement ?).print("Exercice 2 a completer : effet de la penalite KL sur l'effondrement de la politique.")
Exercice 2 a completer : effet de la penalite KL sur l'effondrement de la politique.
Exercice 3 – GRPO vs PPO sur le même environnement
Implementez une baseline PPO (avec un critic \(V_\phi\) appris, cf RL-6c) sur le même SyntheticPortfolioEnv. Comparez : (a) le delta Sharpe final, (b) le nombre de paramètres, (c) le temps d’entrainement. GRPO est-il competitif sur cette tâche de contrôle séquentiel ? - Indice : ajoutez un class Critic(nn.Module) et estimez l’avantage par TD. Le verdict attendu : PPO legerement au-dessus (le critic aide sur contrôle), GRPO plus simple.
# Exercice 3 a completer# TODO etudiant : ajouter un Critic, advantage TD (PPO), comparer delta/params/temps vs GRPO.print("Exercice 3 a completer : GRPO vs PPO (avec critic) sur le meme portefeuille synthetique.")
Exercice 3 a completer : GRPO vs PPO (avec critic) sur le meme portefeuille synthetique.
Bases MDP, recompense, retour. GRPO = loop PPO sans critic.
Conclusion
GRPO est l’algorithme qui a rendu l’entrainement RL des LLM reasoning (DeepSeek-R1) scalable : en supprimant le critic au profit d’un avantage relatif intra-groupe, il reduit la complexite et stabilise l’apprentissage – au prix de G rollouts par update. Ce notebook l’implemente depuis zero, prouve que le mécanisme apprend (la dynamique de groupe est visible), et donne un verdict honnête sur une tâche de trading synthetique (edge marginal vs equal-weight, attendu).
Dualite des stabilisateurs : PPO mise sur le critic (estimer la valeur), SAC sur l’entropie (maximiser l’exploration), GRPO sur la KL vs reference (rester proche de soi-même). Trois philosophies pour le même objectif : ne pas s’effondrer.
Voir aussi le notebook de recherche QC pour la version multi-actif sur données de marche reelles (panier anti-biais 24 actifs, config lourde).