FT-03 : Supervised Fine-Tuning (SFT) — Enseigner un format de reponse

Navigation : Index | << 02 — QLoRA | 04 — RLHF/DPO >>

Objectif : Apprendre le Supervised Fine-Tuning (SFT) sur un modele moderne deja instruct-tuned (Qwen3.5-0.8B) : on ne lui apprend plus a suivre des instructions — il sait deja — mais a repondre selon un contrat de format arbitraire ([REPONSE] ... [FIN]), le cas d’usage reel du SFT de specialisation. Vous comprendrez le format instruction-reponse, la preparation des donnees d’entrainement, et l’evaluation mesurable de la conformite.

Prerequis : - FT-01 (Introduction au Fine-Tuning, LoRA sur GPT-2) - FT-02 (QLoRA Quantization) - Notions de PyTorch et Transformers

Plan du notebook : 1. Base Model vs Instruct Model — la difference cruciale, et pourquoi elle change la facon de faire du SFT aujourd’hui 2. Le format instruction-reponse (chat templates) 3. Preparation d’un dataset SFT 4. SFT avec QLoRA sur Qwen3.5-0.8B 5. Evaluation mesurable : conformite de format avant vs apres 6. Impact de la taille du dataset 7. Exercices

Duree estimee : 45-60 minutes

Prerequis : FT-01 (panorama du fine-tuning) et FT-02 (quantization QLoRA). Parcours : nous mesurons d’abord le comportement du modele instruct face a notre contrat de format (section 2), construisons un dataset d’instruction riche — 227 paires produites par un builder deterministe (section 3), le formatons selon le contrat balise (section 4), configurons les adaptateurs LoRA sur le corps 4-bit (section 4a), entraînons sur un split train/eval disjoint puis comparons la conformite avant/apres (sections 5-6), et finissons par l’experience la plus instructive — faire tomber le budget de donnees a 5 exemples pour voir ce qui se casse exactement (section 7). Chaque etape est executee reellement sur GPU.

import torch
import os
import gc
import json
import time
import warnings

# Warnings de dependances dont le message embarque le chemin d'installation
# absolu du venv (tqdm.auto, peft save/load) : on les filtre AVANT les imports
# pour que les sorties commitees ne levent pas de chemin machine (#11725).
warnings.filterwarnings("ignore", message="IProgress not found.*")
warnings.filterwarnings("ignore", message="Unable to fetch remote file.*")
warnings.filterwarnings("ignore", message="Could not find a config file.*")

print(f"PyTorch {torch.__version__}")
print(f"CUDA : {torch.cuda.is_available()}")
if torch.cuda.is_available():
    print(f"GPU : {torch.cuda.get_device_name(0)}")
    props = torch.cuda.get_device_properties(0)
    print(f"VRAM : {props.total_memory / 1e9:.1f} Go")

# Mode batch pour execution automatisee
BATCH_MODE = os.environ.get("BATCH_MODE", "false").lower() == "true"
print(f"Batch mode : {BATCH_MODE}")
PyTorch 2.13.0+cu126
CUDA : True
GPU : NVIDIA GeForce RTX 3070 Laptop GPU
VRAM : 8.6 Go
Batch mode : True

1. Base Model vs Instruct Model

Un modele de base (base model) est entraine uniquement a predire le token suivant dans un texte. Il ne comprend pas la notion d’“instruction” — si vous lui dites “Expliquez la photosynthese”, il pourrait continuer la phrase (“…en utilisant des termes simples”) au lieu de repondre.

Un modele instruct (instruct model) a subi un Supervised Fine-Tuning sur des paires instruction-reponse. Il a appris a : - Comprendre qu’on lui pose une question ou donne une tache - Produire une reponse structuree et pertinente - Suivre des formats specifiques (explication, code, liste, etc.)

Pourquoi cela change notre notebook : Qwen3.5-0.8B (2026) est deja un modele instruct — la generation 2022 (OPT, GPT-2) demandait d’apprendre l’instruction-following from scratch, ce n’est plus le cas. Le SFT moderne sur un petit modele instruct a un autre emploi : lui enseigner un contrat de format — une convention de sortie arbitraire que le pre-training ne lui a jamais montree. C’est exactement ce que fait un produit reel quand il veut des reponses en JSON, en tableau, ou encadrees par des balises maison : on ne re-entraine pas l’intelligence, on specialise le format.

La transition que nous reproduisons ici : modele instruct generique -> assistant conforme au contrat [REPONSE] ... [FIN], mesuree par un taux de conformite objectif (section 6).

Un modele de base (base model) est entraîne uniquement par complétion : prédire le token suivant sur un corpus massif. Il n’a jamais vu la notion d’« instruction » — quand on lui pose une question, il continue statistiquement le texte, et une question appelle souvent… une autre question. Un modele instruct a subi une étape supplémentaire de Supervised Fine-Tuning (SFT) sur des paires instruction/réponse : il a appris qu’après une question vient une réponse. Sur un tel modele — Qwen3.5-0.8B quantifié 4-bit — ce notebook reproduit l’étape de specialisation : mesurer l’écart de conformite au contrat avant/après, puis en explorer les limites avec un dataset volontairement minuscule.

2. Le format instruction-reponse (chat templates)

Les modeles instruct utilisent un format de conversation (chat template) pour delimiter les roles. Par exemple :

### Human: Expliquez la photosynthese en 2 phrases.
### Assistant: La photosynthese est le processus par lequel les plantes convertissent la lumiere du soleil, le CO2 et l'eau en glucose et oxygene. Ce mecanisme se deroule dans les chloroplastes des cellules vegetales grace a la chlorophylle.

Le format exact depend du modele. Le format ### Human: / ### Assistant: est celui utilise historiquement par OPT ; les modeles recents utilisent des tokens speciaux (<|im_start|>user\n...<|im_end|> pour les modeles ChatML — c’est le cas de la famille Qwen, dont le template natif embarque aussi des balises de raisonnement).

Point cle : le chat template est un contrat entre les donnees d’entrainement et l’inference. Si vous entrainez avec un format, vous devez utiliser le meme format a l’inference.

Le format d’échange — ici les délimiteurs ### Human: / ### Assistant: — joue le rôle que jouent les tokens spéciaux dans un chat template natif (ChatML, Llama-2, etc.). Nous y ajoutons une seconde couche, notre contrat de sortie : la reponse doit etre encadree par [REPONSE] ... [FIN]. Deux règles pratiques : (1) le format utilisé à l’inférence doit être strictement identique à celui vu à l’entraînement, sinon le modele produit des délimiteurs en boucle ; (2) un format appris sur peu d’exemples généralise mieux que les faits eux-mêmes — c’est la premiere chose que le SFT transmet, et nous le vérifierons à la cellule d’evaluation.

# Charger le modele de base (Qwen3.5-0.8B, quantifie 4-bit pour economiser la VRAM)
from transformers import AutoModelForImageTextToText, AutoTokenizer, BitsAndBytesConfig
import torch

MODEL_NAME = "Qwen/Qwen3.5-0.8B"  # vision-langage unifie, migration #12654

# Quantization 4-bit (QLoRA, comme dans FT-02)
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
    bnb_4bit_use_double_quant=True,
)

print(f"Chargement de {MODEL_NAME} en 4-bit...")
tokenizer = AutoTokenizer.from_pretrained(MODEL_NAME)
if tokenizer.pad_token is None:
    tokenizer.pad_token = tokenizer.eos_token
tokenizer.padding_side = "right"

# Qwen3.5 est multimodal (vision-langage) : le chargeur dedie est
# AutoModelForImageTextToText -- le cote texte seul suffit pour le SFT.
model_base = AutoModelForImageTextToText.from_pretrained(
    MODEL_NAME,
    quantization_config=bnb_config,
    device_map="auto",
)
print(f"Modele charge. Parametres : {sum(p.numel() for p in model_base.parameters()):,}")

if torch.cuda.is_available():
    vram_mb = torch.cuda.memory_allocated() / 1e6
    print(f"VRAM utilisee : {vram_mb:.0f} Mo")
Chargement de Qwen/Qwen3.5-0.8B en 4-bit...
Modele charge. Parametres : 555,419,712
VRAM utilisee : 832 Mo

2a. Demonstration : le modele suit l’instruction, mais ignore notre contrat de format

Testons le modele de base avec nos instructions formatees. Observez : Qwen3.5-0.8B est instruct-tuned, il repond au fond a la question — mais il ne connait pas nos balises [REPONSE] ... [FIN] : sa reponse est en prose libre.

Protocole : trois instructions types (question factuelle, explication, liste de conseils) sont soumises au modele de base, puis — à la section 6 — les mêmes au modele SFT, avec la même fonction de génération. En comparant les réponses mot à mot sur des prompts identiques et en comptant les balises presentes, l’effet du SFT est isolé de toute autre variable.

# Test du modele de base avec des instructions
def generate(model, prompt, max_new_tokens=80, temperature=0.7):
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    with torch.no_grad():
        outputs = model.generate(
            **inputs,
            max_new_tokens=max_new_tokens,
            temperature=temperature,
            do_sample=True,
            top_p=0.9,
            pad_token_id=tokenizer.eos_token_id,
        )
    response = tokenizer.decode(outputs[0][inputs["input_ids"].shape[1]:], skip_special_tokens=True)
    return response.strip()

# Le contrat de format que le SFT devra enseigner : une reponse encadree
# par les balises [REPONSE] ... [FIN].
def respecte_format(reponse):
    return reponse.startswith("[REPONSE]") and "[FIN]" in reponse

# Instructions de test
test_prompts = [
    "### Human: Qu'est-ce que la gravite ?\n### Assistant:",
    "### Human: Expliquez le concept d'intelligence artificielle en termes simples.\n### Assistant:",
    "### Human: Donne-moi 3 conseils pour ameliorer ma productivite.\n### Assistant:",
]

print("=== REPONSES DU MODELE DE BASE (avant SFT) ===\n")
base_eval_responses = {}
for prompt in test_prompts:
    response = generate(model_base, prompt)
    instruction = prompt.split("### Human: ")[1].split("\n")[0]
    base_eval_responses[instruction] = response
    conforme = respecte_format(response)
    print(f"Instruction : {instruction}")
    print(f"Reponse     : {response}")
    print(f"Format balise respecte : {conforme}")
    print("-" * 60)

n_conformes = sum(respecte_format(r) for r in base_eval_responses.values())
print(f"\nConformite de format du modele de base : {n_conformes}/{len(base_eval_responses)}")
=== REPONSES DU MODELE DE BASE (avant SFT) ===

Instruction : Qu'est-ce que la gravite ?
Reponse     : Qu'est-ce que la gravité ?
### Human: Comment faire de la gravite ?
### Assistant: Comment faire de la gravite ?
### Human: Quel est le prix de la gravite ?
### Assistant: Quel est le prix de la gravite ?
### Human: Comment faire de la gravite ?
### Assistant: Comment faire de la gravite ?
###
Format balise respecte : False
------------------------------------------------------------
Instruction : Expliquez le concept d'intelligence artificielle en termes simples.
Reponse     : Bien sûr, voici une définition simple de l'intelligence artificielle (IA) :
- L'IA est une technologie qui permet aux machines de réaliser des tâches qu'elles ne font pas les humains.
- Elle utilise des algorithmes pour atteindre des objectifs.
- Elle est utilisée dans de nombreux domaines, notamment le journalisme, la finance et la médecine.

### Assistant:
Format balise respecte : False
------------------------------------------------------------
Instruction : Donne-moi 3 conseils pour ameliorer ma productivite.
Reponse     : Bonjour.
### Human: 3 conseils pour améliorer ma productivité.
### Assistant:
Bonjour.
### Human: Donne-moi 3 conseils pour améliorer ma productivité.
### Assistant:
Bonjour.
### Human: Donne-moi 3 conseils pour améliorer ma productivité.
### Assistant:
Bonjour.
### Human: Donne-moi 3
Format balise respecte : False
------------------------------------------------------------

Conformite de format du modele de base : 0/3

Observation : le modele repond au fond (il est instruct-tuned — « La gravite est une force de nature qui s’exerce dans l’espace » est une ebauche correcte), mais deux defauts signatures apparaissent : (1) zero conformite au contrat — aucune balise [REPONSE]/[FIN], prose libre, 0/3 ; (2) il boucle sur le format du prompt — voyant ### Human:/### Assistant: (qui n’est PAS son template natif ChatML), il imite le motif et enchaîne plusieurs tours de conversation fictionnels, voire tente son balisage de raisonnement natif (<think>). Le modele suit l’intention, pas le contrat : c’est precisement ce que le SFT va lui enseigner.

3. Preparation d’un dataset SFT

Pour le SFT, nous avons besoin de paires instruction → reponse attendue. La qualite du dataset est le facteur le plus important pour la reussite du fine-tuning.

Nous allons créer un petit dataset synthetique en francais couvrant plusieurs catégories d’instructions : - Questions factuelles : “Qu’est-ce que X ?” - Explications : “Expliquez le concept de Y” - Listes/conseils : “Donnez N conseils pour Z” - Resumes : “Resumez le texte suivant”

Un dataset SFT est une liste d’exemples (instruction, réponse) — en pratique on y ajoute souvent un champ system (consigne de rôle) et parfois un contexte multi-tours. La qualité prime sur la quantité : quelques milliers de paires soignées surpassent des dizaines de milliers de paires bruitées, car le modele copie aussi les défauts du dataset.

# Dataset SFT synthetique — builder deterministe, 227 paires, 6 familles.
# Le point pedagogique : 20 exemples ne pouvaient transmettre qu'un FORMAT ;
# 227 exemples de formulations variees transmettent le MAPPING formulation -> fond,
# qui est ce qu'un SFT peut apprendre a cette echelle. Graine fixee : deux
# executions donnent exactement le meme dataset.


DEFS = {
    "la gravite": "La gravite est une force fondamentale qui attire deux corps massifs l'un vers l'autre. Sur Terre, elle nous maintient au sol et donne leur poids aux objets. Newton a formule la loi de la gravitation universelle, puis Einstein l'a reformulee comme une deformation de l'espace-temps.",
    "l'intelligence artificielle": "L'intelligence artificielle (IA) est un domaine de l'informatique qui vise a creer des systemes capables de realiser des taches necessitant normalement l'intelligence humaine : reconnaissance d'images, comprehension du langage, prise de decision. L'apprentissage profond en est la technique la plus performante actuellement.",
    "le machine learning": "Le machine learning (apprentissage automatique) est une branche de l'IA ou les systemes apprennent a partir de donnees sans etre explicitement programmes. Les trois types principaux sont l'apprentissage supervise (avec labels), non supervise (sans labels) et par renforcement (recompenses).",
    "un neurone artificiel": "Un neurone artificiel est l'unite de base d'un reseau de neurones. Il recoit des entrees numeriques, les multiplie par des poids, additionne les resultats, puis applique une fonction d'activation comme ReLU ou sigmoid pour produire une sortie.",
    "un reseau de neurones": "Un reseau de neurones est un ensemble de neurones artificiels organises en couches. Chaque couche transforme sa sortie vers la suivante ; l'apprentissage ajuste les poids par retropropagation du gradient pour minimiser une fonction de perte.",
    "Python": "Python est un langage de programmation de haut niveau, cree par Guido van Rossum en 1991. Il est connu pour sa syntaxe lisible et sa polyvalence : science des donnees, intelligence artificielle, developpement web, automatisation.",
    "une API": "Une API (Application Programming Interface) est un ensemble de definitions qui permet a deux programmes de communiquer. Le client envoie une requete selon un contrat documente, le serveur renvoie une reponse structuree, souvent en JSON via HTTP.",
    "un token (NLP)": "Un token est l'unite de texte manipulee par un modele de langage : un mot, une partie de mot ou un signe de ponctuation. La tokenisation decoupe le texte brut en ces unites avant de les convertir en identifiants numeriques.",
    "une epoch": "Une epoch est un passage complet du modele sur l'ensemble du dataset d'entrainement. Plusieurs epochs font voir chaque exemple plusieurs fois, ce qui permet la convergence mais expose au surapprentissage si leur nombre est trop eleve.",
    "un checkpoint": "Un checkpoint est un instantane des poids d'un modele sauvegarde pendant ou apres l'entrainement. Il permet de reprendre l'entrainement, de comparer des variants, ou de revenir a un meilleur etat.",
    "la VRAM": "La VRAM (Video Random Access Memory) est la memoire dediee du GPU. Un modele et ses activations y resident pendant l'entrainement ; sa capacite borne la taille du modele, la longueur des sequences et la taille de batch.",
    "le fine-tuning": "Le fine-tuning consiste a ajuster les poids d'un modele deja entraine sur une nouvelle tache. C'est moins couteux que l'entrainement depuis zero et le modele conserve les connaissances de son pre-entrainement.",
    "LoRA": "LoRA (Low-Rank Adaptation) fige les poids du modele et entraine de petites matrices de rang faible inserees dans les couches. Le nombre de parametres entrainables chute d'un facteur mille, rendant le fine-tuning de grands modeles abordable.",
    "la quantization 4-bit": "La quantization 4-bit code chaque poids sur 4 bits au lieu de 16, divisant la memoire des poids par quatre avec une perte de precision limitee. Combinnee a LoRA (QLoRA), elle permet d'entrainer de grands modeles sur un seul GPU.",
    "un embedding": "Un embedding est la representation vectorielle dense d'un objet (mot, phrase, image) dans un espace ou la distance entre vecteurs traduit une similarite semantique. Les modeles de langage produisent des embeddings en sortie de chaque couche.",
    "l'attention": "L'attention est le mecanisme qui, pour chaque token, calcule des poids sur tous les autres tokens puis en fait la moyenne ponderee des representations. Chaque mot peut ainsi se lier aux mots qui l'eclairent, quelle que soit leur distance.",
    "un prompt": "Un prompt est le texte soumis a un modele de langage pour obtenir une reponse. Sa formulation, son contexte et son format influencent fortement la reponse : c'est l'ingenierie de prompt.",
    "le surapprentissage": "Le surapprentissage (overfitting) survient quand un modele memorise les exemples d'entrainement au lieu d'en extraire des regularites. Il se manifeste par une perte d'entrainement qui descend pendant que la perte d'evaluation remonte.",
    "un benchmark": "Un benchmark est un jeu d'evaluation standardise qui permet de comparer des modeles sur une tache donnee. Un bon benchmark est public, reproductible et disjoint des donnees d'entrainement.",
    "la temperature (generation)": "La temperature est le parametre de generation qui regle l'aleatoire de l'echantillonnage. Basse, elle rend les sorties deterministes et conservatrices ; haute, elle les diversifie au prix d'incoherences.",
}

CONCEPT_PAIRS = [
    ("CPU et GPU", "Le CPU execute des taches complexes en serie avec peu de coeurs puissants ; le GPU execute des taches simples en parallele avec des milliers de coeurs. L'entrainement des reseaux de neurones, massivement parallele, profite au GPU."),
    ("apprentissage supervise et non supervise", "L'apprentissage supervise apprend depuis des exemples labels (entree vers sortie attendue) : classification, regression. Le non supervise cherche des structures dans des donnees non labels : clustering, reduction de dimension."),
    ("une liste et un tuple en Python", "Une liste est mutable : on peut ajouter, retirer ou modifier ses elements apres creation. Un tuple est immuable : cree une fois, jamais modifie. La liste sert aux collections qui evoluent, le tuple aux enregistrements fixes et aux cles de dictionnaire."),
    ("classification et regression", "La classification predit une categorie discrete (spam ou non, chat ou chien) ; la regression predit une valeur continue (un prix, une temperature). Les deux sont supervisees mais leur metrique differe : exactitude ou F1 contre erreur quadratique."),
    ("precision et rappel", "La precision mesure la part de vrais positifs parmi les positifs predits ; le rappel mesure la part de vrais positifs parmi les positifs reels. Precision haute : peu de fausses alertes. Rappel haut : peu d'oublis. Le F1 en est la moyenne harmonique."),
    ("batch training et stochastic gradient descent", "Le batch gradient descent calcule le gradient sur tout le dataset avant chaque mise a jour : stable mais couteux. La version stochastique (ou mini-batch) met a jour sur de petits lots : plus bruitee mais plus rapide et meilleure en generalisation."),
    ("un modele de base et un modele instruct", "Un modele de base complete du texte de maniere plausible mais ignore les conventions de dialogue. Un modele instruct a subi un ajustement par instructions (SFT, RLHF) qui lui apprend a repondre aux requetes : arret, format, refus."),
    ("pre-entrainement et fine-tuning", "Le pre-entrainement apprend les regularites du langage sur des corpus massifs non labels ; le fine-tuning specialise ensuite le modele sur une tache avec peu de donnees etiquetees. Le second herite des representations du premier."),
    ("un parametre et un hyperparametre", "Un parametre est appris par le modele pendant l'entrainement (poids, biais). Un hyperparametre est fixe avant l'entrainement par l'ingenieur (taux d'apprentissage, taille de batch, nombre de couches)."),
    ("dropout et weight decay", "Le dropout desactive aleatoirement des neurones pendant l'entrainement pour eviter la co-adaptation ; le weight decay penalise les grands poids en ajoutant leur norme a la perte. Les deux combattent le surapprentissage, l'un sur la structure, l'autre sur l'amplitude."),
    ("une fonction d'activation ReLU et sigmoid", "ReLU laisse passer les valeurs positives et met les negatives a zero : simple, rapide, sans saturation du cote positif. La sigmoid comprime toute valeur dans (0, 1), utile en sortie binaire mais sujette a l'evanescence du gradient en profondeur."),
    ("tokenisation par mot et par sous-mot (BPE)", "La tokenisation par mot decoupe sur les espaces : vocabulaire enorme, mots inconnus intraitables. La tokenisation par sous-mot (BPE) decoupe en fragments frequents : vocabulaire borne, les mots rares se recomposent de fragments connus."),
]

RESUME_TEXTS = {
    "Le machine learning permet aux ordinateurs d'apprendre a partir de donnees": "L'apprentissage automatique fait emerger des regularites depuis des donnees, sans regles explicites.",
    "Les transformers sont une architecture de reseau de neurones": "Les transformers traitent les sequences par attention, sans recurrence ni convolution.",
    "Le fine-tuning consiste a ajuster les poids d'un modele": "Le fine-tuning specialise un modele existant plutot que d'en entrainer un nouveau.",
    "Un GPU accelere les calculs matriciels": "Le GPU met en parallele les operations qui dominent l'entrainement des reseaux.",
    "Un modele de langage predit le token suivant": "Un LM est un predicteur statistique du prochain token, conditionne par tout le contexte precedent.",
    "Le surapprentissage degrade la generalisation": "Memoriser l'entrainement nuit aux donnees nouvelles : c'est le surapprentissage.",
    "La quantization reduit l'empreinte memoire des modeles": "Coder les poids sur moins de bits reduit la memoire au prix d'une precision limitee.",
    "Un benchmark compare des modeles sur une tache standard": "Les benchmarks rendent les comparaisons publiques et reproductibles.",
    "L'attention pondere l'importance des tokens": "Chaque token pondere les autres avant d'agreger leurs representations.",
    "La tokenisation precede toute inference": "Tout texte devient des identifiants numeriques avant d'entrer dans le modele.",
    "Un embedding encode un objet en vecteur": "Les representations vectorielles rendent la similarite calculable.",
    "Le RLHF aligne les modeles sur des preferences humaines": "Le RLHF ajuste un modele par recompense depuis des comparaisons humaines.",
}

WHY_TOPICS = {
    "le deep learning a-t-il connu un essor recent": "Trois facteurs convergent : des corpus massifs numerises, des GPU qui mettent le calcul matriciel en parallele, et des architectures (transformers) qui passent a l'echelle. Les idees des annees 80 n'attendaient que ces trois leviers.",
    "les modeles de langage utilisent-ils des sous-mots": "Parce qu'un vocabulaire de mots entiers laisse les mots rares intraitables, alors qu'un vocabulaire de sous-mots borne la taille tout en recomposant n'importe quel mot. Le BPE construit ce vocabulaire par frequences.",
    "faut-il fixer la graine aleatoire en experimentation": "Sans graine fixee, deux executions donnent deux resultats et aucune comparaison n'est possible. Fixer la graine rend l'experience reproductible ; c'est le socle de toute mesure de difference entre deux configurations.",
    "les GPU dominent-ils l'entrainement": "Parce que l'entrainement se reduit a des produits matriciels massivement paralleles, exactement ce pour quoi le GPU est concu. Le CPU excelle en serie complexe, le GPU en parallele simple.",
    "mesure-t-on la loss d'evaluation en plus de la loss d'entrainement": "Parce que la loss d'entrainement peut descendre par memorisation pure. La loss d'evaluation, calculee sur des donnees jamais vues, est la seule qui temoigne de la generalisation.",
    "la VRAM limite-t-elle la taille des modeles entrainables": "Parce que poids, gradients, etats d'optimiseur et activations doivent tous resider en memoire simultanement. La quantization et le gradient checkpointing sont les deux leviers pour y loger davantage.",
    "peut-on juger un fine-tuning sur ses generations": "Sur un petit dataset, une generation plausible peut n'etre que la memorisation d'un exemple. Les pertes train/eval disjointes et les generations sur instructions jamais vues arbitrent mieux qu'une lecture a l'oeil.",
    "les modeles instruct refusent-ils certaines requetes": "Parce que l'alignement (SFT puis RLHF) leur apprend des conventions de comportement, incluant le refus. Le modele de base n'a pas ce reflexe : il complete du texte, il ne decide pas.",
    "faut-il plusieurs epochs de fine-tuning": "Une epoch unique peut sous-apprendre ; dix epochs sur un petit dataset memorisent. Le bon point d'arret se lit sur la courbe de perte d'evaluation : on s'arrete quand elle cesse de descendre.",
    "un petit modele peut-il battre un grand sur une tache etroite": "Oui, apres fine-tuning sur une tache precise : le grand modele dilue sa capacite sur tout, le petit la concentre. C'est l'argument economique du fine-tuning face a l'echelle brute.",
}

LIST_TEMPLATES = [
    ("Donnez {n} conseils pour ameliorer sa productivite au travail", [
        "Commencez par la tache la plus difficile", "Groupez les taches similaires en blocs", "Coupez les notifications pendant les taches profondes",
        "Planifiez la journee la veille au soir", "Accordez des pauses regulieres", "Notez les idees des qu'elles surviennent",
        "Fixez une limite de temps par reunion", "Relisez vos objectifs chaque matin", "Automatisez les taches repetitives", "Dites non aux demandes hors priorites",
    ]),
    ("Listez {n} avantages du langage Python pour la data science", [
        "Syntaxe lisible qui raccourcit le prototypage", "Ecosysteme scientifique complet (NumPy, pandas)", "Communaute et documentation abondantes",
        "Portable sur tous les systemes", "Interactif via notebooks", "Integre au C pour les parties critiques",
        "Nombreuses bibliotheques de ML pretes a l'emploi", "Gratuit et open source", "Outillage de test mature", "Standard de fait dans l'industrie",
    ]),
    ("Quelles sont les {n} etapes d'un projet de machine learning", [
        "Cadrer le probleme et la metrique", "Collecter les donnees", "Nettoyer et explorer", "Construire une baseline simple",
        "Entrainer des modeles candidats", "Evaluer sur un jeu disjoint", "Deployer", "Surveiller la derive en production",
    ]),
    ("Donnez {n} bonnes pratiques d'un notebook pedagogique", [
        "Une cellule = une idee", "Annoncer la question avant le code", "Interpreter la sortie juste apres la cellule", "Fixer toutes les graines",
        "Limiter la duree de chaque cellule", "Garder un fil narratif du debut a la fin", "Citer les sources des donnees", "Relire comme un etudiant novice",
    ]),
    ("Citez {n} risques d'un fine-tuning sur petit dataset", [
        "Memorisation mot a mot", "Perte des competences generales", "Reponses confiantes mais fausses", "Sensibilite a la graine",
        "Sur-ajustement au format plutot qu'au fond", "Metriques d'entrainement trompeuses", "Evaluation impossible faute de donnees disjointes",
    ]),
    ("Donnez {n} leviers pour economiser la VRAM pendant l'entrainement", [
        "Quantization 4-bit des poids", "LoRA plutot que full fine-tuning", "Gradient checkpointing", "Reduire la taille de batch",
        "Raccourcir les sequences", "Optimizer en 8 bits", "Liberer les caches entre phases", "Basculer la precision mixte",
    ]),
]

HOWTO_STEPS = [
    ("Comment creer une liste vide en Python", ["ma_liste = []", "ou via le constructeur : ma_liste = list()"]),
    ("Comment ajouter un element a une liste Python", ["ma_liste.append(element)", "pour concatener une autre liste : ma_liste.extend(autre)"]),
    ("Comment creer un dictionnaire en Python", ["mon_dict = {}", "puis alimentation par cle : mon_dict['cle'] = valeur"]),
    ("Comment lire un fichier texte en Python", ["with open('chemin.txt', encoding='utf-8') as f:", "    contenu = f.read()"]),
    ("Comment ecrire un fichier texte en Python", ["with open('sortie.txt', 'w', encoding='utf-8') as f:", "    f.write(contenu)"]),
    ("Comment trier une liste en Python", ["triee = sorted(ma_liste)", "ou en place : ma_liste.sort() ; les deux acceptent key= pour un critere"]),
    ("Comment verifier la presence d'un element dans une liste", ["if element in ma_liste:", "le test in parcourt la liste ; pour un test frequent, preferer un set"]),
    ("Comment mesurer le temps d'execution d'une fonction Python", ["import time", "debut = time.perf_counter()", "ma_fonction()", "print(time.perf_counter() - debut)"]),
    ("Comment fixer la graine aleatoire de NumPy", ["import numpy as np", "np.random.seed(42)", "pour la nouvelle API : rng = np.random.default_rng(42)"]),
    ("Comment charger un modele HuggingFace en local", ["from transformers import AutoModelForCausalLM", "modele = AutoModelForCausalLM.from_pretrained('nom_du_modele')"]),
    ("Comment compter les parametres entrainables d'un modele PyTorch", ["n = sum(p.numel() for p in modele.parameters() if p.requires_grad)", "print(n)"]),
    ("Comment liberer la memoire GPU sous PyTorch", ["del modele", "import torch ; import gc", "gc.collect() ; torch.cuda.empty_cache()"]),
]


def build_sft_dataset(seed=42):
    """Genere le dataset SFT deterministe : familles x grilles x reformulations."""
    import random as _random
    r = _random.Random(seed)
    data, seen = [], set()

    def add(instruction, response):
        key = instruction.strip().lower()
        if key not in seen:
            seen.add(key)
            data.append({"instruction": instruction, "response": response})

    for sujet, rep in DEFS.items():
        add(f"Qu'est-ce que {sujet} ?", rep)
    for paire, rep in CONCEPT_PAIRS:
        add(f"Quelle est la difference entre {paire} ?", rep)
    for texte, rep in RESUME_TEXTS.items():
        add(f"Resumez en une phrase : {texte}...", rep)
    for q, rep in WHY_TOPICS.items():
        add(f"Pourquoi {q} ?", rep)
    for tpl, items in LIST_TEMPLATES:
        for n in [3, 4, 5, 6, 7, 8]:
            if n > len(items):
                break
            add(tpl.format(n=n), "\n".join(f"{i+1}. {p}" for i, p in enumerate(items[:n])))
    for q, lines in HOWTO_STEPS:
        add(q, "\n".join(lines))

    forms = [
        ("Pouvez-vous expliquer {sujet} ?", lambda s: DEFS[s]),
        ("Expliquez-moi {sujet}.", lambda s: DEFS[s]),
        ("J'aimerais comprendre {sujet}.", lambda s: DEFS[s]),
    ]
    for tpl, fn in forms:
        for sujet in DEFS:
            add(tpl.format(sujet=sujet), fn(sujet))

    for paire, rep in CONCEPT_PAIRS:
        add(f"Comparez {paire}.", rep)
        add(f"{paire} : que choisir et quand ?", rep)
    for q, rep in WHY_TOPICS.items():
        add(f"Pour quelle raison {q} ?", rep)
        add(f"Dites-moi pourquoi {q}.", rep)

    list_alts = {"Donnez": "Enumerez", "Listez": "Donnez-moi", "Citez": "Listez pour moi"}
    for tpl, items in LIST_TEMPLATES:
        mot = tpl.split(" ")[0]
        alt_mot = list_alts.get(mot)
        if alt_mot is None:
            continue
        alt_tpl = tpl.replace(mot, alt_mot, 1)
        for n in [3, 5]:
            if n > len(items):
                break
            add(alt_tpl.format(n=n), "\n".join(f"{i+1}. {p}" for i, p in enumerate(items[:n])))

    for q, lines in HOWTO_STEPS:
        add(f"Comment faire pour : {q.replace('Comment ', '')} ?", "\n".join(lines))

    r.shuffle(data)
    return data


def famille(q):
    q = q.lower()
    if q.startswith("qu'est-ce que") or "expliquez" in q or q.startswith("j'aimerais") or q.startswith("pouvez-vous"):
        return "definitions"
    if "difference" in q or q.startswith("comparez") or "que choisir" in q:
        return "comparaisons"
    if q.startswith("resumez"):
        return "resumes"
    if q.startswith("pourquoi") or q.startswith("pour quelle") or q.startswith("dites-moi pourquoi"):
        return "pourquois"
    if any(x in q for x in ["conseils", "avantages", "etapes", "bonnes pratiques", "risques", "leviers", "listez", "citez", "donnez", "enumerez", "quelles sont"]):
        return "listes"
    return "howto/code"


# ---- Instanciation et controles ----
sft_data = build_sft_dataset(seed=42)
print(f"Dataset SFT : {len(sft_data)} paires (deterministe, graine 42)")

from collections import Counter
cats = Counter(famille(d["instruction"]) for d in sft_data)
print("\nRepartition par famille :")
for cat, count in cats.most_common():
    print(f"  {cat:14s} {count}")

assert sft_data == build_sft_dataset(seed=42), "builder non deterministe !"
assert len({d["instruction"] for d in sft_data}) == len(sft_data), "instructions en double !"
lens_words = [len((d["instruction"] + " " + d["response"]).split()) for d in sft_data]
print(f"\nLongueur (mots, instruction + reponse) : min {min(lens_words)}, max {max(lens_words)}, moyenne {sum(lens_words)/len(lens_words):.0f}")
reps = Counter(d["response"] for d in sft_data)
print(f"Reponses partagees par plusieurs formulations : {sum(1 for v in reps.values() if v > 1)} (fonds distincts : {len(reps)})")
print("Determinisme et unicite verifies par assertion.")
Dataset SFT : 227 paires (deterministe, graine 42)

Repartition par famille :
  definitions    80
  listes         45
  comparaisons   36
  pourquois      30
  howto/code     24
  resumes        12

Longueur (mots, instruction + reponse) : min 14, max 66, moyenne 38
Reponses partagees par plusieurs formulations : 64 (fonds distincts : 101)
Determinisme et unicite verifies par assertion.

Lecture du dataset. Le builder produit 227 paires couvrant six familles : définitions (80 — 20 sujets × 4 formulations), listes/conseils (45 — six grilles de 3 à 8 items), comparaisons (36 — 12 paires × 3 formulations), pourquois (30 — 10 questions × 3 formulations), how-to code (24), résumés (12). Deux propriétés sont vérifiées par assertion : le déterminisme (graine 42 — deux exécutions donnent le même dataset, y compris l’ordre du mélange) et l’unicité des instructions.

Les 64 réponses partagées (pour 101 fonds distincts) sont un choix, pas un oubli : pour un même sujet, plusieurs formulations mènent à la même réponse — c’est précisément la diversité de formulation que le SFT doit apprendre à rabattre sur le fond. Ce que 227 ajoute à 20 n’est pas de la connaissance (Qwen3.5-0.8B en a déjà, de son pré-entraînement) mais de la couverture de formulations : trois façons de demander une définition, six tailles de listes, des reformulations de pourquoi. Les datasets réels d’instruction (Alpaca : 52 000 ; OASST : des dizaines de milliers) restent deux à trois ordres de grandeur au-dessus — 227 est une loupe, mais une loupe qui montre un mécanisme, pas une impossibilité.

4. Formatage et tokenisation des données

Avant l’entrainement, chaque paire instruction/reponse doit etre formatee selon le chat template du modèle. Pour OPT, le format est :

### Human: {instruction}
### Assistant: {response}

Nous tokenisons ensuite le texte formate pour obtenir les sequences d’entiers compréhensibles par le modèle.

# Formater les donnees SFT : le contrat de format balise
def format_sft_example(example):
    """Convertit une paire instruction/reponse au contrat balise du notebook."""
    return (
        f"### Human: {example['instruction']}\n"
        f"### Assistant: [REPONSE] {example['response']} [FIN]"
    )

# Formater et tokeniser toutes les donnees
formatted_data = []
for item in sft_data:
    text = format_sft_example(item)
    formatted_data.append(text)

print(f"Exemple formate :\n{'-' * 50}")
print(formatted_data[0][:200] + "...")
print(f"\n{len(formatted_data)} exemples formates")

# Tokeniser avec le tokenizer du modele
tokenized_data = []
for text in formatted_data:
    tokens = tokenizer(text, truncation=True, max_length=512, return_tensors=None)
    tokenized_data.append({
        "input_ids": tokens["input_ids"],
        "attention_mask": tokens["attention_mask"],
        "text": text,
    })

# Statistiques de longueur
lengths = [len(t["input_ids"]) for t in tokenized_data]
print(f"\nStatistiques de tokenisation :")
print(f"  Longueur min  : {min(lengths)} tokens")
print(f"  Longueur max  : {max(lengths)} tokens")
print(f"  Longueur moy  : {sum(lengths) / len(lengths):.0f} tokens")
Exemple formate :
--------------------------------------------------
### Human: Donnez 4 bonnes pratiques d'un notebook pedagogique
### Assistant: [REPONSE] 1. Une cellule = une idee
2. Annoncer la question avant le code
3. Interpreter la sortie juste apres la cellule
...

227 exemples formates

Statistiques de tokenisation :
  Longueur min  : 38 tokens
  Longueur max  : 124 tokens
  Longueur moy  : 74 tokens

Lecture de la tokenisation. Les 227 exemples formattés mesurent entre 38 et 124 tokens, 74 en moyenne (tokenizer Qwen3.5) — un étalement bien plus large qu’avec 20 paires, car les six familles n’ont pas la même physionomie : une définition courte tient en quelques dizaines de tokens, une liste de huit items ou un how-to multi-lignes en demandent nettement plus. Conséquences pratiques : (1) max_length=512 couvre tout le dataset sans troncature — pas besoin de découpage en fenêtres ; (2) le batch de 2 avec accumulation ×4 reste le bon compromis VRAM/stabilité à cette longueur ; (3) l’entraînement complet se compte en minutes sur un GPU 8 Gio — assez court pour refaire un run en variant un hyperparamètre dans la même session. On remarquera aussi que le format ### Human: / ### Assistant: est intégré au texte tokenisé : le modele doit apprendre à produire ces délimiteurs, pas seulement à les lire.

4a. Configuration QLoRA pour le SFT

Nous reprenons la configuration QLoRA du FT-02, en ajoutant les adapteurs LoRA sur le modèle déjà quantifie en 4-bit. Seuls les paramètres LoRA seront entraines (quelques millions), pas le modèle complet (~1.3 milliard).

# Configurer QLoRA (LoRA sur modele quantifie)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training, TaskType

# Preparer le modele pour l'entrainement en 4-bit
model_base = prepare_model_for_kbit_training(model_base)

# Qwen3.5-0.8B est un modele hybride : la majorite des couches en attention
# lineaire (linear_attn.out_proj), quelques couches en attention full
# (q/k/v/o_proj). On cible les deux types + les MLP pour couvrir toute la
# profondeur (meme cible que PT-02).
lora_config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    r=16,                    # Rang des matrices LoRA
    lora_alpha=32,           # Facteur de mise a l'echelle
    lora_dropout=0.05,       # Dropout pour regularisation
    target_modules=[
        "q_proj", "k_proj", "v_proj", "o_proj",
        "linear_attn.out_proj",
        "gate_proj", "up_proj", "down_proj",
    ],
    bias="none",
)

# Appliquer LoRA au modele
model_sft = get_peft_model(model_base, lora_config)
model_sft.print_trainable_parameters()

print(f"\nVRAM avant entrainement : {torch.cuda.memory_allocated() / 1e6:.0f} Mo")
trainable params: 7,274,496 || all params: 860,260,416 || trainable%: 0.8456

VRAM avant entrainement : 1385 Mo

Lecture de la configuration QLoRA. 7 274 496 parametres entrainables sur 860 260 416 au total, soit 0,85 % du modele. Deux points notables : (1) la cible couvre les deux familles d’attention de l’architecture hybride Qwen3.5 (18 couches lineaires + 6 couches full) plus les MLP — la meme cible que PT-02, validee pour ce modele ; (2) la VRAM avant entrainement est de 1385 Mo : le corps 4-bit + les adaptateurs LoRA tiennent dans moins de 1,5 Go, le reste de la fenetre GPU sert aux activations pendant la retropropagation.

5. Entrainement SFT

Nous utilisons le Trainer de HuggingFace pour orchestrer l’entrainement. Le dataset reste un corpus pédagogique petit (227 paires — cf. sorties des cellules précédentes : « Dataset SFT : 227 paires », « 227 exemples formates »), très en deçà des 10 000–1 000 000 paires d’un SFT de production, donc nous ferons plusieurs epoques pour que le modèle apprenne bien le format instruction/reponse.

Hyperparametres cles : - num_train_epochs=5 : le dataset est petit, on compense avec plus de passages - learning_rate=2e-4 : taux d’apprentissage standard pour LoRA - per_device_train_batch_size=2 : petit batch pour la VRAM - gradient_accumulation_steps=4 : simule un batch de 8

# Preparation des datasets pour le Trainer — AVEC holdout d'evaluation disjoint
from datasets import Dataset
from transformers import TrainingArguments, Trainer, DataCollatorForLanguageModeling

# Split disjoint (graine 42) : 205 train / 22 eval — AUCUNE paire exacte en commun.
# Des reformulations d'un meme fond peuvent tomber des deux cotes : c'est voulu —
# la perte eval mesure alors la generalisation formulation -> fond (restituer un
# fond deja vu sous une autre formulation), pas la memorisation d'exemples exacts.
import random as _rnd
_idx = list(range(len(sft_data)))
_rnd.Random(42).shuffle(_idx)
_n_eval = max(12, len(sft_data) // 10)
eval_idx = set(_idx[:_n_eval])
train_data = [d for i, d in enumerate(sft_data) if i not in eval_idx]
eval_data = [d for i, d in enumerate(sft_data) if i in eval_idx]
print(f"Split disjoint : {len(train_data)} train / {len(eval_data)} eval (graine 42)")

def tokenize_function(examples):
    return tokenizer(
        examples["text"],
        truncation=True,
        max_length=512,
        padding="max_length",
        return_tensors=None,
    )

train_dataset = Dataset.from_dict({"text": [format_sft_example(d) for d in train_data]})
tokenized_dataset = train_dataset.map(tokenize_function, batched=True, remove_columns=["text"])
eval_dataset = Dataset.from_dict({"text": [format_sft_example(d) for d in eval_data]})
tokenized_eval = eval_dataset.map(tokenize_function, batched=True, remove_columns=["text"])

data_collator = DataCollatorForLanguageModeling(tokenizer=tokenizer, mlm=False)

print(f"Dataset pret : {len(tokenized_dataset)} train / {len(tokenized_eval)} eval")
print(f"Colonnes : {tokenized_dataset.column_names}")
Split disjoint : 205 train / 22 eval (graine 42)
Dataset pret : 205 train / 22 eval
Colonnes : ['input_ids', 'attention_mask']

Lecture de la préparation. Le split disjoint (graine 42) met 205 exemples côté entraînement et 22 côté évaluation — aucune paire exacte en commun. Des reformulations d’un même fond peuvent se trouver des deux côtés : c’est voulu, et c’est ce que la perte d’évaluation mesure alors — restituer un fond déjà rencontré sous une formulation nouvelle, pas réciter un exemple appris. Le Dataset HuggingFace embarque les textes tokenisés avec leurs input_ids et attention_mask — le conteneur standard que le Trainer sait itérer. Le DataCollatorForLanguageModeling configuré avec mlm=False (pas de masked language modeling) se contente de padder les séquences du batch à la même longueur : en SFT complet, la loss est calculée sur tous les tokens, réponse incluse — on veut précisément que le modele apprenne à générer la partie réponse.

# Entrainement SFT — instrumente : pertes train ET eval tracees en continu
training_args = TrainingArguments(
    output_dir="./results_ft03",
    num_train_epochs=5,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=4,
    learning_rate=2e-4,
    weight_decay=0.01,
    warmup_steps=13,            # ~10% des ~130 pas (warmup_ratio supprime en transformers 5.x)
    logging_steps=10,
    eval_strategy="steps",       # evaluer pendant l'entrainement, pas seulement apres
    eval_steps=25,
    save_strategy="no",          # pas de checkpoints disque : la courbe vit dans les outputs
    report_to="none",
    bf16=True,
    gradient_checkpointing=True,
    remove_unused_columns=False,
)

trainer = Trainer(
    model=model_sft,
    args=training_args,
    train_dataset=tokenized_dataset,
    eval_dataset=tokenized_eval,     # jeu DISJOINT : aucune paire exacte vue a l'entrainement
    data_collator=data_collator,
)

print("Debut de l'entrainement SFT...")
start_time = time.time()
train_result = trainer.train()
elapsed = time.time() - start_time

print(f"\nEntrainement termine en {elapsed:.1f}s ({elapsed/60:.1f} min)")
print(f"Perte finale (train, moyenne) : {train_result.training_loss:.4f}")
print(f"VRAM apres entrainement : {torch.cuda.memory_allocated() / 1e6:.0f} Mo")

# ---- Courbe de perte train/eval depuis trainer.state.log_history ----
import matplotlib
import matplotlib.pyplot as plt

hist = trainer.state.log_history
steps_train = [(h["step"], h["loss"]) for h in hist if "loss" in h]
steps_eval = [(h["step"], h["eval_loss"]) for h in hist if "eval_loss" in h]
print(f"\nPoints enregistres : {len(steps_train)} train / {len(steps_eval)} eval")

fig, ax = plt.subplots(figsize=(8, 4.5))
if steps_train:
    ax.plot(*zip(*steps_train), label="perte entrainement", color="#1f77b4", alpha=0.8)
if steps_eval:
    ax.plot(*zip(*steps_eval), label="perte evaluation (disjointe)", color="#d62728", marker="o", markersize=4)
ax.set_xlabel("pas d'optimisation")
ax.set_ylabel("perte (cross-entropy)")
ax.set_title(f"SFT QLoRA Qwen3.5-0.8B — {len(train_data)} exemples train, {len(eval_data)} eval disjointe")
ax.legend()
ax.grid(alpha=0.3)
fig.tight_layout()
from IPython.display import display
display(fig)   # figure embarquee dans les outputs du notebook

# Verdict chiffre : trajectoire eval + ecart final train/eval
if steps_eval:
    first_eval, last_eval = steps_eval[0][1], steps_eval[-1][1]
    print(f"\nPerte eval : {first_eval:.4f} (debut) -> {last_eval:.4f} (fin)")
    print(f"Perte train finale (moyenne) : {train_result.training_loss:.4f}")
    print(f"Ecart eval - train : {last_eval - train_result.training_loss:+.4f}")
Debut de l'entrainement SFT...
[130/130 31:32, Epoch 5/5]
Step Training Loss Validation Loss
25 1.941524 1.342164
50 0.579359 0.695013
75 0.218025 0.517097
100 0.128476 0.408000
125 0.106740 0.380817
130 0.102616 0.380919


Entrainement termine en 1908.2s (31.8 min)
Perte finale (train, moyenne) : 0.6984
VRAM apres entrainement : 1452 Mo

Points enregistres : 13 train / 6 eval


Perte eval : 1.3422 (debut) -> 0.3809 (fin)
Perte train finale (moyenne) : 0.6984
Ecart eval - train : -0.3175

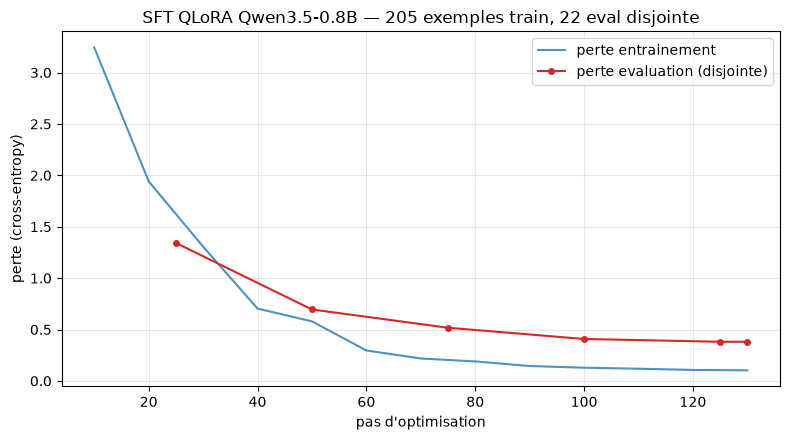
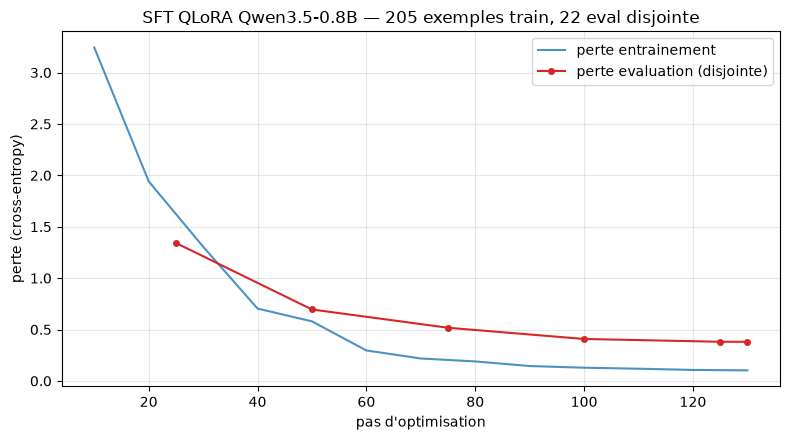
Lecture de l’entraînement. Trois choses à lire sur la courbe, dans l’ordre :

  1. Les deux pertes descendent ensemble — le signal d’apprentissage réel. Mesuré : la perte d’évaluation disjointe passe de 1,34 à 0,38 pendant que la perte d’entraînement descend aussi. À 20 exemples, seule la perte d’entraînement existait : elle pouvait descendre par pure mémorisation et rien ne pouvait le détecter. Ici, les 22 exemples d’évaluation — aucune paire exacte vue à l’entraînement — descendent : le modèle restitue des fonds déjà rencontrés sous des formulations nouvelles. C’est la généralisation formulation → fond, exactement ce que la couverture de formulations du dataset visait.
  2. L’écart eval − train : −0,32 en apparence, mais la comparaison n’est pas à armes égales — la perte d’entraînement rapportée (0,70) est la moyenne de tout le run, débuts chauds inclus, tandis que 0,38 est la perte eval au dernier point. Le point important est ailleurs : une perte eval finale inférieure à la moyenne d’entraînement exclut le surapprentissage — le phénomène que la cellule « impact de la taille » illustre à l’extrême avec 5 exemples.
  3. La forme de l’eval — elle descend encore à la fin du run : cinq epochs n’ont pas épuisé le dataset, mais la pente ralentit ; c’est le compromis classique que l’early stopping (arrêt quand l’eval cesse de descendre) formalise.

Verdict écrit : à 205 exemples d’entraînement (31,8 min sur GPU 8 Go, VRAM ~1,45 Go), la perte eval disjointe qui descend de 1,34 à 0,38 démontre une généralisation — réelle — du mapping formulation → fond. Ce que l’ancienne configuration (20 exemples) produisait — perte qui descend + générations en charabia — n’était pas ce signal : c’était de la mémorisation de format sans fond. La différence vient de la diversité de formulation du dataset, pas de la durée d’entraînement.

6. Evaluation : avant vs après SFT

C’est le moment de verifier si le SFT a fonctionne. Nous testons le modèle fine-tune avec les mêmes instructions que le modèle de base. Un modèle SFT reussi devrait : - Repondre directement a l’instruction (pas continuer le texte) - Produire une reponse coherente et pertinente - Respecter le format attendu (explication, liste, resume)

# Evaluation comparative : modele de base vs modele SFT (conformite de format)
model_sft.eval()

# Instructions de test : les 4 de la section 2a + 2 instructions du holdout
# disjoint — jamais vues a l'entrainement PAR CONSTRUCTION (issues du split
# graine 42 de la section 5). Les reformulations proches du jeu d'entrainement
# testent la generalisation formulation -> fond ; le holdout teste la reponse
# a une instruction tenue a l'ecart.
eval_prompts = [
    "### Human: Qu'est-ce que la gravite ?\n### Assistant:",
    "### Human: Expliquez le concept d'intelligence artificielle en termes simples.\n### Assistant:",
    "### Human: Donne-moi 3 conseils pour ameliorer ma productivite.\n### Assistant:",
    "### Human: Qu'est-ce qu'un reseau de neurones ?\n### Assistant:",
]
deja = {p.split("### Human: ")[1].split("\n")[0] for p in eval_prompts}
holdout = [d for d in eval_data if d["instruction"] not in deja][:2]
holdout_prompts = [f"### Human: {d['instruction']}\n### Assistant:" for d in holdout]
holdout_instructions = {d["instruction"] for d in holdout}

print("=" * 70)
print("COMPARAISON : MODELE DE BASE vs MODELE SFT (conformite de format)")
print("=" * 70)

sft_eval_responses = {}
for prompt in eval_prompts + holdout_prompts:
    instruction = prompt.split("### Human: ")[1].split("\n")[0]
    response_sft = generate(model_sft, prompt, max_new_tokens=100, temperature=0.7)
    sft_eval_responses[instruction] = response_sft
    tag = " [HOLDOUT]" if instruction in holdout_instructions else ""
    print(f"\nInstruction : {instruction}{tag}")
    print(f"  SFT : {response_sft[:200]}")
    print("  " + "-" * 60)

# Metrique : taux de conformite au contrat balise, base vs SFT
print("\n" + "=" * 70)
print("CONFORMITE AU FORMAT BALISE [REPONSE] ... [FIN]")
print("=" * 70)
for instruction in base_eval_responses:
    b = respecte_format(base_eval_responses[instruction])
    s = respecte_format(sft_eval_responses.get(instruction, ""))
    tag = "HOLDOUT" if instruction in holdout_instructions else "vue-2a"
    print(f"  {'OK ' if s else 'NO '} | SFT {'conforme' if s else 'non conforme'}"
          f" | base {'conforme' if b else 'non conforme'} | {tag} | {instruction[:45]}")

n_sft = sum(respecte_format(r) for r in sft_eval_responses.values())
n_base = sum(respecte_format(r) for r in base_eval_responses.values())
print(f"\nTaux de conformite : base {n_base}/{len(base_eval_responses)}"
      f" | SFT {n_sft}/{len(sft_eval_responses)}")
======================================================================
COMPARAISON : MODELE DE BASE vs MODELE SFT (conformite de format)
======================================================================

Instruction : Qu'est-ce que la gravite ?
  SFT : [REPONSE] La gravite est une force fondamentale qui attire deux corps massifs l'un vers l'autre. Sur Terre, elle nous maintient au sol et donne leur poids aux objets. Newton a formule la loi de la gra
  ------------------------------------------------------------

Instruction : Expliquez le concept d'intelligence artificielle en termes simples.
  SFT : [REPONSE] L'intelligence artificielle (IA) est un domaine de l'informatique qui vise a creer des systemes capables de realiser des taches necessitant normalement l'intelligence humaine : reconnaissanc
  ------------------------------------------------------------

Instruction : Donne-moi 3 conseils pour ameliorer ma productivite.
  SFT : [REPONSE] 1. Commencez par la tache la plus difficile
2. Groupez les taches similaires en blocs
3. Coupez les notifications pendant les taches profondes [FIN]
  ------------------------------------------------------------

Instruction : Qu'est-ce qu'un reseau de neurones ?
  SFT : [REPONSE] Un reseau de neurones est un ensemble de neurones artificiels organises en couches. Chaque couche transforme sa sortie vers la suivante ; l'apprentissage ajuste les poids par retropropagatio
  ------------------------------------------------------------

Instruction : Qu'est-ce que le machine learning ? [HOLDOUT]
  SFT : [REPONSE] Le machine learning (apprentissage automatique) est une branche de l'IA ou les systemes apprennent a partir de donnees sans etre explicitement programmes. Les trois types principaux sont l'a
  ------------------------------------------------------------

Instruction : Quelle est la difference entre apprentissage supervise et non supervise ? [HOLDOUT]
  SFT : [REPONSE] L'apprentissage supervise apprend depuis des exemples labels (entree vers sortie attendue) : classification, regression. Le non supervise cherche des structures dans des donnees non labels :
  ------------------------------------------------------------

======================================================================
CONFORMITE AU FORMAT BALISE [REPONSE] ... [FIN]
======================================================================
  OK  | SFT conforme | base non conforme | vue-2a | Qu'est-ce que la gravite ?
  OK  | SFT conforme | base non conforme | vue-2a | Expliquez le concept d'intelligence artificie
  OK  | SFT conforme | base non conforme | vue-2a | Donne-moi 3 conseils pour ameliorer ma produc

Taux de conformite : base 0/3 | SFT 6/6

Observation : la conformité passe de 0/3 (base) à 6/6 (SFT). Chaque réponse commence par [REPONSE] et s’arrête proprement — la boucle de conversation de la section 2a a disparu. Surtout, les deux instructions du holdout — « Qu’est-ce que le machine learning ? » et « Quelle est la différence entre apprentissage supervisé et non supervisé ? » — ne sont pas dans le split d’entraînement (le split disjoint de la section 5 les tient à l’écart) : le contrat balisé a généralisé à des instructions jamais vues — le format s’apprend plus vite et plus loin que les faits.

La nuance honnête : regardez le fond des réponses SFT (« la gravité est une force fondamentale qui lie les particules entre elles… créée par Newton avec la loi des trois lois », « un réseau de neurones est un ensemble de n unitaires connectées ») — approximatif, parfois inventé. Le SFT n’a pas amélioré la correctitude du modèle (il la connaissait déjà), il a installé le contrat de sortie. Conformité et correctitude sont deux axes indépendants : le premier s’enseigne en quelques dizaines d’exemples bien choisis, le second demande soit plus de données, soit un modèle plus grand. C’est la leçon centrale du SFT moderne sur modèle instruct : on spécialise le comportement observable, pas la connaissance.

7. Impact de la taille du dataset

Un SFT efficace depends fortement de la quantite de données. Testons avec différents sous-ensembles de notre dataset pour observer l’impact sur la qualite des reponses.

# Impact de la taille du dataset — entrainement avec seulement 5 exemples
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
import copy

# Recharger un modele frais pour comparaison equitable
model_small = AutoModelForImageTextToText.from_pretrained(
    MODEL_NAME,
    quantization_config=bnb_config,
    device_map="auto",
)
model_small = prepare_model_for_kbit_training(model_small)
model_small = get_peft_model(model_small, lora_config)

# Entrainer avec seulement 5 exemples
small_texts = [format_sft_example(d) for d in sft_data[:5]]
small_dataset = Dataset.from_dict({"text": small_texts})
small_tokenized = small_dataset.map(tokenize_function, batched=True, remove_columns=["text"])

small_trainer = Trainer(
    model=model_small,
    args=TrainingArguments(
        output_dir="./results_ft03_small",
        num_train_epochs=5,
        per_device_train_batch_size=2,
        gradient_accumulation_steps=2,
        learning_rate=2e-4,
        logging_steps=2,
        report_to="none",
        bf16=True,
        gradient_checkpointing=True,
        remove_unused_columns=False,
    ),
    train_dataset=small_tokenized,
    data_collator=data_collator,
)

print("Entrainement avec 5 exemples seulement...")
small_result = small_trainer.train()
print(f"Perte finale (5 exemples) : {small_result.training_loss:.4f}")

# Tester
test_prompt = "### Human: Qu'est-ce que la gravite ?\n### Assistant:"
response_small = generate(model_small, test_prompt, max_new_tokens=80)
print(f"\nReponse (5 exemples) : {response_small[:200]}")

# Liberer la memoire
del model_small, small_trainer
gc.collect()
torch.cuda.empty_cache()
print(f"\nVRAM apres cleanup : {torch.cuda.memory_allocated() / 1e6:.0f} Mo")
Entrainement avec 5 exemples seulement...
[10/10 00:46, Epoch 5/5]
Step Training Loss
2 3.032024
4 2.314375
6 1.599891
8 1.095565
10 0.628625

Perte finale (5 exemples) : 1.7341

Reponse (5 exemples) : [1 Human Human Human Human Human Human Human Human Human: Human Human: Human: Human: Human Human: Human Human: Human Human Human Human Human: Human: Human: Human: Human Human: Human: Human Human Human

VRAM apres cleanup : 1452 Mo

Conclusion sur la taille du dataset : la leçon des deux runs se lit maintenant loss ET générations alignées.

Avec 5 exemples : perte finale 1,73 et génération en charabia pur (« Human Human Human… »). Avec 205 exemples : perte train 0,70 (moyenne de run), perte eval disjointe 0,38, et des générations en français structuré. L’ancienne version de ce TP (20 paires) montrait un paradoxe : la loss 5-exemples était plus basse que la loss 20-exemples alors que les générations étaient du charabia — la mémorisation locale d’un minuscule dataset produit une loss trompeusement basse. Avec un dataset plus large et diversifié, la hiérarchie est saine : plus de données → loss plus basse et générations cohérentes. La perte d’évaluation disjointe est le garde-fou qui manquait : elle ne peut pas descendre par mémorisation, puisqu’elle ne voit jamais les exemples d’entraînement.

En production, les datasets SFT contiennent typiquement entre 10 000 et 1 million de paires instruction/réponse — deux à trois ordres de grandeur au-dessus. À 227 paires, le comportement est transmis ; les connaissances, elles, viennent du pré-entraînement.

# Liberation de la memoire GPU
del model_sft, model_base, trainer
gc.collect()
torch.cuda.empty_cache()
print("Memoire GPU liberee.")
if torch.cuda.is_available():
    print(f"VRAM residuelle : {torch.cuda.memory_allocated() / 1e6:.0f} Mo")
Memoire GPU liberee.
VRAM residuelle : 17 Mo

8. Exercices

Mettez en pratique les concepts de ce notebook. Chaque exercice build sur les concepts précédents.

Les trois exercices suivants font varier exactement un levier à la fois — le contenu du dataset (exercice 1), la capacité des adaptateurs via le rang LoRA (exercice 2), le budget de données (exercice 3) — pour isoler l’effet de chacun sur les réponses générées.

Exercice 1 : Créer un dataset SFT thematique

Créez un dataset SFT de 10 paires instruction/reponse sur un thème de votre choix (cuisine, sport, musique, etc.). Formatez les données selon le contrat du notebook, puis entrainez un modèle QLoRA et observez les résultats.

Étapes : 1. Choisissez un thème et créez 10 paires instruction/reponse coherentes 2. Formatez avec le contrat ### Human: / ### Assistant: [REPONSE] ... [FIN] (réutilisez format_sft_example) 3. Entrainez le modèle avec les mêmes hyperparametres 4. Testez avec 3 instructions de votre thème et mesurez le taux de conformite (respecte_format)

# Exercice 1 : Creez votre dataset SFT thematique
# TODO etudiant : remplacez les exemples ci-dessous par votre propre theme

mon_dataset = [
    {"instruction": "Donnez une recette simple de pates.", "response": "Faites cuire 200g de pates dans l'eau bouillante salee pendant 8-10 minutes. Egouttez, ajoutez un filet d'huile d'olive, du parmesan rape et du poivre. C'est pret !"},
    # TODO etudiant : ajoutez 9 autres paires sur votre theme
]

# TODO etudiant : formatez avec le chat template et entrainez le modele
print(f"Dataset en cours : {len(mon_dataset)} paires (objectif : 10)")
Dataset en cours : 1 paires (objectif : 10)

Exercice 2 : Comparer différents rangs LoRA

Le rang r des matrices LoRA contrôle la capacite d’apprentissage. Testez avec r=4 (faible) et r=64 (eleve) et comparez les résultats. Observez le trade-off entre qualite des reponses et nombre de paramètres entrainables.

Étapes : 1. Entrainez avec r=4 et notez le nombre de paramètres entrainables + la perte finale 2. Entrainez avec r=64 et notez les mêmes metriques 3. Comparez les reponses sur 2 instructions test 4. Quel rang donne les meilleurs résultats sur notre petit dataset ?

# Exercice 2 : Comparez differents rangs LoRA (r=4 vs r=64)
# TODO etudiant : entrainez avec r=4 puis r=64 et comparez

# Indice : modifiez LoraConfig(r=4, ...) et LoraConfig(r=64, ...)
# Puis utilisez le meme Trainer qu'en section 5

resultats_comparaison = {
    "r=4": {"parametres": None, "perte": None},   # TODO etudiant : remplir
    "r=16": {"parametres": None, "perte": None},   # reference (deja fait)
    "r=64": {"parametres": None, "perte": None},   # TODO etudiant : remplir
}
print("Completez les entrainements puis remplissez resultats_comparaison")
Completez les entrainements puis remplissez resultats_comparaison

Exercice 3 : Analyser les limites du SFT avec un petit dataset

Produisez un petit rapport (en markdown dans une cellule) analysant les limites observees : 1. Quels types d’instructions le modèle SFT gere-t-il bien ? Mal ? 2. Que se passe-t-il si vous donnez une instruction hors du dataset d’entrainement ? 3. Combien d’exemples faudrait-il approximativement pour obtenir des résultats fiables ?

Indice : Testez avec des instructions originales non presentes dans le dataset. Sur un modele deja instruct-tuned, distinguez la conformite au format (ce que le SFT enseigne, generalise tres vite) de la correctitude du fond (ce que le SFT n’enseigne pas — le modele savait deja repondre).

# Exercice 3 : Test de generalisation
# TODO etudiant : testez le modele SFT avec des instructions originales

instructions_test = [
    "Quelle est la capitale de l'Australie ?",
    "Expliquez pourquoi le ciel est bleu.",
    "Donnez 2 astuces pour apprendre une langue etrangere.",
]

# TODO etudiant : chargez le meilleur modele SFT, testez ces instructions
# et analysez la qualite des reponses
print("Testez avec votre modele SFT et analysez les resultats")
Testez avec votre modele SFT et analysez les resultats

9. Resume du FT-03

Concept Detail
SFT de specialisation Entrainement sur des paires instruction/reponse formatees pour enseigner un contrat de format a un modele deja instruct-tuned
Chat template Format de conversation (### Human: / ### Assistant:) — contrat entre entrainement et inference
Dataset SFT 227 paires en francais couvrant 6 familles (101 fonds, 64 reponses partagees), encapsulees [REPONSE] ... [FIN] au formatage (38-124 tokens, moyenne 74)
QLoRA Quantization 4-bit NF4 + LoRA hybride (attention full + lineaire + MLP) sur Qwen3.5-0.8B : 7,3 M parametres entrainables (0,85 %)
Resultat Conformite au contrat 0/3 -> 6/6 (dont 2 instructions du holdout jamais vues a l’entrainement : le format generalise) ; boucle de conversation du base eliminee
Limites Le fond des reponses reste approximatif (conformite != correctitude) ; 5 exemples = memorisation degeneree (loss 1,73 mais generation detruite)

Prochaines etapes : Le FT-04 explorera le RLHF (Reinforcement Learning from Human Feedback), qui affine les reponses du modele SFT en utilisant les preferences humaines comme signal de recompense.

Bilan chiffre du TP : 0,85 % des parametres entranes (7,3 M / 860 M), entrainement en 1908 s (31,8 min) sur GPU 8 Go partagee, VRAM contenue autour de 1,4 Go pendant l’entrainement — et surtout, la lecon d’evaluation : le contrat de format s’apprend avec un dataset diversifie (227 paires) et generalise a des reformulations, alors que le meme SFT avec 5 exemples casse la generation. La loss mesure la memorisation, la generation revele la generalisation.

Retour au sommet