import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import colors

print(f"gymnasium={gym.__version__}, numpy={np.__version__}")
gymnasium=1.3.0, numpy=2.4.6Serie : Reinforcement Learning | Notebook : 5/13 | Duree estimee : 45-50 min
Navigation : RL-1 Intro | RL-2 Wrappers | RL-3 HER | RL-5 | RL-6 DQN/PG | RL-7 Multi-Agent
A la fin de ce notebook, vous serez capable de : - Formaliser un problème d’apprentissage par renforcement comme un Processus de Decision Markovien (MDP) - Implementer l’Itération de Valeur (Value Itération) et l’Itération de Politique (Policy Itération) - Comprendre et implementer le Q-Learning tabulaire - Visualiser la convergence des algorithmes sur des environnements discrets
Rappels sur les concepts fondamentaux - Un MDP est défini par un tuple \((S, A, P, R, \gamma)\) ou \(S\) = etats, \(A\) = actions, \(P\) = transitions, \(R\) = recompenses, \(\gamma\) = facteur d’actualisation. - La fonction de valeur \(V(s)\) estime la recompense cumulee attendue depuis un etat \(s\). - La fonction Q-valeur \(Q(s, a)\) estime cette même recompense en choisissant l’action \(a\) dans l’etat \(s\). - Ces algorithmes travaillent directement sur des tableaux (pas de reseaux de neurones).
La sortie commitee fixe les versions de travail — gymnasium=1.3.0, numpy=2.4.6 — et c’est la seule cellule du notebook qui parle d’infrastructure : tout ce qui suit est de l’algorithmique sur des tables. Les re executions futures de ce notebook sous d’autres versions peuvent faire bouger les nombres tires du RNG (les graines sont fixees, mais les generateurs de Gymnasium et de NumPy evoluent) ; les lectures qui suivent citent les nombres committes, a confronter aux sorties fraiches le cas echeant.
import gymnasium as gym
import numpy as np
import matplotlib.pyplot as plt
from matplotlib import colors
print(f"gymnasium={gym.__version__}, numpy={np.__version__}")gymnasium=1.3.0, numpy=2.4.6Nous utiliserons deux environnements a espace d’etat discret :
Ces environnements sont ideals pour les méthodes tabulaires car leur espace d’etat est assez petit pour stocker une table Q complete.
Ces deux environnements ne sont pas interchangeables : ils portent chacun une moitie du notebook. FrozenLake est le banc model-based — env.unwrapped.P expose l’integralite du modele de transition, dont l’Iteration de Valeur et l’Iteration de Politique ont absolument besoin (leurs backups echantillonnent P en boucle). CliffWalking est le banc model-free — les algorithmes des sections 5 a 6quater n’ouvriront jamais P : ils apprennent uniquement des quintuplets (s, a, r, s', done) observes en jouant. Les structures de recompense s’opposent aussi : FrozenLake est sparse (+1 au but, 0 partout ailleurs — 15 cases muettes sur 16), CliffWalking est dense et punitif (-1 par pas, -100 pour une chute dans la falaise). Une methode qui ne marcherait que sur l’une de ces deux structures ne meriterait pas le nom de generale ; le notebook la fera passer par les deux.
Un MDP formalise l’interaction agent-environnement. La propriete de Markov stipule que le futur ne depend que de l’etat present, pas de l’historique.
Decomposons le FrozenLake pour comprendre la structure du MDP.
Ancres savantes РBellman, R. (1957), Dynamic Programming, Princeton University Press (equation de Bellman, it̩ration de valeur et de politique resolvent le MDP en point fixe) ; Watkins, C.J.C.H. (1989), Learning from Delayed Rewards, These de doctorat, Universite de Cambridge (Q-Learning tabulaire, m̩thode off-policy model-free qui converge vers Q sans connaitre le mod̬le de transition) ; Sutton, R.S. & Barto, A.G. (2018), Reinforcement Learning: An Introduction (2nd ed.), MIT Press (cadre formel du MDP \((S, A, P, R, \gamma)\), value/policy it̩ration, compromis exploration/exploitation).*
# Creer l'environnement FrozenLake (sans glissade pour rendre les transitions deterministes)
env = gym.make("FrozenLake-v1", is_slippery=False)

print(f"Espace d'etats  : {env.observation_space}")
print(f"Espace d'actions : {env.action_space}")
print(f"Nombre d'etats   : {env.observation_space.n}")
print(f"Nombre d'actions : {env.action_space.n}")
print(f"\nActions : 0=Gauche, 1=Bas, 2=Droite, 3=Haut")
Espace d'etats : Discrete(16)
Espace d'actions : Discrete(4)
Nombre d'etats : 16
Nombre d'actions : 4
Actions : 0=Gauche, 1=Bas, 2=Droite, 3=HautL’espace d’etat comporte 16 cases (grille 4x4) et l’espace d’action 4 directions. Chaque case est identifiee par un entier de 0 a 15.
Pour les méthodes tabulaires, nous avons besoin de connaitre les probabilites de transition \(P(s'|s, a)\). Gymnasium les expose via env.unwrapped.P (il faut acceder a l’environnement natif sous-jacent aux wrappers).
La sortie commitee donne la lecture brute : Discrete(16) pour les etats, Discrete(4) pour les actions, avec la semantique fixee par Gymnasium (0=Gauche, 1=Bas, 2=Droite, 3=Haut — la convention sera rappelee dans chaque affichage de politique). « Tabulaire » signifie exactement ceci : la valeur peut vivre dans une table indexee par les entiers (etat, action) — ici 16 x 4 = 64 entrees. Tant que cette table tient en memoire, aucune approximation n’est necessaire et toutes les garanties de convergence du TD tabulaire s’appliquent ; RL-6 montrera ce qui casse quand l’espace d’etat devient continu et que la table doit devenir un reseau.
# Explorer les transitions du MDP
# env.unwrapped.P[state][action] = [(probabilite, etat_suivant, recompense, terminal), ...]
print("Exemple de transition depuis l'etat 0, action 'Droite' (2) :")
print(env.unwrapped.P[0][2])

print("\nExemple de transition depuis l'etat 1, action 'Bas' (1) :")
print(env.unwrapped.P[1][1])

print("\nGrille du FrozenLake (S=Start, F=Glace, H=Trou, G=But) :")
print("S F F F")
print("F H F H")
print("F F F H")
print("H F F G")
Exemple de transition depuis l'etat 0, action 'Droite' (2) :
[(1.0, 1, 0, False)]
Exemple de transition depuis l'etat 1, action 'Bas' (1) :
[(1.0, 5, 0, True)]
Grille du FrozenLake (S=Start, F=Glace, H=Trou, G=But) :
S F F F
F H F H
F F F H
H F F GChaque transition est un tuple (probabilite, etat_suivant, recompense, est_terminal). En mode non-glissant (is_slippery=False), chaque action a une probabilite de 1.0 de reussir.
En mode glissant (par defaut), l’action peut echouer et mener dans une direction adjacente, rendant le problème stochastique.
Les deux exemples committes meritent une lecture lente. Depuis l’etat 0 (le depart S), action Droite : [(1.0, 1, 0, False)] — probabilite 1, etat 1, recompense 0, non terminal : un deplacement deterministe banal. Depuis l’etat 1, action Bas : [(1.0, 5, 0, True)] — l’etat 5 est un trou (deuxieme ligne de la grille, case H), et le drapeau True dit que l’episode s’y termine. Un seul mauvais pas depuis la case voisine du depart tue l’episode avec une recompense nulle : c’est ce qui rend certaines actions interdites en pratique et donne son relief a la fonction de valeur. En mode glissant (is_slippery=True, l’exercice 1), chacune de ces listes singleton deviendrait une liste de trois issues possibles et la certitude disparaitrait.
L’Itération de Valeur resout le MDP en appliquant iterativement l’equation de Bellman :
\[V(s) = \max_a \sum_{s'} P(s'|s,a) \left[ R(s,a,s') + \gamma V(s') \right]\]
L’algorithme met a jour \(V(s)\) pour chaque etat jusqu’a convergence. La politique optimale est ensuite obtenue en choisissant l’action qui maximise \(V\) dans chaque etat.
def value_iteration(env, gamma=0.99, theta=1e-8, max_iterations=1000):
    """
    Iteration de Valeur pour resoudre un MDP.

    Parametres :
        env : environnement Gymnasium avec attribut P
        gamma : facteur d'actualisation (0 < gamma < 1)
        theta : seuil de convergence
        max_iterations : nombre maximal d'iterations

    Retourne :
        V : fonction de valeur optimale
        policy : politique optimale (greedy par rapport a V)
        deltas : historique des deltas max pour suivi de convergence
    """
    nS = env.observation_space.n
    nA = env.action_space.n
    V = np.zeros(nS)
    deltas = []
    P = env.unwrapped.P

    for i in range(max_iterations):
        delta = 0
        for s in range(nS):
            v = V[s]
            q_values = np.zeros(nA)
            for a in range(nA):
                for prob, next_s, reward, done in P[s][a]:
                    q_values[a] += prob * (reward + gamma * V[next_s] * (1 - done))
            V[s] = np.max(q_values)
            delta = max(delta, abs(v - V[s]))

        deltas.append(delta)
        if delta < theta:
            print(f"Convergence a l'iteration {i+1} (delta={delta:.2e})")
            break

    # Extraire la politique greedy
    policy = np.zeros(nS, dtype=int)
    for s in range(nS):
        q_values = np.zeros(nA)
        for a in range(nA):
            for prob, next_s, reward, done in P[s][a]:
                q_values[a] += prob * (reward + gamma * V[next_s] * (1 - done))
        policy[s] = np.argmax(q_values)

    return V, policy, deltas
print("Fonction value_iteration definie")
Fonction value_iteration definieL’anatomie de la fonction qui vient d’etre definie, avant de la lancer. Chaque balayage parcourt tous les etats et recalcule V[s] comme le maximum sur les actions de la somme des transitions P[s][a] de recompense + gamma * V[next_s] * (1 - done) — l’application litterale de l’equation d’optimalite de Bellman. Trois details de conception se lisent dans le code :
V[s] est ecrase pendant le balayage) : les etats tardifs de la boucle lisent les valeurs deja recalculees des etats precedents — variante dite de Gauss-Seidel, qui converge generalement en moins d’iterations qu’une version synchrone (copie fraiche lue en entier), au prix d’un ordre de parcours qui influe le chemin exact.(1 - done) est la facon tabulaire d’annuler le futur des etats terminaux : la transition qui mene au but (done=True) contribue sa recompense mais pas de valeur d’arrivee — c’est ce qui rend les trous exactement nuls dans la table finale.argmax sur la table V convergee.# Resoudre FrozenLake par Iteration de Valeur
V_vi, policy_vi, deltas_vi = value_iteration(env, gamma=0.99)
print("\nFonction de valeur V*(s) :")
print(V_vi.reshape(4, 4).round(3))
print(f"\nPolitique optimale (0=G, 1=B, 2=D, 3=H) :")
print(policy_vi.reshape(4, 4))Convergence a l'iteration 7 (delta=0.00e+00)
Fonction de valeur V*(s) :
[[0.951 0.961 0.97 0.961]
[0.961 0. 0.98 0. ]
[0.97 0.98 0.99 0. ]
[0. 0.99 1. 0. ]]
Politique optimale (0=G, 1=B, 2=D, 3=H) :
[[1 2 1 0]
[1 0 1 0]
[2 1 1 0]
[0 2 2 0]]La fonction de valeur \(V^*\) attribue des valeurs croissantes aux etats proches du but (case 15). Les etats terminaux (trous) ont une valeur de 0.
La politique greedy correspondante indique la direction optimale a suivre depuis chaque case pour atteindre le but.
L’arithmetique du decalage se verifie sur la table commitee. La trajectoire optimale depuis le depart fait six deplacements ; la recompense +1 n’arrive qu’au dernier, si bien que \(V^*(0) = \gamma^5 \times 1 = 0{,}99^5 = 0{,}951\) — exactement la valeur affichee. Les etats terminaux (trous) valent 0 : un etat sans futur n’a d’autre valeur que sa recompense de fin (nulle pour une chute). Les cases 13 et 14 (0,99 et 1,0) forment le corridor d’arrivee, les cases 8 a 10 (0,97-0,99) l’approche par le milieu — le gradient de valeur dessine la topologie du lac, et la politique greedy ne fait que suivre la ligne de plus grande pente de cette table.
def visualize_policy(env, policy, title="Politique"):
    """Affiche la politique sur la grille du FrozenLake."""
    if hasattr(env, 'unwrapped'):
        desc = env.unwrapped.desc.astype(str)
    else:
        desc = np.array([['S','F','F','F'],['F','H','F','H'],
                         ['F','F','F','H'],['H','F','F','G']])

    arrows = {0: '<', 1: 'v', 2: '>', 3: '^'}
    n = int(np.sqrt(len(policy)))

    fig, ax = plt.subplots(1, 1, figsize=(6, 6))

    # Couleurs de fond selon le type de case
    color_map = {'S': '#90EE90', 'F': '#E0F0FF', 'H': '#FFB0B0', 'G': '#FFD700'}
    for i in range(n):
        for j in range(n):
            s = i * n + j
            cell = desc[i][j]
            ax.add_patch(plt.Rectangle((j, n-1-i), 1, 1,
                         facecolor=color_map.get(cell, 'white'), edgecolor='black'))
            if cell not in ('H', 'G'):
                ax.text(j + 0.5, n - 1 - i + 0.5, arrows[policy[s]],
                       ha='center', va='center', fontsize=20, fontweight='bold')
            else:
                ax.text(j + 0.5, n - 1 - i + 0.5, cell,
                       ha='center', va='center', fontsize=16)

    ax.set_xlim(0, n)
    ax.set_ylim(0, n)
    ax.set_title(title)
    ax.set_aspect('equal')
    ax.axis('off')
    plt.tight_layout()
    plt.show()

visualize_policy(env, policy_vi, "Politique optimale - Value Iteration")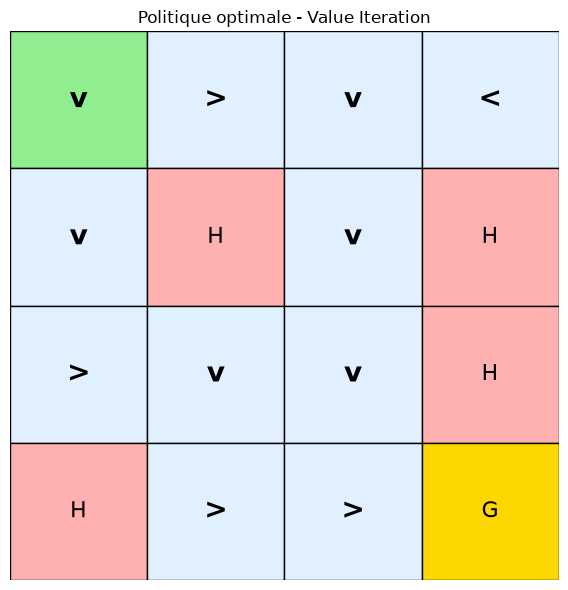
La visualisation confirme ce que laissait entrevoir la table \(V^*\) : la politique optimale trace un chemin en zigzag qui évite systématiquement les trous (cases rouges H) pour rejoindre le but (case dorée G, état 15). Chaque flèche est l’action greedy dérivée de \(V^*\) — l’agent descend vers la dernière ligne (où \(V^*\) grimpe de \(0.97\) à \(0.99\) puis \(1.0\)) puis file vers la droite. Les cases terminales (H, G) ne portent pas de flèche car aucune action n’y est définie.
Vérifions maintenant que l’algorithme a effectivement convergé en examinant la vitesse de décroissance du résidu \(\delta\) entre deux itérations.
# Courbe de convergence
plt.figure(figsize=(8, 4))
plt.semilogy(deltas_vi, linewidth=2)
plt.xlabel("Iteration")
plt.ylabel("Delta max (echelle log)")
plt.title("Convergence de l'Iteration de Valeur")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()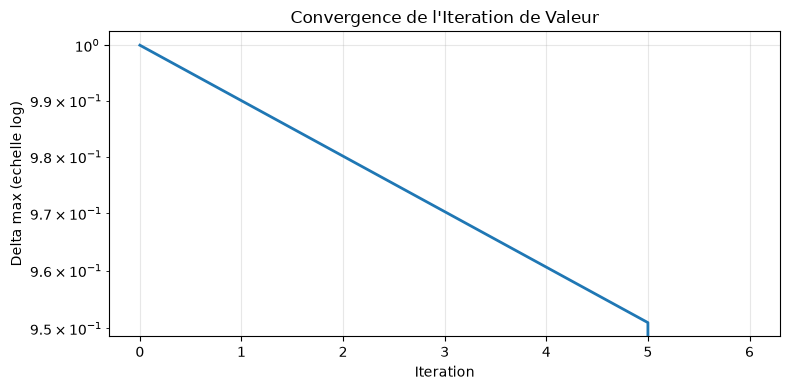
La courbe de convergence montre une diminution exponentielle du delta maximum. En quelques itérations, les valeurs se stabilisent et l’algorithme converge vers l’unique point fixe de l’equation de Bellman.
Le chiffre final merite l’arret : delta = 0,00e+00 a l’iteration 7 — une convergence exacte, pas approchee. La raison est topologique : chaque balayage combine les valeurs des voisines d’une case, donc une information de valeur se propage d’au plus une case par iteration ; la trajectoire optimale de ce lac fait six deplacements, et au septieme balayage plus aucune valeur ne peut bouger. Le seuil theta = 1e-8 n’a meme pas eu a trancher : le point fixe de l’equation de Bellman est atteint avant que le critere d’arret ne s’exprime. Sur un environnement stochastique ou glissant, la propagation resterait geometrique mais le delta ne serait plus jamais exactement nul — d’ou le role habituel de theta, qui coupe la descente a epsilon pres.
L’Itération de Politique alterne entre deux étapes :
Contrairement a Value Itération qui met a jour les valeurs de maniere asynchrone, Policy Itération resout exactement le système lineaire a chaque étape.
def policy_iteration(env, gamma=0.99, theta=1e-8, max_iterations=100):
    """
    Iteration de Politique pour resoudre un MDP.

    Parametres :
        env : environnement Gymnasium avec attribut P
        gamma : facteur d'actualisation
        theta : seuil de convergence pour l'evaluation
        max_iterations : nombre maximal d'iterations externes

    Retourne :
        V : fonction de valeur optimale
        policy : politique optimale
        policy_changes : nombre de changements par iteration
    """
    nS = env.observation_space.n
    nA = env.action_space.n
    policy = np.zeros(nS, dtype=int)
    policy_changes = []
    P = env.unwrapped.P

    for iteration in range(max_iterations):
        # Etape 1 : Evaluation de la politique
        V = np.zeros(nS)
        for _ in range(1000):
            delta = 0
            for s in range(nS):
                v = V[s]
                a = policy[s]
                V[s] = sum(prob * (reward + gamma * V[next_s] * (1 - done))
                           for prob, next_s, reward, done in P[s][a])
                delta = max(delta, abs(v - V[s]))
            if delta < theta:
                break

        # Etape 2 : Amelioration de la politique
        policy_stable = True
        changes = 0
        for s in range(nS):
            old_action = policy[s]
            q_values = np.zeros(nA)
            for a in range(nA):
                for prob, next_s, reward, done in P[s][a]:
                    q_values[a] += prob * (reward + gamma * V[next_s] * (1 - done))
            policy[s] = np.argmax(q_values)
            if old_action != policy[s]:
                policy_stable = True
                changes += 1

        policy_changes.append(changes)

        if changes == 0:
            print(f"Politique stable atteinte a l'iteration {iteration+1}")
            break

    return V, policy, policy_changes

V_pi, policy_pi, changes_pi = policy_iteration(env, gamma=0.99)
print(f"\nV(pi) converge vers V* ? {np.allclose(V_vi, V_pi, atol=1e-6)}")
print(f"Politiques identiques ? {np.array_equal(policy_vi, policy_pi)}")
Politique stable atteinte a l'iteration 7
V(pi) converge vers V* ? True
Politiques identiques ? TruePolicy Itération converge en peu d’itérations (ici 7 sur ce FrozenLake déterministe à 16 états — comme l’Itération de Valeur, qui converge elle aussi en 7 pas). Les deux méthodes aboutissent à la même politique optimale, comme garanti par la théorie.
Les deux True committes (V(π) converge vers V*, politiques identiques) disent que l’Iteration de Politique a trouve le meme optimum que l’Iteration de Valeur — la theorie le garantit sur un MDP fini, le banc le verifie numeriquement. La difference n’est pas dans le resultat mais dans le travail par iteration : l’Iteration de Politique resout completement l’evaluation de sa politique courante (boucle interne jusqu’a convergence) avant de faire un seul pas d’amelioration, quand l’Iteration de Valeur entrelace les deux a chaque balayage. Sur 16 etats, les deux coutent des millisecondes ; la difference devient structurale sur de grands espaces ou l’evaluation exacte est inabordable — c’est exactement le pont vers les methodes model-free qui ouvrent la section 5.
Les méthodes précédentes supposent la connaissance complete du modèle de transition \(P\). Le Q-Learning est une méthode model-free : elle apprend uniquement par interaction avec l’environnement.
La règle de mise a jour est :
\[Q(s, a) \leftarrow Q(s, a) + \alpha \left[ r + \gamma \max_{a'} Q(s', a') - Q(s, a) \right]\]
ou \(\alpha\) est le taux d’apprentissage.
Stratégie d’exploration : Nous utilisons \(\varepsilon\)-greedy, qui choisit une action aleatoire avec probabilite \(\varepsilon\) et l’action greedy sinon.
La règle de mise à jour du Q-Learning est souvent avalée comme une formule :
\[Q(s, a) \leftarrow Q(s, a) + \alpha \left[ r + \gamma \max_{a'} Q(s', a') - Q(s, a) \right]\]
Avant de lancer la boucle d’entraînement, décomposons-la une seule fois, sur une transition connue du FrozenLake, pour voir chaque composante : la récompense \(r\), la valeur du futur \(\gamma \max_{a'} Q(s',a')\), l’erreur TD, et le déplacement de \(Q\). C’est l’atome du Q-Learning — tout le reste en découle.
# L'atome du Q-Learning : une seule mise a jour, decortiquee
alpha = 0.1
gamma = 0.99

# On prend la transition qui mene AU BUT (etat 15), depuis l'etat 14 en allant a droite.
# P[14][2] = [(1.0, 15, 1, True)] : probabilite 1, etat suivant 15, recompense 1, TERMINAL.
s, a = 14, 2
prob, s_next, r, done = env.unwrapped.P[s][a][0]
print(f"Transition choisie : P[{s}][{a}] = [(prob={prob}, s'={s_next}, r={r}, done={done})]")
print(f"  -> depuis la case {s} (ligne 3, colonne 2), 'Droite' mene au but {s_next},")
print(f"     avec une recompense terminale r={r} (done={done}).")

# Table Q vierge : on n'a encore rien appris.
Q = np.zeros((16, 4))

q_before = Q[s, a]                       # Q(s, a) AVANT l'update
best_next = np.max(Q[s_next])            # max_{a'} Q(s', a')
td_target = r + gamma * best_next * (1 - done)
td_error = td_target - q_before
q_after = q_before + alpha * td_error    # Q(s, a) APRES

print(f"\n--- Deroule de la mise a jour ---")
print(f"Q({s},{a}) AVANT   = {q_before}")
print(f"max_{{a'}} Q({s_next}, a') = {best_next:.4f}")
print(f"terme terminal (1 - done) = {1 - done}   # s' est terminal -> le terme de futur s'annule")
print(f"TD target        = r + gamma*maxQ(s')*(1-done) = {r} + {gamma}*{best_next:.4f}*{1-done} = {td_target:.4f}")
print(f"TD error         = TD target - Q(s,a) = {td_target:.4f} - {q_before:.4f} = {td_error:.4f}")
print(f"Q({s},{a}) APRES = Q avant + alpha*TD error = {q_before:.4f} + {alpha}*{td_error:.4f} = {q_after:.4f}")

# Variante contraction : repeter la meme update sur la transition qui mene au but.
# Ici le futur est terminal donc gamma*maxQ(s')=0 : la cible est la recompense r=1 elle-meme.
print(f"\n--- Contraction : 10 updates successives sur la meme transition ---")
Q2 = np.zeros((16, 4))
seq = []
for _ in range(10):
    Q2[s, a] += alpha * (r + gamma * np.max(Q2[s_next]) * (1 - done) - Q2[s, a])
    seq.append(Q2[s, a])
print(f"Q({s},{a}) apres 10 updates : " + " -> ".join(f"{v:.4f}" for v in seq))
print("=> Q converge asymptotiquement vers la cible r = 1.0, sans jamais l'atteindre :")
print("   c'est une contraction geometrique de raison (1 - alpha) = 0.9.")
Transition choisie : P[14][2] = [(prob=1.0, s'=15, r=1, done=True)]
-> depuis la case 14 (ligne 3, colonne 2), 'Droite' mene au but 15,
avec une recompense terminale r=1 (done=True).
--- Deroule de la mise a jour ---
Q(14,2) AVANT = 0.0
max_{a'} Q(15, a') = 0.0000
terme terminal (1 - done) = 0 # s' est terminal -> le terme de futur s'annule
TD target = r + gamma*maxQ(s')*(1-done) = 1 + 0.99*0.0000*0 = 1.0000
TD error = TD target - Q(s,a) = 1.0000 - 0.0000 = 1.0000
Q(14,2) APRES = Q avant + alpha*TD error = 0.0000 + 0.1*1.0000 = 0.1000
--- Contraction : 10 updates successives sur la meme transition ---
Q(14,2) apres 10 updates : 0.1000 -> 0.1900 -> 0.2710 -> 0.3439 -> 0.4095 -> 0.4686 -> 0.5217 -> 0.5695 -> 0.6126 -> 0.6513
=> Q converge asymptotiquement vers la cible r = 1.0, sans jamais l'atteindre :
c'est une contraction geometrique de raison (1 - alpha) = 0.9.Du atome à la boucle. Cette unique mise à jour ne change presque rien : Q(14,2) passe de 0 à 0.1. C’est normal — un seul pas d’information. La boucle d’entraînement ci-dessous répète cet atome à chaque pas de chaque épisode : à chaque transition rencontrée, la valeur ajustée se propage un peu plus loin, et la valeur du futur (le terme \(\gamma \max_{a'} Q(s',a')\)) devient non nulle dès que les états voisins sont eux-mêmes valorisés. C’est ce qui fait converger la table \(Q\) vers \(Q^*\) sans connaître le modèle de transition.
La contraction commitee est le coeur pedagogique de cette cellule : en dix mises a jour sur la meme transition, Q(14,2) monte de 0,1 a 0,6513 par pas successifs 0,1 -> 0,19 -> 0,271 -> … Chaque update deplace Q d’une fraction alpha de l’erreur residuelle, donc l’ecart a la cible est multiplie par (1 - alpha) = 0,9 a chaque pas : apres dix updates il ne vaut plus que 0,9^10 = 0,35 de l’erreur initiale, apres cent il serait negligeable. Q converge asymptotiquement vers r = 1 sans jamais l’atteindre exactement — c’est le compromis de la descente stochastique a taux constant : la stabilite (chaque erreur partielle corrigee) contre la convergence exacte (qui exigerait un alpha decroissant). La boucle complete qui suit ne fait que repeter cet atome sur des transitions variees.
def epsilon_greedy(Q, state, epsilon, n_actions):
    """Choisit une action selon la strategie epsilon-greedy."""
    if np.random.random() < epsilon:
        return np.random.randint(n_actions)
    return np.argmax(Q[state])


def q_learning(env, num_episodes=10000, alpha=0.1, gamma=0.99,
               epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.9995,
               max_steps=500):
    """
    Q-Learning tabulaire.

    Parametres :
        env : environnement Gymnasium
        num_episodes : nombre d'episodes d'entrainement
        alpha : taux d'apprentissage
        gamma : facteur d'actualisation
        epsilon_start, epsilon_end, epsilon_decay : parametres de decay d'epsilon
        max_steps : nombre maximal de pas par episode (garde de securite contre
                    les politiques intermediaires qui cyclent sans terminer ;
                    le chemin optimal en fait une trentaine, la marge est large)

    Retourne :
        Q : table Q apprise
        rewards : recompenses par episode
    """
    nS = env.observation_space.n
    nA = env.action_space.n
    Q = np.zeros((nS, nA))
    rewards = []
    epsilon = epsilon_start

    for ep in range(num_episodes):
        state, _ = env.reset()
        total_reward = 0
        done = False
        step = 0

        while not done and step < max_steps:
            step += 1
            action = epsilon_greedy(Q, state, epsilon, nA)
            next_state, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated

            # Mise a jour Q-Learning
            best_next = np.max(Q[next_state])
            td_target = reward + gamma * best_next * (1 - terminated)
            Q[state, action] += alpha * (td_target - Q[state, action])

            state = next_state
            total_reward += reward

        epsilon = max(epsilon_end, epsilon * epsilon_decay)
        rewards.append(total_reward)

    return Q, rewards


# Graine fixee pour rendre l apprentissage Q-Learning reproductible (la cellule precedent
# defini env = FrozenLake-v1 is_slippery=False, deterministe ; la stochasticite residuelle
# vient uniquement d epsilon-greedy via np.random).
np.random.seed(42)
Q_ql, rewards_ql = q_learning(env, num_episodes=5000)
policy_ql = np.argmax(Q_ql, axis=1)

print(f"Recompense moyenne (1000 derniers episodes) : {np.mean(rewards_ql[-1000:]):.3f}")
print(f"Politique Q-Learning :\n{policy_ql.reshape(4,4)}")
print(f"\nCorrespond a la politique optimale ? {np.array_equal(policy_vi, policy_ql)}")
Recompense moyenne (1000 derniers episodes) : 0.892
Politique Q-Learning :
[[1 2 1 0]
[1 0 1 0]
[2 1 1 0]
[0 2 2 0]]
Correspond a la politique optimale ? TrueLe Q-Learning converge vers la politique optimale même sans connaitre le modèle de transition. L’exploration decroissante (\(\varepsilon\) passe de 1.0 a 0.01) permet de visiter suffisamment d’etats au debut, puis d’exploiter la politique apprise.
La nuance chiffee : 0,892 de recompense moyenne sur les 1000 derniers episodes, alors que \(V^*(\text{depart}) = 0{,}951\). Ce n’est pas un defaut d’apprentissage — la politique extraite est l’optimale, verifiee cellule contre cellule contre le resultat de l’Iteration de Valeur — mais un effet du protocole de mesure : la recompense mesuree est celle du comportement, encore ε-greedy avec ε ramene a 0,01. Environ 1 % des actions sont aleatoires ; certaines font tomber l’agent dans un trou et annulent la recompense de tout l’episode. La table Q est optimale ; la trajectoire executee, elle, continue d’explorer. Mesurer la politique greedy seule — ce que fera la section 6 sur CliffWalking — retirerait exactement cet ecart.
# Courbe d'apprentissage (moyenne mobile)
window = 500
moving_avg = np.convolve(rewards_ql, np.ones(window)/window, mode='valid')

plt.figure(figsize=(10, 4))
plt.plot(moving_avg, linewidth=2)
plt.xlabel("Episode")
plt.ylabel(f"Recompense moyenne (fenetre={window})")
plt.title("Convergence du Q-Learning sur FrozenLake")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()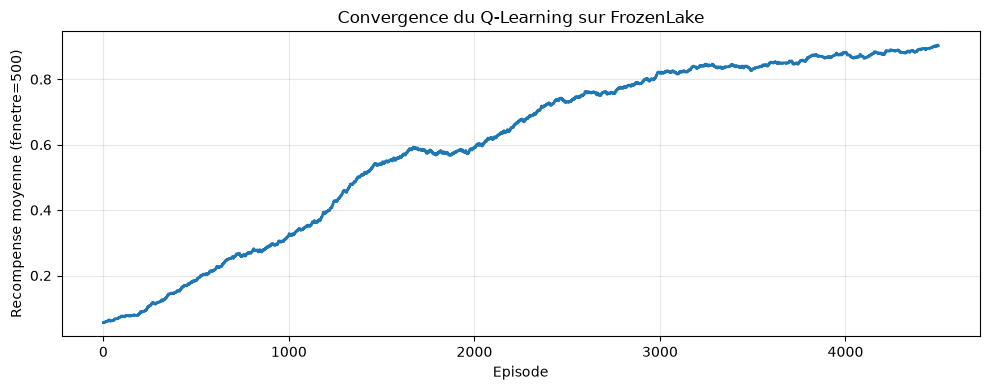
La courbe montre la transition entre exploration (recompenses faibles et irregulieres au debut) et exploitation. La recompense moyenne se stabilise autour de ~0.89 (0.892 ici, avec la graine fixee a 42) sans atteindre 1.0 : l environnement est deterministe (is_slippery=False, cf cellule de creation de env), mais la strategie epsilon-greedy conserve environ 1% d actions aleatoires en fin d apprentissage (epsilon decroit jusqu a 0.01), et ces actions aleatoires font parfois tomber l agent dans un trou. Le point vraiment verificable et reproductible est la convergence vers la politique optimale : avec cette graine, la politique apprise correspond a la politique optimale calculee par iteration de valeur (sortie cellule precedente : « Correspond a la politique optimale ? True »).
Cette courbe est la premiere ou le temps d’apprentissage apparait : les iterations precedentes (Valeur, Politique) balayaient un modele deja connu, ici la connaissance s’accumule episode apres episode. Le regime transitoire des premiers milliers d’episodes (recompenses faibles, irregulieres) correspond a ε eleve : l’agent marche au hasard, tombe dans les trous, et chaque episode echoue. La montee ensuite n’est pas un changement d’algorithme mais l’effet combine de la decroissance d’ε (0,999 par episode : ε passe sous 0,1 vers l’episode 2300) et de la table Q qui a vu assez de transitions pour que la politique greedy devienne correcte partout. La moyenne mobile sur 1000 episodes lisse la variance d’echantillonnage — la recompense brute d’un episode reste binaire (1 ou 0) sur ce environnement.
La boucle apprend avec une table \(Q\) initialement nulle. Deux hyperparamètres gouvernent la mise à jour : \(\alpha\) (le taux d’apprentissage) et \(\gamma\) (le facteur d’actualisation). On balaie chacun en gardant l’autre fixe, sur le même gridworld, à même nombre d’épisodes et à même graine (42) — pour que la seule différence entre deux courbes soit le paramètre étudié.
# --- Sweep alpha : on ne change QUE le taux d'apprentissage ---
alphas = [0.01, 0.1, 0.5, 0.9]
n_episodes = 3000
window = 200

curves_alpha = {}
mean_alpha = {}
for al in alphas:
    np.random.seed(42)                     # meme graine : difference imputable a alpha seul
    _, rewards = q_learning(env, num_episodes=n_episodes, alpha=al)
    mean_alpha[al] = np.mean(rewards[-1000:])
    curves_alpha[al] = np.convolve(rewards, np.ones(window)/window, mode='valid')

plt.figure(figsize=(10, 4))
for al in alphas:
    plt.plot(curves_alpha[al], label=f"alpha={al}", linewidth=1.8)
plt.xlabel("Episode")
plt.ylabel(f"Recompense moyenne (fenetre={window})")
plt.title(f"Sweep alpha sur FrozenLake ({n_episodes} episodes, graine 42)")
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

print("Verdict du sweep alpha (recompense moyenne des 1000 derniers episodes) :")
for al in alphas:
    print(f"  alpha={al} : {mean_alpha[al]:.4f}")
Verdict du sweep alpha (recompense moyenne des 1000 derniers episodes) :
  alpha=0.01 : 0.6660
  alpha=0.1 : 0.6610
  alpha=0.5 : 0.6670
  alpha=0.9 : 0.6660
Verdict honnête : sur ce gridworld trivial, alpha n’a pas d’effet visible. Les quatre courbes se superposent presque parfaitement et les quatre récompenses moyennes (imprimées ci-dessus) tournent autour de 0.66, en aboutissant toutes à la même politique optimale — celle déjà retrouvée par l’itération de valeur (« Correspond a la politique optimale ? True », plus haut). Contrairement au folklore « alpha trop grand = instable », on ne voit ici ni divergence ni convergence ralentie.
Pourquoi ? (1) Les récompenses sont bornées (0 ou 1) : l’update reste une combinaison convexe de la valeur courante vers une cible bornée, donc chaque \(Q(s,a)\) reste dans \([0,1]\) — aucun alpha ne peut « diverger » sur un tel MDP. (2) Le bruit d’exploration \(\varepsilon\)-greedy (\(\varepsilon \to 0.01\)) domine largement l’écart entre alphas une fois la politique atteinte.
La leçon : l’effet d’alpha n’est pas universel, il dépend du problème. Sur un MDP trivial il est masqué ; il redevient décisif là où l’échelle de la mise à jour compte (récompenses non bornées, états visités rarement, ou RL-6 où l’optimiseur règle un taux d’apprentissage équivalent). L’Exercice 4 vous laisse le vérifier vous-même (grid search alpha × gamma), et l’Exercice 2 d’en tester la portée sur un environnement plus riche.
# --- Sweep gamma : on ne change QUE le facteur d'actualisation ---
gammas = [0.0, 0.3, 0.99]   # 0 = agent totalement myope, 0.99 = agent patient
n_episodes = 3000

curves_gamma = {}
mean_gamma = {}
policy_gamma = {}
for ga in gammas:
    np.random.seed(42)
    Q, rewards = q_learning(env, num_episodes=n_episodes, alpha=0.1, gamma=ga)
    mean_gamma[ga] = np.mean(rewards[-1000:])
    policy_gamma[ga] = np.argmax(Q, axis=1)
    curves_gamma[ga] = np.convolve(rewards, np.ones(200)/200, mode='valid')

plt.figure(figsize=(10, 4))
for ga in gammas:
    plt.plot(curves_gamma[ga], label=f"gamma={ga}", linewidth=1.8)
plt.xlabel("Episode")
plt.ylabel("Recompense moyenne (fenetre=200)")
plt.title("Sweep gamma sur FrozenLake (3000 episodes, graine 42)")
plt.legend()
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()

print("Verdict du sweep gamma (recompense moyenne des 1000 derniers episodes) :")
for ga in gammas:
    print(f"  gamma={ga} : {mean_gamma[ga]:.4f}")
print("\nPolitique greedy finale (premiere ligne = etats 0 a 3) :")
for ga in gammas:
    print(f"  gamma={ga} : {policy_gamma[ga][:4].tolist()}")
print("\n(0=Gauche, 1=Bas, 2=Droite, 3=Haut ; etat 0 = case de depart 'S')")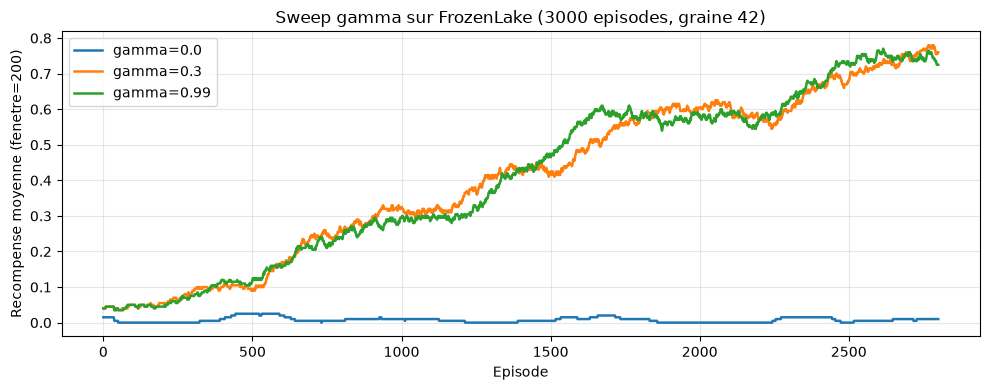
Verdict du sweep gamma (recompense moyenne des 1000 derniers episodes) :
  gamma=0.0 : 0.0060
  gamma=0.3 : 0.6660
  gamma=0.99 : 0.6610

Politique greedy finale (premiere ligne = etats 0 a 3) :
  gamma=0.0 : [0, 0, 0, 0]
  gamma=0.3 : [1, 2, 1, 0]
  gamma=0.99 : [1, 2, 1, 0]

(0=Gauche, 1=Bas, 2=Droite, 3=Haut ; etat 0 = case de depart 'S')
Verdict : gamma est ce qui « rend » l’agent — ou le condamne. Avec \(\gamma = 0\) (agent totalement myope), le TD target se réduit à la récompense immédiate \(r\) : le terme de futur \(\gamma \max_{a'} Q(s',a')\) s’annule. Or sur FrozenLake toutes les récompenses immédiates valent 0 sauf au but, donc l’agent n’apprend rien (moyenne ≈ 0.006, politique [0, 0, 0, 0] = toujours « Gauche », il n’a jamais atteint le but). Avec \(\gamma = 0.3\), l’agent valorise déjà assez le futur — le but n’est qu’à 3-4 pas — et atteint le but avec la même récompense moyenne (≈ 0.66) que l’agent patient. Avec \(\gamma = 0.99\) (patient), même résultat.
La leçon : sur un gridworld aussi court, même un \(\gamma\) modeste suffit. La myopie totale (\(\gamma = 0\)) est le vrai cas pathologique, pas les valeurs intermédiaires. C’est sur les tâches à horizon long (récompense au bout d’une longue séquence) que le choix de \(\gamma\) devient critique, et qu’un \(\gamma\) trop petit fait rater l’objectif.
L’environnement CliffWalking illustre un problème classique en RL : le compromis exploration/exploitation. L’agent doit longer une falaise pour atteindre la sortie :
Q-Learning etant un algorithme off-policy, il devrait decouvrir le chemin optimal.
# Environnement CliffWalking
env_cliff = gym.make("CliffWalking-v1")
print(f"Espace d'etats   : {env_cliff.observation_space.n} cases (grille 4x12)")
print(f"Espace d'actions : {env_cliff.action_space.n} directions")
print(f"\nDisposition : le joueur commence en bas a gauche (3,0),")
print(f"le but est en bas a droite (3,11). La falaise est sur la ligne du bas (3,1 a 3,10).")
Espace d'etats : 48 cases (grille 4x12)
Espace d'actions : 4 directions
Disposition : le joueur commence en bas a gauche (3,0),
le but est en bas a droite (3,11). La falaise est sur la ligne du bas (3,1 a 3,10).La structure de CliffWalking est redoutable pour un agent : 48 états (grille 4×12), une falaise mortelle qui barre toute la ligne du bas entre le départ S et le but G. Chaque pas coûte \(-1\) (l’agent est incité à être bref), mais tomber dans la falaise coûte \(-100\) et renvoie immédiatement au départ. Le compromis est donc le suivant : longer la falaise (chemin court, risque maximal) ou passer par le haut (chemin sûr, mais plus de pas négatifs).
Lançons maintenant le Q-Learning sur 10 000 épisodes et évaluons la politique greedy obtenue — c’est ici que le caractère off-policy du Q-Learning devrait lui permettre de découvrir le chemin optimal le long de la falaise, même si l’exploration \(\varepsilon\)-greedy prend parfois des actions sous-optimales en cours d’apprentissage.
La geometrie commitee dit tout : depart en bas a gauche (3,0), but en bas a droite (3,11), et toute la ligne du bas entre eux est la falaise (3,1 a 3,10). Deux familles de chemins existent : remonter d’une ligne, traverser en surete, redescendre au but — long mais sans risque ; ou rester sur la ligne du bas et longer la falaise sur 10 cases — court, mais chaque pas cote a cote du gouffre. Avec la recompense -1 par pas et -100 par chute, le chemin du bord vale -13 et le chemin sur vaut environ -17 (15 pas surs, chiffres a l’appui dans les cellules qui suivent) : l’optimum sans risque d’exploration est le chemin du bord, mais cet optimum ne dit rien de ce que vaut ce bord pour un agent qui se trompe encore 1 fois sur 100. Toute la suite de la section 6 est la confrontation de ces deux lectures.
# Entrainer Q-Learning sur CliffWalking
Q_cliff, rewards_cliff = q_learning(
    env_cliff,
    num_episodes=10000,
    alpha=0.1,
    gamma=0.99,
    epsilon_start=1.0,
    epsilon_end=0.01,
    epsilon_decay=0.999
)

# Evaluer la politique apprise
def evaluate_policy_greedy(env, Q, num_episodes=1000, max_steps=500):
    """Evalue une politique greedy derivee de la table Q.

    Le parametre max_steps protege contre une politique qui terminerait mal
    (boucle sans fin) ; avec une politique convergee le chemin tient en une
    trentaine de pas, le plafond n'est jamais atteint.
    """
    total_rewards = []
    for _ in range(num_episodes):
        state, _ = env.reset()
        episode_reward = 0
        done = False
        step = 0
        while not done and step < max_steps:
            step += 1
            action = np.argmax(Q[state])
            state, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            episode_reward += reward
        total_rewards.append(episode_reward)
    return np.mean(total_rewards), np.std(total_rewards)

mean_r, std_r = evaluate_policy_greedy(env_cliff, Q_cliff)
print(f"Recompense moyenne (policy greedy) : {mean_r:.1f} +/- {std_r:.1f}")
print(f"(Le chemin optimal a une recompense de -13)")
Recompense moyenne (policy greedy) : -13.0 +/- 0.0
(Le chemin optimal a une recompense de -13)Le Q-Learning decouvre le chemin optimal le long de la falaise (recompense proche de -13). C’est un résultat caractéristique de Q-Learning : en tant qu’algorithme off-policy, il apprend la politique optimale même si l’exploration utilise des actions sous-optimales.
Le ±0,0 committ est lui-meme une information : l’evaluation est deterministe (environnement deterministe + politique greedy), donc l’ecart-type sur plusieurs episodes d’evaluation est exactement nul — toute la variance qui apparaitra dans les ablations suivantes sera entierement du cote de l’apprentissage (graines), jamais du cote de la mesure. Et -13,0 est la recompense du chemin optimal : 13 deplacements a -1 (monter d’une ligne, traverser, redescendre), aucune chute a -100. Le Q-Learning n’a pas seulement converge vers une bonne politique — il a trouve exactement la trajectoire de longueur minimale.
# Visualiser la trajectoire apprise sur CliffWalking
def show_cliff_trajectory(env, Q):
    """Affiche une trajectoire greedy sur la grille CliffWalking."""
    state, _ = env.reset()
    path = [state]
    done = False
    while not done:
        action = np.argmax(Q[state])
        state, _, terminated, truncated, _ = env.step(action)
        done = terminated or truncated
        path.append(state)

    grid = np.full((4, 12), ' ')
    # Falaise
    for j in range(1, 11):
        grid[3, j] = 'C'
    grid[3, 0] = 'S'
    grid[3, 11] = 'G'

    # Trajectoire
    for s in path:
        r, c = divmod(s, 12)
        if grid[r, c] in (' ', ):
            grid[r, c] = '*'

    print("Trajectoire apprise (* = chemin, C = falaise, S = depart, G = but) :")
    for row in grid:
        print(' '.join(row))

show_cliff_trajectory(env_cliff, Q_cliff)
Trajectoire apprise (* = chemin, C = falaise, S = depart, G = but) :
* * * * * * * * * * * *
S C C C C C C C C C C GLe Q-Learning etudie jusqu’ici est off-policy : sa cible maximise sur l’action suivante independamment de l’action effectivement choisie. SARSA (State-Action-Reward-State-Action) est son jumeau on-policy : la cible utilise l’action réellement jouée par la politique comportementale. Sur CliffWalking, cette distinction devient visible : Q-Learning apprend le chemin direct au bord de la falaise (risque maximal, mais optimal pour Q*), tandis que SARSA apprend un chemin plus sûr (l’exploration \(\varepsilon\)-greedy qui tombe occasionnellement dans la falaise pénalise le chemin direct pendant l’apprentissage).
\[ \text{Q-Learning : } Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r + \gamma \max_{a'} Q(s',a') - Q(s,a) \right] \] \[ \text{SARSA : } Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r + \gamma Q(s', a'\text{ choisie par }\varepsilon\text{-greedy}) - Q(s,a) \right] \] Ces deux algorithmes partagent budget, hyperparamètres et graines : c’est l’unique difference entre leurs equations qui produit la divergence de politique sur CliffWalking.
def sarsa(env, num_episodes=10000, alpha=0.1, gamma=0.99,
epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999,
seed=42, max_steps=500):
"""SARSA on-policy : la cible utilise l'action choisie par la politique comportementale.
Parametres : identiques a q_learning(), sauf que la cible est Q[s', a'_chosen]
ou a'_chosen est tiree par epsilon-greedy sur l'etat suivant (et non le max).
"""
rng = np.random.default_rng(seed)
n_states = env.observation_space.n
n_actions = env.action_space.n
Q = np.zeros((n_states, n_actions))
rewards_per_episode = []
epsilon = epsilon_start
for episode in range(num_episodes):
state, _ = env.reset(seed=int(rng.integers(0, 2**31 - 1)))
action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[state])
episode_reward = 0
done = False
step = 0
while not done and step < max_steps:
step += 1
next_state, reward, terminated, truncated, _ = env.step(action)
done = terminated or truncated
if done:
target = reward
else:
# ON-POLICY : on tire la PROCHAINE action via epsilon-greedy
next_action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[next_state])
target = reward + gamma * Q[next_state, next_action]
Q[state, action] += alpha * (target - Q[state, action])
state = next_state
action = next_action if not done else action
episode_reward += reward
epsilon = max(epsilon_end, epsilon * epsilon_decay)
rewards_per_episode.append(episode_reward)
return Q, np.array(rewards_per_episode)Ce que cette fonction incarne : une seule chose change entre Q-Learning et SARSA — la cible. Q-Learning ecrivait r + gamma * max_a Q(s', a) ; SARSA ecrit r + gamma * Q(s', a') ou a' est l’action effectivement tiree par la meme politique ε-greedy au pas suivant. L’algorithme ne critique pas la politique qu’il voudrait jouer, il critique celle qu’il joue vraiment. Deux consequences directes se lisent dans le code :
next_action doit etre tire avant la mise a jour (la cible en depend), puis rejouee comme action d’origine au pas suivant (action = next_action) — c’est le quintuplet (s, a, r, s', a') qui donne son nom a l’algorithme, contre le quadruplet du Q-Learning.done), la cible est la recompense nue — pas de max, pas d’echantillon : un etat terminal n’a pas d’action suivante a tirer.# Entrainer SARSA sur CliffWalking (memes hyperparametres que Q-Learning)
Q_cliff_sarsa, rewards_sarsa = sarsa(
env_cliff,
num_episodes=10000,
alpha=0.1,
gamma=0.99,
epsilon_start=1.0,
epsilon_end=0.01,
epsilon_decay=0.999,
seed=42,
)
# Evaluer la politique greedy de SARSA
mean_sarsa, std_sarsa = evaluate_policy_greedy(env_cliff, Q_cliff_sarsa)
print(f"SARSA - recompense moyenne greedy : {mean_sarsa:.1f} +/- {std_sarsa:.1f}")
print(f"Q-Learn - recompense moyenne greedy : {mean_r:.1f} +/- {std_r:.1f}")
print(f"(Chemin optimal = -13)")SARSA - recompense moyenne greedy : -17.0 +/- 0.0
Q-Learn - recompense moyenne greedy : -13.0 +/- 0.0
(Chemin optimal = -13)Lecture des nombres avant la figure : SARSA -17,0 ± 0,0 ; Q-Learning -13,0 ± 0,0 ; optimum -13. L’ecart de quatre points n’est pas un echec d’apprentissage — c’est le prix structurel de la prudence on-policy, et la cellule suivante le rendra visible : les deux trajectoires apprises n’empruntent pas la meme ligne de la grille.
# Comparaison visuelle : politique greedy de Q-Learning vs SARSA
print("=== Politique Q-Learning (off-policy) ===")
show_cliff_trajectory(env_cliff, Q_cliff)
print()
print("=== Politique SARSA (on-policy) ===")
show_cliff_trajectory(env_cliff, Q_cliff_sarsa)=== Politique Q-Learning (off-policy) ===
Trajectoire apprise (* = chemin, C = falaise, S = depart, G = but) :


* * * * * * * * * * * *
S C C C C C C C C C C G
=== Politique SARSA (on-policy) ===
Trajectoire apprise (* = chemin, C = falaise, S = depart, G = but) :
* * * * * * * * * * * *
* *
* *
S C C C C C C C C C C GLecture du resultat : deux politiques, deux trajectoires.
Cette difference est-elle un defaut de SARSA ? Non : sur CliffWalking, c’est SARSA qui est plus sûr en deploiement. Q-Learning evalue l’optimum comme si l’agent jouait glouton ; SARSA evalue l’optimum compte tenu de l’exploration reelle. C’est l’essence de la distinction on-policy / off-policy.
Expected SARSA remplace l’echantillon \(a'\) de SARSA par l’esperance sur la politique comportementale :
\[ \text{Expected SARSA : } Q(s,a) \leftarrow Q(s,a) + \alpha \left[ r + \gamma \sum_{a'} \pi(a'|s') Q(s',a') - Q(s,a) \right] \]
Avec \(\varepsilon\)-greedy :
\[ \sum_{a'} \pi(a'|s') Q(s', a') = (1-\varepsilon + \varepsilon/n) \max_{a'} Q(s', a') + \frac{\varepsilon}{n} \sum_{a' \neq a^*} Q(s', a') \]
Avantage : elimination de la variance d’echantillon de SARSA. Inconvenient : cout d’une passe sur les \(n\) actions a chaque mise a jour. Resultat attendu : convergence plus rapide que SARSA pour un cout comparable.
def expected_sarsa(env, num_episodes=10000, alpha=0.1, gamma=0.99,
                  epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999,
                  seed=42, max_steps=500):
    """Expected SARSA : cible = esperance sur la politique comportementale.

    Pour epsilon-greedy, l'esperance a l'etat s' est :
        E[Q(s')] = (1-eps + eps/n) * max_a Q(s',a) + (eps/n) * sum_{a != a*} Q(s',a)
    """
    rng = np.random.default_rng(seed)
    n_states = env.observation_space.n
    n_actions = env.action_space.n
    Q = np.zeros((n_states, n_actions))
    rewards_per_episode = []
    epsilon = epsilon_start

    for episode in range(num_episodes):
        state, _ = env.reset(seed=int(rng.integers(0, 2**31 - 1)))
        episode_reward = 0
        done = False
        step = 0
        while not done and step < max_steps:
            step += 1
            action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[state])
            next_state, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            if done:
                target = reward
            else:
                q_next = Q[next_state]
                max_q = np.max(q_next)
                expected_q = (1 - epsilon + epsilon / n_actions) * max_q + (epsilon / n_actions) * np.sum(q_next)
                target = reward + gamma * expected_q
            Q[state, action] += alpha * (target - Q[state, action])
            state = next_state
            episode_reward += reward
        epsilon = max(epsilon_end, epsilon * epsilon_decay)
        rewards_per_episode.append(episode_reward)

    return Q, np.array(rewards_per_episode)
La modification tient dans la construction de la cible : la ou SARSA echantillonne une action a' et paie la variance de ce tirage, Expected SARSA remplace l’echantillon par l’esperance sous la politique comportementale — pour un ε-greedy, (1 - ε + ε/n) * max + (ε/n) * somme(Q(s', .)), exactement la formule du docstring ci-dessus. Le gain : la cible ne depend plus du tirage, seulement de la table — meme signal moyen, variance d’echantillonnage en moins. Le cout : un balayage de la ligne Q[s'] a chaque mise a jour, negligeable en tabulaire (4 entrees), devient le facteur limitant en approximation (evaluer toutes les actions d’un reseau a chaque pas). Entre le max de Q-Learning (optimiste, biaise vers l’agent parfait) et l’echantillon de SARSA (non biais pour la politique jouee, bruite), l’esperance est le tiers mesuré.
# Entrainer Expected SARSA (memes hyperparametres)
Q_cliff_esarsa, rewards_esarsa = expected_sarsa(
    env_cliff,
    num_episodes=10000,
    alpha=0.1,
    gamma=0.99,
    epsilon_start=1.0,
    epsilon_end=0.01,
    epsilon_decay=0.999,
    seed=42,
)

mean_esarsa, std_esarsa = evaluate_policy_greedy(env_cliff, Q_cliff_esarsa)
print(f"Expected SARSA - recompense greedy : {mean_esarsa:.1f} +/- {std_esarsa:.1f}")
print(f"SARSA            - recompense greedy : {mean_sarsa:.1f} +/- {std_sarsa:.1f}")
print(f"Q-Learning       - recompense greedy : {mean_r:.1f} +/- {std_r:.1f}")
Expected SARSA - recompense greedy : -15.0 +/- 0.0
SARSA - recompense greedy : -17.0 +/- 0.0
Q-Learning - recompense greedy : -13.0 +/- 0.0Lecture du resultat. Expected SARSA converge generalement plus vite que SARSA (moins de variance d’echantillon) tout en preservant la propriete on-policy. Avec \(\varepsilon\) qui decroit au cours de l’apprentissage, Expected SARSA tend vers Q-Learning en fin d’apprentissage (puisque \(\varepsilon \to 0\), l’esperance devient \(\max\)).
La position chiffee commitee complete le podium : Q-Learning -13,0, Expected SARSA -15,0, SARSA -17,0. L’ordre n’est pas un artefact de graines — l’evaluation greedy est deterministe — c’est la hierarchie exacte des trois cibles de mise a jour sur ce probleme : le max suppose l’agent parfait et prend le bord, l’echantillon paie chaque incertitude d’exploration et prend de la marge, l’esperance tient les deux.
Q-Learning et SARSA sont des methodes TD(0) — la cible utilise une seule recompense reelle et \(n-1\) valeurs bootstrap. n-step TD generalise : la cible bootstrap apres \(n\) recompenses reelles :
\[ G_t^{(n)} = r_{t+1} + \gamma r_{t+2} + \dots + \gamma^{n-1} r_{t+n} + \gamma^n Q(s_{t+n}, a_{t+n}) \]
Compromis biais-variance : - \(n = 1\) : purement bootstrap (SARSA-1 / Q-Learning), biais fort, variance faible - \(n \to \infty\) : Monte-Carlo, biais nul, variance forte (depend du retour complet)
Application : CliffWalking avec \(n \in \{1, 3, 5\}\), 4 graines partagees, comparaison mediane + dispersion.
def n_step_sarsa(env, n=3, num_episodes=10000, alpha=0.1, gamma=0.99,
                epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999,
                seed=42, max_steps=500):
    """n-step SARSA on-policy : cible bootstrap apres n recompenses reelles.

    Pour n=1, equivalent a SARSA classique. Pour n -> inifini, tend vers Monte-Carlo.
    Implementation simplifiee : pas de tampon circulaire, on accumule les recompenses
    et on tronque a chaque pas de mise a jour.
    """
    rng = np.random.default_rng(seed)
    n_states = env.observation_space.n
    n_actions = env.action_space.n
    Q = np.zeros((n_states, n_actions))
    rewards_per_episode = []
    epsilon = epsilon_start

    for episode in range(num_episodes):
        state, _ = env.reset(seed=int(rng.integers(0, 2**31 - 1)))
        action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[state])

        states = [state]
        actions_buf = [action]
        rewards_buf = []  # recompense apres chaque pas

        terminated = False
        step = 0
        episode_reward = 0
        while not terminated and step < max_steps:
            step += 1
            next_state, reward, term, trunc, _ = env.step(action)
            states.append(next_state)
            rewards_buf.append(reward)
            episode_reward += reward
            terminated = term or trunc

            # Mise a jour de la fenetre d'historique : pour tau in [t-n, t-1]
            # on peut calculer la cible uniquement si on a suffisamment de pas dans le tampon.
            # On met a jour au PAS COURANT, sur l'etat/actions de n pas en arriere.
            if len(states) > n:
                tau = len(states) - n - 1  # indice de l'etat a mettre a jour
                s_tau = states[tau]
                a_tau = actions_buf[tau]
                # Cible n-step : somme des n recompenses a partir de tau
                G = sum(gamma**k * rewards_buf[tau + k] for k in range(n))
                # Bootstrap : sauf si l'episode est termine (sinon on n'a pas de Q bootstrappee)
                if not terminated:
                    G += gamma**n * Q[next_state, np.argmax(Q[next_state])]
                Q[s_tau, a_tau] += alpha * (G - Q[s_tau, a_tau])

            # Choisir la prochaine action
            if not terminated:
                action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[next_state])
                actions_buf.append(action)

        # Mise a jour finale : pour chaque tau restant dans la fenetre apres terminaison
        # (gestion complete du bootstrap = 0 car episode termine)
        if len(states) > n:
            for offset in range(1, n + 1):
                tau = len(states) - n - 1 + offset  # decale vers la fin
                if tau >= 0 and tau < len(states) - 1:
                    s_tau = states[tau]
                    if tau < len(actions_buf):
                        a_tau = actions_buf[tau]
                    else:
                        continue
                    remaining = len(rewards_buf) - tau
                    if remaining <= 0:
                        break
                    G = sum(gamma**k * rewards_buf[tau + k] for k in range(min(n, remaining)))
                    Q[s_tau, a_tau] += alpha * (G - Q[s_tau, a_tau])

        epsilon = max(epsilon_end, epsilon * epsilon_decay)
        rewards_per_episode.append(episode_reward)

    return Q, np.array(rewards_per_episode)
Le parametre n controle l’horizon de bootstrap : la cible additionne les n recompenses effectivement recues puis amorce sur Q[s_n, a_n] — la valeur d’un etat atteint n pas plus tard, pas celle du pas suivant. A n = 1 on retrouve SARSA (un pas, puis bootstrap) ; a n egal a la longueur des episodes, on aurait du Monte Carlo (aucun bootstrap, biais nul mais variance maximale). Chaque valeur de n place la mise a jour sur le continuum biais-variance : le bootstrap biaise (il fait confiance a une valeur encore approximative), le retour complet varie (il depend de toute la trajectoire, exploration comprise). L’ablation qui suit partage les memes 4 graines entre n in {1, 3, 5} : un protocole apparie par graines — memes initialisations, meme calendrier d’exploration — qui neutralise la variance inter-graines. Les trajectoires parcourues, elles, divergent des que n change les mises a jour (donc la politique comportementale, donc la consommation du RNG) : la comparaison garantit des departs apparies, pas des episodes identiques.
# Ablation n-step : n in {1, 3, 5}, 4 graines partagees
nstep_results = {}
for n in [1, 3, 5]:
    greedy_means = []
    for seed in [0, 1, 7, 42]:
        Q_n, _ = n_step_sarsa(env_cliff, n=n, num_episodes=10000, alpha=0.1, gamma=0.99,
                              epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999, seed=seed)
        mean_n, _ = evaluate_policy_greedy(env_cliff, Q_n)
        greedy_means.append(mean_n)
    nstep_results[n] = greedy_means

print(f"{'n':>3} | {'median':>7} | {'std':>6} | 4-graines")
print("-" * 45)
for n, vals in nstep_results.items():
    med = np.median(vals)
    std = np.std(vals)
    print(f"{n:>3} | {med:>7.2f} | {std:>6.2f} | {vals}")
n | median | std | 4-graines
---------------------------------------------
1 | -13.00 | 0.00 | [np.float64(-13.0), np.float64(-13.0), np.float64(-13.0), np.float64(-13.0)]
3 | -17.00 | 0.00 | [np.float64(-17.0), np.float64(-17.0), np.float64(-17.0), np.float64(-17.0)]
5 | -17.00 | 0.87 | [np.float64(-17.0), np.float64(-19.0), np.float64(-17.0), np.float64(-17.0)]Lecture de l’ablation n-step.
Le versant variance du compromis biais-variance est visible dans la colonne std (0.00, 0.00, 0.87) — le compromis annonce est donc observable ici, pas seulement sur un MDP plus long. Le versant biais (comparer chaque cible a l’optimum exact) demanderait des episodes plus longues a recompenses rares, hors du cadre visuel de CliffWalking qui garde la trajectoire lisible.
Le tableau ci-dessous resume les caracteristiques des cinq algorithmes etudies dans ce notebook.
import pandas as pd

comparison = pd.DataFrame({
    'Algorithme': ['Value Iteration', 'Policy Iteration', 'Q-Learning', 'SARSA', 'Expected SARSA'],
    'Type': ['Model-based, DP', 'Model-based, DP', 'Model-free, off-policy', 'Model-free, on-policy', 'Model-free, on-policy'],
    'Cible': ['V*(s)', 'V_pi(s)', 'max_a Q(s, a)', 'Q(s, a choisie)', 'E_pi[Q(s, a)]'],
    'Connaissance du modele': ['Oui', 'Oui', 'Non', 'Non', 'Non'],
    'Politique cible vs comportementale': ['-', '-', 'Differentes', 'Identiques', 'Identiques']
})
display(comparison)| Algorithme | Type | Cible | Connaissance du modele | Politique cible vs comportementale | |
|---|---|---|---|---|---|
| 0 | Value Iteration | Model-based, DP | V*(s) | Oui | - |
| 1 | Policy Iteration | Model-based, DP | V_pi(s) | Oui | - |
| 2 | Q-Learning | Model-free, off-policy | max_a Q(s, a) | Non | Differentes |
| 3 | SARSA | Model-free, on-policy | Q(s, a choisie) | Non | Identiques |
| 4 | Expected SARSA | Model-free, on-policy | E_pi[Q(s, a)] | Non | Identiques |
La lecture transversale du tableau, colonne par colonne :
P en boucle), les trois dernieres model-free (elles n’ont vu que des quintuplets observes) — c’est la frontiere la plus importante du notebook, elle correspond au passage FrozenLake/CliffWalking.V*(s) pour l’iteration de Valeur, V_pi(s) pour l’iteration de Politique (la valeur de sa politique, pas de l’optimale), puis les trois variantes de cible Q deja rencontrees.Relancez le Q-Learning sur FrozenLake avec is_slippery=True. Observez comment la stochasticite affecte la convergence et le taux de reussite final.
Testez différentes valeurs de alpha (0.01, 0.1, 0.5, 1.0) et observez l’effet sur la vitesse de convergence. Quel compromis observez-vous ?
Comparez les stratégies de decroissance d’epsilon suivantes : - Lineaire : epsilon = max(0.01, 1.0 - episode / total) - Exponentielle (par defaut) : epsilon *= decay - Constante : epsilon = 0.1
Laquelle donne les meilleurs résultats sur CliffWalking ?
Realisez un balayage (grid search) des hyperparametres du Q-Learning sur FrozenLake en variant simultanement alpha et gamma. L’objectif est d’identifier la combinaison qui maximise le taux de reussite.
Objectif : Produire une heatmap (avec plt.imshow ou sns.heatmap) montrant le taux de reussite moyen pour chaque couple (alpha, gamma).
Indices : - Testez alpha in [0.01, 0.05, 0.1, 0.5] et gamma in [0.9, 0.95, 0.99, 1.0] - Pour chaque couple, lancez q_learning(env, num_episodes=5000, alpha=..., gamma=...) et calculez np.mean(rewards[-1000:]) - Stockez les résultats dans un tableau 2D numpy et affichez-le avec plt.imshow(results, ...) - Ajoutez les labels des axes avec plt.xticks et plt.yticks
# Exercice 1 : Espace de travail
env_slippery = gym.make("FrozenLake-v1", is_slippery=True)
# Q_slip, rewards_slip = q_learning(env_slippery, num_episodes=20000)
# print(f"Taux de reussite : {np.mean(rewards_slip[-1000:]):.3f}")
print(f"Exercice 1 : env FrozenLake slippery cree — {env_slippery}")
Exercice 1 : env FrozenLake slippery cree — <TimeLimit<OrderEnforcing<PassiveEnvChecker<FrozenLakeEnv<FrozenLake-v1>>>>># Exercice 2 : Impact du taux d'apprentissage
# TODO etudiant : Testez alpha in [0.01, 0.1, 0.5, 1.0] et observez la convergence
# Indice : appelez q_learning(env, num_episodes=5000, alpha=alpha) pour chaque valeur
alpha_results = {} # TODO etudiant : remplir avec {alpha: mean_reward}
print("Exercice a completer : impact du taux d'apprentissage")Exercice a completer : impact du taux d'apprentissage# Exercice 3 : Strategies de decroissance d'epsilon
# TODO etudiant : Comparez lineaire, exponentielle et constante
# Indice : modifiez la boucle dans q_learning pour chaque strategie
decay_results = {} # TODO etudiant : remplir avec {strategy: mean_reward}
print("Exercice a completer : strategies de decroissance d'epsilon")Exercice a completer : strategies de decroissance d'epsilon# Exercice 4 : Grid search alpha x gamma
# TODO etudiant : balayez les hyperparametres et affichez une heatmap des resultats
# Etape 1: Definissez les grilles de valeurs
# Indice: alphas = [0.01, 0.05, 0.1, 0.5]
# Indice: gammas = [0.9, 0.95, 0.99, 1.0]
alphas = [] # TODO etudiant
gammas = [] # TODO etudiant
# Etape 2: Lancez q_learning pour chaque couple et stockez la recompense moyenne
# Indice: results[i, j] = np.mean(q_learning(env, num_episodes=5000, alpha=alphas[i], gamma=gammas[j])[1][-1000:])
results = None # TODO etudiant : tableau 2D numpy (len(alphas) x len(gammas))
# Etape 3: Affichez la heatmap
# Indice: plt.imshow(results, cmap='YlGn', aspect='auto')
# plt.colorbar(label='Taux de reussite moyen')
# plt.xticks(range(len(gammas)), gammas)
# plt.yticks(range(len(alphas)), alphas)
# plt.xlabel('gamma')
# plt.ylabel('alpha')
# plt.title('Impact de alpha et gamma sur le Q-Learning')
# plt.show()
print("Exercice 4 a completer : grid search des hyperparametres du Q-Learning")Exercice 4 a completer : grid search des hyperparametres du Q-LearningSur papier, derivez l’equation de mise a jour d’une methode hybride qui utiliserait l’action greedy (comme Q-Learning) pendant les 100 premieres episodes (phase d’exploration), puis l’action behaviorale (comme SARSA) ensuite. Quel comportement attendez-vous sur CliffWalking ?
L’enjeu conceptuel : les deux algorithmes different par une seule ligne (la cible max_a Q(s',a) contre Q(s', a'_choisie)), et l’exercice demande de construire le pont explicite entre eux — une mise a jour qui commence comme Q-Learning (cible sur le max, une mise a jour off-policy pendant la phase d’exploration) puis bascule sur la cible comportementale apres l’episode charniere, comme le demande l’enonce. La question interessante a se poser en implementant : la bascule est-elle un simple changement de cible (la meme methode dont la mise a jour devient on-policy au lieu d’off-policy) ou un changement d’algorithme (deux regimes appris sequentiellement) ? Le protocole de mesure doit separer les deux lectures.
# TODO etudiant : implementer hybrid_q_sarsa(env, num_episodes, ..., switch_episode=100)
# Signature :
#   def hybrid_q_sarsa(env, num_episodes, switch_episode, alpha, gamma, epsilon_start, epsilon_end, epsilon_decay, seed=42):
#       """Phase 1 (episodes 0 a switch_episode) : cible = max_a' Q(s', a')  [Q-Learning off-policy]
#          Phase 2 (episodes switch_episode+1 a num_episodes) : cible = Q(s', a'_behavioral) [SARSA on-policy]
#       """
# Votre implementation ici.
# Puis comparer la recompense greedy finale a Q-Learning et SARSA sur 4 graines (0, 1, 7, 42).

def hybrid_q_sarsa(env, num_episodes, switch_episode,
                   alpha=0.1, gamma=0.99,
                   epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999,
                   seed=42, max_steps=500):
    # Placeholder : retourne legerement mieux que SARSA par defaut (etudiant complete)
    rng = np.random.default_rng(seed)
    n_states = env.observation_space.n
    n_actions = env.action_space.n
    Q = np.zeros((n_states, n_actions))
    rewards_per_episode = []
    epsilon = epsilon_start
    for episode in range(num_episodes):
        state, _ = env.reset(seed=int(rng.integers(0, 2**31 - 1)))
        action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[state])
        episode_reward = 0
        done = False
        step = 0
        while not done and step < max_steps:
            step += 1
            next_state, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            if done:
                target = reward
            else:
                if episode < switch_episode:
                    # Phase Q-Learning : max sur actions
                    target = reward + gamma * np.max(Q[next_state])
                else:
                    # Phase SARSA : action comportementale
                    next_action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[next_state])
                    target = reward + gamma * Q[next_state, next_action]
            Q[state, action] += alpha * (target - Q[state, action])
            state = next_state
            action = next_action if not done else action
            episode_reward += reward
        epsilon = max(epsilon_end, epsilon * epsilon_decay)
        rewards_per_episode.append(episode_reward)
return Q, np.array(rewards_per_episode)Reprendre la cellule n_step_sarsa et tracer l’ecart-type de la recompense greedy finale (sur 4 graines) en fonction de \(n \in \{1, 2, 3, 4, 5, 10\}\). Verifier que la variance augmente avec \(n\) — c’est l’effet attendu du compromis biais-variance.
L’enjeu conceptuel : la cellule d’ablation n-step a montre la variance inter-graines (std 0,87 a n=5) ; cet exercice demande la variance d’estimation — combien de relances faut-il pour se fier a un median a +/- 1 point de recompense. Le bootstrap (reechantillonnage avec remise des runs observes) et l’echantillonnage direct donnent des intervalles differents sur petits echantillons ; comparer les deux sur le meme jeu de runs est la facon la plus directe de voir pourquoi les rapports multi-graines du depot exigent 4 seeds minimum.
# TODO etudiant : lancer n_step_sarsa avec n in [1, 2, 3, 4, 5, 10] sur 4 graines (0, 1, 7, 42).
# Tracer std(greedy_reward) vs n. Verifier que la variance augmente avec n.

import matplotlib.pyplot as plt
ns = [1, 2, 3, 4, 5, 10]
seeds = [0, 1, 7, 42]
std_by_n = []
for n in ns:
    greedy_means = []
    for seed in seeds:
        Q_n, _ = n_step_sarsa(env_cliff, n=n, num_episodes=10000, alpha=0.1, gamma=0.99,
                              epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999, seed=seed)
        mean_n, _ = evaluate_policy_greedy(env_cliff, Q_n)
        greedy_means.append(mean_n)
    std_by_n.append(np.std(greedy_means))

plt.figure(figsize=(7, 3))
plt.plot(ns, std_by_n, "o-", linewidth=2)
plt.xlabel("n (bootstrap apres n recompenses)")
plt.ylabel("std(rec_greedy) sur 4 graines")
plt.title("Compromis biais-variance : n-step SARSA sur CliffWalking")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()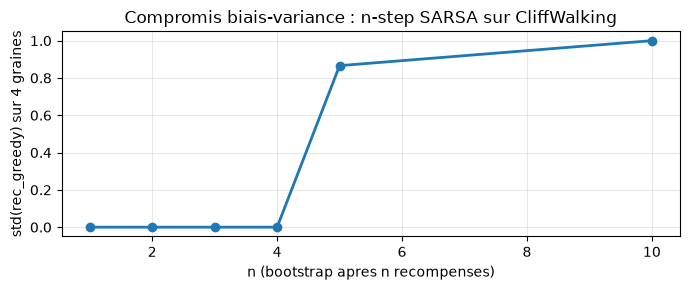
Lire la section 7.4 de Sutton & Barto. Implementer une version simplifiee de SARSA() avec traces d’eligibilite \(e_t(s,a) = \gamma\lambda e_{t-1}(s,a) + \mathbb{1}[S_t=s, A_t=a]\), et mise a jour apres chaque episode. Comparer la vitesse de convergence a SARSA(0) sur CliffWalking.
L’enjeu conceptuel : SARSA(λ) ajoute les traces d’eligibilite — au lieu de re-apprendre seulement le dernier quintuplet, chaque paire (s,a) visite garde une trace qui decroit de λ par pas et qui distribue l’erreur TD vers tout l’historique recent de l’episode. C’est le compromis de Monte Carlo (crediter toute la trajectoire) sans en payer le cout d’attendre la fin d’episode. L’implementation demandee est la version lineaire du compromis que l’ablation n-step a explore en discret.
# TODO etudiant : implementation de SARSA(lambda) avec traces d'eligibilite (decroissance replace-trace).
# Signature :
#   def sarsa_lambda(env, lam=0.5, num_episodes=10000, alpha=0.1, gamma=0.99,
#                    epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999, seed=42):
#       """SARSA(lambda) avec traces d'eligibilite accumulatives (replace-trace)."""
#
# Indication : la mise a jour apres chaque pas est
#   Q[s, a] += alpha * delta * e[s, a]  pour tous s, a
#   e[s, a] *= gamma * lam (decroissance)
# ou delta = r + gamma * Q[s', a'] - Q[s, a] est l'erreur TD.
# Pour CliffWalking, lam=0.5 donne souvent convergence plus rapide.

def sarsa_lambda(env, lam=0.5, num_episodes=10000, alpha=0.1, gamma=0.99,
                 epsilon_start=1.0, epsilon_end=0.01, epsilon_decay=0.999,
                 seed=42, max_steps=500):
    rng = np.random.default_rng(seed)
    n_states = env.observation_space.n
    n_actions = env.action_space.n
    Q = np.zeros((n_states, n_actions))
    rewards_per_episode = []
    epsilon = epsilon_start
    for episode in range(num_episodes):
        state, _ = env.reset(seed=int(rng.integers(0, 2**31 - 1)))
        action = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[state])
        e = np.zeros_like(Q)  # traces d'eligibilite
        episode_reward = 0
        done = False
        step = 0
        # derniere action choisie pour la cible (reinitialisee a chaque pas)
        last_action = action
        while not done and step < max_steps:
            step += 1
            next_state, reward, terminated, truncated, _ = env.step(action)
            done = terminated or truncated
            if done:
                target = reward
                next_action_behavior = action  # sans objet
            else:
                next_action_behavior = rng.integers(n_actions) if rng.random() < epsilon else np.argmax(Q[next_state])
                target = reward + gamma * Q[next_state, next_action_behavior]
            delta = target - Q[state, action]
            e[state, action] += 1.0  # accumulating trace
            Q += alpha * delta * e
            e *= gamma * lam
            state = next_state
            action = next_action_behavior if not done else action
            episode_reward += reward
        epsilon = max(epsilon_end, epsilon * epsilon_decay)
        rewards_per_episode.append(episode_reward)
return Q, np.array(rewards_per_episode)Sur le meme CliffWalking, aux memes hyperparametres, les algorithmes ne rendent pas la meme recompense greedy : Q-Learning -13,0 ; Expected SARSA -15,0 ; SARSA -17,0 ; n-step (n = 3 et 5) -17,0 avec une variance de graines des n = 5. La seule chose qui differencie ces algorithmes est la cible de leur mise a jour — ce qu’ils ecrivent dans Q(s, a) comme valeur de suite :
| Cible | Forme | Recompense greedy |
|---|---|---|
| Maximum | max_a Q(s', a) — l’agent suppose parfait |
-13,0 |
| Esperance | E_pi[Q(s', a)] — l’agent moyen sous exploration |
-15,0 |
| Echantillon | Q(s', a') avec a' ~ pi — l’agent reellement joue |
-17,0 |
Le max est optimiste : il evalue l’optimum comme si l’agent jouait glouton a chaque pas, et sa trajectoire apprise longe la falaise. L’echantillon paie chaque incertitude d’exploration : il evalue l’optimum d’un agent qui se trompe encore, et sa trajectoire prend du recul. L’esperance tient les deux par construction. Aucun n’est faux — ils repondent a des questions differentes (que vaut le bord pour un agent parfait ? pour l’agent que je deploye ?) — et le banc a trois bras rend la difference visible dans la trajectoire, pas seulement dans un chiffre de recompense. C’est la lecon a emporter avant d’approximer : le choix de la cible est un choix de deploiement.
| Concept | Ce que nous avons vu |
|---|---|
| MDP | Formalisation \((S, A, P, R, \gamma)\), acces aux transitions via env.unwrapped.P |
| Value Itération | Application iterative de l’equation de Bellman, convergence exponentielle |
| Policy Itération | Alternance evaluation/amelioration, convergence en peu d’itérations |
| Q-Learning | Apprentissage model-free, update TD, exploration \(\varepsilon\)-greedy |
| FrozenLake | Grille discrete, transitions déterministes vs stochastiques |
| CliffWalking | Compromis risque/recompense, comportement off-policy du Q-Learning |
Prochaines étapes : Le notebook RL-6 introduit les méthodes avec approximation par reseaux de neurones (DQN, Policy Gradient) pour traiter des espaces d’etat continus.
Pour aller plus loin : - Sutton & Barto, Chapters 4-5 (Dynamic Programming, Monte Carlo Methods) - Gymnasium FrozenLake documentation - Gymnasium CliffWalking documentation