SymbolicLearning - Apprentissage Symbolique
← Argument_Analysis | ↑ SymbolicAI | SMT →
Présentation
Comment un agent peut-il apprendre à partir de connaissances existantes plutôt que de données brutes ? Cette série explore l’apprentissage symbolique tel que décrit dans le chapitre 19 d’AIMA (Russell & Norvig), depuis l’apprentissage inductif pur (CBH, Version Space) jusqu’aux méthodes guidées par la connaissance (EBL, RBL).
Le premier notebook pose les bases : représentation d’hypothèses comme conjonctions de contraintes, algorithmes Current-Best-Hypothesis et Candidate Elimination (Version Space), et leurs limites face au bruit et aux concepts disjonctifs. Le second notebook montre comment la connaissance du domaine accélère l’apprentissage : l’apprentissage basé sur les explications (EBL) compile les théories en heuristiques opérationnelles, et l’apprentissage basé sur la pertinence (RBL) identifie les attributs déterminant via les déterminations. Le troisième notebook approfondit le RBL avec le treillis des déterminations, l’algorithme MINIMAL-CONSISTENT-DET et une comparaison avec sklearn. Le quatrième notebook couvre la programmation logique inductive (ILP) : l’algorithme FOIL (top-down), les opérateurs de résolution inverse (bottom-up) et la connexion avec les knowledge graphs, jusqu’à l’ILP moderne (Popper, Learning From Failures). SL-5 reprend et mène à terme la voie bottom-up esquissée en SL-4 (LGG de Plotkin, theta-subsomption, clause bottom par entailment inverse et recherche à la Progol), faisant directement suite à FOIL. SL-6 met quatre moteurs ILP réels face à face — Aleph, Metagol, Popper et ∂ILP (Lernd) — sur une même tâche récursive (ancestor/2), pour comparer leurs machineries (entailment inverse, MIL, Learning From Failures, gradient différentiable).
Les notebooks SL-7 à SL-9 ouvrent ensuite vers des méthodes contemporaines : SL-7 introduit le neuro-symbolique (T-norms différentiables, Logic Tensor Networks, DeepProbLog) ; SL-8 outille la découverte de règles sur knowledge graphs réels avec rdflib et AMIE rule mining ; SL-9 boucle LLM et vérification symbolique pour fiabiliser le raisonnement formel guidé par modèles de langage.
Enfin, deux notebooks concluent la série : SL-10 change de paradigme avec l’apprentissage actif (l’algorithme L* d’Angluin interroge un oracle au lieu de subir un échantillon, et apprend des automates finis avec garanties de minimalité) ;
SL-11 est le capstone qui assemble toute la série en un pipeline neuro-symbolique de bout en bout — du texte brut aux faits découverts, avec un LLM réel (Gemini 3.5 Flash) aux deux extrémités et le symbolique comme colonne vertébrale.
SL-12, ajouté à la série, explore un autre registre du neuro-symbolique : les réseaux de portes logiques differentiables (difflogic, Petersen NeurIPS 2022) — un modèle qui apprend des combinaisons de portes logiques par descente de gradient, puis se discretise en un circuit 100% booleen, interpretable-par-construction et ultra-rapide a l’inference.
SL-12b prolonge SL-12 par l’autre versant du registre discret : la synthèse logique spectrale (Pavlov, arXiv 2601.13953, digestion EPIC #14366 grain G2) — Fourier booléen exact (FWHT), poids ternaires de PTF, routage Sinkhorn sans surclaim, quantification puis recherche discrète (Metropolis, parallel tempering) avec oracle exact et vérité terrain exhaustive. SL-12b’ complète SL-12b par la tranche de recherche G1 du même EPIC : reproduction bornée Phase 1+2 du claim Pavlov, mesure de discrimination linéaire signé vs Sinkhorn-constrained routing, verdict honnête sur 27 opérations.
SL-13 ferme la phase 5 par un diagnostic DISCOVER léger (McCoy et al. arXiv:2608.29530, digestion EPIC #14366 grain G6) — un GRU/Transformer 1-2 couches entraîné sur copy/reverse/interleave est-il porteur d’une structure Tensor Product Representation (TPR) approximative ? Factorisation role × filler par moindres carrés alternés, réinjection dans le décodeur, constituent surgery, contrôle white-box TPR vs embeddings atomiques, balayage de capacité et régularisation L2,1 — le tout CPU-only, avec une conclusion bornée (la structure est approximative, pas une implémentation symbolique exacte).
SL-13b confronte la lecture TPR de SL-13 à une seconde lecture concurrente des mêmes états cachés : un dictionnaire creux (SAE top-k sur-complet) entraîné par le vrai organe ict/sae_dictionary.py de la série ICT (prolongement des insights McCoy proposé en commentaire de l’EPIC #14366). Sur le même GRU copy que SL-13 (protocole de décodage à BOS : chaque position est une cible de prédiction), le notebook mesure quatre confrontations falsifiables : sélectivité des features aux 40 facteurs (position, symbole) contre un null apparié en effectifs, concentration de rang 1 des atomes dédiés dans le découpage TPR (prédiction géométrique du pont role ⊗ filler — non soutenue à ces effectifs, résultat négatif rapporté tel quel, sans inférence formelle), double perturbation (permutation de blocs de coordonnées du découpage TPR — contrôle structurel, pas une intervention sur des rôles appris — contre ablation SAE dirigée, chacune contre son contrôle apparié en activité), et généralisation train → val du dictionnaire (encode-only) contre la TPR partagée. CPU borné, conclusion bornée ; trois exercices non résolus (contraste sur reverse, ablation dirigée par symbole, sur-complétude 32/64/128).
SL-14 ouvre un registre que la série n’avait pas encore visité : la découverte d’équations — la régression symbolique d’AI Feynman 2.0 (Udrescu, Tan, Feng, Neto, Wu, Tegmark, NeurIPS 2020, arXiv:2006.10782 ; digestion Epic #16741 grain T4). Le vrai outil aifeynman est exécuté sur le cas d’école du papier, l’énergie cinétique relativiste, et le notebook ouvre ses trois idées : symétries lues dans les gradients d’un réseau (la séparabilité E(m,v) = g(m)·h(v) détectée par le score S[f] sans chercher aucune formule), critère de description en bits (le MEDL ignore les outliers là où la MSE se fait traîner), et front de Pareto complexité–précision (mv²/2 à 13,6 bits cohabite avec la forme exacte d’Einstein) — plus la leçon transversale : « simple » dépend du langage de description. Le paquet (figé en 2021, extensions Fortran) s’exécute dans le conteneur aifeynman:sl14 construit par assets/Dockerfile.aifeynman (Python 3.9 + gfortran + torch CPU).
À qui s’adresse cette série
Étudiants en IA, informaticiens intéressés par le raisonnement symbolique, et chercheurs en apprentissage automatique souhaitant comprendre les approches non-statistiques.
Prérequis et dépendances
Les notebooks (~22h50 total — 17 Python + 8 jumeaux C# marathon parité #4956 + 1 compagnon Lean natif) se répartissent ainsi :
- Track Python : Python 3.10+ standard library suffit, sauf SL-3 (scikit-learn + numpy pour la comparaison RBL / information mutuelle), SL-4 (Popper +
janus_swi+ SWI-Prolog, kernel Linux/WSL), SL-6 (moteurs ILP réels : SWI-Prolog, Popper, Lernd), SL-7 (torch+LTNtorchpour les Logic Tensor Networks), SL-8 (rdflib+clingopour les knowledge graphs et l’ASP), SL-12 (difflogic + torch), SL-12b (numpy + matplotlib pour la synthèse spectrale), SL-12b’ (numpy seul CPU pour la reproduction Pavlov DLS), SL-13 (torchCPU + numpy pour le diagnostic DISCOVER), SL-15 (ortools9.15 +scikit-learn1.6, CPU seul — CP-SAT joue l’oracle) et SL-14 (conteneur Dockeraifeynman:sl14— le paquetaifeynmanfigé en 2021 exige Python 3.9, NumPy < 2 et gfortran ; construction :docker build -f assets/Dockerfile.aifeynman -t aifeynman:sl14 assets/, puis exécution papermill dans le conteneur) ; SL-9 et SL-11 acceptent une clé OpenRouter optionnelle (fichier.env) pour des appels LLM réels, avec un simulateur déterministe en repli. - Compagnon Lean : SL-1b s’exécute sur le kernel Lean 4
lean4-wsl(lakelearning_theory_lean, Mathlib). - Jumeaux C# : les 8 jumeaux (.NET Interactive 1.4+,
Microsoft.dotnet-interactive) sont des ré-implémentations from-scratch en C# pur des mêmes algorithmes, sans dépendance externe ML. - Niveau requis : une familiarité avec la logique propositionnelle suffit pour SL-1 à SL-6 et SL-10 ; SL-7, SL-9 et SL-11 supposent une intuition des réseaux de neurones et des LLMs.
Parité .NET ⇄ Python
Le notebook SL-1-LogicalLearning-Csharp.ipynb est le jumeau C# (.NET Interactive) de SL-1 — implémentation from-scratch des mêmes algorithmes (CBH + Candidate Elimination) en C# pur (type system + HashSet<>, pas de lib externe). Marathon parité .NET ⇄ Python (#4956).
Compagnon Lean natif
Le notebook SL-1b-LogicalLearning-Lean-Native.ipynb exécute le lake learning_theory_lean (théorie PAC + perceptron de Novikoff, 0-sorry) directement dans le kernel Lean 4 lean4-wsl : #check des théorèmes des 14 modules du lake (borne de Valiant classe finie, généralisation agnostique, concentration de Hoeffding-Chernoff, convergence et serrage du perceptron), une distribution construite à la main, et 3 exercices de preuve. C’est le pendant formel de l’inductif de SL-1 — là où SL-1 implémente l’apprentissage inductif, SL-1b prouve ses garanties d’échantillonnage (See #11703).
Séries connexes
Les notebooks de la série constituent un complément théorique aux séries :
- Tweety — argumentation computationnelle
- SemanticWeb — représentation de connaissances
- ML — apprentissage statistique (contraste avec l’inductif symbolique)
Pourquoi cette série
L’apprentissage symbolique représente la contrepartie théorique du machine learning statistique. Tandis que les méthodes modernes (deep learning, ensembles d’arbres) excellent à extraire des patterns de grandes masses de données, elles souffrent de trois limites fondamentales que l’approche symbolique adresse directement :
- Peu de données disponibles : les méthodes symboliques comme Candidate Elimination ou FOIL apprennent à partir de quelques exemples, voire d’un seul (EBL). Quand la collecte de données est coûteuse ou impossible (diagnostic médical rare, validation formelle), l’induction pure ne fonctionne pas.
- Interprétabilité requise : une règle logique
IF temperature > 38 AND toux THEN infectionest compréhensible par un humain. Un réseau de neurones de 100M de paramètres ne l’est pas. Pour les applications critiques ou réglementées (médecine, finance, justice), l’interprétabilité n’est pas un luxe — c’est une exigence. - Intégration avec la connaissance existante : les méthodes symboliques combinent examples ET théorie du domaine. EBL compile un exemple prouvé en une règle opérationnelle générale ; RBL identifie les attributs déterminants via des contraintes formelles. Aucune méthode statistique ne peut exploiter cette connaissance a priori de la même façon.
Cette série montre que les deux approches ne s’opposent pas — elles se complémentent. La phase finale (SL-7 à SL-9) explore explicitement cette intégration : T-norms différentiables pour rendre la logique compatible avec l’entraînement neuronal, rule mining sur knowledge graphs réels, et boucles de vérification symbolique pour fiabiliser les sorties LLM.
Objectifs d’apprentissage
À l’issue de cette série, vous serez capable de :
Implémenter les algorithmes d’apprentissage inductif de base (CBH, Candidate Elimination, Version Space)
Compiler des preuves en heuristiques opérationnelles via EBL, et identifier les attributs déterminants via RBL et les déterminations
Construire le treillis des déterminations et appliquer MINIMAL-CONSISTENT-DET pour la sélection guidée d’attributs
Apprendre des règles logiques (clauses Horn) à partir d’exemples avec FOIL et la résolution inverse
Construire la chaîne bottom-up de l’ILP : LGG de Plotkin, theta-subsomption, clause bottom et recherche de clause à la Progol
Comparer quatre moteurs ILP modernes réels — Aleph (entailment inverse), Metagol (MIL), Popper (LFF) et ∂ILP (différentiable) — sur une même tâche récursive
Intégrer logique et apprentissage neuronal via T-norms, Logique Tensorielle, et DeepProbLog
Extraire des règles de knowledge graphs réels avec rdflib et AMIE, et effectuer la complétion de graphes
Concevoir une boucle LLM-symbolique : extraction de règles IF-THEN depuis du texte, vérification de cohérence formelle, feedback pour l’amélioration
Implémenter l’algorithme L* d’Angluin : table d’observation, requêtes d’appartenance et d’équivalence, apprentissage actif d’automates minimaux
Assembler un pipeline neuro-symbolique complet : extraction LLM, oracle de validation type, mining de règles, chaînage avant avec provenance, et confrontation LLM vs KG
Calculer le spectre de Fourier exact d’une fonction booléenne (FWHT), le distinguer des poids ternaires d’un PTF, et conduire une recherche discrète bornée (Metropolis, parallel tempering) contre un oracle exact
Diagnostiquer la structure interne d’un GRU 1-2 couches entraîné sur tâches symboliques de séquence via DISCOVER (TPR par ALS, R² sur l’approximation, réinjection decoder, constituent surgery, contrôle white-box TPR vs embeddings atomiques), et conclure de façon bornée sur la nature approximative vs exacte de la structure TPR observée
Vue d’ensemble
| Statistique | Valeur |
|---|---|
| Notebooks | 26 (17 Python canoniques + 8 jumeaux C# marathon parité #4956 + 1 compagnon Lean natif) |
| Exercices (table de pioche) | 61 |
| Kernel | Python 3 + .NET Interactive (jumeaux C#) + lean4-wsl (compagnon Lean) + conteneur aifeynman:sl14 (SL-14) |
| Durée estimée | ~1370 min (~22 h 50 : Python 15 h 20 + compagnon Lean 40 min + jumeaux C# 6 h 50) |
| Prérequis | Python 3.10+ (standard library + sklearn + numpy pour SL-3 seulement ; SL-4 relève de SWI-Prolog/Popper via kernel Linux/WSL ; rdflib+clingo pour SL-8 ; torch+LTNtorch pour SL-7 ; difflogic+torch pour SL-12 ; numpy+matplotlib pour SL-12b ; numpy seul CPU pour SL-12b’ ; torch CPU + numpy pour SL-13 ; ortools + scikit-learn pour SL-15 ; conteneur Docker aifeynman:sl14 pour SL-14 ; clé OpenRouter optionnelle pour SL-9/SL-11) + .NET Interactive 1.4+ pour les 8 jumeaux C# + kernel lean4-wsl (lake learning_theory_lean) pour SL-1b |
Parcours d’apprentissage
Le parcours progresse en sept phases où chacune répond à une limite de la précédente — le bruit motive le recours à la connaissance, la rigidité logique motive la différentiabilité, l’opacité motive la provenance (thèse détaillée en conclusion) :
flowchart TD
    P1["<b>Phase 1 · Inductif pur</b><br/>SL-1 · CBH · Version Space<br/>apprendre d'exemples"]
    P2["<b>Phase 2 · Guidé par la connaissance</b><br/>SL-2/3 · EBL · RBL · déterminations<br/>la connaissance accélère"]
    P3["<b>Phase 3 · Programmes logiques</b><br/>SL-4/5 · FOIL · résolution inverse · Progol<br/>clauses Horn + récursion"]
    P4["<b>Phase 4 · Moteurs ILP réels</b><br/>SL-6 · Aleph · Metagol · Popper · ∂ILP<br/>4 machineries comparées"]
    P5["<b>Phase 5 · Neuro-symbolique</b><br/>SL-7/8/9/13/15 · T-norms · KG mining · boucle LLM · diagnostic TPR · conjectures/oracle<br/>différentiable + vérifiable + structurelle"]
    P6(("<b>Phase 6 · Capstone</b><br/>SL-10/11/12/12b/12b' · L* actif · pipeline 6 étages · portes differentiables · synthèse spectrale + reproduction Pavlov<br/>LLM ↔ logique en boucle"))
    P7["<b>Phase 7 · Découvrir l'équation</b><br/>SL-14 · AI Feynman · gradients + MDL + Pareto<br/>du réseau à la formule fermée"]
    P1 -->|"bruit + disjonction<br/>non représentables"| P2
    P2 -->|"passer des attributs<br/>aux programmes"| P3
    P3 -->|"comparer les machineries<br/>sur une même tâche"| P4
    P4 -->|"rigidité logique<br/>→ différentiabilité"| P5
    P5 -->|"opacité neuronale<br/>→ provenance"| P6
    P6 -->|"langages et circuits fixés<br/>→ découvrir la formule"| P7
Phase 1 : Fondations inductives (SL-1, ~50 min)
Le parcours commence par l’apprentissage inductif pur : un agent doit découvrir une règle cachée à partir d’exemples. SL-1 présente les algorithmes fondamentaux — Current-Best-Hypothesis (ajuste une seule hypothèse incrémentalement) et Candidate Elimination (maintient l’ensemble complet des hypothèses consistantes, le “Version Space”). Vous expérimentez leurs limites face au bruit et aux concepts disjonctifs, ce qui motive naturellement les approches plus riches introduites ensuite.
Phase 2 : Apprentissage basé sur la connaissance (SL-2 a SL-3, ~95 min)
La deuxième phase introduit l’idée centrale que la connaissance accélère l’apprentissage. EBL (SL-2) montre comment compiler un exemple prouvé en une règle opérationnelle générale, en quatre étapes : expliquer, variabiliser, extraire, simplifier. RBL (introduit en SL-2, approfondi en SL-3) explore une autre facette : identifier les attributs qui déterminent vraiment la cible via le formalisme des déterminations et le treillis des sous-ensembles d’attributs. La comparaison avec sklearn (information mutuelle) montre quand la connaissance du domaine bat la statistique brute.
Phase 3 : Programmation logique inductive (SL-4 a SL-5, ~115 min)
SL-4 fait le pont entre apprentissage automatique et intelligence artificielle symbolique classique en couvrant l’ILP : apprentissage de programmes logiques (clauses Horn) à partir d’exemples. L’algorithme FOIL (top-down) et la résolution inverse (bottom-up) sont implémentés de zéro, puis appliqués aux knowledge graphs — avec extraction de règles AMIE et requêtes SPARQL CONSTRUCT. La section finale confronte le FOIL artisanal à l’ILP moderne : Popper (Learning From Failures) retrouve le programme récursif ancestor optimal sur les mêmes données, démontre l’apport de la récursion par ablation, et le programme appris est vérifié indépendamment en SWI-Prolog. SL-5 reprend la promesse bottom-up esquissée en SL-4 et la mène à terme : LGG de Plotkin, theta-subsomption, clause bottom par entailment inverse, et recherche de clause à la Progol qui retrouve la définition de grandfather/2 parmi 56 candidats.
Phase 4 : Moteurs ILP modernes (SL-6, ~65 min)
Après avoir construit FOIL et Progol de zéro, SL-6 met quatre moteurs ILP réels face à face sur une même tâche récursive (ancestor/2, la clôture transitive de parent) : Aleph (entailment inverse, la lignée Progol), Metagol (Meta-Interpretive Learning, avec invention de prédicats), Popper (Learning From Failures) et ∂ILP (ILP différentiable via Lernd). Chaque moteur apprend le même concept par une machinerie différente — recherche symbolique exacte, métarègles, contraintes ASP, descente de gradient — ce qui rend visibles leurs forces et leurs angles morts (sensibilité à la direction des modes, invention de prédicats, tolérance au bruit). Le ∂ILP différentiable amorce naturellement la phase neuro-symbolique suivante.
Les quatre moteurs ILP (Aleph, Metagol, Popper, ∂ILP) sont comparés textuellement dans la cellule 21 du notebook — chacun y apprend le même concept ancestor/2 par une machinerie distincte (recherche symbolique exacte, métarègles avec invention de prédicats, contraintes ASP, descente de gradient), et leurs clauses apprises, scores et temps sont tabulés. Aucune figure illustrative n’est embarquée ici : la comparaison vit dans le notebook, où chaque moteur peut être inspecté dans son contexte d’exécution.
Phase 5 : Intégration neuro-symbolique (SL-7 à SL-9, SL-13 et SL-15, ~225 min)
Cette phase explore les méthodes contemporaines à l’intersection du symbolique et du connexionniste. SL-7 introduit les T-norms différentiables, les prédicats neuronaux et les Logics Tensor Networks qui rendent la logique opérationnelle dans un gradient descent. SL-8 passe à l’échelle avec le rule mining réel sur des knowledge graphs construits avec rdflib (AMIE, complétion de graphes). SL-9 ferme la boucle avec LLMs : extraction de règles depuis du texte naturel, vérification symbolique des sorties, et boucles de rétroaction pour fiabiliser le raisonnement. SL-13 complète la phase 5 en se demandant si la structure TPR (Tensor Product Representation, sum_t role_pos(t) ⊗ filler_symbole(x_t)) émerge organiquement dans un GRU 1-2 couches entraîné sur des tâches symboliques de séquence. Le diagnostic DISCOVER (McCoy et al., arXiv:2608.29530) procède par factorisation role × filler (ALS), réinjection dans le décodeur, constituent surgery et contrôle white-box TPR versus embeddings atomiques — sur architectures CPU petites, avec une conclusion bornée : la structure est approximative et fonctionnellement exploitée, mais pas une implémentation symbolique exacte. SL-15 prolonge la boucle générateur/oracle de SL-9 sur un oracle d’optimisation réel : un MLP entraîné à imiter les solutions sœurs propose des conjectures (fixations de variables) à CP-SAT sur la coloration de graphe, et le notebook mesure ce que le benchmark agrégé ne peut pas voir — le sort de chaque conjecture prise isolément. Verdict mesuré : le hint complet réduit la médiane de 18 % malgré ~25 % d’arêtes conflictuelles (42 sur ~168), mais chaque conjecture individuelle en fait ~63 % — l’empilement dilue le signal ; la boucle conjecture → réfutation → réparation est exécutée de bout en bout.
Phase 6 : Apprentissage actif et capstone (SL-10 à SL-12b’, ~295 min)
Cinq notebooks concluent la série.
SL-10 — Apprentissage actif d’automates inverse le rapport de l’apprenant aux données : au lieu de subir un échantillon, L* d’Angluin choisit ses questions (requêtes d’appartenance et d’équivalence à un oracle MAT) et apprend des automates finis déterministes prouvablement minimaux — le cadre théorique (Myhill-Nerode, fermeture et cohérence de la table d’observation) est implémenté et vérifié de zéro. Le notebook explore aussi la version bruitée du problème (oracle bruité + vote majoritaire type Rivest-Schapire + agrégation d’évidence forward sum-product), montrant que la garantie de minimalité tient tant que le ratio signal/bruit reste favorable.
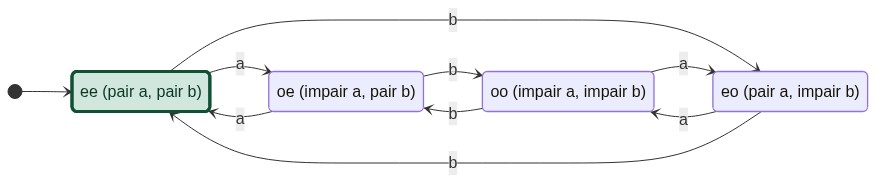 L’automate cible de la tâche
parity2(a,b) : quatre états étiquetés par la parité du nombre de a et du nombre de b lus jusqu’ici. ee (vert) est à la fois l’état initial et l’état acceptant ; chaque symbole a ou b flippe la parité correspondante. Le théorème de Myhill-Nerode assure que cet automate à 4 états est minimal* — toute DFA équivalente en comporte au moins autant. C’est l’objet que l’algorithme L* d’Angluin reconstruit par requêtes d’appartenance et d’équivalence à l’oracle MAT (cellules 20-30 du notebook) ; la version bruitée et l’agrégation bayésienne de preuves sont étudiées dans la cellule 33.*
SL-11 — Capstone neuro-symbolique assemble toute la série en un pipeline en 6 étages (extraction LLM -> oracle de validation -> knowledge graph -> mining de règles -> chainage avant avec provenance -> confrontation LLM vs KG) qui exécute avec de vrais appels Gemini 3.5 Flash, ou chaque étage mobilise un notebook antérieur de la série — y compris une leçon d’architecture découverte dans les sorties réelles : le chaînage avant peut violer les contraintes que l’oracle impose en amont.
SL-12 — Réseaux de portes logiques différentiables explore un autre angle du neuro-symbolique : les réseaux de portes logiques differentiables (difflogic, Petersen NeurIPS 2022) apprennent des combinaisons de portes logiques par descente de gradient sur MNIST 20×20, puis se discretisent en un circuit 100% booleen, interpretable-par-construction et ultra-rapide a l’inference.
Les courbes d’entraînement MNIST 20×20 d’un réseau de portes logiques différentiables — CrossEntropyLoss chutant de 2,3 à ~1,2 en 600 itérations, accuracy train à ~0,74 et test (pointillés rouges) à 0,79 — sont produites par la cellule 11 du notebook. Le circuit booléen final discrétisé, lui — l’objet conceptuel du notebook, le réseau de portes logiques interprétable-par-construction — est visualisable via la cellule 13 (histogramme de la distribution des prédictions après discrétisation) ; la figure de structure du circuit n’est pas embarquée ici car elle exige la ré-exécution de l’environnement difflogic pour rendre la topologie exacte des portes apprises (rendu Netzvis).
SL-12b — Synthèse logique spectrale prend l’autre versant du registre discret : au lieu de portes locales apprises par gradient sur un câblage fixe, il représente les fonctions booléennes dans la base de Fourier — transformée de Walsh-Hadamard exacte (papillon O(n·2^n), reconstruction vérifiée au bit près), coefficients exacts explicitement distingués des poids ternaires {−1,0,+1} d’un PTF, routage Sinkhorn mesuré sans jamais surclaimer une permutation sous ex-aequo, puis quantification (perte mesurée : 8/16 fonctions préservées sur n=2) et recherche discrète — Metropolis et parallel tempering à budget égal, avec rapport d’acceptation exact, oracle déterministe et vérité terrain exhaustive 3^11 = 177 147. Le pont final avec SL-12 : le spectre du circuit AND(OR(x1,x2), XNOR(x3,x4)) rend visible ce que la composition de portes locales fabrique (degré 4, coefficient dominant χ_{3,4} = +0,75).
SL-12b’ — Reproduction Pavlov DLS (recherche) complète SL-12b par la mesure de discrimination au cœur du claim Pavlov (EPIC #14366 G1) : on reproduit Phase 1 (16 opérations n=2) et Phase 2 (11 opérations temporelles n=4) avec un routeur linéaire signé (modèle simple) vs un routeur Sinkhorn-constrained (proxy du papier Pavlov). Mesure multi-seed (4 seeds Phase 1, 3 seeds Phase 2) sur 27 opérations. Verdict honnête : le linéaire signé atteint 100% sur les 27 opérations ; notre proxy Sinkhorn reste à 0-25% — défaut de gradient proxy, pas une réfutation du claim Pavlov original. C’est une tranche de recherche bornée (CPU-only, NumPy seul) qui pose la borne inférieure et identifie la dette (gradient exact du Sinkhorn-Knopp) pour une tranche ultérieure.
Phase 7 : Découvrir l’équation (SL-14, ~75 min)
SL-14 — AI Feynman : découvrir des équations inverse la question de toute la série : au lieu d’apprendre des règles ou des circuits dans un langage donné, peut-on retrouver la formule fermée qui engendre les données ? Le vrai outil aifeynman (AI Feynman 2.0, NeurIPS 2020) est exécuté sur le cas d’école du papier — l’énergie cinétique relativiste — où le front de Pareto complexité–précision fait cohabiter mv²/2 (13,6 bits, erronée aux hautes vitesses) et la forme exacte E = mc²(1/√(1−v²/c²) − 1). Les trois leviers de l’algorithme sont ouverts un à un : symétries lues dans les gradients d’un NN 128/128/64/64 tanh (le score S[f] de l’Eq. 6 détecte que E(m,v) = g(m)·h(v) sans chercher aucune formule — et explique le choix de tanh plutôt que ReLU), MEDL (description en bits des résidus : les outliers coûtent logarithmiquement, la démo Fig. 4 retrouvée), et le biais du langage de description (cos(cos θ) préféré à cos²θ, tanh indécouvrable hors base — compteur RPN à l’appui). Le budget d’exécution est volontairement borné et confronté honnêtement aux résultats du papier. Environnement : conteneur aifeynman:sl14 (paquet PyPI figé en 2021, extensions Fortran via numpy.distutils — construction documentée dans assets/Dockerfile.aifeynman).
Parcours alternatifs
Parcours rapide (SL-1 + SL-7 + SL-9 + SL-11, ~4h)
Pour ceux qui veulent saisir l’essence sans suivre toute la progression : les fondements inductifs (SL-1), l’intégration neuro-symbolique (SL-7), la vérification LLM (SL-9) et le capstone qui assemble le tout (SL-11). Donne une vue d’ensemble du spectre, de l’inductif pur au pipeline neuro-symbolique complet.
Parcours ILP approfondi (SL-1 a SL-6, ~325 min)
Pour les étudiants en logique et IA symbolique : suivre les six premiers notebooks dans l’ordre — de Candidate Elimination a FOIL, puis SL-5 qui mène le bottom-up a terme (LGG, theta-subsomption, clause bottom et Progol), et SL-6 qui confronte quatre moteurs ILP réels (Aleph, Metagol, Popper, ∂ILP) sur une même tâche récursive.
Parcours théorie des langages (SL-1 + SL-10, ~110 min)
Pour les étudiants en informatique théorique : le cadre inductif général (SL-1), puis l’apprentissage actif d’automates avec ses garanties formelles (SL-10) — requêtes, Myhill-Nerode, minimalité, bornes PAC de l’oracle d’equivalence échantillonne.
Parcours knowledge graphs (SL-2, SL-3, SL-4, SL-8, ~205 min)
Pour les professionnels du web sémantique et des données structurees : EBL, RBL, FOIL sur clauses Horn, puis application directe sur des knowledge graphs réels avec rdflib et AMIE. Presuppose une familiarité avec RDF/SPARQL.
Seance de restitution : la table de pioche (61 exercices)
Modalite de la séance : chaque groupe choisit un exercice dans la table ci-dessous, le prépare, et le présente en séance. Resoudre l’exercice est le minimum attendu ; chaque exercice est assorti d’une question-twist (détaillée dans la cellule « Defi présentation » du notebook correspondant) qui fait partie intégrante de la présentation. Premier arrive, premier servi : annoncez votre choix pour éviter les doublons.
| # | Notebook | Exercice | Question-twist (en bref) |
|---|---|---|---|
| 1 | SL-1 | Ex. 1 — CBH avec ordre personnalise | Deux ordres d’exemples, deux hypothèses finales : pourquoi, a accuracy égale ? |
| 2 | SL-1 | Ex. 2 — Version Space sur sous-ensemble | Qu’est-ce qui rend un exemple informatif (frontières S et G) ? |
| 3 | SL-1 | Ex. 3 — Règles avec couverture | Compacite vs hypothèse AIMA : quel biais (rasoir d’Occam) préfère l’une a l’autre ? |
| 4 | SL-1 | Ex. 4 — Réflexion sur le biais conjonctif | Un domaine où ce biais est idéal, un où il est catastrophique (no free lunch) |
| 5 | SL-1 | Ex. 5 — La consistance sans Occam (aima) | Echantillonner les graines ne prouve pas la minimalité : quel algorithme exact le ferait ? |
| 6 | SL-2 | Ex. 1 — EBL differentiation symbolique | Exhiber une variabilisation trop agressive qui produit une règle compilee fausse |
| 7 | SL-2 | Ex. 2 — Filtrage des règles (opérationnalité) | Deux distributions de requêtes qui inversent le classement d’utilite des règles |
| 8 | SL-2 | Ex. 3 — Speedup EBL | Le utility problem (Minton 1990) : pourquoi apprendre plus finit par ralentir |
| 9 | SL-3 | Ex. 1 — Déterminations meteo | Une observation bruitee : quelle détermination minimale survit ? |
| 10 | SL-3 | Ex. 2 — RBL vs sélection aleatoire | Trouver le point de croisement ou la sélection statistique bat le RBL |
| 11 | SL-3 | Ex. 3 — Sélecteur hybride | Quelles garanties votre hybride hérite-t-il vraiment ? Contre-exemple construit |
| 12 | SL-4 | Ex. 1 — sibling avec FOIL |
Le rôle du biais de langage : que se passe-t-il sans le littéral X != Y ? |
| 13 | SL-4 | Ex. 2 — Opérateur W | Généralisation consistante mais fausse : pourquoi le bottom-up y est expose |
| 14 | SL-4 | Ex. 3 — Règles sur mini-KG | Monde clos vs PCA (cf SL-8) : quelle confiance est la bonne pour VOTRE KG ? |
| 15 | SL-4 | Ex. 4 — grandparent avec Popper |
Sans négatif arrière-grand-parent, quel programme plus court devient consistant ? |
| 16 | SL-5 | Ex. 1 — Apprendre grandmother/2 |
Pourquoi grandparent/2 (sans sexe) est plus facile — rôle des négatifs |
| 17 | SL-5 | Ex. 2 — Profondeur de la clause bottom | Croissance de la clause bottom avec la profondeur ; la cible reste-t-elle dans le treillis ? |
| 18 | SL-5 | Ex. 3 — Tolérance au bruit | Le score p - n - L comme argument MDL : quand préfère-t-il une clause imparfaite ? |
| 19 | SL-5 | Ex. 4 — Reduction de Plotkin | Subsomption vs implication : le cas des clauses récursives ou elles divergent |
| 20 | SL-5 | Ex. 5 — Aleph face au bruit | Memoriser l’exception, sur-généraliser ou payer L dans f : trois frontières face au même bruit |
| 21 | SL-6 | Ex. 1 — Direction de mode (Aleph) | Pourquoi (+,-) apprend et (+,+) échoue : ce que la direction des modes change pour l’entailment inverse |
| 22 | SL-6 | Ex. 2 — grandparent non récursif |
Cible a 2 sauts sans clôture : quel biais (max_clauses, pas de récursion) suffit, et l’invention de prédicats sert-elle encore ? |
| 23 | SL-6 | Ex. 3 — Robustesse au bruit (∂ILP vs symbolique) | Un faux positif injecte : ∂ILP degrade sa confiance, Popper exact n’a pas de notion de bruit — a quel prix chacun ? |
| 24 | SL-7 | Ex. 2 — LTN frere/oncle | Retirer les axiomes négatifs : pourquoi une LTN a besoin de négatifs explicites |
| 25 | SL-7 | Ex. 3 — Règle transitive ancestor |
Le modèle trivial « vrai partout » sature la règle : qu’est-ce qui l’évite ? |
| 26 | SL-7 | Ex. 4 — T-norm de Lukasiewicz | Gradients exactement nuls : qu’est-ce qu’une sémantique floue apprenable ? |
| 27 | SL-7 | Ex. 5 — Ablation de l’axiome 4 (LTNtorch) | Le négatif difficile (Marie, Pierre) est-il indispensable ? Contraste avec clingo (SL-8) |
| 28 | SL-8 | Ex. 1 — Nouvelle relation au KG | Règles redondantes (même extension, syntaxe différente) : comment AMIE les évite |
| 29 | SL-8 | Ex. 2 — PCA confidence | Construire un mini-KG ou la PCA confidence est trompeuse |
| 30 | SL-8 | Ex. 3 — Règles a 3 atomes | Explosion combinatoire : pourquoi AMIE impose des règles fermées, a quel prix |
| 31 | SL-8 | Ex. 4 — Reparation minimale (clingo) | Les reparations optimales sont ex-aequo : départager par des poids de confiance |
| 32 | SL-9 | Ex. 1 — Prompt personnalise | Changer de modèle LLM : que garantit vraiment l’oracle symbolique ? |
| 33 | SL-9 | Ex. 2 — Prompt direct vs CoT | Validation oracle vs plausibilite du texte : les deux métriques peuvent diverger |
| 34 | SL-9 | Ex. 3 — Detection d’hallucinations | Le detecteur suppose un monde clos : que devient-il en monde ouvert (cf SL-8) ? |
| 35 | SL-9 | Ex. 4 — Taux d’hallucination du vrai LLM | Maximiser le taux de validation ou le nombre de règles validees par appel ? |
| 36 | SL-10 | Ex. 1 — Le langage « contient abb » | Certificat de minimalité : un suffixe distinguant pour chaque paire d’états (Myhill-Nerode) |
| 37 | SL-10 | Ex. 2 — Fiabilité de l’EQ échantillonnée | Relier le taux de réussite empirique à la borne PAC ; construire une distribution adverse |
| 38 | SL-10 | Ex. 3 — Contre-exemples : prefixes vs suffixes | Le pire cas qui fait exploser la table d’observation (Rivest-Schapire) |
| 39 | SL-10 | Ex. 4 — Oracle bruite | Reparer L* par vote majoritaire : surcout en requêtes et probabilité residuelle d’erreur |
| 40 | SL-11 | Ex. 1 — Etendre le schéma (marie_avec) |
Le mineur redecouvre la symetrie injectee par l’oracle : règle ou tautologie ? |
| 41 | SL-11 | Ex. 2 — Politique de conflit a sources | Truth discovery : estimer la fiabilité des sources en même temps que les faits |
| 42 | SL-11 | Ex. 3 — Le bon seuil n’existe pas | Vraie et fausse règle a confiance égale (0.67) : quel signal au-dela du seuil ? |
| 43 | SL-11 | Ex. 4 — Empoisonnement bout-en-bout | Classer les defenses par étage du pipeline ; ou s’arrete la provenance ? |
| 44 | SL-12 | Ex. 1 — Variation de profondeur | Trade-off capacité vs sur-apprentissage : combien de couches pour quel régime ? |
| 45 | SL-12 | Ex. 2 — Porte favorite d’un neurone isole | Quelle porte (AND/NAND/XOR) l’apprentissage favorise-t-il pour MNIST ? |
| 46 | SL-12 | Ex. 3 — Robustesse au bruit pixel | La discretisation booleenne aide-t-elle face au bruit vs un MLP équivalent ? |
| 47 | SL-1b | Ex. 1 — Erreur nulle contre soi-même (Lean) | Spécialiser trueError_self : quel quantificateur la structure Distribution rend-il gratuit ? |
| 48 | SL-1b | Ex. 2 — Masse des échantillons (Lean) | sampleWeight_sum_one : pourquoi la Fubini discrète suffit-elle sans théorie de la mesure ? |
| 49 | SL-1b | Ex. 3 — Symétrie du désaccord (Lean) | trueError_comm : que dit la symétrie sur l’interprétabilité de l’erreur comme distance ? |
| 50 | SL-12b | Ex. 1 — Spectre de EXACT2 (poids de Hamming) | Degré Fourier contre degré PTF : lequel ment sur la complexité ? |
| 51 | SL-12b | Ex. 2 — Sinkhorn sur ligne uniforme | Une permutation unique au coût minimal prouve-t-elle que le routage « a choisi » ? |
| 52 | SL-12b | Ex. 3 — Instance séparant SA et PT | Qu’est-ce qui rend une instance « dure » pour une seule température ? |
| 53 | SL-13 | Ex. 1 — Tâche à rôles sémantiques (argmax_pos) | Quand les rôles ne sont plus des positions mais des étiquettes, la TPR émerge-t-elle encore ? |
| 54 | SL-13 | Ex. 2 — Constituent surgery sémantique | La permutation des rôles 0↔︎1 dans la TPR produit-elle la sortie attendue pour la séquence aux rôles permutés ? |
| 55 | SL-13 | Ex. 3 — Seuil de capacité et TPR | Quel d_model marque le point d’inflexion entre compression forcée et TPR non-nécessaire ? |
| 56 | SL-14 | Ex. 1 — Rejet statistique anticipé (ν=10) | En combien de points un mauvais candidat meurt-il, et pourquoi ν=10 rend-il le test quasi immunisé aux faux positifs ? |
| 57 | SL-14 | Ex. 2 — Addition relativiste récursive | La symétrie généralisée se déclenche deux fois de suite : jusqu’où peut-on empiler les vitesses ? |
| 58 | SL-14 | Ex. 3 — Frontière de bruit | À quel niveau de bruit la forme relativiste disparaît-elle du front — et que mesure vraiment la table 3 du papier ? |
| 59 | SL-15 | Ex. 1 — Top-k par confiance | Le hint complet ne rend que −18 % là où une fixation isolée vaut −63 % : quelle tête garder, et pourquoi la confiance du MLP n’est pas le juge du gain ? |
| 60 | SL-15 | Ex. 2 — Réfutation des conjectures | Détecter les arêtes en conflit : comment une conjecture peut-elle être fausse au sens de l’oracle et pourtant profitable au solveur ? |
| 61 | SL-15 | Ex. 3 — Réparation gloutonne | Retirer les fixations conflictuelles jusqu’à zéro conflit : le hint réparé conserve-t-il le gain, ou paie-t-il le coût de sa réparation ? |
Note : dans SL-7, le premier exercice de la numérotation interne est un exemple guide ; les exercices à piocher sont Ex. 2 à Ex. 5.
Notebooks
| # | Notebook | Contenu | Durée |
|---|---|---|---|
| 1 | SL-1 - Apprentissage Logique | CBH, Version Space, Candidate Elimination | 50 min |
| 1 (C#) | SL-1 - Apprentissage Logique (Twin C#) | Jumeau C# — CBH (Current-Best-Hypothesis) + Candidate Elimination / Version Space implémentés from-scratch en C# pur (type system + HashSet<>, pas de lib externe ML) (See #4956) |
50 min |
| 1b (Lean) | SL-1b - Apprentissage PAC formel (Lean natif) | Compagnon Lean natif — le lake learning_theory_lean exécuté au kernel lean4-wsl : modèle PAC, borne de Valiant classe finie, agnostique, Hoeffding-Chernoff, perceptron Novikoff + serrage (See #11703) |
40 min |
| 2 | SL-2 - Apprentissage et Connaissance | EBL, introduction au RBL (déterminations) | 45 min |
| 2 (C#) | SL-2 - Apprentissage et Connaissance (Twin C#) | Jumeau C# — EBL (chaînage avant + unification, arbre de preuve, variabilisation) + RBL (vérification de détermination) from-scratch (See #4956) | 50 min |
| 3 | SL-3 - Apprentissage Basé sur la Pertinence | Treillis des déterminations, MINIMAL-CONSISTENT-DET, RBL vs sklearn | 50 min |
| 3 (C#) | SL-3 - RBL (Twin C#) | Jumeau C# — Treillis des déterminations, MINIMAL-CONSISTENT-DET (BFS), PAC bound, information mutuelle from-scratch (See #4956) | 50 min |
| 4 | SL-4 - Programmation Logique Inductive | FOIL, résolution inverse, clauses Horn, knowledge graphs, Popper (LFF) | 55 min |
| 4 (C#) | SL-4 - ILP (Twin C#) | Jumeau C# — FOIL (gain Quinlan) + résolution inverse (V/W) + unification from-scratch, mini-KG (See #4956) | 50 min |
| 5 | SL-5 - Résolution Inverse et Progol | LGG de Plotkin, theta-subsomption, clause bottom, recherche Progol | 60 min |
| 5 (C#) | SL-5 - Résolution Inverse (Twin C#) | Jumeau C# — LGG de Plotkin, θ-subsomption (skolemisation + backtracking), clause bottom (saturation bornée + variabilisation), recherche Progol (score p − L) from-scratch (See #4956) |
55 min |
| 6 | SL-6 - Moteurs ILP modernes | Aleph, Metagol, Popper, ∂ILP (Lernd) sur ancestor/2 (moteurs réels) |
65 min |
| 6 (C#) | SL-6 - Moteurs ILP (Twin C#) | Jumeau C# — FOIL relationnel from-scratch (FOIL_Gain de Quinlan, couverture extensionnelle par backtracking, récursion ancestor/2 = cas de base + pas récursif), benchmark profondeur 5-20, verdict SOTA des 4 moteurs externes (Aleph/Metagol/Popper=RECOVERABLE-MACHINE, ∂ILP=INTRINSIC) (See #4956) |
45 min |
| 7 | SL-7 - Intégration Neuro-Symbolique | T-norms, prédicats neuronaux, LTN, DeepProbLog | 55 min |
| 8 | SL-8 - ILP Moderne et Knowledge Graphs | rdflib, AMIE rule mining, complétion KG, ASP avec clingo | 55 min |
| 8 (C#) | SL-8 - KG mining (Twin C#) | Jumeau C# — KG familial dotNetRDF 3.4.1, AMIE rule mining from-scratch (clauses Horn 1-2 atomes, JOIN relationnel subject-indexé), PCA confidence, complétion KG 5→14, saturation fixpoint, arbre généalogique ASCII (See #4956) | 50 min |
| 9 | SL-9 - LLMs et Apprentissage Symbolique | Prompting, extraction de règles, vérification symbolique (Gemini 3.5 Flash optionnel) | 50 min |
| 10 | SL-10 - Apprentissage Actif d’Automates | L* d’Angluin, table d’observation, requêtes MQ/EQ, Myhill-Nerode | 60 min |
| 10 (C#) | SL-10 - L* Angluin (Twin C#) | Jumeau C# — DFA, ObservationTable (S/E/T), requêtes MQ/EQ, conjecture DFA, contre-exemple (Angluin/Maler-Pnueli), oracle bruité + L* borné, forward sum-product + agrégation d’evidence from-scratch (See #4956) | 60 min |
| 11 | SL-11 - Capstone Neuro-Symbolique | Pipeline 6 étages : extraction LLM, oracle, KG, mining, inférence avec provenance, QA | 90 min |
| 12 | SL-12 - Réseaux de Portes Logiques Différentiables | difflogic (Petersen NeurIPS 2022) : portes logiques apprises par descente de gradient, discrétisation en circuit booléen, inférence ultra-rapide | 45 min |
| 12b | SL-12b - Synthèse Logique Spectrale | Fourier booléen exact (FWHT), PTF ternaires, routage Sinkhorn, quantification + Metropolis/parallel tempering avec oracle exact (Pavlov arXiv 2601.13953) (See #14366) | 75 min |
| 12b’ | SL-12b’ - Reproduction Pavlov DLS (recherche) | Reproduction CPU Phase 1+2 de Pavlov (arXiv 2601.13953) : Walsh exacte, routeur linéaire signé vs Sinkhorn-constrained, mesure de séparation, verdict honnête (See #14366) | 25 min |
| 13 | SL-13 - DISCOVER léger : diagnostic TPR | Diagnostic DISCOVER (McCoy et al. arXiv:2608.29530) sur GRU 1 couche : TPR par ALS (role × filler), réinjection décodeur, constituent surgery, white-box TPR vs embeddings atomiques, balayage capacité d_model ∈ {8,16,32,48}, régularisation L2,1 — conclusion bornée (structure approximative, pas exacte) (See #14366) | 25 min |
| 13b | SL-13b - TPR × SAE : deux lectures des mêmes états cachés | Confrontation de la lecture TPR de SL-13 à un dictionnaire SAE top-k entraîné par l’organe réel ict/sae_dictionary.py (série ICT) : sélectivité aux facteurs (position, symbole) contre null apparié, prédiction géométrique rang 1 (non soutenue à ces effectifs, verdict exploratoire), double perturbation (permutation de blocs de coordonnées — contrôle structurel — vs ablation SAE dirigée, contrôles appariés en activité), généralisation encode-only — CPU borné, conclusion bornée (See #14366) |
30 min |
| 14 | SL-14 - AIFeynman : découvrir des équations | Régression symbolique AI Feynman 2.0 (Udrescu et al., NeurIPS 2020) sur l’énergie cinétique relativiste : symétries lues dans les gradients, front de Pareto complexité-précision, exécuté dans le conteneur aifeynman:sl14 (See #14366) |
75 min |
| 15 | SL-15 - Conjectures apprises pour un vérificateur symbolique | Neural diving en doctrine SL : MLP de solutions sœurs → conjectures (fixations) offertes à CP-SAT ; décomposition par conjecture (300/300 aidantes, médiane −63 %), hint complet −18 % malgré ~25 % d’arêtes conflictuelles (42/~168), boucle conjecture → réfutation → réparation exécutée (42 conflits → 0), seconde famille couverture (hint −15,9 %, réparation coûteuse) (See #17605) | 40 min |
Contenu détaillé
SL-1-LogicalLearning.ipynb
| Section | Contenu |
|---|---|
| Domaine restaurant | Attributs, exemples AIMA, hypothèses comme conjonctions |
| Consistance | Faux positifs/négatifs, vérification d’hypothèses |
| Généralisation/Spécialisation | Opérations fondamentales, hiérarchie de généralité |
| CBH | Algorithme Current-Best-Hypothesis (AIMA Fig 19.2) |
| Version Space | Candidate Elimination, G-set et S-set (AIMA Fig 19.3) |
| Prédiction | Stratégies unanime, conservateur, majority |
| Limites | Sensibilité au bruit, incapacité à représenter les disjonctions |
SL-1b-LogicalLearning-Lean-Native.ipynb
| Section | Contenu |
|---|---|
| Modèle PAC | Distribution (poids ℝ normalisés), Hypothesis, trueError — une distribution construite à la main (Dcoin sur Fin 2) |
| Échantillon | sampleWeight, normalisation sampleWeight_sum_one (Fubini discrète) |
| Borne classe finie | erm_error_bound, uniform_concentration, union bound, pac_finite_class_bound (Valiant : m ≥ (1/ε)(ln \|H\| + ln(1/δ))) |
| Agnostique | sampleProb_mono, pac_agnostic_generalization |
| Concentration | Markov → Chernoff → Hoeffding (queues + concentration bilatérale), estimateur sans biais sampleExpect_empError_eq_trueError |
| Perceptron | Trajectoire perceptronWeights, borne de Novikoff (align_growth, norm_bound, novikoff_mistake_bound), serrage (witnessPts, novikoff_bound_is_sharp) |
| Exercices | 3 preuves à compléter (sorry stubs, convention C.1) : trueError_self, sampleWeight_sum_one, trueError_comm |
SL-2-KnowledgeBasedLearning.ipynb
| Section | Contenu |
|---|---|
| Cadre général | Contrainte d’entraînement, EBL vs RBL vs KBIL |
| EBL - Principe | Exemple de Zog, 4 étapes (expliquer, variabiliser, extraire, simplifier) |
| EBL - Arithmétique | Simplification d’expressions, arbre de preuve |
| EBL - Implémentation | Classe ArithmeticEBL complète |
| EBL - Efficacité | Opérationalité vs généralité, prolifération de règles |
| RBL - Introduction | Déterminations, vérification fonctionnelle, réduction d’espace (approfondi dans SL-3) |
Parité .NET : SL-2-KnowledgeBasedLearning-Csharp.ipynb est le jumeau C# (.NET Interactive) — EBL (chaînage avant + unification, arbre de preuve, variabilisation) et RBL (vérification de détermination) implémentés from-scratch, sans lib ML. Marathon parité .NET ⇄ Python (#4956).
Parité .NET : SL-5-InverseResolution-Csharp.ipynb est le jumeau C# (.NET Interactive) — LGG (Plotkin), θ-subsomption (skolemisation + backtracking), clause bottom (saturation bornée + variabilisation), recherche Progol (score
p−L) implémentés from-scratch, sans lib ML. Marathon parité .NET ⇄ Python (#4956).
SL-3-RelevanceLearning.ipynb
| Section | Contenu |
|---|---|
| Déterminations | Formalisme, monotonie, minimalité, check_determination() |
| Treillis des déterminations | build_determination_lattice(), visualisation ASCII, up-set |
| MINIMAL-CONSISTENT-DET | Implémentation détaillée, données moléculaires, cas d’échec disjonctif (restaurant) |
| Sélection guidée | RBL vs sklearn (information mutuelle), comparaison |
| Analyse PAC | Réduction exponentielle, bornes d’échantillonnage |
| Web Sémantique | Parallel RBL <-> OWL (FunctionalProperty, hasKey) |
SL-4-InductiveLogicProgramming.ipynb
| Section | Contenu |
|---|---|
| Clauses Horn | Représentation, Literal, HornClause, unification |
| FOIL | Algorithme top-down, gain FOIL, littéraux candidats |
| FOIL pas-à-pas | Trace détaillée sur le problème ancestor |
| Résolution inverse | Opérateurs V (absorption) et W (identification) |
| Knowledge Graphs | Règles AMIE, triples RDF, SPARQL CONSTRUCT |
| Popper (Learning From Failures) | Programme récursif optimal, ablation sans récursion, vérification SWI-Prolog (kernel Linux/WSL) |
| Exercices | sibling, opérateur W, règles sur KG |
SL-5-InverseResolution.ipynb
| Section | Contenu |
|---|---|
| Clauses et couverture | covers() par backtracking, validation de la cible grandfather/2 |
| LGG de Plotkin | Anti-unification, généralisation la moins générale, sur-spécialisation |
| Theta-subsomption | subsumes() par skolemisation, le treillis de généralité |
| Clause bottom | Saturation bornée, entailment inverse, variabilisation |
| Recherche Progol | Sous-ensembles connectés du corps de bottom, score f = p - L, consistance dure |
| Cover-set | Boucle d’apprentissage de théorie complète |
SL-6-ModernILP.ipynb
| Section | Contenu |
|---|---|
| Quatre paradigmes | Tableau comparatif : entailment inverse, MIL, LFF, ILP différentiable |
| Tâche partagée | KB parent/ancestor, clôture transitive, positifs/négatifs monde clos |
| Aleph | Entailment inverse via janus_swi (SWI-Prolog), modes et déterminations |
| Metagol | Meta-Interpretive Learning, métarègles, invention de prédicats (metagol.pl vendore, BSD-3) |
| Popper | Learning From Failures, biais déclaratif, sous-processus kernel Linux |
| dILP (Lernd) | ILP différentiable, descente de gradient, tolérance au bruit (env conda dédié, GPL-3.0) |
| Synthèse | Quatre machineries pour un même concept ; forces et angles morts |
| Exercices | Direction de mode (Aleph), grandparent non récursif, robustesse au bruit (dILP) |
Parité .NET : SL-6-ModernILP-Csharp.ipynb est le jumeau C# (.NET Interactive) — FOIL relationnel from-scratch (FOIL_Gain de Quinlan, recherche dans le graphe de raffinement, couverture extensionnelle par backtracking, récursion
ancestor/2via les clauses déjà apprises), benchmark de scalabilité (profondeur 5-20), et verdict SOTA des 4 moteurs externes du twin Python (Aleph/Metagol/Popper=RECOVERABLE-MACHINE Prolog/ASP, ∂ILP=INTRINSIC TensorFlow). Marathon parité .NET ⇄ Python (#4956).
SL-7-NeuroSymbolic.ipynb
| Section | Contenu |
|---|---|
| T-norms / T-conorms | Opérateurs logiques différentiables |
| Prédicats neuronaux | Fonctions P(x) -> [0,1] apprises |
| LTN | Logique Tensorielle simplifiée |
| Raisonnement guidé | Règles logiques guidant l’entraînement neuronal |
| DeepProbLog | Programmation logique probabiliste + prédicats neuronaux |
SL-8-KnowledgeGraphs-ILP.ipynb
| Section | Contenu |
|---|---|
| Knowledge Graphs | Construction avec rdflib |
| AMIE rule mining | Découverte de règles de Horn sur KG |
| Complétion | Inférence de nouveaux triples |
| ASP avec clingo | Validation croisée de la complétion, récursion (ancestorOf), contraintes d’intégrité (pont série Tweety) |
Parité .NET : SL-8-KnowledgeGraphs-ILP-Csharp.ipynb est le jumeau C# (.NET Interactive) — KG familial (14 personnes, 47 triples) construit avec dotNetRDF 3.4.1, AMIE rule mining from-scratch (clauses Horn 1-2 atomes, JOIN relationnel par subject-indexing, PCA confidence), complétion de graphe (+9 triples
grandparentOf, 5→14) et saturation fixpoint (ré-application Datalog non-récursive, 0 nouveau triple : point fixe atteint dès la complétion). Vérdict SOTA du twin Python : rdflib/dotNetRDF=SOTA-OK, clingo ASP=INTRINSIC en .NET (récursion/réparation = principalement un solveur externe). Marathon parité .NET ⇄ Python (#4956).
SL-9-LLM-SymbolicLearning.ipynb
| Section | Contenu |
|---|---|
| LLMs et raisonnement | Forces et limites pour le raisonnement symbolique |
| Parseur de règles | Extraction de règles IF-THEN depuis du texte |
| Vérification symbolique | Cohérence formelle des sorties LLM |
| Boucle LLM-Symbolique | Génération + vérification + feedback |
SL-10-ActiveAutomataLearning.ipynb
| Section | Contenu |
|---|---|
| Apprentissage actif | Passif vs actif, le cadre MAT (Minimally Adequate Teacher) |
| DFA | Représentation, exécution, langage du mot « se termine par a » |
| Table d’observation | Prefixes S, suffixes E, fermeture et cohérence |
| L* | Algorithme complet d’Angluin (1987), construction de l’hypothèse |
| Contre-exemples | Traitement, raffinement, convergence vers le DFA minimal |
| Oracle échantillonné | Équivalence approchée par tirage, lien PAC |
| Théorie | Myhill-Nerode, minimalité, bornes sur le nombre de requêtes |
Parité .NET : SL-10-ActiveAutomataLearning-Csharp.ipynb est le jumeau C# (.NET Interactive) — L* d’Angluin implémenté from-scratch (DFA, ObservationTable S/E/T, requêtes d’appartenance et d’équivalence, conjecture, contre-exemples Angluin/Maler-Pnueli, oracle d’équivalence échantillonné PAC, oracle bruité + L* borné, algorithme forward sum-product et agrégation d’evidence), BCL .NET 9 seule (0 NuGet). Marathon parité .NET ⇄ Python (#4956).
SL-11-Capstone-NeuroSymbolic.ipynb
| Section | Contenu |
|---|---|
| Corpus | Saga « Atelier Verne » : 13 énoncés, 2 pieges factuels |
| Étage 1 - Extraction | LLM (Gemini 3.5 Flash) ou simulateur : texte -> triples candidats |
| Étage 2 - Oracle | Validation typée + contraintes fonctionnelles (cf SL-8) |
| Étage 3 - KG | Knowledge graph valide (cf SL-7) |
| Étage 4 - Mining | AMIE-lite : découverte de règles avec confiance standard (cf SL-4/SL-7) |
| Étage 5 - Inférence | Chainage avant avec provenance ; le dérivé peut violer l’oracle (lecon d’architecture) |
| Étage 6 - QA | Question 2 sauts : réponse KG (dérivation citée) vs réponse LLM seule |
SL-12-DifferentiableLogicGateNetworks.ipynb
| Section | Contenu |
|---|---|
| Motivation | Registre discret du neuro-symbolique (vs SL-7 continu) : neurone = porte logique binaire apprise parmi 16 |
| Prise en main | LogicLayer(in, out), GroupSum(k, tau), choix device/implementation |
| Entraînement MNIST 20x20 | Précision : ~85-92% (référence GPU, 5000 iters) ; le notebook exécute une config CPU réduite (N_ITERS=2000) -> ~79% |
| Inspection | Distribution des 16 portes apprises par les neurones |
CompiledLogicNet |
Export C compilé, ~1M images/s sur 1 core CPU (RECOVERABLE-MACHINE, gcc) |
| Note historique | Remplace la veille Neurosymbolic-EML/ (atome NAND continu, parité-3 dégénéré) — voir _archive/2026-07-04-Neurosymbolic-EML-precurseur-SL12/ |
Référence : Petersen et al., Deep Differentiable Logic Gate Networks, NeurIPS 2022 (arXiv 2210.08277).
SL-12b-SpectralLogicSynthesis.ipynb
| Section | Contenu |
|---|---|
| Convention testée | True ↔︎ +1 (x = 2b−1), portes définies sur les signes, convention croisée bit/signes sur les 4 tables n=2 (le piège du smoke test 6/7 de l’artefact Pavlov) |
| Walsh-Hadamard | Caractères χ_S, transformée naïve vs papillon O(n·2^n), reconstruction exacte (f = H(D f̂), sans division), spectres MAJ3/PARITE3/ET3/OU3 + Parseval |
| Fourier vs PTF | Coefficients exacts contre poids ternaires {−1,0,+1} : énumeration exhaustive 3^4=81 sur n=2 (16/16 représentables, degrés qui divergent), quantification naïve 8/16 |
| Sinkhorn | Projection vers le polytope de Birkhoff, 3 régimes de température, métrique Σ P² ∈ [1,n], ex-aequo mesurés (4 permutations au coût minimal) sans surclaim de permutation |
| Recherche discrète | Oracle exact Hamming 16 entrées, quantification E=2/16, glouton bloqué en minimum local, Metropolis (α = min(1, e^(−ΔE/T))) et parallel tempering (swap exact) à budget égal, vérité terrain exhaustive 3^11 = 177 147 (92 optima globaux) |
| Pont SL-12 ↔︎ spectral | Spectre exact du circuit AND(OR(x1,x2), XNOR(x3,x4)) : degré 4, 8/16 coefficients, χ_{3,4} dominant ; tableau de confrontation portes locales/câblage fixe vs structure spectrale/composition |
Référence : Gorgi Pavlov, Differentiable Logic Synthesis: Spectral Coefficient Selection via Sinkhorn-Constrained Composition (arXiv 2601.13953) — digestion EPIC #14366 grain G2.
SL-12b-PavlovDLS-Reproduction.ipynb
| Section | Contenu |
|---|---|
| Convention | Lecture de la convention Pavlov (DLS Sinkhorn), artefact reproduit |
| Opérations | Énumération : Phase 1 (16 opérations n=2), Phase 2 (11 opérations temporelles n=4) |
| Modèle linéaire signé | Routeur simple sur représentation Walsh, discrimination directe |
| Sinkhorn-constrained routing | Proxy du routeur Pavlov (projection itérative vers le polytope de Birkhoff) |
| Phase 1 | Discrimination linéaire vs Sinkhorn sur les 16 opérations, multi-seed (4 seeds) |
| Phase 2 | Opérations temporelles n=4 (3 seeds) ; où le Sinkhorn aide vraiment |
| Verdict honnête | Linéaire signé 100 % sur 27 opérations vs proxy 0-25 % — défaut de gradient proxy, pas réfutation du claim Pavlov |
| Reproductibilité | Environnement verrouillé, commandes reproductibles, CPU-only (NumPy seul) |
| Exercices | 3 (opération 2-variables rompant la non-régression, opération Phase 2 où le Sinkhorn aide, extension n=3) — tranche de recherche, non inscrits à la table de pioche |
Référence : Gorgi Pavlov, Differentiable Logic Synthesis (arXiv 2601.13953) — reproduction bornée Phase 1+2, EPIC #14366 grain G1.
SL-13-Discover-TPR.ipynb
| Section | Contenu |
|---|---|
| Vocabulaire TPR | role_pos(t) ⊗ filler_symbole(x_t) (Smolensky 1990), lecture guidée |
| Trois tâches symboliques | Copy, reverse, interleave — séquences générées programmatiquement |
| Entraînement | GRU 1-2 couches sur architectures CPU petites |
| Diagnostic DISCOVER | Premier passage : factorisation role × filler par moindres carrés alternés (ALS) |
| Réinjection décodeur | TPR reconstruite injectée dans le décodeur, qualité d’approximation mesurée |
| Constituent surgery | Permutation des rôles, effet attendu sur la sortie |
| White-box TPR | Withheld role-filler, contrôle white-box TPR vs embeddings atomiques |
| Capacité et régularisation | Balayage d_model ∈ {8, 16, 32, 48} ; régularisation L2,1 sur les rôles |
| Conclusion bornée | Structure TPR approximative et fonctionnellement exploitée — pas une implémentation symbolique exacte |
| Exercices | 3 (généralisation du diagnostic, constituent surgery sémantique, seuil de capacité) — table de pioche 53-55 |
Référence : McCoy et al., DISCOVER (arXiv 2608.29530) — diagnostic léger, EPIC #14366 grain G6.
Concepts clés
| Concept | Explication | Notebook |
|---|---|---|
| Hypothèse FOL | Conjonction de contraintes sur les attributs | SL-1 |
| Version Space | Ensemble de toutes les hypothèses consistantes | SL-1 |
| CBH | Maintient une seule hypothèse ajustée incrémentalement | SL-1 |
| EBL | Extrait une règle générale d’un seul exemple par déduction | SL-2 |
| RBL | Identifie les attributs pertinents via les déterminations | SL-2 |
| Détermination | Relation fonctionnelle entre attributs | SL-2, SL-3 |
| KBIL | Apprentissage inductif guidé par la connaissance | SL-2 |
| Treillis des déterminations | Ensemble partiellement ordonné des sous-ensembles d’attributs | SL-3 |
| MINIMAL-CONSISTENT-DET | Trouve la détermination minimale par taille croissante | SL-3 |
| FOIL | Apprentissage top-down de clauses Horn | SL-4 |
| Résolution inverse | Apprentissage bottom-up par opérateurs V et W | SL-4 |
| Clause Horn | Règle logique avec au plus un littéral positif | SL-4 |
| Unification | Trouve une substitution rendant deux termes égaux | SL-4 |
| ILP | Apprentissage de programmes logiques a partir d’exemples | SL-4 |
| Learning From Failures (Popper) | ILP moderne : recherche de programme optimal par contraintes (clingo + Prolog) | SL-4 |
| LGG | Généralisation la moins générale de deux clauses (Plotkin) | SL-5 |
| Theta-subsomption | Ordre de généralité décidable entre clauses (∃θ : Cθ ⊆ D) | SL-5 |
| Clause bottom | Clause la plus spécifique couvrant un exemple (entailment inverse) | SL-5 |
| Progol | Recherche de clause guidée par la clause bottom | SL-5 |
| Aleph | Entailment inverse, l’implémentation de référence de Progol (SWI-Prolog) | SL-6 |
| Metagol (MIL) | Apprentissage meta-interpretatif : métarègles + invention de prédicats | SL-6 |
| dILP | ILP différentiable : règles pondérées apprises par descente de gradient | SL-6 |
| T-norm | Généralisation différentiable de AND | SL-7 |
| DeepProbLog | Programmation logique probabiliste + prédicats neuronaux | SL-7 |
| Knowledge Graph | Graphe orienté de triples (sujet, prédicat, objet) | SL-8 |
| AMIE | Rule mining sur knowledge graphs incomplets | SL-8 |
| LLM-Symbolique | Boucle de rétroaction LLM + vérification formelle | SL-9 |
| Apprentissage actif | L’apprenant choisit ses questions au lieu de subir un échantillon | SL-10 |
| MAT | Minimally Adequate Teacher : oracle d’appartenance + équivalence | SL-10 |
| Table d’observation | Structure (S, E, T) fermée et cohérente dont on lit un DFA | SL-10 |
| Myhill-Nerode | Classes d’équivalence de suffixes = états du DFA minimal | SL-10 |
| Provenance | Trace de dérivation attachée à chaque fait inféré | SL-11 |
| Pipeline neuro-symbolique | LLM aux extrémités, validation et inférence symboliques au centre | SL-11 |
| Caractère de Walsh | χ_S(x) = ∏_{k∈S} x_k — base orthonormée des fonctions {−1,+1}^n | SL-12b |
| PTF ternaire | sign(Σ w_S χ_S) avec w ∈ {−1,0,+1} — objet distinct des coefficients de Fourier exacts | SL-12b |
| Routage Sinkhorn | Projection itérative vers le polytope de Birkhoff ; sous ex-aequo, la limite n’est pas une permutation | SL-12b |
Prérequis
Connaissances requises
- Python de base (fonctions, classes, tuples, dictionnaires)
- Logique propositionnelle (conjonctions, prédicats)
- Notions d’apprentissage supervisé (classification binaire)
Environnement Python
Aucune dépendance externe pour SL-1, SL-2, SL-5 et SL-10 (bibliothèque standard Python 3.10+ uniquement). SL-3 utilise scikit-learn et numpy pour la comparaison avec la sélection statistique. SL-7 utilise torch et LTNtorch pour les Logic Tensor Networks. SL-8 utilise rdflib et clingo (module Python officiel Potassco, installé silencieusement par le notebook — même moteur ASP que le binaire utilisé par la série Tweety via scripts/install_clingo.py). SL-9 et SL-11 utilisent python-dotenv et openai pour les appels LLM optionnels via OpenRouter (Gemini 3.5 Flash) : copiez .env.example vers .env et renseignez OPENROUTER_API_KEY ; sans clé, un simulateur déterministe prend le relais et le notebook s’exécute intégralement. SL-12 utilise torch et difflogic. SL-12b s’exécute CPU uniquement avec numpy (algèbre, transformées, recherche) et matplotlib (spectres, cartes Sinkhorn, trajectoires) — aucune autre dépendance.
SL-4 est en bibliothèque standard pour l’essentiel, mais sa section finale Popper requiert un environnement Unix : Popper utilise signal.SIGALRM, absent de Windows — le notebook s’exécute donc sur un kernel Python Linux (kernel python3-wsl via WSL sous Windows, kernel natif sous Linux/macOS). Dépendances de la section (installées silencieusement par le notebook) : SWI-Prolog >= 9.1.12 (ppa:swi-prolog/stable), popper-ilp épinglé à v4.4.0 (la 5.0 exige Python >= 3.14), janus_swi, clingo, setuptools < 81. Si Popper est indisponible, les cellules de la section l’indiquent et se sautent proprement — le reste du notebook tourne sur n’importe quel kernel Python.
SL-6 (Moteurs ILP modernes) partage l’exigence kernel Linux/WSL : Aleph et Metagol s’exécutent via janus_swi sur SWI-Prolog (Metagol est fourni dans vendor/metagol/, licence BSD-3), Popper en sous-processus, et ∂ILP via un environnement conda dédié lernd-dilp (TensorFlow, licence GPL-3.0 — importé uniquement, jamais vendore). Chaque moteur indisponible se signale proprement (drapeau HAS_*) sans interrompre le notebook.
FAQ / Troubleshooting
rdflib ne s’installe pas ou plantage à l’exécution
SL-8 dépend de rdflib pour manipuler les knowledge graphs RDF. Si l’installation échoue :
pip install rdflibSi rdflib plante avec une erreur de compilateur C sur les parsers RDF/XML : installez lxml comme fallback pip install lxml, ou utilisez un environnement conda (conda install -c conda-forge rdflib).
scikit-learn : version incompatible avec Python 3.10+
SL-3 utilise scikit-learn pour la comparaison information mutuelle vs déterminations. Si vous avez une erreur lors de l’import :
pip install -U scikit-learn numpyLes versions >= 1.3 de scikit-learn sont compatibles avec Python 3.10-3.12.
MemoryError sur le treillis des déterminations (SL-3)
Le treillis des déterminations croît exponentiellement avec le nombre d’attributs. Si vous travaillez avec des datasets > 50 attributs :
- Limitez l’analyse aux 20-30 attributs les plus informatifs en premier
- Utilisez
check_determination()pour filtrer avant de construire le treillis complet - Le notebook inclut un paramètre
max_attributespour contrôler cette taille
Jupyter / kernels Python
- Si le kernel Python n’apparaît pas :
python -m ipykernel install --user --name python3 --display-name "Python 3" - Si Papermill ne tourne pas les notebooks :
pip install papermill - En cas de conflit de sortie entre cellules : redémarrez le kernel avant exécution complète
Ressources
Références
- Russell & Norvig, Artificial Intelligence: A Modern Approach, 3e/4e éd., Chapitre 19
- Tom Mitchell, Machine Learning, Chapitres 2 (Concept Learning) et 11 (EBL)
- AIMA Python Code - Implémentations de référence
Structure des fichiers
SymbolicLearning/
├── SL-1-LogicalLearning.ipynb              # CBH, Version Space
├── SL-1-LogicalLearning-Csharp.ipynb       # Jumeau C# (.NET Interactive) — CBH + Candidate Elimination from-scratch, parité #4956
├── SL-1b-LogicalLearning-Lean-Native.ipynb # Compagnon Lean natif (kernel lean4-wsl) — théorie PAC + perceptron de Novikoff, See #11703
├── SL-2-KnowledgeBasedLearning.ipynb        # EBL, RBL
├── SL-2-KnowledgeBasedLearning-Csharp.ipynb # Jumeau C# (.NET Interactive) — EBL + RBL, parité #4956
├── SL-3-RelevanceLearning.ipynb             # Treillis, MINIMAL-CONSISTENT-DET, RBL vs sklearn
├── SL-3-RelevanceLearning-Csharp.ipynb # Jumeau C# (.NET Interactive) — Treillis + MINIMAL-CONSISTENT-DET + PAC + MI, parité #4956
├── SL-4-InductiveLogicProgramming.ipynb     # FOIL, résolution inverse, knowledge graphs
├── SL-4-InductiveLogicProgramming-Csharp.ipynb  # Jumeau C# (.NET Interactive) — FOIL + V/W + unification, parité #4956
├── SL-5-InverseResolution.ipynb             # LGG, theta-subsomption, clause bottom, Progol
├── SL-5-InverseResolution-Csharp.ipynb      # Jumeau C# (.NET Interactive) — LGG + clause bottom + Progol, parité #4956
├── SL-6-ModernILP.ipynb                     # Aleph, Metagol, Popper, dILP (Lernd) — moteurs réels
├── SL-6-ModernILP-Csharp.ipynb            # Jumeau C# (.NET Interactive) — FOIL relationnel + récursion ancestor/2, parité #4956
├── SL-7-NeuroSymbolic.ipynb                 # T-norms, LTN, DeepProbLog
├── SL-8-KnowledgeGraphs-ILP.ipynb           # rdflib, AMIE rule mining
├── SL-8-KnowledgeGraphs-ILP-Csharp.ipynb    # Jumeau C# (.NET Interactive) — dotNetRDF KG + AMIE from-scratch + PCA + saturation, parité #4956
├── SL-9-LLM-SymbolicLearning.ipynb          # LLMs + vérification symbolique (Gemini 3.5 Flash optionnel)
├── SL-10-ActiveAutomataLearning.ipynb        # L* d'Angluin, apprentissage actif d'automates
├── SL-10-ActiveAutomataLearning-Csharp.ipynb # Jumeau C# (.NET Interactive) — L* d'Angluin (DFA/ObservationTable/MQ-EQ/forward) from-scratch, parité #4956
├── SL-11-Capstone-NeuroSymbolic.ipynb       # Capstone : pipeline neuro-symbolique 6 étages
├── SL-12-DifferentiableLogicGateNetworks.ipynb # Portes logiques différentiables (difflogic), discrétisation en circuit booléen
├── SL-12b-SpectralLogicSynthesis.ipynb      # Synthèse logique spectrale : FWHT, PTF ternaires, Sinkhorn, MCMC (#14366 G2)
├── SL-12b-PavlovDLS-Reproduction.ipynb      # Reproduction Pavlov DLS Phase 1+2 : linéaire signé vs Sinkhorn-constrained, verdict honnête (#14366 G1)
├── SL-12b-PavlovDLS-Reproduction-output.ipynb # Artefact d'exécution papermill (non indexé catalogue)
├── SL-13-Discover-TPR.ipynb                 # Diagnostic DISCOVER (TPR role × filler, ALS, réinjection, surgery, white-box) sur GRU 1 couche (#14366 G6)
├── SL-13-Discover-TPR-output.ipynb          # Artefact d'exécution papermill (non indexé catalogue)
├── assets/
│   └── readme/                              # Figures du README (sl10-dfa-target.png) + MANIFEST.md
├── tests/
│   └── test_aima_knowledge.py               # Tests du vendored reference/aima_knowledge.py
├── vendor/
│   ├── metagol/                             # Metagol (BSD-3) pour SL-6
│   └── difflogic/                           # difflogic (Petersen 2022) pour SL-12
├── _archive/
│   └── 2026-07-04-Neurosymbolic-EML-precurseur-SL12/  # Précurseur EML de SL-12 (archivé)
├── .env.example                             # Modèle de configuration LLM (OpenRouter)
├── requirements.txt                         # Dépendances optionnelles
├── reference/
│   ├── AIMA_Ch19_Knowledge_in_Learning.md   # Notes de référence
│   └── aima_knowledge.py                     # AIMA Ch.19 (CBH, Version Space, MINIMAL-CONSISTENT-DET) — vendored aima-python
└── README.md                                # Cette documentation
Statistiques catalogue à jour
Le bloc CATALOG-STATUS (lignes 5-10) appartient à l’automatisation catalogue (règle catalog-pr-hygiene) : il ne s’édite jamais à la main sur une branche. Il couvre actuellement 23 notebooks (BETA=21, ALPHA=2) — SL-13 y a été inscrit lors de sa livraison, mais pas SL-12b’ ; la régén quotidienne du catalog-cron aligne le bloc — et l’entrée JSON des deux derniers — sur les 24 notebooks du disque (BETA=22, ALPHA=2 ; consistance éventuelle <24 h). Les compteurs en prose de ce README décrivent le disque (24), l’automatisation réconcilie les marqueurs générés.
Table 6 phases × 4 colonnes (disque = 24 notebooks, soit 22 stabilisés + 2 jumeaux C# en stabilisation, état cible réconcilié par le catalog-cron). Ce décompte de 24 couvre les notebooks présents sur le disque — dont SL-1b, compagnon Lean natif, qui n’entre dans aucune phase (il prouve, en parallèle de la phase 1, les garanties d’échantillonnage que SL-1 implémente), et les deux derniers livrés, SL-12b’ (reproduction Pavlov DLS) et SL-13 (diagnostic DISCOVER). Le « 24 notebooks » de la vue d’ensemble compte donc 24 notebooks, jamais deux totaux pour le même ensemble :
| Phase | Notebooks | Maturité | Contenu clé |
|---|---|---|---|
| Phase 1 — Fondations inductives | 2 (SL-1 + jumeau C#) | BETA=2 | Current-Best-Hypothesis, Version Space, Candidate Elimination (AIMA chapitre 19) ; limites face au bruit et aux disjonctions. Jumeau C# : CBH + Candidate Elimination from-scratch en C# pur |
| Phase 2 — Guidé par la connaissance | 4 (SL-2, SL-3 + jumeaux C# SL-2, SL-3) | BETA=4 | EBL (Explanation-Based Learning, 4 étapes : expliquer, variabiliser, extraire, simplifier) ; RBL (Relevance-Based Learning) + treillis des déterminations + MINIMAL-CONSISTENT-DET ; comparaison RBL vs sklearn (information mutuelle). Jumeaux C# : EBL+unification (SL-2), treillis+PAC+information mutuelle (SL-3) from-scratch |
| Phase 3 — Programmes logiques (ILP) | 4 (SL-4, SL-5 + jumeaux C# SL-4, SL-5) | BETA=4 | FOIL top-down + opérateurs V/W de la résolution inverse ; LGG de Plotkin, θ-subsomption, clause bottom par entailment inverse, recherche à la Progol ; pont vers knowledge graphs (AMIE, SPARQL CONSTRUCT). Jumeaux C# : FOIL+V/W+unification+mini-KG (SL-4), LGG+clause bottom+Progol (SL-5) from-scratch |
| Phase 4 — Moteurs ILP modernes | 2 (SL-6 + jumeau C#) | BETA=2 | Quatre moteurs réels face à face sur ancestor/2 : Aleph (entailment inverse), Metagol (MIL, invent. prédicats), Popper (LFF, v4.4.0 épinglé), ∂ILP Lernd (différentiable, env conda lernd-dilp GPL-3.0 importé). Jumeau C# : FOIL relationnel from-scratch + récursion + benchmark profondeur 5-20 |
| Phase 5 — Neuro-symbolique | 5 (SL-7, SL-8, SL-9, SL-13 + jumeau C# SL-8) | BETA=4, ALPHA=1 | T-norms différentiables, LTN, DeepProbLog ; rdflib + AMIE rule mining + complétion KG + ASP clingo ; boucle LLM-symbolique d’extraction et vérification (Gemini 3.5 Flash optionnel via OpenRouter) ; diagnostic DISCOVER (TPR role × filler par ALS, réinjection décodeur, constituent surgery, white-box TPR vs embeddings atomiques) sur GRU 1 couche CPU. Jumeau C# : KG familial dotNetRDF 3.4.1 + AMIE from-scratch + PCA + complétion 5→14 + saturation (ALPHA en stabilisation) |
| Phase 6 — Actif + capstone | 6 (SL-10, SL-11, SL-12, SL-12b, SL-12b’ + jumeau C# SL-10) | BETA=5, ALPHA=1 | L* d’Angluin (table d’observation, requêtes MQ/EQ, Myhill-Nerode, bornes PAC) ; capstone pipeline neuro-symbolique 6 étages avec LLM réel + provenance ; réseaux de portes logiques différentiables (difflogic, Petersen NeurIPS 2022) ; synthèse logique spectrale SL-12b : FWHT exacte, PTF ternaires, Sinkhorn, Metropolis/parallel tempering avec oracle exact ; reproduction Pavlov DLS SL-12b’ : routeur linéaire signé vs Sinkhorn-constrained sur 27 opérations, verdict honnête. Jumeau C# : DFA + ObservationTable + contre-exemples + oracle bruité + agrégation d’evidence (ALPHA en stabilisation) |
| Total | 24 (SL-1b compagnon hors phases) | BETA=22, ALPHA=2 | Python 3.10+ stdlib + .NET Interactive 1.4+ (sauf SL-3 sklearn+numpy, SL-4/SL-6 SWI-Prolog+Popper+janus_swi kernel Linux/WSL, SL-7 torch+LTNtorch, SL-8 rdflib+clingo, SL-9/SL-11 OpenRouter optionnel, SL-12 difflogic+torch, SL-12b numpy+matplotlib, SL-13 torch CPU+numpy) ; SL-1b : kernel lean4-wsl (lake learning_theory_lean) |
Note explicite maturité 22 BETA + 2 ALPHA : la série SymbolicLearning compte 24 notebooks sur disque (15 Python + 8 jumeaux C# marathon parité #4956 + le compagnon Lean natif SL-1b), couverts par l’automatisation catalogue (marqueur et JSON s’alignent sur les 24 à la régén catalog-cron, consistance éventuelle <24 h). La maturité n’est plus 100 % PRODUCTION comme avant le marathon parité : les 13 notebooks Python historiques sont PRODUCTION-equivalent (AIMA chapitre 19, implémentations de référence stables vendored dans reference/aima_knowledge.py) ; les 8 jumeaux C# livrés en marathon #4956 (SL-1, SL-2, SL-3, SL-4, SL-5, SL-6, SL-8, SL-10) sont BETA par défaut, sauf SL-8-C# (KG mining : verdict SOTA du twin Python note clingo ASP=INTRINSIC en .NET) et SL-10-C# (L* forward sum-product + agrégation bayésienne : algorithme le plus récent, vérifications de bornes encore en cours) qui restent ALPHA au catalogue. Les notebooks s’exécutent localement avec Python 3.10+ stdlib pour SL-1/2/5/7/10/13, scikit-learn+numpy pour SL-3, rdflib+clingo pour SL-8, et SWI-Prolog >= 9.1.12+janus_swi+popper-ilp==4.4.0 pour SL-4/SL-6 via kernel Linux/WSL ; numpy+matplotlib pour SL-12b ; torch CPU+numpy pour SL-13 ; les 8 jumeaux C# s’exécutent sur .NET Interactive 1.4+ (Microsoft.dotnet-interactive).
Conformité C.1 (stubs sans raise NotImplementedError) : tous les notebooks respectent la convention notebook 2026-04-26 — patterns de stub corrects (pass / print("Exercice a completer") / return None / result = None # TODO etudiant). La table de pioche de 55 exercices (section dédiée) couvre les angles de chaque algorithme : biais conjonctif de CBH, utility problem de Minton (EBL), borne PAC de l’oracle d’équivalence (L*), seuil de confiance pour les règles AMIE, tasks à rôles sémantiques pour le diagnostic TPR, etc. Dépendances : requirements.txt (scikit-learn, numpy, matplotlib, rdflib, clingo, python-dotenv, openai, janus_swi, torch CPU, setuptools < 81) + SWI-Prolog >= 9.1.12 externe (kernel Linux/WSL pour SL-4/SL-6) + conda env lernd-dilp (TensorFlow) pour ∂ILP. Vendored : vendor/metagol/ (BSD-3), aima_knowledge.py (MIT AIMA).
Posture EPITA-IS / Argumentum : la série SymbolicLearning n’a pas de port EPITA-IS Argumentum (contrairement à Argument_Analysis qui aligne 15 PRs MERGED upstream-verbatim byte-equal — voir EPIC #4960 Argumentum). C’est une série 100 % originale du dépôt, ancrée sur AIMA chapitre 19, avec choix assumé d’inclure la table de pioche de 55 exercices en pied de README (vs un décompte minimal) — le README fait 714 lignes, dense, cohérent avec la densité mathématique de la série.
Écosystème MCP et parenté cross-lane
Trois outils d’infrastructure MCP (cohérent avec cycles 19-31) :
MCP Jupyter (
mcp__jupyter-papermill__*) — note bug #5211 (mode async ignorekernel_name, re-exec =nbconvert --execute --ExecutePreprocessor.kernel_name=python3 --timeout=600). SymbolicLearning notebooks utilisent majoritairement kernel Python 3 (SL-1/2/3/5/7/8/9/10) ; SL-4 et SL-6 requièrent kernel Linux/WSL pour SWI-Prolog+Popper+Aleph+Metagol (Popper utilisesignal.SIGALRMabsent de Windows). Chaque notebook déclare son kernel en cellule metadata, et les sections indisponibles se signalent par drapeauHAS_*sans interrompre l’exécution.Validation pre-commit (
.pre-commit-config.yaml) —gitleaksdétecte les secrets inline ; le validateur notebookvalidate_pr_notebooks.pyenforce C.1 (stubs sansNotImplementedError) et C.2 (notebooks commités AVEC outputs,execution_count != null). Note spécifique SymbolicLearning : les clés API LLM (OPENROUTER_API_KEY) vivent dans.env(jamais en clair dans un notebook), avec.env.exampledocumenté ; sans clé, un simulateur déterministe prend le relais dans SL-9 et SL-11 (le notebook s’exécute intégralement, doctrine anti-théâtre : « pas de sortie maquée, pas de fallback qui prétend être un appel LLM »).MCP QC Cloud (
mcp__qc-mcp-lite__*) — backtest QuantConnect partagé. SymbolicLearning n’utilise pas QC Cloud directement, mais partage avec QC la même rigueur méthodologique : reproductibilité déterministe (graines fixées pour les générateurs pseudo-aléatoires dans les splits train/test de SL-3, bornes PAC documentées pour L* d’Angluin dans SL-10), pas de résultat maquée (les 55 exercices de la table de pioche ont des questions-twist qui forcent l’étudiant à dévier du cas nominal). C’est la version académique de la doctrine « un résultat non vérifié n’est pas un résultat ».
Table parenté cross-lane 15 lignes × 3 colonnes (SymbolicLearning se situe au croisement de plusieurs séries du dépôt — c’est l’une des séries les plus parentées) :
| Notebook SymbolicLearning | Série parente | Pont conceptuel |
|---|---|---|
SL-1 CBH/Version Space |
Tweety (logique propositionnelle) + Lean (formalisation AIMA) | Les hypothèses = conjonctions de littéraux (PL) ; Candidate Elimination peut être formalisé en Lean via Finset pour borner le Version Space |
SL-2 EBL |
Lean + Planners | L’arbre de preuve EBL est une tactique de preuve Lean (compiler une preuve en règle opérationnelle) ; analogue aux heuristiques de planification compilées |
SL-3 déterminations |
SemanticWeb (RDFS/OWL) | RBL ↔︎ OWL FunctionalProperty + hasKey : parallèle direct, exposé dans la section “Web Sémantique” du notebook |
SL-4 FOIL + KG + Popper |
SemanticWeb + Tweety | AMIE rule mining sur triples RDF (SPARQL CONSTRUCT) ↔︎ FOIL sur clauses Horn ; Popper (LFF) ↔︎ ASP clingo (Tweety argument frameworks) |
SL-5 Inverse Resolution + Progol |
Tweety | θ-subsomption = subsomption logique ; entailment inverse = inverse de la résolution ; la clause bottom est un objet mathématique Tweety-nature |
SL-6 4 moteurs ILP |
Tweety + Planners + ML | Metagol (MIL, invention de prédicats) ↔︎ Tweety ASP ; ∂ILP différentiable ↔︎ heuristic learning planners ; Popper ↔︎ clingo ASP |
SL-7 Neuro-symbolique |
Tweety (logique floue / pondérée) + ML (réseaux neuronaux) | T-norms différentiables = logique floue ; LTN = logique tensorielle = pont Tweety pondéré ⇄ MLP |
SL-8 KG mining + clingo |
SemanticWeb + Tweety | rdflib ↔︎ SemanticWeb OWL ; AMIE rule mining ↔︎ SemanticWeb RDFS ; clingo ASP ↔︎ Tweety (même binaire via scripts/install_clingo.py) |
SL-9 LLM-Symbolique |
Argument_Analysis + GenAI | Boucle LLM + vérification = doctrine anti-théâtre Argument_Analysis (sentinelle fabricated_true) ; prompts LLM ↔︎ GenAI prompting structuré |
SL-10 L* Angluin |
Tweety (logique temporelle / automates) + Lean | Myhill-Nerode = théorème formalisable en Lean ; L* sur automates finis ↔︎ Tweety LTL/CTL (vérification de modèles) |
SL-11 Capstone 6 étages |
Argument_Analysis + SemanticWeb + Tweety + GenAI | Pipeline bout-en-bout : LLM (GenAI) → extraction → oracle (Tweety ASP) → KG (SemanticWeb) → mining (AMIE = SymbolicLearning) → inférence avec provenance (Argument_Analysis Restitution_3_Actes pattern) |
SL-12 Portes logiques différentiables |
ML (réseaux de neurones) + GenAI | difflogic (Petersen NeurIPS 2022) = registre discret du neuro-symbolique : neurone = porte logique binaire apprise parmi 16, puis discrétisée en circuit booléen interprétable (vs SL-7 continu) |
SL-12b Synthèse logique spectrale |
ML (représentations apprises) + Lean (analyse de sensibilité) | Fourier booléen exact = changement de représentation certifié au bit près ; PTF ternaires et routage Sinkhorn de Pavlov (arXiv 2601.13953) — suite potentielle de l’EPIC #14366 (bornes de sensibilité formelles) |
SL-12b' Reproduction Pavlov DLS |
ML (mesures multi-seed, verdict honnête) + Lean (formalisation éventuelle de la borne de discrimination) | Reproduction bornée Phase 1+2 du claim Pavlov : routeur linéaire signé vs Sinkhorn-constrained sur 27 opérations — borne inférieure mesurée et dette identifiée (gradient exact du Sinkhorn-Knopp) pour les tranches ultérieures de l’EPIC #14366 |
SL-13 Diagnostic DISCOVER / TPR |
ML (représentations apprises) + Lean (formalisation éventuelle du diagnostic) | TPR = sum_t role_pos(t) ⊗ filler_symbole(x_t) (Smolensky 1990) ; diagnostic DISCOVER (McCoy et al. arXiv:2608.29530) montre qu’un réseau développe une structure approximative et non une implémentation exacte — pont direct avec le questionnement interprétabilité du dépôt, second grain de l’EPIC #14366 sur le versant TPR (vs SL-12b spectrale) |
Paragraphe « effet de composition — SymbolicLearning = carrefour spectre-apprentissage inter-paradigmes » :
Là où Argument_Analysis (cycle 31) déploie le carrefour informel/formel anti-théâtre inter-couches (lecture LLM ⇄ Tweety/Lean), SmartContracts (cycle 30) le carrefour trust/privacy inter-séries (confiance ⇄ confidentialité ⇄ décision collective), Planners (cycle 29) la dualité simulation/proof intra-série (Python ⇄ Lean sur l’admissibilité d’heuristique), SemanticWeb (cycle 28) le carrefour données structurées (standards W3C + GraphRAG anti-hallucination), SymbolicLearning déploie le carrefour spectre-apprentissage inter-paradigmes : c’est la seule série du dépôt à aligner quatre paradigmes d’apprentissage (inductif pur → guidé par la connaissance → ILP → neuro-symbolique) dans un parcours en spirale 6 phases où chaque phase répond à une limite de la précédente :
- Phase 1 (CBH/Version Space) limite : sensible au bruit, ne représente pas la disjonction
- → Phase 2 (EBL/RBL) réponse : la connaissance du domaine accélère (peu de données + interprétabilité)
- → Phase 3 (FOIL/Inverse Resolution/Progol) réponse : passer des attributs aux programmes logiques (clauses Horn + récursion)
- → Phase 4 (4 moteurs ILP) réponse : comparer les machineries sur une même tâche récursive (
ancestor/2) — Aleph, Metagol, Popper, ∂ILP - → Phase 5 (T-norms/KG mining/LLM boucle) réponse : rigidité logique → différentiabilité + vérifiabilité
- → Phase 6 (L* + capstone) réponse : opacité neuronale → provenance + apprentissage actif
Le capstone SL-11 est l’un des rares pipelines neuro-symboliques bout-en-bout du dépôt (avec vrais appels LLM Gemini 3.5 Flash, oracle de validation symbolique Tweety-nature, KG SemanticWeb-nature, mining AMIE SymbolicLearning-nature, inférence avec provenance Argument_Analysis-nature, confrontation LLM vs KG). C’est la convergence opérationnelle des phases précédentes en une boucle où le LLM et la logique se corrigent mutuellement.
Doctrine symétrique — AIMA chapitre 19 + EPITA-IS Argumentum : SymbolicLearning est ancrée sur AIMA chapitre 19 (Russell & Norvig, 3e/4e éd.) avec aima_knowledge.py vendored (référence MIT) — la cohérence algorithmique est garantie par les implémentations canoniques. Aucune série ne peut à elle seule aligner les 4 paradigmes d’apprentissage en 6 phases — c’est la particularité structurelle de SymbolicLearning dans le dépôt.
Cross-séries Bridges
| Série | Lien | Connection |
|---|---|---|
| Tweety | Argumentation | Les logiques formelles de Tweety (propositionnelle, FOL) sont le fondement des hypothèses symboliques |
| SemanticWeb | Représentation de connaissances | RDFS/OWL formalisent les déterminations et les hiérarchies de généralité |
| Planners | Planification | EBL compile les théories en règles opérationnelles, similaire aux heuristiques de planification |
| Lean | Preuves formelles | L’arbre de preuve EBL est analogue aux arbres de preuve Lean 4 |
| Lecture transversale | La mer qui monte | Grille de lecture grothendieckienne du depot : changement de représentation, certification A/B/C |
Version 1.4.0 — Septembre 2026 — ajout SL-13 (diagnostic DISCOVER / TPR, EPIC #14366 grain G6) : table de pioche 55 exercices, phase 5 étendue au versant structurel (TPR approximative vs exacte), parenté cross-lane complétée. Total : 24 notebooks (BETA=22, ALPHA=2, réconciliés par le catalog-cron). EPIC #3975 tranche symboliclearning.
Conclusion / Prochaines étapes
Ce que vous avez appris
Cette série traverse le spectre complet de l’apprentissage, du pur-inductif au pur-neuro-symbolique — un arc qu’aucune autre série du dépôt ne couvre dans son entièreté. Vous avez vu les deux extrémités et le point d’équilibre :
Phase 1-2 — apprendre avec peu de données et beaucoup de connaissance : CBH, Candidate Elimination, Version Space (SL-1) puis EBL (compiler une preuve en règle opérationnelle) et RBL (identifier les attributs déterminants via le treillis des déterminations, SL-2/SL-3). Quand la collecte de données est coûteuse ou impossible, la connaissance du domaine bat la statistique brute.
Phase 3 — apprendre des programmes logiques : FOIL (top-down), résolution inverse et ses opérateurs V/W (bottom-up), LGG de Plotkin, θ-subsomption, clause bottom, recherche à la Progol (SL-4/SL-5) — jusqu’à l’ILP moderne avec Popper (Learning From Failures) qui retrouve le programme récursif optimal et le fait vérifier en SWI-Prolog.
Phase 4 — comparer les moteurs ILP réels : quatre machineries face à face sur
ancestor/2— Aleph (entailment inverse), Metagol (MIL), Popper (Learning From Failures) et ∂ILP (différentiable) (SL-6), pour voir où chaque paradigme gagne ou échoue.Phase 5 — réconcilier le symbolique et le connexionniste : T-norms différentiables, Logics Tensor Networks, DeepProbLog (SL-7) ; rule mining sur knowledge graphs réels avec rdflib + AMIE (SL-8) ; boucle LLM-symbolique d’extraction et vérification (SL-9) ; diagnostic DISCOVER (TPR role × filler par ALS, réinjection, surgery, white-box vs atomique) sur GRU 1 couche CPU (SL-13).
Phase 6 — apprentissage actif, capstone, portes logiques et spectre : L* d’Angluin (SL-10), le capstone SL-11 qui assemble un pipeline neuro-symbolique complet — LLM aux extrémités, validation et inférence symboliques au centre, avec provenance —, les réseaux de portes logiques différentiables (SL-12, difflogic) comme registre discret du neuro-symbolique, et SL-12b qui ouvre le versant spectral : Fourier booléen exact, PTF ternaires, Sinkhorn mesuré et recherche discrète MCMC contre un oracle exact.
La thèse de la série, posée dès l’introduction et démontrée par le capstone : data-driven et knowledge-driven ne s’opposent pas, ils se complètent. Chaque phase est une réponse à une limite de la précédente — le bruit motive la connaissance, la rigidité logique motive la différentiabilité, l’opacité motive la provenance.
Prochaines étapes
- Approfondir les fondations formelles : Tweety (logique propositionnelle, FOL, argumentation — le langage dans lequel les hypothèses symboliques sont exprimées) et Lean (la preuve EBL y devient une tactique, la clause bottom un objet mathématique). SL-4/SL-5 y trouvent leur ancrage rigoureux.
- Passer à l’échelle sur le web de données : SemanticWeb (RDFS/OWL formalisent les déterminations et les hiérarchies de généralité que RBL exploite) — naturellement après SL-7 (knowledge graphs + AMIE).
- Décider sous incertitude : la logique apprise produit des règles certaines ; Probas (Infer.NET) et GameTheory traitent le cas où la certitude n’est pas atteignable — le complément probabiliste du capstone SL-11.
- Du capstone à la production : reprenez le pipeline SL-11 et remplacez l’oracle de validation par une vérification Lean ou une cohérence Tweety — c’est le pont naturel vers une IA générative ancrée sur du vérifiable.
- Relisez la table de pioche (55 exercices) et la Lecture transversale ci-dessus : elles recoupent les six phases sous des angles différents (grothendieckien : changement de représentation, certification A/B/C).
Le fil rouge
L’apprentissage symbolique est l’art de réussir là où les données seules échouent — non pas en ignorant la connaissance, mais en l’écrivant explicitement, en l’induisant des exemples, puis en la réconciliant avec le connexionnisme. Le geste profond de la série : transformer une théorie du domaine (une détermination, une preuve, une ontologie) en un programme qui apprend — et prouver, au capstone, que l’on peut tenir les deux bouts, LLM et logique, dans une même boucle où chacun corrige l’autre.