Ce notebook explore les reseaux de portes logiques differentiables : un modèle qui apprend des combinaisons de portes logiques (AND, OR, NAND, XOR, …) par descente de gradient, puis se discretise en un reseau 100% booléen – interpretable-par-construction et tres rapide a l’inference une fois compile (de l’ordre de 1M images/s sur 1 core CPU ; valeur de la publication, non mesuree ici, cf. section 4).
Base sur Petersen et al., Deep Differentiable Logic Gate Networks, NeurIPS 2022 (arXiv 2210.08277).
Motivation et contexte historique
L’apprentissage neuro-symbolique vise a combiner la flexibilite des reseaux de neurones avec la verifiabilite et l’interpretabilite du symbolique. SL-7 (notebook précédent) l’a illustre cote continu : T-norms, Logique Tensorielle, DeepProbLog – la sortie d’un neurone reste une verite floue dans [0, 1].
SL-12 prend l’angle discret : chaque neurone devient une porte logique binaire apprise parmi 16 possibles. Trois proprietes en decoulent :
Interpretabilite native – un neurone = une porte. Le reseau entier est un circuit logique (quoique appris).
Discretisation automatique – après entrainement, le modèle s’evalue en booléen pur (binaire), pas en flottant.
Inference ultra-rapide – un million d’images MNIST par seconde sur un seul coeur CPU (Petersen 2022).
Ce notebook remplace une veille anterieure (SymbolicAI/Neurosymbolic-EML/, archivee le 2026-07-04) qui reimplementait a la main un << atome NAND continu >> sur parite-3 – workaround degenere (SOTA Prong A + B) au regard de difflogic : la vraie SOTA est une lib entrainee sur un problème reel (MNIST).
Plan
Prérequis : import difflogic, graines déterministes et sanity check CPU
Modèle difflogic : LogicLayer + GroupSum, chemin de référence CPU/PyTorch
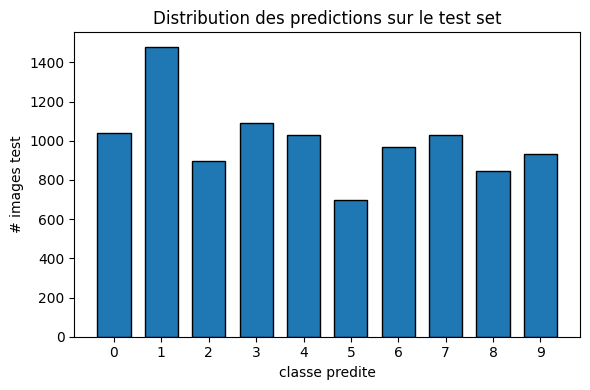
Inspection : distribution des prédictions sur le test set
CompiledLogicNet (RECOVERABLE-MACHINE) : export en C compilé
Note historique : EML/NAND, l’intuition que difflogic réalise en mature
Exercices
import os as _osimport randomimport sysimport numpy as npimport torchimport torch.nn as nn# difflogic : lib de Felix Petersen (NeurIPS 2022, arXiv 2210.08277), MIT.# Installation PyPI `pip install difflogic` requiert un CUDA Toolkit dont la version# correspond a torch.version.cuda (sinon RuntimeError sur la compilation de# l'extension C++/CUDA difflogic_cuda). Sur les machines ou aucune coherence n'est# possible, utiliser le fork `vendor/difflogic/` (CPU-mismatch safe) qui ajoute un# guard CUDA Toolkit + guard d'import dans la lib, permettant le mode CPU-only# `implementation='python'`.## # 1) Installation standard (CUDA Toolkit requis, meme version que torch) :# pip install difflogic# # 2) OU fork CPU-mismatch-safe :# pip install -e vendor/difflogic# Forcer le fork vendor/difflogic : le difflogic en site-packages contient 2# prints de debug `print(self.indices[0].dtype, self.indices[1].dtype)` qui# emettent `torch.int64 torch.int64` x24000 dans les outputs. Le fork vendor les# a retires (cf vendor/difflogic/difflogic/difflogic.py vs site-packages)._VENDOR = _os.path.join(_os.getcwd(), "vendor", "difflogic")if _os.path.isdir(_VENDOR): sys.path.insert(0, _VENDOR)import difflogic# Snapshot pedagogique de reference sur CPU : les connexions, les poids initiaux,# le batch de sanity check et le brassage MNIST sont tous reproductibles.SEED =42random.seed(SEED)np.random.seed(SEED)torch.manual_seed(SEED)torch.use_deterministic_algorithms(True)DEVICE ="cpu"print("difflogic : fork vendor charge")print(f"Python : {sys.version.split()[0]}")print(f"PyTorch : {torch.__version__}")print(f"CUDA dispo : {torch.cuda.is_available()}")print(f"Execution : {DEVICE} (snapshot reproductible)")print(f"Graine : {SEED} (Python, NumPy, PyTorch)")print("Algorithmes : deterministes")print(f" LogicLayer : {difflogic.LogicLayer}")print(f" GroupSum : {difflogic.GroupSum}")
Un LogicLayer(depth) est une couche ou chaque neurone de sortie est une des 16 portes logiques binaires (AND, OR, NAND, NOR, XOR, XNOR, IMPLIES, …). Pendant l’entrainement, chaque neurone a des poids reels et apprend en relajacion differentiable ; après passage en eval(), les poids sont seuilles a 0/1 et la porte est figee.
Le modèle complet est un Sequential PyTorch classique :
Le dataset MNIST 20x20 (propose par difflogic) contient 60 000 images d’entrainement et 10 000 de test, redimensionnees a 20x20 et binarisees par seuillage a 0.5. C’est volontairement modeste pour rester pedague : 400 pixels par image suffisent pour la classification des 10 chiffres avec une accuracy >80% sur un modèle difflogic de 3 couches (run commit = 2000 iters, voir cellule 9).
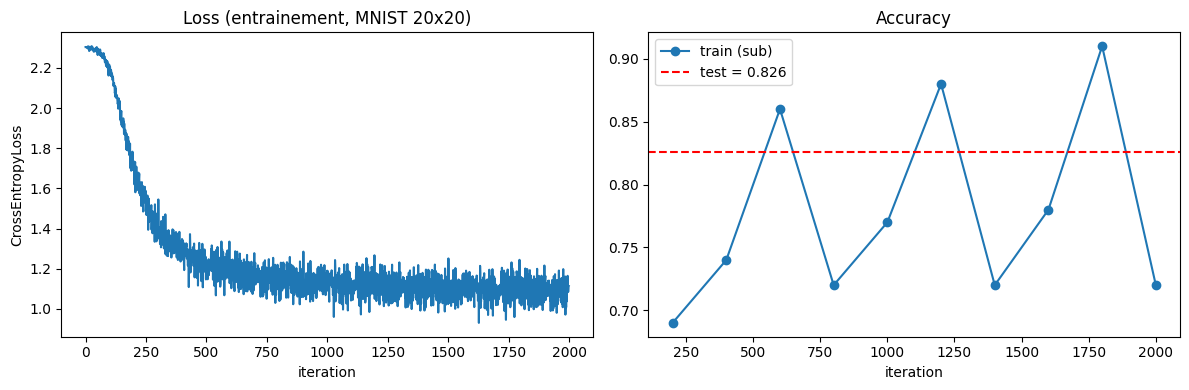
Test accuracy finale : 0.826
Modele trace         : 8bf7f242407101817f5653677040f59f9c2a9dc08a819356caf42824924c53fd
Lecture de la trajectoire d’apprentissage
Avec la graine 42, la perte passe de 1,715 à 1,114 entre les points de contrôle 200 et 2000. La tendance est descendante mais non monotone : elle remonte notamment à 1,175 puis 1,190, tandis que la précision du lot courant varie entre 0,690 et 0,910. Ces valeurs ne sont plus une réalisation aléatoire isolée : deux exécutions depuis des kernels neufs ont produit la même trajectoire et la même empreinte de modèle.
Cette variabilité locale s’explique d’abord par la mesure sur un seul mini-lot brassé à chaque point de contrôle : train_acc n’est pas une précision cumulée sur tout le jeu d’entraînement. Elle reflète aussi la différence entre les deux régimes du réseau. Pendant model.train(), les portes logiques discrètes sont remplacées par des fonctions réelles différentiables afin que la descente de gradient puisse ajuster leurs poids. Une variation continue de ces paramètres peut alors modifier la fonction logique privilégiée par une porte et produire une évolution irrégulière sur un mini-lot particulier. Pendant model.eval(), le réseau utilise au contraire sa configuration logique pour effectuer une évaluation cohérente sur l’ensemble de test.
Il ne faut donc pas comparer directement la précision ponctuelle du dernier mini-lot d’entraînement à la précision calculée sur tout le jeu de test : elles ne portent ni sur le même échantillon ni sur le même agrégat. Le snapshot déterministe obtient 0,826 (8261/10000) sur les 10 000 images de test, dans la fourchette pédagogique attendue pour ce modèle CPU à 2000 itérations. Le papier difflogic rapporte des résultats supérieurs avec une campagne et une architecture différentes ; la comparaison sert ici de repère, pas d’équivalence expérimentale. La section suivante inspecte les fonctions logiques apprises afin de relier cette trajectoire à la structure discrète du réseau.
3. Inspection des predictions
Chaque LogicLayer contient out_dim * 16 poids reels (self.weights, de shape (out_dim, 16)) : une distribution differentiable (softmax) sur les 16 portes logiques possibles, une par neurone. La porte apprise d’un neurone est weights.argmax(-1) dans [0, 15]. Chaque neurone dispose en outre de 2 connexions d’entree fixes (a, b) tirees a l’initialisation (connections='random') parmi les in_dim entrees – ce ne sont pas des poids, seulement le choix des deux entrees que la porte combine. D’ou le compte de parametres : 3 couches LogicLayer x out_dim * 16 = 3 x 2000 * 16 = 96 000 (cf. sortie cellule 5).
Les 16 portes avec leur index :
idx
00
01
10
11
porte
0
0
0
0
0
FALSE (0)
1
0
0
0
1
AND
2
0
0
1
0
a ET ¬b
3
0
0
1
1
a
4
0
1
0
0
¬a ET b
5
0
1
0
1
b
6
0
1
1
0
XOR
7
0
1
1
1
OR
8
1
0
0
0
NOR
9
1
0
0
1
XNOR
10
1
0
1
0
¬b
11
1
0
1
1
a OU ¬b
12
1
1
0
0
¬a
13
1
1
0
1
¬a OU b (a=>b)
14
1
1
1
0
NAND
15
1
1
1
1
TRUE (1)
Colonnes = sorties de la porte pour les entrees (a, b) dans l’ordre (0,0), (0,1), (1,0), (1,1). L’index idx est la table de verite 4 bits (bit de poids faible = sortie pour (0,0)), c’est-a-dire l’ecriture binaire de idx ; verifie sur bin_op(a, b, i) dans vendor/difflogic. Le neurone apprend la porte via weights.argmax(-1) qui renvoie cet idx.
Interpretation typique : les premières couches apprennent surtout des NAND / NOR (universalite logique) ; les couches profondes se specialisent en portes minoritaires (XOR) pour les decisions discriminantes. Dans ce notebook, on regarde la distribution des predictions de classe plutot que la distribution INTERNE des 16 portes par neurone (cette dernière necessiterait un acces direct aux poids weights.argmax(-1) de chaque LogicLayer).
# Distribution des predictions sur le test set (proxy de l'usage des classes apprises)indices = []with torch.no_grad():for x, y in test_loader: x = x.to(DEVICE).squeeze(1) logits = model(x) indices.extend(logits.argmax(dim=1).cpu().numpy().tolist())class_counts = np.bincount(indices, minlength=10)plt.figure(figsize=(6, 4))plt.bar(range(10), class_counts, edgecolor="black", width=0.7)plt.xticks(range(10))plt.xlabel("classe predite")plt.ylabel("# images test")plt.title("Distribution des predictions sur le test set")plt.tight_layout()plt.show()print(f"Predictions par classe : {class_counts.tolist()}")
Predictions par classe : [1039, 1479, 897, 1089, 1027, 696, 969, 1029, 845, 930]
Lecture chiffree — la distribution des predictions se somme et s’etale. Les dix compteurs rendus par Predictions par classe : [1039, 1479, 897, 1089, 1027, 696, 969, 1029, 845, 930] s’additionnent exactement a 10000 : tout le test set est passe, par lots de 100 comme charge en section 2. La moyenne par classe vaut 10000 / 10 = 1000, et l’etendue observee va de 696 (classe 5) a 1479 (classe 1) — un ecart de 783 entre les extremes : le modele vote « 1 » plus du double de « 5 » (1479 contre 696, or 696 x 2 = 1392 reste en dessous). L’accuracy globale de 0.826 laisse 1739 erreurs, et cette distribution montre qu’elles ne se repartissent pas uniformement : le classifieur porte un biais de prediction mesurable vers le 1. Sans matrice de confusion, elle mesure le biais, pas sa provenance — dire quelles vraies classes alimentent le surplus de 1 exigerait l’axe verite terrain.
4. Inference rapide : CompiledLogicNet (avance, RECOVERABLE-MACHINE)
Une fois le modèle entraine, difflogic peut le compiler en code C via CompiledLogicNet. Le binaire produit evalue le circuit logique directement sur des bits, sans aucun flottant ni boucle PyTorch. Le gain annonce par les auteurs (de l’ordre de x100 face au forward pass PyTorch) provient de Petersen et al. (NeurIPS 2022) : ce notebook ne le mesure pas, sa compilation locale ayant echoue juste en dessous.
Cette voie est marquee RECOVERABLE-MACHINE car elle necessite :
gcc dans le PATH (installable via choco install mingw sur Windows, brew install gcc ou xcode-select --install sur macOS, sudo apt install gcc sur Linux)
Un modèle déjà entraine et fige (eval mode)
Données d’entree booleennes (numpy ou torch)
Sa valeur pedagogique : montrer qu’un reseau de portes logiques, une fois appris, se reduit a un programme C de quelques kilooctets – illustration concrete de l’interpretable-par-construction.
# CompiledLogicNet : tentative reelle si gcc est disponible ; sinon la sortie# documente le prerequis machine manquant sans interrompre le notebook.import platformimport shutilif shutil.which("gcc") isNone:print("gcc absent -- RECOVERABLE-MACHINE (non execute)") _sys = platform.system()if _sys =="Windows":print("Pour activer : `choco install mingw` puis re-executer.")elif _sys =="Darwin":print("Pour activer : `brew install gcc` puis re-executer.")else:print("Pour activer : `sudo apt install build-essential` puis re-executer.")else:try: compiled = difflogic.CompiledLogicNet( model=model, num_bits=64, cpu_compiler="gcc", verbose=True ) compiled.compile(save_lib_path="sl12_compiled.so") x_bool =next(iter(test_loader))[0].squeeze(1).bool().numpy() out = compiled(x_bool)print(f"CompiledLogicNet OK : output shape {out.shape}")exceptExceptionas exc:print(f"CompiledLogicNet indisponible -- RECOVERABLE-MACHINE ({exc})")
Skipping torch.nn.Flatten layer (<class 'torch.nn.modules.flatten.Flatten'>).
Skipping GroupSum layer (<class 'difflogic.difflogic.GroupSum'>).
`layers` created and has 3 layers.
CompiledLogicNet indisponible -- RECOVERABLE-MACHINE (compilation exited with error code 1)
Lecture chiffree — ce que le compilateur retient, et l’echec documente. La sortie annonce Skipping torch.nn.Flatten layer puis Skipping GroupSum layer, avant created and has 3 layers : sur les 5 modules du Sequential de la section 1, l’export ne garde que les 3 LogicLayer — Flatten est de la mise en forme, GroupSum de l’agregation de logits, aucun des deux n’est un circuit de portes. Le compte se referme : 3 couches construites, 3 couches exportees. Et la tentative se termine par CompiledLogicNet indisponible -- RECOVERABLE-MACHINE (compilation exited with error code 1) : l’echec de la chaine C est affiche, verdict pose, rien de masque — le notebook poursuit sur le chemin PyTorch de reference sans sortie fabriquee.
Note historique : EML/NAND –> difflogic
Avant SL-12, deux notebooks Neurosymbolic-EML/ (archive 2026-07-04) exploraient une réimplémentation maison d’un << atome NAND continu >> (EML(x, y) = e^x - Log y, d’après Germany, Abdo & Bakarji 2026). L’intuition était juste – un primitif différentiable dont la sémantique est celle d’une porte logique discrète – mais :
Le problème utilisé (parité-3) était dégénéré au sens SOTA Prong B (un moteur SOTA n’y montre aucun avantage sur une baseline triviale).
L’implémentation maison était un workaround au regard de difflogic (Petersen NeurIPS 2022), qui fournit la même intuition en bibliothèque mature.
SL-12 remplace ces notebooks : la lib difflogic est utilisée directement (cf cellule << Prérequis >>), le problème est MNIST 20x20 (non-trivial), et l’atome de difflogic est booléen plutôt que continu – un changement de registre qui réalise l’intuition EML/NAND en plus robuste.
Voir SymbolicAI/SymbolicLearning/_archive/2026-07-04-Neurosymbolic-EML-precurseur-SL12/ pour le matériel préservé (ANALYZE –> MERGE note historique –> ARCHIVE avec header).
Exercice 1 – Variation de profondeur (TODO)
Faites varier le nombre de couches LogicLayer du modèle (entre 1 et 5 couches) et observez l’effet sur l’accuracy test. Trade-off attendu : plus de couches = plus de capacite, mais plus de risque de sur-apprentissage et plus de temps d’entrainement.
# TODO etudiant :# 1. Construire une boucle qui definit model avec 1, 2, 3, 4, 5 couches# 2. Entrainer chaque modele 2000 iterations# 3. Comparer les accuracies test# 4. Tracer une courbe depth vs accuracyresults = {} # depth -> accuracyprint("Exercice 1 a completer -- variance de profondeur.")
Exercice 1 a completer -- variance de profondeur.
Exercice 2 – Porte favorite d’un neurone isole (TODO)
Construisez un modèle difflogic a une seule couche LogicLayer et entrainez-le brievement. Quelles portes sont favorisees en debut d’apprentissage ? Quelle est la distribution finale ?
Hypothese typique : la porte la plus discriminante pour MNIST est XOR entre pixels symetriques, mais l’apprentissage privilegie souvent AND ou NAND pour leur stabilite de gradient.
# TODO etudiant :# 1. Model = Flatten -> LogicLayer(400, 10) -> GroupSum(k=10, tau=1)# 2. Entrainer 2000 iterations# 3. Inspecter les poids de la couche unique (weights.argmax(-1) donne l'index de la porte par neurone)# 4. Conclure sur la porte favoriseemodel_1l =None# TODOfav_gate =None# TODOprint("Exercice 2 a completer -- porte favorite d'un neurone isole.")
Exercice 2 a completer -- porte favorite d'un neurone isole.
Exercice 3 – Robustesse au bruit pixel (TODO)
Ajoutez du bruit gaussien sur les pixels d’entree (flip de pixel avec probabilite p dans {0, 0.05, 0.1, 0.2}) et observez la degradation d’accuracy. difflogic etant binaire, on s’attend a une resilience superieure a un MLP equivalent car le modèle ne propage pas de petites perturbations flottantes – chaque pixel est 0 ou 1.
import numpy as npdef add_noise(x, p):"""Flip pixel avec probabilite p.""" mask = torch.rand_like(x.float()) < preturn torch.logical_xor(x.bool(), mask.bool())# TODO etudiant :# 1. Pour chaque p dans {0, 0.05, 0.1, 0.2}, evaluer le model.eval() sur test_loader bruite# 2. Tracer accuracy vs p# 3. Comparer a un MLP de capacite equivalente (torch.nn.Linear en 3 couches, activation ReLU)print("Exercice 3 a completer -- robustesse au bruit pixel.")
Exercice 3 a completer -- robustesse au bruit pixel.
Conclusion
Ce notebook a montre un reseau de portes logiques differentiables entraine sur MNIST 20x20. Trois proprietes en font une SOTA neuro-symbolique distincte de SL-7 :
Discret-par-construction : chaque neurone = une porte logique. Pas de flottant en inference.
Universalite : les 16 portes logiques sont Turing-completes (NAND seul). Le reseau peut en principe encoder n’importe quel circuit booléen.
Vitesse : CompiledLogicNet (option avancee, RECOVERABLE-MACHINE) compile le modèle en C. Les ordres de grandeur annonces par les auteurs (de l’ordre de 1M images/s sur 1 core CPU, ~x100 face au forward pass PyTorch) viennent de Petersen et al. (NeurIPS 2022) : ce notebook ne les mesure pas, sa propre tentative de compilation s’etant terminee par CompiledLogicNet indisponible -- RECOVERABLE-MACHINE (compilation exited with error code 1) (section 4).
Positionnement dans la serie SymbolicLearning : SL-7 = logique floue continue (T-norms/LTN), SL-12 = logique discrete differentiable (portes), SL-11 = pipeline complet LLM <-> logique. Les deux premiers vivent dans le même gradient, le troisieme orchestre.
API clé : LogicLayer(in, out), GroupSum(k, tau), CompiledLogicNet(model).
Snapshot reproductible : graine 42 pour Python, NumPy, PyTorch, connexions logiques et DataLoader ; algorithmes PyTorch déterministes ; DEVICE=cpu et implementation="python".
MNIST 20x20 : précision 0,826 (8261/10000) avec GroupSum(k=10) et trois couches LogicLayer de dimension 2000 après 2000 itérations. Deux kernels neufs ont produit la même trajectoire, les mêmes prédictions par classe et l’empreinte modèle 8bf7f242407101817f5653677040f59f9c2a9dc08a819356caf42824924c53fd.
Universalité booléenne : 16 portes logiques, dont NAND seul est universel.
Inférence compilée : CompiledLogicNet requiert une chaîne C fonctionnelle ; cette voie optionnelle est classée RECOVERABLE-MACHINE quand la compilation locale est indisponible.
Archive SymbolicAI/SymbolicLearning/_archive/2026-07-04-Neurosymbolic-EML-precurseur-SL12/ : la veille EML/NAND qui a inspiré ce notebook (consolidée).