A la fin de ce notebook, vous saurez : 1. Distinguer apprentissage passif (exemples imposes, SL-1) et actif (l’apprenant pose des questions) 2. Formaliser le modèle MAT (Minimally Adequate Teacher) : requêtes d’appartenance et d’equivalence 3. Implementer la table d’observation d’Angluin (fermeture, consistance) 4. Derouler l’algorithme L* complet et apprendre un DFA inconnu 5. Relier la garantie de minimalite au theoreme de Myhill-Nerode 6. Mesurer ce qui se passe quand l’oracle d’equivalence devient approximatif (echantillonnage, PAC)
Prerequis
SL-1 (espaces d’hypotheses, apprentissage passif)
Notions d’automates finis déterministes (rappel complet en section 1)
Python pur : aucune dépendance externe dans ce notebook
Duree estimee : 60 minutes
Hommage — Stearns et la théorie des automates : LL(k), régularité, hiérarchies
Richard E. Stearns (1936–2026), co-lauréat du prix Turing 1993 pour avoir fondé la théorie de la complexité computationnelle, est aussi un artisan central de la théorie des langages formels que ce notebook met en pratique :
Lewis & Stearns, « Syntax-Directed Transduction » (JACM, 1968) a défini les grammaires LL(k) — la famille de parseurs descendants que la bibliographie ACM présente comme la première méthode d’analyse que les étudiants rencontrent ; les propriétés théoriques ont été établies avec Knuth puis Rosenkrantz & Stearns (1970).
Stearns, « A Regularity Test for Pushdown Machines » (1967) : si un langage régulier possède un DPDA de taille n, il possède un DFA de taille au plus n(n(n^O(n))) — un écart super-exponentiel mais calculable, resserré depuis par Valiant (2(2O(n))). C’est l’un des rares exemples où l’écart entre deux modèles de machines dépasse l’exponentiel sans devenir indécidable.
Stearns a aussi montré que les langages hors-contexte se reconnaissent en espace O(log² n) et établi une hiérarchie en espace — le pendant spatial de la hiérarchie en temps de Hartmanis–Stearns (1965).
Hommage complet (hiérarchie de Hartmanis–Stearns, série Complexity/) : issue #15949 ; autres résonances — paradoxe d’Arrow 1959 et jeux répétés à information incomplète (voir GameTheory/SocialChoice/ et GameTheory/game_theory_lean/README.md).
Tous les algorithmes de la serie jusqu’ici sont passifs : l’apprenant recoit un jeu d’exemples qu’il n’a pas choisi (les 12 restaurants de SL-1, les triples du KG de SL-8) et doit s’en contenter. Or certains concepts sont exponentiellement plus faciles a apprendre si l’apprenant peut poser des questions.
Dana Angluin (1987) formalise cela avec le MAT (Minimally Adequate Teacher), un professeur qui repond a exactement deux types de requêtes :
Requête
Question
Reponse
Appartenance (MQ)
« le mot \(w\) est-il dans le langage cible \(L\) ? »
La cible est ici un langage regulier : un ensemble de mots reconnu par un automate fini déterministe (DFA). C’est un objet pleinement symbolique — etats, transitions, etats acceptants — et le theoreme central d’Angluin est remarquable :
Theoreme (Angluin 1987). L* apprend le DFA minimal de tout langage regulier avec un nombre de requêtes polynomial en le nombre d’etats \(n\) du DFA minimal et la longueur \(m\) du plus long contre-exemple.
A titre de comparaison, apprendre un DFA passivement (trouver le plus petit DFA consistant avec un echantillon donne) est NP-difficile (Gold 1978). Le droit de poser des questions change la classe de complexite du problème.
Commencons par la cible : un DFA jouet que L* devra decouvrir sans jamais regarder sa structure, uniquement en l’interrogeant.
# Un DFA = (etats, alphabet, transitions, etat initial, etats acceptants)from collections import dequeclass DFA:"""Automate fini deterministe. delta : dict (etat, symbole) -> etat."""def__init__(self, states, alphabet, delta, start, accepting):self.states =set(states)self.alphabet =list(alphabet)self.delta =dict(delta)self.start = startself.accepting =set(accepting)def accepts(self, word): q =self.startfor ch in word: q =self.delta[(q, ch)]return q inself.acceptingdef__repr__(self):returnf"DFA({len(self.states)} etats, {len(self.accepting)} acceptants)"# Langage cible (cache pour L*) : mots sur {a, b} avec un nombre PAIR de 'a'# ET un nombre PAIR de 'b'. Etat = (parite des a, parite des b) -> 4 etats.ALPHABET = ["a", "b"]_states = ["ee", "eo", "oe", "oo"] # (pair, pair), (pair, impair), ..._delta = {}for s in _states: pa, pb = s[0], s[1] _delta[(s, "a")] = ("o"if pa =="e"else"e") + pb _delta[(s, "b")] = pa + ("o"if pb =="e"else"e")TARGET = DFA(_states, ALPHABET, _delta, "ee", {"ee"})# L'apprenant n'aura acces qu'a cette fonction (la requete d'appartenance) :def membership_query(word: str) ->bool:return TARGET.accepts(word)# Verification rapide sur quelques motstests = ["", "a", "b", "ab", "aabb", "abab", "aab", "bbaa", "abba"]print(f"Cible : {TARGET} (structure invisible pour l'apprenant)")print(f"{'mot':>8} | nb_a | nb_b | dans L ?")print("-"*36)for w in tests:print(f"{w orchr(949):>8} | {w.count('a'):>4} | {w.count('b'):>4} | "f"{'OUI'if membership_query(w) else'non'}")
Cible : DFA(4 etats, 1 acceptants)  (structure invisible pour l'apprenant)
     mot | nb_a | nb_b | dans L ?
------------------------------------
       ε |    0 |    0 | OUI
       a |    1 |    0 | non
       b |    0 |    1 | non
      ab |    1 |    1 | non
    aabb |    2 |    2 | OUI
    abab |    2 |    2 | OUI
     aab |    2 |    1 | non
    bbaa |    2 |    2 | OUI
    abba |    2 |    2 | OUI
Pourquoi ce langage ?
Le mot vide est accepte (0 est pair), ab est rejete (1 ‘a’, 1 ‘b’), aabb et abab sont acceptes. Le DFA minimal a exactement 4 etats — le produit des deux parites — et aucune conjonction d’attributs a la SL-1 ne peut le representer : l’appartenance depend d’un compteur modulaire, pas de la presence ou l’absence d’un motif. C’est un concept hors de portee des espaces d’hypotheses de SL-1, et parfaitement dans celui de L*.
L’apprenant ne voit que membership_query : une boite noire mot -> booléen. Tout l’enjeu est de reconstruire la structure (etats, transitions) a partir de reponses oui/non bien choisies.
Schema : le DFA cible (invisible pour l’apprenant)
Le langage cible – nombre pair de aet pair de b – est reconnu par le DFA minimal a 4 etats, un par couple (parite des a, parite des b). C’est cette structure (etats + transitions) que L* doit reconstruire a partir des seules reponses oui/non de l’oracle ; elle lui est cachee. La voici :
stateDiagram-v2
    direction LR
    [*] --> ee
    ee --> oe : a
    ee --> eo : b
    oe --> ee : a
    oe --> oo : b
    eo --> oo : a
    eo --> ee : b
    oo --> eo : a
    oo --> oe : b
    ee : ee (pair a, pair b)
    oe : oe (impair a, pair b)
    eo : eo (pair a, impair b)
    oo : oo (impair a, impair b)
    classDef accept fill:#d1e7dd,stroke:#0f5132,stroke-width:3px,color:#0a3622
    class ee accept
Lecture. L’etat initial ee (pair, pair) est aussi le seul etat acceptant (en vert) : un mot est dans le langage si, en le lisant lettre par lettre, on revient en ee. Chaque a bascule la parite des a (colonne gauche/droite), chaque b bascule celle des b – d’ou la symetrie en damier. Aucune conjonction d’attributs a la SL-1 ne capture ce compteur modulaire : c’est précisément ce qui place ce concept hors de portee de l’apprentissage passif et dans celui de L*.
2. La table d’observation
L* organise ses requêtes d’appartenance dans une table d’observation\((S, E, T)\) :
\(S\) : un ensemble de prefixes d’acces (chaque \(s \in S\) est un chemin candidat vers un etat du DFA) ;
\(E\) : un ensemble de suffixes distinguants (des « expériences » qui separent les etats) ;
\(T(s \cdot e) \in \{0, 1\}\) : la reponse de l’oracle a la requête \(s \cdot e \in L\) ?
La ligne d’un prefixe \(s\) est le vecteur \(row(s) = (T(s \cdot e))_{e \in E}\). L’intuition centrale : deux prefixes qui ont la même ligne menent (provisoirement) au même etat. C’est une approximation finie de la congruence de Myhill-Nerode : \(u \equiv_L v \iff \forall w,\; uw \in L \Leftrightarrow vw \in L\) — ici on ne teste pas tous les suffixes \(w\), seulement ceux de \(E\).
Pour pouvoir construire un DFA a partir de la table, deux proprietes sont requises :
Propriete
Definition
Si violee…
Fermeture
\(\forall s \in S, a \in \Sigma\), \(row(s a)\) est la ligne d’un élément de \(S\)
la transition \(row(s) \xrightarrow{a} {?}\) sort de la table : promouvoir\(sa\) dans \(S\)
Consistance
\(row(s_1) = row(s_2) \Rightarrow \forall a, row(s_1 a) = row(s_2 a)\)
deux etats fusionnes a tort : ajouter le suffixe \(a e\) qui les separe a \(E\)
class ObservationTable:"""Table d'observation (S, E, T) d'Angluin, remplie par requetes MQ."""def__init__(self, alphabet, mq):self.A =list(alphabet)self.mq = mqself.S = [""] # prefixes d'accesself.E = [""] # suffixes distinguants (E[0] = mot vide, toujours)self.T = {} # cache mot -> boolself.n_mq =0# compteur de requetes reellesself.fill()def ask(self, w):if w notinself.T:self.T[w] =self.mq(w)self.n_mq +=1returnself.T[w]def fill(self):for s inself.S + [s + a for s inself.S for a inself.A]:for e inself.E:self.ask(s + e)def row(self, s):returntuple(self.ask(s + e) for e inself.E)def find_unclosed(self):"""Renvoie un s.a dont la ligne n'apparait pas dans S, ou None.""" rows_S = {self.row(s) for s inself.S}for s inself.S:for a inself.A:ifself.row(s + a) notin rows_S:return s + areturnNonedef find_inconsistency(self):"""Renvoie un suffixe a+e qui separe deux lignes egales de S, ou None."""for i, s1 inenumerate(self.S):for s2 inself.S[i +1:]:ifself.row(s1) !=self.row(s2):continuefor a inself.A:for e inself.E:ifself.ask(s1 + a + e) !=self.ask(s2 + a + e):return a + ereturnNonedef show(self): eps =chr(949) cols = [e or eps for e inself.E] w =max(6, max(len(s) for s inself.S) +2)print(f"{'':>{w}} | "+" ".join(f"{c:>4}"for c in cols))print("-"* (w +3+5*len(cols)))for s inself.S: r =" ".join(f"{int(v):>4}"for v inself.row(s))print(f"{s or eps:>{w}} | {r}")print("-"* (w +3+5*len(cols)))for s inself.S:for a inself.A: sa = s + aif sa inself.S:continue r =" ".join(f"{int(v):>4}"for v inself.row(sa))print(f"{sa:>{w}} | {r}")# Table initiale : S = {epsilon}, E = {epsilon}table = ObservationTable(ALPHABET, membership_query)print("Table initiale (haut : S ; bas : les successeurs S.A) :\n")table.show()sa = table.find_unclosed()print(f"\nRequetes MQ posees : {table.n_mq}")print(f"Fermee ? {'oui'if sa isNoneelsef'NON : row({sa!r}) absente de S'}")
Table initiale (haut : S ; bas : les successeurs S.A) :

       |    ε
--------------
     ε |    1
--------------
     a |    0
     b |    0

Requetes MQ posees : 3
Fermee ? NON : row('a') absente de S
Lecture de la table initiale
La ligne de \(\varepsilon\) vaut \((1)\) (le mot vide est dans \(L\)), mais celles de a et b valent \((0)\) : la table n’est pas fermee — l’automate conjecture aurait une transition vers un etat qui n’existe pas encore. Le remede est mecanique : promouvoir le prefixe fautif dans \(S\), ce qui créé l’etat manquant, puis re-remplir la table. L’algorithme L* n’est rien d’autre que la repetition disciplinee de ce geste, plus le traitement des contre-exemples.
3. L’algorithme L*
L*(alphabet, MQ, EQ):
    initialiser la table (S = E = {epsilon})
    repeter:
        tant que la table n'est pas fermee ou pas consistante:
            non fermee      -> promouvoir le prefixe s.a fautif dans S
            non consistante -> ajouter le suffixe a.e separateur a E
        H <- DFA conjecture a partir des lignes de la table
        si EQ(H) repond OUI : retourner H
        sinon (contre-exemple c) : ajouter TOUS les prefixes de c a S
La conjecture se lit directement dans la table : les etats sont les lignes distinctes de \(S\), l’etat initial est \(row(\varepsilon)\), un etat est acceptant si sa première colonne (\(e = \varepsilon\)) vaut 1, et la transition par \(a\) envoie \(row(s)\) sur \(row(sa)\) — la fermeture garantit que cette ligne existe, la consistance qu’elle ne depend pas du representant \(s\) choisi.
def conjecture(table):"""Construit le DFA des lignes distinctes de S.""" reps = {} # ligne -> prefixe representantfor s in table.S: reps.setdefault(table.row(s), s) delta = {}for r, s in reps.items():for a in table.A: delta[(r, a)] = table.row(s + a) start = table.row("") accepting = {r for r in reps if r[0]} # E[0] = epsilonreturn DFA(set(reps), table.A, delta, start, accepting)def find_counterexample(hyp, target, alphabet):"""Oracle d'equivalence EXACT : BFS sur l'automate produit, renvoie le plus court mot sur lequel hyp et target different (None si equivalents).""" start = (hyp.start, target.start) seen = {start} queue = deque([("", *start)])while queue: w, qh, qt = queue.popleft()if (qh in hyp.accepting) != (qt in target.accepting):return wfor a in alphabet: nxt = (hyp.delta[(qh, a)], target.delta[(qt, a)])if nxt notin seen: seen.add(nxt) queue.append((w + a, *nxt))returnNonedef lstar(alphabet, mq, eq, verbose=True):"""L* d'Angluin. eq(hyp) renvoie None (equivalent) ou un contre-exemple.""" table = ObservationTable(alphabet, mq) n_eq =0 round_ =0whileTrue:# 1. Stabiliser la tablewhileTrue: sa = table.find_unclosed()if sa isnotNone: table.S.append(sa) table.fill()if verbose:print(f" table non fermee -> S += {sa!r}")continue ae = table.find_inconsistency()if ae isnotNone: table.E.append(ae) table.fill()if verbose:print(f" table non consistante -> E += {ae!r}")continuebreak# 2. Conjecturer et interroger le professeur hyp = conjecture(table) n_eq +=1 round_ +=1 cex = eq(hyp)if verbose: verdict ="ACCEPTEE"if cex isNoneelsef"contre-exemple {cex!r}"print(f"Conjecture {round_} : {len(hyp.states)} etats -> {verdict}")if cex isNone:return hyp, table, n_eq# 3. Integrer le contre-exemple (tous ses prefixes dans S, Angluin 1987)for i inrange(1, len(cex) +1):if cex[:i] notin table.S: table.S.append(cex[:i]) table.fill()print("L* implemente : ObservationTable + conjecture + boucle de raffinement.")
L* implemente : ObservationTable + conjecture + boucle de raffinement.
4. Exécution complete sur le langage cible
Lancons L* contre la boite noire. L’oracle d’equivalence est ici exact (BFS sur l’automate produit) : un luxe possible seulement parce que nous connaissons la cible — la section 6 le remplacera par ce qu’on a vraiment en pratique.
learned, final_table, n_eq = lstar(ALPHABET, membership_query,lambda h: find_counterexample(h, TARGET, ALPHABET))print(f"\nDFA appris : {learned}")print(f"Requetes d'appartenance : {final_table.n_mq}")print(f"Requetes d'equivalence : {n_eq}")print(f"\nTable finale (S = {len(final_table.S)} prefixes, E = {final_table.E}) :\n")final_table.show()# Verification independante exhaustive jusqu'a la longueur 10def all_words(alphabet, max_len):yield"" frontier = [""]for _ inrange(max_len): frontier = [w + a for w in frontier for a in alphabet]yieldfrom frontiermismatch =sum(learned.accepts(w) != TARGET.accepts(w) for w in all_words(ALPHABET, 10))total =sum(1for _ in all_words(ALPHABET, 10))print(f"\nVerification exhaustive : {total - mismatch}/{total} mots (longueur <= 10) identiques")
  table non fermee -> S += 'a'
Conjecture 1 : 2 etats -> contre-exemple 'ba'
  table non consistante -> E += 'a'
  table non consistante -> E += 'b'
Conjecture 2 : 4 etats -> ACCEPTEE

DFA appris : DFA(4 etats, 1 acceptants)
Requetes d'appartenance : 19
Requetes d'equivalence  : 2

Table finale (S = 4 prefixes, E = ['', 'a', 'b']) :

       |    ε    a    b
------------------------
     ε |    1    0    0
     a |    0    1    0
     b |    0    0    1
    ba |    0    0    0
------------------------
    aa |    1    0    0
    ab |    0    0    0
    bb |    1    0    0
   baa |    0    0    1
   bab |    0    1    0

Verification exhaustive : 2047/2047 mots (longueur <= 10) identiques
Interpretation : que s’est-il passe ?
La première conjecture est minuscule et fausse. Avec \(S = E = \{\varepsilon\}\) stabilises, la table ne distingue que « accepte / rejette » : 2 etats. Le professeur repond par un contre-exemple court.
Le contre-exemple force la croissance. Ses prefixes entrent dans \(S\), la consistance casse, des suffixes distinguants entrent dans \(E\) — chaque rejet d’une conjecture ajoute au moins un etat a la suivante. Comme le DFA minimal a 4 etats, il y a au plus 4 conjectures : la terminaison est garantie, pas seulement esperee.
Le cout total est modeste : quelques dizaines de MQ et une poignee d’EQ pour identifier exactement un langage infini. Comparez avec SL-1 : 12 exemples imposes n’avaient pas suffi a stabiliser une simple conjonction. Le choix actif des questions est la source de l’efficacite — chaque requête de la table sert a trancher une distinction precise entre deux etats candidats.
5. Garanties : minimalite et complexite polynomiale
Le theoreme de Myhill-Nerode (1958) donne la borne inferieure structurelle : le nombre d’etats du DFA minimal de \(L\) est exactement le nombre de classes de la congruence \(u \equiv_L v \iff \forall w,\; uw \in L \Leftrightarrow vw \in L\).
Origine. L’exposition canonique du theoreme de Myhill-Nerode et de son rôle pour la minimalite des automates se trouve dans Hopcroft, J. E., Motwani, R. & Ullman, J. D., Introduction to Automata Theory, Languages, and Computation (3e ed., Pearson/Addison-Wesley). Le theoreme (Myhill 1958, Nerode 1958) caracterise un langage regulier par sa congruence syntactique : deux prefixes sont equivalents s’ils ne peuvent etre distingues par aucun suffixe. congruence \(u \equiv_L v \iff \forall w,\; uw \in L \Leftrightarrow vw \in L\).
L* s’y adosse directement :
chaque paire de lignes distinctes de la table est un certificat de non-equivalence (un suffixe de \(E\) separe les deux prefixes), donc la conjecture n’a jamais plus d’etats que le DFA minimal ;
l’oracle d’equivalence fournit des contre-exemples tant qu’elle en a moins ;
l’algorithme s’arrete donc précisément sur le DFA minimal — il ne peut pas retourner autre chose.
Cote complexite : \(O(n)\) requêtes d’equivalence et \(O(|\Sigma| \cdot m \cdot n^2)\) requêtes d’appartenance, ou \(n\) est le nombre d’etats du minimal et \(m\) la longueur du plus long contre-exemple. Verifions empiriquement la croissance sur la famille \(L_k\) = « le nombre de ‘a’ est divisible par \(k\) » (DFA minimal a \(k\) etats) :
# Verification empirique 1 : les classes de Myhill-Nerode du langage cibledef nerode_classes(mq, alphabet, max_prefix=4, max_suffix=4):"""Partitionne les prefixes par leur comportement sur tous les suffixes courts.""" suffixes =list(all_words(alphabet, max_suffix)) signature = {}for u in all_words(alphabet, max_prefix): signature.setdefault(tuple(mq(u + w) for w in suffixes), []).append(u)return signatureclasses = nerode_classes(membership_query, ALPHABET)print(f"Classes de Myhill-Nerode empiriques (prefixes <= 4, suffixes <= 4) : {len(classes)}")for sig, members in classes.items(): eps =chr(949)print(f" classe de {members[0] or eps!r:>6} : {len(members)} prefixes")# Verification empirique 2 : croissance du cout en fonction de nprint(f"\n{'k':>3} | etats appris | MQ | EQ")print("-"*34)for k inrange(2, 7):def mq_k(word, k=k):return word.count("a") % k ==0 dk_states =list(range(k)) dk = DFA(dk_states, ALPHABET, {(q, "a"): (q +1) % k for q in dk_states} | {(q, "b"): q for q in dk_states},0, {0}) hyp, tbl, neq = lstar(ALPHABET, mq_k,lambda h, dk=dk: find_counterexample(h, dk, ALPHABET), verbose=False)print(f"{k:>3} | {len(hyp.states):>12} | {tbl.n_mq:>4} | {neq:>2}")
Classes de Myhill-Nerode empiriques (prefixes <= 4, suffixes <= 4) : 4
  classe de    'ε' : 11 prefixes
  classe de    'a' : 5 prefixes
  classe de    'b' : 5 prefixes
  classe de   'ab' : 10 prefixes

  k | etats appris | MQ | EQ
----------------------------------
  2 |            2 |    5 |  1
  3 |            3 |   14 |  2
  4 |            4 |   23 |  2
  5 |            5 |   34 |  2
  6 |            6 |   47 |  2
Interpretation
Les classes empiriques de Myhill-Nerode sont bien au nombre de 4 — et L* a appris un DFA a 4 etats : la garantie de minimalite n’est pas un a-cote théorique, c’est le mécanisme même de l’algorithme. Sur la famille \(L_k\), le nombre d’etats appris suit exactement \(k\) et le nombre de requêtes croit polynomialement, très loin de l’explosion exponentielle qu’exigerait l’enumeration des DFA candidats.
A noter : c’est un des rares algorithmes de la serie a venir avec une garantie exacte (identification du concept, pas approximation). Le prix est le professeur : sans oracle d’equivalence fiable, la garantie s’evapore — voyons précisément comment.
6. L’oracle d’equivalence en pratique
Dans le monde reel (retro-ingenierie d’un protocole, test d’un composant boite noire), personne ne sait repondre exactement a « ton hypothese est-elle correcte ? ». On approxime l’EQ par echantillonnage : tirer \(N\) mots au hasard, comparer l’hypothese et le système, renvoyer le premier desaccord. S’il n’y en a aucun, declarer l’hypothese correcte… en croisant les doigts.
C’est exactement le cadre PAC (SL-3) : le DFA retourne est probablement approximativement correct — mais plus exactement correct. Et la nuance n’est pas academique : elle depend entierement de la densite des desaccords entre une hypothese fausse et la cible. Mesurons-la sur deux langages aux profils opposes : le langage des parites (ou une hypothese fausse se trompe sur environ un mot sur quatre) et un langage-aiguille, « les mots contenant le facteur aabbaabb », ou les mots discriminants sont rares.
import randomdef make_sampling_eq(mq, alphabet, n_samples, max_len=20, seed=0):"""Oracle d'equivalence approximatif : N mots aleatoires, premier desaccord.""" rng = random.Random(seed)def eq(hyp):for _ inrange(n_samples): w ="".join(rng.choice(alphabet) for _ inrange(rng.randint(0, max_len)))if hyp.accepts(w) != mq(w):return wreturnNonereturn eq# Le langage-aiguille : mots contenant le facteur "aabbaabb".# Son DFA minimal est l'automate de Knuth-Morris-Pratt du motif : 9 etats.def factor_dfa(pattern, alphabet): n =len(pattern) delta = {}for q inrange(n +1):for ch in alphabet:if q == n: delta[(q, ch)] = n # motif deja vu : etat absorbantelif pattern[q] == ch: delta[(q, ch)] = q +1# on avance dans le motifelse: # repli KMP : plus long prefixe s = pattern[:q] + ch # du motif encore suffixe de s delta[(q, ch)] =max(k for k inrange(len(s) +1)if s.endswith(pattern[:k]))return DFA(range(n +1), alphabet, delta, 0, {n})NEEDLE = factor_dfa("aabbaabb", ALPHABET)for name, mq, tgt in [("parites (desaccords DENSES)", membership_query, TARGET), ("contient 'aabbaabb' (desaccords RARES)", NEEDLE.accepts, NEEDLE)]:print(f"Langage {name} :")print(f"{'N essais':>9} | etats | DFA exact ?")for n_samples in [1, 10, 100, 1000]: hyp, tbl, _ = lstar(ALPHABET, mq, make_sampling_eq(mq, ALPHABET, n_samples, seed=7), verbose=False) exact = find_counterexample(hyp, tgt, ALPHABET) isNoneprint(f"{n_samples:>9} | {len(hyp.states):>5} | {'OUI'if exact else'NON'}")print()
Interpretation : tout depend de la densite des desaccords
Sur les parites, un seul mot aleatoire par appel suffit déjà : une hypothese fausse y est en desaccord avec la cible sur environ un mot sur quatre, le premier tirage venu fait office de contre-exemple. La garantie semble intacte — mais c’est une propriete du langage, pas de l’algorithme.
Sur le langage-aiguille, un mot aleatoire de longueur \(\le 20\) ne contient le facteur qu’avec une probabilite de quelques pourcents. A \(N = 1\) ou \(10\) essais, l’EQ approximatif ne voit jamais de desaccord et accepte la toute première conjecture : un DFA a un etat qui rejette tout. Le résultat est grossierement faux et rien dans l’exécution ne le signale — c’est le sens exact du PAC : correct avec probabilite \(1 - \delta\)sur la distribution d’echantillonnage, rien de plus. A \(N = 100\), le contre-exemple finit par sortir, et un seul suffit : ses prefixes injectent dans la table tout le materiel necessaire, et L* deroule les 9 etats sans aide supplementaire.
C’est la même lecon que SL-9, vue de l’autre cote : la-bas, un générateur faillible (le LLM) etait discipline par un oracle exact ; ici, un apprenant exact est fragilise par un oracle faillible. Dans un pipeline neuro-symbolique, identifier qui joue le rôle de l’oracle et ce qu’il garantit vraiment est la première question d’architecture.
7. Posterite : le model learning
L* n’est pas reste un résultat théorique. Sous le nom de model learning (Vaandrager, CACM 2017), ses descendants directs apprennent des machines a etats de systèmes reels, en branchant les MQ sur le système lui-même :
Retro-ingenierie de protocoles : les implementations de TLS, TCP, SSH ou des cartes bancaires ont ete apprises comme des machines de Mealy ; plusieurs violations de specification et failles ont ete trouvees en lisant le DFA appris (etats parasites, transitions interdites presentes).
LearnLib (open source, Java) industrialise L* et ses variantes modernes (TTT, Rivest-Schapire, ADT), avec des EQ approximatifs intelligents (W-method, echantillonnage dirige).
Verification : le DFA appris sert d’interface formelle d’un composant boite noire, sur laquelle un model checker peut ensuite prouver des proprietes (assume-guarantee reasoning).
Et la boucle se referme avec les LLM : des travaux recents utilisent un LLM comme professeur approximatif (repondre aux MQ sur un format textuel, proposer des contre-exemples) et L* comme apprenant exact qui en extrait un automate verifiable — la division générateur faillible / verificateur symbolique de SL-9, devenue protocole d’apprentissage.
8. Exercices
Tableau recapitulatif
Concept
Definition
Implementation
Requête MQ / EQ
\(w \in L\) ? / \(H = L\) ?
membership_query, find_counterexample
Table d’observation
\((S, E, T)\), lignes = etats candidats
ObservationTable
Fermeture
\(row(sa)\) presente dans \(S\)
find_unclosed()
Consistance
lignes egales -> successeurs egaux
find_inconsistency()
Conjecture
DFA des lignes distinctes
conjecture()
EQ approximatif
echantillonnage, garantie PAC
make_sampling_eq()
# Exemple guide 1 : Apprendre le langage "contient 'abb' comme facteur"## On apprend par L* le langage des mots (sur {a, b}) qui contiennent la# sous-chaine "abb", SANS construire le DFA cible : l'apprenant n'a acces# qu'a la requete d'appartenance (l'operateur 'in') et a un oracle# d'equivalence par echantillonnage.# Etape 1 : requete d'appartenance -- une ligne suffit ('abb' in word)def mq_abb(word: str) ->bool:return"abb"in word# Etape 2 : lancer L* avec un oracle d'equivalence par echantillonnagelearned, final_table, n_eq = lstar( ALPHABET, mq_abb, make_sampling_eq(mq_abb, ALPHABET, 2000), verbose=False)print(f"DFA appris : {learned}")print(f" Conjectures (equivalences) : {n_eq}")print(f" |S| = {len(final_table.S)}, |E| = {len(final_table.E)}, "f"MQ posees = {final_table.n_mq}")# Etape 3 : interpretation des etats (prediction theorique : 4 etats)# - "rien vu" : aucune amorce du motif# - "'a' vu" : un 'a' isole, pas encore suivi de 'bb'# - "'ab' vu" : debut du motif, il manque encore un 'b'# - "'abb' vu" : motif trouve, etat absorbant acceptantprint()print("Prediction theorique : 4 etats (rien vu / 'a' vu / 'ab' vu / 'abb' vu).")print(f"-> observe : {len(learned.states)} etats "f"({'confirme'iflen(learned.states) ==4else'a commenter'}).")# Etape 4 : verification sur 10 motstest_words = ["", "a", "ab", "abb", "abbb", "babb", "aaabb","abab", "abbabb", "bbabb"]print()print(f"{'mot':>10} | DFA | vrai | OK ?")print("-"*34)for w in test_words: pred = learned.accepts(w) vrai ="abb"in wprint(f"{w or'(eps)':>10} | {int(pred):>3} | {int(vrai):>4} | "f"{'OK'if pred == vrai else'ECHEC'}")
DFA appris : DFA(4 etats, 1 acceptants)
  Conjectures (equivalences) : 2
  |S| = 13, |E| = 3, MQ posees = 55

Prediction theorique : 4 etats (rien vu / 'a' vu / 'ab' vu / 'abb' vu).
-> observe : 4 etats (confirme).

       mot | DFA | vrai | OK ?
----------------------------------
     (eps) |   0 |    0 | OK
         a |   0 |    0 | OK
        ab |   0 |    0 | OK
       abb |   1 |    1 | OK
      abbb |   1 |    1 | OK
      babb |   1 |    1 | OK
     aaabb |   1 |    1 | OK
      abab |   0 |    0 | OK
    abbabb |   1 |    1 | OK
     bbabb |   1 |    1 | OK
Exercice 1 (variation) : Apprendre un autre langage-facteur
Reprenez la méthode de l’exemple guide pour apprendre par L* le langage des mots (sur {a, b}) qui contiennent la sous-chaîne “ba” (au lieu de “abb”). Combien d’etats le DFA minimal comporte-t-il, et pourquoi ?
Étapes : 1. Ecrire mq_ba(word) : appartenance au langage “contient ‘ba’ comme facteur” 2. Lancer L* avec make_sampling_eq(mq_ba, ALPHABET, 2000) 3. Donner le nombre d’etats du DFA appris et expliquer chacun (prediction théorique : 3 etats) 4. Verifier sur 8 mots de votre choix
# Exercice 1 (variation) : apprendre le langage "contient 'ba' comme facteur"# TODO etudiant : reprenez l'exemple guide ci-dessus avec le motif "ba".# Etape 1 : requete d'appartenance au langage "contient 'ba'"# def mq_ba(word: str) -> bool:# return ... # TODO etudiant : une ligne avec l'operateur 'in'# Etape 2 : lancer L* avec un oracle d'equivalence par echantillonnage# learned_ba, table_ba, n_eq_ba = lstar(ALPHABET, mq_ba,# make_sampling_eq(mq_ba, ALPHABET, 2000),# verbose=False)# Etape 3 : nombre d'etats et interpretation (prediction : 3 etats)# print(f"DFA appris : {learned_ba} ({n_eq_ba} equivalences)")# Etape 4 : verification sur 8 motsprint("Exercice a completer : apprenez le langage 'contient ba' par L*")print("Etape 1 : ecrivez mq_ba(word) avec l'operateur 'in'")print("Etape 2 : lancez lstar(ALPHABET, mq_ba, make_sampling_eq(..., 2000))")print("Etape 3 : donnez le nombre d'etats et expliquez chacun")print("Etape 4 : verifiez sur 8 mots")# Indice : le motif "ba" est plus court que "abb" -> moins d'etats "amorce".# result = None # TODO etudiant : le DFA appris (learned_ba)
Exercice a completer : apprenez le langage 'contient ba' par L*
Etape 1 : ecrivez mq_ba(word) avec l'operateur 'in'
Etape 2 : lancez lstar(ALPHABET, mq_ba, make_sampling_eq(..., 2000))
Etape 3 : donnez le nombre d'etats et expliquez chacun
Etape 4 : verifiez sur 8 mots
L’exercice suivant quantifie ce que la section 6 a montre qualitativement : la fiabilite de l’oracle d’equivalence par echantillonnage est une variable aleatoire, qui se mesure en repetant l’expérience.
# Exemple guide 2 : Fiabilite de l'oracle d'equivalence approximatif## L'oracle d'equivalence par echantillonnage est une variable aleatoire :# sa fiabilite se mesure en repetant l'experience. Pour plusieurs tailles# d'echantillon et 20 graines, on mesure le TAUX de runs qui produisent# un DFA exactement correct (verifie par l'oracle EXACT find_counterexample).# Etape 1 : taux de reussite sur n_seeds grainesdef taux_fiabilite(mq, target, n_samples, n_seeds=20):"""Lance L* n_seeds fois ; retourne la fraction de runs exactement corrects.""" corrects =0for seed inrange(n_seeds): eq = make_sampling_eq(mq, ALPHABET, n_samples, seed=seed) hyp, _, _ = lstar(ALPHABET, mq, eq, verbose=False)if find_counterexample(hyp, target, ALPHABET) isNone: corrects +=1return corrects / n_seeds# Etape 2 : tableau n_samples -> taux de reussite (sur 20 runs), NEEDLE vs TARGETprint("Fiabilite de l'oracle d'equivalence par echantillonnage (20 graines)")print("="*64)print(f"{'n_samples':>10} | {'NEEDLE (desaccords rares)':>26} | "f"{'TARGET parites (denses)':>24}")print("-"*64)for n_samples in [1, 10, 50, 100, 500]: t_needle = taux_fiabilite(NEEDLE.accepts, NEEDLE, n_samples) t_target = taux_fiabilite(membership_query, TARGET, n_samples)print(f"{n_samples:>10} | {t_needle:>25.0%} | {t_target:>23.0%}")# Etape 3 : seuil de fiabilite + pourquoi il depend du langageprint()print("Lecture : le seuil de fiabilite (n_samples au-dela duquel le taux tend")print("vers 100%) depend fortement du langage. NEEDLE (contient 'aabbaabb') a")print("des desaccords RARES -- peu de mots distinguent une hypothese fausse de")print("la cible, il faut donc beaucoup d'echantillons pour tomber sur un mot")print("revelateur. TARGET (parite des 'a' et 'b') a des desaccords DENSES --")print("pres de la moitie des mots distinguent deux DFAs differents -- donc peu")print("d'echantillons suffisent. La fiabilite d'un oracle PAC est plafonnee par")print("la DENSITE des contre-exemples dans le langage cible.")
Fiabilite de l'oracle d'equivalence par echantillonnage (20 graines)
================================================================
 n_samples |  NEEDLE (desaccords rares) |  TARGET parites (denses)
----------------------------------------------------------------
         1 |                        0% |                     50%
        10 |                       10% |                    100%
        50 |                       60% |                    100%
       100 |                      100% |                    100%
       500 |                      100% |                    100%

Lecture : le seuil de fiabilite (n_samples au-dela duquel le taux tend
vers 100%) depend fortement du langage. NEEDLE (contient 'aabbaabb') a
des desaccords RARES -- peu de mots distinguent une hypothese fausse de
la cible, il faut donc beaucoup d'echantillons pour tomber sur un mot
revelateur. TARGET (parite des 'a' et 'b') a des desaccords DENSES --
pres de la moitie des mots distinguent deux DFAs differents -- donc peu
d'echantillons suffisent. La fiabilite d'un oracle PAC est plafonnee par
la DENSITE des contre-exemples dans le langage cible.
Exercice 2 (variation) : Fiabilite vs longueur des mots echantillonnes
Pour NEEDLE, le contre-exemple revelateur est un mot LONG (il faut un mot contenant “aabbaabb”). L’oracle echantillonne des mots de longueur <= max_len : que se passe-t-il si max_len < 8 (aucun mot genere ne peut contenir le motif) ? Mesurez le taux de fiabilite pour max_len dans [5, 8, 12, 20], a n_samples fixe.
Étapes : 1. Reutiliser taux_fiabilite en variant max_len (paramètre de make_sampling_eq) avec n_samples=200 fixe, sur NEEDLE 2. Tableau max_len -> taux de reussite (20 graines) 3. Pourquoi max_len < len(motif) annule-t-il la fiabilite même avec beaucoup d’echantillons ?
# Exercice 2 (variation) : fiabilite vs longueur des mots echantillonnes# TODO etudiant : pour NEEDLE, la fiabilite depend de max_len (longueur max# des mots tires par l'oracle d'equivalence).# Etape 1 : taux_fiabilite en variant max_len, n_samples=200 fixe, sur NEEDLE# def taux_fiabilite_maxlen(max_len, n_samples=200, n_seeds=20):# corrects = 0# for seed in range(n_seeds):# eq = make_sampling_eq(NEEDLE.accepts, ALPHABET, n_samples,# max_len=max_len, seed=seed)# hyp, _, _ = lstar(ALPHABET, NEEDLE.accepts, eq, verbose=False)# if find_counterexample(hyp, NEEDLE, ALPHABET) is None:# corrects += 1# return corrects / n_seeds# Etape 2 : tableau max_len -> taux (20 graines)# for max_len in [5, 8, 12, 20]:# print(f" max_len={max_len:>2} : {taux_fiabilite_maxlen(max_len):.0%}")# Etape 3 : pourquoi max_len < len(motif) annule-t-il la fiabilite ?print("Exercice a completer : fiabilite vs longueur des mots echantillonnes")print("Etape 1 : reutilisez taux_fiabilite en variant max_len (n_samples=200 fixe)")print("Etape 2 : affichez le tableau max_len -> taux sur NEEDLE")print("Etape 3 : expliquez pourquoi max_len < 8 annule la fiabilite")# Indice : si aucun mot genere ne peut contenir le motif 'aabbaabb',# l'oracle ne trouvera JAMAIS de contre-exemple, meme avec n_samples infini.# result = None # TODO etudiant : dict {max_len: taux}
Exercice a completer : fiabilite vs longueur des mots echantillonnes
Etape 1 : reutilisez taux_fiabilite en variant max_len (n_samples=200 fixe)
Etape 2 : affichez le tableau max_len -> taux sur NEEDLE
Etape 3 : expliquez pourquoi max_len < 8 annule la fiabilite
L’exercice suivant touche au coeur algorithmique : la maniere d’integrer le contre-exemple. Angluin ajoute tous ses prefixes a \(S\) ; la variante de Maler-Pnueli ajoute tous ses suffixes a \(E\) — même garantie, couts différents.
# Exemple guide 3 : Variante de traitement du contre-exemple (suffixes vs prefixes)## Angluin (1987) ajoute tous les PREFIXES du contre-exemple a S. La variante# de Maler-Pnueli ajoute tous ses SUFFIXES a E : meme garantie de terminaison,# mais un profil de cout different (|E| croit, |S| reste compact).def lstar_suffixes(alphabet, mq, eq, verbose=False):"""L* variante Maler-Pnueli : integre le contre-exemple par ses SUFFIXES (ajoutes a E) plutot que par ses prefixes (ajoutes a S).""" table = ObservationTable(alphabet, mq) n_eq =0 round_ =0whileTrue:# 1. Stabiliser la table (fermeture + consistance)whileTrue: sa = table.find_unclosed()if sa isnotNone: table.S.append(sa) table.fill()continue ae = table.find_inconsistency()if ae isnotNone: table.E.append(ae) table.fill()continuebreak# 2. Conjecturer et interroger le professeur hyp = conjecture(table) n_eq +=1 round_ +=1 cex = eq(hyp)if cex isNone:return hyp, table, n_eq# 3. Maler-Pnueli : ajouter les SUFFIXES cex[i:] du contre-exemple a Efor i inrange(len(cex)): suf = cex[i:]if suf notin table.E: table.E.append(suf) table.fill()# Deuxieme langage de comparaison : L_5 = mots de longueur divisible par 5.def l5_dfa(): delta = {(q, a): (q +1) %5for q inrange(5) for a in ALPHABET}return DFA(range(5), ALPHABET, delta, 0, {0})L5 = l5_dfa()def eq_exact_pour(target):"""Oracle d'equivalence EXACT pour une cible donnee (DFA)."""returnlambda h: find_counterexample(h, target, ALPHABET)# Etape 2 : comparaison prefixes (Angluin) vs suffixes (Maler-Pnueli)print("Comparaison Angluin (prefixes -> S) vs Maler-Pnueli (suffixes -> E)")print("="*70)print(f"{'Langage':22s} | {'Variante':13s} | {'|S|':>4} | {'|E|':>4} | "f"{'|S|x|E|':>7} | {'MQ':>5} | {'EQ':>3}")print("-"*70)langages = [("TARGET (parites)", membership_query, TARGET), ("L_5 (longueur % 5)", L5.accepts, L5)]for nom, mq, tgt in langages: eq = eq_exact_pour(tgt)for variante, runner in [("Angluin", lstar), ("Maler-Pnueli", lstar_suffixes)]: hyp, tbl, n_eq = runner(ALPHABET, mq, eq, verbose=False) taille =len(tbl.S) *len(tbl.E)print(f"{nom:22s} | {variante:13s} | {len(tbl.S):>4} | {len(tbl.E):>4} | "f"{taille:>7} | {tbl.n_mq:>5} | {n_eq:>3}")# Etape 3 : lectureprint()print("Lecture : les deux variantes echangent |S| contre |E|. Angluin ajoute")print("des PREFIXES a S (un acces par etat revele par le contre-exemple) ;")print("Maler-Pnueli ajoute des SUFFIXES a E (un distinguant par contre-exemple).")print("Sur TARGET (4 etats) les deux coincident. Sur L_5, Maler-Pnueli garde |S|")print("plus petit (5 vs 6) mais grossit |E| (6 vs 4) : le total |S|x|E| et le")print("nombre de MQ sont alors legerement PLUS eleves (41 vs 34). La compacite")print("globale n'avantage donc AUCUNE des deux variantes en general. L'interet")print("reel de la variante suffixes est structurel : ajouter des suffixes a E ne")print("fait que raffiner le partitionnement des lignes (chaque colonne ne peut")print("que distinguer davantage de lignes egales), donc elle ne peut PAS")print("introduire d'inconsistance -- elle la resout, d'ou moins de passes de")print("re-stabilisation de la table.")
Comparaison Angluin (prefixes -> S) vs Maler-Pnueli (suffixes -> E)
======================================================================
Langage                | Variante      |  |S| |  |E| | |S|x|E| |    MQ |  EQ
----------------------------------------------------------------------
TARGET (parites)       | Angluin       |    4 |    3 |      12 |    19 |   2
TARGET (parites)       | Maler-Pnueli  |    4 |    3 |      12 |    19 |   2
L_5 (longueur % 5)     | Angluin       |    6 |    4 |      24 |    34 |   2
L_5 (longueur % 5)     | Maler-Pnueli  |    5 |    6 |      30 |    41 |   2

Lecture : les deux variantes echangent |S| contre |E|. Angluin ajoute
des PREFIXES a S (un acces par etat revele par le contre-exemple) ;
Maler-Pnueli ajoute des SUFFIXES a E (un distinguant par contre-exemple).
Sur TARGET (4 etats) les deux coincident. Sur L_5, Maler-Pnueli garde |S|
plus petit (5 vs 6) mais grossit |E| (6 vs 4) : le total |S|x|E| et le
nombre de MQ sont alors legerement PLUS eleves (41 vs 34). La compacite
globale n'avantage donc AUCUNE des deux variantes en general. L'interet
reel de la variante suffixes est structurel : ajouter des suffixes a E ne
fait que raffiner le partitionnement des lignes (chaque colonne ne peut
que distinguer davantage de lignes egales), donc elle ne peut PAS
introduire d'inconsistance -- elle la resout, d'ou moins de passes de
re-stabilisation de la table.
Exercice 3 (variation) : Variante Rivest-Schapire (un seul suffixe, par dichotomie)
Angluin ajoute tous les prefixes, Maler-Pnueli tous les suffixes. La variante de Rivest-Schapire (1993) est plus parcimonieuse : par recherche dichotomique sur le contre-exemple, elle identifie un seul suffixe distinguant et l’ajoute a E. Implementez cette recherche.
Étapes : 1. Soit un contre-exemple c ou l’hypothese et la cible differentent : trouvez par dichotomie un indice i tel que le suffixe c[i:] separe la ligne d’acces correspondante de celle de la cible 2. Ajoutez ce seul suffixe c[i:] a E (pas tous les suffixes) 3. Comparez le nombre total de MQ avec la variante Maler-Pnueli (tous les suffixes) sur TARGET : Rivest ajoute-t-il moins de colonnes ?
# Exercice 3 (variation) : variante Rivest-Schapire (un seul suffixe par dichotomie)# TODO etudiant : au lieu d'ajouter TOUS les suffixes du contre-exemple a E,# n'en ajouter qu'UN, trouve par recherche dichotomique.# Etape 1 : recherche dichotomique d'un suffixe distinguant dans le contre-exemple# def suffixe_distinguant_rivest(table, cex):# # cex = contre-exemple ou hyp et target differentent# # renvoyer un seul suffixe cex[i:] a ajouter a E# ...# return None # TODO etudiant# Etape 2 : lstar_rivest : copiez lstar_suffixes, remplacez l'ajout de tous les# suffixes par l'ajout du SEUL suffixe renvoye par suffixe_distinguant_rivest# def lstar_rivest(alphabet, mq, eq, verbose=False):# ...# return None # TODO etudiant# Etape 3 : comparer n_mq et |E| avec Maler-Pnueli sur TARGETprint("Exercice a completer : variante Rivest-Schapire (un seul suffixe par dichotomie)")print("Etape 1 : ecrivez suffixe_distinguant_rivest(table, cex) (recherche dichotomique)")print("Etape 2 : ecrivez lstar_rivest (copie de lstar_suffixes, ajout d'un seul suffixe)")print("Etape 3 : comparez n_mq et |E| avec Maler-Pnueli sur TARGET")# Indice : la dichotomie exploite le fait que si row(cex[0:]) (hyp) != row(cex[0:])# (target) mais row(cex[k:]) (hyp) == row(cex[k:]) (target), alors il existe un# point de bascule i ; cex[i:] est le suffixe cherche. O(log|cex|) ajout au lieu de |cex|.# result = None # TODO etudiant : le DFA appris par lstar_rivest
Exercice a completer : variante Rivest-Schapire (un seul suffixe par dichotomie)
Etape 1 : ecrivez suffixe_distinguant_rivest(table, cex) (recherche dichotomique)
Etape 2 : ecrivez lstar_rivest (copie de lstar_suffixes, ajout d'un seul suffixe)
Etape 3 : comparez n_mq et |E| avec Maler-Pnueli sur TARGET
Dernier exercice : la robustesse. Tous les algorithmes de la serie rencontrent tot ou tard cette question, et la reponse de L* est singuliere.
# Exemple guide 4 : Oracle d'appartenance bruite## On enveloppe membership_query dans un oracle qui MENT avec probabilite p,# de facon DETERMINISTE par mot (la premiere reponse est memoisee -- sinon la# table T cacherait deja les mensonges pour nous). On borne L* (max_rounds)# car un oracle bruite peut rendre la fonction d'appartenance non reguliere# (donc la stabilisation de la table peut ne jamais converger).def make_noisy_mq(true_mq, p=0.05, seed=0):"""Oracle d'appartenance qui ment avec probabilite p, deterministe par mot.""" rng = random.Random(seed) cache = {}def noisy_mq(word):if word notin cache: truth = true_mq(word) lie = rng.random() < p cache[word] = (not truth) if lie else truthreturn cache[word]return noisy_mqdef lstar_bounded(alphabet, mq, eq, max_rounds=8, max_steps=60):"""L* borne. Evite la boucle infinie si mq est inconsistant (oracle bruite). On ne conjecture QUE sur une table fermee ET consistante : un oracle bruite peut rendre la fonction non reguliere, auquel cas la stabilisation echoue (max_steps) et l'on retourne (None, table, n_eq, False) = non-stabilise. """ table = ObservationTable(alphabet, mq) n_eq =0 hyp =Nonefor _round inrange(1, max_rounds +1):# Stabiliser la table ; max_steps contre la non-regularite du bruit. steps =0whileTrue: sa = table.find_unclosed()if sa isnotNone: table.S.append(sa) table.fill()else: ae = table.find_inconsistency()if ae isnotNone: table.E.append(ae) table.fill()else:break steps +=1if steps > max_steps:break# Table non stabilisee -> impossible de conjecturer proprement.if table.find_unclosed() isnotNoneor table.find_inconsistency() isnotNone:return hyp, table, n_eq, False# non-stabilise hyp = conjecture(table) n_eq +=1 cex = eq(hyp)if cex isNone:return hyp, table, n_eq, True# stabilisefor i inrange(1, len(cex) +1):if cex[:i] notin table.S: table.S.append(cex[:i]) table.fill()return hyp, table, n_eq, False# max_rounds atteint# Etape 2 et 3 : L* borne sous oracle bruite, pour p = 0.05 puis 0.01 et 0.20print("Oracle d'appartenance bruite : comportement de L* (cible TARGET = 4 etats)")print("="*66)for p in [0.05, 0.01, 0.20]: noisy = make_noisy_mq(membership_query, p=p, seed=0) eq_noisy = make_sampling_eq(noisy, ALPHABET, 300, seed=1) hyp, _tbl, n_eq, stable = lstar_bounded( ALPHABET, noisy, eq_noisy, max_rounds=8)if hyp isNone:print(f"p={p:>4.2f} : NON-STABILISE (aucun DFA coherrent) "f"apres {n_eq} conjectures")continue cex_real = find_counterexample(hyp, TARGET, ALPHABET) exact = cex_real isNone statut ="stable"if stable else"max_rounds" verdict ="EXACT vs TARGET"if exact elsef"ecart (contre-ex {cex_real!r})"print(f"p={p:>4.2f} : {len(hyp.states):>2} etats | {statut:>10s} | "f"{n_eq:>2} EQ | {verdict}")print()print("Lecture : le resultat n'est PAS monotone en p -- il depend de QUELS mots")print("l'oracle ment, pas seulement de combien. Ici le cas le moins bruite")print("(p=0.01) a ete le plus catastrophique : quelques mensonges mal places")print("creent une explosion d'etats (autant de distinctions de Myhill-Nerode")print("FANTOMES, memorisees dans T), alors que p=0.05 et p=0.20 retombent par")print("chance sur la cible de 4 etats. Avec une autre graine, l'issue serait")print("differente. Lecon centrale : un apprenant EXACT comme L* n'a AUCUNE")print("degradation gracieuse face au bruit -- son comportement est path-dependent")print("(un seul mensonge peut tout casser), la ou un classifieur statistique se")print("degrade SMOOTHMENT avec p (loi des grands nombres).")print()print("Reponse a la question : pourquoi UNE seule reponse fausse cree-t-elle un")print("etat fantome permanent ? L* memorise dans T la (fausse) valeur du mot et")print("la traite comme une VERITE de Myhill-Nerode. Cette distinction persiste")print("dans toutes les conjectures suivantes -- le filet statistique (moyenner")print("plusieurs tirages) n'existe pas. Un mensonge est pour L* une constante,")print("pas un bruit : c'est le prix de sa garantie d'exactitude.")
Oracle d'appartenance bruite : comportement de L* (cible TARGET = 4 etats)
==================================================================
p=0.05 :  4 etats | max_rounds |  2 EQ | EXACT vs TARGET
p=0.01 : 50 etats | max_rounds |  3 EQ | ecart (contre-ex 'bbbabbbab')
p=0.20 :  4 etats | max_rounds |  2 EQ | EXACT vs TARGET

Lecture : le resultat n'est PAS monotone en p -- il depend de QUELS mots
l'oracle ment, pas seulement de combien. Ici le cas le moins bruite
(p=0.01) a ete le plus catastrophique : quelques mensonges mal places
creent une explosion d'etats (autant de distinctions de Myhill-Nerode
FANTOMES, memorisees dans T), alors que p=0.05 et p=0.20 retombent par
chance sur la cible de 4 etats. Avec une autre graine, l'issue serait
differente. Lecon centrale : un apprenant EXACT comme L* n'a AUCUNE
degradation gracieuse face au bruit -- son comportement est path-dependent
(un seul mensonge peut tout casser), la ou un classifieur statistique se
degrade SMOOTHMENT avec p (loi des grands nombres).

Reponse a la question : pourquoi UNE seule reponse fausse cree-t-elle un
etat fantome permanent ? L* memorise dans T la (fausse) valeur du mot et
la traite comme une VERITE de Myhill-Nerode. Cette distinction persiste
dans toutes les conjectures suivantes -- le filet statistique (moyenner
plusieurs tirages) n'existe pas. Un mensonge est pour L* une constante,
pas un bruit : c'est le prix de sa garantie d'exactitude.
Exercice 4 (variation) : Robustesse par vote majoritaire
Le bruit de l’oracle d’appartenance casse l’hypothese d’exactitude de L. La parade classique : pour chaque mot, poser la requête K fois a l’oracle bruite et garder la reponse majoritaire (le vrai verdict ressort des que K est grand devant le taux de mensonges). Implementez ce robust_mq et montrez qu’il permet a L de retrouver le DFA exact.
Étapes : 1. Ecrire make_robust_mq(noisy_mq, K) : pour chaque mot, echantillonne K reponses bruitees et renvoie la majorite (memoire par mot, comme le bruite) 2. Lancer lstar_bounded avec robust_mq (K=21) sur un oracle bruite a p=0.05 3. Le DFA appris est-il exact vs TARGET ? Quel K minimal suffit pour p=0.05 ? pour p=0.20 ?
# Exercice 4 (variation) : robustesse par vote majoritaire# TODO etudiant : diluez le bruit en posant K fois chaque requete et en# gardant la reponse majoritaire.# Etape 1 : oracle robuste par vote majoritaire# def make_robust_mq(noisy_mq, K=21):# """Pour chaque mot, pose K fois la requete bruitee et renvoie la majorite."""# cache = {}# def robust_mq(word):# if word not in cache:# ... # TODO etudiant : K appels, majorite (sum(reponses) > K/2)# return cache[word]# return robust_mq# Etape 2 : lancer lstar_bounded avec robust_mq (K=21) sur un bruite p=0.05# noisy = make_noisy_mq(membership_query, p=0.05, seed=0)# robust = make_robust_mq(noisy, K=21)# eq_r = make_sampling_eq(robust, ALPHABET, 1000, seed=1)# hyp, _, _, _ = lstar_bounded(ALPHABET, robust, eq_r, max_rounds=15)# Etape 3 : exactitude vs TARGET + K minimal pour p=0.05 et p=0.20print("Exercice a completer : robustesse par vote majoritaire")print("Etape 1 : ecrivez make_robust_mq(noisy_mq, K) (vote majoritaire par mot)")print("Etape 2 : lancez lstar_bounded avec robust_mq (K=21) sur un bruite p=0.05")print("Etape 3 : le DFA est-il exact vs TARGET ? K minimal pour p=0.05 ? p=0.20 ?")# Indice : le vote majoritaire marche seulement si chaque appel bruite est# INDEPENDANT. Ici make_noisy_mq memoise par mot -> il faut lever la memoire# (un oracle bruite NON memoise) pour que K tirages soient independants.# result = None # TODO etudiant : le DFA robuste appris
Exercice a completer : robustesse par vote majoritaire
Etape 1 : ecrivez make_robust_mq(noisy_mq, K) (vote majoritaire par mot)
Etape 2 : lancez lstar_bounded avec robust_mq (K=21) sur un bruite p=0.05
Etape 3 : le DFA est-il exact vs TARGET ? K minimal pour p=0.05 ? p=0.20 ?
9. Pont vers Infer.NET : du DFA exact a la reconnaissance probabiliste de motifs
Les sections 6 et 7 ont etabli le talon d’Achille de L* : il est exact et donc fragile. L’exemple guide 4 (oracle d’appartenance bruite) l’a montre nettement – un seul mensonge memorise dans la table T créé un etat fantome permanent – et concluait par une promesse :
un apprenant EXACT comme L* n’a aucune degradation gracieuse face au bruit, la ou un classifieur statistique se degrade smoothment (loi des grands nombres).
Cette section construit ce classifieur statistique, et montre qu’il est le pendant probabiliste exact de l’automate appris par L*. C’est le pont vers la programmation probabiliste sur sequences d’Infer.NET (serie Probas/Infer).
Le changement de modèle
Automate exact (L*)
Chaîne probabiliste (Infer.NET)
Objet
DFA déterministe
automate pondere / HMM
Verdict
accepte / rejette (binaire)
P(accepte) (probabilite calibree)
Bruit
aucun modèle – un mensonge = une verite
modèle de canal explicite (epsilon)
Inference
parcours d’etat
algorithme forward (somme-produit)
Au lieu d’un oracle qui ment sur l’appartenance (section 6), on adopte le cadre naturel de la reconnaissance de motifs : un canal d’observation bruite sur les symboles eux-mêmes (pensez OCR, parole, capteurs). Le mot vrai w passe dans un canal qui retourne chaque symbole correct avec probabilite 1 - epsilon et le corrompt avec probabilite epsilon. On observe wabime et l’on cherche P(w vrai appartient au langage | observation).
# Reconnaissance probabiliste : l'algorithme forward sur les etats du DFA.## On reutilise EXACTEMENT le meme automate cible (TARGET, 4 etats de parite) que# L* devait apprendre. Mais au lieu de le parcourir en dur sur l'observation, on# marginalise sur le mot VRAI inconnu, pondere par le modele de canal :# alpha_t[q] = masse des prefixes vrais finissant dans l'etat q, sachant o_1..o_t# alpha_t[q'] = somme_q somme_s alpha_{t-1}[q] * P(s) * P(o_t | s) * [delta(q,s)=q']# C'est une passe somme-produit sur la chaine -- un automate pondere.def forward_accept_prob(dfa, observed, epsilon):"""P(mot vrai accepte par dfa | observation bruitee), canal symetrique.""" A = dfa.alphabet m =len(A) p_flip = epsilon / (m -1) if m >1else0.0# masse repartie sur les mauvais symboles alpha = {q: (1.0if q == dfa.start else0.0) for q in dfa.states}for o in observed: nxt = {q: 0.0for q in dfa.states}for q, mass in alpha.items():if mass ==0.0:continuefor s in A: lik = (1.0- epsilon) if s == o else p_flip # P(observer o | vrai s) nxt[dfa.delta[(q, s)]] += mass * (1.0/ m) * lik Z =sum(nxt.values()) or1.0# renormalise (anti-underflow) alpha = {q: v / Z for q, v in nxt.items()} Z =sum(alpha.values())returnsum(alpha[q] for q in dfa.accepting) / Z if Z >0else0.0# Garde-fou : a epsilon = 0, le canal est parfait -> le forward DOIT redonner le# verdict exact du DFA (1.0 ou 0.0). C'est la coherence avec L*.for w in ["", "a", "ab", "aabb", "abab", "aab", "bbaa", "abba"]: p0 = forward_accept_prob(TARGET, w, 0.0)assert (p0 >0.5) == membership_query(w) andabs(p0 - (1.0if membership_query(w) else0.0)) <1e-9print("Coherence epsilon=0 : le forward redonne le verdict exact du DFA. OK\n")# Une observation bruitee d'un mot VRAI du langage ('aabb' : 2 a, 2 b -> accepte).true_w ="aabb"print(f"Mot vrai w = {true_w!r} (appartient a L ? {membership_query(true_w)})")print(f"{'epsilon':>7} | {'P(accepte | obs)':>16} | lecture")print("-"*52)for eps in [0.0, 0.05, 0.10, 0.20, 0.35]: p = forward_accept_prob(TARGET, true_w, eps) note ="certain"if p >0.95else ("penche accepte"if p >0.5else"doute")print(f"{eps:>7.2f} | {p:>16.3f} | {note}")
Coherence epsilon=0 : le forward redonne le verdict exact du DFA. OK

Mot vrai w = 'aabb'  (appartient a L ? True)
epsilon | P(accepte | obs) | lecture
----------------------------------------------------
   0.00 |            1.000 | certain
   0.05 |            0.828 | penche accepte
   0.10 |            0.705 | penche accepte
   0.20 |            0.565 | penche accepte
   0.35 |            0.504 | penche accepte
Lecture : une probabilite calibree, pas un meilleur verdict
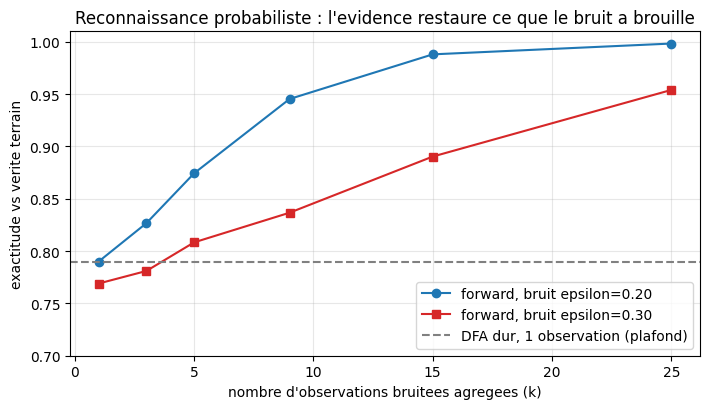
A partir d’une seule observation, la decision a seuil 0.5 du recognizer probabiliste coincide avec le parcours dur du DFA sur l’observation : pour epsilon < 0.5, le symbole le plus probable reste celui observe. Ce que le modèle probabiliste apporte d’emblee n’est donc pas une meilleure exactitude sur un coup, mais une confiance calibree : P(accepte) glisse doucement vers 0.5 quand le bruit monte – jamais le basculement catastrophique de L*, qui construisait un automate faux. La degradation est gracieuse.
Le vrai gain d’exactitude vient quand on dispose de plusieurs observations bruitees du même mot (plusieurs lectures OCR, plusieurs trames audio). C’est la version probabiliste – et correcte – du vote majoritaire de l’exercice 4.
# Agregation de preuves : k observations independantes du meme mot vrai.# Le canal corrompt independamment chaque copie. La vraisemblance par position# se multiplie sur les k copies -- la chaine integre l'evidence.import randomimport matplotlib.pyplot as pltdef forward_accept_prob_multi(dfa, observations, epsilon):"""Comme forward_accept_prob mais avec k observations du meme mot vrai.""" A = dfa.alphabet m =len(A) p_flip = epsilon / (m -1) if m >1else0.0 T =len(observations[0]) alpha = {q: (1.0if q == dfa.start else0.0) for q in dfa.states}for i inrange(T): column = [o[i] for o in observations] # les k lectures de la position i nxt = {q: 0.0for q in dfa.states}for q, mass in alpha.items():if mass ==0.0:continuefor s in A: lik =1.0for o_i in column: # produit de vraisemblance sur les k copies lik *= (1.0- epsilon) if s == o_i else p_flip nxt[dfa.delta[(q, s)]] += mass * (1.0/ m) * lik Z =sum(nxt.values()) or1.0 alpha = {q: v / Z for q, v in nxt.items()} Z =sum(alpha.values())returnsum(alpha[q] for q in dfa.accepting) / Z if Z >0else0.0def _corrupt(word, eps, rng):return"".join(c if rng.random() >= eps else ("a"if c =="b"else"b") for c in word)def batch_accuracy(eps, k, n_words=3000, seed=7):"""Exactitude : verdict dur sur 1 obs vs forward sur k obs, sur n_words mots.""" rng = random.Random(seed) hard1 = probk =0for _ inrange(n_words): w ="".join(rng.choice(ALPHABET) for _ inrange(rng.randint(0, 12))) y = membership_query(w) # verite terrain (mot propre) obs = [_corrupt(w, eps, rng) for _ inrange(k)] hard1 += (TARGET.accepts(obs[0]) == y) # baseline : DFA dur sur 1 lecture probk += ((forward_accept_prob_multi(TARGET, obs, eps) >0.5) == y)return hard1 / n_words, probk / n_wordsprint("Recuperation par agregation de k observations (n=3000 mots) :")print(f"{'k obs':>6} | {'dur (1 obs)':>11} | {'forward (k obs)':>15}")print("-"*40)ks = [1, 3, 5, 9, 15, 25]curve_20, curve_30, hard_ref = [], [], Nonefor k in ks: h20, p20 = batch_accuracy(0.20, k) _, p30 = batch_accuracy(0.30, k) curve_20.append(p20); curve_30.append(p30); hard_ref = h20print(f"{k:>6} | {h20:>11.3f} | eps=.20 {p20:.3f} eps=.30 {p30:.3f}")# Visualisation : la recuperation gracieuse de l'exactitude avec l'evidence.fig, ax = plt.subplots(figsize=(7.2, 4.2))ax.plot(ks, curve_20, "o-", color="#1f77b4", label="forward, bruit epsilon=0.20")ax.plot(ks, curve_30, "s-", color="#d62728", label="forward, bruit epsilon=0.30")ax.axhline(hard_ref, ls="--", color="grey", label="DFA dur, 1 observation (plafond)")ax.set_xlabel("nombre d'observations bruitees agregees (k)")ax.set_ylabel("exactitude vs verite terrain")ax.set_title("Reconnaissance probabiliste : l'evidence restaure ce que le bruit a brouille")ax.set_ylim(0.70, 1.01); ax.grid(alpha=0.3); ax.legend(loc="lower right")plt.tight_layout(); plt.show()
Le pont : Infer.NET fait exactement cela, automatiquement
Trois faits reunis ferment la boucle :
L’algorithme forward est du passage de messages. La recursion alpha_t[q'] = somme ... est l’algorithme somme-produit sur le graphe de facteurs en chaîne etat_0 -- etat_1 -- ... -- etat_T. C’est le même moteur qui calcule les marginales d’un HMM.
Infer.NET (Microsoft Research) automatise ce passage de messages. On y declare le modèle generatif – un mot vrai tire d’un prior, un canal qui le bruite, des observations – et le moteur infere la posterieure. Surtout, Infer.NET sait raisonner directement sur des distributions de sequences (StringDistribution), c’est-a-dire des automates ponderes : la version probabiliste native du DFA que L* apprend.
C’est la synthese neuro-symbolique de la serie. L* fournit la structure exacte (l’automate minimal, garanti) ; Infer.NET l’enveloppe d’une inference statistique robuste au bruit. Structure symbolique + inference probabiliste : ni l’exactitude fragile seule, ni le tout-statistique opaque.
Le canal ci-dessus est symetrique (même epsilon dans les deux sens). Beaucoup de capteurs reels sont asymetriques : confondre a en b est plus frequent que l’inverse. Reprenez forward_accept_prob avec une matrice de confusion P(observe | vrai) quelconque (2x2, lignes sommant a 1) au lieu du scalaire epsilon, puis verifiez que la coherence canal-parfait (matrice identite = verdict exact) tient toujours. Indice : seule la ligne lik = ... change.
# Exercice du pont : canal d'observation ASYMETRIQUE (matrice de confusion).## Objectif : generaliser forward_accept_prob a une matrice de confusion# confusion[(vrai, observe)] = P(observer 'observe' | vrai symbole 'vrai')# chaque ligne (vrai fixe) sommant a 1. Le canal symetrique en est le cas# particulier confusion[(s, s)] = 1 - epsilon, confusion[(s, autre)] = epsilon.def forward_accept_prob_confusion(dfa, observed, confusion):# Indice : recopier forward_accept_prob et remplacer la ligne# lik = (1 - epsilon) if s == o else p_flip# par# lik = confusion[(s, o)]# TODO etudiant : implementer la passe forward avec la matrice de confusion.pass# Verification attendue une fois implemente (canal parfait = identite -> verdict exact) :# identite = {(x, y): (1.0 if x == y else 0.0) for x in ALPHABET for y in ALPHABET}# for w in ["aabb", "aab", "abba"]:# p = forward_accept_prob_confusion(TARGET, w, identite)# assert (p is not None) and (p > 0.5) == membership_query(w)print("Exercice du pont a completer : forward avec matrice de confusion.")
Exercice du pont a completer : forward avec matrice de confusion.
10. Conclusion
Recapitulatif
Le modèle MAT (Angluin 1987) donne a l’apprenant le droit de poser des questions : appartenance (MQ) et equivalence (EQ). Ce droit change la classe de complexite du problème — l’inference passive du plus petit DFA consistant est NP-difficile, l’inference active est polynomiale.
La table d’observation\((S, E, T)\) approxime la congruence de Myhill-Nerode avec un ensemble fini de suffixes distinguants. Fermeture et consistance sont les deux conditions pour qu’elle definisse un DFA.
L* alterne stabilisation de la table, conjecture, et integration du contre-exemple. Chaque conjecture rejetee gagne au moins un etat : terminaison et minimalite sont garanties, en au plus \(n\) equivalences.
L’oracle d’equivalence exact n’existe pas en pratique : on echantillonne, et la garantie exacte devient garantie PAC. La fiabilite du résultat est plafonnee par celle du professeur.
Le model learning industrialise tout cela (LearnLib, machines de Mealy, protocoles reels) — et la variante moderne « LLM comme professeur, L* comme apprenant » re-applique la division du travail de SL-9.
Modalite du cours : chaque groupe choisit un exercice de la serie, le prepare, et le presente en seance. Resoudre l’exercice est le minimum ; ce qui distingue une presentation qui maitrise le sujet, c’est la question-twist associee ci-dessous. Elle fait partie integrante de la presentation attendue.
Exercice
Question-twist a traiter en plus
Ex. 1 (langage ‘abb’)
Verifiez que le DFA appris est minimal en exhibant, pour chaque paire d’etats, un suffixe qui les distingue (certificat de Myhill-Nerode). Pourquoi L* est-il structurellement incapable de retourner un DFA non minimal ?
Ex. 2 (fiabilite de l’EQ)
Reliez votre taux de reussite empirique a la borne PAC : combien d’echantillons la théorie exige-t-elle pour \(\varepsilon = 0.01, \delta = 0.05\) ? Construisez une distribution de tirage qui fait echouer l’echantillonnage quel que soit \(N\) raisonnable.
Ex. 3 (prefixes vs suffixes)
Exhibez le pire cas : une famille de langages ou les contre-exemples sont longs et ou la variante prefixes fait exploser $S$. La variante de Rivest-Schapire n’ajoute qu’UN suffixe trouve par dichotomie sur le contre-exemple : quel est son cout en MQ et pourquoi est-ce le bon compromis ?
Ex. 4 (oracle bruite)
Peut-on reparer L* par vote majoritaire (poser chaque MQ 2k+1 fois) ? Calculez le surcout en requêtes et la probabilite residuelle d’erreur ; comparez avec la degradation graduelle d’un classifieur statistique sous le même bruit. Que conclure sur le contrat exactitude-contre-robustesse du symbolique ?
Ressources
D. Angluin, Learning Regular Sets from Queries and Counterexamples, Information and Computation 75(2), 1987
M. Kearns & U. Vazirani, An Introduction to Computational Learning Theory, ch. 8 (MIT Press, 1994)
F. Vaandrager, Model Learning, Communications of the ACM 60(2), 2017
R. Rivest & R. Schapire, Inference of Finite Automata Using Homing Sequences, Information and Computation 103(2), 1993
LearnLib — bibliotheque de reference du model learning
E. M. Gold, Complexity of Automaton Identification from Given Data, Information and Control 37, 1978