Pipeline d’entraînement ML pour la prévision financière
Pipeline d’entraînement complet pour modèles ML sur données financières OHLCV. Conçu pour l’entraînement GPU avec validation CPU en dry-run. Tous les scripts GPU utilisent l’entraînement sécurisé thermiquement via shared/gpu_training.py (MAX_TEMP=80C, AMP, batch_thermal_check).
Aperçu — la diversité méthodologique du pipeline en images
Les notebooks de ce répertoire explorent une gamme de familles de modèles — du HAR économétrique aux Transformers à attention — appliqués à la prévision de la variance réalisée et à la détection de régimes. Plutôt qu’une galerie séparée du propos, les six sorties de diagnostic ci-dessous sont présentées par paradigme, au plus près de la question qu’elles tranchent ; la plupart documentent des résultats négatifs (prévisions pures, sophistication structurelle qui nuit, dilution d’ensemble), reflet honnête du ladder expérimental. Provenance et poids de chaque figure : assets/readme/MANIFEST.md.
Détection de régimes et structure de la variance
Deux diagnostics ouvrent le ladder : la détection de régimes par HMM et la structure de la variance par HAR-RV-J. Le HMM (m5) produit les probabilités postérieures par état (bull/bear/neutral/vol) ; le HAR-RV-J (m12) décompose la variance réalisée en composante continue et sauts discontinus :
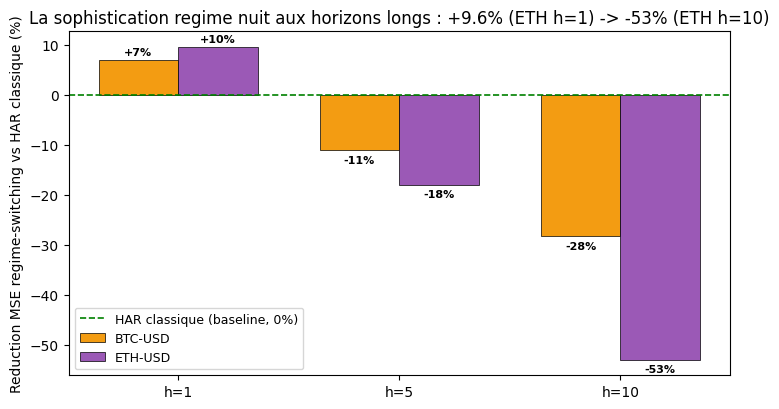
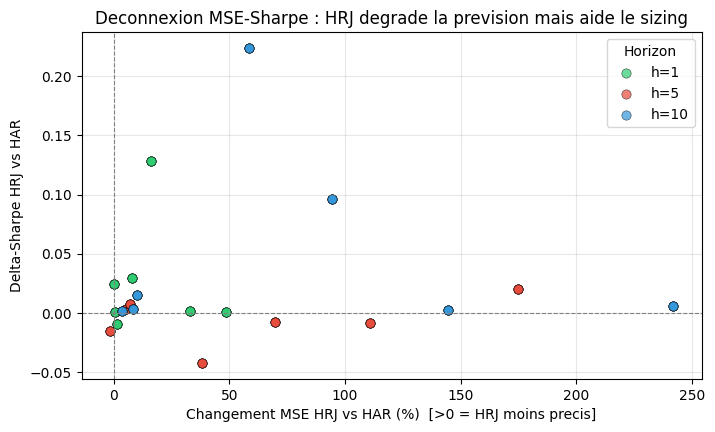
Sorties des notebooks m5 (gauche, cellule 6) et m12 (droite, cellule 6) : régimes HMM et décomposition HAR-RV-J de la variance.
Prévisions de volatilité : DL linéaire vs séquentiel
Sur la prévision de variance réalisée, le DLinear (m4) teste si un simple réseau linéaire bat la baseline HAR — un résultat négatif typique (la sophistication linéaire n’apporte pas gain net). Le Log-LSTM (m15) explore la piste de la mémoire séquentielle :
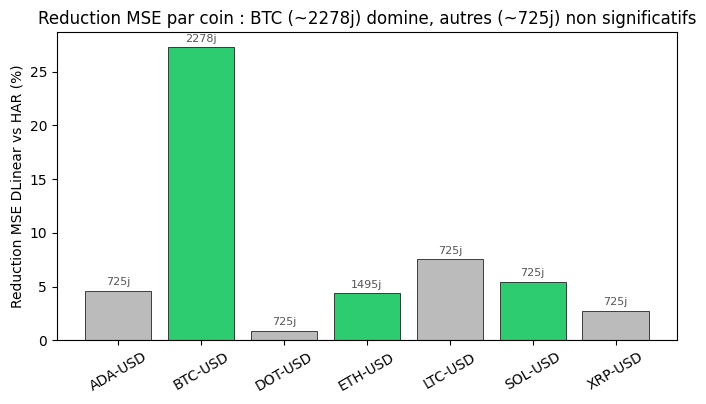
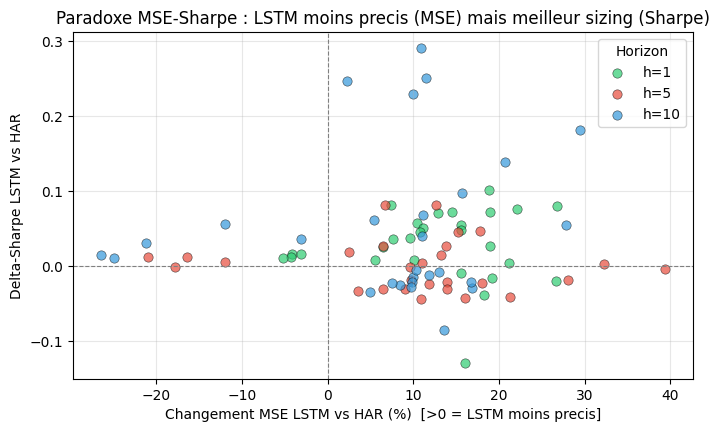
Sorties des notebooks m4 (gauche, cellule 6) et m15 (droite, cellule 6) : prévisions DLinear et Log-LSTM de la variance réalisée.
Attention temporelle et diagnostic d’ensemble
Enfin, le TFT (m9) apporte l’attention temporelle (pondération des variables d’entrée), tandis que le diagnostic d’ensemble HAR-Kelly (m11e) illustre un résultat négatif central : la dilution des performances quand on combine des experts :
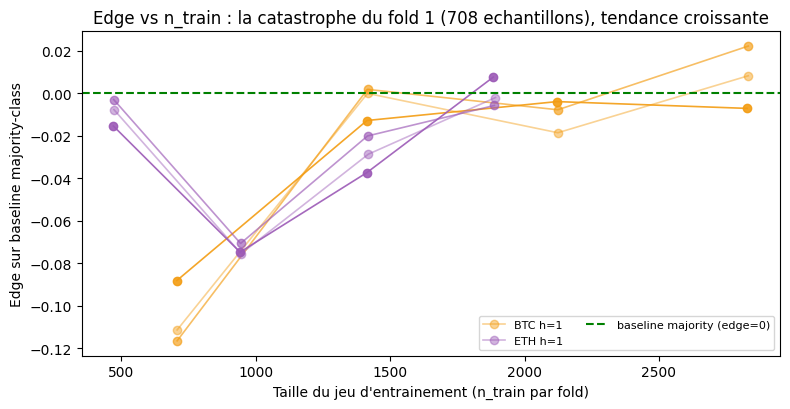
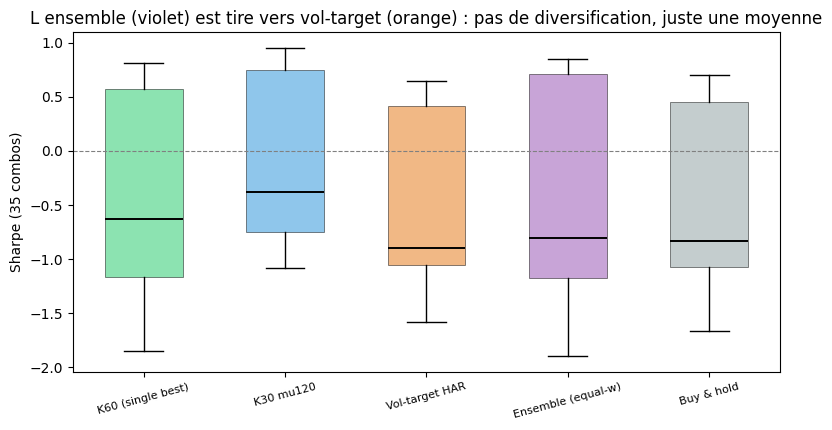
Sorties des notebooks m9 (gauche, cellule 6) et m11e (droite, cellule 6) : attention TFT et diagnostic d’ensemble HAR-Kelly.
Classification type (c) — standalone
Les notebooks de ce répertoire sont des recherches indépendantes (c) — analyses utilisant des données locales (yfinance, sklearn, PyTorch), sans dépendance QuantConnect Cloud.
| Notebook | Sujet | Type |
|---|---|---|
ML-Research-Template.ipynb |
Template pour recherche ML | (c) |
m3_har_asymmetric_semivariance.ipynb |
M16 — HAR asymétrique débiaisé : le signal survit-il hors biais ? | (c) |
research_what_dl_can_predict.ipynb |
Ce que le DL peut prédire en finance | (c) |
research_l1_tsmom.ipynb |
L1 TSMOM — baseline momentum temporelle (NO BEATS) | (c) |
research_l2_dual_momentum.ipynb |
L2 Cross-Sectional + Dual Momentum (NO BEATS) | (c) |
research_l3_trend.ipynb |
L3 Trend Long-Horizon — LSTM directionnel (NO BEATS) | (c) |
research_l4_decision_transformer.ipynb |
L4 Decision Transformer (BEATS panel @10bps ; OOT réel NO-BEATS) | (c) |
c1330_xrp_dt_foldwise_research.ipynb |
c.1330 — XRP Decision Transformer : validation fold-wise §C (verdicts par bucket) | (c) |
hmm_alpha_research.ipynb |
HMM gaussien pour alpha trading (Broad Ch6 Ex4) | (c) |
c875_hmm_alpha_dm_research.ipynb |
C875 — HMM-alpha : validation rigoureuse Ledoit-Wolf DM (stress 50 bps, INCONCLUSIVE) | (c) |
m4_dlinear_vol_research.ipynb |
DLinear-vol : DL linéaire vs HAR (prévisions pures) | (c) |
m5_hmm_regime_research.ipynb |
HMM regime-switching HAR : quand la sophistication structurelle nuit | (c) |
m9_tft_vol_research.ipynb |
TFT (Temporal Fusion Transformer) : l’échec du surparamétrage | (c) |
m11e_ensemble_research.ipynb |
Ensemble HAR-Kelly : la dilution confirmée (3e axe d’échec) | (c) |
m12_har_rv_j_research.ipynb |
HAR-RV-J : décomposition de sauts (Andersen-Bollerslev-Diebold 2007) | (c) |
m15_lstm_rv_research.ipynb |
Log-LSTM RV : mémoire séquentielle pour la variance réalisée | (c) |
m4_dlinear_vol_sc_validation.ipynb |
M4 — DLinear-vol : entrée §C du registre (conjonction multi-seed + DM loss_fn="linear") |
(c) |
m15_lstm_rv_sc_validation.ipynb |
M15 — LSTM RV : entrée §C du registre (2e entrée §C, même protocole) | (c) |
Classification complète : docs/qc/qc-strategies-status.md
Curriculum V2 — Keepers validés (2026-05-16, gate FERMEE)
Après 8 stages testés (S1–S8) sur un univers anti-FAANG/Mag7 (SPY, TLT, XLF, XLK, XLE, XLV, XLY, XLI, XLB, XLU, XLP), 4 KEEPERS confirmés sous OOS strict 2027 holdout, walk-forward 5-fold expanding, 4-seed block bootstrap (22-day blocks), coûts tx 10bps rebalance + 50bps stress — amendé le 2026-09-13 (M12 revalidé NO BEATS, note sous le tableau) :
| Stage | Stratégie | Δ-Sharpe | Signification statistique | MaxDD | Script |
|---|---|---|---|---|---|
| S1 vol | M12 HAR-RV-J (HAR augmenté par sauts) — retiré des keepers le 2026-09-13 | n/a | Cycle 31 : p=0.0015 (56/84 sign-test) — non confirmé (note ci-dessous) | n/a | m12_har_rv_j.py |
| S1 vol | M15 LSTM h=32 (LSTM log-RV) | n/a | p=0.0107 (53/84 sign-test) | n/a | m15_lstm_rv.py |
| S3 regime | HMM Regime (2 états, quotidien) | +0.669 | 4/4 seeds positifs | -39.1% | s3_hmm_regime.py |
| S4 v2 | Ridge vol-inverse + HMM | +0.325 | 4/4 seeds positifs | -17.7% | s4_inverse_vol_ridge_v2.py |
Amendement 2026-09-13 — M12 revalidé NO BEATS (#16004, Epic #1454) : sous protocole cluster symétrique (sept actifs, calibration train-only des deux côtés, DM sur perte MSE, sign-test binomial exact au niveau actif), M12 obtient 0/7 BEATS, p = 1,0 — ADA NO BEATS (3/3 horizons), ETH NO BEATS (h=5/h=10), cinq actifs INCONCLUSIVE. Le BEATS Cycle 31 (p=7,9e-7) n’est pas confirmé : il comptait quatre labels de seed bit-identiques d’un OLS déterministe comme répétitions et calibrait la baseline seule. Non réfuté définitivement — protocoles et fenêtres diffèrent. Détail :
REGISTRY.md§M12 etdocs/M12_HAR_RV_J.md.
S1 long-horizon sweep a également produit 8 BEATS multi-coin sur 16 (XRP h=66 13.5σ, ETH h=132 5.0σ, BTC h=22/66 BEATS). Reco portfolio : S3 + S4 v2 rebalance mensuel, Sharpe ~1.12.
Stages rejetés (NO BEATS) : S2 vol-ensembles (DM, MLP, GSP), S5 stop-loss overlays, S6 LO-only sectors, S7 composites, S8 classifieurs long-horizon (dir_acc ≠ edge).
Detail complet :
docs/Curriculum_V2_Meta_Analysis.md— méthodologie, ablations, leçons. Pivot V2 documenté dansCURRICULUM.md. 3 projets QC Cloud déployés à partir de ces KEEPERS — cf../partner-course-quant-trading/README.md.
Architecture
Le pipeline enchaîne ingestion → features → entraînement (4 familles de modèles) → validation walk-forward → checkpointing reproductible. Chaque étape est découplée et cache ses sorties (Parquet, .pt+metadata.json) pour permettre itérations rapides sans relancer l’amont.
flowchart TD
    DATA["Donnees OHLCV<br/>yfinance / Binance / QC lean-cli"] --> FE["Feature Engineering<br/>features.py (cache Parquet)"]
    FE --> DS["Dataset V2<br/>panier + cross-asset + labels regime"]
    DS --> TRAIN{"Famille de modele"}
    TRAIN -->|"Core direction"| C["RF / XGBoost / LSTM / DQN"]
    TRAIN -->|"Advanced"| A["MoE / PatchTST / iTransformer / Mamba / DT"]
    TRAIN -->|"Volatilite & regime"| V["GARCH+DL / HMM / HAR-RV-J (M12)"]
    TRAIN -->|"Graph"| G["GCN / GAT / MTGNN / ST-GAT"]
    C & A & V & G --> WF["Validation walk-forward<br/>5-fold expanding, 4-seed"]
    WF --> VERD{"Verdict BEATS / NO BEATS<br/>(sign-test, p<0.05, win>=60%)"}
    VERD --> CKPT["Checkpoint<br/>model.pt + metadata.json"]
    VERD -.-> NO["NO BEATS<br/>(documente honnetement)"]
    CKPT --> REG["REGISTRY.md"]
    %% color: explicite -- sans lui, libelle clair sur fond clair en mode sombre GitHub (#15022) ; ton parfois plus fonce que le stroke (le stroke en couleur de texte rendrait infer illisible) : ne pas harmoniser
    style VERD fill:#fff3e0,color:#bf360c
    style CKPT fill:#e8f5e9,color:#1b5e20
    style NO fill:#ffebee,color:#721c24
Ci-dessous, l’arborescence des scripts qui implémente ce pipeline.
scripts/
  # --- Data & Features ---
  features.py                      # Feature engineering réutilisable (indicateurs + cache)
  build_dataset_v2.py              # Builder dataset V2 : panier + cross-asset features + labels regime
  data_utils.py                    # Chargement données, génération synthétique, hachage
  garch_baseline.py                # GARCH(1,1) rolling refit (sans fuite de données) + comparaison leaky
  regime_detector.py               # Détection regime prix-based (uptrend/downtrend/vol/black_swan)
  baselines.py                     # Baselines majority-class, buy-hold, momentum + calcul Sharpe

  # --- Training: Core models ---
  train_classification.py          # RandomForest + XGBoost (CPU/GPU)
  train_lstm.py                    # PyTorch LSTM/GRU (GPU recommandé)
  train_transformer.py             # Transformer financier (GPU requis pour full scale)
  train_dqn_rl.py                  # DQN Reinforcement Learning (GPU recommandé)

  # --- Training: Advanced architectures ---
  train_moe_regimes.py             # MoE avec routing régime-aware (Issue #754 Phase B)
  train_moe.py                     # MoE avec gating network
  train_patchtst.py                # PatchTST (Nie et al., ICLR 2023)
  train_itransformer.py            # iTransformer (Li et al., ICLR 2024)
  train_mamba.py                   # Mamba SSM baseline
  train_rl_dt.py                   # Decision Transformer pour RL

  # --- Training: Volatility & regime ---
  train_volatility_garch_dl.py     # GARCH+DL hybrid prévision volatilité
  train_volatility_regime.py       # Classifieur regime volatilité
  train_regime_classifier.py       # Détection regime HMM
  train_har_baseline.py            # HAR(1,5,22d) vs GARCH-rolling vs naive sur crypto RV (#834 M2)
  train_realized_garch.py          # Realized GARCH (M10, Hansen et al. 2012)

  # --- Volatility sweep series (M10-M15) ---
  realized_variance.py             # RV quotidien à partir de OHLCV intraday + transformée log
  intraday_loader.py               # Loader données horaires yfinance avec cache Parquet
  har_model.py                     # Modèle HAR(1,5,22) + walk-forward pour baseline
  simulate_har_kelly.py            # HAR Kelly sweep (baseline M2)
  m11g_fee_aware_kelly.py          # Framework Kelly fee-aware (shared par tous M-series)
  m11c_sharpe_test.py              # Ledoit-Wolf Sharpe diff SE + sign-test
  m12_har_rv_j.py                  # HAR-RV-J jump-augmented (M12)
  m13_ms_har.py                    # Markov-Switching HAR (M13, Hamilton 1989)
  m14_heavy.py                     # HEAVY bivariate (M14, Shephard & Sheppard 2010)
  m15_lstm_rv.py                   # Log-LSTM RV (M15, neural sur log-realized variance)

  # --- Training: Graph Neural Networks ---
  train_gnn.py                     # GNN (GCN/GAT/RGCN) sur crypto panier
  train_mtgnn.py                   # Multivariate Time-series GNN
  train_stgat.py                   # Spatial-Temporal GAT

  # --- Training: Baselines ---
  train_baselines_crypto_panier.py # Baselines Stage 0 (10 coins, WF 5-fold x 4 seeds)

  # --- Evaluation ---
  eval_rl_dt.py                    # Harness évaluation checkpoint Decision Transformer
  eval_chronos_bolt.py             # Évaluation zero-shot Chronos-Bolt (Amazon, ~200M params)
  eval_kronos_zeroshot.py          # Évaluation zero-shot Kronos (AAAI 2026, 4 tailles)
  eval_finstsb.py                  # Évaluation per-regime style FinTSB (4 régimes)
  eval_existing_checkpoints.py     # Pipeline complet : WF + baselines + régimes + coûts transaction
  shadow_replay.py                 # Suivi en ombre : candidates gelées par SHA, rejeu mensuel, CSV en ajout seul (#18923)

  # --- Infrastructure ---
  checkpoint_utils.py              # Shared sauvegarde checkpoint PyTorch (model.pt + metadata.json)
  launch_po2025_track_a1.py        # Launcher séquentiel : Transformer -> DQN -> LSTM
  launch_ai01_track_b.py           # Launcher Track B (ai-01 RTX 4090 baselines)
  validate_training_package.py     # Valider tous les scripts avec --dry-run
  registry_update.py               # Construire REGISTRY.md depuis checkpoints
  walk_forward.py                  # Splitter walk-forward (expanding window, 5-fold)

checkpoints/                       # Modèles sauvés + metadata (auto-created)
  classification/<timestamp>/
  lstm/<timestamp>/
  transformer/<timestamp>/
  dqn/<timestamp>/
  moe_regimes/<timestamp>/
outputs/                           # Logs d'entraînement et artefacts de run
REGISTRY.md                        # Catalogue checkpoint auto-généré
Démarrage rapide
Valider le pipeline (CPU, pas de données requises)
python scripts/validate_training_package.py --verboseEntraîner sur données réelles
# Classification (RF/XGBoost)
python scripts/train_classification.py --data-dir ../datasets/yfinance --symbol SPY --start 2010-01-01

# LSTM
python scripts/train_lstm.py --data-dir ../datasets/yfinance --symbol SPY --hidden-size 256 --epochs 100

# Transformer (full scale pour GPU 24GB)
python scripts/train_transformer.py --data-dir ../datasets/yfinance --symbol SPY \
    --d-model 256 --nhead 8 --num-layers 6 --dim-ff 1024 --epochs 100 --batch-size 64

# DQN RL agent
python scripts/train_dqn_rl.py --data-dir ../datasets/yfinance --symbol SPY \
    --hidden-size 512 --num-episodes 500
Dry-run de n’importe quel script
python scripts/train_<model>.py --dry-runUtilise des données synthétiques, epochs minimales. Valide le pipeline complet sans GPU ni données réelles.
Modèles
Core (prédiction direction)
| Script | Modèle | Tâche | GPU | Target 24GB |
|---|---|---|---|---|
| train_classification.py | RandomForest / XGBoost | Classification de direction (haut/bas) | Optionnel | 200+ arbres, profondeur 12 |
| train_lstm.py | LSTM / GRU | Régression de rendement | Recommandé | hidden=512, layers=4 |
| train_transformer.py | Transformer encoder | Régression de rendement | Requis | d_model=256, heads=8, layers=6 |
| train_dqn_rl.py | DQN | Actions de trading (buy/sell/hold) | Recommandé | hidden=512, 500 épisodes |
Architectures avancées (Issue #754)
| Script | Modèle | Tâche | GPU | Notes |
|---|---|---|---|---|
| train_moe_regimes.py | MoE + routeur regime | Direction via experts régime-aware | Recommandé | Experts LSTM/GRU/Transformer par régime (bull/bear/neutral/vol) |
| train_moe.py | MoE + gating network | Direction via mixture of experts | Recommandé | Routing soft via gating |
| train_patchtst.py | PatchTST | Prévision multivariée | Requis | Patch tokenization (ICLR 2023) |
| train_itransformer.py | iTransformer | Prévision multivariée | Requis | Inverted attention sur variates (ICLR 2024) |
| train_mamba.py | Mamba SSM | Modélisation séquentielle | Recommandé | Baseline state-space model |
| train_rl_dt.py | Decision Transformer | RL via modélisation séquentielle | Recommandé | Offline RL, return-conditioned |
Volatilité & régime
| Script | Modèle | Tâche | GPU | Notes |
|---|---|---|---|---|
| train_volatility_garch_dl.py | GARCH(1,1) + DL hybrid | Prévision volatilité | Recommandé | Correction LSTM/Transformer/TFT sur résidus GARCH |
| train_volatility_regime.py | Regime LSTM | Détection régime volatilité | Optionnel | HMM + classifieur LSTM |
| train_regime_classifier.py | HMM | Détection régime (bull/bear/neutral/vol) | CPU | Hidden Markov Model |
Graph Neural Networks (crypto panier)
| Script | Modèle | Tâche | GPU | Notes |
|---|---|---|---|---|
| train_gnn.py | GCN / GAT / RGCN | Spillover cross-asset | Requis | Panier crypto 10 coins, adjacency corr rolling |
| train_mtgnn.py | MTGNN | Apprentissage graph multivarié | Requis | Apprend structure de graphe |
| train_stgat.py | ST-GAT | Attention spatio-temporelle | Requis | Attention sur dims spatial + temporal |
Baselines volatilité
| Script | Modèle | Tâche | GPU | Notes |
|---|---|---|---|---|
| train_har_baseline.py | HAR(1,5,22d) | Prévision Realized Variance | CPU | Walk-forward 5-fold vs GARCH-rolling, crypto OHLCV horaire (#834 M2) |
Série volatilité sweep (M10–M15)
Comparaison systématique de modèles de volatilité contre HAR Classic Kelly sur 7 crypto coins (BTC-USD, ETH-USD, SOL-USD, LTC-USD, XRP-USD, ADA-USD, DOT-USD), 3 horizons (h=1,5,10), 4 seeds (0,1,7,42), walk-forward 5-fold expanding. Kelly cap=1.0, fee=50bps. Verdict : sign-test apparié Sharpe-diff vs HAR Classic, BEATS requiert p<0.05 AND win>=60%.
| Script | Doc | Modèle | Params | Verdict |
|---|---|---|---|---|
| train_realized_garch.py | M10_REALIZED_GARCH_VOL.md | Realized GARCH (Hansen et al. 2012) | ~8 | NO BEATS (MSE +62%) |
| simulate_har_kelly.py | M2_HAR_BASELINE.md | HAR Classic Kelly (Corsi 2009) | 4 | Baseline (Sharpe +0.313 vs BH) |
| m12_har_rv_j.py | M12_HAR_RV_J.md | HAR-RV-J (jump-augmented) | 7 | Cycle 31 : BEATS (p=7.9e-7) — non confirmé : revalidation cluster 2026-09-13 NO BEATS (0/7, p=1,0, #16004) |
| m13_ms_har.py | M13_MS_HAR.md | Markov-Switching HAR (Hamilton 1989) | 11 | NO BEATS (39/84, p=0.7774) |
| m14_heavy.py | M14_HEAVY.md | HEAVY (Shephard & Sheppard 2010) | 6 | NO BEATS (48/84, p=0.1149) |
| m15_lstm_rv.py | M15_LSTM_RV.md | Log-LSTM RV (Hochreiter 1997) | ~4.8K (h=32) / ~17.7K (h=64) / ~68.2K (h=128) | NO BEATS h=32 (44/84, p=0.372, §C #11395) / NO BEATS h=64/128 (runs non trackes) |
Modules support : har_model.py, realized_variance.py, intraday_loader.py, m11g_fee_aware_kelly.py, m11c_sharpe_test.py. Roadmap complète : docs/M_NEXT_VOL_PROPOSAL.md.
Harness d’évaluation
| Script | Purpose | Notes |
|---|---|---|
| eval_rl_dt.py | Évaluation checkpoint DT | Walk-forward OOS, comparaison majority-class, analyse coûts transaction |
| eval_chronos_bolt.py | Chronos-Bolt zero-shot | T5-based Amazon, ~200M params, 250x plus rapide que Chronos original |
| eval_kronos_zeroshot.py | Kronos zero-shot | AAAI 2026, pre-trained sur 12B K-lines, 4 tailles modèle (4M-499M) |
| eval_finstsb.py | Évaluation per-regime | 4 régimes (uptrend/downtrend/volatility/black_swan) |
| eval_existing_checkpoints.py | Évaluation pipeline complet | WF + baselines + per-regime + coûts transaction pour tout checkpoint |
| shadow_replay.py | Suivi en ombre des candidates | Gel par SHA, rejeu mensuel du code gelé (local, ou backtest QC via plan-qc puis ingest-qc), CSV en ajout seul ; règles et commandes dans shadow/README.md (#18923) |
Construction de dataset
| Script | Purpose | Notes |
|---|---|---|
| build_dataset_v2.py | Builder dataset V2 panier | 26 symboles, 7 classes d’actifs, features cross-asset, labels régime HMM+price (#754 Phase C) |
Utilitaires partagés
| Script | Purpose | Notes |
|---|---|---|
| features.py | Moteur feature engineering | Indicateurs composables avec cache Parquet |
| data_utils.py | Utilitaires I/O données | Load yfinance/Binance, génération synthétique, hachage SHA256 |
| baselines.py | Modèles baseline | Majority-class, buy-hold, momentum. Calcul Sharpe |
| garch_baseline.py | Utilitaires GARCH | Rolling refit (sans fuite de données) vs comparaison leaky. Calcul vol realized |
| regime_detector.py | Détection régime | Prix-based : uptrend/downtrend/volatility/black_swan |
| checkpoint_utils.py | I/O checkpoint | save_pytorch_checkpoint(): model.pt + metadata.json avec architecture/metrics/history |
| walk_forward.py | Splitter walk-forward | Expanding window, n_splits configurable |
Baselines
| Script | Purpose | Notes |
|---|---|---|
| train_baselines_crypto_panier.py | Baselines Stage 0 (10 coins) | Majority, buy-hold, momentum, RF. WF 5-fold x 4 seeds, 10bps coûts |
Variables explicatives
Tous les indicateurs sont disponibles via scripts/features.py — fonctions composables avec cache Parquet :
from features import FeatureEngineer

engineer = FeatureEngineer(lookback=20)
features = engineer.transform(df, cache_path="cache/spy.parquet")| Feature | Description |
|---|---|
| ret_1d, ret_5d, ret_10d, ret_20d | Rendements multiples horizons |
| vol_5d, vol_20d | Volatilité réalisée |
| vol_ratio | Volume vs moyenne 20 jours |
| ma_ratio_5/10/20/60 | Prix vs ratio moyenne mobile |
| rsi_14 | Relative Strength Index (14 périodes) |
| macd, macd_signal | Indicateur MACD |
| bb_width | Largeur Bollinger Band |
| true_range, atr_14 | True Range et ATR (requiert OHLC) |
| obv | On-Balance Volume (normalisé rolling-std) |
Points de contrôle (checkpoints)
Chaque run d’entraînement sauve dans checkpoints/<model>/<timestamp>/ :
checkpoints/lstm/20260430_143022/
  model.pt (ou model.joblib pour sklearn)
  metadata.json
Structure metadata.json
{
  "timestamp": "20260430_143022",
  "model_type": "lstm",
  "hyperparams": { ... },
  "metrics": { "mse": 0.000123, "direction_accuracy": 0.5432, ... },
  "history": { "train_loss": [...], "val_loss": [...] },
  "data_hash": "a1b2c3d4e5f6g7h8",
  "architecture": { "input_size": 14, "hidden_size": 128, "num_layers": 2 },
  "files": ["model.pt", "metadata.json"]
}
Charger un checkpoint
import torch, json
from pathlib import Path

ckpt = Path("checkpoints/lstm/20260430_143022")
metadata = json.loads((ckpt / "metadata.json").read_text())

# Pour modèles PyTorch (LSTM, Transformer, DQN)
from train_lstm import build_model
model = build_model(
    input_size=metadata["architecture"]["input_size"],
    hidden_size=metadata["architecture"]["hidden_size"],
    num_layers=metadata["architecture"]["num_layers"],
)
model.load_state_dict(torch.load(ckpt / "model.pt", weights_only=True))

# Pour modèles sklearn (classification)
import joblib
model = joblib.load(ckpt / "model.joblib")
Sources de données
Conçu pour fonctionner avec datasets de scripts/datasets/ (Track A) :
| Source | Script | Path par défaut |
|---|---|---|
| yfinance | download_yfinance.py |
../datasets/yfinance/ |
| Binance | download_binance_klines.py |
../datasets/binance/ |
| Crypto archive | manage_crypto_archive.py |
../datasets/crypto_archive/ |
| QC lean-cli | download_qc_data.py |
../datasets/qc/ |
Sécurité thermique (entraînement GPU)
Tous les scripts d’entraînement GPU importent de shared/gpu_training.py pour protection thermique :
from shared.gpu_training import batch_thermal_check, setup_amp, get_gpu_temp| Function | Usage | Défaut |
|---|---|---|
batch_thermal_check(temp, max_temp) |
Pause 30s si GPU dépasse seuil | max_temp=80C |
thermal_check(max_temp) |
Check entre épisodes (DQN) | max_temp=80C |
setup_amp(model, optimizer) |
Activer Automatic Mixed Precision | Activé par défaut |
get_gpu_temp() |
Lire température GPU via nvidia-smi | n/a |
Comportement thermique : Quand GPU dépasse MAX_TEMP, l’entraînement pause 30s. Sur laptops (MSI GE76 RTX 3080 Ti), attendre ~80C baseline, donc pauses thermiques fréquentes. L’efficacité d’entraînement est ~2-5% wall time sur hardware thermiquement contraint.
Lanceurs séquentiels
Track A1 (launch_po2025_track_a1.py) lance modèles séquentiellement avec sécurité thermique complète :
# Track A1 complet : Transformer -> DQN -> LSTM
python scripts/launch_po2025_track_a1.py --symbol SPY --data-dir ../datasets/yfinance
Track B (launch_ai01_track_b.py) lance baselines sur ai-01 (RTX 4090, pas de problèmes thermiques).
Dépendances
Core (tous les scripts)
numpy
pandas
scikit-learn
joblib
PyTorch (LSTM, Transformer, DQN)
torch>=2.0Optionnel
xgboost      # Classification améliorée (fallback vers RF)
arch         # Modèles volatilité GARCH (garch_baseline.py, train_har_baseline.py)
hmmlearn     # Détection régime HMM (train_regime_classifier.py)
fastparquet  # I/O Parquet pour dataset V2 (build_dataset_v2.py)
pyarrow      # Parquet backend (build_dataset_v2.py)
Commandes GPU recommandées (RTX 4090 24GB)
# LSTM - full scale
python scripts/train_lstm.py --data-dir ../datasets/yfinance --symbol SPY \
    --hidden-size 512 --num-layers 4 --dropout 0.3 \
    --seq-len 60 --epochs 200 --batch-size 128 --lr 5e-4

# Transformer - utilisation max
python scripts/train_transformer.py --data-dir ../datasets/yfinance --symbol SPY \
    --d-model 256 --nhead 8 --num-layers 6 --dim-ff 1024 --dropout 0.15 \
    --seq-len 60 --epochs 150 --batch-size 64 --lr 3e-4

# DQN - entraînement étendu
python scripts/train_dqn_rl.py --data-dir ../datasets/yfinance --symbol SPY \
    --hidden-size 512 --num-episodes 1000 --replay-size 200000 \
    --batch-size 128 --lr 5e-4 --eps-decay 0.997
Validation (dry-run)
Tous les scripts supportent --dry-run (données synthétiques, 2 epochs) sauf train_moe.py, train_volatility_garch_dl.py, et train_regime_classifier.py (pas de flag dry-run).
# Valider tous les scripts
python scripts/validate_training_package.py --verbose
Résultats dry-run (CPU, Python 3.13, torch 2.11.0+cpu) :
| Script | Status | DirAcc / Metric | Time |
|---|---|---|---|
| train_classification.py | PASS | Acc=0.427 | ~2s |
| train_lstm.py | PASS | DirAcc=0.476, MSE=0.001 | ~7s |
| train_transformer.py | PASS | DirAcc=0.512, MSE=0.002 | ~7s |
| train_dqn_rl.py | PASS | OOS Sharpe OK | ~120s |
| train_moe_regimes.py | PASS | DirAcc=0.462, 2 folds | ~15s |
| train_gnn.py | PASS | Edge=-0.035 (FAILS baseline) | ~5s |
| train_patchtst.py | PASS | Edge=-0.169 (FAILS baseline) | ~5s |
| train_itransformer.py | PASS | Edge=-0.120 (FAILS baseline) | ~5s |
| train_mamba.py | PASS | Edge=-0.177 (FAILS baseline) | ~5s |
| train_mtgnn.py | PASS | Edge=-0.004 (FAILS baseline) | ~5s |
| train_stgat.py | PASS | Edge=-0.034 (FAILS baseline) | ~5s |
| train_rl_dt.py | PASS | Edge=+0.223 (BEATS baseline) | ~5s |
| train_volatility_regime.py | PASS | Acc=0.663, Edge=-0.266 | ~5s |
Note : dry-run utilise des données aléatoires synthétiques. FAILS baseline est attendu avec random walks. Les résultats données réelles sont dans results/ et sur le dashboard cluster.
Ladder #1409 — Verdicts finaux (2026-06-12, COMPLETE)
Évaluation systématique d’approches de génération de signaux de trading, 7 disciplines strictes (walk-forward 5-fold expanding, multi-seed >= 4, univers anti-FAANG, coûts tx explicites + 50bps stress, Sharpe déflaté, verdict honnête).
La leçon centrale du ladder n’est pas le score d’un modèle isolé mais le contraste entre deux paradigmes de formulation du signal : prédire la direction/action discrète (Buy/Hold/Sell) vs prédire le rendement futur continu puis seuiller. Le graphe ci-dessous résume pourquoi seul le paradigme action-based survit au seuil BEATS face au buy-and-hold 2015-2025 (Sharpe 1.15).
flowchart LR
    subgraph PARA["Deux paradigmes de signal"]
        direction TB
        P1["Paradigme action<br/>RF / DT / DQN"]
        P2["Paradigme prevision<br/>PatchTST / LSTM / Transformer"]
    end
    P1 --> ACT["Sortie = action discrete<br/>(Buy / Hold / Sell)"]
    P2 --> RET["Sortie = rendement<br/>(regression continue)"]
    ACT --> TR1["Trading direct"]
    RET --> TH["Seuillage / conversion<br/>en position"]
    TH --> TR2["Trading differe"]
    TR1 --> RES1["L4 DT : 24/26 panel @10bps<br/>(OOT temporel réel 04/09 : NO-BEATS)"]
    TR2 --> RES2["PatchTST : 0/26 seeds BEATS<br/>Signal noye dans le bruit"]
    %% color: explicite -- sans lui, libelle clair sur fond clair en mode sombre GitHub (#15022) ; ton parfois plus fonce que le stroke (le stroke en couleur de texte rendrait infer illisible) : ne pas harmoniser
    style P1 fill:#e8f5e9,color:#1b5e20
    style P2 fill:#ffebee,color:#721c24
    style RES1 fill:#c8e6c9,color:#1b5e20
    style RES2 fill:#ffcdd2,color:#721c24
L’écart de performance n’est pas un hasard : un classifieur d’action capture la non-linéarité directionnelle qu’un régresseur de rendement lisse et perd dans le seuillage. D’où le verdict consolidé — un seul BEATS (DT action-based, panel @10bps ; non confirmé hors-échantillon en temps, OOT réel 04/09 NO-BEATS), tout le reste NO BEATS (rendement/forecast).
| Rung | Modèle | Approche | Verdict | Métrique clé | Doc |
|---|---|---|---|---|---|
| L1 | TSMOM | Momentum time-series | NO BEATS | Sharpe net -2.56 à -2.26 (coûts tuent le signal) | docs/L1_tsmom.md |
| L2 | CS+DM | Carry + momentum dual | NO BEATS | meilleur CS 252d delta -0.153 | docs/L2_dual_momentum.md |
| L3 | Trend | Regime + trend long-horizon | NO BEATS | 0/75 signal, AUC médian 0.509, 300 combos | results/l3_trend_long_horizon/ |
| L4 | Decision Transformer | Action-based (buy/hold/sell) | BEATS (panel @10bps) | 24/26, AUC médian 0.558 ; @50bps INCONCLUSIVE ; holdout 06/08 non reproduit (-6.63σ interne) ; OOT réel 04/09 NO-BEATS (train gelé ≤ 2025-06-30, 0/5 seeds, −5.38σ) | docs/L4_decision_transformer.md |
| L5 | Composite vol-targeted | Filtre trend + vol-targeting 10% sur composite S7 | NO BEATS | delta -0.236 vs S4 v2 (t=-2.49), DSR 0.074 | docs/L5_vol_targeted_composite.md |
| (side) | PatchTST | Forecast-based (prédiction rendement) — mislabellisé “L5” avant 2026-06-12 | NO BEATS | 0/26, AUC médian 0.501 | results/l5_patchtst/ |
Key findings :
- Action-based >> forecast-based : DT (classifie buy/hold/sell) surperforme massivement PatchTST (prédit magnitude rendement). La couche de traduction portfolio (forecast -> position) détruit le signal forecast via coûts transaction et erreurs de discrétisation.
- Trend overlays systématiquement destructeurs sur cet univers/période : L1, L2, L3 tous NO BEATS, et l’ablation L5 isole le filtre TSMOM 12-1 comme cause de son déficit (-0.260 seul vs -0.025 pour vol-targeting seul).
- Vol-targeting = outil de risque, pas alpha : le vol-target 10% de L5 atteint son objectif de risque (vol réalisée 10.3% vs 16.6%, MaxDD réduit) à coût Sharpe ~nul. À garder comme overlay de risque sur candidats production (S3 + S4 v2 KEEPERS), pas comme signal.
Résultats : scripts/results/{l1_tsmom,l2_dual_momentum,l3_trend_long_horizon,l4_decision_transformer,l5_vol_targeted,l5_patchtst}/results.json. Next : L4 DT multi-seed étendu (BG run ai-01), puis migration QC Cloud.
Reproductibilité
- Hachage données : SHA256 du dataset d’entrée stocké dans metadata
- Hyperparams : Tous les args sauvés verbatim
- Historique entraînement : Courbes de perte par epoch
- Seeds : Données synthétiques utilisent seed=42 ; pour production, configurer
PYTHONHASHSEEDettorch.manual_seed()
Convention de stockage des résultats (#13740)
Trois familles d’artefacts, trois emplacements distincts, un seul verdict canonique par expérience :
| Type | Emplacement canonique | Contenu | Exemple |
|---|---|---|---|
| Verdict canonique | scripts/results/<exp>/results.json (+ seed_significance.json si multi-seed) |
Métriques finales (Sharpe, edge, BEATS/NO BEATS) + per-seed | scripts/results/m11c_dm_test/results.json, scripts/results/baselines_zeroshot/seed_significance.json |
| Poids du modèle | checkpoints/<famille>/<timestamp>/ |
model.pt + metadata.json (args, hash, courbe de perte) |
checkpoints/lstm/20260501_123516/metadata.json |
| Logs de run | outputs/<run_id>/ (auto-créé) |
stdout/stderr, gradients, telemetry GPU | (générés par shared/gpu_training.py) |
Règle d’or : un répertoire <exp>/ = une expérience = un verdict. Pas de JSON plats au racine de scripts/results/.
Dérogations historiques connues (fichiers plats à migrer)
Ces fichiers violent la convention (JSON plat à la racine de scripts/results/ au lieu d’un sous-répertoire <exp>/). Ils sont référencés en dur par m4_dlinear_vol_sc_validation.ipynb (chemins Path(...) dans des cellules), scripts/btc_vol.py (default argparse) et REGISTRY.md (commandes --out-json). La migration est non triviale : déplacer les JSON casserait les consommateurs. Décision : garder en l’état, flagger ici, et traiter dans une PR dédiée quand les chemins seront refactorés en Path(__file__).parent / "<exp>".
| Fichier plat | Réf. canonique cible | Statut |
|---|---|---|
scripts/results/m4_dlinear_vol_btc_sc.json |
scripts/results/m4_dlinear_vol_btc_sc/results.json |
À migrer (4 consumers) |
scripts/results/m4_dlinear_vol_btc_sc_debiased.json |
idem sous-répertoire --debias |
À migrer |
scripts/results/m4_dlinear_vol_btc_sc_debiased_recentered.json |
idem --debias --recentered |
À migrer |
scripts/results/m4_dlinear_vol_btc_sc_mse.json |
scripts/results/m4_dlinear_vol_btc_sc_mse/results.json |
À migrer (3 consumers) |
Pour les nouvelles expériences : appliquer la convention dès la première écriture. Le pipeline de validation (scripts/validate_training_package.py) devrait idéalement rejeter les JSON plats au racine — non implémenté à ce jour.
Conclusion / Prochaines étapes
Ce que ce pipeline démontre
Ce pipeline matérialise l’empirisme honnête appliqué au ML financier : plutôt que de revendiquer un edge sur un backtest unique, il teste systématiquement des familles de modèles (HAR-RV, LSTM, Transformer, DQN, Decision Transformer, GNN, HMM regime) sous une méthodologie stricte et publie les verdicts — y compris les échecs. L’arc pédagogique :
- La rigueur méthodologique d’abord : walk-forward 5-fold expanding, 4-seed block bootstrap, OOS strict (2027 holdout jamais tuné), coûts de transaction réalistes (10bps rebalance + 50bps stress), univers anti-FAANG/Mag7 pour éviter le beta-loading déguisé. Ces choix sont la condition de validité de tout verdict — sans eux, un Sharpe spectaculaire n’est qu’un artefact.
- Les leçons transversales : (1) action-based >> forecast-based — le Decision Transformer (classifie buy/hold/sell) surpasse massivement PatchTST (prédit la magnitude), car la couche de traduction forecast→position détruit le signal via coûts et discrétisation ; (2) trend overlays systématiquement destructeurs sur cet univers/période (L1/L2/L3 tous NO BEATS, le filtre TSMOM 12-1 isolé comme cause du déficit L5) ; (3) vol-targeting = outil de risque, pas d’alpha (atteint sa cible de vol 10.3% vs 16.6%, réduit le MaxDD, à coût Sharpe ~nul).
- Les KEEPERS validés (Curriculum V2, gate 2026-05-16) : S3 HMM Regime (+0.669), S4 Inverse-vol Ridge+HMM (+0.325), M15 LSTM-RV. Reco portfolio S3+S4 monthly = Sharpe ~1.12. Amendement 2026-09-13 : M12 HAR-RV-J, quatrième keeper historique, est retiré — revalidation cluster symétrique NO BEATS (0/7, p=1,0, #16004) ; son BEATS Cycle 31 (pseudo-réplication de seeds d’un OLS déterministe + calibration asymétrique de la baseline) n’est pas confirmé, sans réfutation définitive (protocoles et fenêtres diffèrent).
- La transparence sur les échecs : le Ladder #1409 documente publiquement que 5/6 ladder levels sont NO BEATS. C’est aussi important pédagogiquement que les keepers — la plupart des idées ML ne battent pas le buy-and-hold, et le savoir vaut mieux que l’illusion.
Prochaines étapes
- Reproduire les KEEPERS : cloner le repo, installer les dépendances (
Dependenciesci-dessus), lancerpython scripts/dry_run_validation.pypour valider le pipeline CPU, puis entraîner S3/S4 sur données réelles (python scripts/s3_hmm_regime.py). - Bilan L4 Decision Transformer : BEATS panel @10bps (24/26) — mais la validation hors-échantillon temporelle réelle (04/09, train gelé ≤ 2025-06-30) est NO-BEATS (0/5 seeds, edge −5.38σ) : l’edge reste cantonné à la coupe transversale (détail :
docs/L4_decision_transformer.md, §Protocole OOT). - Migration QC Cloud : les keepers sont des modèles research standalone (type (c), données yfinance) ; l’étape suivante est l’intégration dans des
QCAlgorithmdéployables (cf.../projects/et la série QC-Py). - Surveiller la thermal safety : tout training GPU doit passer par
shared/gpu_training.py(MAX_TEMP=80C, AMP) — le repo RTX 3090/4090 a déjà subi des throttling thermiques. - Consulter le REGISTRY :
REGISTRY.mdcatalogue les 70+ checkpoints par stage (-1/0/1/2) avec verdict BEATS/FAIL/MIXED et l’audit Anti-Bias. - Lire la méta-analyse :
docs/Curriculum_V2_Meta_Analysis.mdpour la synthèse cross-iteration (parcimonie vs expressivité, vol vs direction).
Rappel honnête : ce pipeline est un standalone research (type (c), données yfinance locales). Les verdicts (KEEPERS, NO BEATS) sont valables sur l’univers et la période testés. Un edge en research standalone n’est pas un edge en production — la migration QC Cloud avec vraies données, frais réels et slippage est l’étape de validation obligatoire avant tout déploiement.
Version anglaise (snapshot pré-bascule) : README.en.md.