M12 - HAR-RV-J : Décomposition de sauts (Andersen-Bollerslev-Diebold 2007)
Modèle déployé dans la stratégieHAR-RV-J-Kelly(project QC 31650567).
Ce notebook présente les résultats du modèle HAR-RV-J (Heterogeneous Autoregressive Realized Variance with Jumps) qui étend le HAR classique (Corsi 2009) avec une composante de saut issue de la bipower variation (Huang-Tauchen). C’est le modèle réellement déployé en production dans la stratégie QC HAR-RV-J-Kelly, à distinguer du HAR asymétrique (M3b, décomposition semivariance) étudié dans m3_har_asymmetric_semivariance.ipynb.
Contexte : Le HAR classique traite la variance réalisée (RV) de façon globale. La décomposition de sauts sépare la variation continue (BPV) des sauts (J), capturant l’information de queue utile au position sizing de Kelly.
1. Chargement de la revalidation cluster sept actifs
Les résultats sont recalculés par scripts/m12_har_rv_j.py sur le cluster de sept actifs (BTC, ETH, SOL, LTC, XRP, ADA, DOT en USD) aux horizons 1, 5 et 10 : vingt-et-un couples actif × horizon. Chaque unité utilise un walk-forward à cinq folds. HAR classique et HAR-RV-J suivent le même protocole : leur biais signé est estimé sur une queue de calibration appartenant exclusivement au train (fenêtre identique de 60 jours pour les deux jambes), puis soustrait aux prévisions futures.
Le sweep est fail-closed : si un seul des vingt-et-un couples ne s’évalue pas, le script termine en échec sans verdict. L’artefact chargé ci-dessous porte donc soit le statut complete avec ses preuves de folds, soit un manifeste d’échecs.
L’OLS est déterministe et n’accepte aucun seed stochastique : les labels de seed demandés par le protocole générique restent des contrôles non applicables (n_seeds_effective=1 par unité), sans créer de pseudo-réplications. L’agrégation primaire est par actif (n=7) ; les vingt-et-un couples ne sont jamais comptés comme preuves indépendantes.
import jsonfrom pathlib import Pathimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltresults_path = Path('scripts/results/m12_har_rv_j/results.json')ifnot results_path.exists():raiseFileNotFoundError(f'Artefact manquant : {results_path}. ''Exécuter scripts/m12_har_rv_j.py dans l’environnement coursia-ml-training.' )withopen(results_path, encoding='utf-8') as handle: data = json.load(handle)if data.get('status') !='complete':raiseValueError(f'Sweep incomplet (status={data.get("status")}) : aucun verdict cluster '"n'est exploitable depuis un artefact fail-closed." )df = pd.DataFrame(data['combos'])seed_values = df.iloc[0]['seed_values_requested']manifest = data['data_manifest']print(f'Modèle candidat : {data["candidate"]}')print(f'Baseline : {data["baseline"]}')print(f'Évaluations réelles : {len(df)} unités (contrat fail-closed validé)')print(f'Seeds : N/A pour OLS (labels demandés : {seed_values}, jamais comptés comme observations)')print(f'Actifs chargés : {len(manifest["coins_loaded"])}/{len(manifest["coins_requested"])} — 'f'manquants : {manifest["coins_missing_or_failed"] or"aucun"}')for coin in manifest['coins_requested']: info = manifest['per_coin'][coin] window =f'{info["data_window_start"][:10]} -> {info["data_window_end"][:10]}, {info["n_rv_days"]} jours RV'print(f' {coin:<10}{info["status"]:<20}{window}')print(f'Setup : fee={data["fee_bps"]} bps, refit={data["refit_every"]} j, WF {data["n_splits"]}-fold, 'f'calibration={data["calibration_size"]} j, DM={data["dm_loss_fn"]}')
Modèle candidat : HAR-RV-J avec calibration de biais train-only
Baseline : HAR Classic avec calibration de biais train-only
Évaluations réelles : 21 unités (contrat fail-closed validé)
Seeds : N/A pour OLS (labels demandés : [0, 7, 42, 99], jamais comptés comme observations)
Actifs chargés : 7/7 — manquants : aucun
  BTC-USD    loaded               2018-05-15 -> 2024-08-09, 2278 jours RV
  ETH-USD    loaded               2019-10-21 -> 2023-12-15, 1495 jours RV
  SOL-USD    loaded               2024-09-14 -> 2026-09-13, 724 jours RV
  LTC-USD    loaded               2024-09-14 -> 2026-09-13, 724 jours RV
  XRP-USD    loaded               2024-09-14 -> 2026-09-13, 724 jours RV
  ADA-USD    loaded               2024-09-14 -> 2026-09-13, 724 jours RV
  DOT-USD    loaded               2024-09-14 -> 2026-09-13, 724 jours RV
Setup : fee=50 bps, refit=22 j, WF 5-fold, calibration=60 j, DM=mse
2. Verdict cluster (agrégation primaire par actif, protocole symétrique #16004)
Chaque couple actif × horizon porte son verdict DM-MSE (précision, jamais la seule jambe linéaire). Le verdict d’un actif applique ensuite la réduction par actif du protocole symétrique sept actifs (#16004) : BEATS si une majorité stricte de ses horizons est BEATS, NO BEATS si au moins un horizon est NO BEATS, sinon INCONCLUSIVE. Le verdict cluster repose enfin sur un sign-test binomial exact unilatéral sur les sept verdicts d’actifs.
Les seuils sont donc mécaniques : 7/7 actifs BEATS donne p = 0,0078 (BEATS) ; 6/7 donne p = 0,0625 et 5/7 donne p = 0,2266 — tous deux INCONCLUSIVE. Une majorité sans significativité n’est jamais un BEATS.
Les vingt-et-un couples ne servent qu’au diagnostic descriptif : les horizons d’un même actif sont dépendants, les compter comme preuves indépendantes produirait un faux dénombrement.
=== Verdict cluster HAR-RV-J vs HAR débiaisé (protocole symétrique sept actifs, #16004) ===
Verdict cluster : NO BEATS
Agrégation primaire : 7 actifs (réduction horizon : BEATS si majorité stricte d'horizons BEATS ; NO BEATS si au moins un horizon NO BEATS)
Actifs BEATS : 0/7
Sign-test binomial exact unilatéral (H0 : p = 0.5, greater) : p = 1.000000 au seuil alpha = 0.05

  ADA-USD    NO BEATS       horizons BEATS 0/3, NO BEATS 3
  BTC-USD    INCONCLUSIVE   horizons BEATS 0/3, NO BEATS 0
  DOT-USD    INCONCLUSIVE   horizons BEATS 0/3, NO BEATS 0
  ETH-USD    NO BEATS       horizons BEATS 0/3, NO BEATS 2
  LTC-USD    INCONCLUSIVE   horizons BEATS 0/3, NO BEATS 0
  SOL-USD    INCONCLUSIVE   horizons BEATS 0/3, NO BEATS 0
  XRP-USD    INCONCLUSIVE   horizons BEATS 0/3, NO BEATS 0

Niveau configuration (DESCRIPTIF UNIQUEMENT, n=21) : 0 couples BEATS — les horizons d'un même actif sont dépendants
Rôle des seeds : OLS déterministe : aucun seed stochastique ; les labels demandés sont enregistrés comme contrôles non applicables (n_seeds_effective=1 par unité)
Médiane delta-Sharpe (descriptive, 21 unités) : +0.0009
3. Confronter rendement et précision
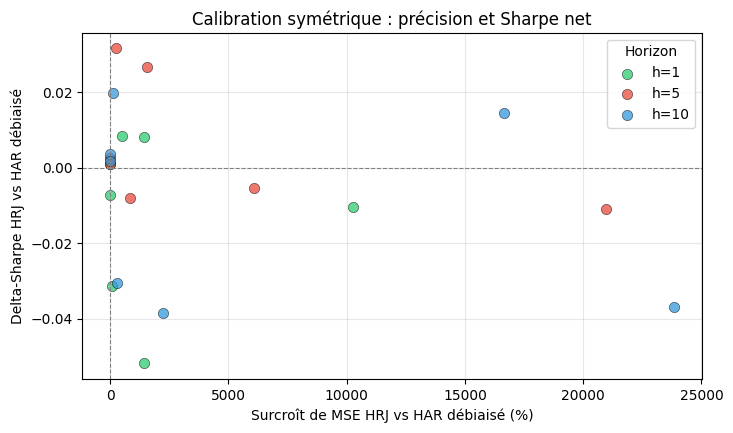
Une comparaison asymétrique peut attribuer au signal de saut un avantage provenant de l’offset de la baseline. Le graphique confronte donc les deux jambes après la même calibration train-only : variation de MSE face au HAR débiaisé et delta-Sharpe net.
Chaque actif × horizon apparaît une seule fois dans le graphique. Les labels de seed du protocole générique sont non applicables à l’OLS et ne créent donc ni lignes supplémentaires ni mesure d’incertitude.
plot_df = dffig, ax = plt.subplots(figsize=(8, 4.5))colors = {1: '#2ecc71', 5: '#e74c3c', 10: '#3498db'}for horizon in [1, 5, 10]: sub = plot_df[plot_df['horizon'] == horizon] ax.scatter(-sub['mse_reduction_pct_vs_debiased_har'], sub['delta_sharpe_hrj_vs_har_debiased'], alpha=0.75, s=55, c=colors[horizon], edgecolors='k', linewidths=0.4, label=f'h={horizon}', )ax.axhline(0, color='gray', linewidth=0.8, linestyle='--')ax.axvline(0, color='gray', linewidth=0.8, linestyle='--')ax.set_xlabel('Surcroît de MSE HRJ vs HAR débiaisé (%)')ax.set_ylabel('Delta-Sharpe HRJ vs HAR débiaisé')ax.set_title('Calibration symétrique : précision et Sharpe net')ax.legend(title='Horizon')ax.grid(alpha=0.3)plt.show()for _, row in plot_df.iterrows(): direction_mse ='moins précise'if row['mse_reduction_pct_vs_debiased_har'] <0else'plus précise' direction_sharpe ='supérieur'if row['delta_sharpe_hrj_vs_har_debiased'] >0else'inférieur'print(f'{row["coin"]} h={row["horizon"]} : HRJ {direction_mse}, Sharpe {direction_sharpe}.')
BTC-USD h=1 : HRJ plus précise, Sharpe supérieur.
BTC-USD h=5 : HRJ moins précise, Sharpe supérieur.
BTC-USD h=10 : HRJ moins précise, Sharpe supérieur.
ETH-USD h=1 : HRJ moins précise, Sharpe inférieur.
ETH-USD h=5 : HRJ moins précise, Sharpe supérieur.
ETH-USD h=10 : HRJ moins précise, Sharpe supérieur.
SOL-USD h=1 : HRJ moins précise, Sharpe supérieur.
SOL-USD h=5 : HRJ moins précise, Sharpe inférieur.
SOL-USD h=10 : HRJ moins précise, Sharpe supérieur.
LTC-USD h=1 : HRJ moins précise, Sharpe supérieur.
LTC-USD h=5 : HRJ moins précise, Sharpe supérieur.
LTC-USD h=10 : HRJ moins précise, Sharpe inférieur.
XRP-USD h=1 : HRJ moins précise, Sharpe inférieur.
XRP-USD h=5 : HRJ moins précise, Sharpe inférieur.
XRP-USD h=10 : HRJ moins précise, Sharpe inférieur.
ADA-USD h=1 : HRJ moins précise, Sharpe inférieur.
ADA-USD h=5 : HRJ moins précise, Sharpe supérieur.
ADA-USD h=10 : HRJ moins précise, Sharpe inférieur.
DOT-USD h=1 : HRJ moins précise, Sharpe inférieur.
DOT-USD h=5 : HRJ moins précise, Sharpe inférieur.
DOT-USD h=10 : HRJ moins précise, Sharpe supérieur.
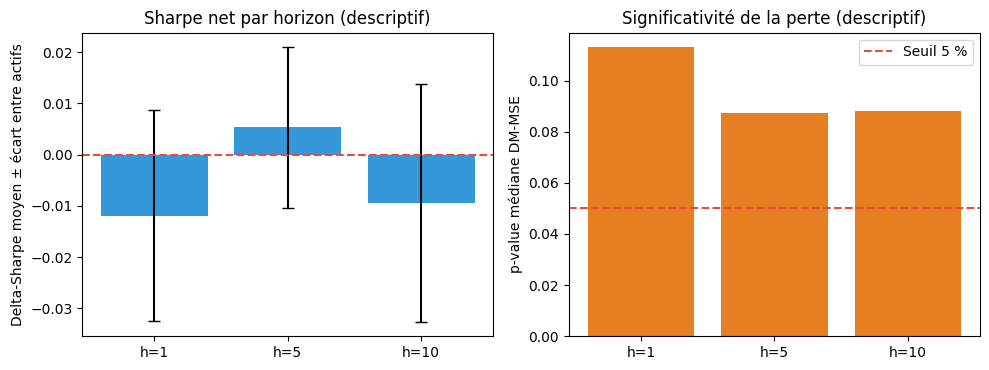
4. Diagnostic par horizon (descriptif uniquement)
La cellule suivante sépare la moyenne du delta-Sharpe, sa dispersion entre actifs, les comptes de verdicts DM-MSE par horizon et la médiane du test DM. Ces statistiques sont descriptives : les horizons d’un même actif sont dépendants, et l’agrégation primaire du verdict reste au niveau actif.
L’OLS déterministe n’offre aucune réplication stochastique : aucun de ces chiffres ne peut se transformer en significativité cross-seed.
print('=== Diagnostic descriptif par horizon (21 couples, jamais indépendants) ===')print()print(f'{"Horizon":<10}{"DM BEATS":<12}{"DM NO BEATS":<14}{"Edge":<10} 'f'{"Écart actifs":<14}{"Seeds N/A":<10}{"DM p méd.":<12}{"Diff. perte"}')for horizon in [1, 5, 10]: row = data['per_horizon'][str(horizon)] ratio = row['cross_asset_edge_ratio'] ratio_text =f'{ratio:.2f}'if ratio isnotNoneelse'N/A'print(f'h={horizon:<8}{str(row["n_beats_dm_mse"]) +"/"+str(row["n_effective"]):<12} 'f'{row["n_no_beats_dm_mse"]:<14} 'f'{row["edge_mean_delta_sharpe"]:<+10.4f} 'f'{row["edge_std_delta_sharpe_across_assets"]:<14.4f} 'f'{str(not row["seeds_applicable"]):<10} 'f'{row["dm_mse_p_median"]:<12.4f} 'f'{row["dm_mse_mean_loss_diff_median"]:+.6f}' )fig, axes = plt.subplots(1, 2, figsize=(10, 3.8))horizons = [1, 5, 10]edges = [data['per_horizon'][str(h)]['edge_mean_delta_sharpe'] for h in horizons]edge_std = [data['per_horizon'][str(h)]['edge_std_delta_sharpe_across_assets'] for h in horizons]dm_pvalues = [data['per_horizon'][str(h)]['dm_mse_p_median'] for h in horizons]axes[0].bar([f'h={h}'for h in horizons], edges, yerr=edge_std, color='#3498db', capsize=4)axes[0].axhline(0, color='#e74c3c', linestyle='--')axes[0].set_ylabel('Delta-Sharpe moyen ± écart entre actifs')axes[0].set_title('Sharpe net par horizon (descriptif)')axes[1].bar([f'h={h}'for h in horizons], dm_pvalues, color='#e67e22')axes[1].axhline(0.05, color='#e74c3c', linestyle='--', label='Seuil 5 %')axes[1].set_ylabel('p-value médiane DM-MSE')axes[1].set_title('Significativité de la perte (descriptif)')axes[1].legend()fig.tight_layout()plt.show()
Cette tranche couvre les sept actifs du cluster. BTC et ETH proviennent des séries horaires locales (Bitstamp ~10 ans, Binance ~4 ans) ; les cinq autres actifs sont téléchargés via yfinance sur la fenêtre glissante ~730 jours. Le manifeste de la section 1 porte les fenêtres exactes effectivement évaluées par unité.
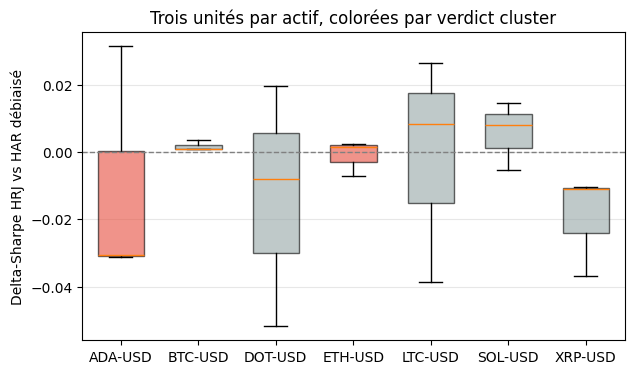
La cellule suivante agrège les vingt-et-un couples par actif : verdict cluster, victoires de delta-Sharpe, et biais signés (prévision - cible) mesurés hors échantillon après calibration train-only identique pour les deux jambes.
coin_verdicts = { row['coin']: row['verdict']for row in data['cluster']['primary_coin_level']['coin_verdicts']}effective_df = dfprint('=== Diagnostic par actif ===')print()print(f'{"Actif":<10}{"Verdict cluster":<18}{"Wins Sharpe":<14} 'f'{"Delta-Sharpe méd.":<20}{"Biais HAR déb.":<18}{"Biais HRJ déb."}')for coin insorted(effective_df['coin'].unique()): sub = effective_df[effective_df['coin'] == coin] wins =int((sub['delta_sharpe_hrj_vs_har_debiased'] >0).sum())print(f'{coin:<10}{coin_verdicts[coin]:<18}{str(wins) +"/"+str(len(sub)):<14} 'f'{sub["delta_sharpe_hrj_vs_har_debiased"].median():<+20.4f} 'f'{sub["har_debiased_bias_oos"].median():<+18.6f} 'f'{sub["hrj_debiased_bias_oos"].median():+.6f}' )fig, ax = plt.subplots(figsize=(7, 4))coins =sorted(effective_df['coin'].unique())bp = ax.boxplot( [effective_df[effective_df['coin'] == coin]['delta_sharpe_hrj_vs_har_debiased'].values for coin in coins], tick_labels=coins, patch_artist=True, widths=0.6,)for box, coin inzip(bp['boxes'], coins): median = effective_df[effective_df['coin'] == coin]['delta_sharpe_hrj_vs_har_debiased'].median() box.set_facecolor('#2ecc71'if coin_verdicts[coin] =='BEATS'else ('#e74c3c'if coin_verdicts[coin] =='NO BEATS'else'#95a5a6')) box.set_alpha(0.6)ax.axhline(0, color='gray', linestyle='--', linewidth=1)ax.set_ylabel('Delta-Sharpe HRJ vs HAR débiaisé')ax.set_title('Trois unités par actif, colorées par verdict cluster')ax.grid(axis='y', alpha=0.3)plt.show()
Conclusion : statut de la revalidation M12 (cluster sept actifs)
Sous le protocole commun de cette revalidation — calibration du biais sur le train uniquement et de façon identique pour les deux jambes, walk-forward à cinq folds, frais identiques, DM sur la perte MSE, agrégation primaire par actif avec sign-test binomial exact (protocole symétrique sept actifs #16004, fail-closed sur les vingt-et-un couples) — le cluster de sept actifs ne confirme pas le verdict BEATS du Cycle 31.
Ce résultat ne réfute pas définitivement le Cycle 31 : protocoles et fenêtres diffèrent. Le Cycle 31 reposait sur une calibration asymétrique et sur ses propres séries ; cinq actifs du cluster ne portent ici qu’environ 724 jours de données yfinance, contre des séries multi-années pour BTC et ETH. La lecture honnête est : BEATSn’est pas confirmé sous ce protocole symétrique, et deux actifs sont en difficulté réelle — ADA sur ses trois horizons et ETH sur deux horizons sont significativement battus en précision DM-MSE.
Sur la plupart des unités, le biais OOS signé de HAR-RV-J calibré reste supérieur à celui du HAR calibré (voir la section 5). L’hypothèse selon laquelle l’asymétrie de calibration du Cycle 31 portait une part de son avantage mesuré est une interprétation cohérente avec ces chiffres, pas une démonstration.
Le déploiement historique de HAR-RV-J-Kelly ne constitue pas une preuve que HAR-RV-J améliore hors échantillon le HAR calibré. Toute décision de conserver ou réviser cette stratégie doit distinguer :
la précision de prévision de la log-variance (jambe DM-MSE, seule jambe du verdict) ;
l’effet économique du sizing de Kelly après frais (delta-Sharpe, descriptif) ;
la portée du cluster : sept actifs, dont cinq sur fenêtre yfinance ~730 jours contre BTC/ETH multi-années — les fenêtres ne sont pas homogènes, le manifeste les documente ;
l’absence de réplications stochastiques indépendantes : les labels de seed sont non applicables à cet OLS déterministe (n_seeds_effective=1 par unité).
Lien avec la stratégie déployée
Aspect
Revalidation cluster
Stratégie HAR-RV-J-Kelly
Modèle
HAR-RV-J, sauts Huang-Tauchen
HAR-RV-J (use_jumps=1)
Baseline
HAR débiaisé, calibration train-only symétrique
Pas de comparaison embarquée
Horizons
1/5/10 évalués séparément, réduction par actif
Horizon de production fixe
Actifs
BTC, ETH, SOL, LTC, XRP, ADA, DOT
Univers de production distinct
Verdict
Sign-test exact sur 7 actifs (primaire)
Verdict de recherche borné
Le résultat est donc un verdict de recherche borné au cluster, pas une validation rétroactive de la stratégie de production ni une réfutation définitive du Cycle 31.
Références
Andersen, T.G., Bollerslev, T. & Diebold, F.X. (2007). Roughing It Up: Including Jump Components in the Measurement, Modeling, and Forecasting of Return Volatility. Review of Economics and Statistics, 89(4), 701-720.
Corsi, F. (2009). A Simple Approximate Long-Memory Model of Realized Volatility. Journal of Financial Econometrics.
Huang, X. & Tauchen, G. (2005). The Relative Contribution of Jumps to Total Price Variance. Journal of Financial Econometrics.