M15 - Log-LSTM RV : Memoire Sequential pour la Variance Realisee
Non-keeper apres le test Diebold-Mariano (PR #11395) : le BEATS historique (docs/RECAP_KEEPERS_V2.md : S1 M15 LSTM h=32) etait base sur un test du signe des Sharpe Kelly, jamais valide par la conjonction §C (edge >= 2 sigma ET dm_p < 0.05 sur la perte de precision). La claim “deployable” est retiree. NON deploye en production, comme son pendant OLS le HAR-RV-J (M12, cf m12_har_rv_j_research.ipynb) qui, lui, reste le keeper deploye.
Ce notebook presente les résultats du modèle Log-LSTM (Hochreiter & Schmidhuber 1997) applique a la prediction de la variance realisee logarithmique (log-RV). Il etudie la capacity du LSTM a capturer la memoire sequencee de la volatilite, par rapport a la moyenne mobile du HAR classique (Corsi 2009).
Modèle (hidden=32, ~4.8K params) :
Input : fenêtre glissante W=22 jours x 3 features [log(RV), returns, sign(returns)]
Model : LSTM(hidden=32, 1 couche) + FC(32, 1)
Target: log(RV_{t+h}), h in {1, 5, 10}
Loss  : MSE sur log-RV
Decode: exp(pred) -> RV, puis log(RV) pour comparaison Kelly
Verdict : NO BEATS (44/84, p=0.372) au test §C – le gain Sharpe median (+0.0029) n’est pas statistiquement distinct du bruit et se paie d’une degradation MSE de +11.2% (edge negatif aux 3 horizons).
Les résultats (84 combinaisons : 7 coins x 3 horizons x 4 seeds) sont pre-calcules par scripts/m15_lstm_rv.py pour hidden=32 (re-run §C, issue #11395 : DM sur perte mse, seeds 0/1/7/42). Setup identique a M12 : Kelly cap=1.0, fee=50bps, walk-forward 5-fold, refit 22 jours.
import jsonfrom pathlib import Pathimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltresults_path = Path('scripts/results/m15_lstm_rv_h32/results.json')ifnot results_path.exists():# RECOVERABLE-MACHINE (cf. issues #11417/#11574, pattern #11420/#11575) : artefact# produit par `python scripts/m15_lstm_rv.py --hidden-size 32` (gitignore, politique# scripts/results/ de la serie, non commite sur main ; il se regenere a chaque run GPU).# Sur un clone frais, ce notebook s'execute sans exception ici, mais les# cellules aval n'ont rien a traiter tant que l'artefact n'est pas produit.print('[INFO] Artefact manquant : '+str(results_path))print(' Produit par : python scripts/m15_lstm_rv.py --hidden-size 32')print(" Runtime au run d'origine : ~4.5h GPU (84 combos, 4 seeds, WF 5-fold, refit 22j).")print(' RECOVERABLE-MACHINE (lane training, GPU 8 Go, env conda coursia-ml-training).')print(' Note de portee : issue #11417 (verdict ecrit).') data =None df =Noneelse:withopen(results_path) as f: data = json.load(f) df = pd.DataFrame(data['combos'])# Vrai changement MSE (LSTM vs HAR), calcule depuis les MSE bruts df['mse_change_pct'] = (df['mse_lstm'] - df['mse_har']) / df['mse_har'] *100print(f'Model: {data["model"]}')print(f'Architecture: LSTM(hidden={data["hidden_size"]}, {data["num_layers"]} couche) + FC, {data["n_params"]} params')print(f'Combinaisons : {len(df)} ({df["coin"].nunique()} coins x {df["horizon"].nunique()} horizons x {df["seed"].nunique()} seeds)')print(f'Runtime original : {data["runtime_s"]/3600:.1f}h (GPU)')print(f'Setup : fenetre W={data["window"]}j, kelly_cap={data["kelly_cap"]}, fee={data["fee_bps"]}bps, WF {data["n_splits"]}-fold, refit={data["refit_every"]}d')
Le LSTM h=32 ne bat pas le HAR Classic au test §C : 44/84 (52.4%) en Sharpe, p=0.372 (test du signe non significatif), avec un edge negatif sur la perte de precision (MSE +11.2% en median). Le test Diebold-Mariano sur la perte mse est significatif a h=1 (dm_p_median=0.027) mais dans le sens LSTM pire : le HAR est significativement plus precis a l’horizon court.
Le BEATS historique (52/84, p=0.019, “deployable”) etait base sur un test du signe des Sharpe Kelly seul – jamais valide par la conjonction §C (edge >= 2σ ET dm_p < 0.05 sur la perte de precision). Cette claim est retiree : M15 h32 sort des KEEPERS (docs/RECAP_KEEPERS_V2.md).
print('=== Verdict global Log-LSTM h=32 vs HAR Classic ===')print()print(f'Verdict : {data["verdict"]}')print(f'Win rate : {data["win_rate"]*100:.1f}% ({data["n_lstm_beats_har"]}/{data["n_combos"]} combos)')print(f'Test du signe p-value : {data["p_sign"]:.4f}')print(f'Median delta-Sharpe : {data["median_delta_sharpe"]:+.4f}')print(f'Median MSE change : {data["median_mse_change_pct"]:+.1f}% (LSTM moins precis en moyenne)')print()print('Test C par horizon (conjonction : edge >= 2 sigma ET dm_p < 0.05 sur la perte mse) :')for h insorted(data['per_horizon_sc']): v = data['per_horizon_sc'][h]print(f' h={h}: edge={v["edge_pct"]:+.1f}% (sigma={v["edge_std_pct"]:.2f}) dm_p_median={v["dm_p_median"]:.4f} 'f'beaten={v["n_beaten"]}/{v["n_rows"]} -> {v["verdict_sc"]}')print()print('Verdict C : NO BEATS. Le gain Sharpe median est du bruit (p=0.372) ; le test DM sur')print('la perte mse est significatif a h=1 (p=0.027) mais dans le sens LSTM PIRE (edge negatif).')print('Une p-value significative n\'est pas un BEATS : c\'est le signe de l\'edge qui compte.')
=== Verdict global Log-LSTM h=32 vs HAR Classic ===

Verdict               : NO BEATS
Win rate              : 52.4% (44/84 combos)
Test du signe p-value : 0.3718
Median delta-Sharpe   : +0.0029
Median MSE change     : +11.2%  (LSTM moins precis en moyenne)

Test C par horizon (conjonction : edge >= 2 sigma ET dm_p < 0.05 sur la perte mse) :
  h=1: edge=-9.1% (sigma=6.50) dm_p_median=0.0266 beaten=18/28 -> NO BEATS
  h=10: edge=-10.9% (sigma=15.41) dm_p_median=0.1115 beaten=7/28 -> NO BEATS
  h=5: edge=-9.0% (sigma=11.43) dm_p_median=0.0834 beaten=7/28 -> NO BEATS

Verdict C : NO BEATS. Le gain Sharpe median est du bruit (p=0.372) ; le test DM sur
la perte mse est significatif a h=1 (p=0.027) mais dans le sens LSTM PIRE (edge negatif).
Une p-value significative n'est pas un BEATS : c'est le signe de l'edge qui compte.
3. Le paradoxe MSE-Sharpe (meme structure que M12)
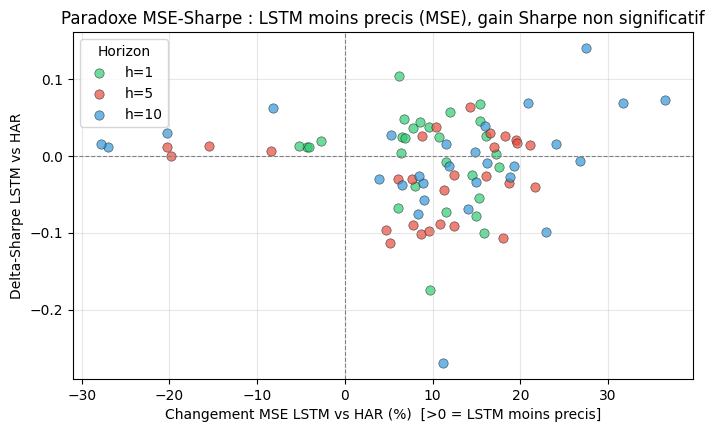
Le paradoxe est reel et mesure : le Log-LSTM degrade la prevision ponctuelle (MSE +11.2% en median) mais ameliore le Sharpe via Kelly (+0.0029 en median, 52.4% des combos). Mais ce gain Sharpe n’est pas statistiquement distinct du bruit (p=0.372) : c’est la lecon du test §C.
Le nuage ci-dessous montre la disconnexion : la plupart des points sont a droite de l’axe vertical (MSE pire). Le gain de Sharpe (axe vertical) est une legerete de points au-dessus de 0, pas un deplacement de masse – et le test DM sur la perte mse tranche contre le LSTM.
fig, ax = plt.subplots(figsize=(8, 4.5))colors = {1:'#2ecc71', 5:'#e74c3c', 10:'#3498db'}for h in [1, 5, 10]: sub = df[df['horizon']==h] ax.scatter(sub['mse_change_pct'], sub['delta_sharpe_lstm_vs_har'], alpha=0.7, s=45, c=colors[h], edgecolors='k', linewidths=0.4, label=f'h={h}')ax.axhline(0, color='gray', linewidth=0.8, linestyle='--')ax.axvline(0, color='gray', linewidth=0.8, linestyle='--')ax.set_xlabel('Changement MSE LSTM vs HAR (%) [>0 = LSTM moins precis]')ax.set_ylabel('Delta-Sharpe LSTM vs HAR')ax.set_title('Paradoxe MSE-Sharpe : LSTM moins precis (MSE), gain Sharpe non significatif')ax.legend(title='Horizon'); ax.grid(alpha=0.3)plt.show()print('Cadran superieur droit = LSTM moins precis (MSE) MAIS meilleur Sharpe (via Kelly).')print(f'MAIS le gain Sharpe n\'est PAS statistiquement significatif : p={data["p_sign"]:.3f} (test du signe).')print('Le test DM sur la perte mse (le vrai bareme C) donne un edge NEGATIF aux 3 horizons.')
Cadran superieur droit = LSTM moins precis (MSE) MAIS meilleur Sharpe (via Kelly).
MAIS le gain Sharpe n'est PAS statistiquement significatif : p=0.372 (test du signe).
Le test DM sur la perte mse (le vrai bareme C) donne un edge NEGATIF aux 3 horizons.
4. Analyse par horizon : des gains Sharpe sans conjonction §C
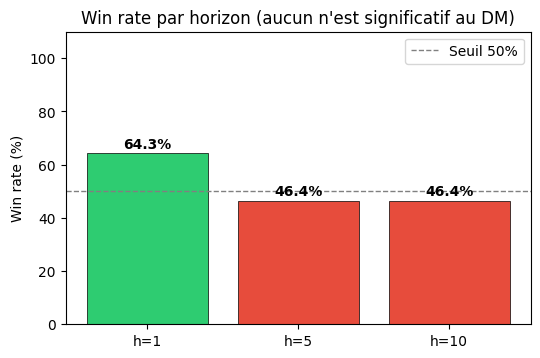
Le gain Sharpe median est positif a l’horizon court (h=1 : 18/28, 64.3%) et negatif aux horizons plus longs (h=5 : -0.0253 ; h=10 : -0.0077). Mais aucun horizon ne tient la conjonction §C : l’edge sur la perte mse est negatif partout (h=1 : -9.1% ; h=5 : -9.0% ; h=10 : -10.9%), et le DM n’est significatif qu’a h=1, dans le sens LSTM pire.
Horizon
Beats (Sharpe)
Med dSharpe
Edge MSE
dm_p_median
Verdict §C
h=1
18/28 (64.3%)
+0.0123
-9.1%
0.027
NO BEATS
h=5
13/28 (46.4%)
-0.0253
-9.0%
0.083
NO BEATS
h=10
13/28 (46.4%)
-0.0077
-10.9%
0.112
NO BEATS
print('=== Performance par horizon ===')print()print(f'{"Horizon":<10}{"BEATS":<12}{"Win %":<8}{"Med dSharpe":<14}{"Med MSE change"}')for h in [1, 5, 10]: sub = df[df['horizon']==h] beats =int((sub['delta_sharpe_lstm_vs_har'] >0).sum()) win = beats /len(sub) *100 med_ds = sub['delta_sharpe_lstm_vs_har'].median() med_mse = sub['mse_change_pct'].median() flag =' <- DOMINATE'if win >=75else (' <- faible'if win <50else'')print(f'h={h:<8}{beats}/{len(sub):<10}{win:<8.1f}{med_ds:<+14.4f}{med_mse:<+8.1f}%{flag}')fig, ax = plt.subplots(figsize=(6, 3.8))horizons = [1, 5, 10]winrates = [(df[df['horizon']==h]['delta_sharpe_lstm_vs_har']>0).mean()*100for h in horizons]barcols = ['#2ecc71'if w>=50else'#e74c3c'for w in winrates]bars = ax.bar([f'h={h}'for h in horizons], winrates, color=barcols, edgecolor='k', linewidth=0.5)ax.axhline(50, color='gray', linestyle='--', linewidth=1, label='Seuil 50%')ax.set_ylabel('Win rate (%)'); ax.set_title('Win rate par horizon (aucun n\'est significatif au DM)')ax.set_ylim(0, 110)for b, w inzip(bars, winrates): ax.text(b.get_x()+b.get_width()/2, w+2, f'{w:.1f}%', ha='center', fontsize=10, fontweight='bold')ax.legend(); plt.show()
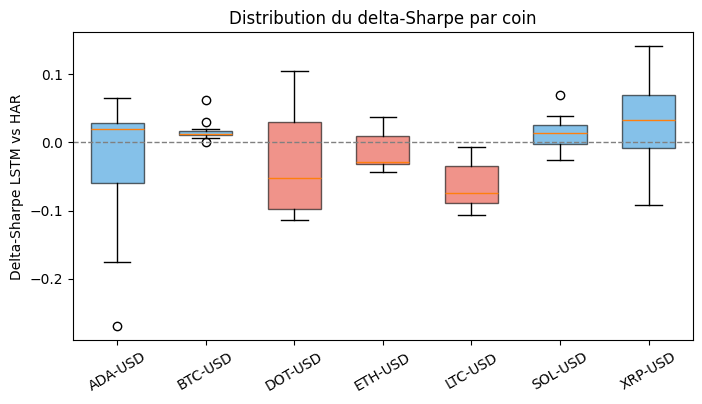
5. Analyse par coin : BTC seul porte le Sharpe ; LTC et DOT resistent
L’edge Sharpe est porte par un seul coin : BTC (12/12, MSE -11.9% – le seul avec une reduction MSE mediane). SOL (9/12), XRP (8/12) et ADA (7/12) suivent en Sharpe mais degradent le MSE. LTC est negatif sur les deux axes (0/12, MSE +14.9%) ; DOT (4/12, +8.7%) et ETH (4/12, +8.3%) resistent.
Coin
Beats (Sharpe)
Med dSharpe
Med MSE change
BTC-USD
12/12
+0.0123
-11.9%
SOL-USD
9/12
+0.0131
+17.1%
XRP-USD
8/12
+0.0331
+17.4%
ADA-USD
7/12
+0.0192
+9.4%
ETH-USD
4/12
-0.0286
+8.3%
DOT-USD
4/12
-0.0530
+8.7%
LTC-USD
0/12
-0.0744
+14.9%
Le BEATS historique (DOT 12/12, ADA 11/12, XRP 9/12) ne se reproduit pas sur le re-run §C (seeds 0/1/7/42) : les chiffres du run original (non tracke) et du run §C (tracke) divergent.
print('=== Performance par coin ===')print()print(f'{"Coin":<10}{"BEATS":<10}{"Med dSharpe":<14}{"Med MSE change"}')for coin insorted(df['coin'].unique()): sub = df[df['coin']==coin] beats =int((sub['delta_sharpe_lstm_vs_har']>0).sum()) med_ds = sub['delta_sharpe_lstm_vs_har'].median() med_mse = sub['mse_change_pct'].median() sig =' (fort)'if beats >=11else (' (faible)'if beats <=4else'')print(f'{coin:<10}{beats}/{len(sub):<8}{med_ds:<+14.4f}{med_mse:<+8.1f}%{sig}')fig, ax = plt.subplots(figsize=(8, 4))coins =sorted(df['coin'].unique())bp = ax.boxplot([df[df['coin']==c]['delta_sharpe_lstm_vs_har'].values for c in coins], tick_labels=coins, patch_artist=True, widths=0.6)for box, c inzip(bp['boxes'], coins): med = df[df['coin']==c]['delta_sharpe_lstm_vs_har'].median() box.set_facecolor('#3498db'if med >0else'#e74c3c'); box.set_alpha(0.6)ax.axhline(0, color='gray', linestyle='--', linewidth=1)ax.set_ylabel('Delta-Sharpe LSTM vs HAR'); ax.set_title('Distribution du delta-Sharpe par coin')ax.tick_params(axis='x', rotation=30); plt.show()
6. Pourquoi M15 n’est pas deploye : le test §C infirme (le contraste avec M12)
Le BEATS historique de M15 h32 venait d’un test du signe des Sharpe Kelly, jamais valide par la conjonction §C. Le re-run §C (ce notebook) infirme : edge negatif sur la perte mse aux 3 horizons (-9.1% / -9.0% / -10.9%), gain Sharpe median non significatif (p=0.372). M15 h32 sort des KEEPERS (docs/RECAP_KEEPERS_V2.md).
Le contraste avec M12 est instructif : le HAR-RV-J (M12) reste le keeper deploye (HAR-RV-J-Kelly). La difference n’est pas une “barriere d’inference” (Torch vs OLS) – c’est l’edge lui-meme qui n’est pas la.
Le role du test DM dans la decision
Question
M12 HAR-RV-J (deploye)
M15 Log-LSTM h=32 (retire)
Verdict documente
BEATS (p=0.0015, 84 combos)
NO BEATS (p=0.372, 84 combos)
Edge perte de precision
— (documente pre-§C)
negatif (-9 a -11% MSE)
DM sur perte mse
—
h=1 significatif, sens LSTM pire
Portage QC Cloud
Trivial (OLS natif)
Complexe (ONNX / Torch in QC)
La lecon pedagogique : un gain de Sharpe non accompagne d’un gain de precision est indiscernable du bruit sur 84 combos. Le bareme §C (conjonction edge >= 2σ ET dm_p < 0.05 sur la perte de precision) existe exactement pour ca – il retire ici une claim “deployable” qui n’avait jamais ete validee par la conjonction.
Les strategies QC LSTM existantes ne sont PAS M15
Le repo contient des strategies LSTM (DL-LSTM, LSTM-Forecasting) mais elles divergent de M15 :
DL-LSTM predit des prix (pas la RV), 2 couches bidirectionnelles hidden=50 (vs M15 hidden=32 unidirectionnel).
LSTM-Forecasting est en realite un MLPClassifier sklearn (le docstring le dit : replacing hand-rolled fake LSTM).
Aucune strategie QC deployee n’implemente le Log-LSTM M15 sur la variance realisee – et le re-run §C donne a cette absence une raison plus profonde que l’ingenierie du portage : le modele n’a pas d’edge valide a porter.
References
Hochreiter, S. & Schmidhuber, J. (1997). Long Short-Term Memory. Neural Computation 9(8):1735-1780.
Corsi, F. (2009). A Simple Approximate Long-Memory Model of Realized Volatility. Journal of Financial Econometrics. (baseline HAR)