Sous-série ICT (trajectoires intégrées, Epic #4588). Notebook compagnon du module ict.inhibited_action (PR #8825). Jambe C2 de la tresse transverse — parallèle à C1 — ICT-12c (prégnance/valence incarnée, #7740), et distincte d’ICT-30 (inhibition de l’innovation, strate 7 collective, #7746) : ici l’inhibition porte sur l’action d’un animat individuel (strate 3/5).
Le maillon Laborit
Henri Laborit (L’Éloge de la fuite, 1976) : des rats soumis à des chocs développent une hypertension durable surtout quand ni fuite ni action défensive ne sont possibles. Ce n’est pas le choc qui pathologise, c’est l’inhibition de l’action — « le système apprend que ses actions ne contrôlent plus son environnement ». L’analogue formel est un animat dont les actions, à mesure que la contrôlabilité s’effondre, deviennent sans effet sur la transition d’état, et qui, le détectant, rigidifie sa politique.
Ce notebook incarne ce maillon comme un substrat expérimental falsifiable (substrat + bancs dans ict.inhibited_action), puis le relie quantitativement à la dette d’irréversibilité\(I(R)\) d’ICT-18. Quatre verdicts falsifiables, chacun avec son contrôle négatif.
Portée honnête : la rencontre avec la strate 7 (inhibition de l’innovation, ICT-30) est une issue ultérieure ; ce notebook reste au niveau animat (strate 3/5). La lecture post-structuraliste (Foucault/Derrida/Serres) de la boucle signifiant/signifié = générateur de modèles, hors scope expérimental (spec #7741).
Statut épistémique — Établi : L’animat inhibé (Laborit) rigidifie son action sous perte de contrôle, et la dette d’irréversibilité I(R) échappe à l’action. Portée et détail dans la matrice de dissociations.
L’environnement est un anneau d’états \(\{0, \dots, n{-}1\}\) (la 1-torus, minimale). L’action \(a \in \{-1, 0, +1\}\) déplace l’animat. La contrôlabilité\(\alpha \in [0,1]\) est le bouton de Laborit :
avec probabilité \(\alpha\), l’action est appliquée (l’animat contrôle) ;
avec probabilité \(1-\alpha\), l’action est ignorée et l’état dérive d’un pas aléatoire (inhibition).
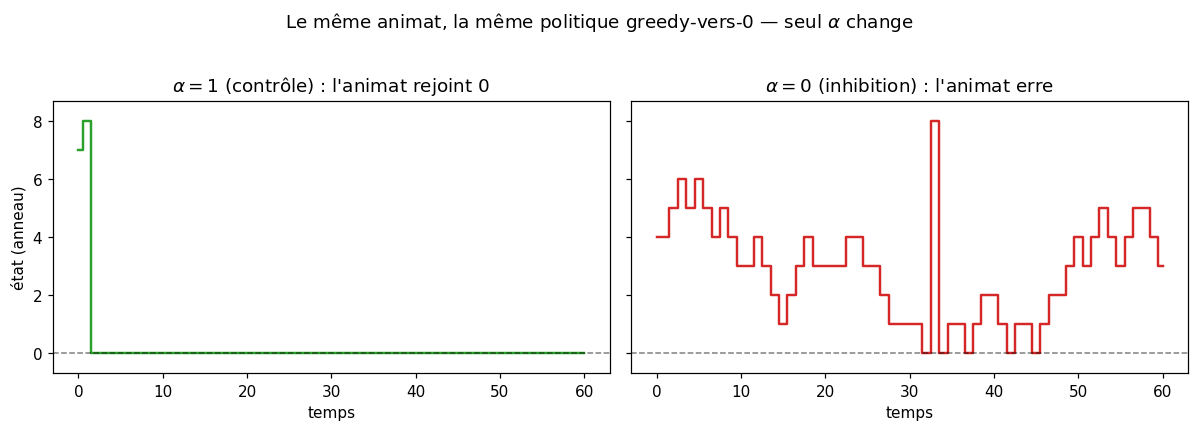
\(\alpha = 1\) : contrôle total. \(\alpha = 0\) : inhibition totale — l’animat peut bien « choisir », son choix n’a aucun effet sur le suivant. Démontrons-le : un animat qui cherche à rejoindre l’état 0 (politique greedy) y parvient sous \(\alpha=1\), et erre sous \(\alpha=0\).
n_states =9n_steps =60def greedy_toward(state, n=n_states): fwd = (0- state) % nif fwd ==0:return0return1if fwd <= n //2else-1def run_homing(alpha, seed): rng = np.random.default_rng(seed) env = InhibitedEnvironment(n_states, alpha=alpha, drift="uniform", rng=rng) s =int(rng.integers(0, n_states)) traj = [s]for _ inrange(n_steps): a = greedy_toward(s) s = env.transition(s, a) traj.append(s)return np.array(traj)traj_ctrl = run_homing(1.0, 0)traj_inh = run_homing(0.0, 1)fig, axes = plt.subplots(1, 2, figsize=(11, 3.8), sharey=True)for ax, traj, title, col in [ (axes[0], traj_ctrl, r"$\alpha=1$(contrôle) : l'animat rejoint 0", "C2"), (axes[1], traj_inh, r"$\alpha=0$(inhibition) : l'animat erre", "C3"),]: ax.step(np.arange(len(traj)), traj, where="mid", lw=1.6, color=col) ax.axhline(0, color="k", ls="--", lw=1, alpha=0.5) ax.set_xlabel("temps"); ax.set_title(title) ax.set_ylim(-0.7, n_states -0.3)axes[0].set_ylabel("état (anneau)")fig.suptitle(r"Le même animat, la même politique greedy-vers-0 — seul $\alpha$ change", y=1.02)fig.tight_layout(); plt.show()print("couverture états alpha=1 :", len(set(traj_ctrl.tolist())), "/", n_states)print("couverture états alpha=0 :", len(set(traj_inh.tolist())), "/", n_states)
2. Détection : l’animat « apprend » qu’il ne contrôle plus
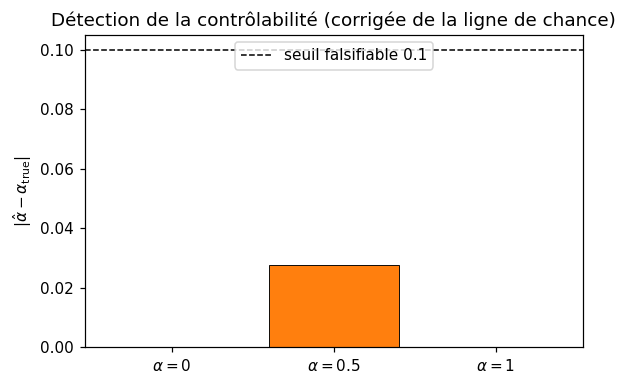
Le prérequis de l’inhibition de Laborit est la détection : sans elle, pas de « savoir que mes actions ne contrôlent plus ». estimate_controllability estime \(\alpha\) depuis les transitions observées en comparant le déplacement signé à l’action, corrigé de la ligne de chance (la dérive n’est pas uniforme sur les états mais sur les pas \(\{-1,0,+1\}\) — un estimateur naïf sur-estimerait \(\alpha\)).
Verdict falsifiable : \(|\hat\alpha - \alpha_\text{true}| < 0.1\) pour \(\alpha \in \{0, 0.5, 1\}\). Un estimateur aveugle (constant 0.5) raterait \(\alpha=0\) et \(\alpha=1\).
v2 = controllability_estimation_test(n_states=9, n_steps=2000, seed=0)for k, val in v2.items():print(f" {k:28} = {val:.3f}"ifisinstance(val, float) elsef" {k:28} = {val}")print()print("VERDICT 'detected' =", int(v2['detected'])," (max |erreur| =", round(v2['max_abs_err'], 3), "< 0.1)")alphas = [0.0, 0.5, 1.0]errs = [v2["abs_err_alpha_%.1f"% a] for a in alphas]fig, ax = plt.subplots(figsize=(5.5, 3.6))ax.bar([r"$\alpha=0$", r"$\alpha=0.5$", r"$\alpha=1$"], errs, color=["C3", "C1", "C2"], edgecolor="k", lw=0.6)ax.axhline(0.1, color="k", ls="--", lw=1, label="seuil falsifiable 0.1")ax.set_ylabel(r"$|\hat\alpha - \alpha_\mathrm{true}|$")ax.set_title("Détection de la contrôlabilité (corrigée de la ligne de chance)")ax.legend(loc="upper center")fig.tight_layout(); plt.show()
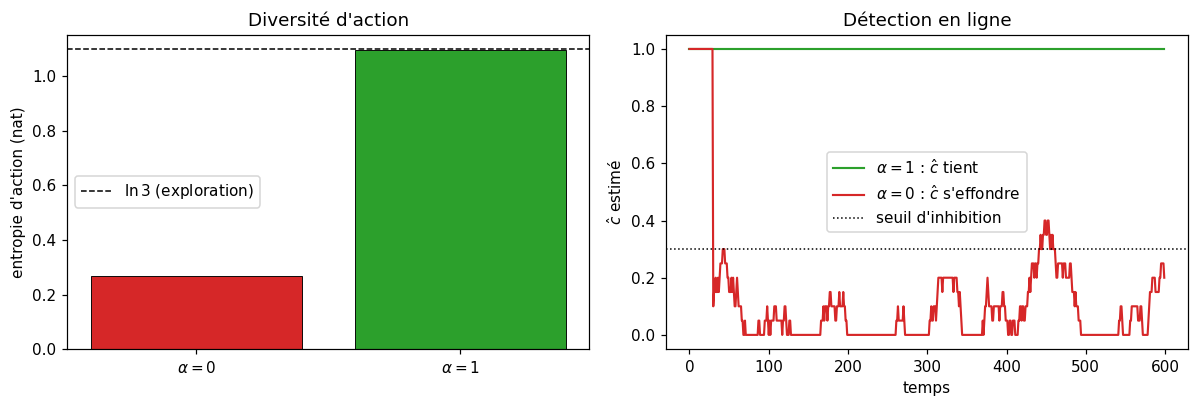
Sous \(\alpha=0\), l’animat détecte \(\hat c \to 0\) et se replie sur le no-op (action 0) — c’est l’inhibition adaptative. Sa diversité d’action s’effondre : l’entropie de Shannon de la distribution d’action passe de \(\ln 3 \approx 1.099\) (exploration) à \(\approx 0\) (répétition stérile). Sous \(\alpha=1\), \(\hat c\) reste élevé et l’animat explore.
Verdict falsifiable : rigidified ssi la chute d’entropie \(H(\alpha{=}1) - H(\alpha{=}0) > 0.3\) nat. Un animat qui n’inhiberait pas garderait la même diversité — le test le détecterait.
4. Perte d’efficacité : l’animat ne peut plus atteindre ni maintenir un but
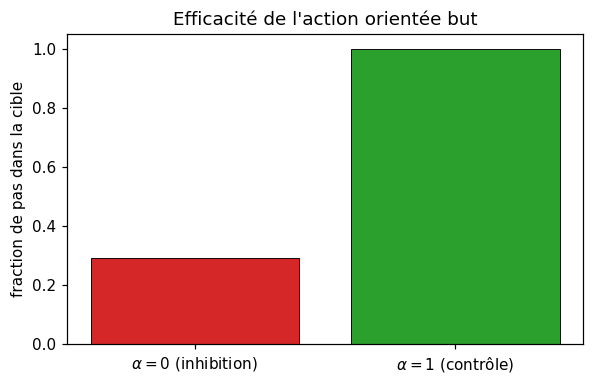
La couverture d’états ne s’effondre pas sous inhibition (la dérive porte l’animat partout sur un petit anneau) — ce n’est donc pas la bonne pathologie. Celle de Laborit est la perte d’efficacité de l’action orientée but : même en cherchant activement à se rendre à la cible (état 0 et ses voisins), l’animat inhibé n’y séjourne plus.
Verdict falsifiable : lost_control ssi la fraction de pas dans la cible est strictement supérieure sous \(\alpha=1\) que sous \(\alpha=0\).
v4 = goal_seeking_efficacy_test(n_states=9, n_steps=800, seed=0)for k, val in v4.items():print(f" {k:30} = {val:.3f}"ifisinstance(val, float) elsef" {k:30} = {val}")print()print("VERDICT 'lost_control' =", int(v4['lost_control'])," (baisse d'efficacité =", round(v4['efficacy_drop'], 3), ")")fig, ax = plt.subplots(figsize=(5.5, 3.6))ax.bar([r"$\alpha=0$(inhibition)", r"$\alpha=1$(contrôle)"], [v4["target_fraction_inhibited"], v4["target_fraction_controlled"]], color=["C3", "C2"], edgecolor="k", lw=0.6)ax.set_ylabel("fraction de pas dans la cible")ax.set_title("Efficacité de l'action orientée but")ax.set_ylim(0, 1.05)fig.tight_layout(); plt.show()
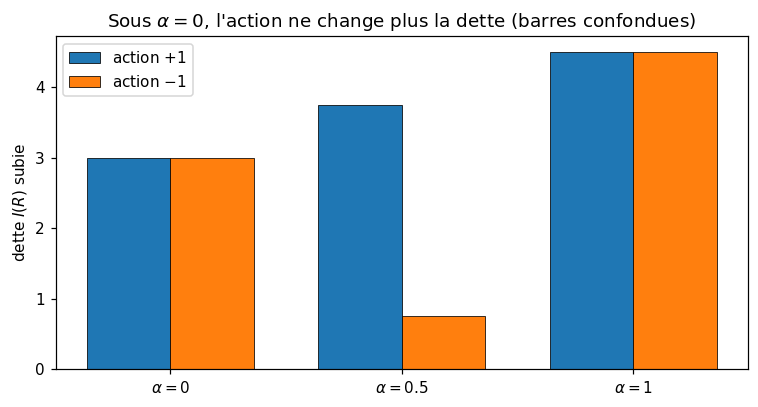
5. Le pont \(I(R)\) : la dette d’irréversibilité échappe à l’action
Le pont vers la dette d’irréversibilité \(I(R)\) (cf. ICT-18, ict.reversibility_budget.work_budget) n’est pas « la dette monte sous inhibition » : une permutation déterministe porte aussi une forte flèche du temps. Le finding est plus fin — sous inhibition (\(\alpha=0\)), changer d’action ne change plus la dette subie : l’animat a perdu toute prise sur l’irréversibilité qu’il subit, devenue dictée par la dérive seule. À contrôlabilité partielle (\(\alpha=0.5\)), l’action modulait encore cette dette.
Verdict falsifiable : trapped ssi (a) l’effet de l’action sur la dette est nul sous inhibition (\(|\Delta| < 10^{-9}\)), ET (b) non-négligeable à contrôle partiel (\(|\Delta(\alpha{=}0.5)| > 0.5\)) — preuve que l’action était opérante puis a cessé de l’être.
6. Robustesse inter-seeds : les verdicts tiennent-ils hors du seed 0 ?
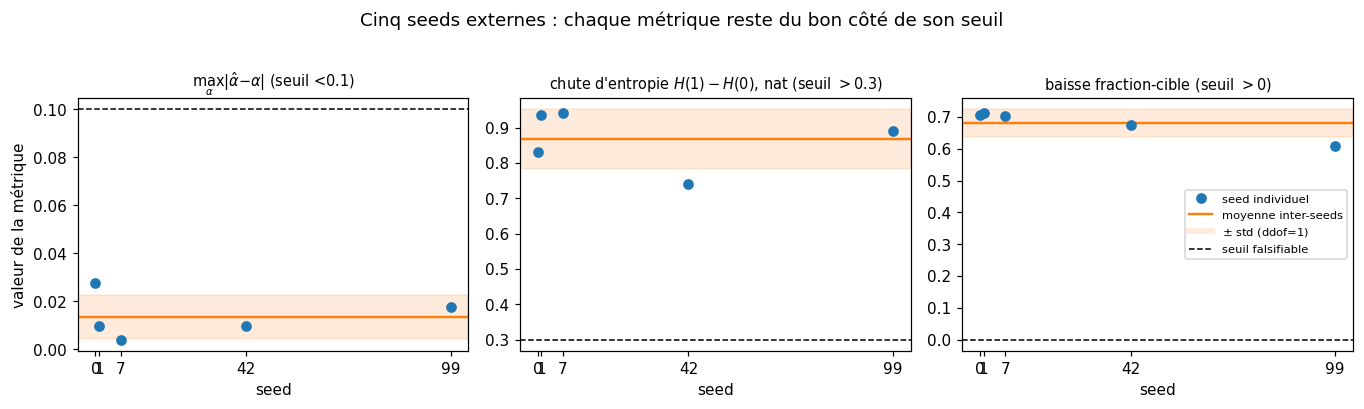
Les bancs des sections 2 à 4 sont stochastiques : un verdict établi sur un seul seed pourrait n’être qu’un coup de dé chanceux. Protocole de robustesse : on rejoue les trois bancs stochastiques (détection, rigidification, perte d’efficacité) sur cinq seeds externes \([0, 1, 7, 42, 99]\), sans toucher aux paramètres (\(n_\text{states}=9\), \(n_\text{steps}\) et inhibit_threshold identiques aux sections précédentes). Pour chaque banc on suit sa métrique porteuse de conclusion — celle qui décide du verdict :
efficacité : baisse de fraction-cible sous inhibition (verdict lost_control ssi \(> 0\)).
Le pont \(I(R)\) (section 5) est déterministe — noyau de transition analytique, aucun tirage aléatoire — il n’y a rien à disperser : sa robustesse est structurelle, pas statistique, et il reste hors de ce protocole.
import pandas as pdSEEDS = [0, 1, 7, 42, 99]rows = []for s in SEEDS: d = controllability_estimation_test(n_states=9, n_steps=2000, seed=s) r = rigidification_test(n_states=9, n_steps=600, inhibit_threshold=0.3, seed=s) e = goal_seeking_efficacy_test(n_states=9, n_steps=800, seed=s) rows.append((s, d["max_abs_err"], int(d["detected"]), r["entropy_drop"], int(r["rigidified"]), e["efficacy_drop"], int(e["lost_control"])))df_seeds = pd.DataFrame(rows, columns=["seed", "max_abs_err", "detected","entropy_drop", "rigidified", "efficacy_drop", "lost_control"])metrics = [ # (colonne, seuil falsifiable, label) ("max_abs_err", 0.1, r"$\max_\alpha|\hat\alpha-\alpha|$(seuil $<0.1$)"), ("entropy_drop", 0.3, r"chute d'entropie $H(1)-H(0)$, nat (seuil $>0.3$)"), ("efficacy_drop", 0.0, r"baisse fraction-cible (seuil $>0$)"),]for col, seuil, _label in metrics: v = df_seeds[col]print(f"{col:14s}: mean = {v.mean():.4f} std(ddof=1) = {v.std(ddof=1):.4f}"f" plage [{v.min():.4f}, {v.max():.4f}] (seuil {seuil})")print(f"\nverdicts sur {len(SEEDS)} seeds : detected {int(df_seeds['detected'].sum())}/5,"f" rigidified {int(df_seeds['rigidified'].sum())}/5,"f" lost_control {int(df_seeds['lost_control'].sum())}/5")fig, axes = plt.subplots(1, 3, figsize=(12.5, 3.6))for ax, (col, seuil, label) inzip(axes, metrics): v = df_seeds[col] ax.scatter(df_seeds["seed"], v, color="C0", zorder=3) ax.axhline(v.mean(), color="C1", lw=1.6) ax.axhspan(v.mean() - v.std(ddof=1), v.mean() + v.std(ddof=1), color="C1", alpha=0.15) ax.axhline(seuil, color="k", ls="--", lw=1) ax.set_xticks(SEEDS); ax.set_xlabel("seed"); ax.set_title(label, fontsize=9.5)axes[0].set_ylabel("valeur de la métrique")axes[-1].plot([], [], "o", color="C0", label="seed individuel")axes[-1].plot([], [], "-", color="C1", lw=1.6, label="moyenne inter-seeds")axes[-1].plot([], [], "-", color="C1", lw=4, alpha=0.15, label=r"$\pm$ std (ddof=1)")axes[-1].plot([], [], "--", color="k", lw=1, label="seuil falsifiable")axes[-1].legend(fontsize=7.5)fig.suptitle("Cinq seeds externes : chaque métrique reste du bon côté de son seuil", y=1.02)fig.tight_layout(); plt.show()df_seeds.round(4)
Interprétation : les verdicts sont robustes aux seeds
Sortie obtenue : les trois bancs stochastiques tiennent leur verdict sur 5/5 seeds — aucune bascule. Détail parlant : le seed 0 (utilisé dans les sections précédentes) est le pire cas de la détection (erreur 0.0275, la plus haute des cinq) — la démonstration mono-seed n’était pas flatteuse, elle était conservatrice.
Métrique porteuse
Moyenne
std (ddof=1)
Plage sur 5 seeds
Seuil
Marge au pire seed
\(\max_\alpha \|\hat\alpha - \alpha\|\)
0.014
0.009
0.004 – 0.028
\(< 0.1\)
\(\approx 3.6\times\) sous le seuil
Chute d’entropie (nat)
0.868
0.084
0.741 – 0.942
\(> 0.3\)
\(\approx 2.5\times\) au-dessus du seuil
Baisse de fraction-cible
0.681
0.043
0.609 – 0.713
\(> 0\)
pire cas 0.609, jamais proche de 0
Points clés :
Dispersion faible devant les marges : l’écart-type le plus large (chute d’entropie, \(\sigma \approx 0.08\) nat) est ~7× plus petit que la distance de la moyenne à son seuil (\(0.868 - 0.3 \approx 0.57\) nat) ; aucun seed n’approche un seuil.
La variation de la chute d’entropie reflète la vitesse du repli sur le no-op sous \(\alpha=0\) (l’animat passe \(\hat c < 0.3\) plus ou moins tôt selon sa trajectoire), pas une ambiguïté du verdict — les deux extrêmes (0.741 et 0.942) décrivent la même pathologie.
Le pont \(I(R)\) (section 5) est déterministe : noyau analytique, aucun tirage aléatoire — sa robustesse est structurelle, pas statistique ; il n’entre pas dans ce protocole.
Portée honnête : \(n = 5\) seeds établit la stabilité des verdicts (aucune bascule, marges confortables), pas une estimation fine des tailles d’effet — l’écart-type échantillonnal n’est lui-même connu qu’à ~35 % près (\(1/\sqrt{2(n{-}1)}\)).
7. Synthèse — la factorisation 4-objets et le seuil de bascule
Les quatre verdicts se laissent lire sur la factorisation 4-objets\((s, q, \pi, W)\) : l’inhibition de l’action attaque l’opérateur de workspace\(W\) (l’animat ne peut plus agir en retour sur la totalité), puis, par rétroaction, la prégnance/valence\(\pi\) (rigidification) et la représentation prédictive\(q\) (perte d’efficacité). C’est l’envers de la dissociation \(\hat p / \pi\) d’ICT-12c : là-bas on séparait deux grandeurs qui tiennent ; ici on montre une grandeur (\(W\)) qui s’effondre, et emporte les autres.
Le seuil de bascule est la contrôlabilité \(\alpha_c\) en-dessous de laquelle l’animat inhibe — l’analogue, au niveau animat, du seuil de performativité \(\rho_c\) du cadrage strate 7 (D1/D2). Sa rencontre avec l’inhibition de l’innovation collective (ICT-30, #7746) est l’issue ultérieure.
Tracez l’entropie d’action finale en fonction de \(\alpha \in \{0, 0.1, \dots, 1\}\) (fixez n_steps=600, moyenné sur 3 seeds). Identifiez le seuil de bascule\(\alpha_c\) où l’animat bascule d’explorateur à inhibé. Ce seuil dépend-il de inhibit_threshold ? De n_states ?
Exercice 2 — Dérive hostile (biased)
Remplacez drift="uniform" par drift="biased" (environnement qui pousse dans un sens). L’animat peut-il exploiter une dérive orientée pour atteindre la cible même sous faible \(\alpha\) ? Mesurez la fraction-cible dans les deux régimes de dérive. Que dit le pont \(I(R)\) ?
Exercice 3 — Inhibition sans détection
Construisez un animat qui n’estime pas\(\alpha\) (politique fixe aléatoire, sans repli sur le no-op). Comparez son entropie d’action sous \(\alpha=0\) à celle de l’animat adaptatif. La rigidification de Laborit est-elle une pathologie de l’estimation ou de l’environnement ?
# Exercice 1 — squelette.# alphas = np.arange(0, 1.01, 0.1)# for a in alphas:# ... # adapter rigidification_test ou appeler adaptive_animat directement# print("a completer")# Exercice 2 — squelette.# for drift in ("uniform", "biased"):# ... # goal_seeking_efficacy_test n'expose pas drift -> appel direct# print("a completer")# Exercice 3 — squelette.# ... # animat non-adaptatif : actions uniformes sans condition sur chat# print("a completer")
Conclusion
Ce notebook incarne le maillon « animat inhibé » de l’échelle Laborit (animat simple → animat inhibé → agent augmenté → agent créateur → collectif) comme un substrat expérimental falsifiable, et en livre quatre verdicts contrôlés :
Détection — l’animat estime \(\alpha\) depuis ses transitions (corrigé de la ligne de chance) ;
Rigidification — sous inhibition, sa politique se replie et la diversité d’action s’effondre ;
Perte d’efficacité — il ne peut plus atteindre ni maintenir un but, quand bien même il le cherche ;
Pont \(I(R)\) — l’action ne module plus la dette d’irréversibilité subie, preuve qu’elle a cessé d’être opérante.
Robustesse : les trois bancs stochastiques tiennent leurs verdicts sur cinq seeds externes \([0, 1, 7, 42, 99]\) — aucune bascule, dispersion faible devant les marges (section 6, tableau par métrique) ; le pont \(I(R)\) est déterministe, robuste par construction.
Portée honnête : substrat 1-torus minimal (anneau à 9 états) — l’objet est la mécanique de l’inhibition de l’action (détection → rigidification → perte de prise sur \(I(R)\)), transposable à des animats richer. La rencontre avec la strate 7 (inhibition de l’innovation, ICT-30, #7746) est une issue ultérieure ; ce notebook reste au niveau animat individuel.
Module : ict.inhibited_action (PR #8825). Parallèle : C1 — ICT-12c (#7740). Références : Laborit 1976 (L’Éloge de la fuite) ; spec #7741 (conversation de conception tours 756-761, 2026-07-20) ; pont \(I(R)\) via ict.reversibility_budget (ICT-18).