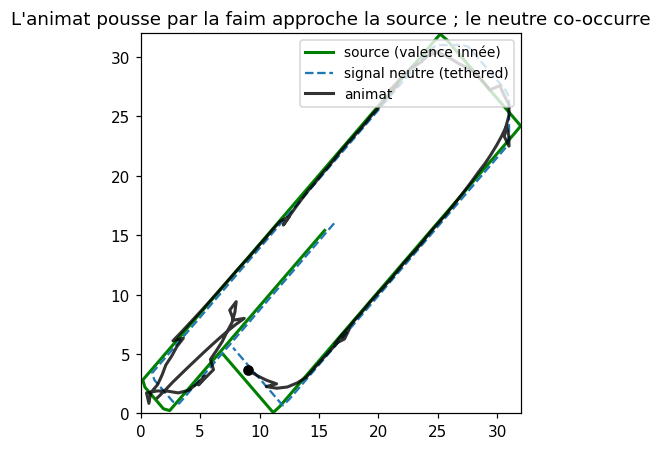
ICT-12b a montré qu’une valence peut être apprise (Rescorla-Wagner), transférable (un signal neutre devient attractif) et distincte de la prédiction \(\hat p\) — mais sur des bancs désincarnés : un signal y est un index abstrait, sans environnement, sans corps, sans action. Ce notebook fait le pas suivant (jambe C1, #7740) : incarner cette « expérience manquante » dans un animat qui se déplace, a un état interne (la faim), et choisit ses actions.
L’enjeu scientifique : une fois incarnée, la valence et la prédiction se dissocient-elles encore ? Ou l’incarnation les recolle-t-elle en un seul signal de poursuite ? La réponse passe par une matrice de dissociation, pas un printout par mesure.
Statut épistémique — Établi : Incarné, p̂ et π se dissocient : erratique détruit p̂ mais le conditionnement tient. Portée et détail dans la matrice de dissociations.
API publique : ['approach_fraction', 'prediction_trace', 'reset', 'set_intrinsic_valences', 'step'] ...
1. L’animat — un corps, un modèle \(\hat p\), une valence \(\pi\), une faim
PregnanceAnimat réutilise les fondations de ICT-12b sans les modifier :
un modèle prédictif\(\hat p\) (predict_source de ICT-12 : extrapolation EMA-vitesse de la position future des objets) ;
une valence apprise\(\pi\) (la classe LearnedValence de ICT-12b : Rescorla-Wagner, neutre à l’init) ;
un drive internehunger (croît avec le temps, tombe à la capture d’une source) ;
une politique\(a_t = f(\text{salience}, \text{hunger})\) où la salience apparente d’un objet est \(\pi_i + \text{intrinsic}_i\) (valence apprise + valence innée de source).
Le couplage incarné : la valence décide SI on poursuit ; la crédibilité de \(\hat p\) décide COMMENT (interception anticipée si \(\hat p\) est fiable, poursuite réactive sinon). Sur un régime erratique, \(\hat p\) est peu fiable — l’animat poursuit réactivement, là où la cible est. C’est le germe de la dissociation.
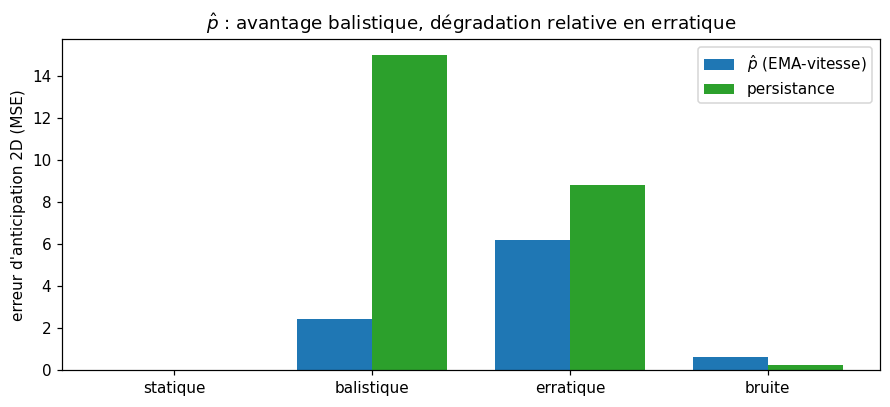
L’erreur d’anticipation 2D de \(\hat p\) (MSE à l’horizon lead) contre 3 baselines du Cran A (persistance, moyenne mobile, AR(1)), par régime de source. Sans complaisance : \(\hat p\)gagne en balistique (vitesse constante, extrapolation exacte) mais son erreur explose en erratique — les renversements trompent l’EMA-vitesse, et l’avantage sur la persistance fond (ratio 0.16 → 0.71 à graine 0). C’est le levier de la dissociation : \(\hat p\) est fragile là où le conditionnement ne l’est pas.
sweep = phat_regime_sweep(seed=0)regimes = ["statique", "balistique", "erratique", "bruite"]errs = {r: sweep[r]["err_phat"] for r in regimes}errs_p = {r: sweep[r]["err_persistence"] for r in regimes}fig, ax = plt.subplots(figsize=(8.2, 3.8))x = np.arange(len(regimes)); w =0.38ax.bar(x - w/2, [errs[r] for r in regimes], w, label=r"$\hat p$(EMA-vitesse)", color="C0")ax.bar(x + w/2, [errs_p[r] for r in regimes], w, label="persistance", color="C2")ax.set_xticks(x); ax.set_xticklabels(regimes)ax.set_ylabel("erreur d'anticipation 2D (MSE)")ax.set_title(r"$\hat p$ : avantage balistique, dégradation relative en erratique")ax.legend()plt.tight_layout(); plt.show()for r in regimes:print(f" {r:11s} : p_hat={errs[r]:6.2f} pers={errs_p[r]:6.2f} "f"ratio={errs[r]/(errs_p[r]+1e-12):.2f}")
Lecture de la sortie. Quatre régimes, quatre lignes \((\hat p,\ \text{persistance},\ \text{ratio})\) : statique \((0{,}03,\ 0{,}01,\ 2{,}61)\), balistique \((2{,}43,\ 15{,}00,\ 0{,}16)\), erratique \((6{,}20,\ 8{,}79,\ 0{,}71)\), bruité \((0{,}64,\ 0{,}24,\ 2{,}60)\). La colonne qui décide est le ratio : en dessous de 1, \(\hat p\) bat la persistance. Seul le balistique s’y trouve (\(0{,}16\)) – vitesse constante, l’extrapolation EMA est exacte et écrase la baseline. L’erratique est le cas intermédiaire le plus instructif : l’erreur de \(\hat p\)explose (\(6{,}20\) contre \(2{,}43\) en balistique), mais celle de la persistance explose davantage encore (\(8{,}79\)) – l’avantage relatif survit à la dégradation (\(0{,}71 < 1\)). Statique et bruité, enfin, rendent la persistance imbattable (ratios \(2{,}61\) et \(2{,}60\)) : une position immobile ou un bruit blanc sont exactement ce que la persistance prédit au mieux, et \(\hat p\) y est environ \(2{,}6\times\) pire. Lire la seule colonne \(\hat p\) aurait inversé la conclusion : c’est le rapport aux baselines qui départage.
3. Mesure 2 — transfert incarné : le neutre devient-il approché seul ?
ICT-12b mesurait le transfert sur \(\pi\) (scalaire). Ici on le mesure comportementalement : après conditionnement (neutre tethered à la source), le neutre est présenté seul (source retirée, faim élevée). L’animat l’approche-t-il par lui-même ? Un contrôle non-conditionné (présenté seul, \(\pi = 0\)) ne doit pas l’être — sinon c’est une fuite de l’inné vers tout.
rep = embodied_transfer_test(kind="balistique", seed=0)print("Verdict TRANSFERT incarné :")for k, v in rep.items():print(f" {k:34} = {v:.4f}")print(f"\n=> transferred = {rep['transferred']:.1f} "f"(approche cond {rep['approach_fraction_conditioned']:.2f} vs contrôle "f"{rep['approach_fraction_control']:.2f}, gain +{rep['approach_gain']:.2f})")
Lecture de la sortie, chiffre par chiffre.post_valence_neutral\(= 1{,}0000\) : après conditionnement, le signal neutre porte une valence positive maximale – alors que le contrôle non-conditionné reste à \(0{,}0000\), preuve que la valence est apprise, pas intrinsèque. Le comportement suit : l’animat approche le neutre présenté seul dans \(62{,}5\,\%\) des cas contre \(11{,}25\,\%\) pour le contrôle – un gain de \(+0{,}5125\), soit plus de cinq fois le niveau d’exploration spontanée. Le contrôle est la pièce maîtresse : \(0{,}1125\) mesure ce qu’un animat non conditionné fait face au même signal, et le contraste \(0{,}62\) contre \(0{,}11\) isole ce que le conditionnement a réellement ajouté. D’où le verdict transferred = 1 : la valence migrée de la source vers le neutre se traduit en approche autonome, source retirée.
4. Mesure 3 — engagement d’action : un animat investi se replie sur sa cible
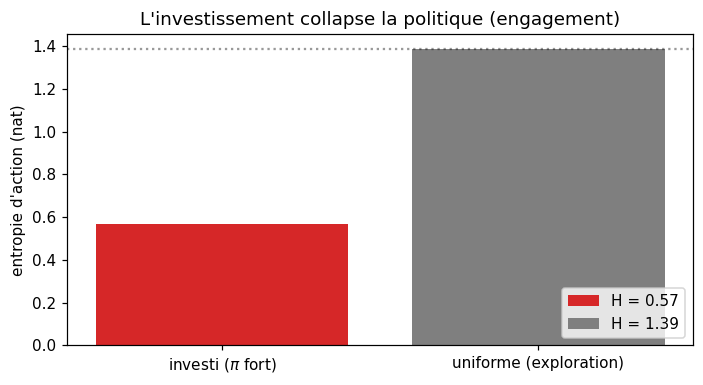
Un animat investi (forte \(\pi\), faim élevée) collapse sa distribution d’actions sur sa cible : son entropie d’action chute sous le maximum \(\ln(n_\text{actions})\) (uniforme = exploration pure). C’est la signature d’un engagement morphologique — l’envers de l’inhibition (strate 6, ict.inhibited_action). Le témoin est la borne supérieure \(\ln(n_\text{actions})\), forme close.
Lecture de la sortie. Trois nombres tiennent la mesure : entropy_drop\(= 0{,}820\), committed\(= 1\), pi_signal\(= 1{,}00\). Quand la valence du signal sature (\(\pi = 1{,}00\)) et que la faim est élevée, la distribution d’actions perd \(0{,}82\) d’entropie : l’animat abandonne l’exploration uniforme pour se replier sur les actions qui rapprochent de la cible. C’est la signature de l’engagement annoncée en intro – l’envers morphologique de l’inhibition : même corps, même répertoire d’actions, mais une concentration décisionnelle radicalement différente. Le verdict committed = 1 certifie que la chute dépasse le seuil fixé par le test.
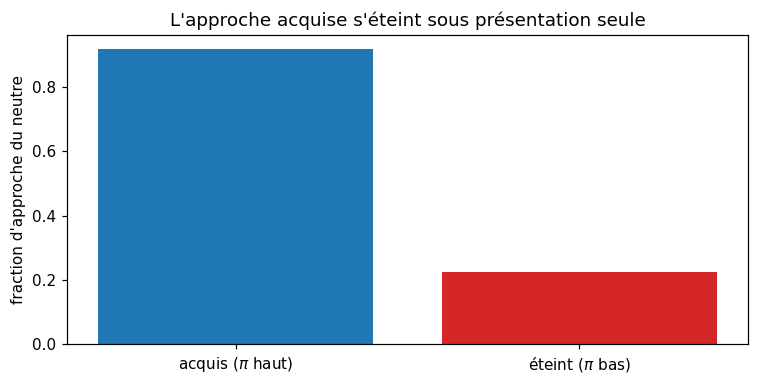
Miroir comportemental de la réversibilité de ICT-12b : après acquisition d’une approche du neutre (co-occurrence), on présente le signal seul prolongé (extinction). L’approche doit chuter — parce que \(\pi\) s’éteint (Rescorla-Wagner : acquisition et extinction partagent la même règle). Ce qui s’apprend (approche) peut se désapprend.
Lecture de la sortie. La ligne raconte l’extinction complète en trois temps : valence acquise \(1{,}000\), valence éteinte \(0{,}0000\) – un retour exact à zéro, pas un affaiblissement résiduel – pour une chute d’approche de \(0{,}69\). Le verdict reversible = 1 clôt la mesure : ce qui s’est appris (approche du neutre) se désapprend quand la co-occurrence cesse. C’est la symétrie Rescorla-Wagner en acte : acquisition et extinction partagent la même règle d’apprentissage, donc la même pente – l’animat n’a pas besoin d’un mécanisme séparé pour désapprendre.
6. La matrice de dissociation — la porte scientifique #7740
Quatre mesures qui bougent ensemble ne prouvent rien (elles pourraient n’être qu’un seul signal de poursuite). La validation est une matrice de dissociation : un régime où \(\hat p\) est fortement dégradé MAIS transfert + engagement + réversibilité tiennent. Le régime erratique est ce levier : ses renversements de vitesse cassent l’estimation EMA (mesure 1), mais le conditionnement Rescorla-Wagner ne dépend que de la co-occurrence — pas de la prévisibilité. Donc \(\hat p\) et \(\pi\) se dissocient.
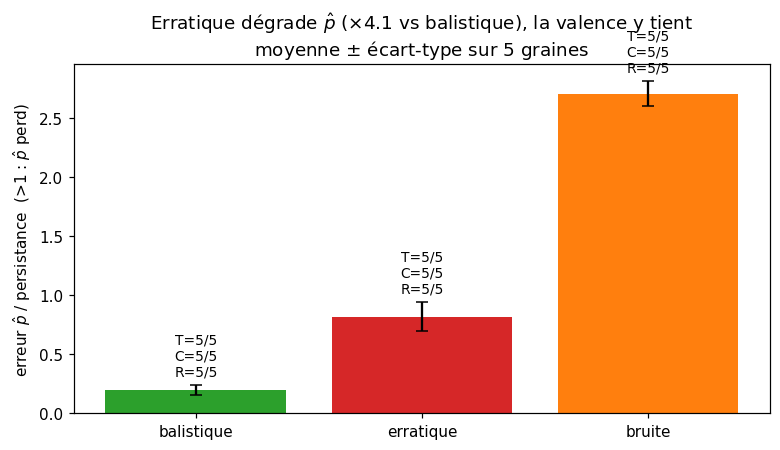
Une conclusion tirée d’un seul tirage ne vaut rien (#14439) : la matrice est donc évaluée sur cinq graines (0, 1, 7, 42, 99), et la grandeur qui porte la conclusion — le ratio erreur \(\hat p\)/persistance — est rapportée avec sa dispersion inter-graines (moyenne ± écart-type), verdicts comptés par graine.
# 5 graines : la conclusion ne doit pas dependre d'un tirage unique (#14439).SEEDS = [0, 1, 7, 42, 99]kinds = ["balistique", "erratique", "bruite"]dms = {s: dissociation_matrix(seed=s) for s in SEEDS}# Dispersion inter-graines du ratio erreur p_hat / persistanceratio_mean = {k: np.mean([dms[s][k]["err_phat_vs_persistence"] for s in SEEDS])for k in kinds}ratio_std = {k: np.std([dms[s][k]["err_phat_vs_persistence"] for s in SEEDS], ddof=1)for k in kinds}tcr = {k: (int(sum(dms[s][k]["transferred"] for s in SEEDS)),int(sum(dms[s][k]["committed"] for s in SEEDS)),int(sum(dms[s][k]["reversible"] for s in SEEDS)))for k in kinds}fig, ax = plt.subplots(figsize=(7.2, 4.2))colors = ["C2", "C3", "C1"]ax.bar(kinds, [ratio_mean[k] for k in kinds], yerr=[ratio_std[k] for k in kinds], capsize=4, color=colors)ax.set_ylabel(r"erreur $\hat p$ / persistance (>1 : $\hat p$ perd)")ax.set_title(rf"Erratique dégrade $\hat p$($\times$"f"{ratio_mean['erratique'] / ratio_mean['balistique']:.1f} vs balistique), "r"la valence y tient""\n"r"moyenne $\pm$ écart-type sur 5 graines")for i, k inenumerate(kinds): T, C, R = tcr[k] ax.text(i, ratio_mean[k] + ratio_std[k] +0.08,f"T={T}/5\nC={C}/5\nR={R}/5", ha="center", fontsize=9)plt.tight_layout(); plt.show()for k in kinds: per_seed =" ".join(f"{dms[s][k]['err_phat_vs_persistence']:.2f}"for s in SEEDS) T, C, R = tcr[k]print(f"{k:11s} ratio p̂/pers par graine [0, 1, 7, 42, 99] : {per_seed}")print(f"{k:11s} moyenne ± écart-type = {ratio_mean[k]:.3f} ± {ratio_std[k]:.3f}"f" T={T}/5 C={C}/5 R={R}/5")n_diss =int(sum(dms[s]["_verdict"]["dissociation_observed"] for s in SEEDS))print(f"\ndissociation_observed = {n_diss}/{len(SEEDS)} graines -> "f"{'dissociation robuste'if n_diss ==len(SEEDS) else'dissociation NON robuste'}")
Lecture du résultat : la dissociation survit aux cinq graines
Sortie obtenue : ratio \(\hat p\)/persistance, moyenne ± écart-type sur les graines 0, 1, 7, 42, 99 — balistique 0.20 ± 0.04, erratique 0.82 ± 0.12, bruité 2.70 ± 0.11 ; verdicts T/C/R à 5/5 dans les trois régimes ; dissociation_observed5/5.
Régime
ratio \(\hat p\)/pers (moy ± std)
T / C / R
Lecture
balistique
0.20 ± 0.04
5/5 · 5/5 · 5/5
\(\hat p\) extrapole proprement
erratique
0.82 ± 0.12
5/5 · 5/5 · 5/5
\(\hat p\) dégradé (×4.1 vs balistique), valence intacte
bruité
2.70 ± 0.11
5/5 · 5/5 · 5/5
\(\hat p\) perd contre la persistance, valence intacte
Points clés :
La conclusion n’est pas un artefact de graine : le verdict de dissociation (erratique dégrade \(\hat p\) relativement au balistique TANDIS QUE transfert + réversibilité tiennent) est observé sur chacune des cinq graines.
Lecture honnête du ratio erratique : 0.82 ± 0.12 reste sous 1 — en erratique, \(\hat p\) bat encore marginalement la persistance (valeurs par graine de 0.69 à 0.95, jamais au-dessus). La dégradation est relative (×4.1 vs balistique), pas un effondrement absolu. Le dépassement de la persistance (2.70 ± 0.11) se produit dans le régime bruité — où la valence tient elle aussi (5/5) : la dissociation est robuste tant sous dégradation relative qu’en échec absolu de \(\hat p\).
Dispersion modérée : l’écart-type vaut ~15 % de la moyenne en erratique, ~21 % en balistique ; l’ordre des régimes (balistique < erratique < bruité) est stable sur les cinq graines — le classement ne repose pas sur un tirage chanceux.
7. Trois lecteurs orthogonaux de \(\hat q\) — erreur, énergie libre, information
La matrice de dissociation (§6) opposait \(\hat p\) à la valence \(\pi\). On change de grandeur : \(\hat q\) — la prédiction lead-ahead de l’animat (prediction_trace()) — admet trois lecteurs distincts, chacun avec un comportement de régime propre :
Erreur de point (MSE) — mesure 1 : \(\hat q\) loin de l’observation en distance.
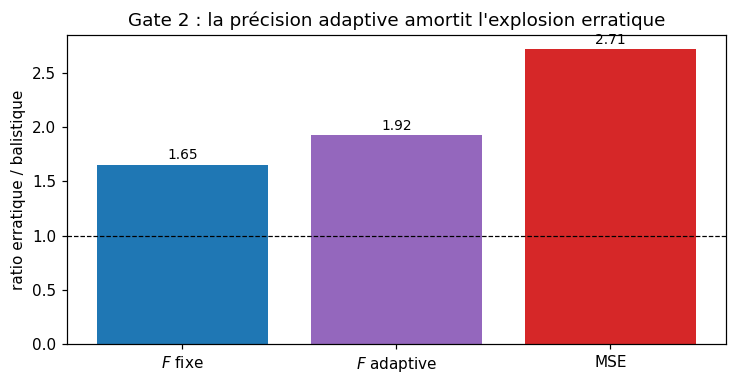
Énergie libre adaptive (FE) — mesure 4 : la surprise renormalisée par la variance attendue. En précision fixe, ce n’est qu’un habillage du MSE (gate 1) ; en précision adaptive, elle amortit l’explosion erratique (gate 2).
Information prédictive (MI) — mesure 5 : \(I(\hat q;o)\) en bits, combien \(\hat q\) réduit l’incertitude sur l’observation.
Ces bancs sont orthogonaux à la dissociation \(\hat p/\pi\) : ils opposent des lecteurs de \(\hat q\) lui-même. Leur conclusion : la représentation prédictive \(q\) n’est pas réductible à un seul scalaire d’erreur.
7.1 Énergie libre adaptive (mesure 4) — la surprise renormalisée
free_energy_profile_test calcule la surprise lead-ahead de \(\hat q\) en précision fixe puis adaptive (EMA causale des erreurs passées, plancher scale-aware à 5 % de la variance globale), confrontée au MSE, à travers les régimes balistique / erratique.
Deux verdicts falsifiables :
fe_fixed_monotone_with_mse : en précision fixe, FE et MSE rangent les régimes pareil (FE = habillage du MSE, gate 1).
fe_adaptive_amortizes_mse : la précision adaptive amortit l’explosion erratique (ratio FE-adaptive err/bal inférieur au ratio MSE, gate 2).
fe4 = free_energy_profile_test(seed=0)labels = [r"$F$ fixe", r"$F$ adaptive", r"MSE"]ratios = [fe4["F_fixed_ratio_err_over_bal"], fe4["F_adaptive_ratio_err_over_bal"], fe4["mse_ratio_err_over_bal"]]colors = ["C0", "C4", "C3"]fig, ax = plt.subplots(figsize=(6.8, 3.6))ax.bar(labels, ratios, color=colors)ax.axhline(1.0, color="k", lw=0.8, ls="--")ax.set_ylabel(r"ratio erratique / balistique")ax.set_title(r"Gate 2 : la précision adaptive amortit l'explosion erratique")for i, r inenumerate(ratios): ax.text(i, r +0.05, f"{r:.2f}", ha="center", fontsize=9)plt.tight_layout(); plt.show()print(f"fe_fixed_monotone_with_mse = {fe4['fe_fixed_monotone_with_mse']:.0f} "f"(F fixe range comme le MSE : gate 1)")print(f"fe_adaptive_amortizes_mse = {fe4['fe_adaptive_amortizes_mse']:.0f} "f"(F-adaptive {fe4['F_adaptive_ratio_err_over_bal']:.2f} < "f"MSE {fe4['mse_ratio_err_over_bal']:.2f} : gate 2)")
fe_fixed_monotone_with_mse = 1  (F fixe range comme le MSE : gate 1)
fe_adaptive_amortizes_mse  = 1  (F-adaptive 1.92 < MSE 2.71 : gate 2)
Lecture des deux verdicts. Les deux gates passent, et le second se chiffre : sous erratique, la surprise renormalisée en précision adaptive vaut \(1{,}92\) là où le MSE brut monte à \(2{,}71\) – un amortissement de \(0{,}79\), soit près de \(30\,\%\) de l’explosion absorbés par la seule renormalisation de la précision. Le premier verdict (fe_fixed_monotone_with_mse\(= 1\)) garantit l’ancrage : en précision fixe, la FE range les régimes comme le MSE – elle n’est pas un lecteur divergent gratuit, juste un habillage. Tout l’apport est dans le passage fixe \(\rightarrow\) adaptive.
7.2 Information prédictive (mesure 5) — \(I(\hat q;o)\) vs MSE
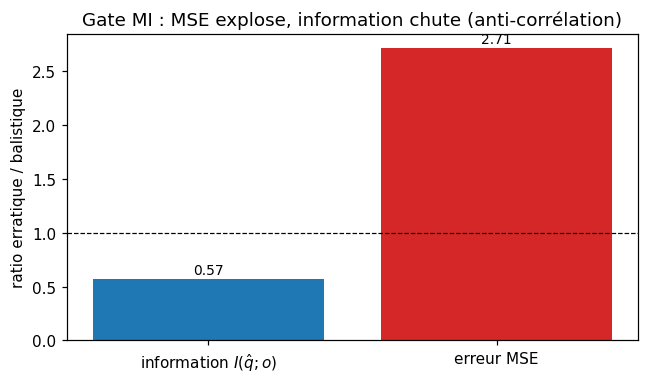
predictive_information_regime_contrast mesure l’information mutuelle (en bits) entre \(\hat q[t]\) et \(o[t+\mathrm{lead}]\) — projettée sur \(x\), discrétisée en quantiles — confrontée au MSE. Verdict falsifiable :
mi_anticorrelated_with_mse : sous erratique, le MSE explose (ratio > 1) mais la MI chute (ratio < 1). Les deux lecteurs vont en sens inverse — la cible erratique est génuinement moins prévisible (plafond épistémique, pas un défaut d’estimateur).
Lecture du verdict, en chiffres. L’anti-corrélation exigée par le gate se lit sur la ligne : MI \(= 0{,}57\) bit qui chute pendant que le MSE monte à \(2{,}71\). Les deux lecteurs de \(\hat q\) partent en sens exactement opposés sous erratique – l’erreur quadratique explose, l’information mutuelle s’effondre – parce que la cible devient véritablement moins prévisible : moins de bits partagés entre la prédiction et le futur, quel que soit le soin de l’estimateur. C’est le plafond épistémique annoncé : la MI mesure ce que le MSE ne voit pas.
7.3 Synthèse — \(\hat q\) n’est pas un scalaire
Trois lecteurs, trois comportements de régime distincts : le MSE explose sous erratique, la FE-adaptive l’amortit, la MI chute (plafond épistémique). Aucun scalaire unique ne résume la représentation prédictive \(q\) — c’est la contribution propre des mesures 4 et 5 au tableau 4-objets \((s, q, \pi, W)\), et l’envers exact de la dissociation \(\hat p/\pi\) du §6 (qui séparait deux grandeurs qui tiennent ; ici on montre que \(q\) lui-même se décompose en lecteurs hétérogènes).
8. Exercices
Les exercices étendent l’animat sur des leviers non couverts (second ordre, rôle du drive, abstention). Conventions : print "à compléter", pas de raise.
Exercice 1 — Conditionnement de second ordre
Un signal \(B\) neutre co-occurre avec un signal \(A\)déjà conditionné (pas avec la source directement). \(B\) devient-il attractif ? Modifiez _tethered_trajectories pour que \(B\) suive \(A\) (lui-même tethered à la source), et mesurez embodied_transfer_test sur \(B\).
# Exercice 1 : conditionnement de second ordre (B suit A suit source).# TODO étudiant :# 1. Construire des trajectoires où A est tethered à la source, B tethered à A.# 2. Conditionner, puis tester l'approche de B seul.print("Exercice 1 à compléter : transfert de second ordre B -> A -> source.")
Exercice 1 à compléter : transfert de second ordre B -> A -> source.
Exercice 2 — Sensibilité au drive hunger
La politique pondère la salience par hunger. Que se passe-t-il si hunger_rate est divisé par 10 (animat rarement affamé) ? Le verdict transferred survive-t-il ? Écrivez une boucle sur AnimatConfig(hunger_rate=...) et tracez approach_gain vs hunger_rate.
# Exercice 2 : sweeper hunger_rate, tracer approach_gain.# TODO étudiant :# 1. for hr in [0.001, 0.005, 0.015, 0.03]: cfg = AnimatConfig(hunger_rate=hr) ...# 2. Collecter approach_gain, tracer vs hr.print("Exercice 2 à compléter : approach_gain vs hunger_rate.")
Exercice 2 à compléter : approach_gain vs hunger_rate.
Exercice 3 — Abstention : un signal à valence négative
Toutes les sources ici sont attractives (intrinsic_valence > 0). Ajoutez un objet répulsif (intrinsic_valence < 0, par exemple un prédateur). L’animat doit-il l’éviter ? Proposez une mesure avoidance_fraction symétrique à approach_fraction, et vérifiez qu’elle est haute pour le répulsif.
# Exercice 3 : valence négative + avoidance_fraction.# TODO étudiant :# 1. ObjectSpec(idx=3, intrinsic_valence=-1.0) (prédateur).# 2. Mesurer avoidance = 1 - approach_fraction(pred_idx) ; vérifier qu'elle est haute.print("Exercice 3 à compléter : abstention face à un signal répulsif.")
Exercice 3 à compléter : abstention face à un signal répulsif.
Conclusion
L’incarnation ne recolle pas valence et prédiction — elle les dissocie plus nettement encore. Sur le régime erratique, le modèle interne \(\hat p\) est fortement dégradé (ratio erreur vs persistance ×4.1 relativement au balistique) mais l’investissement thomien — la valence apprise \(\pi\), transférée par co-occurrence, réversible par extinction, mobilisant l’action — tient. C’est la réponse à la question #7740 : prégnance et représentation sont deux grandeurs distinctes, même chez un animat incarné.
Cette dissociation survit à l’analyse multi-graines : sur les cinq graines 0, 1, 7, 42, 99, le verdict dissociation_observed tient 5/5, l’ordre des régimes (balistique < erratique < bruité) est stable, et transfert/engagement/réversibilité sont 5/5 partout. Lecture honnête de la dispersion : en erratique, le ratio \(\hat p\)/persistance vaut 0.82 ± 0.12 — toujours sous 1, c’est-à-dire que \(\hat p\) bat encore marginalement la persistance (valeurs par graine de 0.69 à 0.95) ; la dégradation est relative au balistique (0.20 ± 0.04), pas un effondrement absolu. Le dépassement de la persistance appartient au régime bruité (2.70 ± 0.11) — où la valence tient elle aussi (5/5) : la dissociation est robuste tant sous dégradation relative qu’en échec absolu de \(\hat p\).
Portée honnête : ce notebook couvre les six mesures 1, 2, 3, 4, 5, 6 + la matrice de dissociation. Les mesures 4 (énergie-libre adaptive) et 5 (information prédictive), différées en PR-A comme recherche, sont désormais livrées (§7) : free_energy mode fixed n’est qu’un habillage du MSE (gate 1), mais la précision adaptive amortit l’explosion erratique (gate 2), et l’information mutuelle \(I(\hat q;o)\) y est anti-corrélée au MSE (plafond épistémique). Trois lecteurs orthogonaux de \(\hat q\).
Voir aussi.ICT-12 (valence programmée, champ spatial), ICT-12b (valence apprise désincarnée, le banc algorithmique que cet animat incarne), ICT-0-Framing (jambe C1, #7740).