GenAI Texte - Maîtrise des LLMs : Fondement de tout Génératif
← Documentation GenAI | ↑ .. | → Semantic Kernel
La maîtrise des LLMs constitue la pierre angulaire de toute expertise en Génératif. Chaque image générée, chaque instruction d’agent et chaque requête RAG trouve son origine dans le texte. Cette série vous guide à travers une progression pédagogique complète pour transformer votre interaction avec l’IA.
Ce que vous apprendrez
À travers cette série pratique, vous acquerrez une expertise complète : - Art du prompt engineering : du zéro-shot au chain-of-thought - Structuration des réponses : JSON Schema, Pydantic, extraction de données - Intelligence augmentée : function calling, RAG moderne, code interpreter - Raisonnement avancé : modèles o4-mini, gpt-5-thinking - Production enterprise : gestion de sessions, retry, batch processing - Déploiement local : vLLM, quantification, optimisation des coûts - Test-time scaling (ICR) : routeur agentique, mémoire persistante, Tree-of-Thoughts sur CSP, courbes de scaling, raisonnement natif, plugins Semantic Kernel (notebooks 13 à 18, arc approfondi au-delà de NB-12) - Analyse linguistique (TAL) : lemmatisation, dépendances syntaxiques, entités nommées avec spaCy, et leur comparaison à la tokenisation BPE (notebook 23)
Contenu détaillé
Tier 1 : Fondations (Débutant)
| # | Notebook | Description | Durée |
|---|---|---|---|
| 1 | 1_OpenAI_Intro.ipynb |
Introduction à l’API OpenAI, tokens, Chat Completions, Responses API | 45 min |
| 2 | 2_PromptEngineering.ipynb |
Zero-shot, few-shot, Chain-of-Thought, modèles raisonnants | 50 min |
Tier 2 : Sorties Structurées (Intermédiaire)
| # | Notebook | Description | Durée |
|---|---|---|---|
| 3 | 3_Structured_Outputs.ipynb |
JSON Schema, Pydantic, mode strict, extraction de données | 55 min |
| 3b | 3b_Typed_Decisions_System1.ipynb |
Décisions typées « système 1 » : contrat choice/score/noul, LLM gelé lu sur ses logits et tête d’attention fine-tunée (jevlike) contre témoin classique, calibration (NLL, Brier, ECE, température), escalade, banc tiers CC0 hors domaine (v1/v2, chute mesurée) | 55 min |
| 3c | 3c_Constrained_Decoding_Python.ipynb |
Décodage contraint au niveau du token : automate fini (DFA) codé à la main pour le format date ISO \d{4}-\d{2}-\d{2}, dérivation du masque de logits depuis les états de l’automate, génération pas à pas d’une date valide — le complément token-level du 3 (JSON Schema agit au niveau API, le masque agit sur la distribution elle-même) |
— |
| 4 | 4_Function_Calling.ipynb |
Tools API, appels parallèles, boucle agentique | 60 min |
Tier 3 : Augmentation (Intermédiaire)
| # | Notebook | Description | Durée |
|---|---|---|---|
| 5 | 5_RAG_Modern.ipynb |
RAG, embeddings, chunking, Responses API multi-turn, citations | 65 min |
| 6 | 6_PDF_Web_Search.ipynb |
Support PDF (base64/file_id), web_search intégré | 50 min |
| 7 | 7_Code_Interpreter.ipynb |
Code interpreter, analyse de données, génération de graphiques | 55 min |
Tier 4 : Fonctionnalités Avancées
| # | Notebook | Description | Durée |
|---|---|---|---|
| 8 | 8_Reasoning_Models.ipynb |
o4-mini, gpt-5-thinking, reasoning_effort, comparaisons | 60 min |
| 9 | 9_Production_Patterns.ipynb |
Conversations API, background mode, retry, batch processing | 70 min |
| 9b | 9b_Prompt_Security_RedTeam.ipynb |
Versant adversarial du 9 : taxonomie de l’injection (directe / indirecte RAG / jailbreak / exfiltration), 3 attaques mesurées sur le routeur DeepSeek self-hosted (≥1 réussie avant défense), défenses testées + tableau attaque × défense, suite de tests rejouable (propriété « PWNED jamais délivré »), 3 exercices stubs C.1 | 70 min |
| 10 | 10_LocalLlama.ipynb |
Serveur OpenAI-compatible auto-hébergé (vLLM) : 3 étages honnêtement nommés (local étudiant / auto-hébergé du cours / repli distant OpenRouter), multi-endpoints, benchmarking | 60 min |
| 10b | 10b_Inference_Mechanics.ipynb |
KV-cache from scratch, exactitude des logits, speedup/mémoire, TTFT et ITL mesurés sur vLLM | 75 min |
| 10c | 10c_Long_Context_Strategies.ipynb |
Stratégies pour contextes longs : budget de tokens (comptage avec le tokenizer réel), biais de position, map-reduce, prefix caching — quatre mesures sur notre vLLM | 50 min |
| 10d | 10d_TensorSharp_DotNet_Inference.ipynb |
Pilote diagnostique .NET : TensorSharp CUDA charge Gemma 4 E4B et répond en OpenAI-compatible, mais le contrôle qualitatif détecte une répétition de <pad> (RECOVERABLE-LOCAL, adoption différée) |
55 min |
| 10e | 10e_LLamaSharp_DotNet_BakeOff.ipynb |
Bake-off Phase 2 du #12353 : binding .NET de llama.cpp 0.27.0, charge Qwen3-4B Q4_K_M en local sur RTX 3080 Ti 16 Go, produit 4 réponses Phase 1 en français avec 0% pad à 70,11 tok/s GPU (vs 99.4% pad TensorSharp) — subprocess .NET 8 self-contained, harnais versionné tools/llamasharp-bakeoff/ (#15570) |
50 min |
| 10f | 10f_ORTGenAI_DotNet_BakeOff.ipynb |
Phase 3 du bake-off : ONNX Runtime GenAI 0.15.2 charge Qwen3-4B ONNX int4 avec l’EP CUDA prouvée, rejoue les quatre invites communes et tranche le go/no-go par axe face à TensorSharp et LLamaSharp | 45 min |
| 11 | 11_Quantization.ipynb |
AWQ, GPTQ, llmcompressor, modèles vision, déploiement vLLM | 60 min |
| 12 | 12_Test_Time_Scaling.ipynb |
Best-of-N, Tree-of-Thoughts (BFS/DFS), Reflexion, routeur adaptatif (cf ICR) | 60 min |
Tier 5 : Test-Time Scaling approfondi (ICR)
Le notebook 12 introduit en Python pur les quatre moteurs d’inférence au moment du test (Best-of-N, Tree-of-Thoughts, Reflexion, routeur adaptatif). Les notebooks 13 à 18 approfondissent cet arc en s’inspirant du projet de référence Iterative-Contextual-Refinements (ICR) : on passe d’un routeur codé en dur à une orchestration agentique, on rend la mémoire persistante, on attaque des problèmes de recherche où le single-shot échoue, on quantifie les compromis de scaling, on compare au raisonnement natif, puis on expose le tout comme plugins réutilisables.
| # | Notebook | Description | Durée |
|---|---|---|---|
| 13 | 13_Agentic_Orchestration.ipynb |
Routeur agentique : function calling (pont NB-04) pour laisser un LLM choisir le moteur par sous-tâche (mode “Agentic” d’ICR) | 60 min |
| 14 | 14_Persistent_Memory.ipynb |
Mémoire vectorielle persistante (baseline BoW + cosine, pont NB-05 RAG) qui rétrocède les leçons aux runs suivants (agent “Memory” d’ICR) | 55 min |
| 14b | 14b_Paginated_Memory-Python.ipynb |
Mémoire paginée d’agent (Python) — fenêtre glissante, résumé progressif, éviction LRU/MRU, mémoire vectorielle paginée, mémoire multi-domaine ; 3 exercices (#18330) | 70 min |
| 15 | 15_Tree_of_Thoughts_Search.ipynb |
Tree-of-Thoughts sur cryptarithmes (SEND+MORE=MONEY) : recherche DFS colonne par colonne avec propagation de retenue (pont séries Search/Sudoku) | 60 min |
| 16 | 16_Scaling_Test_Time_Compute.ipynb |
Courbes de scaling Snell 2024 : estimateur pass@k, BoN vs Reflexion, frontière compute-optimale selon la difficulté | 65 min |
| 17 | 17_Native_Reasoning_vs_Scaling.ipynb |
Raisonnement natif (deepseek-r1, reasoning tokens) vs scaling hand-rolled (BoN), comparaison cost-normalisée en tokens | 60 min |
| 18 | 18_Semantic_Kernel_Plugins.ipynb |
Moteurs exposés en plugins Semantic Kernel (@kernel_function) composables via le kernel (pont série SemanticKernel) |
60 min |
| 19 | 19_OWUI_Orchestration.ipynb |
Orchestration sans code via Open WebUI v0.9.0 (Automations RRULE / Task Management / Calendar) ; trois niveaux d’abstraction (produit OWUI vs LangGraph vs CrewAI) ; migration async 0.8→0.9 ; skeleton API OpenAI-compatible avec graceful skip (OWUI_API_KEY) |
60 min |
| 20 | 20_OWUI_Native_API.ipynb |
Compagnon du 19 : introspection de la vraie surface API native OWUI v0.9.6 (routes REST auth-free : santé/version/config ; couche authentifiée Bearer) via urllib standard ; graceful skip honnête si OWUI_API_KEY absente (Stop & Repair, pas de sortie fabriquée) |
60 min |
Figures clés de l’arc test-time scaling. Trois sorties matplotlib des notebooks 16 et 17 matérialisent les compromis quantifiés par Snell 2024 — le cœur pédagogique du Tier 5.
pass@k : la frontière s’ouvre avec le budget. L’estimateur pass@k mesure le taux de succès quand on autorise k échantillons indépendants. Snell 2024 montre que cette frontière dépend fortement de la difficulté : les problèmes faciles saturent presque immédiatement, tandis que les difficiles continuent de monter avec k — d’où l’intérêt d’investir le compute là où le single-shot échoue.
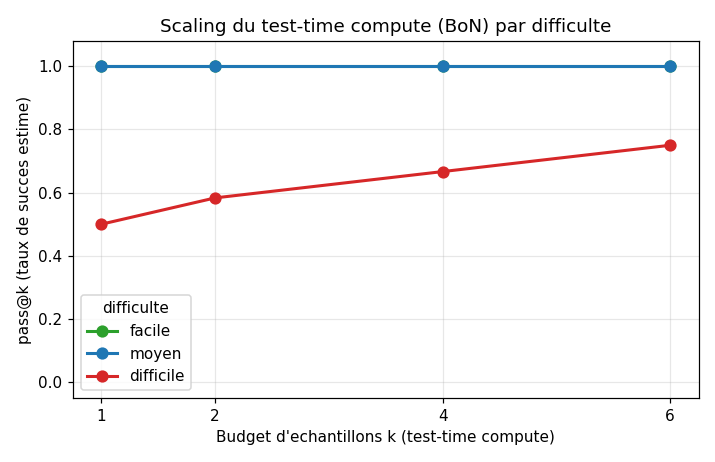
pass@k vs budget k (16) — 3 courbes (taux de succès Y, budget d’échantillons k X), une par bucket de difficulté : le facile sature dès k=1, le difficile monte de 0.50 à 0.75 de k=1 à k=6 sans plafonner dans la plage observée (résultat central de Snell).
BoN vs Réflexion : sur ce run, la frontière apparaît sur « difficile ». Comparer Best-of-N parallèle (plusieurs essais indépendants) à la Réflexion séquentielle (un essai qui se corrige) est la comparaison compute-optimale de Snell. Sur le run committé, facile et moyen rendent 1.00/1.00 — plafond commun, ces régimes saturés ne pouvaient pas départager les stratégies — et sur difficile le séquentiel gagne : BoN 0.67 contre Réflexion 0.75 (annotation committée <- Reflexion). La frontière de Snell apparaît exactement là où elle est prédite : le séquentiel (affiner par le retour du vérificateur) paie sur le bucket difficile, le parallèle suffit là où le modèle est déjà fiable.
Ce verdict décrit une réalisation, pas une loi : la Réflexion résout ici 3 énoncés sur 4 au bucket décisif, l’écart avec BoN tient dans la marge d’un seul énoncé, et le décodage est échantillonné (temperature=0.7) sans graine — un seul échantillon qui bascule renverse le verdict (le notebook le pose en règle en section 4, limites honnêtes G.2). Six appels vides côté Réflexion sont de surcroît comptés comme des échecs : le 0.75 est une borne inférieure. Ce run est conforme à la prédiction de Snell ; il ne l’établit pas statistiquement — la figure documente le run committé, elle ne tranche pas la frontière compute-optimale, ce qui demande des n plus grands et des problèmes plus discriminants.
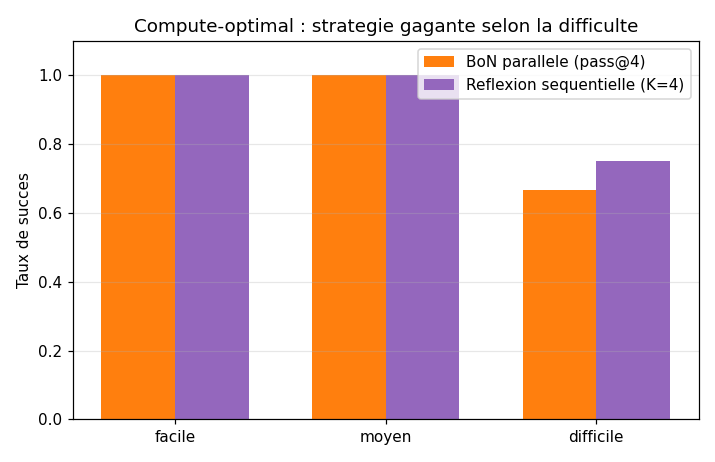
BoN vs Réflexion par difficulté (16) — diagramme en barres groupées (taux de succès Y) : plafond commun 1.00 sur facile/moyen, et sur difficile BoN 0.67 contre Réflexion 0.75 pour ce run committé. L’écart tient dans un seul énoncé et le décodage est échantillonné — la figure documente une réalisation, elle ne tranche pas (cf. texte).
Raisonnement natif vs scaling hand-rolled. La comparaison cost-normalisée — en tokens dépensés plutôt qu’en échantillons — oppose le BoN « fait maison » (courbes) au raisonnement natif de deepseek-r1 (croix) : à coût token égal, la croix r1 se place au-dessus de la courbe BoN, le raisonnement natif exploite donc mieux chaque token que le simple parallélisme.
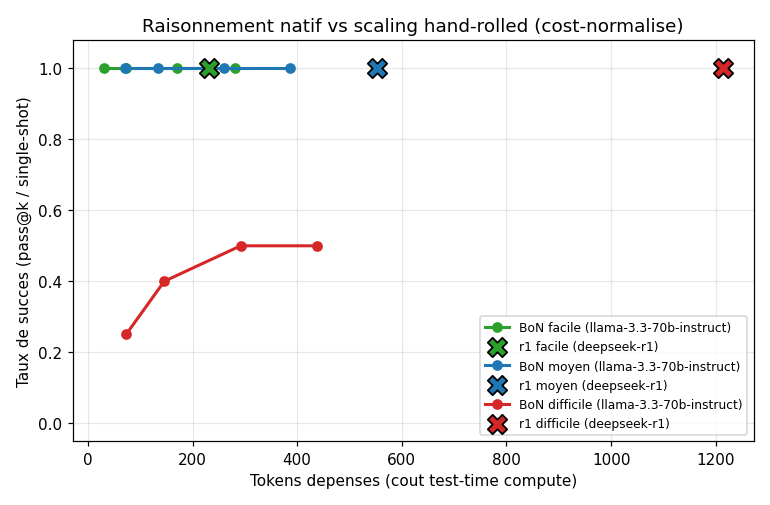
Raisonnement natif vs scaling hand-rolled (17) — courbes (BoN) et croix (r1) du taux de succès vs tokens dépensés (comparaison cost-normalisée) : la croix au-dessus de la courbe au même coût = le raisonnement natif gagne.
Provenance et poids de chaque figure : assets/readme/MANIFEST.md.
Tier 6 : Fine-tuning (Avancé)
Les tiers 1 à 5 exploitent un LLM tel quel (prompting, structuration, augmentation, scaling au moment du test). Le notebook 21 franchit le pas suivant : adapter le modèle lui-même à une tâche précise sans tout réentraîner. La technique est LoRA / QLoRA (Low-Rank Adaptation) : on gèle les poids du modèle de base et on n’entraîne que de petits adaptateurs de bas rang — quelques millions de paramètres au lieu de quelques milliards — ce qui tient dans 8 Go de VRAM et évite l’oubli catastrophistique des connaissances pré-entraînées.
Le fil rouge est volontairement discriminant : enseigner au modèle un format balisé arbitraire ([T]Terme[/T][D]Définition[/D][E]Exemple[/E]) que le modèle de base ne produit jamais spontanément. On observe d’abord l’échec du base (prose avec deux-points, balises ignorées), puis on quantifie en 4-bit (NF4 + double quantification, calcul en bf16 via BitsAndBytesConfig), on greffe les adaptateurs LoRA avec peft, et on entraîne avec trl sur un petit jeu d’exemples bien formatés. Le vrai outil SOTA est branché bout en bout (peft, bitsandbytes, trl, datasets, transformers) — aucun substitut. Ce notebook fait pont avec la série PostTraining et l’EPIC #10247 (fine-tuning/training). GPU CUDA requis (environnement coursia-ml-training).
| # | Notebook | Description | Durée |
|---|---|---|---|
| 21 | 21_LoRA_FineTuning.ipynb |
QLoRA (NF4 4-bit + double quant, bf16) sur Qwen2.5-0.5B-Instruct : fil rouge = format balisé [T]/[D]/[E] que le base échoue à produire ; adaptateurs LoRA via peft + bitsandbytes + trl + datasets, GPU CUDA requis (pont PostTraining / #10247) |
75 min |
| 22 | 22_Evaluating_Generated_Text.ipynb |
Évaluation des sorties générées : BLEU (précision n-gram avec clipping) et ROUGE (rappel) construits à la main et mesurés — deux métriques lexicales aveugles au sens — puis juge LLM avec protocole anti-biais (paire évaluée dans les deux ordres à T=0, ne tranche que si les deux passes coïncident), 3 exercices C.1 | — |
| 22b | 22b_Profil_Cognitif_CHC.ipynb |
Approfondit le 22 : on évalue le générateur plutôt que sa sortie. Profil cognitif CHC (Hendrycks et al., 2025) mesuré par une mini-batterie à correction mécanique sur 8 domaines (mémoire de travail générée, stockage long terme, hallucinations, fluence, vitesse…) sur 4 modèles réels (Qwen3.5-0.8B local + 3 API), avec IC bootstrap ; profil « jagged » vs score agrégé ; contortions de capacité mesurées (carnet de mémoire réinjecté, RAG) ; types d’IA stratégiques et cube A×G×I du Singapore Consensus 2026, 3 exercices C.1 | — |
Tier 7 : Analyse linguistique (TAL)
Les notebooks TAL classiques (23–26 : pipeline spaCy, n-grammes, CRF, PCFG/CYK) ont migré vers leur série dédiée : MyIA.AI.Notebooks/NLP/ (EPIC #16271). Cette série-ci reste centrée sur l’ingénierie des LLM — prompts, RAG, fine-tuning, scaling — et renvoie à la série NLP pour la tradition symbolique/probabiliste du traitement des langues.
Prérequis
Configuration API
- Copier
.env.examplevers.env - Ajouter votre clé API OpenAI :
OPENAI_API_KEY=sk-...
Pour les notebooks locaux (10, 10b et 11)
- Docker avec support GPU pour servir le modèle réel avec vLLM
- Ollama ou vLLM installé pour les notebooks de déploiement
- PyTorch CPU suffit pour la partie from scratch de
10b; un endpoint vLLM authentifié est requis pour ses mesures TTFT/ITL
Harnais de mesure LLamaSharp (10e, tools/llamasharp-bakeoff/)
Le binaire Test.exe que le notebook 10e_LLamaSharp_DotNet_BakeOff.ipynb mesure en processus externe est compilé depuis la source versionnée dans tools/llamasharp-bakeoff/ (test.csproj + Program.cs, LLamaSharp 0.27.0, self-contained .NET 8 + backend CUDA 12). Reproduction sur une machine propre :
- Modèle — télécharger
Qwen3-4B-Q4_K_M.gguf(2,4 Go) depuisQwen/Qwen3-4B-GGUFverstools/llamasharp-bakeoff/models/(gitignoré). sha256 de la lignée officielle :7485fe6f11af29433bc51cab58009521…. - Compiler —
dotnet publish -c Release -r win-x64 --self-contained true -o publishdepuistools/llamasharp-bakeoff/(le RID est obligatoire, cf §4 du notebook). - Runtime CUDA — le paquet
LLamaSharp.Backend.Cuda12.Windowsne livre pascudart64_12/cublas64_12/cublasLt64_12; les wheelsnvidia-cuda-runtime-cu12==12.4.127etnvidia-cublas-cu12==12.4.5.8(canal officiel, sans CUDA Toolkit ni UAC) les fournissent, à colocaliser auprès deggml-cuda.dll(publish/runtimes/win-x64/native/cuda12/). - Sonde de détection — sans CUDA Toolkit, LLamaSharp n’énumère jamais le candidat CUDA : poser
%CUDA_PATH%pointant vers unversion.jsonportant la clélibcublas(le notebook, cellule 4bis, fait les étapes 3-4 automatiquement).
Le notebook exécute ces étapes lui-même (cellules 3, 4bis, 4ter) : exécuté depuis ce dossier de série, il recompile, répare et mesure sans dépendre d’aucun artefact hors dépôt.
Parcours suggéré
┌─────────────────────────────────────────────────────────────────┐
│                                                                 │
│  1_OpenAI_Intro ─────► 2_PromptEngineering                     │
│        │                      │                                 │
│        │                      └──────► 8_Reasoning_Models       │
│        │                                                        │
│        └──────► 3_Structured_Outputs                           │
│                       │                                         │
│                       └──────► 4_Function_Calling              │
│                                      │                          │
│                    ┌─────────────────┼─────────────────┐       │
│                    │                 │                 │       │
│                    ▼                 ▼                 ▼       │
│           5_RAG_Modern      7_Code_Interpreter  9_Production   │
│                 │                                    │          │
│                 └──────► 6_PDF_Web_Search     9b_RedTeam       │
│                                                       │         │
│                                                       └─attack/defend stack self-hosted
│                                                                 │
│  10_LocalLlama (indépendant, prérequis: 1)                     │
│        └──────► 10b_Inference_Mechanics                        │
│                         └──────► 11_Quantization               │
│                                                                 │
└─────────────────────────────────────────────────────────────────┘
APIs couvertes
| API | Notebooks | Description |
|---|---|---|
| Chat Completions | 1-4, 8 | API classique, toujours supportée |
| Responses API | 1, 5, 9 | Nouvelle API avec persistance |
| Embeddings | 5 | text-embedding-3-large |
| Tools/Functions | 4, 6, 7 | Function calling moderne |
| File Upload | 6, 7 | Support PDF et fichiers |
| Reasoning | 2, 8 | Modèles o4-mini, gpt-5-thinking |
Technologies et écosystème
- OpenAI API : GPT-5, GPT-5-mini, o4-mini, gpt-5-thinking
- Python : openai, pydantic, tiktoken, semantic-kernel
- Local : vLLM, KV-cache et PagedAttention, métriques TTFT/ITL, Qwen3.5-35B-A3B, ZwZ-8B, llmcompressor, AWQ/GPTQ
- Bases vectorielles : scikit-learn (demo), Pinecone, Qdrant, Chroma
Mode batch
Tous les notebooks supportent un mode batch pour les tests automatisés :
# Dans .env
BATCH_MODE=true
Ce mode désactive les interactions utilisateur et utilise des exemples prédéfinis.
Validation
# Valider la structure
python scripts/notebook_tools/notebook_tools.py validate GenAI/Texte --quick

# Exécuter tous les notebooks
python scripts/notebook_tools/notebook_tools.py execute GenAI/Texte --timeout 300
Recette : maîtriser les LLMs pour piloter tout le génératif
Le fil rouge de cette série est la progression de l’interaction basique avec un LLM vers la maîtrise complète en production. Voici comment les tiers s’articulent :
Tier 1 (fondations) : 1_OpenAI_Intro couvre l’API OpenAI et les tokens. 2_PromptEngineering explore les techniques de prompting (zero-shot, few-shot, chain-of-thought). À la fin, vous savez interagir efficacement avec un LLM.
Tier 2 (sorties structurées) : 3_Structured_Outputs maîtrise les formats JSON et Pydantic. 4_Function_Calling connecte le LLM à des outils externes. Ces deux notebooks sont essentiels pour tout système qui pilote d’autres modèles génératifs (image, audio, video).
Tier 3 (augmentation) : 5_RAG_Modern et 6_PDF_Web_Search enrichissent le LLM avec des sources externes. 7_Code_Interpreter lui donne la capacité d’exécuter du code.
Tier 4 (production et local) : 8_Reasoning_Models exploite les modèles raisonnants. 9_Production_Patterns couvre les patterns enterprise, complété par son versant adversarial 9b_Prompt_Security_RedTeam qui attaque puis défend la stack self-hosted (injection directe/indirecte RAG, jailbreak, exfiltration). 10_LocalLlama déploie le service (3 étages honnêtement nommés : local chez l’étudiant, auto-hébergé du cours, repli distant OpenRouter), 10b_Inference_Mechanics construit le KV-cache puis relie son coût aux TTFT/ITL réels, et 11_Quantization réduit l’empreinte des poids servis par vLLM.
Tier 5 (test-time scaling approfondi) : partant de 12_Test_Time_Scaling (les quatre moteurs en Python pur), l’arc NB-13..18 décompose chaque facette de l’inférence au moment du test — orchestration agentique via function calling (13), mémoire persistante par similarité (14), mémoire paginée d’agent (14b : fenêtre glissante, résumé progressif, éviction, mémoire vectorielle paginée, mémoire multi-domaine), Tree-of-Thoughts sur des problèmes de recherche (15), courbes de scaling de Snell (16), raisonnement natif vs scaling hand-rolled (17), puis intégration Semantic Kernel (18).
Le schéma ci-dessous résume comment les cinq tiers s’enchaînent pour maîtriser les LLMs : du prompt one-shot (tier 1) aux patterns de production puis à l’arc test-time scaling approfondi (tiers 4-5), en passant par les sorties structurées (tier 2) et l’augmentation RAG/code interpreter (tier 3).
flowchart TD
    subgraph T1["Tier 1 · Fondations"]
        A1["1 : API OpenAI & tokens"]
        A2["2 : Prompt engineering"]
    end
    subgraph T2["Tier 2 · Sorties structurées"]
        B1["3 : Structured Outputs"]
        B2["4 : Function Calling"]
    end
    subgraph T3["Tier 3 · Augmentation"]
        C1["5-6 : RAG & PDF/Web"]
        C2["7 : Code Interpreter"]
    end
    subgraph T4["Tier 4 · Avancé & production"]
        D1["8-9 : Reasoning & Production"]
        D1b["9b : Red-team sécurité LLM (sibling adversarial de 9)"]
        D2["10-11 : Local, KV-cache & Quantization"]
        D3["12 : Test-Time Scaling"]
    end
    subgraph T5["Tier 5 · Test-time scaling approfondi (ICR)"]
        E1["13-14 : Agentic & Mémoire"]
        E2["15-17 : ToT, Scaling, Native"]
        E3["18 : Plugins Semantic Kernel"]
    end
    T1 --> T2 --> T3 --> T4 --> T5
FAQ
Chat Completions vs Responses API — laquelle utiliser ?
Les notebooks couvrent les deux APIs OpenAI :
- Chat Completions (notebooks 1-4, 8) : l’API classique
client.chat.completions.create(). Toujours supportée, simple d’usage, stateless. Idéale pour les requêtes unitaires et les prototypes. - Responses API (notebooks 1, 5, 9) : la nouvelle API
client.responses.create(). Ajoute la persistance automatique des conversations, le support natif du RAG multi-turn, et les citations. Recommandée pour les workflows multi-étapes.
En pratique, commencez avec Chat Completions (notebook 1), puis migrez vers Responses API quand vous avez besoin de persistance ou de RAG (notebook 5).
Structured Outputs échoue en mode strict
Le mode strict (strict=True) impose des contraintes sur les schémas JSON :
- Tous les champs doivent être
required(pas de champ optionnelOptional). - Pas de types union complexes (
str | int | None). - Pas de profondeur excessive (> 5 niveaux d’imbrication).
- Le schéma doit être déterministe : chaque champ a exactement un type possible.
Si le mode strict échoue, retirer strict=True et utiliser le mode par défaut (moins strict, mais le schéma est quand même respecté dans ~95% des cas). Le notebook 3_Structured_Outputs montre les deux approches.
Function calling : le modèle appelle un outil inexistant
Ce phénomène (hallucination d’outils) arrive quand :
- La description de l’outil est ambiguë ou incomplète.
- Le prompt utilisateur est vague et le modèle “invente” un outil pour répondre.
- Trop d’outils sont déclarés simultanément (> 10).
Mitigation : fournir des descriptions précises pour chaque outil, valider les arguments côté client avant exécution, et limiter le nombre d’outils actifs. Le notebook 4_Function_Calling montre le pattern de validation.
RAG : les réponses sont hors-sujet ou inventées
Les causes les plus fréquentes :
- Chunking trop grand : les segments dépassent 512 tokens, diluant le contenu pertinent. Utiliser des chunks de 200-400 tokens avec chevauchement de 50 tokens.
- Embedding inadapté :
text-embedding-3-smallest plus rapide mais moins précis quetext-embedding-3-largepour le RAG technique. - Pas de citation : sans vérification, le modèle peut halluciner des sources. La Responses API (notebook 5) génère automatiquement des citations.
- Top-k trop élevé : injecter trop de contexte noie le signal. Commencer avec
top_k=3et ajuster.
Modèles raisonnants (o4-mini, gpt-5-thinking) : tokens et coût
Les modèles raisonnants consomment des reasoning tokens (non visibles) en plus des tokens d’entrée/sortie. Implications :
- Coût : le coût réel peut être 3-10x supérieur à un modèle non-raisonnant pour le même prompt. Utiliser
reasoning_effort="low"pour les tâches simples. - Latence : les modèles raisonnants prennent plus de temps (10-60s vs 2-5s). Pas adaptés au temps réel.
- Usage : excellents pour les tâches de planification, l’analyse multi-étapes, et la décomposition de problèmes complexes. Inutiles pour le simple formatage ou l’extraction.
Le notebook 8_Reasoning_Models compare les coûts et la qualité entre modèles raisonnants et classiques.
LLM local (vLLM) : erreur CUDA ou OOM
Les notebooks 10, 10b et 11 utilisent vLLM : le 10 déploie et compare les endpoints, le 10b mesure TTFT/ITL et le 11 sert des modèles quantifiés. Problèmes courants :
- VRAM insuffisante : Qwen3.5-35B-A3B en FP16 nécessite ~70 GB. Utiliser la quantification AWQ (notebook 11) pour réduire à ~12 GB.
- Version CUDA : vLLM requiert CUDA 12.1+. Vérifier avec
nvidia-smietnvcc --version. - Port déjà occupé : vLLM utilise le port 8000 par défaut. Utiliser
--port 8001si besoin. - Timeout au premier appel : le chargement du modèle prend 30-120s au démarrage. Les appels suivants sont instantanés.