16. Scaling du test-time compute (Snell 2024)

Navigation : Index | << Précédent | Suivant >>

Phase 4 de l’epic #2926 — suite de NB-12 (moteurs), NB-13 (routeur), NB-14 (memoire), NB-15 (ToT sur CSP).

L’idee de Snell et al. 2024

“Scaling LLM Test-Time Compute Optimally can be more effective than scaling model parameters.” — Snell, Lee, Xu, Kumar (DeepMind, 2024).

Le test-time compute (combien de calcul on depense a l’inference : plus d’echantillons, plus de recherche, plus de tours de Reflexion) se met a l’echelle comme le compute d’entrainement. Mais la stratégie optimale depend du regime :

  • Sur des problemes faciles (pour le modèle) : echantillonner large en parallele (Best-of-N) est le plus efficace — un seul essai rate rarement.
  • Sur des problemes difficiles : la recherche séquentielle (affiner via le retour d’un verificateur, facon Reflexion) est plus compute-efficace qu’echantillonner a l’aveugle.

Il existe donc une frontiere compute-optimale : pour un budget donne, quelle stratégie maximise le taux de succes depend de la difficulte.

Plan (ce notebook mesure tout sur de vraies données)

  1. Suite graduee de problemes a reponse entiere verifiable (facile / moyen / difficile).
  2. Scaling BoN : pass@k (estimateur non-biasé HumanEval) pour k = 1, 2, 4, 6, par bucket.
  3. Compute-optimal : a budget egal, BoN (parallele) vs Reflexion (séquentiel).
  4. Limites honnetes (G.2) : petit N, petit modèle, bruit — les lois de Snell sont asymptotiques ; ce notebook est illustratif, pas une replication a l’echelle.

Pont Phase 5 : comparer a un modèle a raisonnement natif (le raisonnement est alors “interne” au modèle, compute decale dans les tokens de pensée).

0. Setup — même infrastructure que NB-12 a NB-15

%pip install -q openai python-dotenv matplotlib numpy

import os, re, math, time
from pathlib import Path
from openai import OpenAI
from dotenv import load_dotenv

# Cherche un .env plausible : cwd, racine GenAI, parent, master.env
_candidates = [Path.cwd() / '.env',
               Path.cwd() / 'MyIA.AI.Notebooks' / '.env',
               Path.cwd().parent / '.env',
               Path.home() / '.secrets' / 'master.env']
_env_path = next((p for p in _candidates if p.exists()), None)
if _env_path:
    load_dotenv(_env_path)
    print(f'.env charge depuis : {_env_path.name}')
else:
    print('Pas de .env trouve — fallback sur variables d environnement OS')

# Modele : Qwen3.6-35B-A3B servi par notre infrastructure (facade claudish,
# API OpenAI-compatible) -- plus aucun modele 2024 du type gpt-4o-mini.
# Aucune superiorite n'est revendiquee ici : mesure du 2026-09-15, ce modele
# resout toute la mathematique verifiable courte qu'on lui a presentee
# (25+ candidats, N=6). C'est pourquoi le bucket `difficile` du banc a ete
# recalibre PAR LA MESURE, et pourquoi la section 6 enonce le resultat tel
# qu'il sort de l'execution, y compris s'il est negatif.
# NB : ce deploiement emet ~250-1300 tokens de raisonnement AVANT la
# reponse finale (mesure 2026-09-14). chat() garde donc un budget
# genereux : un budget court rend content VIDE (finish_reason=stop),
# ce qui se confondrait avec un echec de raisonnement.
FAST_MODEL = os.getenv('TTC_MODEL', 'qwen3.6-35b-a3b')
BIG_MODEL = os.getenv('TTC_MODEL_BIG', 'qwen3.6-35b-a3b')
N_ECH = int(os.getenv('TTC_N_ECH', '8'))
BATCH_MODE = os.getenv('BATCH_MODE', 'true').lower() in ('1', 'true', 'yes')
if BATCH_MODE:
    N_ECH = max(4, min(N_ECH, 6))
# Facade claudish : cle DEDIEE (CLAUDISH_PROXY_KEY), distincte de
# VLLM_API_KEY (qui authentifie le sidecar vLLM) et d'OPENAI_API_KEY.
# Aucun repli cross-provider : le secret d'un fournisseur ne part jamais
# vers l'hote d'un autre (secrets-hygiene).
CLAUDISH_BASE_URL = os.getenv('CLAUDISH_BASE_URL', 'https://models.myia.io/v1')
if not os.getenv('CLAUDISH_PROXY_KEY'):
    raise RuntimeError(
        'CLAUDISH_PROXY_KEY absente de l environnement : la facade claudish '
        'exige sa cle dediee (regle F : reparer l env, jamais contourner). '
        'Aucun repli sur OPENAI_API_KEY n est prevu.')
client = OpenAI(base_url=CLAUDISH_BASE_URL, api_key=os.environ['CLAUDISH_PROXY_KEY'])
print(f'Modele={FAST_MODEL} | base_url={CLAUDISH_BASE_URL} | N_ECH={N_ECH}')
Note: you may need to restart the kernel to use updated packages.
.env charge depuis : .env
Modele=qwen3.6-35b-a3b | base_url=https://models.myia.io/v1 | N_ECH=6
def chat(prompt, system=None, model=FAST_MODEL, temperature=0.7, max_tokens=4096, retries=3):
    """Chat avec retry leger sur 429/5xx transient. Renvoie '' si echec total,
    ou si le modele epuise son budget de raisonnement sans emettre de contenu :
    cette reponse vide est TERMINALE, pas transitoire (mesure 2026-09-15 : un
    enonce vide a 4096 tokens l'est aussi a 8192, et la facade repond 5xx sur
    les budgets plus larges). Doubler le budget a chaque essai coutait plusieurs
    minutes par echantillon pour retrouver la meme vide ; la vide est la donnee,
    les cellules de collecte la comptent a part."""
    msgs = ([{'role':'system','content':system}] if system else []) + \
           [{'role':'user','content':prompt}]
    for essai in range(retries + 1):
        try:
            resp = client.chat.completions.create(model=model, messages=msgs,
                                                  temperature=temperature,
                                                  max_tokens=max_tokens)
            return resp.choices[0].message.content or ''
        except Exception as exc:
            if essai == retries:
                print(f'  [chat] echec apres {retries+1} essais : {exc}')
            else:
                time.sleep(2.0 * (essai + 1))
    return ''

_ping = chat('Reponds uniquement par OK', max_tokens=1024, temperature=0.0)
print('Ping :', repr(_ping[:40]) if _ping else 'ECHEC')
Ping : '\n\nOK'

Lecture : le wrapper chat() — connectivité prouvée, échec toléré

Le Ping : '\n\nOK' établit la seule chose qu’on doit savoir avant toute expérience : la route vers le modèle servi (qwen3.6-35b-a3b derrière la façade maison, conformément à la migration #14755 — aucun modèle d’API externe n’est appelé) répond. Le wrapper mérite une lecture attentive car TOUT le notebook repose sur lui : retries=3 avec repli silencieux — une requête transitoire ne tue pas une collecte d’échantillons — et la fonction renvoie '' en cas d’échec total plutôt que de lever. Ce choix de robustesse a une contrepartie méthodologique : un échec persistant se traduit par une réponse VIDE, qui échoue la vérification et est donc comptée comme incorrecte dans les estimateurs qui suivent — les taux mesurés sont ainsi des bornes inférieures en présence d’erreurs réseau ou de budget de raisonnement épuisé, et chaque collecte rapporte son compte de réponses vides pour que l’artefact ne se lise pas comme un échec de raisonnement (la section 4 y revient). Noter aussi le temperature=0.7 par défaut : c’est lui qui fournit la diversité d’échantillonnage dont Best-of-N a besoin — à température 0, six échantillons d’un même prompt seraient six clones et le pass@k n’aurait plus de sens.

1. Suite graduee + verificateur + estimateur pass@k

On travaille sur des problemes a reponse entiere verifiable (pas de juge LLM : le verificateur est exact, ce qui rend pass@k objectif). Trois buckets de difficulte.

Estimateur pass@k non-biasé (HumanEval / Snell) : a partir de n echantillons dont c sont corrects, pass@k = 1 - C(n-c, k) / C(n, k). C’est l’estimateur standard (Chen et al. 2021).

# Suite graduee : (enonce, reponse_entiere_attendue).
# NIVEAU FACILE    : arithmetique 1 etape (GSM8K niveau CP).
# NIVEAU MOYEN     : GSM8K standard, 2-3 etapes.
# NIVEAU DIFFICILE : comptage / enumeration exacte. Ce bucket est calibre PAR
# LA MESURE, pas par l'intuition : un pilote de discrimination a evalue 25+
# candidats sur le modele servi (N=6, temp 0.7). Profil mesure du modele : il
# repond JUSTE ou ne repond pas (25/25 reponses justes, 0 fausses ; les
# non-reponses sont des contenus vides, budget de raisonnement epuise). Le
# bucket garde donc UN probleme d'echec structurel (triplets somme 20 : vide a
# tous les budgets testes, 4096 comme 8192) et UN probleme a succes PARTIEL
# (deux fois le chiffre 7 : repondu juste 1 fois sur 6 au pilote) -- seul
# regime ou BoN ait quelque chose a corriger. Les MATH-lite du premier jet
# (equation lineaire, regles d'exposants, aire 3-4-5) etaient resolus a tous
# les coups.
PROBLEMES = {
    'facile': [
        ("J'ai 7 billes. On m'en donne 5 de plus. Combien ai-je ? Reponds par le nombre seul.", 12),
        ("Combien font 15 + 28 ? Reponds par le nombre seul.", 43),
        ("Un paquet de 6 bonbons. J'achete 4 paquets. Combien de bonbons ? Reponds par le nombre seul.", 24),
    ],
    'moyen': [
        ("Marie a 3 fois l'age de Luc. Dans 5 ans, Marie aura 32 ans. Quel est l'age actuel de Luc ? Reponds par le nombre seul.", 9),
        ("Une voiture parcourt 60 km en 1h, puis 30 km en 30 min. Quelle distance totale en km ? Reponds par le nombre seul.", 90),
        ("Un jardinier a 48 fleurs. Il en plante 1/3 dans le jardin A, et la moitie du reste dans le jardin B. Combien reste-t-il de fleurs non plantees ? Reponds par le nombre seul.", 16),
    ],
    'difficile': [
        ("Un comite de 3 personnes est choisi parmi 8, dont un trio inseparable (si l'un est choisi, les deux autres doivent l'etre aussi). Combien de comites VALIDES differents ? Reponds par le nombre seul.", 11),
        ("Combien de triplets (x, y, z) d'entiers avec 0 <= x < y < z <= 12 et x + y + z = 20 ? Reponds par le nombre seul.", 17),
        ("Combien d'entiers entre 1 et 1000 contiennent exactement deux fois le chiffre 7 ? Reponds par le nombre seul.", 27),
        ("Combien de mots de 5 lettres distinctes prises parmi A, B, C, D, E (dans n'importe quel ordre) ne contiennent pas A et E adjacents ? Reponds par le nombre seul.", 72),
    ],
}

# ---------------------------------------------------------------------------
# Verite terrain du banc -- recalcul EXACT a chaque execution.
#
# Lecon fondatrice (mesure 2026-09-15). Un attendu brute-force ne vaut QUE si
# l'enumeration calcule la quantite que la QUESTION demande. Le premier jet du
# bucket `difficile` annotait 40 le probleme du trio inseparable, en comptant
# « les comites avec AU PLUS 1 membre du trio » -- alors que l'enonce dit
# « si l'un est choisi, les deux autres doivent l'etre aussi », donc valides =
# « aucun membre du trio, ou les trois » = C(5,3) + 1 = 11. Le modele repondait
# 11 six fois sur six : il avait raison, la verite terrain avait tort.
#
# Ce que ce bloc garantit : chaque attendu declare est recalcule, et une
# divergence leve une AssertionError. Ce qu'il ne garantit PAS : que la
# quantite recalculee soit celle de l'enonce -- la force brute attrape une
# erreur d'arithmetique, jamais une erreur de specification. D'ou les deux
# disciplines ci-dessous, qui se lisent a l'oeil :
#   1. la docstring de chaque controle enonce la quantite EN TOUTES LETTRES ;
#   2. tout comptage non trivial est croise par son complementaire
#      (valides + invalides = total), ce qui attrape un terme oublie.
# ---------------------------------------------------------------------------
from itertools import combinations, permutations


def _c_billes():
    """7 billes plus 5 billes."""
    return 7 + 5


def _c_somme():
    """Somme de 15 et 28."""
    return 15 + 28


def _c_bonbons():
    """4 paquets de 6 bonbons."""
    return 4 * 6


def _c_age_luc():
    """Age actuel de Luc : Marie = 3 x Luc, et Marie + 5 = 32."""
    marie = 32 - 5
    assert marie % 3 == 0
    return marie // 3


def _c_distance():
    """Distance totale : 60 km puis 30 km."""
    return 60 + 30


def _c_fleurs():
    """Fleurs non plantees : 48, moins 1/3 dans A, moins la moitie du reste dans B."""
    reste_apres_a = 48 - 48 // 3
    return reste_apres_a - reste_apres_a // 2


def _c_comites_trio():
    """Comites de 3 parmi 8 ou le trio {0, 1, 2} est INSECABLE : un comite est
    valide s'il ne contient AUCUN membre du trio, ou s'il contient LES TROIS
    (un comite a 3 sieges : « contient les trois » <=> c'est le trio lui-meme)."""
    tous = list(combinations(range(8), 3))
    valides = [c for c in tous if len({0, 1, 2} & set(c)) in (0, 3)]
    invalides = [c for c in tous if len({0, 1, 2} & set(c)) in (1, 2)]
    assert len(valides) + len(invalides) == len(tous), 'complementaire incoherent'
    return len(valides)


def _c_triplets_somme_20():
    """Triplets d'entiers 0 <= x < y < z <= 12 dont la somme vaut exactement 20."""
    return sum(1 for x in range(13) for y in range(x + 1, 13)
               for z in range(y + 1, 13) if x + y + z == 20)


def _c_deux_sept():
    """Entiers de 1 a 1000 dont l'ecriture decimale contient EXACTEMENT deux
    fois le chiffre 7 (77 compte ; 777 contient trois 7, il ne compte pas)."""
    valides = [n for n in range(1, 1001) if str(n).count('7') == 2]
    invalides = [n for n in range(1, 1001) if str(n).count('7') != 2]
    assert len(valides) + len(invalides) == 1000, 'complementaire incoherent'
    return len(valides)


def _c_permutations_sans_adjacence():
    """Permutations de A, B, C, D, E ou A et E ne sont jamais adjacents."""
    toutes = list(permutations('ABCDE'))
    sans = [p for p in toutes
            if not any({p[i], p[i + 1]} == {'A', 'E'} for i in range(4))]
    assert len(sans) <= len(toutes)
    return len(sans)


_controles = {
    "J'ai 7 billes. On m'en donne 5 de plus. Combien ai-je ? Reponds par le nombre seul.": _c_billes,
    "Combien font 15 + 28 ? Reponds par le nombre seul.": _c_somme,
    "Un paquet de 6 bonbons. J'achete 4 paquets. Combien de bonbons ? Reponds par le nombre seul.": _c_bonbons,
    "Marie a 3 fois l'age de Luc. Dans 5 ans, Marie aura 32 ans. Quel est l'age actuel de Luc ? Reponds par le nombre seul.": _c_age_luc,
    "Une voiture parcourt 60 km en 1h, puis 30 km en 30 min. Quelle distance totale en km ? Reponds par le nombre seul.": _c_distance,
    "Un jardinier a 48 fleurs. Il en plante 1/3 dans le jardin A, et la moitie du reste dans le jardin B. Combien reste-t-il de fleurs non plantees ? Reponds par le nombre seul.": _c_fleurs,
    "Un comite de 3 personnes est choisi parmi 8, dont un trio inseparable (si l'un est choisi, les deux autres doivent l'etre aussi). Combien de comites VALIDES differents ? Reponds par le nombre seul.": _c_comites_trio,
    "Combien de triplets (x, y, z) d'entiers avec 0 <= x < y < z <= 12 et x + y + z = 20 ? Reponds par le nombre seul.": _c_triplets_somme_20,
    "Combien d'entiers entre 1 et 1000 contiennent exactement deux fois le chiffre 7 ? Reponds par le nombre seul.": _c_deux_sept,
    "Combien de mots de 5 lettres distinctes prises parmi A, B, C, D, E (dans n'importe quel ordre) ne contiennent pas A et E adjacents ? Reponds par le nombre seul.": _c_permutations_sans_adjacence,
}

# Chaque enonce du banc porte exactement un controle, et l'attendu declare doit
# etre celui que le controle recalcule (appariement par enonce, pas par valeur :
# deux problemes peuvent partager un attendu).
_declares = {enonce: attendu for _, probs in PROBLEMES.items() for enonce, attendu in probs}
assert set(_declares) == set(_controles), (
    'banc et controles ne portent pas les memes enonces : '
    f'sans controle={sorted(set(_declares) - set(_controles))}, '
    f'orphelins={sorted(set(_controles) - set(_declares))}')
for _enonce, _fn in _controles.items():
    _recalc = _fn()
    assert _recalc == _declares[_enonce], (
        f'attendu declare {_declares[_enonce]} != recalcul {_recalc} '
        f'pour : {_enonce[:70]}...')
print(f'  verite terrain : {len(_controles)} enonces recalcules, tous concordants')


def extraire_nombre(texte):
    """Dernier entier du texte : le modele conclut par sa reponse.

    Prendre le PREMIER entier (premier jet) lisait un nombre du raisonnement et
    transformait une bonne reponse en echec des que le modele detaille son
    calcul -- un modele qui ecrit « ... 45 - 5 = 40 » avant de conclure etait
    note 45. Le prompt demande explicitement de repondre par le nombre seul, le
    dernier entier est donc la reponse.
    """
    m = re.findall(r'-?\d+', texte or '')
    return int(m[-1]) if m else None


def est_correct(reponse_attendue):
    def _verif(texte):
        n = extraire_nombre(texte)
        return n is not None and n == reponse_attendue
    return _verif


def pass_at_k(n, c, k):
    """Estimateur non-biaise pass@k (HumanEval / Snell 2024)."""
    if n - c < k:
        return 1.0
    return 1.0 - math.comb(n - c, k) / math.comb(n, k)


# Sanity check de l'estimateur
print('pass@k (n=8, c=5):', {k: round(pass_at_k(8, 5, k), 3) for k in (1, 2, 4, 6)})
print('Nb problemes par bucket :', {b: len(p) for b, p in PROBLEMES.items()})
  verite terrain : 10 enonces recalcules, tous concordants
pass@k (n=8, c=5): {1: 0.625, 2: 0.893, 4: 1.0, 6: 1.0}
Nb problemes par bucket : {'facile': 3, 'moyen': 3, 'difficile': 4}

Lecture : l’estimateur non-biaisé pass@k — la formule se vérifie sur la sortie

La sortie pass@k (n=8, c=5): {1: 0.625, 2: 0.893, 4: 1.0, 6: 1.0} se recompute à la main, et c’est l’occasion de comprendre CE que mesure l’estimateur. Sur n = 8 échantillons dont c = 5 corrects, pass@k est la probabilité qu’un sous-ensemble ALÉATOIRE de k réponses contienne au moins une correcte : pass@k = 1 - C(n-c, k) / C(n, k). Vérification sur les nombres affichés : pass@1 = 1 - C(3,1)/C(8,1) = 1 - 3/8 = 0,625 ; pass@2 = 1 - C(3,2)/C(8,2) = 1 - 3/28 = 0,893 ; pass@4 = 1 - C(3,4)/C(8,4) = 1 - 0 = 1,0 — choisir 4 réponses sur 8 quand 3 seulement sont fausses garantit une correcte. L’intérêt de la forme binomiale (Chen 2021, reprise par Snell 2024) : elle est NON-BIAISÉE sans exiger le partitionnement en k groupes disjoints, et chaque tirage de n échantillons alimente TOUS les k simultanément — exactement ce que la suite exploite pour tracer les courbes de scaling à coût constant. Détail qui distingue ce banc : la ligne du haut (verite terrain : 10 enonces recalcules, tous concordants) signifie que la vérité terrain est recalculée par énumération exacte à chaque exécution, jamais codée en dur — c’est elle qui rend la vérification objective.

2. Scaling BoN — pass@k par bucket

Pour chaque problème, on genere n echantillons independants (temperature > 0), on compte les corrects, puis on estime pass@k. On agregre par bucket (taux moyen). Petit n (BATCH_MODE) pour garder l’exécution rapide et dans le budget API.

K_LIST = [1, 2, 4, 6]

def echantillonner_bon(enonce, n, model=FAST_MODEL):
    """Genere n echantillons independants (temperature > 0)."""
    # Budget genereux : le modele raisonne avant de repondre (~250-1300
    # tokens). A 120 tokens le contenu revient VIDE, et le bucket entier
    # serait alors lu comme un echec de raisonnement (mesure 2026-09-14).
    return [chat(enonce, model=model, temperature=0.7, max_tokens=4096) for _ in range(n)]

resultats = {b: {k: [] for k in K_LIST} for b in PROBLEMES}
# Une reponse VIDE n'est pas une erreur de raisonnement : le modele peut
# epuiser tout son budget en raisonnement interne et rendre un contenu vide
# (finish_reason=stop, pas length). On les compte a part, sinon un
# artefact de budget se lit comme un echec du modele.
vides = 0
total_reps = N_ECH * sum(len(p) for p in PROBLEMES.values())
print(f'BoN : {N_ECH} echantillons / probleme, K={K_LIST} (modele={FAST_MODEL})')
t0 = time.time()
for bucket, probs in PROBLEMES.items():
    for enonce, attendu in probs:
        reps = echantillonner_bon(enonce, N_ECH)
        vides += sum(1 for r in reps if not (r or '').strip())
        verif = est_correct(attendu)
        corrects = sum(1 for r in reps if verif(r))
        for k in K_LIST:
            resultats[bucket][k].append(pass_at_k(N_ECH, corrects, k))
    print(f'  bucket {bucket:9s} : collecte OK')
print(f'  Reponses vides (budget de raisonnement epuise) : {vides}/{total_reps}')
print(f'  Duree : {time.time() - t0:.1f}s')

print('\n=== pass@k moyen par bucket (estimateur non-biaise) ===')
header = 'bucket      | ' + ' | '.join(f'pass@{k}' for k in K_LIST)
print(header); print('-' * len(header))
agg = {b: {k: (sum(v)/len(v) if v else 0.0) for k, v in d.items()} for b, d in resultats.items()}
for b in PROBLEMES:
    print(f'{b:11s} | ' + ' | '.join(f'  {agg[b][k]:.2f} ' for k in K_LIST))
BoN : 6 echantillons / probleme, K=[1, 2, 4, 6] (modele=qwen3.6-35b-a3b)
  bucket facile    : collecte OK
  bucket moyen     : collecte OK
  bucket difficile : collecte OK
  Reponses vides (budget de raisonnement epuise) : 12/60
  Duree : 738.7s

=== pass@k moyen par bucket (estimateur non-biaise) ===
bucket      | pass@1 | pass@2 | pass@4 | pass@6
-----------------------------------------------
facile      |   1.00  |   1.00  |   1.00  |   1.00 
moyen       |   1.00  |   1.00  |   1.00  |   1.00 
difficile   |   0.50  |   0.58  |   0.67  |   0.75 

Lecture : une seule ligne scale — le résultat central de Snell en un tableau

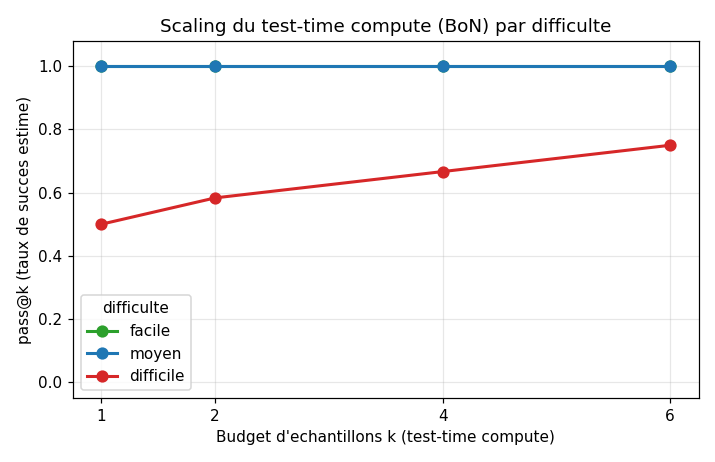
Le tableau condense l’expérience BoN (6 échantillons par problème, qwen3.6-35b-a3b) et sa lecture tient en une asymétrie : les buckets facile et moyen affichent 1,00 sur TOUTE la ligne — saturés dès pass@1, aucun k ne les améliore — tandis que difficile monte de 0,50 (k=1) à 0,75 (k=6), palier après palier (0,50 / 0,58 / 0,67 / 0,75). C’est LE résultat de Snell 2024 rendu visible : le bénéfice du test-time compute dépend du RÉGIME du problème. Sur un problème que le modèle résout déjà, dépenser plus d’échantillons est du gaspillage ; sur un problème à la frontière de sa capacité, quadrupler les tentatives (k=1 → 4) fait passer le taux de 0,50 à 0,67. Cette ligne qui scale n’est pas un hasard de composition : le bucket difficile (4 énoncés) a été retenu par un pilote de discrimination précisément pour ne pas saturer — sans lui, les trois lignes seraient plates et le tableau muet. Conséquence pratique directe : un budget d’inférence s’alloue par difficulté estimée, pas uniformément — c’est ce que la section 3 formalise en opposant parallèle (BoN) et séquentiel (Reflexion) à budget égal.

# Figure 1 : courbes de scaling pass@k par bucket (le coeur de Snell 2024).
import matplotlib
matplotlib.use("Agg")           # PDF-safe ; on affiche via display ci-dessous
import matplotlib.pyplot as plt
from IPython.display import display, Image
import io

fig, ax = plt.subplots(figsize=(6.5, 4.2))
couleurs = {"facile": "#2ca02c", "moyen": "#1f77b4", "difficile": "#d62728"}
for b in PROBLEMES:
    ys = [agg[b][k] for k in K_LIST]
    ax.plot(K_LIST, ys, "-o", label=b, color=couleurs[b], linewidth=2, markersize=7)
ax.set_xlabel("Budget d'echantillons k (test-time compute)")
ax.set_ylabel("pass@k (taux de succes estime)")
ax.set_title("Scaling du test-time compute (BoN) par difficulte")
ax.set_ylim(-0.05, 1.08); ax.set_xticks(K_LIST)
ax.grid(True, alpha=0.3); ax.legend(title="difficulte")
buf = io.BytesIO(); fig.tight_layout(); fig.savefig(buf, format="png", dpi=110); plt.close(fig)
buf.seek(0)
display(Image(data=buf.read()))
print("Figure 1 : pass@k vs k. Si facile sature vite et difficile monte avec k,")
print("c'est le resultat central de Snell : le gain du scaling depend du regime.")

Figure 1 : pass@k vs k. Si facile sature vite et difficile monte avec k,
c'est le resultat central de Snell : le gain du scaling depend du regime.

Lecture : la figure traduit le tableau — plateaux contre pentes

La Figure 1 porte en abscisse le k et en ordonnée le pass@k, une courbe par bucket. Les tables précédentes annoncent les formes : facile et moyen dessinent des lignes PLATES au plafond (la saturation est immédiate, la courbe ne raconte rien), difficile une PENTE qui monte de 0,50 vers 0,75 — c’est la courbe qui porte l’information, et elle monte exactement comme le prédit le régime « la capacité augmente avec le budget ». La légende imprimée sous la figure formule le critère de lecture : si facile sature vite et difficile monte avec k, le gain du scaling dépend du régime. Un détail de méthode : les points proviennent du MÊME tirage de 6 échantillons (l’estimateur binomial réutilise chaque tirage pour tous les k), ce qui rend les courbes cohérentes entre elles — mais avec un seul tirage par problème, la pente de difficile reste une estimation à petit n : la section 4 y reviendra honnêtement.

3. Compute-optimal — parallele (BoN) vs séquentiel (Reflexion)

A budget de calcul egal (même nombre d’appels), on compare deux stratégies : - BoN (parallele) : K echantillons independants, succes si l’un passe (pass@K). - Reflexion (séquentiel) : on genere, on verifie, on renvoie le diagnostic a l’LLM qui reessaie, jusqu’a K tours. Succes si un tour passe.

Snell : le séquentiel est compute-optimal sur les problemes difficiles (chaque essai profite du feedback), le parallele sur les faciles (pas besoin de feedback, juste retry).

K_SEQ = 4

def reflexion_sequentielle(enonce, attendu, K=4, model=FAST_MODEL):
    """K tours : genere, verifie, renvoie le feedback si rate."""
    global vides  # compte les reponses vides au niveau du module (collecte)
    verif = est_correct(attendu)
    feedback = ''
    for tour in range(1, K + 1):
        if not feedback:
            invite = enonce
        else:
            invite = (f'{enonce}\n\nEssai precedent INCORRECT. Feedback : {feedback}\n'
                      f'Reessaie correctement cette fois. Reponds par le nombre seul.')
        rep = chat(invite, model=model, temperature=0.7, max_tokens=4096)
        if not (rep or '').strip():
            vides += 1
        if verif(rep):
            return True, tour
        feedback = f'ta reponse etait {extraire_nombre(rep)} (incorrect)'
    return False, K

reflex = {b: [] for b in PROBLEMES}
vides = 0
total_reps = K_SEQ * sum(len(p) for p in PROBLEMES.values())
t0 = time.time()
print(f'Reflexion sequentielle : K={K_SEQ} tours max (modele={FAST_MODEL})')
for bucket, probs in PROBLEMES.items():
    for enonce, attendu in probs:
        ok, _ = reflexion_sequentielle(enonce, attendu, K=K_SEQ)
        reflex[bucket].append(int(ok))
    taux = sum(reflex[bucket]) / len(reflex[bucket])
    print(f'  bucket {bucket:9s} : taux Reflexion(K={K_SEQ}) = {taux:.2f}')
print(f'  Reponses vides (budget de raisonnement epuise) : {vides} appels')
print(f'  Duree : {time.time() - t0:.1f}s')

print(f'\n=== Compute-optimal : BoN pass@{K_SEQ} vs Reflexion K={K_SEQ} (budget egal) ===')
header = f'bucket      | BoN pass@{K_SEQ} | Reflexion K={K_SEQ}'
print(header); print('-' * len(header))
compare = {}
for b in PROBLEMES:
    bon = agg[b][K_SEQ]
    ref = sum(reflex[b]) / len(reflex[b])
    compare[b] = (bon, ref)
    gagnant = 'BoN' if bon > ref else ('Reflexion' if ref > bon else 'egal')
    print(f'{b:11s} |     {bon:.2f}      |     {ref:.2f}      <- {gagnant}')
Reflexion sequentielle : K=4 tours max (modele=qwen3.6-35b-a3b)
  bucket facile    : taux Reflexion(K=4) = 1.00
  bucket moyen     : taux Reflexion(K=4) = 1.00
  bucket difficile : taux Reflexion(K=4) = 0.75
  Reponses vides (budget de raisonnement epuise) : 6 appels
  Duree : 281.7s

=== Compute-optimal : BoN pass@4 vs Reflexion K=4 (budget egal) ===
bucket      | BoN pass@4 | Reflexion K=4
----------------------------------------
facile      |     1.00      |     1.00      <- egal
moyen       |     1.00      |     1.00      <- egal
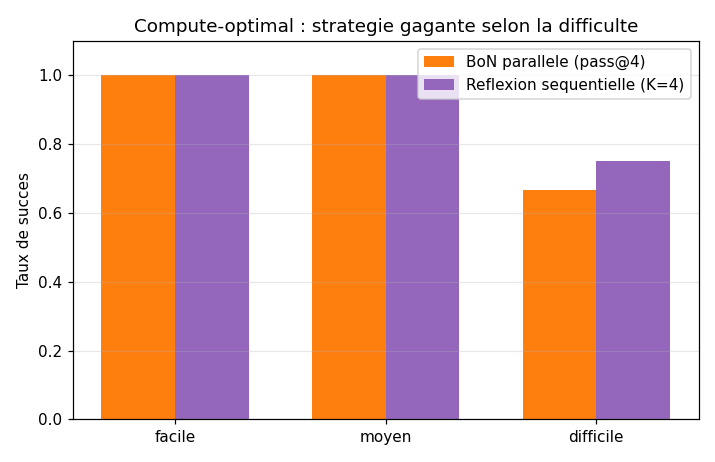
difficile   |     0.67      |     0.75      <- Reflexion

Lecture : la frontière compute-optimale apparaît sur « difficile » — une réalisation, pas une loi

Le tableau final compare, à budget de calcul ÉGAL (4 appels), le parallèle (BoN pass@4) et le séquentiel (Reflexion K=4) : 1,00 / 1,00 et 1,00 / 1,00 sur facile et moyen — annotations <- egal, plafond commun, ces régimes saturés ne pouvaient pas départager les stratégies — et sur difficile 0,67 contre 0,75, annotation <- Reflexion. Sur CE run, la frontière de Snell apparaît exactement là où elle est prédite : le séquentiel (affiner par le retour du vérificateur) gagne sur le bucket difficile, et le parallèle suffit là où le modèle est déjà fiable. La réserve est tout aussi importante que la conformité : Reflexion résout ici 3 énoncés sur 4 (0,75), l’écart avec BoN (0,67) tient dans la marge d’un seul énoncé — un seul échantillon qui bascule renverse le verdict, et le décodage est échantillonné (temperature=0.7) sans graine (la section 4 pose la règle : le verdict BoN vs Reflexion est un tirage, les nombres cités une réalisation, pas une loi). Six appels vides côté Reflexion sont de surcroît comptés comme des échecs : le 0,75 est une borne inférieure. Ce run est conforme à la prédiction de Snell ; il ne l’établit pas statistiquement — départager parallèle et séquentiel exige des n plus grands et des problèmes plus discriminants, exactement l’objet des exercices 1 et 3 (l’exercice 2 en quantifie le bruit par intervalle de confiance).

# Figure 2 : BoN parallele vs Reflexion sequentielle par bucket (frontiere compute-optimale).
fig, ax = plt.subplots(figsize=(6.5, 4.2))
buckets = list(PROBLEMES.keys())
x = range(len(buckets))
bon_vals = [compare[b][0] for b in buckets]
ref_vals = [compare[b][1] for b in buckets]
w = 0.35
ax.bar([i - w/2 for i in x], bon_vals, w, label=f"BoN parallele (pass@{K_SEQ})", color="#ff7f0e")
ax.bar([i + w/2 for i in x], ref_vals, w, label=f"Reflexion sequentielle (K={K_SEQ})", color="#9467bd")
ax.set_ylabel("Taux de succes"); ax.set_ylim(0, 1.1)
ax.set_title("Compute-optimal : strategie gagante selon la difficulte")
ax.set_xticks(list(x)); ax.set_xticklabels(buckets)
ax.legend(); ax.grid(True, alpha=0.3, axis="y")
buf = io.BytesIO(); fig.tight_layout(); fig.savefig(buf, format="png", dpi=110); plt.close(fig)
buf.seek(0); display(Image(data=buf.read()))
print("Figure 2 : si Reflexion gagne sur 'difficile' et BoN sur 'facile', c'est la")
print("frontiere compute-optimale de Snell (chaque regime a sa strategie).")

Figure 2 : si Reflexion gagne sur 'difficile' et BoN sur 'facile', c'est la
frontiere compute-optimale de Snell (chaque regime a sa strategie).

4. Limites honnetes (G.2) et lecture des resultats

Ce notebook est illustratif, pas une replication a l’echelle de Snell et al. 2024 :

  • Petit n / petit K (N_ECH = 6 echantillons par probleme, K <= 6) : l’estimateur pass@k a une variance elevee ; les courbes sont bruitees. Snell utilise des milliers d’echantillons sur des centaines de problemes de competition (MATH). Avec 3 a 4 problemes par bucket, les estimations de pente sont des INDICATIONS, pas des mesures precises.
  • Modele maison Qwen3.6-35B-A3B (servi par la facade, x-proxy-key) : choix delibere conforme a la migration issue #14755 (substitution des modeles 2024 du type gpt-4o-mini par notre infrastructure). Aucun chiffre d’un run anterieur a un autre modele n’est repris ici : les seules valeurs citees sont celles imprimees par la presente execution.
  • Verificateur exact (entier) : pas de juge LLM, donc pass@k est objectif, mais cela limite le notebook a des problemes a reponse entiere.
  • Reponses vides : sur un probleme a calcul lourd, le modele peut epuiser tout son budget en raisonnement interne et rendre un contenu vide. Ce n’est pas une erreur de raisonnement mais un artefact de budget ; les deux cellules de collecte les comptent donc separement.
  • Le verdict BoN vs Reflexion est un tirage. Le decodage est echantillonne (temperature 0.7) et sans graine dans les deux chemins (echantillonner_bon, reflexion_sequentielle) : sur un bucket de 4 enonces, un seul echantillon qui bascule deplace le verdict de la section 6. Les nombres cites sont UNE realisation, pas une loi.
  • Cout : le test-time compute a un cout API reel (k echantillons = k appels) – c’est le compromis que Snell met en balance contre le cout d’entrainement. BATCH_MODE=true plafonne N_ECH a 6.

Ce qui est demontre ici : la methodologie – suite graduee, verite terrain recalculee par enumeration exacte a chaque execution, estimateur pass@k non-biaise, comparaison parallele/sequentiel a budget egal. La section 6 enonce le resultat mesure sur cette suite, y compris s’il est negatif.

Note methodologique — un attendu faux fabrique un faux discriminant.

Le bucket difficile a ete choisi par un pilote de discrimination : 25+ candidats evalues sur le modele servi (N=6, temp 0.7), afin de ne garder que les enonces qui ne saturent pas. Ce pilote a d’abord designe un candidat « comites de 3 parmi 8 dont un trio inseparable », annote 0/6.

Ce candidat etait un faux positif, et la cause vaut d’etre retenue : la question demande les comites ou le trio est insécable, donc valides = ceux qui ne contiennent aucun membre du trio, ou les trois – soit C(5,3) + 1 = 11. Le bloc de controle comptait « au plus 1 membre du trio » = 40, c’est-a-dire une autre question. Le modele repondait 11 six fois sur six : il avait raison, la verite terrain avait tort.

La lecon est en deux temps, et le second est le piege :

  1. un attendu doit etre recalcule par une enumeration exacte (c’est ce que fait _controles) ; mais
  2. l’enumeration ne protege que si elle calcule la quantite que l’enonce demande. La force brute attrape une erreur d’arithmetique, jamais une erreur de specification – un controle qui compte consciencieusement la mauvaise chose rend un nombre exact et une conclusion fausse.

D’ou les deux disciplines du bloc _controles : chaque controle enonce la quantite en toutes lettres dans sa docstring, et tout comptage non trivial est croise par son complementaire (valides + invalides = total), ce qui attrape un terme oublie. Le croisement ne remplace pas la relecture de l’enonce.

5. Travaux pratiques

Les exercices sont a completer (convention C.1 : pas d’erreur volontaire).

Exercice 1 : etendre le banc et le re-mesurer

Ajoutez 2 problemes a reponse entiere de niveau competition dans PROBLEMES['difficile'], prouvez chaque attendu par enumeration exacte (comme les controles de la cellule du banc – « verifie a la main » n’est pas une preuve), puis relancez la collecte (N_ECH = 16, BATCH_MODE=false).

Deux pieges a eviter, tous deux mesures dans ce notebook :

  1. L’attendu faux. Le controle doit calculer la quantite que votre enonce demande, pas une quantite voisine : voir la note methodologique de la section 4. Ecrivez la quantite en toutes lettres dans la docstring du controle, et croisez les comptages non triviaux par leur complementaire.
  2. Le probleme trop lourd. Au-dela d’un certain volume de calcul, le modele n’essaie plus de repondre : il epuise son budget de raisonnement et rend un contenu vide. Visez un pass@1 compris entre 0.2 et 0.8 – en dessous, BoN et Reflexion restent tous deux a 0 par artefact de budget ; au-dessus, la frontiere s’aplatit.

Indice : garder le format (enonce, attendu) et ajouter votre controle au dictionnaire _controles, qui est indexe par l’enonce – l’AssertionError vous preveniendra si un enonce n’a pas de controle, si un controle est orphelin, ou si l’attendu declare differe du recalcul.

def ajouter_bucket_competition():
    """Exercice 1 : retourne 2 problemes MATH/AMC [(enonce, attendu), ...] dont les attendus sont prouves par enumeration exacte (bloc _controles)."""
    # TODO etudiant : verifier chaque attendu par enumeration exacte, comme _controles.
    return None

_r = ajouter_bucket_competition()
print(f"Exercice 1 - bucket competition : {'defini' if _r is not None else 'a completer'}")
Exercice 1 - bucket competition : a completer

Exercice 2 : estimateur pass@k multi-trials avec bootstrap

L’estimateur actuel calcule pass@k depuis une seule serie de n echantillons. Implemente l’estimation sur plusieurs trials independants : t jeux de n echantillons, et moyenne + ecart-type (ou IC bootstrap 95%) — pour quantifier le bruit souligne en section 4.

Indice : pour chaque probleme, tires t jeux de n echantillons, calcule pass@k sur chaque jeu, puis moyenne + ecart-type.

def pass_at_k_avec_ic(enonce, attendu, k, n=6, trials=3):
    """Exercice 2 : pass@k moyen + intervalle de confiance bootstrap sur `trials` essais."""
    # TODO etudiant : t trials de n echantillons chacun -> pass@k par trial -> IC.
    return None

print(f"Exercice 2 - pass@k + IC : {'implemente' if False else 'a completer'}")
Exercice 2 - pass@k + IC : a completer

Exercice 3 (avance) : frontiere compute-optimale reelle (budget variable)

Trace la frontiere compute-optimale : pour chaque budget total B (appels) de 1 a 16, calcule le taux de succes max entre BoN(B) et Reflexion(B), par bucket. Affiche la strategie gagnante en fonction de B et de la difficulte (une heatmap bucket x B).

Indice : boucle sur B, evalue BoN pass@B et Reflexion K=B, garde le max ; heatmap matplotlib (imshow) bucket (lignes) x B (colonnes) coloree par la strategie gagnante.

def frontiere_compute_optimale(budgets=range(1, 9)):
    """Exercice 3 : pour chaque budget, strategie gagante (BoN vs Reflexion) par bucket."""
    # TODO etudiant : boucler sur budgets, evaluer les deux strategies, renvoyer la matrice.
    return None

print(f"Exercice 3 - frontiere compute-optimale : {'implemente' if False else 'a completer'}")
Exercice 3 - frontiere compute-optimale : a completer

6. Conclusion et suite

On a mesure le scaling du test-time compute (Snell et al. 2024) sur notre infrastructure : pass@k par bucket de difficulte (estimateur non-biaise HumanEval) et comparaison parallele (BoN) vs sequentiel (Reflexion) a budget egal.

Resultats observes (modele qwen3.6-35b-a3b servi par la facade, N_ECH = 6 echantillons / probleme, execution de ce notebook) :

bucket pass@1 pass@2 pass@4 pass@6 BoN pass@4 Reflexion K=4
facile 1.00 1.00 1.00 1.00 1.00 1.00
moyen 1.00 1.00 1.00 1.00 1.00 1.00
difficile 0.50 0.58 0.67 0.75 0.67 0.75

Lecture : Le bucket difficile porte du relief : pass@1 = 0.50 contre 1.00 et 1.00 sur facile et moyen. Sur ce bucket, BoN pass@4 = 0.67 et Reflexion K=4 = 0.75 : Reflexion > BoN – un verdict qui, sur 4 enonces et a decodage echantillonne sans graine, reste un tirage (section 4). Le relief compute-optimal ne se lit donc que sur le bucket non sature – c’est le regime que Snell decrit, et il n’apparait ici que parce que la suite a ete recalibree par la mesure.

Reponses vides (budget de raisonnement epuise, comptees a part) : 12/60 appels en BoN, 6 en Reflexion. Une reponse vide n’est pas une erreur de raisonnement ; la compter comme telle gonflerait artificiellement la difficulte.

Methodologie : la frontiere BoN/Reflexion ne se lit que si la suite discrimine reellement. Le bucket difficile n’a donc pas ete choisi par intuition mais par un pilote de discrimination (25+ candidats, N=6 par candidat, attendus recalcules par enumeration exacte) ; la section 4 documente le piege rencontre – un attendu faux, qui a designe un faux discriminant. Les estimateurs (pass@k non-biaise, HumaneEval), les deux strategies et la comparaison a budget egal restent valides et reutilisables tels quels.

Suite de l’epic #2926 : - Phase 5 – suite de competition a reponse entiere assez large (MATH/AMC, dizaines de problemes) pour faire apparaitre la frontiere sur un modele qui sature les enonces courts. - Phase 6 – plugin Semantic Kernel (pont series SemanticKernel, integration Python).

References : Snell, Lee, Xu, Kumar, “Scaling LLM Test-Time Compute Optimally” (2024) ; Chen et al., “Evaluating Large Language Models Trained on Code” (HumanEval, pass@k, 2021) ; Yao et al., “Tree of Thoughts” (2023) ; NB-12/13/14/15 de cette serie.

Retour au sommet